Engineering
SRE팀 테이블 명세서 자동화 구축기
Olivia Kim여기어때
2024년 12월 11일
원문에서 보기 ↗안녕하세요, 여기어때컴퍼니 SRE팀 인턴으로 합류한 올리비아입니다.
약 1달 반 동안 ‘테이블 명세서 자동화 프로젝트’를 진행한 경험을 공유하려 합니다.
먼저 프로젝트 배경을 이해하기 위해, 여기어때에서 사용하는 Amazon Aurora에 대해 간단히 설명드리겠습니다. Amazon Aurora는 MySQL 및 PostgreSQL과 호환되는 완전 관리형 관계형 데이터베이스 엔진입니다.
Amazon Aurora에서는 아래와 같은 네 가지 종류의 엔드포인트를 지원합니다:
- 클러스터 엔드포인트 (Cluster endpoint): DB 클러스터의 Writer Instance에 연결되는 엔드포인트 (인스턴스 1개)
- 리더 엔드포인트 (Reader endpoint): DB 클러스터의 Reader Instance에 연결되는 엔드포인트 (인스턴스 n개)
- 커스터머 지정 엔드포인트 (Customer endpoint): 인스턴스의 역할(Writer/Reader)에 상관없이 정의 가능한 엔드포인트
- 인스턴스 엔드포인트 (Instance endpoint): 특정 DB 인스턴스에 연결되는 엔드포인트
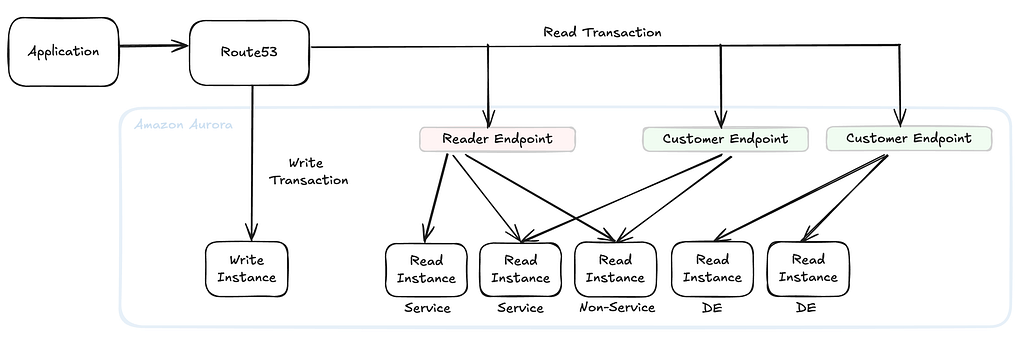
SRE팀 내 Aurora 구성을 참고하여 작성함
여기어때에서는 리더 인스턴스가 필요할 때 리더 엔드포인트 와 커스터머 엔드포인트 를 주로 사용합니다. 특히, 커스터머 엔드포인트는 서비스 트래픽과 비서비스 트래픽을 구분해 DB 운영 효율성을 높이기 위해 활용됩니다.
- 서비스 트래픽: WAS가 클라이언트와 서버의 데이터베이스(DB), 외부 API 등과 통신하면서 처리하는 모든 작업
- 비서비스 트래픽: 데이터 분석, 백업, 유지보수와 같이 사용자 요청과 무관하게 내부 시스템에서 발생하는 데이터 처리 작업
만약 리더 엔드포인트 를 통해 서비스/비서비스 트래픽을 동시에 처리한다면, 서비스 트래픽의 성능이 저하될 가능성이 있습니다. 따라서 비서비스 트래픽은 커스터머 엔드포인트를 사용해 별도로 처리하고 있습니다. 이런 이해를 바탕으로, 이번 프로젝트에서는 클러스터 정보를 가져오기 위해 리더 엔드포인트를 활용했습니다.
1. 문제 배경
그동안 SRE팀-DBA 파트에서 대부분의 테이블 명세서를 관리해 왔으나 일부는 조직별로 관리되는 테이블 명세서도 있고 최신화 기준이 상이하여 다음과 같은 어려움이 존재했습니다:
- 오너십이 있는 일부 조직에서도 직접 테이블 명세를 관리하다 보니 전사적 표준화가 어려움
- 위 사유로 다양한 관리 도구를 이용한 테이블 명세 포맷으로 통합 관리와 최신화 어려움
- 다른 조직의 데이터 모델링 문서에 대한 접근성이 낮음
위 어려움을 개선하고자, 각 팀에서 제공하는 테이블 명세서를 Confluence 페이지를 통해 링크 형태로 취합 및 관리하는 프로젝트를 진행했습니다. 프로젝트 구성의 순서는 다음과 같습니다.
- DB 객체 정보 수집 : Aurora 클러스터, 데이터베이스와 테이블 정보를 자동으로 수집
- 수집 데이터를 기반으로 테이블마다 메타데이터 표 작성: 테이블 구조, 컬럼 설명, 데이터 타입, 인덱스 등을 포함하여 메타데이터 표를 생성
- 자동화 스케줄링: 매일 메타데이터 표를 갱신해, 모든 문서가 전일 기준으로 최신 상태를 유지하도록 설정
2. 프로젝트 결과
보안상 회사의 데이터를 보여드리기 어려워, 구축한 내용을 예시와 함께 이미지로 설명하겠습니다.
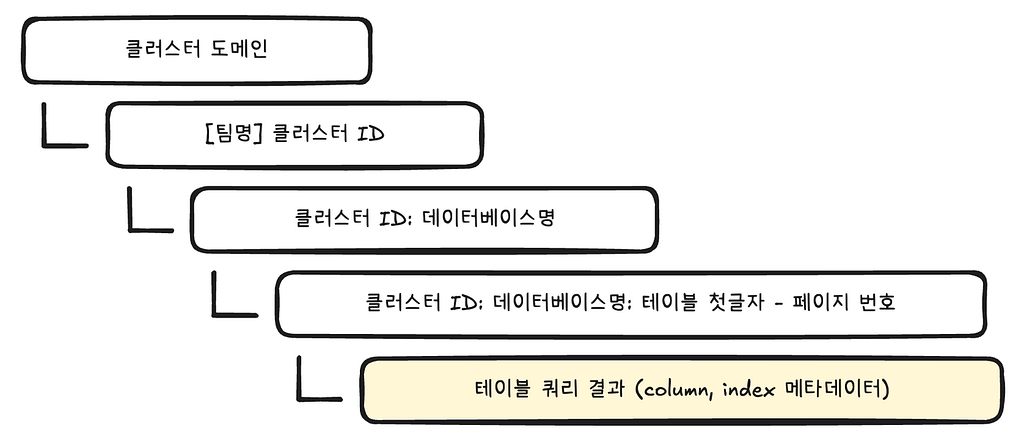
전체 Confluence 페이지 구조 (계단식)
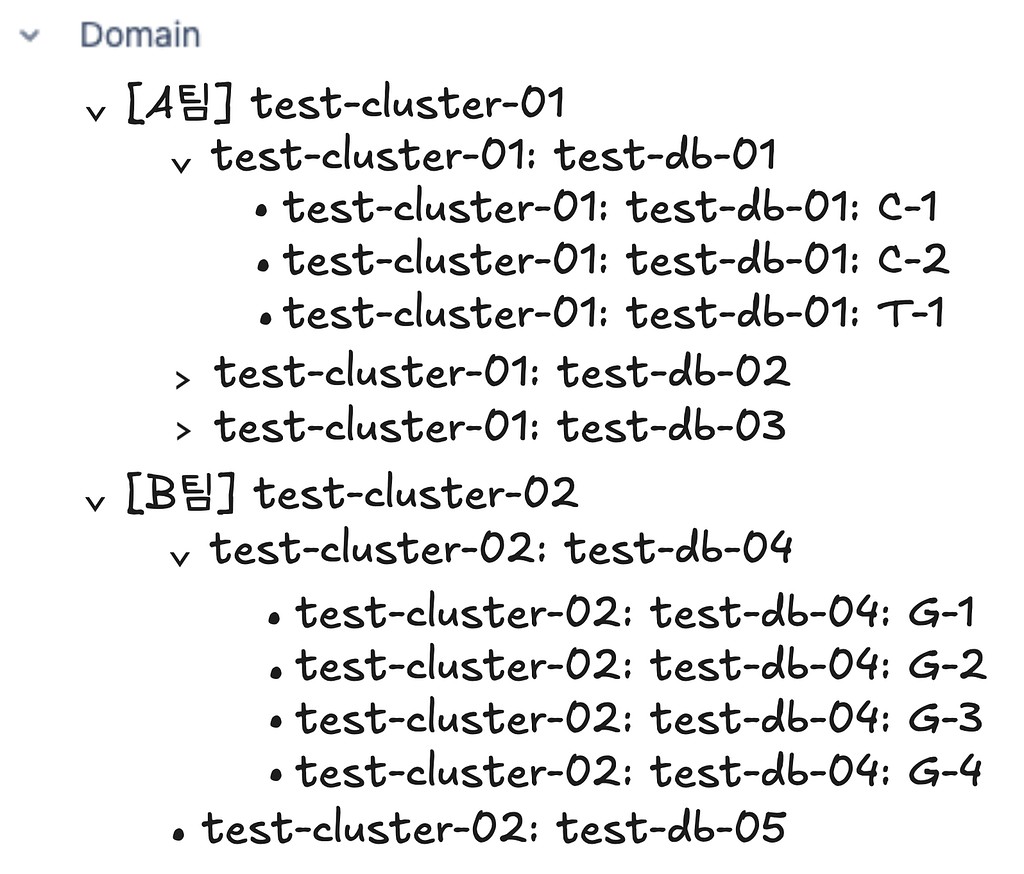
일부 Confluence 페이지 구조 예시
SRE팀의 테이블 명세서 페이지 구조는 위처럼 도메인, 클러스터, 데이터베이스, 테이블 순으로 계단식 페이지 구조로 만들어 각 데이터를 체계적으로 정리했습니다.
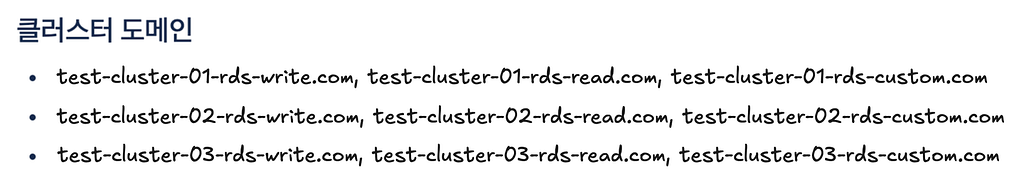
도메인 페이지 예시
도메인 페이지에서는 자식 페이지인 클러스터 페이지들(40개)의 도메인들을 확인할 수 있습니다. 라이터 도메인, 리더 도메인, 커스터머 도메인 모두 표기해두었습니다.
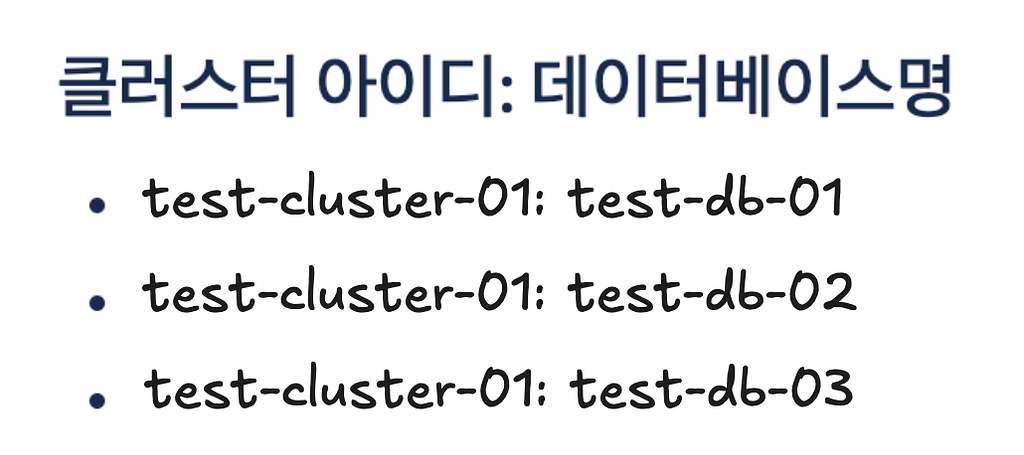
클러스터 페이지 예시
클러스터 페이지에서는 자식페이지인 데이터베이스들을 확인할 수 있습니다.
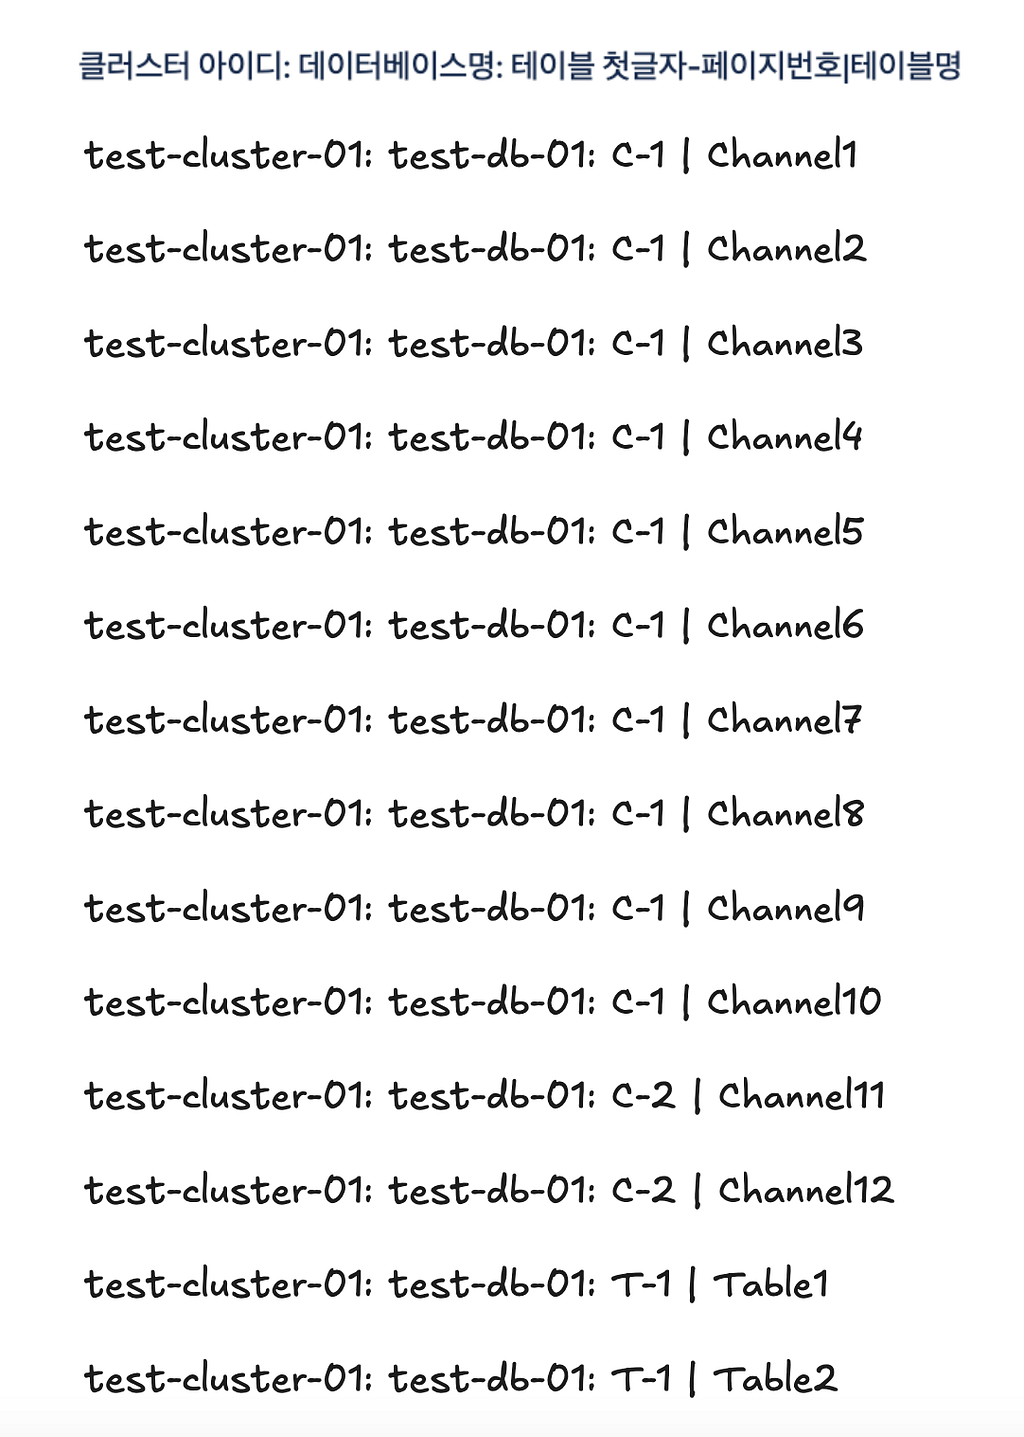
데이터베이스 페이지 예시
데이터베이스 페이지에서는 자식페이지인 테이블들을 확인할 수 있습니다. 링크를 클릭시, 해당 테이블의 메타데이터 표로 이동합니다. 실제 테이블의 메타데이터 표로 이동하면,
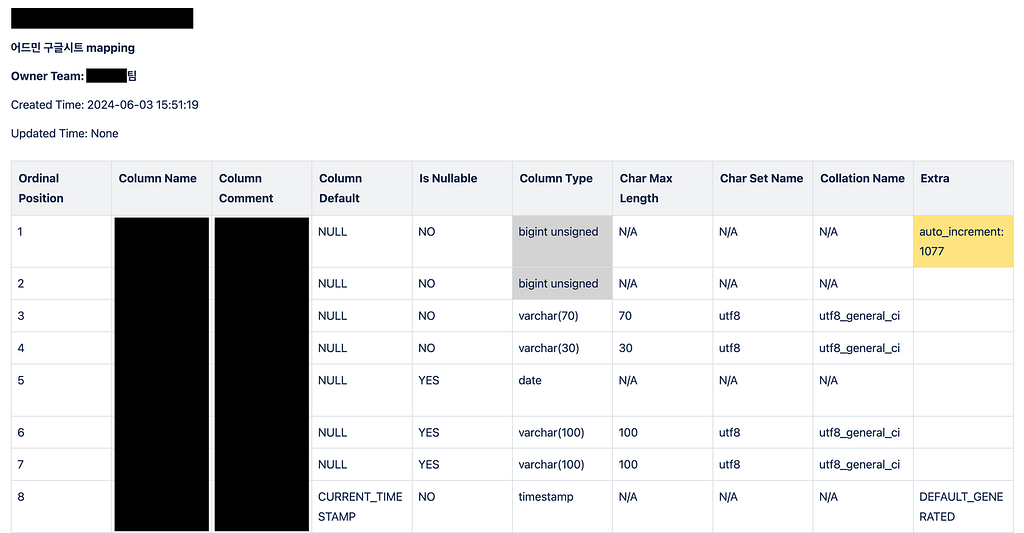
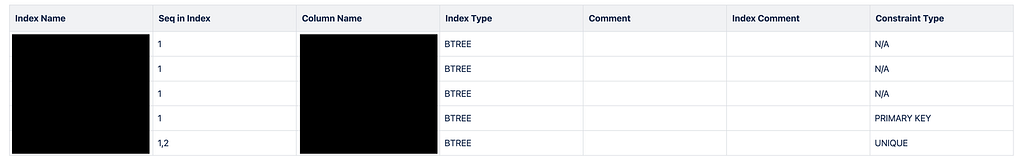
테이블에 대한 메타 데이터인 ‘컬럼 메타 데이터 표’와 ‘인덱스 메타 데이터 표’를 확인할 수 있습니다.
3. 이슈 및 해결
- 데이터 정리
def list_rds_clusters():
    rds_client = boto3.client(
        'rds',
        aws_access_key_id=PROD_ACCESSKEY,
        aws_secret_access_key=PROD_SECRETKEY,
        region_name=PROD_REGION
    )

    # RDS 클러스터 목록 가져오기
    clusters = rds_client.describe_db_clusters()

    # 클러스터 정보를 저장할 딕셔너리 초기화
    cluster_instances = {}
    owner_teams = fetch_all_owner_teams()

    # 각 클러스터에 대해 반복
    for cluster in clusters['DBClusters']:
        cluster_id = cluster['DBClusterIdentifier']

        # 클러스터 정보 초기화 (엔드포인트, 데이터베이스, 팀 정보)
        cluster_instances[cluster_id] = {'endpoints': [], 'databases': {}, 'team': []}

        # 클러스터의 'Team' 태그 값을 가져오기
        team_value = get_tag_value(cluster, 'Team')

        if team_value:
            # team_value가 리스트가 아닐 경우 리스트로 변환
            if isinstance(team_value, list):
                cluster_instances[cluster_id]['team'].extend(team_value)  # 여러 팀 값을 추가
            else:
                cluster_instances[cluster_id]['team'].append(team_value)  # 단일 팀 값을 추가

        # 엔드포인트 리스트에 값 추가
        endpoint_keys = ['Endpoint', 'ReaderEndpoint', 'CustomEndpoints']
        for key in endpoint_keys:
            endpoint = cluster.get(key, None)
            if endpoint:
                if isinstance(endpoint, list):  # 리스트일 경우 각 요소를 추가
                    cluster_instances[cluster_id]['endpoints'].extend(endpoint)
                else:
                    cluster_instances[cluster_id]['endpoints'].append(endpoint)

        # 데이터베이스 및 테이블 정보 가져오기
        for cluster_name, cluster_info in cluster_instances.items():
            if cluster_info['endpoints']:
                # ReaderEndpoint 사용하여 인스턴스 엔드포인트 가져오기
                first_endpoint = cluster_info['endpoints'][1]
                cluster_info['identifier'] = cluster_name  # 클러스터 이름을 identifier로 설정

                # cluster_name과 owner_teams를 넘겨서 데이터베이스 및 테이블 정보 가져오기
                cluster_info['databases'] = fetch_databases_and_tables(first_endpoint, cluster_name, owner_teams)

    return cluster_instances
클러스터, 데이터베이스, 테이블, 오너십 등 관련된 모든 정보를 체계적으로 관리하기 위해, 이를 하나의 cluster_info 딕셔너리에 정리하여 필요할 때 효율적으로 활용할 수 있도록 코드를 설계했습니다.
2. 페이지 생성 API 호출 속도 느림
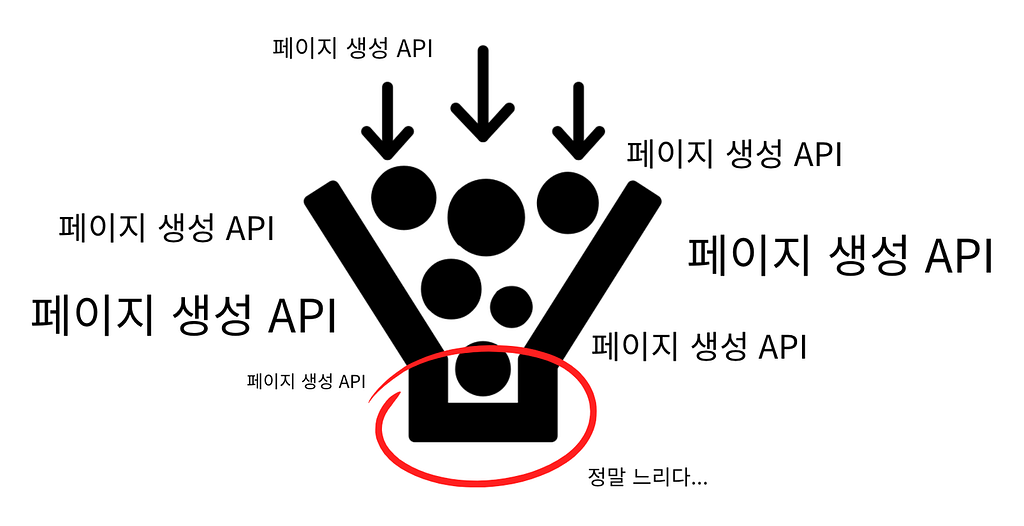
최종적으로 1000개가 넘는 페이지를 만들어야 하기에, 페이지 생성 API를 순차적으로 호출할 경우 25분의 시간이 소요되었습니다. Python의 ThreadPoolExecutor 를 사용해 클러스터 단위로 병렬처리하여 소요시간을 11분까지 단축시켰습니다.
3. 페이지 생성 API 실패
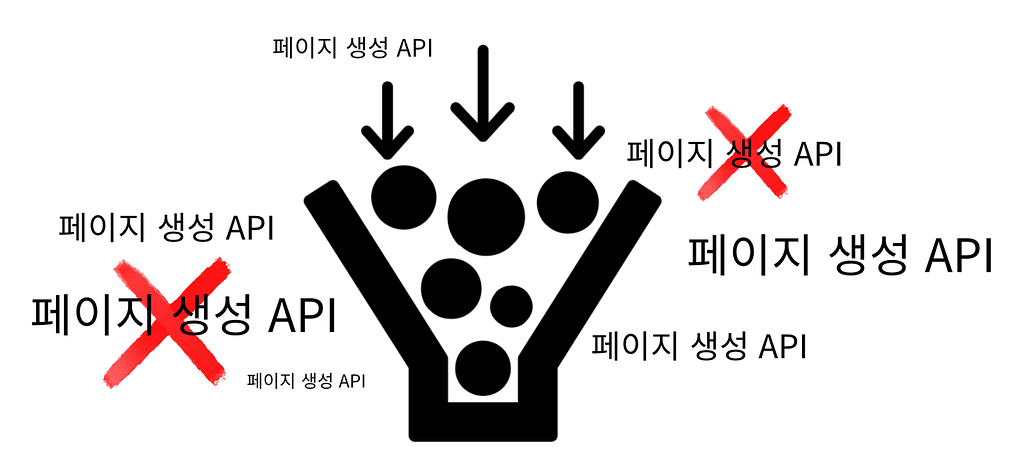
하지만, 많은 API들이 병렬로 호출되다보니 간헐적으로 페이지 생성에 실패했습니다. API Response를 확인해보면 방금 생성된 페이지 ID가 나와있으나, 실제로 Confluence에서는 해당 페이지가 없다는 걸 발견했습니다.
# 페이지가 실제로 존재하는지 확인
def current_page_exists(title, space_key):
    url = f"{BASE_URL}?title={title}&spaceKey={space_key}"
    response = requests.get(url, headers=HEADERS)
    if response.status_code == 200:
        results = response.json()
        if results['size'] > 0:
            return results['results'][0]  # 페이지 정보 반환
    return None  # 페이지가 존재하지 않음
for attempt in range(1, MAX_RETRIES + 1):
    response = requests.post(url, headers=HEADERS, data=json.dumps(data))

    if response.status_code in [200, 201]:
        print(f"페이지 '{title}' 생성 성공!")

        # 페이지가 실제로 존재하는지 확인
        existing_page = current_page_exists(response.json()['title'], response.json()['space']['key'])

        if existing_page:
            return response.json()  # 페이지 생성 성공 및 존재 확인 시 결과 반환

        else:
            print(f"페이지 '{title}'가 생성 실패!")
따라서 실제로 페이지가 있는지 추가적으로 확인 한 후에, 없다면 생성 API를 재호출 하도록 로직을 수정했습니다.
4. UI에 대한 고민
이 부분은 여러 개발자분들께 조언을 구하며 고민을 많이 했던 부분입니다. 원하는 데이터를 찾을 때, 어떻게 UI를 구성하면 편하게 접근할 수 있을지 생각해 보았습니다.
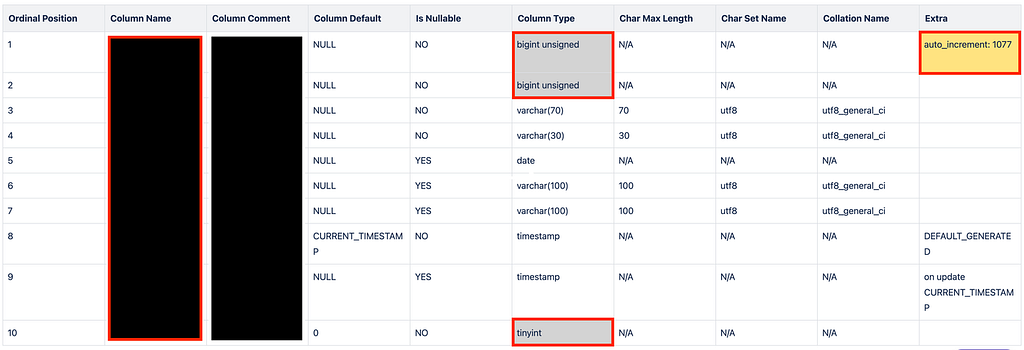
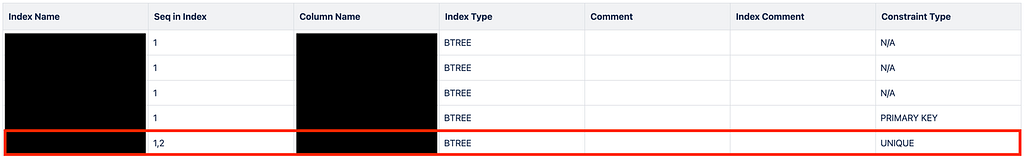
우선 컬럼 메타데이터의 경우 Column Name, Column Type 숫자형, Auto_increment 에 대해 색을 입혔습니다. 인덱스 메타데이터의 경우 Column Name에 색을 입히고 같은 인덱스 네이밍을 가진 경우 하나의 튜플로 합쳐 보여도록 SQL문을 작성했습니다.
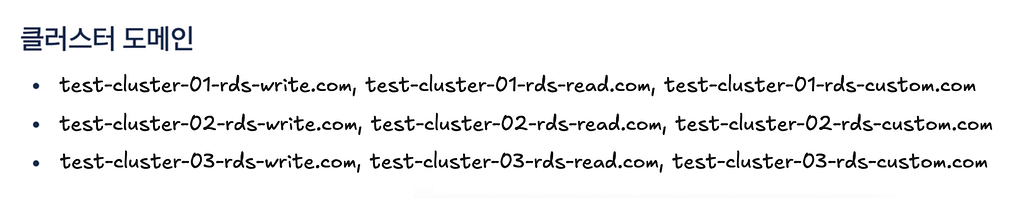
추가적으로 개발자분들께서 클러스터에 접근할 경우, 엔드포인트 단위가 아닌 도메인 단위로 접근한다는 것을 알고 AWS Route53을 활용해 엔드포인트에 매칭되는 도메인을 찾아내는 작업을 진행했습니다.
5. 링크 클릭시 이동 속도 느림
예를 들어, ‘test-db-01’ 데이터베이스의 ‘Channel7’ 테이블 명세서를 보기 위해 링크를 클릭했을 때, ‘C’로 시작하는 테이블이 많다면 메타데이터 표로 이동하기까지 오랜 시간이 걸렸습니다. 따라서 페이지당 10개의 테이블 메타데이터 표만 들어갈 수 있도록 페이지네이션을 구현했습니다. (검색속도 1/10)
for table_name, table_data in tables_info.items():
    html_table = table_data['html_content']
    first_letter = table_name[0].upper()  # 테이블 이름의 첫 글자 대문자
    if first_letter not in table_dict:
        table_dict[first_letter] = []  # 첫 글자가 없으면 새 리스트 생성
    table_dict[first_letter].append(
        (table_name, html_table))  # 'D': [("DB1", html),("DB2", html),("DB3", html)]

# 테이블 페이지 생성 및 업데이트
table_links = ""  # 모든 테이블에 대한 링크를 저장할 변수

for first_letter, tables in table_dict.items():
    page_count = 0
    num_tables_per_page = 10  # 한 페이지에 들어갈 테이블 개수 설정

    for i in range(0, len(tables), num_tables_per_page):
        page_title = f"{identifier}: {db_name}: {first_letter}-{page_count + 1}" # 페이지 제목 생성
        ...
        page_count += 1
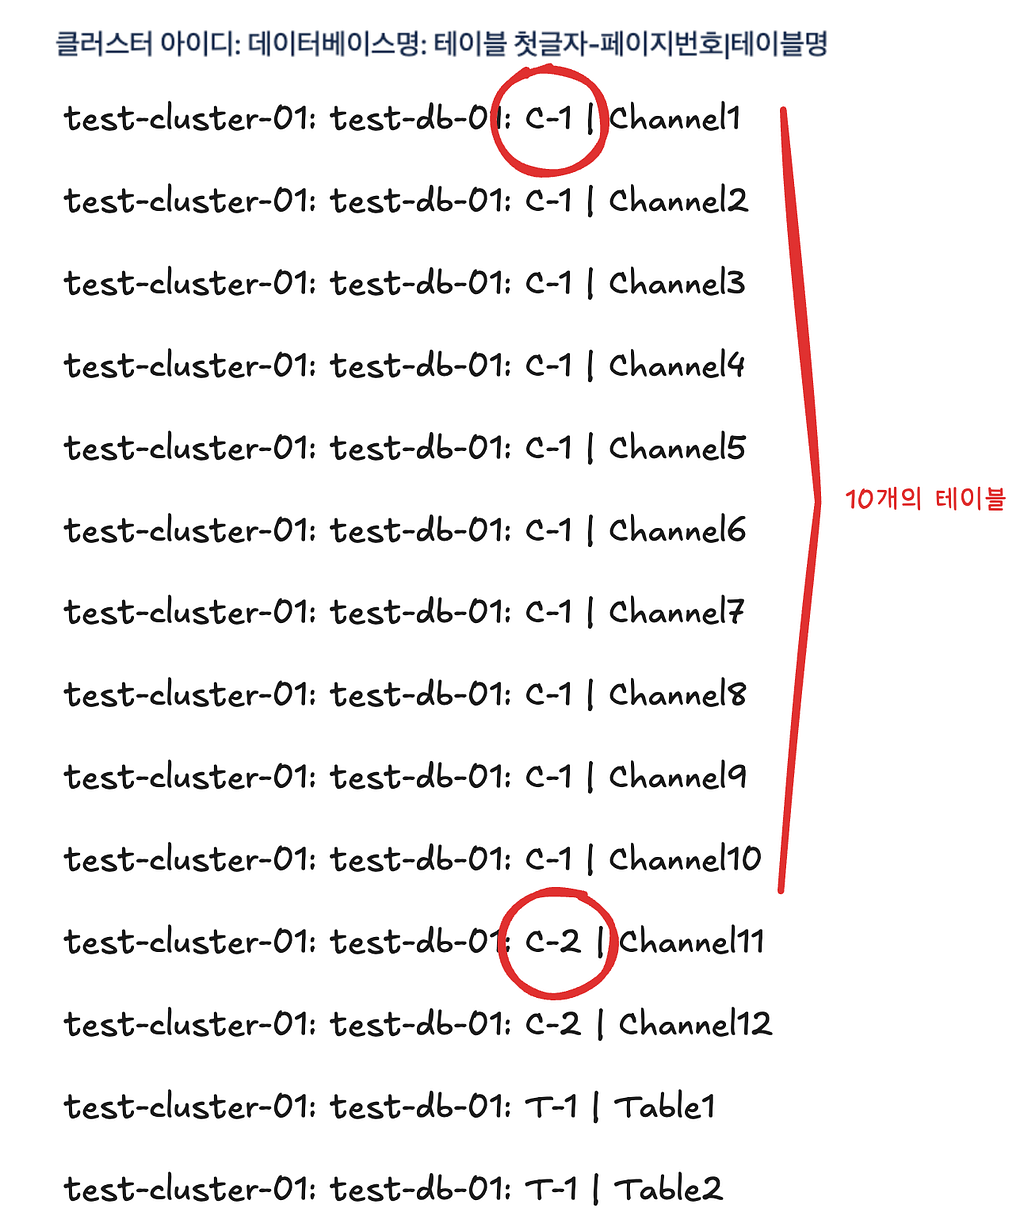
이로써 테이블 링크를 클릭해도 빠르게 해당 테이블 명세서로 이동이 가능해졌습니다.
6. Confluence의 한계로 인한 문제 발생 (1)
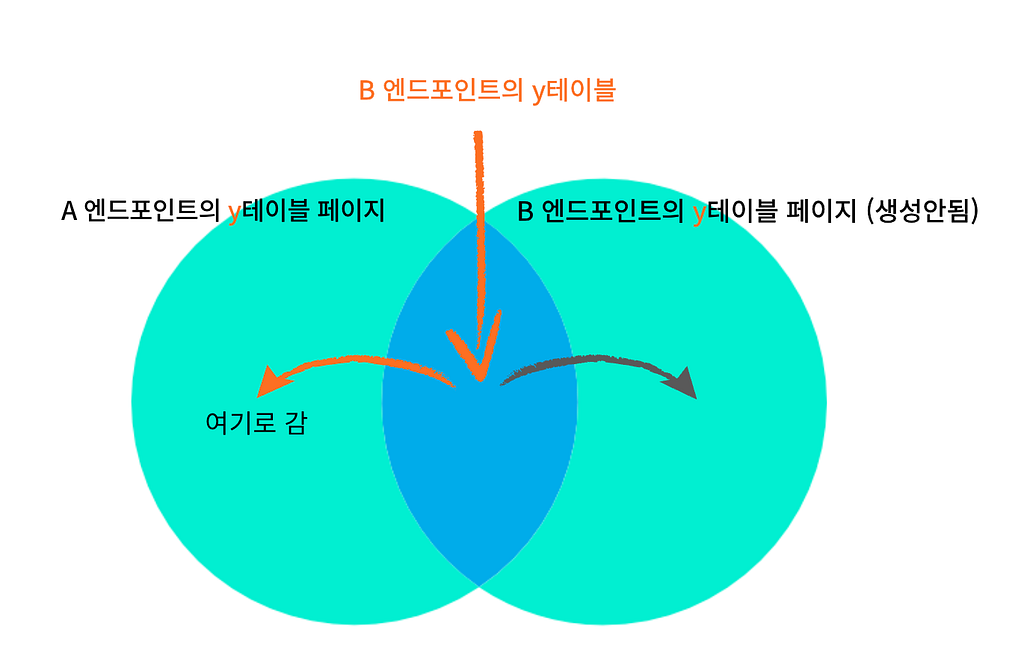
데이터 검수를 하던 중, ‘B엔드포인트의 y테이블’이 ‘A엔드포인트의 y테이블 페이지’에 생성된다는 것을 발견했습니다. 이는 Confluence에서 같은 네이밍의 페이지가 이미 존재하는 경우, 페이지 생성이 불가능하기 때문입니다. 팀원들과 소통을 통해 페이지 네이밍이 중복되지 않도록 변경하여 해결했습니다.
7. Confluence의 한계로 인한 문제 발생 (2)
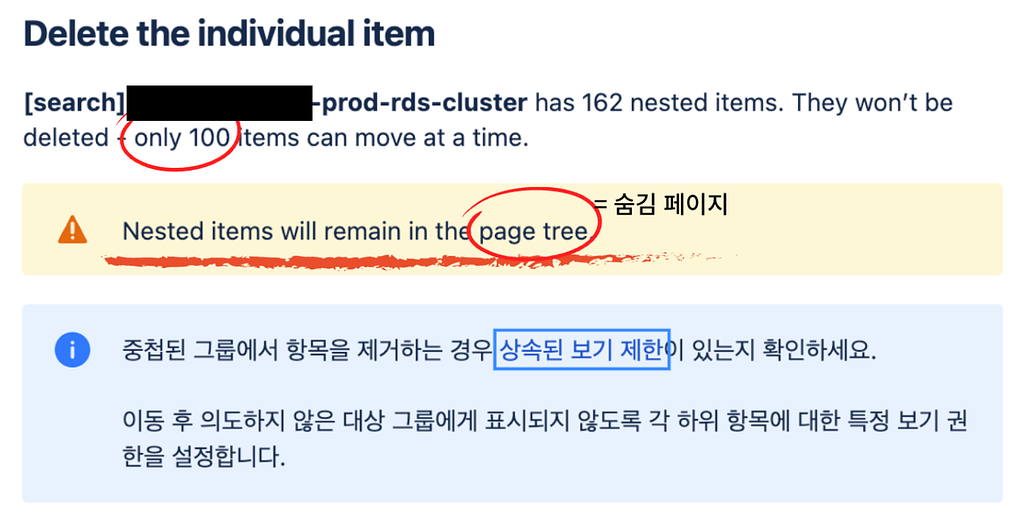
매일 테이블 명세서를 최신화하는 만큼, 오전 2시에 페이지를 모두 삭제하고 생성하는 작업이 수행됩니다. 위의 사례와 마찬가지로 데이터 검수를 하던 중, 프로그램을 실행할 때마다 총 페이지 수가 줄어드는 것을 발견했습니다. 그 이유는 페이지 삭제 API를 날리면서 부모페이지부터 삭제하다 보니, 해당 페이지의 자식페이지가 100개를 넘는 순간 Confluence의 Page Tree(=숨김 페이지)로 넘어가기 때문이었습니다. 결과적으로 일부 페이지가 제대로 삭제되지 않아 최신화된 페이지 생성에 실패한 것입니다. 추가적으로, 1000번의 삭제 API를 호출하다보니 간헐적으로 실패가 발생했습니다.
def delete_all_descendants(parent_id, space_key, first_parent_id):
    child_pages = fetch_child_pages(parent_id, space_key) # 자식 페이지 가져오기

    # 마지막 자식 페이지까지 순회하며 모든 하위 페이지 삭제
    for child in child_pages:
        delete_all_descendants(child['id'], space_key,first_parent_id)

    if parent_id != first_parent_id:  # 첫 번째 부모 페이지는 삭제하지 않음
        while True:
            remaining_children = fetch_child_pages(parent_id, space_key)
            if not remaining_children:  # 자식 페이지가 모두 삭제된 경우에만 부모 페이지 삭제
                delete_page(parent_id)
                break  # 부모 페이지를 삭제한 후 루프 종료
            else:
                for child in remaining_children:  # 자식 페이지가 남아 있다면 다시 삭제 시도
                    delete_all_descendants(child['id'], space_key, first_parent_id)
따라서 자식페이지부터 삭제하도록 코드를 수정함과 동시에 반복문을 통해 모든 자식페이지가 삭제된 후에야 부모페이지가 삭제될 수 있도록 코드를 수정해 앞으로의 문제를 예방하고,
def get_orphaned_page_ids(space_key):
    page_ids = []  # 삭제해야 하는 페이지 ID를 담을 리스트
    start_index = 0

    while True:
        url = f"{BASE_URL}?key={space_key}&startIndex={start_index}"
        response = requests.get(url, headers=HEADERS)

        if response.status_code != 200:
            break

        soup = BeautifulSoup(response.text, 'html.parser')  # 페이지 내용 파싱

        # data-linked-resource-id에서 페이지 ID 추출
        page_links = soup.select("a[data-linked-resource-id]")
        if not page_links:
            break

        for link in page_links:
            page_id = link['data-linked-resource-id']
            page_ids.append(page_id)

        start_index += 30  # 다음 페이지 인덱스로 이동
        if start_index > 210:
            break

    return page_ids
이미 Page Tree로 넘어간 500여개의 페이지는 HTML을 파싱하여 삭제해야할 페이지 ID 리스트를 가져온 후, 삭제 API를 호출해 일괄적으로 삭제하여 문제를 해결했습니다. ( Confluence 측에서 해당 기능 API 지원 X )
8. 테이블의 오너십 추가
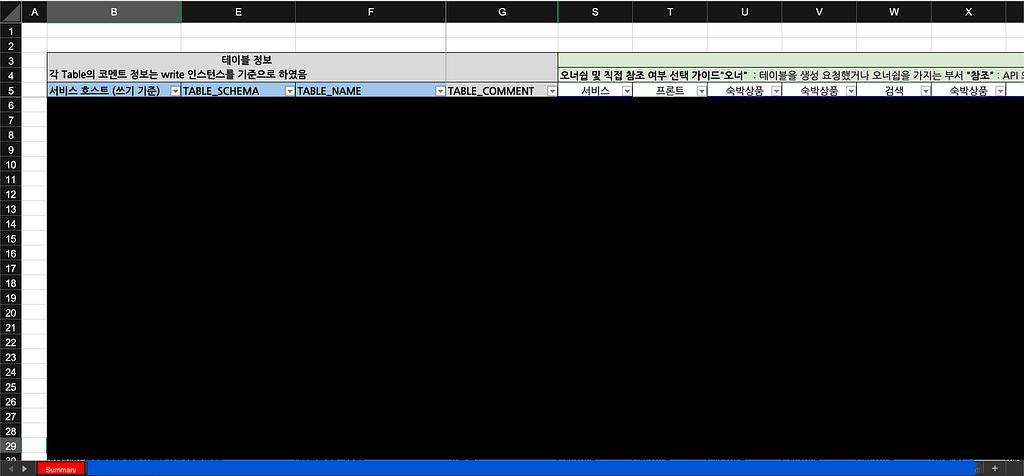
여기어때에서는 각 테이블의 오너십 및 참조 등 메타 정보들을 스프레드시트로 정리해왔습니다. 더 이상 문서 작업을 하지 않기 위해 40개의 클러스터에 대해 정리되어 있던 4400여개의 테이블 오너십을 아래와 같이 하나의 테이블에 저장했습니다.
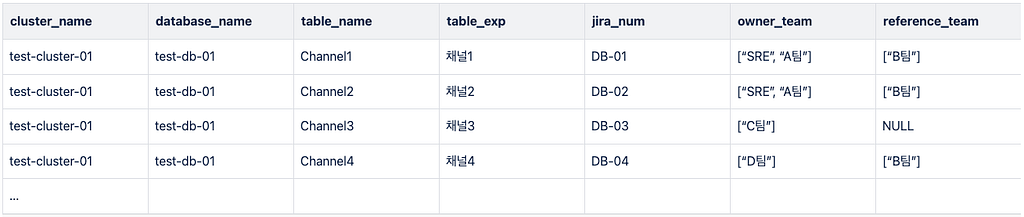
그 후, fetch_all_owner_teams() 에서 owner_data = {} 에 오너십을 저장하고 fetch_databases_and_tables(endpoint, cluster_name, owner_teams) 에서 그 오너십에 대응되는 클러스터, 데이터베이스, 테이블을 찾아내어 generate_html_table(table_info, columns, indexes, table, owner_team) 로 넘기면 HTML을 정확하게 생성해내어 테이블 메타데이터 표를 완성합니다.
def fetch_all_owner_teams():
    owner_data = {}
    connection = get_owner_team_connection()
    if connection:
        try:
            with connection.cursor() as cursor:
                cursor.execute("""
                    SELECT cluster_name, database_name, table_name, owner_team
                    FROM team_permissions;
                """)
                results = cursor.fetchall()
                for cluster, schema, table, team in results:
                    # 클러스터 수준에서 딕셔너리 초기화
                    if cluster not in owner_data:
                        owner_data[cluster] = {}
                    # 데이터베이스 수준에서 딕셔너리 초기화
                    if schema not in owner_data[cluster]:
                        owner_data[cluster][schema] = {}
                    # 테이블 수준에서 owner_team 저장
                    if table not in owner_data[cluster][schema]:
                        owner_data[cluster][schema][table] = team
                    else:
                        # 기존 team에 추가
                        owner_data[cluster][schema][table] += f", {team}"

        except Exception as e:
            print(f"owner_team 에러 발생: {e}")
        finally:
            connection.close()
    return owner_data
def fetch_databases_and_tables(endpoint, cluster_name, owner_teams):
    result = {}  # 데이터베이스 및 테이블 정보를 담을 딕셔너리
    connection = get_database_connection(endpoint)
    if connection:
        try:
            with connection.cursor() as cursor:
                # 모든 데이터베이스 가져오기 (system databases 제외)
                cursor.execute("""
                    SHOW DATABASES
                    WHERE `Database` NOT IN ('information_schema', 'mysql', 'performance_schema', 'sys');
                """)
                databases = [db[0] for db in cursor.fetchall()]

                # 클러스터에 해당하는 데이터만 추출
                cluster_owner_teams = owner_teams.get(cluster_name, {})

                # 각 데이터베이스에 대해 테이블 및 컬럼 정보 가져오기
                for db_name in databases:
                    db_owner_teams = cluster_owner_teams.get(db_name, {})  # 데이터베이스에 해당하는 데이터만 추출

                    cursor.execute(f"SHOW TABLES IN `{db_name}`;")
                    tables = sorted([table[0] for table in cursor.fetchall()], key=lambda x: x.lower())  # 테이블 정렬

                    tables_info = {}  # 해당 데이터베이스의 테이블 정보를 담을 딕셔너리

                    for table in tables:
                        # 해당 테이블의 owner_team 가져오기
                        owner_team = db_owner_teams.get(table, None)

                        # 컬럼 정보 가져오기
                        cursor.execute(COLUMN_QUERY, (db_name, table))
                        columns = cursor.fetchall()

                        # 인덱스 정보 가져오기
                        cursor.execute(INDEX_QUERY, (db_name, table))
                        indexes = cursor.fetchall()

                        # 테이블 정보 가져오기
                        cursor.execute(TABLE_QUERY, (db_name, table))
                        table_info = cursor.fetchone()

                        # 테이블 정보를 HTML로 변환
                        html_table = generate_html_table(table_info, columns, indexes, table, owner_team)
                        tables_info[table] = {'html_content': html_table}

                    # 해당 데이터베이스와 그 안의 테이블 정보를 result에 추가
                    result[db_name] = {'tables': tables_info}

        except Exception as e:
            print(f"{endpoint} 에러 발생: {e}")
        finally:
            connection.close()
    return result
이로써 Confluence 페이지에서도 테이블 별 오너십을 확인할 수 있습니다.
9. 프로그램 장애 모니터링
총 실행시간, 총 생성된 페이지 수, 프로그램 장애 여부, 장애 발생시 재시도 횟수, 장애 원인 등을 로그로 남겨 DBA 파트에서 확인가능하도록 하였고, Slack 예약 메세지 API를 통해 작업 현황을 보내고 있습니다.
4. 회고
이번 ‘테이블 명세서 자동화 프로젝트’를 진행하며 여기어때 DB 시스템의 구조를 깊이 이해할 수 있었습니다.
다양한 플랫폼과의 연동을 통해 외부 API를 활용하고 대용량 데이터를 처리하는 경험을 쌓으면서 기술적으로 성장했을 뿐만 아니라, 여러 개발팀과 협업하며 요구사항에 맞는 시스템을 기획하는 과정을 통해 실무적인 관점에서도 많은 배움을 얻었습니다.
추가적으로 자동화의 필요성을 깨달았습니다. 그래서 ‘자동화를 위한 자동화’ 작업을 상당히 많이 했는데요 ( 도메인-엔드포인트 매칭 작업, 엑셀에서 오너십을 추출 후 기존의 테이블 코멘트에 추가하기 위한 Alter문 작성 작업, Page Tree로 넘어간 페이지 ID를 파싱한 후 삭제하는 작업 등)
이제는 “어디 자동화할 거 없나?” 하고 찾아보게 되었습니다. 하하.
옆에서 조언해주신 팀원분들 덕분에, 많은 것을 배우고 경험하게 되어 뿌듯합니다.

긴 글 읽어주셔서 감사합니다!