AI/ML
데이터 분석 에이전트를 만들며 배운 컨텍스트 설계
2026년 10월 2일
원문에서 보기 ↗LLM 에이전트는 목표를 받으면 필요한 정보를 찾고 적절한 도구를 선택해 실행하며, 그 결과를 관찰한 뒤 다음 행동을 결정합니다. Anthropic은 에이전트를 활용한 여러 실험을 공개했습니다. Claude Sonnet 4.5로 Claude.ai를 재현하는 실험 과 Claude Opus 4.6 기반 에이전트가 Rust로 Linux 6.9 커널을 빌드할 수 있는 C 컴파일러를 개발한 사례를 소개했습니다. 이처럼 모델의 성능이 높아지면서 에이전트가 자율적으로 수행할 수 있는 작업의 범위도 넓어지고 있습니다. 이러한 작업을 수행하려면 에이전트는 현재 목표와 진행 상황, 이전 작업의 결과를 파악할 수 있어야 합니다.
그렇다면 에이전트에 어떤 정보를 언제 전달해야 할까요? LLM이 작업을 수행하는 데 필요한 입력 정보를 선별하고 구성하는 과정을 컨텍스트 엔지니어링(Context Engineering)이라고 부릅니다. 이 글에서 다룰 데이터 분석 에이전트는 사용자의 비즈니스 질문에 맞는 데이터를 찾고, SQL을 작성하고 실행한 뒤, 결과를 설명합니다. 데이터 분석 에이전트 개발 경험을 바탕으로 에이전트가 각 단계에서 필요한 정보를 얻고 다음 행동을 결정하도록 컨텍스트를 어떻게 설계했는지 살펴보겠습니다.
컨텍스트
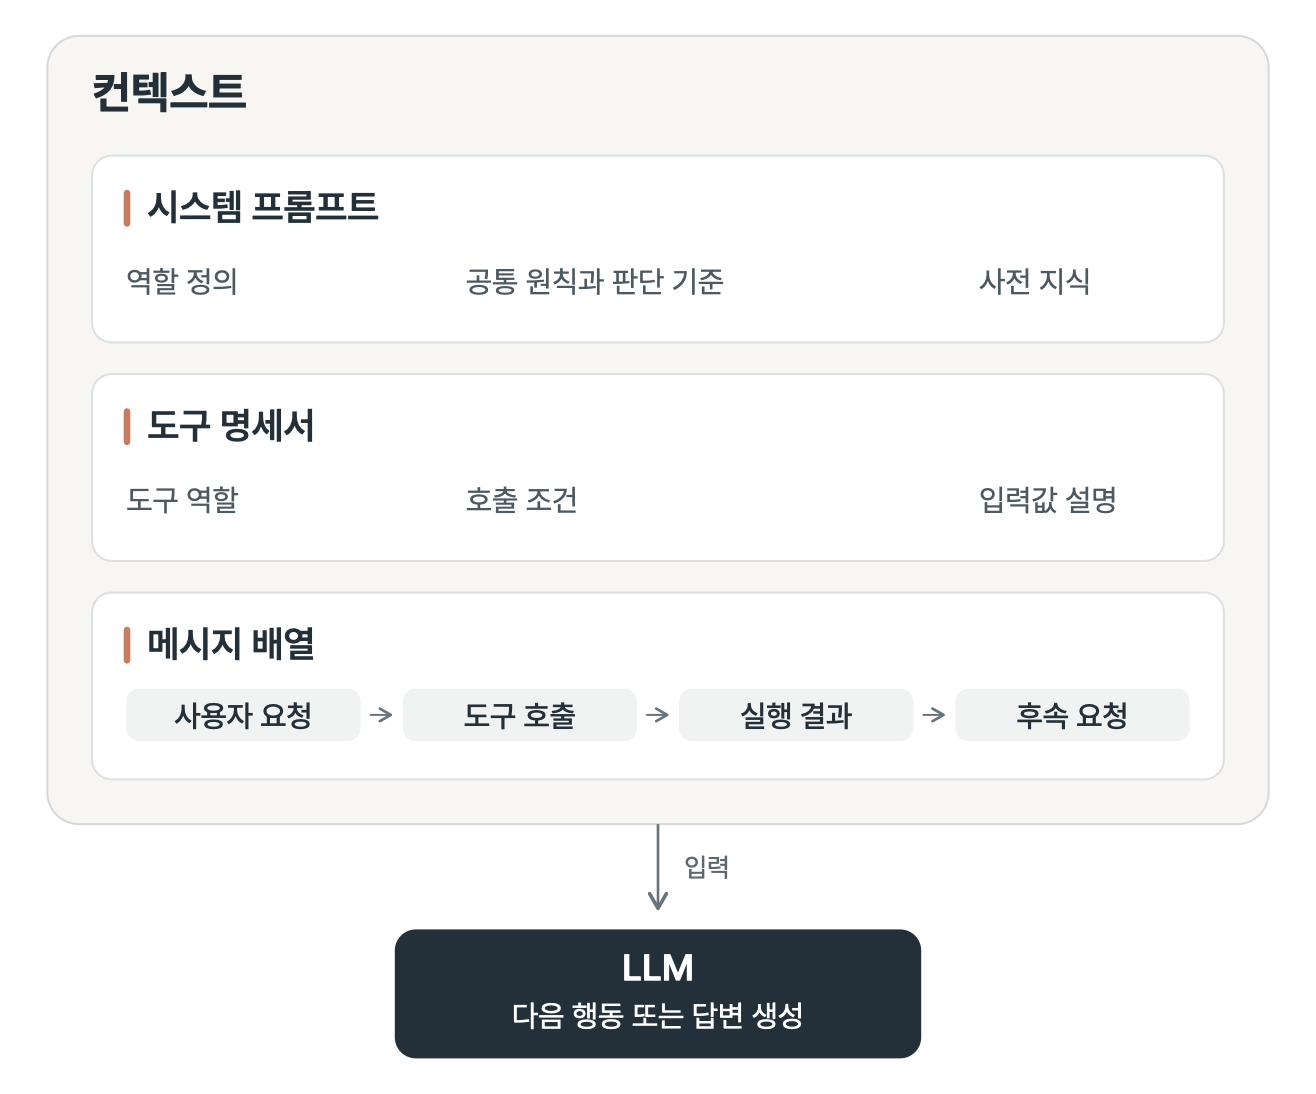
컨텍스트는 보통 문맥이나 맥락으로 번역되지만, LLM 에이전트에서는 모델이 다음 행동을 결정하거나 답변을 생성할 때 입력으로 받는 정보를 뜻합니다. 여기에는 에이전트의 역할과 행동 지침, 사용할 수 있는 도구의 설명, 사용자와의 대화 및 도구 실행 결과 등이 포함됩니다. 이 글에서는 컨텍스트를 시스템 프롬프트, 도구 명세서, 메시지 배열의 세 요소를 중심으로 살펴보겠습니다.
시스템 프롬프트
시스템 프롬프트에는 에이전트가 작업 전반에서 따라야 할 공통 규칙과 기본적인 배경지식을 작성합니다. 주로 포함하는 항목은 다음과 같습니다.
-
역할 정의: 에이전트가 어떤 역할을 맡고, 어떤 업무를 수행하며, 어떤 결과를 제공해야 하는지 작성합니다.
-
안전 규칙: 에이전트가 도구를 사용하고 답변을 작성할 때 지켜야 할 제한과 대응 방식을 설명합니다.
-
판단 기준과 기본값: 사용자의 요청만으로는 작업에 필요한 정보가 충분하지 않을 때 적용할 기본값과 추가 확인이 필요한 조건을 설명합니다.
-
도구 사용 가이드: 여러 도구에 공통으로 적용되는 사용 원칙이나 도구 간의 우선순위, 반드시 지켜야 하는 절차를 작성합니다. 개별 도구의 역할과 호출 조건, 입력값의 의미는 도구 명세서에 작성합니다.
-
답변 가이드: 에이전트가 작업의 진행 상황과 결과를 사용자에게 전달할 때 지켜야 할 공통 원칙을 설명합니다. 진행 안내는 무엇을 왜 하는지 짧게 전달하고, 최종 답변은 결과를 이해하는 데 필요한 만큼 작성하도록 합니다. 개별 도구의 결과를 어떤 형식과 범위로 설명할지는 도구 명세서에 작성합니다.
-
사전 지식: 사용자의 요청을 이해하고 작업을 시작하는 데 필요한 도메인 배경을 제공합니다. 서비스별 테이블 목록도 함께 제공하면 에이전트가 어떤 데이터를 탐색할지 판단하는 출발점으로 활용할 수 있습니다.
다음은 위 항목을 반영한 시스템 프롬프트 예시입니다.
- 당신은 데이터 분석가입니다. 사용자의 비즈니스 질문을 이해하고, 필요한 데이터를 탐색, 조회, 분석한 뒤 결과를 사용자가 이해하기 쉽게 설명하세요.

- 사용자가 사용자 수를 요청하면서 집계 기준을 지정하지 않으면 일별 활성 사용자 수(DAU)를 기본으로 사용하세요.
- 사용자 요청이 기존에 합의된 지표 정의나 집계 규칙과 충돌하면 어떤 기준을 따를지 사용자에게 확인하세요.

- 이미 확보한 정보만으로 답할 수 있으면 추가 도구 호출 없이 답하세요.
- 새로운 계산이나 추가 근거가 필요하면 적합한 도구를 호출하세요. 확인하지 않은 수치를 추정해 답하지 마세요.

- 도구 호출 시 무엇을 왜 하는지 1~2문장으로 안내하세요.
- 최종 답변은 결과 전달에 필요한 만큼 작성하고, 이전 답변이나 동일한 정보를 반복하지 마세요.
- 도구 실행 후 답변의 형식과 범위는 해당 도구 명세서의 '결과 표시' 항목을 따르세요.
- 도구 결과를 설명한 뒤 추가 작업이 필요하면 같은 응답에서 다음 도구를 호출하세요. 명세서에서 답변 생략을 명시한 경우에는 설명을 생략하세요.

- 사용자 식별자가 결과에 그대로 노출되는 SQL은 실행하지 마세요.
- 이러한 요청에는 사용자 수나 분포 같은 집계, 통계 분석을 대안으로 제시하세요.

- 서비스 이름: {서비스 이름}
- 서비스 설명: {서비스의 주요 기능과 목적}
- 용어와 약칭: {같은 데이터를 가리키는 용어와 약칭}
- 서비스별 테이블 목록: {서비스별 테이블 이름과 설명}
에이전트를 처음 개발하던 GPT-4 시기에는 모델이 현재 상황에 맞는 도구와 작업 순서를 스스로 판단하는 능력이 지금보다 부족했습니다. 당시에는 도구 명세서에 각 도구가 하는 일만 간략히 적고, 상세한 사용 조건과 절차는 시스템 프롬프트에 모아두었습니다. ‘Workflow’ 항목을 만들고 여기에 요청과 관련된 테이블을 찾고 SQL을 생성 및 실행하는 순서를 명시하고, “이미 알고 있는 데이터라면 검색을 생략한다”, “기존 SQL을 일부 수정하면 되는 요청은 수정 도구를 사용한다” 같은 상황별 지침을 추가했습니다. 이후 모델의 성능이 높아지면서, 모델이 사용자의 요청과 현재 상황을 바탕으로 필요한 도구와 작업 순서를 판단하도록 구성을 바꾸었습니다.
이를 위해 각 도구의 사용 조건을 해당 도구의 명세서에 작성했습니다. Anthropic도 도구 정의 가이드에서 “매우 상세한 설명을 제공하라(Provide extremely detailed descriptions)”고 강조하며, 도구가 하는 일과 사용해야 하거나 사용하지 말아야 할 상황, 각 매개변수의 의미와 제약 사항을 구체적으로 설명하도록 권고합니다. 이 에이전트에서도 도구별 사용 조건과 입력값의 의미, 결과 전달 방식을 도구 명세서에 작성하고, 시스템 프롬프트에는 역할과 안전 규칙, 여러 도구에 공통으로 적용되는 사용 원칙을 남겼습니다.
도구 명세서
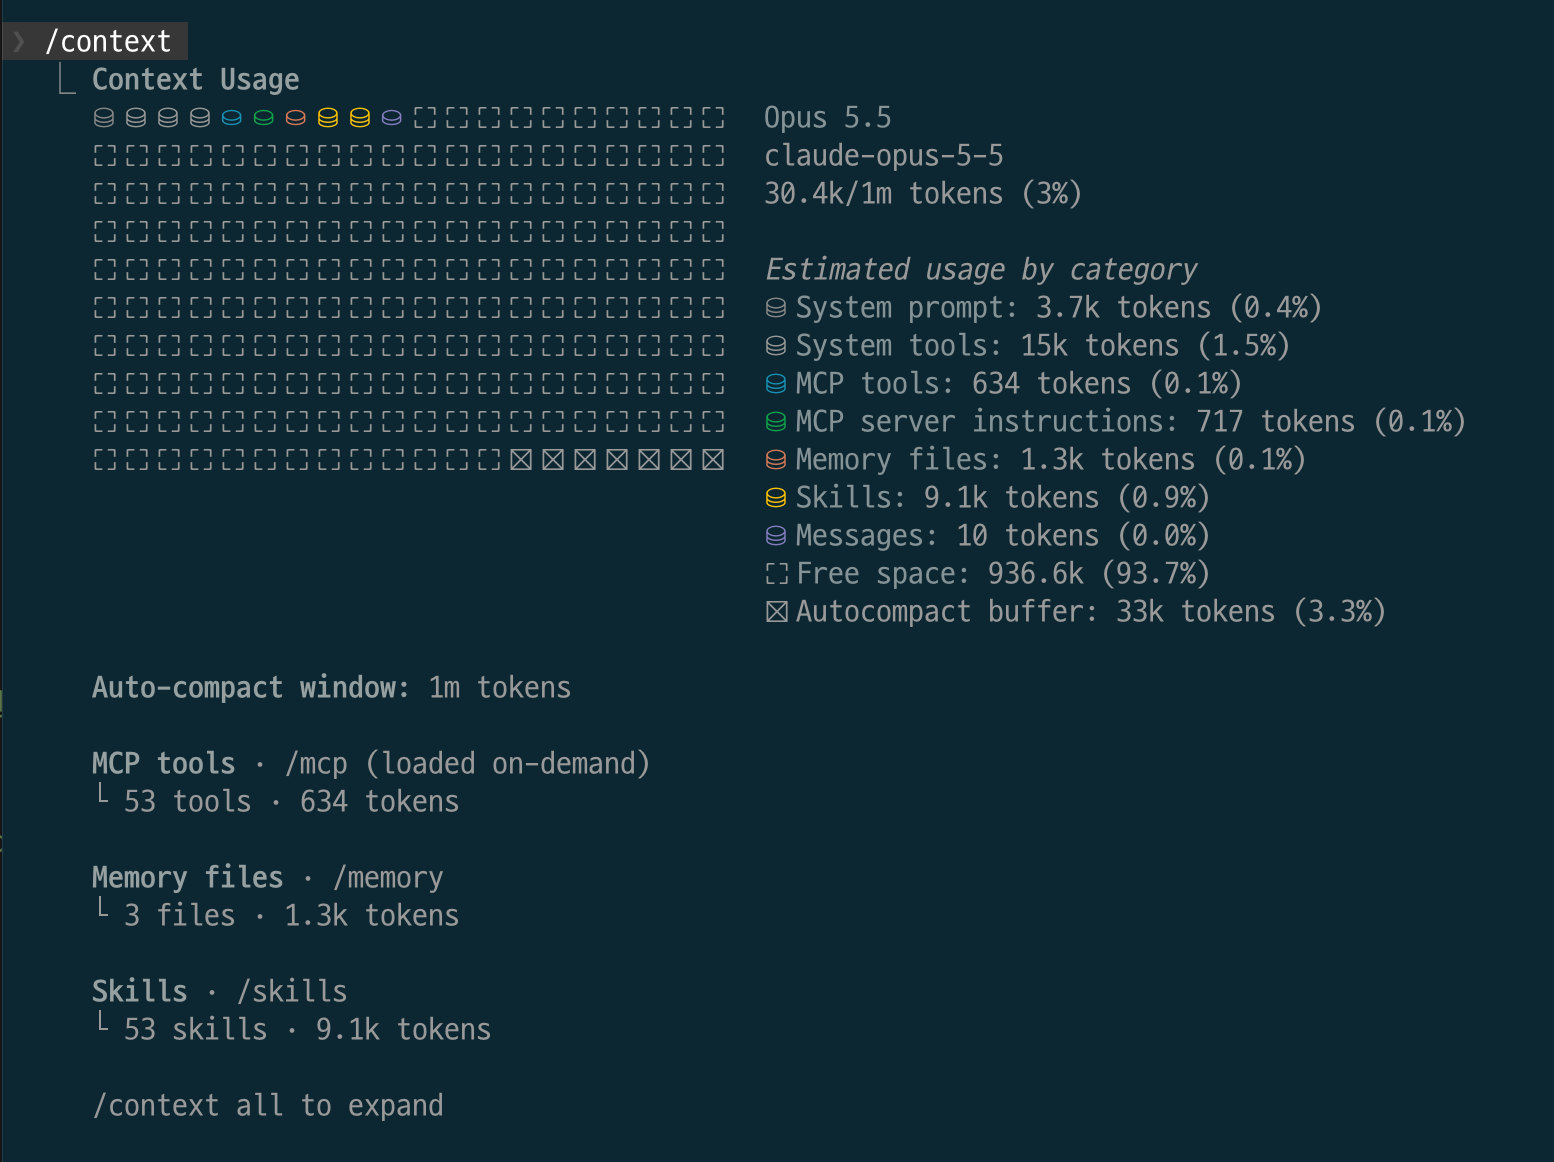
도구 명세서는 에이전트가 사용할 수 있는 도구의 역할과 사용 조건을 설명하는 문서입니다. 에이전트는 이 명세서를 바탕으로 지금 어떤 도구가 필요한지, 어떤 값을 입력해야 하는지, 실행 결과에서 무엇을 기대할 수 있는지 판단합니다. 아래 Claude Code 사례에서 도구 명세서의 분량은 약 15k 토큰으로, 시스템 프롬프트(3.7k 토큰)의 약 4배입니다. 에이전트가 잘 작동하기 위해서는 충분한 도구 설명을 작성해야 하는 것을 보여줍니다.
도구 명세서를 작성할 때는 도구의 역할, 호출 조건, 입력값의 의미와 선택 기준, 결과 전달 방식을 구체적으로 설명해야 합니다. 차트 생성 도구를 예로 들어보겠습니다. 이 도구는 기존 분석 작업의 실행 결과를 바탕으로 차트를 생성하며, 에이전트는 차트의 종류와 차트로 확인하려는 내용을 입력값으로 전달합니다.
-
도구 역할: 도구가 무엇을 대상으로 어떤 일을 하는지 설명합니다. 차트 생성 도구의 명세서에는 “실행 결과를 기반으로 Vega-Lite Spec을 생성한다”고 작성합니다.
-
호출 조건: 도구를 언제 사용해야 하는지 설명합니다. 이 도구의 명세서에는 “사용자가 명시적으로 차트 생성을 요청한 경우에만 호출한다”와 “앞서 실행한 SQL의 결과가 있어야 한다”는 조건이 있습니다.
-
결과 표시: 도구 실행 후 사용자에게 무엇을 설명할지 작성합니다. 이 에이전트에서는 생성한 차트를 화면에 보여주므로, 답변에서는 차트 데이터를 글로 옮기지 않고 분석에서 얻은 인사이트를 한두 문장으로 덧붙이도록 했습니다.
입력값의 의미와 선택 기준은 parameters에 작성합니다. 예를 들어 chart_type은 만들 차트의 종류를 지정하며, enum으로 선택 가능한 값을 제한합니다. 설명에는 “시계열 추세는 line, 카테고리 비교는 bar”처럼 분석 목적에 맞는 선택 기준을 함께 제공합니다.
도구가 직접 볼 수 없는 맥락도 입력값으로 전달해야 합니다. 이 에이전트의 차트 생성 도구는 내부에서 별도의 LLM을 호출해 Vega-Lite Spec을 만듭니다. 이 LLM은 사용자와의 대화를 보지 못하므로, 메인 에이전트가 instruction에 차트로 확인하려는 내용과 강조할 부분을 작성하도록 했습니다. 예를 들어 “9월 일별 DAU 추세와 주말 하락을 보여줘”라고 전달하면, 생성기는 이를 참고해 축 제목과 정렬 방식 등을 정하고, 질문과 강조점이 드러나도록 차트를 구성합니다.
다음은 차트 생성 도구의 명세서 예시입니다.
{
  "name": "generate_chart",
  "description": "실행 결과를 기반으로 Vega-Lite Spec을 생성한다.\n\n## 호출 조건\n- 사용자가 명시적으로 차트 생성을 요청한 경우에만 호출한다.\n- 앞서 실행한 SQL의 결과가 있어야 한다.\n\n## 입력 원칙\n- 차트 생성기는 대화를 보지 못하므로, 차트로 확인하려는 내용과 강조할 부분을 instruction으로 전달한다.\n\n## 결과 표시\n- 차트는 화면에 표시된다. 차트 데이터를 글로 옮기지 않고 분석에서 얻은 인사이트를 한두 문장으로 덧붙인다.",
  "parameters": {
    "type": "object",
    "properties": {
      "chart_type": {
        "type": "string",
        "enum": [
          "bar",
          "line",
          "area",
          "point",
          "pie",
          "donut",
          "heatmap"
        ],
        "description": "차트 타입. 시계열 추세는 line, 시간에 따른 누적량이나 구성 변화는 area, 카테고리 비교는 bar, 구성비는 pie/donut, 두 변수 관계는 point, 2차원 분포는 heatmap을 사용한다."
      },
      "instruction": {
        "type": "string",
        "description": "이 차트로 확인하려는 내용과 강조할 부분을 한두 문장으로 설명합니다 (예: '9월 일별 DAU 추세와 주말 하락을 보여줘'). 생성기는 이 설명을 참고해 축 제목과 정렬 방식 등을 정하고, 질문과 강조점이 드러나도록 차트를 구성합니다."
      }
    },
    "required": [
      "chart_type",
      "instruction"
    ]
  }
}
위의 차트 생성 도구처럼 기능마다 별도의 도구를 추가하다 보면 도구의 개수가 점점 늘어납니다. 같은 대상을 다루더라도 생성, 수정, 조회 기능을 각각의 도구로 만들고, 작업의 세부 단계까지 나누어 제공하면 에이전트가 읽어야 할 명세서가 늘어나고, 도구를 선택할 때 고려해야 할 후보도 많아집니다. 관련된 도구들이 공통으로 사용하는 설명과 입력 규칙이 반복되기도 합니다. 이런 경우에는 관련 기능을 하나의 도구로 묶을 수 있을지 고려합니다. "A Philosophy of Software Design"에서는 단순한 인터페이스로 풍부한 기능을 제공하는 ‘깊은 모듈’을 설명합니다. 호출자는 적은 정보만으로 모듈을 사용할 수 있고, 복잡한 내부 처리는 모듈이 담당하는 것입니다. 에이전트 도구도 관련 기능을 하나로 묶고 내부에서 세부 작업을 처리하도록 만들 수 있습니다. 이렇게 하면 도구 설명의 중복을 줄이고, 여러 단계의 도구를 각각 선택하고 호출하지 않아도 됩니다.
예를 들어, 이 에이전트에는 자주 사용하는 SQL을 노트로 저장해두고 재사용할 수 있는 편의 기능이 있습니다. 노트 저장 도구는 생성과 수정을 함께 처리합니다. 대상 노트가 지정되면 기존 내용을 수정하고, 지정되지 않으면 새로 저장합니다.
{
  "name": "upsert_note",
  "description": "SQL을 포함한 노트를 새로 저장하거나 기존 노트를 수정한다. 사용자가 저장 또는 수정을 명시적으로 요청했을 때 사용한다.",
  "parameters": {
    "type": "object",
    "properties": {
      "note_key": {
        "type": ["string", "null"],
        "description": "수정할 기존 노트의 key. 새 노트를 생성할 때는 null을 전달한다."
      },
      "body": {
        "type": "string",
        "description": "저장할 노트 본문. 기존 노트를 수정할 때는 수정이 반영된 전체 본문을 전달한다."
      }
    },
    "required": ["note_key", "body"]
  }
}
에이전트는 같은 도구를 호출하면서 note_key의 값으로 생성과 수정을 구분합니다.
여러 단계로 이루어진 작업도 하나의 도구가 담당하도록 구성할 수 있습니다. 데이터 분석에서는 SQL을 작성하고 실행한 뒤, 오류가 발생하면 수정하고 다시 실행하는 과정이 필요합니다. 이 과정을 하나로 묶어 하나의 도구로 만들 수 있는데, 이 도구는 SQL 생성 및 실행을 전담하는 서브에이전트가 됩니다. 메인 에이전트가 분석 목적과 필요한 정보를 전달하면, 서브에이전트가 SQL 작성부터 실행과 오류 수정까지 처리합니다. 추가적인 설명은 ‘서브에이전트’ 절에서 다루겠습니다.
메시지 배열
메시지 배열은 사용자와 LLM이 주고받은 대화, 도구 호출과 실행 결과를 순서대로 담는 목록입니다. 에이전트는 이 기록을 입력으로 받아 사용자의 요청과 지금까지 확인한 내용을 파악하고, 다음 행동을 결정합니다.
분석 요청을 처리하는 과정을 예로 들어보겠습니다. 사용자가 “지난 일주일 동안 서비스 A의 일별 이용자 수를 집계해줘”라고 요청했고, 사용할 테이블의 스키마는 확인했지만 실제 값은 아직 확인하지 않은 상황입니다. 다음은 스키마 조회 결과까지 포함한 메시지 배열을 입력으로 받아, LLM이 다음 도구 호출을 출력하는 과정을 단순화한 예시입니다.
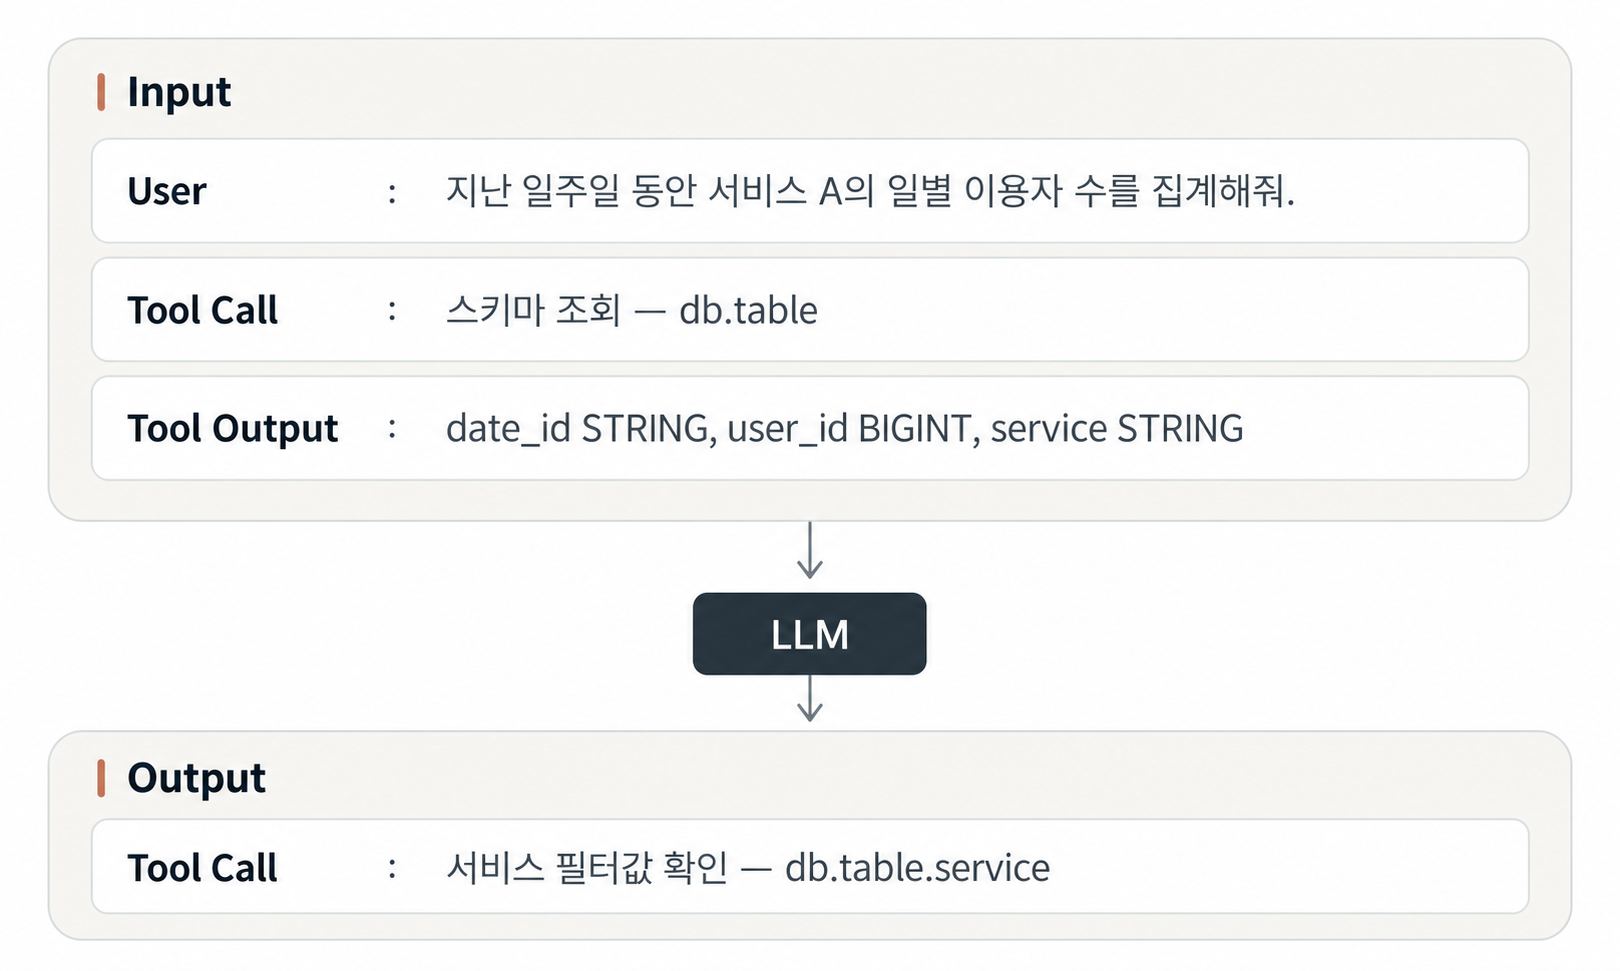
입력에는 사용자의 요청, 그에 따른 스키마 조회 호출과 실행 결과가 순서대로 담겨 있습니다. LLM은 조회 결과에서 service 컬럼이 있다는 것을 확인할 수 있지만, 샘플값에는 일부 값만 포함되어 있어 서비스 A에 해당하는 실제 값은 아직 알지 못합니다. 따라서 다음 행동으로 서비스 필터값을 확인하는 도구 호출을 출력합니다. 이 도구의 실행 결과도 메시지 배열에 추가되어 다음 LLM 호출의 입력으로 사용됩니다. 하나의 사용자 요청을 처리하는 동안에도 이러한 과정은 여러 번 반복됩니다. 이 기록은 사용자의 후속 요청을 처리할 때도 활용됩니다. 하나의 분석이 끝난 뒤 “기간을 한 달로 늘려줘”라는 요청이 들어오면, 에이전트는 대화와 실행 기록을 참고해 어떤 분석의 기간을 바꿔야 하는지 판단합니다.
컨텍스트 엔지니어링
에이전트가 작업을 수행하는 동안 필요한 정보는 계속 변경됩니다. 요청에 맞는 테이블을 찾을 때는 서비스 설명과 테이블 목록이 필요하고, SQL을 작성할 때는 선택한 테이블의 상세 스키마와 분석 규칙이 필요합니다. SQL 실행 중 발생한 오류와 수정 기록은 문제를 해결하는 데 쓰이지만, 이후 분석에서도 모두 필요한 것은 아닙니다. 이 절에서는 점진적 발견으로 필요한 정보를 단계적으로 가져오는 방법과, 서브에이전트로 중간 기록을 별도 컨텍스트에서 관리하는 방법을 살펴보겠습니다.
점진적 발견
Anthropic은 Effective context engineering for AI agents에서 에이전트가 스스로 데이터를 탐색하고 관련 컨텍스트를 점차 발견하는 방식을 ‘점진적 발견(progressive disclosure)’이라고 불렀습니다. 에이전트는 탐색에서 얻은 정보를 바탕으로 다음에 확인할 대상을 정합니다. 이 과정을 반복하며 작업에 필요한 정보를 컨텍스트에 추가합니다.
Claude Code가 프로젝트에서 로그인 관련 코드를 찾는 과정을 예로 들어보겠습니다.
-
파일명 검색: 파일명이나 경로에
login, auth, session같은 단어가 포함되어 있는지 검색해src/auth.ts, src/session.ts같은 후보를 찾습니다. -
코드 내용 검색: 로그인 관련 키워드나 함수 이름을 검색합니다. 이 과정에서 파일명만으로는 관련성을 알기 어려웠던
src/routes.ts에서signIn함수를 호출하는 부분을 발견할 수 있습니다. -
관련 코드 읽기: 발견한 호출 위치와 함수가 구현된 코드를 읽습니다. 예를 들어
authenticate로 인증을 수행하고createSession으로 세션을 생성하는 흐름을 확인합니다. -
정의와 사용처 추적: 앞 단계에서 발견한
createSession의 정의와 사용처를 검색합니다.src/session.ts에 있는 구현과src/auth.ts에서 호출하는 부분을 읽으며 동작을 파악합니다.
처음부터 읽을 파일과 검색할 함수를 모두 정해두는 것이 아니라, 탐색 중 발견한 경로와 함수 이름을 바탕으로 다음에 읽을 파일이나 검색할 함수를 정합니다.
스킬(Skills)도 같은 원리를 활용합니다. 에이전트는 먼저 스킬의 이름과 설명을 확인해 현재 작업에 필요한 스킬을 고르고, 선택한 스킬의 상세 지침을 읽습니다. 지침에 별도 참고 자료가 연결되어 있다면 작업에 필요한 자료를 추가로 읽습니다.
데이터 분석 에이전트에서는 분석에 사용할 테이블과 컬럼을 찾는 과정에 이 원리를 적용했습니다. 초기에는 별도의 탐색 에이전트가 관련 서비스와 테이블을 검색하고 상세 스키마를 가져왔습니다. 하지만 메인 에이전트는 어떤 테이블에 접근할 수 있는지 몰랐기 때문에, 필요한 테이블이 없는 경우에도 탐색을 반복한 뒤에야 분석할 수 없다고 판단하는 일이 있었습니다. 이를 개선하기 위해 서비스 설명과 에이전트가 접근할 수 있는 전체 테이블 목록을 서비스별로 정리해 시스템 프롬프트에 작성했습니다. 메인 에이전트는 이 목록에서 사용할 테이블의 후보를 고르고, 스키마 조회 도구로 선택한 테이블의 컬럼 이름과 타입, 샘플값, 분석 규칙을 가져옵니다.
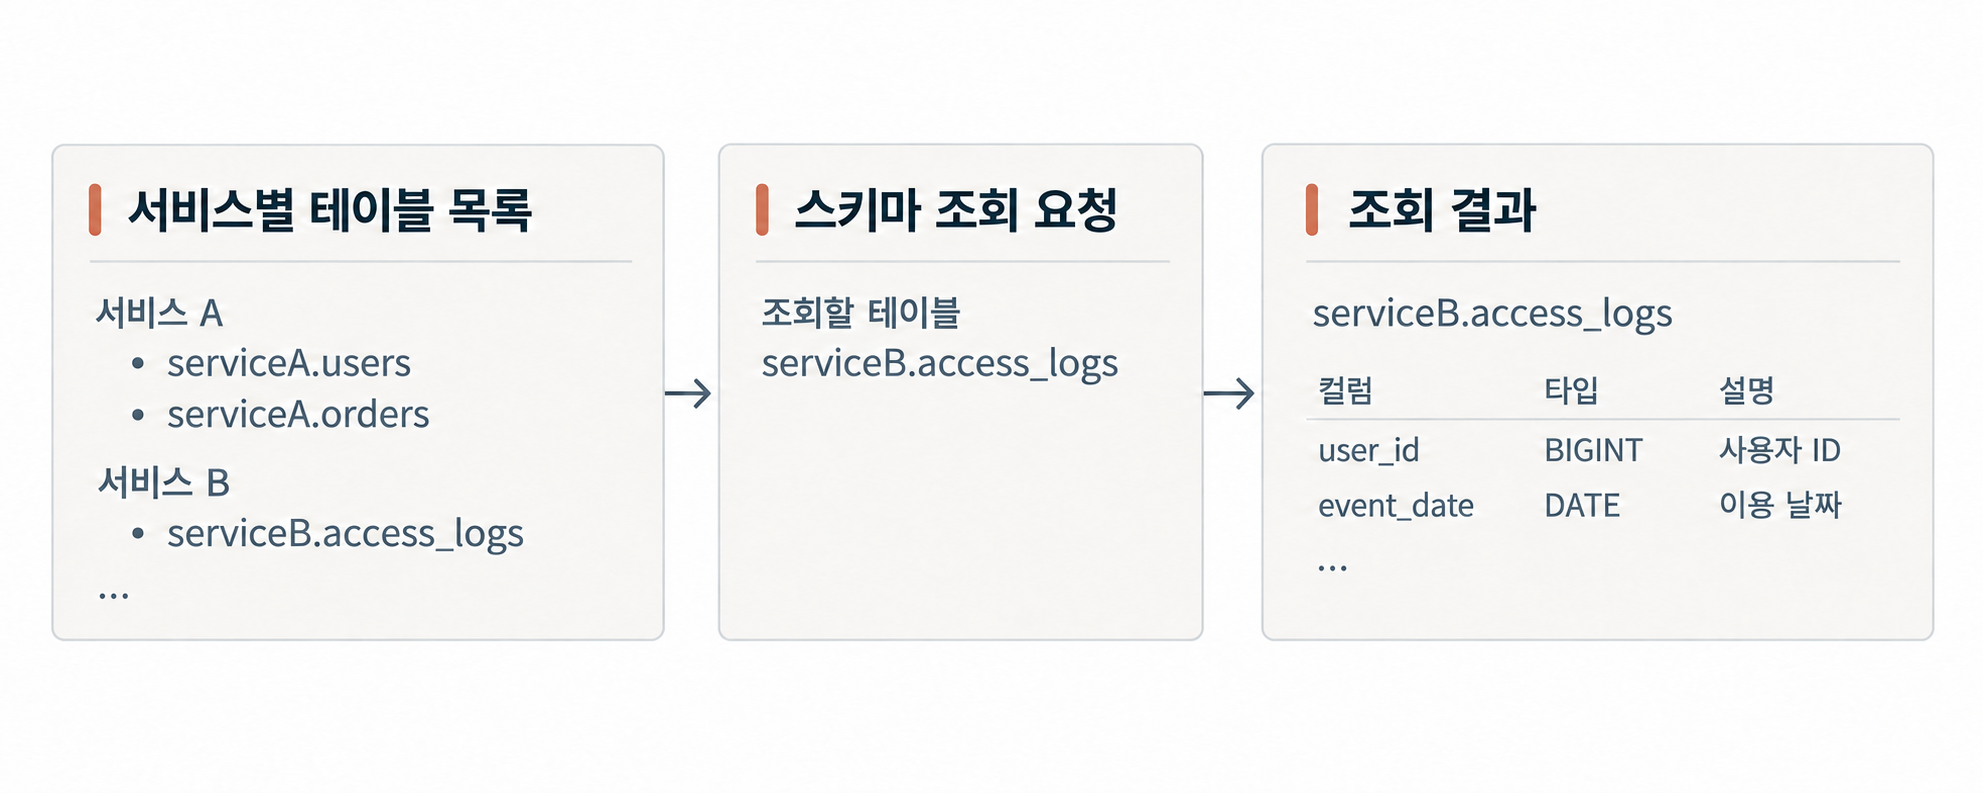
이렇게 변경한 뒤에는 필요한 테이블이 목록에 없는 경우를 더 일찍 파악하고, 테이블을 찾는 데 필요한 턴 수도 줄일 수 있었습니다. 서비스별 테이블 목록은 스킬의 이름과 설명처럼, 어떤 정보가 있고 어디서 더 찾을 수 있는지 알려주는 인덱스 역할을 합니다. 에이전트는 테이블 이름과 짧은 설명으로 후보를 좁힌 뒤, 필요한 테이블의 상세 스키마를 조회합니다. 즉, 모든 정보를 시스템 프롬프트에 작성하는 것이 아니라, 에이전트가 필요한 정보를 동적으로 찾아볼 수 있도록 인덱스를 작성합니다.
서브에이전트
서브에이전트는 메인 에이전트로부터 작업을 전달받아 별도의 컨텍스트에서 수행하는 에이전트입니다. Claude Code에는 코드 탐색을 위한 Explore, 계획 수립에 필요한 코드 조사를 위한 Plan, 탐색과 코드 수정 등 여러 단계의 작업을 수행하는 범용 general-purpose 서브에이전트가 있습니다. 이처럼 작업에 맞는 지침과 도구를 별도로 구성할 수 있습니다. 게다가 서브에이전트에서 작업한 중간 기록은 별도의 컨텍스트에 남기 때문에 메인 에이전트에는 필요한 결과만 전달할 수 있습니다.
초기에는 메인 에이전트가 SQL을 작성하고 실행하며, 오류가 발생하면 수정과 재실행까지 담당했습니다. 이 과정에서 실패한 SQL과 오류 메시지가 메시지 배열에 계속 쌓였고, 문제가 해결된 뒤에도 이 기록이 다음 분석의 입력에 포함되었습니다. 이것을 개선하기 위해 SQL 작성과 실행, 오류 수정을 전담하는 서브에이전트를 두고, 중간 기록을 별도의 컨텍스트에서 관리하도록 했습니다.
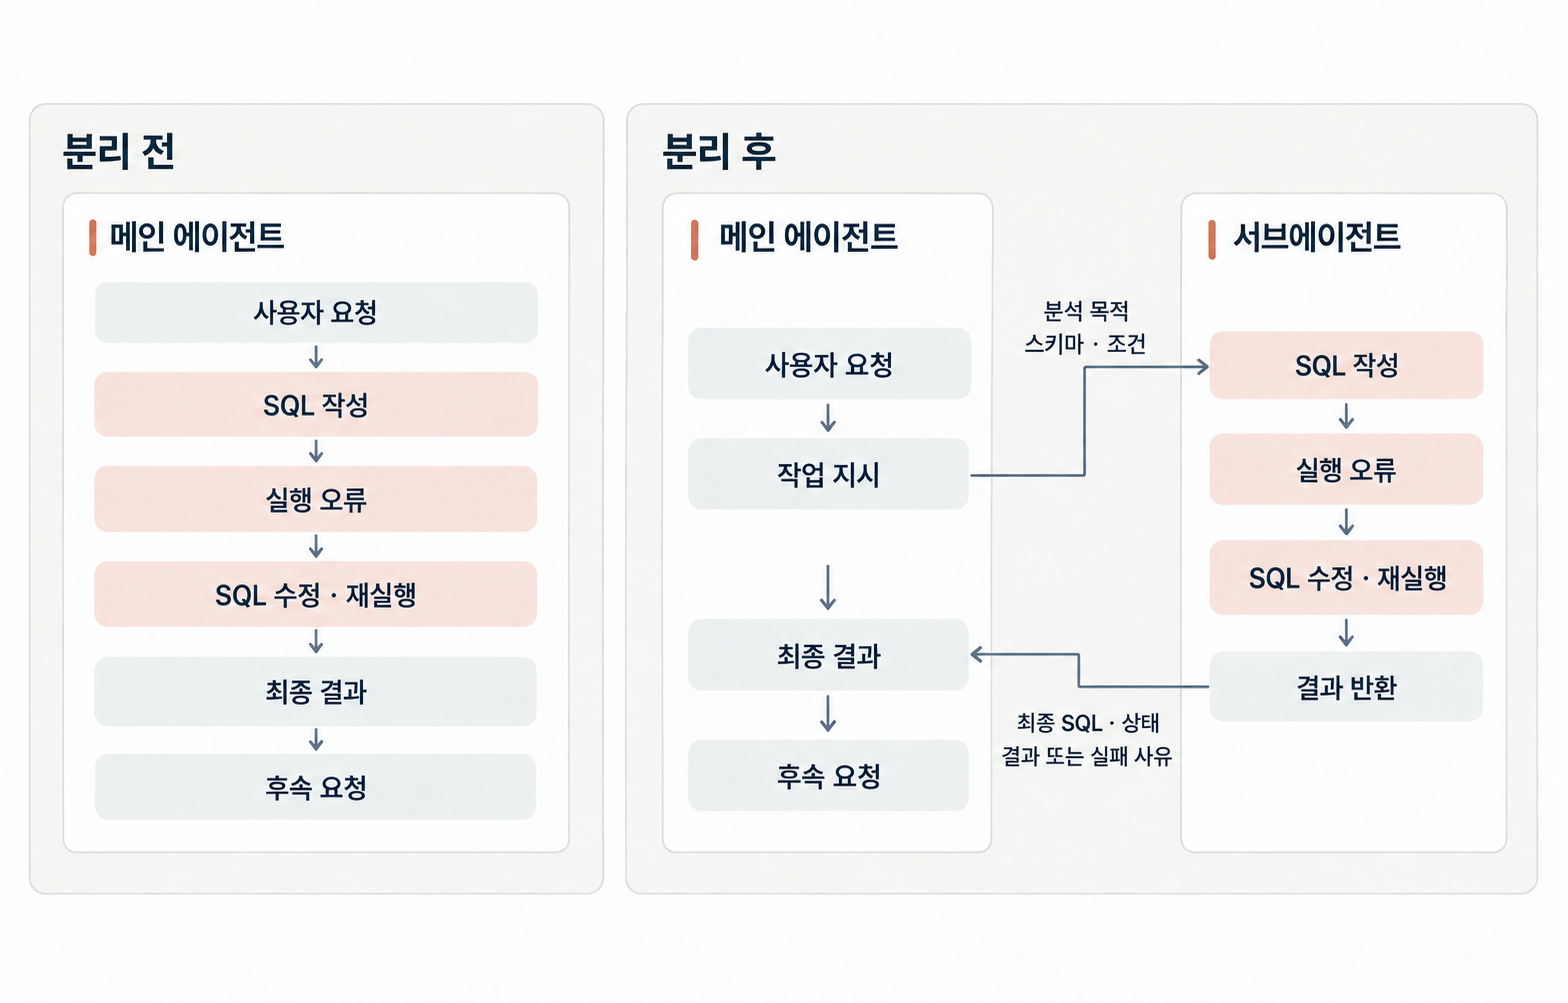
메인 에이전트는 SQL 작업을 담당하는 서브에이전트를 도구로 호출하면서, 분석 목적과 사용할 테이블, 조회 기간, 필터 조건, 집계 기준을 전달합니다. 이때 선택한 테이블의 스키마와 분석 규칙도 서브에이전트의 컨텍스트에 함께 제공됩니다. 메인 에이전트의 대화 기록이 그대로 전달되지는 않으므로, 앞서 확인한 조건도 작업 지시에 명시해야 합니다. 서브에이전트는 SQL 작성과 실행, 오류 수정을 처리한 뒤, 최종 SQL과 실행 상태, 결과 또는 실패 사유를 메인 에이전트에 반환합니다.
앞서 테이블 탐색에서는 별도의 탐색 에이전트를 두지 않고 메인 에이전트가 직접 스키마를 조회하도록 바꾸었습니다. 두 경우의 차이는 작업 중에 얻은 정보를 이후에도 사용하는지에 있습니다. 테이블 목록과 스키마는 SQL 작업을 지시하고 결과를 해석할 때 계속 필요하므로 메인 에이전트의 컨텍스트에 두었습니다. 반면 실패한 SQL과 오류 메시지는 문제가 해결되면 다시 참고할 일이 거의 없으므로 서브에이전트의 컨텍스트에서 처리하고, 메인 에이전트에는 최종 결과만 전달했습니다.
마무리
이번 글에서는 데이터 분석 에이전트를 개발하면서 컨텍스트를 구성한 방법을 알아보았습니다. 시스템 프롬프트에는 역할과 공통 규칙을 작성하고, 도구별 사용 조건과 입력값의 설명은 도구 명세서에 작성했습니다.
테이블 탐색에서는 서비스별 테이블 목록을 미리 제공하고, 필요한 테이블의 상세 스키마를 조회하도록 했습니다. 이렇게 변경한 뒤에는 필요한 테이블이 없는 경우를 더 일찍 파악하고, 탐색에 필요한 턴 수도 줄일 수 있었습니다. SQL 작성과 실행은 서브에이전트로 분리해, 실패한 SQL과 오류 메시지가 메인 에이전트의 메시지 배열에 계속 쌓이지 않도록 했습니다.
에이전트를 개발할 때는 각 작업에 어떤 정보가 필요한지, 작업 중에 얻은 정보를 이후에도 사용하는지 확인해보시길 바랍니다.
참고자료
-
Anthropic, Claude.ai 재현 실험
-
Anthropic, Building a C compiler with a team of parallel Claudes
-
Anthropic, Define tools: Best practices for tool definitions
-
Anthropic, Writing effective tools for AI agents—using AI agents
-
John Ousterhout, A Philosophy of Software Design
-
Anthropic, Effective context engineering for AI agents
-
Anthropic, Equipping agents for the real world with Agent Skills
-
Anthropic, Claude Code: Create custom subagents