Engineering
“서버가 죽었어요”에서 시작된 이야기, Grafana OnCall과 Amazon Connect로 완성한 실전형 온콜 시스템
백인출Cash(캐쉬) / SRE팀여기어때
2025년 12월 17일
원문에서 보기 ↗
“서버가 죽었어요.”
안녕하세요.
여기어때컴퍼니 SRE에서 클라우드 업무를 담당하고 있는 캐쉬 입니다.
이 문장은 SRE엔지니어라면 한 번쯤 새벽에 들어봤을 말일 겁니다.
개발자에게 야간 알람은 악몽입니다.
깊은 잠을 깨우는 진동, Slack의 붉은 점, 그리고 머릿속을 스치는 생각들,
“이번엔 또 뭐가 터졌지?”
특히 장애가 서비스 전체에 영향을 미칠 때는, 해당 서버의 담당자 즉, 누군가의 즉각적인 대응이 필요합니다.
하지만 단순히 알람 도구를 도입한다고 해결되지는 않습니다.
“누가 대응해야 하는가?”, “어떻게 즉시 전화로 알릴까?”, “비용은 최소화할 수 있을까?”
이런 문제들은 항상 뒤따릅니다.
그래서 구축한 Grafana OnCall + Amazon Connect로 만든 실전형 온콜 시스템
이 글은 단순히 Grafana OnCall을 소개하는 포스팅은 아닙니다.
저는 이 흔한 고민을 해결하기 위해 Grafana OnCall의 DB를 커스터마이징하고 , Amazon Connect , Slack, Target Group에서 비정상 트래픽 감지를 직접 연동 하여 비용 효율적이면서도 사용하기 좋은 온콜 시스템을 구축했습니다.
전화 + SMS + Email 등을 사용하는 고가의 상용 솔루션 없이,
Amazon Connect + Grafana OnCall + Slack만으로도 비용 최적화 된 자동 전화 알림 시스템을 완성했습니다.
이 포스팅에서는 실제 운영 환경에서 어떻게 AWS Target Group에서 비정상 트래픽 감지 (Target Group의 Unhealthy 상태)를 즉시 감지하고 , 담당자에게 자동으로 전화를 걸며 , Slack을 통해 알림 제어까지 완벽하게 구현했는지
그 과정을 단계별로 소개합니다.
1. LGTM Stack 위에 Grafana OnCall 구축하기
저희 인프라의 중심에는 LGTM Stack(Loki , Grafana, Tempo, Mimir) 이 있습니다.
로그(Loki), 트레이스(Tempo), 메트릭(Mimir)이 하나의 통합된 관측 기반 위에서 연결되어 있기 때문에, 문제 발생 시 “무엇이, 언제, 왜 터졌는가”를 한눈에 파악할 수 있었습니다.
하지만 관측(Observability)만으로는 대응(Incident Response) 이 완성되지 않습니다.
문제가 탐지되었을 때 누가, 어떤 순서로, 어떻게 대응할 것인가 를 체계적으로 관리해야 진짜 운영 자동화가 가능합니다.
그래서 우리는 LGTM 스택의 마지막 퍼즐로 Grafana OnCall을 선택했습니다.
Grafana OnCall은 Grafana의 플러그인 형태로 동작하지만,
단순히 알림을 전달하는 수준을 넘어 팀별 온콜 일정 관리 , 라우팅 규칙 , 슬랙과의 양방향 동기화 , 그리고 자동화된 알림 제어(Silence, Resolve) 기능을 제공합니다.
즉, “누가 대응할지”와 “어떻게 알릴지”를 하나의 대시보드에서 통합적으로 관리할 수 있습니다.
2. Grafana OnCall을 LGTM 스택에 통합한 이유
- 단일 관측 플랫폼 통합 Grafana는 이미 Mimir, Loki, Tempo와 같은 데이터 소스들을 시각화하는 중심 허브였습니다. 여기에 Grafana OnCall을 추가하면, 장애 발생 → 탐지 → 알림 → 대응까지의 전 과정이 한 환경에서 이어집니다. 예를 들어, 특정 어떠한 알림이 Error 상태로 감지되면 → Mimir의 메트릭 경보가 트리거되고 → OnCall이 라우팅 규칙에 따라 담당자에게 Slack 알림 발송하며 → Grafana 대시보드에서는 해당 지표의 변화를 즉시 확인할 수 있습니다.
- 운영 일관성 확보 기존에는 Alertmanager, Slack Bot 등이 각각 별도로 관리되며 팀별 설정이 분리되어 유지보수가 복잡했습니다. OnCall을 LGTM 안으로 통합함으로써, 모든 알림 정책과 팀별 룰이 Grafana 내부에서 버전 관리되고, 시각적으로 구성될 수 있었습니다.
- 오픈소스 기반의 유연성 Grafana OnCall은 완전한 오픈소스이며, 내부 데이터베이스 구조가 명확하게 정의되어 있어 커스터마이징이 용이합니다. 덕분에 팀별로 다른 근무 형태(예: 주간 전담, 로테이션 등)에 맞춰 커스텀 스케줄링 로직을 추가할 수 있었습니다. Slack 사용자를 기준으로 자동 동기화하여, 신규 입사자도 별도 계정 설정 없이 LDAP 연동을 통해 바로 온콜 로테이션에 참여할 수 있도록 구현했습니다.
이제 OnCall의 데이터 영속성 을 위해, 기본 SQLite 대신 AWS RDS(MySQL) 를 연동했습니다.
이 선택은 단순히 안정성뿐 아니라, 운영 중인 EKS의 Pod 재시작, 스케일링, 혹은 배포 과정에서도 모든 온콜 설정이 안전하게 보존되도록 하기 위함이었습니다.
Helm Chart(oncall 1.16.5 · grafana/grafana )를 사용하여 배포했으며,
Ingress 설정과 외부 Grafana 연동, Slack OAuth 연계를 통해 프로덕션 수준의 구성을 완성했습니다.
아래는 주요 설정 예시입니다.
# grafana-oncall/values.yaml
ingress:
  enabled: true
  className: nginx
  hosts:
    - host: oncall.dev.example.com
      paths:
        - path: /
          pathType: Prefix
  tls:
    - secretName: oncall-cert
      hosts:
        - oncall.dev.example.com
grafana:
  enabled: false  # 이미 외부 Grafana 사용
database:
  type: mysql
  host: oncall-xxxx.xxxx-xxxx.ap-northeast-2.rds.amazonaws.com
  user: ${ONCALL_DB_USER}
  password: ${ONCALL_DB_PASSWORD}
  name: grafana_oncall
slack:
  enabled: true
  client_id: ${SLACK_CLIENT_ID}
  client_secret: ${SLACK_CLIENT_SECRET}
  signing_secret: ${SLACK_SIGNING_SECRET}
이렇게 구축된 Grafana OnCall on LGTM 환경은 단순한 알림 도구가 아닌,
실시간 운영 자동화 플랫폼 으로 발전했습니다.
메트릭 → 알람 → 대응 → 복구까지의 전 과정을 하나의 Grafana 생태계 안에서 통합 관리함으로써, 운영 효율성과 비용 효율을 동시에 확보할 수 있었습니다.
- Ingress, NGINX Ingress Controller, cert-manager는 비활성화되어 있습니다.
- 외부에서 서비스를 노출하지 않고, oncall-engine:8080 같은 Kubernetes Service(ClusterIP) 네임스페이스 내부 접근만 활성화되어 있습니다.
- 외부 접속이나 인증서 관리는 Kubernetes Service Type(NodePort/LoadBalancer/port-forward 중 실제 적용된 방식을 별도로 문서화) 또는 Grafana를 통한 플러그인 접근으로 처리 중입니다.
- 외부 DB 연동: RDS 엔드포인트를 oncall.database.host/user/password 로 지정
- 내부 Grafana 비활성화: 기존 Grafana 인스턴스와 통합
- Slack 통합: SRE 및 팀별 Slack 채널에 즉시 알림 전송
이렇게 구성된 Grafana OnCall은 단순 알림 도구를 넘어 팀 단위의 온콜 체계와 자동화된 알림 흐름을 제어하는 중앙 허브로 자리 잡았습니다.
3. 비싼 솔루션 없이 완성한 24/7 자동 전화 알림 구조
대부분의 기업은 전화 + SMS를 보낼 수 있는 값 비싼 솔루션을 사용 합니다.
하지만 저희는 AWS 기본 서비스와 오픈소스 조합으로 같은 수준의 기능을 구현했습니다.
핵심 구성은 다음과 같습니다.
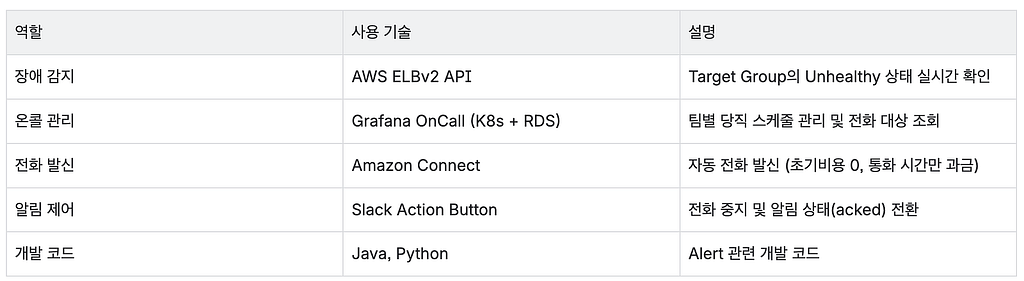
아래의 아키텍처 다이어그램은 장애 감지부터, 온콜 담당자 식별, 알림·전화·슬랙 통보까지의 전체 흐름을 한눈에 볼 수 있도록 정리한 것입니다.
Grafana 기반의 OnCall 시스템을 중심으로 하여, 모니터링 경고 발생 시 알림을 처리하고 외부 AWS 서비스 및 EC2 인스턴스로 연결하는 과정을 보여줍니다.
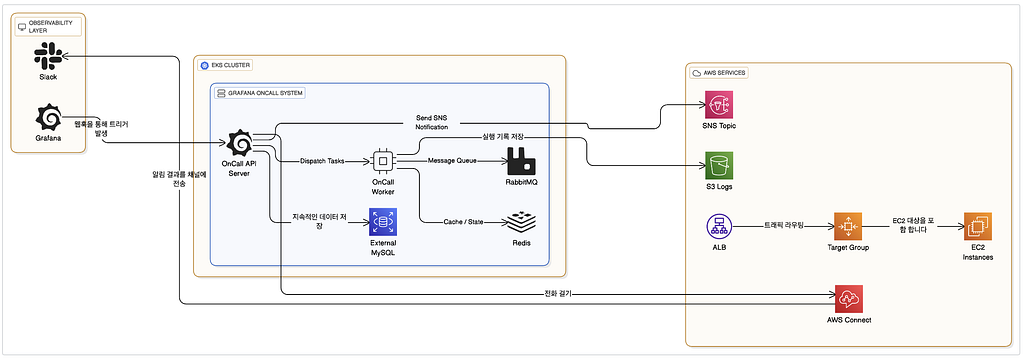
1. 알림 발생 및 수신 (좌측: Observability Layer)
- Grafana에서 모니터링 조건에 따라 경고(Alert)가 발생합니다.
- 이 경고는 Slack으로 알림을 보내는 동시에, Grafana OnCall 시스템에 “웹훅을 통해 트리거”를 발생시킵니다.
- Grafana는 또한 “알림 발송/알림 일정을 Grafana OnCall API Server에 전송”하는 역할도 수행합니다.
2. Grafana OnCall 시스템 내부 처리 (중앙: Grafana OnCall Cluster)
Grafana로부터 웹훅/알림 데이터를 수신한 Grafana OnCall API Server가 핵심적인 역할을 수행합니다.
- Grafana OnCall API Server 는 수신된 데이터를 내부 Message Queue (RabbitMQ)로 보냅니다.
- Message Queue는 메시지를 일시적으로 저장합니다.
- Grafana OnCall Worker는 Message Queue에서 메시지를 가져와 처리합니다.
- External MySQL에 “지속적인 데이터 저장”을 수행합니다.
- Redis 를 “Cache / State” 용도로 사용합니다.
- 처리 결과에 따라 “Send SNS Notification”을 외부 AWS 서비스로 요청합니다.
- Grafana OnCall Worker는 또한 Grafana 쪽으로 “실행 기록 저장” 피드백을 보냅니다.
3. AWS Services
Grafana OnCall 시스템의 처리 결과에 따라 외부 AWS 서비스로 다양한 액션이 이어집니다.
SNS Topic : Grafana OnCall Worker의 “Send SNS Notification” 요청을 받아 다양한 구독자(예: 이메일, SMS 등)에게 알림을 전달합니다.
S3 Logs : 시스템 또는 경고 관련 로그를 저장하는 데 사용됩니다.
Amazon Connect : “전화 걸기” 액션을 수행하여 Grafana OnCall 경고 시 담당자에게 전화를 거는 데 사용됩니다.
ALB (Application Load Balancer) : 트래픽을 분산하는 역할을 하며, “트래픽 라우팅”을 통해 Target Group으로 연결합니다.
Target Group : ALB의 요청을 수신하며, 실제 애플리케이션이 구동 중인 EC2 Instances로 요청을 전달합니다.
4. Target Group Unhealthy 상태 실시간 감지
저희의 출발점은 “장애를 어떻게 가장 빠르게 감지할 수 있을까 ”였습니다.
CloudWatch 경보보다 더 즉각적인 대응을 위해,
주기적으로 AWS ELBv2 API를 직접 호출하는 방식을 채택했습니다.
스크립트의 주요 흐름은 다음과 같습니다.
describe_load_balancers: 모든 ELB 목록 조회
async with aioboto3.Session().client("elbv2", region_name=REGION) as client: try: paginator_lb = client.get_paginator("describe_load_balancers") .....describe_target_groups: 각 로드밸런서에 연결된 Target Group 수집
paginator_tg = client.get_paginator("describe_target_groups") async for page_tg in paginator_tg.paginate(LoadBalancerArn=elb["LoadBalancerArn"]): ....describe_target_health: 각 Target Group의 인스턴스 헬스 체크 상태 확인
target_healths = await client.describe_target_health(TargetGroupArn=tg["TargetGroupArn"]) ...State == ‘unhealthy’ 인 인스턴스 탐지
if health["TargetHealth"]["State"] == "unhealthy": ....Target Group의 Team 태그를 읽어 어느 팀의 담당 서비스인지 식별
team_tag = next((t["Value"] for t in tags["TagDescriptions"][0]["Tags"] if t["Key"] == "Team"),None,) ....
테스트나 스테이징 환경의 Target Group은 미리 제외하여 불필요한 알림 노이즈를 줄였습니다.
5. OnCall DB에서 사용자 정보 조회 및 전화 발신
Unhealthy 대상이 감지되면, 이제 “누가 담당자인가? ”를 찾아야 합니다.
Grafana OnCall의 RDS DB를 직접 조회하여,
현재 시간대에 OnCall 스케줄이 잡힌 엔지니어의 정보를 가져옵니다.
이때 cached_ical_final_schedule 필드의 iCal 데이터를 파싱해
현재 시각이 포함된 DTSTART/DTEND 이벤트를 찾고,
해당 이벤트의 SUMMARY에 기록된 이름과 전화번호를 추출합니다.
이렇게 찾은 전화번호는 Amazon Connect의 start_outbound_voice_contact API로 전달되어 즉시 발신됩니다.
그럼 전화번호는 어떻게 가져오느냐? 자동화를 통해 LDAP 정보를 기반으로 개발팀의 연락처를 저장하여 가져오게 됩니다.
그리고 Amazon Connect의 장점은 사용량 기반 과금 입니다. (알림 빈도가 낮다면 그만큼 비용은 더 줄어 들겠죠?)
타 솔루션처럼 사용자 라이선스 비용이 없고, 실제 통화 시간에 대해서만 요금이 발생합니다.
또한 Contact Flow를 구성하여전화 수신자에게 “서비스 장애가 발생했다고 알려주는” 음성 안내 멘트를 자동 재생하도록 설정했습니다.
6. 알림 제어와 중복 방지: DB 중심의 상태 관리
가장 중요한 것은 알림 피로도를 줄이는 것입니다.
이를 위해 알림 상태를 DB에 기록하고, 이미 acked(확인됨) 상태인 리소스에 대해서는 새로운 알림이나 전화 발신을 차단했습니다.
- status=’firing’ → 전화 유지
- status=’acked’ → 전화/알림 즉시 중단
- 아래는 실제 알림이 온 내용 입니다.
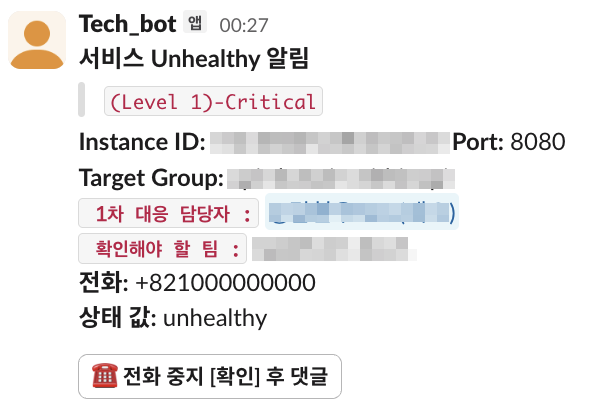
Slack 메시지의 “☎ 전화 중지” 버튼을 누르면
stop_contact API가 호출되어 현재 통화를 종료하고,
DB 상태가 acked로 갱신됩니다.
이후 주기 실행 시에는 해당 리소스는 다시 전화하지 않습니다. 또한 전화 중지 버튼을 누른 사용자가 누군지도 알려줍니다.
실전 운영 팁
- 야간/주말만 전화 알림: 근무시간 외에만 start_call 실행 (공휴일 API 연동으로 정밀 제어)
- Amazon Connect Quick Connect 활용: 사전 녹음된 음성 메시지로 장애 상황을 즉시 전달
- Team 태그 기반 라우팅: Target Group의 Team 태그와 Grafana OnCall 팀 이름을 1:1 매핑, 코드 수정 없이 확장 가능
- 비동기 처리: asyncio + aioboto3 + aiomysql 조합으로 초 단위 응답
- Fallback 채널 운영: 시스템 오류 시 별도 Slack 채널로 폴백 알림
실제 활용 사례
근무 외 시간, 배포 오류 즉시 감지
긴급 패치 후 일부 인스턴스가 503 에러로 Unhealthy 상태 발생.
→ 1분 내 감지 → 10초 내 전화 → 사용자 확인
기존 서비스의 사용자 확인이 안되는 것을 담당자 확인이 가능하여 빠른 처리가 가능합니다.
결과적으로 알림 노이즈 최소화 + 대응 시간 단축 효과를 얻었습니다.
7. Target Group 비정상 트래픽감지 그 이상의 알림 적용
이번 구축은 단순히 헬스체크 자동화에 그치지 않습니다.
Grafana OnCall의 유연한 구조와 Slack 통합 기능을 활용하면,
다음과 같은 다양한 이벤트에도 응용할 수 있습니다.
EC2 상태 변화 감지
RDS 연결 실패 이벤트
EKS Pod CrashLoopBackOff 감지
ALB 응답 지연 등…
다양한 알림 유형에 Grafana OnCall의 전화 및 이메일 기능을 적용할 수 있습니다.
실제 우리 SRE팀에서도 많은 알림을 이와 같은 형식으로 운용 하고 있습니다.
또한 Grafana OnCall의 Escalation Policy를 적용하면
1차 담당자 → 2차 담당자 → 팀 리더 → 팀 채널 순으로
자동 에스컬레이션이 가능합니다.
이로써 “사람이 놓치는 시간”을 최소화하고,
항상 누군가는 즉시 대응할 수 있는 체계를 완성했습니다.
정리
시스템의 핵심 가치
- 비용 최적화와 안정성: AWS의 기본 서비스인 ELBv2 및 Connect 와 검증된 오픈소스 툴인 Grafana OnCall , Slack을 전략적으로 조합하여, 고가용성을 유지하면서도 불필요한 비용을 최소화했습니다.
- 운영 효율성 극대화: 복잡한 알림 프로세스를 자동화하여 장애 대응 시간을 단축하고, 시스템 관리의 부담을 경감시켰습니다.
개발자 및 관리자를 위한 핵심 기능
저희 온콜 자동화의 핵심은 개발자나 관리자의 ‘대응 스트레스’를 줄이는 것에 있습니다.
- 꼭 필요할 때만 울리는 전화: 중요도가 높은 경고에 대해서는 교대(Rotation) 일정에 맞춰 지정된 시간에만 전화 알림이 작동합니다. 불필요한 야간 호출을 최소화합니다.
- 정확한 담당자에게만 전달되는 알림: 경고 유형과 시간에 따라 온콜 로직이 자동으로 가장 적합한 담당자를 판별하여 알림을 전달합니다. 알림의 “노이즈”를 제거하고 담당자의 집중도를 높입니다.
AWS의 기본 서비스(ELBv2, Amazon Connect)와 오픈소스 툴(Grafana OnCall, Slack)을 조합해
비용은 최소화하고, 대응 속도는 극대화한 온콜 시스템 을 완성했습니다.
특히 Target Group의 비정상 상태를 실시간으로 감지해
“누가 대응해야 하는가?”에 대한 고민을 자동화로 해결한 점이 가장 큰 차별점입니다.
결국 중요한 건 “도구”가 아니라 “흐름”입니다.
어떤 장애가 발생하더라도 즉시 감지 → 자동 알림 → 대응자 식별 → 연락 → 알림 제어 의 사이클이 끊김 없이 이어지는 것, 이것이 우리가 추구한 진짜 온콜 시스템입니다.
이 구축 경험이 같은 고민을 가진 팀이나 엔지니어에게 “비용 효율적인 온콜 자동화”의 좋은 참고 사례가 되길 바랍니다.
그리고 무엇보다, 다음 새벽에 들려올 “서버가 죽었어요”라는 한 마디가 조금은 덜 두렵기를 바랍니다.
끝까지 긴글 읽어주셔서 감사합니다.