AI/ML
밑바닥부터 Kanana LLM 개발하기: Post-training
kloud.off카카오
2024년 11월 14일
원문에서 보기 ↗안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 알파(Kanana ⍺) 조직에서 자체 언어모델을 개발하고 있는 Kloud입니다. 저희 조직에서는 카나나 언어모델(Kanana LLM: Kanana Nano, Essence, Flag)의 Post-training 과정 전반을 담당하고 있습니다.
이 글에서는 앞선 효율적인 고성능 LLM 학습을 위한 Pre-training 과정에 이어, LLM의 Post-training 과정을 다루고자 합니다. Pre-training 과정이 LLM에 지식을 주입하는 과정이라면, Post-training은 LLM이 사용자의 명령을 잘 이해하고 따를 수 있도록 만드는 단계인데요. 이를 통해 개발된 Kanana Essence Instruct와 Kanana Nano Instruct 모델의 학습 과정과 성능결과를 소개하겠습니다. Instruct 모델 또한, 앞서 소개한 베이스 모델과 마찬가지로 유사 사이즈의 글로벌 SOTA 모델들과 비교해 동등한 수준의 영어 성능과 압도적인 한국어 성능을 확인하였습니다.
1. Post-training 이란?
Pre-training이 완료된 LLM은 방대한 텍스트 데이터를 통해 세상의 다양한 지식을 이해하는 능력을 갖추게 됩니다. 하지만 Pre-training 단계에서는 다음 단어를 예측하는 방식으로 다양한 “문서”들에 대해서 학습하기 때문에 사용자가 제시하는 명령을 “이해하고 수행”하는 데 필요한 능력은 부족한 경우가 많습니다. 따라서 모델이 사용자의 명령을 인식하고 적절히 반응할 수 있는 LLM을 만들기 위해서는 적절한 Post-training 과정을 거쳐야 합니다.
Post-training은 사후 학습, 즉 Pre-training 이후에 사용자의 명령을 따르도록 학습하는 일련의 과정을 의미합니다. LLM은 다양한 유형의 명령어, 지시문 등의 데이터를 학습하는 Post-training 과정을 통해 특정 문맥에서 바람직한 응답을 선택하고 적절히 추론하는 능력을 키우게 됩니다.
2. 일반적인 LLM의 Post-training 방식
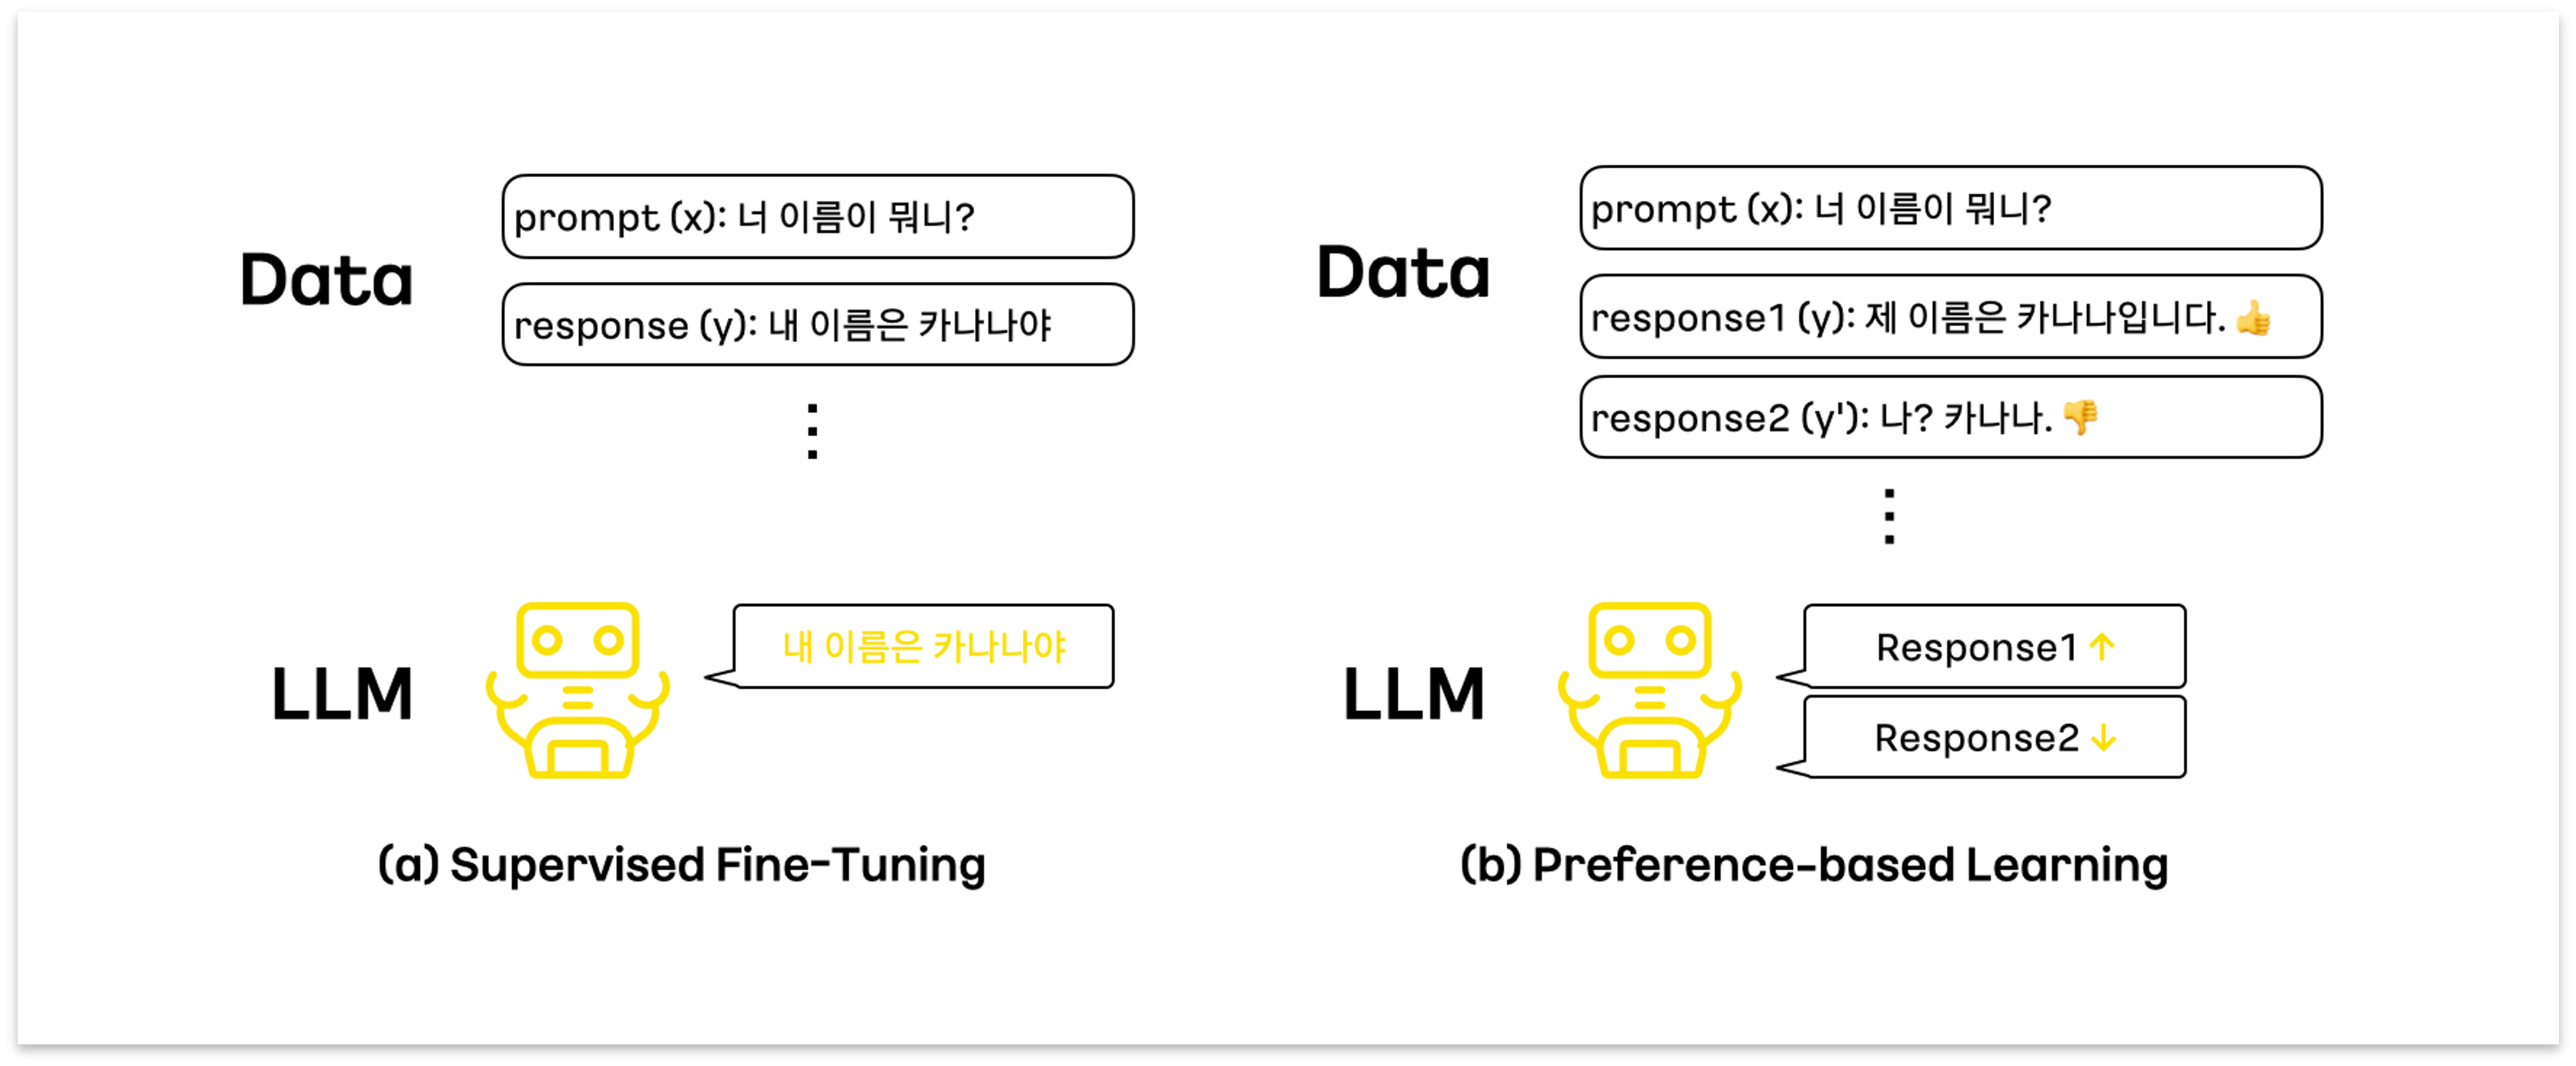
Post-training을 수행하는 일반적인 방법은 지도 학습을 통한 미세 조정(Supervised Fine-tuning, SFT)과 선호도 기반 학습(Preference-based Learning)*으로 나누어볼 수 있습니다.
*여기에서는 RL기반의 다양한 학습방식도 Preference-based learning의 일종으로 포괄하여 설명합니다.
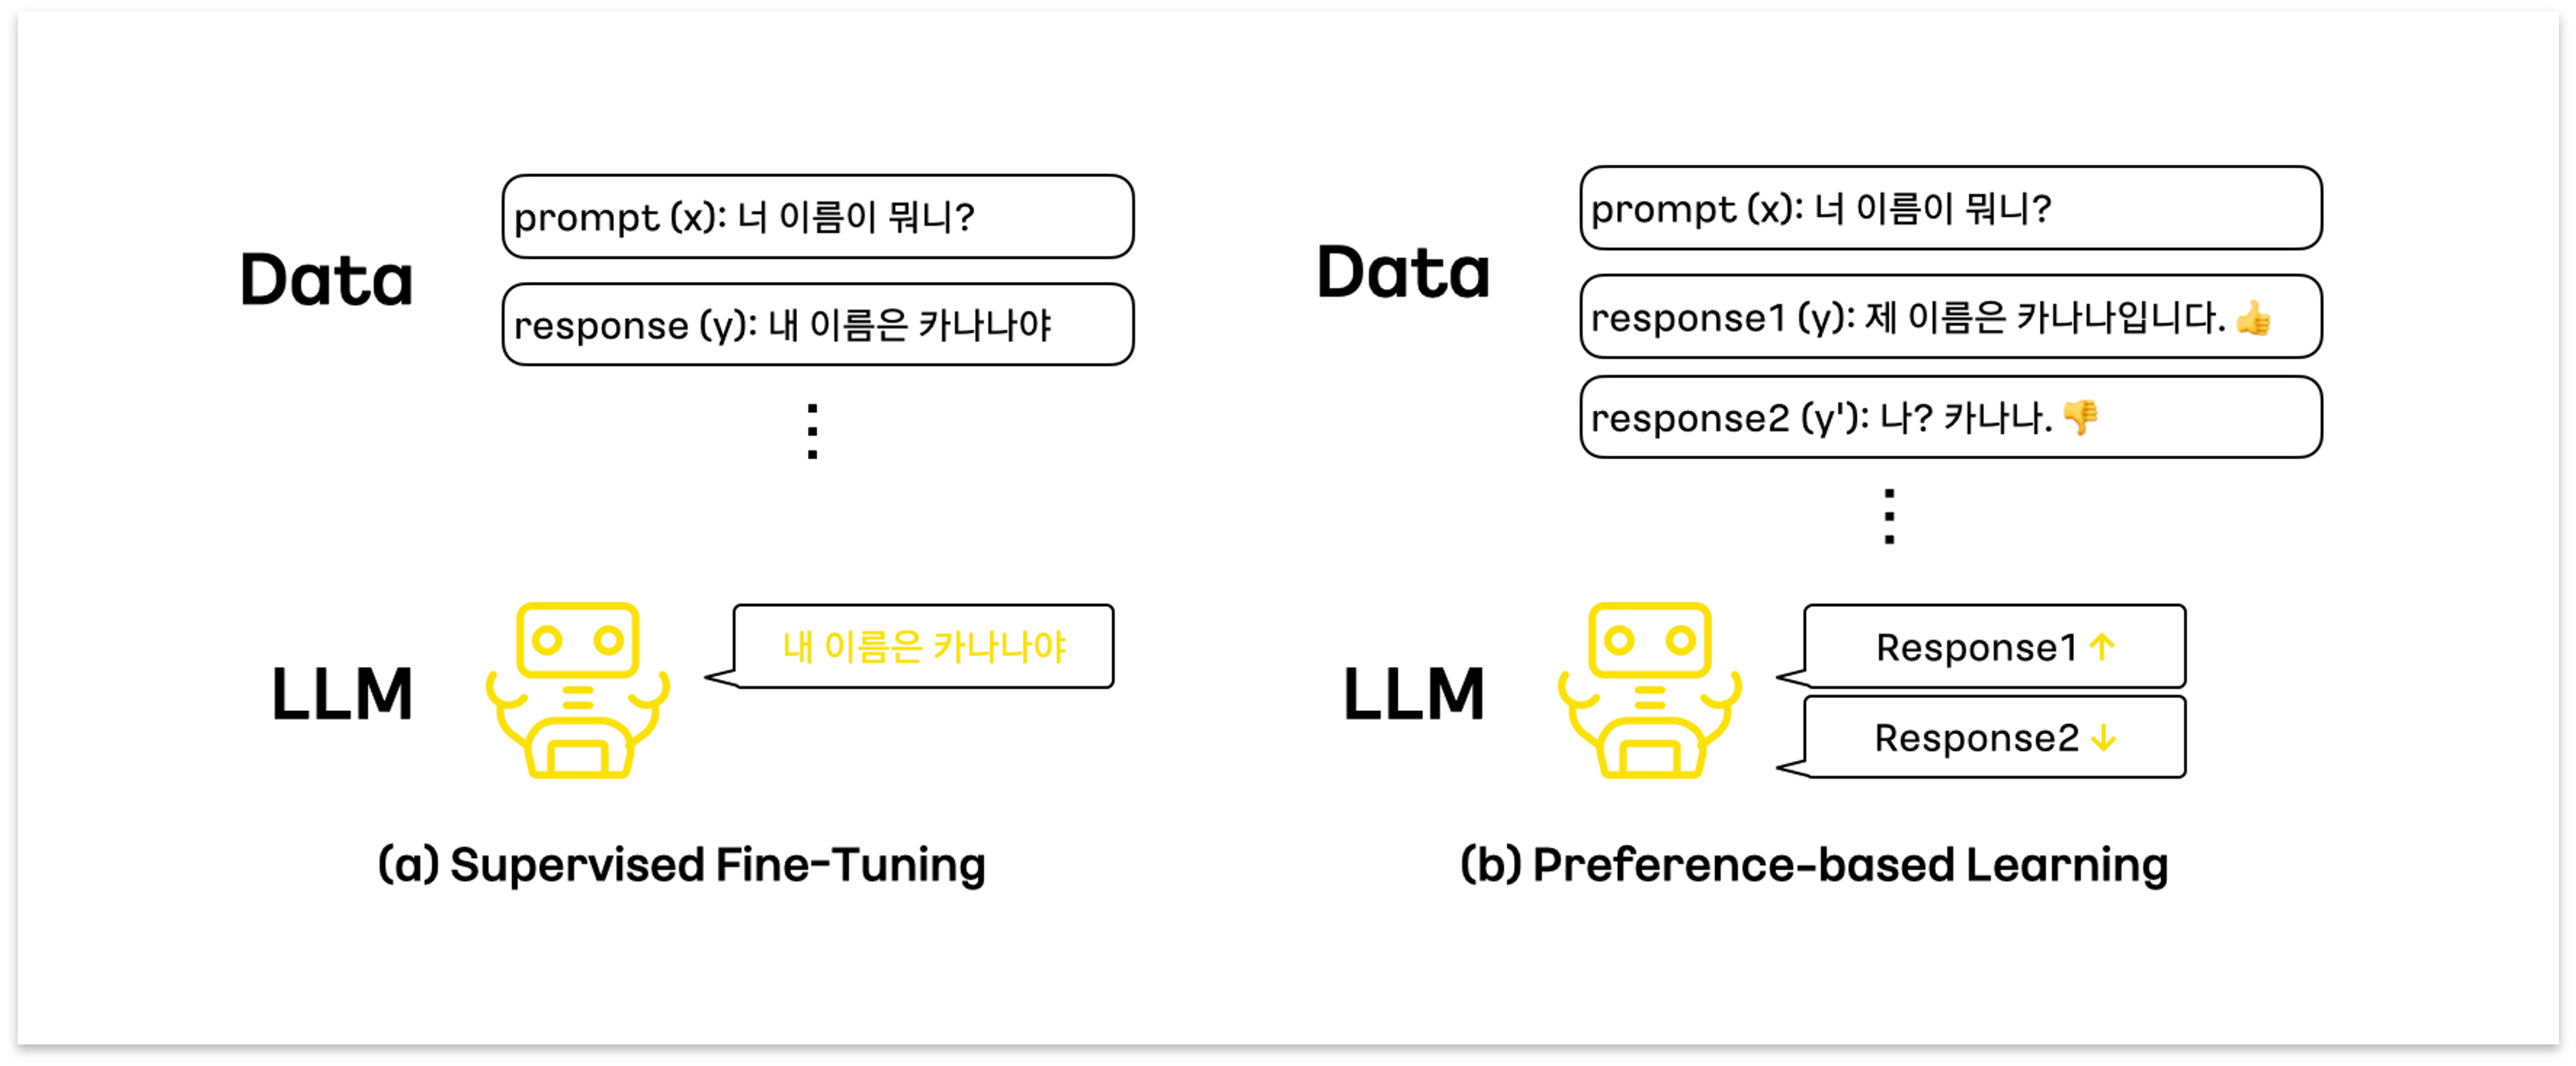
- Supervised Fine-tuning(SFT) : 먼저 SFT는 모델에게 사용자의 입력(Prompt)과 그에 대응하는 적절한 응답(Response) 쌍을 학습시키는 과정입니다. 이때 LLM은 사용자의 입력이 주어졌을 때 이에 대응하는 응답을 직접 생성하도록 학습합니다. 이 방법은 LLM이 사람의 예제 응답을 모방하도록 유도함으로써, 특정 문맥에서 적절한 응답을 생성하는 능력을 키우게 합니다.
<그림 2-(a)>- Preference-based Learning++ : 선호도 기반 학습은 SFT 이후 모델 성능을 더욱 개선하기 위한 방법으로, 사용자가 선호하는 바람직한 응답을 더 잘 생성할 수 있도록 학습하는 과정입니다. 이때 LLM은 사용자의 입력이 주어지고 이에 대한 여러 응답이 있을 때 좋은 응답을 강화하고 안 좋은 응답을 약화하는 방향으로 학습합니다. 이 방식은 모델이 사용자의 기대와 일치하는 방향으로 학습함으로써 더 효율적이고 정확하게 사용자의 명령을 따르게 됩니다.
<그림 2-(b)>
실제 Post-training 과정은 일반적으로 Supervised Fine-tuning을 수행하고 후속으로 Preference-based learning을 적용하는 형태로 진행하게 됩니다.
3. Kanana LLM의 Post-training 방식
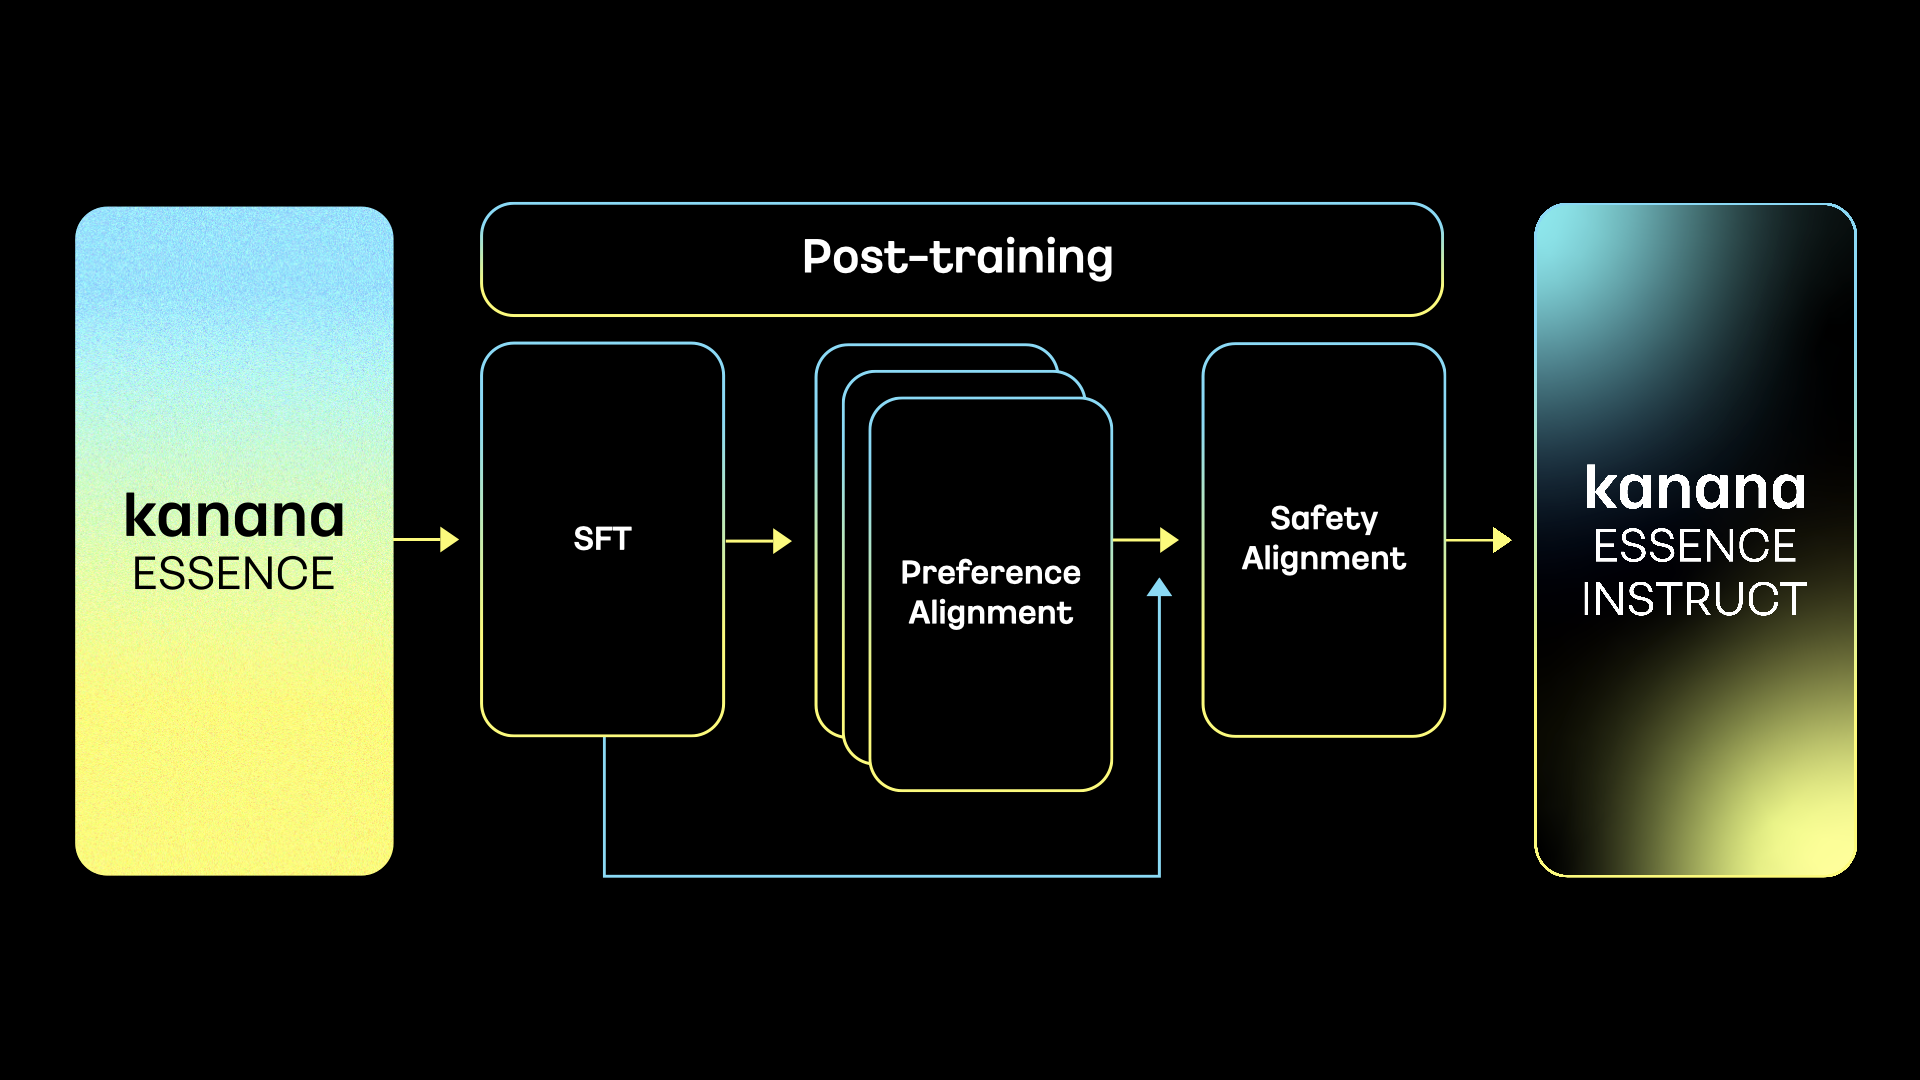
Kanana LLM은 사용자의 명령을 따르는 능력을 갖추기 위해 아래와 같은 Post-training 과정을 수행하였습니다. 첫 번째 단계로 다양한 도메인에 대해 사람이 직접 만든 입력(Prompt) 및 모델을 통해 증강시킨 입력과 그에 적절한 응답(Response) 쌍 데이터를 구축하여 Supervised Fine-tuning(SFT) 기법을 통해 학습시켰습니다. 그 후, 같은 입력에 대해 여러 응답 선호도 데이터를 구축하여 SFT 학습이 완료된 모델에 Preference-based learning 기법을 적용하였습니다. 마지막으로, 각 학습 단계별 Model merging 기법 적용을 통해 최적의 모델 성능을 도출하였습니다.
3.1. Chat Template
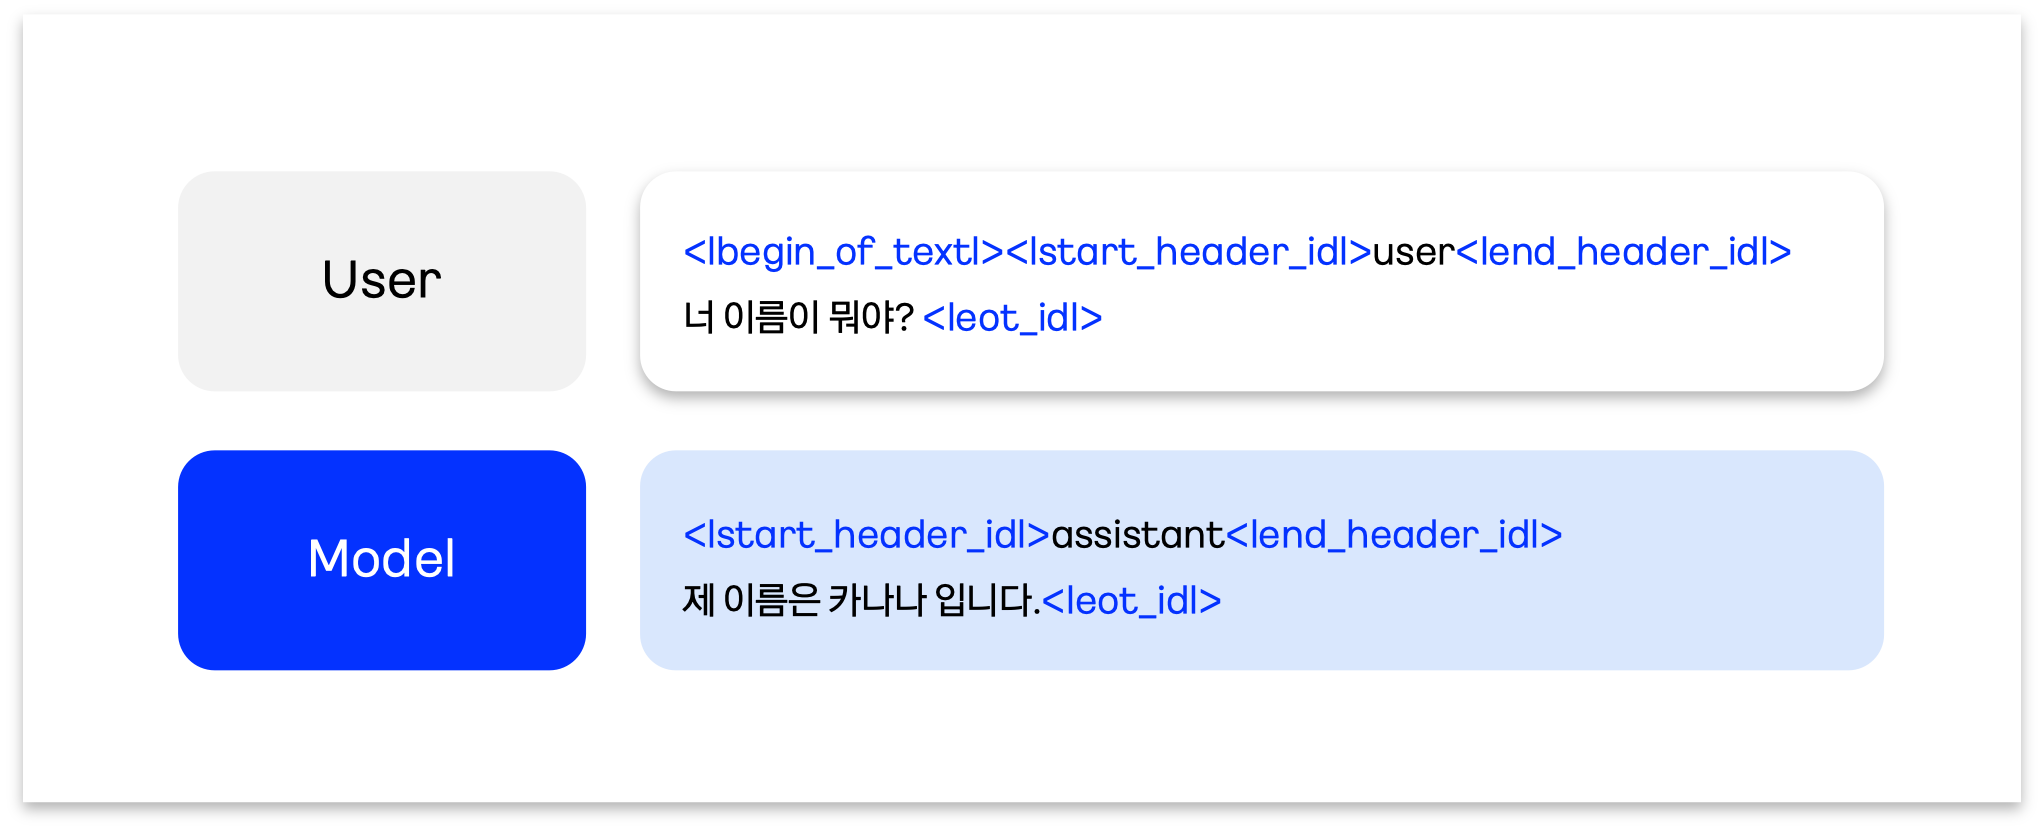
Post-training이 적용된 모델은 대화(Chat) 형식에 의도대로 응답을 생성할 수 있도록 특정한 Chat-template을 사용합니다 <그림 3>. 이러한 Chat-template은 대화에서 “user”와 같은 역할을 지정하여 발화의 주체를 명확히 하고 Multi-turn 대화에서 대화의 순서를 구분하는 데 사용됩니다. Kanana 모델의 Chat template 은 Llama-3 계열의 Instruct 모델과 동일한 형식을 사용하였습니다.^[1]^
3.2. Supervised Fine-Tuning(SFT)
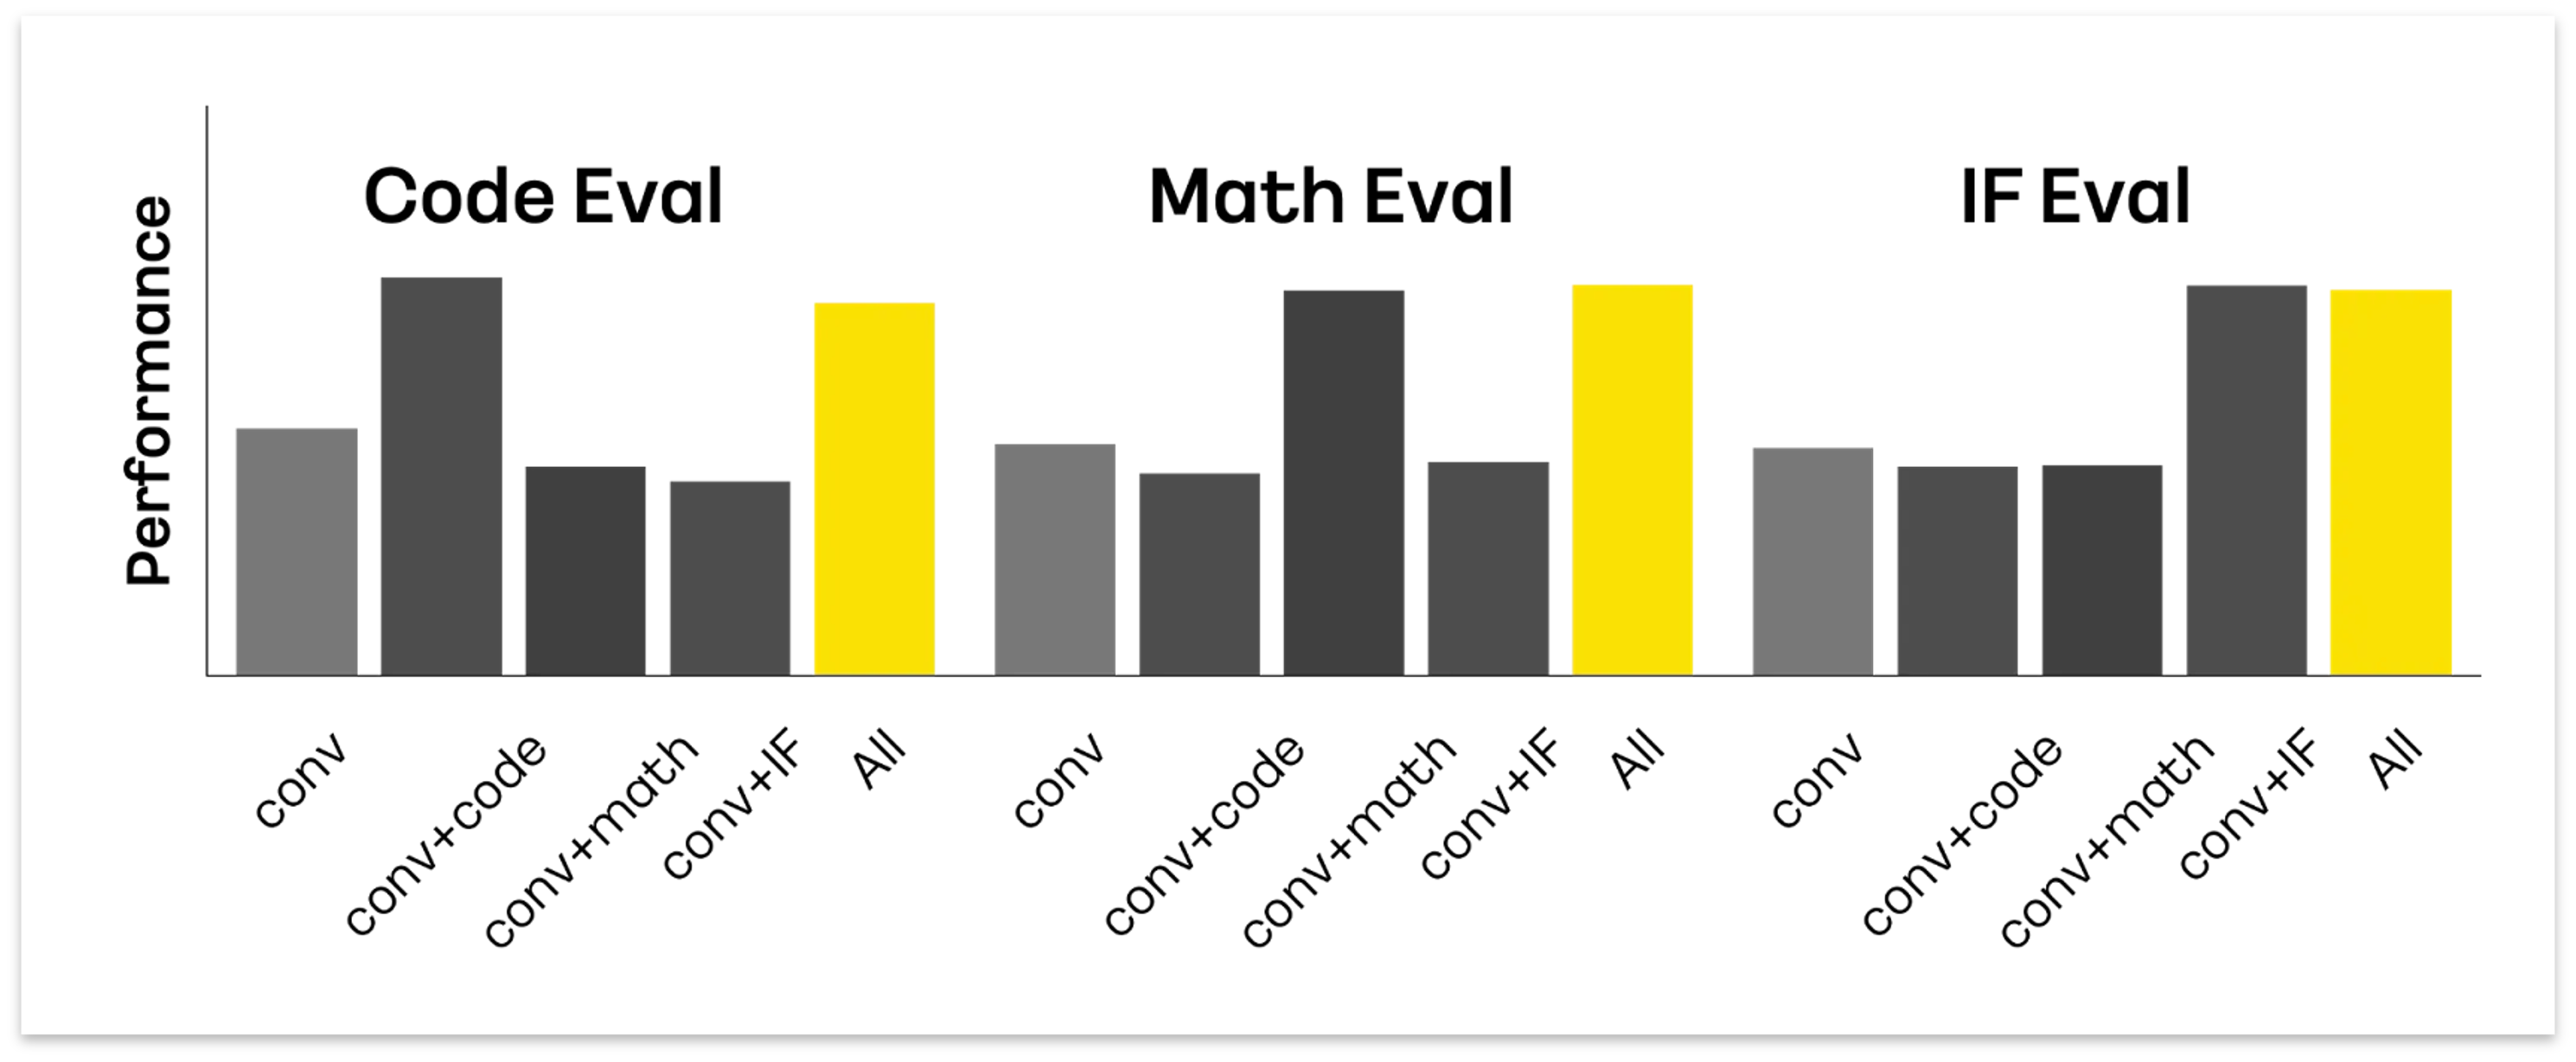
Kanana 모델이 다양한 분야에서 고루 좋은 성능을 내기 위해서는 다양한 도메인의 데이터셋이 필요하였습니다. 초기 토이 실험을 통해, 목표로 하는 도메인에 해당하는 데이터셋을 직접적으로 사용하는 것이 성능 향상에 크게 기여함과 동시에, 다른 도메인의 성능에는 별다른 영향을 끼치지 않는다는 것을 확인하였습니다 <그림 4>.
이에 따라, Supervised Fine-tuning을 위해서 다양한 도메인의 데이터를 수집하였으며, 각 도메인은 아래와 같습니다.
- General-chat
- Instruction Following*
- Code
- Math
- Safety
*입력에 제시된 특정한 조건을 만족하면서 답변하는 경우를 Instruction following이라고 구분하였으며, 별도의 도메인으로 정의하였습니다.
각 도메인의 데이터 수집을 위해 내부 자체 수집 데이터와 외부 공개 데이터의 Prompt를 활용하였습니다. Instruction Following 도메인의 경우, AutoIF^[2]^방식을 차용하여 자체적으로 생성하였습니다. 이렇게 수집된 데이터셋은 이후 필터링 과정을 통해 특정 개인 정보, 잘못된 자기 식별 데이터 및 중복을 포함한 데이터를 제거하고 SFT 학습에 사용되었습니다.
3.3. Preference-based Learning
Preference-based learning은 크게 두 가지로 나누어볼 수 있는데, Offline 방식과 Online 방식이 있습니다. Offline 방식은 <그림 5-(a)>와 같이 복수의 응답과 그에 대한 선호정보가 이미 데이터로 존재하여 이 데이터를 이용하여 학습하는 방식을 뜻합니다. 반면에 Online 방식은 <그림 5-(b)>와 같이 데이터로는 Prompt만 존재하고 LLM이 직접 응답을 여러 번 생성하여 실시간 데이터로 학습하는 방식입니다. Online 방식의 경우 외부 Reward model을 통해 실시간으로 선호 정보를 받아 이를 학습하게 됩니다.
Kanana 모델은 SFT 단계가 완료된 후 Offline/Online Preference-based learning 과정을 모두 적용하였습니다. 먼저, SFT 단계에서 수집된 입력(Prompt)들에 대해 다양한 모델로부터 복수 개의 응답을 추출하여 만들어낸 Preference dataset을 가지고 Direct Preference Optimization (DPO)^[3]^을 적용하여 Offline preference learning을 수행하였습니다. 또한 동 데이터를 이용하여 Reward model을 구축하고 현재 시점의 모델을 사용해 여러 응답을 생성하고 해당 Reward model을 통해 가장 선호되는 응답과 가장 선호되지 않는 응답을 선택하여 DPO 알고리즘을 Iterative 하게 적용하였습니다.
3.4. Model Merging
마지막으로, 학습된 모델의 성능을 더욱 끌어올리기 위하여 각 단계 사이에 모델 머징 방법을 사용하였습니다^[4]^. 다양한 머징 방법들이 존재하지만, 여러 실험 세팅에서 특정 방법이 우위를 가지는 경우가 없었기 때문에 가장 심플한 방법인 Linear 방법을 적용하였습니다. 모델 머징은 단계별로 다른 Hyperparameter로 학습된 모델을 대상으로 수행하였습니다.
여기서 모델의 성능을 한층 높임과 동시에 사용자에게 해가 되는 정보를 사전에 차단하고, 안전하고 신뢰성 있는 답변을 제공하고자 Safety Alignment를 최종적으로 거쳐 Instruct 모델을 개발하게 됩니다.
4. 주요 성능 결과
학습된 모델의 다양한 능력을 평가하기 위해, 아래와 같은 벤치마크 평가셋을 사용하였습니다.
- Korean: LogicKor^[5]^, Maru
- English: MT-Bench^[6]^, Arena-hard^[7]^
- Instruction Following: IFEval^[8]^
- Code: HumanEval+^[9]^
- Math: GSM-8k^[10]^
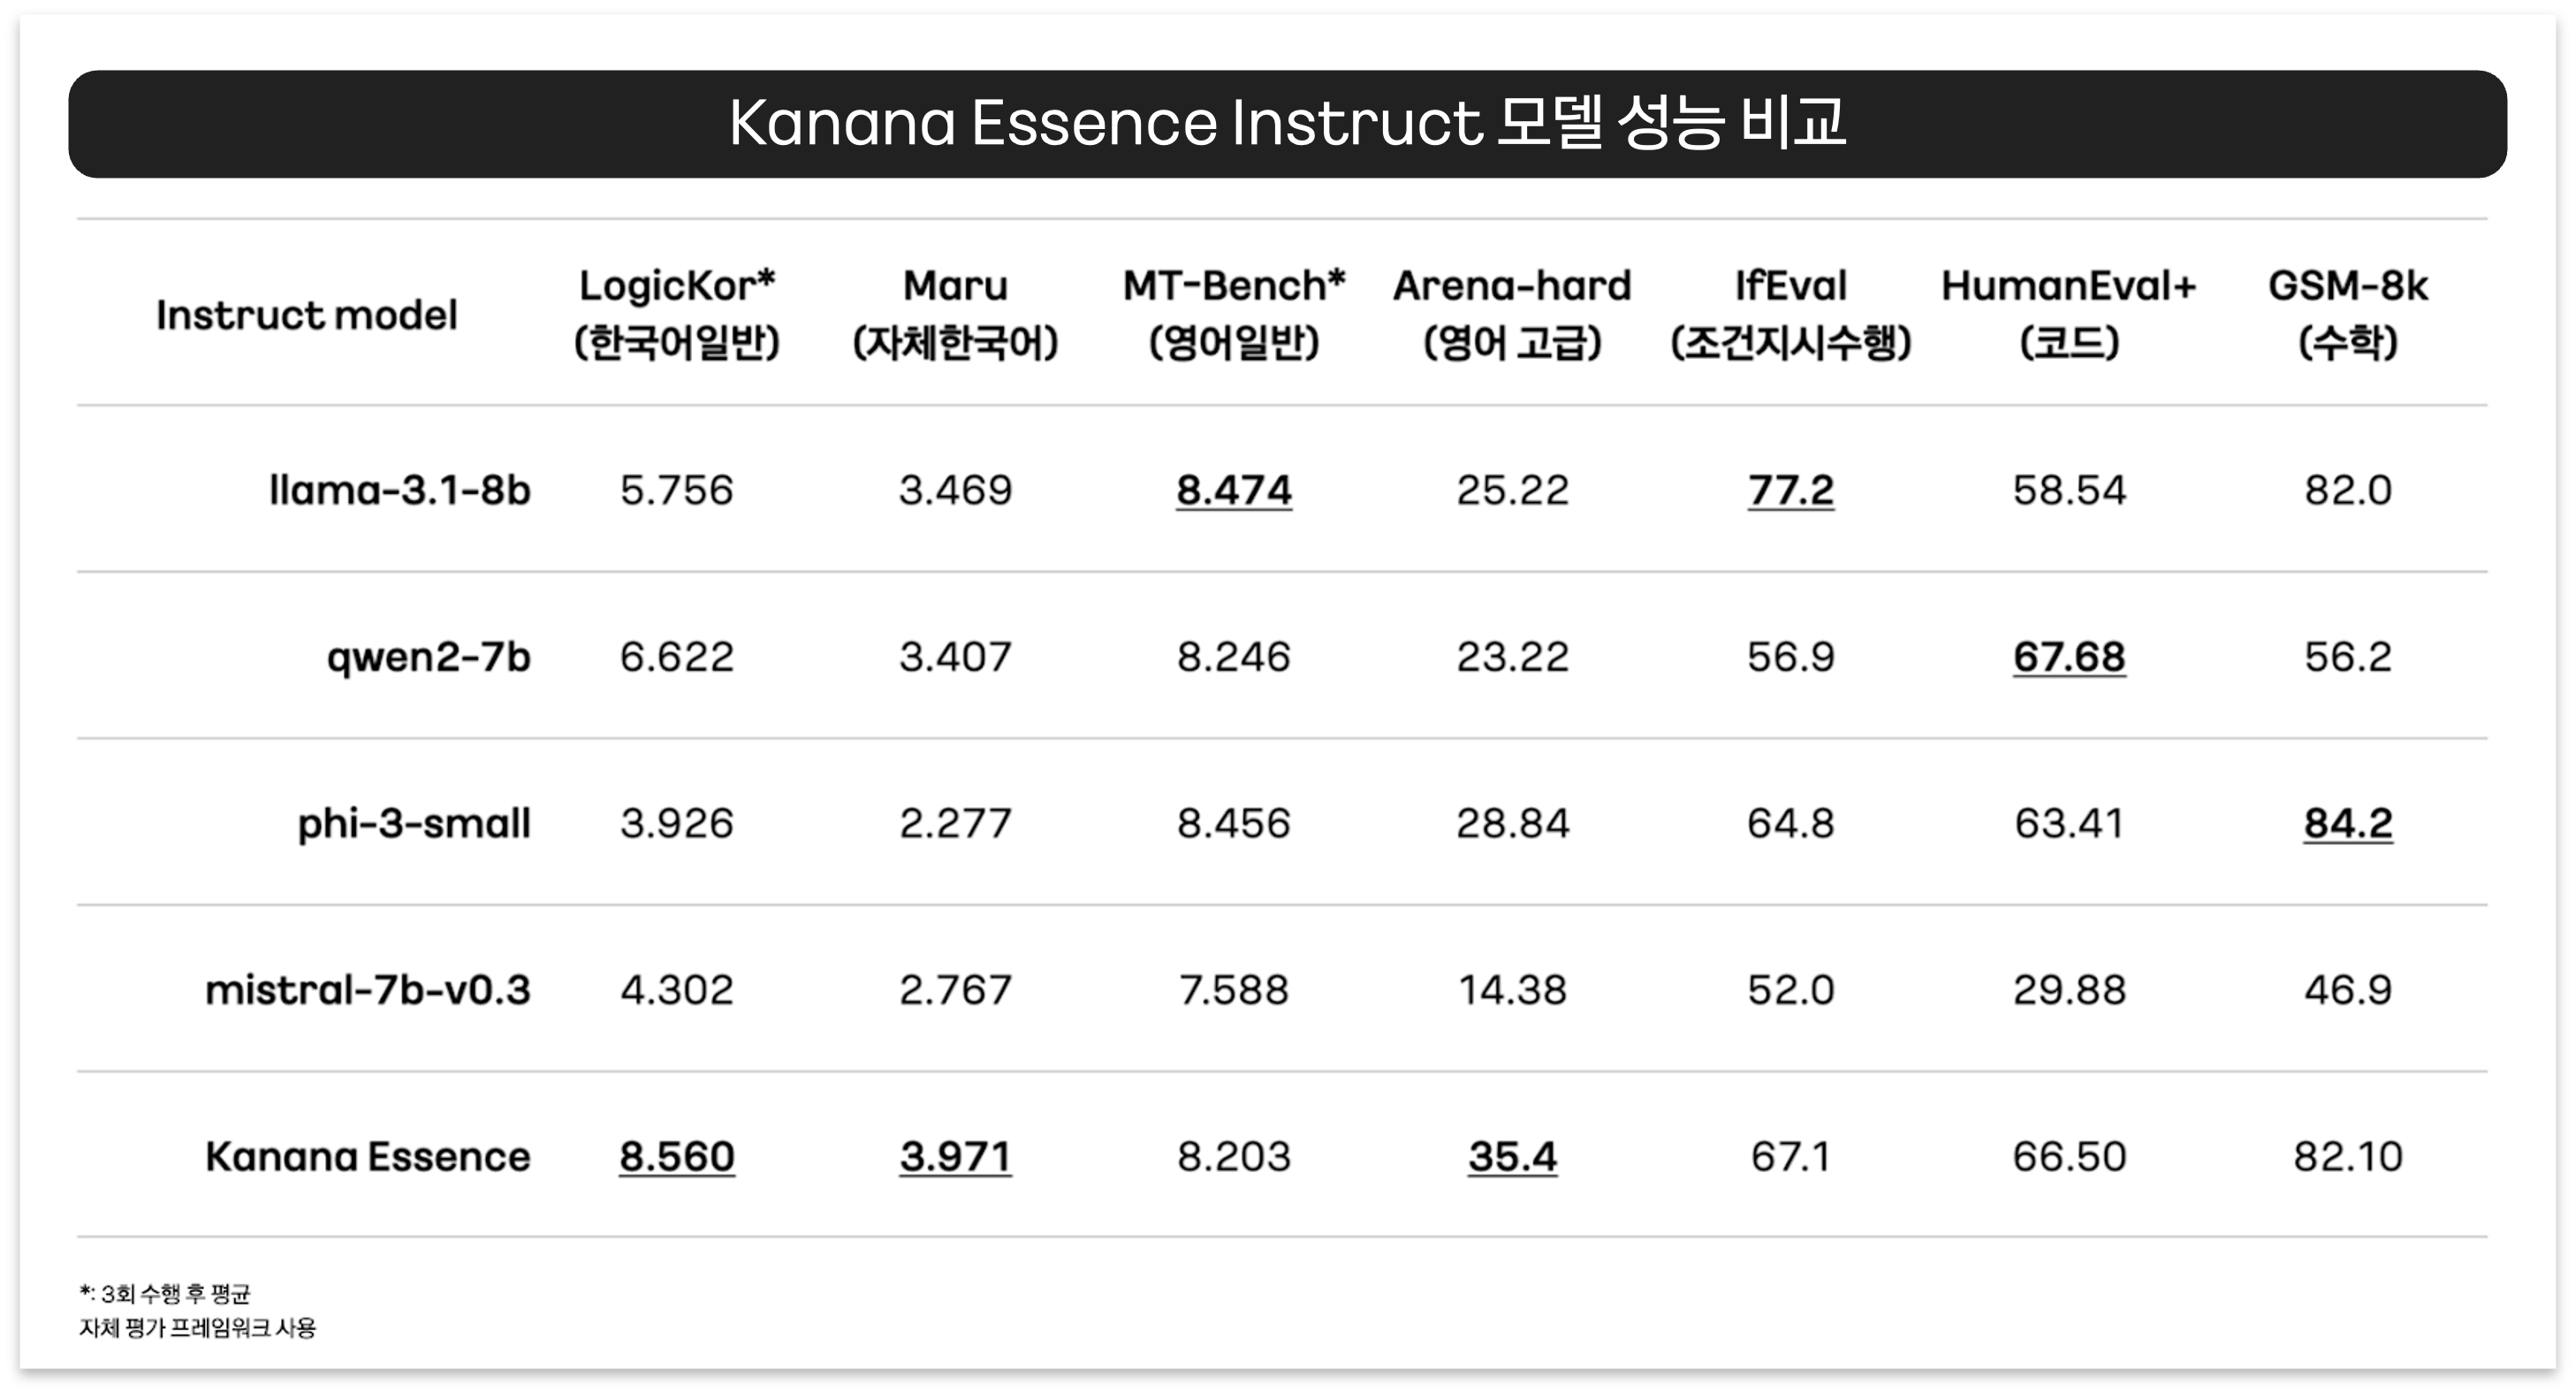
Kanana Essence Instruct 모델을 비슷한 규모의 오픈소스 LLM과 비교한 성능표는 <표 1>과 같습니다. 우선 한국어 관련 평가의 경우, Kanana 모델이 다른 모델들과 비교하여 월등히 성능이 좋음을 확인할 수 있었습니다. 또한, 영어 관련 태스크의 경우에도 다른 대표적 모델들과 함께 비견될 수 있는 좋은 수준의 성능을 보임을 확인할 수 있었습니다. 마찬가지로 일반 대화가 아닌 코드, 수학 등 다른 도메인에서도 최고와 유사한 수준의 성능을 보임을 확인할 수 있습니다.
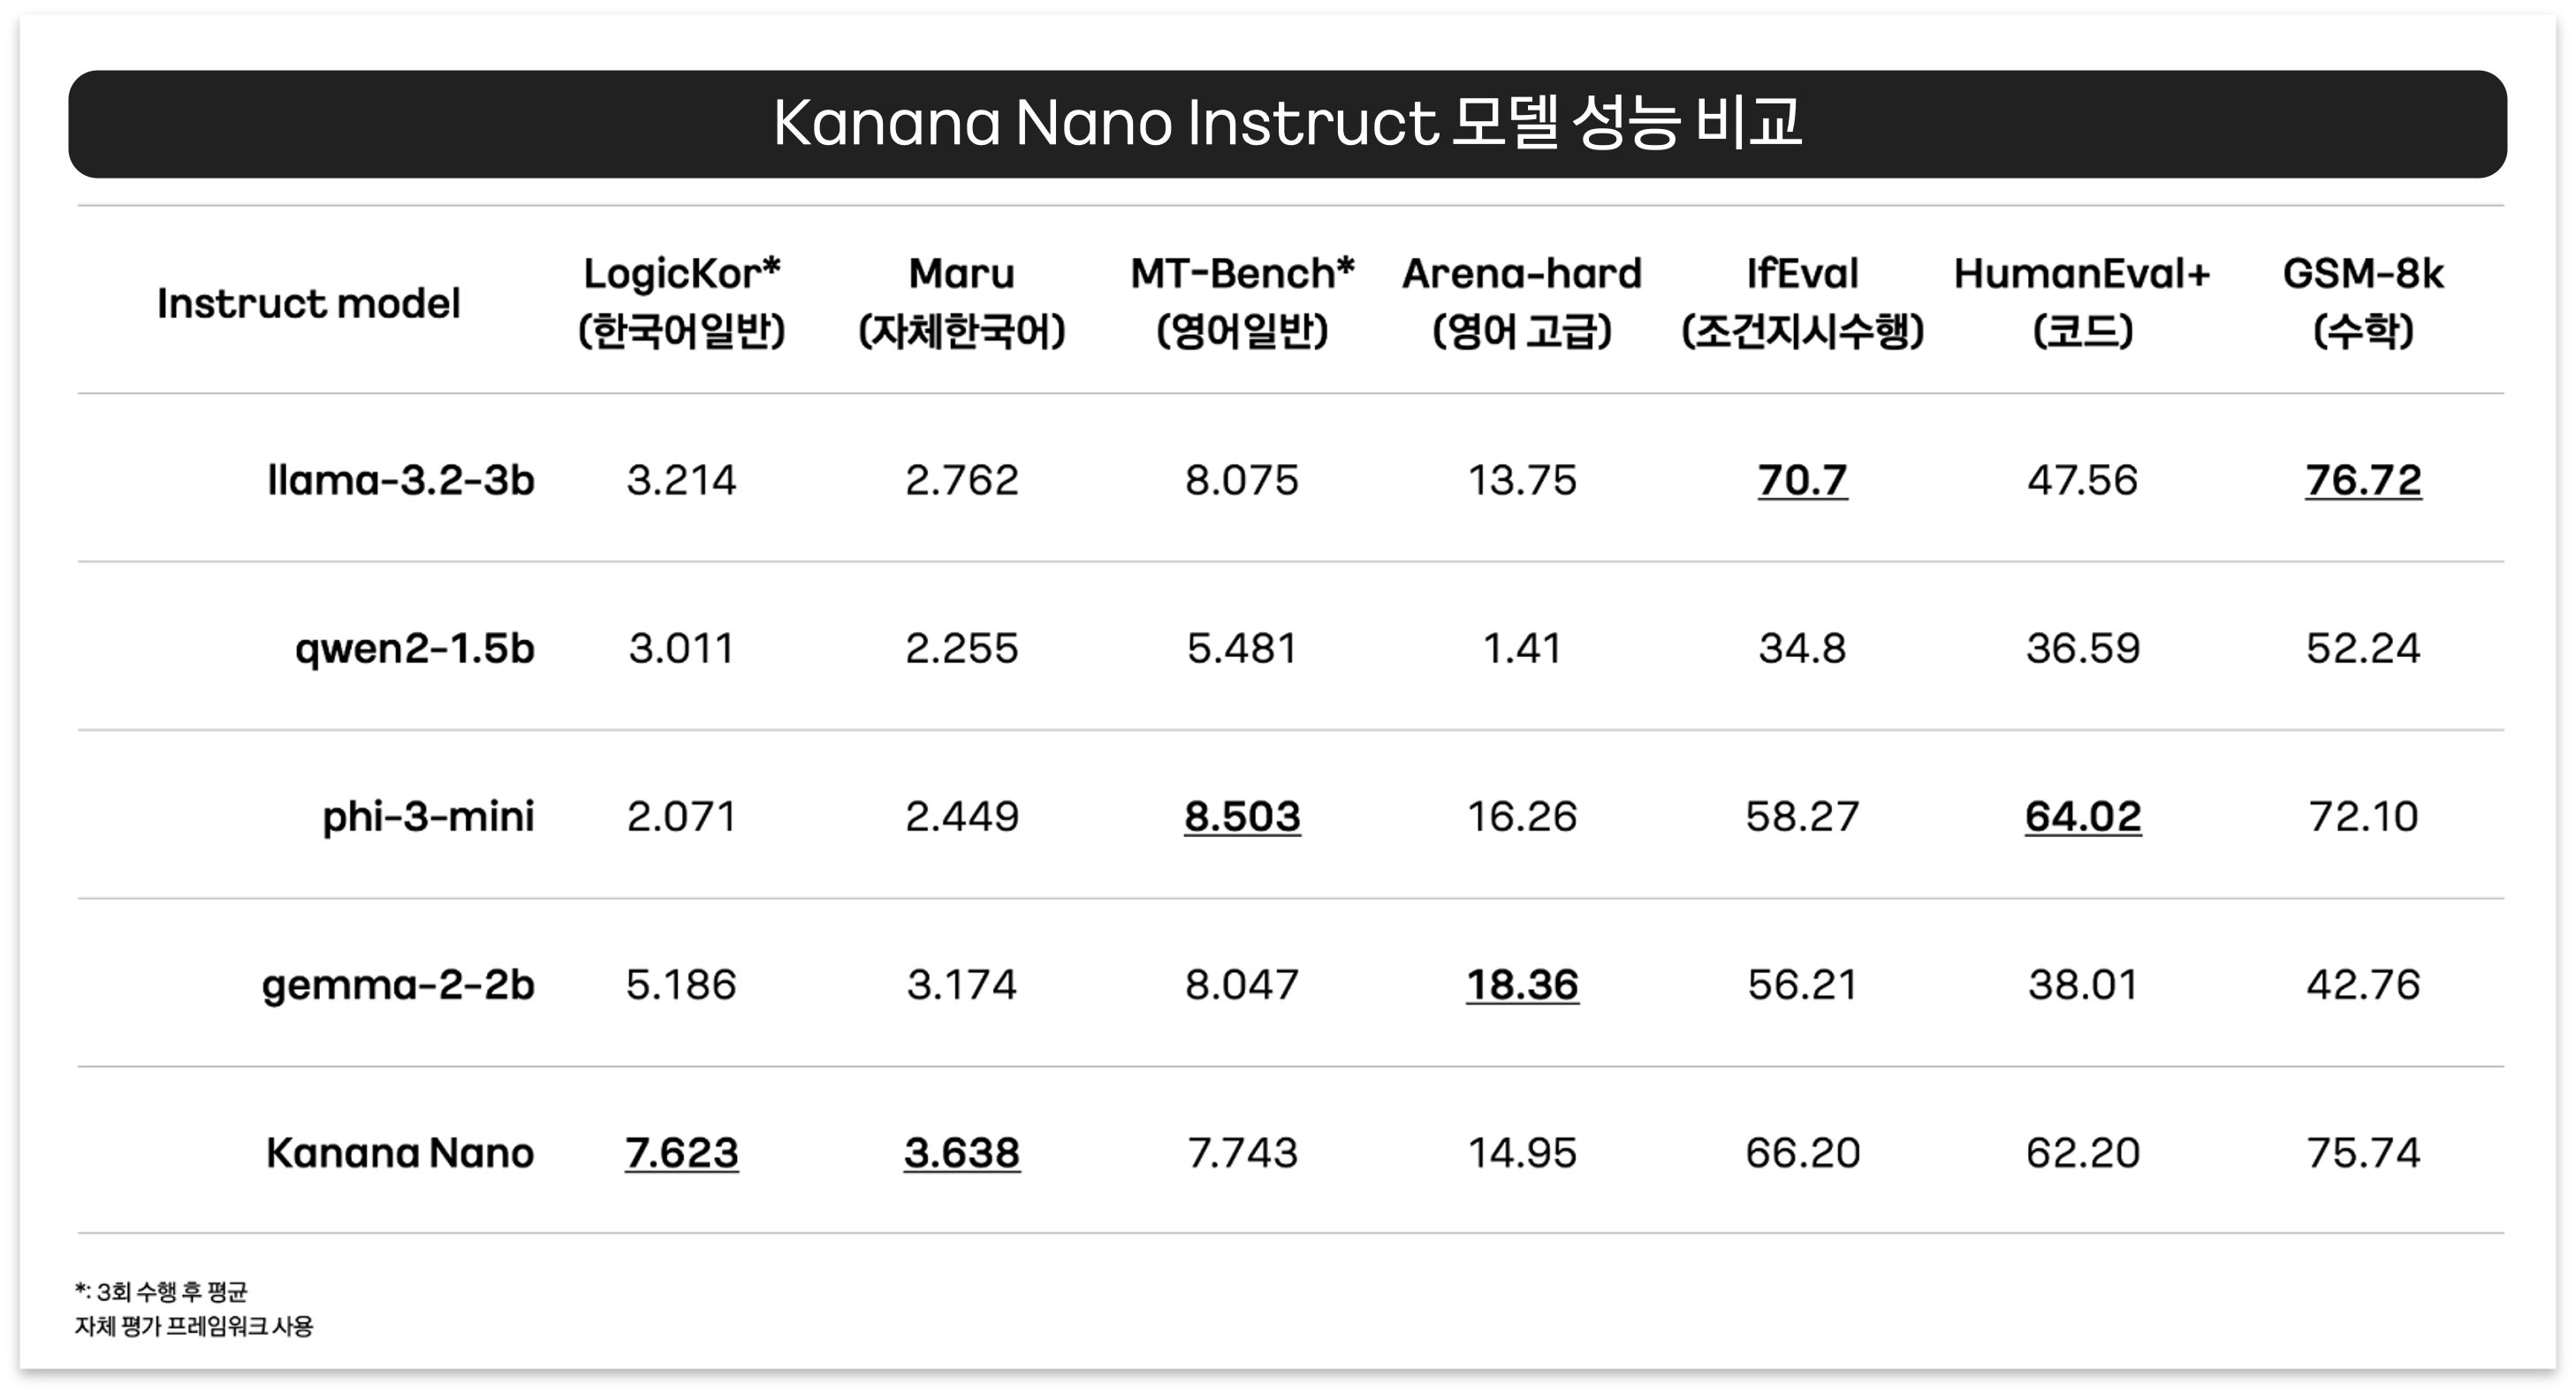
더 작은 스케일의 모델인 Kanana Nano Instruct의 경우에도 Essence 모델의 결과와 전반적으로 비슷한 경향을 가짐을 <표 2>를 통해 확인할 수 있습니다. 한 가지 흥미로운 점은 Nano 모델의 경우 타 모델과 한국어 성능의 차이가 Essence 모델의 성능 비교보다 더 커진다는 것입니다. 일반적으로 모델 사이즈가 작아질수록 다국어 성능, 정확히는 다른 종류의 언어 데이터를 소량만 보고도 잘 일반화(Generalization)할 수 있는 능력이 떨어지기 때문에, 상대적으로 좋은 퀄리티의 한국어 데이터가 많이 학습된 Kanana 모델이 확연하게 다른 모델 대비 한국어 성능이 좋은 부분을 확인할 수 있습니다. 이는 비용 감소를 위해 점점 소형 모델의 중요성이 강조되는 현재 경향성에 빗대어 볼 때, 독립적으로 데이터를 확보하고 학습한 자체 모델의 필요성을 이야기해 주기도 합니다.
5. 마치며
본 글에서는 카나나 언어모델의 Post-training 수행 과정 및 주요 결과를 살펴보았습니다. 카카오는 이처럼 글로벌 경쟁력을 갖춘 모델을 바탕으로, 개별 태스크에 특화된 전용 모델을 개발하고 있습니다. RAG, Function calling 및 요약 등 태스크에 특화된 전용 모델을 개발해 각 서비스에 최적화된 모델 구조를 구축해 서비스 적용을 확대해 나가고 있습니다. 효율적인 고성능 모델을 통해 더 큰 사이즈의 모델로만 가능하던 태스크를 더 작은 모델에서 보다 빠르게 유사한 성능을 발휘하도록 합니다. 앞으로도 카카오는 서비스에 최적화된 고성능 모델을 지속 개발해 나갈 계획입니다.
참고로 이번 블로그에서 다루지 않은 Post-training의 성능 개선을 위한 다양한 시도 속에서 얻었던 주요 교훈점은 아래 발표영상을 통해 소개하고 있습니다. 글을 읽는 모든 분들에게 작게나마 도움이 되었길 바라봅니다. 감사합니다.
Contributions
Kanana ⍺ 조직의 chloe.py (함지연), daniel.rl (남원태), kevin.nlp (고현웅), khel.2h (김현호), kloud.off (온경운), louie.m (이창민), sean.ai (정승재)가 기여해 주셨습니다.
Acknowledgements
전체 내용에 대한 검수를 맡아주신 Kanana ⍺ 조직의 loophy.cc (조정민)님께 감사의 말을 전합니다.
관련 글 목록
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다
- 밑바닥부터 Kanana-LLM 개발하기: Pre-training
- 밑바닥부터 Kanana-LLM 개발하기: Post-training
- 나만의 프로필 이미지 생성 모델 개발기
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
- 작지만 강한 Kanana Nano 효율적으로 개발하기
참고문헌
[1] Dubey, Abhimanyu, et al. “The llama 3 herd of models.” arXiv preprint arXiv:2407.21783 (2024).
[2] Dong, Guanting, et al. “Self-play with Execution Feedback: Improving Instruction-following Capabilities of Large Language Models.” arXiv preprint arXiv:2406.13542 (2024).
[3] Rafailov, Rafael, et al. “Direct preference optimization: Your language model is secretly a reward model.” Advances in Neural Information Processing Systems 36 (2024).
[4] Wortsman, Mitchell, et al. “Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time.” International conference on machine learning. PMLR, 2022.
[5] https://github.com/instructkr/LogicKor
[6] Zheng, Lianmin, et al. “Judging llm-as-a-judge with mt-bench and chatbot arena.” Advances in Neural Information Processing Systems 36 (2023): 46595-46623.
[7] Li, Tianle, et al. “From live data to high-quality benchmarks: The arena-hard pipeline, April 2024.” URL https://lmsys.org/blog/2024-04-19-arena-hard (2024).
[8] Zhou, Jeffrey, et al. “Instruction-following evaluation for large language models.” arXiv preprint arXiv:2311.07911 (2023).
[9] Liu, Jiawei, et al. “Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation.” Advances in Neural Information Processing Systems 36 (2024).
[10] Cobbe, Karl, et al. “Training verifiers to solve math word problems.” arXiv preprint arXiv:2110.14168 (2021).
[11] Yang, An, et al. “Qwen2 technical report.” arXiv preprint arXiv:2407.10671 (2024).
[12] Abdin, Marah, et al. “Phi-3 technical report: A highly capable language model locally on your phone.” arXiv preprint arXiv:2404.14219 (2024).
[13] Jiang, Albert Q., et al. “Mistral 7B.” arXiv preprint arXiv:2310.06825 (2023).
[14] Team, Gemma, et al. “Gemma 2: Improving open language models at a practical size.” arXiv preprint arXiv:2408.00118 (2024).