Frontend
자바스크립트 엔진의 최적화 기법 (1) - JITC, Adaptive Compilation
2016년 4월 18일
원문에서 보기 ↗자바스크립트 엔진의 최적화 기법 (1) - JITC, Adaptive Compilation
목 차
- 들어가며
- Just-in-Time Compilation (JITC)
- JavaScript에서는 JITC보다 interpreter가 더 낫다?
- Adaptive JIT Compilation
- 결론
1. 들어가며
신입 개발자 교육 시간에 누군가 질문을 했습니다. JavaScript 코드를 구현할 때 성능을 고려하여 피해야 할 코딩 스타일이 있는지에 대한 질문이었습니다. 저는 대학원에 있는 동안 JavaScript 엔진을 주로 연구했었는데 JavaScript로 프로그램을 직접 짜 본 적은 거의 없었습니다.그러나 JavaScript 엔진이 어떤 방식으로 동작하는지 그 내부 구조를 알기 때문에 몇 가지 떠오르는 아이디어가 있었습니다.
제 나름대로 알고 있는 사실들을 정리하고 다른 사람들과 공유도 할 겸 앞으로 JavaScript 엔진 내부에 관한 포스팅을 올려 볼까 합니다. 단순히 동작 방식만 설명하면 재미없으니, 엔진의 입장에서 좋은 코드란 어떤 것인지에 초점을 맞추어 한 가지씩 답을 찾아보겠습니다. 제가 엔진에 대한 모든 것을 다 아는 것은 아니기 때문에 이렇게 쓰는 글들이 JavaScript 개발을 하는 데 있어서 큰 도움이 되진 않을 테지만 심심하거나 따분할 때 재미 삼아 읽어보면 좋을 내용 정도로 생각해주시면 좋겠습니다.
오늘은 최근 대부분의 JavaScript 엔진에서 사용하는 방식인 Just-in-Time compilation 방식과 Adaptive compilation에 대해 소개하겠습니다.
2. Just-in-Time Compilation (JITC)
현재 많이 쓰이고 있는 JavaScript 엔진(Safari, Chrome, FireFox 등)은 모두 JITC 방식을 사용합니다. JavaScript 엔진은 interpreter 방식으로 동작한다고 많은 분들이 알고 계시는데, 초기 버전의 JavaScriptCore (WebKit의 JS 엔진, Safari browser에 포함)나 V8 (Chrome)는 수행되는 모든 JavaScript 코드를 바로(just-in-time) native code로 컴파일하는 방식이었습니다.
JavaScript JITC는 보통 아래 그림과 같은 방식으로 수행됩니다.
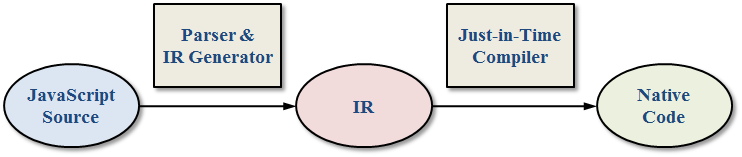 JavaScript는 기본적으로 text 형태로 배포되기 때문에 이를 수행하기 위해서는 일단 변환이 필요합니다. 처음에 source code를 parsing하여 중간 언어(IR, intermediate representation)인 bytecode 형태로 먼저 변환합니다. 그런 다음 interpreter 모드라면 bytecode를 하나씩 읽어가며 동작을 수행하고, JIT 모드라면 생성된 bytecode를 기반으로 native code로 컴파일 하여 수행하게 됩니다. 원래 JITC는 Java VM에서 많이 사용되던 방식인데, Java는 보통 bytecode 형태인 .class 파일로 배포되기 때문에 parsing 과정이 생략됩니다.
당연히 interpreter로 수행하는 것보다 native code로 수행하는 것이 빠르겠지만, JITC의 경우에는 그렇지 않습니다. GCC와 같은 static compiler라면 native code를 생성하는 도중에 많은 최적화 알고리즘들을 적용하기 때문에 생성되는 코드의 성능이 좋지만(이를 보통 code quality가 높다고 표현합니다), JITC는 컴파일 과정 자체가 수행 중에 발생하기 때문에 이것이 overhead가 되고, 따라서 컴파일에 많은 시간을 쓸 수가 없습니다. 그러므로 코드 전체를 훑어서 최적화하는 방식(data flow analysis가 필요한 최적화들)은 꿈도 못 꾸고, 보통 아주 최소한의 최적화만 적용하여 native code를 생성하게 됩니다.
그럼에도 불구하고 interpreter 수행 시간보다 native code의 수행 성능이 월등히 낫기 때문에 JITC에 overhead가 포함되더라도 interpreter보다 빠르게 수행하므로 Java VM에서는 JITC를 많이 사용합니다. 그런데...
3. JavaScript에서는 JITC보다 interpreter가 더 낫다?
JavaScript JITC가 최소한의 최적화를 적용한다는 점 외에도 두 가지 문제가 더 있습니다.
JavaScript는 잘 알려진 대로 변수의 타입이 수행 도중 달라질 수 있고, class 대신 object로 상속되는 prototype-based 방식을 사용하는 등 매우 동적인 언어이기 때문에 JavaScript JIT compiler는 모든 예외적인 케이스를 다 고려하여 코드를 생성해야 합니다. 단순한 변수 두 개를 더하는 덧셈 같은 경우에도 예외 케이스를 다 고려하면 아래 그림과 같이 많은 양의 native code가 생성됩니다. (ARM) 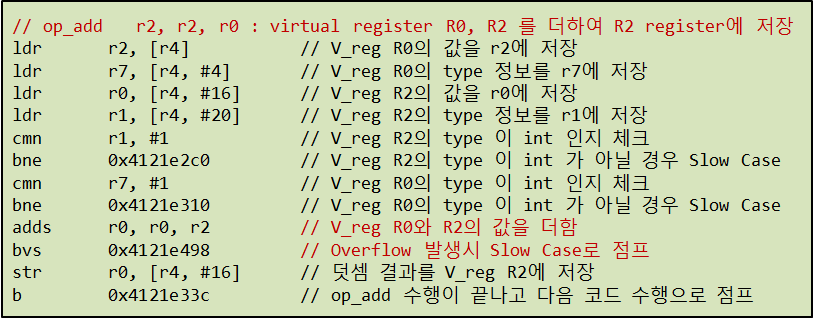 만약 덧셈의 두 operand가 모두 int형(JavaScript는 타입이 없는 대신 엔진 내부적으로 타입을 가지고 있습니다)이라면 그냥 더해서 변수 값에 저장하면 되지만, 덧셈의 operand 둘 중 하나라도 int형이 아니거나, 혹은 더하고 보니 integer 범위를 벗어나는 등 예외 케이스가 발생하게 되면 __slow case__로 건너뛰게 됩니다. Slow case는 native code로 생성하기 어려운 (정확히는 native code로 표현하면 양이 많아지는) 동작들을 native code로 뽑아내는 대신 미리 엔진 내부에 C로 구현된 function(helper function)을 호출하여 동작을 수행하는 경우를 말합니다. 만약 덧셈에서 int+int, string+string, string+int 이런 케이스를 모두 native code로 뽑아낸다면 단순한 덧셈을 위해 엄청나게 많은 native code가 필요하게 되므로 helper function을 호출하게 됩니다.
그런데 이런 helper function은 interpreter 모드로 수행할 때와 똑같은 코드를 사용하게 됩니다! 즉 JIT compiler로 native code를 수행한다 해도, 많은 부분은 interpreter와 별반 차이가 없게 되는 것입니다. 게다가 심지어는 compilation overhead 가 더해지게 되므로 JavaScript JITC는 Java에서보다 훨씬 비효율적입니다.
또 다른 문제는 JavaScript로 구현된 프로그램들의 코드 특성이 Java와는 많이 다르다는 점입니다. Java는 연산이 많은(compute-intensive) 프로그램들이 많은 반면에, JavaScript는 주로 web page의 layout을 건드리거나, 사용자 입력에 반응하는 방식의 프로그램이 많습니다. 두 가지의 가장 큰 차이점은 __자주 반복돼서 수행되는 구간(hotspot)__이 얼마나 많은가 인데, JavaScript는 상대적으로 hotspot이 매우 적습니다. 즉, loop이 적고 한 두번만 수행되는 코드가 대부분이라는 점입니다. (물론 HTML5로 들어오면서 compute-intensive한 프로그램도 많아졌습니다) Hotspot이 적어지게 되면 native code를 수행하는 시간에 비해 그 native code를 만드는 시간, 즉 compile overhead가 상대적으로 커지게 되는 문제가 있습니다. 결과적으로 compilation overhead + native 가 interpreter 의 수행시간 보다 짧을 것이라는 JITC의 가정이 깨지게 됩니다. 이러한 맥락에서 application들의 특성을 비교하여 JavaScript JITC이 성능 향상에 기여하는 바가 거의 없다는 연구도 진행된 바 있습니다.
참고자료
An Analysis of the Dynamic Behavior of JavaScript Programs, PLDI 2010 JSMeter: Comparing Real-World Behavior of JavaScript Programs, USENIX 2010
결국 hotspot이 별로 없는 JavaScript는 interpreter로 수행하는 것이 낫습니다. 그런데 최근에는 꼭 그렇다고 말하기가 어려워졌습니다. JavaScript가 단순히 web에서 event 처리 용도로만 사용되는 것이 아니라 비즈니스 로직에도 어느 정도 관여를 할 만큼 많은 일들을 수행하도록 요구되며 점차 compute-intensive한 프로그램 역시도 충분히 구현되기 때문에 JITC를 완전히 버릴 수는 없는 것이지요.
그렇다면 고전적인 방식의 JavaScript 코드와 compute-intensive 코드들의 수행 성능을 모두 만족시키는 방법은 무엇일까요?
4. Adaptive JIT Compilation
그래서 최근 JavaScript 엔진들은 대부분 adaptive compilation 방식을 택하고 있습니다. Adaptive compilation이란, 모든 코드를 일괄적으로 같은 수준의 최적화를 적용하는 것이 아니라, 반복 수행되는 정도에 따라 유동적으로(adaptive) 서로 다른 최적화 수준을 적용하는 방식입니다.
기본적으로 모든 코드는 처음에 interpreter로 수행합니다. 그러다가 자주 반복되는 부분(hotspot)이 발견되면, 그 부분에 대해서만 JITC를 적용하여 native code로 수행합니다. 최근의 엔진들은 JITC도 여러 단계로 나누어서 적용합니다. 처음에는 최소한의 최적화만 적용하는 JITC (baseline-JITC)로 컴파일 하여 수행하다가, 여기서 더 자주 반복된다 싶은 코드에는 더 많은 최적화를 적용하는 JITC(Optimizing-JITC)로 컴파일 하여 code quality가 높은 코드를 생성하게 됩니다.
아래는 Chrome V8 엔진의 adaptive JITC인 crankshaft의 동작 방식을 간단히 나타낸 것입니다. 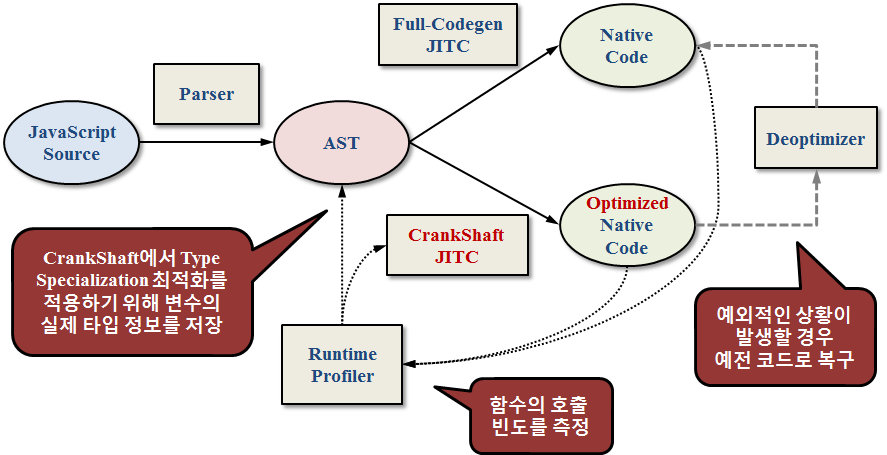 (Crankshaft는 interpreter가 없고 baseline JITC부터 시작합니다)
공통적으로 adaptive JITC를 사용하는 엔진은 runtime profiler가 있어서 함수의 수행 빈도를 기록하게 됩니다. 뿐만 아니라 profiler는 사용되는 변수들의 타입이나 값을 profile해 두었다가 optimizing JIT을 적용할 때 이들 정보를 이용하여 예전 JITC에서 생성했던 예외 처리 루틴들을 대폭 생략한 효율적인 코드를 생성합니다.
다만 이렇게 코드를 생성할 경우에 예외적인 상황이 발생할 수 있는데, 예를 들어 loop를 100만번 수행하는 동안 x라는 변수가 계속 integer였다가, 그 다음 iteration에서 갑자기 string으로 바뀌어 버린다거나 하는 경우입니다. 이런 경우에는 optimizing JITC로 생성된 코드는 더 이상 유효하지 않기 때문에 다시 예전 baseline-JITC로 생성한 코드로 수행하게 됩니다. 이렇듯 예외 상황이 발생하면 overhead가 엄청나게 커 지지만, 'profiling을 수행하는 동안 특정 변수의 타입이 변하지 않았다면 그 이후에도 그 변수는 타입이 변하지 않을 가능성이 매우 높을 것이다' 라는 가정을 바탕에 둔 최적화입니다.
실제로 JavaScript 엔진에서 수행하는 많은 최적화들 (hidden class, inline caching 등)은 이러한 방식으로 최적화를 많이 수행하는데, 변수의 타입이나 object property가 바뀌는 등 동적인 상황이 발생할 수 있지만, __실제로는 동적인 변화가 자주 일어나지 않을 것__이라고 가정합니다. 따라서 동적인 변화가 발생했을 때 페널티는 크더라도, 변화하지 않았을 때 큰 성능 이득을 볼 수 있는 최적화들을 적용합니다. 이런 대표적인 최적화로 대부분의 JavaScript JITC에서 사용하고 있는 hidden class나 inline caching을 들 수 있는데, 실제로 이러한 최적화가 엄청난 효과가 있습니다. 이들 최적화에 관해서는 2부에 이어서 이야기 하겠습니다.
5. 결론
지금까지의 내용을 요약하면 다음과 같습니다. •Hotspot이 별로 없는 고전적인 JavaScript 프로그램들에는 interpreter가 JITC보다 효율이 좋다. •최근 많이 사용되는 compute-intensive한 JavaScript 프로그램들에는 JITC가 좋다. •두 가지 성향의 코드에 대한 성능을 모두 만족하기 위해 최근 엔진들은 adaptive JITC를 채용한다. •Adaptive JITC는 type profiling을 수행하므로, 변수의 type이 변하지 않는다면 높은 성능을 얻을 수 있다.
마지막 항목은 바꿔 말하면, 자주 반복되는 loop 안에서 수행 도중 변수의 type이 변하게 되면 많은 페널티가 발생하게 된다는 것입니다. 실제로 코드를 구현할 때 그런 상황은 거의 없겠지만, 알아두면 언제든 유용할 것입니다.
JavaScript 엔진을 연구하는 사람들은 그 놈의 dynamic typing 때문에 많은 고생을 합니다. 위에서 설명한 Adaptive JITC에서의 type profiling 뿐만 아니라, 미리 type을 유추하는 type inferencing 기법, 변수 선언 시 type을 명시적으로 annotation하여 엔진에서 고정된 type으로 변수를 활용하게 하는 asm.js 등 dynamic typing language라는 성능 최적화의 가장 큰 벽을 뛰어넘기 위한 연구가 가장 활발히 이루어지고 있습니다.
만약 성능이 좋은 JavaScript 코드를 만들고 싶다면, JavaScript 코드를 작성할 때 마치 C나 Java처럼 static typing 언어라고 생각하세요.
특히 array가 중요한데, 하나의 array에는 하나의 type만 넣어주는 것이 최고입니다!