Engineering
Log Aggregation의 진화: 카카오의 Fluentd 대체기
hardy.jwc카카오
2024년 12월 4일
원문에서 보기 ↗카카오는 내부 로그 수집 시스템으로 kemi-log를 운영하고 있습니다. kemi-log는 여러 가지 오픈 소스를 이용하여 구축되었으며, 특히 Fluentd를 메인 컴포넌트로 활용하여 수년간 운영해온 플랫폼입니다. 이 글에서는 Fluentd를 대체하기 위한 마이그레이션 프로젝트를 소개하고자 합니다. 구체적으로는 이러한 프로젝트를 진행하게 된 배경과 개발 과정, 그리고 실제 도입 후 달성한 성과에 대해 설명하고자 합니다.
kemi-log 현황
kemi-log는 현재는 발전하여 아래와 같은 구조를 가지고 있습니다.
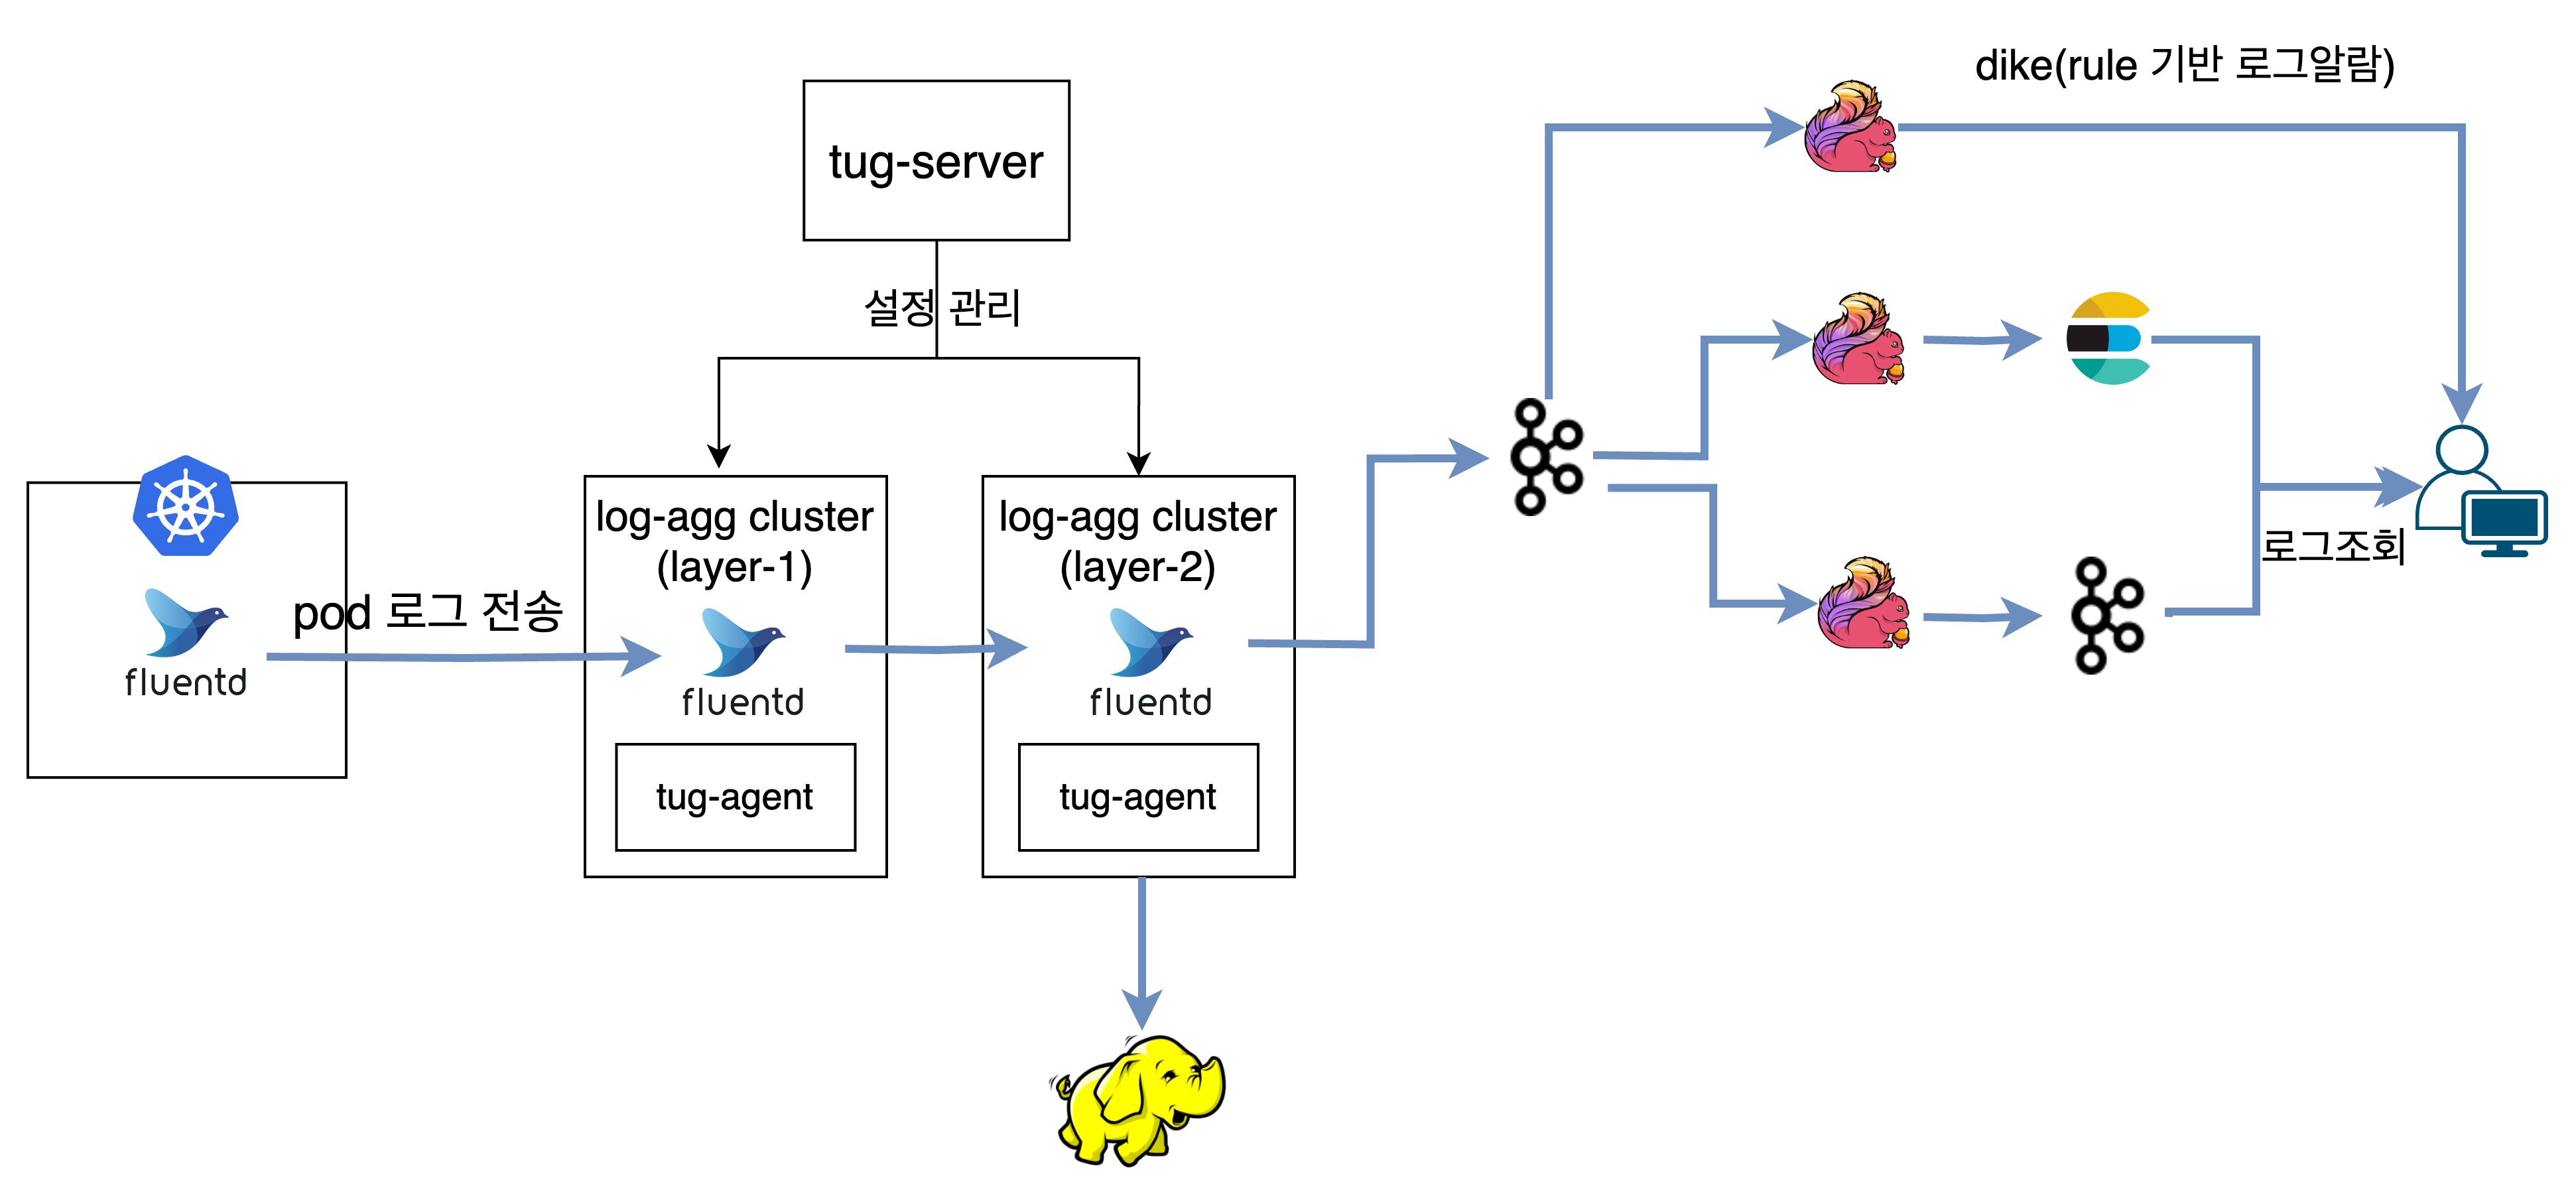
2개 레이어로 구성된 시스템 아키텍처의 log aggregator 영역은 2개의 레이어로 분리되어 있습니다. 1 layer는 사용자로부터 직접 로그 데이터를 수신하게 되고 2 layer는 1 layer로부터 데이터를 넘겨받아 각각의 스토리지로 데이터를 전송하는 역할을 맡고 있습니다.
2개의 layer로 분리하게 된 이유는 스토리지 쪽으로 데이터를 보내는 기능이 시스템 자원을 많이 차지하고 운영상 이슈가 발생하는 경우가 있기 때문이었습니다. aggregator가 하나라면 특정 스토리지 전송 쪽 이슈가 발생했을 때 모든 aggregator가 영향을 받게 됩니다. 그래서 2개의 layer로 분리해서 1 layer에서는 일단 로그를 받아서 버퍼링을 하고 있고 2 layer를 통해서 받은 로그를 스토리지에 저장하도록 하고 있습니다. 2 layer도 스토리지 별로 여러 개로 그룹핑되어 있습니다. 특정 서비스의 로그 트래픽이 많은 경우 분리해서 관리하기 위한 용도와 스토리지 쪽 장애가 발생했을 때 그 때문에 다른 스토리지로의 적재에 영향을 미치지 않도록 하기 위해서 구분하는 용도입니다.
운영 관리 시스템 tug
Fluentd는 설정을 파일로 기록하고 관리합니다. 신규 로그 데이터를 받거나 기존의 설정을 변경하려면 설정 파일을 변경하고 업데이트해야 합니다. 이런 설정 작업이 자주 있습니다. 운영 초기에는 Ansible을 통해서 이런 변경사항을 반영하고 Fluentd를 재시작했었습니다. 운영경험이 쌓여 나가면서 작업 실수를 줄이기 위해서 여러 대의 Fluentd를 모아서 클러스터화 하고 그걸 통합해서 관리할 수 있는 tug라는 시스템을 만들어서 사용했습니다.
tug는 중앙에서 전체 Fluentd들을 관리하는 역할을 하는 tug-server와 Fluentd와 같은 서버에 있으면서 tug-server로부터 Fluentd 설정을 받아서 반영하는 tug-agent로 구성되어 있습니다.
직접 tug라는 Fluentd 설정 관리 시스템을 만들고, 필요한 경우는 오픈 소스인 Fluentd에 코드 기여를 하면서 운영해 왔지만 Fluentd의 구조상 한계에 부딪히게 되었습니다.
Logriver 개발 결정
Fluentd의 구조적 한계를 극복하기 위해 대체 Logriver라는 새로운 로그수집기를 자체 개발하게 되었습니다.
Fluentd의 대안을 생각하면서 그동안 새롭게 나온 여러 가지 오픈 소스들을 대안으로 생각해 보았습니다. 하지만 이미 사내에서는 Fluentd를 통한 로그 수집이 표준화되어 있었기 때문에 카카오 내부의 수만 대의 서버에 Fluentd가 설치되어 동작 중이었습니다. 이러한 Fluentd를 모두 동시에 변경하는 작업은 현실적으로 불가능하다고 판단했습니다. 마침. Fluentd는 통신 프로토콜이 공개되어 있기 때문에 Fluentd와 동일한 프로토콜로 데이터를 받을 수 있으면서 그동안의 운영상의 여러 이슈를 해결할 수 있는 시스템을 직접 개발하는 게 좋겠다고 생각하게 되었습니다.
엔터프라이즈급 관리 기능 필요성
또한 현재 나와 있는 로그 수집용 오픈 소스 중에서 대규모의 클러스터를 관리할 수 있는 기능을 제공해 주는 것은 찾기 어려웠습니다. 대규모 시스템을 운영해야 했고, 그렇다면 어떤 오픈 소스를 도입하던 결국 tug 같은 운영시스템이 추가로 필요해질 거라고 생각했습니다.
그래서 중앙에서 컨트롤할 수 있는 구조를 가진 로그수집 시스템을 처음부터 새로 만들게 되었습니다. 이 시스템은 Logriver라는 이름을 가지고 있고 현재 Fluentd의 역할을 대체해 나가고 있습니다.
Logriver 개발기
무중단 설정 변경을 위한 Dynamic 설정 구현
Logriver는 실제 로그를 처리하는 에이전트(agent)와 중앙에서 여러 에이전트들을 그룹화해서 관리하는 컨트롤러(controller)로 나뉘어 있습니다. 에이전트의 설정을 변경하려면 기존처럼 각각의 에이전트의 설정을 일일이 변경하고 재시작하는 방식이 아니라 컨트롤러에서 설정을 변경하고 대상 에이전트들에 적용하는 방식으로 동작합니다.
기존에 Fluentd에서는 설정을 변경 후 적용하려면 일단 Fluentd 프로세스를 graceful shutdown 한 후 다시 시작했어야 합니다. 이 과정에서 처리해야 할 잔여 데이터가 많다면 재시작하는 데 많은 시간이 소요되기도 했습니다. Logriver 에이전트는 컨트롤러로부터 새로운 설정을 받아서 업데이트하고 이때 에이전트는 프로세스 재시작 없이 동적으로 설정을 변경할 수 있습니다.
우선 무중단으로 config를 재설정하기 위해서 어떻게 개발해야 할지 고민했습니다. 여러 가지 방식이 있을 수 있겠지만 go 언어의 고루틴을 활용하기로 결정했습니다. 프로세스는 재시작하지 않고, 새로운 설정을 가진 고루틴을 시작해서 트래픽을 받도록 하고, 기존 고루틴은 graceful 하게 종료하도록 했습니다. 새로 시작한 고루틴이 기존 고루틴과 동일한 포트를 이용할 수 있도록 하기 위해서 TCP 서버를 만들 때 SO_REUSEPORT 옵션을 사용하도록 했습니다. 신규 고루틴이 생성되고 트래픽을 받기 시작하면 기존 고루틴은 graceful shutdown을 시작합니다. 이렇게 해서 프로세스의 재시작이나 트래픽의 끊김 없이 새로운 설정을 적용할 수 있었습니다.
실제로 이러한 동작이 트래픽 끊김 없이 잘 동작하는지 검증하기 위해서, 개발 과정에서는 트래픽 발생기와 검증기를 직접 개발해서 사용했습니다. 단위 시간당 필요한 만큼의 로그를 생성하고 스토리지에 잘 적재되었는지를 하나씩 검증했습니다. 이때에서는 들어온 데이터를 인코딩해서 파일에 저장하고 다시 디코딩해서 스토리지로 보내는 데이터 변환 과정에서 문제가 발생해서, 이런 부분들을 집중적으로 검증했습니다.
Go 언어 사용으로 CPU 사용 효율 개선
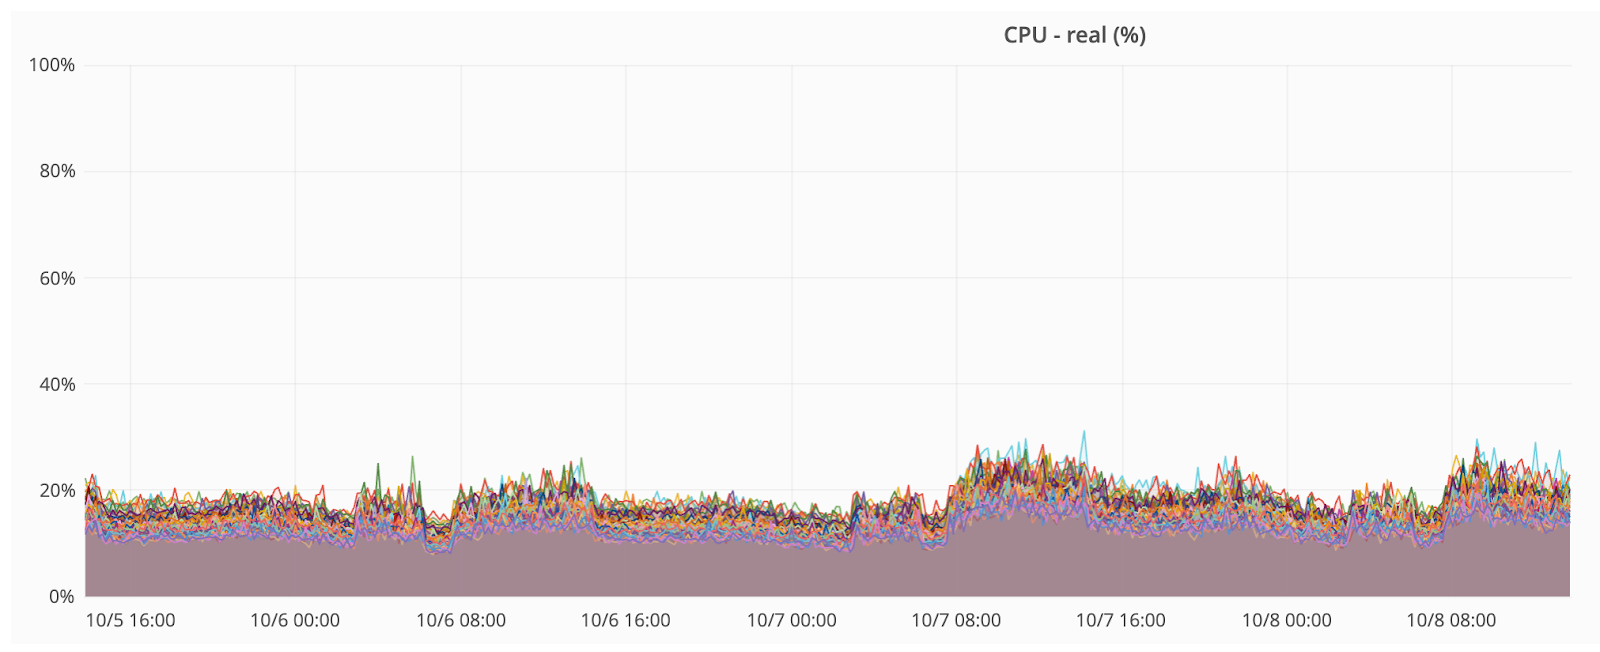
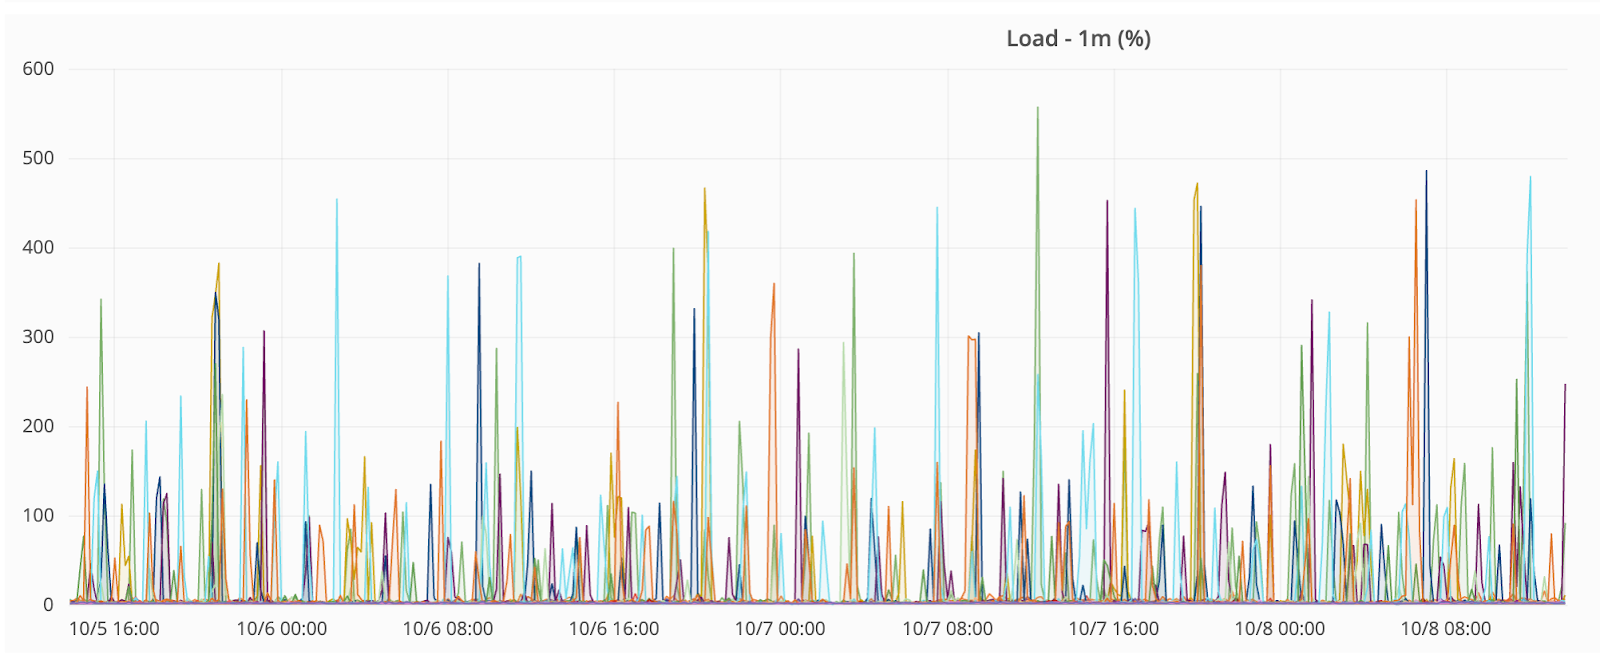
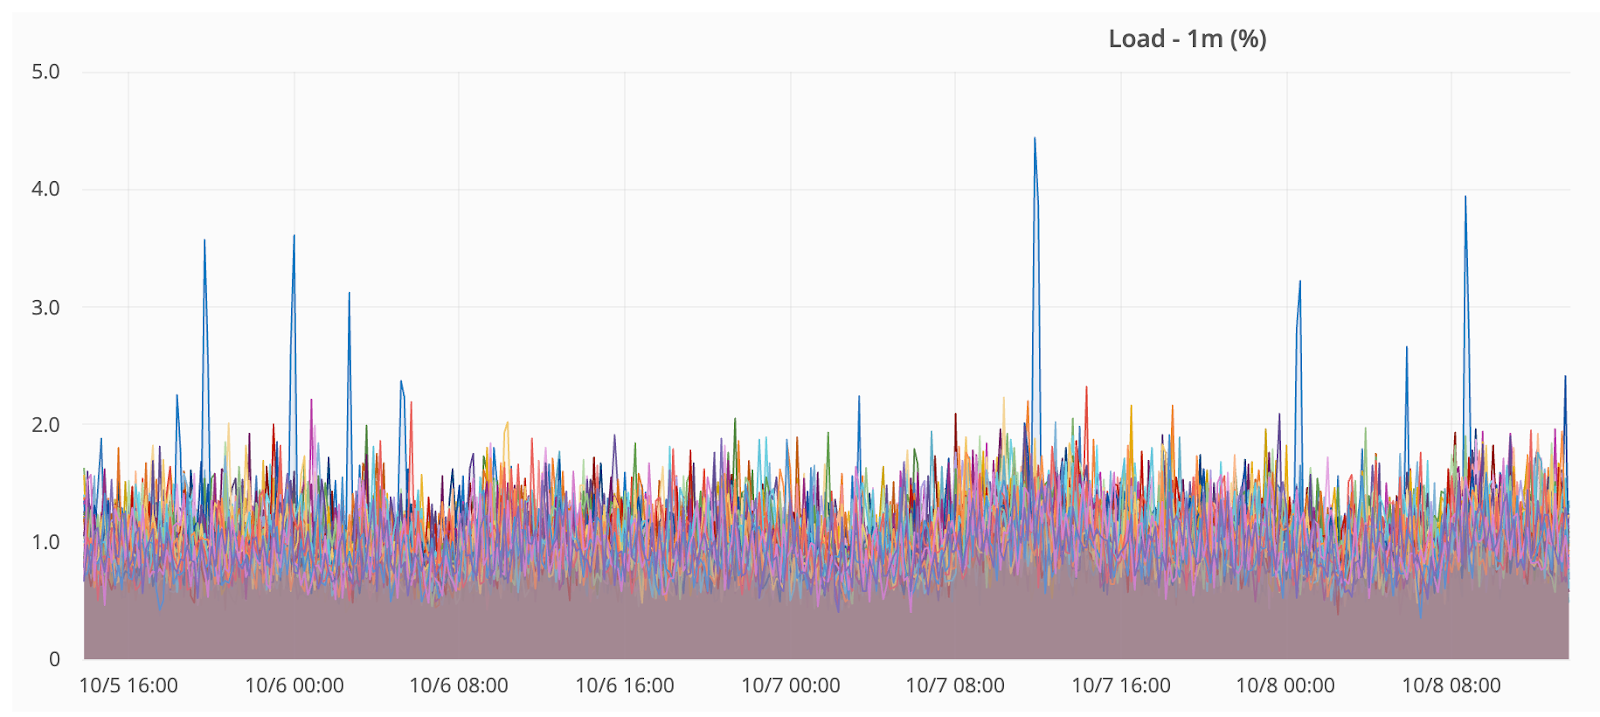
Fluentd는 루비(Ruby)로 개발됐기 때문에 멀티 코어를 잘 활용하지 못하는 이슈가 있었습니다. 루비의 프로세스는 한 번에 하나의 CPU코어만 사용할 수 있기 때문에 서버의 CPU 자원이 충분한데도 불구하고 모든 CPU를 효율적으로 사용하지 못했습니다. 그렇기 때문에 아래처럼 CPU 자원은 여유가 있지만 잘 활용하지 못하고 시스템 load가 수백이 넘게 올라가는 이슈가 있었습니다.
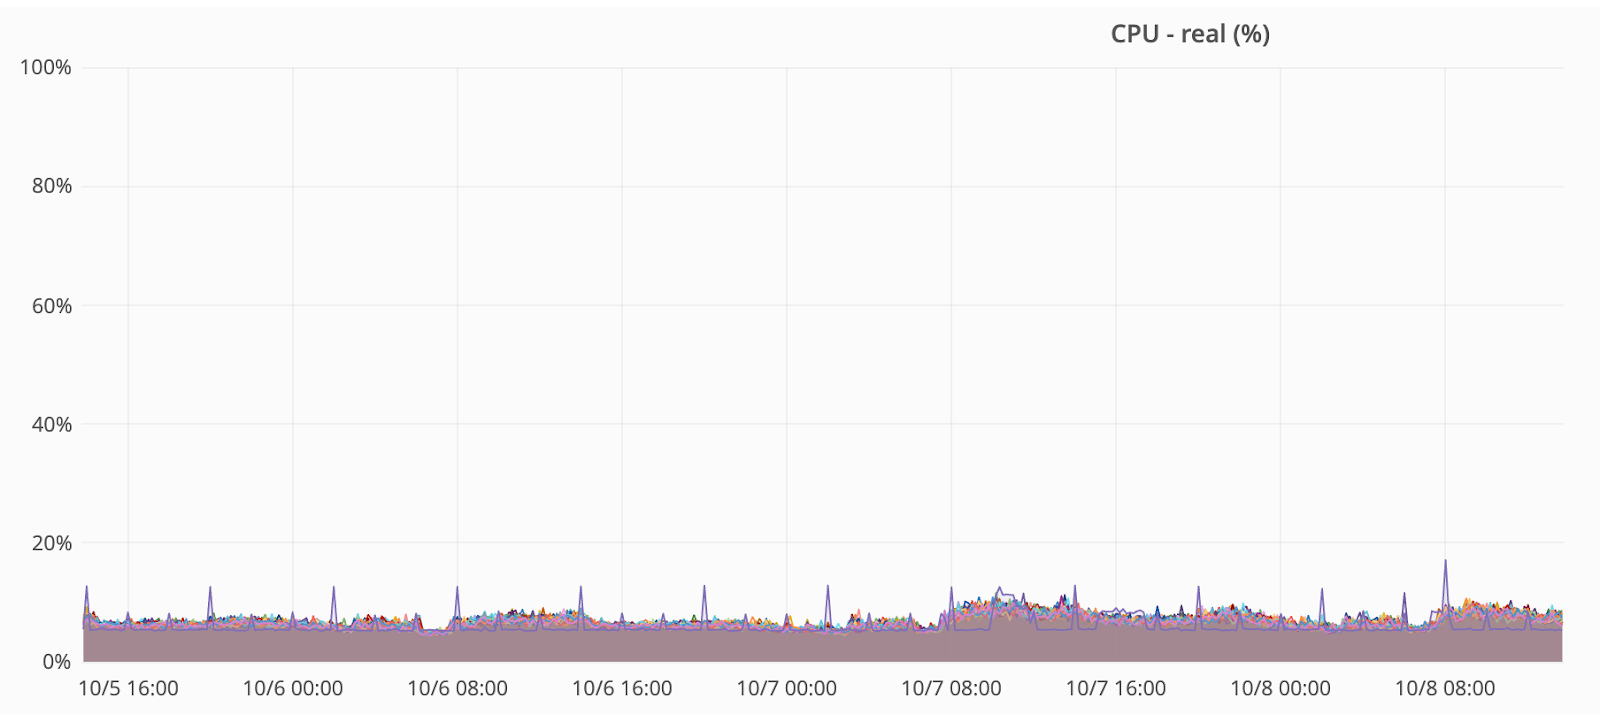
Go로 개발된 Logriver는 멀티코어 CPU 자원을 충분히 활용할 수 있어 아래처럼 안정적인 상태를 유지할 수 있습니다. 동일한 데이터를 처리하는데 CPU 사용량 자체도 작고 load도 최대치가 5를 넘지 않는 등 안정적인 모습을 보여줍니다.
그 외에 성능 튜닝은 주로 CPU, 메모리 사용량과 flame graph를 확인하면서 진행했습니다. flame graph 상에서 가장 많은 부분을 차지하는 곳은 버퍼파일을 읽고 쓸 때 데이터를 JSON으로 인코딩/디코딩하는 부분이었습니다. 그 부분을 개선하기 위해서 Go 언어의 기본 JSON 라이브러리 외에 다양한 라이브러리들의 성능을 비교했고, 카카오의 사용 방식상 가장 성능이 뛰어난 go-json을 라이브러리로 선택했습니다. 다만 go-json에서 스트림 방식으로 데이터를 디코딩할 때는 해결되지 않은 이슈가 있어서 버퍼에 데이터를 쓰는 역할에만 사용하고, 버퍼에서 데이터를 읽을 때는 Go 언어의 기본 라이브러리를 사용했습니다.
Memory 사용량 90% → 15% 대폭 감소
Fluentd의 HDFS(Hadoop Distributed File System)와 kafka plugin은 match 구문이 많아지는 경우 메모리 사용량이 상당히 커집니다. kemi-log는 카카오의 여러 서비스에서 사용하고 있기 때문에 그를 구분하기 위해 많은 match 구문이 필요했었고, 이에 따라 메모리 사용량이 늘어나는 이슈가 있었습니다. 이 현상을 해소하기 위해서 하나의 match 구문에서 여러 가지 서비스를 동시에 처리하도록 해서 메모리 사용량을 줄여서 운영해 왔습니다. 기존 match 구문을 1,000개에서 30개 정로도 줄여서 Fluentd의 워커당 메모리 사용을 30% → 3%로 줄일 수 있었습니다.
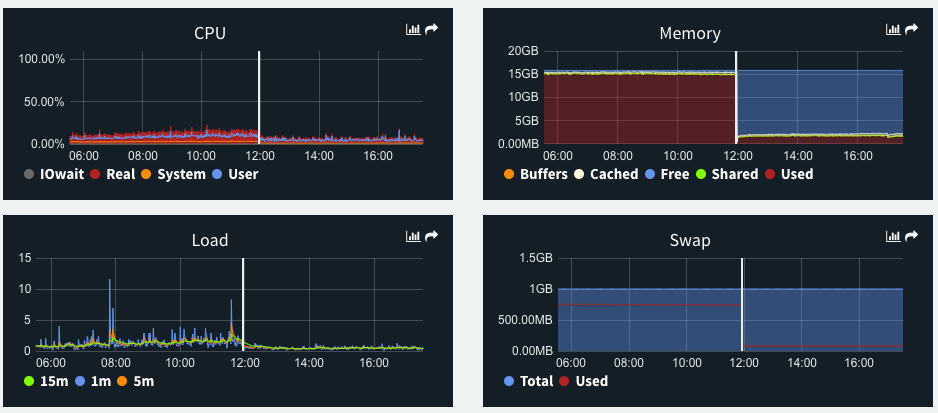
그렇게 했음에도 점점 사용량이 늘어나서 아래처럼 Fluentd가 서버의 메모리를 90% 가까이 사용하고 있었습니다.
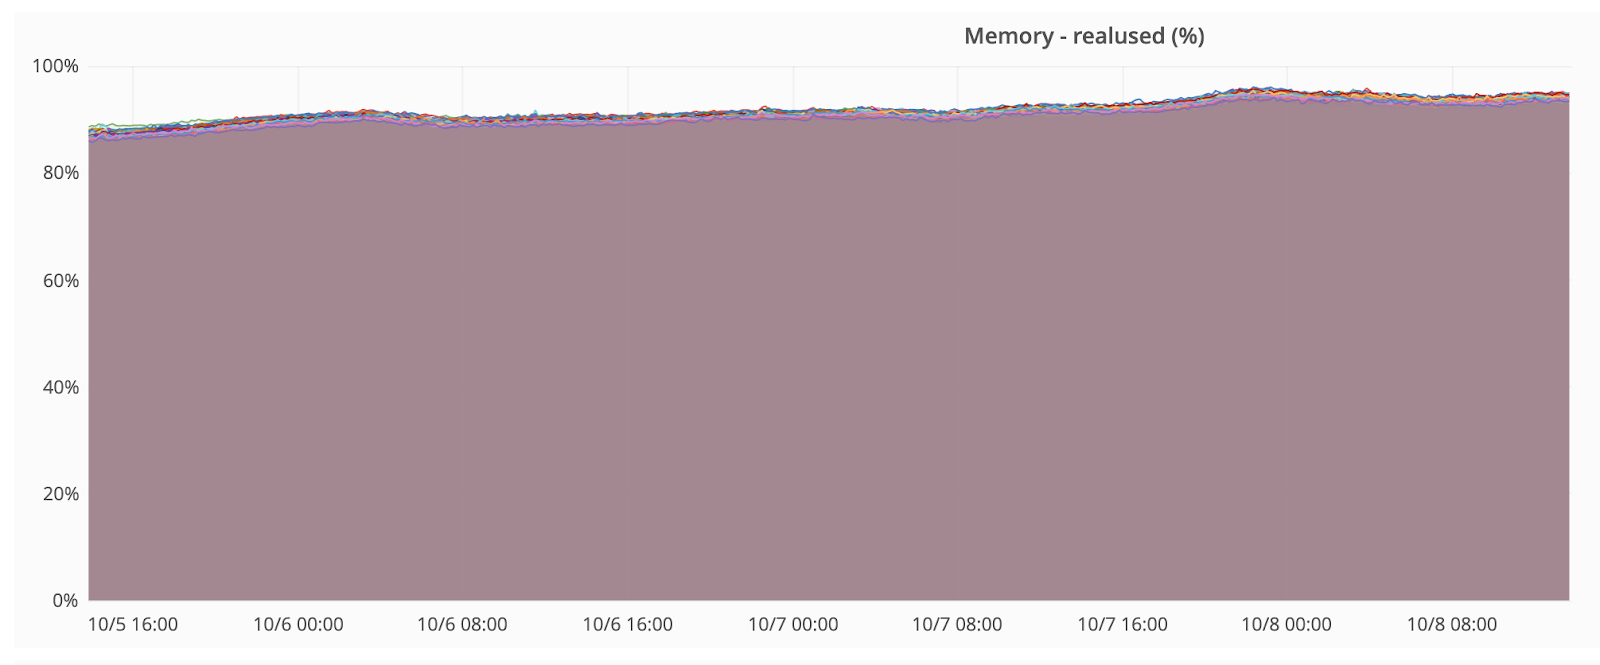
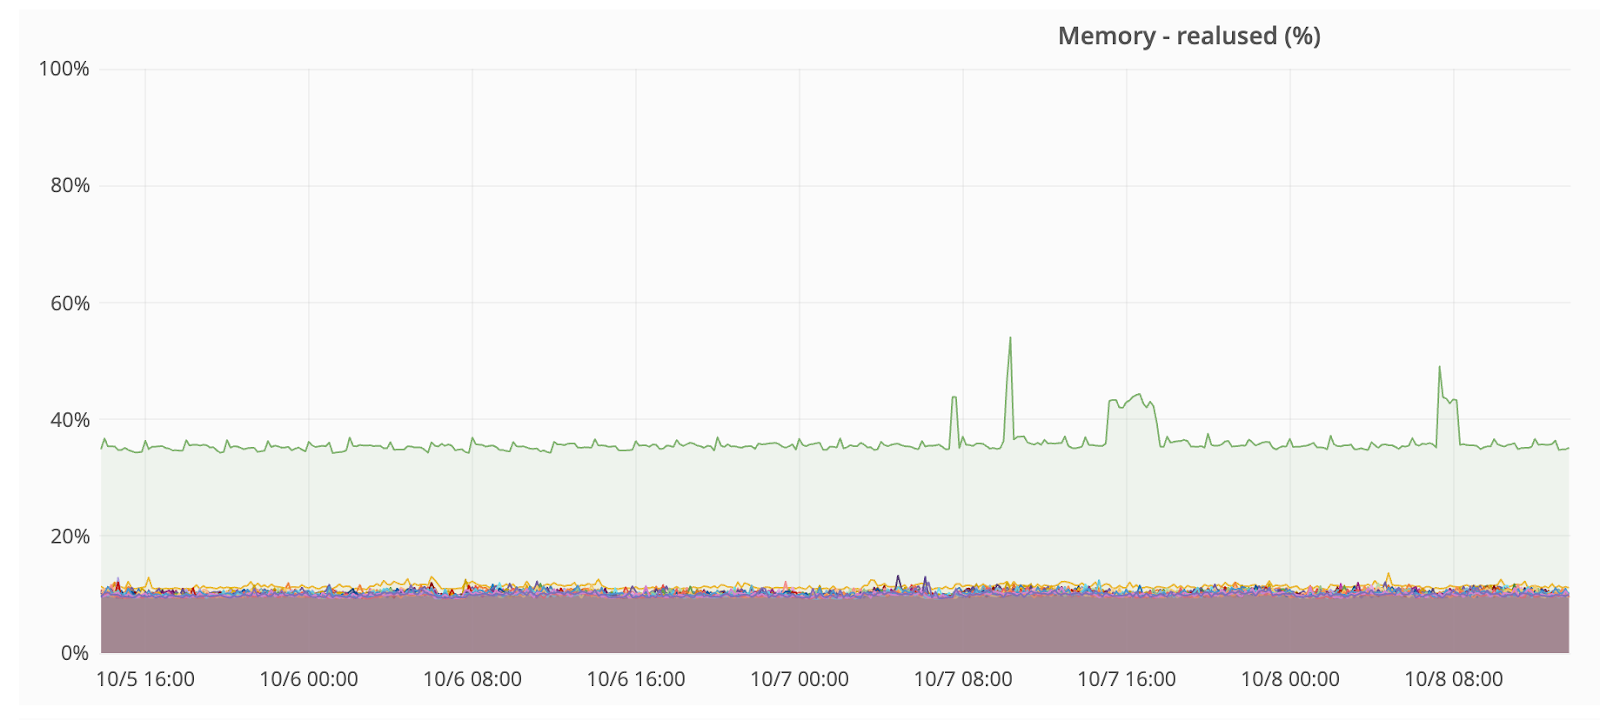
이를 Logriver로 변경하면서 match 구문 관련 내용을 일괄처리할 수 있도록 개선해서 아래처럼 서버의 메모리 사용량을 90% → 15%로 줄일 수 있었습니다.
네트워크 커넥션 수 4000개 → 200개 감소
Fluentd는 로그를 tag라는 단위로 구분하고 처리하고 있습니다. 그렇기 때문에 카프카(Kafka)로 데이터를 보내는 경우 처리하는 tag 당 하나의 커넥션을 만들어서 전송하기 때문에 처리하는 tag가 늘어나는 경우 아래처럼 커넥션 개수도 함께 늘어나게 됩니다.
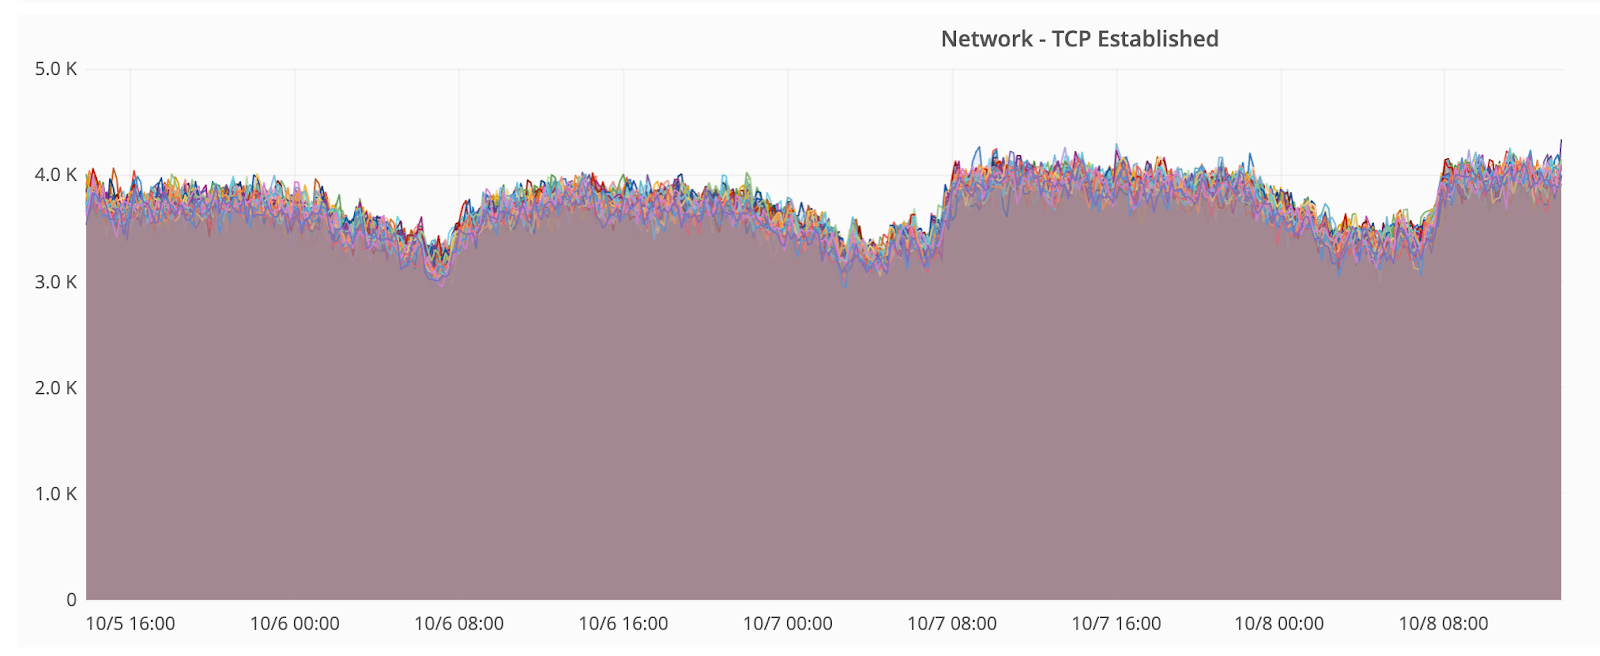
이렇게 되면 Fluentd 서버개수가 늘어나게 되면 데이터를 받아주는 카프카 쪽에는 그에 비례해서 서버 접속 커넥션이 늘어나게 돼서 부담이 될 수 있습니다. 이 부분을 줄여주기 위해서 처리하여 tag 수와 상관없이 카프카 브로커당 동일한 커넥션을 재사용하도록 구조를 개선해서 아래처럼 커넥션 개수를 많이 줄였습니다.
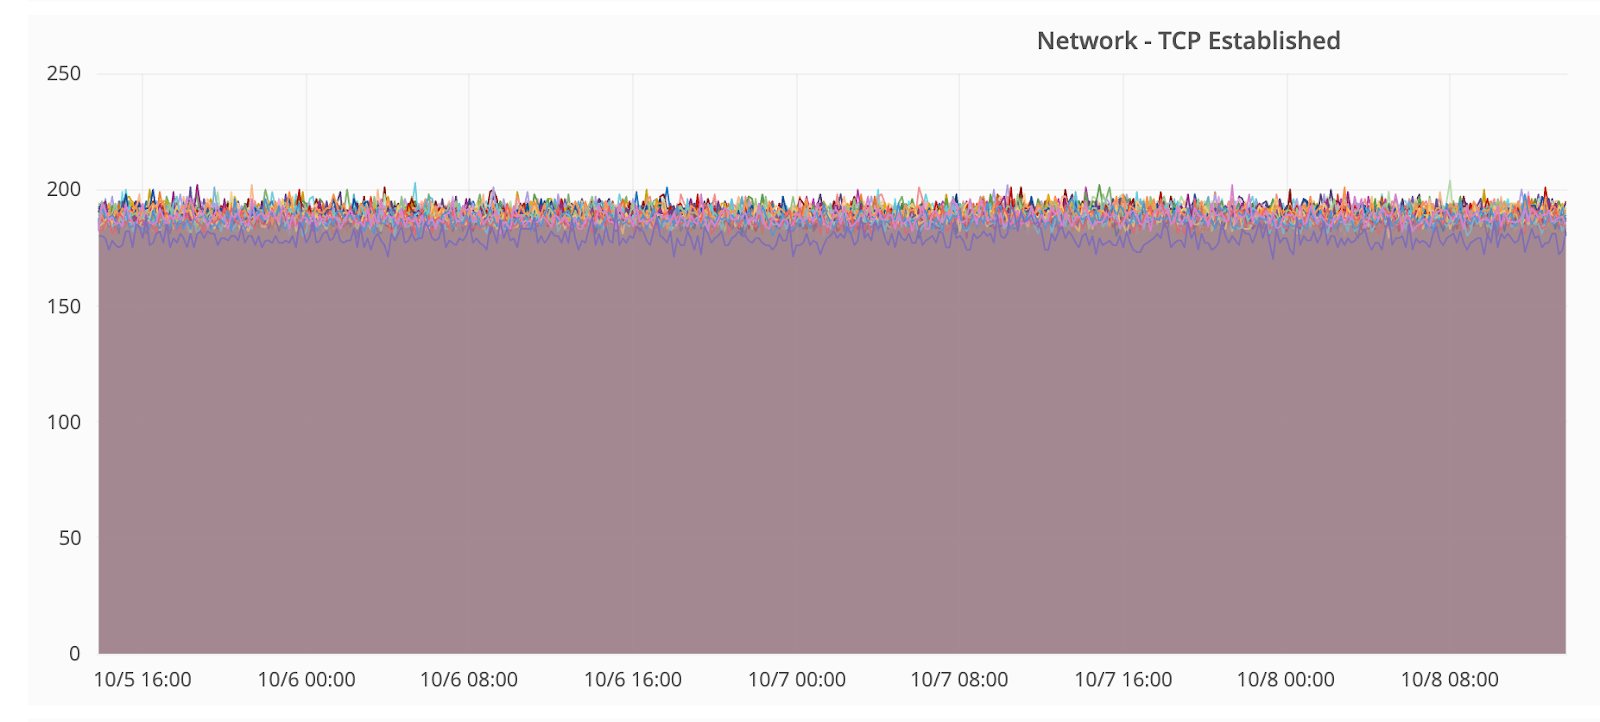
최대 4000개가량 있던 커넥션 개수를 200개가량으로 줄였습니다.
버퍼 통합 관리로 운영 개선
Fluentd에서 많은 tag들에 대해 설정을 하려면 설정 충돌이 없어야 하므로 설정마다 다른 id를 사용해야 합니다. 이런 id를 기반으로 Fluentd는 tag에 대한 버퍼를 만들어서 관리합니다. 조직에서 관리하는 Fluentd tag 개수가 수천 개이기 때문에 하나의 서버에 수천 개의 버퍼 디렉터리가 생깁니다.
그런데 Fluentd 설정을 변경해야 하는 경우 이 id를 기반으로 버퍼 파일들의 디렉터리명도 변경됩니다. 이 상태에서 신규 설정을 적용하기 위해서 Fleuntd를 재시작하게 되면 Fluentd는 신규 설정 기반으로 버퍼 디렉터리를 처리하게 되고, 기존 id에서 사용하던 버퍼 디렉터리는 처리하지 않는 현상이 발생합니다. 그러므로 데이터 유실을 방지하기 위해서는 기존 버퍼 디렉터리에 있던 데이터를 확인해서 신규 버퍼 디렉터리 쪽으로 옮겨줘야 합니다.
이런 버퍼 디렉터리 관리는 Fluentd를 운영하면서 많은 리소스를 소모하게 하는 작업이었습니다. 그래서 Logriver는 tag 개수와 상관없게 버퍼를 통합 관리하도록 함으로써 이런 이슈를 줄일 수 있게 되었습니다.
DDoS 공격 대응을 위한 RateLimit 기능 적용
플랫폼을 운영하다 보면 여러 가지 이유로 트래픽이 급증하는 경우가 있습니다. 특정 이벤트(기념일, 사건사고 등) 때문에 갑자기 트래픽이 증가할 수도 있고, 외부의 DDoS 공격 때문일 수도 있습니다. 이럴 때 실제 서비스 사용량이 늘어난 경우라면 증설을 통해서 원활하게 트래픽에 대응하면 됩니다. 하지만 DDoS 공격 때문이라면 증설이 아니라 늘어난 트래픽을 모두 처리하지 않도록 대응해야 할 필요가 있습니다. 기존에 Fluentd 기반의 로그 수집에서는 이런 일이 있을 때 애를 먹었기 때문에 Logriver에는 커넥션당 트래픽을 제어할 수 있는 기능을 추가해서 이를 막아낼 수 있도록 했습니다.
메트릭 수집 및 확인 방법 개선
플랫폼을 운영하게 되면 필요한 것이 운영에 필요한 메트릭 정보인데요. tag별 로그 사용량(개수/사이즈)을 측정하기 위해서 기존에는 별도의 Fluentd plugin을 개발해서 프로메테우스로 수집해서 사용했었는데, 이 부분을 Logriver에서는 내장해서 좀 더 메트릭 확인이 편하게 만들었습니다.
실서비스 적용 검증
개발 과정 검증이 지난 후 실제 서비스 환경에 적용하기 전에는 실제와 동일한 데이터를 이용해서 데이터 인코딩/디코딩의 문제가 없는지 검증해야 했습니다. 트래픽 자체는 미러링해서 테스트 환경으로 받을 수 있었습니다. 하지만 실제 서비스 환경에서는 원하는 만큼의 데이터를 제한된 만큼 생성하고 끊는 게 어렵기 때문에 다른 방법을 생각해야 했습니다. 여러 대의 서버를 이용해서 최대한 실제와 동일한 환경에서 테스트를 해야 했기 때문에 데이터가 들어오는 순서가 보장되지 않았고 적재되는 순서도 보장되지 않았습니다. 이를 해결하기 위해서 검증기를 다시 만들었습니다. 로그에 있는 timestamp를 이용해서 1분 간격으로 데이터를 모아서 검증했습니다. 검증을 시작하면 실제 서비스 환경과 테스트 환경에 데이터가 들어오는 게 차이가 있었지만 결국 단위 시간당 들어온 데이터 건수가 동일해지는 걸 확인할 수 있었습니다.
이후 데이터 건수뿐만 아니라 데이터 내용 자체도 같은지 검증해야 했습니다. 검증용으로 사용했던 것은 kemi-log가 처리하는 일부 데이터이긴 했지만 분당 들어오는 데이터가 30만 건이 넘는 양이었습니다. 데이터가 많기 때문에 모든 데이터를 메모리에 들고 있으면서 실시간으로 1:1 매칭을 하는 건 불가능하다고 생각해서 데이터를 해시화해서 검증했습니다. 수집한 로그는 대부분이 JSON 형태였고, 이걸 그대로 해시화 하게 되면 실제로는 동일한 데이터이지만 멤버의 순서가 바뀐 경우 다른 해시값으로 변경되어 문제가 있었습니다. 그래서 JSON 데이터를 하나의 문자열로 만들어서 그걸 알파벳순으로 정렬한 다음 해시를 해서 해시값의 일관성을 보장하도록 만들었습니다. 이 과정에서 데이터 인코딩 이슈가 있었던 일부 사례를 찾아서 수정할 수 있었습니다.
적용 효과
위의 여러 가지 개선의 결과 Fluentd보다 시스템 사용 효율성이 크게 개선되었기 때문에 Logriver로 전환하고 나서 기존에 사용하던 서버 사용량을 50% 절감할 수 있었습니다.
결론
오픈 소스의 장점은 원하는 기능의 초기 구축을 빠르게 할 수 있다는 점입니다. 그러나 여러 해 동안 구축된 시스템을 운영하다 보면 회사 내에서 필요한 정책과 기능이 필요해지며, 이를 기존 시스템에 통합할지에 대한 고민을 하게 됩니다. 기본적으로는 해당 오픈 소스에 기여를 해 나가면서 함께 발전해 나가는 걸 목표로 하고 있지만 현실적인 어려움 또한 존재합니다.
오픈 소스의 활성도가 줄어들어서 유지보수가 잘 되지 않을 수도 있습니다. 오픈소스의 메인 관리자가 아닌 경우 원하는 기능을 개발해서 코드 기여를 하려 하더라도 거부당하게 될 수도 있습니다. 회사 내에서만 필요한 기능을 추가해서 사용하는 경우는 코드 기여 자체가 불가능합니다. 이런 경우 그 오픈 소스의 메인스트림과는 별도의 기능을 내부에서 계속해서 별도로 관리해야 되는 이슈가 있을 수도 있습니다. 이러한 제약 사항 때문에 결국 자체 개발과 오픈 소스 활용 두 가지 방안 사이에서 고민을 하게 됩니다.
카카오는 Fluentd를 수년간 운영한 경험을 바탕으로, 다양한 기능 중에 어떤 기능을 사용하고 있는지 파악하고 있었습니다. 그렇기에 Fluentd의 모든 기능과 다양한 plugin들을 모두 자체 개발하는 게 아니라, 이미 사용 중인 필수 기능들만을 선별적으로 내재화하는 전략을 채택함으로써 효율적인 시스템 마이그레이션이 가능했습니다. 이 사례가 오픈 소스를 사용하고 있거나 도입을 고려 중인 조직에서 참고할 만한 유용한 사례가 되기를 바랍니다.
Written by Hardy.jwc
Edited by Marron.b