Backend
MySQL Json 데이터 타입의 저장 구조와 성능 비교
jin.1115카카오
2025년 9월 18일
원문에서 보기 ↗개요
MySQL은 Ver 5.7.8부터 데이터 타입으로 JSON을 추가하여 지원하고 있습니다. JSON 데이터 타입은 JSON-format 문자열을 저장할 때 일반적인 문자열 컬럼에 저장하는 것에 비해 다음과 같은 이점을 가집니다.
- 저장된 JSON 데이터의 유효성 보장
- JSON 데이터에 최적화된 저장 방식 제공
하지만, JSON 데이터를 저장할 때 항상 JSON 데이터 타입만 사용하여 저장하지는 않습니다. TEXT 타입으로도 JSON 데이터를 문자열 형태로 저장할 수 있습니다.
여기에서는 JSON 데이터 타입에 대해 알아보면서 JSON 데이터를 저장할 때 JSON, TEXT 데이터 타입 중 어떤 데이터 타입을 사용하는 것이 더 성능에 유리한지 알아보려고 합니다.
1. JSON 데이터 타입 저장 방식
MySQL에서 JSON 데이터 타입 컬럼을 설정하여 데이터를 사용할 때 다음과 같은 2가지 변환 작업 과정이 진행됩니다.
- 직렬화(Serialization)
- 역직렬화(Deserialization)
[참고]
여기서 말하는 직렬화/역직렬화 용어는 MySQL과 JSON에만 국한된 용어가 아닙니다.
JSON 타입과 TEXT 타입에 동일한 JSON 문자열을 저장해 보면서 내부적으로 어떤 작업이 일어나는지 확인해 보도록 하겠습니다.
1.1 JSON 데이터 저장하기
다음과 같은 JSON 데이터를 저장한다고 가정해 보겠습니다.
{
  "a":"x",
  "b":"y",
  "c":"z"
 }
다음과 같은 쿼리를 수행하여 동일한 JSON 데이터를 JSON 타입과 TEXT 타입에 저장합니다.
use test_db;

CREATE TABLE json_ibd_test (id bigint primary key, json_data json);
CREATE TABLE text_ibd_test (id bigint primary key, text_data text);

INSERT INTO json_ibd_test VALUES (1115, '{"a":"x","b":"y","c":"z"}');
INSERT INTO text_ibd_test VALUES (1115, '{"a":"x","b":"y","c":"z"}');
이제 위에 저장한 JSON 데이터가 어떻게 저장되어 있는지 hexdump를 사용하여 확인해 보도록 하겠습니다.
hexdump -C /data/mysql/test_db/json_ibd_test.ibd > json_ibd_test.hexdump
hexdump -C /data/mysql/test_db/text_ibd_test.ibd > text_ibd_test.hexdump

vi json_ibd_test.hexdump
vi text_ibd_test.hexdump
vi 에디터 내에서 ‘supremum’ 으로 검색하여 이동하면 INSERT한 데이터가 실제로 저장된 위치를 찾을 수 있습니다.
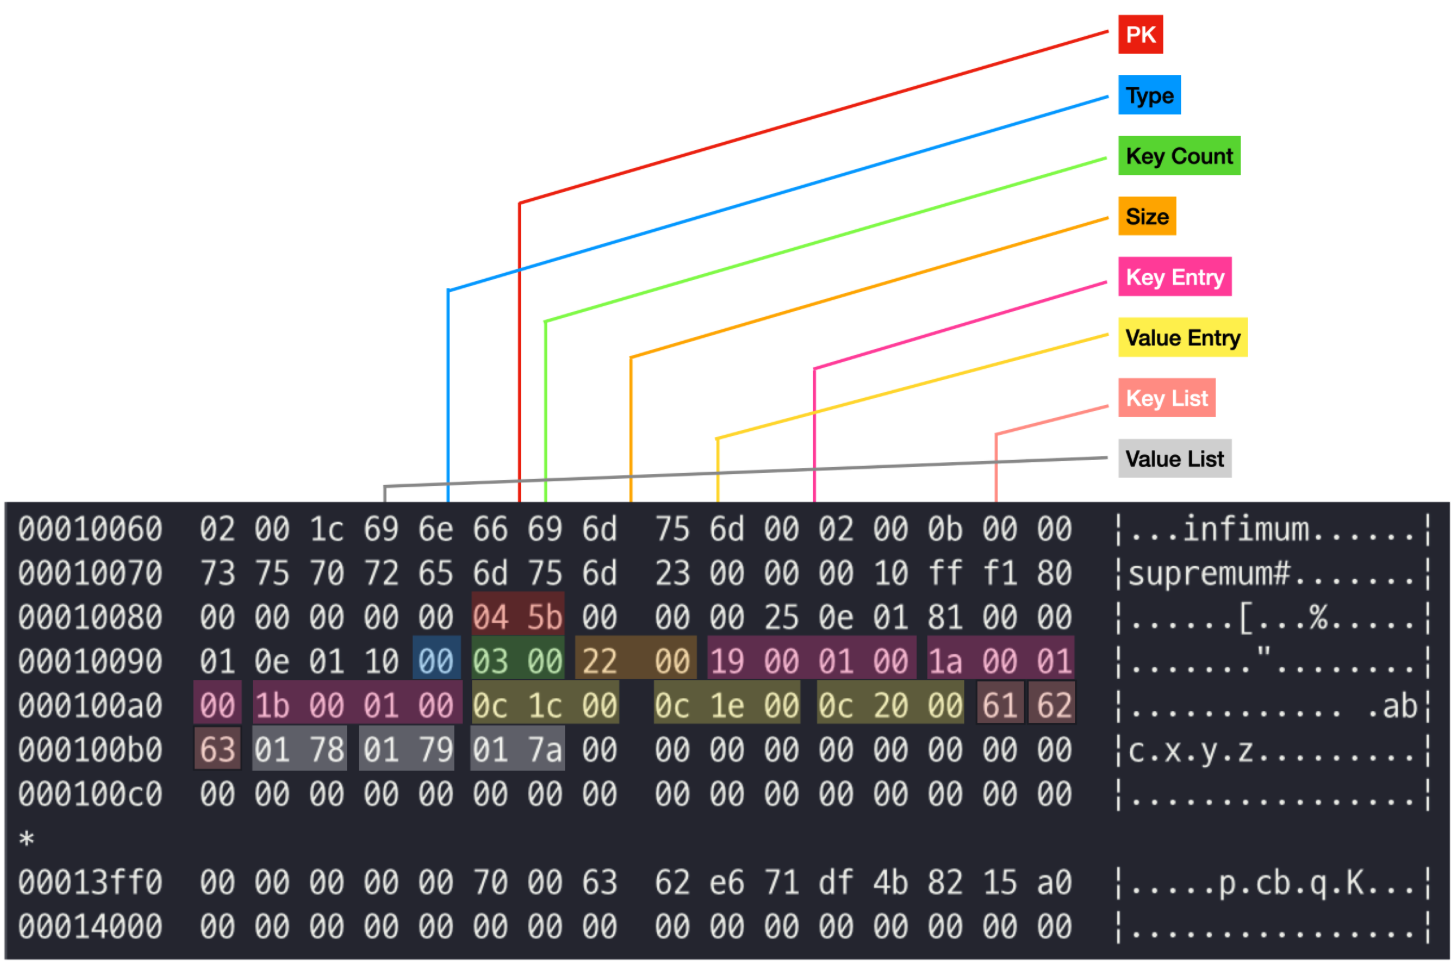
위 그림 예제는 JSON 타입의 컬럼에 JSON 데이터를 저장한 테이블 파일을 hexdump로 변환하여 분석한 그림입니다. 그림에 표현한 것과 같이 JSON 데이터를 입력할 때, Type, Key Count 등 메타 정보를 파악하여 함께 저장한 것을 확인할 수 있습니다. 이처럼 JSON 데이터 타입은 저장 시 클라이언트로부터 받은 문자열을 문자열 그대로 저장하는 것이 아니라, 일련의 변환 과정을 거쳐 정해진 형식에 맞게 저장합니다. 이러한 변환 작업을 직렬화라고 합니다. 저장 시, 이런 변환 과정을 거쳐 저장하고 있기 때문에 다시 읽을 때도 클라이언트에게 전송하기 위한 문자열로 재구성하기 위한 변환 작업이 필요할 것임을 유추할 수 있습니다.
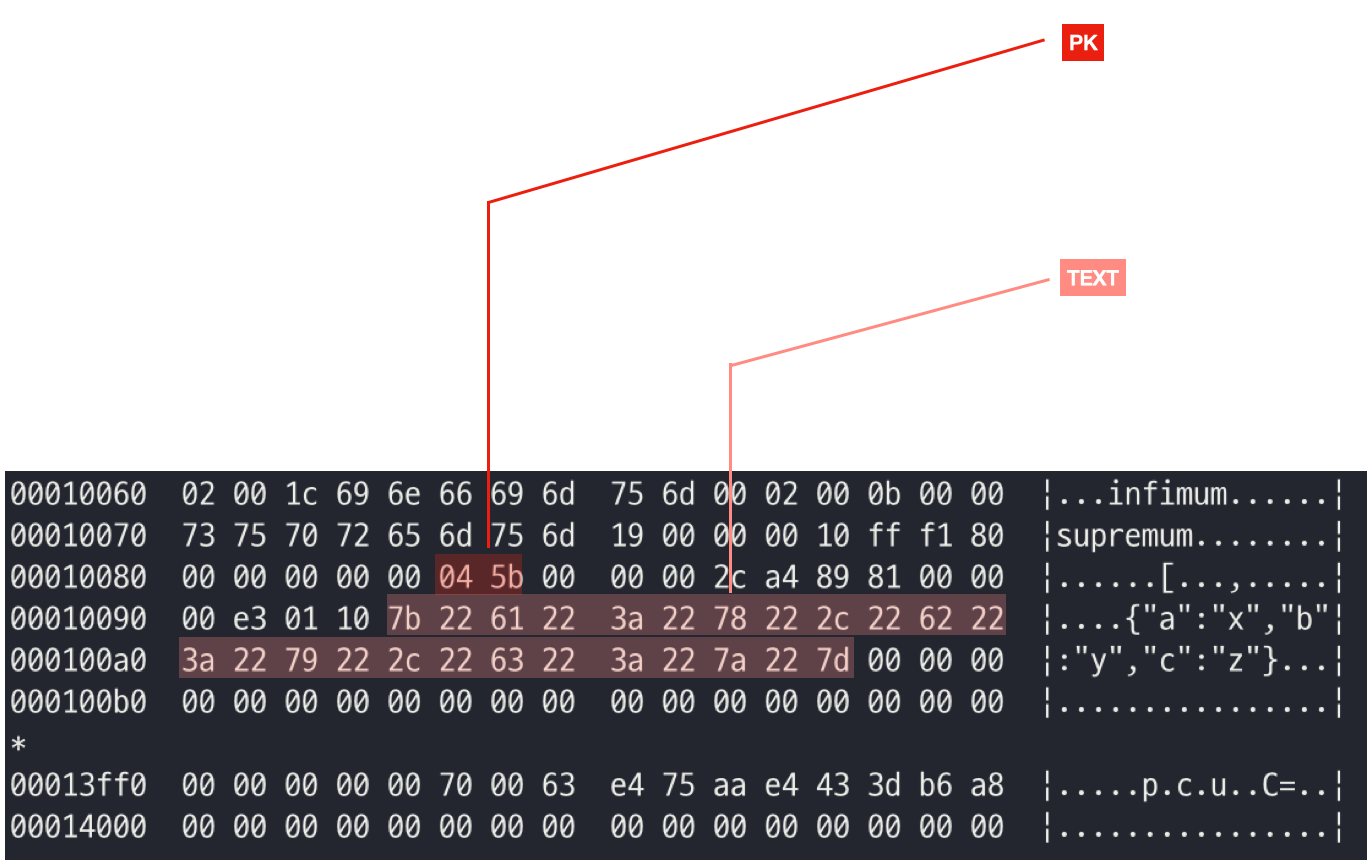
위 예제는 TEXT 데이터 타입의 컬럼에 JSON 데이터를 저장한 것을 hexdump로 확인하여 분석한 내용을 정리한 내용입니다. hexdump를 통해 저장된 정보를 분석해 보면 TEXT 데이터 타입은 JSON 포맷의 문자열을 입력 받은 문자열 그대로 저장하고 있음을 확인할 수 있습니다.
이제는 JSON 데이터 타입에 JSON 데이터를 저장할 때, 전달받은 문자열을 어떻게 직렬화하여 저장하는지 그 작업 단계를 간단히 정리해 보도록 하겠습니다.
1.1.1 직렬화 과정
클라이언트에게 문자열 형태로 전달 받은 JSON 데이터는 저장을 위해 크게 3가지 과정을 거칩니다.
- 문자열을 파싱하여 JSON 인스턴스 생성
- 저장하기 위한 문자열로 변환
- 저장
1.1.1.1 JSON 인스턴스 생성
JSON 데이터를 저장할 때 먼저 sql_common/json_dom.h에 정의된 JSON 객체를 사용하여 해당 데이터를 저장할 인스턴스를 생성합니다. json_dom.h에 JSON 객체는 다음과 같이 정의되어 있습니다.
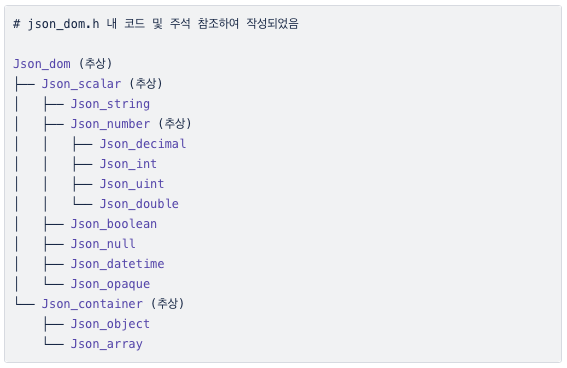
입력 받는 JSON 데이터는 구조의 특성에 따라 위에 설명한 json_dom 클래스를 상속 받아 서브 클래스들을 통해 구현합니다. 예를 들어, Json_object 와 Json_array의 구현을 살펴보면, 특성에 맞는 자료구조를 활용하여 구현 되었음을 알 수 있습니다.
| 클래스 | 설명 |
|---|---|
| Json_object | 키와 값을 저장하고 키를 통해 빠르게 접근하기 위해 std:map을 사용한다. |
| Json_array | 순서가 있는 리스트를 저장하기 위해 벡터 배열을 사용한다. |
일반적으로 JSON이라고 했을 때 떠올리는 { key : value } 구조의 JSON 데이터를 저장하면, Json_object 인스턴스를 생성하여 저장하게 됩니다.
1.1.1.2 직렬화 작업
직렬화 작업은 다음과 같은 프로세스로 진행됩니다.
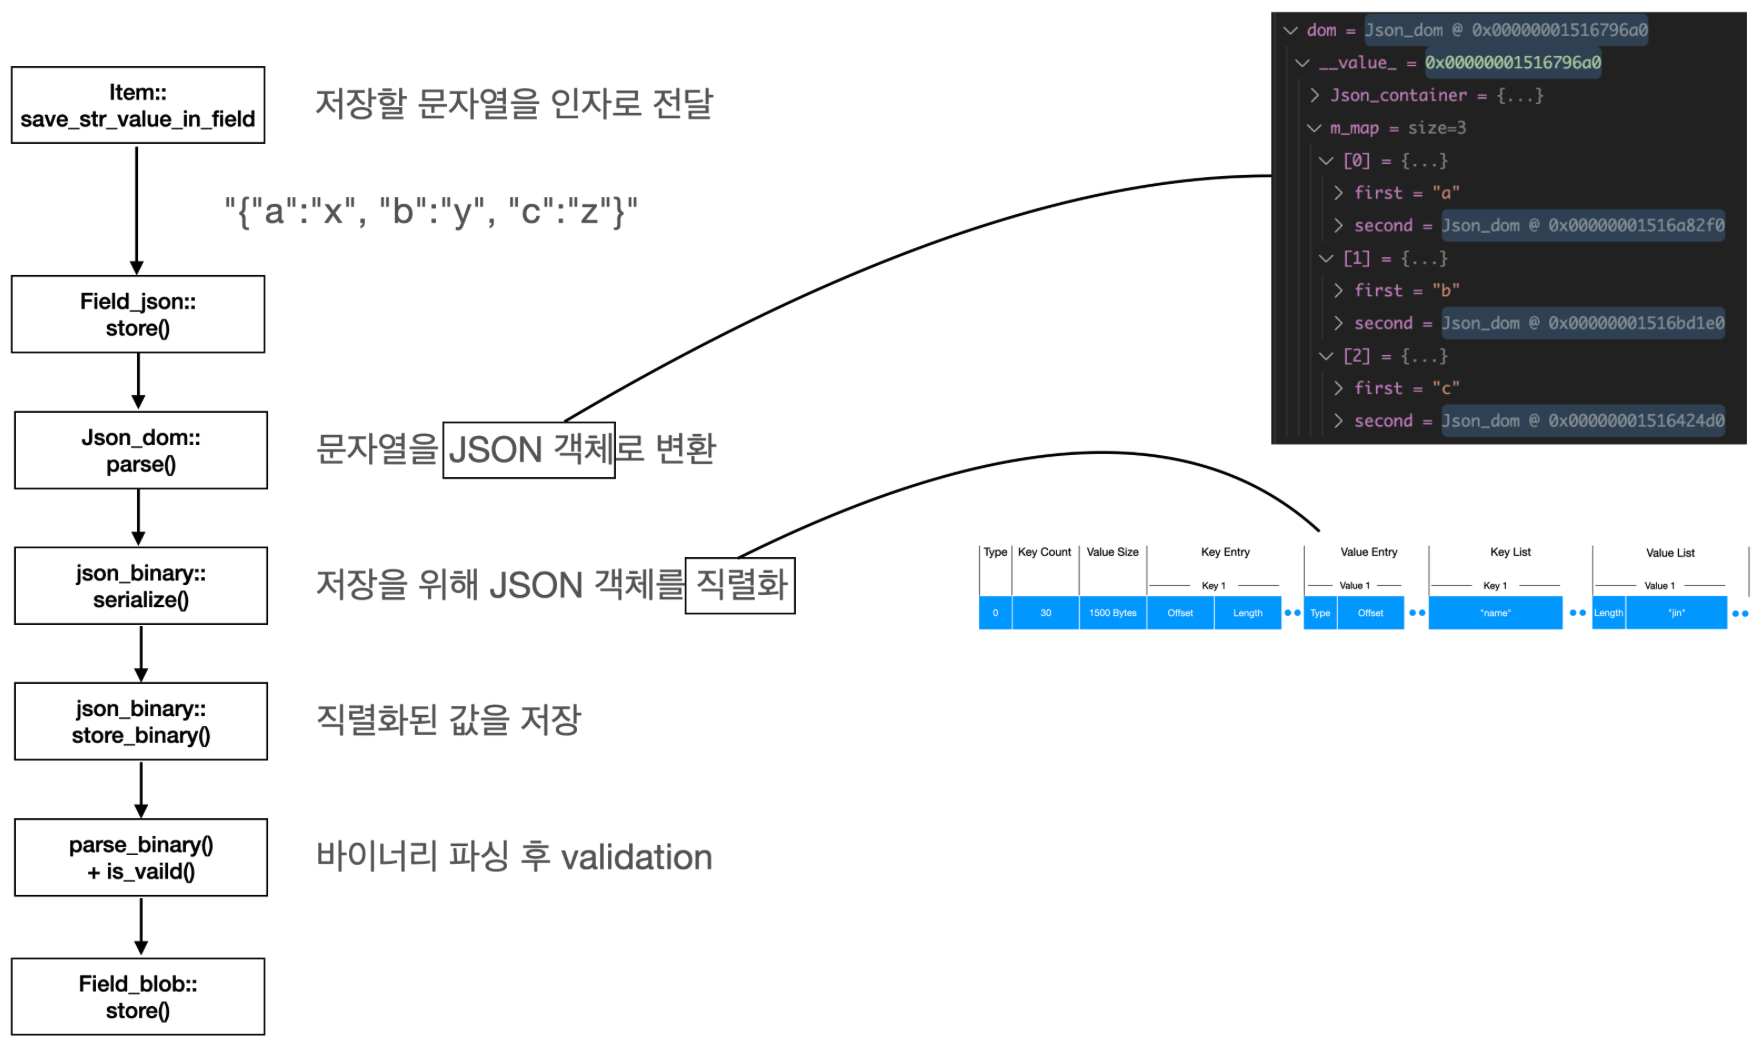
클라이언트가 전달한 JSON 문자열을 Item::save_str_value_in_field() 함수 내에서 Field_json::store() 함수로 전달하면서 작업이 시작됩니다. Field_json::store() 함수를 호출하면 클라이언트가 전달한 문자열을 인자로 받아 parse() , serialize(), store_biary() 함수를 순차적으로 호출하여 직렬화 작업을 진행합니다. serialize() 함수가 직렬화 작업을 마치고 결과 값을 store_binary() 함수에 전달하면 여기에서 JSON 형식에 적합한지 아닌지 검사합니다. 마지막으로, Field_blob::store()를 호출하여 작업을 마무리합니다.
1.1.1.3 TEXT 데이터 타입과 입력 처리 비교
TEXT 데이터 타입의 저장 방법은 JSON 데이터 타입의 저장 방법과 비교하여 굉장히 간단합니다. 클라이언트가 전달한 문자열을 별도의 변환 과정 없이 저장하기 때문입니다. 그림으로 표현하면 다음과 같습니다.
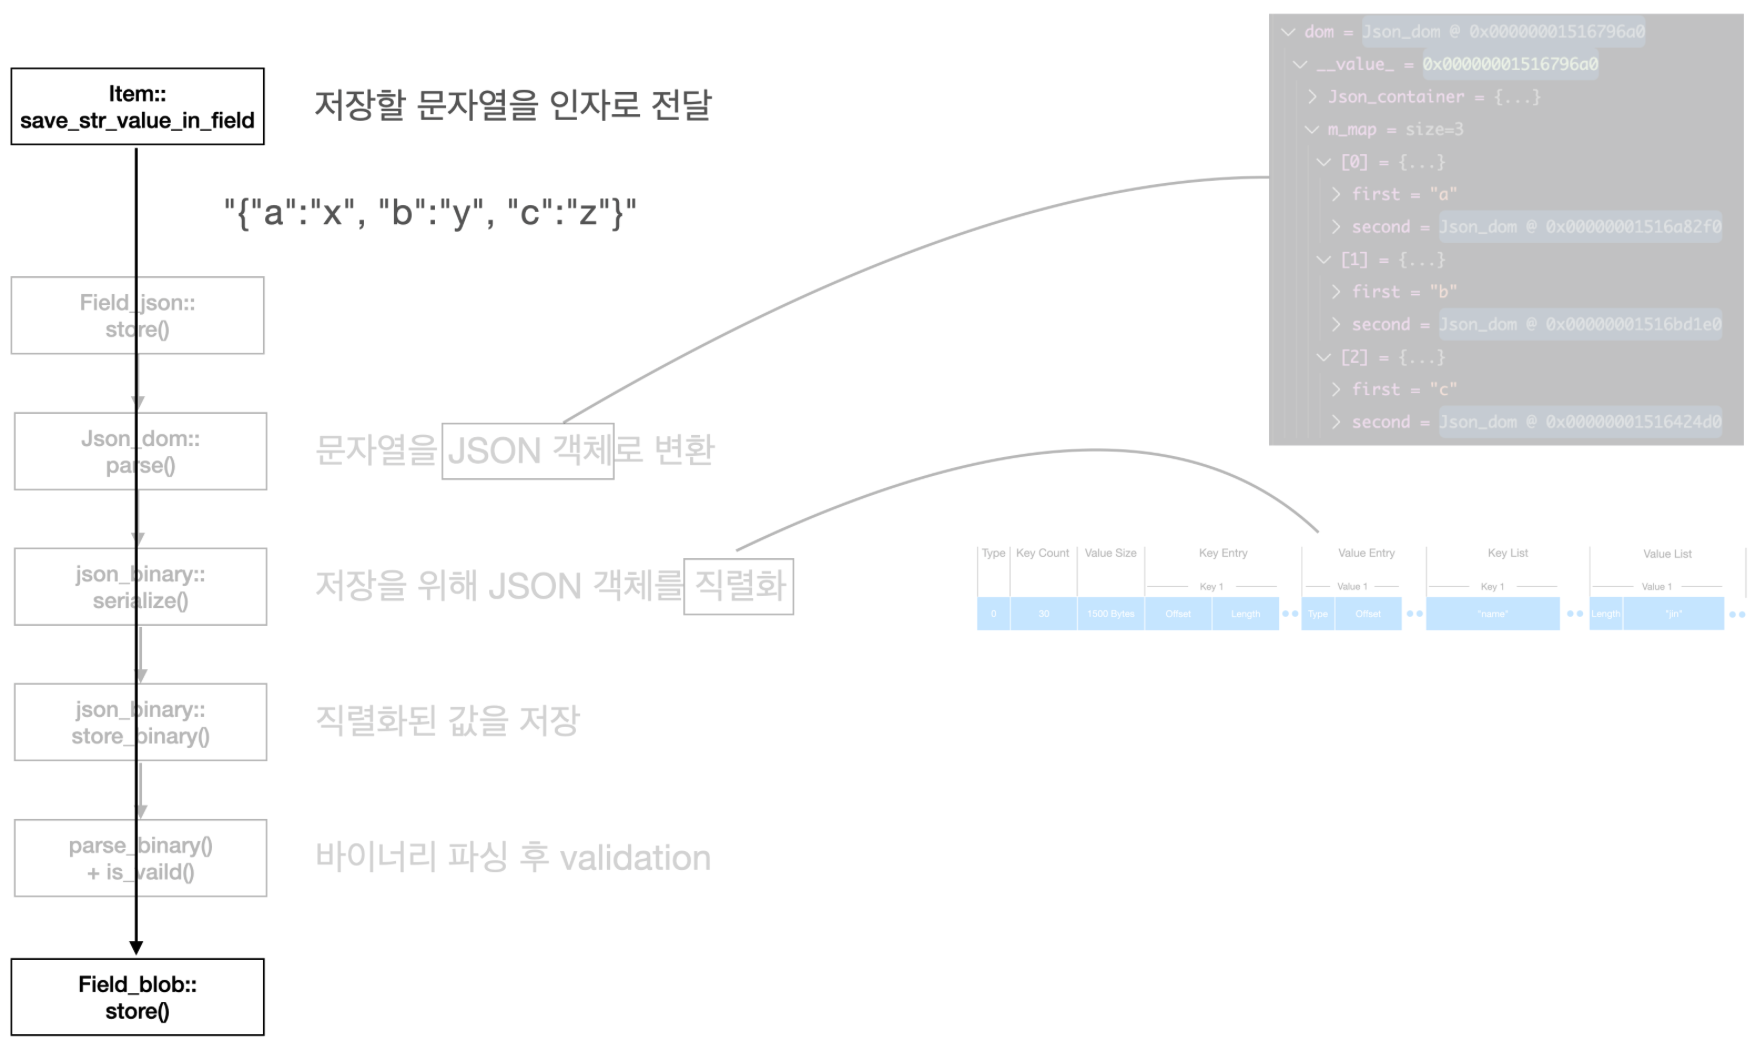
즉, JSON 데이터 타입에 데이터를 저장하는 과정에는 직렬화, Validation(유효성 확인)과 같은 추가 작업이 포함되어 있습니다. 이 과정의 차이가 JSON 데이터 타입과 TEXT 데이터 타입 간의 성능 차이의 주요 요소가 됩니다.
1.1.2 JSON Object 구조
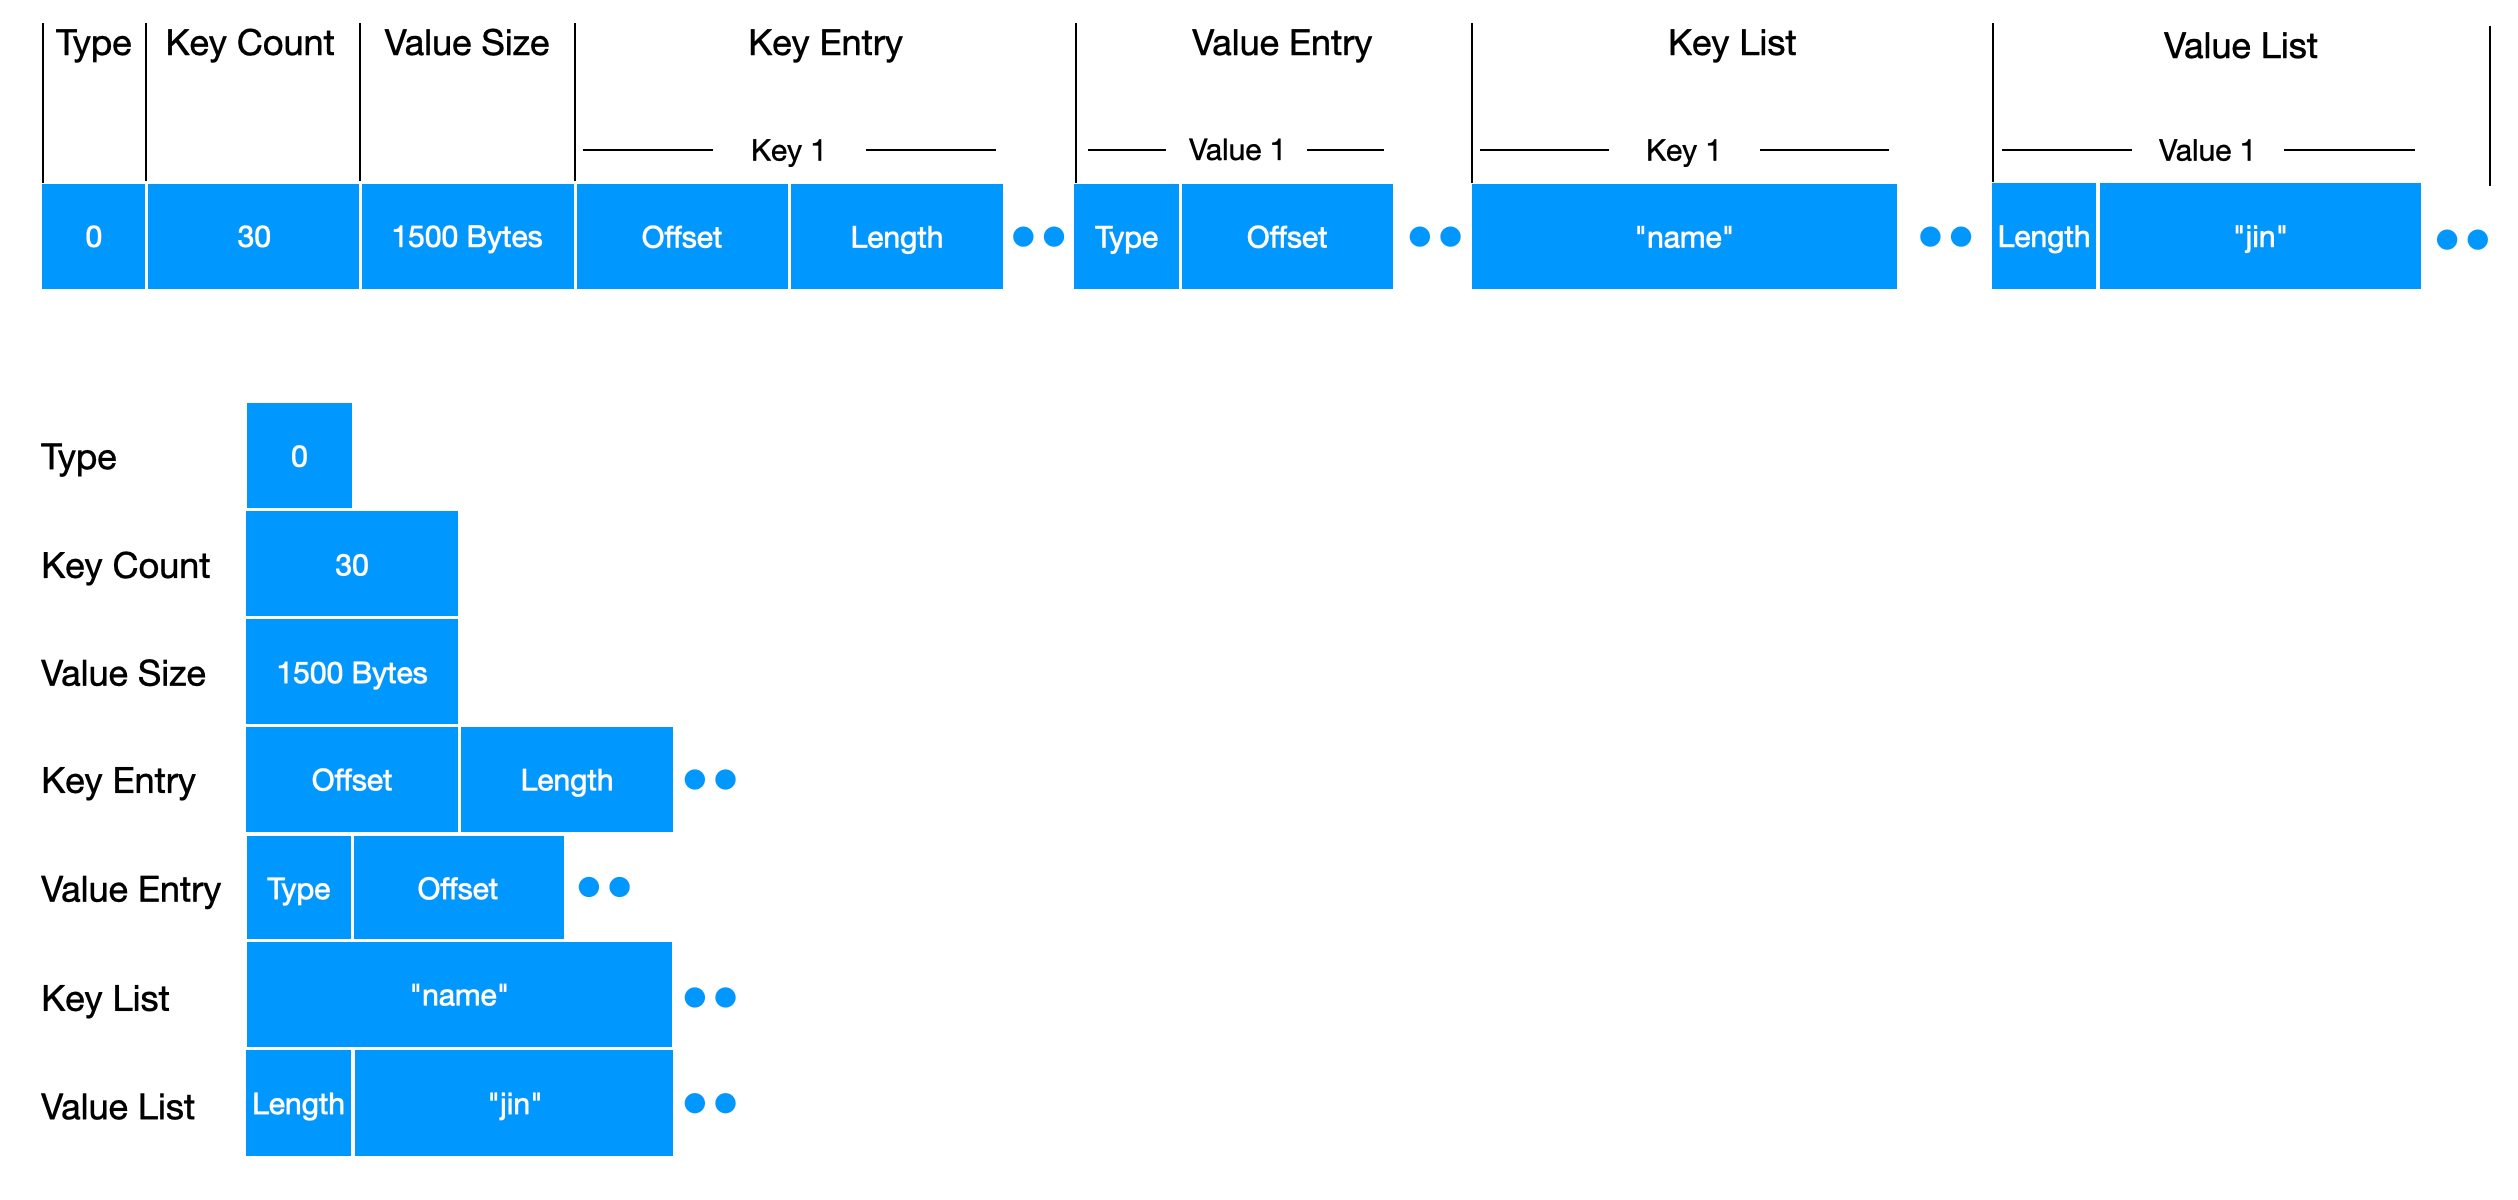
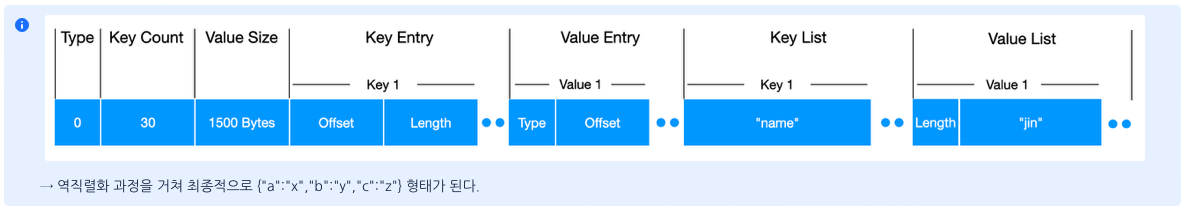
앞에서 설명해 드린 것과 같이 JSON 데이터 타입은 저장 시 저장할 JSON에 대한 메타 정보를 만들어서 함께 저장합니다. 다시 말해, Json_object 객체를 통해 직렬화된 정보들이 다음과 같은 포맷으로 테이블 ibd 파일에 저장됩니다.
[참고]
위 그림은 테이블 구조와 데이터를 실제로 저장하고 있는 ibd 파일을 hexdump하여, Json_object를 물리적으로 저장하고 있는 구조를 시각화하여 표현한 것입니다.
1.1.2.1 저장 구조 분석
위 그림에 나타난 요소들이 각각 어떤 의미를 가지는지 간단히 정리해 보도록 하겠습니다.
[Type(Type Identifier)]
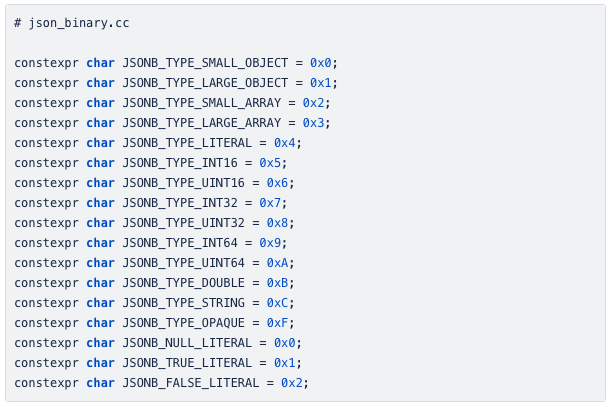
1바이트의 크기를 가지며, Json Document의 Type(유형)을 표시하는데 사용합니다. MySQL 내에 Type Identifier가 가질 수 있는 값은 json_biary.cc 파일 내 매크로 변수로 정의되어 있습니다.
[Key Count]
JSON Document 내 key(elements)의 값의 갯수를 의미합니다. Key Count 영역의 크기는 직전 바이트에 저장된 Type에 의해 결정됩니다.
| Type | 사이즈 |
|---|---|
| JSONB_TYPE_SMALL_OBJECT | unit16(2 bytes) |
| JSONB_TYPE_LARGE_OBJECT | unit32(4 bytes) |
[Value Size]
JSON Object의 크기를 말합니다. 즉, 이 Json_object가 몇 바이트인지를 저장합니다. Value Size 영역의 크기는 Key Count와 동일하게 Type에 의해 결정됩니다.
| Type | 사이즈 |
|---|---|
| JSONB_TYPE_SMALL_OBJECT | unit16(2 bytes) |
| JSONB_TYPE_LARGE_OBJECT | unit32(4 bytes) |
[Key Entry]
각 키의 오프셋(위치)과 길이를 저장합니다.
| 설명 | |
|---|---|
| offset | Key 저장 위치 |
| length | Key의 길이 |
[Value Entry]
각 Value의 타입과 오프셋을 저장합니다.
| 설명 | |
|---|---|
| type | Json Value의 타입(String, int16, …) |
| offset | Value의 위치 |
[Key List]
실제 JSON Key들을 저장합니다. 하지만, Key:Value 형태로 저장하지 않고, [key1, key2 …]와 같이 이어져 저장됩니다.
[Value List]
실제 JSON Value를 저장합니다. Key와 마찬가지로 Value도 이어서 저장됩니다.
1.2 데이터 타입에 따른 저장 크기 비교
이제는 동일한 JSON 데이터를 입력할 때 각 타입별로 어느 정도 저장공간이 필요한지 알아보겠습니다.
앞에서 예제로 설명한 JSON 데이터를 JSON 데이터 타입의 컬럼에 저장했을 때와 TEXT 데이터 타입의 컬럼에 저장했을 때 저장 공간 사이즈가 어느 정도 차이가 나는지 확인해 보도록 하겠습니다.
저장하고자 하는 JSON 문자열은 1.1의 예제와 동일합니다.
{
  "a":"x",
  "b":"y",
  "c":"z"
 }
hexdump를 통해 실제 데이터가 저장된 영역을 보면서 사용한 저장공간 크기를 계산해 보도록 하겠습니다.
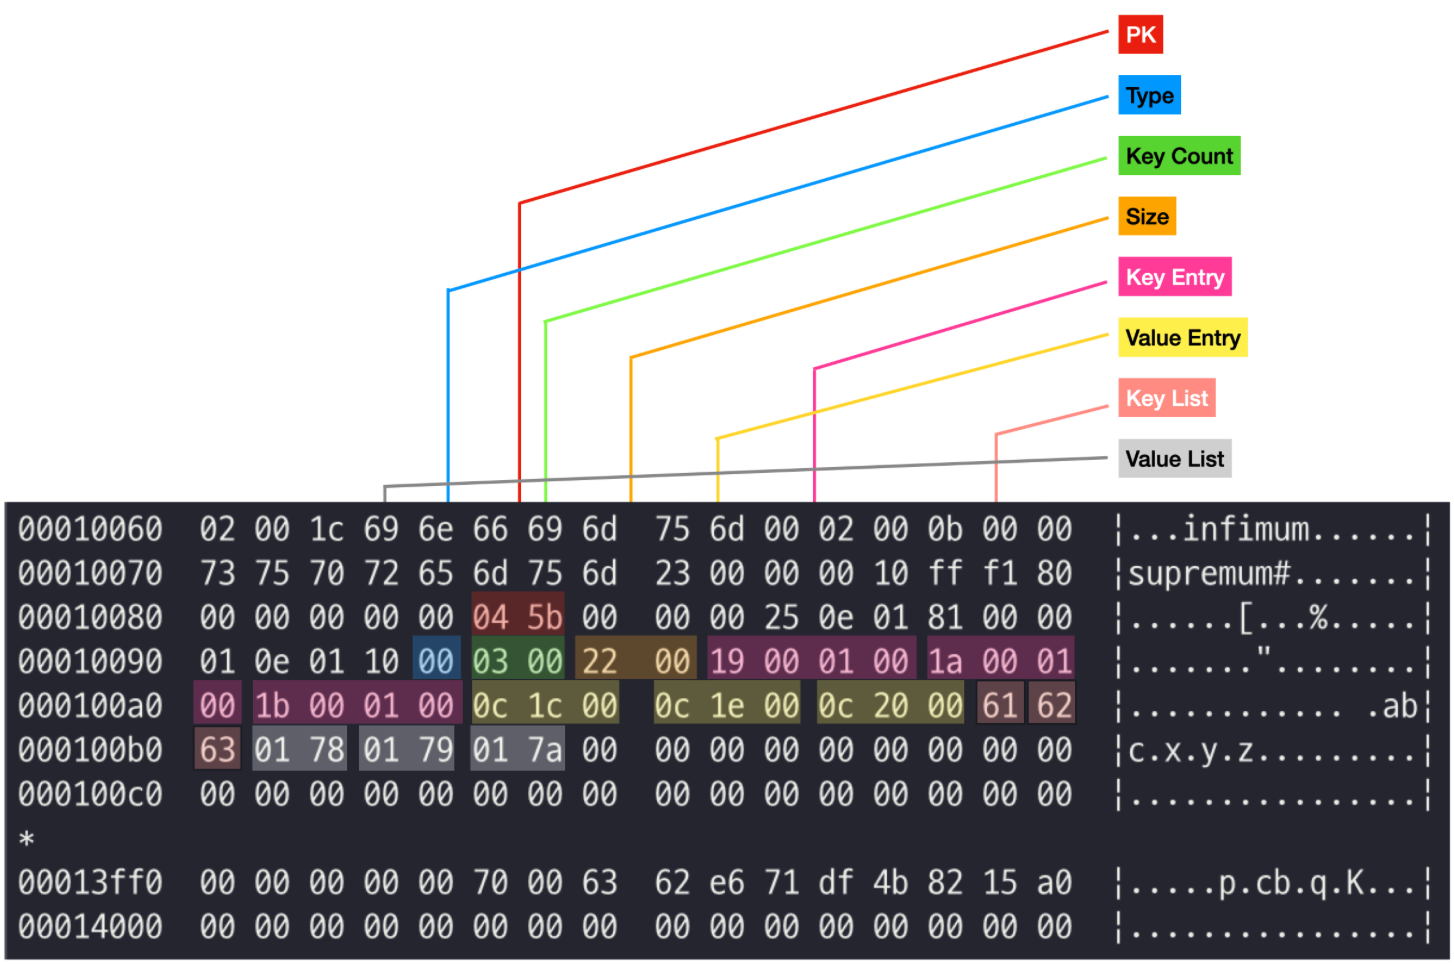
JSON 데이터 타입은 다음과 같이 공간이 사용됨을 계산할 수 있습니다.
Type : 1 Byte
Key Count : 2 Bytes
Value Size : 2 Bytes
Key Entries : 4 * key_count Bytes
Value Entries : 3 * key_count Bytes
Key List : key_string_length
Value List : key_count*(1byte) + value_string_length

Key_count : 키 전체 개수로 여기서는 3개가 된다.
Key_string_length : 키가 저장된 저장 공간 사이즈로 여기서는 3 Bytes가 된다.
Value_string_length : Value가 저장된 저장 공간 사이즈로 여기서는 3 Bytes가 된다.

⇒ 전부 더하면 35 Bytes가 됨을 확인할 수 있다.
TEXT 데이터 타입으로 저장할 때 사용한 공간을 확인해 보도록 하겠습니다. 앞서 계산한 것과 동일하게 hexdump를 사용하여 확인한 정보를 기반으로 계산하도록 하겠습니다.
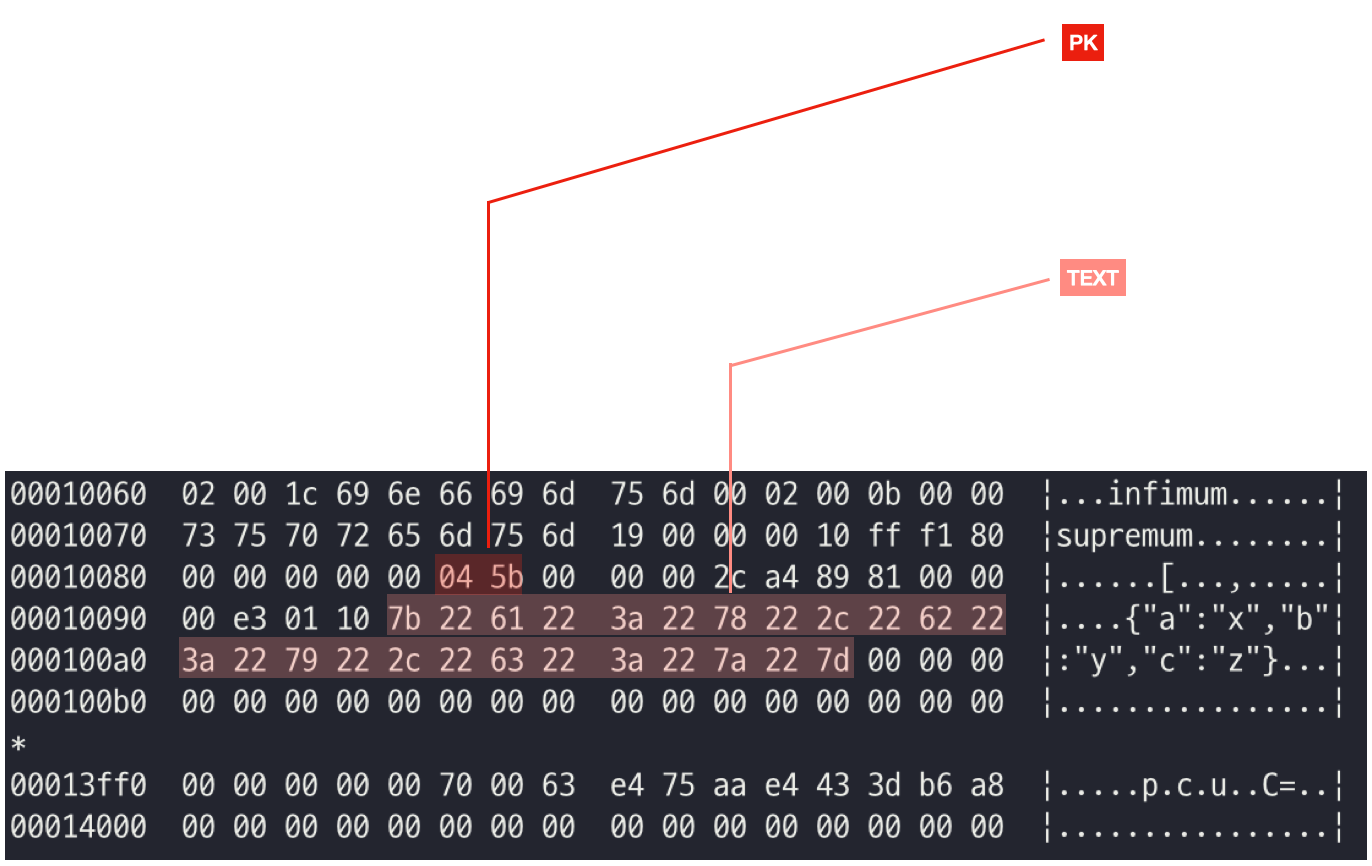
위 그림을 기반으로 계산하면 다음과 같이 계산됨을 확인할 수 있습니다.
2 Bytes (중괄호 문자 저장공간)
Key_count * 6 - 1 (쌍따옴표(“), 쌍점(:), 쉼표(,) 문자 저장공간)
Key_string_length
Value_string_length

Key_count : 키 전체 개수로 여기서는 3개가 된다.
Key_string_length : 키가 저장된 저장 공간 사이즈로 여기서는 3 Bytes가 된다.
Value_string_length : Value가 저장된 저장 공간 사이즈로 여기서는 3 Bytes가 된다.

⇒ 전부 더하면 25 Bytes가 됨을 확인할 수 있다.
실제 데이터를 저장할 때 여러 메타 정보를 함께 저장하는 JSON 데이터 타입이 상대적으로 더 많은 공간을 사용하는 것을 확인할 수 있습니다.
[참고]
TEXT 데이터 타입은 전달 받은 문자열 그대로 저장합니다. 즉, 저장할 JSON-format 문자열에 불필요한 공백이나 의미 상 불필요한 문자들이 많이 포함되어 입력되는 경우 TEXT 데이터 타입은 그 모든 문자열을 같이 다 저장합니다.
JSON 데이터 타입은 저장 시 불필요한 모든 문자 정보를 제거하고 저장합니다.
그래서, 의미 상 불필요한 문자가 많이 포함된 JSON-format 문자열을 저장하게 되면 TEXT 데이터 타입이 더 많은 공간을 사용하게 될 수도 있습니다.
2. JSON 데이터 추출하기
JSON 데이터를 JSON 데이터 타입에 저장하면, 내부적으로 직렬화 과정을 거치지 때문에 TEXT 데이터 타입에 저장한 경우와 다르게 시간 소요도 더 걸리고 저장 공간이 더 필요함을 확인할 수 있었습니다. 이제는 저장된 데이터를 추출할 때 두 데이터 타입에 따라 어떻게 동작 방식이 다른지 확인해 보도록 하겠습니다.
2.1 JSON 데이터 추출하기
JSON 데이터 타입에 저장된 데이터를 조회하게 되면 내부적으로 역직렬화 작업 단계를 거쳐서 진행됩니다. 즉, 역직렬화 과정은 ibd 파일에 저장된 데이터를 추출하여 JSON 오브젝트로 구성하고 클라이언트로 전달하는 과정이라고 말할 수 있습니다.
2.1.1 JSON 데이터 역직렬화 과정
JSON 데이터 타입에 저장된 JSON 값은 다음과 같은 과정을 거쳐 클라이언트에게 전달됩니다.
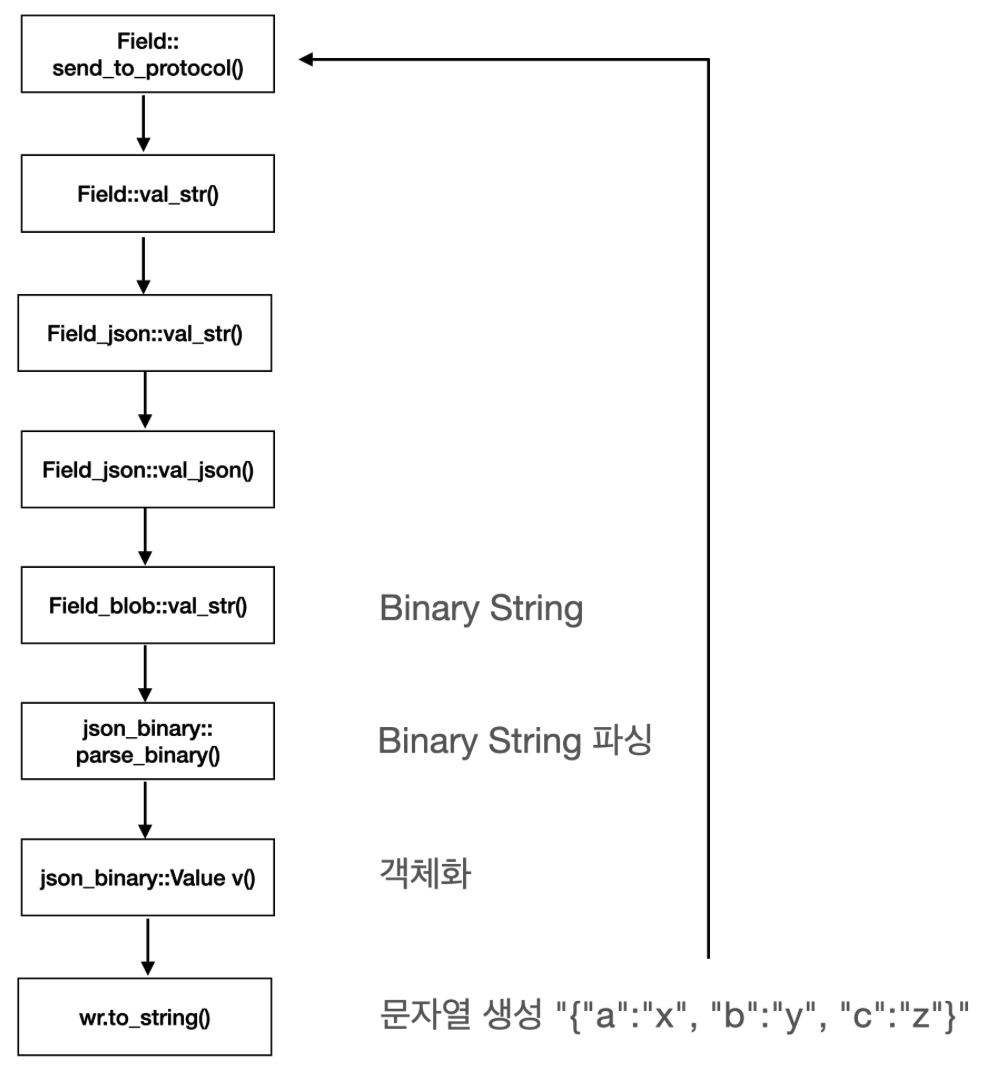
위 그림에 표현된 작업 단계를 거쳐 저장된 데이터를 JSON 객체로 만들고, 그 객체를 기반으로 문자열을 만들어서 클라이언트에 전달합니다.
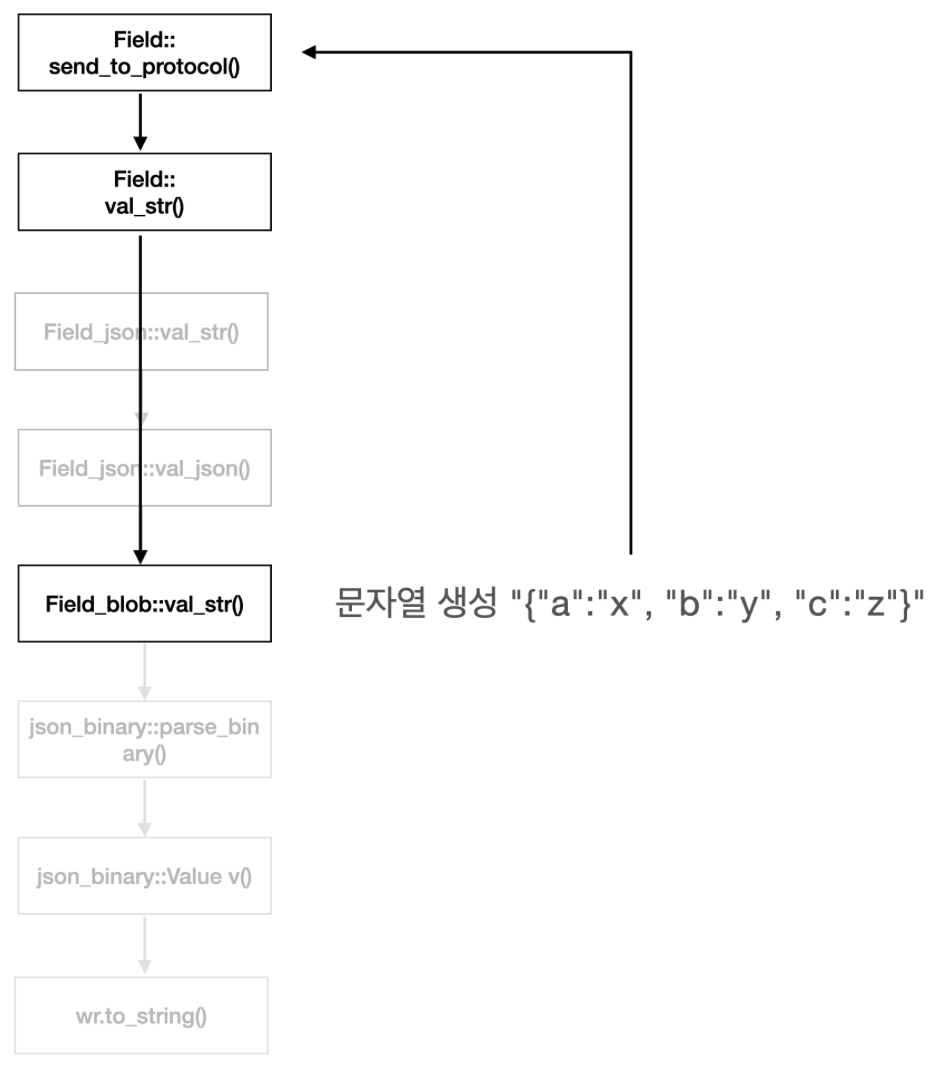
TEXT 데이터 타입은 다음 그림처럼 변환 작업 없이 추출하여 클라이언트에 전달합니다.
3. JSON / TEXT 데이터 타입에 따른 성능 비교
이제는 어떤 데이터 타입의 컬럼을 선택하느냐에 따라 어떤 성능 차이가 있는지 알아보려고 합니다. 필자는 해당 테스트를 위해 다양한 시나리오를 만들어서 테스트를 진행했는데요. 여기에 설명하면 너무 글이 길어지고 장황해질 수 있어서 진행한 테스트를 기반으로 중요한 내용만 정리해 보도록 하겠습니다.
3.1 TEXT 데이터 타입을 사용해야 하는 경우
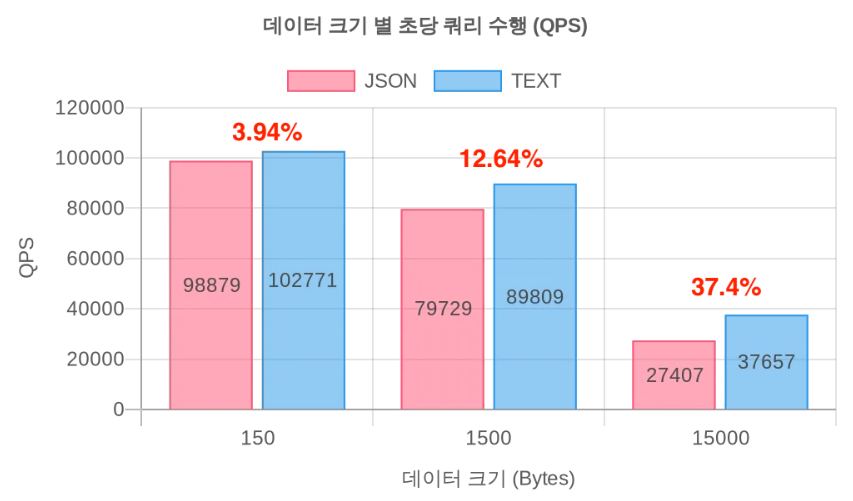
JSON 데이터를 저장하고, JSON 전체를 추출하는 등 단순 저장 및 읽기용으로 사용하는 경우에는 TEXT 데이터 타입이 성능적으로 더 유리합니다. TEXT 데이터 타입을 사용하게 되면 저장/추출 시에 직렬화/역직렬화 작업을 수행하지 않으므로 더 빠른 시간에 쿼리 수행을 완료할 수 있습니다. 물론 저장되는 JSON 데이터에 대한 Validation 체크는 할 수 없겠지만, Validation 체크는 Application 상에서도 할 수 있는 영역이기 때문에 단순 저장/추출만 한다면 TEXT 데이터 타입을 사용하는 것을 권장합니다.
[참고]
위 설명에서 ‘단순 조회’는 SELECT 시 별도 JSON 함수를 사용하지 않고 컬럼 전체를 읽는 쿼리를 의미합니다.
3.2 JSON 데이터 타입을 사용해야 하는 경우
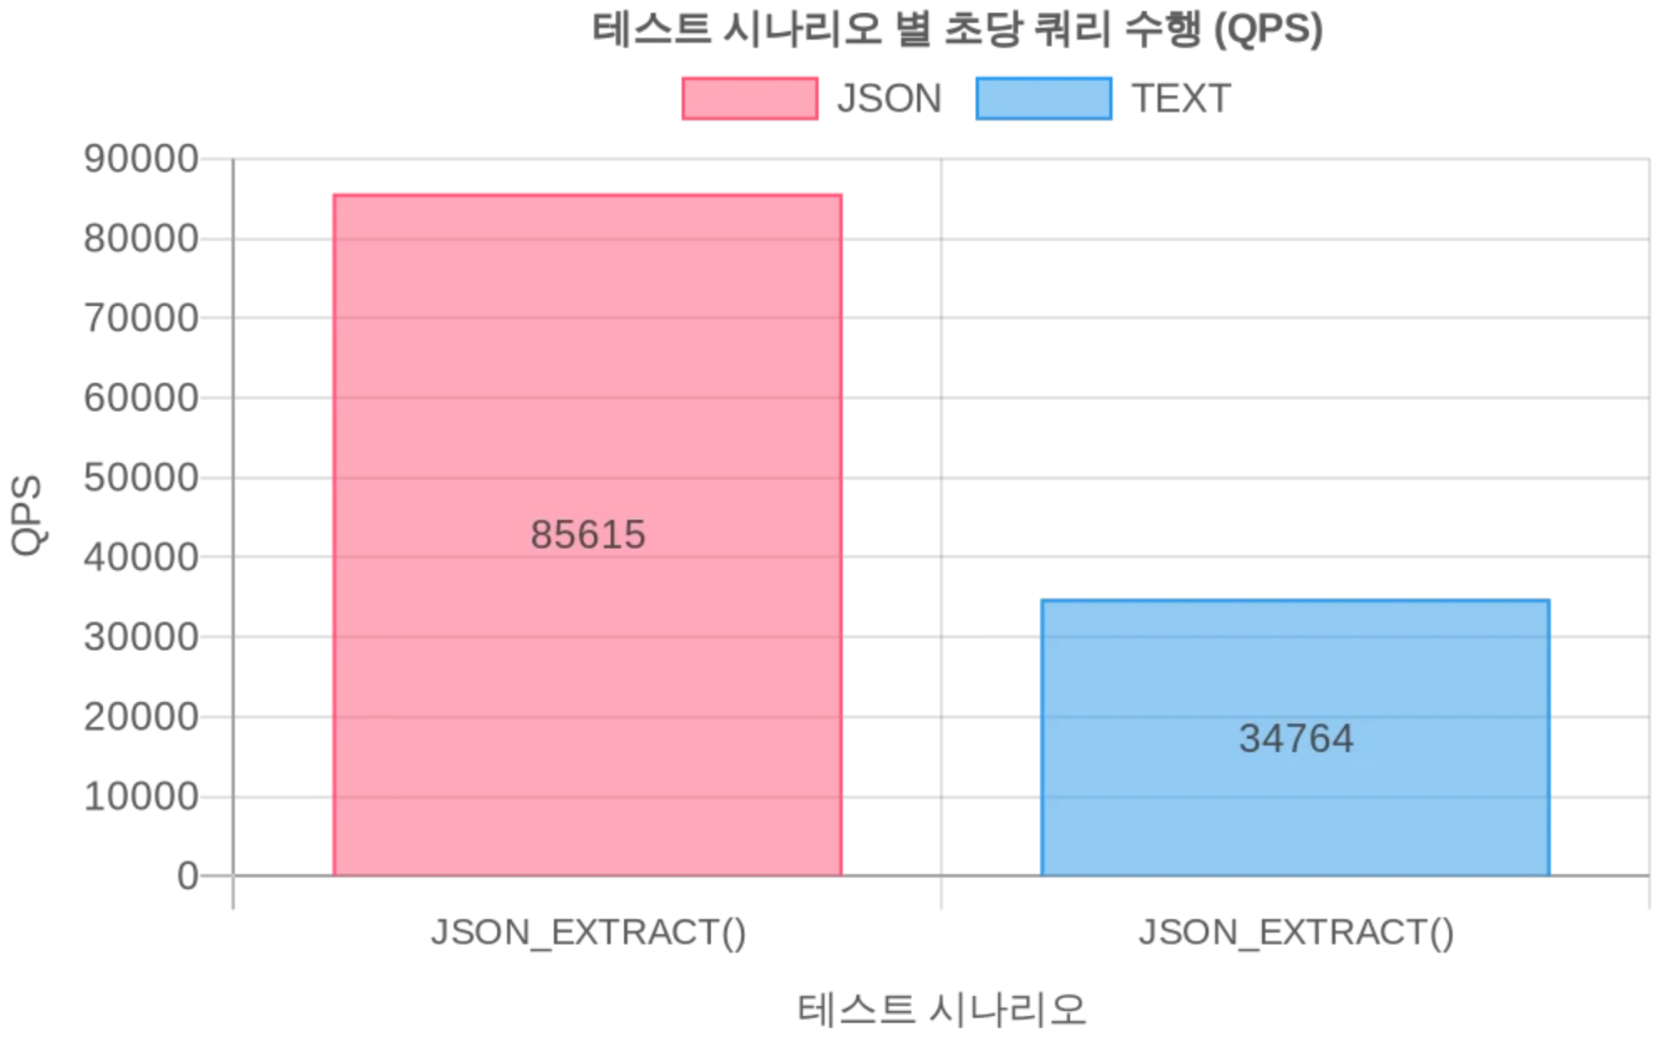
JSON 데이터를 저장/추출만 하는게 아니라, 여러 JSON 함수를 사용하여 가공 처리하는 경우에는 JSON 데이터 타입을 사용하는 것이 성능 상 더 유리합니다. 특히, key를 사용하여 데이터를 추출하는 경우에는 전체 JSON 데이터를 추출하는 것보다 훨씬 더 좋은 성능을 보여준다는 것을 확인할 수 있습니다. 대표적인 함수 JSON_EXTRACT() 사용 시 쿼리 성능을 비교해 보면 다음과 같이 큰 차이가 있음을 확인할 수 있습니다.
[참고]
TEXT 타입 컬럼도 JSON 함수를 사용할 수는 있습니다. 다만, 그래프에 나타난 것처럼 JSON 타입 컬럼에서 JSON 함수를 사용할 때 훨씬 더 좋은 쿼리 성능을 보여줍니다.
그래프는 SELECT절에 JSON_EXTRACT() 함수를 사용하여 조회했을 때의 QPS를 나타냅니다. 다른 JSON 함수의 경우 결과가 다를 수 있으니 참고 바랍니다.
4. 마무리
MySQL / InnoDB Storage Engine을 사용하는 OLTP성 환경의 DB에 JSON 데이터 사용이 필수는 아니지만, 과거에 비해 많이 보편화되고 있습니다. 이러한 환경 변화에 맞춰, 이 문서에서 JSON 데이터의 효율적인 저장과 활용 방안을 내부 저장 구조 및 프로세스 분석을 통해 정리하였습니다.
어떤 상황에서나 적용되는 완벽한 '정답’은 없지만, 기술적 원리를 이해한다면 분명 '최선의 선택’은 할 수 있습니다. MySQL에서 JSON 데이터를 어떻게 다루어야 할지 고민하는 분들께 이 문서가 실질적인 해답을 찾는 데 도움이 되길 바랍니다.