Engineering
Gen AI를 활용한 리뷰 하이라이트
갈렙Caleb(이상훈) / Business Insight팀여기어때
2024년 10월 18일
원문에서 보기 ↗
안녕하세요 Business Insight팀 갈렙입니다!
여러분, 여행 갈 때 숙소 선택 정말 어렵죠? 🤔 수많은 리뷰를 일일이 읽어보기도 벅차고, 이 숙소만의 특별한 매력을 바로 알기란 쉽지 않잖아요. 이럴 때, “어디가 좋을까?” 고민하다가 지쳐버리기도 하구요. 그런데, 만약 누군가가 중요한 리뷰만 쏙쏙 뽑아서 이 숙소의 진짜 매력과 꿀팁을 바로 보여준다면 어떨까요? 🏨✨ 그래서 Business Insight팀은 Microsoft Azure OpenAI 모델을 사용해 생성형 AI로 리뷰를 분석하고, 숙소의 핵심 포인트와 꿀팁을 자동으로 추출하는 시스템을 만들었어요!
이제 사용자는 긴 리뷰를 헤매지 않아도, 숙소의 장점과 특장점을 한눈에 알 수 있답니다. 이걸 통해 숙소의 매력도를 한껏 높여서, 여러분이 더 쉽게
‘이거다!’ 싶은 숙소를 찾을 수 있게 도와드리려고 해요.
이번 글에서는 저희가 어떻게 데이터를 다루고, 모델을 개선해가며 이걸 가능하게 했는지 공유하려고 해요. 읽어보시고, “우리 회사가 이런 것도 한다니!”라고 자랑할 만한 기술이 됐으면 좋겠어요. 😎
리뷰 데이터, 정말 깨끗할까요? 📱
숙소를 선택할 때 가장 먼저 확인하는 건 무엇일까요? 아마도 숙소 사진을 보고, 위치를 확인하는 것이겠죠? 그런데 그 다음에는 자연스럽게 리뷰를 보게 됩니다. 다른 사람들이 남긴 리뷰를 보면 숙소의 실제 모습을 알 수 있을 것 같지만, 막상 읽어보면 몇 줄로는 부족한 느낌이 들 때가 많아요. 그래서 스크롤을 계속 내리게 되죠.
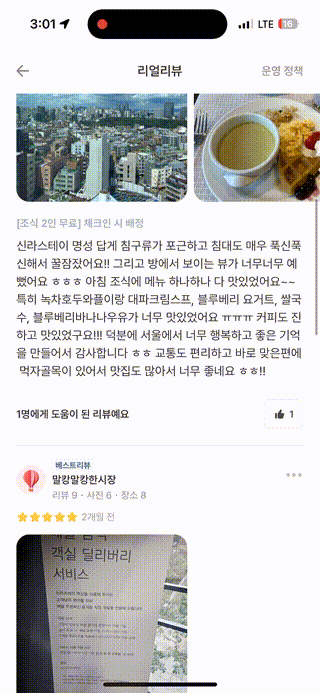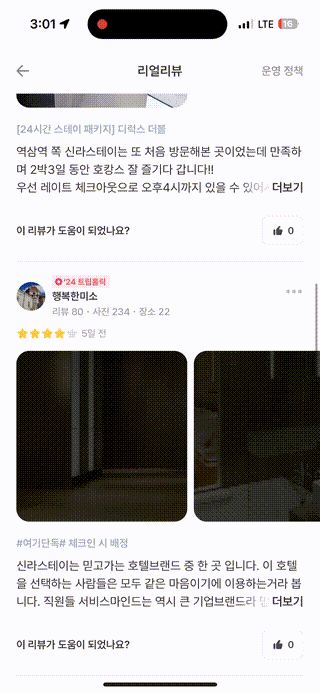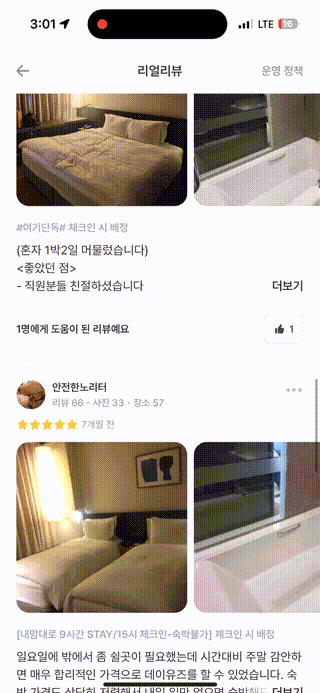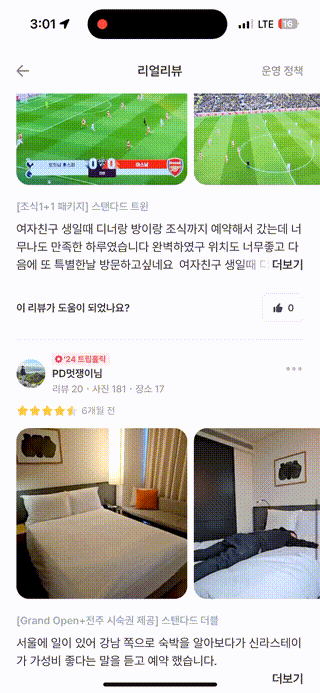
하지만 리뷰가 많아지면 너무 주관적이거나 중복된 내용 이 많아져서 중요한 정보를 놓치게 됩니다. 그래서 우리가 하는 첫 번째 작업은, 이 리뷰 데이터를 깔끔하게 정리하는 거예요. 그런데 어떻게 이 많은 리뷰를 효율적으로 정리할 수 있을까요?
텍스트 전처리로 리뷰를 깔끔하게! 🔍
여기서 중요한 개념이 바로 텍스트 전처리 입니다.
“텍스트 전처리”라니, 조금 어려워 보이지만 쉽게 말해 리뷰에서 불필요한 정보를 제거하고, 중요한 정보만 남기는 과정이에요.
예를 들어, “이 숙소 완전 최고! 정말 깨끗하고 방도 넓어요!!” 같은 리뷰에서 우리는 ’깨끗함 ’과 ’넓은 방’이라는 핵심 정보를 얻고 싶어요. 그런데 이런 리뷰에는 불필요한 감탄사나 반복되는 표현이 많아서, 이를 정리하는 과정이 필요합니다.
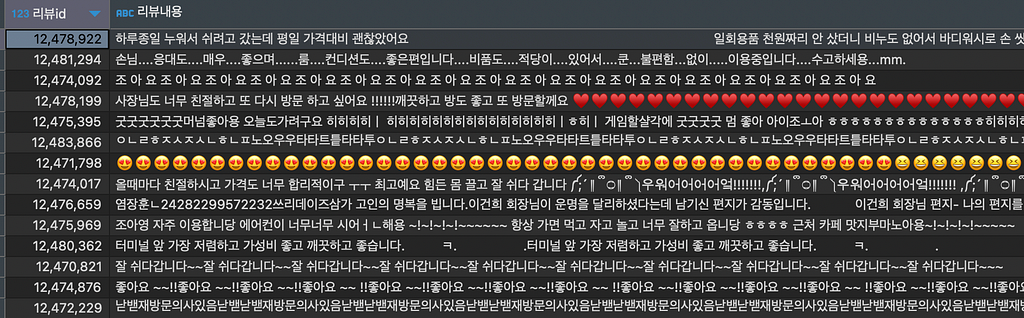
전처리 전 리뷰모습
우리는 리뷰 데이터에서 특수문자 , 반복된 단어 , 오탈자 등을 제거하여 텍스트를 깔끔하게 정리했어요. 이렇게 하면 리뷰가 더 명확해지고, 중요한 내용을 쉽게 파악할 수 있게 됩니다.
# 텍스트 전처리 함수: 특수문자, 반복문, 오탈자 등 제거
def normalize_text(text):
    text = ' '.join(text.split())
    text = re.sub(r'[^\w\s]', '. ', text)
    text = re.sub(r'(\b\w+\b)( \1)+', r'\1', text)
    text = re.sub(r'(.)\1{3,}', r'\1', text)
    text = re.sub(r'([ㅏㅑㅓㅕㅗㅛㅜㅠㅡㅣ]+|[ㄱ-ㅎ]+|[ㅏㅑㅓㅕㅗㅛㅜㅠㅡㅣ]+\s*)', ' ', text)
    return text
이 함수는 리뷰 데이터에서 불필요한 부분을 제거하고, 텍스트를 깔끔하게 정리해줘요. 처리된 결과는 이렇게 달라져요
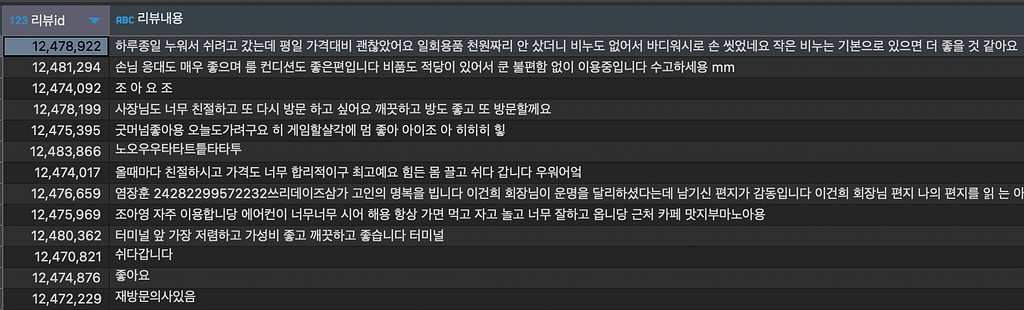
전처리 후 리뷰모습
“리뷰의 질을 높이고 신뢰할 수 있는 분석을 위해, 불필요한 텍스트를 전처리하고, 최신 50개 리뷰 중 100글자 이상인 것만 남겨, 리뷰가 충분히 있는 숙소들로 최종 데이터셋을 구성했어요.”
핵심 키워드 도출 과정 🔑
이제 전처리된 데이터를 바탕으로, 고객들이 가장 많이 언급한 특징들과 팁들 을 추출할 차례예요. 그런데 키워드가 너무 많고 다양하면 오히려 중요한 특징들이 잘 드러나지 않더라고요 . 🤔 그래서 우리는 키워드를 유형별로 분류해 보기로 했어요. 예를 들어, “전망”, “청결”, “분위기”, “객실” 같이 총 18개의 카테고리로 분류한 다음, 각 유형별로 가장 많이 언급된 키워드를 뽑아냈죠. 그리고 이 키워드들 중에서도 고객이 가장 먼저 고려할 만한 사항들이 잘 보이도록 우선순위를 정했어요. 여기서 중요한 역할을 한 건 바로 LLM(대형 언어 모델)이었어요. 이 모델은 복잡한 텍스트를 분석하고, 중요한 정보를 추출하는 데 큰 도움을 줬답니다.
LLM을 활용한 키워드 추출 🤖
LLM이란?
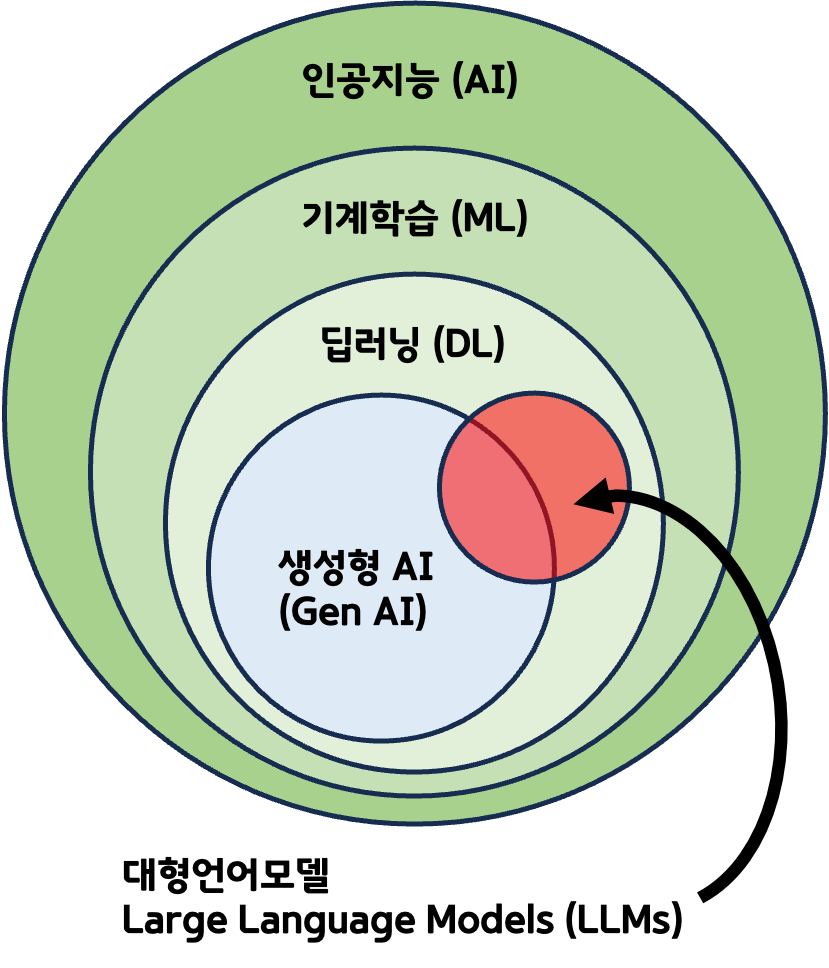
LLM은 AI(인공지능, Artificial Intelligence)의 한 종류로 특별히 언어와 텍스트에 특화된 기술이에요 AI가 큰 우산이라면 LLM은 그 아래의 특정도구라고 볼수 있어요. LLM은 대형 언어 모델(Large Language Model)의 약자이고, 수많은 데이터를 학습해 사람처럼 자연스러운 언어를 이해하고 생성할 수 있는 모델이죠. 우리가 사용하는 GPT-4 같은 모델이 대표적인 예입니다.
Azure OpenAI와 GPT-4-Turbo 활용하기
이번 작업에서는 Microsoft사의 Azure OpenAI 의 GPT-4-Turbo 모델을 사용했어요. 이 모델은 텍스트 분석에 뛰어난 성능을 발휘하는 최신 기술로, 고객 리뷰에서 중요한 키워드를 추출하는 데 정말 유용했답니다.
아래는 Azure OpenAI API를 사용해 간단한 질문을 던지고, 그에 대한 답변을 받는 예시 코드입니다.
import openai

# Azure OpenAI 설정
openai.api_type = "azure"
openai.api_key = "YOUR_API_KEY"  # Azure OpenAI API 키를 입력합니다.
openai.api_base = "https://YOUR_AZURE_ENDPOINT.openai.azure.com/"  # Azure OpenAI 엔드포인트를 입력합니다.
openai.api_version = "2024-05-01-preview"

# 간단한 질문과 답변을 수행하는 함수
def ask_question(question):
    response = openai.ChatCompletion.create(
        model="gpt-4-turbo",  # GPT-4 모델을 사용합니다.
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},  # 모델의 역할을 정의합니다.
            {"role": "user", "content": question},  # 사용자의 질문을 입력합니다.
        ]
    )

    # 모델의 답변을 반환합니다.
    answer = response['choices'][0]['message']['content']
    return answer

# 질문 예시
question = "Azure OpenAI 모델은 무엇인가요?"
answer = ask_question(question)

print("질문:", question)
print("답변:", answer)
모델에게 지시하기 : 프롬프트 엔지니어링 ✍️
프롬프트는 LLM에게 특정 작업을 지시하기 위한 명령어 같은 거예요. 모델이 정확한 결과를 도출할 수 있도록, 어떻게 질문을 던질지 설계하는 과정이죠. 예를 들어, 우리는 모델에게
“당신은 세계최고의 OTA에서 일하는 직원입니다. 숙소 이용 후기를 읽고 키워드를 추출해야 합니다.”
라고 role(역할)을 부여했어요. 이렇게 하면 모델이 더 정확하게 우리가 원하는 작업을 수행할 수 있어요. 아래는 키워드 추출에 사용된 프롬프트 엔지니어링 기법들이에요. 이렇게 세밀하고 정교하게 설계해야 고품질의 결과를 얻을 수 있어요.
[ # " 프롬프트 엔지니어링 "
  {    "1. 역할 부여 (Role Assignment)",
     ("모델에게 특정 역할을 부여하여 그 역할에 맞는 응답을 생성하도록 지시합니다."),
  "예시": "role: 'system', '당신은 세계최고의 OOO과 같은 OTA에서 일하는 직원입니다.'"},
  {    "2. Few-shot 학습 (Few-shot Learning)",
        ("프롬프트에 예시를 포함시켜 AI가 특정 형식이나 스타일로 응답하도록 합니다."),
  "예시":"content":
[   "|  분류 유형   |   내용 예시   |   형태    |",
    "|-----------|-------------|----------|",
    "|   전망    | 오션뷰, 시티뷰 전망이 좋은  | '~ 전망이 좋은', '야경이 멋있는'  |"},
  {    "3. 프롬프트 템플릿 (Prompt Template)",
         ("응답의 형식을 미리 지정하여 일관된 결과를 얻도록 하는 기술입니다."),
  "예시": "content:
           '결과는 JSON 형식으로 출력해주세요. JSON의 키는 분류 유형으로,
            값에는 추출한 키워드들을 넣어주세요.'"  },
  {    "4. 페르소나 (Persona)",
        ("특정 인격이나 성격을 부여하여 그에 맞는 응답을 제공하도록 합니다."),
  "예시": "당신은 OTA 직원으로, 고객에게 최고의 숙소를 추천하는 것이 목표입니다."  },
  {    "5. 출력 형식 지정 (Output Format Specification)",
        ("응답의 형식을 미리 지정하여 일관된 출력 형식을 제공받을 수 있습니다."),
  "예시": "response_format: 'JSON',
            content": "{'분류 유형': [추출한 키워드1, 추출한 키워드2...]}"  },
  {    "6. Chain of Thought (COT)",
        ("복잡한 문제를 단계별로 나누어 논리적으로 해결하는 방식입니다."),
  "예시": "후기를 읽고, 항목에 해당하는 내용을 순차적으로 분석하여 키워드를 추출해주세요."},
  {    "7. 명령 추가 (Additional Instructions)",
        ("응답에 영향을 미치는 추가적인 제약이나 지침을 제공하는 기법입니다."),
  "예시": "['한국어 맞춤법을 준수하여 키워드를 추출합니다.',
            '부정적인 내용이 포함되면 벌점을 받습니다.']"  }
]
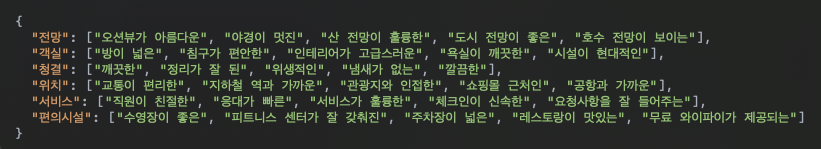
도출된 키워드 리스트(Json 형식)
대표 키워드 선정하기 🔍
이 렇게 추출된 키워드를 통해 각 숙소의 리뷰를 더욱 깊이 분석할 수 있었어요. 하지만 단순히 키워드를 추출하는 것에서 그치지 않고, 각 숙소의 특징을 가장 잘 나타내는 TOP 3 키워드를 선정하는 과정이 필요합니다.
키워드를 선정하는 과정은 우선 유형별로 키워드별 빈도수로 정렬한 후
  ano      | aname           | type   | keywords  | cnt
  ---------|---------------- |----- --|-----------|-----
  623434   | 호텔 피자 명동     | 전망    | 오션뷰가 좋은 | 2
  624434   | 호텔 피자 명동     | 객실    | 룸이 넓은    | 3
  809064   | 뉴시즈터 레지던스   | 청결    | 침구가 편안한 | 5
  809064   | 뉴시즈터 레지던스   | 위치    | 좋은위치     | 4
숙소의 핵심 가치를 보여주는 유형별로 우선순위를 고려하였어요. 핵심가치는 고객이 숙소를 선택할 때 가장 중요하게 여기는 요소들이에요.
TOP 3 키워드 선정📊
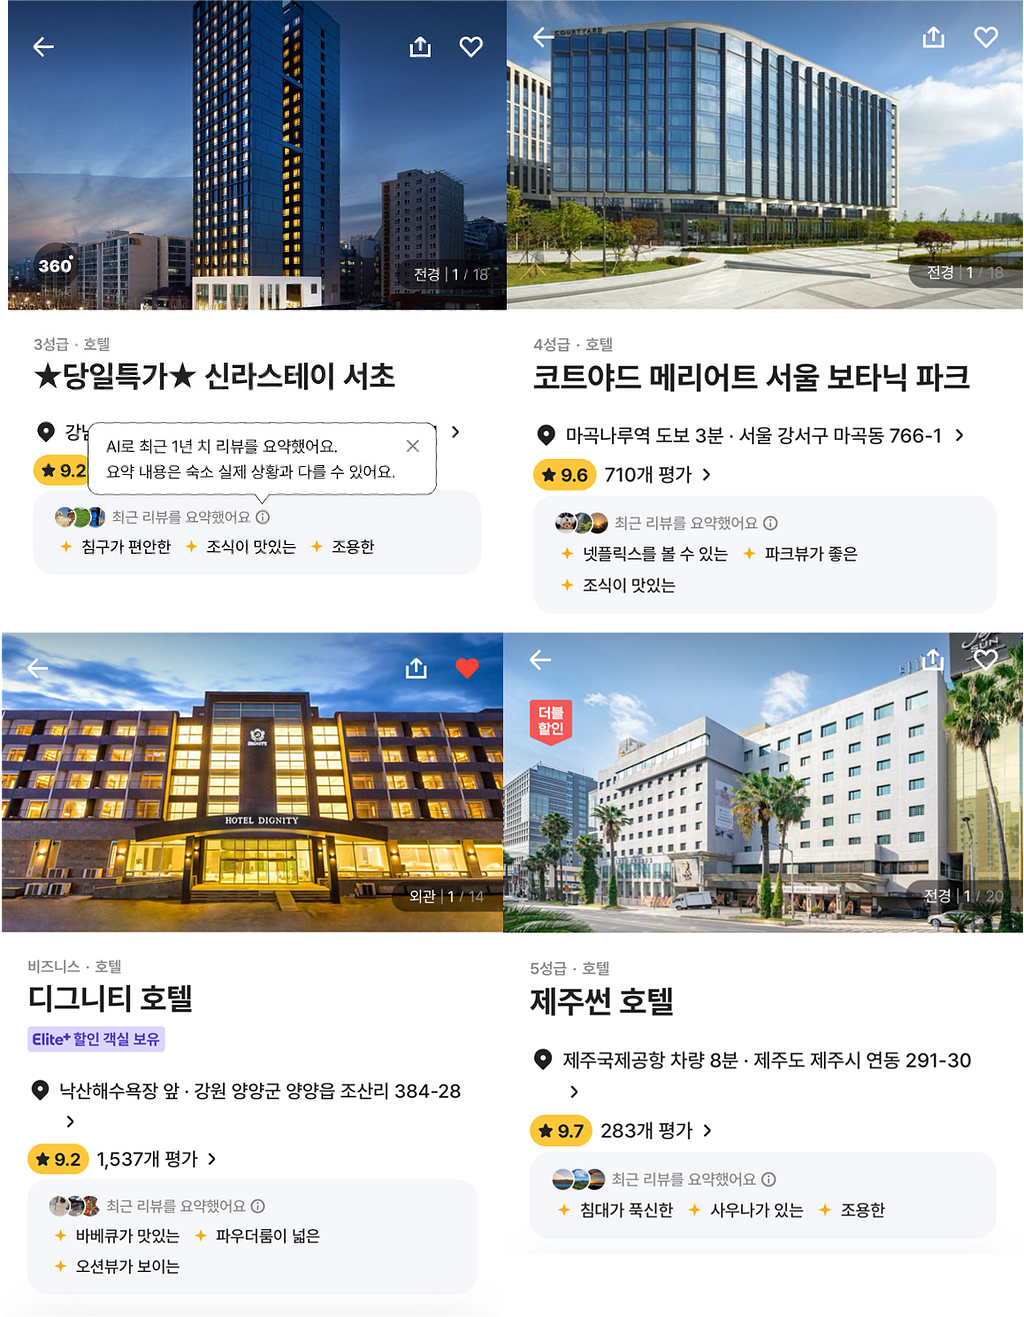
마지막으로, 이 모든 정보를 바탕으로 각 숙소별로 가장 중요한 3개의 키워드를 선정했어요. 이때 빈도수와 우선순위를 모두 고려해, 고객이 숙소의 매력을 빠르게 파악할 수 있는 키워드들을 뽑아냈습니다.
  ano      | aname                | keywords
  ---------|----------------------|------------------------------------
  623434   | 호텔 피자 명동          | ["오션뷰", "넓은 객실", "깨끗한"]
  809064   | 뉴시즈터 레지던스        | ["좋은 위치", "깨끗한", "편안한 침대"]
AI 모델 개선하기 🧠
물론 처음부터 이 모델이 완벽했던 것은 아니었어요. 프로젝트를 진행하면서 여러 가지 어려움 에 직면했는데요, 특히 LLM에만 전적으로 의존할 수 없다는 점 이 큰 도전이었어요. 처음에는 간단한 방법으로 키워드를 추출했지만, 원하는 만큼 정확하지 않았고 중요한 정보를 놓치는 경우도 많았어요. 그래서 수많은 시행착오 를 거쳐야 했죠. 총 5번에 걸친 모델 개선을 통해 점차 성능을 향상시킬 수 있었습니다.
이 과정에서 PO인 카야의 치밀한 기획과 검수가 큰 역할을 했어요. 👏
카야의 세심한 기획과 검토 덕분에 우리가 놓치고 있던 부분들을 발견하고 개선할 수 있었죠. 분석가와 기획자가 함께 기획 의도를 끝까지 구현하기 위해 끊임없이 노력했답니다. 아직까지는 LLM을 전적으로 의존하기보다, 사람의 판단과 조율이 필요하다는 것을 절실히 느꼈어요.
결국 이러한 노력의 결과로, 가장 좋은 성능을 보이는 모델을 선택하고 구현할 수 있었답니다! 🎉
실제 구현 모습 💻
실제로 구현된 모습은 이렇게 생겼답니다! 상품 페이지 상단에 이 정보를 배치해서 사용자가 숙소의 매력을 한눈에 파악할 수 있도록 했어요. 이제는 긴 리뷰를 일일이 읽지 않아도, 숙소의 핵심 가치를 쉽게 이해할 수 있답니다. 👀✨
마치며
이번 프로젝트를 통해 우리는 GPT 를 활용해 수천 개의 리뷰를 효율적으로 요약하는 모델 을 빠르게 구축할 수 있었어요. LLM(대형 언어 모델) 이라는 최신 기술의 가능성을 확인할 수 있었지만, 이 모델도 여전히 개선의 여지가 많답니다.
앞으로는 RAG (Retrieval-Augmented Generation) 과 LangChain 같은 최신 기술을 도입해 모델을 더욱 발전시킬 계획이에요. 이를 통해 방대한 리뷰 데이터 에 대한 처리 효율성을 더욱 높이고, 다양한 형식의 리뷰 에 대해서도 일관된 요약 을 제공할 수 있도록 고도화할 예정입니다. 이러한 기술적 향상을 통해 사람의 개입을 현저히 줄이고 , 더 높은 정확도의 리뷰 요약을 제공할 수 있을 것으로 기대됩니다. 📈
또한, 템플릿 작성 등을 통해 작업 효율성을 극대화 하고, 휴먼 리소스의 부담을 줄이는 방안 도 모색하고 있습니다. 이를 통해 분석가와 기획자는 더 창의적이고 전략적인 업무에 집중할 수 있게 될 거예요. 🛠️✨
앞으로도 Business Insight팀은 최신 기술을 지속적으로 도입 하고, 사용자에게 더 나은 서비스를 제공하기 위해 끊임없이 발전해 나갈 것입니다. 많은 기대 부탁드려요! 🌟
이렇게 해서 AI를 활용해 리뷰에서 핵심 정보를 추출 하고, 이를 통해 사용자에게 더 나은 서비스를 제공하는 방법을 소개해 드렸습니다. 기술적인 내용이 조금 있었지만, 최대한 쉽게 설명하려고 노력했어요. 읽어주셔서 감사합니다! 😊