Engineering
AI 번역의 시대1: 세태(世態)
2026년 9월 14일
원문에서 보기 ↗
세태(世態), 사람들의 일상생활
지금 바로 클로드에 접속해, 문장 하나를 쓰고 "영어로 번역해줘"라는 프롬프트를 날려보세요. 어떠한 길이의 문장이나 표현이든지 빠르게 번역하고, 더 나아가 문맥을 물으며 대안을 제시하기도 합니다. AI의 등장과 발전 덕분에 누구든지 외국어를 배우지 않고도 다른 언어권의 사람과 소통할 수 있는 시대가 되었습니다.
넷플릭스는 2026년 초에 공개한 주주 서한에서 콘텐츠 제작과 홍보 전 과정에 AI를 도입한다고 밝혔습니다. 자막 로컬라이제이션에 AI를 활용하여 보다 많은 시청자가 언어 장벽 없이 작품에 접근할 수 있게 하겠다는 것입니다. 유튜브는 2025년 9월, 2년간의 시험 운영을 마친 AI 다국어 더빙 기능을 전 세계의 크리에이터들에게 정식으로 출시했습니다. 화자의 억양과 톤까지 재현하는 음성 복제 방식인데, 이 기능을 쓴 채널은 전체 시청 시간의 25% 이상이 원어가 아닌 다른 언어권에서 나왔다고 합니다. 또한 올해 3월에 출시된 삼성 갤럭시 S26에서는 오버레이 번역이라는 기능이 추가되었습니다. 카메라로 메뉴판을 비추면 원문이 있던 자리에 그대로 번역문을 그려 넣는 방식입니다. 화면뿐 아니라 실시간 영상에도 번역 결과가 따라다닙니다.
즐겨 이용하는 콘텐츠, 업무 등 우리들의 일상생활 곳곳에서 AI 번역이 이루어지고 있습니다. 번역가인 저도 이 흐름을 직접적으로 겪고 있습니다. CAT(Computer-Assisted Translation) 툴로 번역 업무를 하던 저 역시 클로드나 제미나이를 활용해 번역 업무를 수행하는 횟수가 늘어났습니다. 특히 짧은 문장이나 일정이 급한 작업은 클로드에 업로드한 번역 지침과 용어집(글로서리)를 참고해 AI가 번역하고 인간이 검수하는 경우가 많아졌습니다.
AI 번역의 정확도가 완벽하지 않은 경우도 있지만 생산성과 속도가 어마무시하기에 저의 일손을 크게 돕고 있습니다. AI 번역은 신기한 것을 넘어서서 우리의 자연스러운 일상이 되어가고 있는데요. 그렇다면 어떻게 AI가 사람의 언어를 자연스럽게 번역할 수 있게 되었을까요? 그 이면에는 나름 복잡한 체계가 작동하고 있습니다.
AI의 번역 방식
LLM, 다음 토큰을 예측하다
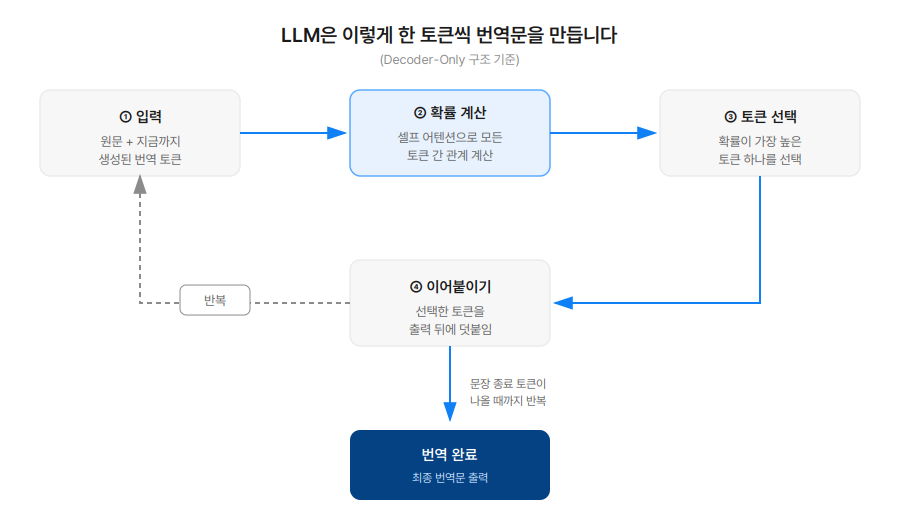
현재 가장 널리 쓰이는 AI 번역은 클로드·GPT·제미나이 같은 범용 대규모 언어모델(Large Language Model, LLM)에 "번역해줘"라고 프롬프트로 시키는 방식입니다. LLM 입장에서는 "번역"이 특별한 작업이 아닙니다. 그저 "번역해줘: [원문]"이라는 텍스트 뒤에 자연스럽게 이어질 토큰을 계속 예측하는 것으로서 모델이 원래 하던 동작과 동일합니다.
번역을 잘하는 이유
번역을 따로 가르친 적이 없는데도 이걸 잘 해내는 이유는, 학습 과정에서 같은 개념을 여러 언어로 설명하는 방대한 텍스트(위키백과, 다국어 웹 문서 등)를 함께 접했기 때문입니다. 언어 간 대응 관계를 명시적으로 배운 게 아니라, 방대한 데이터 속에서 암묵적으로 습득한 결과인 셈입니다.
여기에는 구조적 차이도 하나 있습니다. 파파고 같은 기존 신경망 기계번역(Neural Machine Translation, NMT)은 원문을 읽는 인코더와 번역문을 쓰는 디코더가 분리된 Encoder-Decoder 구조인 반면, LLM은 원문과 번역문을 하나의 문맥으로 통째로 이어 처리하는 Decoder-Only 구조입니다. 이 구조는 인코더와 디코더를 따로 만들 필요 없이 디코더 하나만 깊게 쌓으면 되기 때문에 모델을 더 크게 키우기도 훨씬 수월하고, 정렬된 언어쌍 데이터 없이도 이 방대한 데이터를 그대로 학습에 쓸 수 있어 데이터 확보 면에서도 스케일링이 유리합니다.
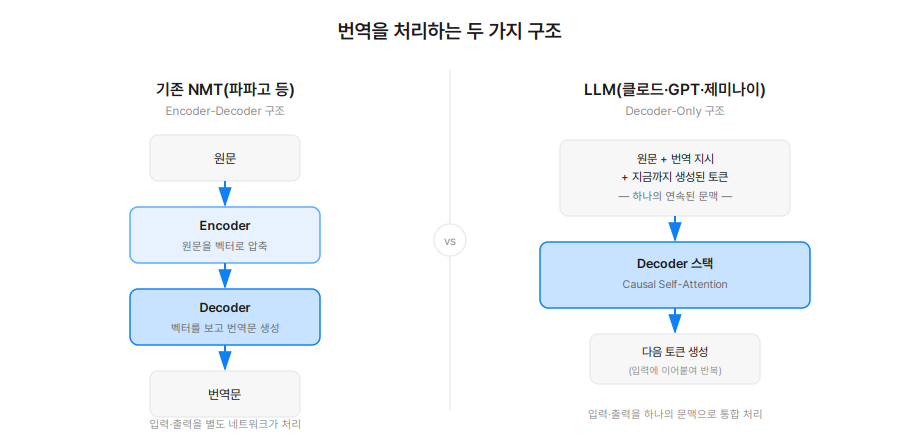
LLM의 동작 원리 자체는 단순합니다. LLM은 주어진 텍스트 다음에 올 토큰을 확률적으로 예측하고, 하나씩 이어 붙여 문장을 만듭니다. 이 동작을 뒷받침하는 게 문장 안의 모든 토큰이 서로 얼마나 관련 있는지 한 번에 계산해서, 지금 만들 토큰이 어디에 얼마나 주목 해야 하는지를 정하는 방식인 셀프 어텐션(self-attention)입니다. 사실 셀프 어텐션 자체는 LLM만의 원리가 아닙니다. 원조 트랜스포머(2017)를 쓰는 NMT도 인코더와 디코더 내부에서 각각 셀프 어텐션을 쓰고, 그 둘을 잇는 크로스 어텐션(cross-attention)까지 갖춘 구조입니다. 반면 LLM은 인코더도 크로스 어텐션도 없이, 원문과 번역문을 하나로 이어 붙인 뒤 인과적 셀프 어텐션(causal self-attention) 하나만으로 전체 관계를 계산합니다. 이 구조 덕분에 문장이 길어져도 정보가 희석되지 않고, 학습 속도도 비약적으로 빨라졌습니다.
NMT vs LLM
방금 살펴본 Encoder-Decoder(NMT)와 Decoder-Only(LLM), 즉 문장 단위 처리와 문서 전체를 하나의 문맥으로 처리하는 방식의 차이는 실무에서 아래와 같이 나타납니다.
| 기존 NMT | LLM 기반 | |
|---|---|---|
| 처리 단위 | 문장 단위 | 문서·대화 전체 |
| 지시 반영 | 파인튜닝 필요 | 프롬프트로 즉시 반영(In-Context Learning) |
| 일관성 | Constrained Decoding으로 높은 확률로 강제 가능 | 문서가 길면 흔들릴 수 있음 |
| 속도 | ~100ms | NMT 대비 최대 20배↑ 느림(업계 전반 10~100배) |
속도 차이의 원인도 구조에 있습니다. 두 방식 모두 토큰을 한 개씩 순차 생성하지만, LLM은 매 토큰마다 훨씬 많은 레이어와 파라미터를 통과해야 합니다. 이전 토큰들의 연산을 재사용하는 KV 캐시 덕분에 매번 처음부터 다시 계산하지는 않지만, 문맥이 길어질수록 캐시 자체의 크기와 매 스텝 참조해야 할 범위가 함께 커져서 지연시간이 늘어납니다. 그래서 지연시간이 중요한 환경에서는 지금도 NMT가 쓰입니다. 이런 신경망 기반 번역 기술은 오늘날 전문 번역가들이 쓰는 CAT 툴에도 결합되어 있습니다.
지금까지 살펴본 것처럼, AI는 문맥을 읽고 어디에 주목할지 계산해가며 그럴듯한 번역문을 만들어냅니다. 하지만 엄밀히 말하면 이것은 번역이 아니라 학습된 패턴에 기반한 확률적 추측에 가깝습니다. 그리고 그 추측이 언제나 옳은 것은 아닙니다.
2편, 오착(誤錯)에서 이어집니다.
