Engineering
AI 에이전트로 카카오톡 추천 지표 분석 자동화하기
rupert.kim카카오
2026년 6월 16일
원문에서 보기 ↗AI 에이전트로 카카오톡 추천 지표 분석 자동화하기: Hadoop 기반 도입 사례
안녕하세요. 소셜추천엔진팀에서 숏폼 추천 모델을 개발하고 있는 루퍼트(rupert)입니다.
추천 시스템을 개발하다 보면 코드를 짜는 시간만큼이나 데이터를 들여다보는 시간이 길어집니다. 지표가 조금만 움직여도 “이번 주 CTR이 왜 떨어졌지?”, “실험군 반응은 어땠지?”, “배포 이후 특정 사용자군에서 달라진 점은 없을까?” 같은 질문이 이어집니다.
질문은 한 문장이지만, 답을 얻기까지는 매번 비슷한 절차를 반복해야 합니다. 분석 환경에 접속하고, 적절한 테이블을 찾고, 쿼리를 작성하고, 결과를 해석한 뒤 다시 관점을 바꿔 확인합니다.
이 글에서는 이 반복적인 데이터 분석을 AI 에이전트로 줄여본 경험을 공유합니다. 핵심은 새로운 분석 플랫폼을 만든 것이 아니라, 사람이 매번 수행하던 절차와 판단 기준을 AI가 읽을 수 있는 지침으로 정리한 것입니다. 사용자는 분석의 목적과 관점만 자연어로 설명하고, AI는 기존 Hadoop 환경 위에서 필요한 실행을 이어갑니다.
결론부터 말하면, 핵심은 AI에게 더 많은 권한을 주는 것이 아니라 사람이 알고 있던 분석 절차와 판단 기준을 에이전트가 읽을 수 있는 형태로 정리하는 것이었습니다.
1. 쉬운 질문도 분석까지는 오래 걸린다
분석 요청은 대개 명확한 문제의식에서 출발합니다. 지표가 왜 변했는지, 특정 실험군 반응은 어떤지, 최근 일주일 새 이상치가 있는지 확인하고 싶어 합니다. 그러나 질문이 단순하다고 해서 실행도 단순한 것은 아닙니다. 한 줄짜리 질문에 답하기까지는 보통 이런 단계를 거칩니다.
01 환경 세팅 → 하둡 클라이언트 설치, 인증(Kerberos)

02 정보 수집 → 어떤 하둡 클러스터·테이블에 데이터가 있는지 확인

03 쿼리 작성 → 지표 정의에 맞는 컬럼·기간·세그먼트 선택

04 쿼리 실행 → 명령어 입력, 결과 대기

05 결과 해석 → 수치 검토, 표·차트 정리, 인사이트 도출
분석 환경이 처음인 사람에게는 1번부터가 벽이고, 익숙한 사람에게도 3~5번은 매번 반복됩니다. 게다가 추천 분석은 종합 지표 하나로 끝나는 경우가 드뭅니다. "왜 떨어졌나"의 답은 보통 연령대별·카테고리별·시간대별로 관점을 바꿔가며 같은 절차를 여러 번 돌려야 보입니다.
이때부터는 데이터를 해석하는 시간보다 데이터를 준비하고 추출하는 시간이 더 길어지기 쉽습니다.
어렵진 않지만 손이 많이 가고 자주 해야 하는 일 — 이런 구조가 자동화의 가장 좋은 대상입니다. 첫 번째 목표는 사용자가 쿼리와 실행 절차를 직접 다루지 않아도, AI가 필요한 단계를 따라가며 초안 분석 결과를 만드는 것이었습니다.
2. AI에게 데이터 접근 방법을 가르치기
AI에게 "알아서 분석해줘"라고만 하면 좋은 결과를 기대하기 어렵습니다. 어떻게 데이터에 접근해야 하는지, 어떤 지표 정의를 따라야 하는지, 어떤 컬럼을 기준으로 집계해야 하는지 알 수 없기 때문입니다.
여기서 제가 택한 방향은, 새로운 분석 플랫폼을 만들거나 MCP 서버 같은 연동 계층을 새로 붙이는 것이 아니었습니다. 막혀 있던 지점은 실행 도구 자체가 아니라, 그 도구를 어떻게 사용해야 하는지에 대한 지식이었습니다. 하둡 클러스터에 접속하는 스크립트는 이미 팀에 있었지만, AI는 그 사용법을 알지 못했습니다. 결국 제가 한 일은 하나였습니다 — AI에게 하둡 클러스터에 접속해 데이터를 뽑는 방법을 알려준 것입니다.
그래서 사람이 매번 수행하던 절차를 스킬(Agent Skill)로 정리했습니다. 스킬이라고 하면 거창하게 들리지만, 실체는 'AI가 읽는 Markdown 문서(SKILL.md)'입니다 — "하둡에 접속하려면 이렇게, 쿼리를 실행하려면 이렇게"를 사람이 읽는 자연어로 적어둔 것이죠. 에이전트는 그 스킬을 따라 사용자 대신 접속·실행·정리합니다. 그리고 이 스킬들을 하나로 묶어 배포한 것이 사내 Hadoop 활용법을 담은 플러그인 hadoop-butler입니다. 동작 구조는 4단계로 단순합니다.
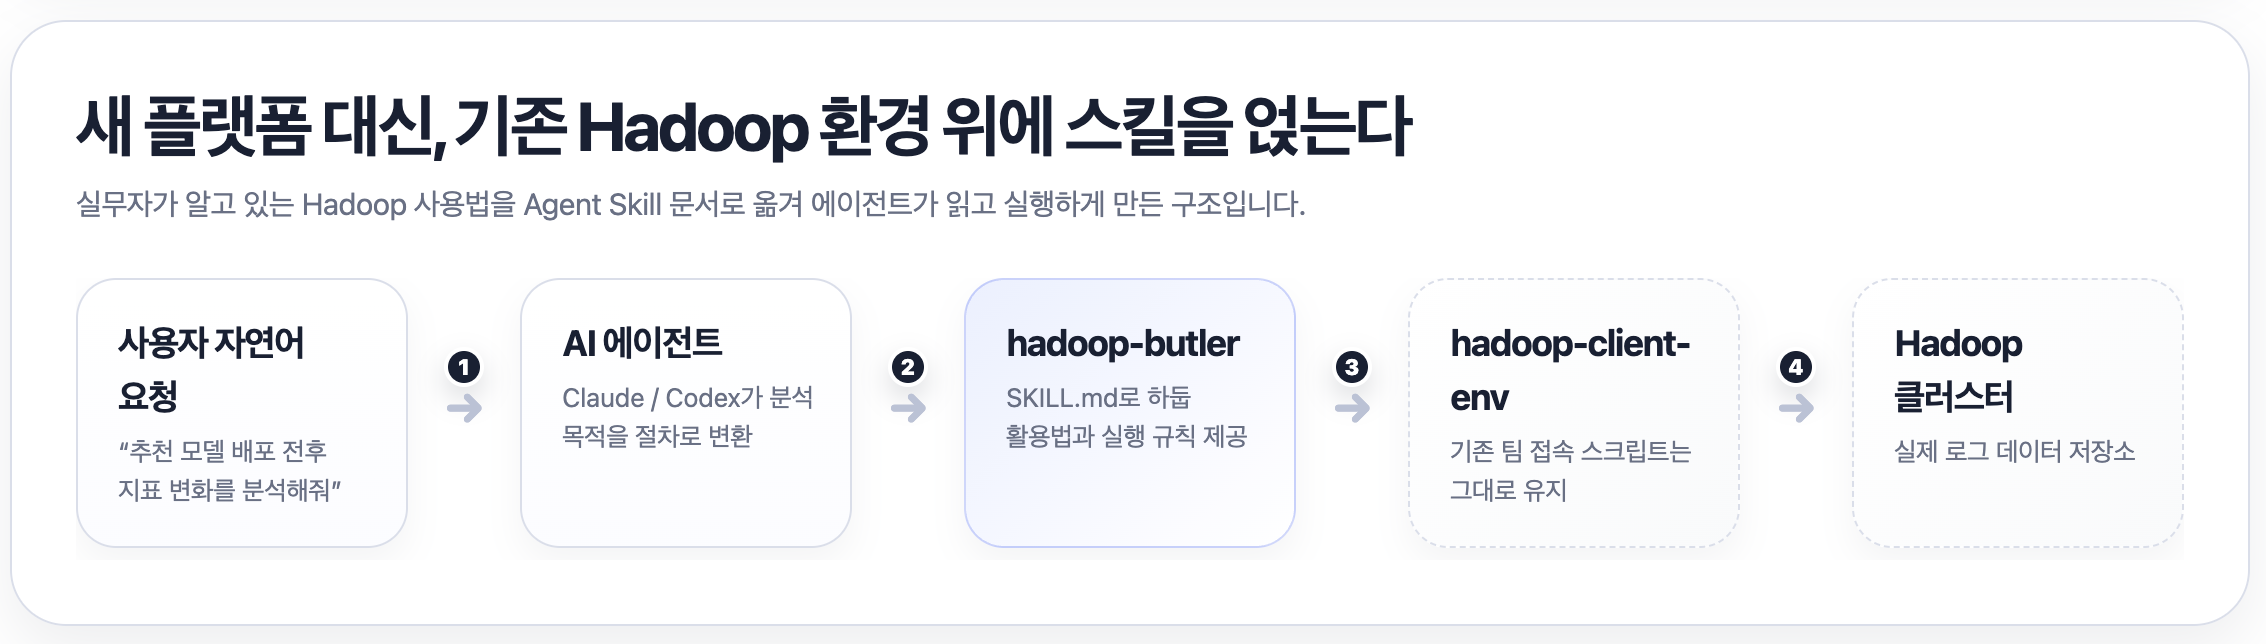
강조하고 싶은 판단이 하나 있습니다. 새 코드를 거의 짜지 않았다는 점입니다. 접속 스크립트는 손대지 않고, AI에게 "하둡에 접속하려면 이렇게, 쿼리를 실행하려면 이렇게 쓰면 된다"를 Markdown으로 적어준 것이 거의 전부입니다. AI는 이 지침을 읽고 로그 데이터에 접근해 SQL을 작성·제출하고, 결과에서 인사이트를 뽑아냅니다. 정리하면 hadoop-butler가 한 일은 — AI가 데이터에 접근해 분석을 할 수 있게 만든 것입니다.
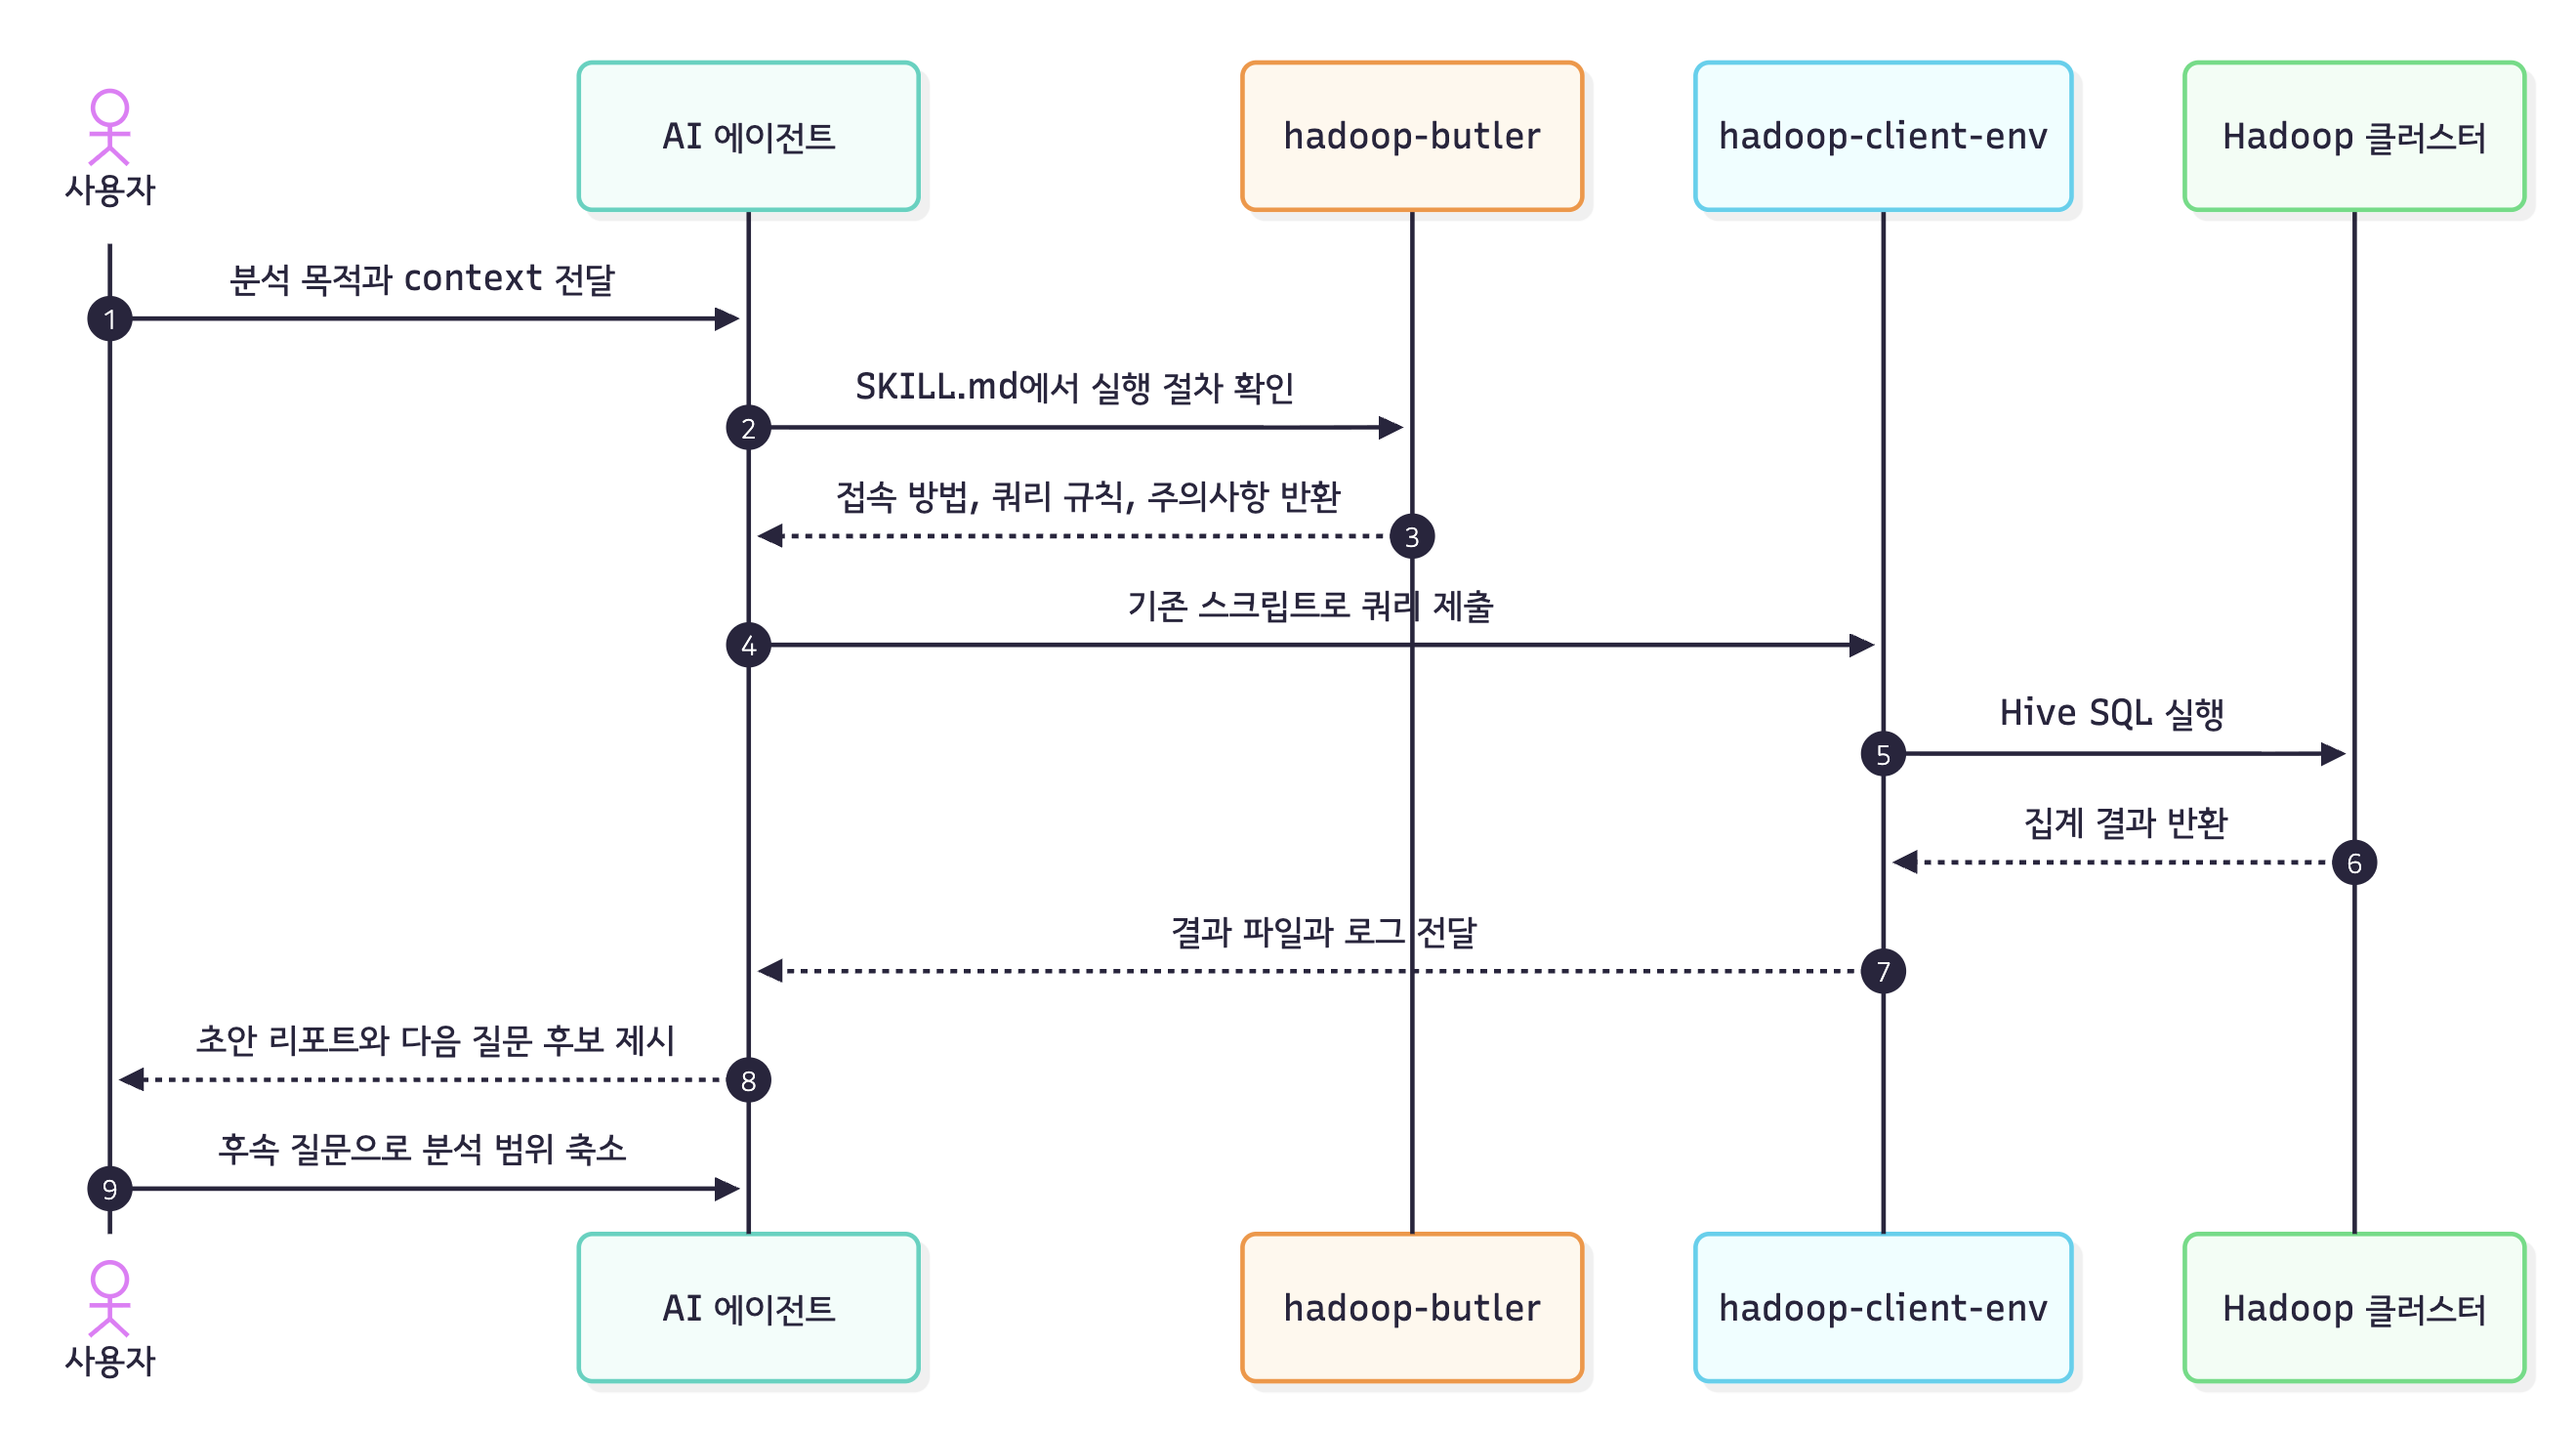
물론 지침만 써주면 끝나는 단순한 이야기는 아니었습니다. 정작 공이 든 곳은 그다음 — AI가 틀리지 않게 만들고, 그 동작을 검증 가능하게 만드는 일이었습니다.
발견 ① — AI를 일에 붙이는 가장 빠른 길은 새 시스템을 만드는 것이 아니라, 흩어져 있던 작업 절차와 노하우를 에이전트가 읽을 수 있는 스킬로 옮겨 기존 인프라에 접착제처럼 얹는 것이다. 이건 특정 도구가 없어도 어떤 반복 업무에든 그대로 적용된다.
3. AI가 데이터를 ‘오류없이’ 분석하게 만들기
AI가 데이터에 접근해 분석을 할 수 있게 됐다면, 두번째 목표는 분석을 잘하게 만드는 것입니다. 이 둘은 다릅니다. 접근할 수 있다는 것과 올바르게 분석한다는 것은 별개니까요.
여기서 가장 효과가 컸던 준비물이 컨텍스트 문서였습니다(Claude는 CLAUDE.md, Codex는 AGENTS.md). 분석할 디렉터리에 이 문서를 두고, AI에게 이 분석의 방향과 데이터의 세부 특성을 미리 일러둡니다. 담아두는 내용은 대략 이렇습니다.
-
분석 테이블과 클러스터
-
주요 피처의 의미 (예:
watch_length= 시청 시간,valid_view= 유효 조회 기준) -
사용자·세션 집계 기준
-
자주 쓰는 지표의 정의
이렇게 적어두면 AI가 같은 시행착오를 반복하지 않습니다. "어느 테이블에서, 어떤 기준으로"를 매번 다시 설명하지 않아도 되고, 같은 디렉터리에서 대화를 이어가도 맥락이 유지됩니다. 자연어 요청은 짧아지지만, 그 뒤에 놓인 지표 정의와 데이터 특성은 여전히 정확해야 합니다. 컨텍스트 문서는 그 정확성을 사람의 기억이 아니라 문서가 책임지게 하는 장치입니다.
이 작업은 AI를 위한 준비이면서, 동시에 팀의 데이터 지식을 정리하는 일이기도 합니다. 사람 머릿속에만 있던 내용을 문서로 옮기면, AI뿐 아니라 새로 합류한 동료도 같은 기준으로 분석을 시작할 수 있습니다.
발견 ② — 에이전트의 출력 품질은 컨텍스트 품질을 넘지 못한다. 모호한 정의, 비슷한 이름의 후보가 있는 곳일수록 명시적 기준을 문서로 못 박아 두어야 한다. 이것은 프롬프트 기교가 아니라 컨텍스트 엔지니어링의 문제다.
4. AI는 초안을 만들고, 사람은 질문을 이어간다
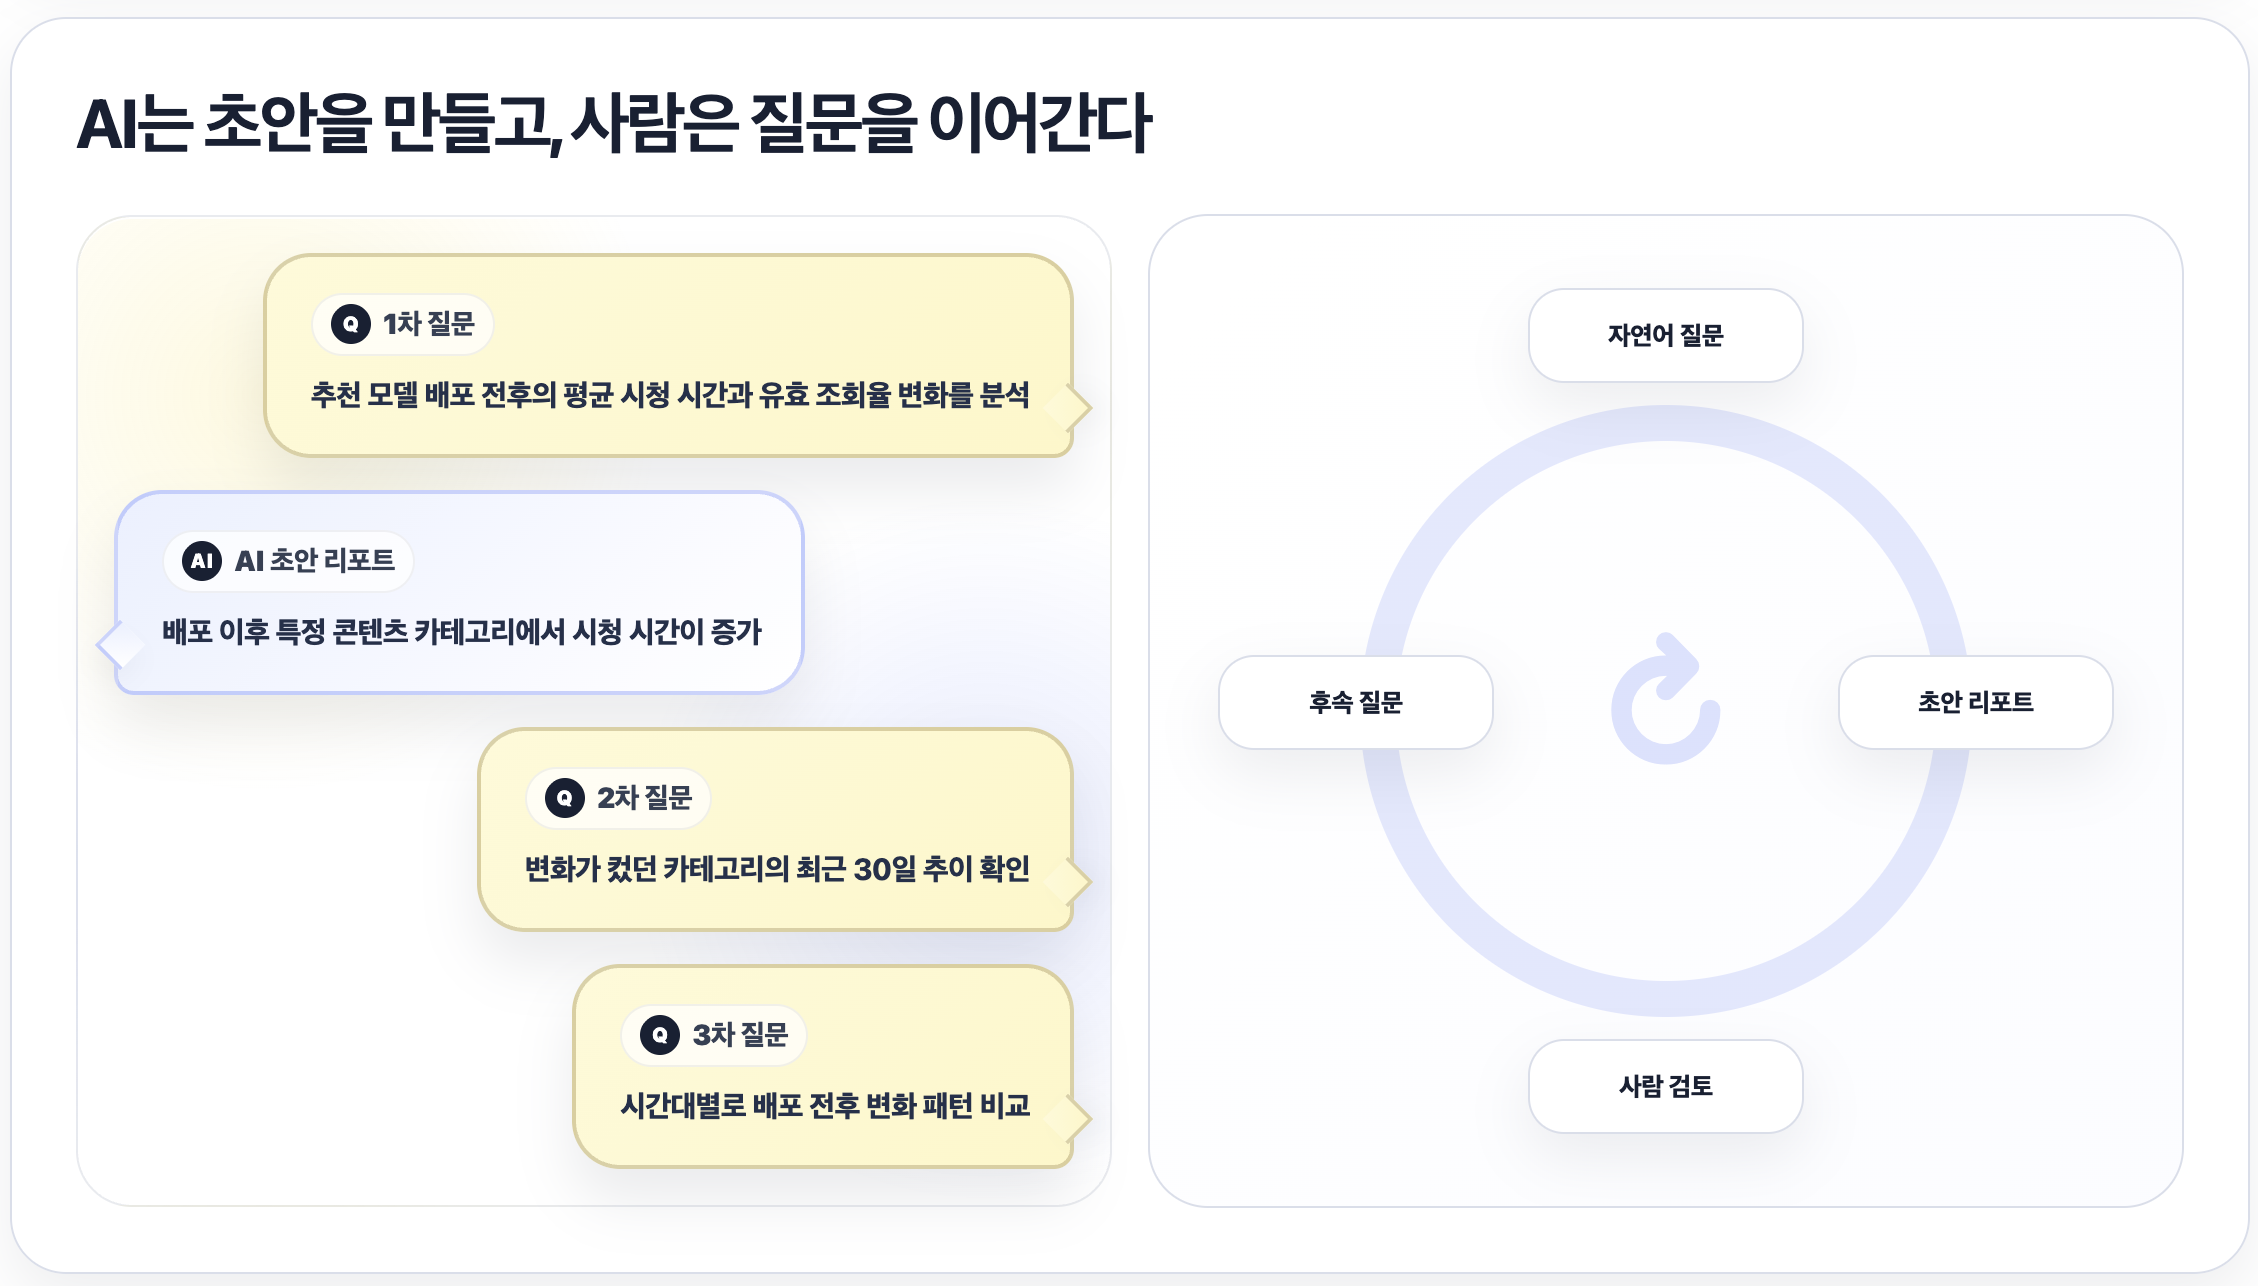
자연어 분석의 장점은 첫 결과를 빠르게 얻고, 이어지는 질문으로 분석을 좁혀갈 수 있다는 점입니다. 한 번의 요청으로 완성된 결론을 얻기보다, 초안 리포트를 보고 다음 질문을 던지는 방식이 더 잘 맞았습니다.
실무에서는 이상치 확인, 실험 결과 비교, 주간 현황 점검처럼 반복적으로 보는 분석에 특히 잘 맞았습니다. 기존 대시보드가 수치를 빠르게 보여준다면, 자연어 분석은 "어디를 더 봐야 할지"에 대한 후보를 함께 제시합니다. 이 후보를 사람이 검토하고 필요한 방향으로 질문을 이어가면 분석의 깊이가 좋아집니다.
다만 AI가 만든 리포트는 검토 대상이지 최종 결론이 아닙니다. 쿼리 기준, 컬럼 선택, 지표 정의가 맞는지 반드시 확인해야 합니다.
발견 ③ — AI는 초안을, 사람은 판단을 맡는다. 에이전트의 가치는 "정답을 한 번에 내는 것"이 아니라 "다음 질문의 후보를 빠르게 펼쳐주는 것"에 있다. 최종 해석과 의사결정은 여전히 사람의 몫이다.
5. AI는 그럴듯하게 틀린다
앞에서 "결과를 반드시 검토해야 한다"고 적었는데, 왜 그런지 구체적으로 보여드리는 게 좋겠습니다. AI가 만든 결과물의 까다로운 점은 — 대개 문법적으로는 맞다는 것입니다. 쿼리는 에러 없이 돌고, 잡(Job)은 정상으로 끝납니다. 문제는 업무적으로, 또 성능 면에서 틀릴 수 있다는 데 있습니다. 겪었던 두 가지를 풀어보겠습니다.
① 의미 오류 — 비슷하게 생긴 컬럼
사용자 수를 집계할 때는 계정 단위 식별자(user_id)를 써야 했는데, AI가 비슷하게 생긴 다른 식별자(세션 성격의 session_user_id)를 골라 집계한 적이 있습니다. 두 컬럼 모두 "사용자 ID"처럼 보였기 때문에, 결과 수치를 검증하기 전까지는 무엇이 잘못됐는지 알아채기 어려웠습니다. 쿼리는 완벽하게 동작했지만, 답은 틀렸던 거죠.
-- 잘못된 기준

COUNT(DISTINCT session_user_id)


-- 문서(claude.md)에 명시한 기준

COUNT(DISTINCT user_id)
② 성능 오류 — 문법은 맞지만 느린 쿼리
여러 컬럼의 고유값 개수를 한 번에 보려고, AI가 SELECT COUNT(DISTINCT a), COUNT(DISTINCT b), …처럼 다중 COUNT(DISTINCT)를 하나의 SELECT에 합쳐 작성한 적이 있습니다. 문법적으로는 완벽합니다. 하지만 Hive에서는 이 형태가 단일 리듀서로 처리되어 극단적으로 느려집니다. 사람이라면 "이건 컬럼별로 쪼개서 병렬로 돌려야지"라고 알지만, AI는 가장 자연스러운(=그럴듯한) 한 줄을 택합니다.
-- AI가 처음 작성한 형태

SELECT

COUNT(DISTINCT col_a),

COUNT(DISTINCT col_b),

COUNT(DISTINCT col_c)

FROM sample_table

WHERE dt BETWEEN '2026-05-01' AND '2026-05-07';
두 사례의 공통점은 분명합니다. AI는 가장 그럴듯한 선택을 하지, 가장 옳은 선택을 하지 않습니다. 그리고 그 차이는 SQL 의미론과 쿼리 엔진의 실행 특성을 아는 사람만이 알아챌 수 있습니다.
6. 어떻게 막았나 — 기준은 문서로, 검증은 테스트로
해결의 방향은 두 갈래였습니다.
첫째, 사람이 아는 기준을 문서에 못 박는다. 앞의 두 함정은 모두 "AI가 몰라서"가 아니라 “명시해주지 않아서” 생긴 일입니다. 그래서 컨텍스트 문서와 활용 지침에 기준을 한 줄씩 적어두었습니다.
## 집계 기준- 사용자 집계 시 반드시 user_id 사용

(session_user_id와 혼동 주의 — session_user_id는 세션 성격)
같은 원리로, 활용 지침에는 “모든 컬럼명은 백틱(`)으로 감싼다”(예약어 충돌 방지), “다중 COUNT(DISTINCT)는 컬럼별로 분리해 병렬 실행한다” 같은 규칙을 박아두었습니다. 이 한 줄을 적는 데 드는 10초가, 잘못된 결과를 뒤늦게 발견하고 되짚는 30분을 줄여줍니다.
둘째, 지침 자체를 회귀 테스트한다. 지침과 스킬이 늘어나자 새로운 문제가 생겼습니다. 프롬프트 한 줄을 고쳤을 뿐인데 전혀 다른 곳의 동작이 깨지는 일이 반복된 것입니다. 자연어 지침은 코드처럼 컴파일 에러로 잡히지 않으니, 깨진 줄도 모르고 배포하기 쉬웠습니다.
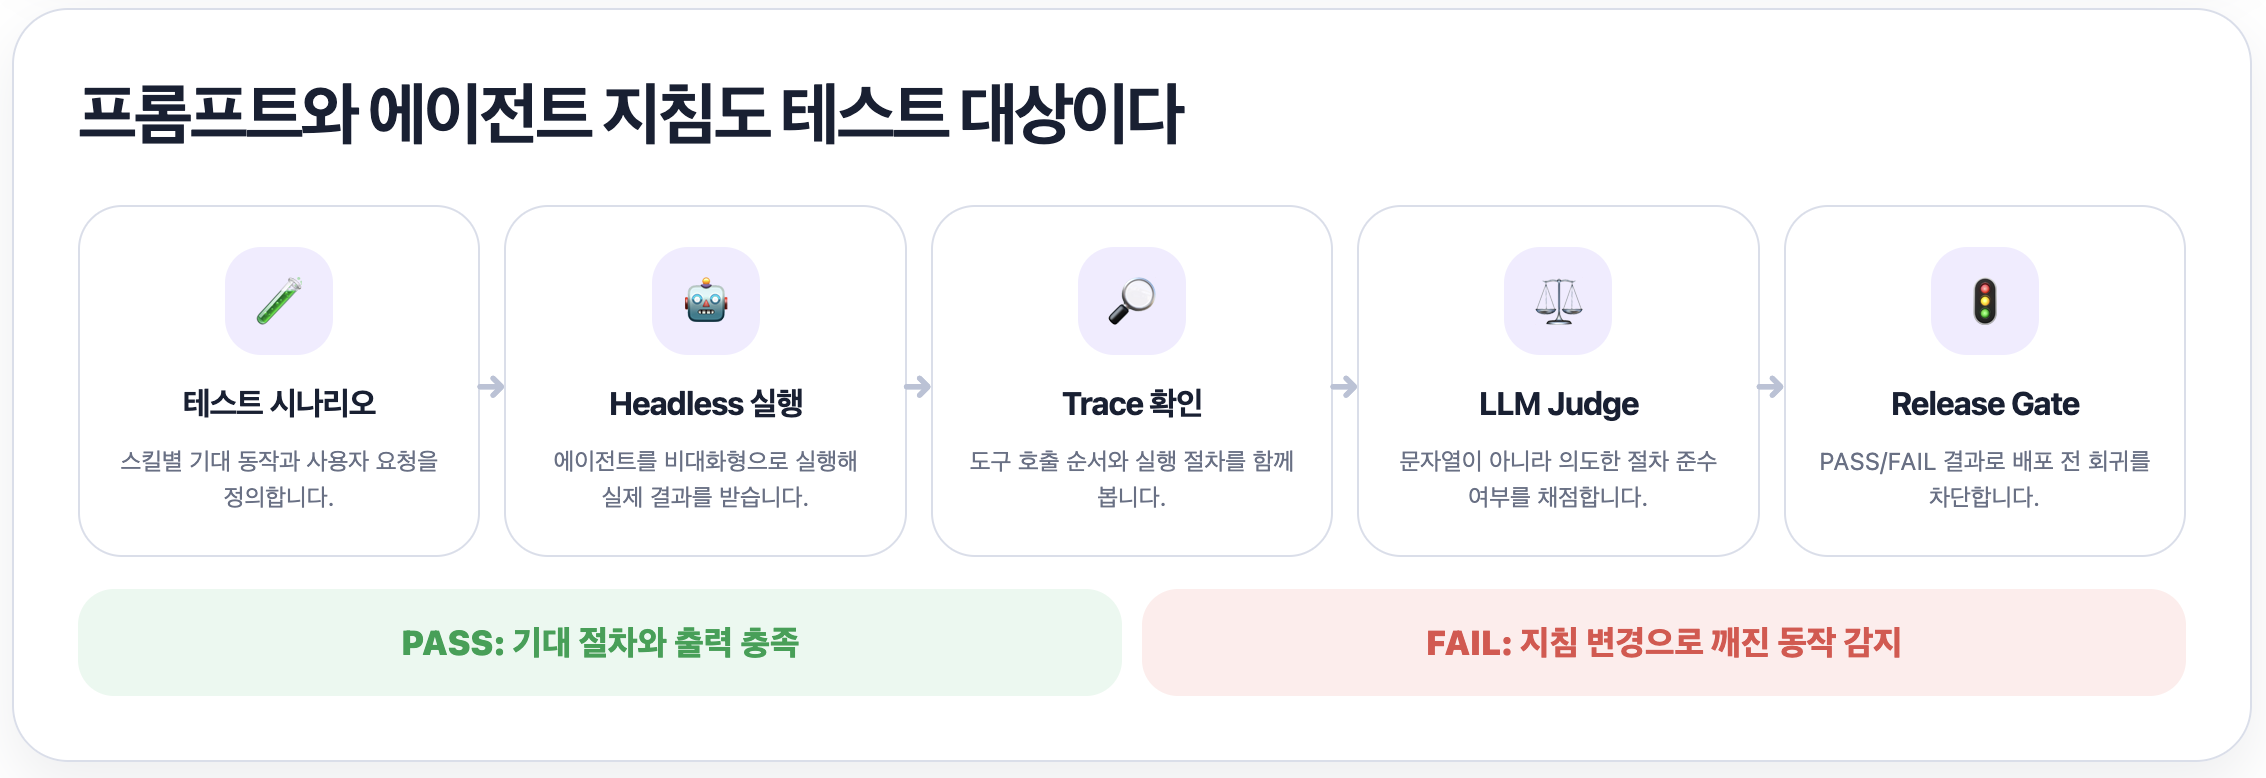
그래서 AI 산출물도 소프트웨어처럼 다루기로 했습니다. MLflow를 기반으로 E2E 자동 평가 파이프라인을 만들었습니다.
-
스킬별 기대 동작을 테스트 시나리오로 정의한다.
-
에이전트를 헤드리스(비대화형)로 실행해 실제 결과를 받는다. (
claude -p) -
그 결과를 다시 LLM Judge에게 채점시킨다 — 단순 문자열 매칭이 아니라 에이전트가 절차를 제대로 따랐는지를 본다. 어떤 도구를 어떤 순서로 호출했는지(Tool call), 실행 트레이스, 최종 출력을 차례로 짚는 다층 검증으로 PASS/FAIL을 매긴다.
-
배포 전 한 번의 명령으로 전체 시나리오를 회귀 검증한다.
덕분에 "지침을 고쳤더니 엉뚱한 스킬이 깨졌다"를 배포 후가 아니라 배포 전에 잡을 수 있게 됐습니다.
발견 ④ — 프롬프트와 에이전트 지침은 비결정적 소프트웨어다. 사람이 읽는 자연어라고 해서 테스트에서 면제되지 않는다. 오히려 컴파일러가 잡아주지 않기 때문에 회귀 테스트가 더 중요하다. AI를 일에 붙일 때는 "어떻게 시킬까"만큼이나 "어떻게 검증할까"를 함께 설계해야 한다.
7. 마치며
이번 작업은 Hadoop 분석이라는 구체적인 문제에서 시작했지만, 돌아보면 AI 에이전트를 업무에 붙이기 위해 필요한 요소를 하나씩 맞춰가는 과정이었습니다.
정리하면 핵심은 네 가지였습니다.
-
모델: 자연어 요청을 이해하고 분석 절차를 수행할 AI 에이전트
-
컨텍스트: 에이전트가 참고할 지침과 도메인 정의(테이블·피처·지표)
-
실행 환경: 실제 데이터에 접근하고 쿼리를 실행할 기존 Hadoop 환경
-
검증 루프: 결과와 실행 절차가 의도대로 동작했는지 확인하는 테스트 체계
AI를 업무에 붙인다는 것은 단순히 모델에게 일을 시키는 것이 아니었습니다. 모델이 참고할 컨텍스트를 만들고, 기존 실행 환경에 연결하고, 결과를 검증할 루프까지 함께 설계하는 일이었습니다.
중요한 것은 "AI가 알아서 해줄 것"이라고 기대하는 것이 아니라, 사람이 알고 있던 기준과 맥락을 AI가 읽을 수 있는 형태로 바꾸는 일입니다. 반복되는 절차가 있고, 그 절차를 잘 아는 사람이 있으며, 결과를 검증할 기준이 있다면 AI 에이전트는 새로운 플랫폼 없이도 꽤 실용적인 동료가 될 수 있습니다.