Engineering
HTML diff
2017년 12월 21일
원문에서 보기 ↗HTML diff란?
- MS워드의 '변경 내용 추적'기능처럼 HTML의 렌더링 결과 화면의 변경 부분을 탐지하고 해당 내용을 시각화하여 표시해주는 기능이다.
- HTML 텍스트에서 태그와 속성 데이터를 파싱하여 트리같은 자료구조로 구조화하고 구조화한 트리를 비교해서 변경 내용을 탐지한 뒤, 탐지한 변경 내용을 HTML 렌더링된 원문에 시각화하여 사용자에게 보여준다.
- 따라서 HTML 파서, HTML 구조화 기능(HTML → 트리), 트리 diff, diff 내용 시각화 기능을 구현해야 한다.
- 동작 시퀀스 다이어그램은 다음과 같다.
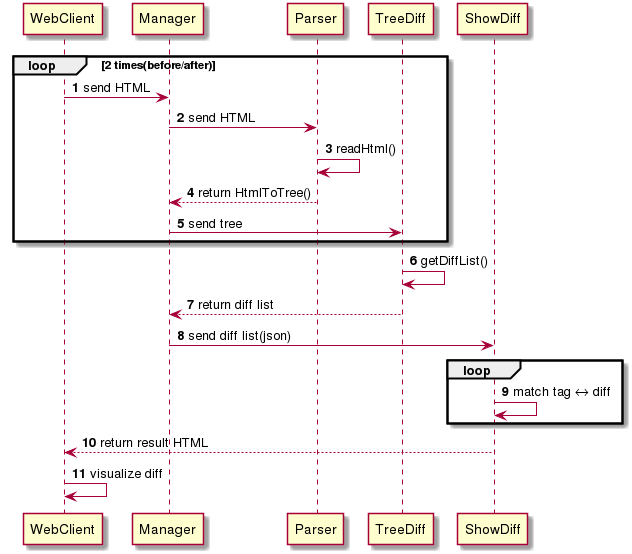
HTML 파서
HTML 파서로는 jsoup같이 잘 구현한 오픈 소스가 이미 있다. 그러나 특정 태그의 데이터를 파싱하는 데에는 적합하지만 모든 태그를 하나하나 탐색하기에는 적합하지 않다(.getNextNode()같은 함수 등 미구현). 따라서 직접 HTML 파서를 구현했다.
구현 과정
파싱에 앞서서 파싱 단위를 결정해야 한다. 한 줄씩 파싱하거나 하나의 문자열로 파싱하는 방법 두 가지가 있다.
- 먼저 한 줄씩 파싱하면 태그와 속성, 내용 등을 명확히 파싱할 수 있지만 한 줄에 여러 개의 태그가 있거나 script 태그의 자바스크립트 코드에서 개행이 이루어지는 등의 불확실한 케이스에 완벽히 대응할 수 없어서 사용하지 않았다.
- 전체 HTML 텍스트를 하나의 문자열로 보고 파싱하면 어떤 케이스든 파싱이 가능하기 때문에 HTML 파서에 적합하다. 그러나 HTML 텍스트가 길어질수록 성능 저하 문제가 발생한다. 성능 문제는 기능 구현 이후에 다시 다루기로 한다.
태그 타입은 '<', '>'를 기준으로, 태그 내용은 태그 타입을 기준으로, 속성값은 '='과 '"'을 기준으로 파싱한다. 즉 인덱스를 바탕으로 파싱하기 때문에 String 클래스에 절대적으로 의존한다. 따라서 HTML 텍스트가 길면 길수록 성능이 저하된다(.split(), .substring() 등 String의 성능 문제). 인덱스를 바탕으로 파싱하다 보니 조금만 차이가 나도 파싱에 오류가 생겨서 처리할 예외들이 많이 생겨서 JUnit을 사용하여 TDD개발로 전환했다.
TDD개발, 예외 처리
- 각각의 데이터(태그 타입, 태그 내용, 속성(attribute, value))의 추가/삭제/변경을 조합한 약 12개의 테스트 케이스로 시작했고 약 25개로 테스트 케이스를 늘려가며 예외 처리를 보강했다. 그러나 직접 추가하는 테스트 케이스는 심각한 예외는 잘 못잡아서 실제 웹 HTML을 테스트 케이스로 추가했다.
- 많은 예외가 발생했지만, 그 중 가장 까다로웠던 것은 script 태그다. script 태그 내용에 또다른 HTML 텍스트가 포함되어있으면 파싱이 원활하게 진행되지 않는 문제가 발생했다. 그래서 아예 script 태그를 만나면 끝 태그(end tag)까지의 텍스트를 무조건 script 태그의 태그내용으로 파싱하는 방법으로 예외 처리하고, script 태그도 원활히 파싱하게 됐다.
- 사용자의 예기치 못한 오타를 방지하기 위한 예외도 고려했다.
<p/>와 같이 슬래시가 뒤에 오는 경우나<s/cript>와 같이 오타가 난 경우도 파싱할 수 있도록 정규식을 통하여 슬래시 위치를 정상적으로 바꾸는 방법을 적용했다. - 마찬가지로 공백을 데이터로 인식하는 경우도 정규식으로 예외 처리했으며, 렌더링 결과에 영향을 주지 못하는 주석 또한 파싱 전에 미리 정규식으로 삭제하는 방법으로 예외 처리했다.
성능 문제
- 직접 구현한 HTML 파서의 성능은
String클래스에 절대적으로 의존한다. 따라서 HTML 텍스트의 길이와 걸리는 시간은 비례한다. - 오픈 소스 jsoup보다 성능이 나쁜 것을 확인하고, 성능 개선을 위해 코드를 검토했다.
성능 개선 작업
String 클래스 의존도 완화
- 파서에서 주로 사용하는
String클래스의 함수는.indexOf(),.replace(),substring()가 있다..indexOf()함수는 성능에 영향을 주지 못하는 것을 확인했고,.replace()함수와.substring()함수는 개선이 필요했다.
.replace() 함수
String클래스의.replace()함수는 정규식으로 구현돼서 문자열의 길이가 길면 느려진다. 성능을 개선한 다른 함수들과StringBuilder클래스의 함수를 사용한 경우들과 성능을 비교했다.- 결과는 다음과 같다.
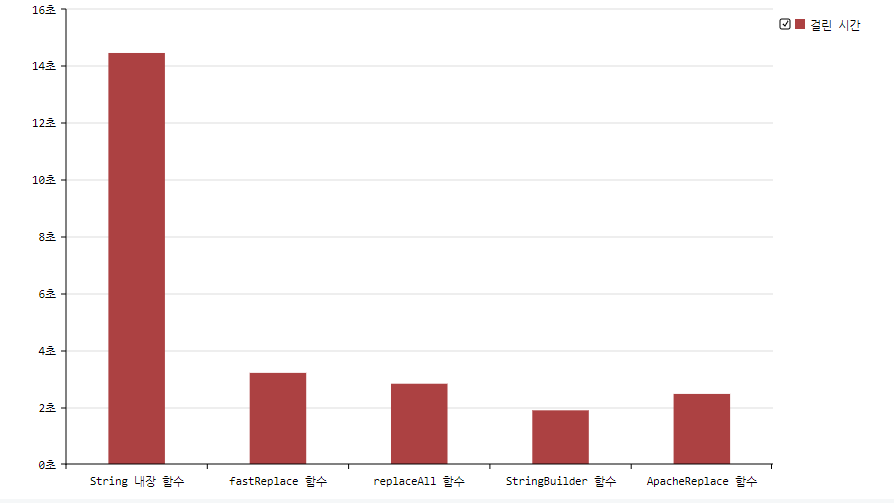
String클래스 내장 함수가 가장 느렸고, 따로 구현된 함수들은 비슷한 성능을 보였다. 하지만 가장 빠른 함수는StringBuilder클래스 함수였다.String에서StringBuilder로 변환해야 함에도 불구하고String함수들 보다 더 빨랐다. 따라서, 구현한 파서의 모든.replace()함수를StringBuilder함수로 교체했다.
.substring() 함수
.substring()함수도.replace()함수와 같은 결론이 나왔다. 단, 문자열 길이가 약 12000자 정도 되면String과StringBuilder의 성능이 거의 같아진다. 확인해본 결과 단순한 함수 성능이 아닌String에서StringBuilder로 변환하는 과정의 오버헤드 때문이었다. 따라서 순수 함수 성능은StringBuilder가 더 빠르지만String으로 다시 변환해야 한다면 문자열의 길이를 고려해야 한다.- HTML 파서에는 12000자 이상의 문자열을 한 번에 파싱하는 경우가 일반적이지 않으므로
StringBuilder함수를 사용했다.
파싱 로직 개선
공백 제거
- 디버깅을 통해 정규식으로 공백을 제거하는 함수가 전체 HTML 텍스트를 대상으로 적용되고 있어서 성능 저하를 유발하는 것을 확인하고 해당 함수를 공백 제거가 필요한 부분에만 적용하도록 수정했다.
- 수정 후 5.5초 → 0.4초로 개선
파싱 단위
- 가장 성능에 영향을 주는 부분인 HTML 텍스트를 읽는 부분을 수정했다. 기존의 파서는 한번에 전체 HTML 텍스트를 읽고 차례차례 파싱했는데, 무조건 HTML 텍스트 전체를 파싱하다 보니 성능 저하가 일어날 수 밖에 없었다.
- 한 번에 한 줄씩 파싱하고, 한 줄이 긴 경우는 3000자 단위로 나눠서 파싱을 진행하는 방식으로 구현했다.
- 3000자 단위로 나눠서 파싱하면 script태그와 style태그의 시작 태그와 끝 태그 사이의 문자열을 무조건 content로 파싱하는 로직에서 3000자 내에 끝 태그가 없는 경우 예외가 발생한다. 이 경우 추가로 3000자를 더 파싱하는 예외 처리를 적용해서 해결했다.
- 수정 후 0.4초 → 0.05초로 개선
개선 결과
- 기존 구현한 파서보다는 8배, jsoup보다는 2배 빠르게 구현됐다.
- 한 줄씩 파싱하는 경우 발생하는 불확실한 케이스에 대응하기 위해서 한 번에 읽어오는 문자열의 단위만 수정하고 기존 코드는 수정하지 않았다.
- jsoup과는 파싱 방식이 조금 다른데(구현한 방식: 문자열을 읽고 문자열에서 파싱 / jsoup방식: 문자열을 문자 단위로 읽으면서 파싱), 한 글자씩 읽는 jsoup방식은 매번 문자를 읽을 때 마다 파싱 여부를 판단해야 하고, 구현한 방식은 문자열 단위로 읽을 때 마다 파싱 여부를 판단한다. 여기서 파싱 여부 판단 횟수의 차이 때문에 성능에서 차이를 보이는 것 같다.
HTML 구조화 기능
구현 과정
- HTML을 구조화 하기에는 상하관계가 분명하고 순서를 반영하는 HTML 특성을 그대로 반영한 자료구조인 트리가 가장 적합하다.
- 시작 태그와 끝 태그가 있는 HTML의 특성을 살려서 시작 태그를 스택에 추가하고 끝 태그를 만나면 대응하는 시작 태그를 스택에서 삭제하는 식으로 구현하려고 했다. 하지만 2차원 구조인 HTML DOM Tree를 1차원인 스택으로 구현하기에는 완벽하지 않았다.(A태그의 하위태그 A, B, C태그가 있으면 스택 구현에서 C의 상위 태그가 어떤 A태그인지 알 수 없음) 리스트도 같은 이유로 채택하지 않았고, 맵은 순서를 고려할 수 없으므로 제외했다. 결국 HTML DOM처럼 트리가 가장 적합했다.
- 구조화하는 도중 필요한 기능을 바로바로 추가할 수 있게
Tree클래스와Node클래스를 직접 구현하고 HTML 태그를 파싱하는 대로 루트 노드부터 하위 노드에 추가하는 방식으로 구현했다. 이 때 HTML 구조를 그대로 트리에 반영해야 하기 때문에 자식 노드로 추가할 지 형제 노드로 추가할 지 결정해야한다. 결정 기준은 끝 태그를 만났는지의 여부이고, 구현 과정은 다음과 같다.- 현재 노드에 다음 태그를 추가할 때 끝 태그를 만난 뒤면 현재 노드를 부모 노드로 올리고 자식 노드를 추가한다.(형제 노드 추가)
- 끝 태그를 만나지 않은 상태면 그대로 자식 노드를 추가한다.(하위 노드 추가)
- 끝 태그가 없는 void 태그 같은 경우는 끝 태그를 만난 상태를 적용하는 방식으로 예외 처리했다.
- 역시 JUnit을 사용해서 TDD개발로 구현했다. 테스트 케이스는 HTML 파서 테스트 케이스와 별개로 작성했다.
트리 diff
트리의 diff를 계산하기 위해서 최장 공통 노드 리스트를 계산해야 한다. 두 트리의 공통 노드를 제외하면 추가/삭제/변경된 노드를 구할 수 있기 때문이다. 기존 최장 공통 노드 리스트를 계산하는 모든 알고리즘은 문자로 이루어진 문자열을 대상으로 적용하기 때문에, 트리에 적용하기 위해서는 다른 방법을 사용해야 한다. 직접적으로 노드에 diff 알고리즘을 적용하기는 힘들기 때문에 트리를 노드의 키값으로 이루어진 리스트로 변환해서 diff 알고리즘을 적용한다. 그러나 diff 알고리즘을 문자열로 이루어진 리스트에 적용할 수 있게 수정해야 한다.
diff 노드 설계
트리 구조의 diff를 구하는 것이므로 똑같은 트리 구조를 만들고 diff 내용만 추가해서 구현하려고 했으나 비교하는 변경 이전/이후 트리 구조가 다르면 다를수록 처리하기가 까다로워져서 다른 방법을 고려해야 한다. 따라서 단순하게 diff 내용을 담은 노드를 리스트에 추가하는 식으로 구현했다.
- 연산(operation)의 적용 범위를 고려해야 한다. Diff 노드에 직접 연산을 적용하게 되면 노드의 어떤 부분에 적용되는 연산인지 알 수 없으므로 적합하지 않다. 노드의 데이터(type, content, attribute, value)마다 연산을 적용하면 정확히 어떤 데이터에 어떤 연산이 적용되었는지 알 수 있으므로 적합하다.
- 속성값의 경우(attribute, value) 여러가지 값을 가지고 있을 수 있기 때문에 역시나 하나의 연산으로 처리할 수 없다. 따라서 속성값 하나하나 연산을 적용한다.
- Diff 노드는
text,changeText변수를 추가로 가진다.text는 같거나 추가되거나 삭제된(EQUAL/INSERT/DELETE) 텍스트를 가지고changeText는 변경된 텍스트 중에서 변경 이후의 텍스트를 저장한다. 즉 CHANGE 연산일 경우에만 사용되고, 이 때text는 변경 이전의 텍스트를,changeText는 변경 이후의 텍스트를 가진다. - 클래스 다이어그램은 다음과 같다.
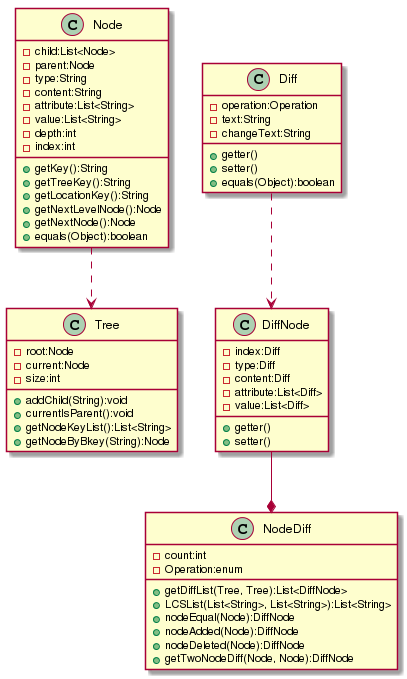
연산 분류
노드 단위의 diff를 계산하기 위해 연산의 종류를 결정해야 한다.
- 문자열의 경우 EQUAL/INSERT/DELETE만 고려하면 되지만, 노드는 변경되는 경우도 고려해야 한다.
- 노드의 데이터는 같지만 위치만 다른 경우(이동한 경우)를 고려하기 위해 깊이, 인덱스, 부모, 자식 등의 정보를 바탕으로 이동한 노드를 탐지하는 알고리즘을 구현했으나 렌더링 결과의 변화를 따지면 결국 변경된 내용(CHANGE)과 큰 차이가 없기 때문에 고려하지 않았다.
- 최종적으로 노드의 연산은 EQUAL/INSERT/DELETE/CHANGE로 결정했다.
- CHANGE 연산이 적용되는 변경된 노드란 속성이 변경되거나(ex.
<p style="color:red">→<p style="color:blue">) 태그 내용이 변경된(ex.<p>내용</p>→<p>추가 내용</p>) 노드를 의미하는데, 이런 경우를 문자열처럼 단순하게 DELETE/INSERT로 나누지 않고 변경된 부분만 따로 표시하면 더 직관적으로 어느 부분이 변경되었는지 알 수 있다. - 변경된 노드의 기준은 태그 타입으로, 태그 타입의 변경은 고려하지 않는다.
- CHANGE 연산이 적용되는 변경된 노드란 속성이 변경되거나(ex.
LCS(Longest Common Subsequence) 알고리즘 구현
기존의 문자열(문자 리스트)이 아닌 문자열(문자열 리스트)에 적용하는 리스트 기반 LCS 알고리즘을 먼저 구현했고, 코드는 다음과 같다.
public List<String> getLcsList(List<String> listA, List<String> listB) {
    int[][] dp = new int[listA.size() + 1][listB.size() + 1];

    for (int i = 0; i < listA.size(); i++) {
        for (int j = 0; j < listB.size(); j++) {
            if (listA.get(i).equals(listB.get(j)))
                dp[i + 1][j + 1] = 1 + dp[i][j];
            else
                dp[i + 1][j + 1] = Math.max(dp[i + 1][j], dp[i][j + 1]);
        }
    }

    LinkedList<String> results = new LinkedList<>();
    for (int x = listA.size(), y = listB.size(); x != 0 && y != 0;) {
        if (dp[x][y] == dp[x - 1][y])
            x--;
        else if (dp[x][y] == dp[x][y - 1])
            y--;
        else {
            assert listA.get(x - 1).equals(listB.get(y - 1));
            results.addFirst(listA.get(x - 1));
            x--;
            y--;
        }
    }

    return results;
}
LCS 알고리즘 적용
LCS를 적용하기 위해 다음을 고려한다.
- LCS는 리스트에 적용할 수 있으므로 트리를 리스트로 변환해야 한다. 트리를 순회하며 노드를 차례대로 리스트에 추가하면 되지만, 트리 diff를 구현하는 과정이므로 순서를 고려해야 한다. 순서는 실제 HTML 텍스트와 같은 순서를 갖게 하기 위해 전위순회(pre-order)를 적용한다.
- 노드 단위의 LCS를 따로 구현하는 것 보다 문자열 단위의 LCS를 적용하는 것이 빠르기 때문에 노드의 키값을 가지고 LCS를 적용한다.
- 노드의 키값은 가지고 있는 모든 데이터를 조합하고 해싱해서 생성된다. 완전히 같은 노드가 아닌 이상 키값은 유일하다.
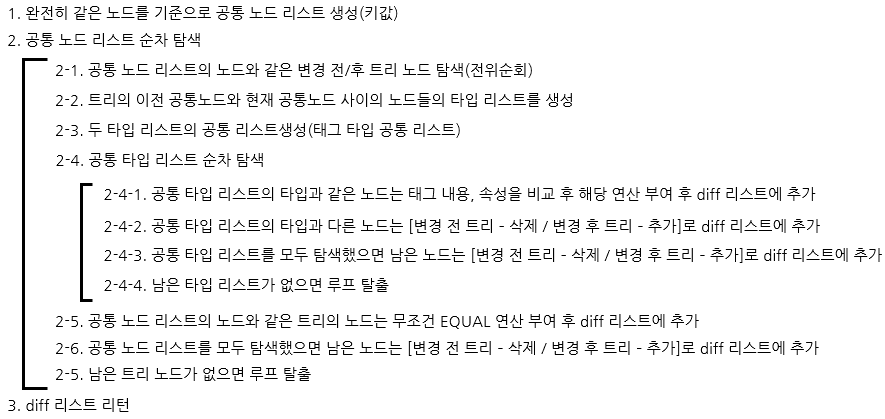
LCS 알고리즘 구현 과정은 다음과 같다.
-
모든 노드의 키값을 리스트로 만들고(전위순회 순서), 문자열 LCS를 적용하여 공통 노드 리스트를 생성한다.
-
공통 노드 리스트를 기준으로 각각의 트리 노드가 같을 때 까지 탐색한다.
-
완전히 같은(모든 노드의 값) 노드는 EQUAL로 처리한다.
-
공통 노드 전까지의 노드들은 각각 태그 타입을 기준으로 다시 공통 타입 리스트를 생성한다.
-
태그 타입을 기준으로 생성한 공통 타입 리스트를 기준으로 남은 노드들이 같을 때 까지 탐색한다.
-
예시
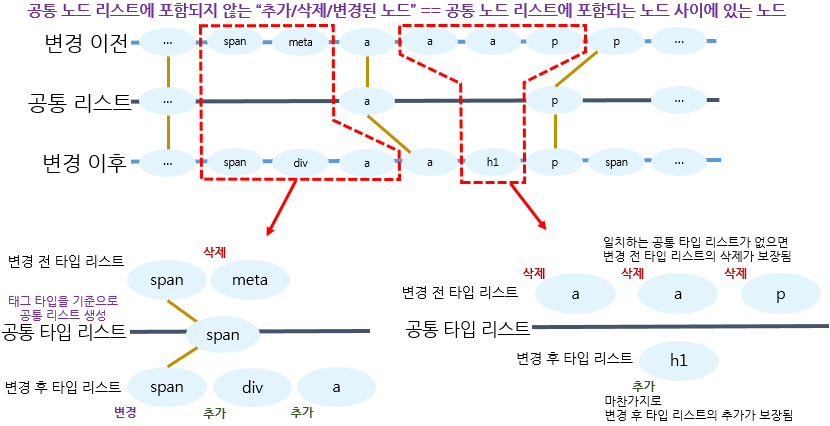
-
같지 않은 노드들은 차례대로 DELETE/INSERT로 처리한다(변경 이전 노드는 DELETE, 변경 이후 노드는 INSERT).
-
같은 노드는 태그 내용, 속성을 하나하나 비교하며 해당하는 연산을 부여하고 diff 리스트에 추가한다.
-
위 싸이클을 공통 노드 리스트가 끝날 때 까지 반복한다.
-
공통 노드 리스트를 다 탐색하고 노드가 남았으면 남은 노드들의 태그 타입으로 공통 타입 리스트를 생성하고 위 루프를 그대로 적용한다.
-
속성값(attribute, value)도 리스트로 이루어져 있으므로 역시 공통 리스트를 생성해서 연산을 결정하고 diff 리스트에 추가한다.
-
LCS 적용 예시
LCS 알고리즘 적용 범위
구현한 LCS는 다음에 모두 적용된다.
- diff 리스트의 노드를 기준으로 적용
- 완전히 같지 않은 노드들의 타입을 기준으로 적용
- 노드의 속성(attribute, value)을 기준으로 적용
LCS 알고리즘 성능
- LCS 알고리즘은 동적 계획법으로 구현돼서 시간복잡도가 O(N^2)으로 비교하는 리스트가 길면 길수록 시간이 오래 걸리는 단점이 있었다.
- 노드의 개수가 약 2000개 일 때 diff 계산 과정만 약 12초가 걸린다.
- 성능 개선을 위해 복잡하지만 성능 면에서 좋은 마이어스 알고리즘(Myers Algorithm, Eugene W.Myers)을 적용한다.
마이어스 알고리즘
- 마이어스 알고리즘은 두 문자열 간의 diff를 계산하는 알고리즘으로, 구현한 HTML diff에 필요한 공통 노드 리스트를 얻을 수 있는 다른 알고리즘이다.
- HTML diff에서 LCS 알고리즘을 사용한 이유는 파싱한 두 트리의 공통 노드 리스트를 얻을 수 있기 때문이다. 마이어스 알고리즘도 마찬가지로 공통 노드 리스트를 얻을 수 있어서, 직접적으로 마이어스 알고리즘을 적용하는 대신 공통 노드 리스트를 구하는 LCS 알고리즘을 마이어스 알고리즘으로 대체한다.
- 마이어스 알고리즘의 시간복잡도는 기본적으로 O(ND)다(N: 비교할 두 문자열 길이의 합, D: 변경된 문자의 개수).
- 마이어스 알고리즘은 기존 LCS 알고리즘과 달리 동적 계획법으로 모든 경우를 탐색하지 않는다. 대신 SES(Shortest Edit Script)알고리즘과 탐욕 알고리즘을 동시에 사용해서 최장 공통 노드 리스트를 구함과 동시에 추가되거나 삭제된(INSERT, DELETE) 부분까지 알 수 있다. *참고
구현 과정
- 마이어스 알고리즘은 문자열을 대상으로 적용된다. 하지만 HTML diff에서는 노드 리스트를 대상으로 적용해야 하기 때문에 LCS 알고리즘을 수정했던 것과 마찬가지로 적용 대상을 문자열에서 문자열 리스트로 변경하는 작업이 필요하다.
- 구현에는 구글 오픈 소스를 활용했다.
String클래스에서는 지원하지만List클래스에서는 지원하지 않는 함수를 모두 구현하고, '문단 나눔'같은 문자열은 갖지만 리스트에는 없는 특징들을 활용한 로직을 삭제하거나 수정해서 문자열 리스트에 적용할 수 있게 구현했다.
성능 비교
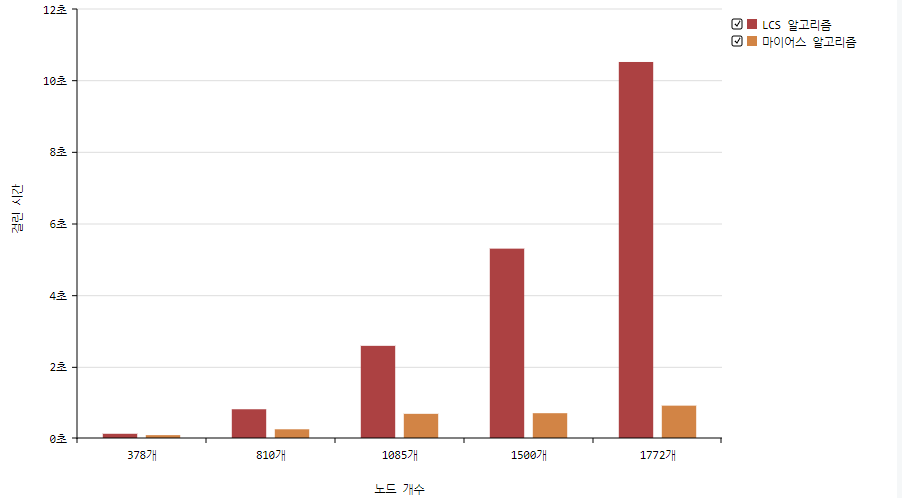
- 노드 개수가 적을 때는 큰 차이가 없지만, 노드 개수가 많아질수록 LCS 알고리즘보다 마이어스 알고리즘이 더 빠른 것을 확인할 수 있다.
diff 내용 시각화
리스트 자료구조로 만든 diff 내용을 JSON포맷으로 변환해서 자바스크립트에서 그대로 사용한다. 원본 HTML 텍스트는 렌더링하고, 포함한 모든 태그를 배열로 만들어서 diff 리스트와 비교하며 diff 내용(연산이 EQUAL이 아닌 모든 태그)을 렌더링 결과 화면에 함께 시각화한다.
시각화 방식(태그 내용 변경)
렌더링된 HTML 텍스트에 .innerHTML()함수와 jQuery의 함수를 사용해서 직접 태그를 삽입하여 추가/삭제를 시각화한다. 변경된 내용(CHANGE)은 LCS(Longest Common Substring) 알고리즘을 적용해서 동일 문자열을 제외한 부분을 추가/삭제로 나눠서 시각화한다. 시각화되는 css는 다음과 같다.
- 추가 : 연두색 배경/녹색 글씨
- 삭제 : 다홍색 배경/빨간색 글씨/취소선
- 변경 : 연보라색 배경/보라색 글씨
- 동일 : 기존 css적용
시각화 방식(태그 타입, 속성 변경)
MS워드처럼 우측 빈 공간에 변경된 내용의 텍스트를 추가하고 해당하는 태그와 선을 그어서 연결하는 방식으로 구현하려고 했으나 결과 화면에서 해당 태그와 변경된 내용의 텍스트를 연결하는 선을 긋는 것이 생각보다 어려웠다. 대신 해당 태그 좌측 상단에 변경된 내용의 텍스트를 추가해서 표시하는 방식을 적용했다.
- 예시
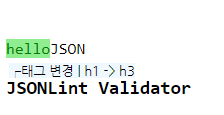 해당 태그의 offset 좌표(top, left)를 얻어와서 적절한 위치에 표시되도록 위치 보정 연산 수행 후 원본 HTML에 삽입한다.
원본 HTML 태그 중에서 변경된 태그 타겟팅
변경된 부분의 내용은 diff 리스트에 있지만 정확히 원본 HTML의 어떤 태그의 변경 내용인지에 대한 정보는 없다. 따라서 diff 리스트의 변경 내용을 원본 HTML 태그와 연결하는 과정이 필요하다.
- 태그 타입을 기준으로 검색해서 타겟팅하려고 했으나 같은 태그가 있는 경우 오류가 발생한다.
- diff 리스트의 노드의 개수는 반드시 태그 배열의 태그의 개수보다 같거나 많다. diff 리스트의 노드에는 기본적으로 태그 배열의 태그를 포함하고 있고(변경 이후 HTML을 기반으로 생성했기 때문에), 태그 배열의 태그와 일치하지 않는 DELETE노드(변경 이전 HTML에 있던 태그)가 있기 때문이다.
- 따라서 diff 리스트의 노드와 태그 배열의 태그를 하나씩 비교하면서 같으면 diff 노드의 연산대로 처리하면 되고, 다르면 원본 HTML에 태그를 추가하고 deleteClass를 적용한다. 이 때 태그의 인덱스를 1증가시켜서 타겟팅에 문제가 생기지 않도록 한다.
- Diff 리스트에는 EQUAL 연산을 가진 노드도 포함되어 있기 때문에 원본 HTML의 모든 태그 배열을 얻어와서 하나하나 순차적으로 비교하면 정확한 타겟팅이 가능하다(둘 다 전위순회).
- 그러나 diff 리스트의 노드와 태그 배열의 태그들이 정확히 일치하지 않기 때문에(DELETE/INSERT 등 변경 노드는 2개씩 추가되거나 DELETE된 태그는 HTML 태그 배열에 존재하지 않음) 인덱스를 동기화해주면서 타겟팅을 진행해야 한다.
타겟팅 한 태그에 접근
변경된 내용 중에서 직접적으로 렌더링되는(ex. 태그 내용)부분은 원본 HTML을 수정해서 시각화 하는데, 태그를 삭제하고 삽입하는 방법을 사용하려고 했으나 상하관계가 꼬이는 경우가 많아서(보통 자식 노드로 추가) 적용하지 못했다. 원본 HTML을 수정하는 방법이 더 쉬워서 span 태그로 태그 내용을 따로따로 감싸는 식으로 구현했다. 추가/삭제/변경의 표현은 css에서 class단위로 적용하고 span 태그에 insertClass/deleteClass/chageClass를 적용해서 가독성을 향상시켰다.
변경된 태그 시각화
변경된 부분은 통째로 changeClass를 적용했는데, 변경 이전/이후가 한눈에 들어오지 않아서 다른 방식을 적용했다.
- 마이어스 알고리즘을 적용해서 추가/삭제 된 부분을 각각 모두 표시하는 방법이 있는데, 시각적으로 추가/삭제가 번갈아가면서 표시되면 가독성도 좋지 않고, 무엇보다 diff 노드에 추가/삭제된 부분을 하나하나 담기가 불가능해서(가능은 하지만 diff 노드가 추가되면서 순차적으로 탐색해가는 기존 방식에 영향) 적절하지 않다.
- 기준을 정하고 앞뒤로 추가/삭제된 부분만 표시하는 방법은 현재 탐색 방식에도 반하지 않고 시각적으로도 큰 문제가 없다. 기준은 LCS(Longest Common Substring) 알고리즘을 적용해서 가장 긴 공통 문자열은 변경되지 않은 부분이니 원본 그대로 보존하고 LCS문자열을 기준으로 앞/뒤로 추가/삭제된 부분만 표시한다. 이미 구현한 insertClass와 deleteClass를 적용해서 구현했다.
예외 처리
- 원본 HTML 텍스트에 포함된 script 태그가 따로 자바스크립트 코드로 읽히는 바람에 원본 HTML이 깨지는 문제가 발생했다. HTML 파싱 코드에
<script>를<script>로 바꾸는 코드를 추가해서 해결했다. - 삭제된 태그는 변경 후 HTML 텍스트에 존재하지 않기 때문에 따로 추가해준다. 원본 HTML에 태그를 추가하고 나면 diff 리스트와 비교하던 HTML 태그 배열의 인덱스가 달라지는 문제가 발생한다. 추가하는 태그의 개수만큼 인덱스에 더해주는 방식으로 해결했다.
- 변경된 태그를 처리할 때 LCS(Longest Common Substring) 알고리즘을 적용하고 변경된 부분과 변경되지 않은 부분을 나눌 때
.split()함수를 써서 구현했는데, 변경된 부분(기준 문자열)이 2개 이상 있을 경우.split()함수가 오작동하는 경우가 있다..split()함수가 아닌.indexOf()함수로 변경된 부분의 인덱스를 기준으로 앞/뒤를 나눠서 해결했다.
최종 결과 예시
태그 내용 : h5 → h1 / Hooray! → Dooray! / delete text equal text → equal text insert text 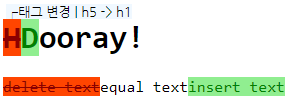
후기
먼저 diff 알고리즘 관련 자료를 공부하고, 구현했습니다. 파서를 구현하면서 자바의 String 클래스가 어떻게 구현됐는지를 위주로 공부했습니다. 함수들이 어떻게 구현됐고 왜 이렇게 구현했는지를 고민한 것이 정말 큰 도움이 된 것 같습니다. 직접 함수들의 성능을 비교해보기도 하고 다른 방법으로 직접 구현한 함수와 비교하면서 이렇게 구현했을 때의 장점, 이유 등을 알게 되면서 재밌게 프로젝트를 진행했습니다.
오픈 소스를 직접 사용해보기도 하고 분석하기도 했는데, 통째로 수정하고 모든 코드를 뜯어 본 적은 처음이었습니다. 특히 HTML 파서의 성능 개선 작업을 진행하면서 jsoup의 구현 방법과 비교하기 위해 코드를 열심히 분석했습니다. 다행히 규모가 엄청나게 큰 오픈 소스는 아니라 좀 더 수월했던 것 같습니다. jsoup에서 좋아보이는 부분은 적용하고 고치면 더 좋을 것 같은 부분은 고쳐서 파서를 개선했습니다. jsoup보다 빨리 파싱하는 걸 보고 뿌듯했습니다.
diff 알고리즘 성능 개선 작업도 어려웠습니다. LCS 알고리즘을 구현했지만 성능이 너무 나빠서 마이어스 알고리즘으로 대체했는데, 오픈 소스 자체를 수정하면서 구현했습니다. 마이어스 알고리즘 자체가 생각보다 복잡해서 구현을 잘 못하고 있었는데, 오픈 소스를 참고하는게 구현에 도움이 됐습니다.
이번에 인턴 기간동안 이 프로젝트를 진행하면서 지금까지 진행해본 어떤 프로젝트보다 많이 배우고 공부한 것 같습니다. 검색의 벽에 막힐 때 마다 다들 도와주셔서 더 원활히 진행할 수 있었습니다. 자바와 자바스크립트 공부도 많이 했지만, 앞으로 어떤 식으로 공부해야되는지를 배운게 더 큰 경험인 것 같습니다. 고맙습니다.