Engineering
메시징 서버의 스트레스 테스트 노하우와 AI가 덜어 준 부분
jyami.kim카카오
2026년 5월 22일
원문에서 보기 ↗Part 1. 개요 - 안정적인 운영을 위한 노력들
안녕하세요 저는 톡메시징플랫폼 서버개발자 쟈미(jyami)입니다. 톡메시징 개발 플랫폼팀은 카카오톡의 메시지 수발신 채팅방 목록 관리와 같은 카카오톡 채팅시스템의 개발, 운영을 담당하고 있습니다. 카카오톡의 채팅 트래픽을 담당하는 부서이기 때문에 어떤 상황에서든 안정적으로 운영하기 위한 노력을 기울이고 있습니다. (추천 글 : https://tech.kakao.com/posts/603)
그 노력 중 하나로 성능테스트가 있습니다. 저희는 서버가 어느 지점에서 한계를 드러내는지를 미리 확인할 수 있도록 상시 스트레스 테스트 환경 을 갖춰 두고있습니다. 스트레스 테스트는 시스템의 한계치를 넘는 부하(트래픽 급증, 자원 고갈)를 주었을때 장애 발생 지점 및 복구 능력을 확인 하는 성능 검증 테스트를 의미합니다.
이번 글에서 저는 이 환경을 어떻게 구성하였고, 어떤 것들을 분석하는지, 그리고 그 작업을 어디까지 AI 에 맡길 수 있었는지를 풀어 보려 합니다.
Part 2. 성능 테스트에 신경 쓰는 부분들
2.1 현재 테스트 환경의 구성
저희가 운영 중인 상시 스트레스 테스트 환경은 두 축으로 구성돼 있습니다. 한 축은 테스트 대상 서버 이고, 다른 한 축은 부하를 만들어 내는 클라이언트 입니다.
테스트 대상 서버는 실 운영 인스턴스와 동일한 스펙으로 관리합니다. JVM heap, CPU / 메모리 한도, 네트워크와 같은 장비 스펙 자체가 실제와 다르면, 측정값이 그 자체로 의미를 잃어버리기 때문입니다. 다만 운영과 동일한 스펙의 장비여도 서버 대수는 다르기 때문에, 일부 지표는 실제 수치와 그대로 비교하기 어렵습니다. 따라서 이런경우엔 수치적인 계산을 포함하곤 합니다.
부하를 만들어 내는 쪽은 Locust 프레임워크를 사용하고 있습니다. 내부 cluster의 리소스에 따라 워커수를 조절하여 부하를 줄 대규모 클라이언트를 만들어내며, 필요할 때 수백 파드 단위로 스케일 업 했다가 테스트 후 정리합니다. 서버 성능 측정에 집중하기 위해 최대한 넉넉한 리소스의 클라이언트 수만큼 스케일 업하여 클라이언트 병목으로인한 노이즈를 제거합니다. 이때 굳이 Locust 가 아니더라도 부서원들의 선호에 따라org.openjdk.jmh:jmh-core 를 사용하는 경우도 있었습니다.
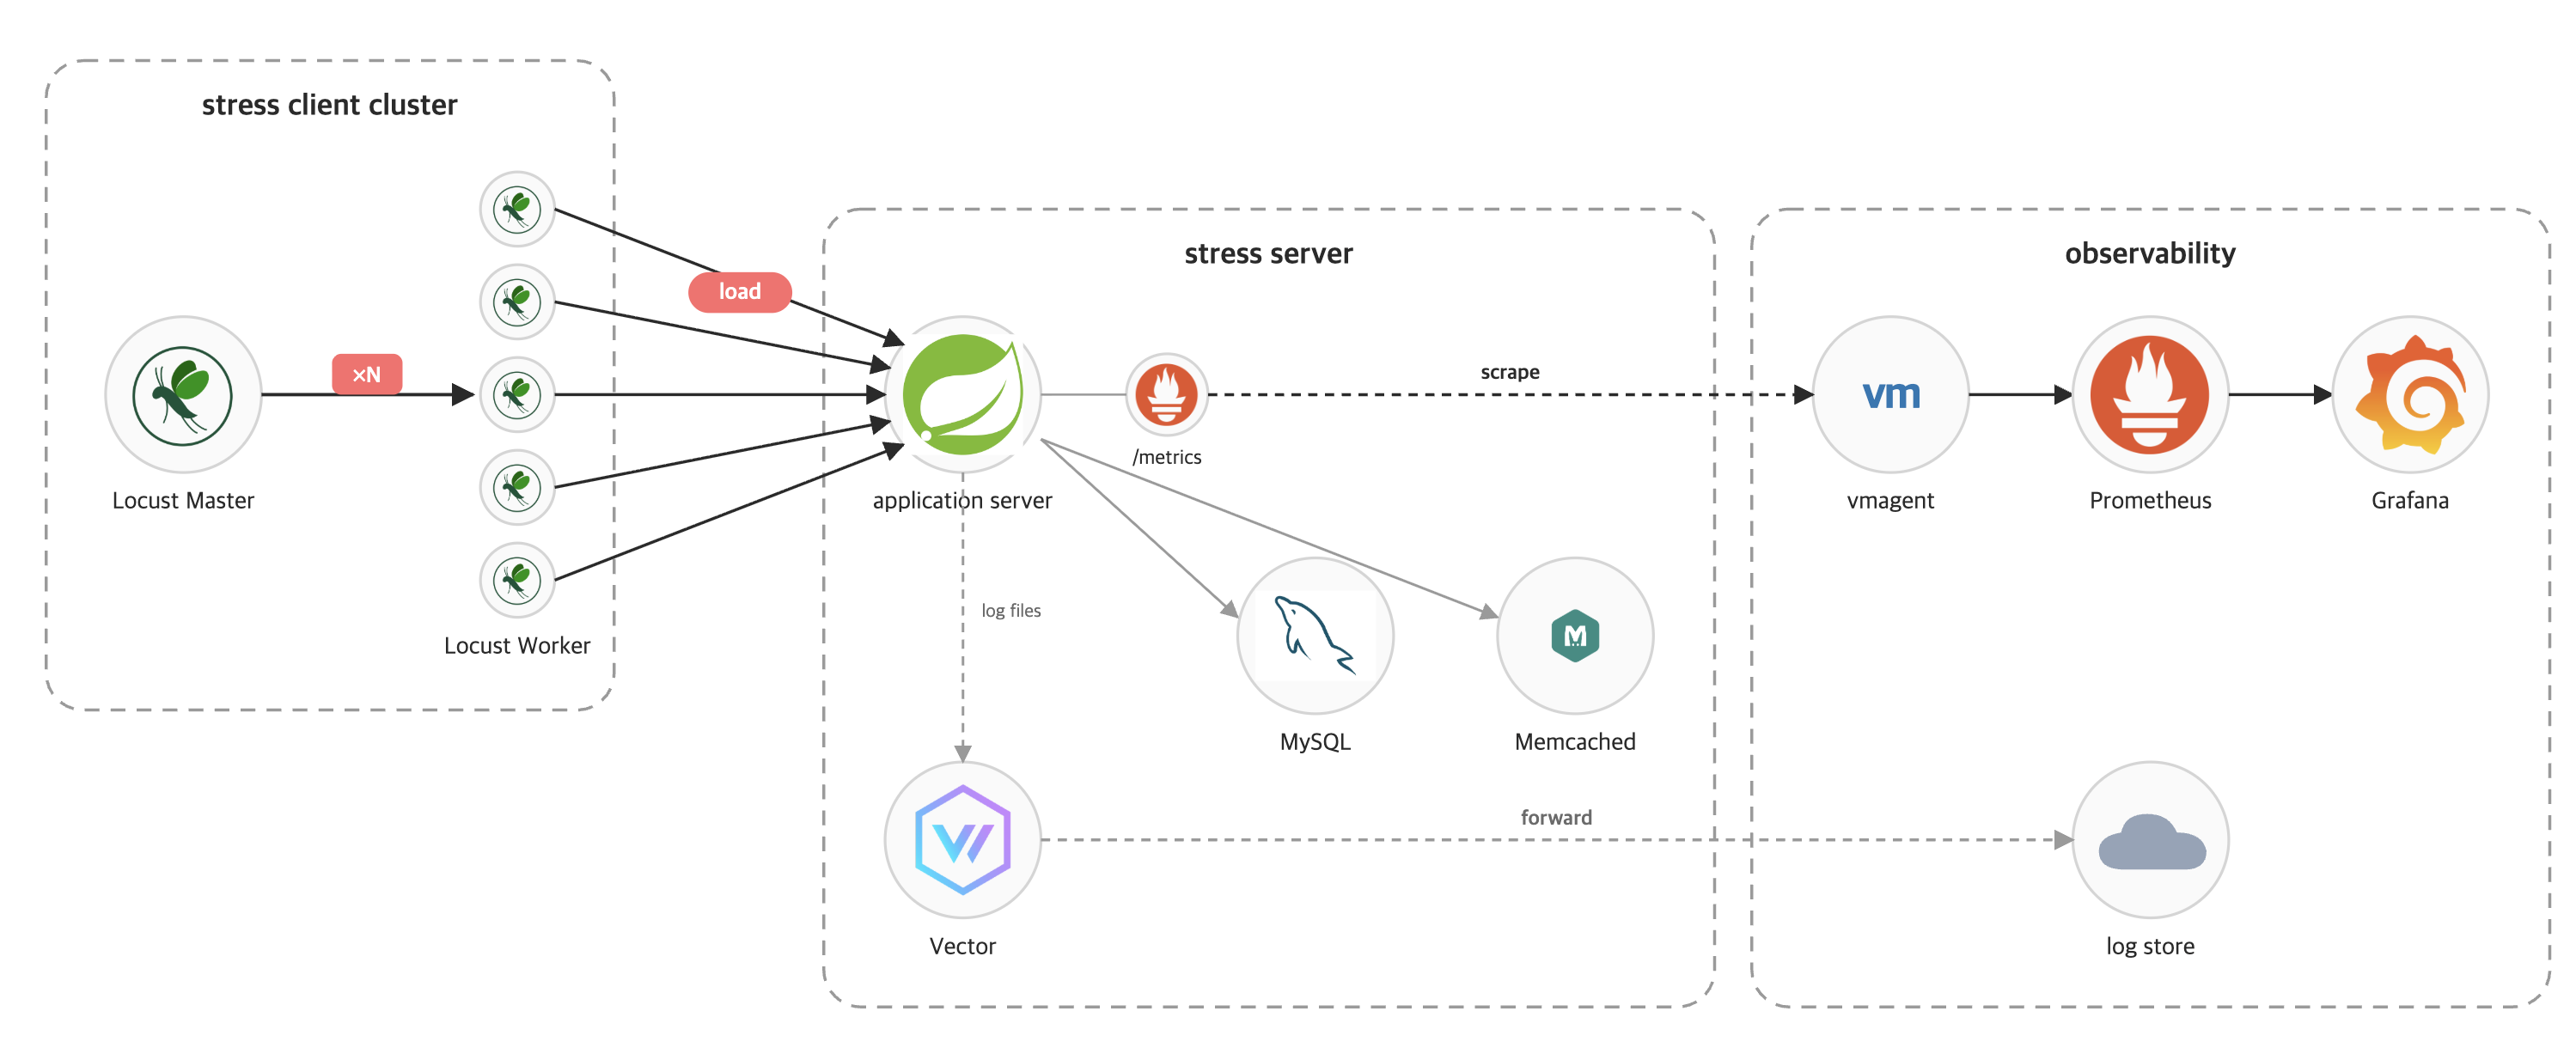
클라이언트 쪽은 단순히 Locust 워커를 많이 띄우는 데서 끝나지 않습니다. 부서에서 자주 사용하는 시나리오들은 모듈마다 리얼 환경과 비슷한 트래픽 비율대로 여러 개 모아두고 관리하고 있습니다. 주로 (1) 평시 트래픽 양상을 많이 테스트하고, 가끔 최악의 케이스를 고려를 할땐 실제로 발생했던 (2) 신년인사로 00시에 발송이 많아지는 트래픽 양상을 테스트합니다.
이와 같이 시나리오를 분리하고 트래픽 양상을 보는 이유는 평시 전송량에 비해서 READ와 WRITE를 주관하는 프로토콜의 비율이 달라지기 때문입니다. 아래 표에 서술한 것처럼 각각의 경우 병목 지점이 달라져 테스트의 최대 부하 RPS가 달라질 수 있어 고려 대상입니다.
| 사용자 동작 | 평시 정오 (12:00) | 신년 자정 (00:00) | 차이 |
|---|---|---|---|
| 메시지 전송 | 52% | 61% | ▲ 9% |
| 채팅방 입장 | 23% | 27% | ▲ 4% |
| 채팅방 리스트 조회 | 18% | 8% | ▼ 10% |
| 메시지 조회 | 7% | 4% | ▼ 3% |
- 표 1. 평시 정오엔 메시지 전송과 채팅방 입장·리스트 조회가 골고루 섞인 분포지만, 신년 자정 burst에서는 메시지 전송 비중이 급격하게 올라간다.
평시 정오 혹은 신년 자정과는 다른 양상의 추가적인 시나리오가 필요하다면 어떻게 할까요? 이때마다 부하 코드를 새로 작성하는 방법도 있겠지만, 여러 번의 경험 끝에 현재 메시징에서 구성해둔 locust 환경은 아래 코드와 여러 세팅을 통해 다양한 케이스를 커버할 수 있도록 구성되어 있습니다.
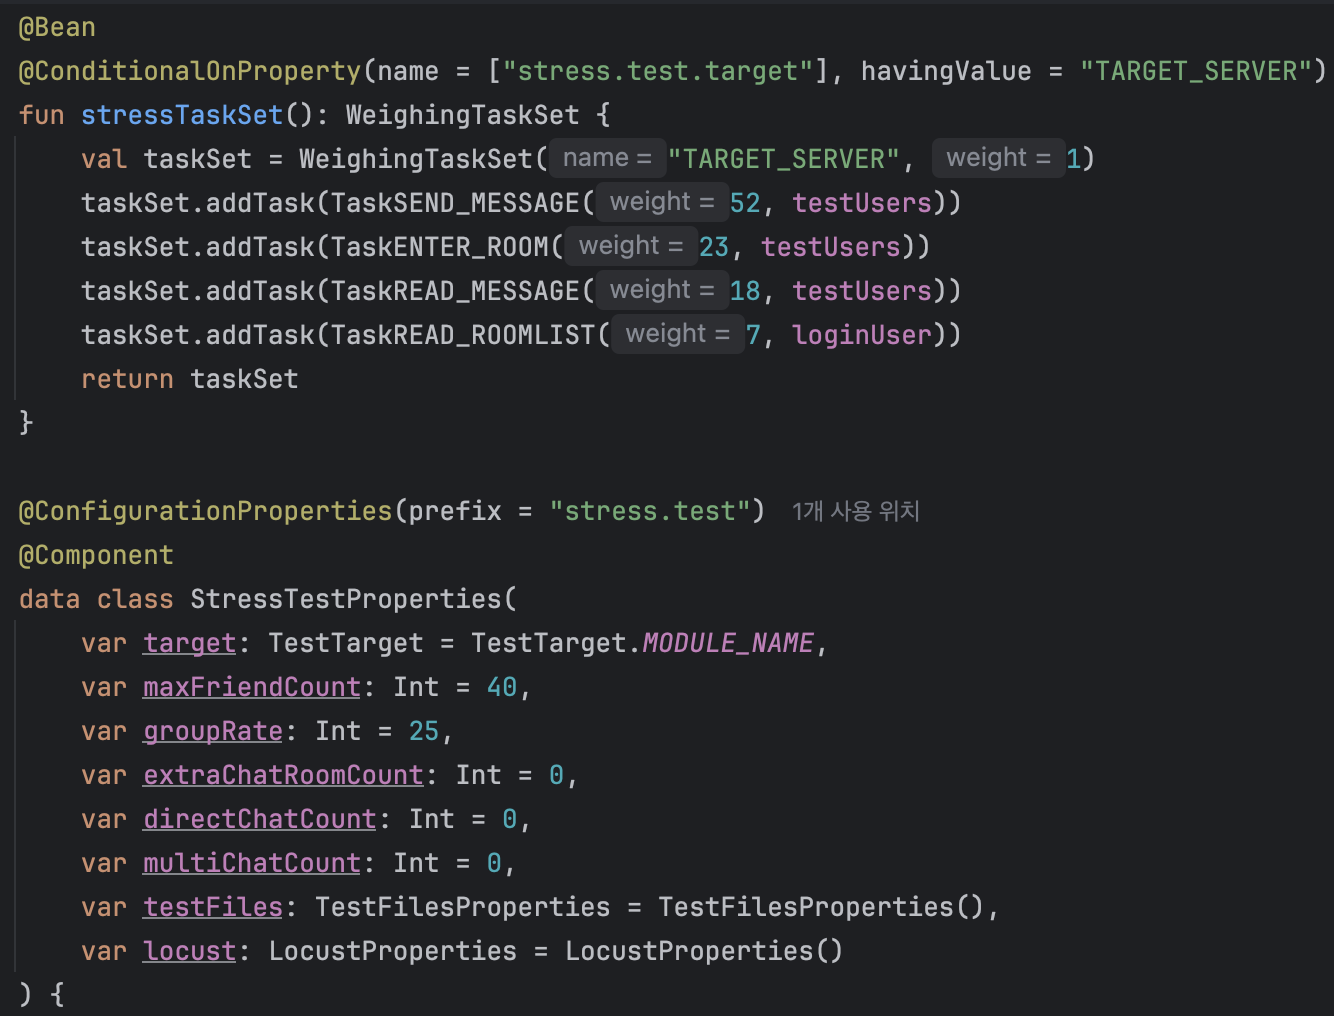
- TaskXXX : 어떤 프로토콜이 어떤 비율로 호출되는지
- TestProperties
    - directChatCount / multiChatCount : 방 타입별 생성 수(채팅방 타입의 비율)
    - maxFriendCount : 단톡방 멤버수
- target : 메시징 내에 어떤 모듈에 트래픽 부하를 줄 지 테스트 대상
위 코드와 설명처럼, 다양한 세팅값들을 조정하여 테스트를 원하는 다양한 트래픽 시나리오를 빠르게 만들어보고 측정을 할 수 있습니다.
2.2 메시징 도메인에서 우리가 돌리는 스트레스 테스트의 형태들
그렇다면 메시징 개발자들은 스트레스 클라이언트와 스트레스 서버라는 두 가지 서버군이 갖춰진 환경에서 어떤 테스트들을 진행하는 걸까요? 주로 성능에 영향을 줄 수도 있는 변경에 대해서 검증을 진행합니다. 이때 영향이 있을 변경을 판단할 때는, 이전에 문제가 발생했던 부분에 대해서 재발하지 않도록 안정성을 보장하고 싶을 때를 기준으로 합니다. 외에도, 당연히 개편 전후 성능을 비교해야 하는 거대한 변경이 있을 때에도 진행합니다. 따라서 이번 섹션에서는 메시징에서 경험적으로 선택했던 스트레스 테스트 대상들에 대해 소개합니다.
케이스 A — 관측 / 로깅 인프라 추가
대규모 트래픽 운영할 때의 재빠른 대응과 문제점에 대한 분석을 위해선 로깅/메트릭/트레이싱 파이프라인이 매번 중요한 역할을 합니다. logstash, fluent bit, opentelemetry, vector DB가 그 예시입니다. 이런 컴포넌트들을 운영 중인 서버에 신규로 혹은 교체하여 적용할 때 스트레스 테스트를 아래 요소들을 집중하여 테스트를 진행하고 지표를 검증합니다.
- application의 처리량과 elased time에 손실이 없는지
- 메트릭 추가로 인해 호스트의 CPU / 메모리 / 네트워크 시스템 지표가 어떤 양상으로 영향을 주는지
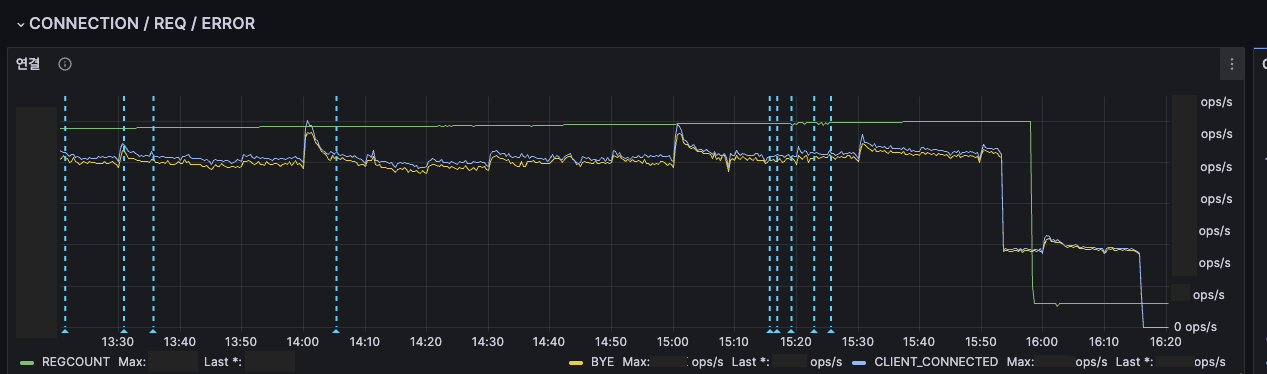
실제로 과거에 metric 수집 주기로 인한 실제 application load가 증가하는 현상이 발생했었고, 이때 이후로 현재는 관측성 인프라 추가 시 더욱 더 신경을 쓰게 되었습니다. 이 외에도 그림과 같이 높은 트래픽으로 인해 내부 지표 지연이나 알림 시스템 지연이 있는지를 추가적으로 확인하기 위해서라도 추가되는 컴포넌트에 대한 성능 검증은 언제나 중요합니다.
케이스 B — 서버 프로토콜 / 프레임워크 벤치마크 / 포팅 테스트
메시징 내부에서 server to server api로 사용되는 프로토콜 혹은 프레임워크를 유지보수 혹은 성능 향상을 위해 실제로 비즈니스 로직을 변경하기 전에 벤치마크 테스트를 진행하기도 합니다. 비즈니스 로직 없이 IO sleep을 가정한 상태에서 프레임워크에 같은 부하를 주었을 때의 시스템 메트릭의 차이를 저희가 가진 스트레스 테스트를 환경을 이용해 확인합니다. webflux가 IO 작업에 유리하니까 혹은 virtual thread를 도입하면 좋다와 같은 추상적인 말들이 아니라 실제로 worker 수를 늘려가면서 테스트 했을 때 프레임워크 혹은 프로토콜단의 숫자를 직접 확인하여 결정합니다.
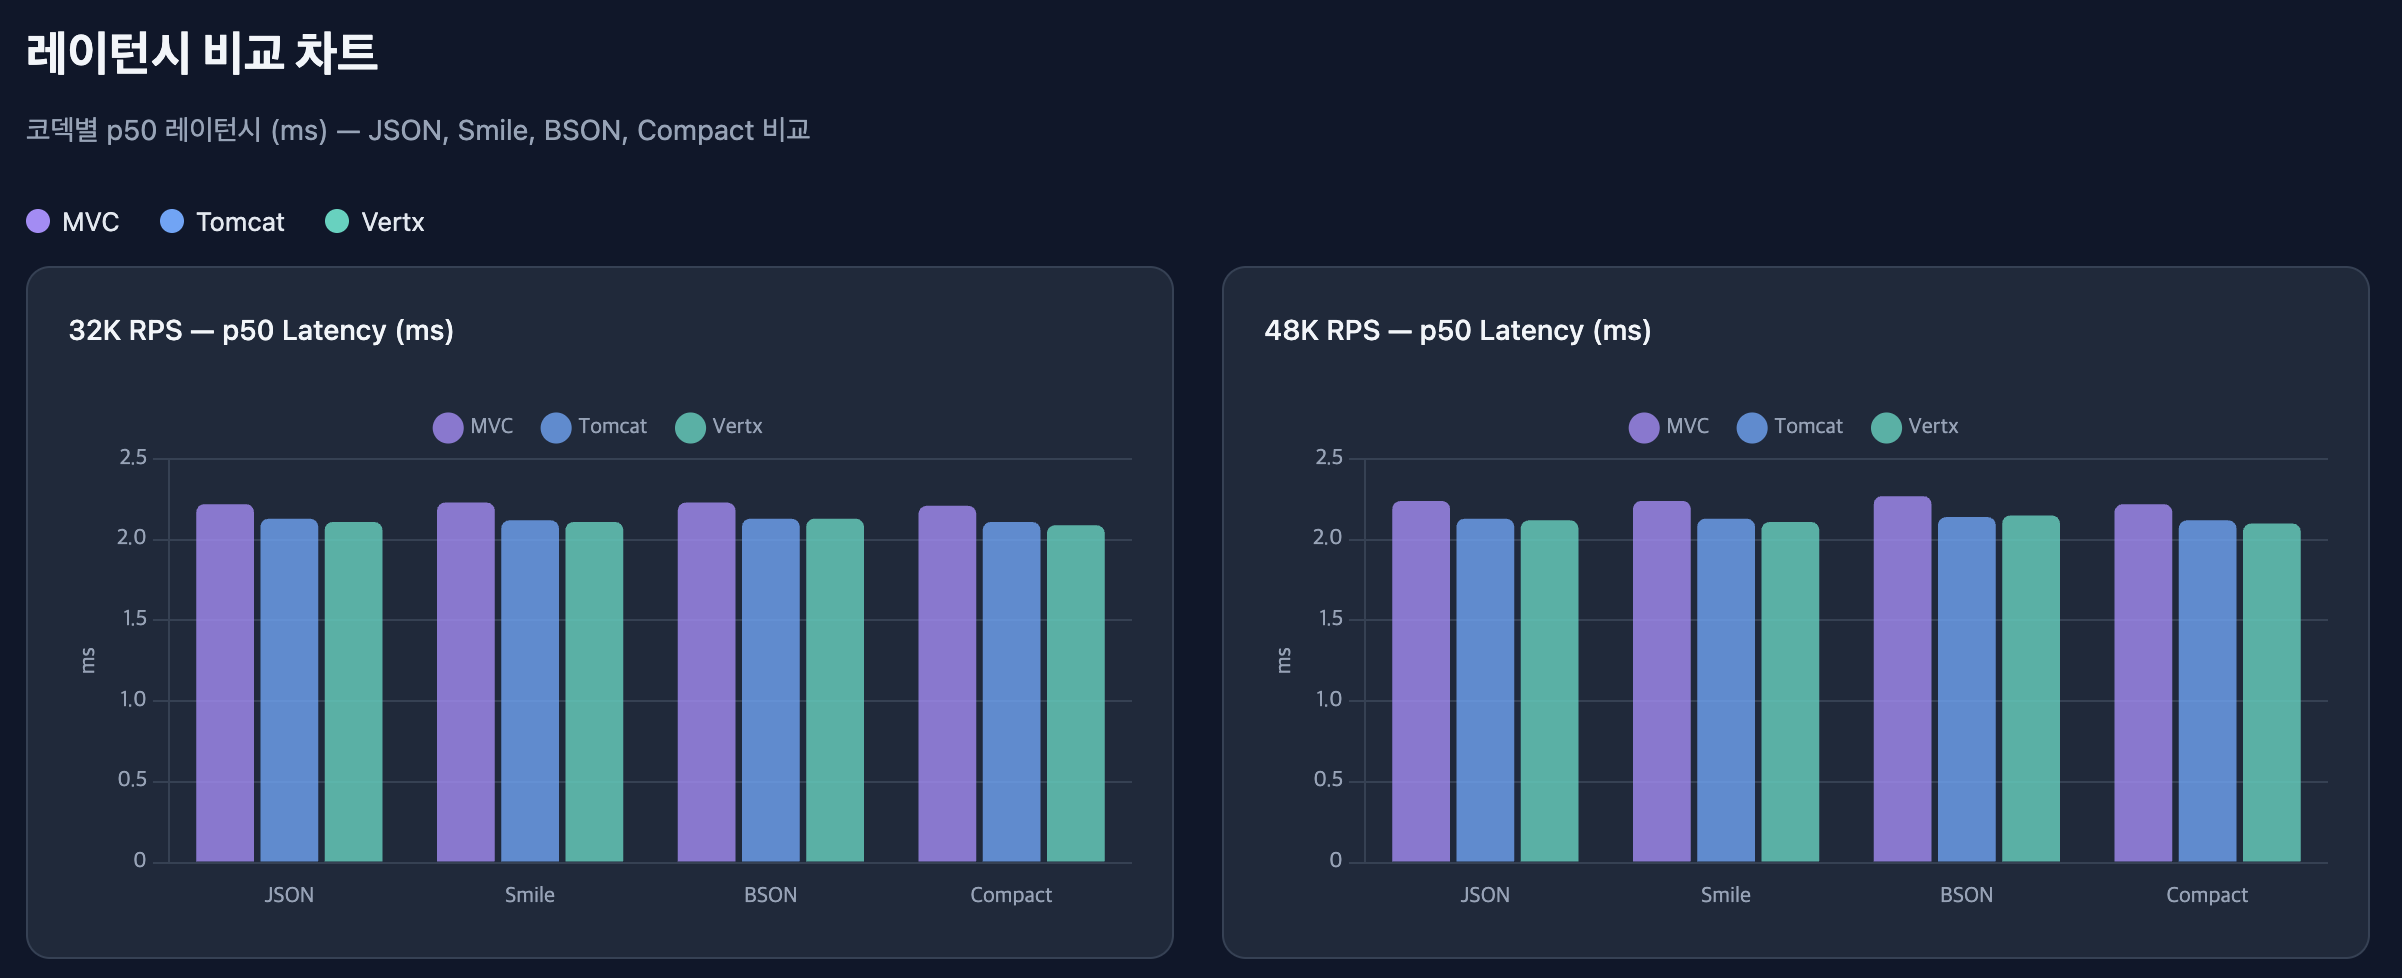
현재 우리가 운영하고 있는 모듈의 응답시간과 cpu bound 작업인지 io bound 작업인지 내부 처리 로직 특성을 확인하고, 선택한 조합이 우리 환경에서 충분한지를 고려하여 결정해야 합니다. 따라서 벤치마크 테스트 시에 cpu 부하를 점차적으로 추가했을 때, IO wait를 증가했을 때 각각에 따라 결과값을 확인합니다. 이때 확인하는 가장 기본적인 결과 값은 애플리케이션의 rps 당 latency 차이나 시스템 지표가 있습니다.
실제로 메시징의 메인 서버 cpp > kotlin 포팅 시에도 충분한 안정성 검증을 위해 스트레스 테스트를 진행했으며, 덕분에 두 언어 간의 시스템 메트릭 지표 차이를 확인할 수 있었습니다. 이런 테스트 결과 덕에 최대한 전후 성능 지표를 동일하게 가져가기 위해 추가적인 gc 튜닝을 하기도 하면서 투입 초반부터 안정적으로 서버를 운영할 수 있었습니다.
케이스 C — 인프라 OS 변경 및 보안 시스템 추가
카카오는 온프레미스 서버를 운영하기 때문에, 호스트 전환과 같은 인프라 작업 시에도 애플리케이션 개발자들이 모니터링을 함께하곤 합니다. 이때 slab 메모리의 누수 현상, 혹은 인프라팀에서 사용하는 백신이 동작하는 시간에 애플리케이션 리소스 소모가 크게 발생하는 현상이 있었습니다. 평소엔 부하로 인식되지 않는 보안·인프라 모니터링 시스템도, 트래픽 규모가 커지면 비로소 드러나는 변수였던 것 입니다. 이런 경험들로 현재는 호스트 OS 변경이나 보안·모니터링 에이전트와 같은 인프라 컴포넌트가 추가될 때에도 고부하 어플리케이션의 응답시간·처리량에 변화가 없는지 스트레스 테스트 후 적용하는 과정을 갖게 되었습니다.
케이스 D — 특정 유저 시나리오 임계치
메시징 서비스에서 가장 트래픽이 몰리는 순간은 “한 채팅방에서 여러 명이 동시에 write한다”, “새벽 0시 메시지 burst”, “멤버가 수백 명인 단톡방에 들어가는 순간”처럼 도메인 특유의 모양을 가집니다. 평소 패턴에서는 잘 안 보이지만 서버 입장에선 최악의 경우로 발생 가능한 최악의 시나리오입니다. 이런 도메인 특화 시나리오의 경우엔 2.1 현재 테스트 환경의 구성 에서 이야기한 대로 세팅 값을 실제와 비슷하게 세팅하여 빠르게 흉내냅니다. 작년에 런칭한 메시지 입력 중 기능 같은 신규 기능도, 서버의 부하 상황을 예측하기 위해 위와 같은 스트레스 테스트를 진행하여 병목지점을 파악한 후 안정적으로 런칭할 수 있었습니다.
지금까지 소개한 각각의 케이스처럼 메시징 개발자들은 여러 상황에 대한 안정성을 검증하고, 지표를 확인한 후 보고서를 작성합니다. 그럼 이렇게 진행한 테스트를 측정한 지표와 이 지표가 정상이라는 점을 판단하는 방법은 어떤 걸까요?
2.3 측정한 지표에서 확인해야하는 요소들
어떤 케이스든, 한 사이클의 부하테스트를 돌린 후 나온 지표를 확인하고 해석하는건 매우 중요합니다. 가장 먼저 보이는 지표를 확인하고 이상이 있는 경우에 원인을 파악하기 위해 내부에 상세 지표를 하나하나 뜯어보게 되는데요. 이상이 있는 경우는 사실 디버깅을 하는 것과 비슷하다는 생각을 하곤 합니다. 이 이유를 가장 상위 레이어부터 어떤 지표들을 확인해야 하는지와 함께 설명드리겠습니다.
레이어 1 — endpoint 지표
제가 가장 먼저 보는 것은 트래픽 처리량과 응답속도가 정상 범위로 발생하는가입니다. 어떤 스트레스 테스트이든 이 신호가 출발점이 되고, 문제가 발생한다면 이 신호의 원인을 찾아 내려가는(디버깅하는) 형태로 분석을 하게 됩니다. 각각의 에러 양상에 따른 해결 방법과 추가적인 탐색 방법이 달라지기 때문입니다.
[ RPS - endpoint 처리량 ] 두 가지 측정 방법이 있습니다. (1)클라이언트 워커 수를 늘려 트래픽을 점진적으로 올렸을 때 어느 지점이 포화지점인지 확인합니다. 혹은 (2)동일한 워커 수로 트래픽을 흘리고 있을 때 rps가 흔들림 없이 일정하게 유지되는지 확인합니다. 예상치 못하게 너무 작은 rps 상황에서 포화지점에 도달한 걸로 보이거나, rps가 급격하게 흔들린다면 문제가 발생한 상황으로 인지하고 다음 레이어로 넘어가서 원인을 파악합니다.
[ Latency — P50 / P95 / P99 응답 시간 ] 어떤 percentile이 먼저 튀는가를 통해 내부 병목 포인트를 확인할 수 있습니다. P50은 대부분의 사용자 경험, P95·P99는 worst case입니다. P95, P99가 급격하게 증가하는 경우 내부 처리량 한계를 의심하고 튜닝포인트를 추가로 잡을 수 있습니다. 외에도 P50이 기존 리얼 환경에 비해 혹은 스트레스 테스트의 목표치에 비해 응답시간이 길어지는 상황일 때도 비정상으로 인식하고 추가적인 튜닝 혹은 원인을 파악합니다.
[ Error rate — 5xx / timeout / 비즈니스 에러 비율 ] 에러는 특히나 양상이 다를 수 있어서 근본적인 원인 파악에 집중해야 합니다. 차라리 에러율이 발생할 때는 비정상 지표임을 더더욱 확신할 수 있는 경우입니다. 5xx의 경우 서버에서의 처리량 한계에 도달한 경우일 가능성이 높으며 부하상황의 원인을 파악해야 하는 경우입니다. timeout이 클라이언트 cutoff로 인한 상황이라면 생성한 클라이언트 쪽 자원이 부족하지 않은지 확인을 해볼 수 있습니다. 외에도 400 에러가 발생한다면 비즈니스 로직 깨짐 상황일 가능성이 있어, 사전에 설정한 시나리오 데이터에 이상이 있는지 확인해 봅니다.
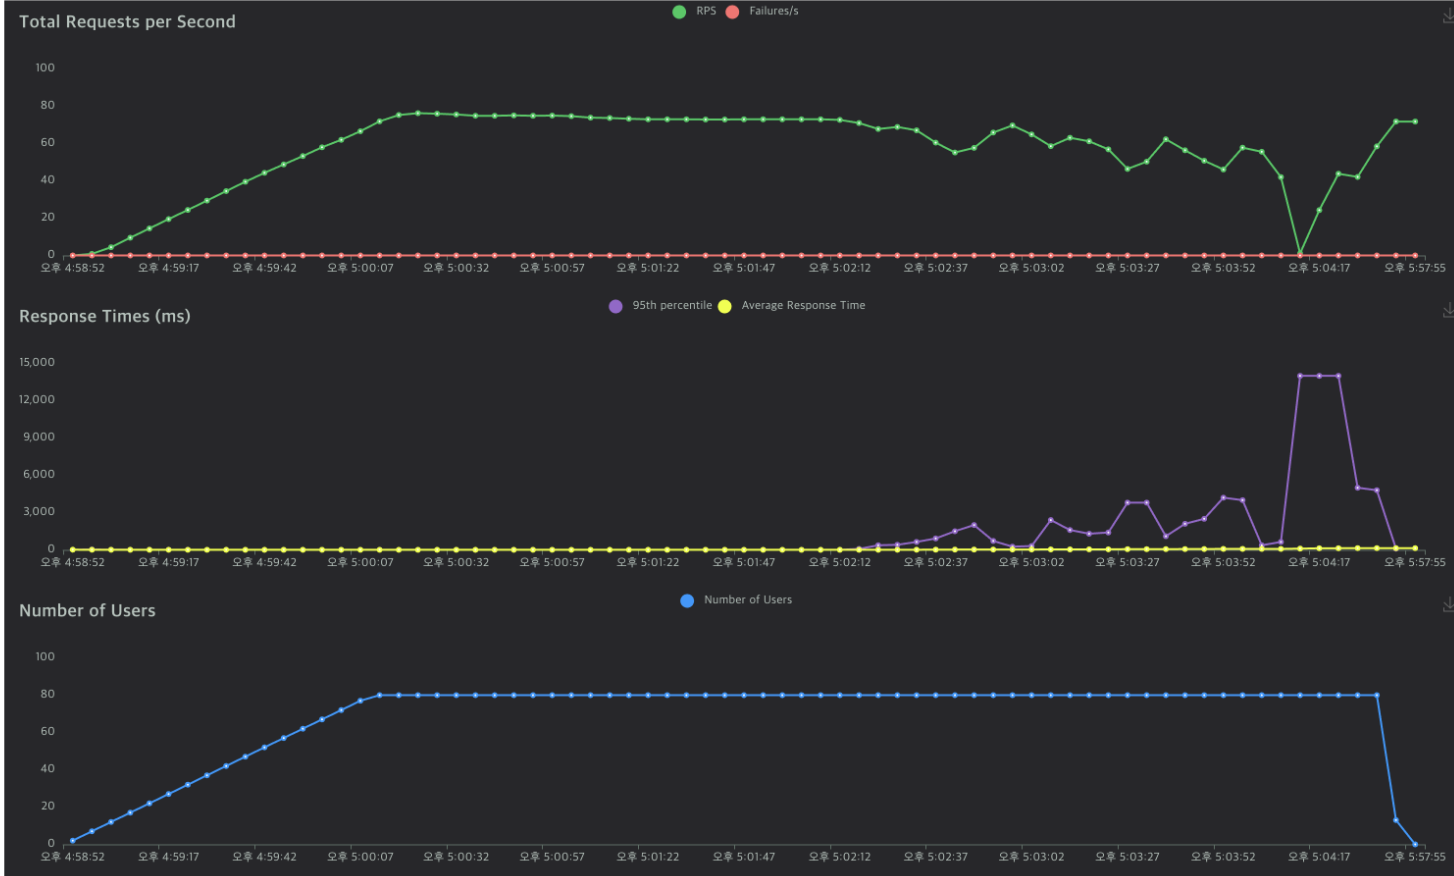
이처럼 원하는 시나리오의 트래픽을 흘렸을 때 RPS나 latency가 비선형으로 튀는 시점이 보이거나 에러가 발견된다면 좀 더 깊숙한 레이어의 디버깅이 필요합니다.
레이어 2 — 시스템 자원
다음으로 봐야 하는 부분은 시스템 자원 지표입니다. 단순히 서버가 죽지 않았거나 에러율이 0%이라 해서 정상 동작으로 인지하는 것이 아니라 평시와 peak 구간에서 각 자원이 얼마나 여유가 있는지를 확인해야 합니다. 즉, 서버가 위의 rps를 소화하는 데 어느 정도의 자원을 사용하는지 확인하는 것이죠. 외에도 측정한 RPS가 이상 상태로 보일 때 이 시스템 자원 지표는 간단하게는 병목으로 의심되는 범위를 좁혀줍니다.
- CPU (process / system load) -> thread / cpu profile 확인
- Memory(사용량 / RSS / 페이지 캐시) -> jvm heap 확인
- I/O(디스크 / 네트워크 I/O, file descriptor) -> 외부 호출 client / thread 확인
- 네트워크 대역폭 -> 네트워크 한계 확인
레이어 3 — JVM 런타임상태
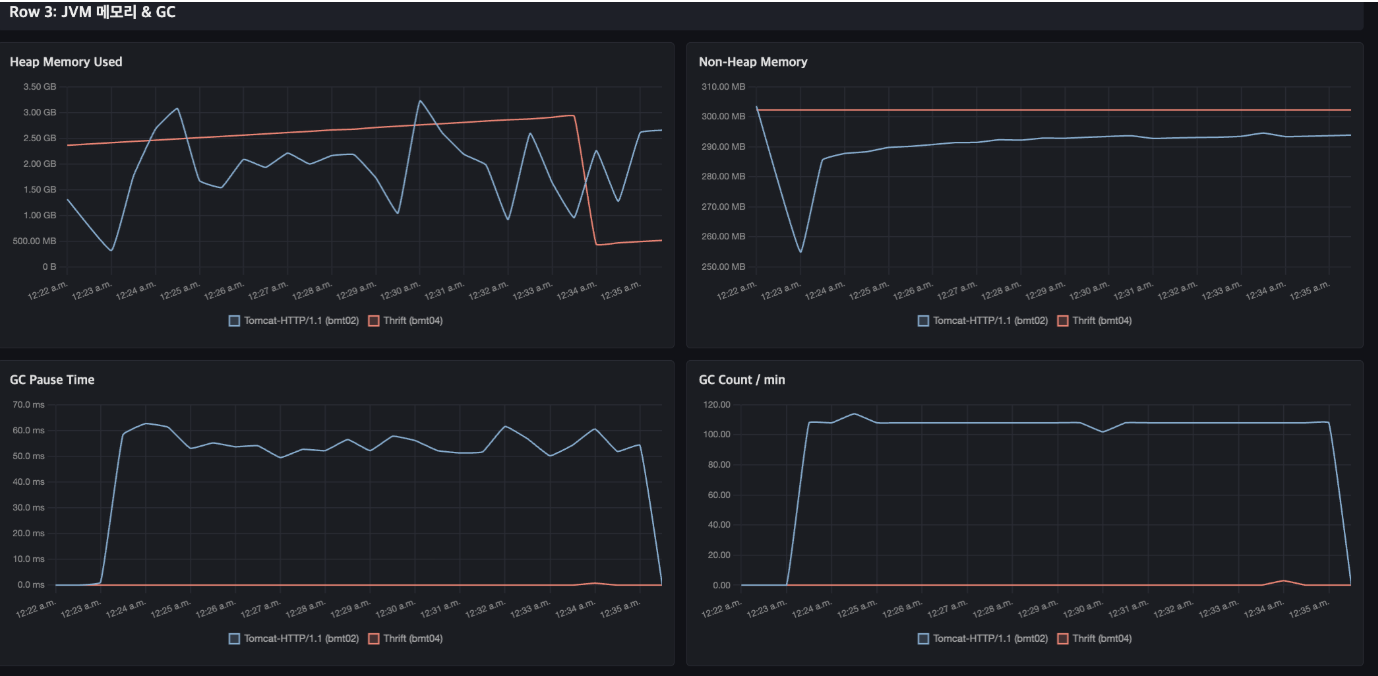
시스템 지원에 이상이 있다면 더 안쪽의 application 레벨 분석으로 나아가야 합니다. 현재 저희 시스템의 대부분이 JVM으로 되어있어 보통은 아래와 같은 시스템 지표들을 볼 수 있는 grafana를 만들어 두고 참고해 둡니다. 만약 부족한 지표가 있다면 추가적인 jvm metric을 노출시켜 추가적인 분석을 이어갑니다.
[ Thread state ] active / waiting / blocked / timed-waiting 분포를 확인합니다. blocked가 많아지면 lock 경합 신호고, waiting이 많아지면 외부 호출 응답을 기다리고 있다는 뜻입니다. thread가 똑같이 처리를 못하는 상황이지만 지표에 따라 의심되는 부분이 분리됩니다.
[ Executor queue ] 비동기 큐의 잔여 작업, prestart core size, 활성 thread 수를 같이 봅니다. queue remain 이 차오르기 시작하면 서버의 thread 처리 속도가 들어오는 요청의 속도를 못 따라간다는 뜻이기 때문에, 고부하 트래픽이 지속적으로 들어오거나, 또 다른 peak가 들어온다면 가장 먼저 문제가 발생할 부분입니다. 따라서 현재 서버에 할당된 core 수나 thread 수를 한번 더 확인하여 적절한 지점을 찾습니다.
[ GC pause ] pause count / sum / max, ZGC spike, allocation rate의 종합적인 지표를 함께 봅니다. allocation rate가 평소 대비 몇 배로 튀면 ‘일시적으로 사용하는 객체가 비정상적으로 많이 만들어지고 있다’ 는 신호고, 이게 누적되어 GC 가 못 따라가기 시작하면 heap에도 영향을 주게 됩니다. 외에도 GC pause가 길어지는 경우 latency가 급격하게 증가하는 현상도 발생 가능합니다. 이런 식으로 이상 GC 지표들은 추가적인 분석 후보가 됩니다.
[ Heap 사용량 추세 ] Old Gen의 증가 곡선과 GC 이후에도 회수되지 않는 영역을 주로 봅니다. heap이 시간에 따라 우상향만 하고 GC 후에도 평평하게 떨어지지 않으면, GC가 회수하지 못하는 객체가 누적되고 있다는 뜻이라, 해당 객체를 찾아내는 추가적인 분석이 필요합니다.
[ 커스텀 지표 ] 메시징에선 netty를 기반으로 한 서버로 프로토콜 요청응답을 처리하고 있어 netty pending queue라는 지표를 추가적으로 확인합니다. 트래픽이 많을 경우 pending이 쌓이면서 처리율이 고정되게 되고, 과도한 트래픽의 backpressure 역할을 하도록 설계되어 있습니다. 어찌됐든 서버 처리량에 문제가 있을 때 추가적으로 확인 가능한 부분이므로 각 애플리케이션의 성격에 따라 커스텀 지표도 도움이 됩니다.
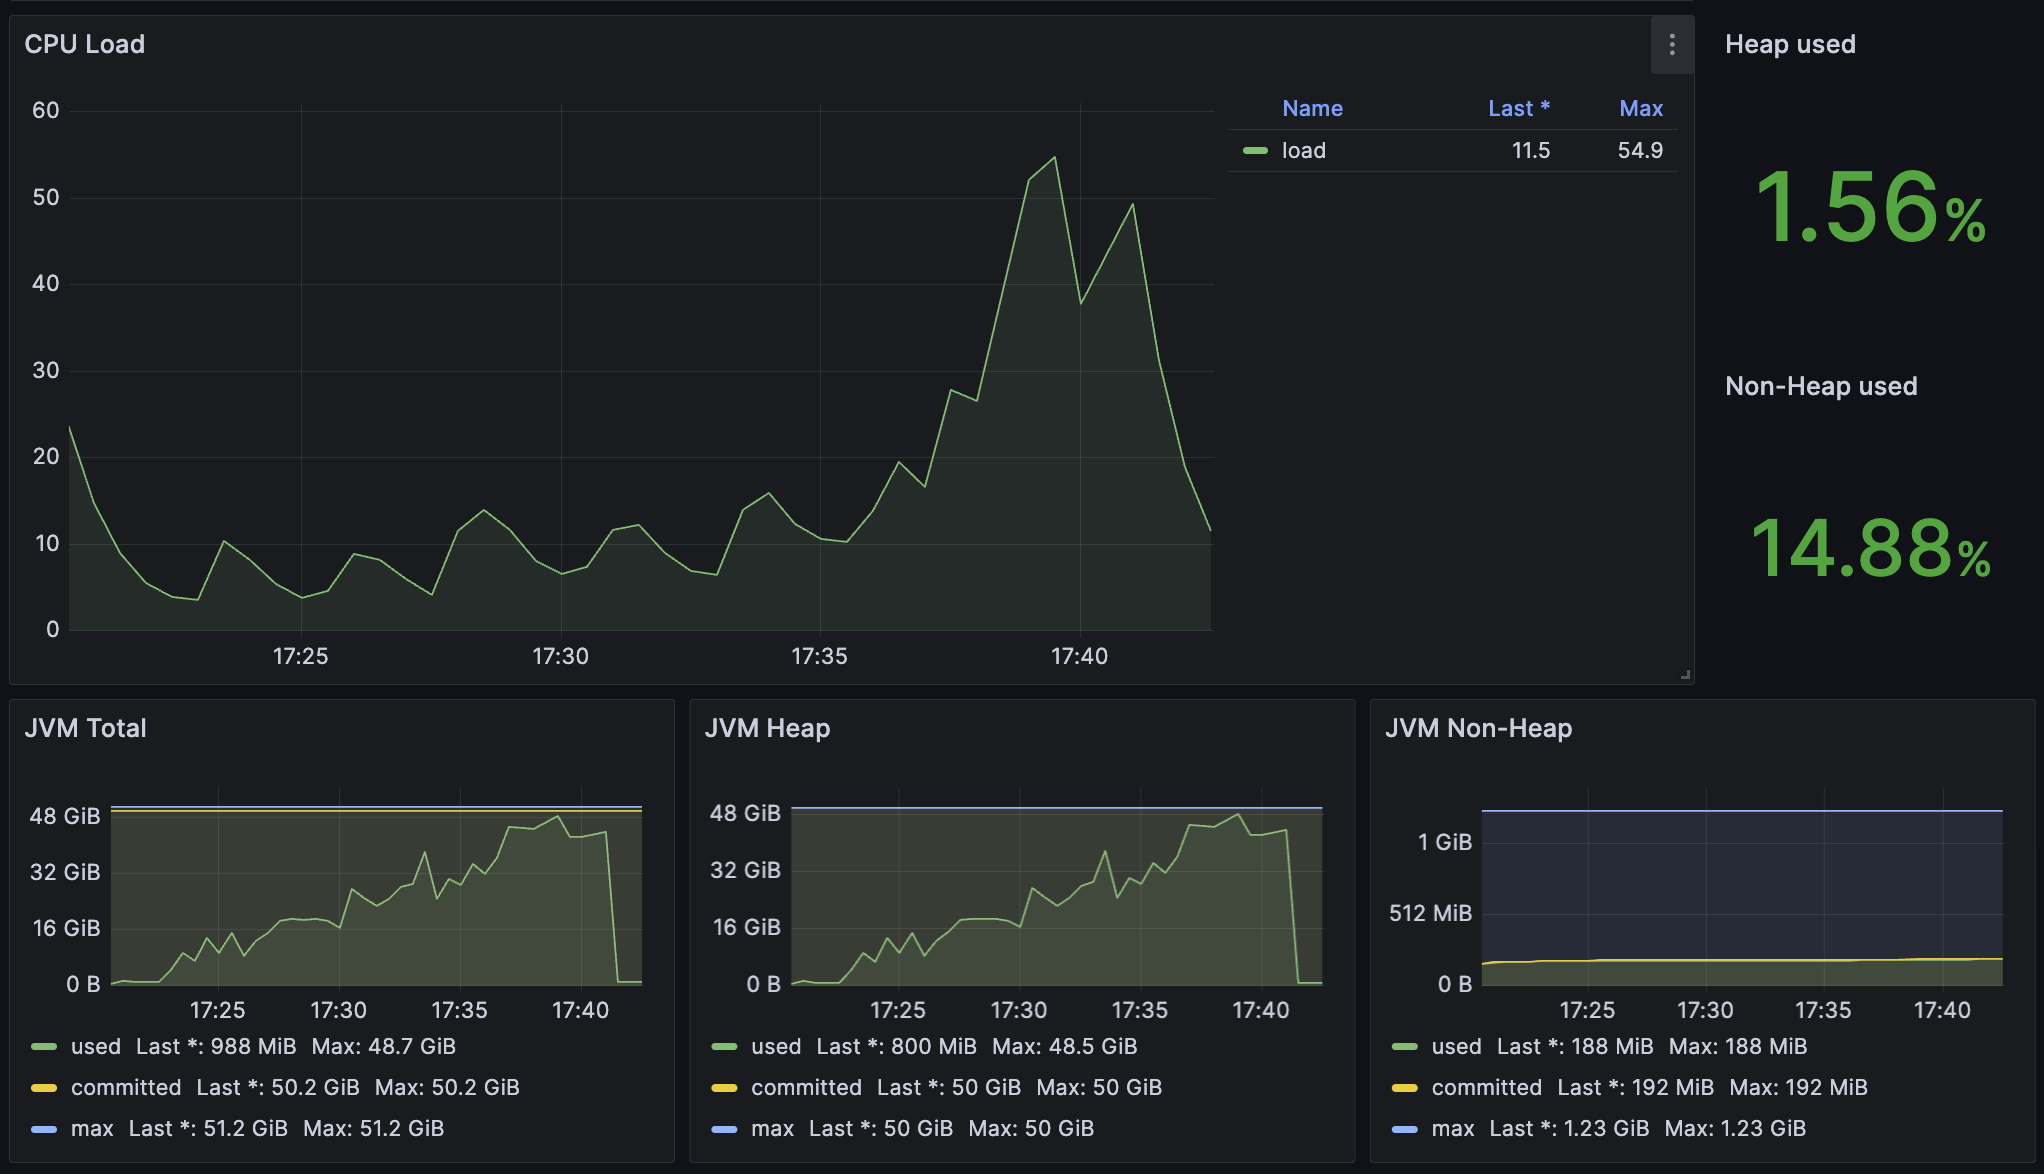
위 그림처럼 시스템 지표는 한 개의 항목이 단독으로 잡히기보다 여러 개 항목이 연쇄적으로 인과가 될 수 있습니다. 고부하 트래픽 테스트 시 heap 점유 → ZGC pause 가 못 따라감 → CPU load 상승 → executor queue 차오름 → readTimeout 으로 이어지는 병목 포인트가 있었습니다. 메모리에서 시작된 부하가 결국 CPU 와 큐로 옮겨 붙으면서 어느 한 항목만 봐서는 잡히지 않았기에 지표를 확인할 때도 원인과 결과의 관계를 확실히 규명할 수 있어야 합니다.
레이어 4 — 객체 레벨 디테일
[ heap dump로 메모리를 객체 단위로 들여다보기 ] 위 예시와 같이 heap이 시간에 따라 우상향만 하고 GC 이후에도 회수되지 않는 시점이 오면, 더 이상 메트릭 그래프로는 답이 안 나옵니다. 어떤 객체인지 판별해서 실제 근본적인 원인을 직접 확인해야하기 때문이죠. heap dump는 그 시점 JVM 안에 살아 있는 모든 객체와 객체 사이의 참조 관계를 통째로 떠 내는 메모리 스냅샷입니다. 어떤 객체가 얼마나 많이 어느 GC root에서 시작된 참조 경로로 살아남아 있는지를 객체 트리로 따라가면, 문제가 되는 코드 한 줄 까지 좁혀 들어갈 수 있습니다.
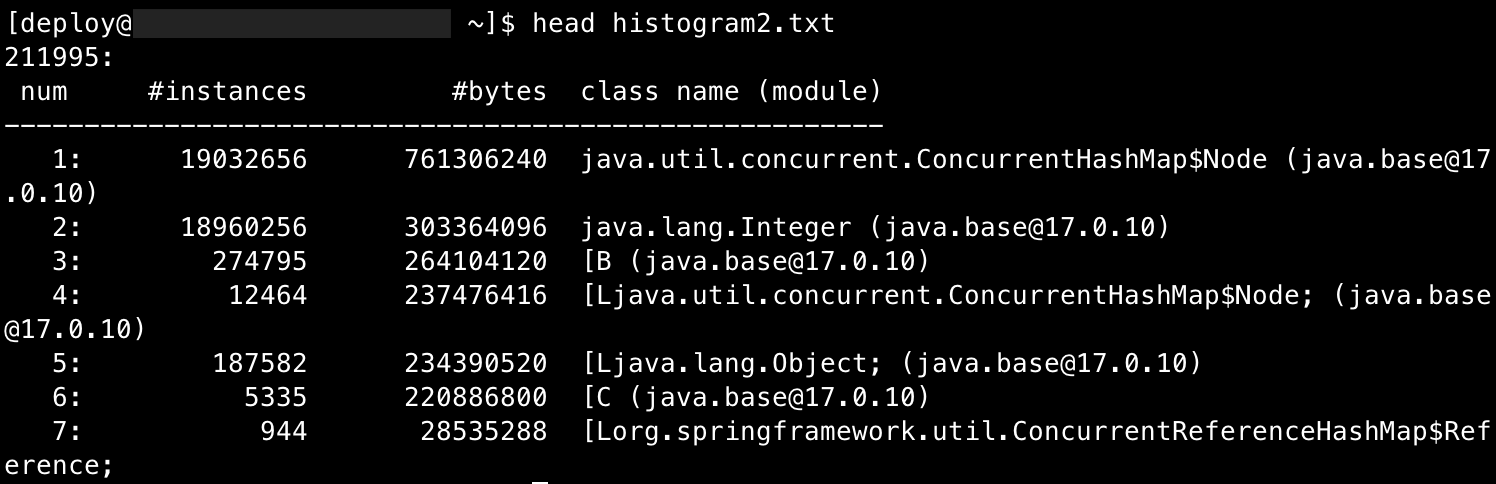
위 그림은 고부하 트래픽의 시나리오의 테스트에서 비즈니스 로직으로 객체의 생성속도 보다 GC가 못 따라가 old gen이 차오르는 경우에 발견했던 heap dump 결과 입니다. 이후 문제가 되는 부분의 코드를 수정하여 RPS 향상을 확인하였습니다.
[ cpu / thread 단 깊이가 필요한 경우 ] jvm 메모리 측면에서 heap dump의 예시를 설명드렸다면 다른 측면을 답하는 도구로 CPU profiling과 thread dump가 있습니다.
- CPU profiling (JFR ExecutionSample/ async-profiler) — CPU 자원을 어떤 메서드가 주로 점유해서 사용하는지 확인할 때 유용합니다. 일정 시간 동안 stack을 샘플링한 결과를 flame graph 로 시각화할 수 있기 때문에 아래 그림과 같이 stack trace를 메서드 단위까지 분해하여 분석이 가능합니다.
- Thread dump (jstack) — blocked, waiting과 같은 thread 상태의 한 시점 스냅샷을 확인할 수 있습니다. 어떤 stacktrace에서 유래된 쓰레드에서 현재 blocking으로 인한 병목이 있는지 확인할 때 사용 가능합니다. 두 지표 모두 thread와 관련된 지표 확인시 사용이 가능하지만 CPU가 높은 상황에서 이 한계 지점에 대한 파악이 필요한지, 혹은 CPU가 낮은데 처리율이 안나와서 병목지점을 확인해야하는지 용도에 따라 다르게 사용됩니다.
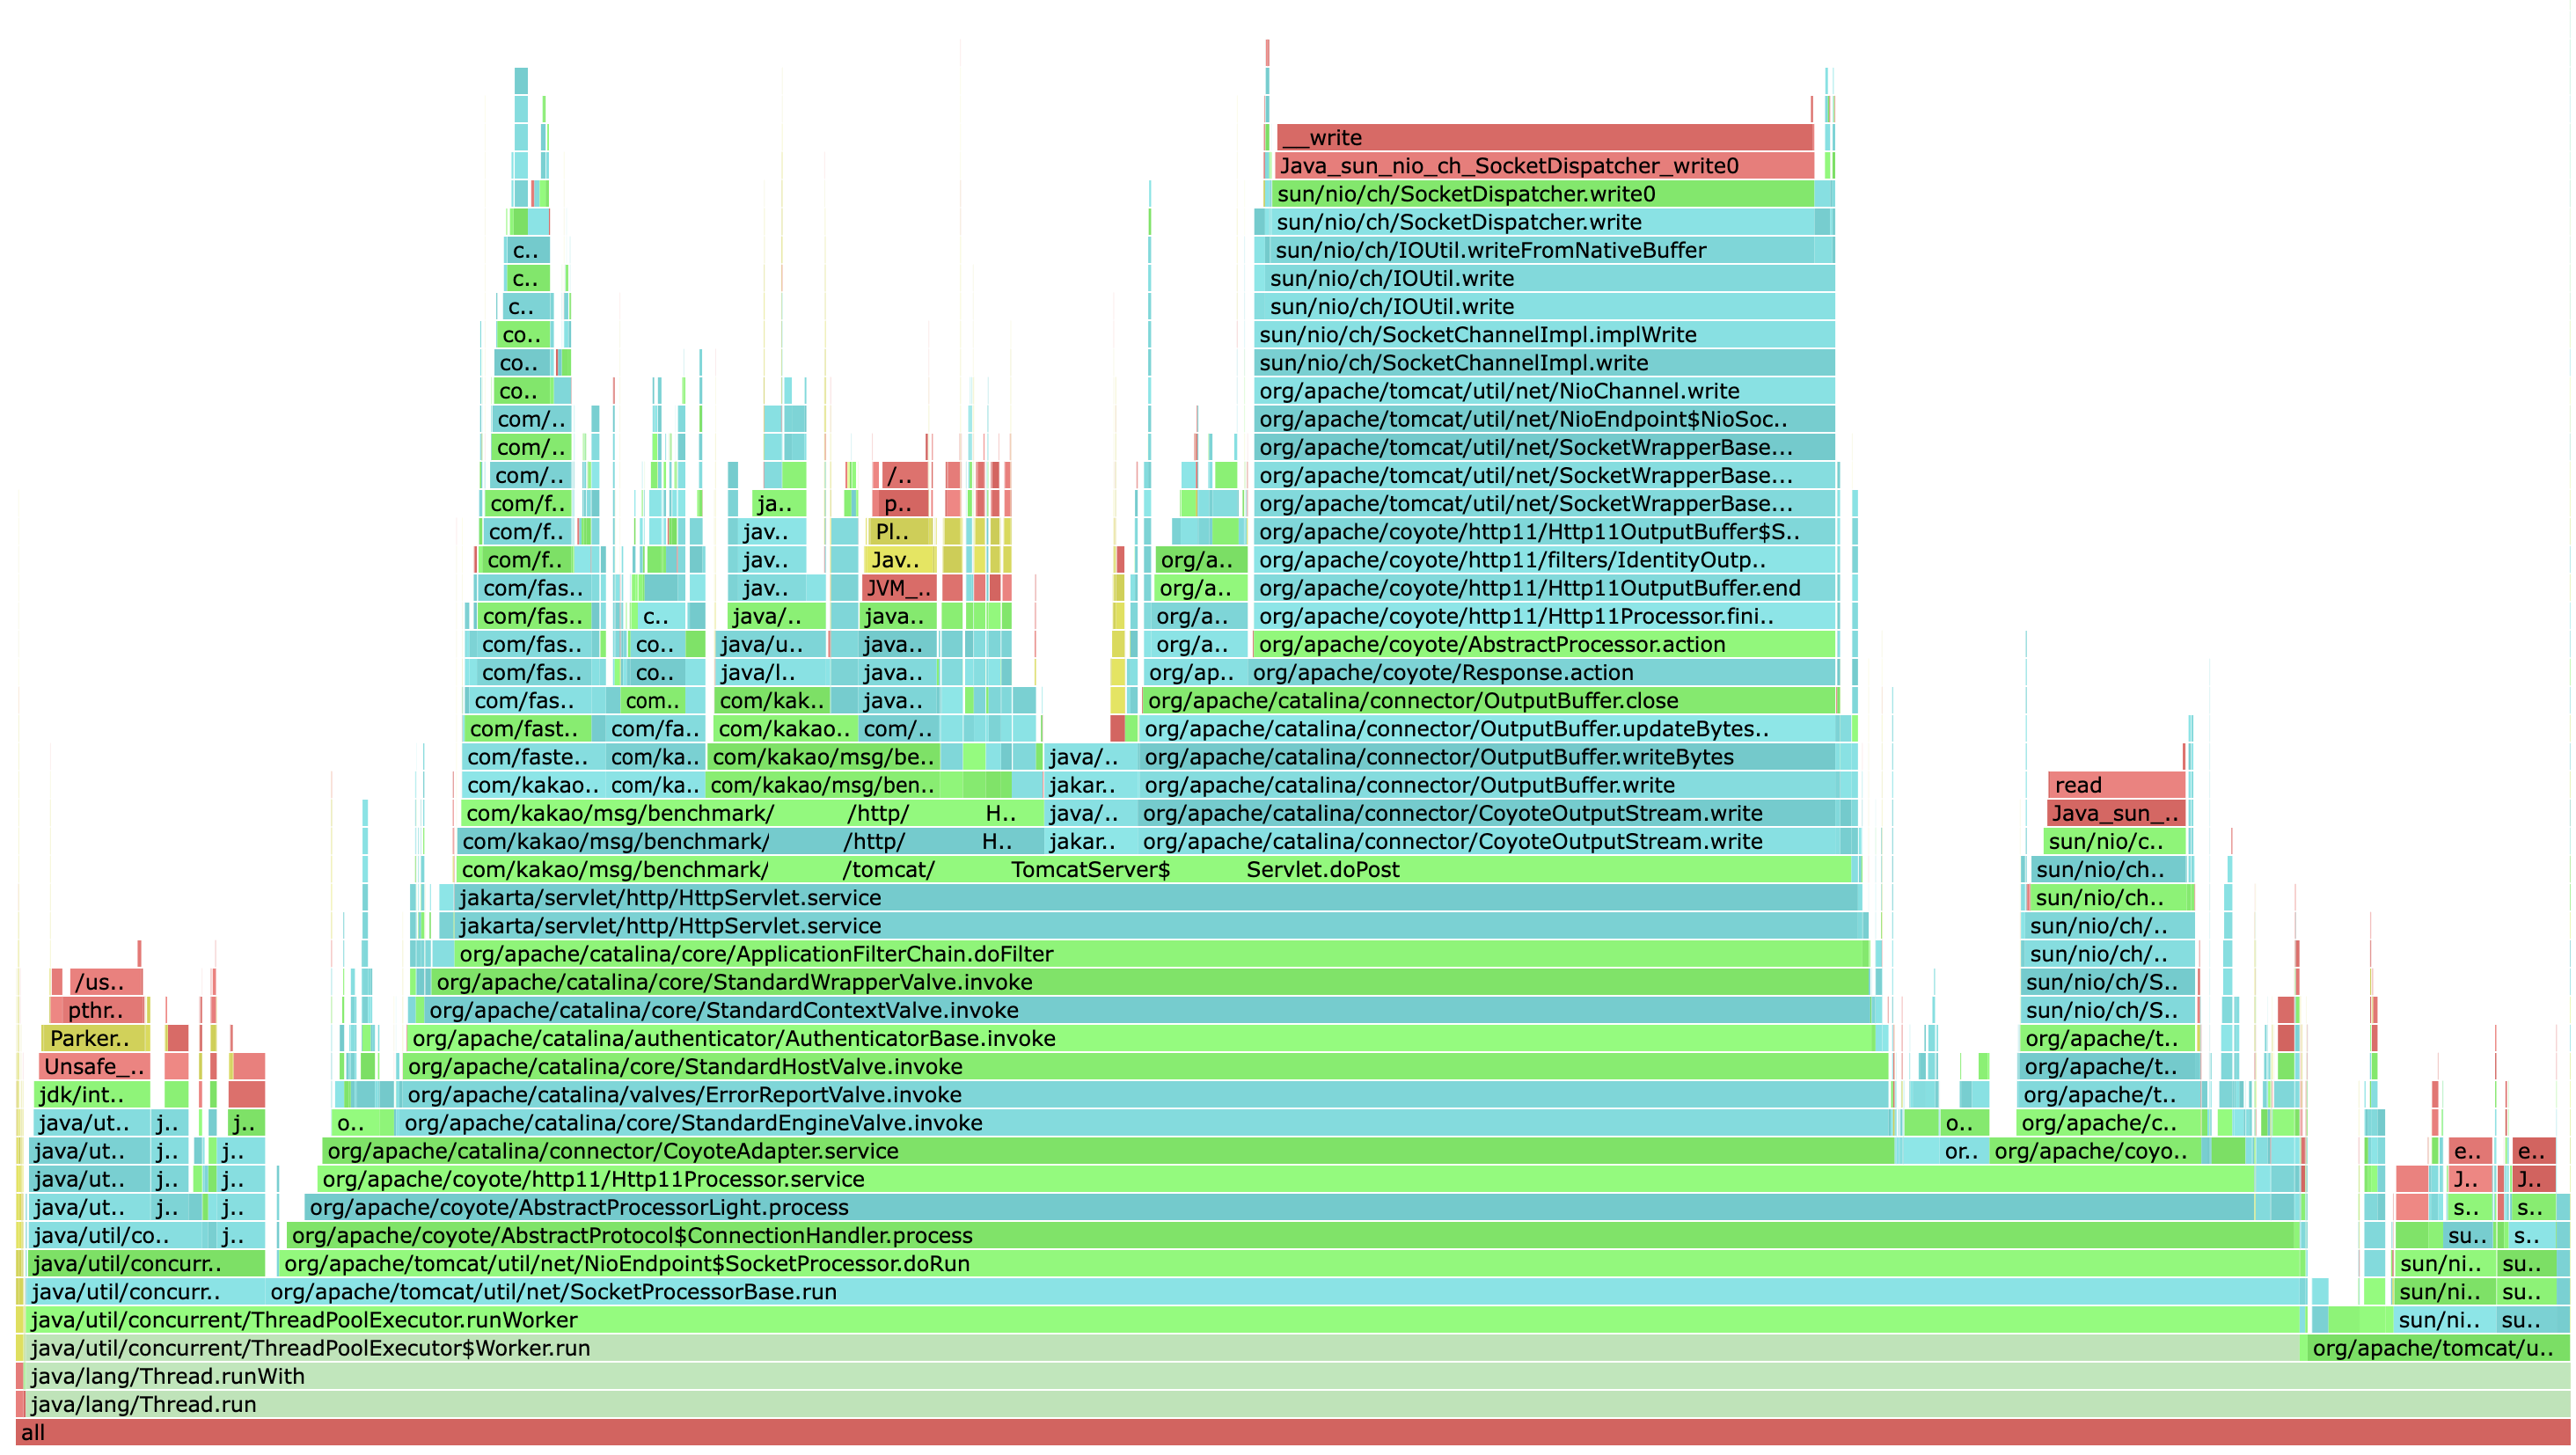
이 레이어까지 내려오면 이번 스트레스 테스트 라운드는 더 이상 측정이 아니라 코드 수정을 위한 디버깅 단계에 가깝습니다. layer3 에서 언급한 heap memory usage, cpu load, thread status 지표로도 어느정도 상황을 확인할 수 있으나 이 작업을 하는 이유는 stacktrace를 따라 문제 되는 코드를 찾아내기 위해 분석하는 상황도 필요하기 때문입니다. 제가 초반에 부하 테스트가 디버깅 같다고 했던 말이 이 레이어에서 가장 분명해집니다.
어디까지 내려갈 것인가 — 한 라운드의 깊이
지금까지의 이야기처럼 endpoint 지표부터 객체 레벨 디테일까지 잡고 나면 비로소 한 시나리오의 테스트 결과가 손에 잡힙니다.
- 먼저 endpoint 지표를 확인해 이상 여부를 판단하고,
- 시스템 자원이 한계라면 인프라 스케일 업/아웃 결정으로,
- JVM 런타임이 한계라면 튜닝 결정으로,
- 객체 레벨이 문제라면 코드 픽스 PR로 이어집니다.
- 전부 아니라면 추가할 만한 지표가 있는지를 다시 봅니다.
그래서 스트레스 테스트 한 사이클의 무게는 어디까지 확인했는가에 따라 결정됩니다. 가장 바깥 레이어인 endpoint 지표만 보고 만족스러운 지표로 확인 후 쉽게 끝날 수도 있으면서도, 가장 안쪽인 stracktrace 분석까지 시간투자를 많이 해야 하는 경우도 있습니다.
2.4 스트레스 테스트를 의사결정의 근거로 만드는 다섯 가지
그럼 매 스트레스 테스트 측정마다 가장 깊은 단까지 매번 반복해서 봐야 할까요? 결국 스트레스 테스트의 목적에 따라 다릅니다. 고부하를 받기 위한 추가적인 튜닝을 목표로 할 수도 있고, 평시와 동일하게 받는게 목표일 수도 있습니다. 이런 목적은 결국 '지금 변경이 괜찮다, 아니다’라는 근거를 만들기 위함이라고 생각합니다. 따라서 의사결정을 위해 놓치지 않아야 하는 원칙들을 짚어보았습니다.
원칙 1 — 측정 목적
테스트의 목적이 한 줄로 정해져야 뒤에 따르는 과정과 그 결과를 분석하는 과정이 의미있게 됩니다.
2.1 현재 테스트 환경의 구성 에서 이야기한 것 처럼 어떤 트래픽 시나리오로 테스트를 할 지를 분명히 할 수 있게 됩니다. 이에 따라 원하는 트래픽 세팅 값을 조절해가면서 의도를 담아 테스트를 할 수 있게 됩니다.
두번째로 2.3 측정한 지표에서 확인해야하는 요소들 에서 이야기 했듯이 결과를 확인할 때 어느 레이어의 지표까지 고려하고 확인할 지도 정해집니다. 예를 들어 '평시 트래픽에서 netty worker 수 조정 세팅을 찾는 것' 이 목적이라면, 각 세팅별 RPS 부하 포인트만 찾아내도 충분합니다. 굳이 객체 레벨까지 내려가지 않아도 결과를 낼 수 있습니다.
이런 목적을 잡는 것이 어렵다면 ‘성능 부족 / 유지보수·확장 / 신기술 도입 / 보안·규정’ 중 우선 현재 고민하고 있는 포인트가 어떤 부분인지 고려해보시면 좋습니다.
원칙 2 — 현재 서비스 구조 분석
개편 후가 좋다 를 보이려면, 먼저 개편 전 숫자가 있어야 합니다. 특히 프레임워크 변경이나 새로운 컴포넌트 도입으로 인해 성능저하가 예상되는 상황이라도, 어느 정도의 트레이드 오프를 감안해서 운영 상의 이득을 얻을 수 있는지 혹은 개발자의 편의가 향상되는지를 기존 메트릭에 대비해 수치화할 수 있어야 합니다.
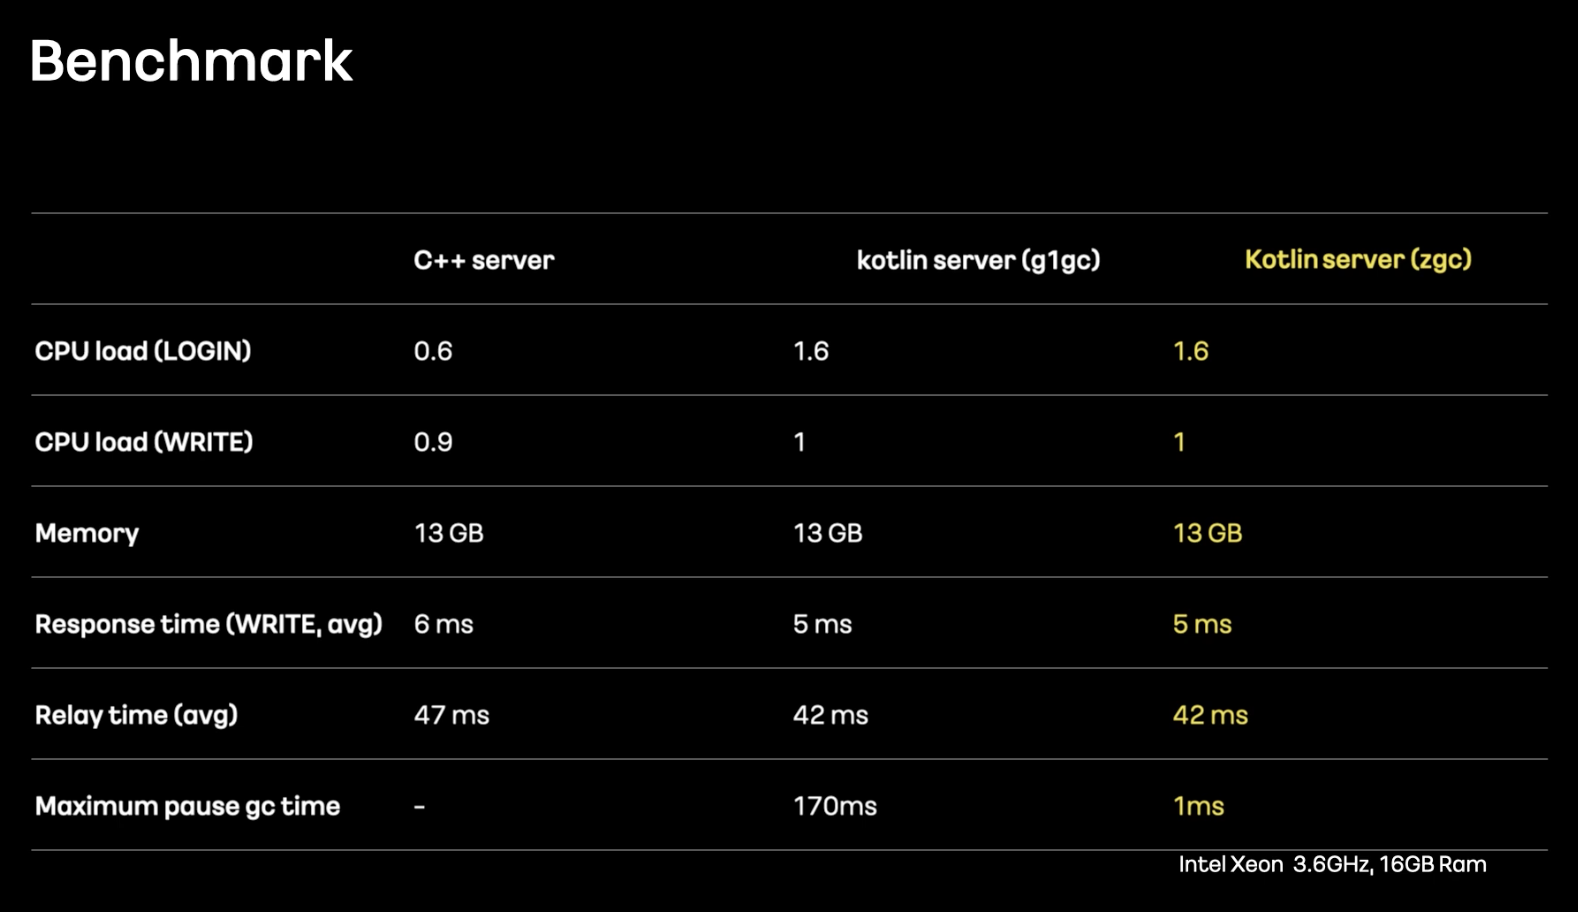
고려해야 하는 수치적 요소들입니다.
- 해당 서버의 endpoint 의 총 RPS / CPU 사용량 / Memory 사용량 (평시 / peak)
- 해당 서버의 endpoint 의 대당 RPS / CPU 사용량 / Memory 사용량 (평시 / peak)
- 해당 서버의 커넥션 특징 (server-to-server, 커넥션 수)
- 해당 서버의 비즈니스 로직상 특징: 프로토콜 부하 vs 비즈니스 로직 부하의 비중
여기서 RPS 를 총 과 대당으로 나누어 적은 이유가 있습니다. 부하 테스트를 하더라도 실제 서버를 리얼 서버만큼 서버를 받아서 테스트할 수 없는 경우 스트레스 테스트 장비 양이 훨씬 적기 때문에, 두 환경의 절대 수치를 그대로 비교할 수는 없습니다. 그래서 기본적인 비교는 대당 RPS 기준으로 잡고, 거기에 더해 개편 후 총 RPS가 어떻게 움직일지를 별도로 제안할 수 있어야 합니다.
이런 수치적인 지표를 근거로 산술적인 계산을 더하면 '성능 저하의 트레이드 오프가 있더라도 현재 서버 대수로도 운영이 가능하다' 와 같은 운영 측 결론이 나옵니다. 그래서 저는 기존 지표의 경우 평시/부하 시점의 지표를 대당·총으로 모두 캡쳐해 두고, 개편 후 측정치와 직접 줄세워 비교하고 전후 변경으로 어느 정도의 리소스 증감이 있는지를 정리해두곤 합니다.
원칙 3 — 후보군 추리기
이 단계는 모든 스트레스 테스트에 들어가지는 않습니다. 비교해야 하는 후보군이 많은 경우에 들어가는 step 인데요. 여러 기술 중에 선택의 근거를 만들어나가는 과정입니다. 비교군 전부 다 테스트해보면 좋겠지만, 개발자의 리소스는 한정되어 있기 때문에 '여러 후보 중 어느 조합이 우리 환경에 맞는가’는 꼭 생각해봐야 하는 요소입니다.
예시) 프로토콜 프레임워크 개편이 필요해서 여러 후보군을 조사하는 상황
클라이언트 라이브러리 × 인코더/디코더 × 프로토콜 × 서버 프레임워크
위 예시와 같이 너무 많은 후보를 동시에 비교하면 테스트와 해석 둘다 의미가 없어지는 데이터들이 많아질 수 있습니다. 따라서 여기 각각의 변인이 되는 요소들을 실제 측정 전에 최대한 줄여나가는것이 좋습니다.
이때 원칙 2에서 이야기했던 측정 대상의 서비스 구조 분석이 중요한 역할을 합니다. 저희 팀의 경우엔 실제 운영의 수월성이나 앞으로의 확장성을 기반으로 판단을 주로 했었습니다.
- 우리 도메인의 커넥션 특성 / 트래픽 패턴에 부합하는가
- 팀 내 운영 친숙도 / 모니터링 도구가 받쳐 주는가
- EOL / 라이선스 / 보안 정책에 막히지 않는가
원칙 4 — 비교군 통제
변경 전 후를 보여주고 싶다면 어떤 변경이 있었는지에 대해 변경되는 대상 외에는 전부 동일해야 근거가 탄탄해집니다. 따라서 여러 번의 스트레스 테스트를 돌리더라도 아래와 같은 비교 원칙을 세울 수 있습니다.
- 변경 요소 외에는 통일 — TPS, 부하 패턴(평시 / 버스트), 지속 시간, 측정 시점(같은 시각 / 같은 클러스터 상태), 장비, 서버 내부 로직, JVM heap까지 모두 통일합니다.
- 한 실험 = 한 변수 — 동시에 두가지 이상의 변수를 바꾸게 되면 결과가 잘 나오든 아니든 이 원인이 무엇인지 모르기 때문에 한번 더 통제해서 진행을 해야 하는 상황이 생길 수 있습니다.
- 지표는 객관적으로, 환경 정보 명시 필수 — CPU / 메모리, 부하 패턴, 측정 시간, 클라이언트 수, 그리고 그래프의 단위. 단위와 환경이 빠진 그래프는 이후에 해당 그래프를 다시 봤을 때 혹은 처음 보는 사람의 입장에서는 해석이 어려워지기 때문에 꼭 명시합니다.
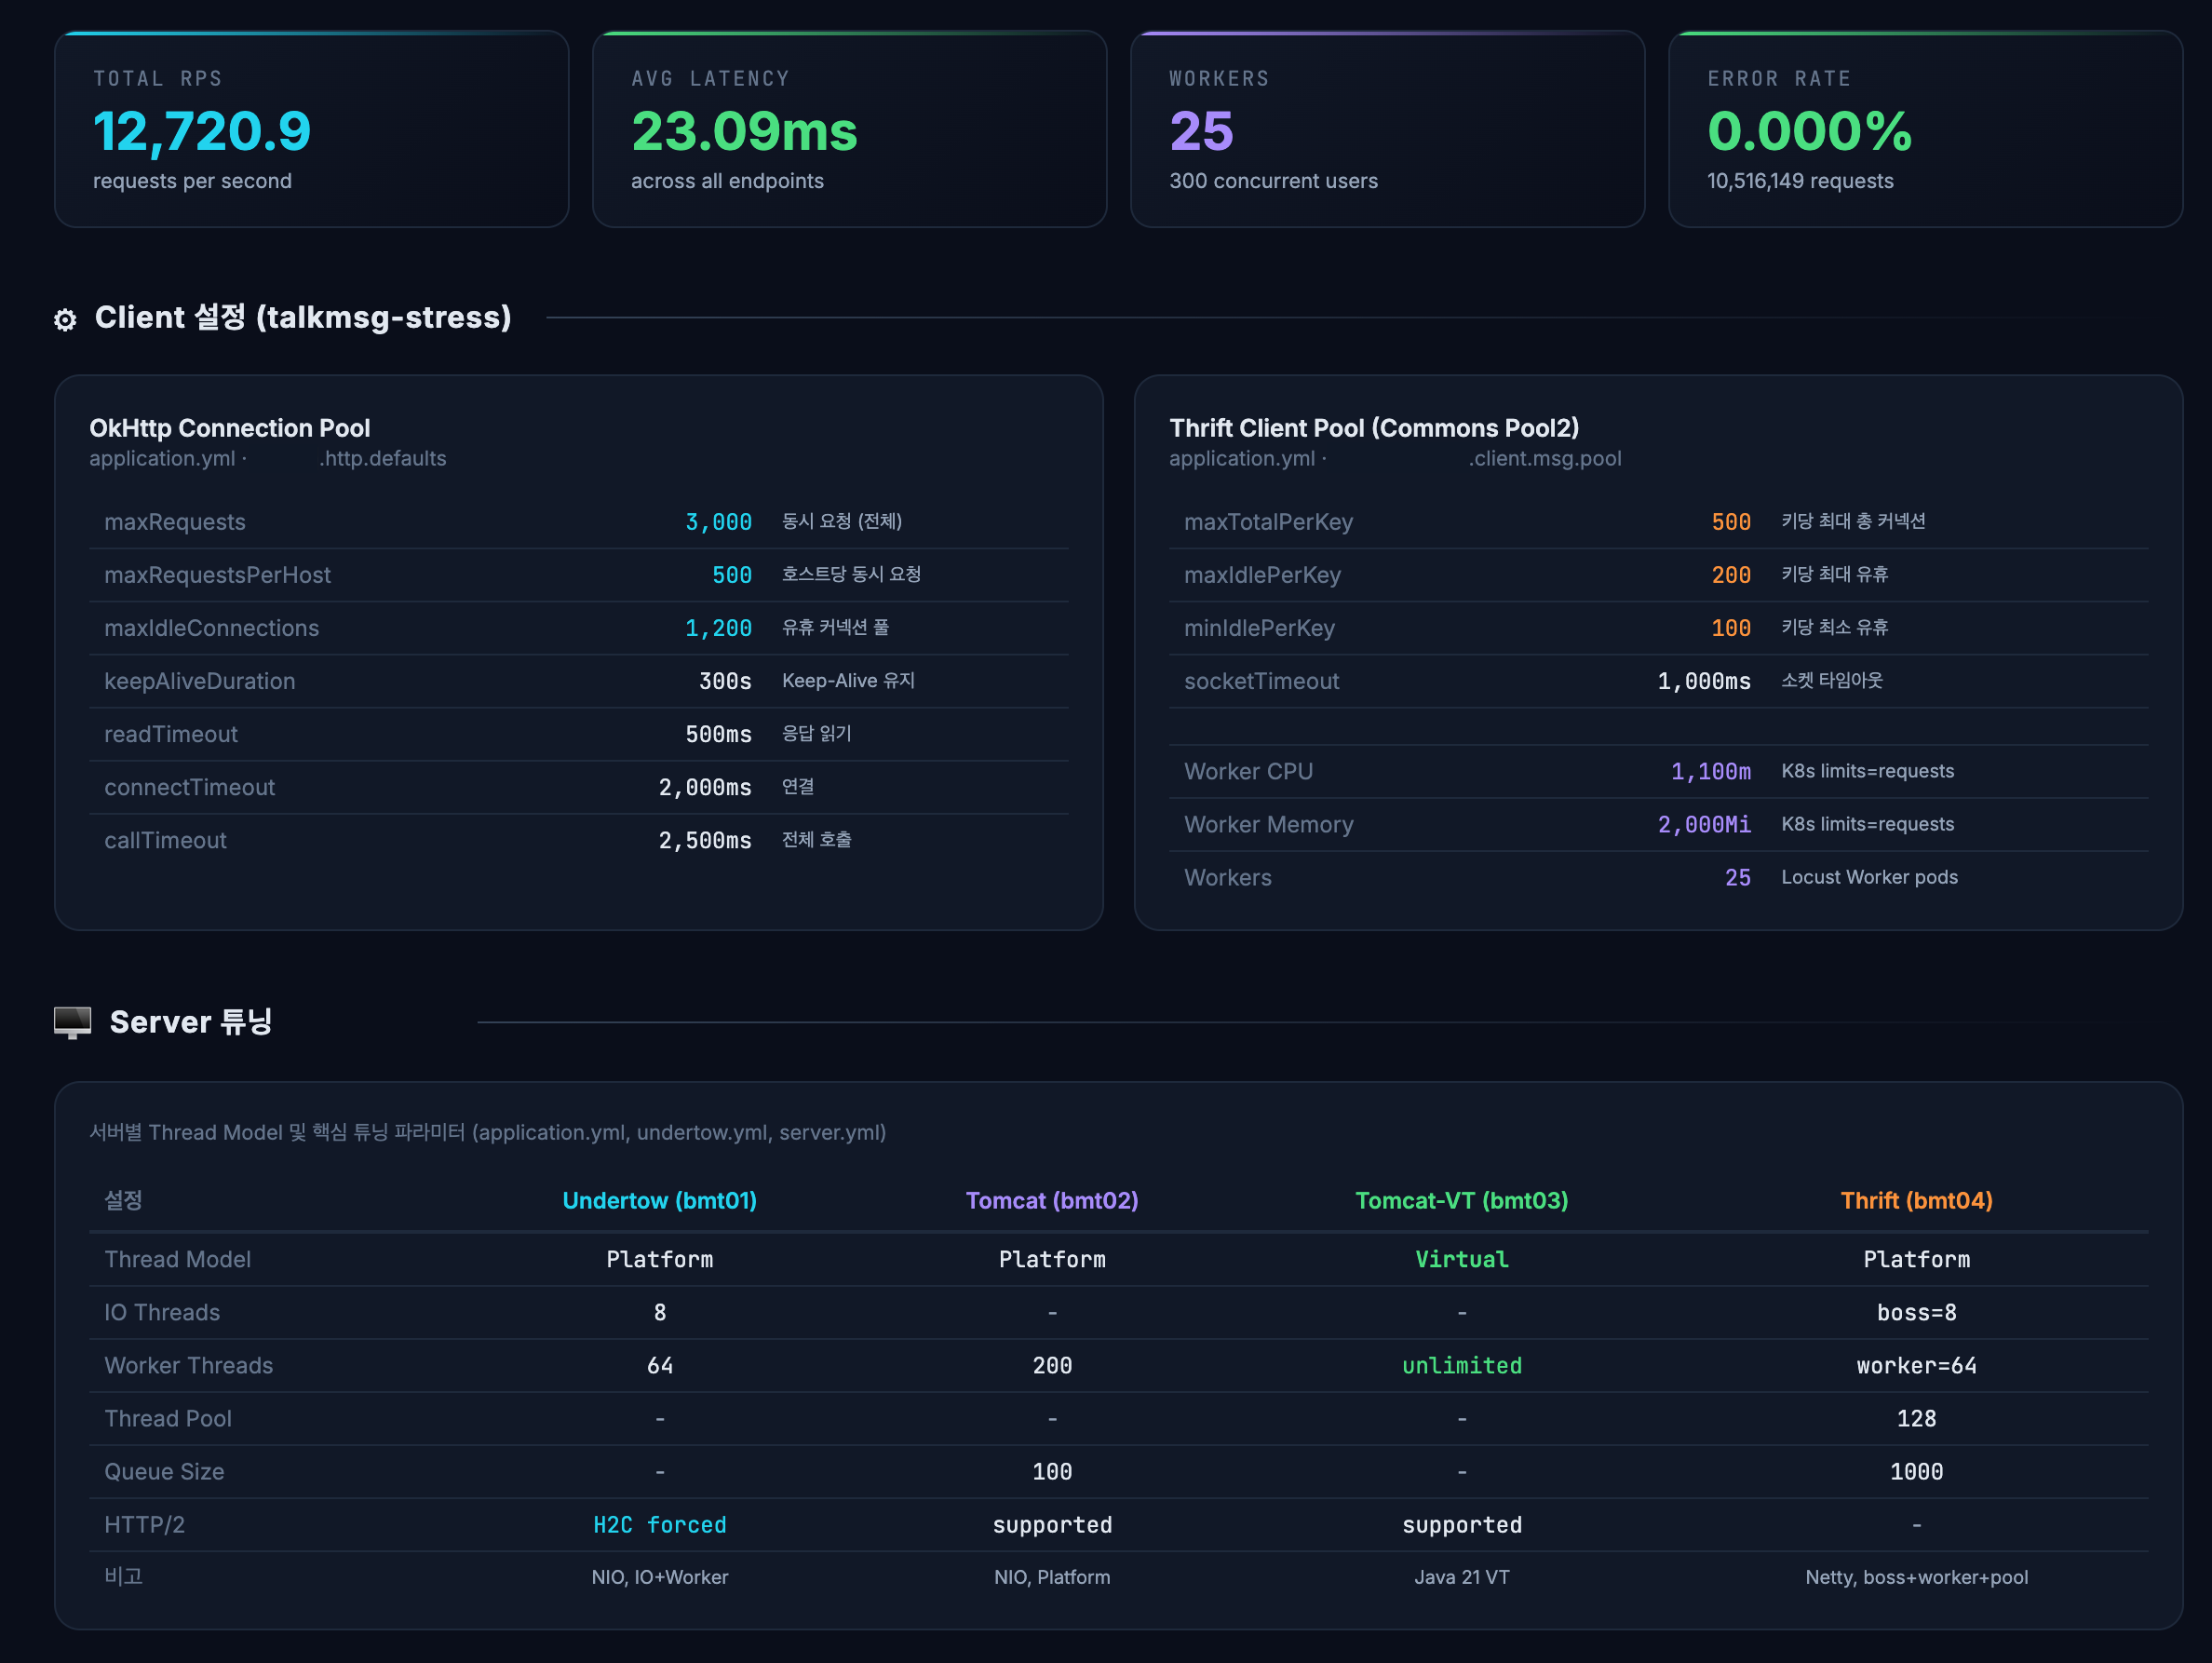
원칙 5 — 결과 정리 및 팀 공유
원칙 4 의 통제된 비교는 한 번에 끝나는 일이 아닙니다. 단일 변수 변경 후 테스트를 돌리고, 모든 지표 레이어를 확인한 후 원칙 1에서 설정한 목표에 지표가 가까워질 때까지 변수를 변경하면서 반복합니다. 목표에 가까워졌다면 마지막으로 팀이 의사결정에 쓸 수 있도록 정제합니다. 우선 반복되었던 테스트의 결과 설정값과 변경사항을 한 묶음으로 정리하고, 중요한 변경이 있었던 부분이 있었다면 그 부분은 주요 변수로 공유합니다
이때 의사결정에 도움이 되는 데이터는 결국 수치화된 지표이기 때문에 [[stress-test-with-llm-jyami#2.3 측정한 지표에서 확인해야하는 요소들]] 에 적은 지표를 가져갑니다. ‘문제없습니다’ 라는 한 줄이 아니라 숫자로 뒷받침하는 것이죠.
아래는 가상의 시나리오로 만든 예시입니다. 특정 모듈을 포팅해야 할 때 기존 대비 CPU 로드가 올라가는 상황입니다.
| 항목 | 변경 전 | 변경 후 |
|---|---|---|
| 대당 평균 CPU | 약 60% | 약 65% (+5%p) |
| 평시 40K TPS 처리에 필요한 인프라 | 120 대 | 약 130 대 (+10 대) |
표의 첫 번째 줄 처럼, 스트레스 테스트 대상인 서버 한 대의 그래프에서는 가벼워 보이는 수치일 수도 있습니다. 하지만 두 번째 줄에서 운영하 고있는 서버 대수를 고려했을 땐 의외로 커질 수 있습니다. 여러분들은 어떤 의사결정을 하실건가요?
동일한 CPU usage를 유지하고 싶은 상황이라면 CPU +5%p가 인프라 약 10대 증가라는 결정을 할 수 있습니다. 아니면 (2)추가적으로 튜닝할 만한 부분이 없는지 찾아 재테스트를 하는것도 의사결정의 하나가 될 수도 있습니다.
서버 개발자에게 성능 / 유지보수성 / 메모리 효율같은 다른 요소와의 트레이드 오프 고려는 항상 의사결정에서 중요했습니다. 따라서 이런 구체적인 수치를 근거로 한 결정은 힘을 가질 수 밖에 없습니다.
2.5 정리
지금까지 서버 개발자가 스트레스 테스트를 돌리고 그 결과를 분석할 때 어디까지 고민하는가를 풀어보았습니다. 어떤 환경으로 세팅했는지, 어떤 형태로 클라이언트를 구성하는지, 측정시 어떤 요소들을 봐야 하는지, 그리고 의사결정을 위해 집중해야 하는 사항들을 순서로 풀어보았습니다.
제가 글에 힘을 뺀 부분이 있습니다. 지금까지 판단과 의도에 대한 이야기를 집중적으로 했었는데, 반복에 대한 이야기가 빠져 있습니다. 테스트를 통해 최종결과를 만들 때 매 회차마다 클라이언트 수를 늘려 부하를 만들고, rps 그래프를 눈으로 확인하고, 결과 패널을 캡쳐하고, 표를 채우고, 같은 톤으로 문제를 분석해서 보고서를 정리하는 작업이 매번 반복됩니다. 매 스트레스 테스트의 '왜 수치가 이렇게 나왔는가’의 분석은 결국, 반복으로 나온 정밀한 분석이기 때문에 테스트를 위한 반복적인 시간은 어쩔수 없이 많이 들어가게 됩니다.
따라서 다음 파트에서는 반복되는 작업을 최대한 줄이고 실질적인 분석을 위한 시간을 늘리기 위해 AI를 어디까지 맡겨보았는지를 풀어보려 합니다.
Part 3. AI 로 스트레스 테스트의 스트레스를 줄이는 방법
3.1 반복되는 측정과정
처음에 저는 스트레스 테스트가 단순히 부하를 걸고 지표를 뽑는 일이라고 생각했습니다. 하지만 한번의 테스트 수행을 위해 필요했던 노력을 리스팅해보면 아래와 같습니다.
- 타겟 서버의 변경사항을 새 버전으로 빌드합니다.
- 빌드한 이미지로 타겟 서버를 배포합니다.
- 클라이언트의 시나리오에 변경사항이 있다면 클라이언트도 새 버전으로 빌드, 배포하고, 워커를 수백개로 scale-up합니다.
- 부하를 흘릴 클라이언트인 locust master에 명령을 보내 트래픽을 흘립니다.
- 사용자 수를 점진적으로 올려가면서 테스트합니다. 사용자 수를 10 > 50 > 100 > 150 … 와 같이 10번정도 늘리면서 반복하다보니 약 50분 정도 소요됩니다.
- 테스트를 종료하고 서버의 지표 캡쳐를 위해 grafana에서 RPS·latency·GC·스레드 풀·커넥션·CPU 같은 패널을 하나하나 캡처합니다.
- 해당 캡쳐를 옮겨서 이번 테스트에서 의미 있던 부분을 정리하고 완료 시 팀에 공유합니다.
한번에 1~6으로 끝나면 너무 좋겠지만, 대부분은 1~5의 과정을 10번 이상 반복합니다. 설정값 하나만 바꾸더라도 처음부터 다시 돌려야 하기 때문입니다. 저희 동료들끼리 하는말이 있습니다. “스트레스 테스트 돌리다가 내가 스트레스 받아버린다”라고 할 만큼, 테스트가 돌아가는 동안 대기하고 확인하는 과정에 지쳐가기 때문입니다.
3.2 업무에서 반복되는 작업을 그룹핑하여 자동화하기
현재 저희팀에서는 claude code + codex를 다들 선호에 따라 사용하고 있습니다. 팀원들 모두 AI 툴에 점점 익숙해짐에 따라 많은 운영 업무들을 이전보다 자동화 할 수 있었고, 그 중 하나가 스트레스 테스트입니다. 각 스텝마다 개발자가 손수 기계적으로 반복하는 작업들을 claude skill(혹은 command)로 분리하여 그룹핑합니다.
/deploy-target: 테스트 대상이 되는 서버의 이미지를 빌드, 푸시, 배포합니다. 배포가 완료되면 헬스체크 api로 정상 동작을 확인합니다./deploy-stress: 시나리오가 바뀔 때 클라이언트 코드가 변경되므로 이미지 빌드, 푸시, 배포합니다. 배포시 client 부하 분산을 위한 워커수를 지정하여 조정 가능합니다.(default:300)/run-stress: locust 마스터에 명령을 보내 트래픽을 흘립니다. 때때로 master가 죽어 있는 경우도 있어 검증을 위해 헬스체크를 진행합니다. 또한 현재 worker가 떠 있는지도 함께 확인합니다. SWARM / STOP / RESET/USER_COUNT 등의 명령어를 두어 트래픽을 쉽게 조절할 수 있습니다./render-dashboard: 테스트 대상 서버의 지표를 확인하는 대시보드의 json을 읽고 . 각 패널의 promQL을 지정 시간 범위로 쿼리해서 해당 테스트 시나리오 시간만큼을 HTML 파일로 만듭니다. 45분치 대시보드 전체가 하나의 html이 됩니다. 내부 지표 저장소가 영구적이지 않아 생각해 낸 방법입니다./make-report: 위에 만든 지표 html을 파싱하여 이번 테스트의 결과를 ai가 분석한 내용을 md 혹은 HTML 파일로 생성합니다.
기존에 하나하나 커맨드를 입력하면서 혹은 눈으로 확인하던 작업들을 이렇게 묶어두면, 개발자는 만들어진 결과를 확인하여 ai의 분석이 맞는지 확인하여 해석하는 일만 남게 됩니다.
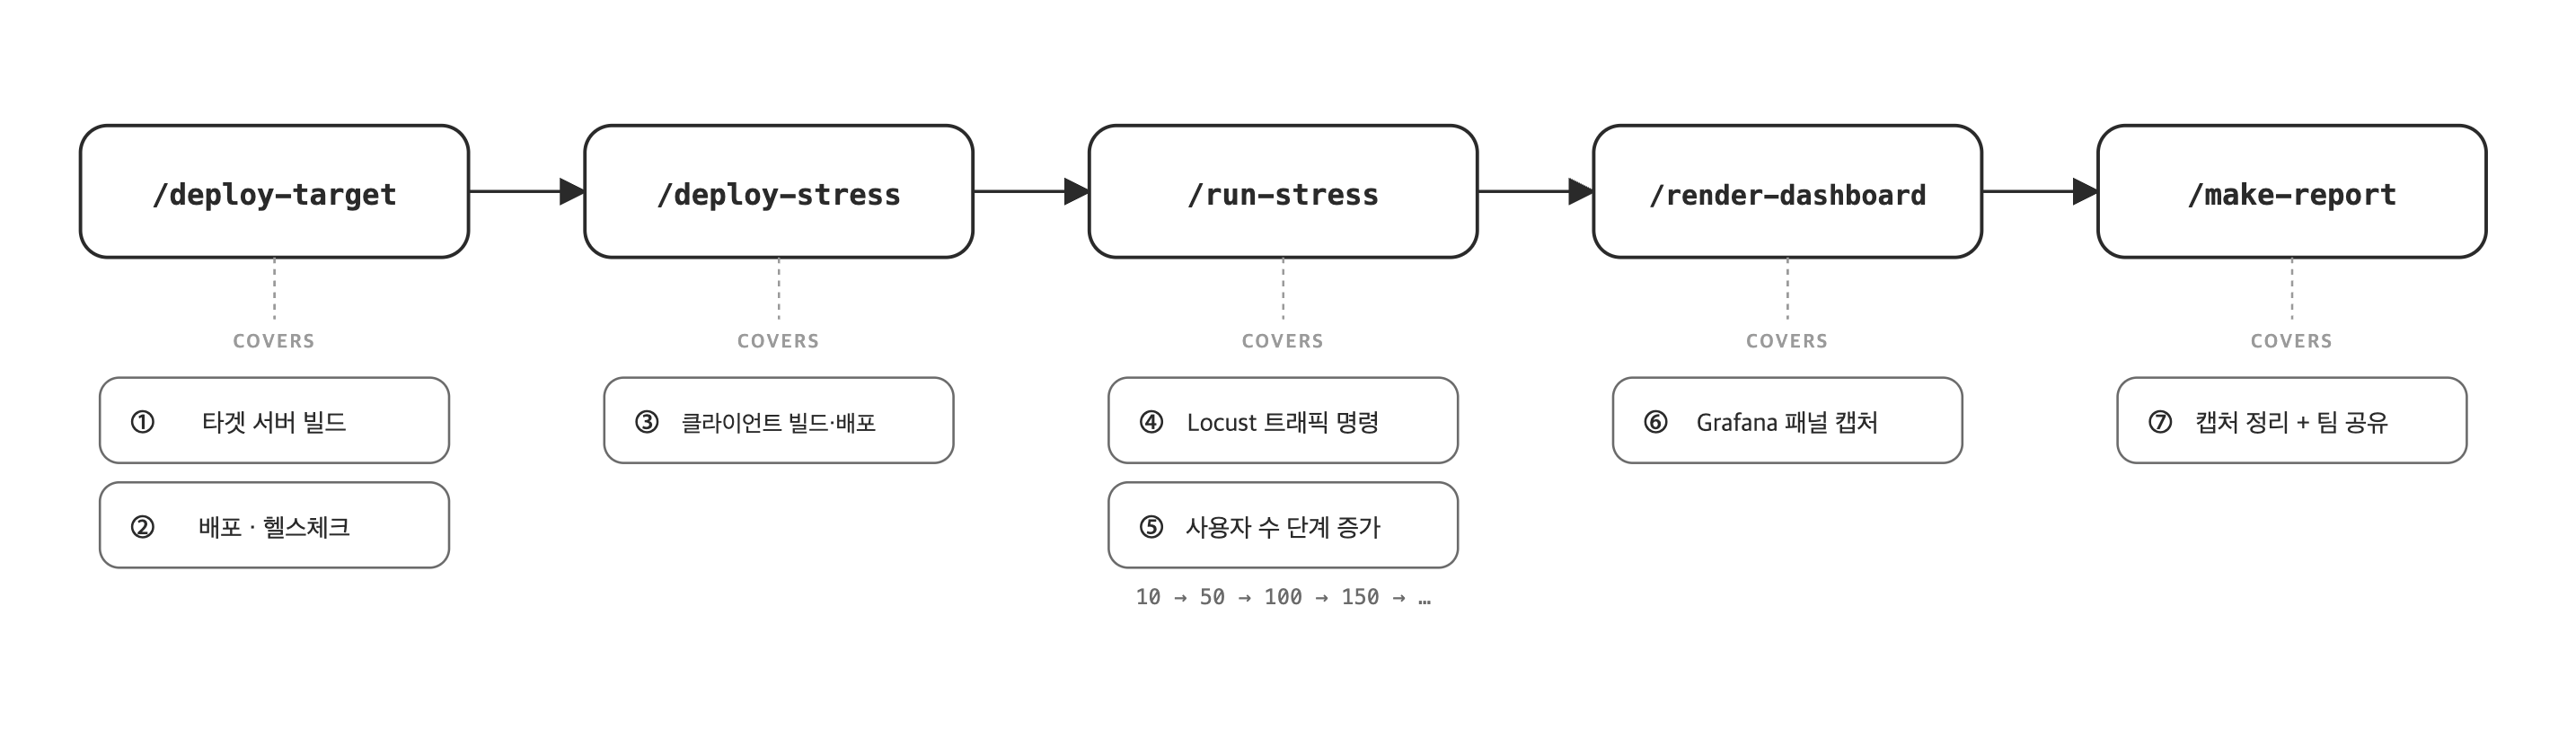
'기존에 명령어를 손수 여러 번 치던 걸 묶은건데, AI가 아니라 재사용 가능한 script를 만들면 되는 거 아냐?'라고 생각할 수 있으나, 사람이 판단하기에 묶음으로 동작해야 하는 작업을 명시했고, LLM 덕분에 고정적인 script가 아니더라도 빠르고 쉬운 변경이 가능해집니다. 또한 이런 skill 단위 묶음은 LLM이 orchestrator 역할을 할 수 있는 기반이 되어 자동화의 첫 시작이 됩니다.
3.3 한 라운드를 LLM 에게 맡기기
방금 실행한 round3와 같은 조건인데
target server의 compression type 을 application/json 으로
변경하여 비교 테스트 해줘.
위와 같은 의도 한 줄을 프롬프트로 입력하면 LLM 이 어떤 skill을 어떤 순서로 부를지를 알아서 결정해 제가 위에서부터 언급드린 스텝을 그대로 흘려줍니다. 작업 단위를 잘 분리해 둔 덕분에 LLM이 orchestrator 역할로서 알맞는 skill들 호출하면 되는 구조가 되었습니다.
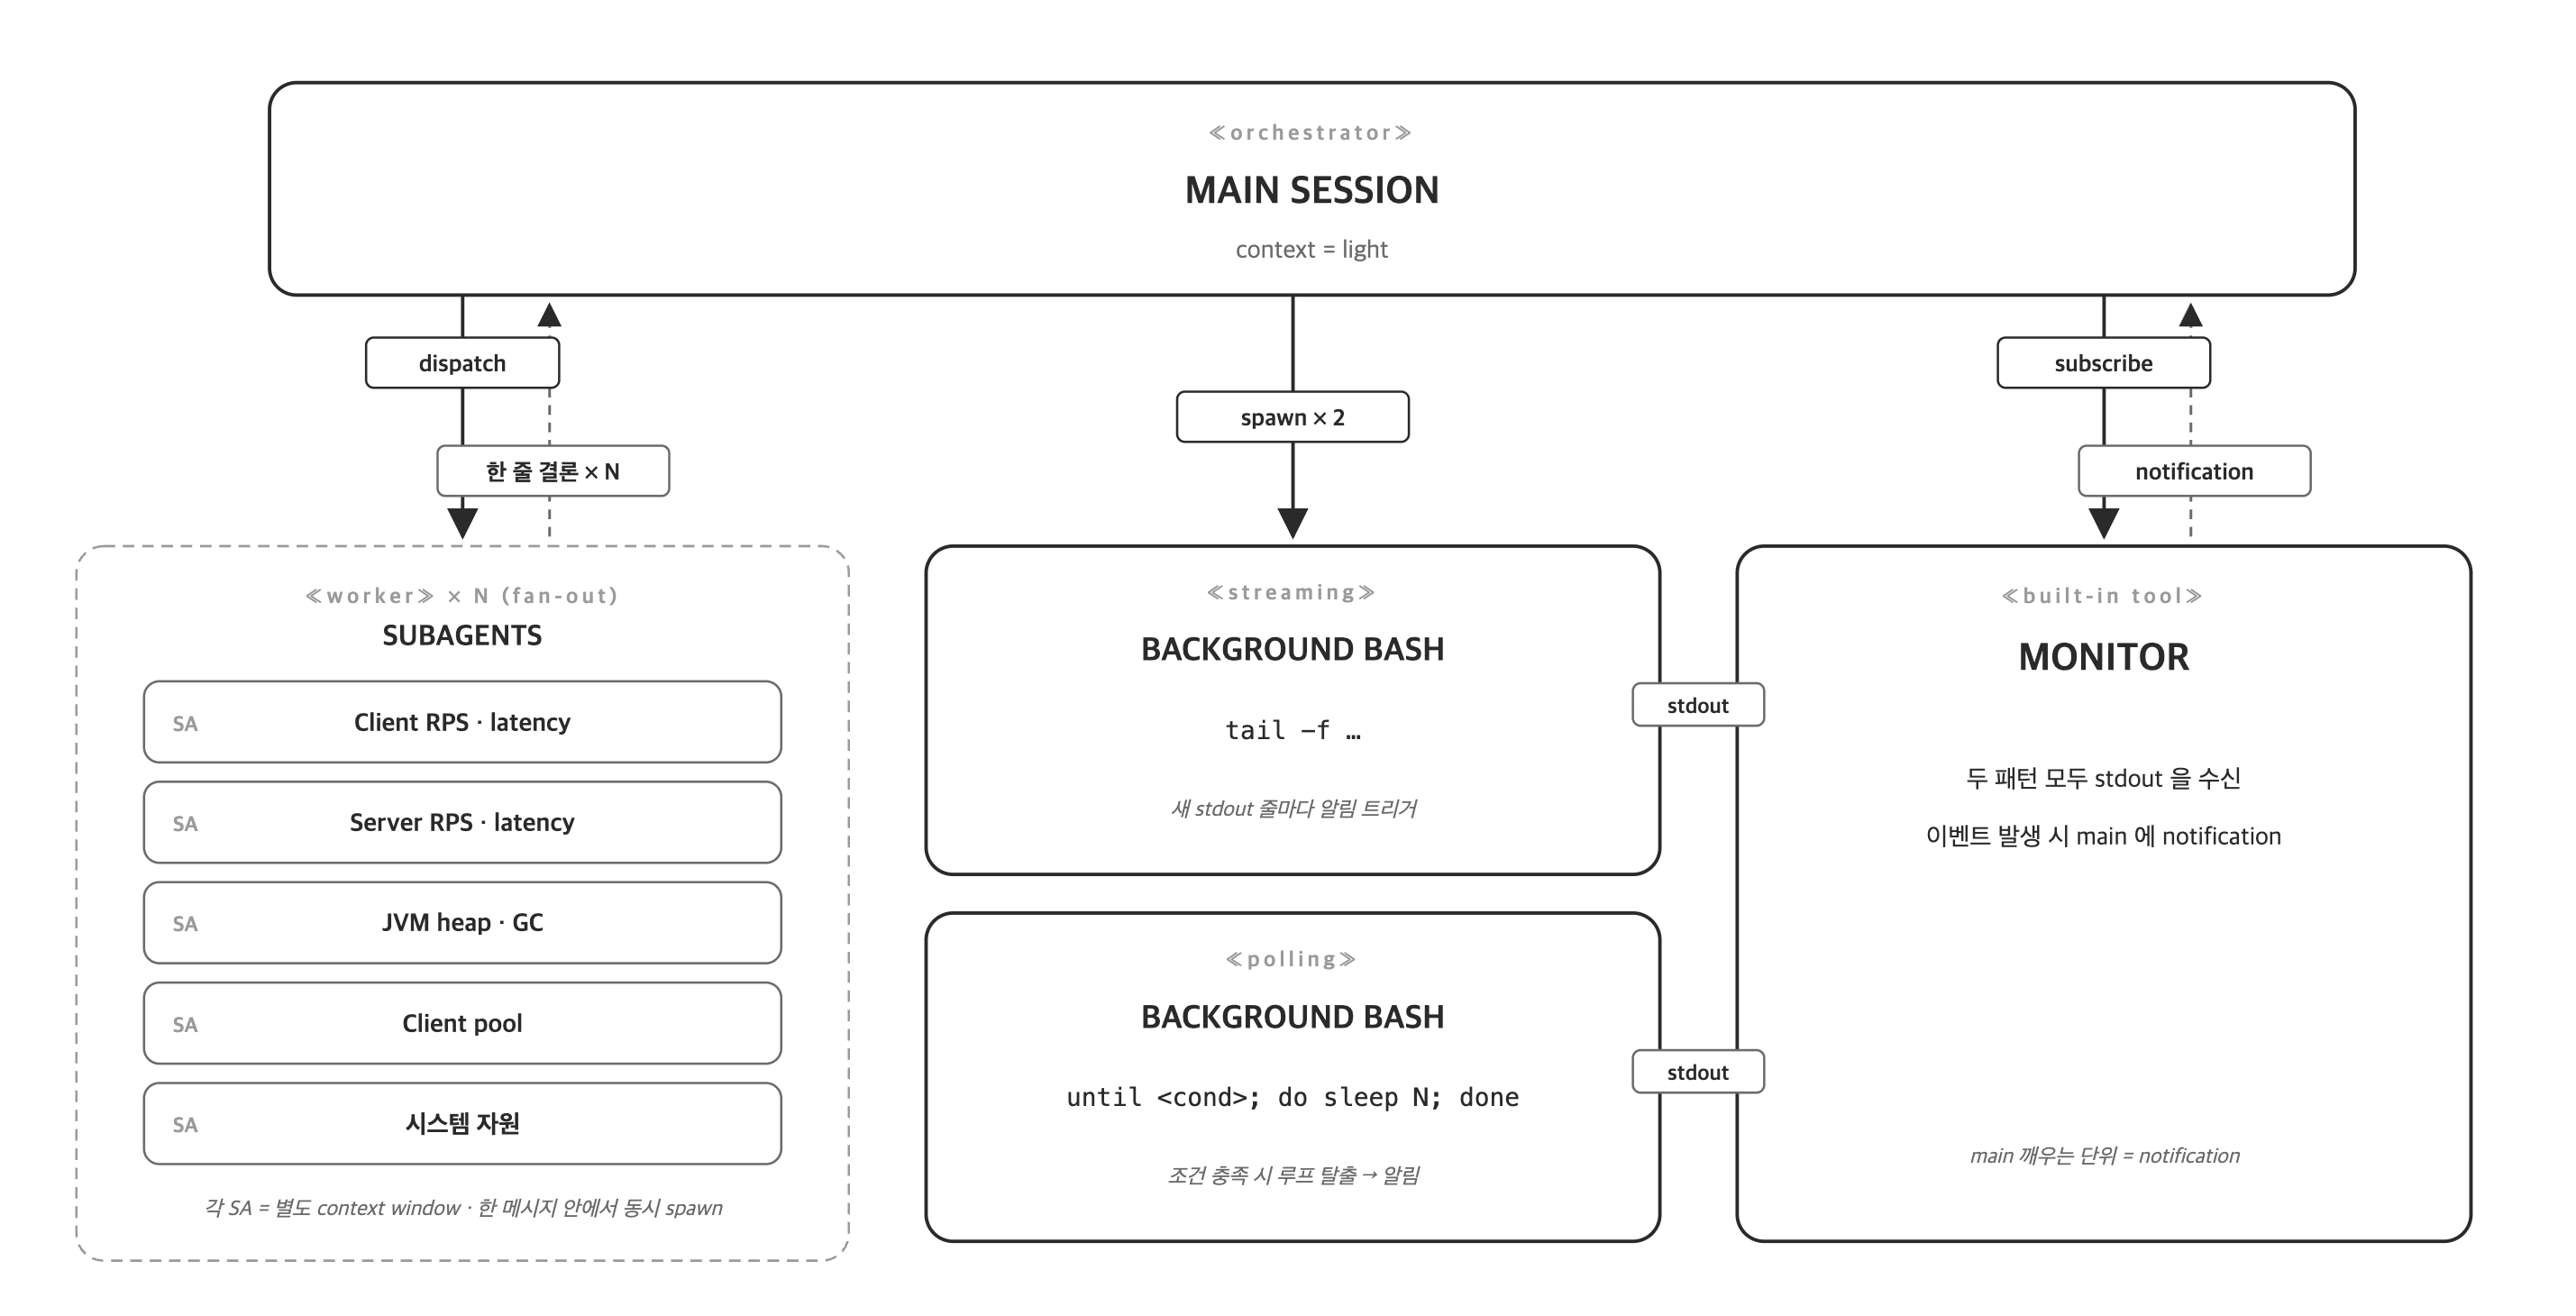
[ subagent 위임으로 시간 줄이기] 이때 /render-dashboard와 /make-report와 같은 스킬은 여러 지표를 수집해야 하다보니 순차로 진행하면 테스트 수행이 아닌 지표 수집/보고서 작성을 LLM에게 맡긴 시간 자체가 오래 걸리게 됩니다. 따라서 스킬 내부에 지표 캡쳐, 분석 항목을 쪼개서 각 subagent에게 위임하라는 지침을 해두었습니다.
예를 들면 client의 rps·latency, server의 rps·latency, JVM heap·GC, client pool 지표, 시스템 자원 다섯 개로 쪼개서 각 subagent가 각각 promQL 조회 -> 그래프 캡쳐 -> 결론을 받아옵니다. 결국 subagent가 하는 작업 조차도 쪼개어 동시에 수행하게 함으로써 시간을 줄여보자 했습니다.
[ subagent 위임으로 메인 컨텍스트는 orchestrator 역할만 담당] subagent의 사용은 컨텍스트 분리에도 좋았습니다. 메인 세션에서 만약 raw PromQL 출력을 모두 받아버리면 컨텍스트는 금방 무거워져서 compaction이 일어나는 시간까지도 테스트의 대기시간이 되어버리게 됩니다. subagent는 메인과는 별도 컨텍스트에서 도는 구조라, 데이터를 직접 만지는 일은 subagent 쪽에서 마무리되고 메인에는 결론만 넘어옵니다. 결과는 html · md 파일로 남으니 필요할 때만 메인에서 열어보면 되니 메인은 컨텍스트를 아껴 orchestrator 역할만 담당하게 합니다.
[ background bash + Monitor — 메인을 깨어 있게 하기] 또 제가 llm 사용시 자주 쓰는 패턴은 50분 동안 스트레스 테스트를 돌리는 긴 작업을 background bash로 띄우고 Monitor로 진행을 추적합니다. background bash에서 특정 시점마다 로깅같은 이벤트를 발행하도록 하고, Monitor가 이를 탐지하여 main에 알림을 주게 됩니다. 50분짜리 테스트가 돌아가는 동안 메인 세션은 멈춰있을 필요가 없기 때문에, 이처럼 개발자는 Monitor로 현재 진행상황을 파악하기도 하고, 이전 결과에 대한 재분석을 재명령할 수도 있게 됩니다.
[ 도메인 하네스의 존재] 외에도 메시징에서는 내부 도메인 지식을 매핑해둔 하네스를 구성해두었습니다. 서버군의 별칭, 프로토콜 코드값 같은 도메인 용어들을 정리해두어 한줄의 프롬프트에서 LLM에게 사전 설명을 최대한 줄이려 한 노력입니다. 외에도 자주 사용하는 사내 시스템들을 자동화해 둔 플러그인 모음이 있어, 스트레스 테스트 관련 LLM 명령에도 문제 없이 잘 동작하는 기반이 있었습니다.
3.4 AI에게 맡길 수 없는 것
그래서 사실 요즘 많이들 나오는 말인 'AI가 개발자 대체하는거아냐?'라고 생각하실 수 있을 것 같습니다. 이에 몇몇 일화들이 떠오릅니다.
1) 시니어는 시니어다, 경험에서 나오는 조언
처음에 스트레스 테스트를 돌릴 때 대조군과 비교군을 두고 비교했던 방법은 두 서버에 같은 rps를 걸고 나란히 비교해보면 간단하다고 생각했습니다. 그러나 이렇게 했을 때 저부하 구간과 고부하 구간의 지표 데이터가 너무 달라서, 그 중간 지점을 찾아내는 데 헤메고 있었습니다. 여러 번 반복 테스트를 시도하지만 결과는 명확하지 않고, 소요시간은 계속 늘어갔습니다. 이때 사실 도움을 준 건 AI가 아닌 사람이었습니다. 고연차 개발자 분과 이야기하다가
두 서버를 같은 user 수로 비교하지 말고, 한 서버에 대해 user 수를
점진적으로 올려 가면서 부하 구간의 곡선 자체를 뽑으세요.
그러면 어디가 베이스라인이고 어디가 병목인지가 한 그래프에 다 나와서,
해석이 훨씬 수월해질거에요.
이 말 덕분에 제가 위에부터 말씀드린 유저수를 점차적으로 증가시키는 테스트 방법론의 뿌리가 되었습니다.
2) 거짓말을 하는 AI report 누가 문제일까
자동화된 리포트는 그럴듯한 모양으로 거짓말을 했습니다. 테스트가 문제가 있는 경우 근본 원인을 파악하기보단, 그럴듯한 이유를 붙이는 형상이었습니다.
AI가 만들어준 테스트 리포트의 실패율은 0인데 실제로 서버 지표 에러 카운트는 증가 중이었습니다. 원인은 처음에 LLM이 빠르게 짜준 클라이언트 코드가 문제였으며 올바르게 고치고 나서야 서버 지표가 올바른 걸 확인했습니다. 한번은 비교 테스트에서 비교군과 대조군의 결과가 너무 똑같이 나와서 ‘이 변경이 이렇게까지 잘 흡수되나’ 라며 한참 들여다봤습니다. 알고 보니 배포 SKILL은 명시된 대로 배포를 수행하고 ‘배포완료’ 라고 돌려줬지만, 내부 image cache가 살아 있어 새 이미지가 실제로는 올라가지 않은 상태였습니다. 비교군과 대조군이 사실 같은 이미지로 돌고 있었던 셈이었죠. 그러나 AI의 리포트는 성능이 전후 비교가 없이 성능이 '아주 좋음!'으로 한줄 평을 하고 있었습니다.
Claude가 보고서 문장을 써 준 건 맞지만 추가적인 성공 조건들을 알려주지 않거나, 환경적으로 추가적인 검증을 두지 않은건 LLM에게 제가 일하는 방식을 명시하지 못했던 탓이기도 합니다. 결국 명령을 하는 개발자가 판단하는 성공 / 실패 / 검증 기준을 구체화 해서 보강하는 과정이 있을수록 AI의 결과가 정밀해졌습니다. 이에 스트레스 테스트에 AI를 도입하는 여러 실패 과정들이 오히려 AI를 사용하기 좋은 환경을 만들어 주었습니다.
3) 의심은 사람의 몫
따라서 결국 명확한 목표치가 있다면 어느 정도 AI의 결과를 의심하고, 본인의 노하우를 활용하는 과정이 필요합니다. 반복 작업을 찾아내고, AI의 동작이 올바른지 판단하고, AI가 올바른 결과를 낼 수 있게 추가적인 지식을 주는 것 모두 사람 손을 어느정도 탄다는 생각이 들었습니다. 판단은 사람이, LLM은 그 사이 사이에 있는 귀찮은 반복들을 빠르게 해줄 뿐입니다.
Part 4. 마치며
지금까지 메시징에서 스트레스 테스트로 얻고자 하는 것들과 이를 위해 치열하게 고민해왔던 과정들을 일반화 하여 풀어보았습니다. 글을 정리하면서 다시 느낀 건, 스트레스 테스트를 단순히 부하를 거는 테스트라고 하기엔 결론을 위한 너무나도 많은 지식과 사고과정이 있다는 점입니다.
사실 제가 한 일은 대단한 게 아니었습니다. 기존 개발에서 반복되는 구간에 부딪힐 때마다 “자동화는 AI가 잘하지않나? AI야 해줘!”를 한 번씩 시도해 본 것뿐이었고, 그게 몇 주 쌓이다 보니 제 업무의 여러 자리가 어느새 조금씩 자동화되어 있었습니다. 하지만 이 글을 작성하는 지금도 AI agent 기능은 매번 더 나아지고 있어 제 글에 써있는 AI 활용법도 사실 누군가에겐 너무 기본적일 거라고 생각합니다. 또 먼 미래에는 이조차도 생각하지 않을 수도 있습니다.
그럼에도 최대한 세상의 속도를 따라잡으며 공부하는 개발자로서 앞장서서 경험하려 합니다. 카카오톡이 대규모 트래픽과 복잡한 도메인 속에서도 빠르고 안정적으로 동작하는 지금의 모습, 그리고 앞으로 더 나아갈 모습을 기대하면서요 :) 긴 글 읽어주셔서 감사합니다.