Engineering
모든 기술은 처음이 있었다 - 카카오테크가 만난 Andi Gutmans
kakao tech, sue.cream카카오
2024년 8월 14일
원문에서 보기 ↗✍️요약
우리 앞에 주어진 모든 기술과 환경은 낯선 처음이 있었습니다. 웹과 인터넷이 태동하고, 모바일 혁명과 디지털 전환의 시대를 거쳐 AI가 열어가는 새로운 세상까지, IT 역사의 흐름을 직접 겪어온 기술 리더들이 티타임을 가졌습니다. 예전의 변화 앞에서 했던 도전, 오늘의 변화 앞에서 또다시 맞이하는 고민들을 공유합니다.
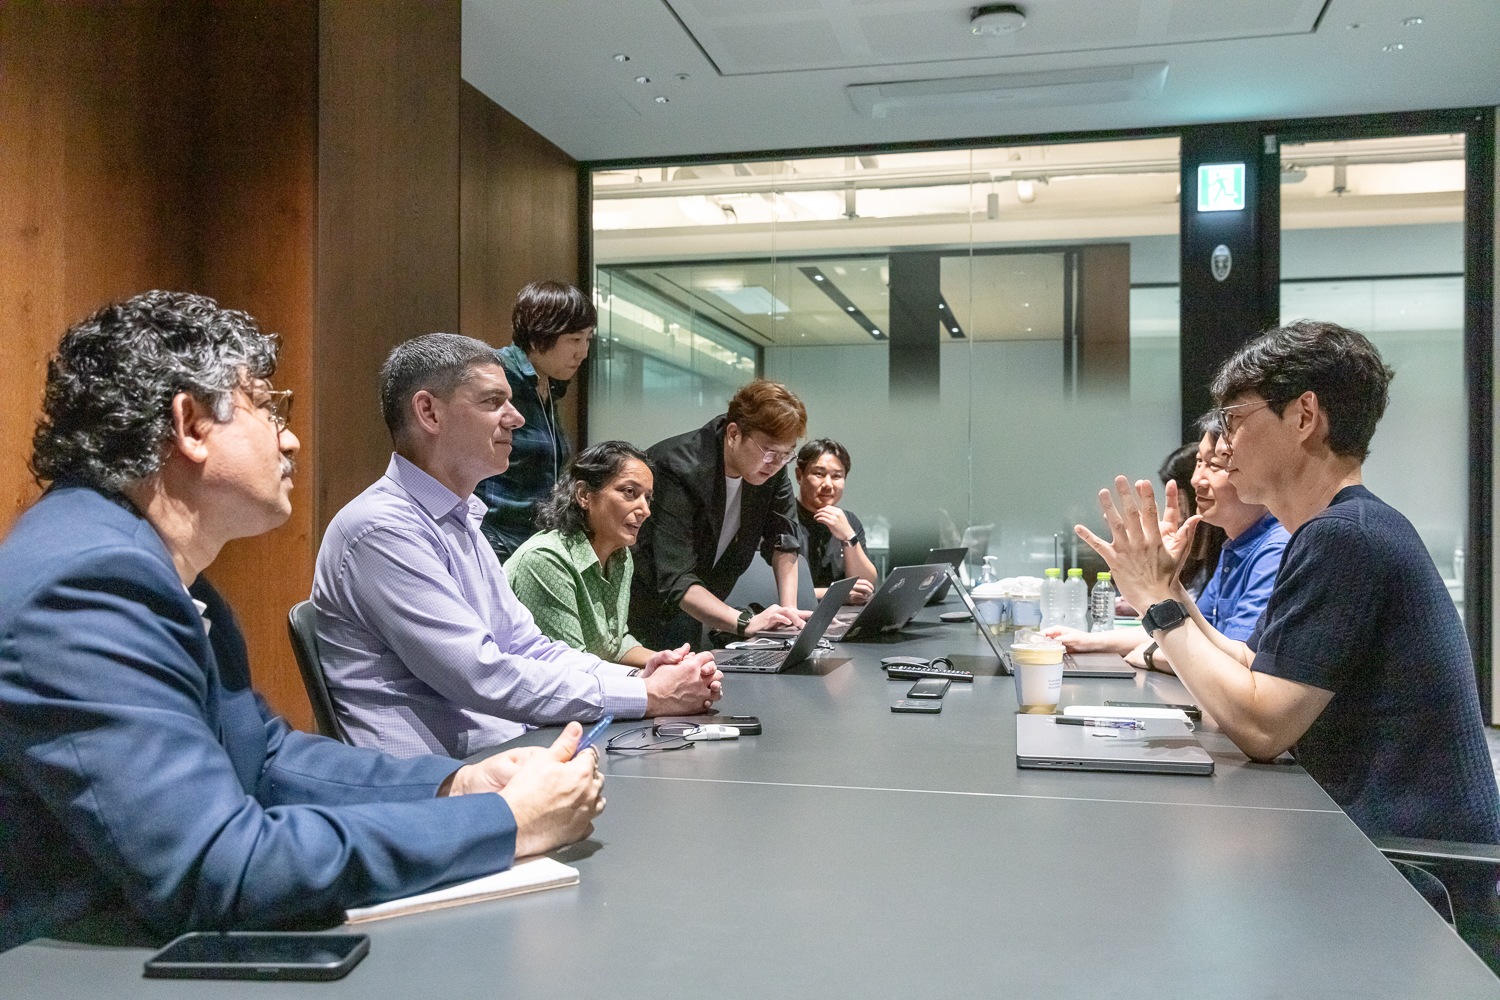
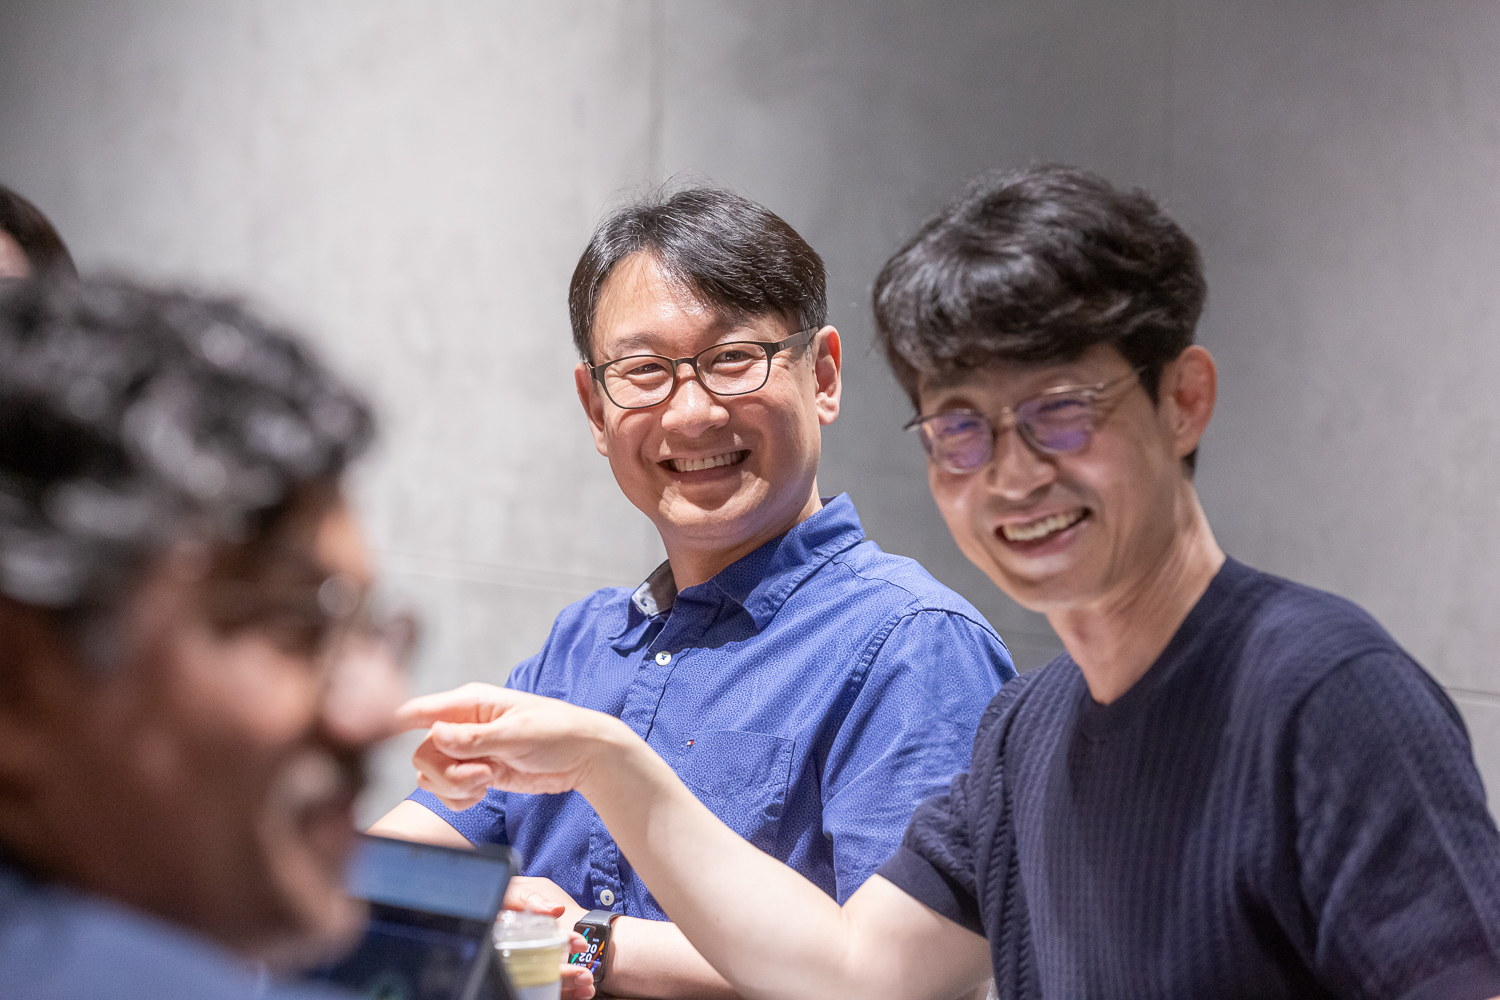
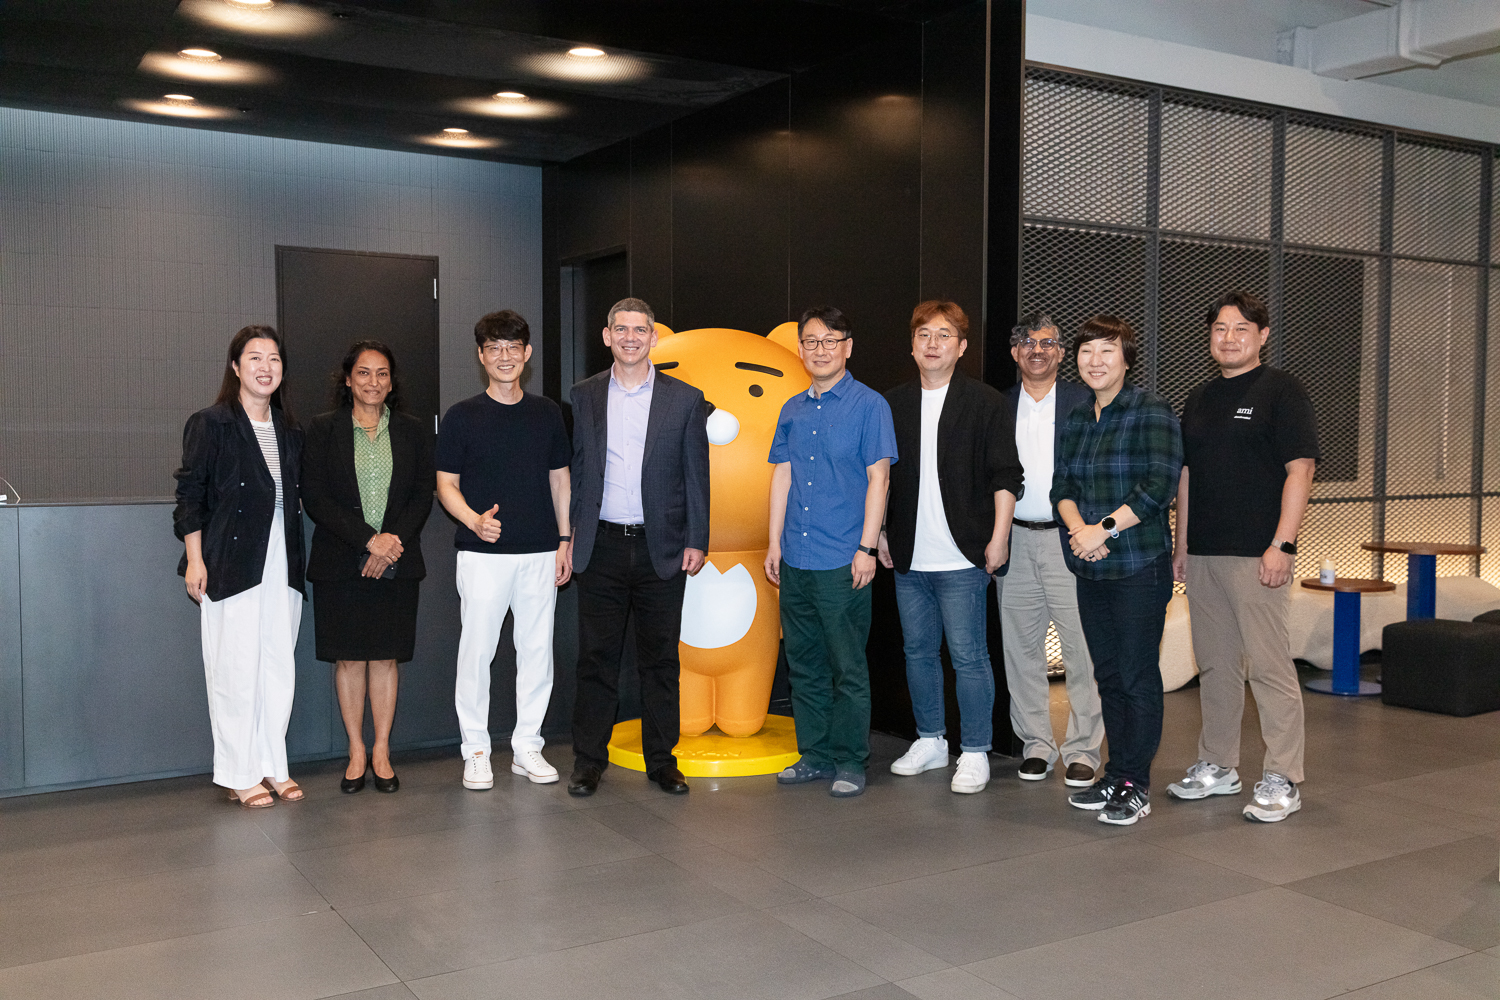
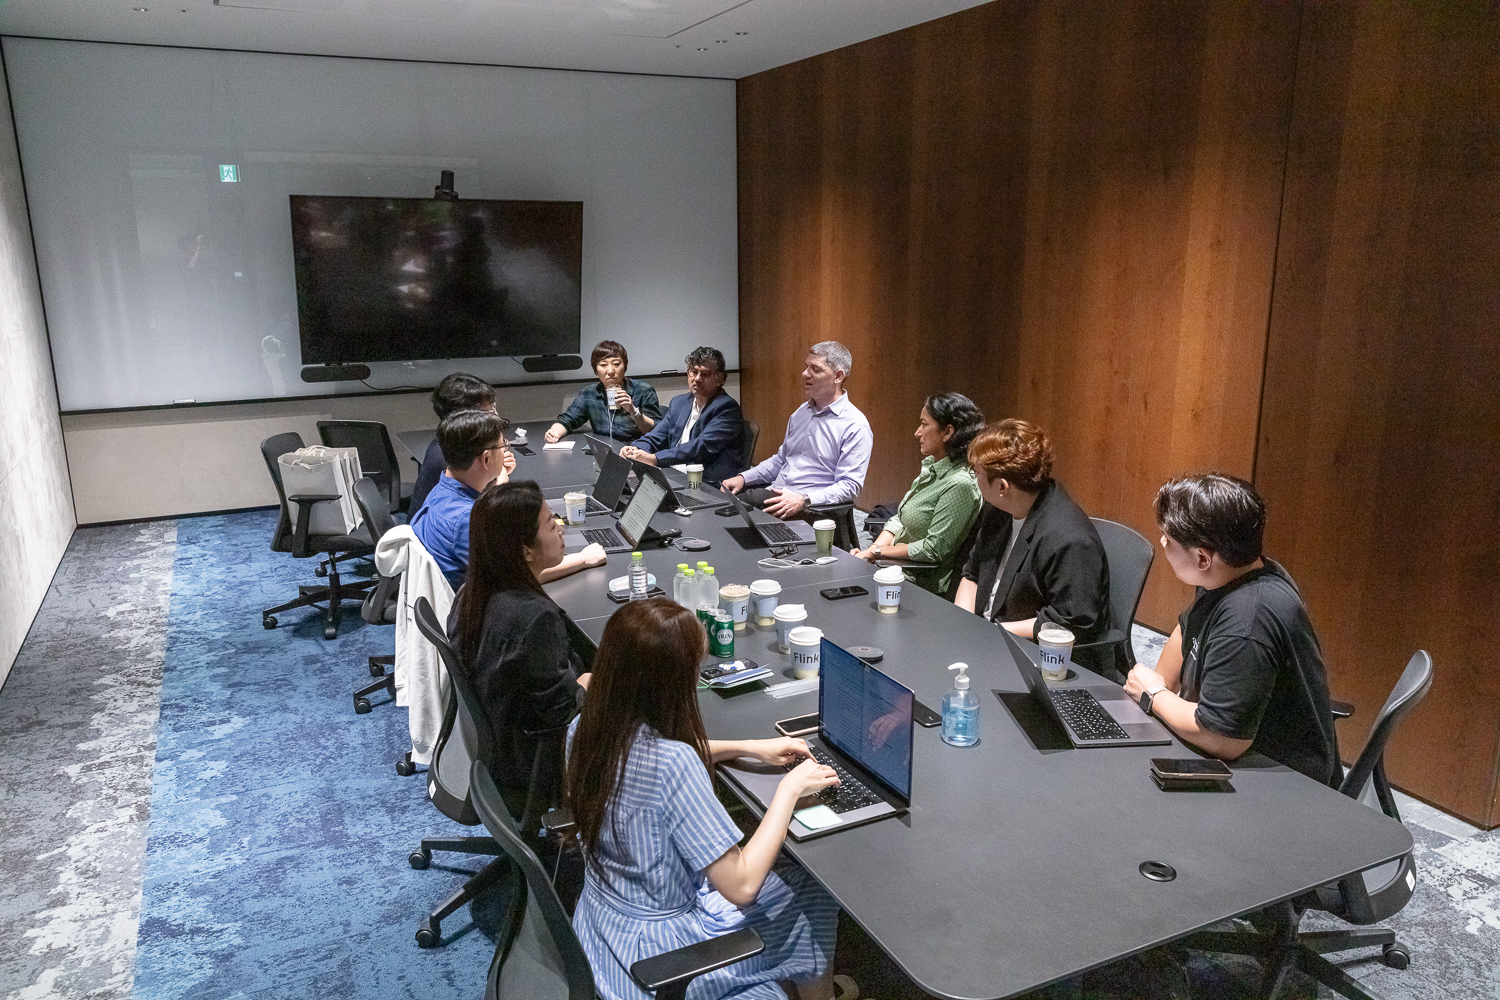
PHP의 주역, 웹 개발의 선구자이며, 현재 구글 클라우드 데이터베이스를 총괄하는 🔵 앤디 구트만스 (Andi Gutmans, 이하 Andi )와, 카카오의 기술을 총괄하는 🟡 정규돈 CTO (이하 GD )가 7월 30일, 카카오의 판교아지트에서 티타임을 가졌습니다.
구글 클라우드의 모니카 굽타 (Monica Gupta, 이하 Monica) 시니어 디렉터와 수바시 구아다드 (Subhash Guaddad, 이하 Subhash) 디렉터, 카카오의 데이터플랫폼 조직을 이끄는 오민석 리더 (이하 Vincent) 등 기술 리더들이 함께했어요.
IT 기술이 태동하고 변화했던 시대를 거쳐온 리더들의 대화가, 또다시 변화 앞에 선 개발자 여러분께 의미 있는 메시지가 되면 좋겠습니다.
Era of Web and internet: 역사의 시작
웹과 인터넷이 등장한 1990년대에 두 분은 무엇을 하고 있었나요?
그 시기의 고민과 가장 도전적인 과제는 무엇이었는지 들려주세요.
🔵 Andi :
1990년대면 저는 대학에서 컴퓨터공학을 공부하고 있었는데요, 공부하는 것보다 코딩을 더 좋아했습니다. 그래서 친구와 함께 수업을 듣는 대신 프로젝트를 하기로 했습니다. 당시로서는 꽤 선진적이었던, 쇼핑카트 웹사이트를 만드는 프로젝트였고, 지도교수님이 있었어요. 친구 Zeev가 hosting provider를 작업하면서, PHP/FI를 알게 되었고, 우리는 그 언어를 사용해서 쇼핑카트 웹사이트를 만들기로 했어요. 한 시간쯤 개발하다가 ‘우리가 이 언어를 더 잘 만들 수 있겠다’고 생각했어요. 그때 저희는 대학에서 막 컴파일러 수업을 이수한 상태였거든요. 그래서 쇼핑카트 프로젝트는 잠시 치워두고 이 언어를 다시 만들기로 했어요. 그렇게 PHP3가 탄생했습니다.
PHP3를 들고 지도교수님께 가서, 우리가 새 언어를 만들었으니 이것을 새 프로젝트로 받아주실지 물어봤는데 거절하셨어요. 그래서 저희는 컴파일러 수업을 하셨던 교수님께 갔어요. 그 교수님은 이스라엘 IBM research의 리더이기도 했는데 흔쾌히 프로젝트를 맡아주기로 하셨어요. 그래서 저희는 PHP3를 들고 PHP/FI를 사용하는 사람들에게 가서, 우리가 새 버전을 만들었으니 여기로 옮겨오는 것이 어떨지 제안했고, 작은 커뮤니티였지만 사람들이 PHP3를 써주기 시작했어요. 그렇게 일 년 반 만에 약 4만 개의 웹사이트가 150만 개로 증가했고, 정말 재미있었어요. 그리고 잘 아시듯이 PHP3를 오픈소스로 공개했어요.
그런데 PHP3를 오픈소스로 런칭하고 보니 여전히 ‘이것보다도 더 잘할 수 있겠다’는 생각이 들었어요. 그래서 저희는 바로 PHP4를 만들기 시작합니다. PHP4는 PHP3와 달리, 엔진을 분리하기로 했습니다. 그리고 분리한 엔진에는 Zend(Zeev+Andi)라는 이름을 붙였어요. Java에 JVM이 있는 것처럼 PHP에는 Zend 엔진이 있는 거예요. 아무튼 이 Zend엔진이 PHP4를 만들었고, 이 PHP4를 기반으로 야후, 페이스북 등이 만들어졌어요.
🟡 GD :
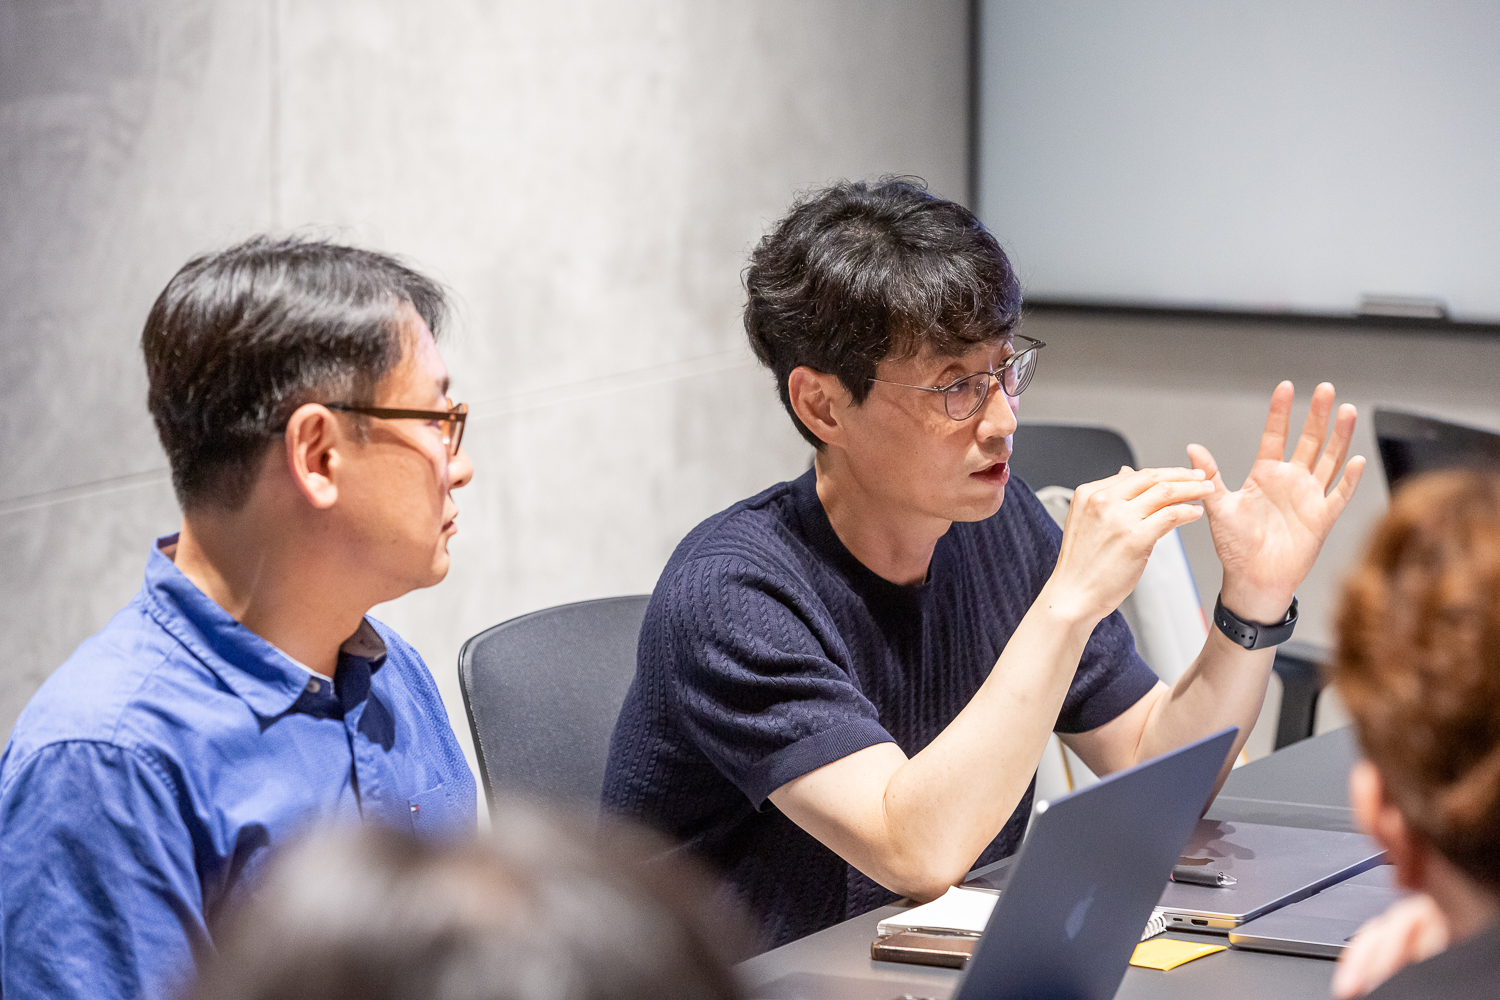
웹과 인터넷이 부상하기 시작한 때가 우리나라는 IMF 기간이라, 개인적으로 가장 도전적인 과제는 취업이었습니다(농담반 진담반). 우연히 소프트웨어 쪽으로 진로를 정하고 ‘라이코스(Lycos)’라는 초기 포털에서 ‘JMS(Java Message Service)’라는 메시징 미들웨어 개발을 하게 됐어요. 여기서 재미난 경험을 하게 되는데, 당시에는 Solaris라는 상용 서버 운영체제로 인프라가 구성되어 있었고 Linux는 거의 쓰이지 않고 Java도 초기라 관련 개발자가 없던 시절이었어요. 그런데 소프트웨어 쪽은 오픈소스 커뮤니티가 부상하기 시작했고, 저도 우연히 ‘OpenJMS’의 컨트리뷰터로 조인하게 되었습니다. 상용이 아닌 프로덕트가 개발되고 공유되는 형태를 경험하면서 굉장히 인상적이었어요. 당시만 해도 윈도우 세상이었고, 당연히 소프트웨어도 하드웨어와 같이 비용을 지불하고 쓰는 세상이었는데(물론 해킹버전이 많았지만ㅎ), 오픈소스를 기반으로 하는 소프트웨어는 그것과는 거리가 먼 세상이었던 거죠. OpenJMS는 ‘SourceForge’라는 (오늘날의 GitHub과 비슷한) 오픈소스 플랫폼이 있었던 것 같아요. 이런 환경에서 개발자들은 세상의 개발자들과 함께 실력과 경험을 쌓기 좋았고, 저도 오픈소스 커뮤니티의 개발자들과 소통하면서 OpenJMS를 바탕으로 자체 메시징 미들웨어를 개발할 수 있었습니다.
그 당시의 개발자 커뮤니티와 오픈소스는 어떤 모습이었는지도 궁금한데요,
오픈소스 커뮤니티와 관련된 경험을 조금 더 들려주세요.
🟡 GD :
아파치 재단의 오픈소스 중에 기억에 남은 것은 ‘아발론(Avalon)’이라고 하는 컴포넌트 기반 서버 프레임워크예요. 당시에는 지금의 쓰레드풀, 커넥션풀이 따로 라이브러리화 되지 않고 직접 만들어 쓰던 시절이었는데요, 경력 있는 개발자들은 자기만의 라이브러리를 다 가지고 있어서 제가 주니어일 때는 선임이 바뀔 때마다 그분들의 라이브러리를 익히는 과정이 필요했어요. 그런데 오픈소스는 그런 개별적인 수고를 덜어줄 수 있었죠. 아발론 프레임워크를 기반으로 스토리지 서버를 만들었는데, 컴포넌트로 서버의 기능을 나누고 생명주기를 관리하는 법을 배웠고, 쓰레드풀에 버그가 있어서 커뮤니티에 물어보면서 고쳐서 썼던 기억이 있네요.
솔직히 얘기하면 당시 이런 무료 오픈소스가 오래 갈거라 생각하는 사람들은 주변에 많진 않았습니다. 그런데 결과를 보면 이런 시스템, 문화가 지금의 빅테크 기업을 만든 원동력이 됐어요. 소프트웨어 산업에만 있는 특이한 문화라고 볼 수 있어요. 지식을 회사나 개인의 소유로만 가두지 않고 같이 공유하는 문화가 인터넷의 태동기의 정신과 어울려 발전했던 시기를 초기부터 보고 경험했던 부분은 큰 행운이었다고 생각합니다. 지금은 깃헙을 중심으로 오픈소스 커뮤니티가 발전하고 현재 화두가 되는 LLM 시장에서도 오픈소스가 이렇게 쏟아져 나오는 걸 보며 놀라움을 금치 못하고 있어요. 이런 환경에서 개발자 생태계는 더욱 발전하고 또 그런 개발자들이 공헌하는 오픈소스 프로덕트는 더욱 발전하는 선순환을 만들게 되는 것이죠.
과거와 현재를 관통하는 열정
🟡 GD :
Andi는 컴퓨팅 언어와 컴파일러의 전문가였는데, 데이터베이스 전문가로 커리어를 바꾸셨잖아요. 두 분야는 많이 다른데, 어떻게 전환이 가능했는지 궁금해요.
🔵 Andi :
PHP4를 공동 제작했을 때, Zend 회사를 시작했었는데, 2015년에 매각했어요. 아주 오랜 시간이 걸렸네요. Zend를 매각하고 다음 할 일을 고민하고 있던 중에, 친구가 데이터베이스 부문의 리더십 직책을 고려해보라고 했어요. 저는 당시에 이용자로서만 사용해봤지, 데이터베이스의 내부 사정에 대해서 잘 몰랐거든요, 그런데 그냥 와서 배우면서 일을 해보라고 했어요.
데이터베이스에는 시스템 측면과 쿼리 프로세싱 측면 두 가지가 모두 있잖아요. 저는 시스템을 다루는 사람(System person)이기 때문에 시스템이 어떻게 돌아가는지 잘 이해할 수 있었어요.
제가 데이터베이스 관련해서 처음 했던 프로젝트는 새로운 그래프 데이터베이스 생성을 주도하는 것이었어요. 저는 직관이 좋고 아주 빠르게 배우는데요, 모르는 것을 부끄러워하지 않고 아주 많은 질문을 했어요. 감사하게도 주변에 훌륭한 엔지니어들이 있었기 때문에 그분들에게 쿼리 프로세싱, 쿼리 최적화와 같이 제가 궁금한 것들을 모두 질문하곤 했어요. 데이터베이스 분야에서 최고의 사람들과 팀으로 함께하면서 빠르게 배울 수 있었던 것이 행운이었어요.
저는 학문적인 데이터베이스 전문가는 여전히 아니고 단지 분산 시스템, 스토리지, 쿼리 프로세싱 같은 것들이 뭔지 알고 있을 뿐이에요. 그렇지만 제가 생각하는 저의 강점은 핵심 시스템(core system)이고, 언제나 새로운 것을 배우는 것을 좋아하고, 질문하는 것을 부끄러워하지 않는 그런 점들인 것 같아요. 지금까지도, 제 주변에는 저보다 훨씬 잘하고 항상 새로운 것을 가르쳐 주는 엔지니어들이 많이 있으니까요.
웹과 인터넷이 열어준 시대는 곧이어 시작한 모바일 혁명과 클라우드 컴퓨팅 등의 부상으로 빠르게 다음 단계로 나아갔어요. 과거에서 현재로, 이야기를 한 단계씩 건너와 볼까요?
🟡 GD :
모바일 혁명이 만든 24시간 열린 인터넷 세상은 모든 산업을 빨아들이면서 엄청난 데이터를 축적했어요. 이런 연결선 상에서 각 산업의 디지털 트랜스포메이션은 2010년대 후반에 주목을 받기 시작했는데요. 이때 저는 카카오뱅크 CTO로 기존 은행을 모바일 은행으로 바꾸는 프로젝트를 했어요.
2017년 오픈한 카카오뱅크는 우리나라에서 최초로 영업점이 없는 모바일로만 가능한 은행이었고 당시에 이 정도로 많은 고객들이 사용하는 메이저 은행으로 발전할지 누구도 생각하지 못했어요. 왜냐하면 은행은 여전히 오프라인 거점 중심일 거라는 생각이 지배적이었으니까요. 그리고 모바일 사용성이 이미 은행계좌가 있는 사용자들을 전이시킬 거라고 생각하지 못했어요. 하지만 결과는 달랐어요. 1주일에 100만, 3개월에 500만 이후 1000만까지 빠른 속도로 고객이 모이기 시작했거든요.
이 시점 이후부터 우리나라 금융시장은 디지털 트랜스포메이션을 중요한 과제로 두고 빠르게 변화했습니다. 이런 디지털 트랜스포메이션은 영업사원이 패드를 쓴다고 바뀌는 것도 아니고, 리눅스나 오픈소스를 쓴다고 바뀌는 것도 아니고, 조직과 문화에 걸친 일이기 때문에 변화에는 시간이 걸리고 있어요.
그런 와중에 AI 시대가 도래한 거죠. 아까 잠깐 말씀드린 PC 시대에서 모바일시대로 넘어오면서 24시간 연결된 인터넷 세상은, AI, 특히 딥러닝, 특히 LLM으로 대변되는 시장에서 가장 중요한 데이터의 기반을 닦게 하는 중요한 계기가 됐던 거라고 보여요. 여전히 디지털 전환은 산업별로 시간차를 두고 진행 중이고 여기에 AI 시대가 오면서 이 두 가지를 단순히 기술의 도입이 아닌 기업의 조직과 문화에 어떻게 접목하고 서비스화 하는지가 앞으로의 10년 내의 큰 변화의 요소가 아닐까 생각합니다.
🔵 Andi :
예전에 우리를 설레게 했던 것(what excited us then)과 지금 우리를 설레게 하는 것(what excites us now)을 잠시 얘기해 볼게요. 예전에 우리를 설레게 하던 것은 ‘지적 호기심’이었습니다. 웹, 모바일 등 새로운 플랫폼이 나왔고, 새로운 플랫폼은 더 나은 무언가를 필요로 했고, 그런 새로운 것을 만들어갈 수 있는 세상이었으니까요.
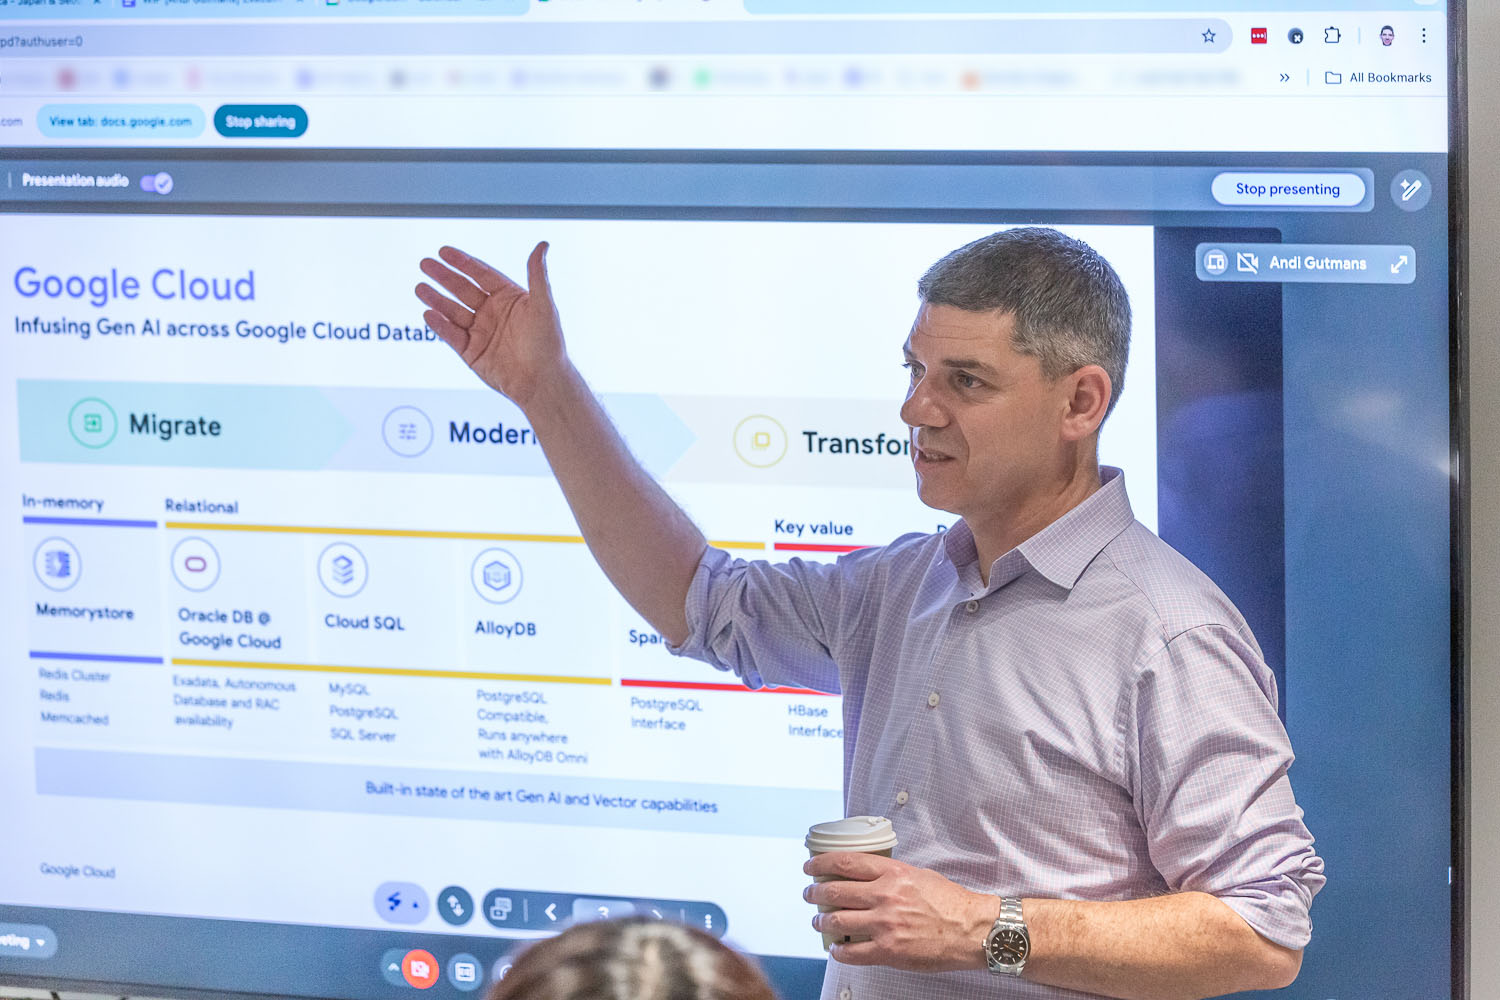
한편 지금 저를 설레게 하는 것은 ‘Gen AI(생성형 AI)’인 것 같아요. 다만 Gen AI 자체보다 좀 더 개발자의 관점에서 바라본 Gen AI요. 왜냐하면 많은 사람들이 여전히 Gen AI를 데이터사이언스나 모델 훈련과 같은 영역으로 생각하는데요, 사실 Gen AI의 정말 흥미로운 점은 이제 모든 개발자가 AI 어플리케이션을 만들 수 있게 되었다는 사실이거든요. 그래서 제가 데이터베이스에서 관심 있게 살펴보고 있는 것 중 하나가, ‘어떻게 하면 개발자들에게 이런 AI 서비스를 만드는 경험을 줄 수 있을까?’입니다. 마치 웹 시대에 저희가 PHP를 만들었던 것 같은 편리한 경험을, Gen AI 시대의 모든 개발자들에게 제공하고 싶어요.
New Era of AI and Data: 진정한 AI 시대의 기업이 되기 위해
🟡 GD :
모바일과 디지털 전환이 한창 진행 중이었는데 갑자기 AI 전환이 시작되면서 이 변화를 어떻게 기회로 잡을 수 있을지 고민이 많아요. PC 시대에서 모바일 시대로 넘어올 때 카카오는 기존 PC 시대의 레거시가 없는 ‘모바일 네이티브’ 회사였기 때문에, 모바일에 최적화된 방식으로 프로덕트를 빠르게 만들 수 있었어요. 이제 AI 시대에 또다시 빠르게 적응하려면, 앞 시대의 레거시와 자산에 집중하지 않고 ‘AI 네이티브(AI native)’로 새롭게 전환해야 한다고 생각했어요.
제 생각에는 AI와 LLM의 변화가 Backend에서부터 시작되는 것처럼 보이기 때문에, 현재 제공되는 서비스들의 모습이 모바일 혁명만큼 급격하게 바뀌진 않을 것 같아요. 하지만 점차, 서비스의 도메인 정보에 접근하는 방식과 인터페이싱을 또 한 번 바꿀 것으로 보입니다. 전문지식은 더욱 쉽게 모델화 되고 인터페이스는 자연어와 모달 기술의 발전으로 내추럴하게 바뀜으로써 음성과 영상 인터페이스는 보다 핵심적인 인터페이스로 바뀌게 될 거예요.
저의 고민은 이런 세상의 필수 기술인 Gen AI를 어떻게 바라보고 준비할지입니다. 빅테크 기업의 플랫폼을 기다릴 것인지, SLM(Small Language Model)같이 소규모 도메인에 특화되게 하는 게 맞는 것인지 아직 안 보이니까요. 그래서 접근방식을 AI native로 삼은 것이고요. 세상의 변화에 기민하게 대응하기 위해선 모바일 시대에 카카오가 그랬던 것처럼, 기업 전반의 시스템부터 DNA까지 AI를 자연스럽게 사용하고 생각하는 그런 기업으로 바꾸면서 세상의 변화에 대응하면 그에 맞는 서비스도 가장 기민하게 내놓을 수 있다는 판단이에요. 그런 의미에서, 모바일 네이티브로 시장에서 성공했던 방정식과, AI native로 새로운 시장에서 성공하기 위한 방정식에 연결고리가 있을 것 같아요. 그것이 무엇일지 찾고 있습니다. Andi는 어떻게 생각하시나요?
🔵 Andi :
데이터베이스에서도 고민하시는 것(AI native)과 똑같은 전환 과정을 거쳐왔어요. 저희 팀원들은 데이터베이스 전문가였지, 굳이 어플리케이션 전문가일 필요가 없었어요. 그래서 저희는 모든 곳에 AI를 주입하는 방법을 고민했어요. 쉬운 길은 아니지만 어떻게 보면 모든 개발자가 성공할 수 있는 기회이기도 했어요.
도움이 되었던 것이 몇 가지 있었는데, 그중 하나는 구글에서 많은 사내 도구들이 AI 기능을 갖추고 있다는 점이었어요. 예를 들면 IDE나 코드 생성기(Code generator), 코파일럿, 디코딩 도구 같은 것들이요. 그래서 사내의 엔지니어들이 새로운 기술로 무엇이 가능한지를 경험할 수 있게 해주는 거예요.
두 번째로는, 일찍이 조직을 위한 비전(vision)과 전략을 세우는 작은 팀을 만들었어요. AI가 어떻게 각 데이터베이스의 일부분이 될 것인가, AI를 어떻게 데이터베이스 조직 전체에 걸쳐서 바라볼 것인가 등을 고민하는 거죠. 쉽지는 않았어요. 대부분의 사람들은 이런 것들을 생각하고 있지 않았거든요. 저희는 매주 회의하는 포럼을 하나 만들었어요. 왜냐하면 저는 이게 정말 중요하기 때문에 매주 우리가 만나서 이것에 대해서 얘기해보았으면 했고, 모든 팀이 AI를 도입하기 위해 무엇을 해야 하는가 등에 대해서도 논의해야 한다고 생각했어요. 진행 상황을 보고, 리소스를 확인하는 등 자세하고 지속적으로 얘기를 했어요. 처음에는 설득의 과정이 필요하지만, 지속적인 관찰과 토론 끝에 구성원들 모두 가능성을 확인할 수 있었어요.
예를 하나 들어드릴게요. 제가 ‘모든 데이터베이스는 벡터 지원(Vector support)을 해야 한다’라고 선언했었어요. 지금은 당연해 보이지만, 2년 전이었으니까 벡터 지원이 다른 이니셔티브보다 더 중요하다는 의견에 모두가 동의하지는 않았어요. 그래서 초기에는 제 노력이 좀 필요했지만, 팀들이 하나둘 결과물을 만들어내고 서로 그걸 지켜보면서 자연스럽게 다른 팀들에서도 관심을 가졌어요. 그리고 처음처럼 제가 나서지 않아도, 이제는 스패너(spanner)의 벡터 지원을 런칭하고, 그런 일들이 계속 일어나고 있어요.
🔵 Andi :
AI native 회사가 되기 위한 고민에서 두 가지 핵심 영역은 ‘고객을 위해 AI를 어떻게 사용할 것인가?’ 그리고 ‘사내에서 임직원들과 AI를 어떻게 사용할 것인가?’인 것 같아요.
구글에서는 CEO인 순다르(Sundar)를 비롯한 경영진이 지속적으로 우리가 어떻게 고객경험을 변화시키고 있는지를 여러 예시를 통해서 보여주고 있습니다. 일회성이 아니라 지속적으로, 리더들과 회의 때마다 피쳐나 기능의 데모를 항상 가지고 나와서 임직원들과 공유하고, 회사 밖으로도 이런 데모를 가지고 나가서 계속 보여주는 거죠. 이런 예시를 꾸준히 공유하면 사람들이 더 많은 관심을 가지게 되고, 각자의 서비스에 적용할만한 아이디어를 적극적으로 찾게 돼요. 말로만 듣는 것과 직접 보는 것은 정말 다르거든요. 더 많은 사람들에게 보여주면 더 많은 고객 경험이 바뀔 수 있습니다.
반면 임직원들에게는 조금 달라요. 직원들은 아직 AI를 사용할 준비가 되지 않아서 어떻게 도입해야 할지 모르는 경우도 있어 처음에는 다소 회의적일 수 있어요. 하지만 더 중요한 일들에 더 많은 시간을 사용할 수 있도록 AI가 어떻게 도울 수 있는지 - 예를 들어 개발자가 보일러플레이트 코드(boilerplate code)를 단순히 작성하고 있다면 그런 것은 AI를 사용하고, 개발자는 아키텍처나 더 어려운 고민에 집중할 수 있다는 사실을 보여주면, AI가 얼마나 혁신적인 기술인지 깨닫기 시작해요. 그러니까 임직원들과 AI를 사용할 때는, ‘생산성을 높이자’라는 방식보다는 ‘더 재밌고 효율적으로 일하자’라는 방향으로 그런 문화를 만드는 것이 중요합니다. AI가 당신의 일을 뺏는 것이 아니라 당신의 일이 더 재밌어지도록, 당신이 더 많은 일을 할 수 있도록 도와줄 것이다, 라는 방식으로 접근해야 하는 것 같아요.
State of the art Database
자연스레 구글클라우드의 데이터베이스들과 오픈소스, 카카오의 데이터베이스 구조에 대한 이야기도 나누었는데요, 한 가지만 전해드립니다.
🟠 Vincent :
구글클라우드는 이미 스패너(Spanner) 데이터베이스가 있고, 스패너가 PostgreSQL 인터페이스도 지원하고 있는데요, 왜 Alloy DB를 출시했나요?
🔵 Andi :
AlloyDB를 만들 때 저희가 염두에 둔 고객은 레거시 데이터베이스를 제거하려는 분들이었어요. 많은 저장 프로시저(stored procedure)를 가진 고객들도 포함이에요. 오픈소스 PostgreSQL가 거의 비슷하게 지원해서 더 나은 가용성과 확장성을 만들어주긴 하지만요, 스케일 업에 조금 더 초점을 둔 모델이에요.
스패너에서는 페타바이트(PB) 수준의 트랜잭션 처리를 지원하기 때문에 전통적인 저장 프로시저와 같은 기능은 사용할 수 없어요. 그리고 스패너가 PostgreSQL 인터페이스를 가지고 있긴 하지만 100% 호환이 되지는 않아요. 모든 확장 프로그램이나 저장 프로시저 등을 다 지원하지는 않아요. 그래서 고성능 PostgreSQL을 지원하고 레거시 데이터베이스를 제거하기 위한 지원이 필요했던 거예요. AlloyDB는 저장 프로시저를 지원하고, PostgreSQL을 코드 변경 없이 그대로 마이그레이션 할 수 있어요.
마치며
지금까지 Andi, GD, Vincent, Monica, Subhash와 함께 약 30년간의 IT 기술의 변곡점을 회상하며, 각 시대의 도전과 경험, 그리고 또다시 새로운 변화를 맞이는 고민을 이야기했습니다.
우리 앞에 주어진 모든 기술과 환경은 낯선 처음이 있었습니다. 여전히 역사의 한 페이지를 살아가며, 다음 변화가 올 때 우리는 오늘의 고민을 어떻게 회상할지 궁금해집니다. 또 그런 재미있는 이야기로 돌아오겠습니다!
📚시리즈의 글
- (현재 글) 모든 기술은 처음이 있었다 - 카카오테크가 만난 Andi Gutmans
- AI 시대와 로봇 - 카카오테크가 만난 조규진 교수님
- AI Agent와 개발자 - 카카오테크가 만난 Thomas Dohmke
Directed by
Yang.me,Hunter.joPhoto by
Derek.sWritten by
Sue.cream