Backend
PostgreSQL to ES: (1) Kafka Connect CDC 파이프라인 구성
finn.h카카오
2025년 10월 10일
원문에서 보기 ↗안녕하세요. 클린플랫폼에서 컨텐츠 모니터링 시스템을 개발하는 핀입니다.
저희 시스템은 약 10년 동안 운영되면서 점차 레거시가 쌓였습니다. 그중에 하나가 PostgreSQL의 데이터를 ES로 동기화하는 파이프라인이었습니다. 이번 글에서는 복잡했던 동기화 파이프라인을 대체한 Kafka Connect CDC 파이프라인을 소개합니다.
1. 문제 상황과 대안 선정
1.1 기존 파이프라인의 복잡성
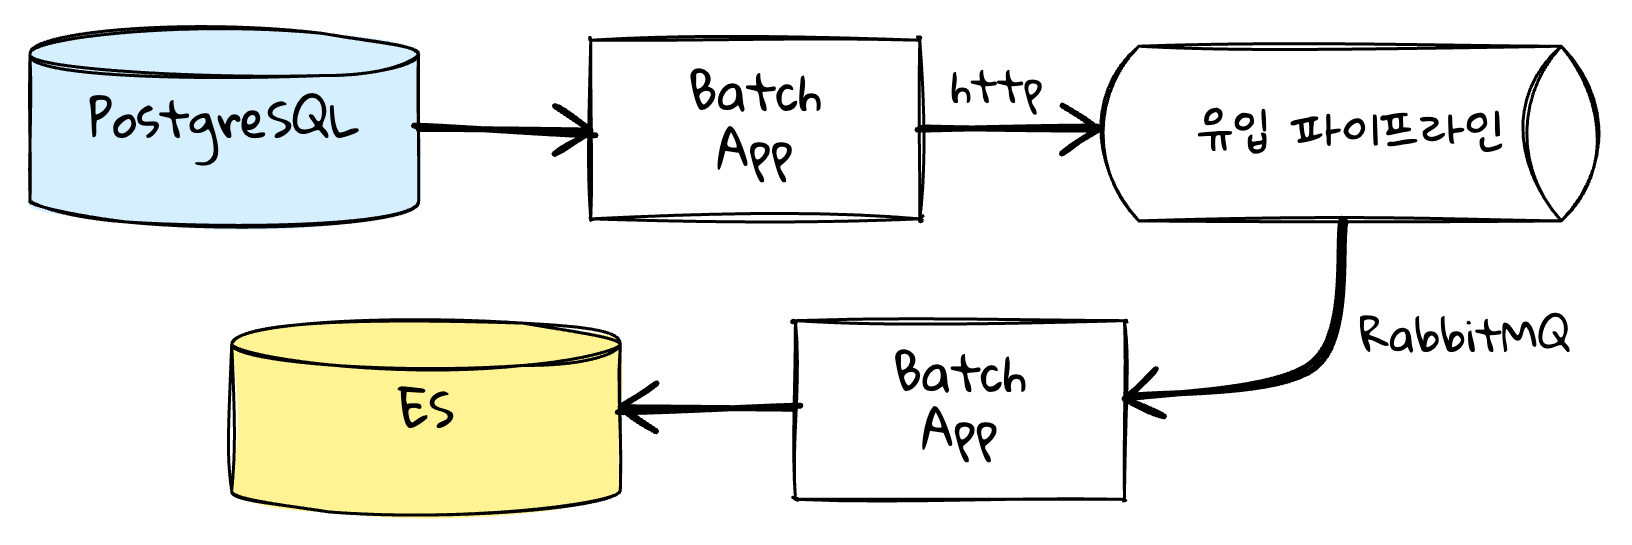
기존 파이프라인에서는 아래 순서로 동기화가 진행되었습니다.
-
PostgreSQL에 큐로 사용하는 테이블을 두어 ES에 인덱싱할 데이터를 저장
-
배치 앱에서 큐 테이블을 조회하여 유입 파이프라인으로 전송
-
유입 파이프라인에서 ES로 갈 데이터를 필터링하여 RabbitMQ로 전송
-
배치 앱에서 RabbitMQ 메시지를 컨슘하여 ES에 인덱싱
위 과정에서 언급된 유입 파이프라인은 저희 시스템에 연동된 서비스가 보낸 데이터를 처리하는 곳입니다. 유입된 데이터를 파싱하여 DB에 저장하고 있습니다. 굳이 ES에 인덱싱할 데이터가 거쳐 갈 필요는 없는 곳으로, 오히려 장애 지점만 늘리고 있습니다. 과거에는 나름의 이유를 갖고 이와 같이 설계되었지만 이제는 불필요하게 복잡한 설계로 남게 되었습니다. 그래서 문제가 발생했을 때 원인 파악에 어려움이 있었습니다. 기존 설계를 유지할 필요는 없었기 때문에 새로운 방식으로 파이프라인을 구성하기로 했습니다.
1.2 대안 선정
동기화 파이프라인을 새로 구성하기 위해 고민했던 툴은 Logstash, NiFi, PGSync, Kafka Connect가 있었습니다. 주로 PostgreSQL의 CDC(Change Data Capture) 이벤트를 캡처하는 툴을 찾았습니다. 그중에서 Kafka Connect를 선택했습니다. Kafka가 익숙하여 유지보수에 용이할 거라 판단했고, 가용성과 확장성 등의 이점을 그대로 가져올 수 있기 때문입니다.
2. 배경지식
이번 섹션에는 미리 알고 있으면 글을 읽을 때 도움이 되는 개념들을 작성했습니다. Kafka Connect의 구성 요소와 PostgreSQL의 Logical Decoding을 알고 계신다면 다음 섹션으로 건너뛰셔도 됩니다.
2.1 Kafka Connect 구성 요소
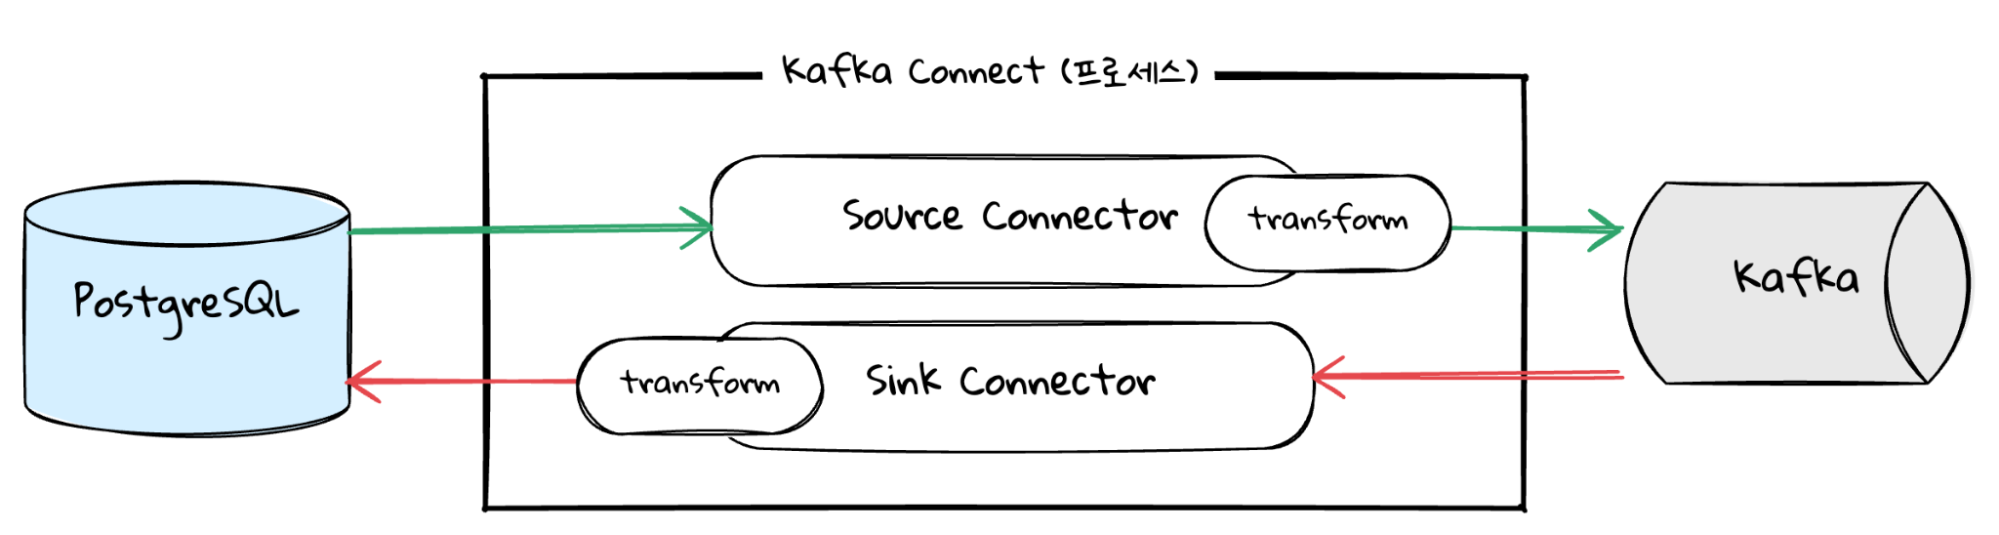
Kafka Connect
Kafka Connect는 자주 반복되는 카프카 기반의 데이터 작업을 실행하기 위한 JVM 프로세스입니다. Connector와 Task를 실행하고 관리하는 역할을 합니다. Connect는 단일 모드 또는 분산 모드로 실행될 수 있습니다. 단일 모드에서는 하나의 프로세스만 실행되기 때문에 장애가 발생하면 복구가 어려울 수 있습니다. 분산 모드는 여러 Connect 프로세스를 하나의 클러스터로 묶어서 관리합니다. 그래서 특정 프로세스에 장애가 발생해도 다른 프로세스에서 복구될 수 있습니다.
Kafka Connector
Kafa Connector는 수행할 작업을 구체적으로 정의하는 일종의 템플릿입니다. 어떤 작업을 할지에 대해 선언적으로 설정하여 배포할 수 있습니다. Connector 종류에는 Source Connector와 Sink Connector가 있습니다. Source Connector는 특정 소스에 있는 데이터를 Kafka로 전송합니다. 이와 반대로 Sink Connector는 Kafka 메시지를 컨슘하여 목적지로 전송합니다.
Task
Task는 Connector의 설정에 따라 실제로 데이터를 처리하는 스레드입니다. Connect 프로세스 내에서 실행됩니다.
Transforms
Transforms는 단일 메시지에 대해 변환할 수 있는 Connector의 설정입니다. 이미 구현된 플러그인을 사용할 수도 있고, 직접 커스텀하게 구현하여 사용할 수도 있습니다. Source Connector에 적용하면 Kafka 토픽에 넣기 전에 실행되고, Sink Connector에서는 목적지에 데이터를 넣기 전에 실행됩니다.
2.2 PostgreSQL의 Logical Decoding
PostgreSQL의 논리적 디코딩(Logical Decoding)은 데이터베이스의 변경 사항(WAL)을 외부에서 쉽게 이해할 수 있는 형식으로 변환하여 스트리밍하는 기술입니다. 이 스트리밍 과정은 구독자가 Replication Slot을 통해 특정 Publication을 구독하면 시작됩니다. 이후 Publication에 정의된 테이블에서 변경 사항이 발생하면, PostgreSQL은 WAL에 기록된 내용을 Output Plugin으로 디코딩 후 구독자에게 전달합니다.
Publication
데이터베이스 변경 사항을 발행할 테이블 목록입니다.
Replication Slot
데이터를 어디까지 읽었는지 기록하기 위한 책갈피입니다. 구독자가 데이터 변경 사항을 읽다가 연결이 끊겨도 Slot을 통해 끊긴 지점부터 변경 사항을 읽어올 수 있습니다.
Output Plugin
데이터베이스 변경 사항(WAL)을 특정 형식(json, sql 등)으로 변환하는 모듈입니다.
3. CDC 파이프라인 미리보기
3.1 파이프라인 구조
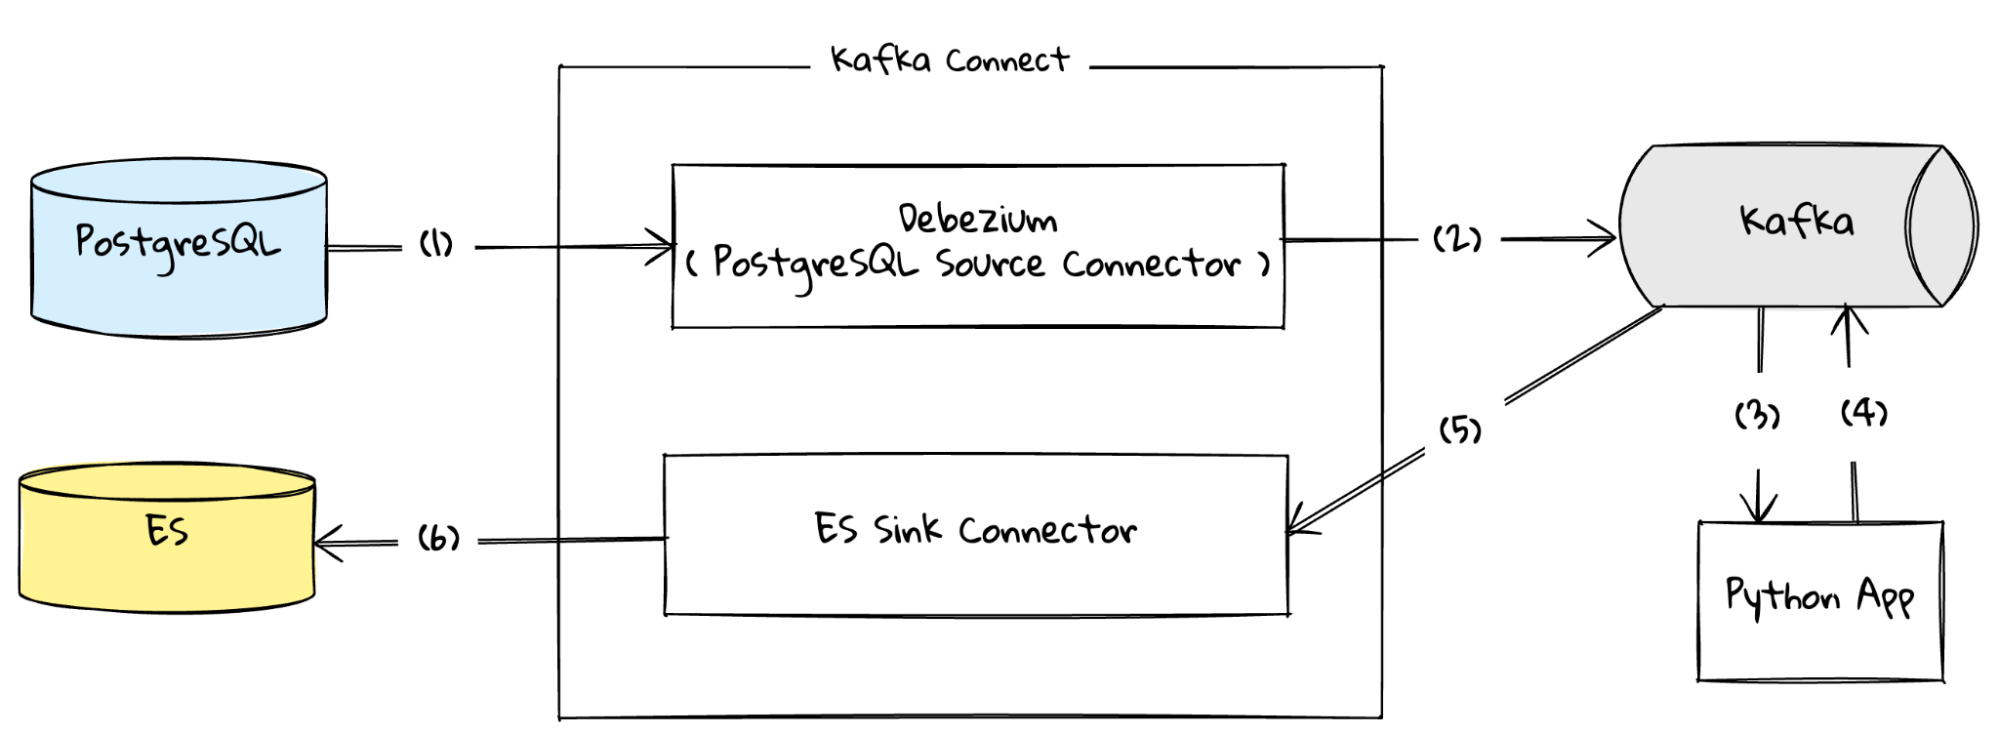
기본적인 파이프라인의 구조는 위와 같습니다. PostgreSQL의 데이터 변경 사항을 준실시간으로 Elasticsearch에 동기화합니다. 중간에 있는 Python 앱에서는 조직 내 비즈니스 로직에 맞게 데이터를 변환하고 있습니다.
Debezium은 Source Connector의 하나로 PostgreSQL의 CDC 이벤트를 Kafka로 전송합니다. ES Sink Connector는 CDC 이벤트 기반의 Kafka 메시지를 컨슘하여 ES에 인덱싱합니다. Debezium과 ES Sink Connector에서 필요로 하는 값들을 요구 사항에 맞게 설정하여 파이프라인을 구축하는 것이 주된 작업입니다.
3.2 데이터 흐름
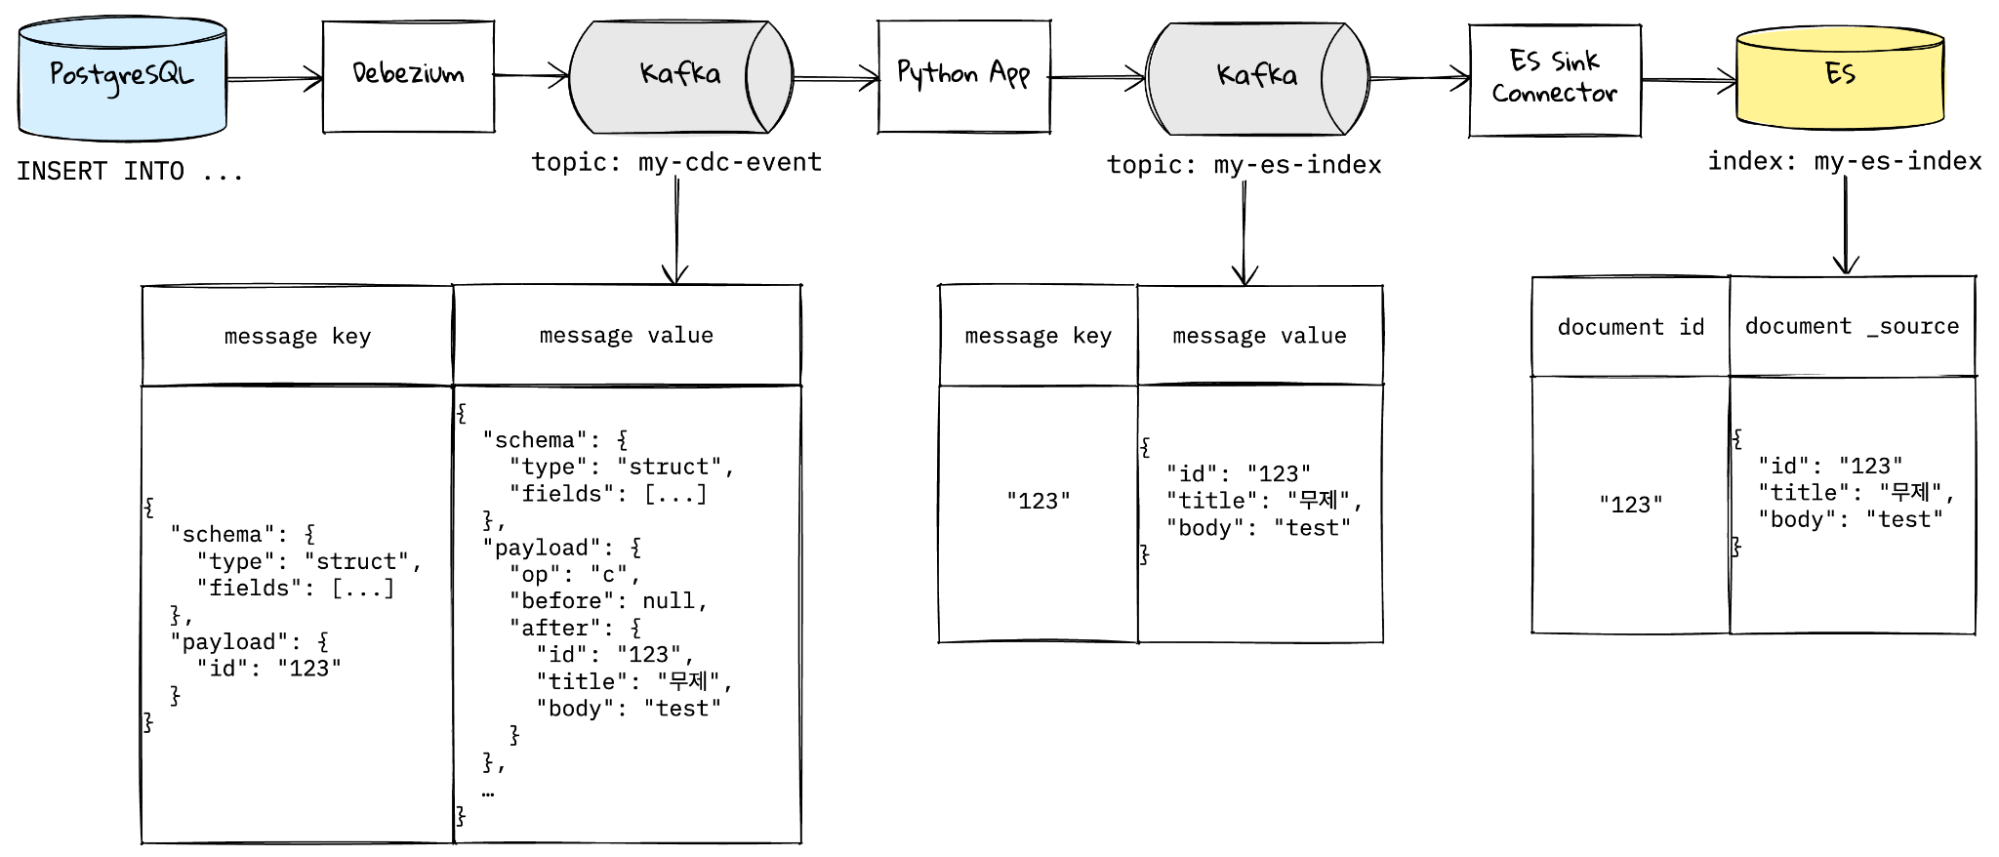
위 그림은 파이프라인 구성 후의 데이터 흐름입니다. 실제로는 더 복잡하지만 구조를 쉽게 이해할 수 있도록 간단히 나타냈습니다.
- PostgreSQL -> Debezium
- Debezium이 PostgreSQL에 연결한 뒤 구독하는 테이블의 변경 사항을 스트리밍합니다.
- 위 그림과 같이 INSERT INTO 쿼리가 실행되면 Output Plugin에 의해 디코딩 된 데이터가 Debezium에게 전달됩니다.
- Debezium -> Kafka
- Kafka Connect에는 고유한 json 스키마가 있습니다. schema와 payload로 구성되어 있습니다. 기본적으로 Debezium은 해당 스키마로 CDC 이벤트를 전송합니다.
- 메시지 키에는 CDC 이벤트가 발생한 레코드의 id가 들어있고, 메시지 값에는 이벤트 유형(op)과 변경 전 데이터(before)와 변경 후 데이터(after) 등이 들어있습니다.
- Python App -> Kafka
- 레코드 id를 추출하여 메시지 키에 넣고, ES에 넣을 데이터를 메시지 값에 넣었습니다.
- 실제로는 비즈니스 로직에 맞춰 ES에 넣을 데이터를 변환하고 있지만, 예제에서는 간단히 나타냈습니다.
- ES Sink Connector -> ES
- 컨슘한 토픽 이름을 ES의 인덱스 이름으로 사용합니다.
- 컨슘한 메시지 키를 도큐먼트 id로 사용합니다.
- 컨슘한 메시지 값을 도큐먼트 _source에 넣습니다.
4. CDC 파이프라인 구성
이제 본격적으로 CDC 파이프라인을 구성해 보겠습니다. Kafka Connect와 Kafka Connector의 설정값들을 구체적으로 설명합니다. 배포 방식은 뒤 섹션에서 설명하기 때문에, 이번 섹션에서는 어떤 설정값이 필요한지만 살펴보겠습니다.
4.1 Kafka Connect 환경 구성
Connector를 배포하기 전에 우선 Connect의 환경을 구성해야 합니다.
bootstrap.servers:  my-kafka-server:9092
group.id:  my-connect

config.storage.topic:  kakao-connect-config
offset.storage.topic:  kakao-connect-offset
status.storage.topic:  kakao-connect-status

plugin.path:  /opt/kafka/plugins
- bootstrap.servers
- 연결하려는 Kafka 클러스터입니다. Connect의 분산 모드에서 프로세스끼리 소통을 위해 사용하거나, Connector가 메시지를 컨슘하거나 전송할 때 사용할 클러스터입니다.
- group.id
- Kafka Connect가 분산 모드에서 실행될 경우 필요합니다. 여러 Connect 프로세스를 하나로 묶어주는 역할을 합니다. 같은 group.id를 가진 Connect 프로세스 중에 리더를 선출하고, 장애가 발생하면 같은 group.id를 갖는 Connect 프로세스 내에서 작업을 재분배합니다.
- *.storage.topic
- Connect가 내부적으로 사용하는 토픽입니다.
- config에서는 Connector의 설정 정보를 저장하고, offset에서는 Connector가 어디까지 처리했는지 저장하고, status에서는 Connector와 Task의 상태를 저장합니다. 분산 모드에서 특정 Connect 프로세스에 장애가 생겼을 때, 해당 토픽들을 사용하여 다른 프로세스에서도 Connector의 설정값과 시작 위치를 알 수 있습니다.
- plugin.path
- 사용할 Connector와 Transforms 플러그인이 있는 디렉토리 경로입니다. 해당 경로에 Connector의 JAR 파일을 두어야 Connect가 플러그인을 찾아 실행할 수 있습니다.
4.2 Kafka Connector 설정
설정이 필요한 Connector는 Debezium과 ES Sink Connector입니다. 각 Connector를 설정하고 Connect 프로세스에 배포하면 Task 스레드가 실행됩니다.
4.2.1 Debezium(PostgreSQL Source Connector) 설정
PostgreSQL 관련 설정
어떤 DB에서 어떤 테이블의 변경 사항을 스트리밍 해올지 설정해야 합니다.
database.hostname:  my-db-host
database.port:  5555
database.dbname:  mydb
database.user:  ''
database.password:  ''

plugin.name:  pgoutput
publication.name:  my_publication
publication.autocreate.mode:  disabled
slot.name:  my_slot

table.include.list:  kakao.article,kakao.comment
-
database.*
- 연결할 PostgreSQL 정보입니다.
-
plugin.name
- WAL을 변환할 플러그인을 설정합니다. pgoutput은 PostgreSQL에 기본적으로 내장된 플러그인입니다.
-
publication.name
- Debezium에서 사용할 Publication 이름입니다. 미리 생성했습니다.
-
publication.autocreate.mode
- Publication 생성 방식에 대한 설정입니다. 미리 생성했기 때문에 disabled로 설정했습니다.
-
slot.name
- Debezium에서 사용할 Slot입니다. 없으면 자동으로 생성되며 Debezium마다 구분해서 사용해야 합니다.
-
table.include.list
- 캡처하려는 테이블 목록입니다. schema.table로 설정합니다. Debezium은 Publication에 설정된 테이블의 변경 사항을 모두 받지만, table.include.list에 있는 테이블만 다시 필터링합니다.
Kafka 관련 설정
어떤 Kafka 토픽으로 CDC 이벤트를 전송할지 설정해야 합니다. 사용하는 Kafka 토픽은 기본적으로 .. 포맷입니다. 그래서 Kafka 토픽이 테이블 이름에 의존적입니다. 테이블 구분 없이 하나의 토픽만 사용하기 위해 transforms 설정을 추가했습니다.
topic.prefix:  kakao

# 단일 메시지 변환 설정
transforms:  Reroute
transforms.Reroute.type:  io.debezium.transforms.ByLogicalTableRouter
transforms.Reroute.topic.regex:  (.*)\.(.*)\.(article|comment)
transforms.Reroute.topic.replacement:  my-cdc-event
-
topic.prefix
- 사용할 Kafka 토픽의 prefix입니다.
-
transforms
- 사용할 transform의 별칭입니다. Reroute로 정의했으므로 transforms.Reroute.* 방식으로 필드 값을 설정할 수 있습니다.
-
transforms.Reroute
-
정규식에 매칭된 Kafka 토픽을 다른 토픽으로 라우팅 합니다. 위 설정을 적용하면 article과 comment 테이블의 CDC 이벤트는 my-cdc-event 토픽으로 전송됩니다.
-
ByLogicalTableRouter은 Debezium에서 제공하는 transforms 플러그인입니다.
-
topic.regex와 topic.replacement는 ByLogicalTableRouter가 주입받아서 사용하는 필드입니다.
-
4.2.2 ES Sink Connector 설정
Kafka 관련 설정
어떤 Kafka 토픽에서 메시지를 꺼내고 어떻게 해석할지 설정해야 합니다.
topics:  my-es-index

key.converter:  org.apache.kafka.connect.json.JsonConverter
value.converter:  org.apache.kafka.connect.json.JsonConverter

key.converter.schemas.enable: false
value.converter.schemas.enable: false

schema.ignore: true
-
topics
- 컨슘할 Kafka 토픽입니다. 토픽은 저장할 인덱스로 사용됩니다. ,(comma)로 구분해서 여러 토픽을 설정할 수도 있습니다.
-
*.converter
- Connector 입장에서는 메시지 키와 값의 구조를 알 수 없어서 컨슘하는 메시지가 어떤 구조인지 알려줘야 합니다.
- 현재 json으로 보내고 있기 때문에 JsonConverter로 설정했습니다.
-
*.converter.schemas.enable
- 메시지 구조에 스키마가 포함됐는지를 확인합니다.
- Debezium이 기본적으로 보내는 메시지 구조에는 스키마가 포함되지만, 중간에 Python 앱을 거치면서 스키마를 제거했기 때문에 false로 설정했습니다.
-
schema.ignore
- 인덱싱 과정에서 스키마를 무시할지 설정합니다. 만약 메시지 구조에 스키마가 있다면 스키마를 토대로 매핑을 진행합니다.
- 예시에서는 true로 설정하여 다이내믹 매핑이 되도록 했습니다.
ES 관련 설정
connection.url: my-es-url:9200
behavior.on.null.values:  delete
-
connection.url
- 연결할 ES 정보입니다.
-
behavior.on.null.values
- Kafka 메시지 값이 null로 왔을 때 어떻게 동작할지에 대한 설정입니다. delete로 설정하여 도큐먼트를 삭제하도록 했습니다.
5. 배포
Kafka Connect를 배포하는 가장 기본적인 방법은 Confluent에서 제공하는 도커 이미지를 사용하는 것입니다. 도커 컨테이너를 띄운 후 Kafka Connect에서 지원하는 REST API로 Connector를 생성하고 삭제하고 상태를 조회할 수 있습니다.
저희 조직에서는 대부분의 앱을 쿠버네티스에 올리고 GitOps로 관리하고 있습니다. Kafka Connect도 같은 방식으로 관리할 수 없을지 고민하던 중 Strimzi라는 툴을 발견했습니다. Strimzi는 쿠버네티스 환경에서 Kafka Connect를 배포할 수 있게 해줍니다. 이번 섹션에서는 Strimzi로 Connect와 Connector를 배포하는 방식을 설명합니다.
5.1 Strimzi 설치
$  helm  install  strimzi-cluster-operator
oci://quay.io/strimzi-helm/strimzi-kafka-operator

$  kubectl  get  deployment
NAME  READY  UP-TO-DATE  AVAILABLE  AGE
strimzi-cluster-operator  1/1  1  1  3m57s
Strimzi는 helm 커맨드로 간단하게 설치 가능합니다.
5.2 Kafka Connect 배포
Kafka Connect 이미지 준비
FROM  quay.io/strimzi/kafka:0.29.0-kafka-3.0.0
USER  root:root
COPY  ./my-plugins/  /opt/kafka/plugins/
쿠버네티스에 배포할 Connect 이미지를 빌드하기 위해 위와 같이 Dockerfile을 작성했습니다. 베이스 이미지 태그는 사용할 Kafka 버전에 맞춰 설정해야 합니다. my-plugins에는 사용할 Connector 또는 Transforms의 JAR 파일이 들어있어야 합니다. Debezium과 ES Sink Connector 플러그인도 Confluent Hub에서 다운받아서 이미지에 넣어줬습니다.
커스텀 리소스 작성
apiVersion:  kafka.strimzi.io/v1beta2
kind:  KafkaConnect
metadata:
    name:  my-connect
    annotations:
	    strimzi.io/use-connector-resources:  true
spec:
    version:  3.0.0
    replicas:  2
    bootstrapServers:  my-kafka-server:9092
    image:  my-kafka-connect:latest
    config:
	    group.id:  my-connect
	    config.storage.topic:  kakao-connect-config
	    offset.storage.topic:  kakao-connect-offset
	    status.storage.topic:  kakao-connect-status
	    plugin.path:  /opt/kafka/plugins
이제 Strimzi의 커스텀 리소스를 통해 Connect를 배포할 수 있습니다. 일부 필드만 살펴보겠습니다.
-
kind
- 커스텀 리소스인 KafkaConnect로 설정합니다.
-
spec.replicas
- 분산 모드를 제대로 지원하기 위해 2 이상으로 설정해야 합니다. 2로 설정하면 2개의 파드가 실행됩니다.
-
spec.image
- 위에서 준비했던 Connect 이미지를 넣어주면 됩니다. 사용할 플러그인이 잘 포함되어야 합니다.
-
spec.config
- 파이프라인 구성 섹션에서 살펴봤던 설정들이 들어갑니다.
배포
$  kubectl  apply  -f  connect.yaml
kafkaconnect.kafka.strimzi.io/my-connect  created

$  kubectl  get  KafkaConnect
NAME  DESIRED  REPLICAS  READY
my-connect  2  True

$  kubectl  get  pods
NAME  READY  STATUS  RESTARTS  AGE
my-connect-connect-0  1/1  Running  0  33s
my-connect-connect-1  1/1  Running  0  33s
배포하면 파드 두개가 뜬 것을 볼 수 있습니다. 이제 Connector를 배포하기 위한 준비가 되었습니다.
5.3 Debezium 배포
커스텀 리소스 작성
apiVersion:  kafka.strimzi.io/v1beta2
kind:  KafkaConnector
metadata:
	name:  debezium
	labels:
		strimzi.io/cluster:  my-connect
spec:
	class:  io.debezium.connector.postgresql.PostgresConnector
	tasksMax:  1
	config:
		database.hostname:  my-db-host
		database.port:  5555
		database.dbname:  mydb
		database.user:  ''
		database.password:  ''

	    plugin.name:  pgoutput
	    publication.name:  my_publication
	    publication.autocreate.mode:  disabled
	    slot.name:  my_slot

	    table.include.list:  kakao.article,kakao.comment

	    topic.prefix:  kakao

	    transforms:  Reroute
	    transforms.Reroute.type:
	    io.debezium.transforms.ByLogicalTableRouter
	    transforms.Reroute.topic.regex:  (.*)\.(.*)\.(article|comment)
	    transforms.Reroute.topic.replacement:  my-cdc-event
Kafka Connect의 매니페스트를 작성한 것과 크게 다르지 않습니다. 일부만 살펴보겠습니다.
-
kind
- 커스텀 리소스인 KafkaConnector로 설정합니다.
-
metadata.labels.strimzi.io/cluster
- Connector가 실행될 Connect의 이름을 넣습니다.
-
spec.class
- 실행할 Connector 플러그인을 설정합니다. Connect의 플러그인 경로에 존재하는 플러그인이어야 합니다.
-
spec.tasksMax
- Connector에서 사용할 Task 개수를 설정합니다. PostgreSQL Debezium에서는 순서 보장을 위해 최대 1개의 Task만 실행됩니다.
-
spec.config
- 파이프라인 구성 섹션에서 살펴봤던 설정들이 들어갑니다.
배포
$  kubectl  apply  -f  debezium.yaml
kafkaconnector.kafka.strimzi.io/debezium  created

$  kubectl  get  KafkaConnector
NAME  CLUSTER  CONNECTOR  CLASS  MAX  TASKS  READY
debezium  my-connect PostgresConnector  1  True
배포하면 KafkaConnector 리소스로 조회할 수 있습니다. Connect 파드의 로그를 보면 Task가 실행되는 것을 확인할 수 있습니다.
5.4 ES Sink Connector 배포
커스텀 리소스 작성
apiVersion:  kafka.strimzi.io/v1beta2
kind:  KafkaConnector
metadata:
    name:  es-sink-connector
    labels:
	    strimzi.io/cluster:  my-connect
spec:
    class:  io.confluent.connect.elasticsearch.ElasticsearchSinkConnector
    tasksMax:  4
    config:
	    topics:  my-es-index

	    key.converter:  org.apache.kafka.connect.json.JsonConverter
	    value.converter:  org.apache.kafka.connect.json.JsonConverter
	    key.converter.schemas.enable: false
	    value.converter.schemas.enable: false
	    schema.ignore: true

	    connection.url: my-es-url:9200
	    behavior.on.null.values:  delete
Debezium과 설정값만 다를 뿐 구조는 동일합니다.
- spec.tasksMax
- Sink Connector는 카프카 메시지를 컨슘하기 때문에 파티션 개수를 고려해서 Task 개수를 설정하면 좋습니다.
배포
$  kubectl  apply  -f  es_sink_connector.yaml
kafkaconnector.kafka.strimzi.io/es-sink-connector  created

$  kubectl  get  KafkaConnector
NAME  CLUSTER  CONNECTOR  CLASS  MAX  TASKS  READY
es-sink-connector  my-connect  ElasticsearchSinkConnector  5  True
배포 후 KafkaConnector 리소스로 확인할 수 있습니다.
6. 정리
지금까지 Kafka Connect를 활용하여 CDC 파이프라인을 구성해 봤습니다. 데이터를 어떻게 전달하고 읽어올지에 따라 Connector의 설정값과 파이프라인 구성 방식이 달라질 수 있습니다. 예를 들면 위에 구성한 Debezium에서 불필요한 데이터를 제거한 뒤 Kafka로 보낼 수도 있습니다. 조직과 환경의 요구 사항에 맞춰 적절하게 설정하시면 될 것 같습니다.
성과 측면에서는, 우선 간헐적으로 발생하던 정합성 문제가 모두 해소되었습니다. 또한 불필요한 의존성을 제거하고 파이프라인을 단순화했기 때문에 문제가 발생해도 원인을 쉽게 찾을 수 있게 됐습니다. ES 인덱싱 속도는 기존 대비 최대 47% 향상되기도 했습니다.
다음 글에서는 CDC 파이프라인을 구성하면서 겪었던 트러블슈팅을 중점적으로 소개합니다. 이번 글에서 구성한 파이프라인을 적용했을 때 어떤 문제가 발생했고 어떻게 해결했는지 공유할 예정입니다.