Data
뼈대 있는 가문의 데이터로 만들기
2021년 7월 8일
원문에서 보기 ↗데이터 처리, 집계, 모델링 업무를 수행하다 보면 인지하지 못하는 복잡한 상관관계가 만들어지게 됩니다. 특히 테이블이라고 표현되는 Relational Database의 DataSet들은 조회 용으로 쓰이는 경우도 있지만 많은 경우 다른 DataSet의 입력이 되거나 참조하는 meta성 데이터가 되기도 합니다.
그러다 보니 아래와 같은 경우가 심심치 않게 자주 발생됩니다.
모델러 A님이 고심하여 "게임유료결제회원이력테이블 T1"을 만들었고 이를 팀원 분들에게 알렸습니다.
같은 팀 모델러 B님는 A님에게 "서비스별 MPU(Monthly Pay User) 테이블 T2"를
T1으로 만들 것이니 변경되면 공유해줘!라고 말했습니다.

T2 테이블을 본 분석가 C님는 "와 누군가 MPU를 말아놨네~ 매달 초 리포트에 써야지!"라는 생각을 했습니다.
A님께 앞으로 PAYCO회원의 유료결제 이력도 집계하는 업무가 할당되어 기존에 만들었던 T1을 개량하고
B님에게 변경내용을 알렸습니다.

T2는 서비스별 코드로 분류하고 있고 조회 시 코드별로 구분해서 조회하고 있으니
B님은 별다른 대응을 하지 않아도 문제가 없습니다.
다음 달 C님은 아무 의심 없이 T2를 합산해서 게임 결제 유저가 많이 늘었다는 보고서를 작성 했습니다.

... 이하 생략 ...
어떻게 대응해야 할까요? ㅠ.ㅠ
이를 해결하기 위해서는 T1을 참조하는 테이블 다시 말해서 T1의 자손들을 찾아야 합니다. 또 이 자손 테이블 들을 담당하고 있는 Owner가 누구인지 알 수 있어야 합니다. 그리고 이런 것들을 찾을 수 있도록 각종 데이터를 모아야 합니다. 이런 환경 및 결과물을 "Data Lineage"라고 부르고 있습니다.
BI분석서비스실에서도 시스템으로 유입되는 데이터가 변경되는 경우, 그 여파가 어느 정도 되는지 파악하기 힘들다 보니 이러한 족보를 만드는 작업을 하고 있습니다.
다행히 실행이력이 존재하기도 하고 작업 쿼리 등이 용도 별로 그룹핑되어있어 적지 않은 노력을 들이기는 했지만 생각보다 어렵지 않게 아래 그림처럼 2천 개 이상의 테이블이 4천 개 이상의 상관관계를 만들어 내고 있는 것을 알아냈습니다.
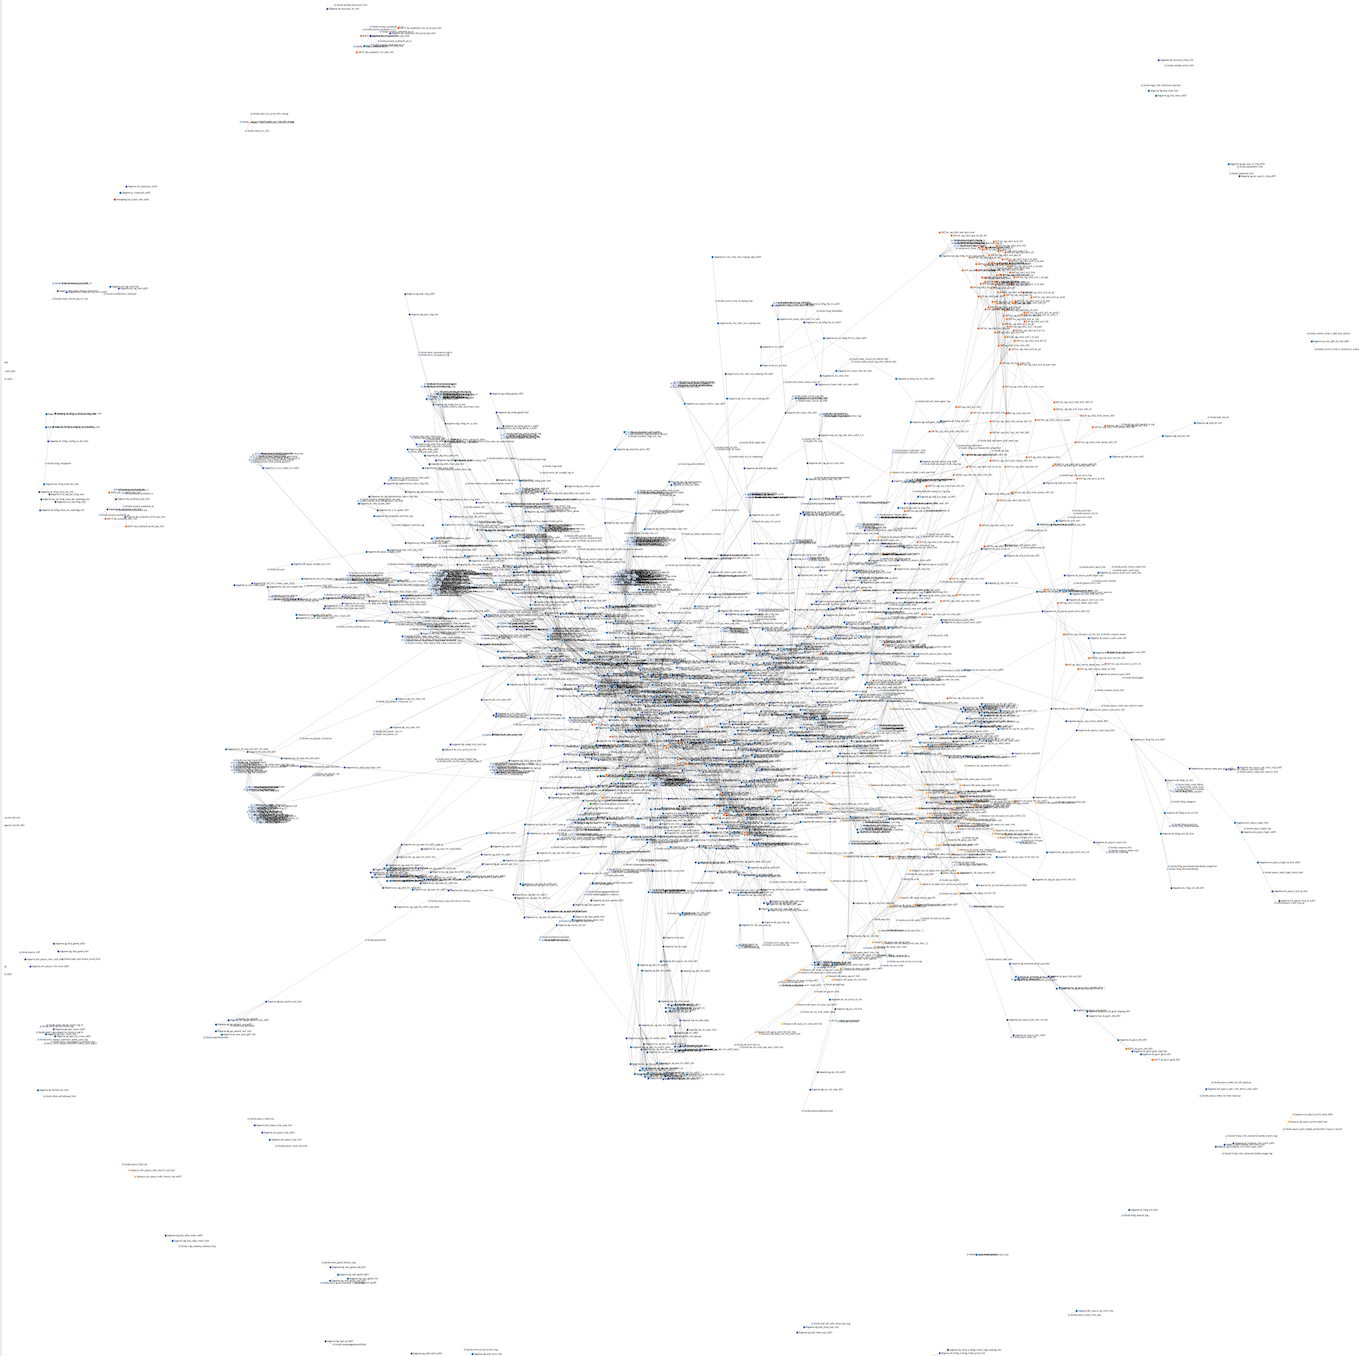 <그림> BIP의 데이터 리니지
여기까지 보시고 "처음부터 이런 것을 고려해서 시스템을 만들었으면 가능 하지만 우린 이미 이 부분을 고려하지 않고 많이 진행되었는 걸..."이라고 생각하시는 분들도 계실 듯하여 제가 수행한 과정 중 사 후 처방한 내용도 같이 공유해 드리겠습니다.
SQL을 자주 쓰시는 분들은 SQL을 AST(Abstract Syntax Trees)로 표현 가능한 것을 알고 계실 것 같은데요. AST 등으로 파싱 된 쿼리에서 참조 테이블 및 생성 테이블을 뽑아오면 그것이 데이터 리니지의 노드 및 엣지 정보가 됩니다.
또 다행스럽게 이러한 기능을 수행하는 모듈을 직접 만드실 필요가 없이 hadoop의 SQL 에코시스템인 hive의 package를 참조하면 됩니다.
다음은 insert select 쿼리에서 데이터 리니지를 뽑기 위해 간단하게 만들어본 코드 예제입니다.
package org.airguy.lineage.sql;

import org.apache.hadoop.hive.ql.parse.ParseException;
import org.apache.hadoop.hive.ql.parse.SemanticException;
import org.apache.hadoop.hive.ql.tools.LineageInfo;

public class GetLineage {

    public GetLineage() throws SemanticException, ParseException {

        LineageInfo li = new LineageInfo();

        String query = "insert overwrite table bigame.dp_posbank_rtm_pay_hist partition (work_ymd = '20200616')\n" +
                "             select\n" +
                "                co_cd\n" +
                "                , slip_no\n" +
                "                , mrc_cd\n" +
                "                , stat_tp_cd\n" +
                "                , nvl(case when dc1 <> 0 then dc1 else dc2 end, 0) as dc_amt\n" +
                "                , nvl(crd_amt, 0) as crd_amt\n" +
                "                , nvl(setl_amt, 0) as setl_amt\n" +
                "                , nvl(pay_amt, 0) as pay_amt\n" +
                "                , nvl(cash_rct_pubt_amt, 0) as cash_rct_pubt_amt\n" +
                "                , nvl(cust_cnt, 0) as cust_cnt\n" +
                "                , pay_dt\n" +
                "               from (\n" +
                "                select\n" +
                "                    pe.com_id as co_cd\n" +
                "                    , pe.pe_id as slip_no\n" +
                "                    , pe.rct_code as mrc_cd\n" +
                "                    , cast(pe.pe_ck as string) as stat_tp_cd\n" +
                "                    , case when nvl(dc.dc_amt,0) <> 0 then nvl(dc.dc_amt,0) else nvl(pe.pe_dc,0) end as dc1\n" +
                "                    , (ps.ps_amt + ps.ps_tax) * -1 as dc2\n" +
                "                    , pe.pe_misu  as crd_amt\n" +
                "                    , pe.pe_ec as setl_amt\n" +
                "                    , pe.pe_tot as pay_amt\n" +
                "                    , nvl(cr.cashrct,0) as cash_rct_pubt_amt\n" +
                "                    , nvl(rt.ctcnt,0) as cust_cnt\n" +
                "                    , pe.pe_pdate as pay_dt\n" +
                "                  from biods.possys_posbank_pe_rt pe\n" +
                "                  left join biods.possys_posbank_cr_rt cr on cr.partitionkey = '20200616' and pe.com_id = cr.com_id and pe.pe_id = cr.pe_id\n" +
                "                  left join biods.possys_posbank_rt_rt rt on rt.partitionkey = '20200616' and pe.com_id = rt.com_id and pe.pe_id = rt.pe_id\n" +
                "                  left join biods.possys_posbank_dc_rt dc on dc.partitionkey = '20200616' and pe.com_id = dc.com_id and pe.pe_id = dc.pe_id\n" +
                "                  left join biods.possys_posbank_ps_rt ps on ps.partitionkey = '20200616' and pe.com_id = ps.com_id and pe.pe_id = ps.pe_id and ps.pr_code = '99999998'\n" +
                "                 where pe.partitionkey = '20200616'\n" +
                "                   and pe_ck <> 0\n" +
                "               ) a";

        li.getLineageInfo(query);

        for(String inputTable : li.getInputTableList()) {
            System.out.println("input=" + inputTable);
        }

        for(String outputTable : li.getOutputTableList()) {
            System.out.println("output=" + outputTable);
        }
    }


    public static void main(String[] args) throws Exception{
        GetLineage gl = new GetLineage();
    }

}
실행 결과는 다음과 같습니다. 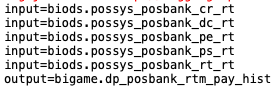
혹시 진짜로 실제로 사용하실지도 모르니 pom까지 붙여놓겠습니다. ^^;;
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>DataLineage</groupId>
  <artifactId>HiveLineage</artifactId>
  <version>0.0.1-SNAPSHOT</version>
  <name>HiveDataLineage</name>

  <properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.6</maven.compiler.source>
    <maven.compiler.target>1.6</maven.compiler.target>
  </properties>

  <dependencies>
    <dependency>
        <groupId>org.apache.hive</groupId>
        <artifactId>hive-exec</artifactId>
        <version>1.2.1</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>2.7.1</version>
    </dependency>
  </dependencies>

</project>
이제 실행한 쿼리 목록만 모을 수 있다면 이제 족보를 그리는 것은 식은 죽 먹기입니다.
이 개념을 겸직하고 있는 뉴딥기술랩, 데이터 테크랩에서는 좀 더 확장해서 사용하고 있습니다. 조직 특성상 업무 중 여러 데이터를 운영하다 보니 SQL 환경이 아닌 곳에서도 데이터 처리 작업을 수행하는 경우가 많습니다. (SPARK, MapReduce, PIG,...) 당연히도 역시 유사한 상황이 발생하고 이를 해소하기 위해 작업/데이터 간 Lineage를 표현할 수 있는 방법을 고민하고 있습니다.
해결 방안으로는 이전에도 소개드렸던 것처럼 이벤트 기반의 데이터 처리 작업의 실행/이력 등을 관장하는 스케쥴러를 만들고 이곳에 작업을 등록할 때 어떤 데이터가 필요한 지와 어떤 데이터를 만들어 내는지 기입하도록 강제했습니다.
물론 강제만 하면 저항이 생길 테니 이 환경을 쓰면 생기는 여러 장점을 같이 제시했습니다.
- 등록하는 작업은 어떤 방법을 쓰든(hive SQL, impala SQL, Streaming, SPARK, MapReduce,...) 상관 안 할 테니 편한 방식으로 처리고 이것을 실행 가능한 쉘로만 감싸줘!
- 어떤 데이터가 필요한 지 기입하면 이 데이터가 변경될 때 이것을 감지해서 자동으로 작업을 실행시켜 줄게!
- 물론 crontab처럼 시간을 기입해도 실행되니 걱정 마!
- 자주 쓰는 기능은 template으로 만들어 놨으니 복붙 해서 쓰고 너는 로직에만 신경 써!
- 네가 필요한 데이터/작업을 누가 만들었는지 UI로 알려줄게!
그렇다 보니 별다른 작업 없이 자동으로 Lineage가 만들어진다는 장점 이외에도 Airflow, Oozie, Azkaban, Luigi와 같은 다른 WorkFlow Engine과 달리 데이터 처리 코드 이외에 별도의 DAG, 작업 명세서를 작성할 필요가 없었습니다.
앞의 과정에서 생성된 데이터를 참조하려면 기존의 DAG 혹은 pipe를 수정해야 하는 부담도 자연스럽게 같이 없어졌고요. 작업의 장애요소를 해결한 후 해당 작업을 실행하면 완료 후 자손들이 자동으로 실행되어 복구되는 "일촌 파도타기"도 가능 해졌습니다.
또 여기에 작업 실행이력(log)을 오버레이 해서 다음과 같은 데이터/작업 가족의 변천사(job log)도 timeline 별로 확인이 가능하도록 구성하여 관리에 편의를 도모할 수 있었습니다.
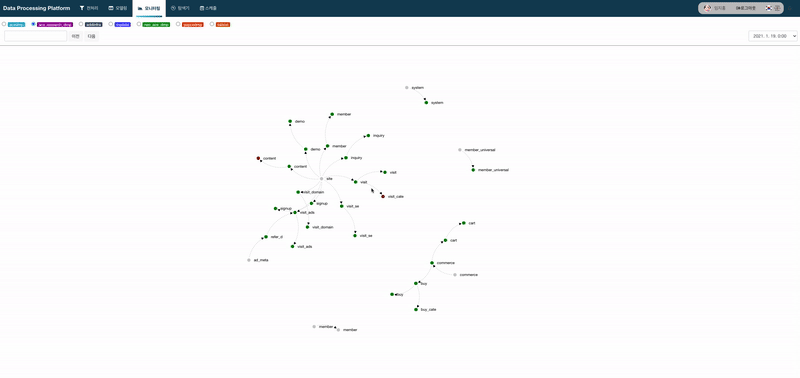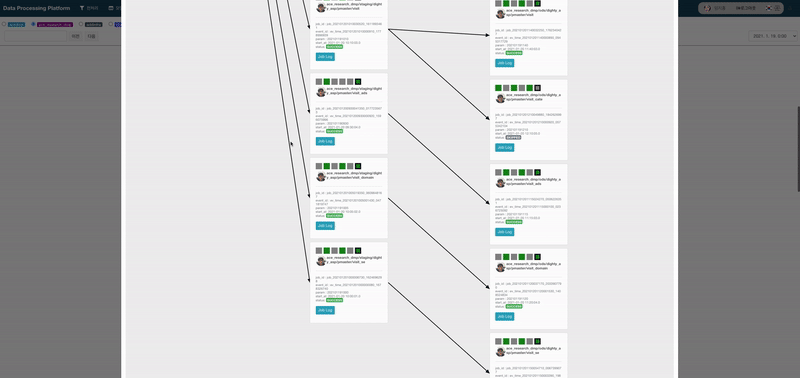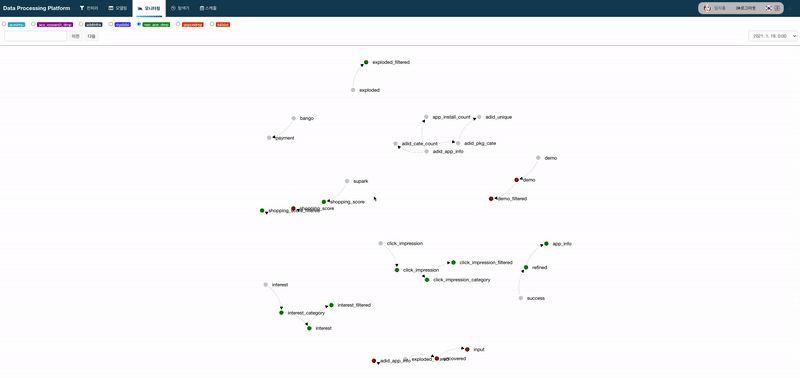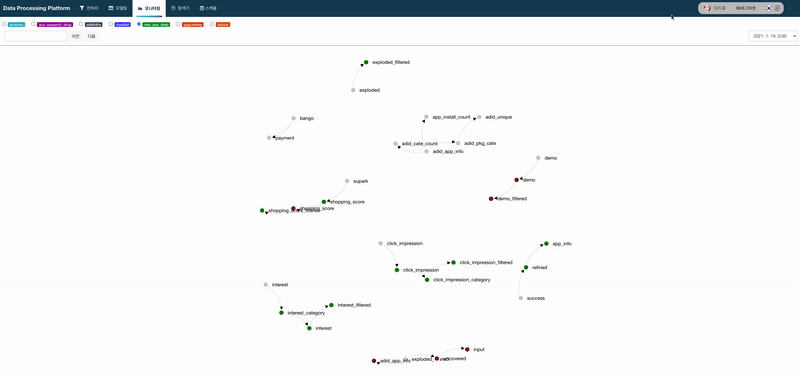 <그림> Data Manager - Workflow Engine
최근 데이터 거버넌스라는 용어를 많이 들어보셨을 것 같습니다. 의미를 위키에서 찾아보면
"기업에서 사용하는 데이터의 가용성, 유용성, 통합성, 보안성을 관리하기 위한 정책과 프로세스~~~"
라고 합니다.
저는 그냥 개발자스럽게 데이터를 잘 관리/활용하기 위한 솔루션이라고 생각하고 있습니다. 데이터 리니지는 (제 입장에서) 애매한 표현인 데이터 거버넌스 중에서 눈으로 명확하게 볼 수 있는 몇 안 되는 부분이기도 하여 데이터 카탈로그와 함께 거버넌스 솔루션 상에서 중요한 역할을 하는 framework 이기도 합니다.
다음에 기회가 된다면 data lineage와 연동되어 꿰어야 보배가 되는 데이터들이 어디에 있는지 어떻게 생겼는지 찾아볼 수 있는 data catalog에 대해 말씀드려보겠습니다.
또 이러한 개념은 꼭 데이터 영역으로만 한정할 필요가 없이 다양한 개발 업무 과정에서 유사한 고민을 해결할 수 있는 답이 될 수도 있겠다 라는 생각이 들기도 하고요.
일하다가 문득 공유해야겠다는 생각이 들어 작성하다 보니 갑자기 코드도 튀어나오고 정리도 부족한 엉성한 글이지만 조금이라도 도움이 되셨기를 기원하며 시간 내시어 긴 글 읽어주셔서 감사합니다.