Engineering
학생에서 개발자로: 로또 구현부터 레거시 개선까지, 서버의 흐름을 배우다
daniel.hoon, danny.197, seogi.nam, frank.jeong카카오
2026년 3월 13일
원문에서 보기 ↗2026 신입공채 테크 뉴크루들은 기술 온보딩 과정 을 통해 업무에 필요한 기술 역량 과 지식을 체계적으로 익히며 성장했습니다.
이번 글에서는 카카오 서버 개발 직군 온보딩을 직접 경험한 크루의 시선으로, 그 과정과 그 안에 담긴 의미를 이야기해보려 합니다.
기술 온보딩이 종료된 이후 진행된 랩업미팅에서 서버 세션 발표 주제는 이것이었습니다.
“서버, 라면 끓이기보다 쉽다.”
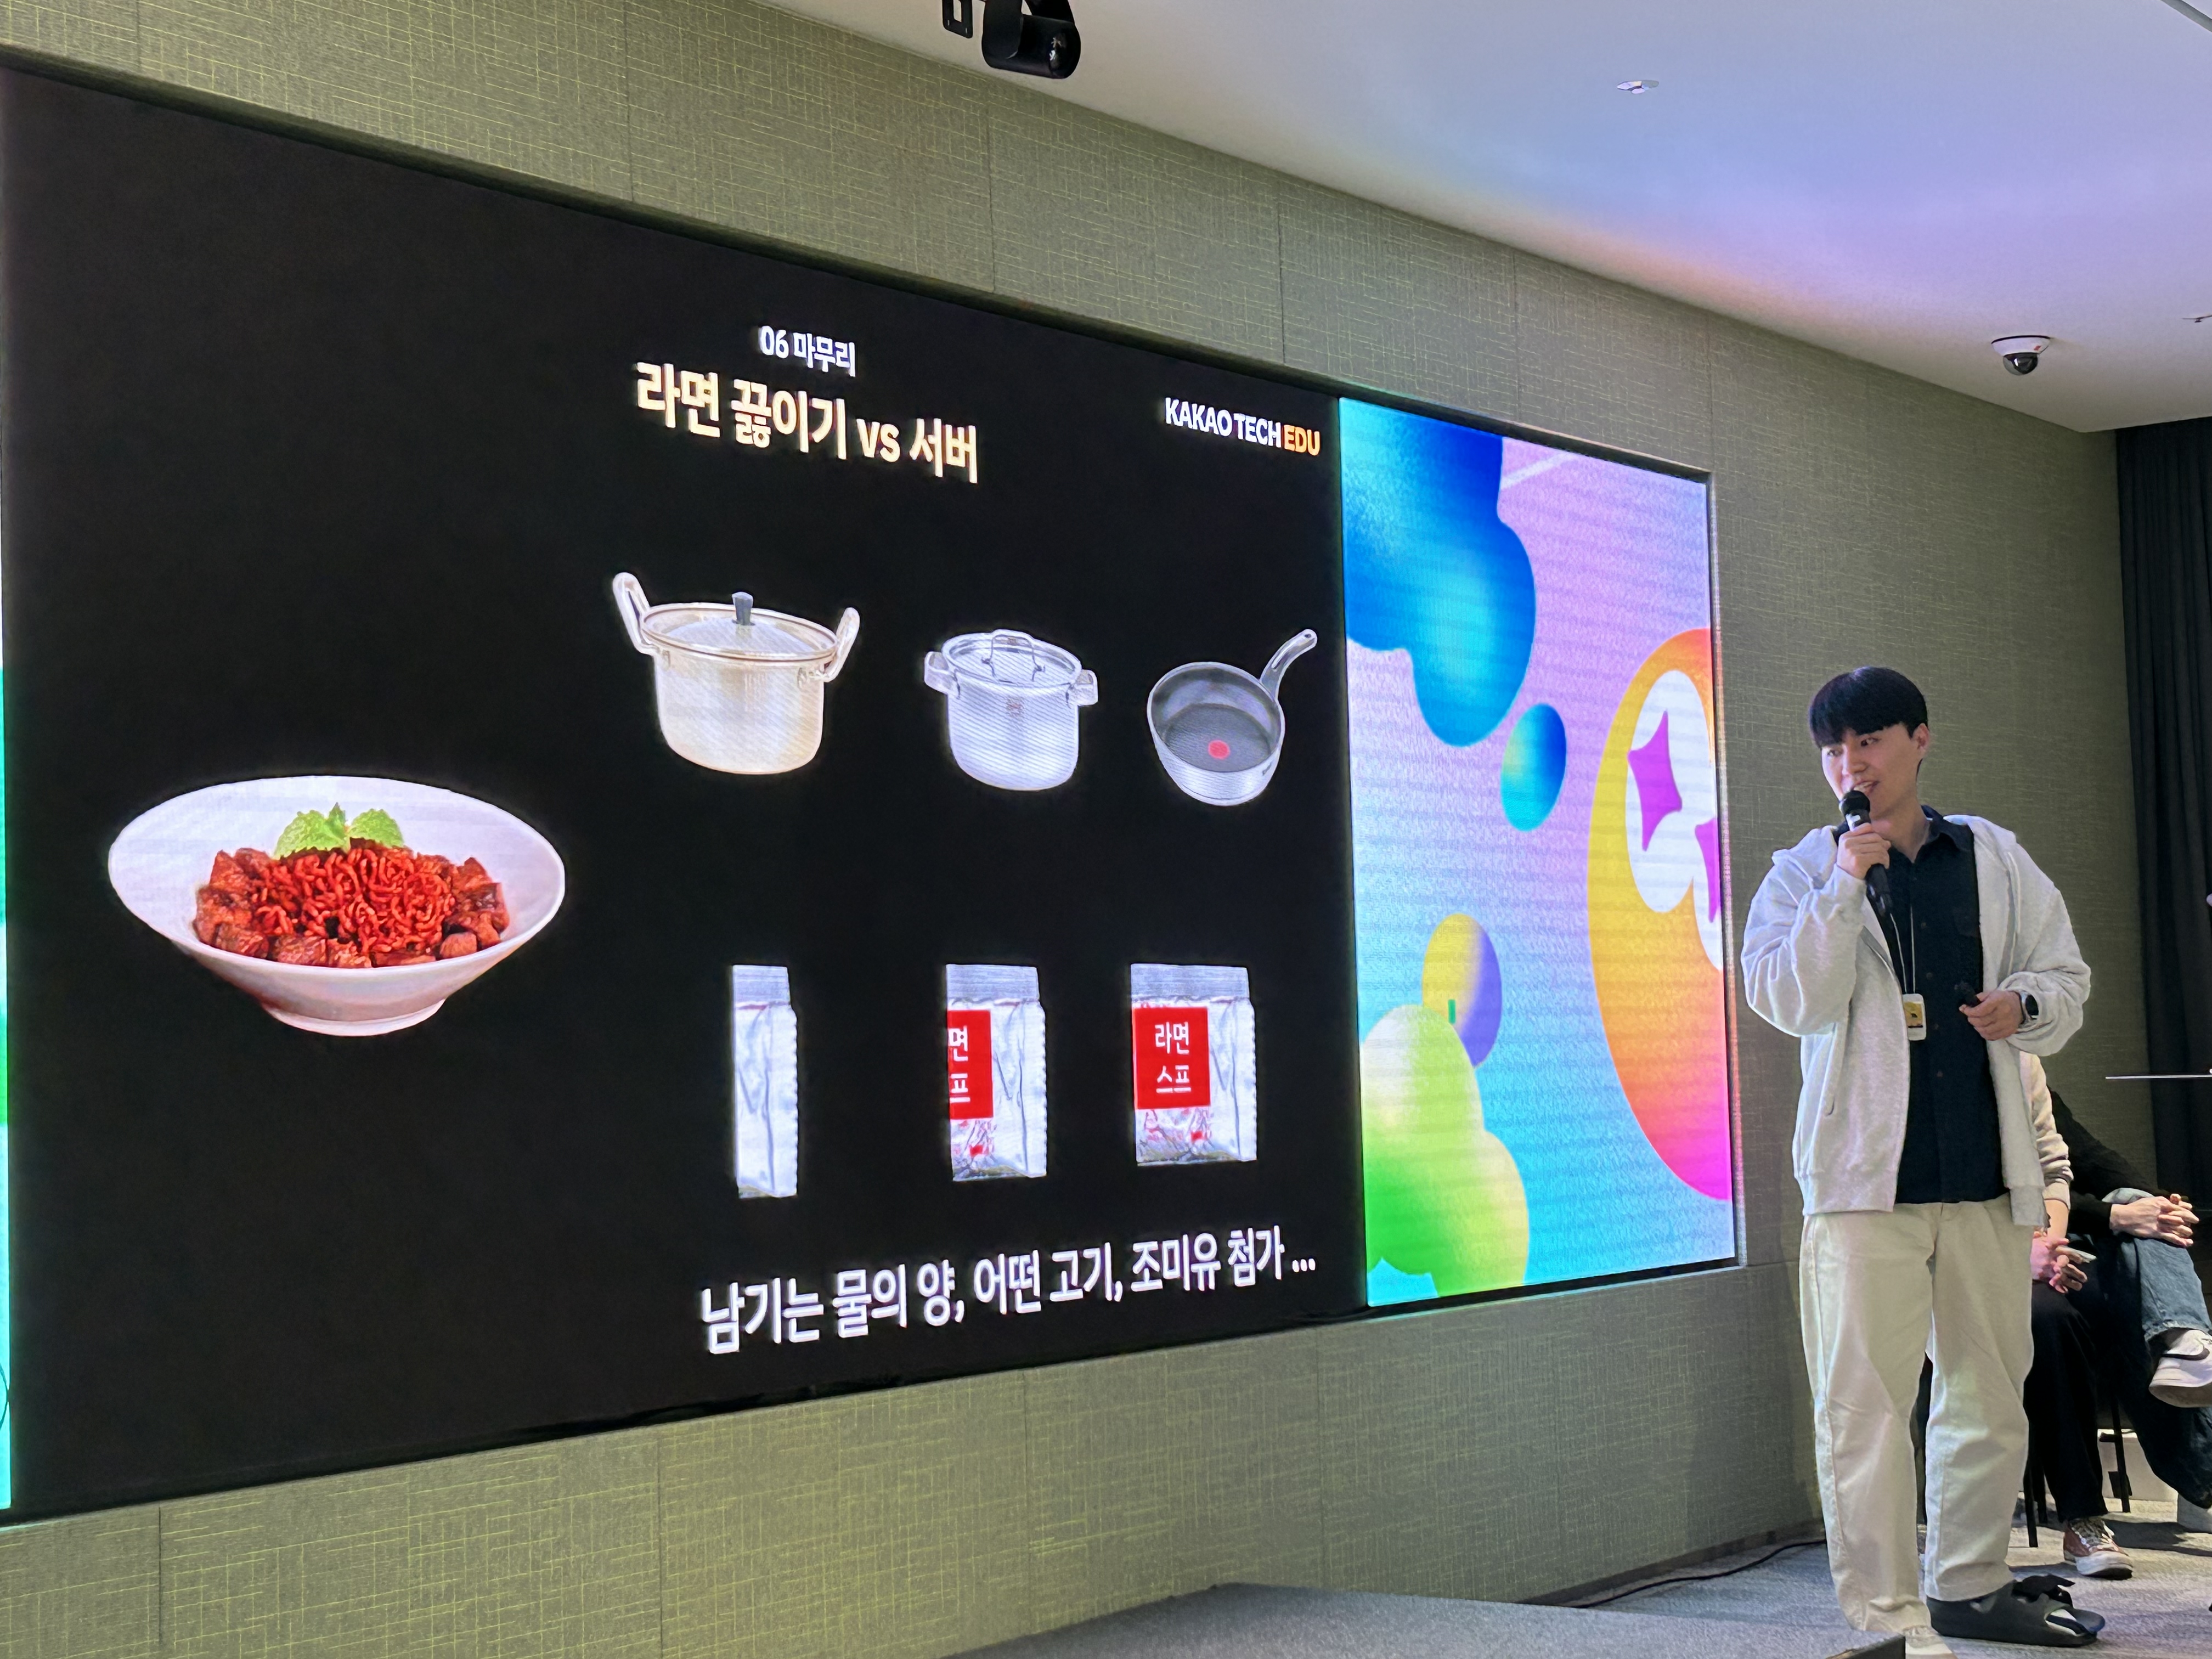
다소 도발적으로 들릴 수도 있는 문장이었지만, 그 말은 서버 개발이 쉽다는 뜻이 아니었습니다. 오히려 그 반대에 가까웠습니다.
이 문장이 전하고자 한 의미는
“제대로 이해하고 접근하면 방향이 보인다”
또는 조금 더 담백하게 정리하면, “막연함은 충분히 걷어낼 수 있다” 는 이야기였습니다.
왜 이 말이 유독 와닿았는지,
그리고 온보딩 과정 속에서 어떤 경험을 통해 그 막연함이 구체로 바뀌었는지,
이제 하나씩 풀어보려 합니다.
0️⃣ 서버 온보딩, 무엇을 하는 과정일까?
온보딩에서 가장 많이 들었던 질문은 이것이었습니다.
“왜 이렇게 설계했나요?”
정답을 알려주는 대신, 질문으로 시작하는 수업이었습니다.
2026 카카오 서버 온보딩은 총 3단계로 구성되어 있습니다.
-
TDD & OOP 기반 구현
-
레거시 코드 인수 테스트 작성
-
레거시 코드 리팩터링
즉, 기능을 구현하고 → 기존 코드를 보호하고 → 구조를 개선하는 흐름입니다.
이 구성만 보면 단순한 실습형 프로그램처럼 느껴질 수도 있습니다.
하지만 이 온보딩의 본질은 달랐습니다.
이 과정은 ‘무엇을’보다, ‘어떻게’ 를 더 고민하는 시간이었습니다.
다시 말해, ‘카카오스럽게 개발하는 법’ 을 배우는 시간에 가까웠습니다.
원래는 서버 직군만 참여하던 프로그램이었지만, 탄탄한 커리큘럼 덕분에 이번에는 FE, Android, iOS 직군까지 함께하게 되었습니다. 기술 스택은 달라도, 좋은 엔지니어링의 기준은 같기 때문입니다.
교육의 목표 또한 명확했습니다.
-
유지보수 가능한 구조를 설계하는 힘
-
레거시를 분석하고, 테스트 기반으로 안전하게 개선하는 역량
-
협업과 AI 활용까지 포함한 책임 있는 개발 태도
특히 마지막 항목은 인상 깊었습니다.
우리는 단순히 AI를 ‘사용’하는 법이 아니라, 어떻게 활용할 것인지까지 함께 고민했습니다.
🤖 AI 활용 전략
이번 온보딩에서 저희가 세운 AI 활용 전략은 세 가지였습니다.
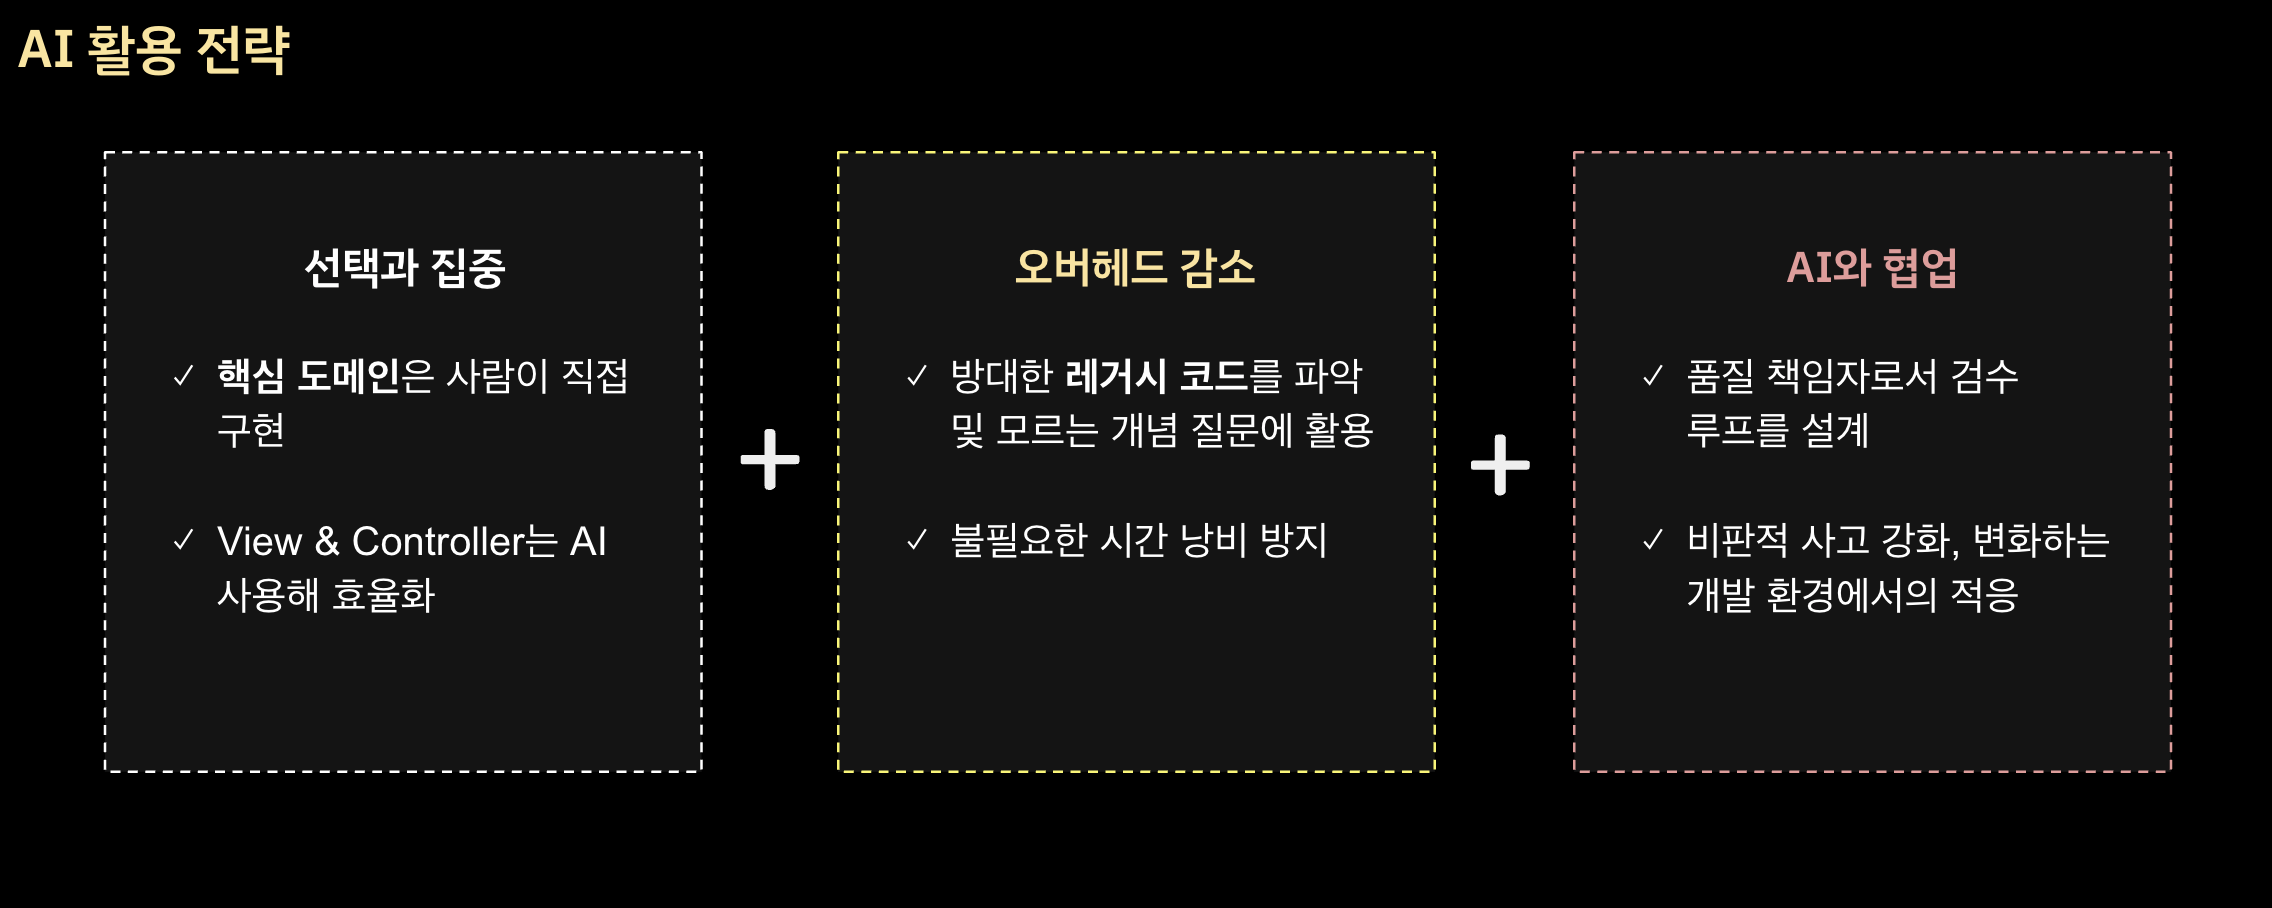
결국 이 온보딩은 단순히 코드를 작성하는 법을 배우는 시간이 아니라
지속 가능한 엔지니어링이 무엇인지 고민하고, 그 기준을 스스로 세워보는 시간이었습니다.
1️⃣ 서버 개발, 정말 라면 끓이기보다 쉬울까?
처음 서버 개발을 시작했을 때의 막연함은 아직도 생생합니다.
트래픽, 동시성, 확장성, DB 설계…
단어만 들어도 벽처럼 느껴졌습니다.
‘실무는 또 얼마나 다를까?’ 하는 걱정도 자연스럽게 따라왔습니다.
그 간극을 좁히기 위해 시작된 것이 바로 이번 온보딩이었습니다.
하지만 온보딩은 정답을 알려주지 않았습니다.
대신 끊임없이 질문을 던졌습니다.
-
왜 이렇게 설계했나요?
-
이 책임은 정말 이 객체가 가져야 하나요?
-
이 테스트는 무엇을 보호하고 있나요?
기능 구현보다 더 중요했던 것은,
스스로 설명할 수 있는 설계였습니다.
PR 리뷰에서는 단순한 코드 피드백을 넘어 사고의 흐름을 점검했습니다.
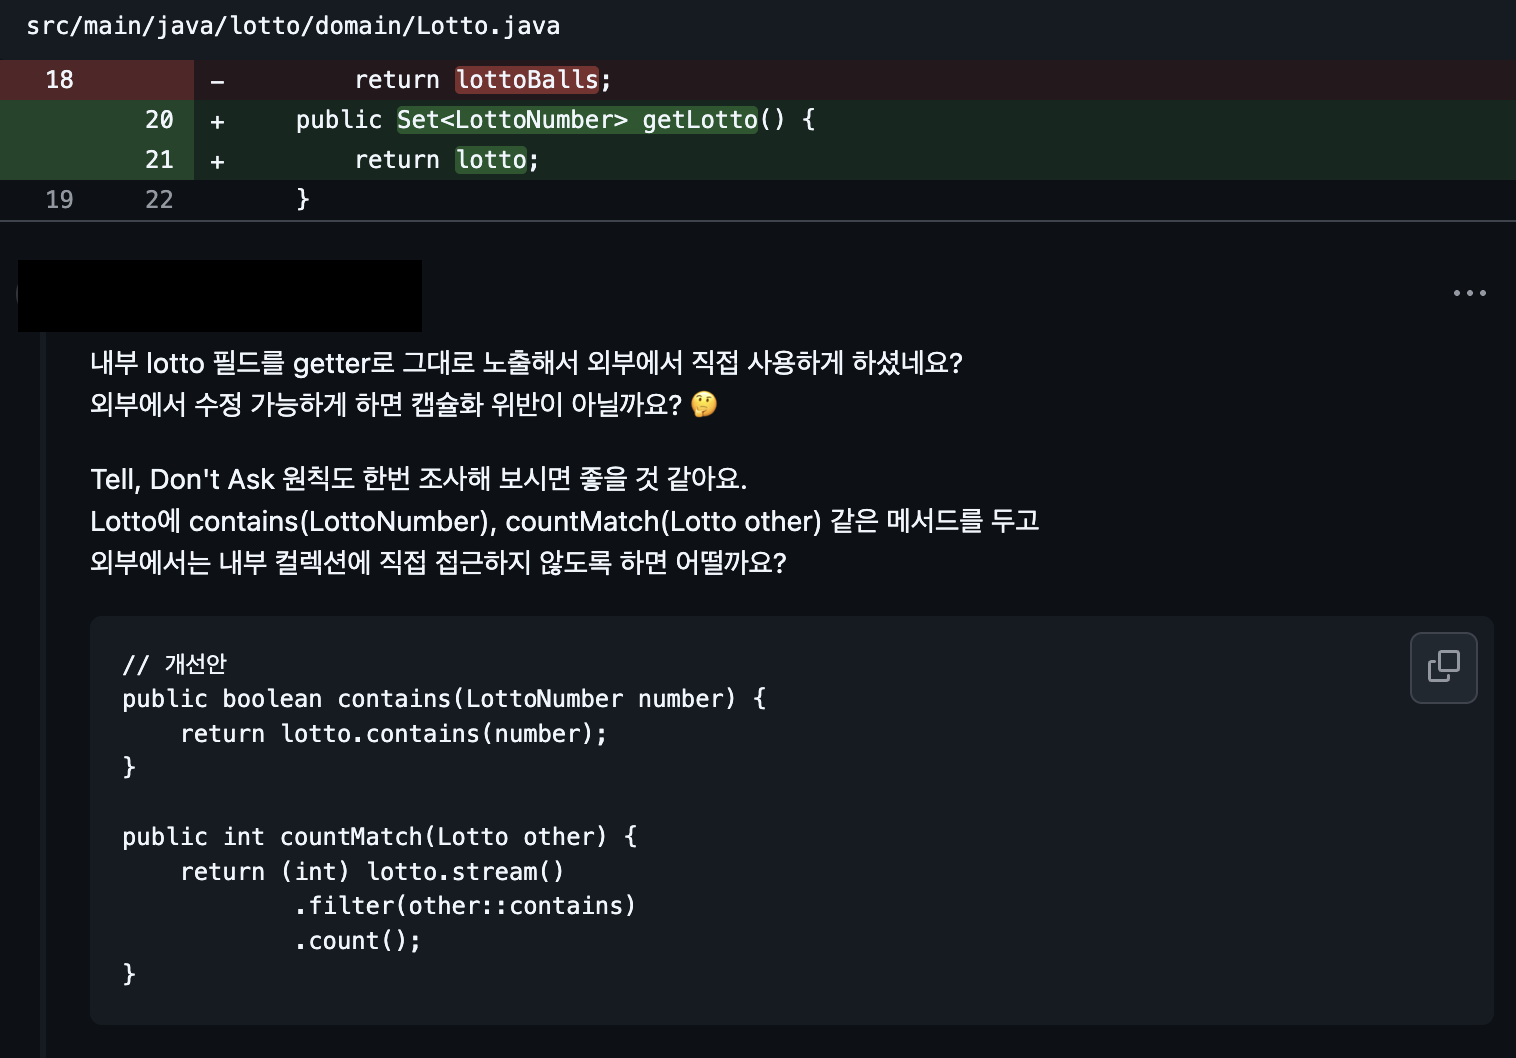
이 과정에서 분명해진 사실이 하나 있습니다.
“개발은 혼자 잘한다고 완성되는 일이 아니다” 는 점입니다.
저희의 하루는 늘 비슷한 리듬으로 흘러갔습니다.
매일 아침 데일리 미팅에서 각자의 트러블슈팅을 공유 하고,
페어 프로그래밍으로 설계를 토론 하며,
PR 리뷰에서 끝없이 “왜?” 를 묻고 또 답했습니다.
그 질문들이 쌓이면서 조금씩 변화가 생겼습니다.
어느 순간, 우리는 단순히 서버를 구현하는 사람이 아니라,
‘카카오 서버 크루’로서 사고하는 방법을 배우고 있었습니다.
이제 그 변화의 과정,
그리고 우리가 수행했던 미션들에 대해 하나씩 소개해보겠습니다.
2️⃣ 미션 1 – 로또 게임 구현 (TDD & OOP)
첫 번째 미션은 로또 게임 구현이었습니다.
step 1 - 자동 구매
구입금액을 입력해 주세요.
6000

6개를 구매했습니다.
[8, 21, 23, 41, 42, 43]
[3, 5, 11, 16, 32, 38]
[7, 11, 16, 35, 36, 44]
[1, 3, 5, 14, 22, 45]
[5, 9, 38, 41, 43, 44]
[2, 8, 9, 18, 19, 21]

지난 주 당첨 번호를 입력해 주세요.
1, 2, 3, 4, 5, 6
보너스 볼을 입력해 주세요.
7

당첨 통계
---------
3개 일치 (5000원) - 1개
4개 일치 (50000원) - 0개
5개 일치 (1500000원) - 0개
5개 일치, 보너스 볼 일치 (30000000원) - 0개
6개 일치 (2000000000원) - 0개
총 수익률은 0.83입니다.
step 2 - 수동 + 자동 구매
구입금액을 입력해 주세요.
6000

수동으로 구매할 로또 수를 입력해 주세요.
3

수동으로 구매할 번호를 입력해 주세요.
8, 21, 23, 41, 42, 43
3, 5, 11, 16, 32, 38
7, 11, 16, 35, 36, 44

수동으로 3장, 자동으로 3개를 구매했습니다.
[1, 3, 5, 14, 22, 45]
[5, 9, 38, 41, 43, 44]
[2, 8, 9, 18, 19, 21]

...
요구사항은 비교적 단순했습니다.
-
로또 1장의 가격은 1000원
-
자동 발급 기능 (Step-1) / 수동 발급 기능 (Step-2)
-
당첨 통계 계산
겉으로 보면 평범한 구현 과제처럼 보입니다.
하지만 진짜 난이도는 요구사항이 아니라 ‘제약 조건’에 있었습니다.
-
들여쓰기 depth 1단계 유지
-
메서드 10라인 이하
-
원시값 포장과 일급 컬렉션 사용
-
else 사용 지양 (Early Return 권장)
이 규칙들은 저희를 불편하게 만들었고, 그 불편함이 좋은 설계로 바꾸었습니다.
게다가 모든 구현은 TDD로 진행해야 했기 때문에, 코드보다 테스트가 먼저였습니다.
💡 랜덤 로직은 어떻게 테스트할 것인가?
로또 번호는 랜덤으로 생성됩니다. 하지만 테스트는 예측 가능해야 합니다.
미션 시작과 함께 저희가 마주친 문제는 아래와 같았습니다.
-
구현체에 직접 의존하고 있었고,
-
실행할 때마다 결과가 달라졌으며,
-
테스트 코드에서 값을 통제할 수 없었습니다.
해결 방법은 생성 전략을 추상화하는 것이었습니다.
-
번호 생성 인터페이스를 도입하고,
-
외부에서 전략을 주입받도록 구조를 변경하고,
-
테스트용 Generator를 따로 구현했습니다.
문제 코드
public class LottoNumberGenerator {

    public List generate() {
        List numbers = IntStream.rangeClosed(1, 45)
                .mapToObj(LottoNumber::new)
                .collect(Collectors.toList());

        Collections.shuffle(numbers);

        return numbers.stream()
                .limit(6)
                .sorted()
                .toList();
    }
}

public class LottoMachine {

    public List issueLottos(int count) {
        LottoNumberGenerator generator = new LottoNumberGenerator();

        return Stream.generate(() -> new Lotto(generator.generate()))
                .limit(count)
                .toList();
    }
}
개선 코드
public interface LottoNumberGenerator {
    List generate();
}

public class RandomLottoNumberGenerator implements LottoNumberGenerator {

    @Override
    public List generate() {
        // 내부 구현
    }
}

public class LottoMachine {

    public List issueLottos(int count, LottoNumberGenerator generator) {

        return Stream.generate(() -> new Lotto(generator.generate()))
                .limit(count)
                .toList();
    }
}
그제야 테스트는 통제 가능해졌고, 설계는 더 단단해졌습니다.
만약 TDD 없이 바로 구현부터 시작했다면,
코드는 동작했을지 몰라도 구조는 쉽게 무너졌을 겁니다.
💡 값 객체는 매번 새로 생성해야 할까?
1부터 45까지의 숫자를 매번 새 객체로 만들어야 할까요?
값이 같다면, 같은 객체를 재사용할 수는 없을까요?
이 고민은 자연스럽게 캐싱 전략으로 이어졌고,
우리는 ‘객체의 정체성’ 과 ‘값의 동일성’ 의 차이를 깊이 고민하게 되었습니다.
문제
public class LottoNumber {
    private final int number;

    public LottoNumber(int number) {
        validate(number);
        this.number = number;
    }

    private void validate(int number) {
        // 유효성 검사
    }
}

public class RandomLottoNumberGenerator implements LottoNumberGenerator {

    @Override
    public List generate() {
        List numbers = IntStream.rangeClosed(1, 45)
                .mapToObj(LottoNumber::new)
                .collect(Collectors.toList());

        Collections.shuffle(numbers);

        return numbers.stream()
                .limit(6)
                .sorted()
                .toList();
    }
}
개선 코드
public class RandomLottoNumberGenerator implements LottoNumberGenerator {
    private final List cachedLottoNumbers =
        IntStream.rangeClosed(1, 45)
                .mapToObj(LottoNumber::new)
                .toList();

    @Override
    public List generate() {
        List numbers = new ArrayList<>(cachedLottoNumbers);
        Collections.shuffle(numbers);

        return numbers.stream()
                .limit(6)
                .sorted()
                .toList();
    }
}
이 미션에서 배운 것은 기능 구현이 아니라 “설계의 기준” 이었습니다.
단순히 문제를 해결하는 개발자에서,
구조를 고민하는 개발자로 한 단계 성장한 순간이었습니다.
3️⃣ 미션 2 – 레거시 코드 인수 테스트
두 번째 미션은 실제 서비스 수준의 레거시 프로젝트를 다루는 것이었습니다.
처음 코드를 열었을 때의 감정은 솔직히 ‘두려움’이었습니다.
-
“이걸 내가 이해할 수 있을까?”
-
“잘못 건드리면 서비스가 망가지는 건 아닐까?”
그래서 저희는 바로 코드를 수정하기보단, 인수 테스트 작성을 차근차근 진행했습니다.
🎯 무엇을 보호해야 하는가?
보호해야 할 대상은 명확했습니다.
-
사용자의 행동(Action)
-
시스템의 반환 결과(Response)
-
외부에서 관찰 가능한 상태 변화(State)
저희는 여기에 Strong Assertion 전략을 적용했습니다.
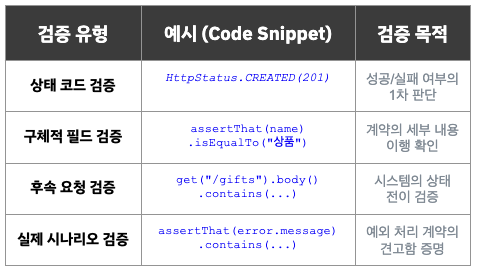
단순히 “성공했다”는 결과를 확인하는 것이 아니라,
“올바르게 성공했다”는 사실을 증명하는 테스트를 작성했습니다.
또한 Cucumber 기반 BDD를 도입해,
비개발자도 이해할 수 있는 시나리오 형태로 테스트를 구성했습니다.
테스트 는 개발자만을 위한 코드가 아니라,
모두가 공유할 수 있는 명세가 되어야 한다고 생각했기 때문입니다.
🎯 운영 환경과 동일하게 – Production Parity
“제 컴퓨터에서는 잘 되는데요.”
개발을 하다 보면 한 번쯤 하게 되는 말입니다.
하지만 이런 상황은 결국 환경 차이에서 비롯됩니다.
우리는 이 문제를 구조적으로 해결하기 위해,
운영과 동일한 환경에서 테스트가 실행되도록 만들었습니다.
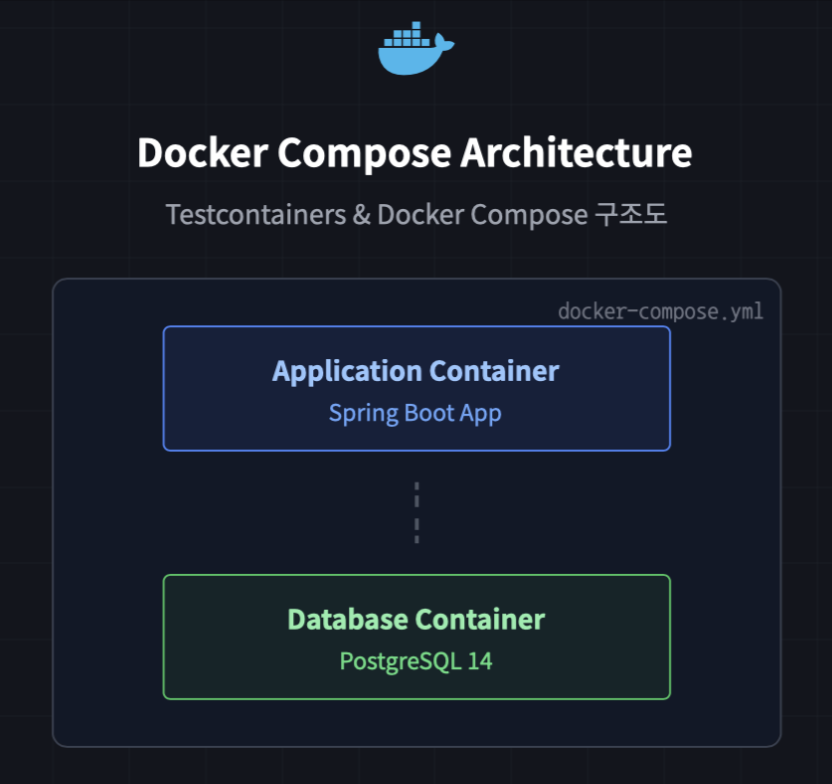
- 운영 환경과 동일한 DB 사용 (H2 데이터베이스 → PostgreSQL)
- 실행 환경 통일 및 컨테이너화 (Docker 기반)
- 테스트 자동화 구축 (Gradle Task 기반)
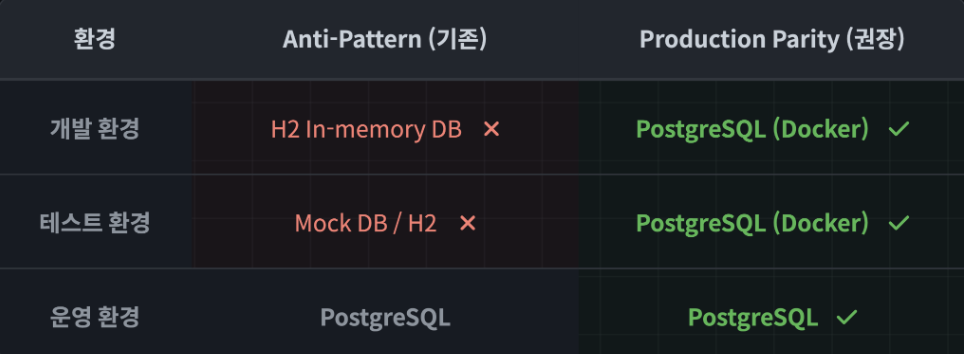
환경을 맞추자, 테스트는 더 이상 개인의 환경에 의존하지 않았습니다.
🎯 테스트 데이터 격리 문제 해결
안정적인 테스트를 위해 데이터 격리 전략도 직접 설계했습니다.
-
FK 역순 삭제 전략 적용
-
TRUNCATE … CASCADE 활용
-
공통 Cleanup 유틸리티 작성
이를 통해 테스트 간의 의존성을 제거했고,
항상 동일한 상태에서 테스트가 시작되도록 보장할 수 있었습니다.
이 미션에서 배운 것은 단순한 테스트 기술이 아니었습니다.
결국 중요한 것은 도구 사용법 자체가 아니라,
상황에 맞는 최선의 선택을 내리는 ‘판단 기준’ 임을 느끼게 되었습니다.
4️⃣ 미션 3 – 레거시 코드 리팩터링
마지막 미션은 레거시 코드 리팩터링이었습니다.
개발자에게 가장 중요한 역량 중 하나가 무엇이냐고 묻는다면,
저는 주저 없이 ‘리팩터링’이라고 말하고 싶습니다.
처음에는 클린 코드를 만들고, 더 좋은 코드를 구별하는 방법을 배우는 과정이라고 생각했습니다.
하지만 이 미션의 핵심은 단순한 코드 수정이 아니었습니다.
이 과정은 기준을 세우는 훈련이었습니다.
🔹 리팩터링의 핵심 원칙
저희가 가장 중요하게 지킨 기준은 하나였습니다.
구조 변경과 동작 변경을 명확히 분리하는 것.
구조를 정리할 때 는 동작을 바꾸지 않았고,
동작을 수정할 때는 구조를 건드리지 않았습니다.
이 원칙은 단순한 규칙이 아니라,
안전하게 코드를 개선하기 위한 행동 기준이었습니다.
PR 리뷰에서는 일반적인 코드 품질에 대한 피드백도 함께 이루어졌습니다.
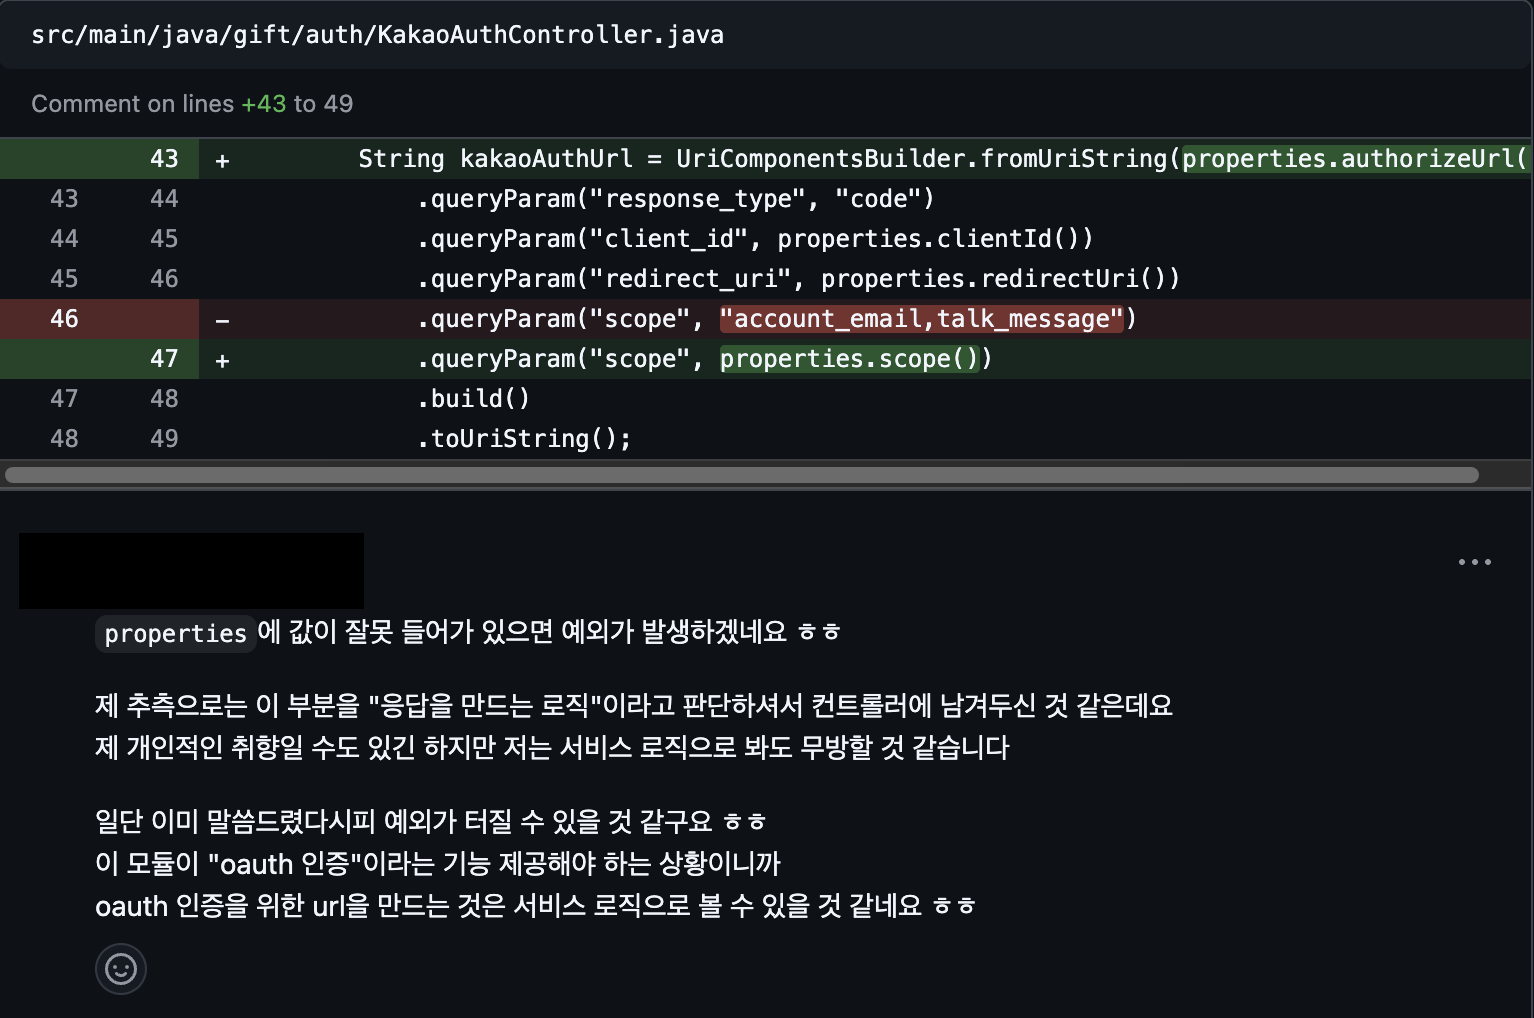
또한, 구조 개선이 목적이었지만 의도치 않게 동작이 바뀌는 경우,
리뷰어는 그 지점도 정확히 짚어주셨습니다.
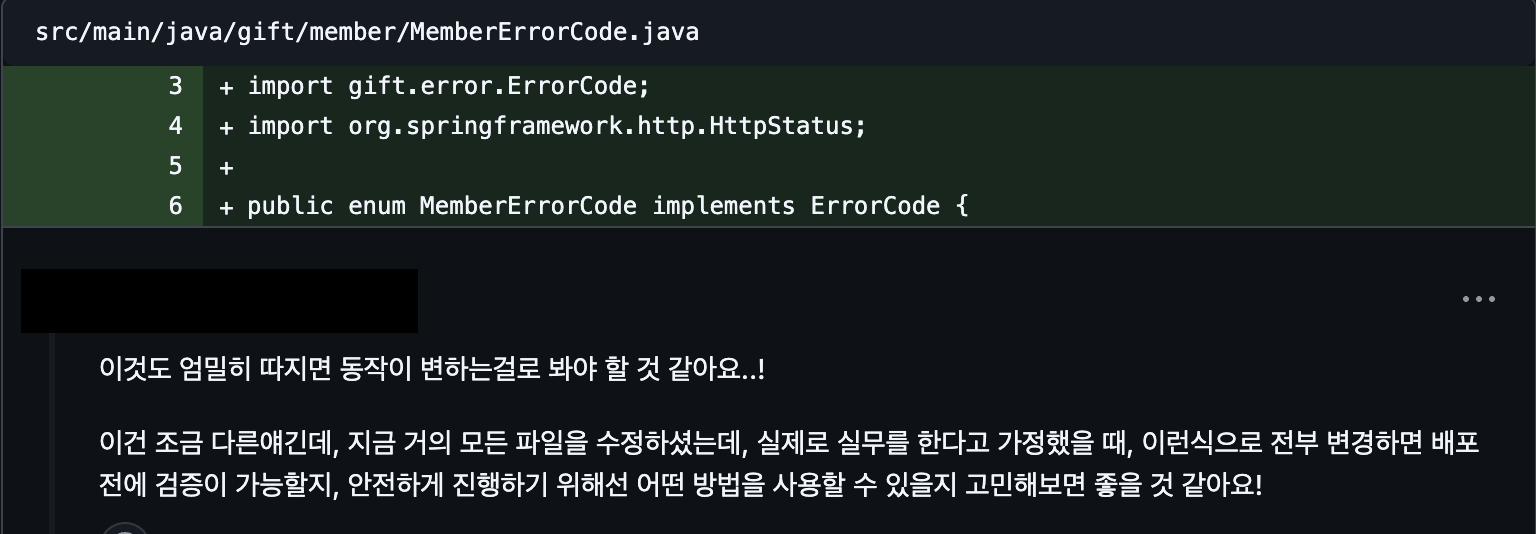
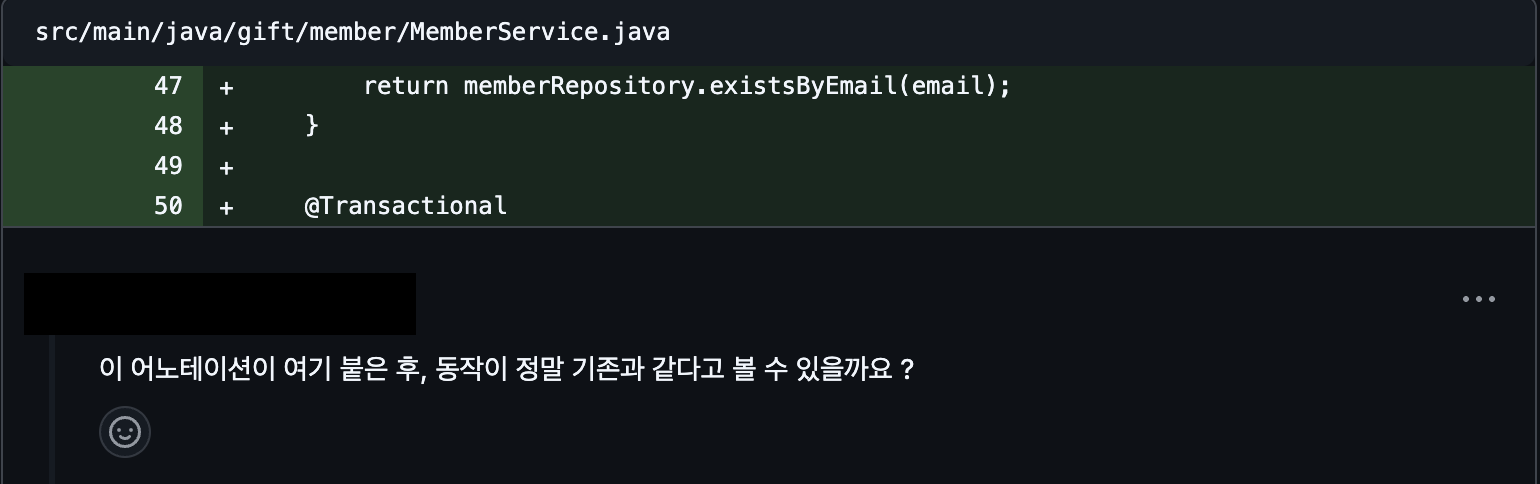
그 과정은 단순한 코드 리뷰가 아니라, 변경을 예측하고 통제할 수 있는 역량을 길러주었습니다.
🤖 AI와의 협업
이번 리팩터링 과정에서는 AI와도 적극적으로 협업했습니다.
처음에는 넓은 범위의 리팩터링을 한 번에 요청했습니다.
AI는 많은 부분을 빠르게 정리해 주었고, 분명 도움이 되었습니다.
하지만 변경 범위가 지나치게 넓어지면서
검증이 어려워지는 문제를 경험했습니다.
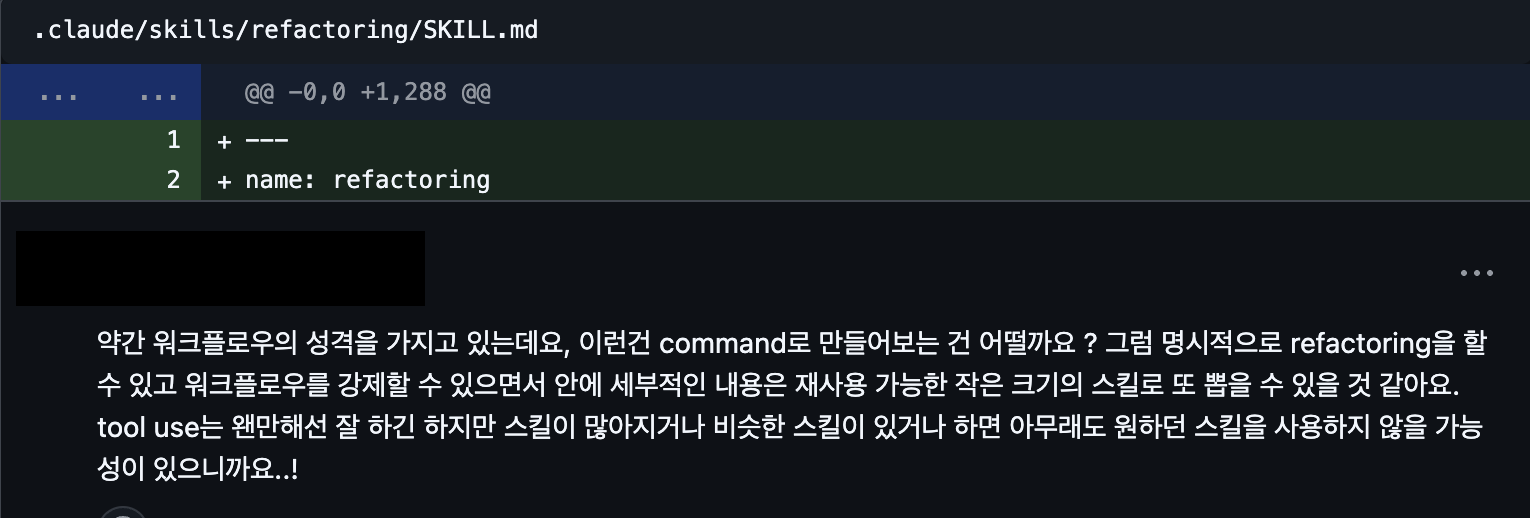
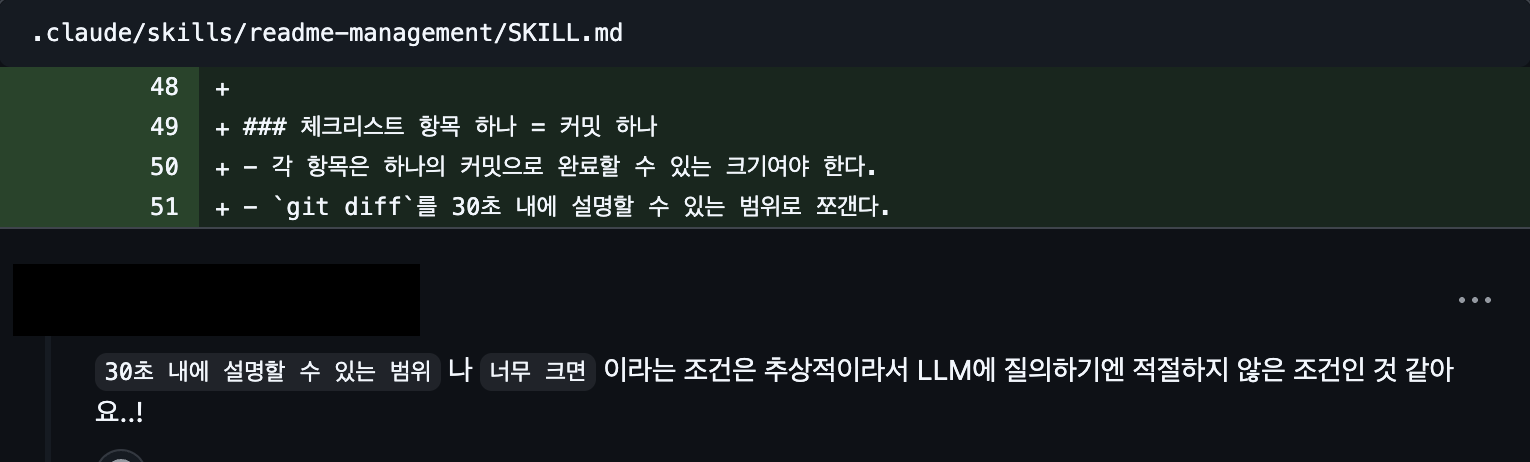
PR 리뷰에서도 같은 조언을 받았습니다.
“변경 범위를 더 쪼개자.”, “더 명확한 조건을 추가하자”
이후 저희는 AI에게도 작은 단위로 요청하기 시작했습니다.
통제 가능한 범위 안에서, 검증 가능한 변경만 허용하기로 했습니다.
그 경험을 통해 AI와 협업할 때의 기준도 명확해졌습니다.
-
반복적이고 기계적인 작업은 AI에게 맡긴다.
-
방향 설정과 최종 판단은 사람이 한다.
-
AI가 작성한 코드라도 테스트 없이 신뢰하지 않는다.
AI 시대의 개발자는 더이상 코드를 빠르게 작성하는 사람 만을 의미하지 않습니다.
기준을 세우고, 변경을 검증하며, 올바른 방향을 판단하는 사람이 되었습니다.
리팩터링 미션은 결국, 좋은 코드를 만드는 방법보다, 좋은 판단을 내리는 방법을 배우는 과정이었습니다.
5️⃣ 그래서, 서버 개발이 보이기 시작했다
서버 개발이 갑자기 쉬워진 건 아닙니다.
TDD도, 객체지향 설계도, 리팩터링도 여전히 어렵습니다.
하지만 예전처럼 막막하지는 않습니다.
레거시를 만나면 무작정 고치기보다는
먼저 이해하고,
테스트로 안전망을 만들고,
구조를 정리한 뒤 동작을 개선합니다.
그 순서를 익히고 난 뒤, 두려움이 훨씬 줄어들었습니다.
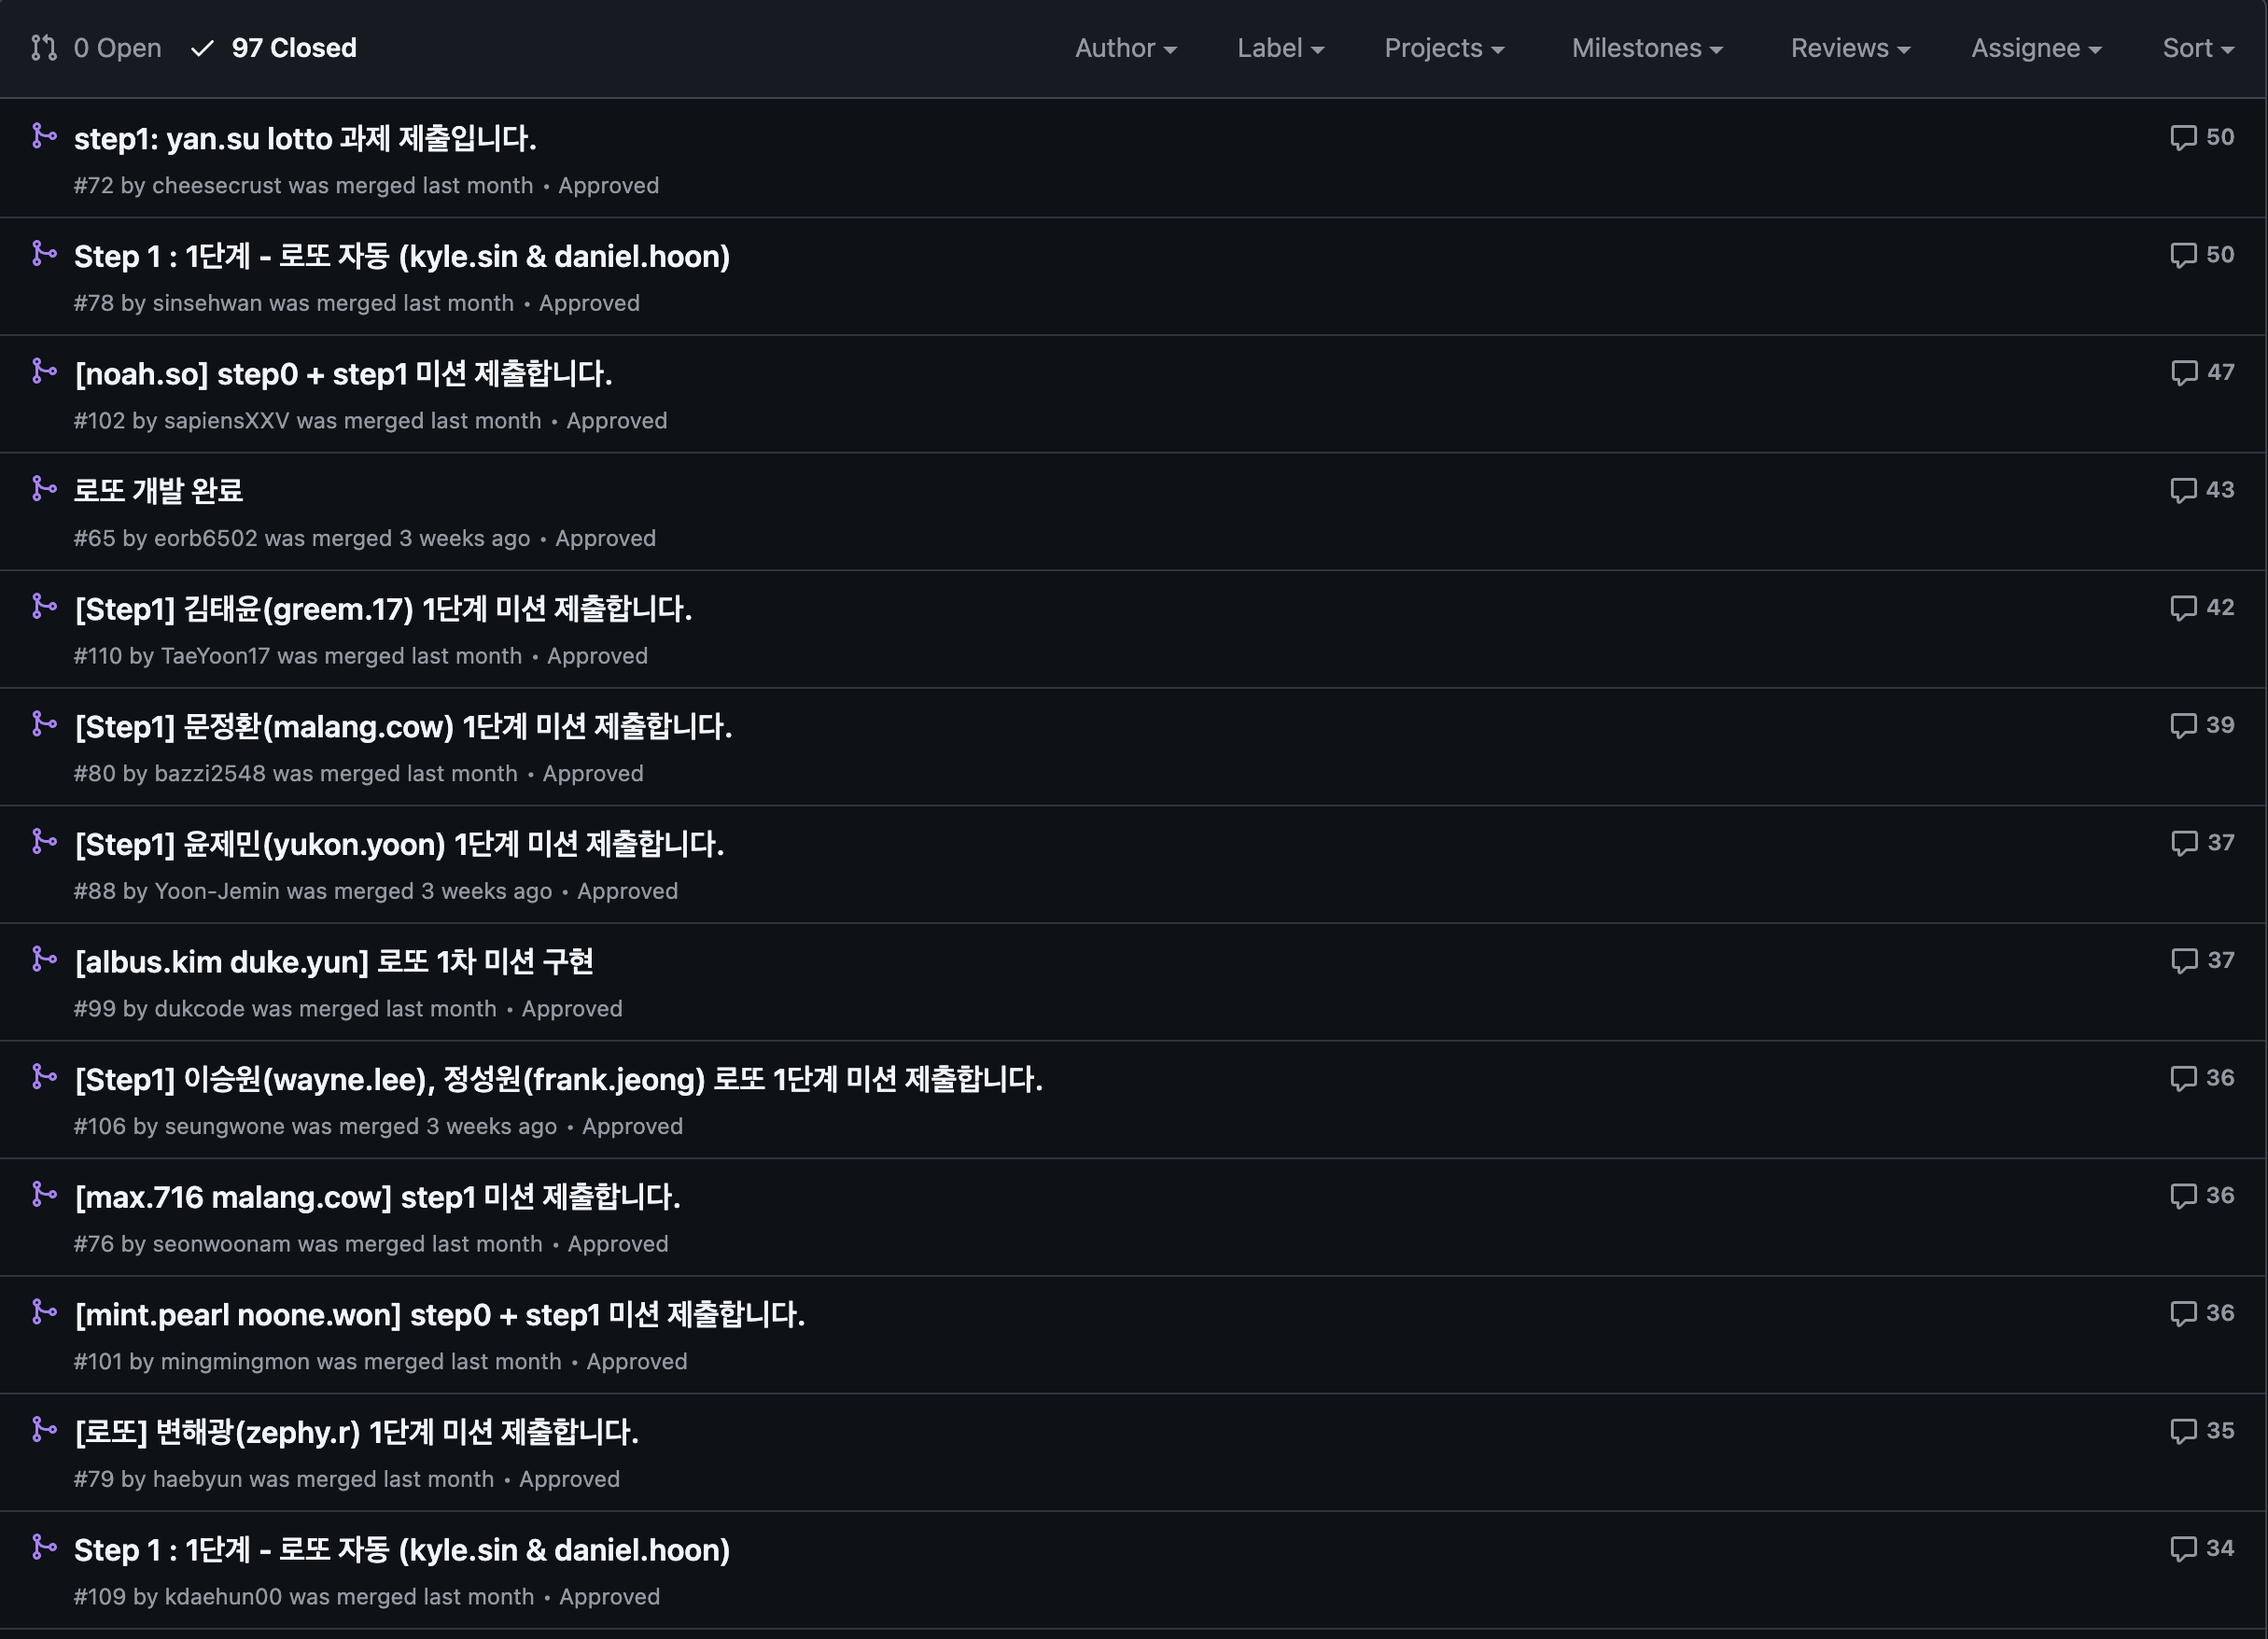
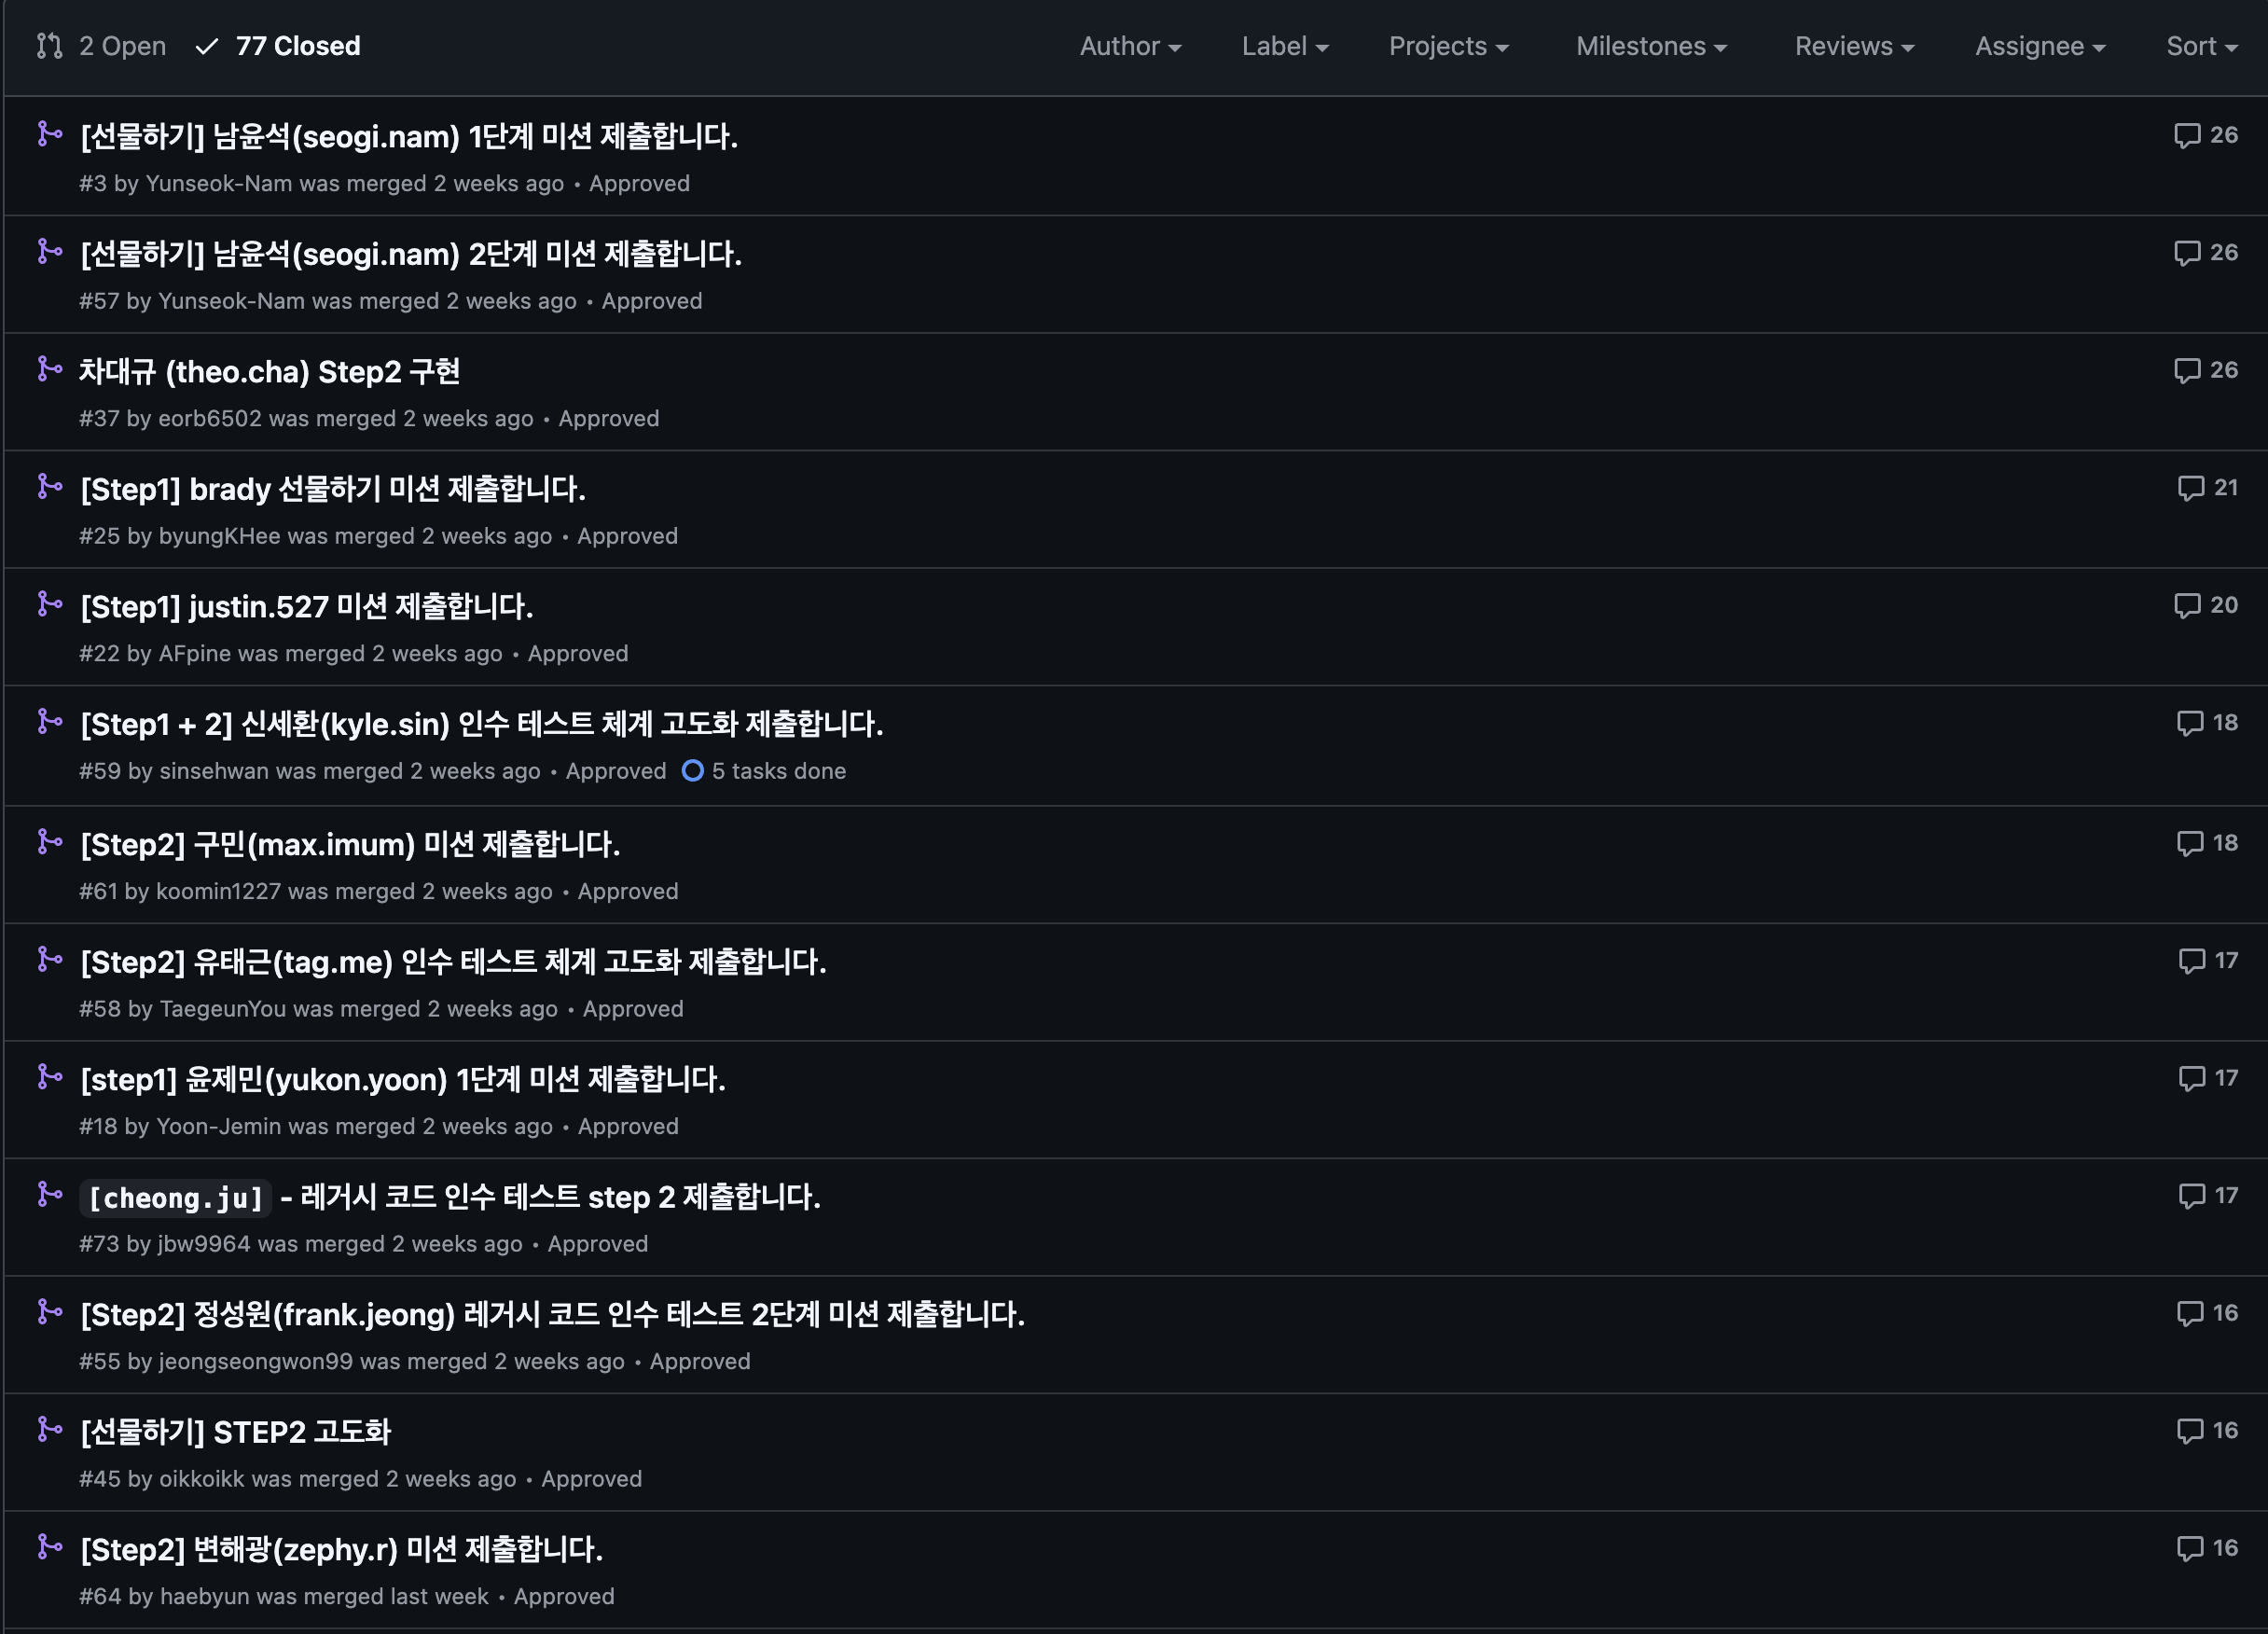
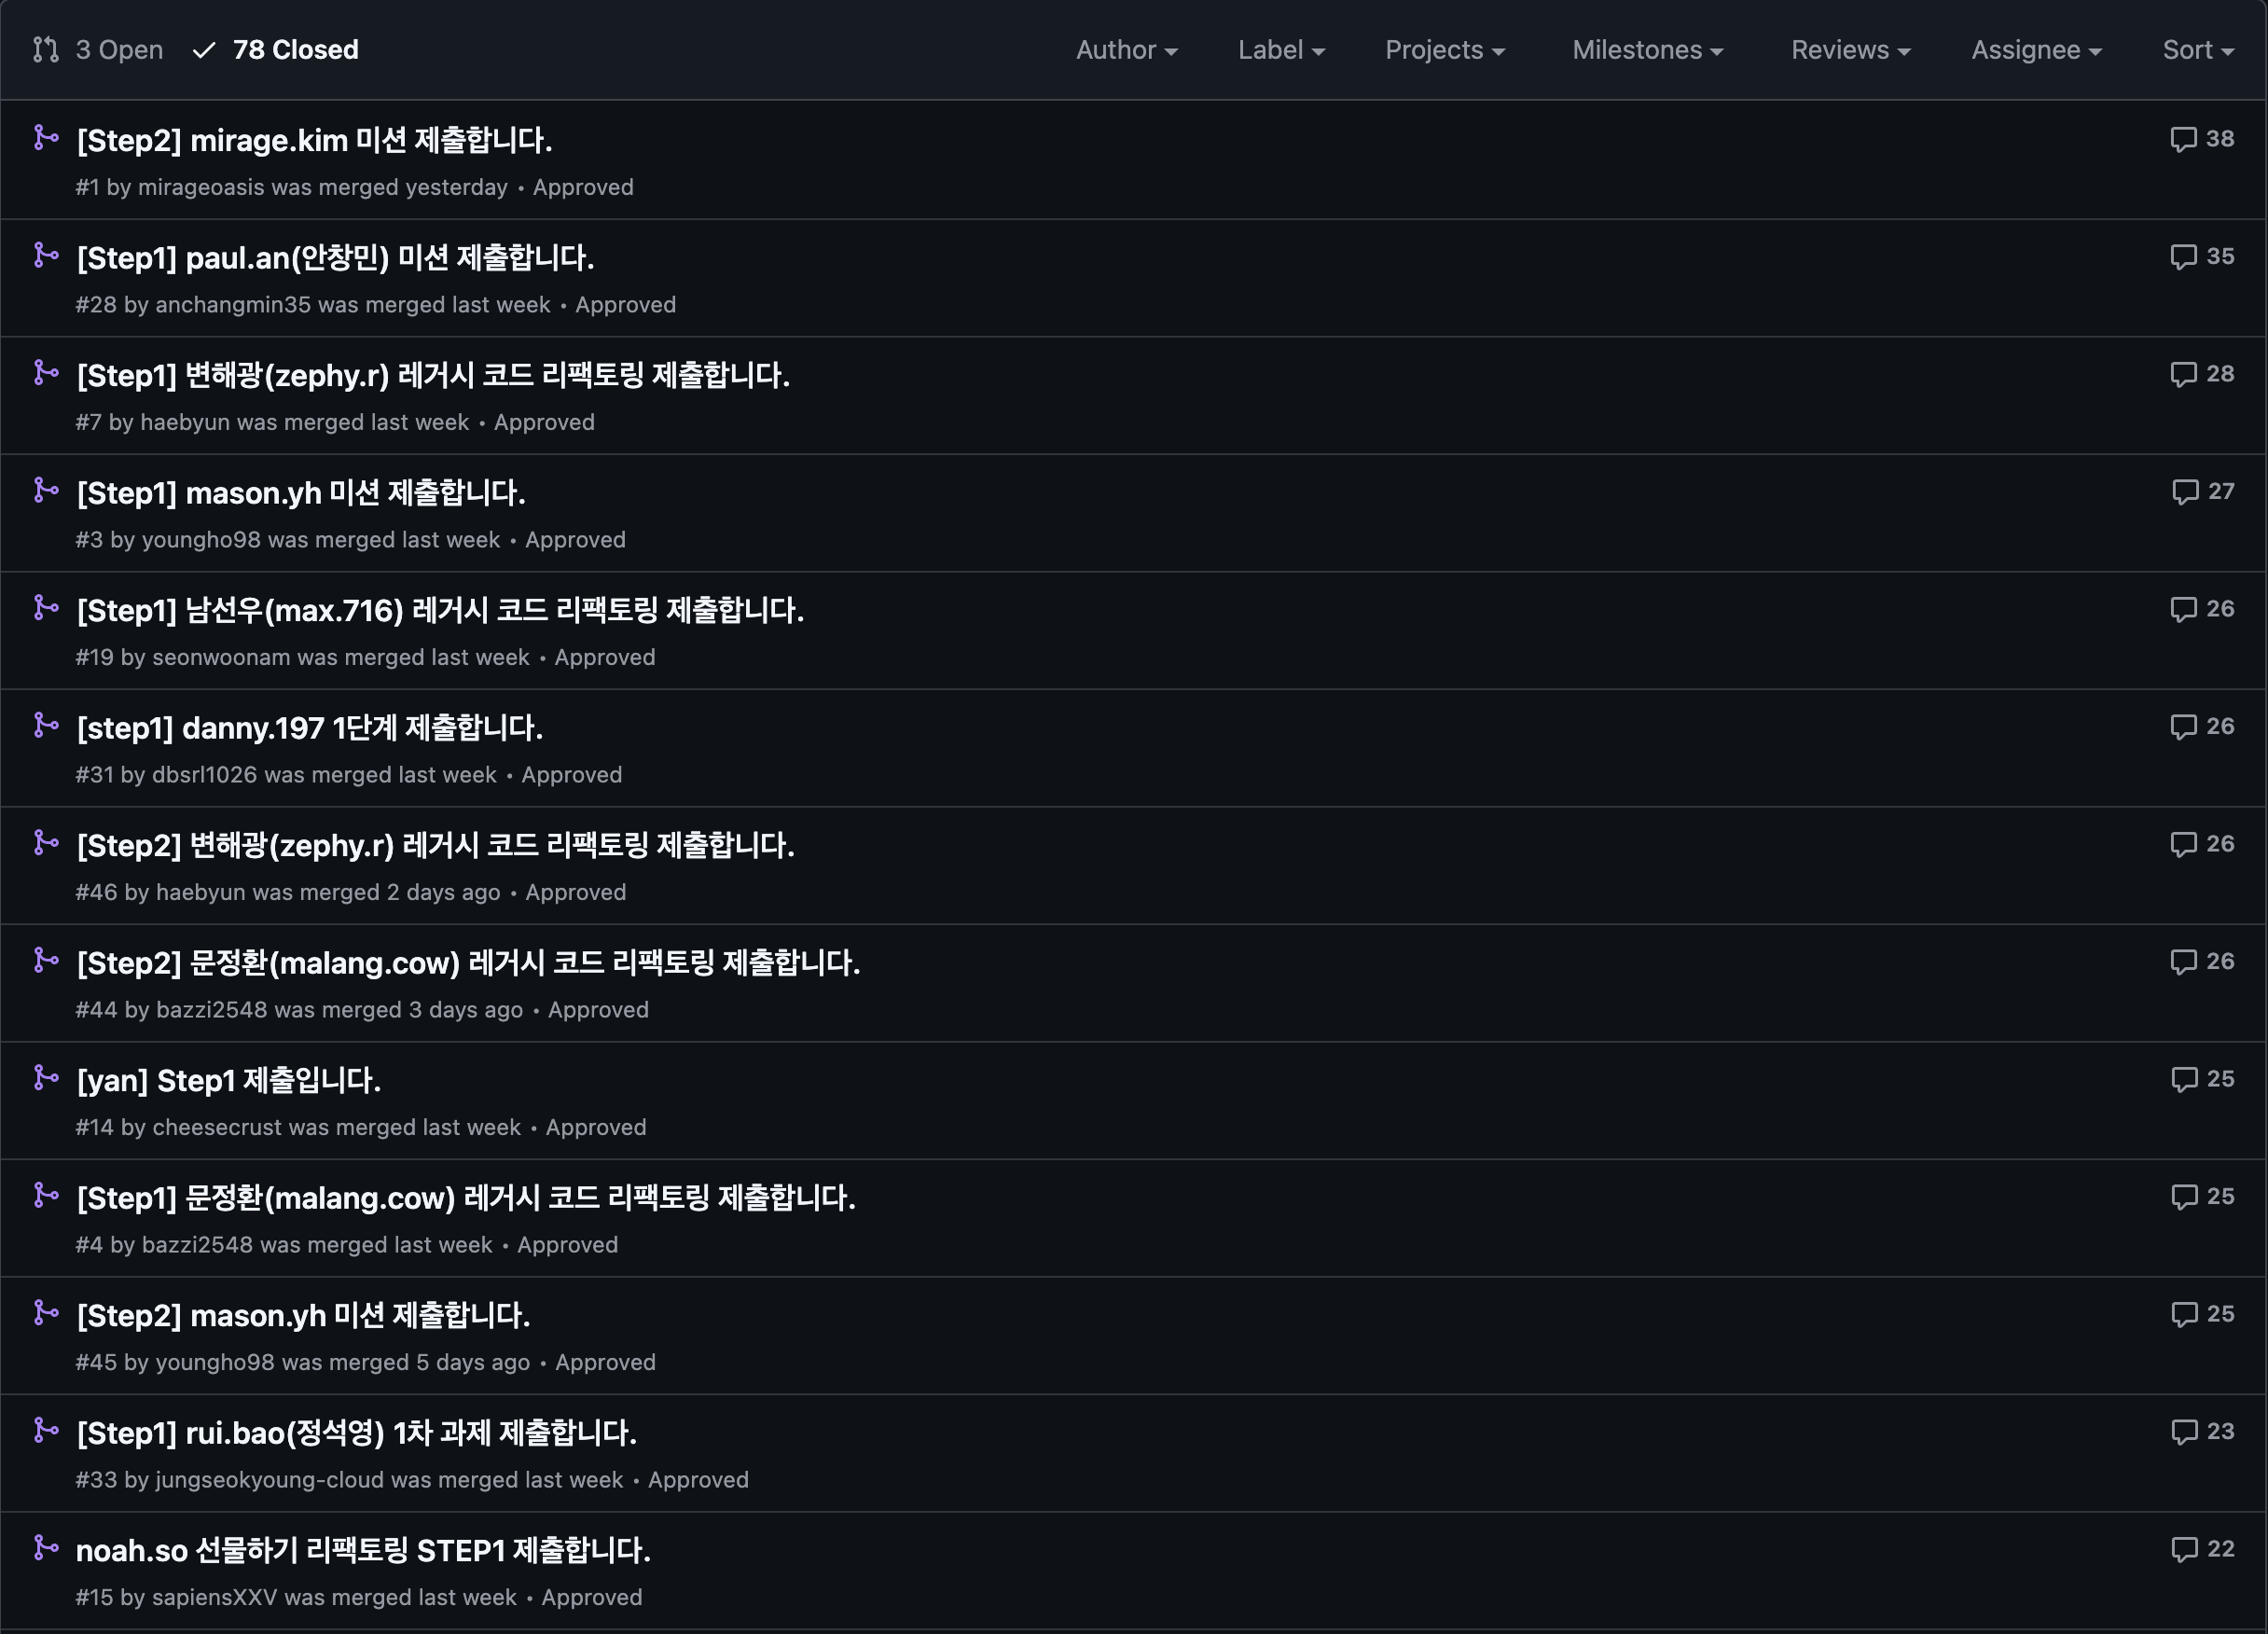
저희는 총 수백 개의 PR과 수백 건의 리뷰를 거치며 이 과정을 반복했습니다.
그래서 서버 개발은 더 이상 거대한 기술의 벽이 아니라,
문제를 구조적으로 풀어가는 과정처럼 느껴집니다.
라면을 끓이는 일과 비슷합니다.
정해진 순서를 알고 있다면, 결과는 크게 벗어나지 않습니다.
테스트, 설계, 리팩터링, 검증이라는 순서를 지키면 됩니다.
카카오에는 이 과정을 반복해볼 수 있는 환경이 이미 마련되어 있습니다.
질문이 오가는 문화 가 있고, 기준을 함께 고민해주는 동료들이 있습니다.
그 환경 속에서 기준을 세우고 고민해온 신입 크루들은,
이제 카카오스럽게 개발하는 개발자로 성장했습니다.