Engineering
Deview 2014 강연 정리: Clustered computing with CoreOS, fleet and etcd
2015년 11월 30일
원문에서 보기 ↗
안녕하세요! NHN엔터테인먼트 정성환입니다. 오랜만에 글로 인사드립니다. 이번 DEVIEW 2014의 주요 이슈를 정리하여 보았습니다.
0. 들어가기 전에
이번에 DEVIEW 2014에 참석하는 기회를 주셔서, 좋은 강연 잘 들었습니다. 올해도 개발자들이 힐링할 수 있는 (그리고 자신을 돌아볼 수 있는) 좋은 기회였던 것 같습니다. 들은 강연 내용 중 인상깊었던 내용을 나름으로 정리하여 공유하고자 합니다.
먼저 CoreOS라는 분산 환경 지향 OS에 대해서 이야기해 보겠습니다. 보다 설명이 필요한 부분(예컨데, 컨테이너, Paxos vs Raft)은 이해를 돕고자, 제가 알고 있는 선에서 최대한 덧 붙이고 가다듬었습니다.
1. 개요
먼저 아래는 이번 Deview 2014 행사 중 발표자료입니다. http://www.slideshare.net/deview/2c4clustered-computing-with-coreos-fleet-and-etcd
CoreOS는 2013년 10월에 첫 버전을 릴리스한 신생 리눅스 배포판입니다. 이번 Deview 2014 발표에서는, 이 프로젝트의 미션을 ‘인터넷을 안전하게 지키기(secure the internet)’라고 소개했습니다. CoreOS의 개발자들은 이 미션을 위한 첫걸음은 자동 OS 업데이트라고 생각했습니다.
1.1 자동 OS 업데이트
OS를 업데이트 한다는 것은 내부 시스템의 근간인 커널과 디바이스 드라이브를 업데이트 한다는 것입니다. CoreOS는 이를 위해 OS 이미지를 중앙 저장소에 가지고 있습니다. 그리고 주기적으로 버전을 polling하여 확인하게 되는데, 이때는 구글의 ‘Ohama 프로토콜’을 사용합니다. 이 프로토콜은 xml 기반의 문서를 HTTP 통신으로 주고 받게 됩니다.
커널 이미지를 교체해야 하는 작업이기에, 일반적으로 서비스가 동작하는 라이브 환경에서는 진행하기 힘듭니다. CoreOS는 이 문제를 해결하려고 다음과 같은 트릭을 사용합니다.
읽기만 가능한 루트 파일 시스템을 2개 만듭니다. 그리고 하나는 active, 나머지 하나를 passive 루트 파티션이라고 간주합니다. 현재 부팅시 사용한 루트 파티션을 active라고 한다면, 업데이트간 passive 파티션의 OS 이미지를 갈아끼웁니다. 그리고, GPT를 수정하여 passive 파티션을 active 파티션으로 변경하고 리부팅하여 OS 업데이트를 완료합니다.
이러한 동작 방식을 좀 더 용의케하려고 OS의 부분적 업데이트는 없습니다. 즉, 바뀐 부분만 받는 delta 업데이트나 여러 단계의 업데이트를 지원하지 않습니다. 때문에, CoreOS는 OS 이미지를 기껏해봐야 100MB로 만들어두고 있습니다. OS 이미지만으로 업데이트가 진행되는 꼴입니다. 특이점은 apt나 yum과 같은 패키지 관리자를 따로 두고 있지 않는데요. 이것은 리눅스 컨테이너와 관련된 부분이라 나중에 서술하겠습니다.
이 때 문제점은 어찌됐든 OS 업데이트를 완료하기 위해 리부팅을 해야 한다는 것입니다. (사실 문제점은 아니죠.. 어쩔 수 없으니까요.) 이 문제를 극복하려고 독자적인 fleet이라는 클러스터 레벨의 init 시스템을 가지고 있습니다. 일반적인 유닉스 시스템의 init 프로세스가 모든 프로세스의 부모 프로세스로 동작하듯, fleet은 CoreOS 클러스터에 동작하는 애플리케이션의 부모입니다.
CoreOS는 fleet을 사용하여 클러스터에 동작하는 애플리케이션을 스케쥴링 해, 한 시스템의 OS 업데이트간(즉, downtime) 전체 서비스는 죽지 않게 합니다.
1.2 대규모 서버 배포를 위한 리눅스 (Linux for Massive Server Deployments)
홈페이지를 방문하면 큼지막하게 위와 같은 모토를 확인할 수 있습니다. 이를 위해 CoreOS는 몇 가지 독자적인 콤포넌트를 제공합니다. 각각에 대해서는 후술하겠지만, 먼저 간략히 소개하자면 다음과 같습니다.
- fleet: 클러스터 레벨의 init 시스템
- etcd: fleet을 위한 분산 저장소
- docker: 리눅스 컨테이너 관리 시스템
개별 시스템(노트)의 그림을 그리자면 아래와 같습니다.
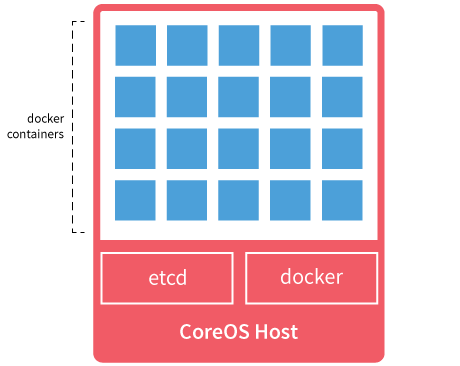
그리고 이런 다수개의 노드로 구성된 클러스터의 그림을 그리자면 아래와 같습니다.
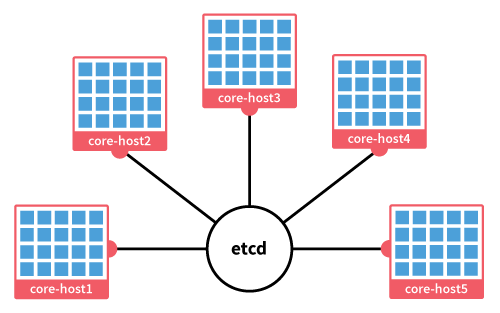
즉, 분산 저장소인 etcd를 중심으로 개별 시스템의 fleet이 연결되고, 클러스터가 구성됩니다. fleet은 docker를 이용하여 애플리케이션을 구동하게 됩니다.
2. 기술적 배경
이해를 돕기 위해 CoreOS를 이루는 기술들을 나열해보도록 하겠습니다.
2.1 Chrome OS
CoreOS는 Chrome OS를 기본 베이스로 파생된 리눅스 배포판입니다. OS 업데이트에 사용되는 Ohama 프로토콜도 여기서 따 온 것으로 보입니다.
2.2 Docker
Docker는 오픈소스 리눅스 컨테이너 플랫폼입니다. 먼저 컨테이너에 대해 짚고 넘어가야할 것 같은데요. 컨테이너는 쉽게 말해 ‘가벼운 가상 머신’이라고 생각하시면 될 것 같습니다.
아래 그림은 일반적인 가상머신과 컨테이너와 차이를 보여주고 있습니다.
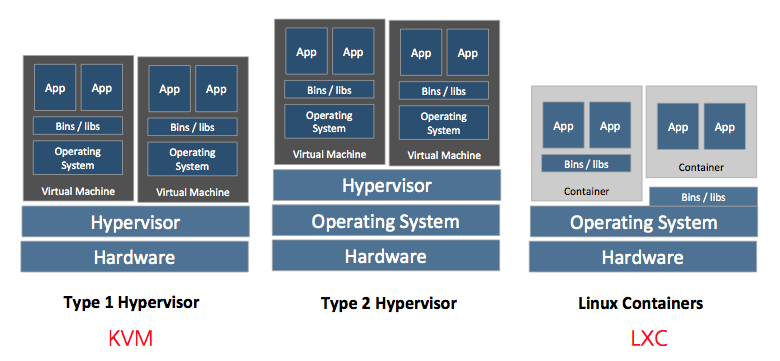
예컨대 OpenStack에서 주로 많이 사용하는 KVM이나 Xen의 경우 위 그림에서는 Type 1 Hypervisor를 사용하는 VM입니다. virtualbox나 VMWare fusion, parallels와 같은 솔루션은 Type 2 Hypervisor VM인데요. 두 타입 모두 가상 장비 개개별로, 즉 guest VM마다 OS 커널이 동작합니다.
lxc와 같은 컨테이너는 이와 달리 guest마다 OS 커널이 필요 없습니다. host의 OS를 공유하기 때문입니다. 때문에 일반적인 VM의 자원 분할과 같은 장점을 가지면서 개별 이미지 크기를 줄일 수 있습니다. 또한 guest 마다 별도의 OS 기동이 필요하지 않으므로, 순식간에 guest를 구동할 수 있는 장점이 있습니다. 하나의 계층을 줄여 성능을 높였지만, 물론 일반적인 VM만큼의 자원 격리(isolation)은 이루어지지 않습니다.
아래는 kvm과 lxc간 성능을 간단히 표로 정리한 것입니다.
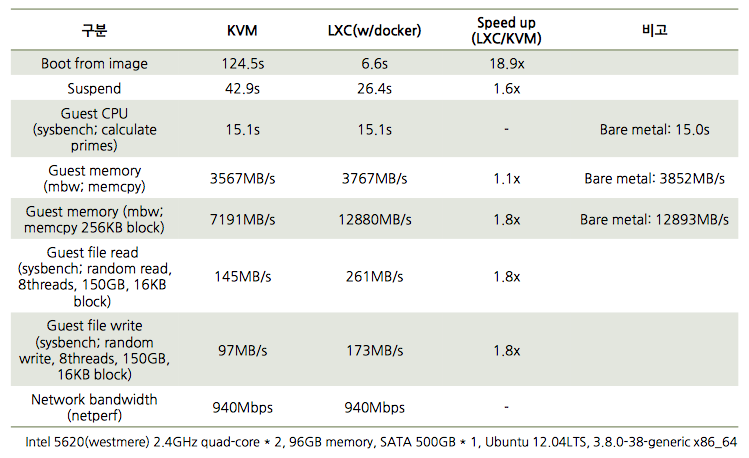 (출처: http://www.slideshare.net/BodenRussell/kvm-and-docker-lxc-benchmarking-with-openstack)
CoreOS에서는 모든 애플리케이션이 Docker를 통해 구동됩니다. Docker 컨테이너 이미지 자체가 실행될 애플리케이션이기 때문에, CoreOS는 별도의 패키지 관리자를 가지고 있지 않습니다.
대신, 예를 들어 웹 서버인 nginx를 CoreOS에서 구동하려면, 저장소(private 저장소 or Docker public 저장소)에서 nginx Docker 이미지를 다운로드합니다. 그리고 이를 구동하여 실행합니다. 이 작업은 fleet을 통해 클러스터 스케일로 확장 가능한데요. 이는 이후 fleet에서 간단히 살펴보겠습니다.
2.3 systemd
systemd는 기존 init을 대체하는 리눅스의 새로운 PID 1 프로세스 시스템입니다. 그 역할은 모든 프로세스를 생성하는, 모든 프로세스의 부모입니다. 현재 빠르게 대부분 배포판의 PID 1 자리를 꿰어 차고 있습니다. CentOS/RHEL(7부터), Debian/Ubuntu와 같은 굵직한 배포판에서 대체되거나 대체 계획이 발표되고 있습니다.
기존 init과 다르게 자원 분할을 해주는 cgroups과 일종의 API로 UDS나 D-Bus 인터페이스도 제공하고 있습니다. 또, 프로세스의 헬스 체크가 가능하고, 실패한 서비스는 재구동하는 기능도 갖추고 있습니다.
CoreOS fleet은 D-Bus 인터페이스(정확히는 IPC)를 통해 systemd에 Docker 이미지의 기동이나 중단을 명령합니다. 개개의 애플리케이션을 systemd에서는 unit이라고 표현하는데, fleet은 unit의 상태도 이 인터페이스를 통해 주기적으로 받아옵니다.
2.4 fleet
먼저도 언급했지만 fleet은 클러스터 레벨의 init 시스템이라 할 수 있습니다. CoreOS는 개별 시스템 레벨에서는 프로세스 관리를 위해 systemd를 사용하지만, 클러스터 레벨에서는 fleet을 사용합니다.
개별 장비에 설치된 fleet 에이전트는 D-Bus를 통해 systemd에 접근, 현재 로컬 시스템에서 구동중인 서비스를 알 수 있습니다. 그리고 systemd를 통해, (그리고 다시 Docker를 통해) 애플리케이션을 구동할 수 있습니다.
fleet을 통해 애플리케이션을 구동하는 과정을 간단히 살펴보면 다음과 같습니다.
- systemd unit 파일을 명세: 실행하고자하는 동작을 명세 (e.g., docker run application)
- fleetctl 커맨드라인 툴로 etcd 디렉터리 서비스에 해당 unit 파일을 등재
- fleetctl 커맨드라인 틀로 클러스터에 애플리케이션(unit) 구동
보다 자세한 내용은 다음과 같은 링크에서 살펴볼 수 있습니다. : https://www.digitalocean.com/community/tutorials/how-to-create-and-run-a-service-on-a-coreos-cluster
unit(즉, 애플리케이션 or 서비스)를 클러스터 레벨에서 구동하려면, 클러스터를 이루는 각 노드들의 정보나 상태 등은 중앙 집중적인 저장소에 관리되고 있어야 합니다. 그리고, 그 중앙 집중 저장소는 단일 장애지점(single failure point)가 되므로 굉장한 고가용성(highly availability)가 요구됩니다.
fleet과 비슷한 플랫폼으로는 Apache Mesos(http://mesos.apache.org)가 있는데요. Mesos에서는 이 저장소로 zookeeper를 사용합니다. CoreOS에서는 다음 절에서 이야기 할 etcd를 사용합니다.
2.5 etcd
CoreOS는 클러스터 정보 관리를 위해 etcd라는 고가용성의 중앙 집중 저장소를 사용합니다. 일반적으로 이러한 용도의 저장소에는 zookeeper가 사용되는데요. CoreOS에서는 etcd라는 별도의 솔루션을 사용합니다.
CoreOS는 조금 생소하실지 모를 Go 언어로 작성되어 있습니다. zookeeper는 너무 JAVA라는 언어에 종속적이어서, 이외 언어에서는 조금 곤란한 점들이 있습니다.
이 뿐만 아니라, 가장 큰 문제는 zookeeper 자체가 너무 비대하다는 것 입니다. 이런 클러스터 시스템에서 zookeeper는 configuration 관리나 노드의 fault detection용으로 주로 사용됩니다.하지만 그 모든 기능을 사용하지 않은 상황에서, 일정 기능만 사용하는 클러스터의 핵심 요소로는 오버 스펙일 수 있습니다. 실제로, zookeeper를 사용한 서비스를 옆에서 지켜보고 도와준 경험이 있는데요. zookeeper의 ephemeral node를 사용하여 fault detection를 하는 상황에서 zookeeper의 일시적인 성능 저하로 노드 상태를 false negative로 판정해버려 결국 모든 노드가 장애가 발생했던 상황이 있습니다.
물론 zookeeper는 오래되고 훌륭하며 매우 안정적으로 동작하는 오픈소스 솔루션이나, CoreOS와 같이 작은 기능을 잘 되도록 집중하려는 프로젝트에서는 오버 스펙이라고 판단하는 것 같습니다.
또, zookeeper는 Paxos라는 컨센서스 알고리즘(consensus algorithm)을 사용합니다. 분산환경에서 일정한 성능을 보장하기 위해서는, 분산 환경을 구성하는 각 노드들 간 상호 의견 타협이 필요한데 이를 Paxos라는 알고리즘을 사용한다는 것 입니다. 이 알고리즘은 80년대 Leslie Lamport라는 분산 시스템의 대가에 의해 고안 되었습니다. 그런데 매우 이해하기 어려운 알고리즘으로 널리 알려졌으며, 2001년도에는 Lamport 본인이 ‘Paxos Made Simple’이라는 글을 통해 아래와 같이 이야기 하기도 했습니다.
“The Paxos algorithm, when presented in plain English, is very simple.”
그런데도 여전히 어렵습니다. 현 시점에서 zookeeper의 LOC는 137k 라인입니다. zookeeper는 이렇게 거대한 규모인데 그 기반인 알고리즘 또한 어려운 셈이지요. 참고로, zookeeper 이외에도 그 유명한 구글의 분산 락 시스템인 Chubby가 이 Paxos를 사용합니다.
etcd는 Raft라는 Paxos 대안 알고리즘을 사용합니다. Raft는 2013년에 스탠퍼드의 Diego Ongaro가 고안한 컨센서스 알고리즘으로, Paxos와 동일한 능력을 가지되 사람에게 보다 쉽게 이해할 수 있도록 작성되어 있습니다.
2013년 논문 발표 이후 Raft 구현체가 우후죽순 생겨나고 있는데(2014년 10월 현재 54개), 이는 역사상 수개의 구현체만 존재하는 Paxos 보다 무척 쉽다는 점을 단적으로 보여줍니다.
etcd는 그래서 겨우 17k의 LOC를 가집니다. (서드파티까지 포함하면 33k)
조금 내용이 길어졌는데, CoreOS에서는 하고자 하는 일에 집중하려 했고 zookeeper는 너무 오버스펙이어서 etcd를 개발하려 한 것 같습니다.
2.6 Go language
CoreOS는 fleet, etcd 등의 구현을 모두 Go 언어로 통합하고 있습니다. (저도 참 좋아하는데요.) Go 언어는 그 유명한 Ken Thompson, Rob Pike가 2007년에 구글에서 만든 언어입니다.
컴파일시 타입 추론(compile-time type inference), 빌트인 동시성 프리미티브(e.g., channel, light-weight thread;goroutine) 등을 제공하는 최신 세대의 언어입니다.
요새들어 devops들에게 각광받고 있는데요. 파이썬만큼 간단한 문법, 이미 대부분 기능이 빌트인된 현대적인 표준 라이브러리, 파이썬보다 훨씬 좋은 성능(컴파일 언어이므로), 정적 컴파일(동적 라이브러리 같이 배포할 필요 없고, 바이너리 한개만 배포하면 됨) 등이 그들에게 큰 점수를 받은 것 같습니다.
이 언어의 창시자인 Rob Pike는 점점 복잡해지는 C++ 개발자를 위해 만들었다지만, 시장에서는 파이썬 개발자에게 큰 어필을 하고 있습니다.
CoreOS는 특히나 minimal OS를 지향했고, Go 언어는 특히나 minimal 배포를 그 강점으로 삼고 있으므로 궁합이 잘 맞습니다.
3. 디자인 문제와 그 해결
Deview 2014에서는 실제 CoreOS 개발 진행 과정 상 맞닥들였던 여러 문제들과 그 극복 방안을 소개했습니다. 이 절에서는 그 부분에 대하여 이야기 해 봅니다.
3.1 systemd 관련
-
신뢰할 수 없는 D-Bus의 pub/sub 처음에는 D-Bus의 pub/sub 기능을 이용하여 unit의 상태를 받아보려고 했었습니다. 그런데 생각보다는 pub/sub 기능이 신뢰할 수 없어서, 단순히 polling하는 방법으로 전환했다고 합니다. 이렇게 하여 효율은 떨어졌지만, 안정성은 크게 높아졌다고 합니다.
-
Docker와의 궁합 systemd와 Docker는 둘 다 기본으로 cgroups를 사용합니다. 때문에 systemd의 명령어가 Docker가 구동한 컨테이너에 제대로 전달되지 않는 문제가 있다고 합니다. Docker가 systemd와 별도로 cgroup을 생성하므로, systemd에서는 Docker를 통해 구동한 컨테이너의 cgroup을 제대로 트래킹하지 못하기 때문입니다. 이는 아직 해결 방안을 찾고 있는 중인데요, Docker가 생성한 컨테이너의 cgroup을 systemd가 관리하는 영역에 수동으로 옮긴다거나, 아예 Docker는 이미지 관리만 하고, 컨테이너의 구동 방식은 systemd-nspawn을 사용하는 방법 등을 고민하는 것 같습니다.
3.2 fleet / etcd 관련
- 신뢰할 수 없는 watch 기능 아직 etcd도 한창 개발중이기에, etcd가 제공하는 watch 기능이 조금 문제가 있습니다. 리더 선출과 같은 컨센서스가 진행중이거나 etcd에 과중한 부하가 걸렸을 경우 CoreOS의 각 노드가 unit의 상태 변경을 제때 통지 받지 못한다고 합니다. 또, etcd는 Raft 알고리즘에 의해 일어났던 이벤트를 기록하고 있는데요. 모든 이벤트를 기록할 수 없으니 일정 개수의 윈도를 가지고 이벤트를 기록합니다. 그런데, 갑자기 이벤트가 많아졌고 CoreOS의 각 노드가 이 이벤트를 제때 살펴보지 못한다면, 윈도 범위보다 이벤트 개수가 많아져 결국 이벤트가 유실됩니다.
이를 해결하기 위해서, fleet이 unit을 스케쥴링할 때 각 노드의 상태와 unit의 상태를 모두 질의하여 스케쥴링을 진행하는 reconciler model을 사용한다고 합니다. 결국 스케쥴링에 블록킹이 생겨 그 효율은 떨어지나, 안정성은 높아진다고 합니다.
CoreOS에서는 이러한 점을 보완하기 위해, reconciler model을 적용하는 트리거로 watch를 사용한다거나 하는 최적화 방법을 고안중입니다.
3.3 Go 언어(golang) 관련
-
패키지 관리 시스템의 부재 golang은 아직 성숙기에 접어든 언어/플랫폼이 아니므로, 자바에서만큼 여러 도구들이 제공되지는 못하는 실정입니다. 자바라면 maven등을 통해 연관관계가 있는 패키지의 버전을 관리하는데, golang은 현재 이러한 도구가 없는 실정입니다. CoreOS에서는 역시 뾰족한 수가 없으니, 자신의 패키지 소스에 번들링하여 이를 해결합니다. 별개로 godeps와 같은 프로젝트에서 패키지 버전을 관리하려는 움직임이 있으니, 추후에는 이러한 솔루션을 사용할 것 같습니다.
-
큰 바이너리 golang 애플리케이션은 대개 바이너리 한개로 구성됩니다.
다시 말해 그 바이너리 안에 애플리케이션 실행 코드와 golang runtime이 모두 포함됩니다. 그래서 다른 언어로 작성된 애플리케이션보다 훨씬 큰 크기를 가지는데요, 단순히 helloworld만 찍는 애플리케이션이라도 10메가 바이트에 육박하게 됩니다. 한가지 다행인 점은 golang 버전이 올라갈수록 코드 최적화가 이루어져 용량이 점점 줄어들고 있습니다. CoreOS에서는 수동적인 방법으로는 (어쩔수 없으니) golang 버전이 올라가고 바이너리 크기가 줄어들기를 기대하고 있습니다.
그리고 적극적인 방법으로는 한가지 트릭을 사용하는데요. 바로 한 바이너리에 여러 구성요소를 모두 담는 것입니다. 그리고 심볼릭 링크를 이용하여 여러 프로그램 이름으로 링크를 생성합니다. 그런 다음, main 함수에서 argv에 붙은 인자 중 맨 처음 인자인 프로그램 이름으로 분기하여 해당 구성요소로 동작하게 합니다. 이렇게 하면, golang runtime에 필요한 중복적인 용량을 줄일 수 있습니다.
바이너리 크기까지 신경 쓰는건 처음 이야기했던 대로, minimal single OS image를 생성하기 위함입니다.
4. 결론
CoreOS는 ‘cluster by default’라는 문구가 인상적인 또 하나의 클라우드 솔루션입니다. 기반 기술로 systemd나 Docker와 같은 비교적 최신의 기술을 잘 버무려 구성하고 있습니다. 한 때 VM 기술이 완전히 밀렸던것 같은 컨테이너가 Docker라는 구원투수에 의해 다시 수면 위로 부상한 점 눈여겨 볼만 합니다. 빠른 배포/구동이 큰 장점인 컨테이너 기술이 클라우드 시대에 재조명 받아 VM과 어깨를 나란히 할 수 있을지도 관전 포인트입니다.
또, 이러한 클라우드 솔루션은 암묵적으로 OpenStack 휘하에 집결되고 있는데, CoreOS 또한 예외는 아니어서 OpenStack과 어떻게 시너지를 낼 수 있을지도 관심이 갑니다.
이렇게 꽤나 장황하게 CoreOS에 대해 정리하였습니다. Deview 2014에 발표된 내용을 뼈대로, 추가 부연 설명을 하느라 글이 의도치 않게 길어지게 되었습니다.
지금까지 읽어주신 분들께 감사드립니다!