Engineering
음성 AI 모델을 프로덕션에 올리기까지: Kanana-O 서빙 최적화 여정
hulk.5, steve.ai카카오
2026년 5월 6일
원문에서 보기 ↗TL;DR
kanana-o는 텍스트·이미지·오디오를 종합적으로 이해하고 자연스러운 텍스트와 음성으로 응답하는 멀티모달 모델입니다(자세히 알아보기). 모델을 학습하는 것과 사용자에게 서비스하는 것은 전혀 다른 문제입니다. 이 글에서는 Kanana-O를 실시간 음성 대화 서비스로 제공하기 위해 마주한 엔지니어링 문제들과, 이를 해결하며 만든 서빙 서버 Kanana-Omni Server의 핵심 최적화 기법들을 공유합니다.
1. 모델은 완성됐는데, 서빙은 다른 문제였습니다
Kanana-O의 내부 파이프라인 구조는 세 개의 핵심 컴포넌트로 구성되어 있습니다.
- Thinker: 멀티모달 입력을 이해하고 텍스트를 생성하는 대형 언어 모델(LLM)
- Talker: 생성된 텍스트 임베딩을 전달받아 음성 토큰을 순차적으로 생성하는 모델
- VoiceBox: 만들어진 음성 토큰을 조합해 실제 사람들이 들을 수 있는 오디오 파형으로 합성하는 모델
단순 연구 및 학습 환경에서는 이 세 컴포넌트를 순차적으로 실행하면 됩니다. 하지만 프로덕션에서는 이야기가 달라집니다. 아래와 같은 엄격하고 까다로운 조건들이 요구되기 때문입니다.
- 사용자는 수백 밀리초(ms) 안에 첫 음성 응답을 기대합니다.
- 서버는 동시에 접근하는 여러 사용자의 요청을 처리해야합니다.
- 텍스트 생성과 오디오 합성이 동시에 끊김 없이 스트리밍되어야 합니다.
- 각각의 컴포넌트가 요구하는 GPU 메모리의 크기와 특성이 서로 다릅니다
이 글은 위와 같은 복잡한 요구사항들을 충족시키고 병목 현상을 하나씩 해결해 나간 기록입니다.
2. 범용 프레임워크로 충분하지 않았나?
처음에는 프레임워크가 없었습니다
Kanana-Omni Server 개발을 시작했을 때, 이 문제를 풀어주는 범용 프레임워크는 존재하지 않았습니다. 우리가 필요한 것은 3개의 모델이 비동기로 데이터를 주고받으며, 실시간으로 오디오를 스트리밍하는 고도화된 아키텍쳐입니다. 단순히 “모델을 API로 감싸는” 수준이 아니라, 모델 간의 데이터 흐름 자체를 설계해야 하는 문제였습니다.
개발 도중 vllm-omni 같은 멀티모달 서빙 프레임워크가 등장하기 시작했지만, 여러 이유로 채택하지 않았습니다. Kanana-O의 파이프라인이 기존 프레임워크가 가정하는 패턴과 맞지 않았기 때문입니다.
범용 프레임워크가 커버하지 못하는 지점들
1. Thinker → Talker 간 데이터 전달이 토큰이 아니라 ‘임베딩’입니다.
- 일반적인 LLM 서빙에서 모델의 출력은 토큰 ID이고, 다음 단계에는 이 토큰을 다시 입력으로 넣습니다.
- 하지만 Kanana-O에서는 Thinker가 생성한 히든 스테이트 임베딩 벡터를 Talker에게 직접 전달합니다.
- 수천 차원의 부동소수점 텐서를 토큰 단위가 아닌 임베딩 단위로, 실시간으로 넘겨야 합니다.
- 이를 네트워크를 통해 직렬화해서 전달하거나 CPU 메모리로 복사하는 것보다는, GPU 메모리 주소만 보내는 zero-copy 방식으로 직접 구현 했습니다.
2. Talker의 출력을 VoiceBox가 비대칭적으로 소비합니다.
- Talker는 매 스텝마다 일정 수의 음성 토큰을 생성합니다.
- 반면 VoiceBox는 이 토큰이 충분히 쌓일 때까지 기다렸다가, 한꺼번에 청크(chunk) 단위로 오디오를 합성합니다.
- 생산 속도와 소비 속도가 다른 비대칭 파이프라인이며, 이 사이에 비동기 버퍼링과 청크 분할 로직이 필요합니다.
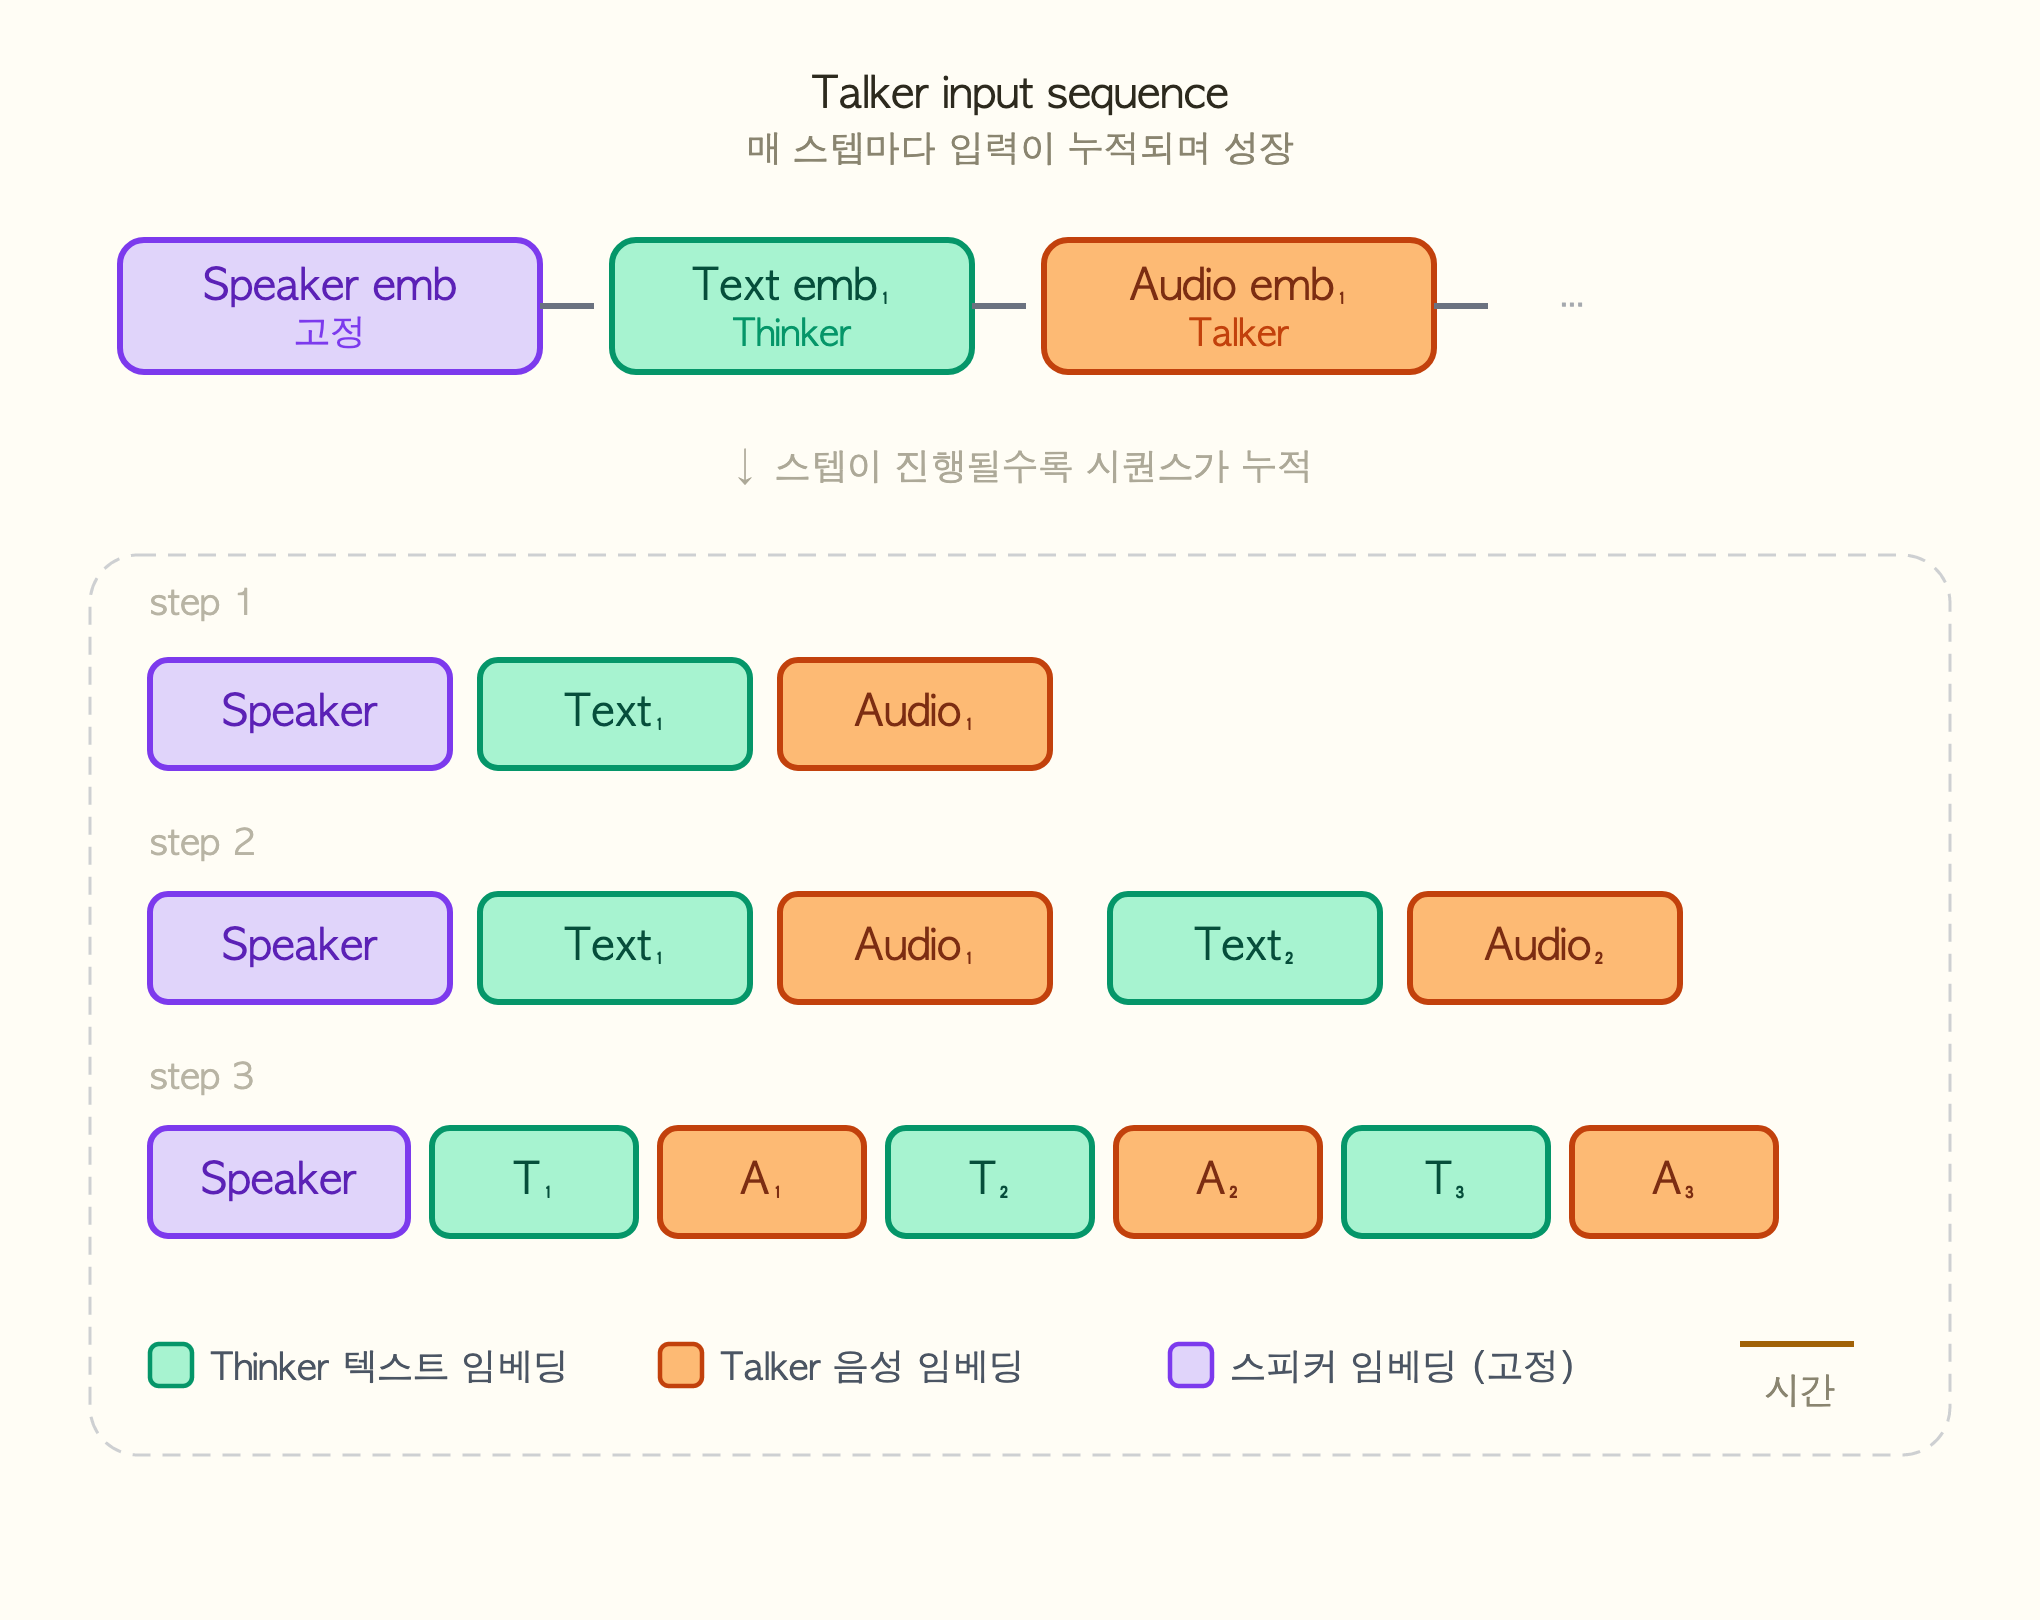
3. Talker의 입력 구조가 일반적이지 않습니다.
- Talker에는 Thinker가 생성한 텍스트 임베딩만 들어가는 것이 아닙니다.
- 화자의 음성 특성을 담은 스피커 임베딩이 먼저 들어가고, 여기에 Thinker의 출력이 이어 붙습니다.
- 여기에 Talker 자신이 이전 스텝에서 생성한 음성 임베딩이 누적됩니다.
- 매 스텝마다 입력 텐서가 자라나는 이 구조는 표준적인 autoregressive 디코딩과는 다르며, 범용 프레임워크의 입력 파이프라인으로는 표현하기 어렵습니다.
이런 요구사항들이 겹치면서, 우리는 Kanana-O에 특화된 서빙 서버를 직접 만드는 길을 택했습니다. 결과적으로 이 선택은 실제 벤치마크 결과로도 그 성능이 검증되었습니다.
| naive implementation | vllm-omni | Kanana-Omni Server | |
|---|---|---|---|
| throughput (relative) | 0.44 | 1 | 1.6 |
동시 접속 유저 64 기준 상대 throughput
3. 첫 번째 병목: 컴포넌트 간 데이터 전달
문제
Kanana-O의 세 컴포넌트는 설정에 따라 서로 다른 GPU에서 실행되기도 합니다. Thinker와 Talker를 별도 프로세스로 분리한 이유는 섹션 5에서 다루겠지만, 여기서는 분리된 상태에서의 통신 문제를 먼저 살펴봅니다. Thinker가 생성한 수천 차원의 임베딩 벡터를 Talker에게 넘겨야 음성 생성이 시작되는데, 순진하게 구현하면 다음과 같은 복잡한 경로를 거치게 됩니다.
Thinker(GPU 0) → CPU 메모리 → 직렬화 → IPC → 역직렬화 → CPU 메모리 → Talker(GPU 1)
매 토큰마다 이 경로를 타면, 직렬화/역직렬화 오버헤드가 사용자가 체감하는 지연으로 직결됩니다.
해결: 사전 할당 공유 메모리 풀
서버 시작 시 대량의 공유 메모리 블록을 OS 레벨에서 미리 할당합니다. 런타임에는 할당/해제가 발생하지 않습니다. Thinker가 데이터를 생성하면 풀에서 블록을 꺼내 직접 쓰고, Talker는 블록 이름(메타데이터)만 받아 같은 메모리 주소를 읽습니다.
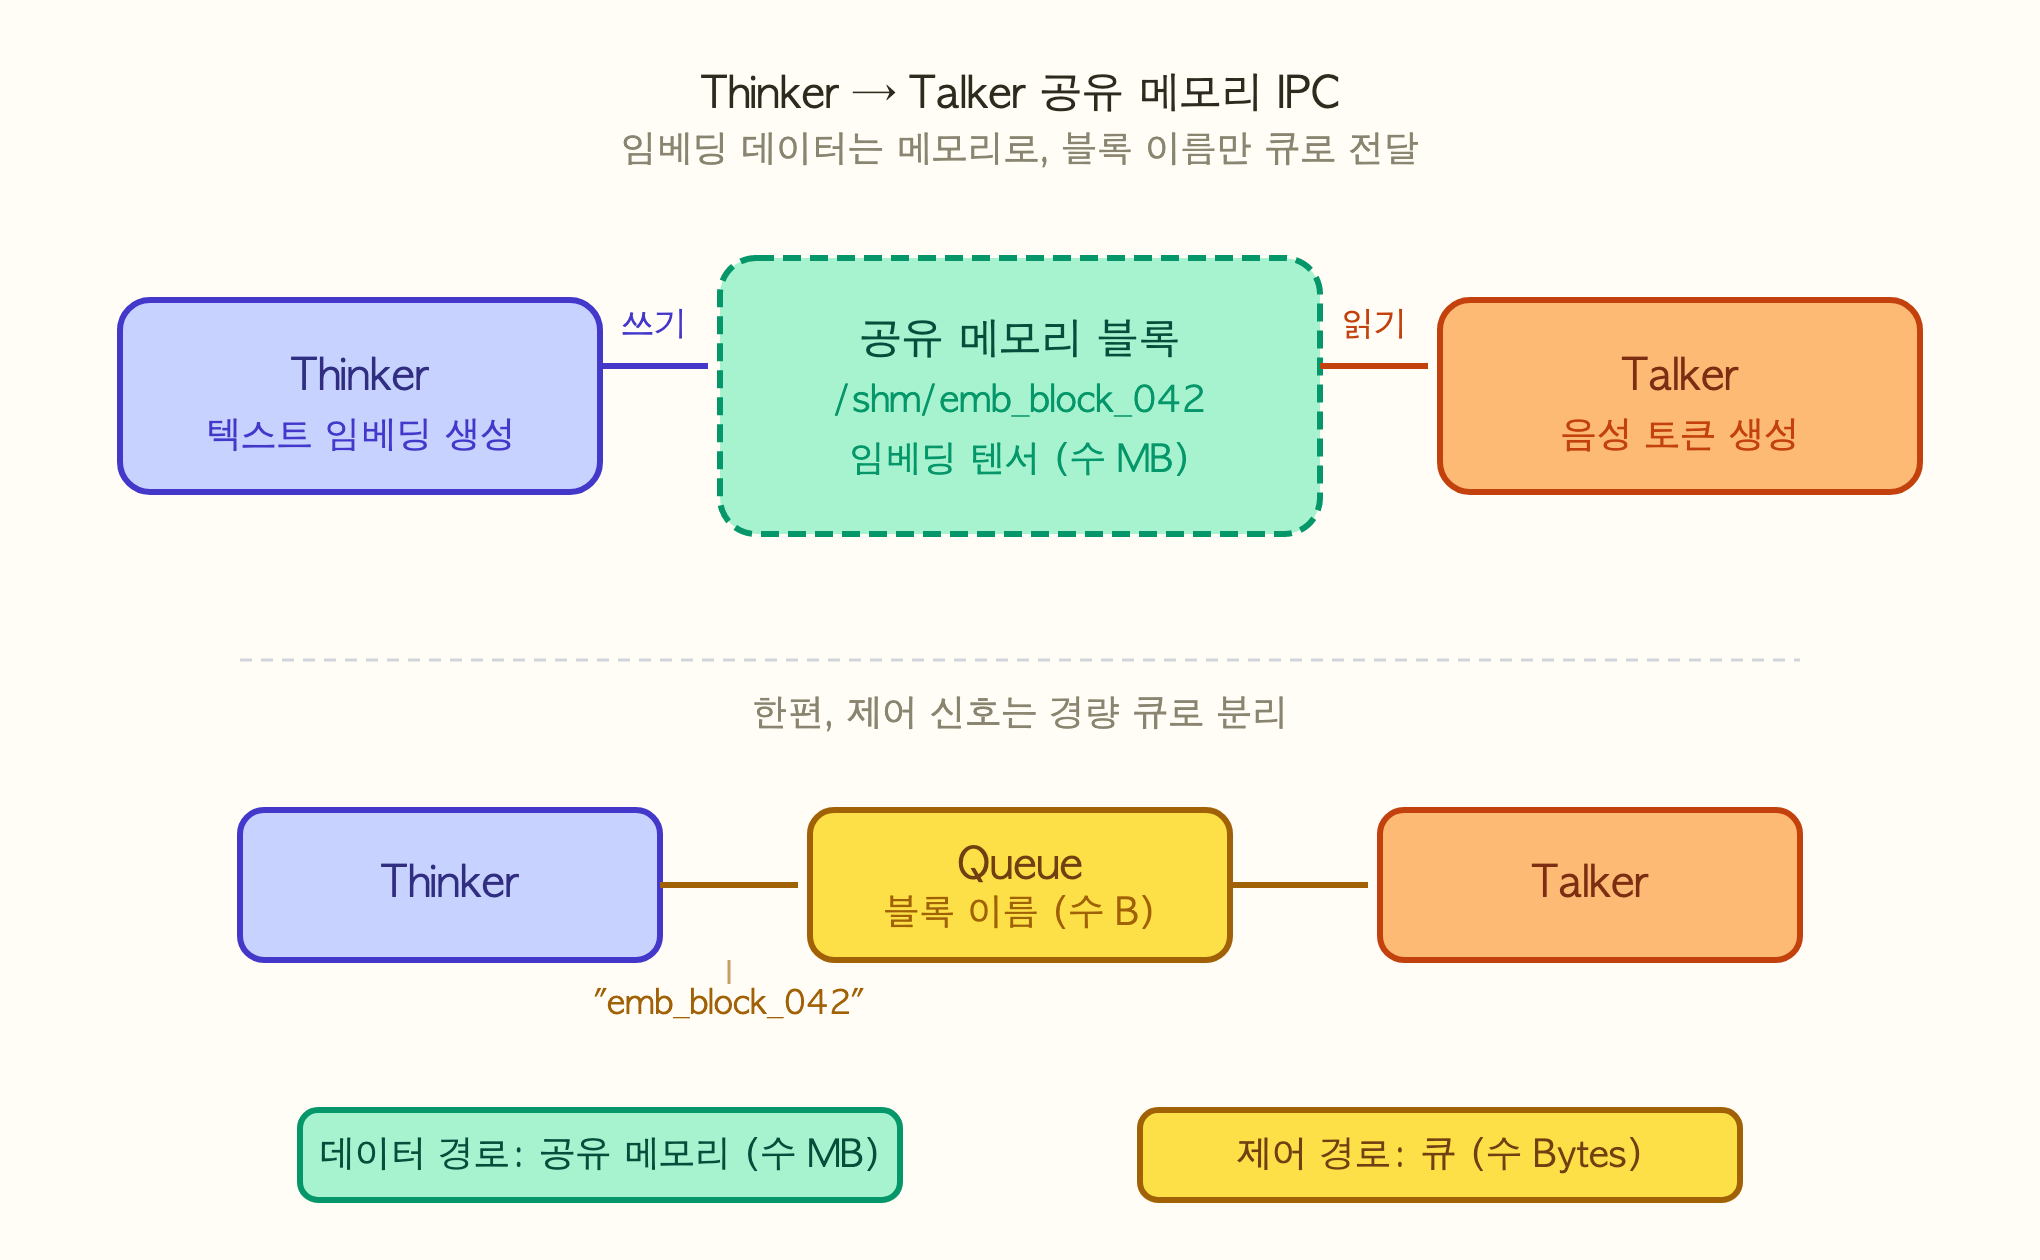
이렇게 함으로써 데이터 복사와 직렬화 오버헤드를 제거했습니다. 전달되는 것은 "몇 번 블록에 몇 바이트가 있다"는 메타데이터 뿐입니다.
CUDA IPC: GPU 텐서는 더 빠르게
같은 노드 내 GPU 간 텐서 전달에는 CUDA IPC(Inter-Process Communication)를 활용합니다. GPU 메모리에 올라간 텐서를 CPU로 내리지 않고 GPU 간 직접 전달하여, ‘Device→Host→Device’ 변환 오버헤드를 완전히 제거합니다.
이 두 가지 최적화로, 컴포넌트 간 데이터 전달이 파이프라인의 병목에서 사라졌습니다.
4. 두 번째 병목: 순차 실행의 지연
문제
만약 Thinker가 텍스트를 모두 생성한 뒤 Talker가 시작하고, Talker가 모두 끝난 뒤 VoiceBox가 시작하면 어떻게 될까요?
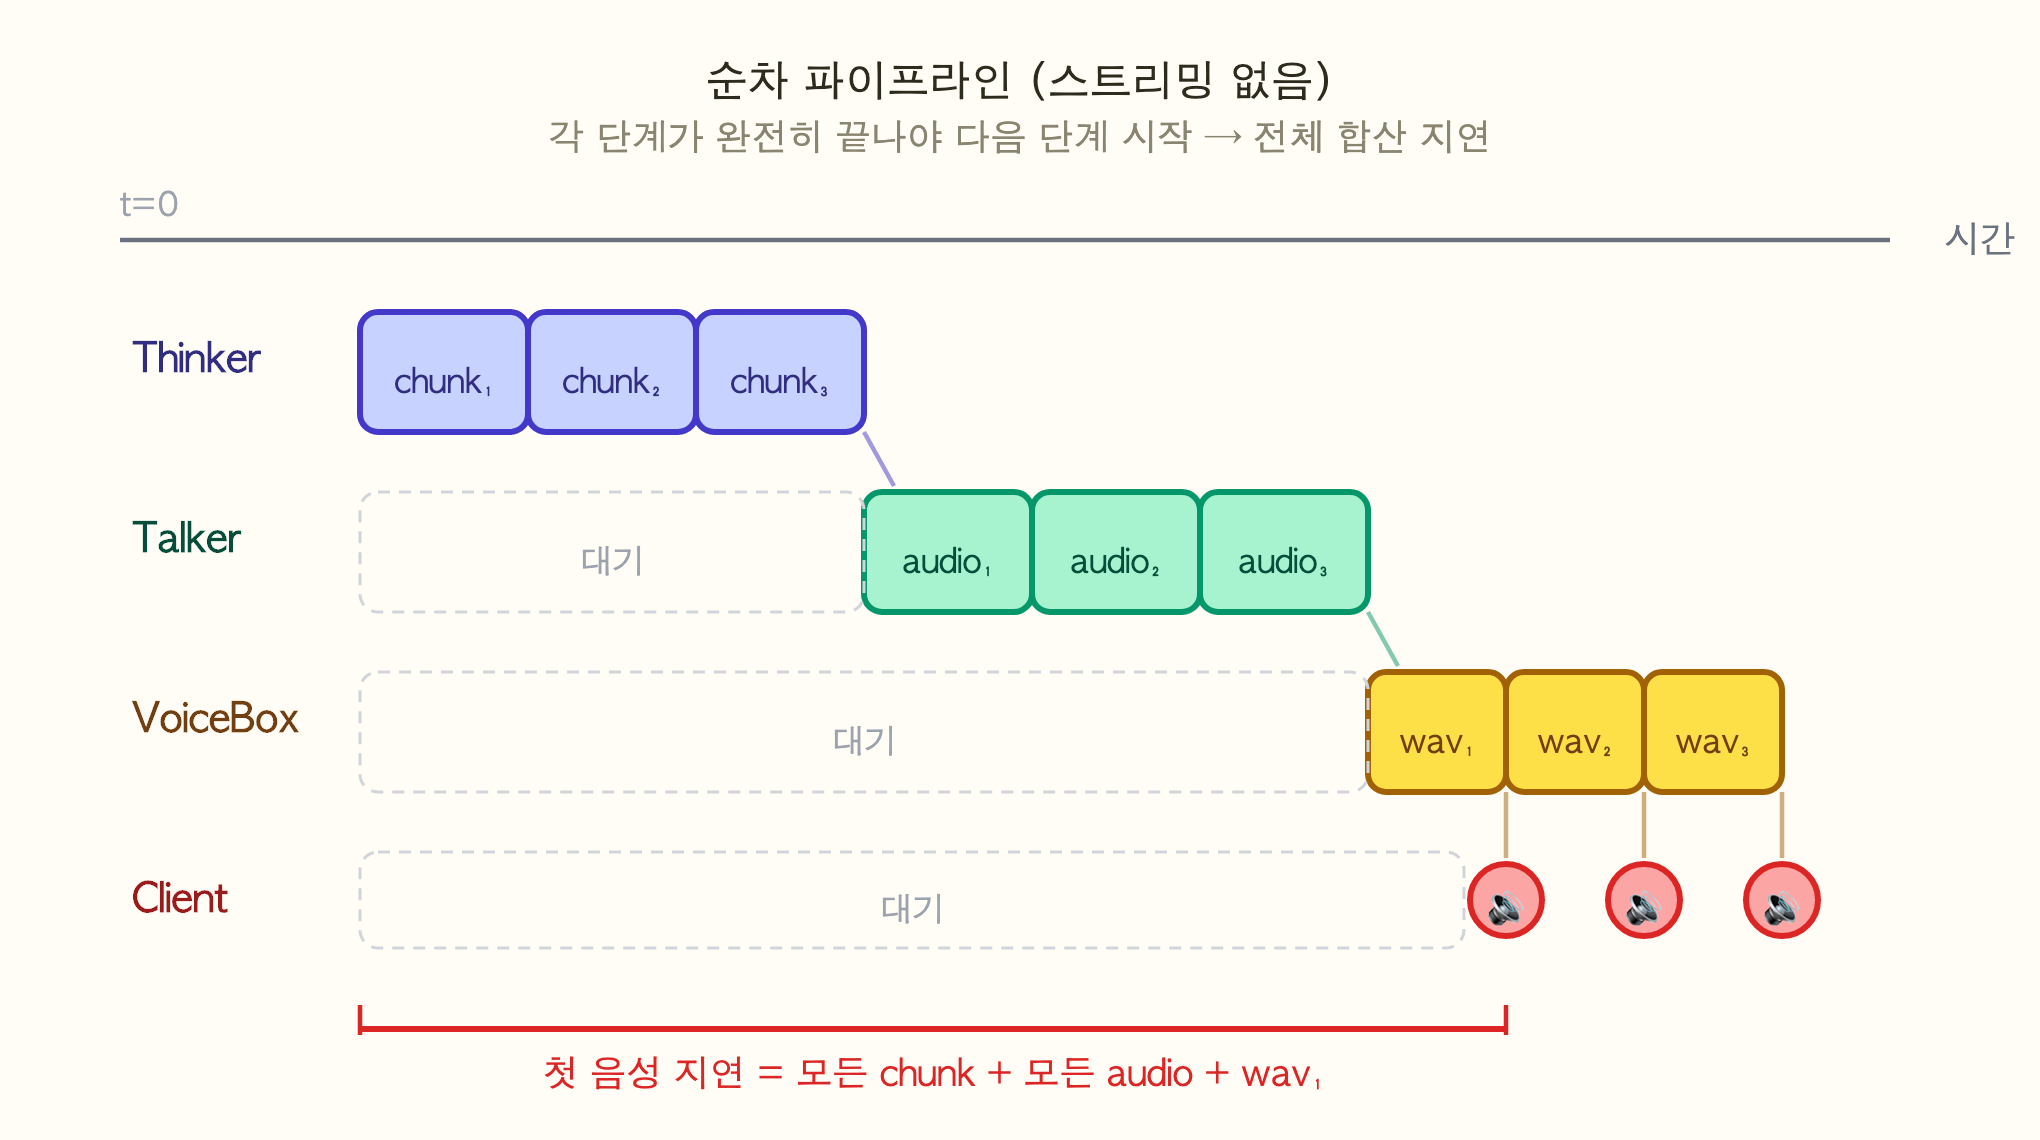
사용자는 전체 파이프라인이 끝날 때까지 아무 소리도 듣지 못합니다. 긴 응답이면 수 초가 걸릴 수 있으며, 사용자는 장애 상황으로 인지할 수 있는 치명적인 문제입니다.
해결: Cascaded Streaming Pipeline 도입
Thinker와 Talker를 별도의 비동기 태스크로 실행하고, 비동기 큐로 연결합니다. Thinker가 첫 번째 청크를 생성하는 순간, Talker는 이미 이전 청크의 음성 토큰을 만들고 있고, 동시에 VoiceBox는 그 전 청크의 오디오를 합성하고 있습니다.
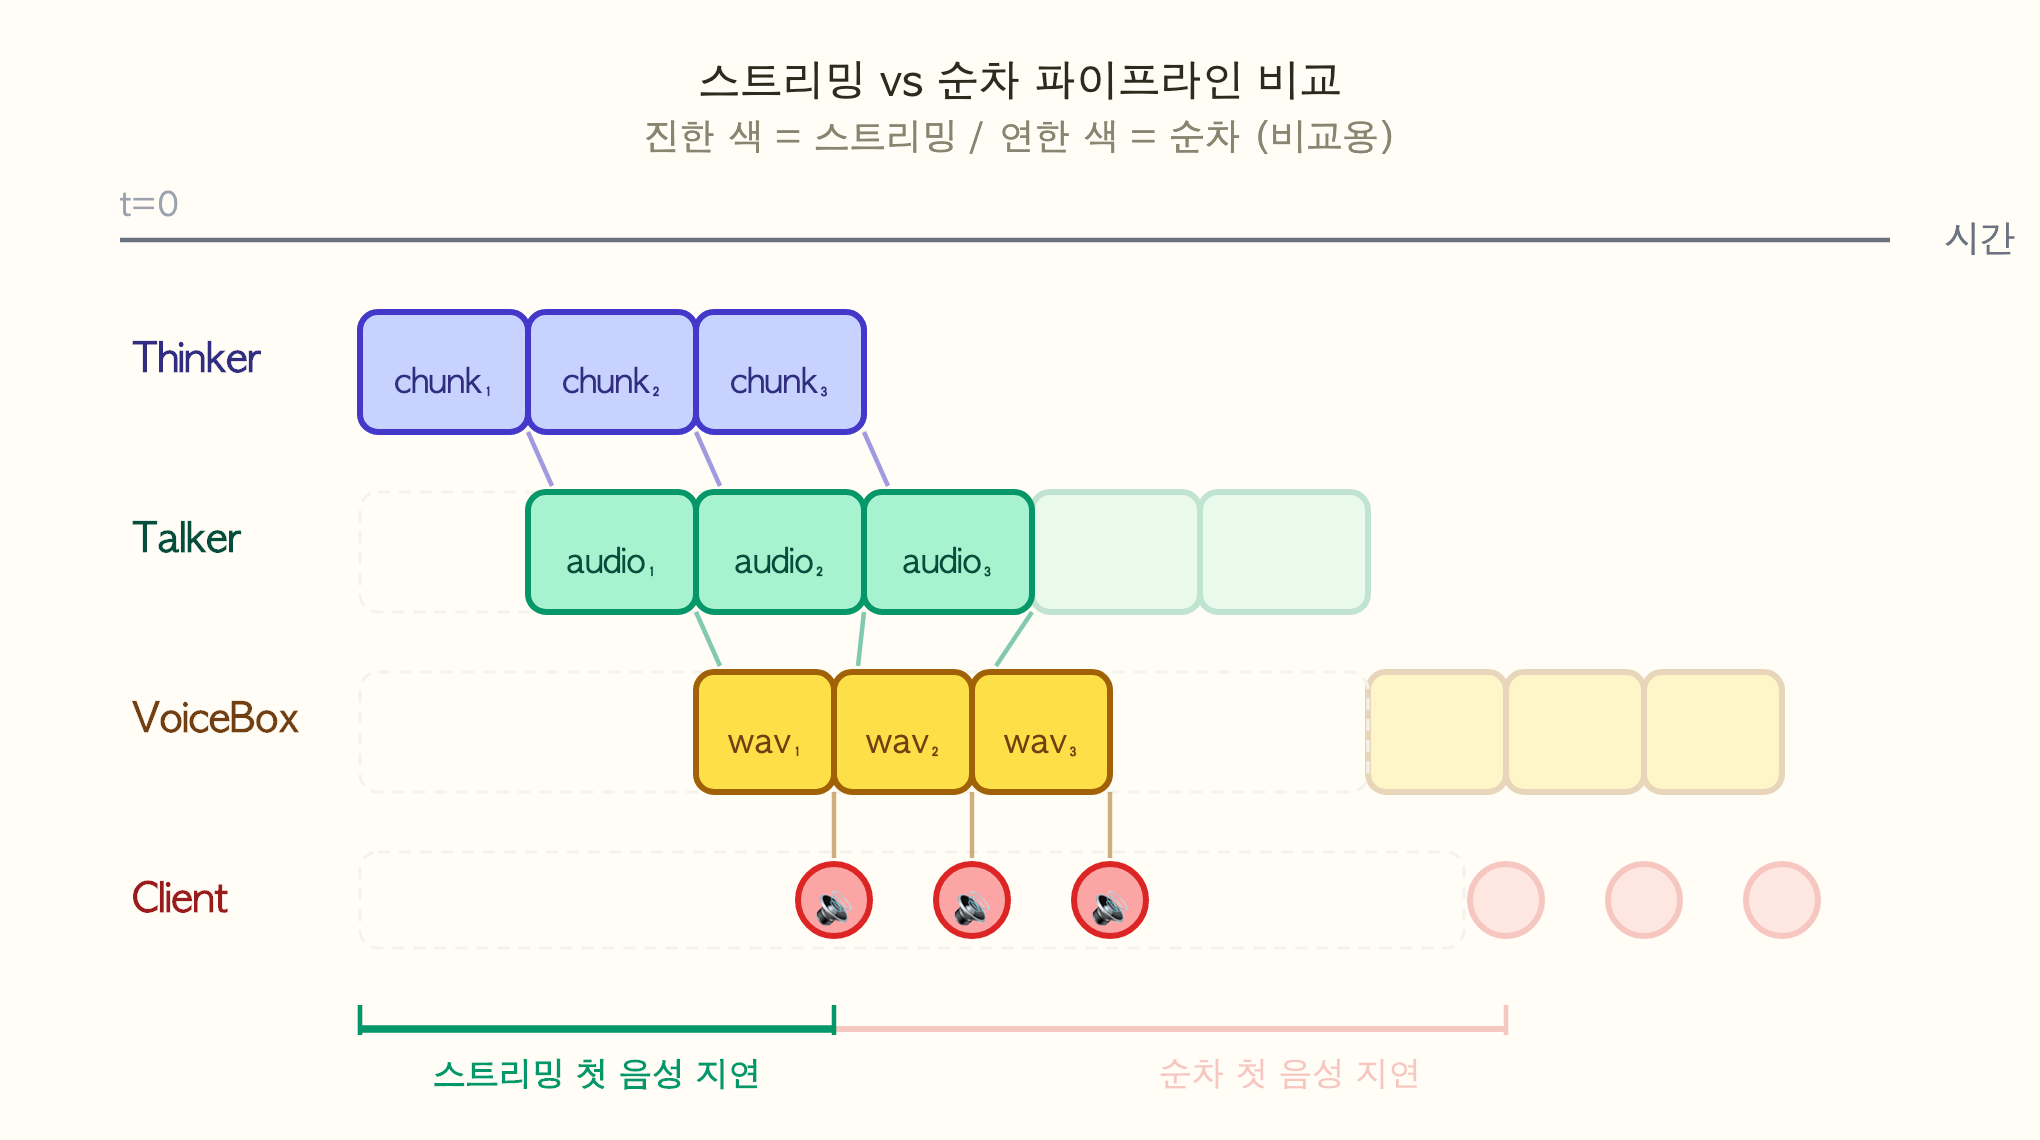
Talker는 매 스텝마다 일정 수의 음성 토큰을 생성하며, 이 토큰들이 충분히 쌓이면 VoiceBox가 오디오 파형으로 변환합니다. 파이프라인 스테이지가 톱니바퀴처럼 겹쳐서 동시에 실행되므로, 사용자가 첫 음성까지의 체감 대기 시간이 크게 단축되었습니다.
5. 프로세스 격리와 장애 전파 차단
왜 프로세스를 분리하는가
Kanana-O의 Thinker와 Talker는 각각 독립된 vLLM 엔진으로 구동됩니다. vLLM은 모델 로딩부터 KV cache 관리, 스케줄링까지 자체적으로 하나의 완결된 추론 런타임을 구성합니다. 만약 하나의 프로세스에서 두 개의 vLLM 엔진을 동시에 띄우면, CUDA 컨텍스트 충돌이나 메모리 관리 간섭이 발생할 수 있습니다.
따라서 Kanana-Omni Server는 Thinker와 Talker를 각각 별도의 프로세스로 실행하는 구조를 채택했습니다… 각 프로세스가 자신만의 vLLM 엔진을 가지고, 자신만의 CUDA 컨텍스트에서 독립적으로 추론합니다.
mp.set_start_method("spawn", force=True)

self.thinker_manager = VLLMProcessManager(gpu_ids=gpu_ids_thinker, ...)
self.talker_manager = VLLMProcessManager(gpu_ids=gpu_ids_talker, ...)
프로세스 생성 방식으로는 fork 대신 spawn을 사용합니다.
fork는 부모 프로세스의 메모리를 그대로 복사하기 때문에 CUDA 컨텍스트와 충돌할 수 있습니다.spawn은 깨끗한 Python 인터프리터 환경에서 프로세스를 시작하여, GPU 상태 오염 가능성을 원천 차단합니다.
이렇게 분리된 프로세스 구조는 장애 격리의 이점도 가져옵니다. 예를 들어, 트래픽 폭주로 Thinker 프로세스가 메모리 부족(OOM)으로 죽더라도, Talker와 메인 API 서버는 영향을 받지 않으며, 각 엔진을 독립적으로 재시작하거나 종료할 수 있는 운영 안정성을 확보했습니다.
6. 동시 요청을 배치로 묶기 — vLLM의 continuous batching 활용
왜 직접 배치를 만들지 않았는가
프로세스가 분리된 상태에서, 다음 과제는 각 프로세스 안에서 동시 요청을 효율적으로 처리하는 것입니다. 여러 사용자의 요청이 동시에 들어올 때, Thinker와 Talker 각각에서 배치 처리를 극대화하는 것이 처리량의 핵심입니다.
하지만 직접 배치를 구성하는 것은 생각보다 까다롭습니다.
- Thinker는 멀티모달 입력(이미지, 오디오)의 크기가 요청마다 다릅니다. 어떤 요청은 이미지 하나, 어떤 요청은 오디오 여러 개를 포함합니다. 이를 하나의 배치로 묶으려면 padding이 필요하고, 그만큼 GPU 연산이 낭비됩니다.
- Talker는 더 까다롭습니다. 요청마다 누적된 embedding 길이가 다르기 때문에 수동 배칭은 복잡한 동기화 로직을 수반합니다.
해법은 간단했습니다. 배치 구성은 vLLM의 continuous batching ‘스케줄러에 위임’하고, 저희는 요청을 빠르게 밀어넣는 구조에 집중했습니다.
요청을 비동기로 쏟아붓기
앞서 설명한 Thinker와 Talker의 vLLM 프로세스 내부 루프는 다음과 같이 동작합니다.
while True:
    cmd = await asyncio.to_thread(input_q.get)
    asyncio.create_task(
        generate(request_id, prompt, max_tokens, ...)
    )
input_q.get()으로 요청을 받자마자 asyncio.create_task(generate(...))로 fire-and-forget합니다. 요청이 끝날 때까지 기다리지 않고, 즉시 다음 요청을 받을 준비를 합니다.
각 generate() 태스크는 독립적으로 engine.generate()를 호출합니다. vLLM 엔진은 내부적으로 여러 요청을 하나의 forward pass에 묶어서 실행하지만, 결과는 request_id 기준으로 분리되어 돌아옵니다. generate() 함수는 이 request_id를 기반으로 자신의 결과만 골라 yield하는 역할을 합니다. 여러 요청이 엔진 안에서 섞여 처리되더라도, 각 태스크는 자기 응답만 스트리밍할 수 있는 구조입니다.
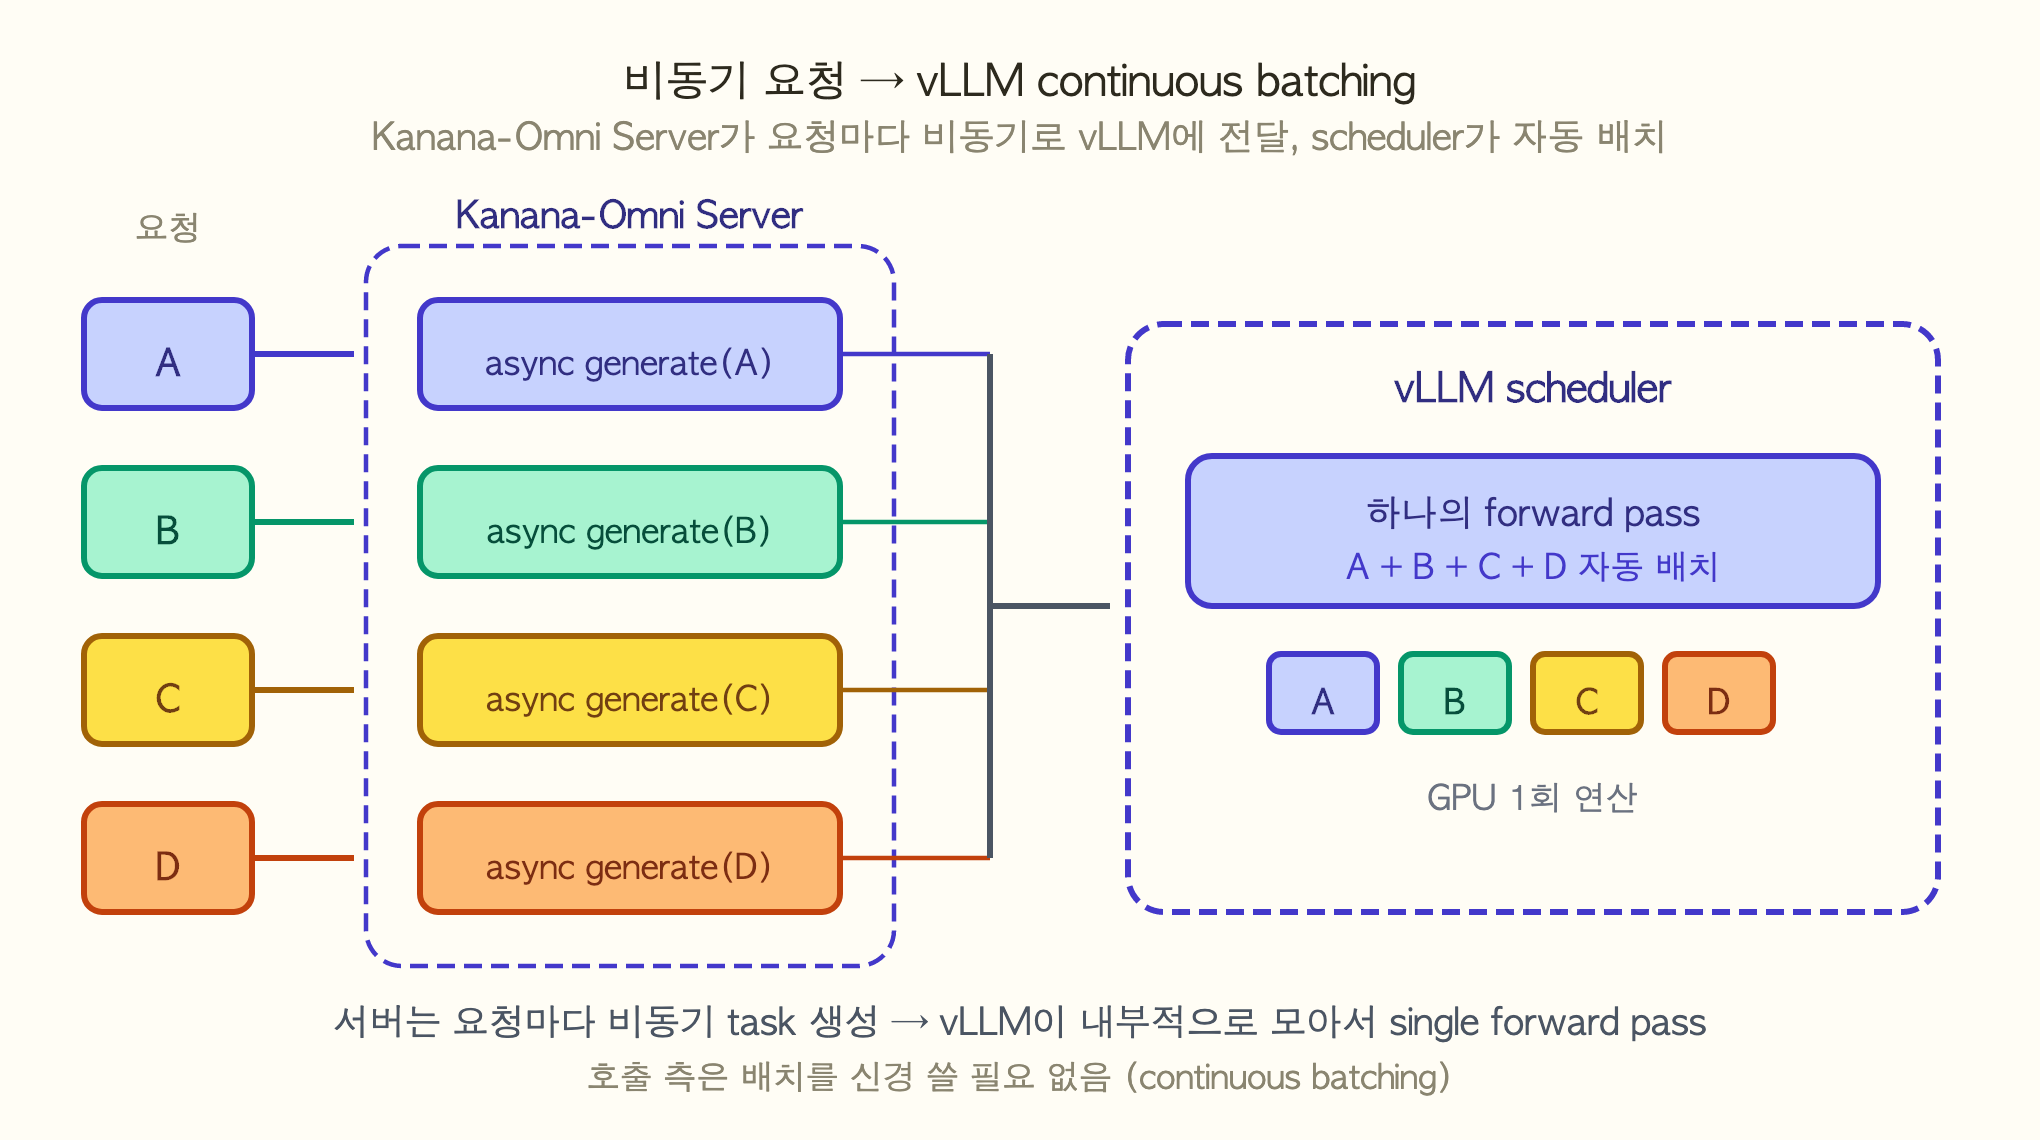
vLLM 설정에서 동시에 처리할 수 있는 시퀀스 수의 상한을 지정할 수 있으며, 이 범위 안에서 스케줄러가 가용 GPU 메모리와 요청 상태를 고려하여 최적의 배치를 구성합니다. 우리는 배치 로직을 작성할 필요 없이, 요청을 최대한 빠르게 엔진에 제출하는 것만으로 GPU 활용률을 높일 수 있었습니다. 하지만 요청을 빠르게 밀어넣는 구조가 가능하려면, API 서버 자체가 동시 요청을 블로킹 없이 받아들일 수 있어야 합니다.
7. FastAPI workers=1 — 그리고 async/await로 CPU사용률 올리기
workers=1일 수밖에 없는 이유
Kanana-Omni Server는 FastAPI + Uvicorn 기반으로 구축되었습니다. 일반적인 웹 서버라면 workers=N으로 워커 프로세스를 늘려 동시 처리량을 높이겠지만, 무거운 모델 서빙 환경에서는 이야기가 다릅니다.
uvicorn.run(app, ..., workers=1)
만약 Uvicorn이 워커를 N개 띄우면, 각 워커 프로세스가 vLLM 엔진을 각자 로드합니다. GPU 메모리가 N배로 소비되고, 모델 로딩 시간도 N배가 됩니다. 이미 Thinker가 GPU 메모리의 대부분을 쓰는 상황에서 워커를 2개만 띄워도 GPU 메모리가 부족합니다. 사실상 멀티워커는 불가능합니다.
각 모델을 별도 서버로 분리하면 워커를 늘릴 수도 있었겠지만, 이 경우 ‘Thinker → Talker’ 간 임베딩 전달이 네트워크를 타게 됩니다. 수천 차원의 부동소수점 텐서를 매 스텝마다 네트워크로 전송하면 zero-copy의 이점을 모두 잃게 되므로, 이를 아키텍처 설계 단계에서 제외했습니다.
workers=1의 위험 해결
워커가 하나라는 것은, 어디선가 동기 블로킹이 발생하면 동시 접속한 모든 사용자의 요청이 일제히 멈춘다는 뜻입니다. 요청 A의 텐서 연산이 이벤트 루프를 점유하는 동안, 요청 B는 HTTP 응답조차 받지 못합니다.
해결: 끝에서 끝까지 async chain
이 문제를 해결하기 위해 요청 처리 경로 전체를 async/await로 구성했습니다.
generate_streaming         (async)
    → ...                  (async)
      → run_thinker_talker (async)
        → run_thinker      (async task)
        → run_talker       (async task)
      → run_voicebox       (async)
API 엔드포인트부터 최종 오디오 생성까지 모든 함수가 async입니다. 이벤트 루프를 블로킹하는 지점이 없으므로, 하나의 워커에서도 여러 요청을 인터리빙(Interleaving) 처리할 수 있습니다.
CPU-bound 작업은 스레드 풀로 위임
async/await는 오래 걸리는 일을 기다리는 동안 다른 일을 처리하게 해주는 구조이지만, 모든 종류의 작업에 만능은 아닙니다. 특히 텐서 계산이나 직렬화처럼 CPU를 계속 붙잡고 계산하는 작업은 그동안 현재 실행 흐름을 막아버릴 수 있습니다. 그래서 이런 작업은 이벤트 루프에서 직접 처리하지 않고, 별도의 스레드 풀(Thread Pool)로 넘겨서 돌리게 했습니다. 이렇게 하면 메인 이벤트 루프는 막히지 않고, 다른 요청이나 다른 비동기 작업을 계속 처리할 수 있습니다. 여기서 중요한 포인트는 두 가지입니다.
1. 이벤트 루프 보호입니다.
비동기 서버의 핵심은 이벤트 루프가 빠르게 제어권을 주고받으면서 여러 요청을 동시에 다루는 것입니다. CPU-bound 작업이 이벤트 루프 위에서 직접 돌면 그 순간 다른 요청들이 기다리게 됩니다. 스레드 풀로 넘기면, 이벤트 루프는 그 작업이 끝나기를 기다리기만 하고 자기 자신은 계속 다른 일을 할 수 있습니다.
2. PyTorch 연산의 특성입니다.
파이썬은 보통 GIL 때문에 CPU 작업의 병렬성이 제한되는데, PyTorch의 무거운 연산은 내부적으로 C++에서 수행되면서 GIL을 해제하는 경우가 많습니다. 그래서 이런 연산은 스레드 풀로 넘겨도 실제로 괜찮은 동시성을 얻을 수 있었습니다.
VoiceBox 동시 실행 제어
VoiceBox는 GPU 메모리를 집중적으로 사용하는 보코더이므로, 동시에 너무 많은 요청이 들어오면 OOM이 발생합니다. asyncio.Semaphore로 동시 합성 수를 제한합니다.
async with voicebox_semaphore:
    async for audio, ended_turn in tts_pipeline.stream_inference(...):
        yield audio
세마포어 덕분에 동시 합성 수가 상한을 넘으면 대기하게 되며, GPU 메모리 초과 없이 안정적으로 동시 처리할 수 있습니다.
앞서 설명한 Cascaded Streaming Pipeline — Thinker와 Talker를 asyncio.create_task()로 병렬 실행하고 비동기 큐로 연결하는 구조 — 도 이 async chain 위에서 동작합니다. Single worker임에도 여러 요청이 이벤트 루프에서 인터리빙 처리되며, CPU-bound 작업은 스레드 풀로, GPU-bound 작업은 세마포어로 제어하여 하나의 프로세스 안에서도 동시성을 확보했습니다.
8. 같은 모델, 다른 요구사항: Latency-First vs Quality-First
파이프라인과 동시성 구조가 잡힌 뒤에는, 서비스 품질과 운영 안정성을 위한 선택들이 남아 있었습니다.
모든 사용 시나리오가 같은 최적화를 원하지는 않습니다.
- 실시간 대화: 첫 응답이 빠르게 나와야 합니다. 음성 품질은 약간 양보할 수 있습니다.
- 콘텐츠 생성: 시간은 좀 걸려도 되니, 고품질의 자연스러운 음성 결과물이 필요합니다.
VoiceBox의 청크(Chunk) 크기가 이 트레이드오프(Trade-off)를 결정합니다. 작은 청크는 속도는 빠르지만 문맥이 부족해 음질이 떨어지고, 큰 청크는 속도가 느리지만 더 자연스러운 음성을 만듭니다.
| 모드 | 청크 크기 | 첫 응답 | 음성 품질 | 시나리오 |
|---|---|---|---|---|
| Latency-First | 작음 | 빠름 | 보통 | 실시간 대화, 챗봇 |
| Quality-First | 큼 | 느림 | 높음 | 콘텐츠 생성, TTS |
우리는 클라이언트가 요청 단위로 전략을 유연하게 선택할 수 있게 만들었습니다.
{
  "model": "kanana-o",
  "stream": true,
  "latency_first": true
}
이를 통해 같은 서버, 같은 모델, 같은 GPU에서 실시간 대화와 고품질 TTS를 동시에 서비스할 수 있습니다.
9. 서버 시작 시 준비: 워밍업과 워터마킹
콜드 스타트 제거
PyTorch 모델의 첫 번째 추론은 CUDA 커널 컴파일, 메모리 할당 등으로 인해 이후 추론보다 수 배 느립니다. 서버 시작 후 첫 번째 사용자가 이 비용을 고스란히 부담하게 됩니다.
이를 방지하기 위해, 서버 시작 시 VoiceBox를 Latency-First 모드와 Quality-First 모드 각각에 대해 더미 토큰으로 미리 실행해 웜업(Warm-up) 과정을 거칩니다. 이 과정에서 CUDA 커널을 사전 컴파일하고 메모리 할당 패턴을 안정화하며, torch.compile 최적화도 이 시점에 적용됩니다.
워터마킹
최근 AI가 생성한 음성의 품질이 점점 자연스러워지면서, "이 음성이 AI가 만든 것인가?"를 판별하는 것이 중요해지고 있습니다. Kanana-Omni Server는 윤리적인 AI 생태계 구축을 위해서 모든 생성 음성에 워터마크를 자동 삽입합니다. 모델 고유의 식별자를 인코딩한 메시지를 일반 사람은 들을 수 없는 대역대에 삽입하지만, 자체 검증 도구로 Kanana-O가 생성한 음성인지 식별할 수 있습니다.
이러한 워터마크 모델도 서버 시작 시 짧은 오디오와 긴 오디오로 워밍업하여, 첫 요청부터 일관된 지연 시간을 보장합니다.
10. OpenAI 호환: 생태계의 힘을 빌리다
아무리 잘 만든 서버라도, 사용하기 어려우면 개발자들에게 채택되지 않습니다. Kanana-Omni Server는 외부 인터페이스를 업계 표준으로 자리 잡은 OpenAI의 Chat Completions API 규격과 100% 호환되도록 구현했습니다.
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="token")

response = client.chat.completions.create(
    model="kanana-o",
    modalities=["text", "audio"],
    audio={"voice": "preset_spk_1"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "input_audio", "input_audio": {"data": audio_b64}},
            {"type": "text", "text": "이 오디오를 요약해줘"}
        ]
    }]
)
사용자는 엔드포인트 URL 주소만 바꾸면 기존 작성했던 OpenAI SDK 코드를 그대로 재활용할 수 있습니다… 또한 modalities 필드로 텍스트 전용 / 텍스트+오디오 모드를 요청 단위로 전환할 수 있고, 다양한 입력 검증 규칙으로 잘못된 요청에 대해 구체적인 에러 메시지를 반환합니다.
11. 돌아보며
Kanana-O 서빙을 최적화하면서 얻은 교훈을 정리합니다.
모델의 구조를 알면, 범용 해법보다 나은 선택지가 생깁니다
- 공유 메모리 풀을 사전 할당할 수 있었던 것은 Thinker→Talker로 전달되는 데이터의 크기와 형태를 정확히 알고 있었기 때문입니다.
- Cascaded Streaming Pipeline을 구현할 수 있었던 것은 스테이지 구조가 고정되어 있기 때문입니다.
- GPU 메모리를 정밀 분배할 수 있었던 것은 각 컴포넌트의 요구량을 측정했기 때문입니다.
- 범용 프레임워크에서는 이 모든 것이 "미리 알 수 없는 것"이기 때문에, 보수적으로 처리할 수밖에 없습니다.
프로덕션은 추론 성능만이 아닙니다
- 모델 서빙을 평가할 때 토큰/초, 지연시간 같은 단순 추론 성능만 보기 쉽습니다.
- 하지만 실제 서비스에서는 워터마킹, 입력 검증, 에러 핸들링, 헬스 모니터링, 콜드 스타트 제거 같은 운영 요소가 서비스 안정성을 좌우합니다.
- 이런 것들은 모델 학습이 끝난 뒤에야 비로소 드러나는 문제들이고, 서비스 요구사항에 맞춰 직접 풀어야 합니다.
기능을 넓히지 않은 대신, 구조를 더 깊이 다듬을 수 있었습니다
- Kanana-Omni Server는 "Kanana-O의 음성 대화 서빙"이라는 좁은 범위만 지원합니다. 다중 모델 지원도, 이미지 생성도, 멀티노드 분산 추론도 없습니다.
- 하지만 이 제약 덕분에 소규모 코드베이스로 엔지니어가 전체를 파악하고 통제할 수 있는 강력한 시스템을 만들 수 있었습니다.
현재 Kanana-O는 베타테스트를 진행중에 있습니다. 이 글에서 다룬 것 외에도 새로이 최적화할 부분들이 발견되고 수정되는 중이며, 더 좋은 서비스를 만들기 위해 노력중입니다.
긴 글 읽어주셔서 감사합니다.