Engineering
MySQL 3분 vs ClickHouse 0.3초 — 같은 쿼리입니다
2026년 5월 11일
원문에서 보기 ↗
들어가며
최근 MySQL 기반 서비스들로부터 ClickHouse 도입 문의를 받으면서 직접 검토하고 도입하게 되었습니다. 실제 운영 중인 서비스에 적용하며 성능을 확인할 수 있었고, 기술과 경험을 공유하고자 글을 작성했습니다.
ClickHouse란?
ClickHouse는 데이터를 빠르게 읽기 위해 만들어진 데이터베이스입니다. MySQL은 행(Row) 단위로 데이터를 저장하고, ClickHouse는 열(Column) 단위로 데이터를 저장합니다.
행 단위 DBMS는 데이터를 블록 단위로 저장하고 읽기 때문에 일부 열만 필요한 쿼리라도 해당 행 전체 블록을 메모리에 올려야 합니다. 즉, 불필요한 열 데이터까지 I/O가 발생합니다.
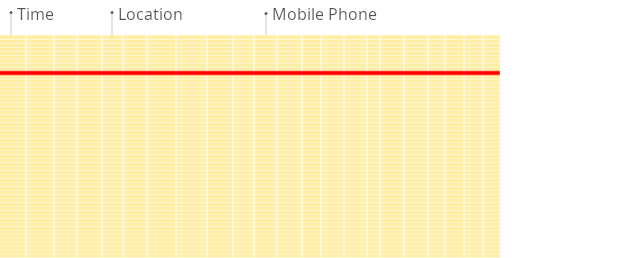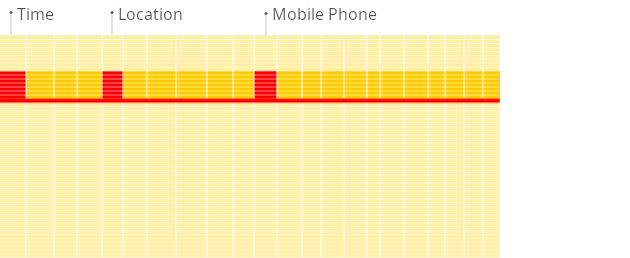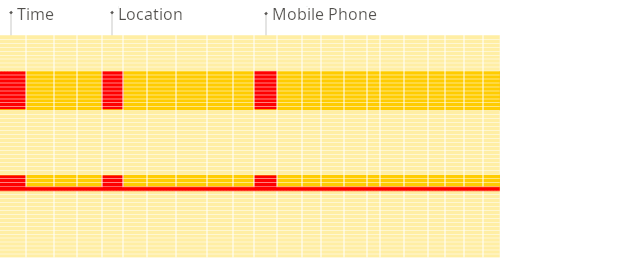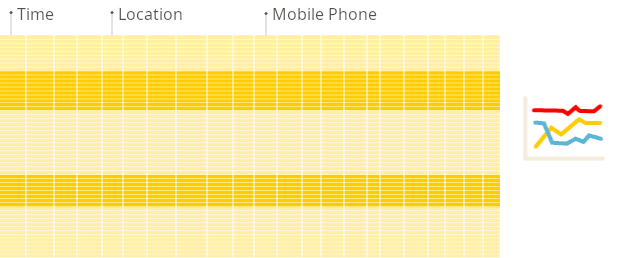 (source: https://clickhouse.com/docs/intro)
반면 열 단위 DBMS는 열 단위로 데이터를 순차 저장하기 때문에 쿼리에 필요한 열만 선택적으로 읽을 수 있어 불필요한 I/O를 방지하고 분석 쿼리 성능이 크게 향상됩니다.
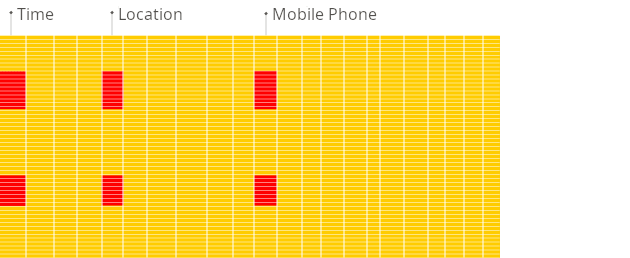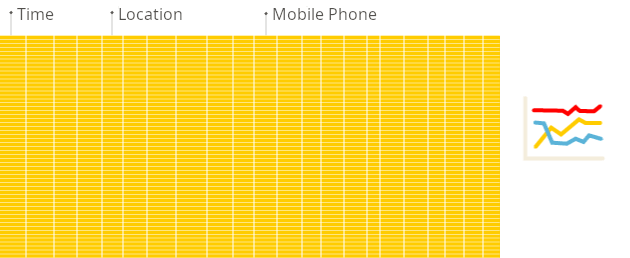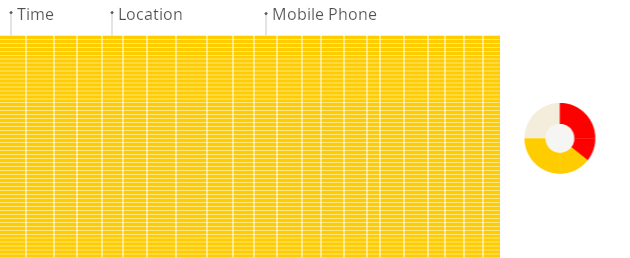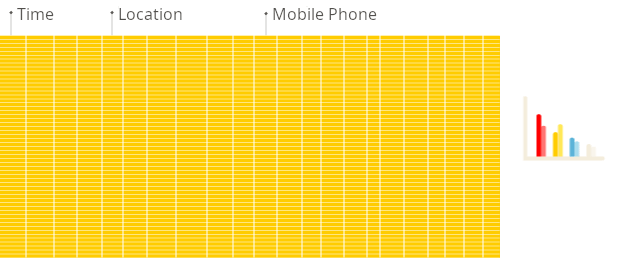 (source: https://clickhouse.com/docs/intro)
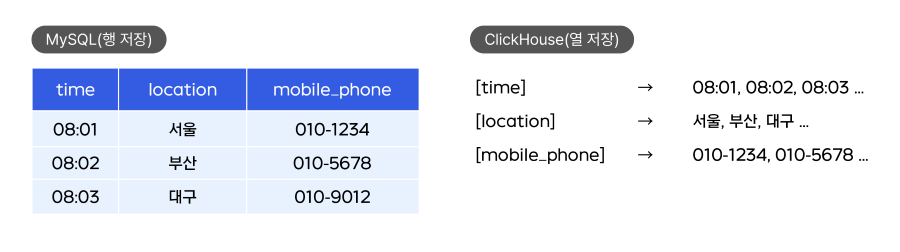
따라서 SUM, COUNT, AVG 같은 집계 쿼리를 실행할 때 MySQL은 모든 열을 읽어야 하지만 ClickHouse는 필요한 열만 읽기 때문에 대량 데이터 조회에서 빠른 성능을 냅니다.
MySQL의 한계, 그리고 ClickHouse
MySQL은 트랜잭션, 단건 조회/수정/삭제 작업에 현재도 널리 사용됩니다. 다만, 한계가 있습니다.
MySQL이 한계를 보이는 순간
데이터가 수천만 건을 넘어가면서 집계 쿼리 하나가 30초, 1분, 그리고 타임아웃으로 이어지기도 합니다. 인덱스를 아무리 잘 잡아도, 읽어야 할 데이터 자체가 너무 많으면 성능 개선이 어렵습니다. MySQL은 행(Row) 단위로 저장하기 때문에 SUM(amount) 하나를 구하려 해도 모든 칼럼을 통째로 읽어야 해서 느립니다. 데이터가 쌓일수록 이 문제는 피할 수 없습니다.
ClickHouse가 돌파한 지점
| MySQL의 한계 | ClickHouse의 해결 |
|---|---|
| 집계 쿼리 = 전체 행 풀스캔 | 필요한 칼럼만 읽는 열 저장 구조 |
| 인덱스로 한계, 수억 건은 답 없음 | 파티션 + 정렬 키로 읽는 범위 자체를 줄임 |
| 무거운 쿼리 1개가 전체 DB 영향 | 병렬 처리로 쿼리 간 간섭 없음 |
| 대용량 적재 시 성능 저하 | 배치 INSERT에 최적화된 구조 |
| 저장 공간 그대로 | 열 단위 압축으로 용량 80% 이상 절감 |
ClickHouse를 다루는 올바른 이해
다만, MySQL을 사용하듯이 ClickHouse를 사용하면 오히려 MySQL보다 느리거나 데이터가 기대와 다르게 동작할 수 있습니다. ClickHouse를 단순히 "빠른 MySQL"로 이해해서는 안 됩니다.
두 DB는 해결하려는 문제가 다르므로 이 차이를 이해하고 사용해야 효과적으로 운영할 수 있습니다.
OLTP vs OLAP — 설계 철학이 다릅니다
| 구분 | OLTP | OLAP |
|---|---|---|
| 대표 DB | MySQL, PostgreSQL | ClickHouse, BigQuery |
| 주요 작업 | 단건 조회, INSERT/UPDATE/DELETE, 트랜잭션 | 대량 집계, 통계, 분석 |
| 최적화 방향 | 정합성, 트랜잭션 보장 | 빠른 읽기, 압축, 처리량 |
| 저장 단위 | 행(Row) | 열(Column) |
| 설계 철학 | "1건도 틀리면 안 된다" | "1억 건을 빠르게 본다" |
OLTP는 트랜잭션 처리에 최적화된 설계입니다. ACID(원자성·일관성·격리성·지속성)를 보장하며, 결제 도중 오류가 나면 전체가 롤백 되고 데이터는 항상 일관된 상태를 유지합니다. 단건 조회·수정·삭제처럼 "1건도 틀리면 안 된다"라는 워크로드에 적합합니다.
OLAP는 분석 처리에 최적화된 설계입니다. 트랜잭션과 같은 다중 테이블 정합성 보장은 설계 범위 밖이며, 수십억~수조 개의 행을 빠르게 읽고 집계하는 것에 집중합니다. "1억 건을 빠르게 본다"라는 워크로드에 적합합니다.
MySQL은 OLTP DB이며, 트랜잭션 정합성과 단건 처리에 최적화되어 있습니다. ClickHouse는 OLAP DB이며, 모든 설계가 "대량 데이터를 빠르게 읽는다"라는 목표에 맞춰져 있습니다.
두 DB는 경쟁 관계가 아닙니다. 정합성이 절대적인 트랜잭션 워크로드는 MySQL이, 대량 데이터를 빠르게 집계·분석하는 워크로드는 ClickHouse가 맡는 구조로 함께 사용하는 것이 올바른 접근입니다.
ClickHouse 적합 케이스
이런 상황이면 ClickHouse가 효과적입니다.
| 상황 | 예시 |
|---|---|
| 대량 데이터의 집계/통계 조회 | 일별/월별 매출 합산, 사용자 행동 분석 |
| 데이터가 계속 쌓이는 로그성 테이블 | 이벤트 로그, 결제 이력, 접속 기록 |
| 특정 칼럼만 골라서 분석하는 쿼리 | SELECT SUM(amount) WHERE date BETWEEN ... |
아래 쿼리 패턴을 사용한다면 ClickHouse에서 성능을 확인할 수 있습니다.
패턴 1 - 날짜 범위 + 집계
-- AS-IS: MySQL에서 30초 이상 걸리던 쿼리
SELECT DATE(created_at) AS day, COUNT(*) AS cnt, SUM(amount) AS total
FROM orders
WHERE created_at BETWEEN '2024-01-01' AND '2024-12-31'
GROUP BY day
ORDER BY day;

-- TO-BE: ClickHouse로 이관 → 1초 이내
-- 구조 동일
💡 적용 추천: 일별/월별 리포트, 대시보드 통계
패턴 2 - 특정 조건 필터 후 대용량 COUNT
-- 수천만 건 테이블에서 특정 상태값 집계
SELECT status, COUNT(*) AS cnt
FROM user_events
WHERE created_at >= '2024-06-01'
GROUP BY status;
💡 적용 추천: 사용자 행동 분석, 이벤트 로그 집계
패턴 3 - 다중 그룹핑 통계
-- 서비스별 + 날짜별 + 타입별 3중 집계
SELECT service_id, DATE(created_at), event_type, SUM(amount)
FROM transaction_log
WHERE created_at BETWEEN '2024-01-01' AND '2024-12-31'
GROUP BY service_id, DATE(created_at), event_type;
💡 적용 추천: 정산, 정기 리포트, 매출 분석
ClickHouse 부적합 케이스
ClickHouse가 맞지 않는 패턴도 확인해야 합니다. 다음과 같은 상황에서는 MySQL을 그대로 사용하는 것을 권장합니다.
1. 단건 조회/단건 INSERT
SELECT * FROM users WHERE user_id = 12345;
앞서 살펴본 바와 같이 ClickHouse는 데이터를 열(Column) 단위로 저장합니다. 열 저장 구조는 같은 타입의 데이터가 연속으로 모여 있어야 압축도 잘 되고 집계도 빠릅니다. 반대로 단건 조회는 id, name, age, amount처럼 서로 다른 칼럼을 각각 따로 찾아서 조합해야 합니다. 열이 흩어져 있으니 오히려 더 많은 I/O가 발생합니다.
INSERT도 마찬가지입니다. ClickHouse는 대량 배치 INSERT에 최적화되어 있습니다. 열 단위로 데이터를 모아서 한꺼번에 압축 저장하기 때문에 건별 INSERT는 비효율적입니다. 1건씩 INSERT하면 매번 새로운 파트(Part)가 생성되어 오히려 성능이 크게 저하됩니다.
즉 ClickHouse는 "많이 모아서 한 번에"에 특화된 DB이며, 단건 조회/INSERT처럼 "하나씩 처리"하는 패턴에는 MySQL이 적합합니다.
2. 트랜잭션(결제, 주문 등)
BEGIN;
UPDATE orders SET status = 'paid' WHERE order_id = 999;
UPDATE stock SET quantity = quantity - 1 WHERE item_id = 1;
COMMIT;
ClickHouse는 트랜잭션을 지원하지 않습니다. 이는 ClickHouse가 의도적으로 선택한 트레이드오프입니다. 속도를 얻기 위해 정확도(정합성)를 일부 포기한 설계입니다. MySQL은 ACID(원자성·일관성·격리성·지속성)를 보장해 결제 도중 오류가 나면 전체가 롤백 되고, 데이터는 항상 일관된 상태를 유지합니다. ClickHouse는 이 복잡한 정합성 보장 대신 "빠르게 많이 쓰고, 빠르게 많이 읽는다"에 집중했습니다. 덕분에 수천만~수억 건의 집계를 초 단위로 처리할 수 있습니다.
결제, 주문처럼 "틀리면 안 되는" 작업은 MySQL, 통계, 분석처럼 "빠르게 봐야 하는" 작업은 ClickHouse를 사용하면 효과적입니다.
3. 빈번한 UPDATE/DELETE
UPDATE orders SET status = 'cancel' WHERE order_id = 999;
DELETE FROM logs WHERE created_at < '2023-01-01';
ClickHouse에서 UPDATE/DELETE는 동작 구조가 MySQL과 다릅니다.
UPDATE
→ ReplacingMergeTree 엔진으로 대체 동일 키로 새 데이터를 INSERT 하면 백그라운드에서 중복을 제거하는 방식입니다.
→ 즉시 반영이 안 되고 Merge 타이밍에 처리됩니다.
DELETE
→ Mutation으로 동작(ALTER TABLE ... DELETE WHERE ...)
→ 해당 파트를 통째로 재작성하는 방식이므로 처리 비용이 크고 속도가 느립니다. 소량 건별 삭제에는 부적합합니다.
기술적으로 불가능한 것은 아니지만, 빈번한 단건 UPDATE/DELETE에는 설계 자체가 맞지 않습니다. 이런 패턴은 MySQL이 적합합니다.
MySQL vs ClickHouse 성능 테스트 비교
이 테스트는 "ClickHouse가 잘하는 영역(집계, 대용량 분석)에서 실제로 얼마나 차이가 나는지"를 확인하기 위한 목적으로 진행했습니다. 앞서 설명한 대로 두 DB는 경쟁 관계가 아니라 역할이 다릅니다. ClickHouse의 도입 필요성을 판단하기 위한 참고 수치로 활용하시기 바랍니다. 실제 도입 시에는 서비스의 쿼리 패턴에 맞는 스키마와 정렬 키 설계가 선행되어야 합니다.
1. 서버 스펙
| 항목 | MySQL 서버 | ClickHouse 서버 | 비고 |
|---|---|---|---|
| CPU | 16코어 | 16코어 | taskset으로 동일하게 맞춤 |
| MEM(RAM) | 64GB | 64GB | 동일 |
| 디스크 | HDD 8.7TB | HDD 1TB | 타입 동일 |
2. 테스트 조건
| 항목 | 내용 |
|---|---|
| 데이터 | 5,000만 건 이벤트 로그(6개 칼럼) |
| 측정 방식 | 3회 반복 측정 후 중간값 채택 |
| 데이터 범위 | 2023-01-01 ~ 2024-12-31(2년치) |
3. 테스트 테이블 스키마
MySQL은 구조상 PK가 필수이며, 행을 유일하게 식별하는 고유 식별자로 동작합니다.
ClickHouse의 PK는 개념이 다릅니다. ORDER BY로 지정한 정렬 키가 PK 역할을 하며, 고유성 보장이 아닌 데이터 탐색 범위를 줄이기 위한 용도로 사용됩니다.
-- MySQL
CREATE TABLE IF NOT EXISTS events (
    id          BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id     BIGINT NOT NULL,
    service_id  INT NOT NULL,
    event_type  VARCHAR(20) NOT NULL,
    amount      DECIMAL(15,2) NOT NULL,
    status      VARCHAR(10) NOT NULL,
    created_at  DATETIME NOT NULL,
    PRIMARY KEY (`id`),
    INDEX idx_created_at_service_event (created_at, service_id, event_type)
    -- MySQL은 구조상 PK가 필수이기 때문에 id 칼럼을 PK로 두되, ClickHouse의 ORDER BY 정렬 키와 동일한 구성으로 복합 인덱스를 별도 생성하여 조건을 맞춤
) ENGINE=InnoDB;

-- ClickHouse
CREATE TABLE events (
    id          UInt64,
    user_id     UInt64,
    service_id  UInt32,
    event_type  LowCardinality(String),
    amount      Decimal(15,2),
    status      LowCardinality(String),
    created_at  DateTime
)
ENGINE = MergeTree()
ORDER BY (created_at, service_id, event_type);
-- ORDER BY = 정렬 키. 쿼리 필터 조건과 맞출수록 성능 향상
같은 데이터, 같은 쿼리이지만 결과는 달랐습니다.
테스트 1. 집계 쿼리 속도(핵심)
쿼리 A: GROUP BY 단일 — 월별 금액 합산
SELECT DATE_FORMAT(created_at, '%Y-%m'), SUM(amount)
FROM events
GROUP BY 1 ORDER BY 1;
| 항목 | MySQL | ClickHouse | 차이 |
|---|---|---|---|
| 실행 시간 | 49초 | 0.2초 | 약 245배 빠름 |
쿼리 B: GROUP BY 다중 — 서비스별 + 날짜별 + 타입별 3중 집계
SELECT service_id, DATE(created_at), event_type, COUNT(*), SUM(amount)
FROM events
WHERE created_at BETWEEN '2024-01-01' AND '2024-12-31'
GROUP BY 1, 2, 3;
| 항목 | MySQL | ClickHouse | 차이 |
|---|---|---|---|
| 실행 시간 | 208초(=3분28초) | 0.3초 | 약 693배 빠름 |
쿼리 C: COUNT — 조건부 카운트 + DISTINCT
SELECT event_type, status,
       COUNT(*), COUNT(DISTINCT user_id), SUM(IF(amount > 50000, 1, 0))
FROM events
WHERE created_at BETWEEN '2024-06-01' AND '2024-12-31'
GROUP BY event_type, status;
| 항목 | MySQL | ClickHouse | 차이 |
|---|---|---|---|
| 실행 시간 | 67초 | 0.2초 | 약 335배 빠름 |
쿼리 D: MySQL View vs ClickHouse View
| 항목 | MySQL View | ClickHouse View | 차이 |
|---|---|---|---|
| 실행 시간 | 94초 | 0.398초 | 약 236배 빠름 |
ClickHouse는 MySQL과 마찬가지로 VIEW를 제공합니다. 원리는 같지만, ClickHouse는 데이터를 열(column) 단위로 저장하는 구조 덕분에 집계 쿼리 시 필요한 열만 읽어 I/O를 최소화합니다. 같은 VIEW 개념임에도 MySQL 대비 약 236배 빠른 성능을 보입니다.
추가: ClickHouse Materialized View 활용
| 항목 | ClickHouse View | ClickHouse Materialized View | 차이 |
|---|---|---|---|
| 실행 시간 | 0.398초 | 0.1초 | 약 4배 빠름 |
ClickHouse에서 성능을 더 끌어올리고 싶다면 Materialized View(MV)를 활용할 수 있습니다.
일반 View가 조회 시점마다 원본 테이블을 다시 읽는 반면, MV는 데이터가 INSERT 될 때 집계를 미리 계산해 별도 테이블에 저장합니다.
조회 시에는 이미 집계된 결과를 바로 반환하기 때문에 0.398초 → 0.1초로 추가 단축됩니다. 대시보드처럼 동일한 집계를 반복 조회하는 서비스에 특히 효과적입니다.
테스트 2. 동시 요청 처리(집계 쿼리 10개 동시 실행)
| 항목 | MySQL | ClickHouse |
|---|---|---|
| 최소 응답시간 | 약 48초 | 약 0.3초 |
| 최대 응답시간 | 약 48초 | 약 0.9초 |
| 평균 응답시간 | 약 48초 | 약 0.9초 |
MySQL과 달리 ClickHouse는 병렬 처리 구조로 10개 동시 요청도 안정적으로 응답합니다. MySQL은 동시 요청 10개에 48초, ClickHouse는 0.9초. 같은 쿼리입니다.
테스트 3. 저장 용량(압축률)
| 항목 | MySQL | ClickHouse | 절감 |
|---|---|---|---|
| 5,000만 건 데이터 용량 | 5.6GB | 2.6GB | 약 54% |
ClickHouse는 열(column) 단위 저장 + LZ4 압축 덕분에 같은 데이터를 훨씬 작게 저장합니다. 스토리지 비용 절감은 물론, 디스크 I/O가 줄어 쿼리 속도에도 직접 영향을 줍니다.
테스트 4. INSERT 속도(대량 적재)
| 항목 | MySQL | ClickHouse | 차이 |
|---|---|---|---|
| 5,000만 건 적재 시간 | 849초(14분) | 49초 | 약 17배 빠름 |
MySQL은 약 14분, ClickHouse는 1분 이내에 완료되었습니다. MySQL은 행 단위로 데이터를 즉시 디스크에 쓰고 인덱스를 갱신하지만, ClickHouse는 데이터를 메모리에 모아 열 단위로 일괄 압축한 뒤 디스크에 한 번에 씁니다. 여기에 멀티 코어 병렬 처리까지 더해져 대량 적재에서 빠른 속도를 냅니다.
테스트 5. MySQL 호환성
| 검증 항목 | MySQL 문법 그대로 CH에서 실행 | 결과 일치 |
|---|---|---|
| DATE_FORMAT, 날짜 함수 | 동작 | 일치 |
| IF / CASE WHEN | 동작 | 일치 |
| LIKE / IN / BETWEEN | 동작 | 일치 |
| HAVING + 서브쿼리 | 동작 | 일치 |
| MySQL Client(포트 7004) 접속 | 접속 성공 | - |
동일 문법, 동일 결과로 쿼리 동일성을 검증했습니다. MySQL에 익숙하다면, ClickHouse 쿼리 문법 자체에 대한 진입 장벽은 낮습니다.
NHN Cloud의 ClickHouse 활용 케이스
1. Notification Hub
NHN Cloud의 Notification Hub는 SMS, Email, Push 등 다양한 채널로 메시지를 발송·관리하는 통합 메시징 서비스입니다.
카카오 비즈센터에서 제공하는 통계 API는 다양한 검색 조건으로 통계를 조회하는 기능을 제공하지 않습니다.
이에 따라 카카오 비즈센터의 전체 통계 데이터를 ClickHouse에 저장한 뒤, Notification Hub 고객에게 다양한 검색 조건으로 통계를 조회할 수 있도록 제공하는 구조로 구성했습니다. 이는 Notification Hub 전체 발송 통계에 ClickHouse를 적용하기 앞서, 서비스 안정성을 검증하기 위한 PoC(proof of concept, 개념 증명) 목적으로 카카오 통계에 먼저 도입했습니다.
ClickHouse 도입 후 달라진 점은 크게 네 가지입니다.
1) 적재 파이프라인 단순화 - MySQL에서 필요했던 사전 전처리·병합 과정이 사라지고, raw 데이터를 그대로 적재하는 단순한 구조로 바뀌었습니다.
2) 데이터 보정 편의성 향상 - ReplacingMergeTree 엔진을 활용해 멱등성을 보장합니다. 기존 데이터를 삭제하지 않고도 보정 데이터를 추가할 수 있고, 중복 적재가 발생해도 문제가 없습니다.
3) 누락 데이터 확인 용이 - 병합 전 raw 데이터가 그대로 쌓이기 때문에, 어떤 데이터가 누락됐는지 훨씬 빠르게 파악할 수 있습니다.
4) 조회 성능 향상 - 1,000만 건 이상의 데이터에 다양한 필터 조건으로 집계 쿼리를 수행했을 때 356ms 수준의 응답 속도를 확인했습니다. 사전 전처리 없이 조회 시점에 집계하는 방식으로도 충분히 서비스를 제공할 수 있음을 검증했습니다. 카카오 통계 PoC를 통해 안정성과 성능을 확인한 만큼, 이후 Notification Hub 전체 발송 통계로의 확대 적용도 검토 중입니다.
2. Cab-Verify
CAB은 NHN Cloud의 상품·프로젝트 라이프사이클 등을 관리하는 Framework이며, Cab-Verify는 CAB에서 사용하는 인증을 관리하는 서비스입니다. 현재 최대 1억 건의 토큰 인증 이력을 보관하고 있으며, CAB 7.0 API 토큰 인증 의무화·도입 상품 수 증가·퍼블릭 API 확대로 향후 10억 건 이상으로 증가가 예상되는 상황이었습니다.
MySQL로는 이 규모를 감당하기 어렵다는 판단 아래 ClickHouse 도입을 진행했습니다. 토큰 인증 이력 데이터를 ClickHouse에 적재하여 대규모 인증 이력 통계 조회를 고성능으로 처리하고, 향후 10억 건 규모로 확대되더라도 안정적인 조회 성능을 확보하는 것이 목표입니다.
3. Resource Watcher
NHN Cloud의 Resource Watcher는 NHN Cloud의 로그 플랫폼 개발팀에서 직접 ClickHouse를 도입하여 운영 중인 사례입니다. MySQL에서 반복적으로 발생하던 슬로 쿼리 문제를 ClickHouse로 해결한 경험을 공유해 주셨습니다.
Framework에서는 하루 한 번 resource 목록을 배치로 조회하는 과정에서 Resource Watcher의 MySQL에 슬로 쿼리가 반복 발생했습니다. CPU 사용량이 95%를 초과하면서 MySQL이 헬스 체크(health check)에 응답하지 못하는 상황이 발생했고, 이로 인해 DB role change(failover, 장애 조치)가 발생할 위험이 있었습니다.
배치 조회 트래픽을 ClickHouse로 분리하여 MySQL의 부하를 제거했습니다. 기존 API를 ClickHouse 기반 신규 API로 교체하고, 쿼리도 기존 3개에서 1개로 통합했습니다. 결과적으로 반복 발생하던 슬로 쿼리가 해소되었고, 배치 조회가 서비스 트래픽에 영향을 주지 않는 구조로 개선되었습니다.
1) MySQL 슬로 쿼리 해소 - DB CPU 부하 및 장애 조치(failover) 위험을 제거했습니다.
2) 배치 조회와 서비스 트래픽의 DB 레벨 격리 - 배치와 서비스가 각각 다른 DB를 바라보도록 분리하여 서로 영향을 주지 않고 독립적으로 동작합니다.
3) 쿼리 구조 개선으로 조회 성능 향상 - LIMIT/OFFSET 쿼리 수행 시 발생하던 성능 문제가 개선되었습니다.
타사 ClickHouse 사용 사례
최근에는 많은 기업들이 다양한 목적으로 ClickHouse를 도입해 사용하고 있습니다. 대표적인 사례를 소개합니다.
| 회사 | 도입 목적 | 처리 규모 | 핵심 성과 |
|---|---|---|---|
| 카카오페이 증권 | 로그 플랫폼 전환 (OpenSearch → ClickHouse) | 일 41TB, 200억 건 로그 | 비용 85% 절감, 지연 20초 이내 |
| 토스 | 랭킹 서비스 개선 | 인기 랭킹 시간당 1억 건 로그 | 실시간 랭킹 제공 (1초 미만 응답) |
| SK텔레콤 | 고객 여정 데이터를 기반으로 한 사내 서비스 개선 | 2억 건 가량의 고객 행동 데이터 | 응답 10초 이내 |
| Netflix | 대용량 로그 핫 티어 | 일 5PB, 초당 1,060만 이벤트 | 로그 생성 후 20초 이내 검색 가능 |
| LINE Yahoo Japan | Kafka 인프라 모니터링 | 초당 700만 행 | 24대 서버로 전사 인프라 관측성 확보 |
- https://tech.kakaopay.com/post/pallas-v2-log-platform/
- https://www.youtube.com/watch?v=8P2OL7cwFEU
- https://devocean.sk.com/blog/techBoardDetail.do?ID=167943&boardType=techBlog
- https://clickhouse.com/blog/netflix-petabyte-scale-logging
- https://clickhouse.com/jp/blog/line-yahoo-jp
- https://clickhouse.com/user-stories
마치며
지금까지 ClickHouse가 무엇인지, MySQL과 대비하여 구조적으로 어떻게 다르고 왜 빠른지 알아보았습니다. 나아가 설계 철학부터 다른 두 데이터베이스를 각각 어떤 케이스에 활용하면 적합한지 살펴보았고, 실제로 ClickHouse를 활용하는 사례들을 소개했습니다. MySQL의 집계 쿼리 성능 한계로 슬로 쿼리와 타임아웃을 자주 마주하시는 분들, ClickHouse에 관심이 있으시거나 도입을 고려하시는 분들 등 많은 분들께 도움이 되길 바라며 글을 마치겠습니다. 긴 글을 읽어 주셔서 감사합니다. 😀
