Backend
카카오 개발자들을 위한 공용 Message Streaming Platform - Kafka & RabbitMQ
loki.god카카오
2021년 12월 23일
원문에서 보기 ↗안녕하세요, 인프라팀 loki 입니다.
오랜 시간 인프라에서 TF단위로 소소하게 제공하던 공용 Kafka와 공용 RabbitMQ의 사용량이 점점 커지고, 많은 서비스팀에서 이용해 주셔서, 운영고도화를 위해 정식 MessageQueue TF 조직이 2021년에 신설되었습니다. 이에 따라 TF에서 현재 운영하고 있는 메시지 큐 서비스의 운영 현황 및 향후 목표를 공유드리고자 합니다.
운영 현황
MessageQueue TF
2016년 경까지는 Kafka와 RabbitMQ를 모든 서비스팀에서 각각 사용하고 있었으나 사용량이 계속 늘어가고 있는 상황이었습니다. 그러던 중에 “메시지 큐 시스템을 각 팀별로 각각 구성해서 사용하는 게 아니라 공동으로 사용할 수 있다면, 인프라 비용도 줄일 수 있고 서비스팀에서는 운영 리소스를 줄여 서비스 개발에 좀 더 집중할 수 있지 않을까”라는 생각으로 2016년에 스터디 그룹을 만들게 되었습니다. 그 결과 최초로 모든 서비스팀이 같이 사용할 수 있는 공용 클러스터를 같은 해인 2016년에 오픈할 수 있었습니다.
그 후로 여러 차례 성능 테스트와 튜닝 등을 거치면서 2018년도에 안정된 버전이라고 할 수 있는 Kafka 클러스터 공용 버전을 처음 오픈했습니다. 또한, 2020년에 최신 클러스터에서 신규 Kafka 버전으로 업그레이드한 후에는 서비스팀들이 가장 많이 사용하시는 클러스터이기도 합니다.
그리고 사용량이 점점 늘어나면서 저희 TF가 지원하는 범위도 점점 확대되게 되었습니다. 얼마 전에는 메시지 큐에 대한 지원을 강화하고 운영 범위를 확대 및 안정적으로 운영하기 위해 MessageQueue TF 조직이 신설되었고, 2022년에는 새로운 신규 클러스터를 오픈할 예정입니다.
Kafka 기본 구조
다음은 Kafka 도입 시의 인프라 구성도입니다.
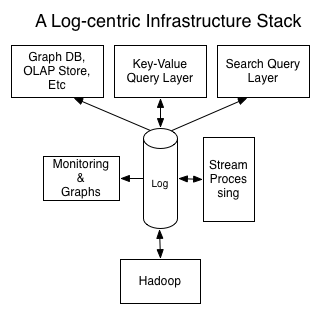
카카오에서는 서비스 규모가 거대해지고, 서비스 인프라 또한 점점 거대해지면서 MQ의 개념이 많이 사용되고 있었습니다. 그러나 그 과정에서 각각의 데이터 플랫폼을 개발자들이 직접 운영, 관리 및 유지보수하고 메시지 손실에 대한 고민도 직접 하다보니 운영 리소스 낭비가 매우 심했습니다.
그 후 컨플루언트에서 Kafka를 오픈 버전으로 정식 발표하면서, 공통된 대용량 데이터 플랫폼 개념이 등장하게 되었습니다. Kafka를 도입하게 되면 서비스팀에서 많이 사용하시는 용도에서 굉장히 안정적으로 운영이 가능하고, 대용량 트래픽을 실시간으로 처리할 수 있다는 점에서 많은 각광을 받았습니다.
RabbitMQ 기본 구조
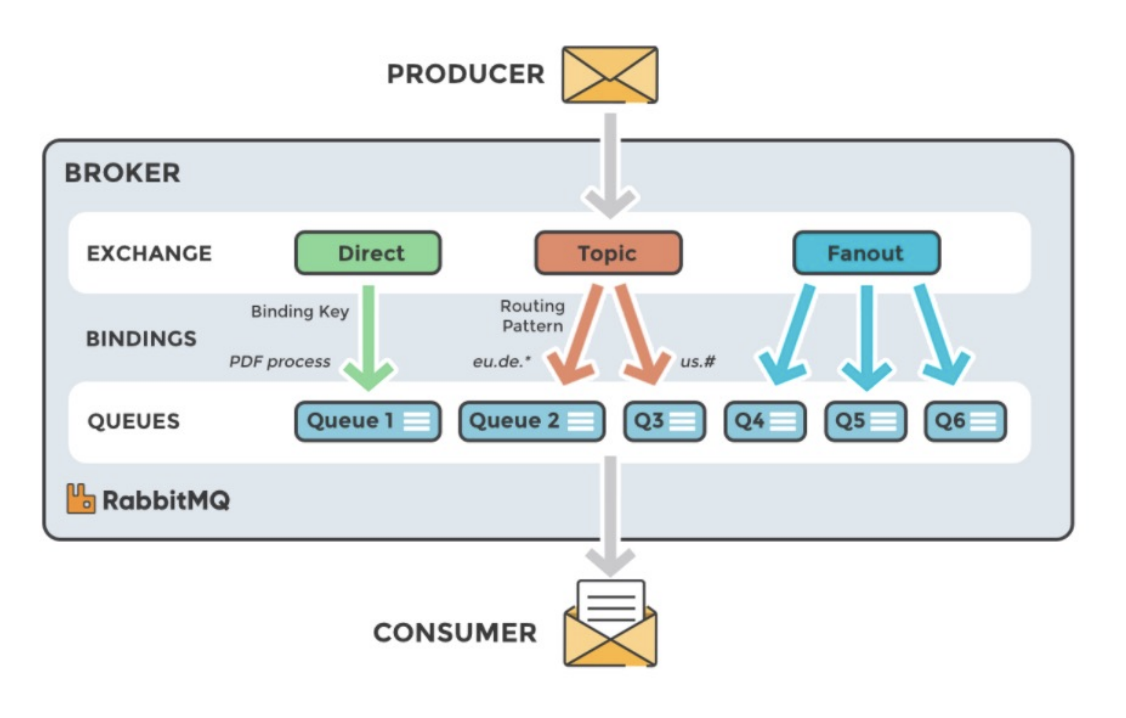
다음은 RabbitMQ입니다. RabbitMQ의 경우 실제로 Kafka와 조금 비슷한 부분도 있고 다른 부분도 있는데요, RabbitMQ의 가장 큰 특징은 메시지 라우팅 키를 통해 메시지 라우팅을 지원하는 점입니다. 주키퍼(Zookeeper) 같은 코디네이터가 별도로 없으면서 토픽 대신에 익스체인지와 Queue의 바인딩을 통해서 메시지를 소비할 수 있다는 점입니다.
Kafka는 대용량의 분산 로그 트래픽을 처리한다는 점에서 유리하다면, RabbitMQ는 높은 처리량보다는 지정된 수신인에게 원하는 방식으로 메시징을 신뢰성 있게 전달하는데 초점이 맞춰져 있습니다. 그래서 RabbitMQ 경우에는 대용량 트래픽에는 조금 불리한 점이 있는 대신 익스체인지 타입이나 라우팅 정책에 따라서 동작 방식을 선택할 수가 있는 장점이 있습니다. 이 때문에 저희 TF에서는 Kafka 뿐 아니라 RabbitMQ에 대해서도 공용 플랫폼을 제공하고 있습니다.
공용 메시지큐 시스템에 대하여
카카오의 Kafka 시스템 구성도
카카오에서 운영 중인 공용 Kafka와 공용 RabbitMQ의 시스템 구성도는 거의 비슷합니다. 이 중 공용 Kafka가 더 대용량 데이터를 다루는 만큼, Kafka를 기준으로 시스템 구성도를 그려 보았습니다.
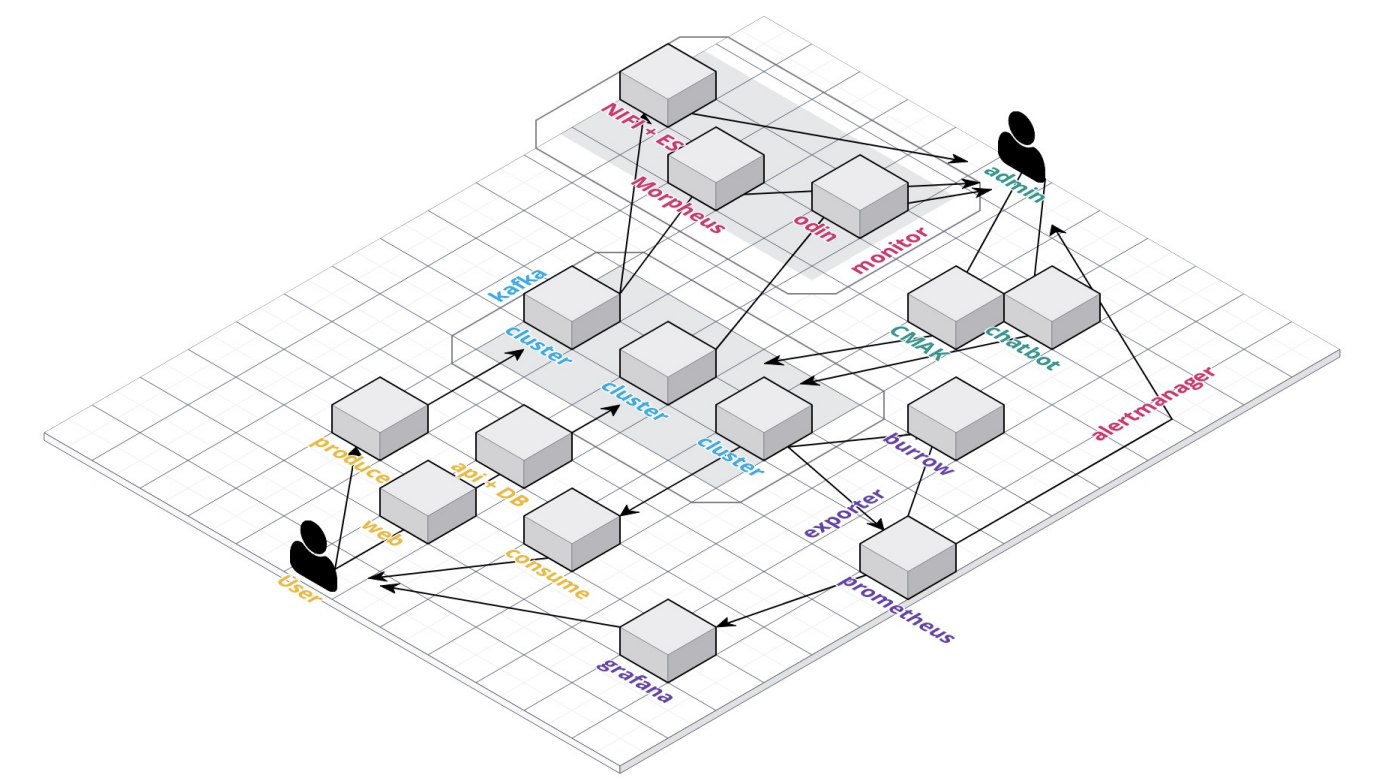
- 중앙에는 Kafka 클러스터(하늘색)가 위치합니다.
- 왼쪽 아래의 노란색 부분이 유저입니다. 유저가 데이터(메시지)를 produce 및 consume하고, 웹과 API를 통해 자신의 토픽 또는 큐 등을 관리합니다.
- 오른쪽 위의 녹색 어드민(MessageQueue TF)이 공용 Kafka 클러스터의 안정적 운영을 위해 24시간*365일 모니터링하고 있습니다. 모니터링 지표를 분석하고 장애 처리를 하기 위한 툴들도 함께 운영 및 관리 중에 있습니다.
- 또한, 유저도 자신의 로그와 메트릭을 직접 확인할 수 있도록 중앙 아래의 보라색 부분과 같이 지표를 제공하고 있습니다.
시스템 운영 도구
조금 더 구체적으로 사용 중인 시스템 도구를 소개해 드리면 다음과 같습니다.
| 운영 현황 | 사용 도구 |
|---|---|
| Kafka 로그 | NIFI + ES => 사내 와치타워(카카오톡 알람) |
| 리소스 | 사내 도구인 Morpheus, Odin |
| 지표(메트릭) 수집 | Kminion, Burrow |
| 지표 시각화 | Telegraf + InfluxDB => Prometheus + Grafana |
| 관리 및 운영 | CMAK, Chatbot |
- Kafka에서 발생하는 모든 로그는 NIFI를 통한 로그 파서 과정을 거쳐 ES(Elasticsearch, 사내 ES TF에서 관리)에 메시지를 저장합니다. 이렇게 저장된 로그는 사내의 와치타워를 통해 어드민 조직에서 실시간으로 알람을 수신하게 됩니다.
- 모든 리소스는 사내 도구인 Morpheus와 Odin을 통해 수집 및 확인하고 있으며 동일하게 알람도 수신합니다.
- 매트릭 수집에 대해서는, Kminion과 Burrow라는 두 개의 오픈소스를 자체 구축한 쿠버네티스 클러스터에 올려서 무중단 운영 중에 있습니다. 버전 업그레이드나 배포 및 재시작이 지속적으로 이루어지고 있음에도 불구하고 무중단 운영을 위해 최대의 노력을 기울이고 있습니다.
- 이렇게 수집된 지표는 Telegraf와 InfluxDB를 사용해 저장하고 Grafana 대시보드를 통해 시각화해서 제공하고 있습니다.
- 마지막으로 Kafka 클러스터의 관리 및 운영을 위해 CMAK이라고 하는 구 Kafka Manager를 사용하고 있고, 그 외에도 이제 자체 개발한 챗봇도 함께 사용하고 있습니다.
공용 메시지큐 시스템 사용의 장단점
각각의 서비스 팀에서 Kafka 클러스터를 직접 구축하게 되면, 결국 모니터링과 운영 부분에 대한 고려가 반드시 필요합니다. 즉, 그만큼의 리소스와 운영 인력이 필요하게 됩니다. 하지만 메시지큐 시스템을 조금 더 자유롭게 사용하거나, 보안 등과 관련해 독립성을 보장받고자 하는 경우에는 전용 시스템을 사용해야 할 수 있습니다. 이러한 경우에 대비해, 저희 TF에서 공용 클러스터와 동일한 수준으로 사이징하고 전용 클러스터를 구성, 설치 및 운영 지원하고 있습니다.
공용 메시지큐 시스템에 필요한 대시보드의 형태
Kafka 대시보드
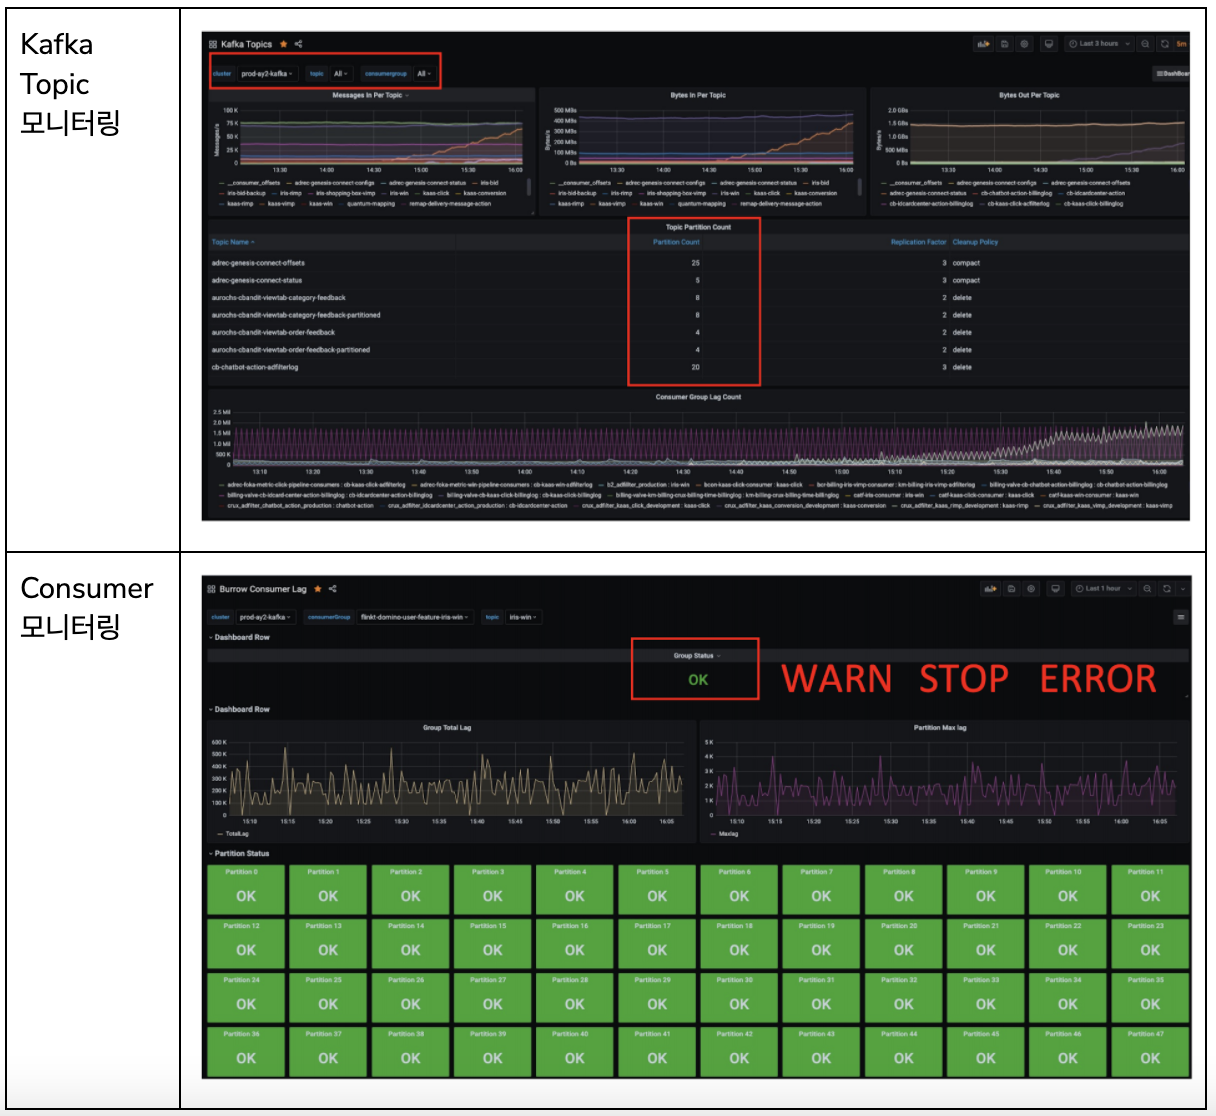
Kafka 관련 Grafana 대시보드는 다음의 2가지 타입을 제공하고 있습니다.
카프카 토픽 대시보드
카프카 토픽에 대한 대시보드에서는, 본인이 사용하는 클러스터 그리고 토픽을 선택을 할 수 있도록 구성했습니다. 클러스터 전체에 대한 모니터링뿐 아니라 토픽의 파티션 카운트나 레플리카 설정 값 등의 기본적인 정보를 확인할 수 있습니다. 또한, 토픽에의 인입량과 Consumer의 consume량, lag 사용량 등을 종합적으로 표시하고 있습니다. 현재는 오픈소스인 Grafana를 활용하고 있지만 향후에는 자체 웹 대시보드를 구성할 계획을 가지고 있습니다.
Consumer 대시보드
토픽에 얼마나 많은 메시지가 인입 및 인출되고 있는지를 Consumer 입장에서 확인할 수 있는 대시보드를 구성했습니다. 그룹 상태를 제일 위에 표시하고, 그룹 상태로는 크게 OK, WARN, STOP, ERROR로 나타내고 있습니다.
- OK: 모든 Consumer 그룹의 구성원들이 파티션으로부터 정상적으로 메시지를 consume하고 있다는 의미
- WARN: 오프셋이 증가할 때 consume이 계속 진행되면서 마찬가지로 lag가 더 많이 증가하는 경우로 produce되는 메시지가 consume 속도를 못 따라간다는 의미
- STOP: Consumer의 오프셋 커밋이 일정 시간이 멈춰있는 상태로 보통은 더 이상 사용하지 않는 토픽이거나 또는 Consumer 그룹이 클러스터에서 제외되었을 수 있음
- ERROR: 오프셋 커밋이 멈춘 상태에서 계속 랙이 증가하고 있는 것으로, 메시지가 produce은 되고 있는데 Consumer들이 못 가지고 가고 있어, Consumer에 문제가 생겼다는 의미. 사용 중인 Consumer로 실제로 서비스 중인 토픽이라면 바로 조치가 필요한 상태
그룹의 토픽에 들어오는 전체 lag는 왼쪽에 표시하고, 오른쪽에는 lag가 많이 쌓인 파티션 값을 표시했습니다. 파티션 관련 도표의 경우, 확인할 필요가 많지는 않지만 특정 상황에서 특정 파티션만 메시지를 못 가져가는 이슈가 가끔 발생하기 때문에 그런 상황에서 원인 분석에 도움을 드리고자 만든 지표입니다.
RabbitMQ 클러스터 대시보드
다음은 RabbitMQ 관련 지표에 대한 대시보드입니다.
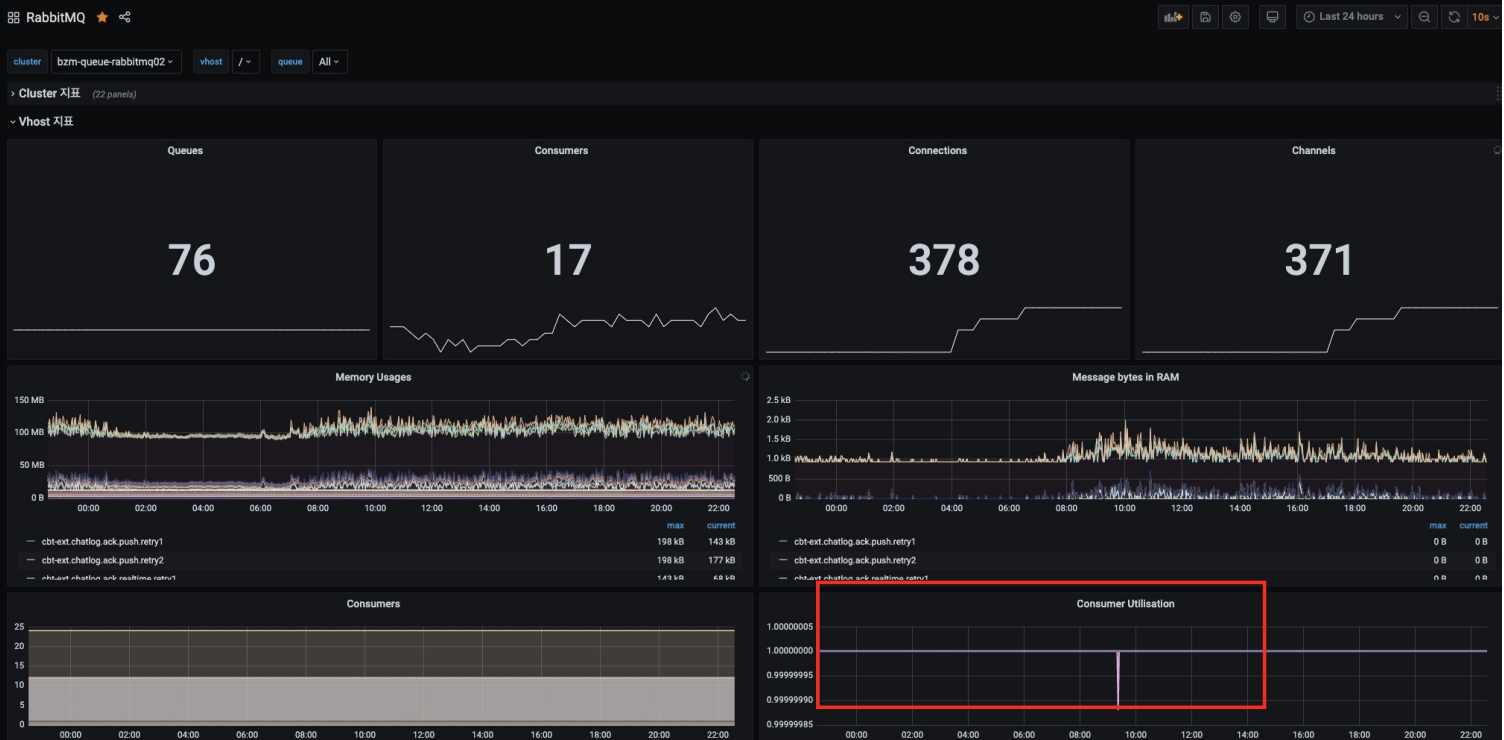
클러스터별, VHOST별, 큐별로 운영 현황을 확인할 수 있습니다. 클러스터 전체 모니터링도 가능하고 특정 VHOST 단위로도 모니터링 가능합니다. 빨간 박스로 표시한 부분은 Consumer Utilization으로, Kafka Consumer 그룹의 상태와 비슷한 개념입니다.
Consumer Utilization은 0에서 1 사이의 값으로 표시가 됩니다. 1은 모든 Consumer들이 정상적으로 메시지를 가져갈 수 있는 준비(ready) 상태를 의미하며, 0과 1 사이에 값이 있을 때는 일부 Consumer들이 현재 준비가 되지 않아 메시지를 제대로 가져가지 못하고 있을 수 있습니다. 또한, 0은 Consumer들이 전부 멈췄다라는 의미입니다. 이 값을 통해 현재 consume이 잘 되고 있는지 문제가 없는지를 판단하는데 사용할 수 있습니다.
Kafka Web & API
최근에는 Kafka Web과 API도 오픈했습니다. 아직은 베타 상태로, 사용성 개선과 기능 추가 등을 지속해 갈 생각입니다.
Kafka Web에서는 현재 자신이 속한 부서를 기준으로 속해 있는 클러스터 정보를 보여주고 있습니다. 각 개발 단계별 클러스터의 부하 정보를 확인할 수 있습니다. Kafka Web에서는 공용 클러스터에 대한 정보뿐 아니라 전용 클러스터 생성도 가능하며 전용 클러스터에 대한 정보도 표시하고 있습니다.
또한 클러스터별로 생성된 토픽 리스트(기본 파티션 수, 레플리카 수 등)를 확인할 수도 있습니다. 토픽은 생성한 담당자만 토픽을 수정하거나 파티션 수를 증가시키거나 토픽을 삭제하는 등의 수정 작업이 가능하도록 설정해 놓았습니다.
마지막으로 Consumer 관련 지표도 확인할 수 있고, 필요한 알람이 있는 경우에는 알람을 설정할 수도 있습니다.
공용 메시지큐 시스템 잘 쓰기
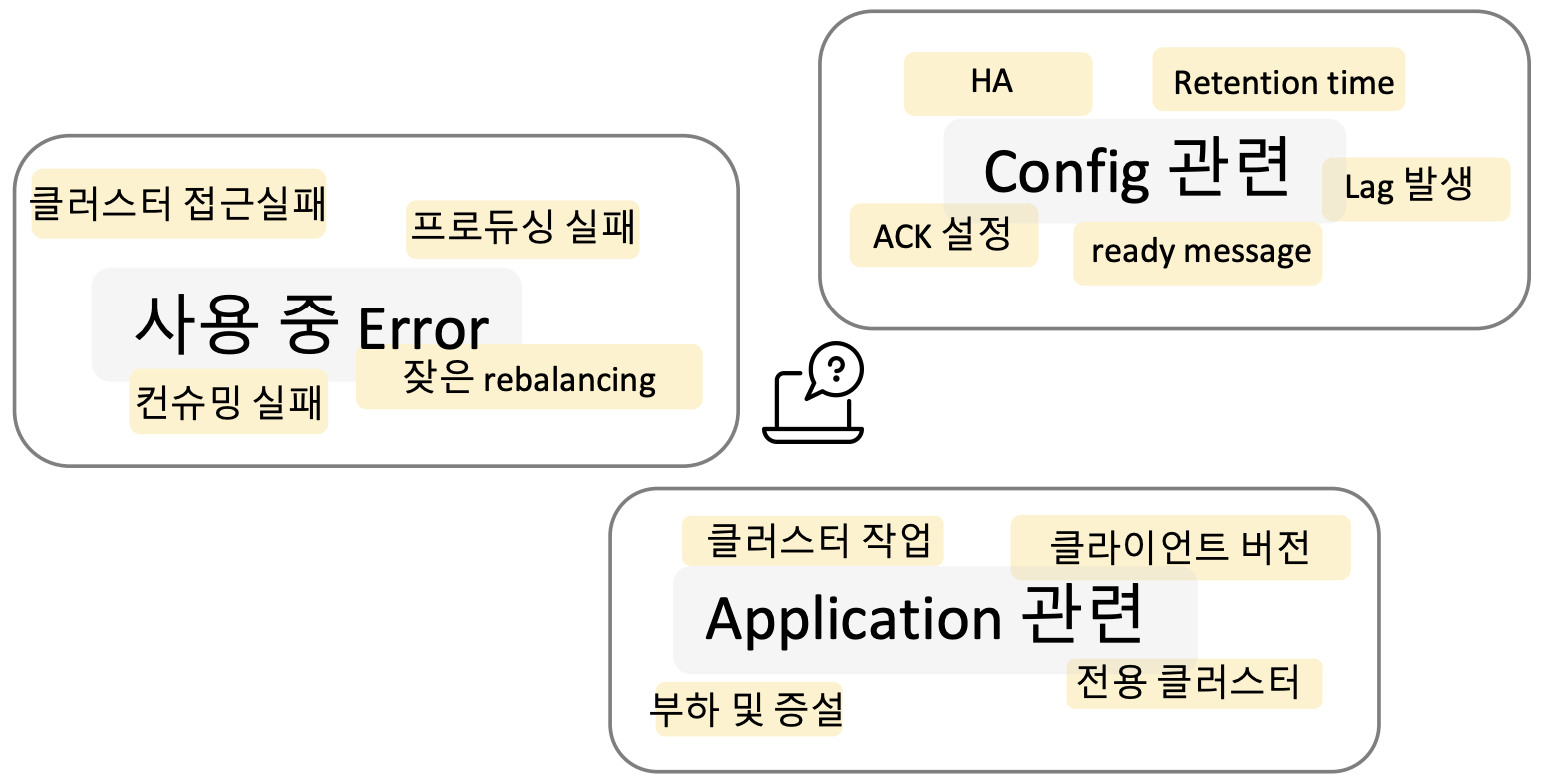
공용 메시지큐 시스템을 사용하다 보면 에러가 발생할 수 있습니다. 예를 들어, 클러스터 접근 실패가 발생할 수 있습니다. 이런 경우는 보통 이제 ACK 설정 이슈일 때가 많고, 혹은 개발 단계별 존 차이(Dev 존과 Production Zone)로 인한 이슈일 수 있습니다.
이 외에도, Producing이나 Consuming에 실패하거나 Consumer들이 자주 리밸런싱되는 등의 문제가 발생할 수도 있습니다. 이에 대해서는 Consumer나 Producer의 Config 값을 바탕으로 원인 분석을 시도해 볼 수 있습니다.
애플리케이션의 Config 관련된 부분이나 Kafka의 ACK 설정이나 리텐션에 대한 설정 값에 따라서는 의도하지 않은 결과가 나올 때도 있습니다. 만약 공용 Kafka나 RabbitMQ로는 수용하기 어려운 Config 값을 사용해야 하는 경우에는 공용 시스템이 아닌 전용 시스템을 사용할 것을 권장합니다.
마지막으로 증설이나 장애 처리 등 클러스터 작업이 주기적으로 이루어지는데, 이로 인해 유저 서비스에 영향이 있을 수 있기 때문에 저희는 최대한 주간에 작업을 진행하는 것을 원칙으로 하고 있습니다.
앞으로의 공용 메시지큐 시스템
사내의 개발자들이 더 편리하게 공용 메시지큐 시스템을 사용할 수 있도록 저희 TF에서는 앞으로도 지속적으로 다음과 같은 개선을 진행할 예정입니다.
- SaaS 형태의 자동화된 전용 클러스터 제공
- 서비스 및 부서별 사용현황 대시보드 제공
- 무중단 및 자동화 배포를 위한 쿠버네티스 전환
- 웹 UI 개선 및 API 기능 확대
- 모니터링 고도화 프로젝트
감사합니다.