Engineering
우리 팀만의 vLLM 플러그인 만들기 2편 - 모델 변환부터 배포까지 AI-native로 자동화하기
2026년 8월 11일
원문에서 보기 ↗1편에서는 검색·추천 모델을 vLLM 사용자 정의 플러그인으로 옮겨 서빙 성능을 높인 과정을 소개했습니다. 모델을 vLLM에서 실행할 수 있게 된 뒤에는 또 다른 문제가 남았습니다. 모델마다 반복해야 하는 변환 작업이 복잡하고, vLLM의 빠른 변화까지 계속 따라가야 한다는 점입니다.
Hugging Face 모델 하나를 vLLM에 올리는 과정은 버튼 한 번으로 끝나지 않습니다. ‘딸깍’ 한 번으로 완성할 수는 없습니다. 하지만 자동화를 우리 문제에 맞게 계속 ‘깎아’ 나갈 수는 있습니다. 저희는 변환 절차를 Claude Code Skill로 만들고, 실제 모델을 변환하며 두 번의 큰 시행착오를 거쳐 스킬 자체도 계속 개선했습니다. 이 글은 vLLM 모델 변환부터 배포까지를 AI-native로 자동화하고, 그 자동화를 어떻게 다듬어 왔는지에 대한 기록입니다.
그 결과 서로 다른 유형의 모델 7개를 같은 절차로 변환해 운영에 적용했고, 변환 과정에서 발견한 주의 사항 45개를 재사용 가능한 지식으로 축적했습니다. 호출할 때마다 전체 지식을 입력하던 방식도 필요한 지식만 불러오는 구조로 바꿔, 지식 전달에 필요한 호출당 토큰 수를 6,900개에서 170개로 97% 줄였습니다. 마지막에는 이 협업 방식을 저장소 경계 너머로 확장해, 사용자가 GitHub Issue 하나를 작성하면 변환부터 배포까지 이어지는 E2E 파이프라인을 만들었습니다.
이 글에서 다루는 모델 변환과 배포 자동화의 전체 구조는 다음과 같습니다.
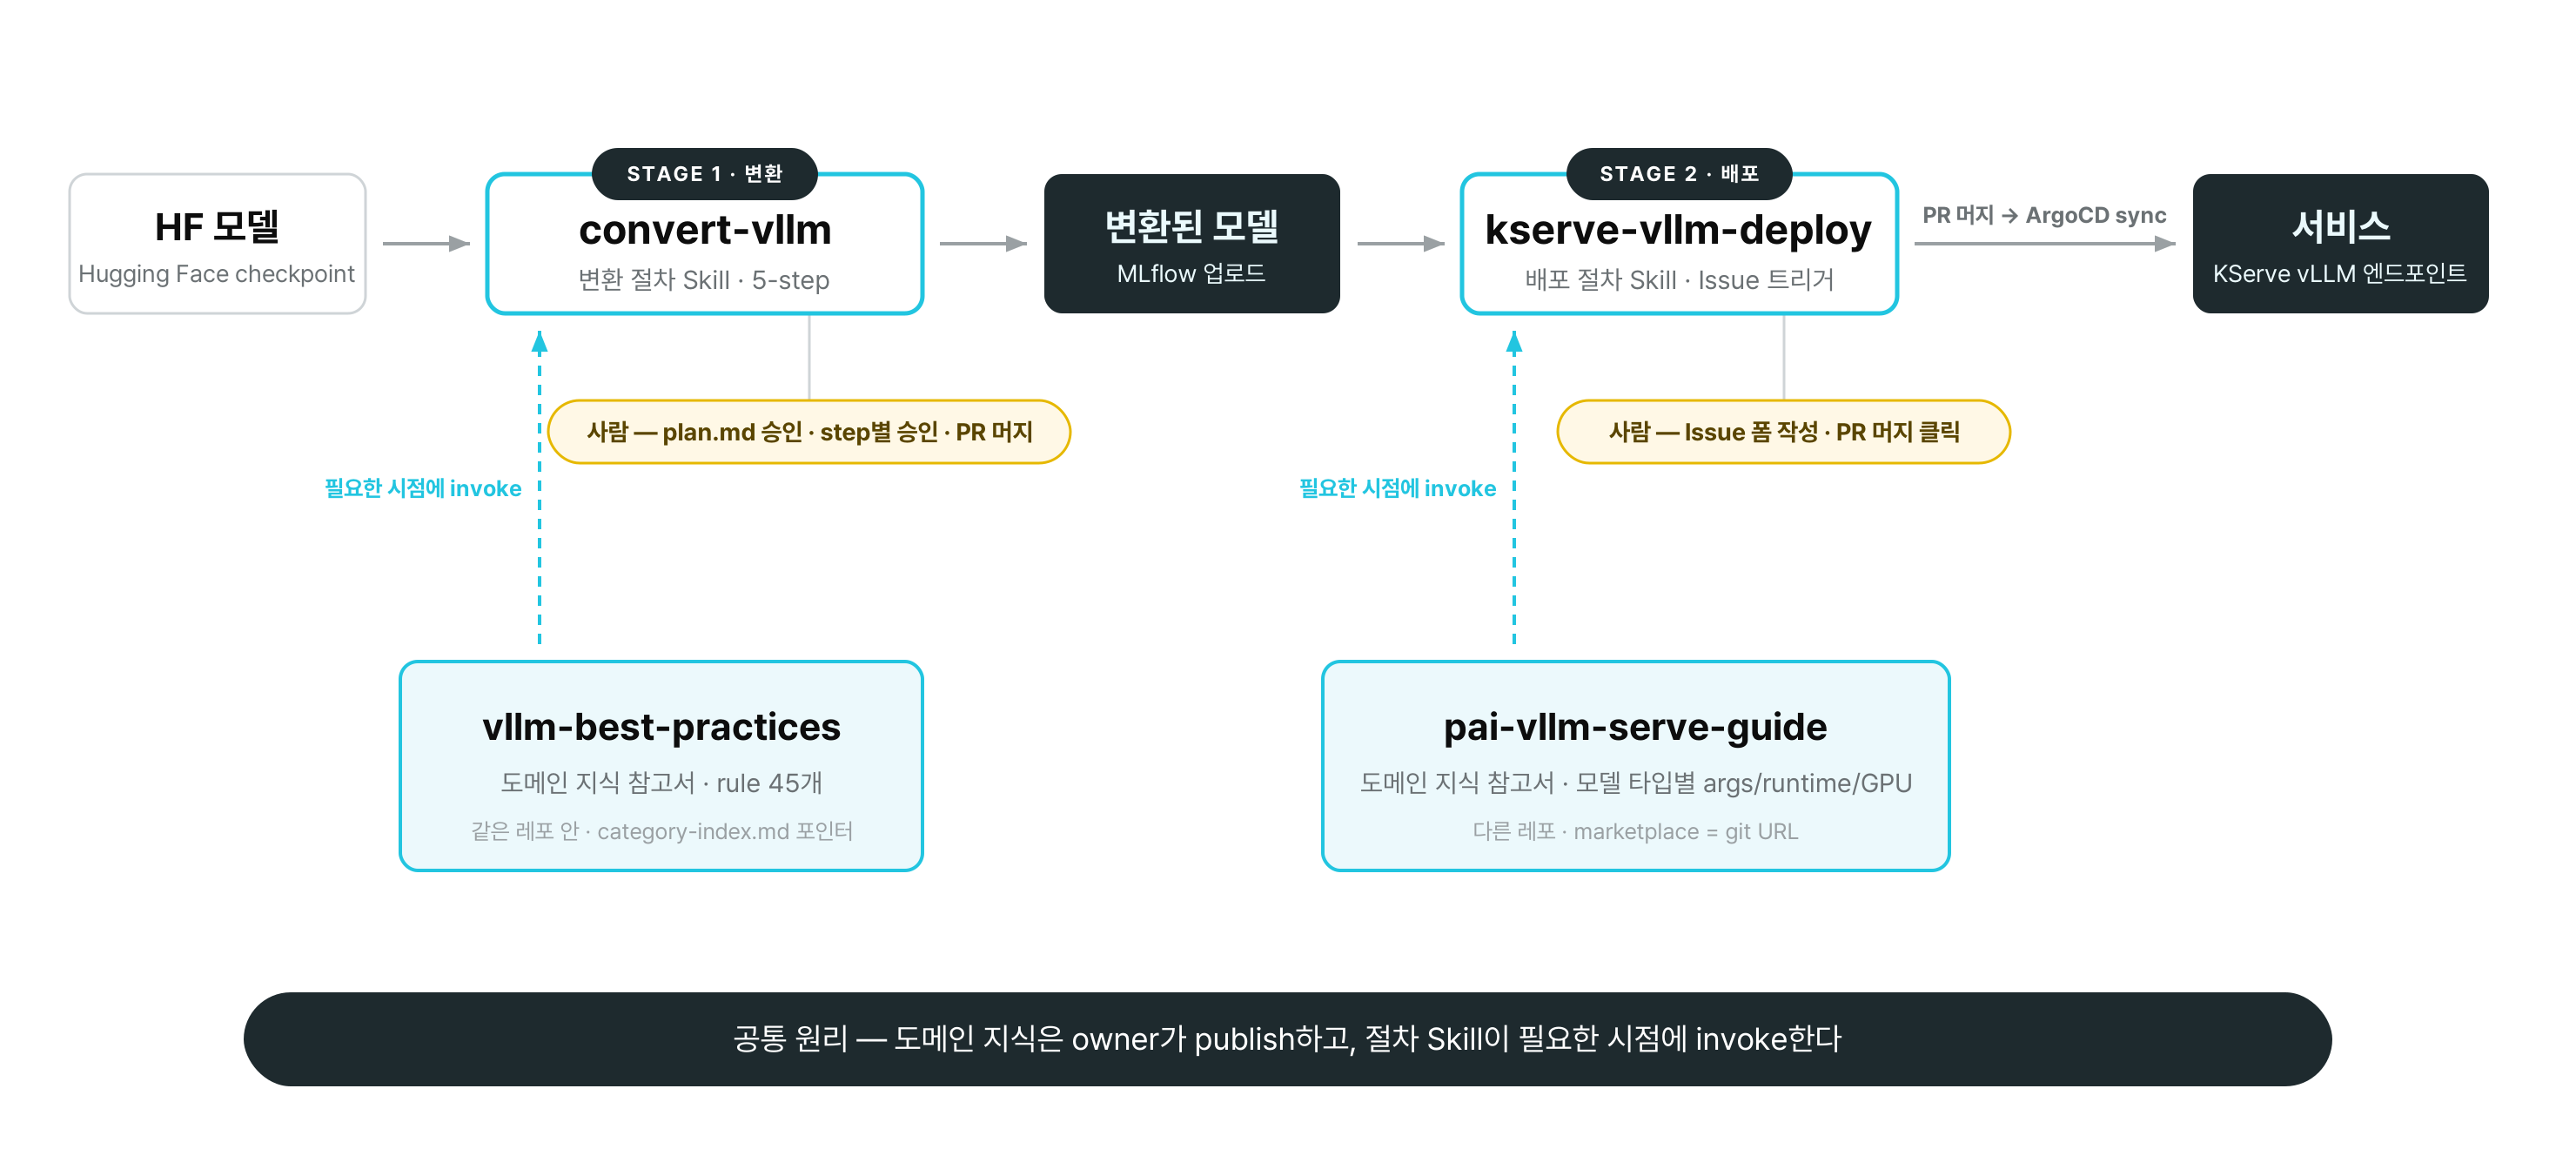
변환과 배포 절차를 담당하는 스킬이 필요한 시점에 도메인 지식 스킬을 호출하는 전체 구조
모델 변환이 어려운 이유
모델 변환은 단순한 코드 마이그레이션이 아닙니다. Hugging Face로 학습한 가중치는 유지하되 모델 구현을 vLLM의 실행 방식에 맞게 다시 작성해야 합니다. 이 과정에는 모델과 서빙 인프라 양쪽의 지식이 모두 필요합니다.
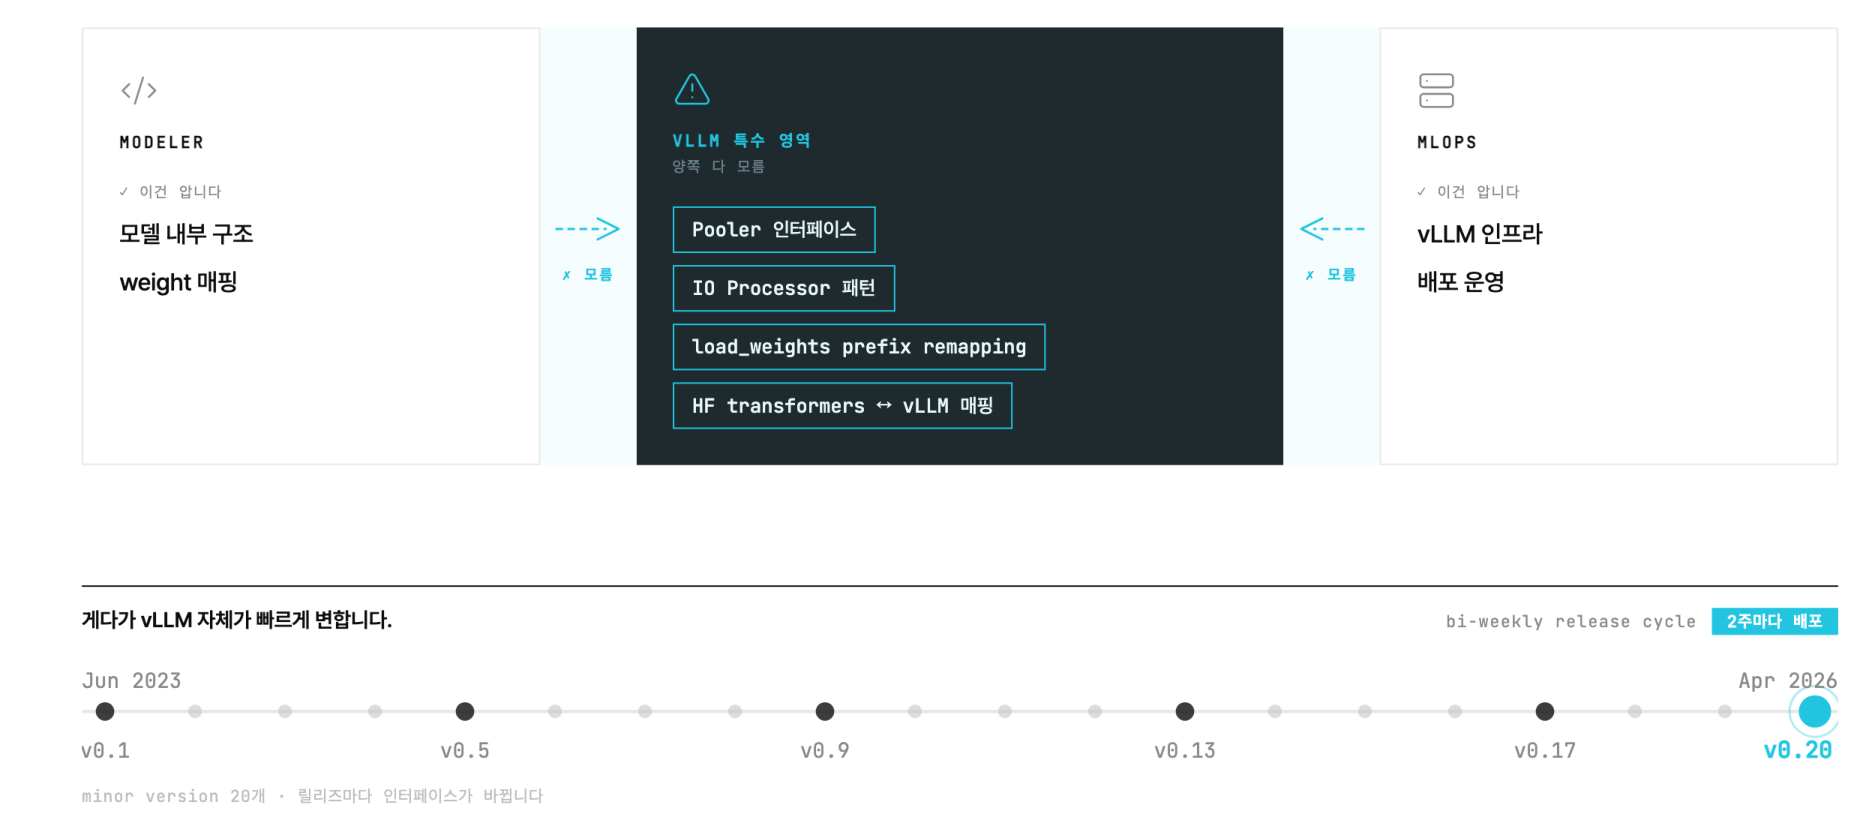
모델 구조를 아는 모델 개발자와 vLLM 인프라를 아는 MLOps 엔지니어 사이에 존재하는 지식의 공백
모델 개발자는 모델의 내부 구조와 가중치 매핑을 잘 알지만 vLLM의 풀링 인터페이스나 IO Processor 패턴과 같은 vLLM 특수 지식은 없습니다. MLOps 엔지니어는 vLLM 기반 인프라를 잘 알지만 모델의 가중치 구조나 Transformers 구현과 vLLM 구현 사이의 미묘한 차이는 모릅니다.
즉, 모델 개발자 혼자도 MLOps 엔지니어 혼자도 하기 어려운 작업입니다. 프레임워크가 빠르게 바뀐다는 점도 어려움을 더합니다. vLLM은 약 3년 동안 v0.1에서 v0.20까지 발전했고, 약 2주 간격으로 새 버전이 배포되면서 인터페이스도 계속 바뀌었습니다. 이 변화를 사람이 매번 따라가 적용하는 일은 누구에게도 쉽지 않습니다.
이처럼 두 도메인이 교차하고 프레임워크가 빠르게 변하는 문제가 있었기 때문에, 저희는 AI 도입 초기부터 모델 변환 자체를 AI-native 방식으로 풀기로 했습니다.
모델 경로에서 PR까지 이어지는 변환 스킬
변환 절차는 convert-vllm이라는 Claude Code Skill로 구현했습니다. Claude Code Skill은 Anthropic의 코딩 에이전트 CLI인 Claude Code에서 반복 작업의 절차를 SKILL.md에 정의해 두고, 에이전트가 필요할 때 읽어 실행하는 기능입니다. 매번 긴 프롬프트를 작성하는 대신 검증된 순서와 판단 기준을 재사용할 수 있습니다.
사용자가 Hugging Face 모델 경로를 입력하면 독립적으로 실행할 수 있는 다섯 개의 하위 스킬이 순서대로 실행돼 PR 생성까지 진행합니다.
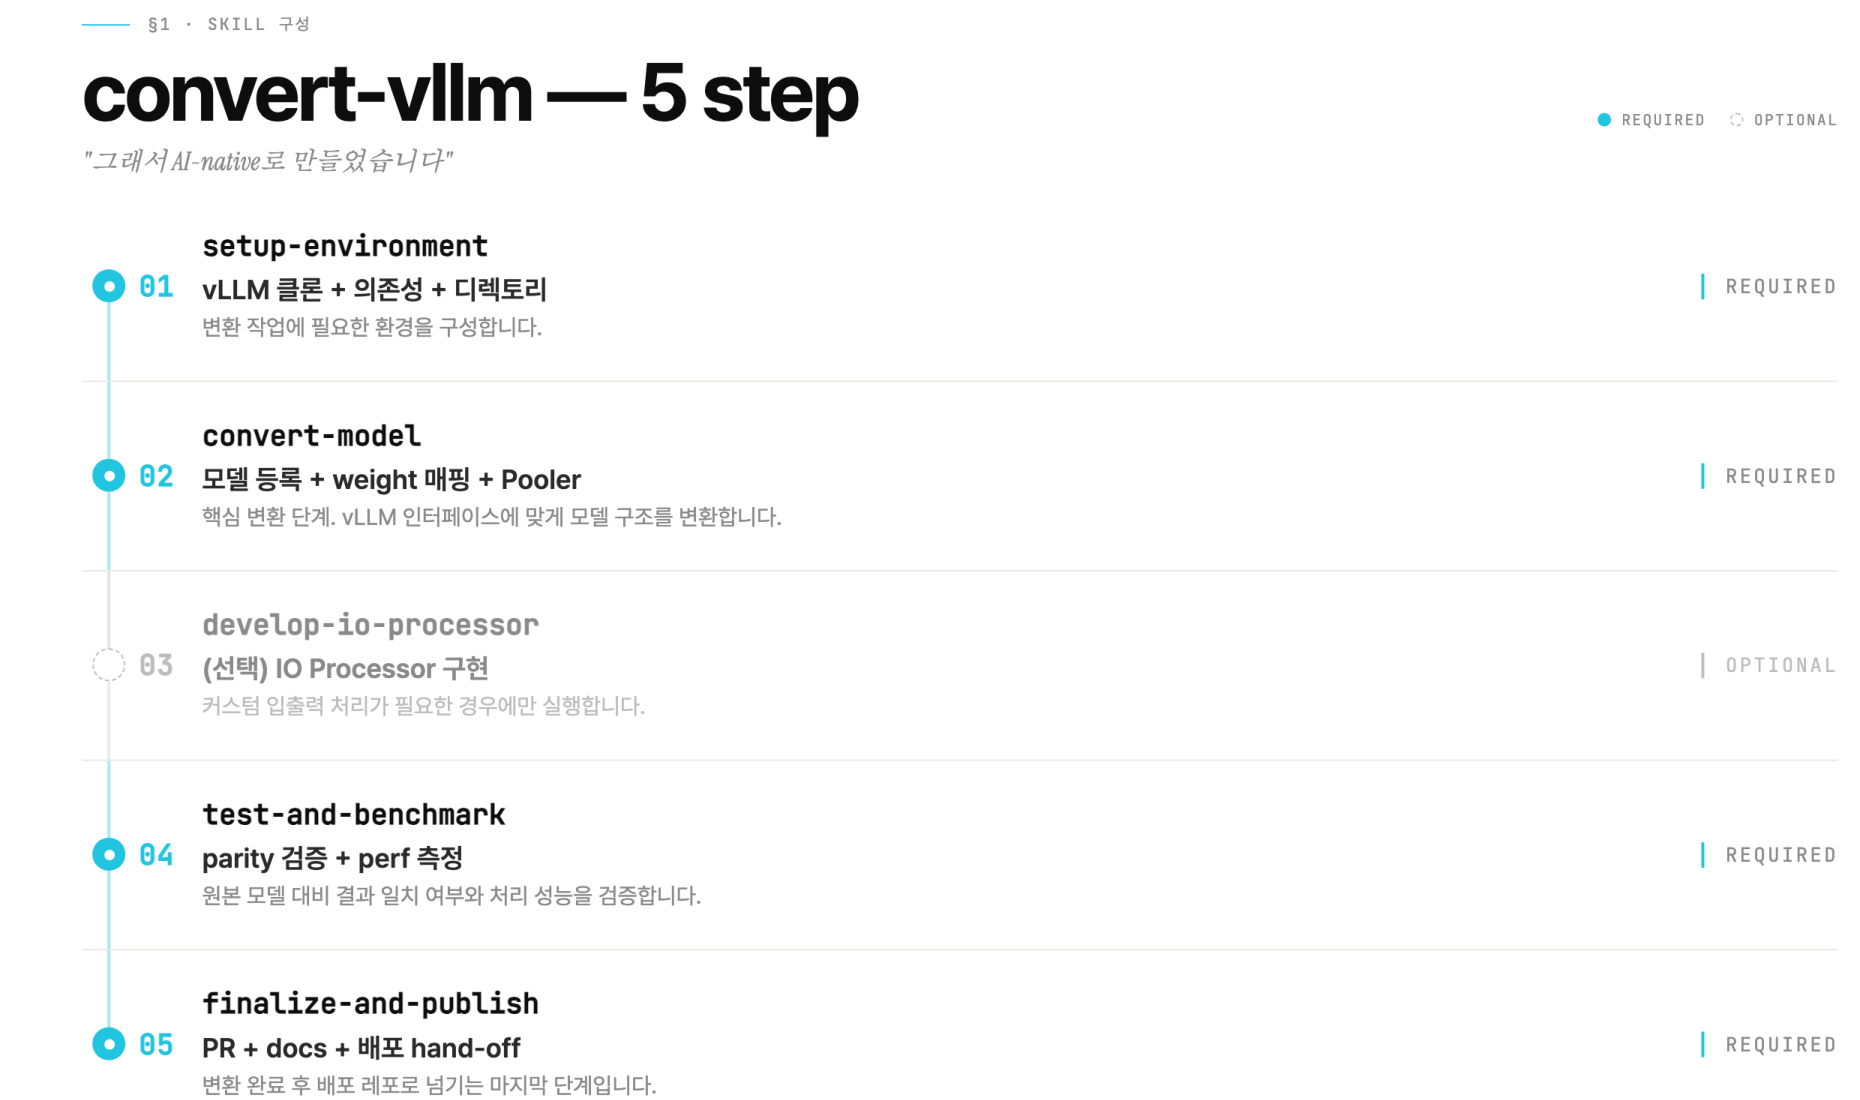
convert-vllm 스킬의 다섯 단계. 입출력 전후처리가 필요 없는 모델은 세 번째 단계를 건너뜁니다.
setup-environment: MLflow와 S3에서 모델 아티팩트를 내려받고 개발 환경을 구성합니다.convert-model: 변환의 핵심 단계입니다.config.json을 분석해 생성, 풀링, 분류 등의 모델 유형을 판단합니다. 이어서 vLLM용 설정 클래스, 모델 클래스, 가중치 적재 코드, 모델 등록 코드를 작성합니다.develop-io-processor: 모델에 필요한 입출력 전처리와 후처리를 구현합니다. 풀링 모델 등 일부 모델에만 필요한 단계로, 모델 유형에 따라 실행 여부를 자동으로 결정합니다.test-and-benchmark: 단위·통합 테스트를 작성하고, 가장 중요한 동등성(parity) 검증, 즉 Hugging Face 원본과 vLLM 변환 모델이 같은 출력을 내는지 확인합니다. 성능을 측정하고 최적화 가이드도 작성합니다.finalize-and-publish: 변환된 모델을 MLflow에 올리고 배포 가이드를 작성한 뒤 PR을 생성합니다.
완전 자동화 대신 설계한 두 가지 협업 장치
이 다섯 단계는 완전 자동이 아닙니다. 대신 사람이 변환 방향과 단계별 결과를 승인하고, 별도 에이전트가 구현 결과를 독립적으로 검증하도록 두 가지 협업 장치를 설계했습니다.
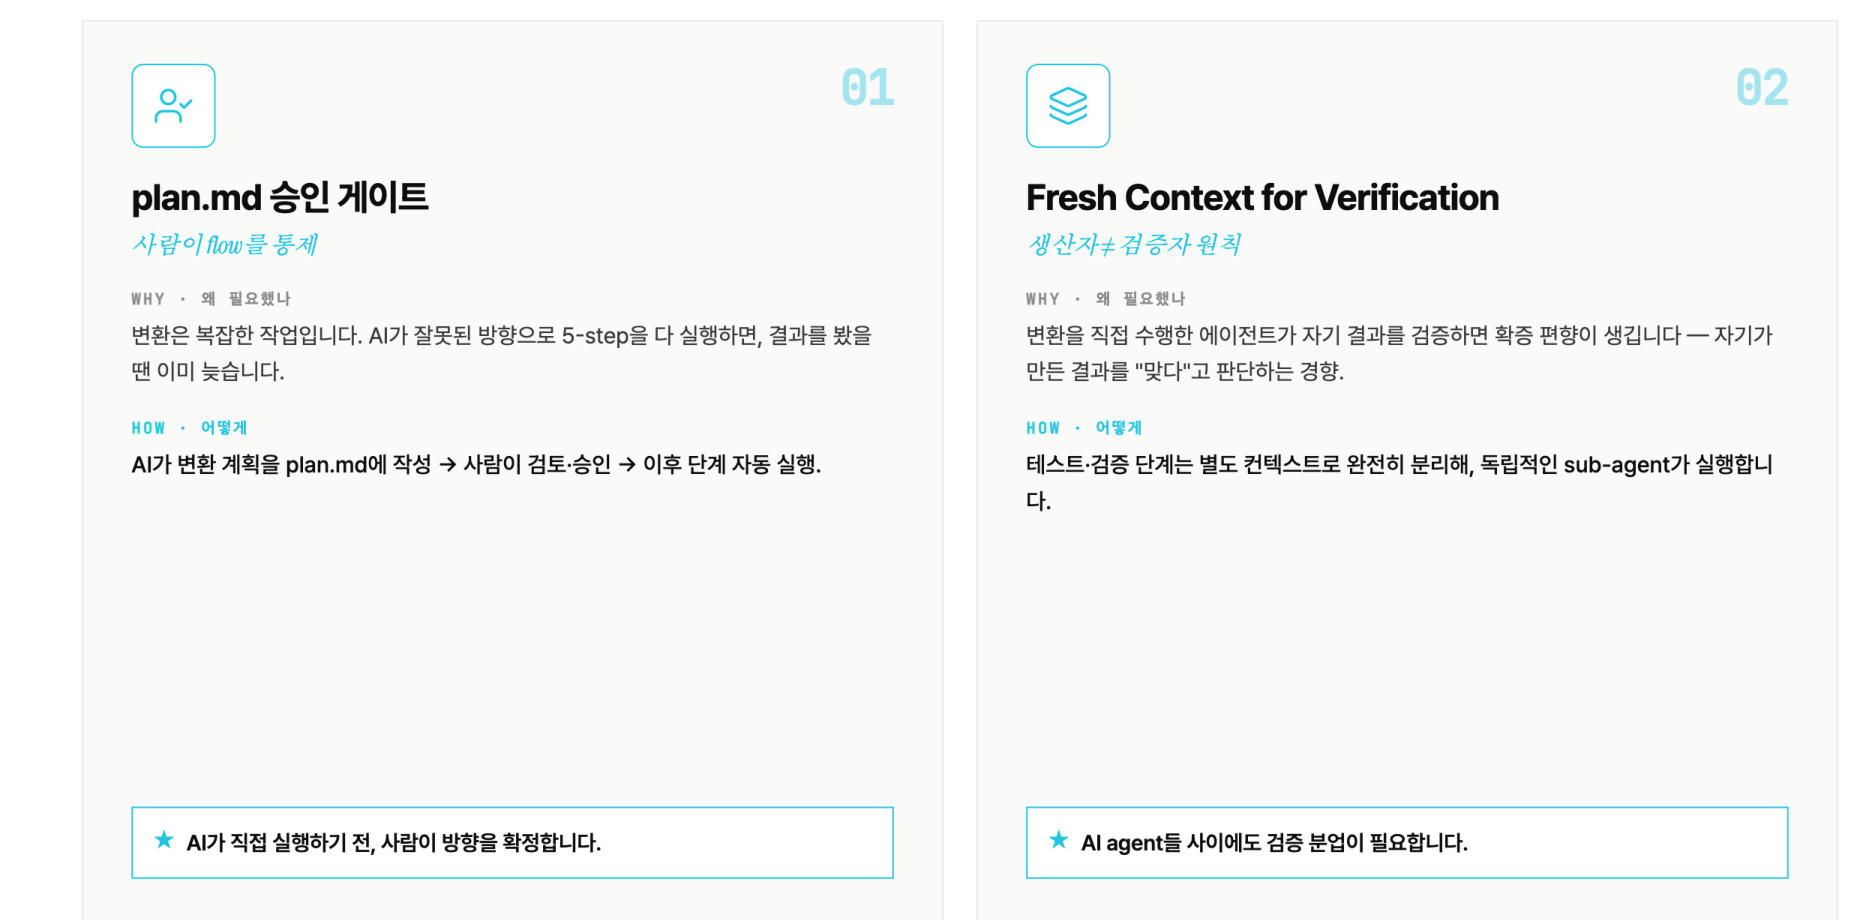
plan.md 승인 게이트와 독립 컨텍스트를 사용하는 검증 구조
첫 번째는 plan.md 승인 게이트입니다. 복잡한 변환 작업을 처음부터 끝까지 에이전트에게 맡기면 잘못된 판단을 늦게 발견할 수 있습니다. 이를 막기 위해 실행 전에 변환 계획을 plan.md로 작성하게 했습니다. 사람이 계획을 검토하고 승인한 뒤에만 구현을 시작하며, 각 단계가 끝날 때마다 결과를 다시 확인해 전체 방향과 단계별 결과를 확정합니다.
두 번째는 구현과 검증의 컨텍스트를 분리하는 것입니다. 저희는 변환을 수행한 에이전트가 자신의 결과를 다시 검증할 때, 자신이 만든 구현을 맞다고 전제해 오류를 놓치는 경향을 관찰했습니다. 구현 담당과 검증 담당을 나누는 역할 분리는 AI 에이전트 사이에서도 필요했습니다. 그래서 테스트 작성과 결과 검증은 별도 컨텍스트에서 동작하는 하위 에이전트가 담당하도록 했습니다.
변환할수록 쌓이는 규칙
이 스킬로 분류, 개체명 인식(NER), 임베딩, 속성 기반 감성 모델(ABSA, Aspect-Based Sentiment Analysis), 이미지 스코어링 등 서로 다른 유형의 모델 7개를 변환해 운영에 적용했습니다. 이 과정에서 발견한 함정(gotcha)은 다음 변환에도 활용할 수 있도록 규칙으로 정리했습니다.
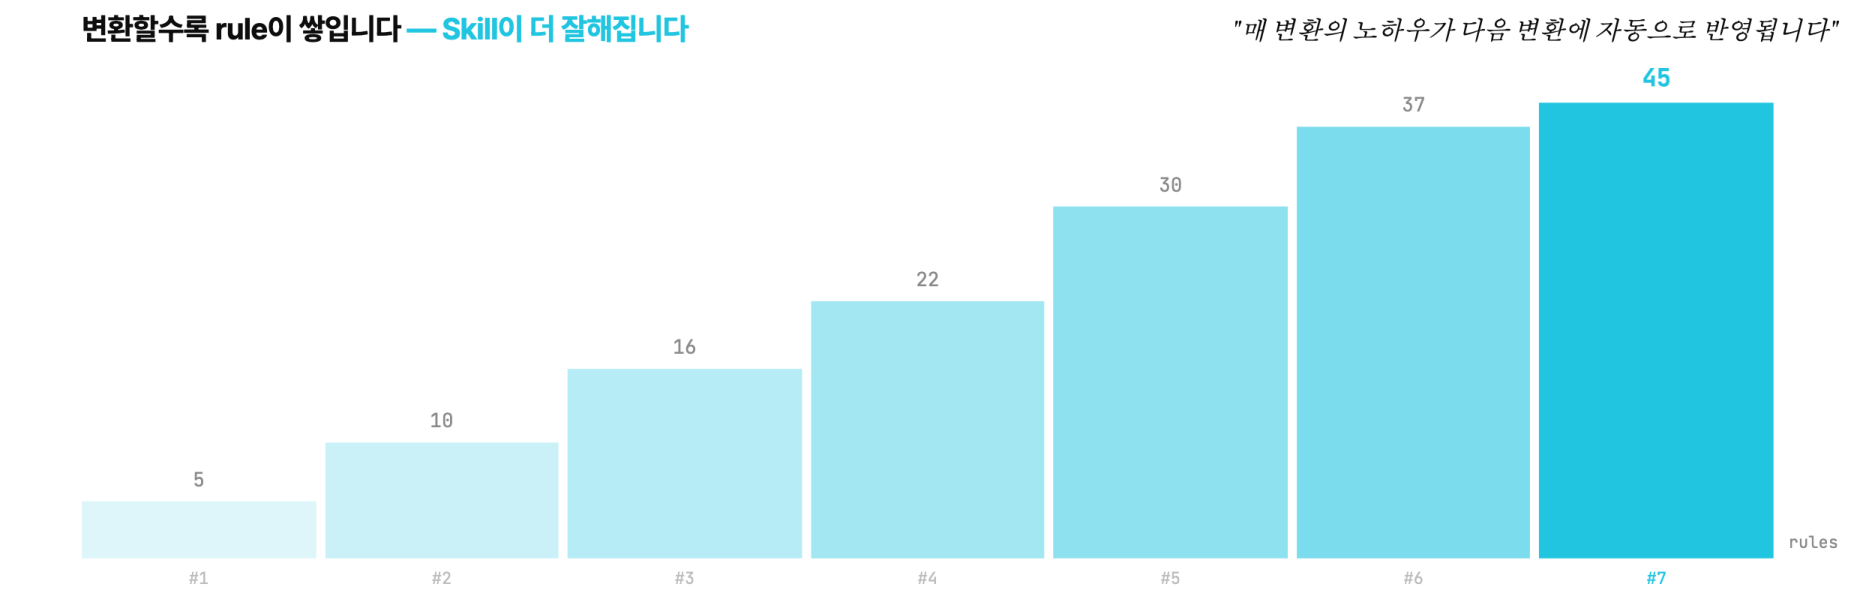
첫 번째 모델에서 정리한 규칙 5개가 일곱 번째 모델을 거치며 45개로 증가했습니다.
축적된 규칙을 다음 변환에 적용하면서 같은 문제를 반복하지 않게 되었고, 변환 과정도 점차 빨라졌습니다. 스킬 자체가 점점 똑똑해지는 셈입니다. 이 지식을 에이전트에게 어떻게 제공할지는 뒤에서 다시 살펴보겠습니다.
출발점 — 200K 컨텍스트가 만든 체크포인트 구조
다만 이 스킬이 처음부터 지금과 같은 모습이었던 것은 아닙니다. convert-vllm의 첫 버전에는 단계마다 진행 상태를 저장하는 체크포인트가 있었습니다. 당시 Claude Code의 컨텍스트 상한은 200K 토큰이었습니다. 한 단계만 실행해도 컨텍스트가 가득 차 다섯 단계를 한 세션에서 마치기 어려웠고, 중간에 작업이 끊기면 해당 단계를 처음부터 다시 실행해야 했습니다.
그래서 4개의 체크포인트와 9개의 상태 필드를 만들고, --from=step으로 원하는 단계부터 다시 시작할 수 있게 했습니다. 당시 제약에서는 이것이 최선이었습니다.
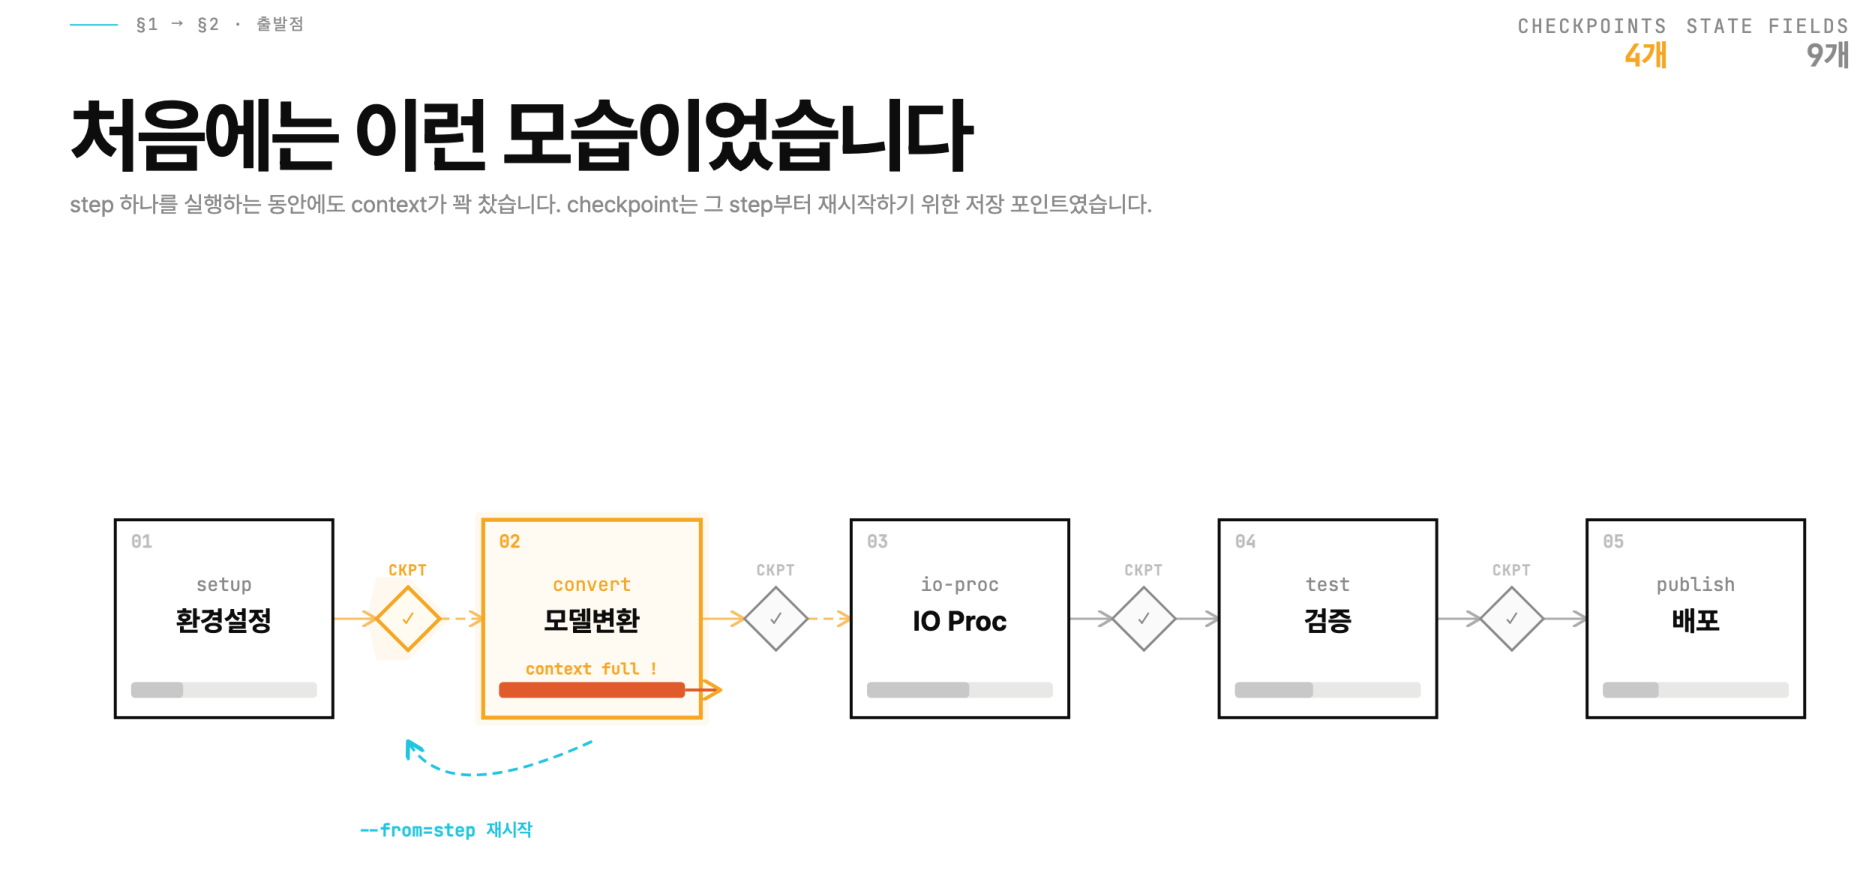
단계 사이의 상태를 저장해 작업을 이어 가던 초기 변환 흐름
이 체크포인트가 첫 번째 시행착오의 주인공이 됩니다.
시행착오 1 — AI 도구가 변하면 스킬도 변해야 한다
체크포인트는 당시 제약에서는 필요했지만, Claude Code가 1M 컨텍스트를 지원하면서 전제가 달라졌습니다. 같은 변환을 다시 실행하자 컨텍스트 압축 없이 한 세션에서 다섯 단계가 모두 끝났습니다.
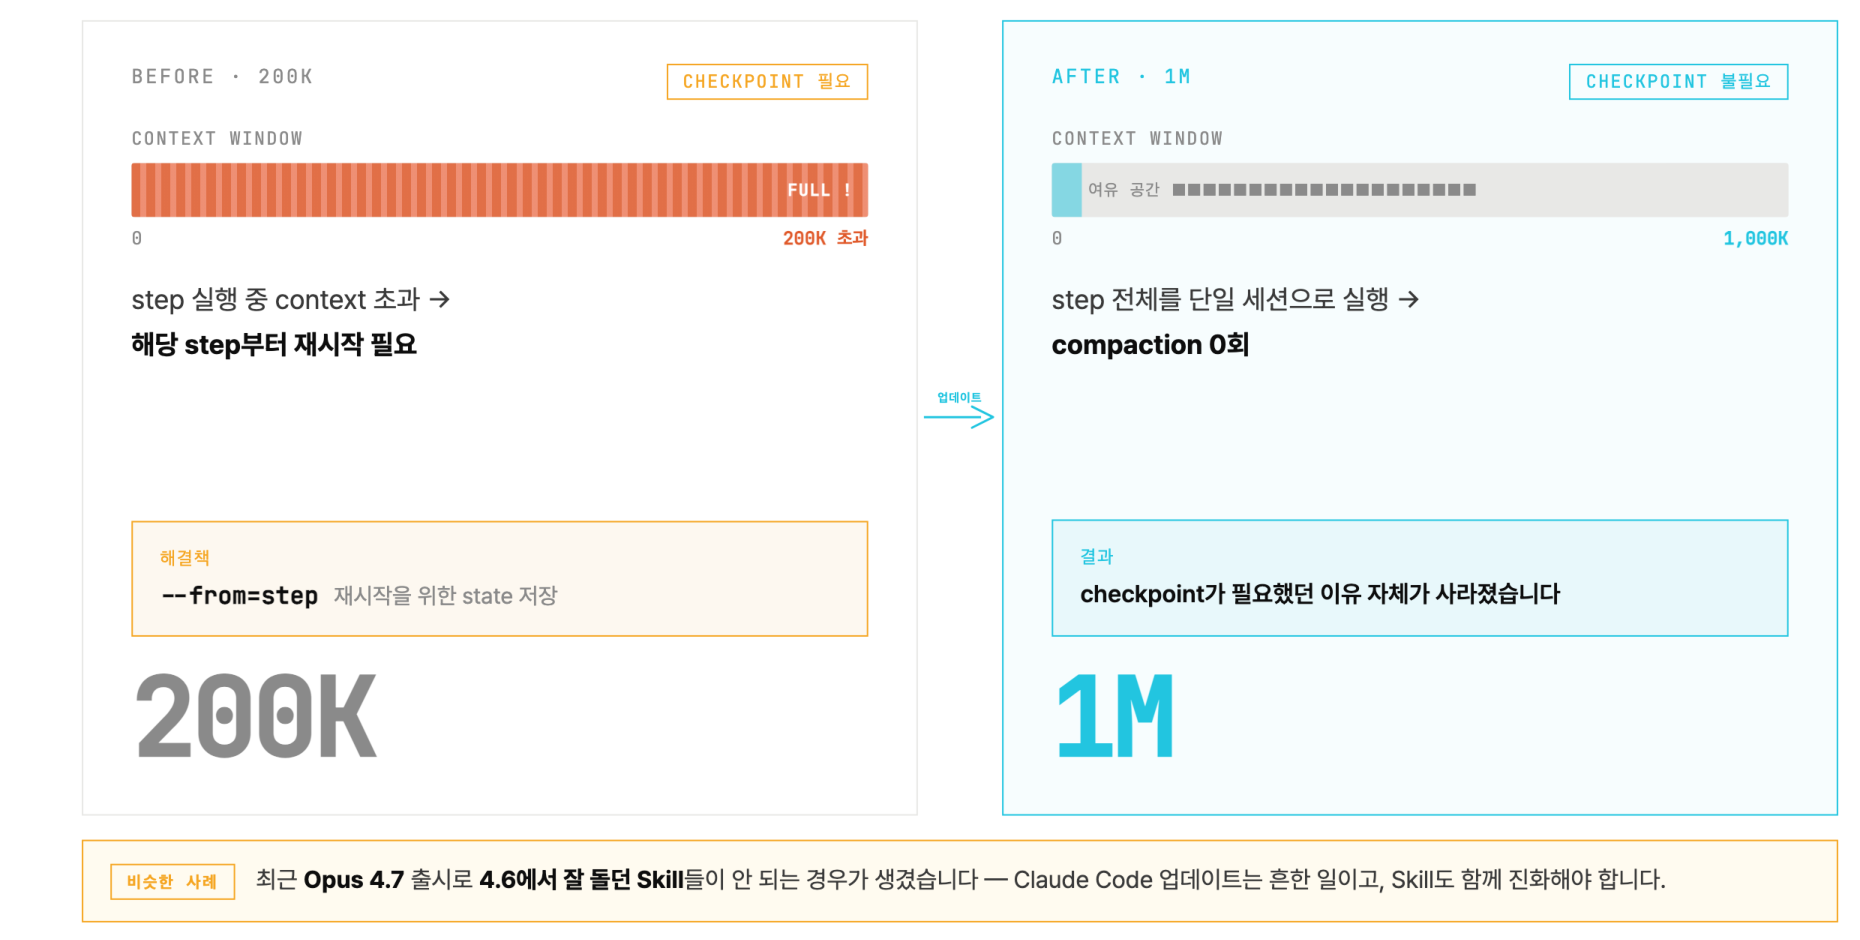
200K 컨텍스트에서는 단계별 체크포인트가 필요했지만 1M 컨텍스트에서는 단일 세션으로 작업을 마쳤습니다.
존재 이유가 사라진 체크포인트 코드를 제거하자 SKILL.md는 492줄에서 332줄로 33% 줄었습니다. 세션마다 다섯 번 이상 발생하던 컨텍스트 압축은 발생하지 않았고, 상태 필드 아홉 개도 모두 없어졌습니다.
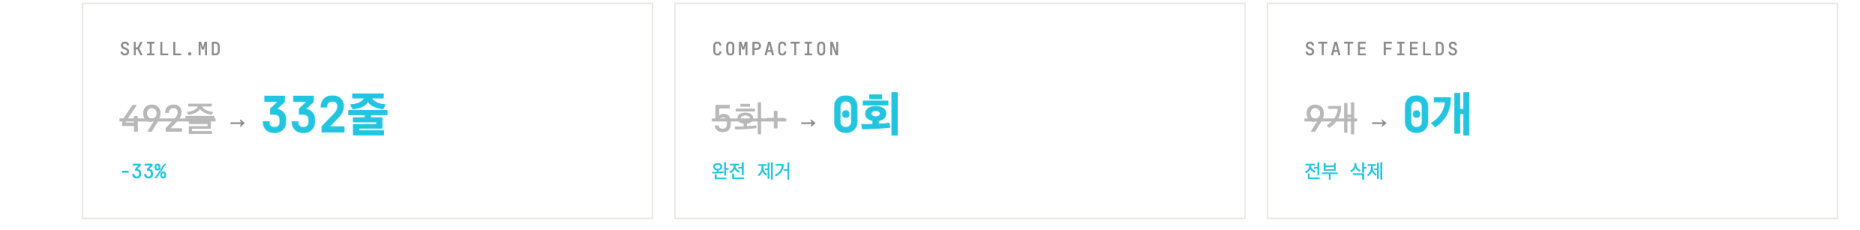
체크포인트 제거 후 스킬 문서 길이와 컨텍스트 관리 비용의 변화
SKILL.md의 33%, 즉 3분의 1은 모델 변환 지식이 아니라 당시의 컨텍스트 한계를 우회하기 위한 임시 구조였습니다. 도구의 제약이 사라진 뒤에도 이 구조가 남아 복잡도만 높이고 있었던 것입니다.
이런 일은 한 번 겪고 끝나는 것이 아닙니다. 최근에도 Claude 모델이 Opus 4.6에서 4.7로 바뀌면서 4.6에서 동작하던 스킬의 일부가 동작하지 않는 사례가 있었습니다. AI 도구의 업데이트는 자주 일어나고, 어느 부분에 영향을 줄지는 미리 예측하기 어렵습니다. 결국 스킬은 만들어 두는 것이 아니라 도구와 함께 계속 관리해야 합니다. 기술 부채는 소스 코드에만 생기지 않습니다.
시행착오 2 — AI에게 무엇을·언제·얼마나 제공할지 설계해야 한다
두 번째 시행착오는 “팀의 도메인 지식을 에이전트에게 어떻게 전달할 것인가”라는 더 근본적인 질문에서 시작됐습니다. 모델 유형별 구현 방식과 변환 과정에서 발견한 주의 사항을 에이전트가 알아서 참고하게 만들고 싶었습니다.
먼저 결론부터 말하면, 처음 선택한 훅(hook) 방식은 전체 지식을 강제로 입력해 호출당 6,900토큰을 추가하면서도 오히려 품질을 해쳤습니다. 이에 필요한 지식만 골라 읽는 스킬 방식으로 바꿨고, 호출당 토큰 수를 170개로 줄이면서 같은 목표를 더 잘 달성했습니다. 그 전환 과정에서 무엇을 배웠는지 공유합니다.
첫 시도 — 훅으로 전체 지식을 강제 입력
처음에는 ‘AI 컨텍스트에 우리 지식을 어떻게든 보게 만드는’ 방법을 찾았고, 그 답이 Claude Code의 훅이었습니다. 훅은 Claude Code가 도구를 호출하는 순간마다 지정한 내용을 자동으로 실행하거나 컨텍스트에 삽입하는 기능입니다. 이 기능으로 도구 호출 직전마다 팀의 지식 베이스 전체를 컨텍스트에 넣었습니다.
그 결과 도구를 한 번 호출할 때마다 약 6,900개의 토큰이 컨텍스트에 추가됐습니다. 이를 22번 반복하면 같은 지식 베이스가 중복해서 들어가, 컨텍스트에서 약 15만 2천 토큰을 차지했습니다.
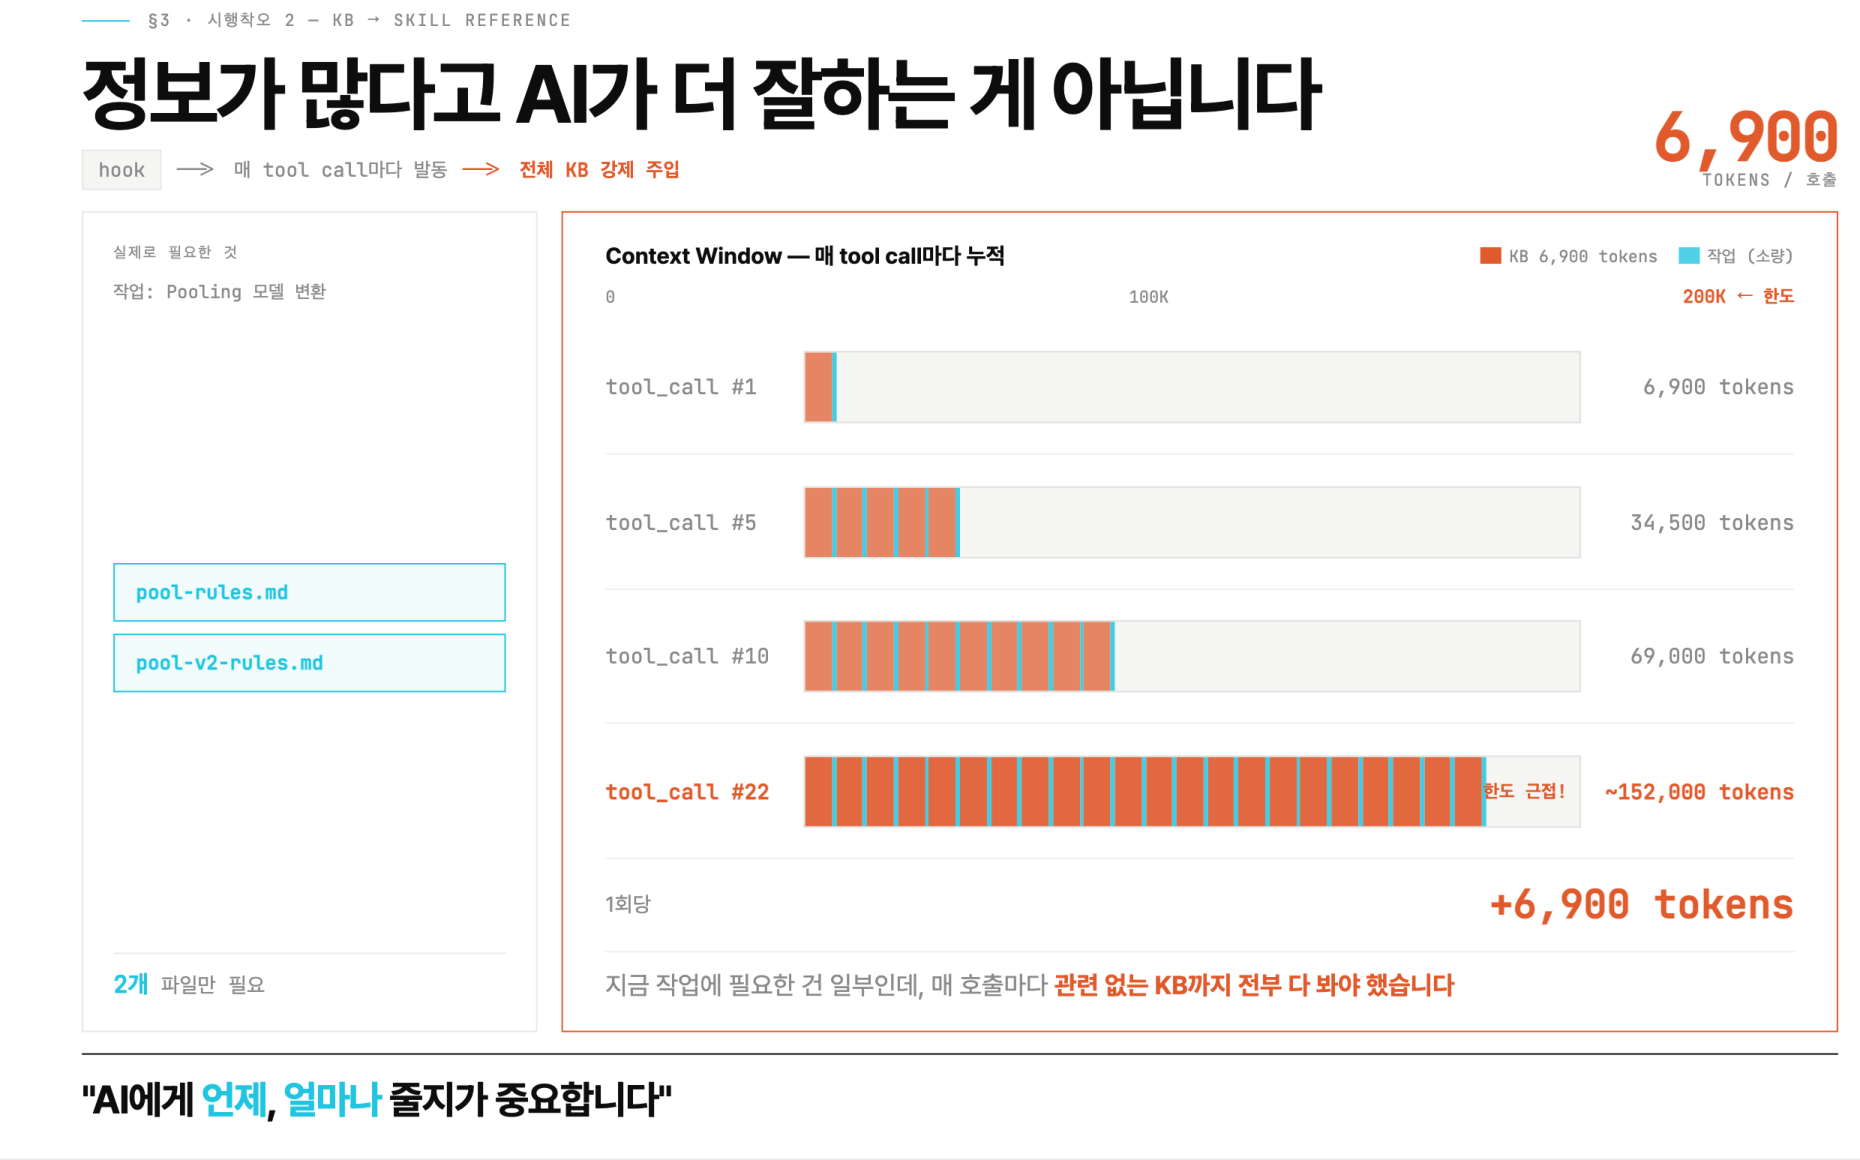
도구를 호출할 때마다 전체 지식 베이스가 반복해서 추가되는 구조
그런데 더 큰 문제는 정보의 양이 아니라 적합성이었습니다. 작업에 필요한 것은 지식 베이스의 일부뿐인데, 호출할 때마다 관련 없는 지식까지 통째로 입력됐습니다. 풀링 모델을 변환하는 중에도 생성, 임베딩, 재순위화(reranking) 모델의 규칙이 함께 입력되면서 에이전트가 엉뚱한 규칙을 참조하는 일도 생겼습니다. 정보가 많다고 AI가 더 잘하는 것은 아니었습니다. 컨텍스트 상한이 1M으로 커져도 정보가 많아질수록 중요한 내용에 대한 주의가 분산되는 현상(attention dilution)은 남습니다.
스킬이 지식을 불러오는 방식
훅을 대체할 방법을 찾기 위해 Claude Code가 스킬을 선택하고 읽는 과정을 다시 살펴봤습니다. 이 과정은 세 단계로 이어집니다.
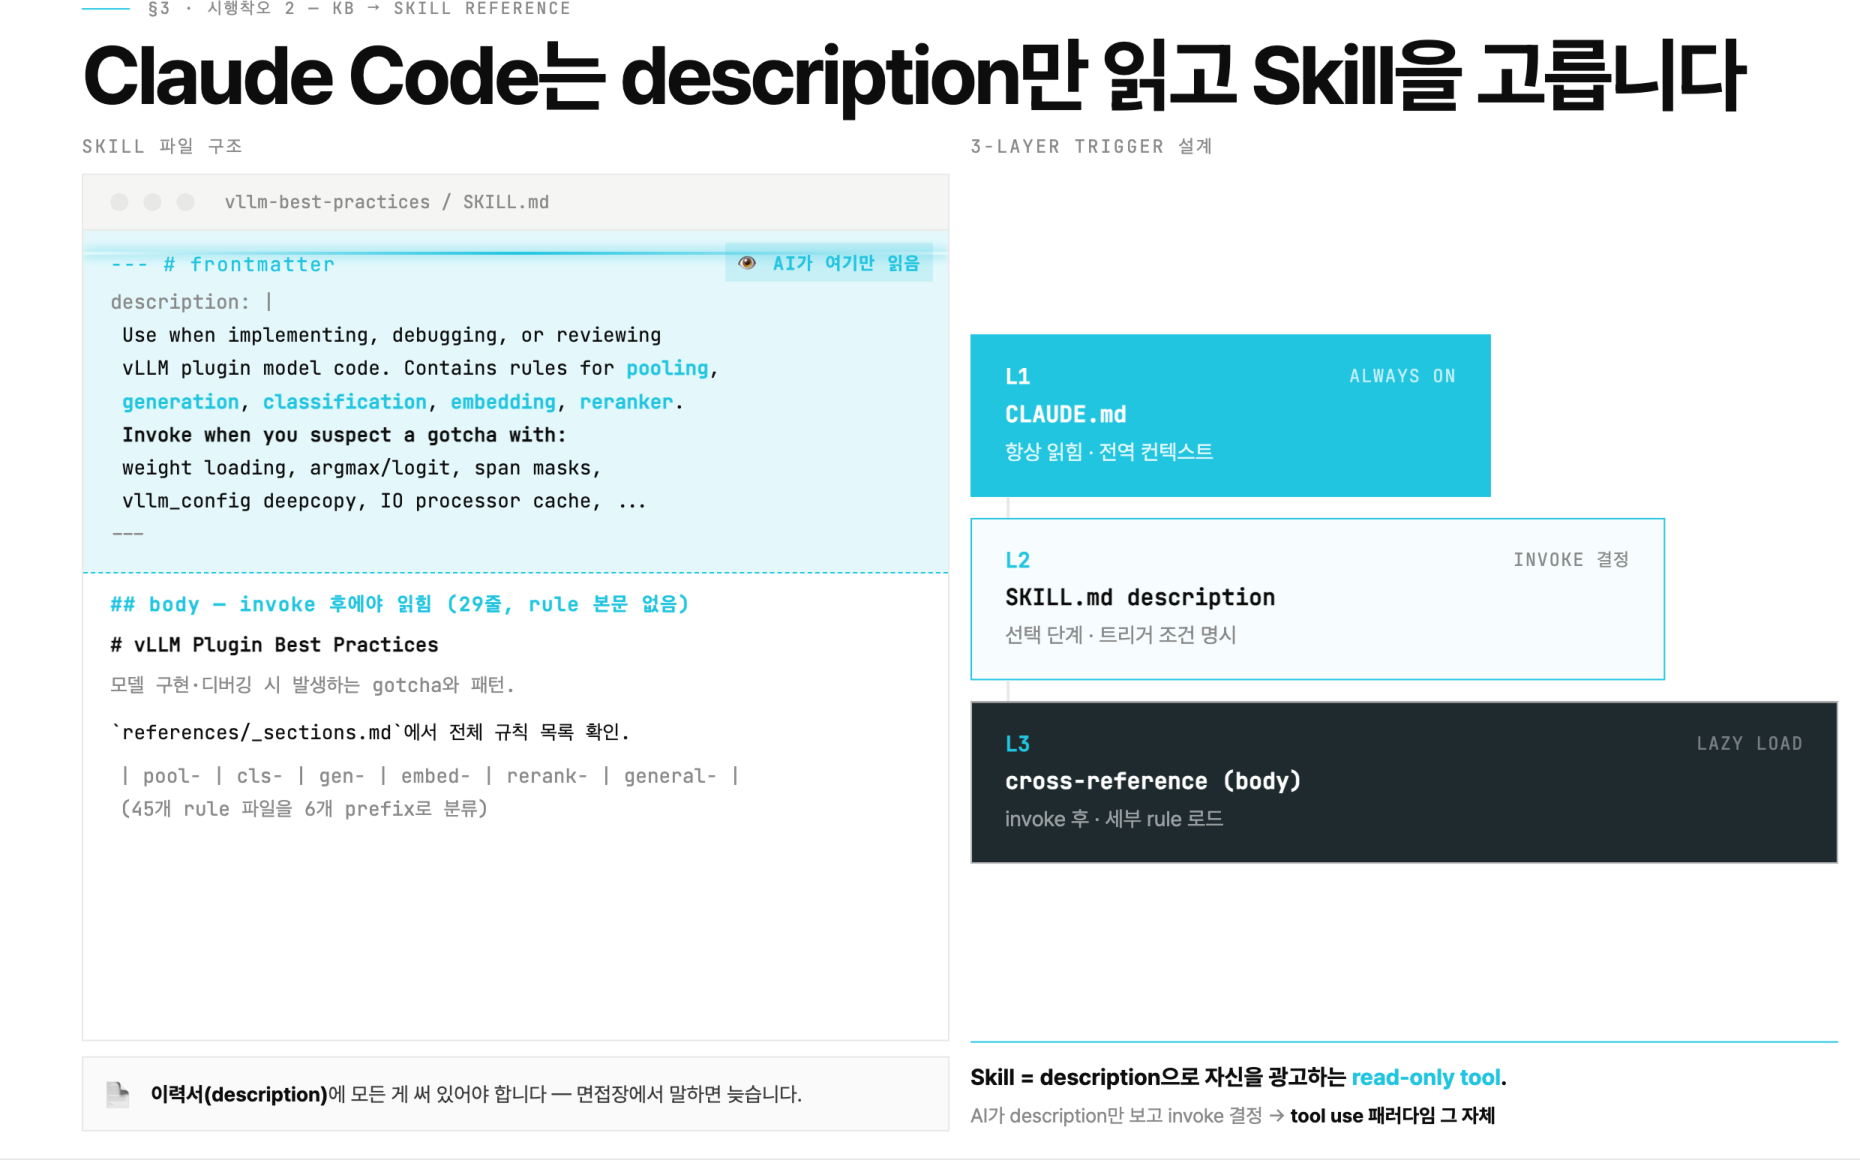
설명 탐색, 스킬 호출, 참조 문서 로딩으로 이어지는 세 단계
- 세션이 시작되면 등록된 스킬의 frontmatter에 있는
description만 컨텍스트에 들어갑니다.SKILL.md본문은 아직 읽지 않습니다. - 에이전트는 사용자 요청과
description을 비교해 사용할 스킬을 선택합니다. - 스킬을 선택한 뒤에야
SKILL.md본문을 읽고, 본문이 가리키는references/파일 가운데 필요한 것만 추가로 읽습니다.
스킬의 description은 어떤 상황에 이 스킬을 사용해야 하는지 알려주는 색인입니다. 실제 절차와 지식은 스킬이 선택된 뒤에만 컨텍스트에 들어옵니다. 면접에 비유하면 description은 스킬을 선택하기 전에 보는 이력서이고, 본문과 참조 문서는 선택된 뒤에 펼쳐 보는 포트폴리오입니다. 결국 스킬은 description으로 자신의 쓰임새를 알리고, 모델이 그 설명을 보고 직접 골라 호출하는 도구입니다.
같은 결론에 도달한 외부 사례 — Supabase agent-skills
이런 고민을 저희만 하지는 않을 것이라 생각해 공개된 사례를 찾았고, 오픈 소스 BaaS이자 Firebase의 대안인 Supabase의 agent-skills를 참고했습니다. Supabase는 Postgres의 성능, 보안, 권한 관리 방법을 코딩 에이전트가 작업 중에 선택해서 읽을 수 있도록 스킬로 제공하고 있습니다. Supabase 블로그는 MCP가 에이전트에게 데이터베이스에 접근할 기능을 준다면, agent-skills는 그 기능을 올바르게 사용하는 방법을 알려준다고 설명합니다.
이 관점은 훅 방식의 문제를 정확히 짚어 줬습니다. 에이전트에게 기능이 있더라도 지금 어떤 규칙을 참고해야 하는지는 전체 지식을 강제로 넣는 방식으로 해결하기 어렵습니다. 필요한 시점에 필요한 참조 문서만 골라 읽는 구조가 필요했고, 훅은 그와 반대되는 방식이었습니다.
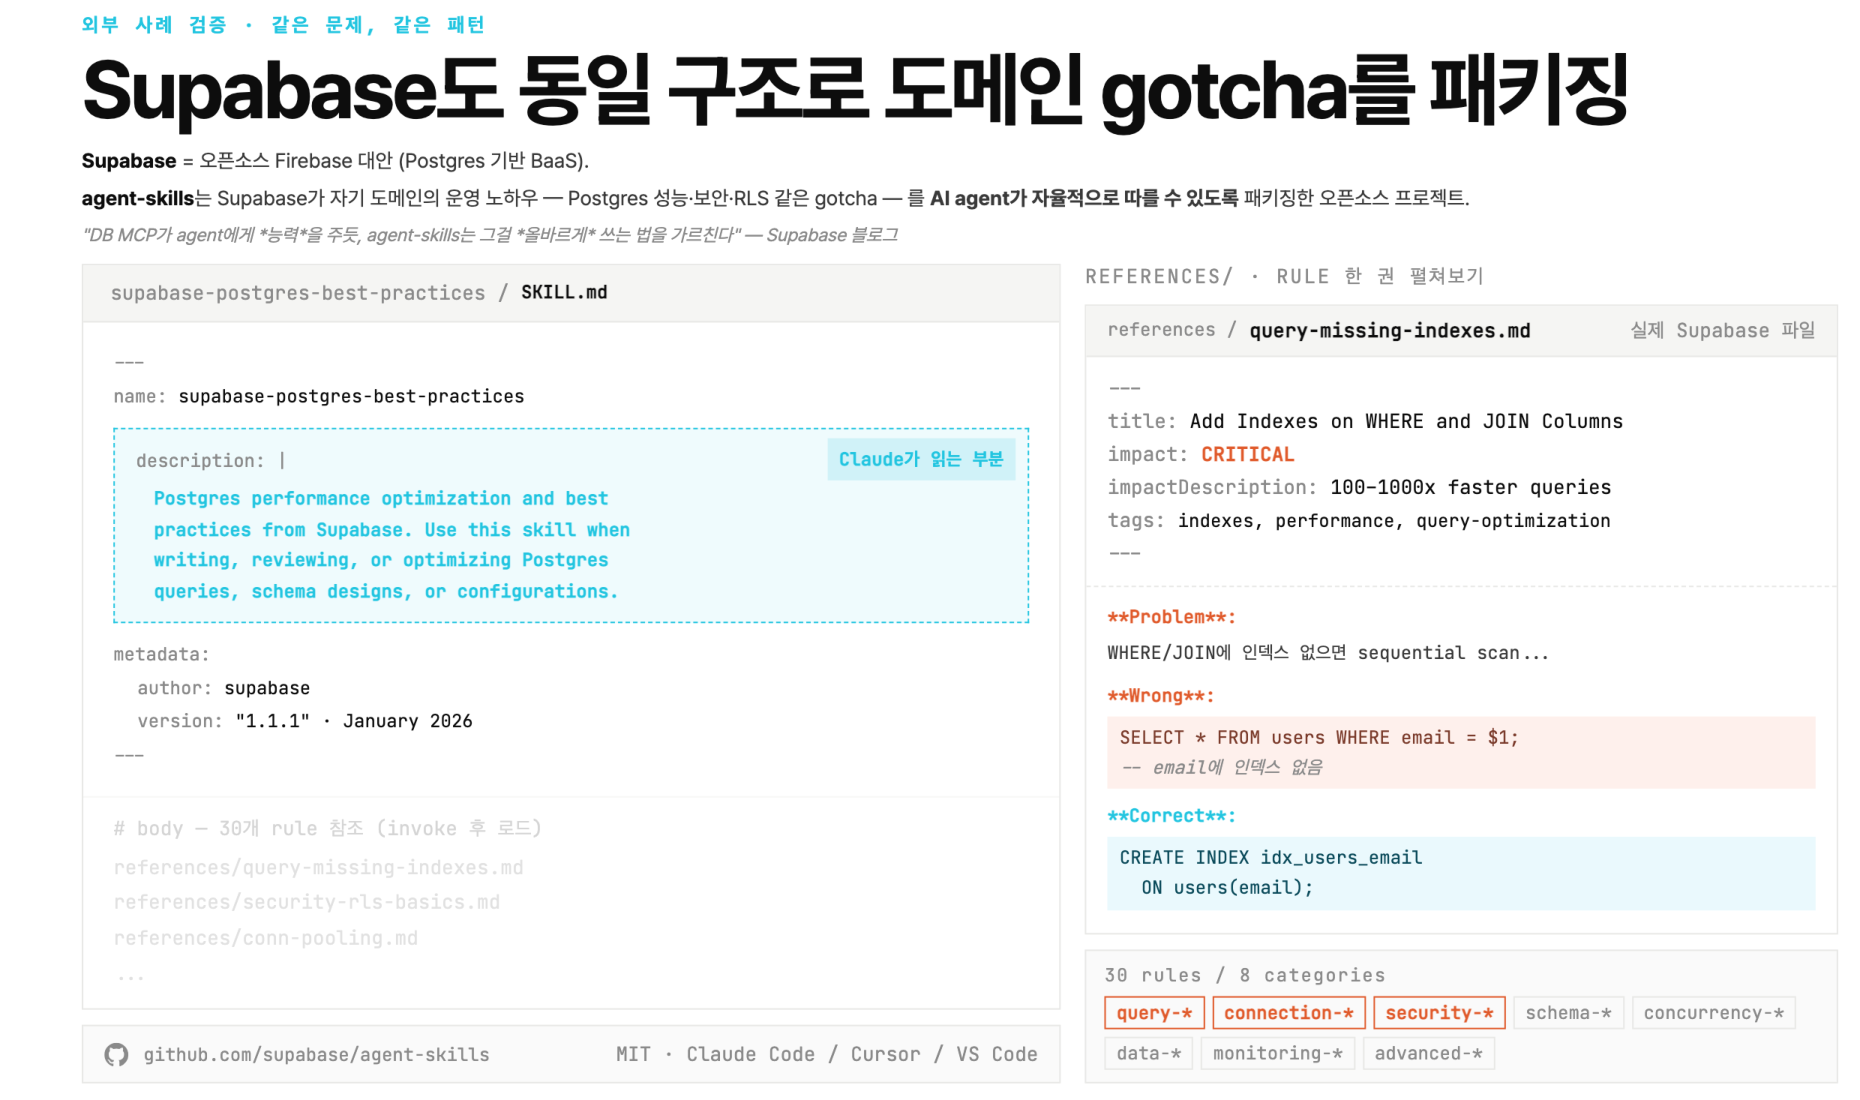
SKILL.md를 입구로 두고 주제별 규칙을 references/에 분리한 Supabase의 구성
Supabase의 각 규칙은 Problem, Wrong, Correct, References 네 부분으로 구성됩니다. 규칙 30개는 query-, conn-, security-, schema- 등을 포함한 접두사 8개로 분류돼 있습니다. 다른 도메인의 팀이 같은 설계 도구를 사용해 저희가 향하던 방향과 거의 같은 구조에 도달했다는 점은, 도메인별 함정을 관리하기에 적합한 구조라는 신호였습니다.
패턴의 차용과 재구성 — vllm_version과 Source 필드
저희는 이 구조를 가져오되 vLLM 도메인에 맞게 세 가지를 다듬었습니다.
첫째, 규칙을 pool-, cls-, gen-, embed-, rerank-, general- 접두사로 분류하되, 각 규칙을 Problem, Wrong, Correct, References의 네 부분으로 구성하는 형식은 그대로 차용했습니다.
둘째, 변환 절차와 도메인 지식을 서로 다른 두 스킬로 나눴습니다.
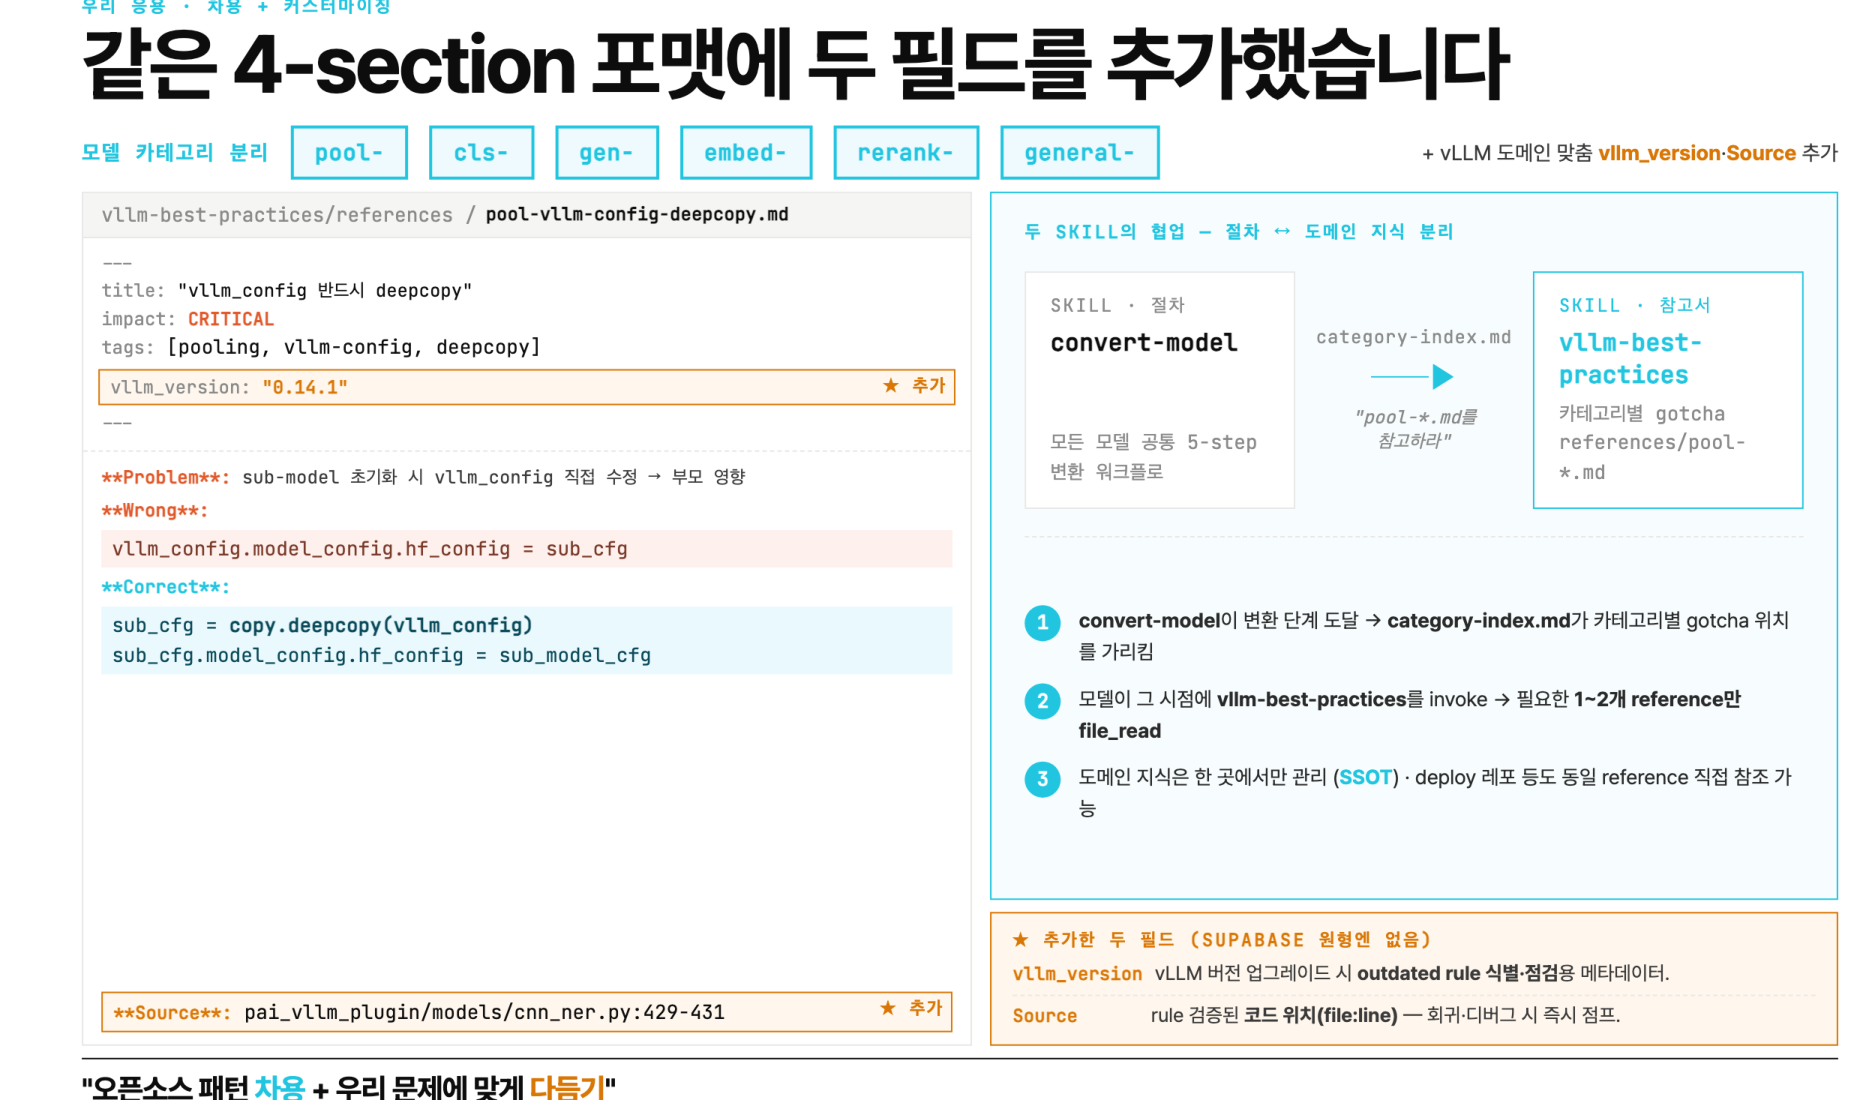
절차 스킬이 모델 유형에 맞는 도메인 규칙만 선택해 읽는 구조
convert-model은 변환 단계와 순서를 관리하는 절차 스킬이고, vllm-best-practices는 모델 유형별 함정을 관리하며 도메인 지식의 단일 기준(SSOT) 역할을 하는 스킬입니다. 비유하면 전자는 변환 과정을 이끄는 ‘커리큘럼’이고, 후자는 필요한 지식을 찾아보는 ‘참고서’입니다. category-index.md는 두 스킬을 잇는 명시적인 포인터입니다. convert-model은 특정 유형의 모델을 처리할 때 이 파일에서 필요한 규칙의 위치를 확인하고, 그 시점에 vllm-best-practices를 호출해 해당 규칙만 읽습니다.
셋째, Supabase의 원형에는 없지만 vLLM의 빠른 변화를 고려해 두 가지 메타데이터를 추가했습니다.
vllm_version: "0.14.1"(frontmatter): 해당 규칙을 검증한 vLLM 버전입니다. 예를 들어 vLLM 0.15가 나왔을 때 다시 확인하거나 수정해야 할 규칙을 찾는 데 사용합니다.Source: <파일 경로>:<줄 번호>(body 끝): 규칙을 실제로 검증한 코드의 위치입니다. 관련 코드가 바뀌었을 때 규칙이 여전히 유효한지 바로 확인할 수 있습니다.
공개된 좋은 패턴을 그대로 가져오는 데서 끝내지 않고, 규칙 분류와 스킬 간 협업 구조, 버전·근거 코드 추적 방식을 vLLM 변환 문제에 맞게 다듬었습니다.
결과 — 호출당 토큰 97% 절감과 결정 주체의 전환
다듬은 결과는 수치로 확인할 수 있었습니다. 규칙 45개는 풀링 8개, 분류 7개, 생성 9개, 임베딩 6개, 재순위화 8개, 공통 7개로 정리됐습니다.
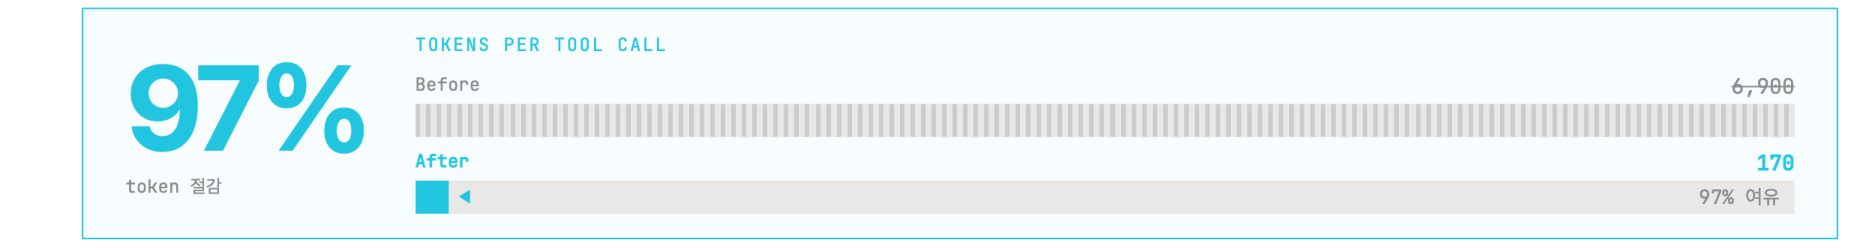
훅 방식과 스킬 방식의 호출당 토큰 수 비교(6,900개 → 170개, 97% 감소)
도메인 지식을 전달하는 데 필요한 호출당 토큰 수는 6,900개에서 170개로 97% 줄었습니다. 전체 지식을 반복해서 넣는 대신, 에이전트가 필요한 시점에 관련 규칙만 읽도록 만든 결과입니다. 새 세션에서 vllm-best-practices가 자동으로 호출되고 관련 참조 문서만 선택해 읽는 것도 검증했습니다.
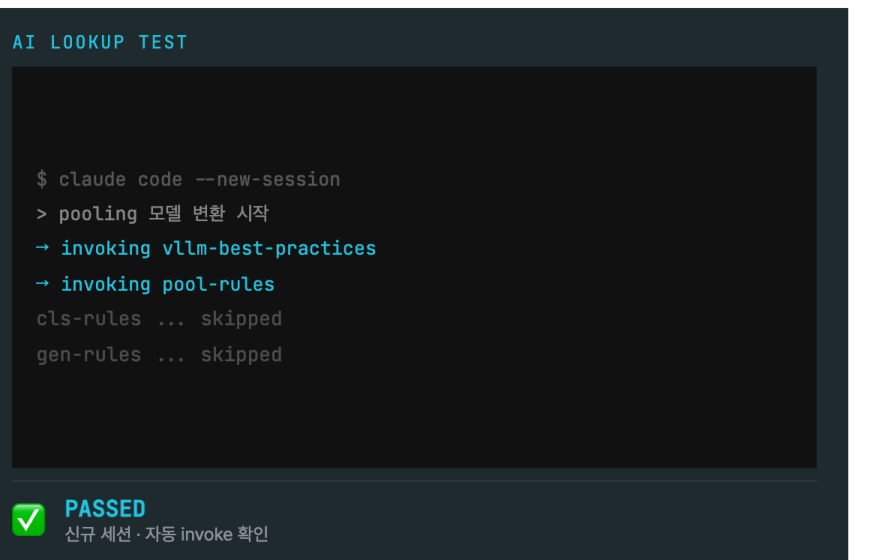
새 세션의 에이전트가 작업과 관련된 참조 문서만 선택한 결과
수치보다 중요한 것은 지식을 선택하는 주체가 달라졌다는 점입니다.
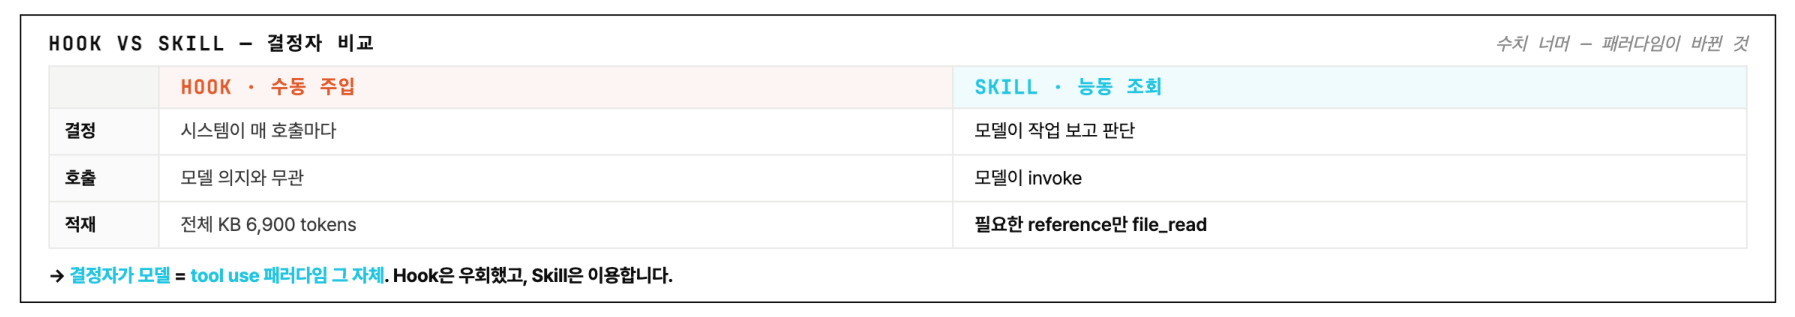
훅에서는 시스템이 지식을 강제로 입력하고, 스킬에서는 에이전트가 필요한 지식을 선택합니다.
훅 방식에서는 시스템이 어떤 지식을 넣을지 미리 결정하지만, 스킬 방식에서는 모델이 작업과 설명을 비교해 필요한 도구를 선택합니다. 필요한 도구를 결정하고 호출하며 지식을 읽는 주체가 시스템에서 모델로 바뀐 것입니다. 훅은 이 선택 메커니즘을 우회하고, 스킬은 이를 이용합니다.
GitHub Issue에서 시작하는 배포 자동화
지금까지는 한 저장소 안에서 두 스킬이 협업하는 방식을 다뤘습니다. 마지막으로 이 방식을 저장소 경계 너머로 확장해, 모델 변환뿐 아니라 배포까지 같은 원리로 연결했습니다.
Issue 폼 하나로 시작되는 배포
저장소의 변경 사항을 기준으로 배포 상태를 관리하는 GitOps 저장소에 ‘KServe vLLM 신규 배포’ Issue 템플릿을 만들었습니다. Issue가 생성되면 GitHub Actions가 배포 스킬인 kserve-vllm-deploy를 자동으로 실행합니다.
배포를 시작할 때 사용자가 하는 일은 Issue 폼 작성뿐입니다. 모델 이름과 버전, 모델 저장소 경로, 배포 환경, GPU 유형을 입력하면 에이전트가 Issue를 분석해 방향을 제안하는 코멘트를 남깁니다. 코멘트에는 이름 규칙 검증, 모델 유형 추론, 모델 크기에 따른 GPU 권장, vLLM 런타임 버전 선택, 실행 인자 결정, 생성할 파일 목록과 배포 작업 체크리스트가 포함됩니다. 사람은 분석 결과를 검토해 승인하거나 수정을 요청합니다.
다음은 480M 이미지 스코어링 모델인 clip-score를 스테이징 환경의 H100 GPU에 배포한 실제 사례입니다.
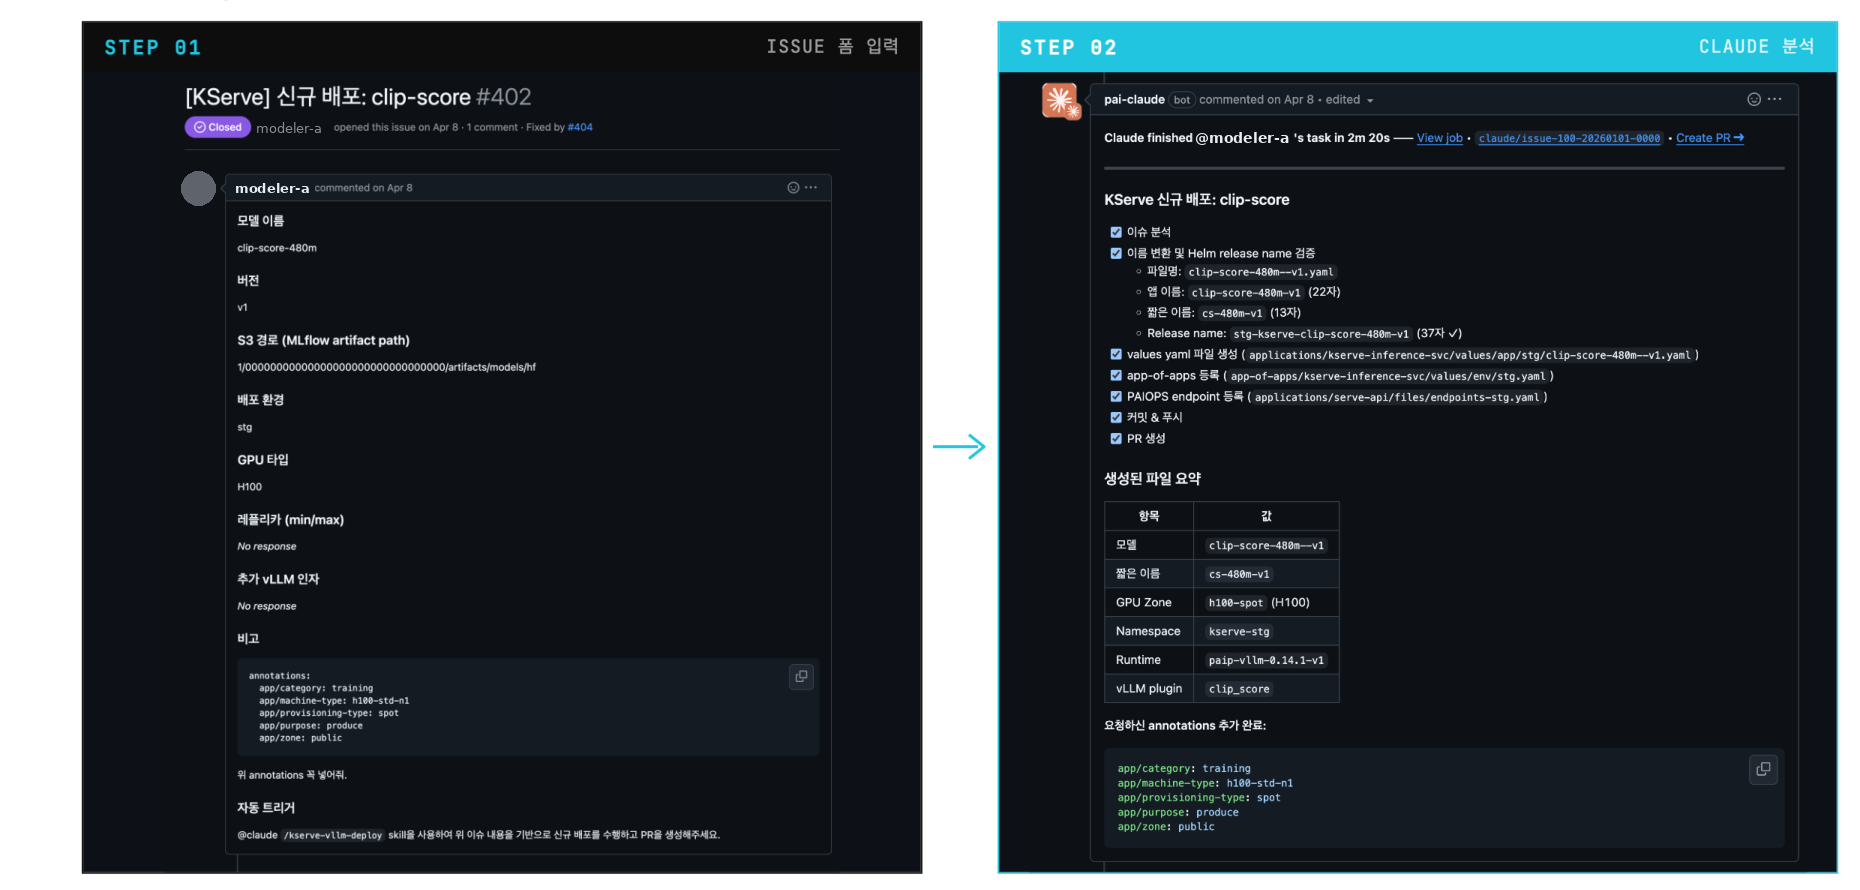
이미지 스코어링 모델 배포를 위해 작성한 Issue와 에이전트가 남긴 분석 코멘트
사람이 승인한 방향을 바탕으로 PR이 자동 생성됩니다.
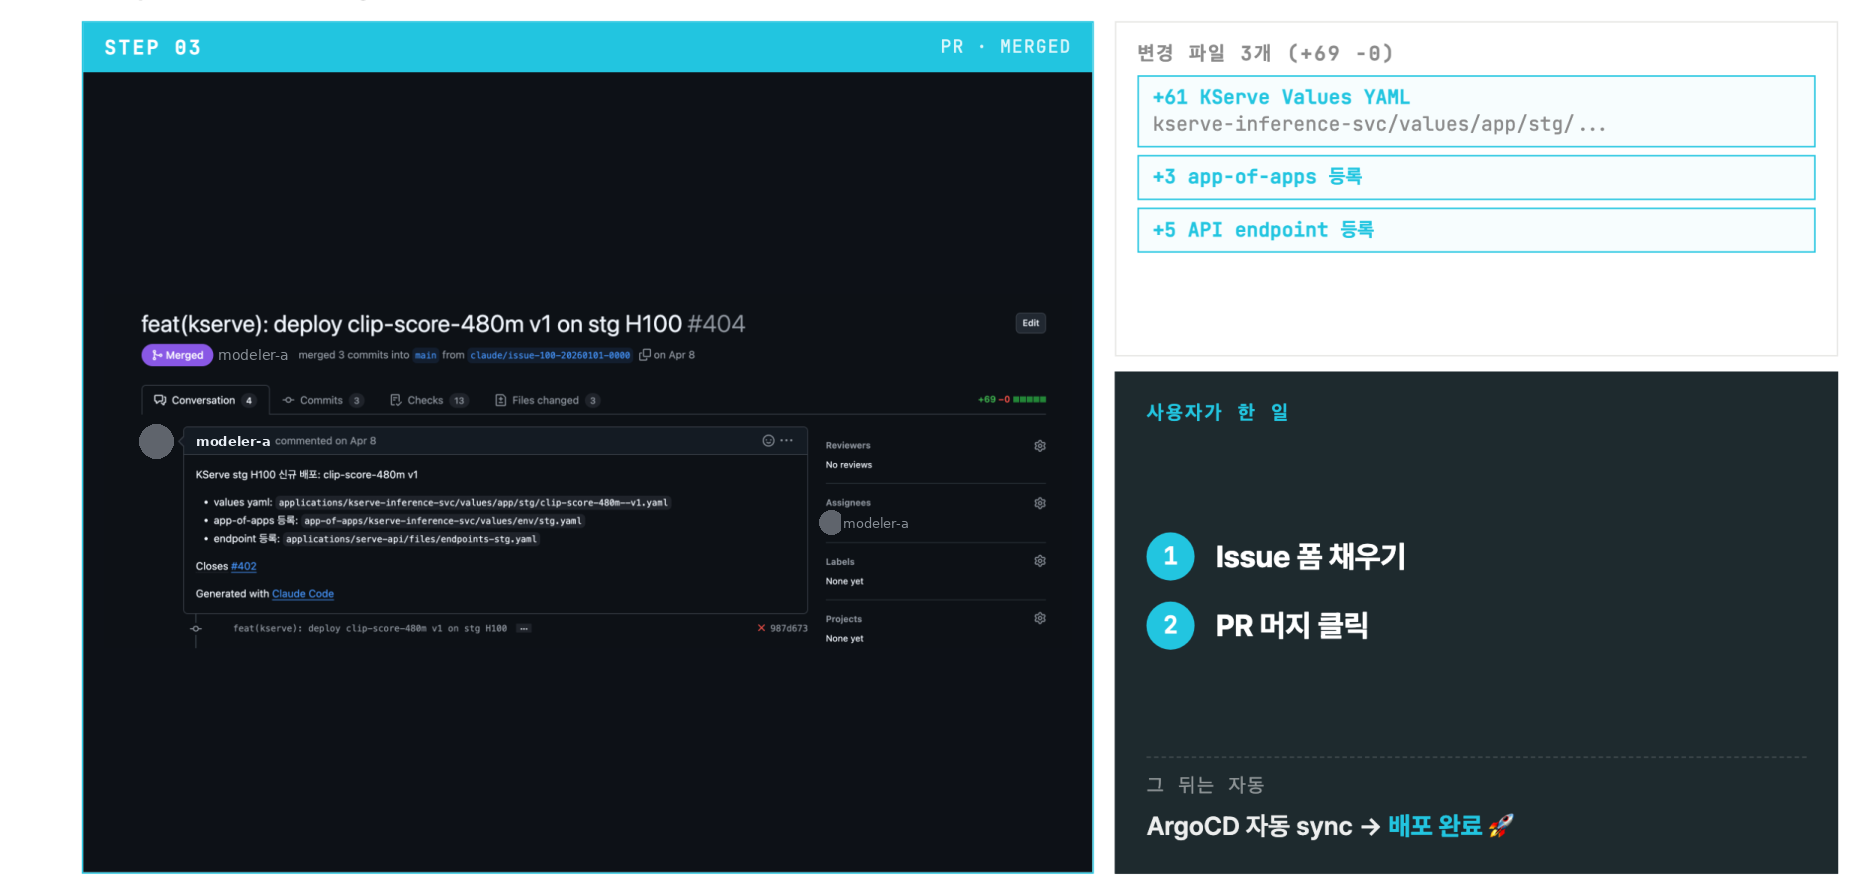
KServe values, app-of-apps 등록, API 엔드포인트 설정을 포함해 자동 생성된 PR
자동 생성된 PR에는 KServe values YAML, app-of-apps 등록, API 엔드포인트 설정까지 파일 3개의 변경 사항 69줄이 포함됐고, 실제로 머지됐습니다. 사용자가 한 일은 Issue 폼을 작성하고 PR 머지 버튼을 누른 것뿐입니다. 이후 Git 저장소의 상태를 클러스터에 자동으로 동기화하는 GitOps 도구인 ArgoCD가 변경 사항을 반영해 배포를 마쳤습니다.
GitOps 저장소에 vLLM 지식을 넣지 않은 이유
배포 스킬을 작성하다 보니 두 도메인의 지식이 하나의 SKILL.md에 섞이려는 문제가 보였습니다. 그래서 책임을 실제 소유자별로 정리했습니다.
배포 스킬에는 두 종류의 지식이 필요했습니다. 파일 경로와 app-of-apps 구성, GPU 영역 매핑은 GitOps 저장소가 관리하는 인프라 지식입니다. 반면 모델 유형별 vLLM 실행 인자와 런타임 버전, 모델 크기별 GPU 권장 사항, IO Processor 사용법은 vLLM 플러그인 저장소가 관리해야 할 지식입니다.
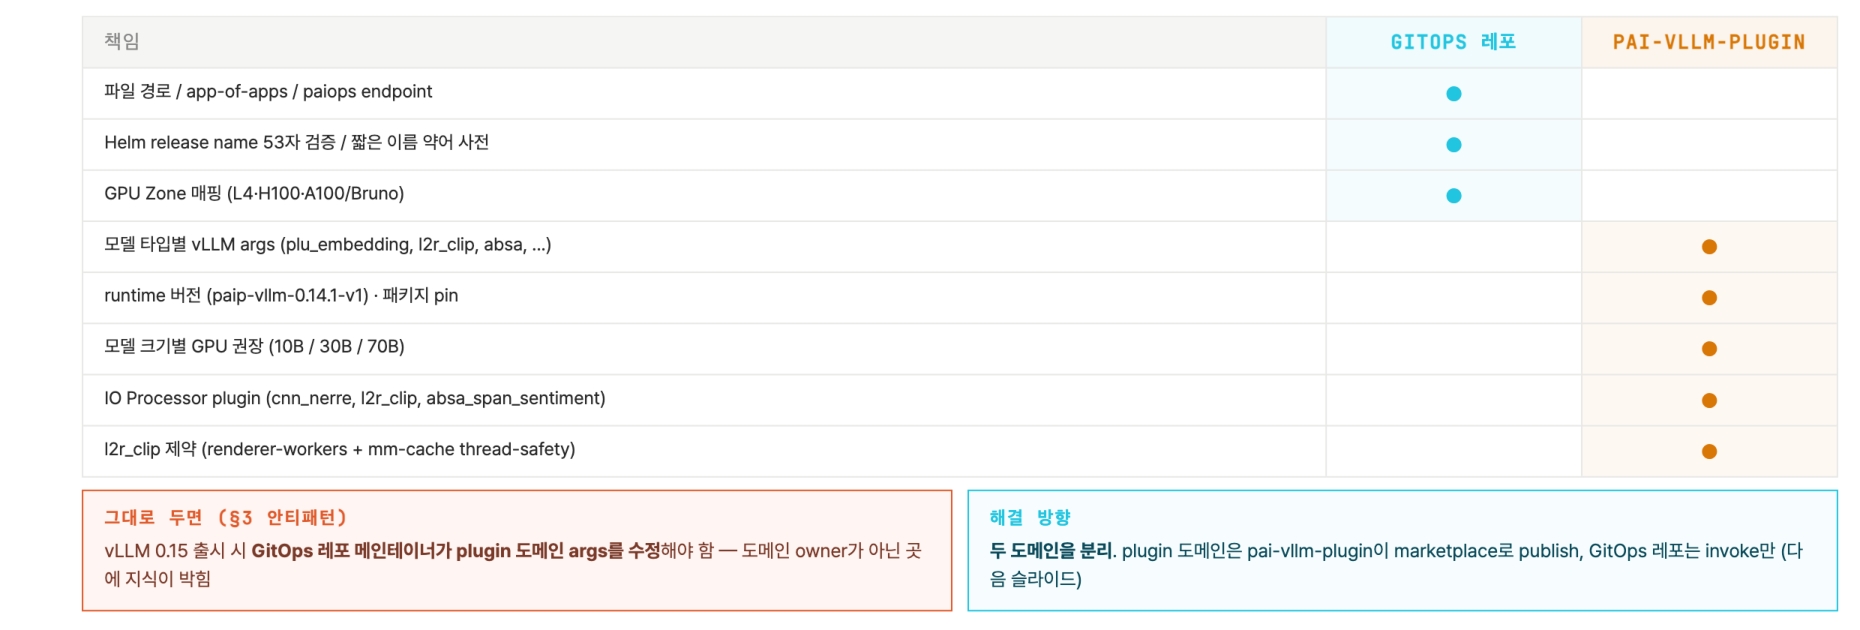
배포 인프라와 vLLM 모델 서빙 지식을 실제 소유 팀과 저장소에 따라 분리
두 지식을 하나의 SKILL.md에 넣으면 vLLM 0.15가 나왔을 때 GitOps 저장소의 담당자가 vLLM 플러그인 도메인의 실행 인자를 수정해야 합니다. 도메인 소유자가 아닌 곳에 지식이 들어가는 상황을 피하기 위해 두 도메인을 분리했습니다.
Git 저장소를 이용한 스킬 배포
저장소 사이에서 스킬을 공유하기 위해 스킬 마켓플레이스 패턴을 사용했습니다. 여기서 마켓플레이스는 별도의 서버가 아니라 스킬을 제공하는 Git 저장소의 URL입니다. GitHub Actions 설정에 저장소 URL과 사용할 플러그인 이름을 지정합니다.
plugin_marketplaces: |
  https://<git-host>/<org>/agent-plugins.git
plugins: |
  pai-vllm-serve-guide
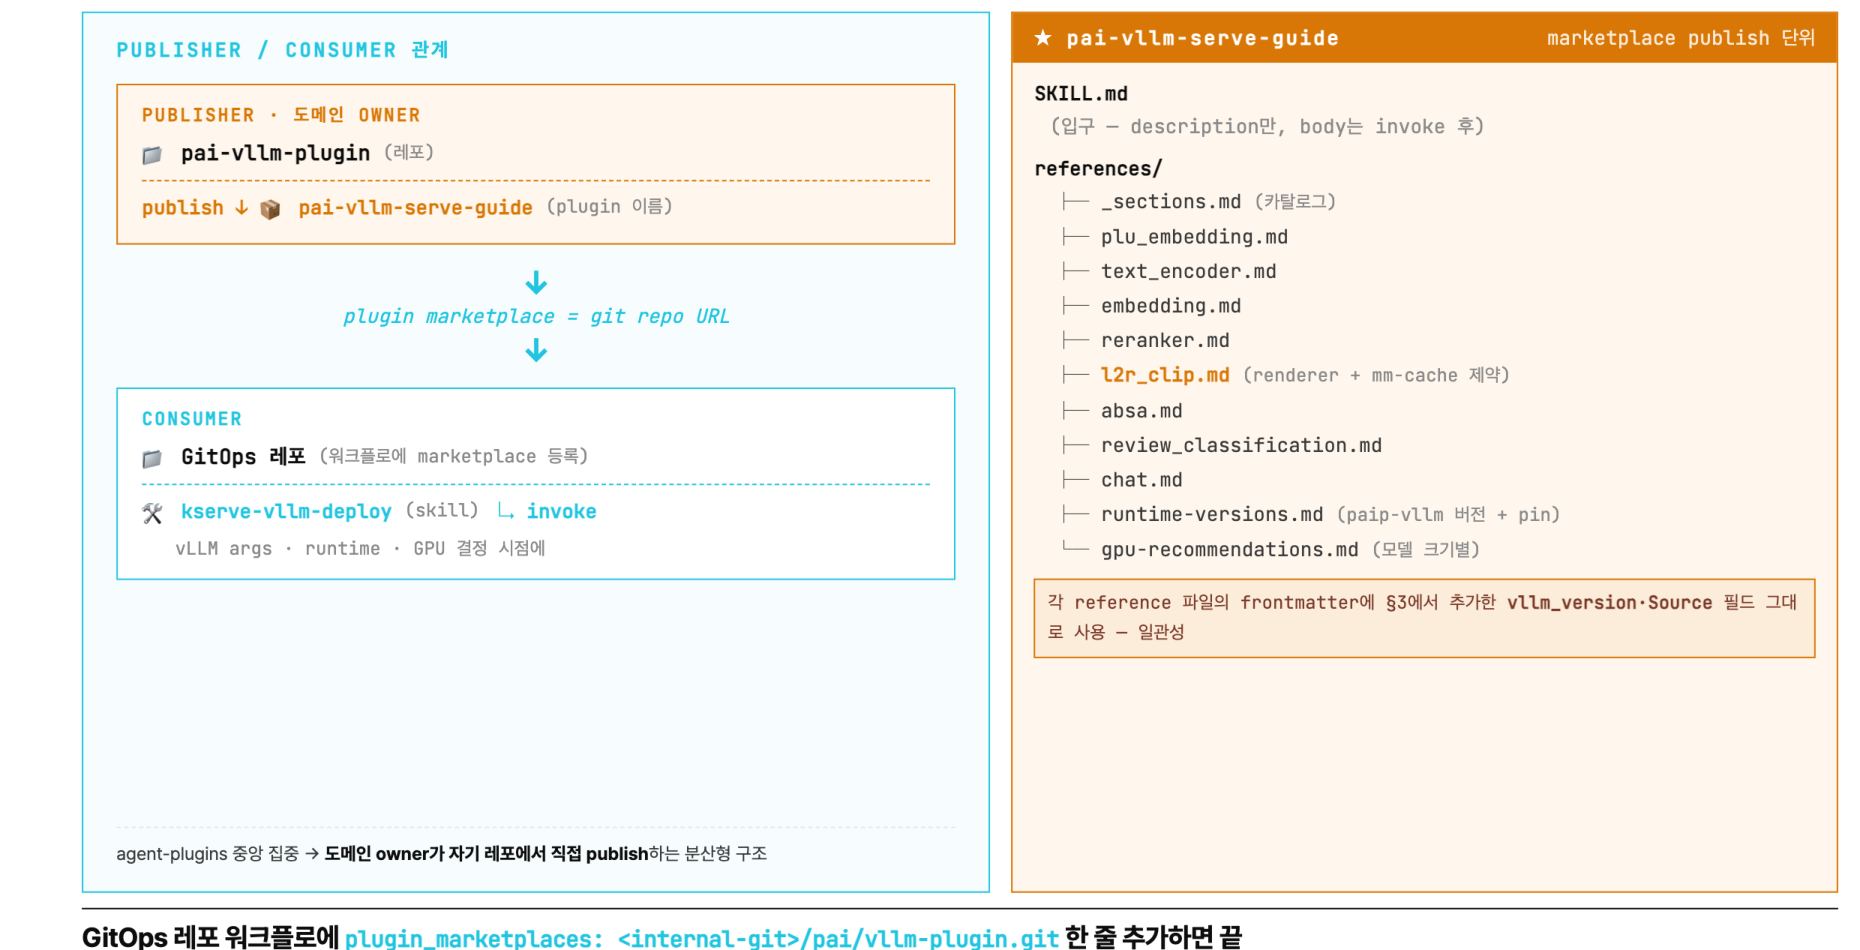
vLLM 플러그인 저장소가 서빙 지식을 제공하고 GitOps 저장소가 필요한 시점에 가져오는 구조
vLLM 플러그인 저장소는 운영 지식을 pai-vllm-serve-guide라는 플러그인으로 제공합니다. GitOps 저장소의 배포 스킬은 런타임과 GPU, 실행 인자를 결정할 때 이 플러그인을 호출합니다. 참조 문서에는 앞에서 정의한 vllm_version과 Source를 그대로 사용해 검증 버전과 근거 코드를 추적합니다. 한 저장소 안에서든 저장소 경계를 넘어서든 같은 메타데이터를 사용해 규칙 관리의 일관성을 유지합니다.
그 결과 도메인 지식 관리는 중앙 집중형에서 각 도메인 소유자가 자신의 저장소에서 직접 제공하는 분산형으로 바뀌었습니다. 일반 코드에서 패키지를 가져다 사용하는 것과 같은 구조입니다.
저장소 경계를 넘는 협업 패턴
이 구조는 한 저장소 안에서 사용한 두 스킬의 협업 방식을 저장소 경계 너머로 확장한 것입니다.
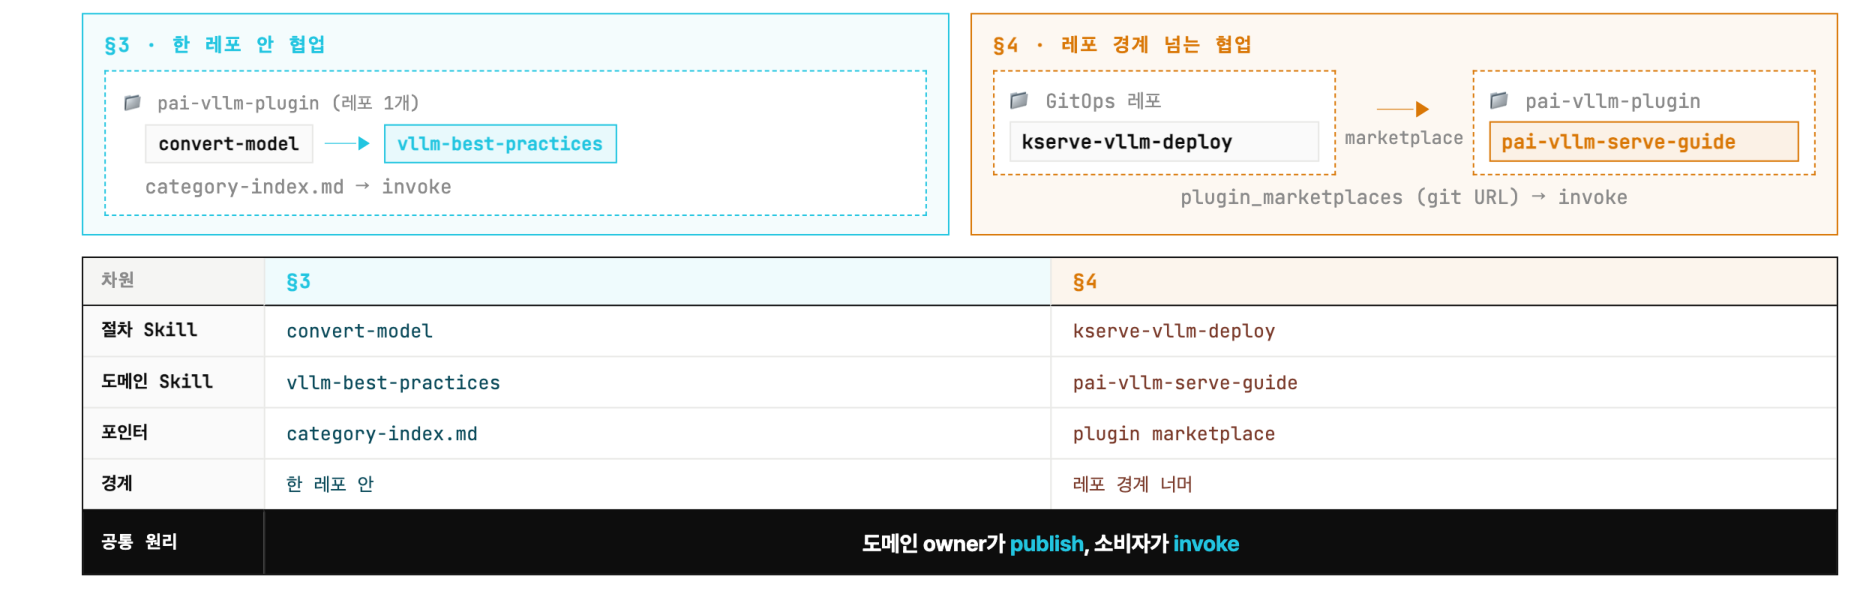
절차 스킬이 필요한 시점에 도메인 지식 스킬을 선택하는 공통 구조
변환 저장소에서는 convert-model이 category-index.md를 보고 vllm-best-practices를 선택합니다. 배포 저장소에서는 kserve-vllm-deploy가 마켓플레이스를 통해 pai-vllm-serve-guide를 선택합니다. 경계는 다르지만, 도메인 지식은 소유자가 제공하고 작업 수행자가 필요한 순간에 불러온다는 원칙은 같습니다.
사용자 입장에서는 Issue 하나로 변환부터 배포까지 끝나고, 내부적으로는 두 스킬의 협업이 Git URL 한 줄을 통해 저장소 경계를 넘어 확장됩니다.
마치며
vLLM 모델 변환과 배포 자동화를 만들고 운영하면서 다음과 같은 변화를 확인했습니다.
| 변경 전 | 변경 후 |
|---|---|
| 단계 사이 체크포인트 4개 | 컨텍스트 압축 0회의 단일 세션 |
| 호출당 6,900토큰 | 호출당 170토큰(97% 절감) |
| 수동 배포 | E2E 자동화(Issue 하나 → 배포) |
| 도메인 소유자가 아닌 저장소에 지식이 들어감 | 소유자가 제공하고 소비자가 호출하는 구조 |
이 과정에서 얻은 교훈은 네 가지입니다.
첫째, AI 도구가 업데이트되면 스킬도 함께 업데이트해야 합니다. 200K 컨텍스트에서 최선이었던 체크포인트가 1M 컨텍스트에서는 복잡도만 남겼습니다. 도구의 제약을 우회한 구조는 제약이 사라졌을 때 다시 검토해야 합니다. 기술 부채는 소스 코드에만 생기지 않습니다.
둘째, AI에게 무엇을·언제·얼마나 제공할지 직접 설계해야 합니다. 전체 지식을 통째로 넣기보다 모델이 필요한 시점에 직접 골라 읽게 했을 때 결과가 더 좋았습니다. 모델을 변환할수록 검증된 함정이 축적돼 스킬도 계속 개선됩니다.
셋째, AI-native 패턴의 진짜 가치는 차용이 아니라 자신의 문제에 맞게 재구성하는 데서 나옵니다. Supabase의 규칙 형식을 차용했지만, vllm_version과 Source를 추가해 빠르게 변하는 vLLM 환경에서도 규칙의 유효성을 추적할 수 있게 했습니다.
넷째, 좋은 협업 구조는 저장소 경계를 넘어서도 통합니다. 절차 스킬이 필요한 시점에 도메인 지식 스킬을 선택하는 구조는 Git URL 한 줄로 저장소 경계를 넘어 배포 자동화까지 확장됐습니다. 도메인 지식은 소유자가 제공하고, 소비자는 필요한 시점에 호출합니다.
여기까지가 저희가 vLLM 변환과 배포를 AI-native로 자동화하고, 그 자동화를 우리 문제에 맞게 계속 깎아온 과정입니다.