Engineering
더 작고 강해진 Kanana SLM 개발
2026년 7월 28일
원문에서 보기 ↗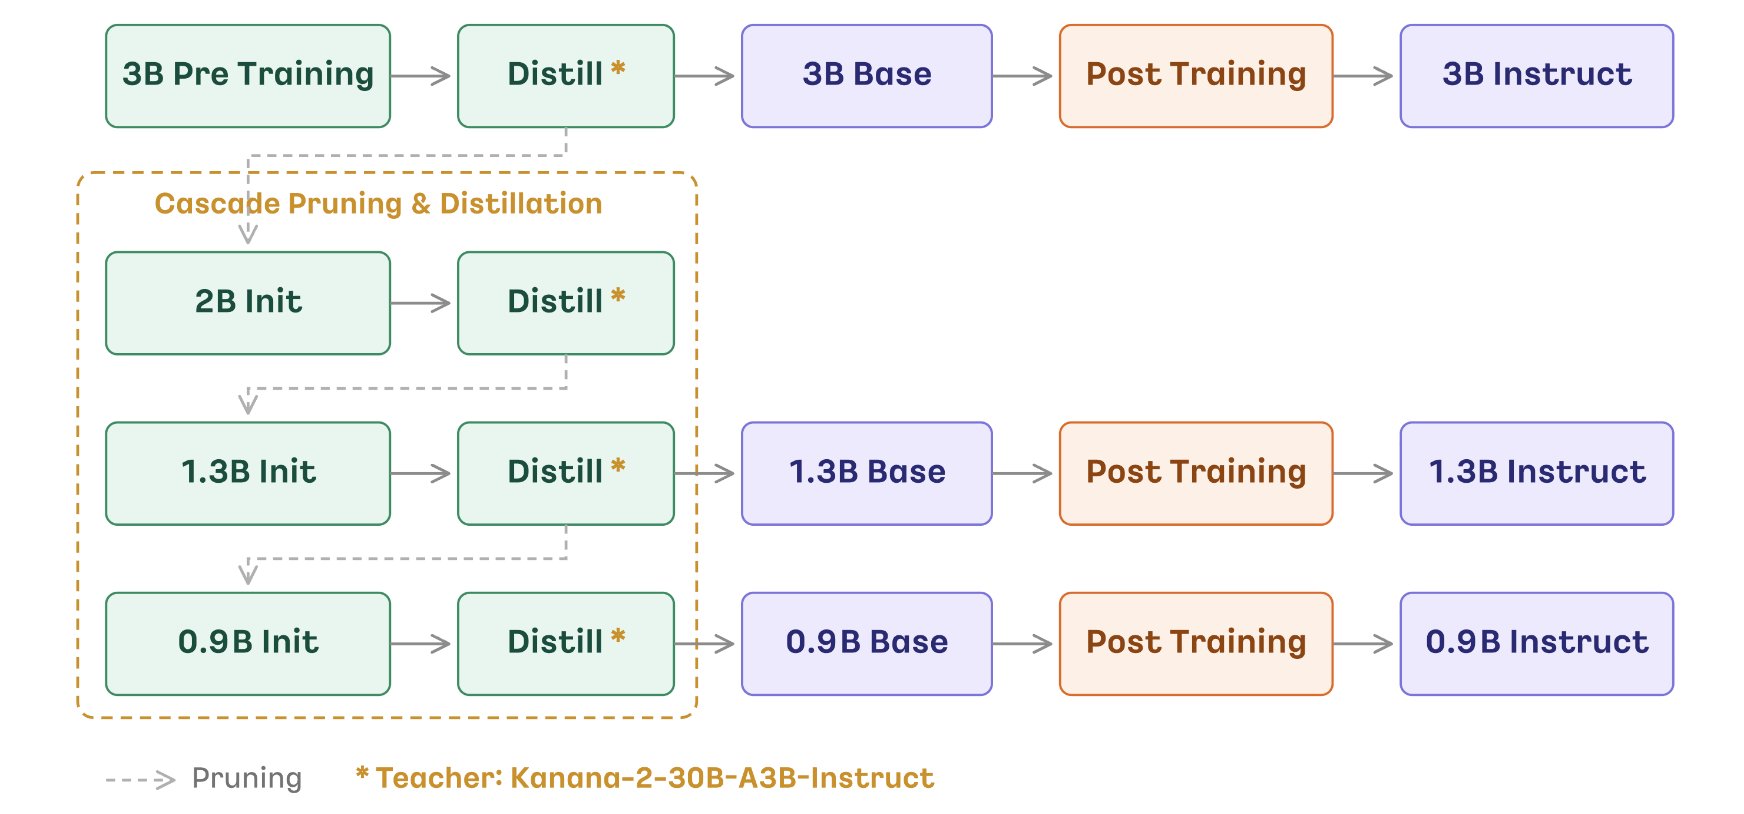
안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 LLM 조직에서 언어모델을 개발하고 있는 Kaya, Ryan, Wavy 입니다.
지난 “작지만 강한 Kanana Nano 효율적으로 개발하기”에서 비용 효율적으로 SLM(Small Language Model)을 개발하는 방법에 대해서 소개드렸었는데요, 이번 글에서는 더 강력해져서 돌아온 카카오의 두 번째 SLM 시리즈를 소개드리고자 합니다.
이번에 소개해드릴 모델은 Kanana-2-3B, Kanana-2-1.3B, Kanana-2-0.9B 총 세 가지 모델이며 강력한 SLM을 만들기 위하여 사용했던 다양한 학습 기법에 대해서 상세하게 공유드리고자 합니다. 더불어, Kanana-2-3B, Kanana-2-1.3B 모델의 Base, Instruct 모델까지 모두 공개하오니 많은 관심 부탁드립니다.
작년 “Kanana LLM 1.5 개발기”를 통해서 소개해 드렸던 것처럼, Agentic AI가 화두가 되어 모델의 크기가 더 커지고 더 많은 출력을 통해서 성능을 끌어올리면서 올해는 진정 Agentic AI의 해라고 부를 수 있을 정도로 이제는 일상에서 없어서는 안될 기술이 되었습니다.
하지만 실제 비즈니스 환경에서는 여전히 SLM을 필요로 하고 있습니다. 특히 스마트폰과 같은 온디바이스(On-device) 환경에서는 매우 제한된 메모리와 연산 자원으로 인하여 SLM은 선택이 아닌 필수이며, 이에 따라 서비스에서 요구하는 다양한 상황에 대처할 수 있도록 강력한 성능을 유지하면서도 작고 빠른 모델을 제공해야 합니다.
카카오에서도 지난 3월 온디바이스 AI기반 서비스인 카나나 인 카카오톡을 정식 출시하였으며, 자체 개발한 SLM을 활용하고 있습니다. 이에 따라 저희 카나나 LLM 조직에서도 지속적으로 더 강력하면서도 더 효율적인 SLM을 개발하기 위해서 꾸준히 노력하고 있습니다.
이번 Kanana-2 SLM 개발에는 지난 Kanana-2-30B-A3B 개발 과정에서 얻은 노하우를 활용함과 동시에, 이전 Kanana Nano 모델을 만들 때 보다 진화된 Pruning & Distillation 방법 그리고 teacher 모델을 활용하는 off-policy, on-policy 학습을 새로 도입하여 더욱 강력한 모델을 만들 수 있었습니다.
학습 방법 외에도 추론 및 언어 효율성을 대폭 다듬었습니다.
- Kanana-2 Tokenizer: 주요 대상 언어인 한국어 처리 효율을 기존 대비 30% 이상 향상함.
- Sliding Window Attention(SWA): KV Cache 크기를 축소하여 추론 메모리 효율을 크게 개선함.
지금부터 이러한 배경을 바탕으로 저희가 어떻게 강력하고도 효율적인 SLM을 만들었는지 상세히 공유드리도록 하겠습니다.
3B Pre-Training
Kanana-2-3B-Base 모델은 TPU 기반의 사전 학습을 시작으로, teacher 모델을 활용한 Distillation, 그리고 32K까지의 Long Context 학습 과정을 거쳐 개발되었습니다. 모델의 기초 체력을 다지고 성능을 극대화하기 위해 수행한 기술적 여정을 단계별로 소개합니다.
[TPU 기반 사전학습 (7.5T + 2T)]
       ↓
[GPU 기반 Teacher Distillation]
       ↓
[32K Long Context & LR Decay (Mid-training)]
TPU 기반 Pre-Training (From Scratch)
먼저, TPU v5e 클러스터에서 MaxText 기반의 자체 학습 프레임워크를 사용해 3B 모델을 from scratch로 사전학습하였습니다. 카카오 LMT(Language Model Training) 조직은 TPU와 GPU 간 seamless하게 학습을 이어갈 수 있는 기술을 확보해 왔으며, 이를 통해 동일한 모델을 가속기 종류에 상관없이 필요에 따라 서로 다른 클러스터에 분배하여 학습을 진행할 수 있었습니다.
실제로 Kanana-2-3B도 TPU에서 사전학습을 마친 뒤, 이어지는 Distillation 학습은 GPU 클러스터에서 자연스럽게 진행되었습니다.
TPU에서 진행한 사전학습은 2-staged pre-training 방식으로 진행했습니다.
- Stage-1: 7.5T 토큰
- Stage-2: 2T 토큰
- Optimizer : 사전학습 전 구간에 Muon Optimizer 적용 (Pre-training 블로그 참조)
한편, 이러한 대규모 학습 환경에서는 Learning Rate와 같은 하이퍼파라미터를 본 학습 스케일에서 직접 탐색하는 것이 사실상 불가능합니다. 이에 저희는 적은 예산으로 탐색이 가능한 'Proxy Token Scale’을 활용하였습니다.
구체적으로는 Stage 1의 데이터 분포를 그대로 유지한 채 100B 토큰 규모의 Proxy Scale에서 다양한 Learning Rate 후보군을 먼저 탐색했습니다. 이후, 여기서 도출된 최적 LR을 본 학습 스케일에 맞춰 스케일링하여 적용하였으며, 이 과정에서 “Scaling Optimal LR Across Token Horizons” 에서 제안한 Token Horizon 스케일링 법칙을 참조하였습니다.
\text{LR}^*(D_{\text{target}}) \approx \text{LR}^*(D_{\text{proxy}}) \cdot (D_{\text{target}} / D_{\text{proxy}})^{-\beta}
여기서 D_proxy = 100B, D_target = 7.5T이며, β는 논문의 권장값인 0.32를 사용하였습니다. 최적 LR은 Token Horizon이 길수록 작아지는 경향을 보입니다. 이러한 스케일링 법칙을 활용하여, 제한된 탐색 예산으로도 본 학습 규모에 맞는 안정적인 학습 설정을 확보할 수 있었습니다.
Distillation
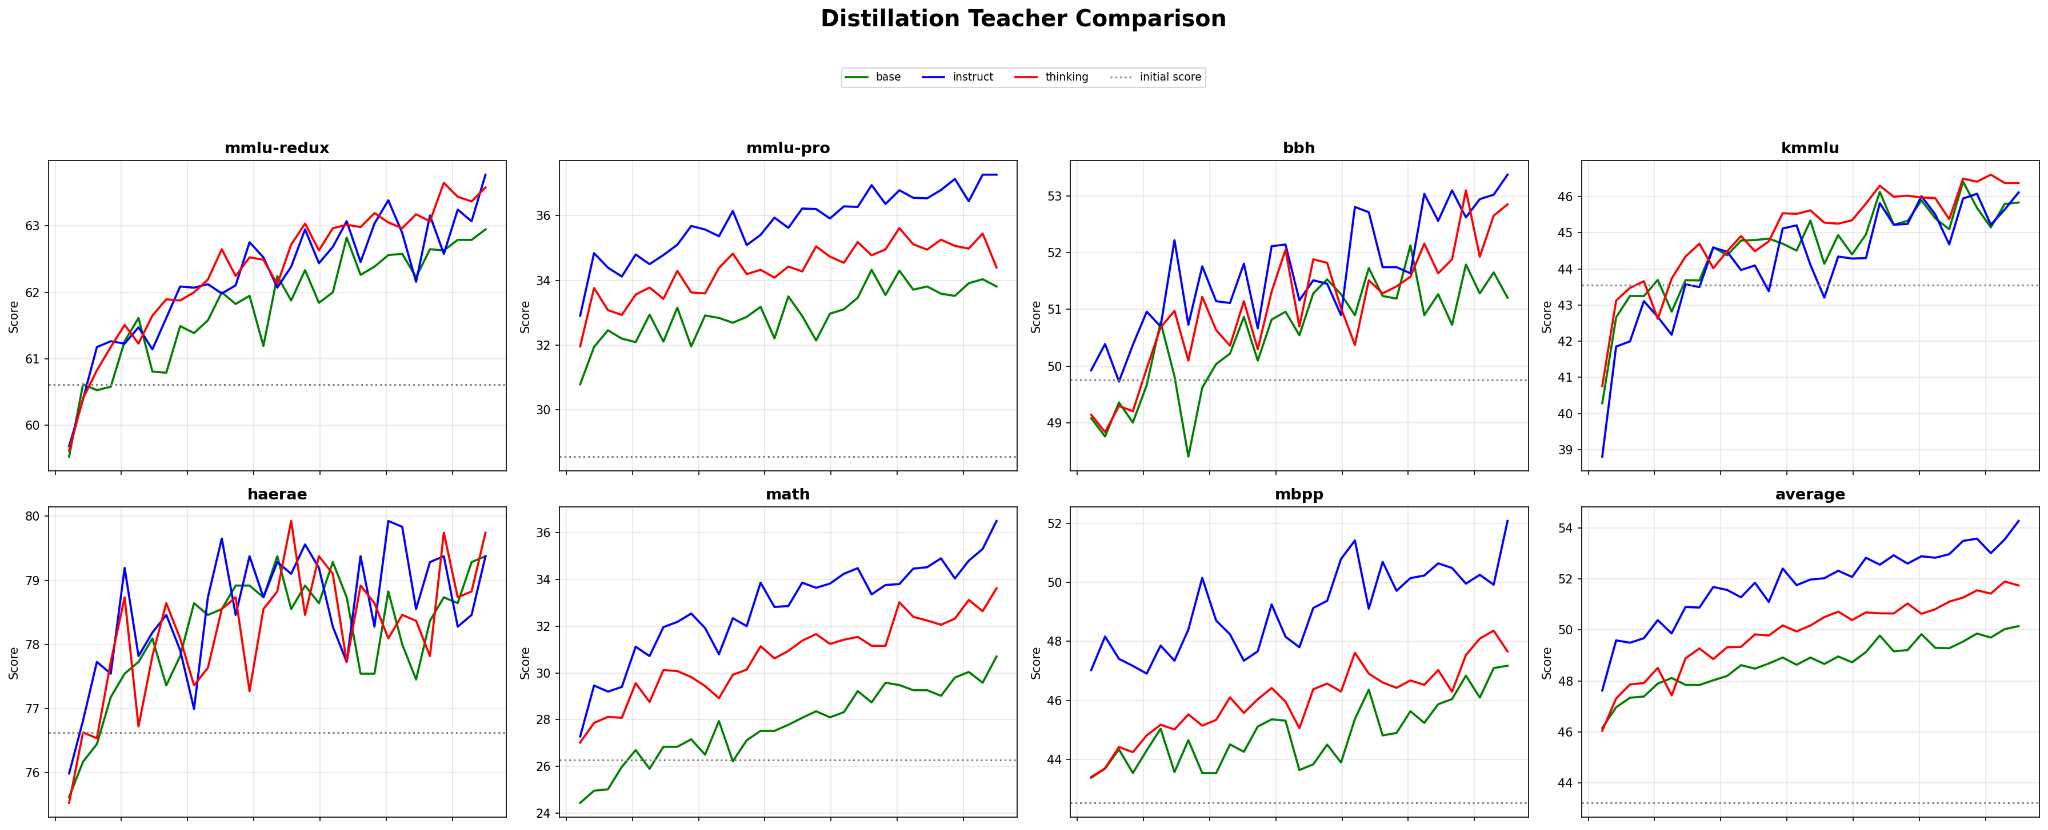
이어 GPU 클러스터 기반의 자체 Megatron-LM 프레임워크를 활용하여 Kanana-2-30B-A3B-Instruct-2601 모델을 Teacher로 설정하고 Distillation 학습을 수행하였습니다.
최근 연구(Distilled Pretraining, Ministral3)에 따르면, Pre-trained 모델보다 Post-trained 모델을 Teacher로 사용할 때 특히 수학 및 코드 영역에서 성능 향상이 두드러집니다. 이를 검증하고자 Kanana-2-30B-A3B의 Base, Instruct, Thinking 모델을 각각 Teacher로 설정하여 실험을 진행했습니다.
그 결과, 학습 과정 전반에 걸쳐 Instruct 모델을 Teacher로 사용할 때 가장 우수한 성능을 보임을 확인했습니다. (그림 1. 참조)
Long Context Training
이후 4K에서 YaRN을 적용해 32K까지 길이를 확장한 Long-context 학습을 진행하였고, LR decay 단계에서 Mid-training 데이터를 추가하여 최종적으로 Kanana-2-3B-Base 모델을 학습하였습니다.
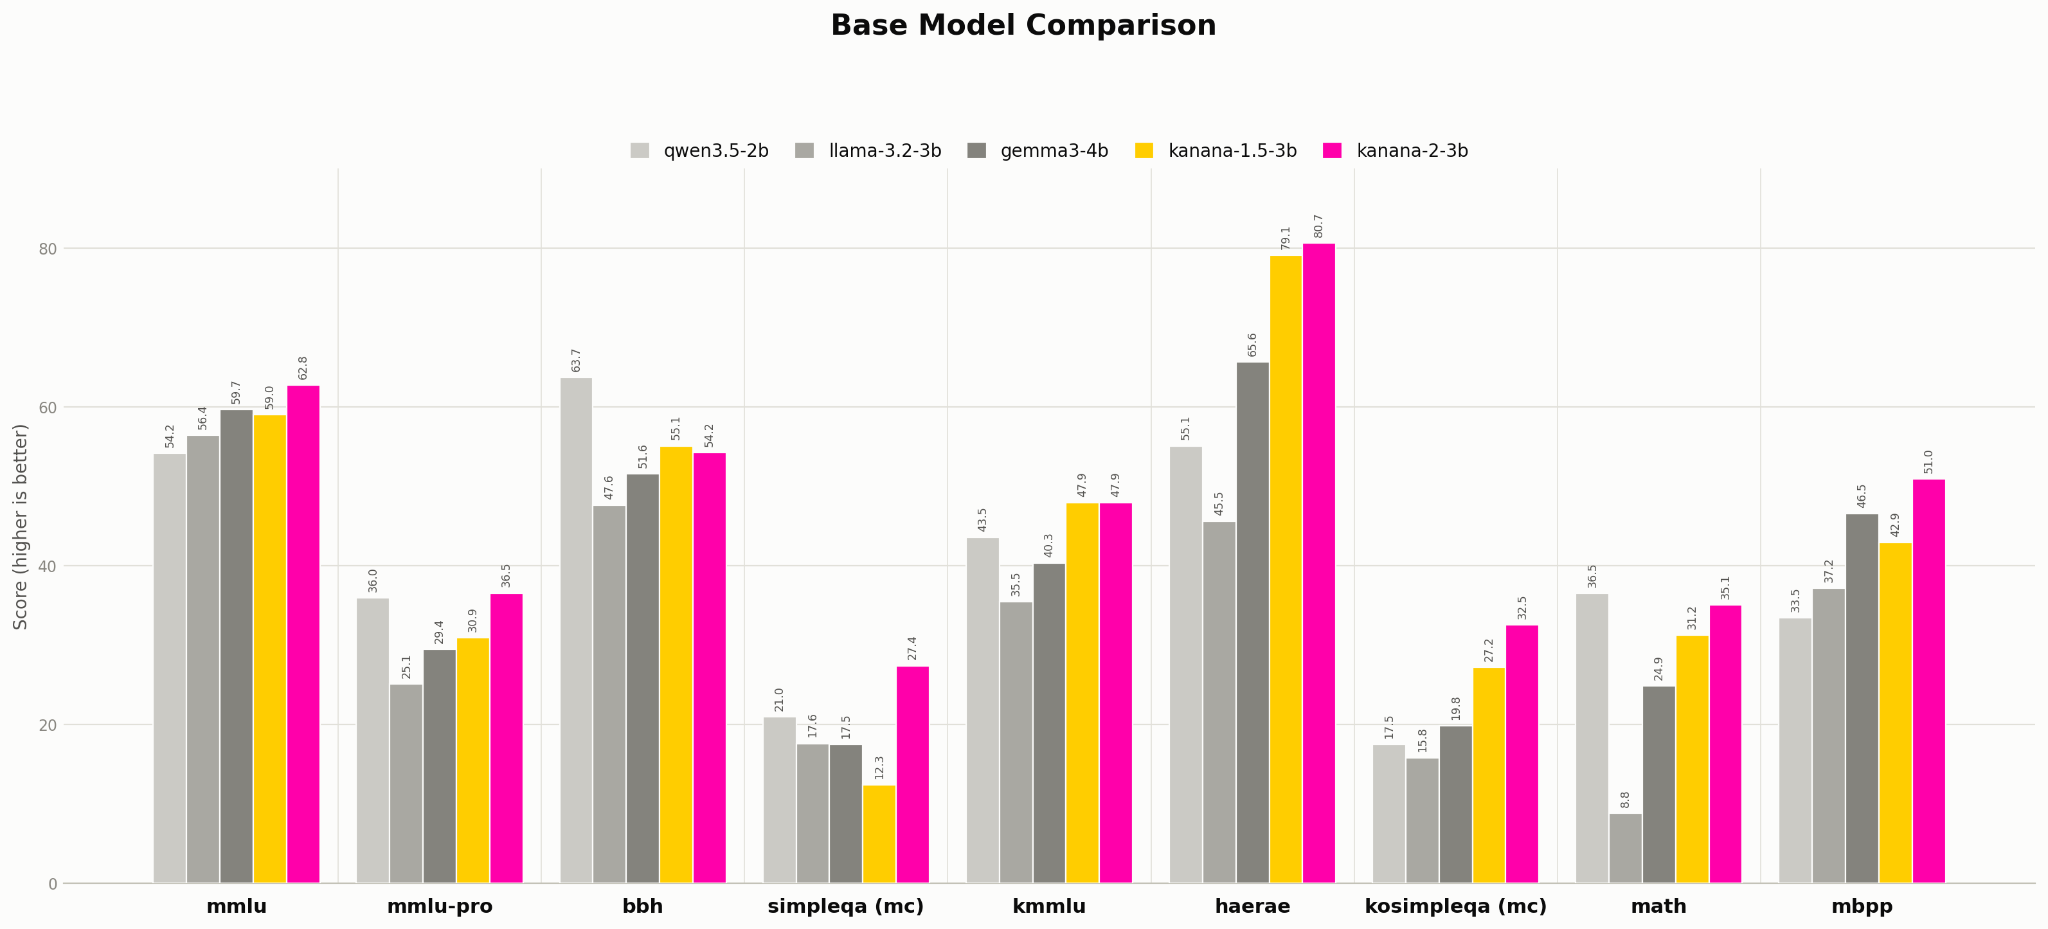
이렇게 학습된 Kanana-2-3B-Base 모델은 이전 Kanana 시리즈의 3B Base 모델들을 한국어/영어 지식, 수학, 코드 등의 모든 영역에서 크게 능가할 뿐만 아니라 유사 사이즈의 오픈 소스 SOTA Base 모델들과 비교해도 대부분의 영역에서 상회하는 결과를 보였습니다.
Pruning & Distillation (1.3B & 0.9B)
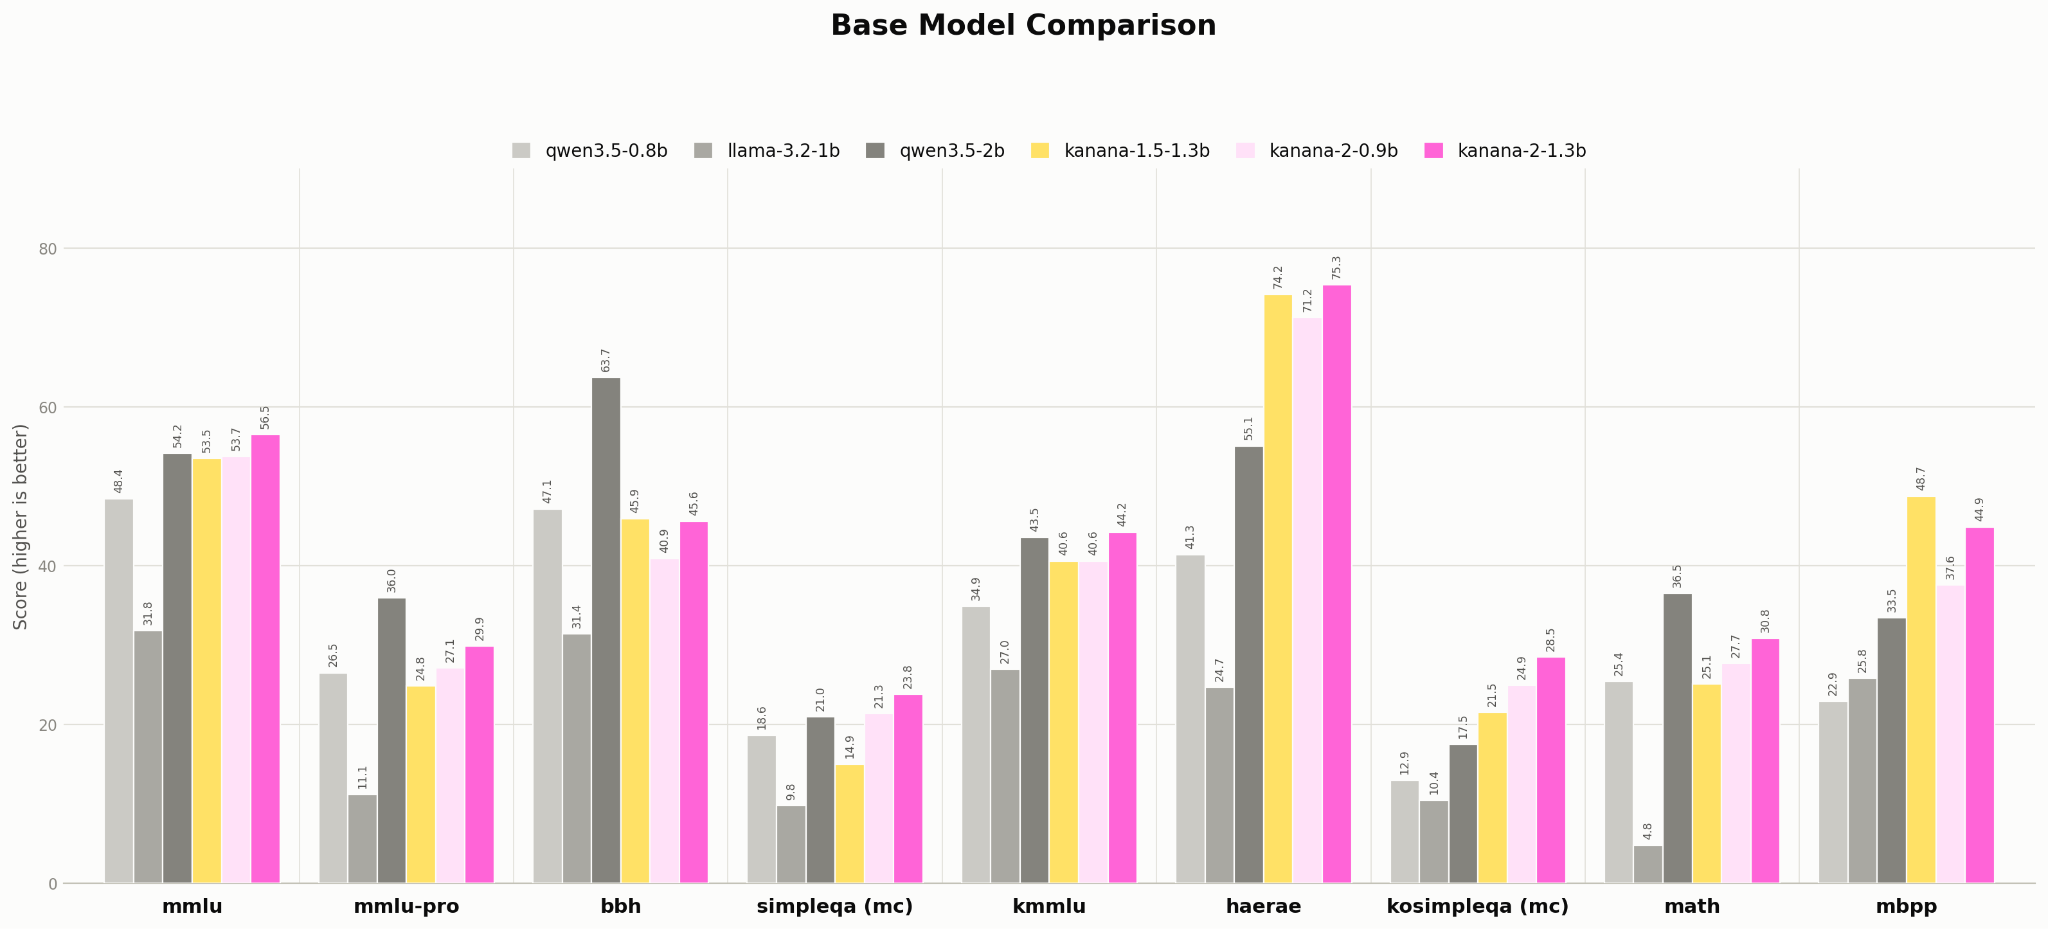
이전 Kanana Nano에서는 Kanana Essence-8B를 다양한 크기의 Nano 모델로 압축하기 위해 Minitron[1, 2] 기반 Pruning & Distillation 방법을 소개했었습니다. 이번 Kanana-2 SLM에서는 이를 한 단계 발전시켜, Kanana-2-3B-Base로부터 Kanana-2-1.3B-Base 와 Kanana-2-0.9B-Base를 단계적으로 개발했습니다.
또한 온디바이스 환경에서 Decoding 속도 병목을 완화하기 위해 Sliding Window Attention(SWA)를 도입하고, SWA 환경에 맞춘 Long Context 학습을 수행했습니다.
Pruning 방법 세부 개선 및 탐색
Pruning & Distillation은 모델의 크기를 줄이는 대표적인 압축 기법입니다. LLM에서는 Layer, Hidden Dimension, MLP intermediate dimension, Attention head 등 다양한 Component를 대상으로 하는 Pruning 기법이 활발히 연구되고 있습니다[1, 2, 3, 4].
이전 Kanana Nano에서는 Minitron의 Structured Pruning과 Knowledge Distillation 방법론을 기반으로, Importance Scoring과 세부 Pruning 방식을 개선하여 모델을 압축했습니다. 이번 Kanana-2 SLM에서는 Hidden dimension pruning 방법을 한 단계 더 고도화했습니다. 기존 Hidden dimension pruning은 Calibration 데이터를 Forward하여 얻은 Activation을 기반으로 각 Hidden dimension의 Importance score를 계산하고, Importance score가 높은 Dimension만 선택하여 Hidden dimension을 축소합니다. 이러한 방법은 구현이 단순하고 효율적이지만, 각 Hidden dimension을 독립적으로 평가하기 때문에 Hidden representation이 여러 Dimension에 걸쳐 형성하는 정보를 충분히 고려하지 못한다는 한계가 있습니다.
이번 Kanana-2 SLM에서는 이러한 한계를 보완하기 위해 Ministral 3에서 제안한 PCA(Principal Component Analysis) 기반 Hidden dimension pruning을 적용했습니다.
처리 절차:
- Calibration 데이터로 모든 레이어의 Attention RMSNorm Input, MLP RMSNorm Input, Final RMSNorm Input의 Activation 통계를 수집합니다.
- PCA를 실행해 Global Rotation Matrix를 계산합니다.
- 이를 Token Embedding, Attention, MLP Projection Weight 입출력에 일관되게 적용해 Hidden dimension을 회전 후 축소합니다.
- 회전된 모델에서 다시 Activation을 수집하여 Attention head와 MLP intermediate dimension의 Importance score를 계산하고 순차적으로 Pruning을 진행합니다.
MLP intermediate dimension pruning 시 score 합산 방식도 다각도로 검토했습니다.
- Global 방식: 전체 레이어 점수를 통으로 합산해 모든 레이어에서 동일 Index 제거
- Layer-wise 방식: 레이어별 Importance를 따로 측정하여 서로 다른 Index 제거
이번 PCA 기반 파이프라인에서는 두 방식의 성능 차이가 거의 없었기 때문에, 레이어별 Activation 특성을 유연하게 반영할 수 있는 Layer-wise 방식을 선택하였습니다. Pruning에 대한 자세한 내용은 아래 Algorithm 1과 같습니다.
Algorithm 1. PCA-based Structured Pruning
def prune(model, target_config):
    # Activations are cached during calibration forward passes.
    # Norm inputs are collected before rotation, while attention and MLP
    # activations are collected after rotation.

    # Hidden dimension pruning
    norm_inputs = collect_norm_inputs(model)
    rotation = PCA(
        norm_inputs,
        n_components=target_config.hidden_dim,
    )
    model = apply_rotation(
        model,
        rotation,
        target_dim=target_config.hidden_dim,
    )

    # Attention head pruning
    head_importance = sum(
        score_query_heads(layer.attn)
        for layer in model.layers
    )
    heads_to_keep = select_topk_heads_per_kv_group(
        head_importance,
        k=target_config.query_heads,
    )
    for layer in model.layers:
        layer.attn = prune_query_heads(
            layer.attn,
            heads_to_keep,
        )

    # MLP intermediate dimension pruning
    for layer in model.layers:
        intermediate = (
            silu(layer.mlp.gate_proj.output_x)
            * layer.mlp.up_proj.output_x
        )
        importance = aggregate_intermediate_importance(intermediate)
        dims_to_keep = topk(
            importance,
            k=target_config.intermediate_dim,
        )
        layer.mlp = prune_intermediate_dims(
            layer.mlp,
            dims_to_keep,
        )

    return model
PCA 기반 vs. Index 기반 성능 검증
PCA 기반 Hidden dimension pruning의 효과를 검증하기 위해, 기존 Kanana Nano에서 사용한 Index 기반 Hidden dimension pruning과 비교 실험을 수행했습니다. 동일한 2B 규모에서도 Hidden dimension, MLP intermediate dimension, Attention head 중 어떤 Component를 중심으로 축소하는지에 따라 모델 구조와 초기 성능이 달라질 수 있습니다. 특정 구조에 따른 영향을 최소화하기 위해 세 요소의 축소 비율을 서로 다르게 설정한 세 가지 candidate를 구성했습니다. 아래 표는 각 candidate의 2B 규모 모델 Config를 나타냅니다.
| Hidden | Intermediate | Query heads | Params | |
|---|---|---|---|---|
| Kanana-2-3B | 2048 | 8192 | 32 | 3.18B |
| Candidate 1 | 1792 | 7168 | 32 | 2.05B |
| Candidate 2 | 1792 | 8064 | 24 | 2.09B |
| Candidate 3 | 2048 | 6144 | 24 | 2.01B |
표 1. 다양한 조합의 2B 모델 Config
각 candidate에서는 Kanana-2-3B 모델을 약 2B 규모로 Pruning한 뒤 Distillation을 수행하며, 성능 회복 속도를 비교했습니다. Hidden dimension pruning 방법(PCA 또는 Index)만 변경하고, MLP intermediate dimension pruning과 Attention head pruning은 동일한 방식으로 수행했습니다.
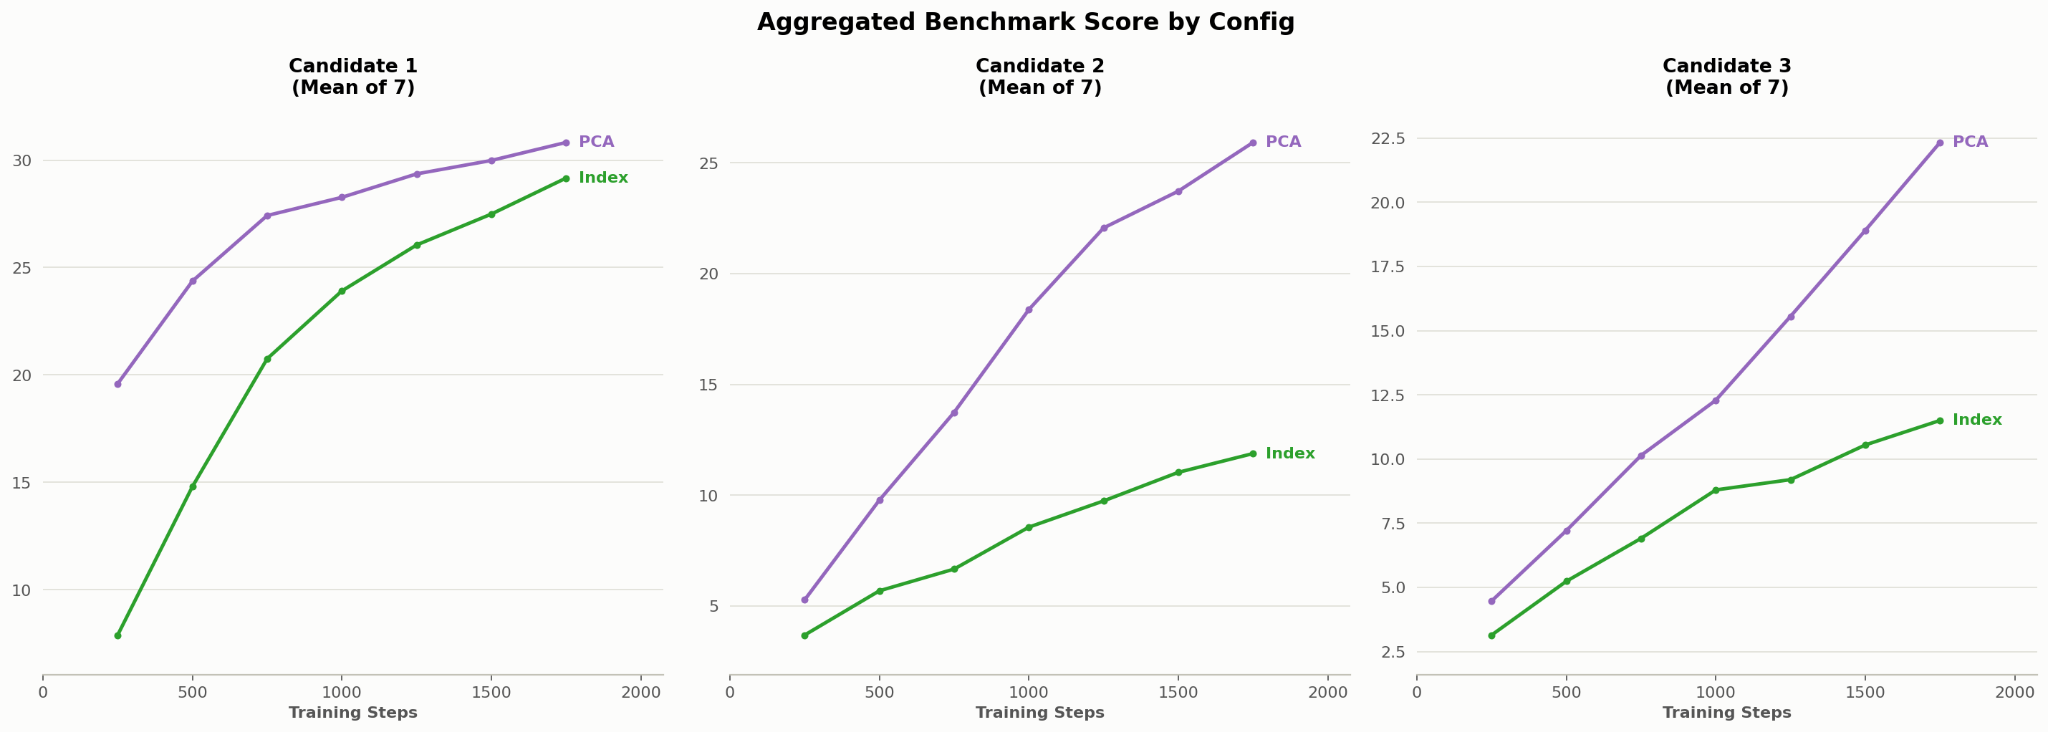
모든 모델에서 PCA 기반 Hidden dimension pruning이 기존 Index 기반 방식보다 일관되게 높은 성능을 보였습니다. 특히 Distillation 초기부터 더 높은 성능으로 시작했으며, 학습이 진행되는 전 구간에 걸쳐서 그 우위를 유지했습니다.
이러한 차이는 Attention head까지 함께 줄인 Candidate 2와 Candidate 3에서는 더욱 크게 나타났습니다. 이는 Attention capacity가 제한된 구조일수록 주요 Hidden representation을 보존하는 것이 Pruning으로 인한 정보 손실을 줄이는 데 더욱 중요할 가능성을 보여줍니다. 이러한 결과를 바탕으로 저희는 Hidden dimension pruning에서는 PCA 방법을 사용하기로 결정했습니다.
레이어 구조 결정 (Width vs Depth)
최종 2B 모델의 구조를 결정하기 위해 Hidden dimension, MLP intermediate dimension, Attention head, Layer의 축소 조합이 서로 다른 여러 candidate를 구성하고, 동일 조건에서 Distillation하며 성능 회복 속도를 비교했습니다. Layer pruning이 적용된 candidate에는 제거할 Layer를 결정하기 위해 Minitron에서 사용한 Block Influence(BI)와 Ministral 3에서 사용한 Norm ratio를 각각 이용해 Layer importance score를 계산했습니다.
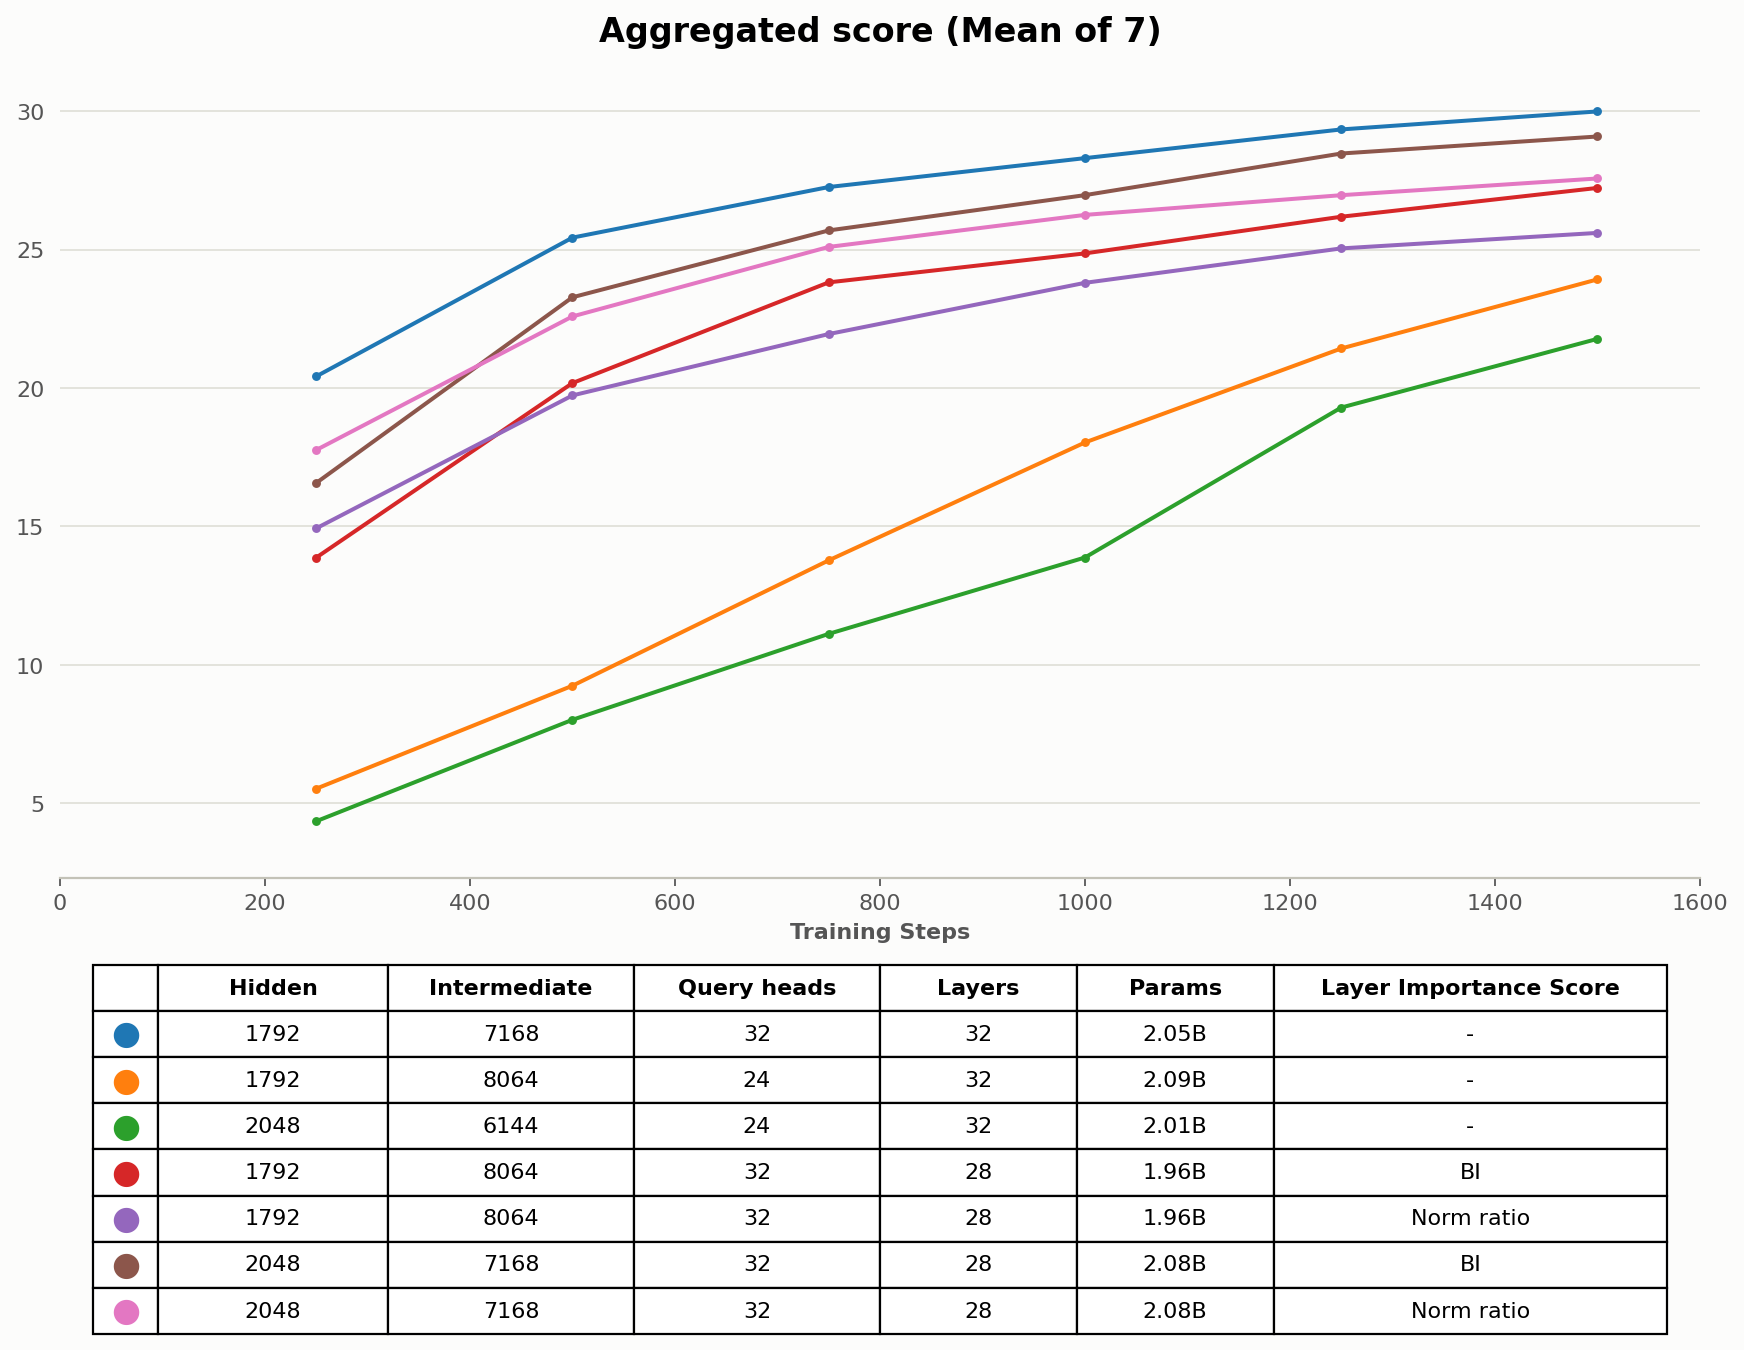
실험 결과, 이전 Kanana Nano에서와 마찬가지로 Attention head를 축소한 구조에서 가장 큰 성능 저하가 관찰되었습니다. Layer pruning 역시 BI와 Norm Ratio 중 어떤 Layer importance score 계산 방법을 사용하더라도, 동일한 파라미터 규모의 Width-pruned 모델보다 높은 성능을 보이지 못했습니다. 이에 따라 최종 Pruning 파이프라인에서 Layer 수를 유지하고, Hidden dimension과 MLP intermediate dimension을 중심으로 Width Pruning만 적용했습니다.
Cascade Pruning & Distillation
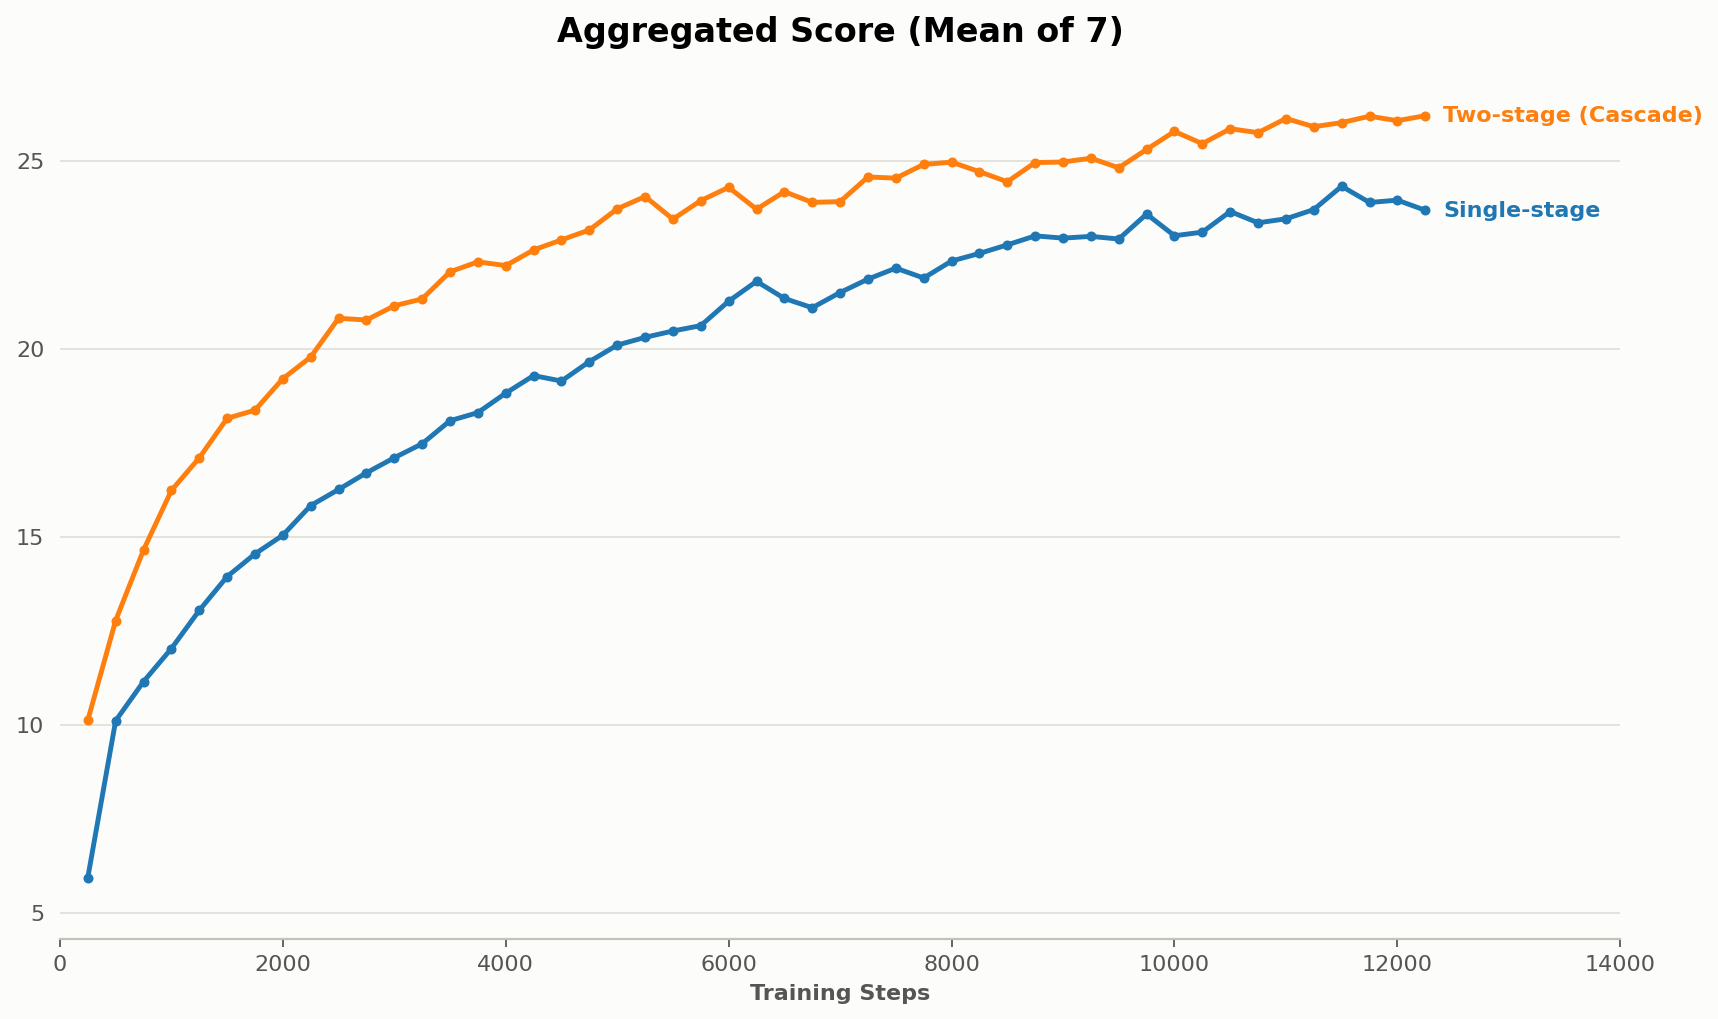
Minitron과 Ministral 3에서는 여러 중간 크기의 모델을 거치며 Pruning과 Distillation을 반복적으로 수행하는 Cascade 방법이 단일 단계로 압축하는 방법보다 더 효과적이라고 보고했습니다. Cascade 방법의 효과를 검증하기 위해, 총 Distillation Token 수를 동일하게 맞춘 조건에서 3B에서 0.9B로 직접 압축하는 Single-stage 방법과 3B → 2B → 0.9B로 단계적으로 압축하는 Two-stage (Cascade) 방법을 비교했습니다. 그 결과 Two-stage 방식은 0.9B 모델의 Distillation 초기부터 더 높은 성능으로 시작해, 학습 전반에 걸쳐 지속적으로 더 높은 성능을 보였습니다. 이를 바탕으로 최종 모델은 3B → 2B → 1.3B → 0.9B 순으로 단계적인 Pruning & Distillation을 수행하였습니다.
앞선 실험 결과를 반영하여, 각 단계의 모델은 Layer 수와 Query head를 유지한 채 Hidden dimension과 MLP intermediate dimension만 축소했습니다. 최종 Config는 아래 표와 같습니다.
| Params | Hidden | MLP Intermediate Dimension | Query heads | Layers |
|---|---|---|---|---|
| 3B | 2560 | 8192 | 32 | 32 |
| 2B | 1792 | 7168 | 32 | 32 |
| 1.3B | 1280 | 5760 | 32 | 32 |
| 0.9B | 1024 | 4608 | 32 | 32 |
표 2. Kanana-2 SLM 시리즈 모델들의 사이즈에 따른 Config
온디바이스 최적화: Sliding Window Attention(SWA)
Kanana-2-1.3B와 Kanana-2-0.9B는 온디바이스 배포를 전제로 설계되었습니다. 온디바이스 환경은 GPU 서빙 환경과 병목의 특성이 다릅니다. GPU 서빙은 높은 메모리 대역폭과 대규모 배칭으로 KV Cache 비용을 효과적으로 흡수할 수 있는 반면, 온디바이스는 메모리 대역폭이 제한적이기 때문에 Decode 속도가 사실상 토큰당 메모리 읽기량에 의해 결정됩니다.
Full Attention 구조에서는 KV Cache가 시퀀스 길이에 비례해 증가하며, 매 토큰 생성 시 누적된 KV Cache를 모두 읽어야 합니다. 따라서 문맥이 길어질수록 메모리 사용량과 Decode latency가 함께 증가하며, 메모리 용량과 대역폭이 모두 제한된 온디바이스 환경에서는 이러한 특성이 주요 병목으로 작용합니다. 이를 해결하기 위해 Kanana-2-1.3B와 Kanana-2-0.9B에는 Sliding Window Attention(SWA)을 도입했습니다.
SWA는 각 토큰이 고정된 크기의 Window 내에서만 Attention을 수행하는 방식입니다. 따라서 SWA 레이어에서 유지해야 하는 KV Cache의 길이는 Window size로 제한되며, 토큰당 KV Cache 읽기량 역시 시퀀스 길이와 무관하게 일정하게 유지됩니다. 그러나 모든 레이어를 SWA로 구성하면 Window 밖의 정보를 참조할 수 없어 Long Context 성능이 저하될 수 있습니다. 이를 방지하기 위해 Full Attention 레이어가 주기적으로 전체 문맥을 참조하도록 SWA 레이어와 Full Attention 레이어를 3:1 비율로 교차 배치한 하이브리드 구조를 채택했습니다. 이 구조에서는 전체 레이어의 3/4에서 KV Cache 크기와 토큰당 읽기량이 상수로 유지되므로, 시퀀스 길이에 따른 KV Cache 증가가 Full Attention 레이어에서만 발생합니다.
1.3B 모델 기준 KV Cache 크기 비교(BF16)
아래 표는 BF16 기반 Kanana-2-1.3B 모델 기준으로 레이어별 Attention 타입을 다르게 했을 때 시퀀스 길이별 KV Cache 크기를 비교한 결과입니다.
| Architecture | Length 2K | Length 8K | Length 32K |
|---|---|---|---|
| Full-only | 256MiB | 1024MiB | 4096MiB |
| SWA:Full=1:1 | 192MiB (-25.0%) | 576MiB (-43.8%) | 2112MiB (-48.8%) |
| SWA:Full=3:1 (채택) | 160MiB (-37.5%) | 352MiB (-65.6%) | 1120MiB (-72.7%) |
표 3. Sliding Window Attention 레이어 비율에 따른 문맥 길이별 KVCache
Full Attention만 사용하는 구조는 32K 길이에서 4GiB의 KV Cache가 필요해 온디바이스 서빙에 적합하지 않습니다. 반면 3:1 하이브리드 구조는 같은 조건에서 KV Cache를 최대 72.7% 절감하여, 제한된 메모리에서도 Long Context 서빙이 가능합니다. 특히 시퀀스가 길어질수록 절감 폭이 커지는 것을 확인할 수 있습니다.
하이브리드 구조에서 Window size는 성능과 메모리 절감 사이의 트레이드오프를 결정하는 핵심 요소입니다. 적절한 Window size를 정하기 위해 1.3B 모델을 대상으로 SWA:Full = 3:1 비율을 고정한 상태에서 Window size를 128, 512, 1024로 변경하며 4K Context Distillation 성능을 비교했습니다. Distillation의 Teacher는 앞선 3B 학습과 동일하게 Kanana-2-30B-A3B-Instruct-2601을 사용했습니다. 학습 데이터로는 Pruning 시작 모델인 Kanana-2-3B-Base의 Stage 2 데이터를 사용했으며, 2B, 1.3B, 0.9B 각 단계는 각각 300B 토큰 규모로 Distillation을 수행했습니다. 손실 함수는 KL divergence만 사용했습니다.
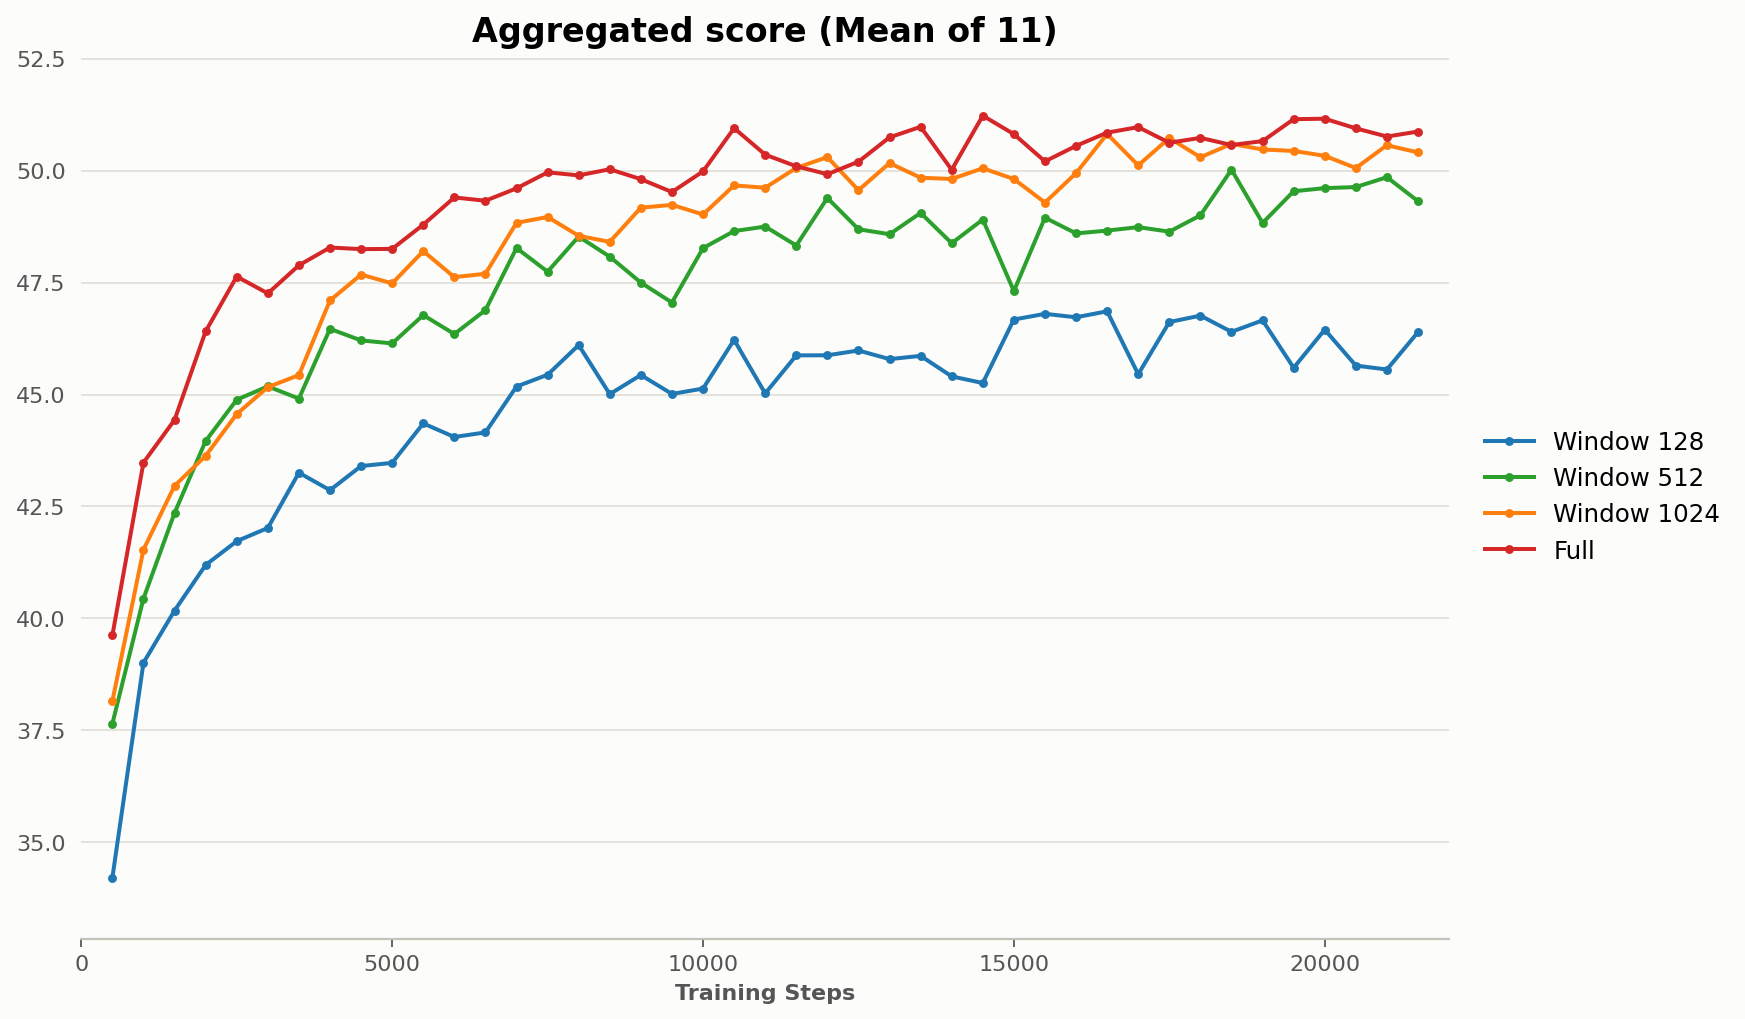
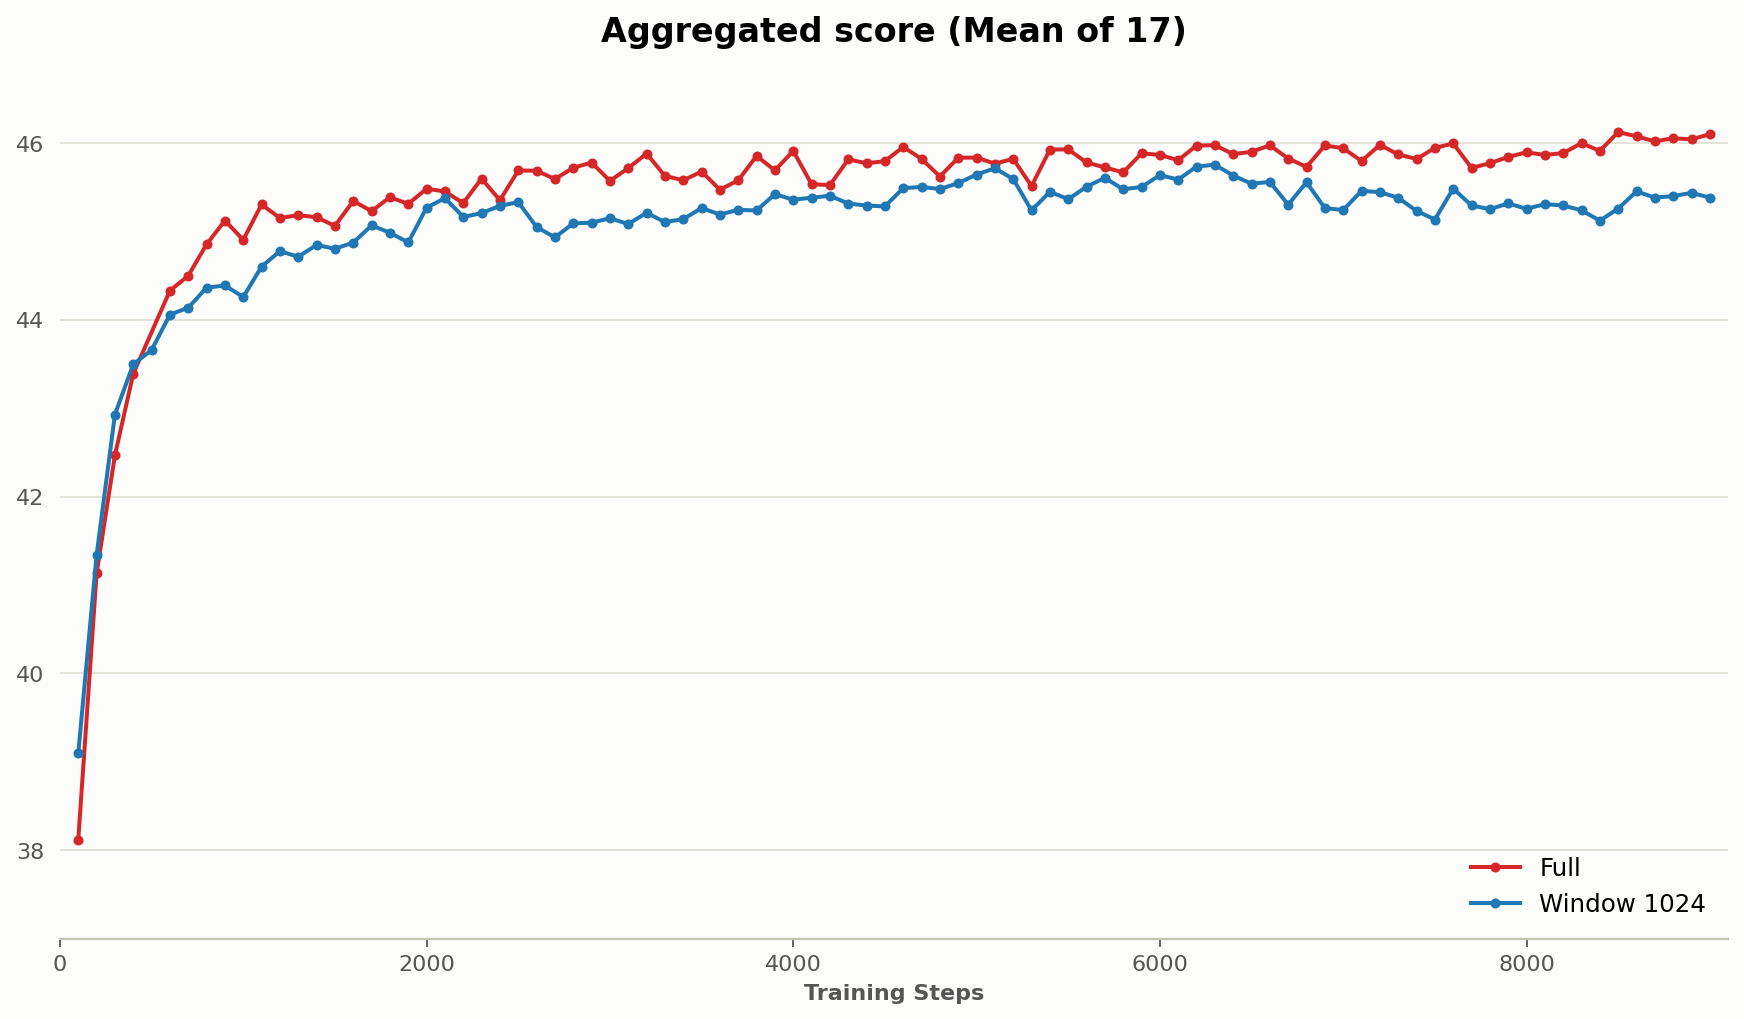
Window size가 작을수록 성능이 낮았으며, Window size 128에서는 Full 대비 격차가 뚜렷했습니다. 반면 Window size를 키울수록 Full Attention에 근접했고, 특히 Window 1024는 학습 전 구간에 걸쳐 Full과 거의 유사한 성능을 보였습니다.
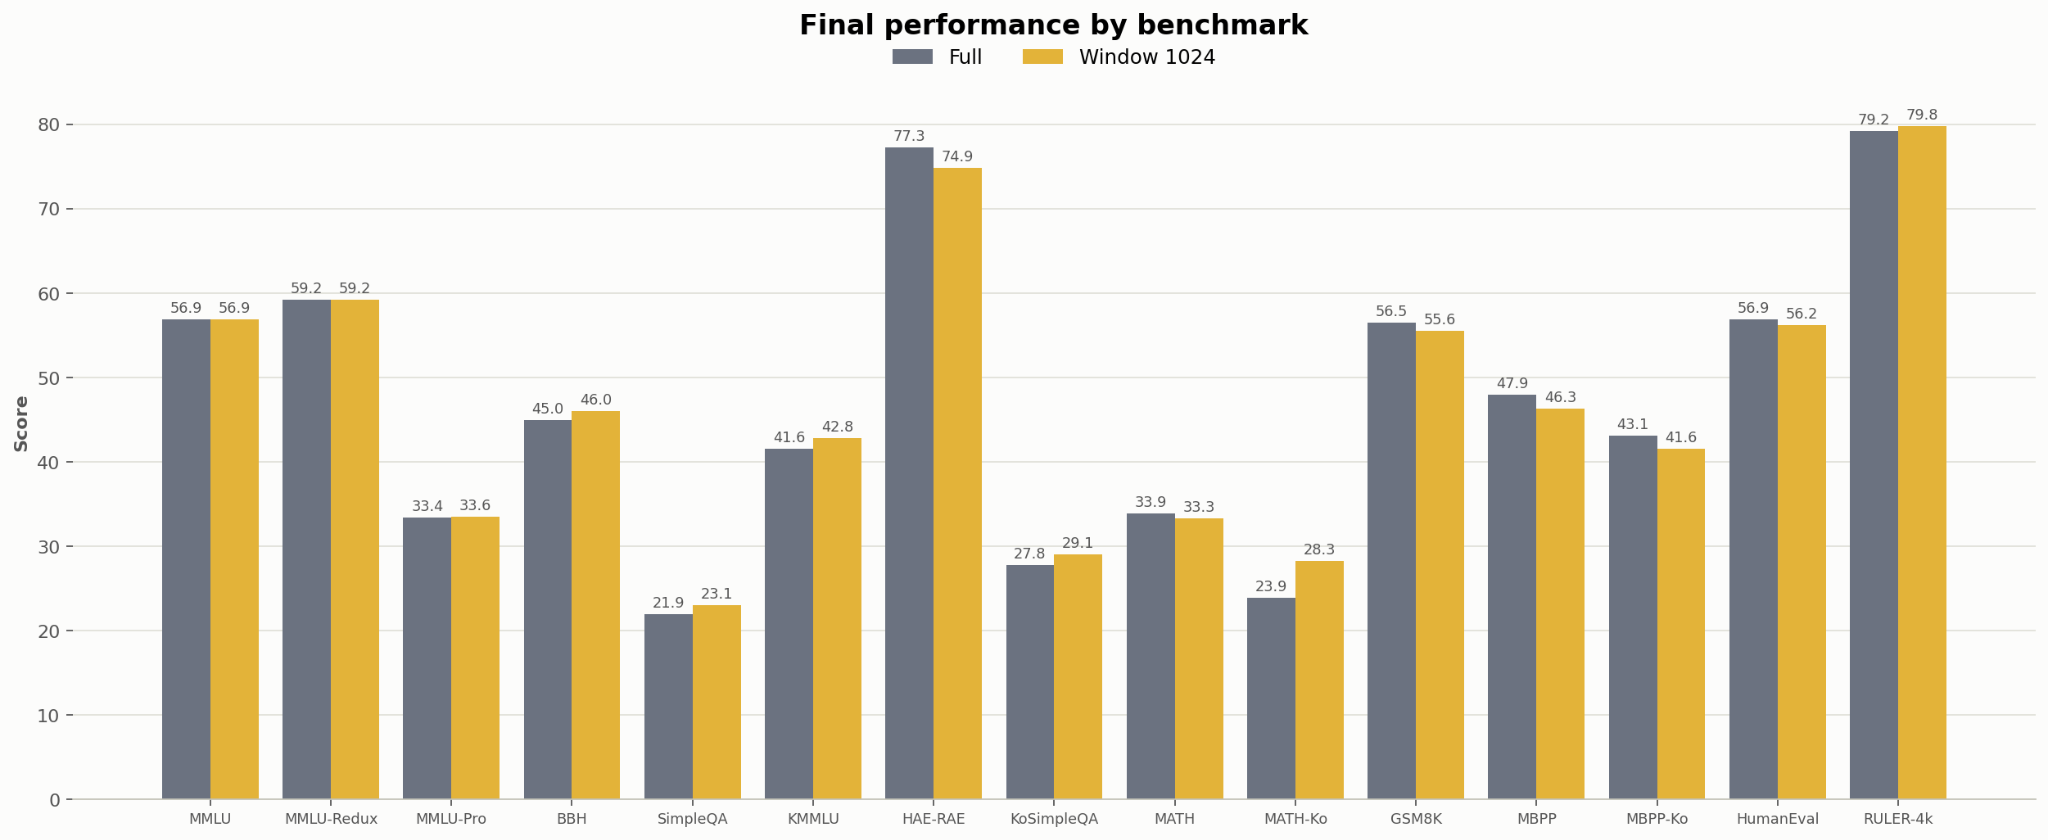
Window size 1024와 Full Attention을 벤치마크 단위로 비교한 결과에서도 두 구조의 성능은 대부분의 벤치마크에서 유사했습니다. 특히 Long Context 성능을 평가하는 RULER-4K에서 Window 1024가 Full과 큰 차이 없는 성능을 보여, SWA를 적용하더라도 4K Context에서는 성능 저하가 크지 않음을 확인했습니다.
Long Context Training (32K)
SWA 구조에서 Full Attention 레이어는 전체 문맥을 참조하는 반면, SWA 레이어는 고정된 Window 내에서만 Attention을 수행합니다. 이에 따라 Long Context 확장을 위한 Position Embedding은 Full Attention 레이어에만 Yarn을 적용하고, SWA 레이어는 기존 RoPE를 그대로 유지했습니다. 이를 통해 장거리 문맥 정보는 Full Attention 레이어에서 효과적으로 처리하면서도, SWA 레이어는 Local Attention의 효율성을 유지할 수 있습니다.
Long Context에서는 Kanana-2-3B-Base의 Long Context 학습 데이터 구성을 일부 재조정했습니다. 데이터를 분석한 결과, 일부 한국어 Long Context 데이터에 노이즈가 있는 것을 확인하였고, 이러한 영향이 상대적으로 사이즈가 작은 모델에서 더 크게 나타났습니다. 이에 일부 한국어 Long Context 데이터의 비중을 축소하는 대신, Math, Code, 영어 데이터의 비중을 확대하여 Long Context 학습 데이터를 재구성했습니다.
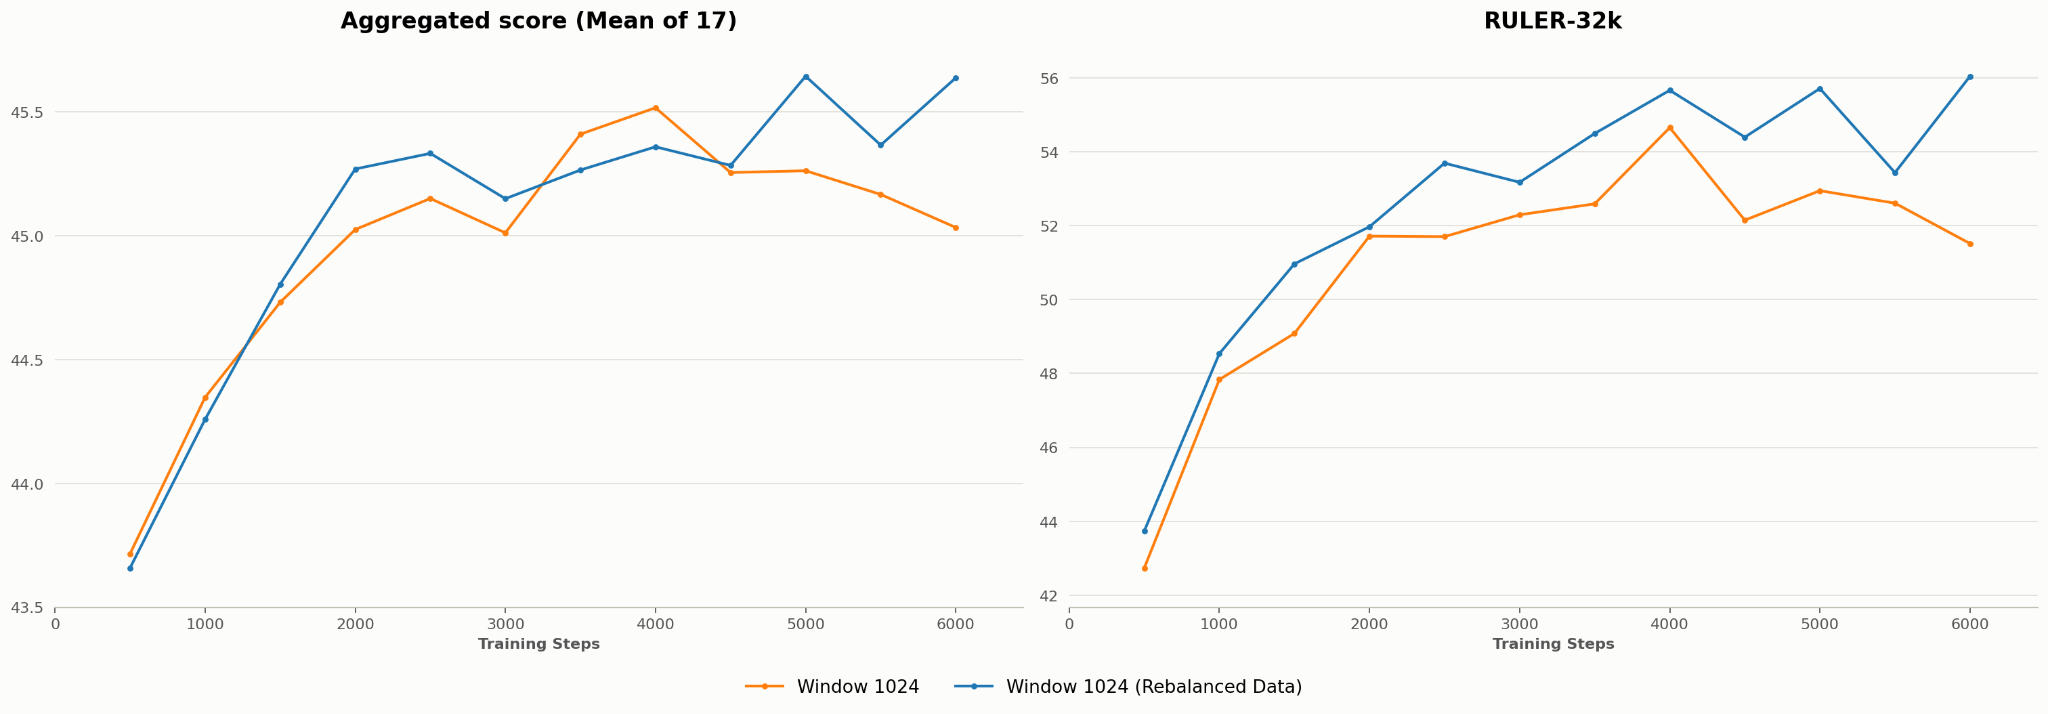
실험 결과, 데이터 재조정은 RULER-32K에서 더 높은 성능을 보였고, 전체적인 모델 성능 향상에 도움이 되었습니다.
| Kanana-2-3B-Base | Kanana-2-1.3B-Base | Kanana-2-0.9B-Base | |
|---|---|---|---|
| MMLU 5-shot | 62.77 | 56.49 | 53.72 |
| MMLU-Pro 5-shot | 36.54 | 29.87 | 27.11 |
| BBH 3-shot | 54.23 | 45.58 | 40.87 |
| SimpleQA 5-shot | 27.39 | 23.76 | 21.34 |
| KMMLU 5-shot | 47.92 | 44.17 | 40.58 |
| HAERAE 5-shot | 80.66 | 75.34 | 71.22 |
| KoSimpleQA 5-shot | 32.50 | 28.50 | 24.90 |
| MATH 4-shot | 35.08 | 30.82 | 27.68 |
| MBPP 3-shot | 50.95 | 44.86 | 37.56 |
표 4. Kanana-2 SLM 시리즈 Base 모델 성능
Post-Training
3B Post-Training
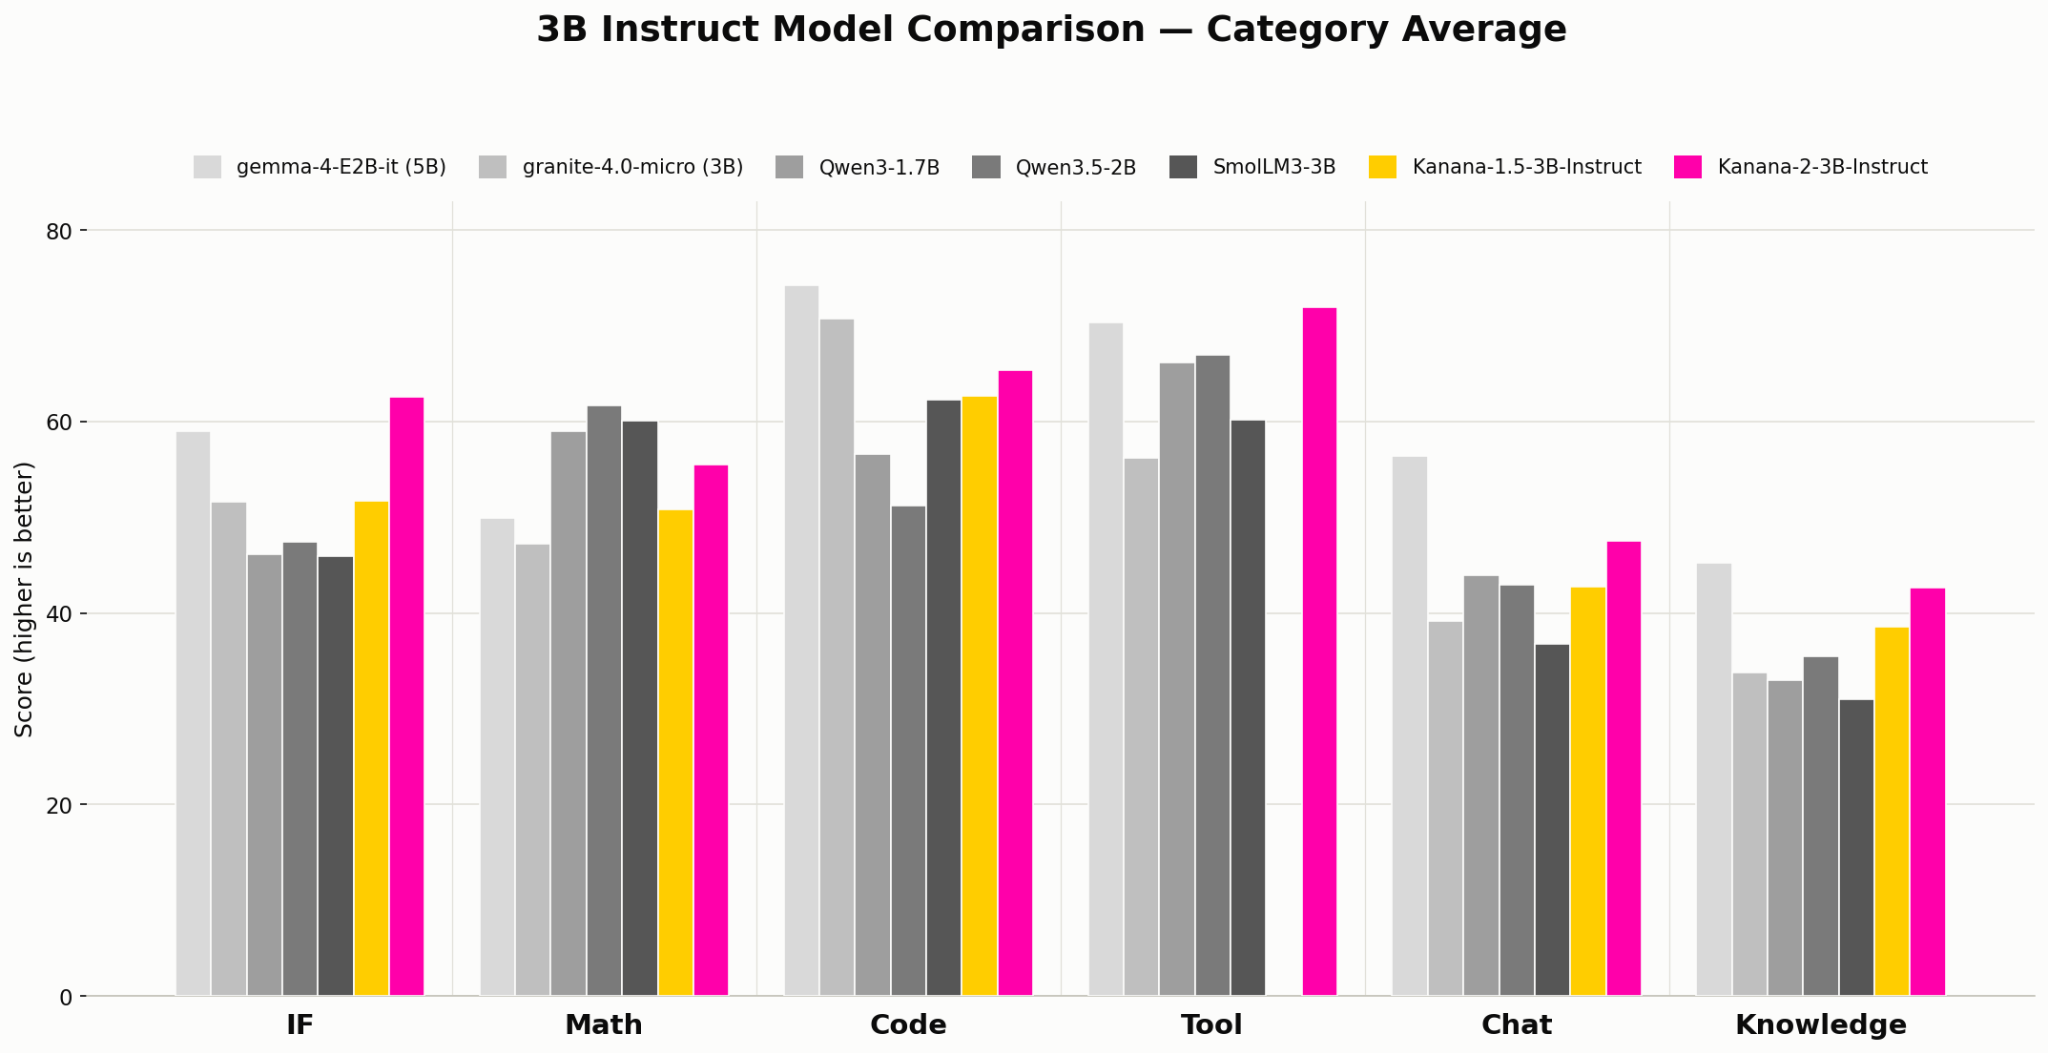
Kanana-2-3B 모델의 경우 Kanana-2 개발기에서 기술된 Instruct 모델 학습 방법을 따라서 Post-Training을 진행하였습니다. 먼저, Nemotron을 비롯한 여러 오픈소스 SFT 데이터셋을 확보하고, 이 데이터를 바탕으로 SFT를 수행하였습니다. 이후 RL 데이터를 Chat, Math, Code, Tool Call, Instruction Following과 같은 도메인 카테고리로 나누어 각각 RL을 수행하였습니다. 이렇게 얻어진 각 Domain Expert 모델을 Model Merging을 통해 하나로 합치고 Calibration을 수행하는 방식으로 진행하였습니다.
Staged SFT
최근 온디바이스 환경에서도 Tool Call 에 대한 필요성이 대두되고 있는 만큼, 지난 SLM 시리즈와 다르게 SFT 단계부터 Tool Call을 위한 다양한 소스의 데이터를 학습에 사용하였습니다. 이 때, 큰 모델에서와 다르게 작은 모델에서는 학습하는 데이터 분포가 바뀜에 따라 이전 지식이 일부 사라지는 Catastrophic Forgetting 문제가 매 순간 관찰되었습니다. 이를 완화하기 위해 초반에 적은 비중의 Tool Call 데이터로 시작하여 점차 비중을 높여가는 Staged SFT 방식을 적용하였습니다. SFT 학습에는 학습 효율성을 위해 학습 데이터에 32K 길이로 sequence packing을 적용하였습니다.
Parallel-RL
이렇게 SFT가 완료된 모델로부터 위에 기술한 5개의 Domain((Instruction Following, Math, Code, Tool, Chat, Knowledge) Expert를 얻기 위한 RL 학습을 진행하였습니다. 일반적으로 언어 모델의 Alignment 성능을 극대화하기 위해 최근에 GRPO (Grouped Relative Policy Optimization)가 널리 사용되고 있습니다. 하지만, 저희는 이번 Kanana-2-3B의 Post-training 과정에서 GRPO가 가진 몇 가지 한계를 극복하고 학습 효율과 안정성을 극대화하기 위해 최신 RL 방법론인 DAPO (Decoupled Clip and Dynamic Sampling Policy Optimization)을 도입했습니다.
- Dynamic Sampling: 유의미한 그래디언트 피드백을 주지 못하는 프롬프트 그룹을 실시간 제외하고, 학습 가치가 높은 유효 샘플로 배치를 채우는 기법입니다. 자원 낭비를 줄이고 수렴 속도를 높입니다.
- Clip-Higher: 상향 클리핑 범위를 넓혀 특정 답변 패턴에 갇히는 엔트로피 붕괴(Entropy Collapse)를 방지하고 다양성을 유지합니다.
- Token-level PG Loss & Overlong Penalty: 토큰 단위 정교한 정책 교정 및 불필요하게 길어지는 답변 억제를 통해 온디바이스에 최적화된 높은 응답 정확도와 속도를 완성했습니다.
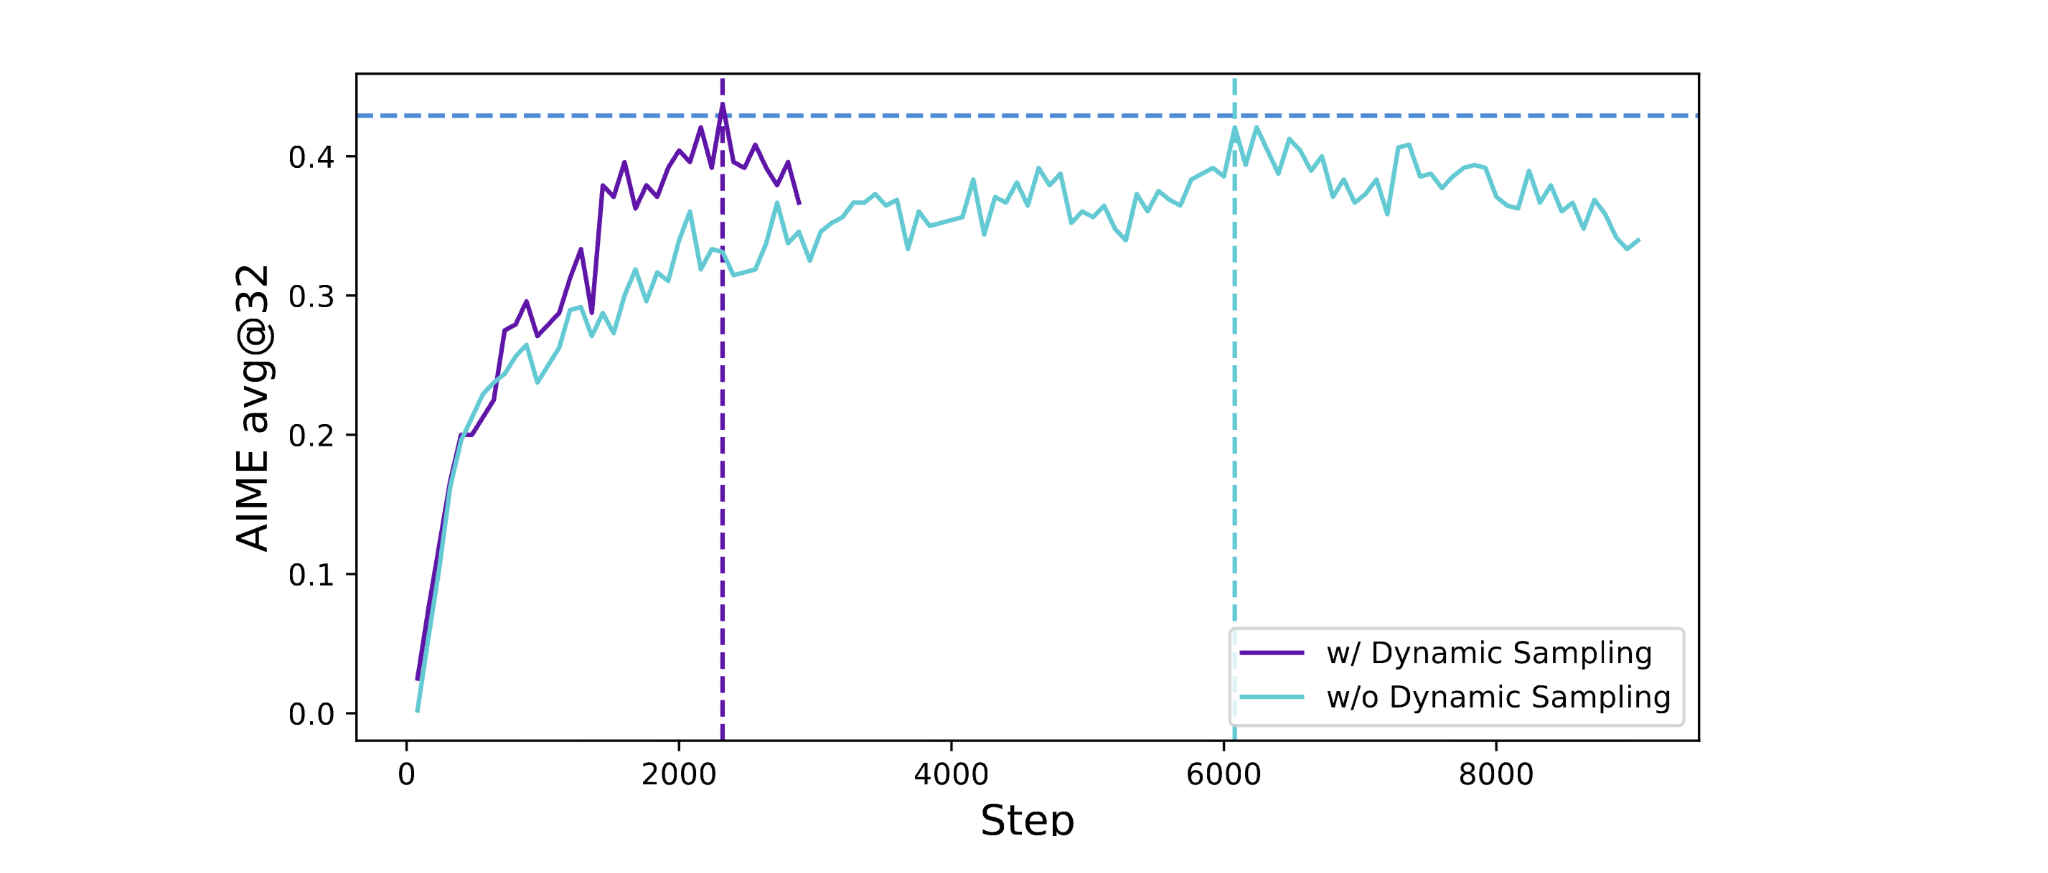
여기에 더해 DAPO는 기존 RL 학습의 고질적인 한계들을 정교하게 보완하며 Kanana-2-3B의 완성도를 한 단계 더 끌어올렸습니다. 먼저 정책 변화율의 상향 클리핑 범위를 넓히는 ‘Clip-Higher’ 기법을 통해 모델이 특정 답변 패턴에 갇히는 Entropy Collapse(엔트로피 붕괴) 현상을 원천 차단하고 새로운 고품질 답변을 끊임없이 탐색하도록 유도했습니다. 또한, 전체 답변 단위가 아닌 토큰 단위로 미세하게 정책을 교정하는 Token-level PG Loss와, 무의미하게 길어지는 답변에 감점을 부여하는 Overlong Penalty를 함께 결합하였습니다. 그 결과, 온디바이스 환경에 최적화된 높은 응답 정확도와 효율성을 갖춘 Expert 모델을 구축할 수 있었습니다.
Merge-Calibration
| Stage | IF | Math | Code | Tool | Chat | Knowledge | Avg. (Macro) |
|---|---|---|---|---|---|---|---|
| SFT | 44.93 | 47.64 | 62.56 | 71.51 | 40.73 | 39.63 | 46.18 |
| Merge | 62.39 | 56.18 | 61.61 | 65.84 | 46.17 | 41.46 | 50.95 |
| Calibration | 62.56 | 57.05 | 61.31 | 71.94 | 47.58 | 40.74 | 51.52 |
표 5. Kanana-2-3B-Instruct 모델의 학습 단계별 성능 변화
이렇게 확보한 각 Domain Expert 모델로부터 학습에 사용한 각 도메인 RL 프롬프트로 rollout을 각각 얻고, 정답인 응답 결과만 필터링하였습니다. 위에서 설명 드린 바와 같이, 작은 모델에서는 학습 데이터 분포가 바뀜에 따라 기존 지식을 잃는 취약점을 지니고 있어 domain 샘플 별로 개수를 균등하게 맞추는 작업을 추가하였습니다. 모델의 가중치들을 병합할 때에는 각 Domain Expert 모델들의 고유 강점을 간섭 현상 없이 융화하기 위해 SCE (Select, Calculate, Erase) 방식을 사용하였습니다. 병합된 가중치에 각 Expert 모델로부터 얻은 데이터와 소량의 held-out 데이터를 학습하는 Calibration 과정을 거쳐 유사 사이즈 글로벌 모델에 준하는 성능이며, 한국어 지시 수행 능력 및 한국적 지식도 풍부하게 담은 Kanana-2-3B-Instruct 모델을 확보하였습니다.
1.3B & 0.9B Post-Training
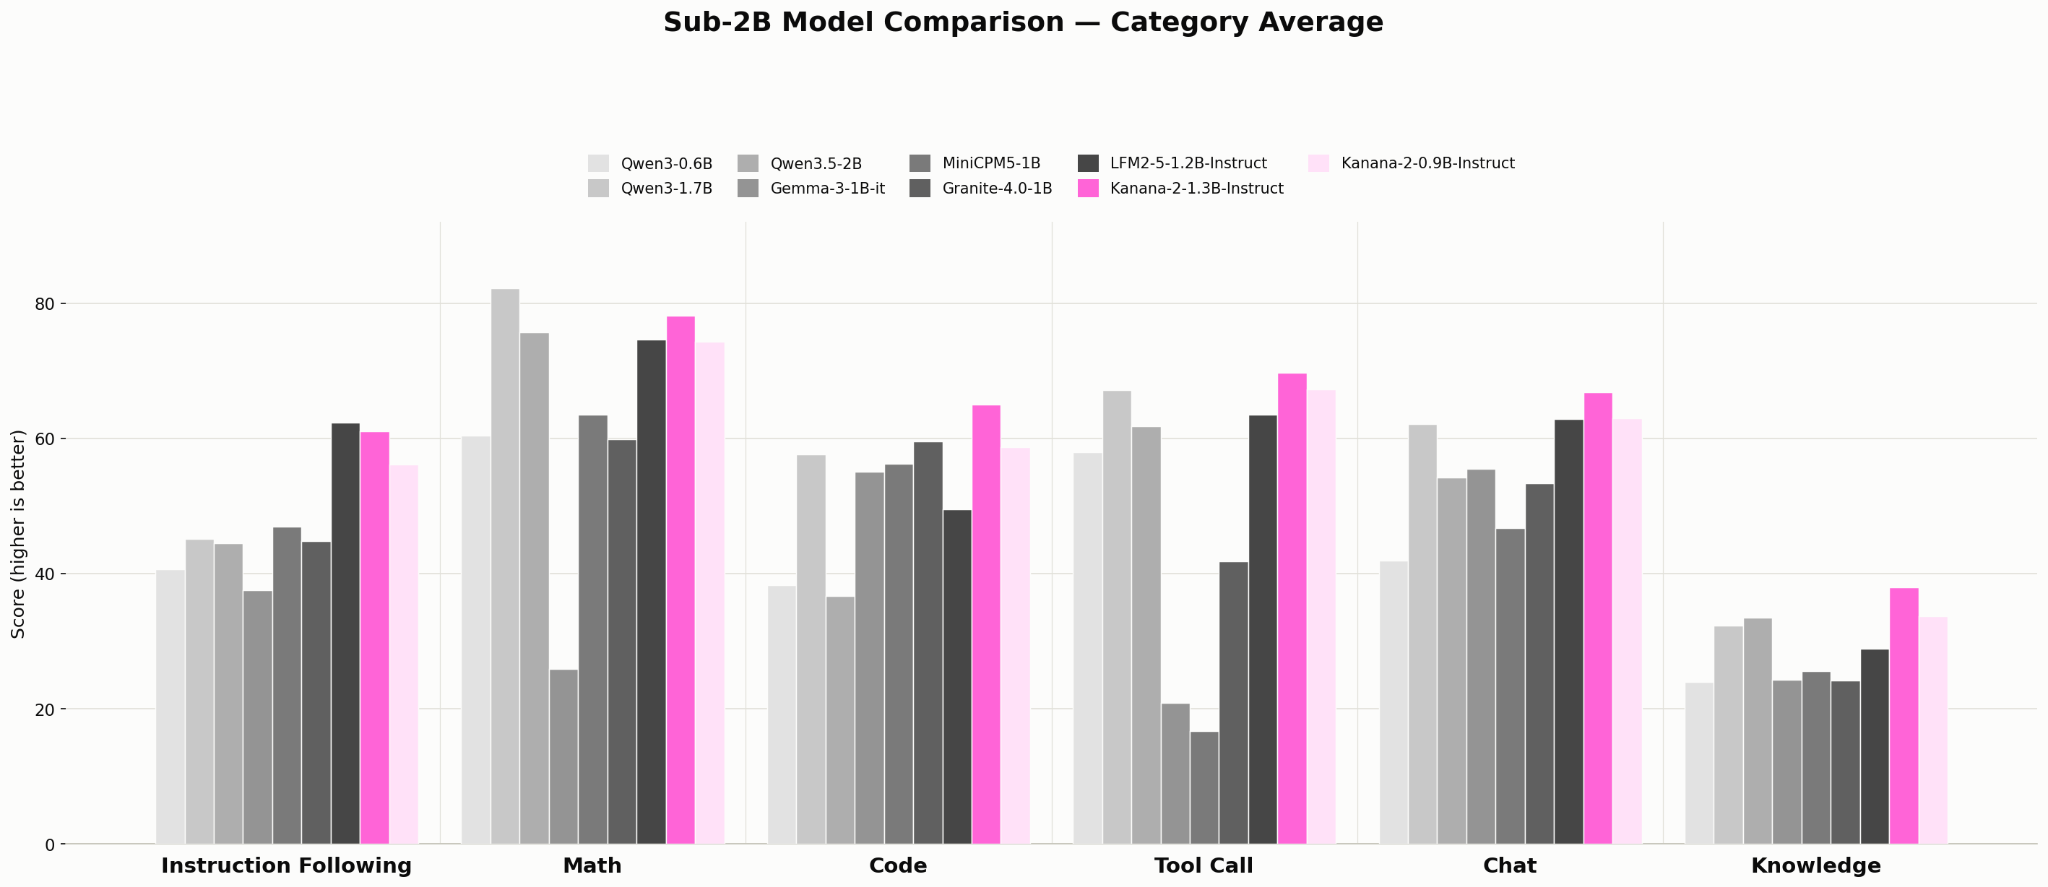
Off-Policy Distillation
Kanana-2-1.3B/0.9B-Base 모델의 Post-training 첫 단계로, Teacher Model의 rollout을 학습 데이터로 사용하는 Off-Policy Distillation을 수행하였습니다. 이때 이후 단계에서 사용할 데이터와 겹치지 않는 프롬프트 셋을 사용했으며, 다음 두 가지 목적을 동시에 달성하고자 했습니다.
- Chat Template에 호응되는 포맷의 답변을 생성하도록 Student 모델을 미세 조정하기.
- On-Policy Distillation에 앞서 Student와 Teacher의 분포 차이를 줄여, on-policy 단계 초반의 rollout 품질과 학습 안정성을 확보하기.
Teacher 응답은 학습 중 매 스텝 online으로 생성할 수도 있고 사전에 생성해둘 수도 있는데, Off-Policy 세팅에서는 Teacher의 생성 분포가 Student 파라미터와 무관하게 고정되어 있어 online 생성이 사전 생성 대비 어떤 정보 이득도 주지 않습니다. 오히려 다음과 같은 비용만 추가됩니다. 1) 생성은 decode-bound라 토큰당 비용이 크고 latency가 응답 길이에 비례하므로, 배치 내에 긴 응답이 섞이면 학습 GPU에 idle time이 발생해 낮은 학습 MFU로 이어짐. 2) Degenerate 생성이 발생하면 필터링 후 재생성하는 동안 추가적인 idle time이 발생함. 따라서 주어진 프롬프트에 대해 사전에 Teacher Model의 응답을 생성해두고, 작은 모델에 취약할 수 있는 repetition이 발생한 degenerate 응답을 필터링한 뒤, 남은 샘플로 Distillation을 수행하였습니다.
On-Policy Distillation
Kanana-2-1.3B/0.9B-Base에 Off-Policy Distillation을 수행한 후, 지난 블로그와 같이 On-Policy Distillation을 수행하였습니다. 이 과정에서 다음과 같은 두 가지 고민을 하였습니다.
- Forward KL / Reverse KL 중 어떤 KL 방향을 사용할지?
- Rejection Sampling을 수행할지?
먼저, KL 방향은 통념과 다르게 forward KL을 선택했습니다. On-Policy Distillation의 핵심 이득은 Student Model이 실제로 생성한 결과에 대해 Teacher Model의 교정을 받는 것, 즉 Exposure Bias를 해소하는 데에 있고, 이는 어떤 KL을 쓰는지와는 별개의 문제입니다. 오히려 KL의 방향 선택은 “이 단계의 결과로 무엇을 원하는가”에 달려 있는데, 저희 파이프라인에서는 On-Policy Distillation 뒤 후술할 내용과 같이 RL을 수행합니다. Reverse KL은 mode-seeking 성질로 분포를 미리 날카롭게 만들어 Pass@1을 높이는 대신 엔트로피를 감소시키는데, RL의 성능 상한은 결국 초기 policy가 탐색 중에 정답을 얼마나 자주 발견하느냐 (Pass@K)에 따라 결정되므로, 이는 RL이 쓸 탐색 여력을 미리 제한하는 셈이 됩니다. 분포를 날카롭게 다듬는 일은 어차피 RL 과정에서 실제 reward로 더 정확하게 수행할 작업이기 때문에 해당 단계에서는 Teacher Model 분포의 커버리지를 넓게 유지하는 forward KL로 “탐색 여지가 남아있는 좋은 RL 시작점” 모델을 만드는 데에 집중했습니다.
같은 이유로 rejection sampling도 별도로 수행하지 않았습니다. Teacher Model의 logits가 매 토큰마다 dense한 감독 신호를 주기 때문에, 정답에 도달하지 못한 rollout이라도 Student Model이 틀리기 시작하는 바로 그 지점에서 Teacher Model의 교정을 학습할 수 있습니다. 오히려 실패한 trajectory야 말로 exposure bias 교정 효과가 가장 큰 데이터인데, rejection sampling으로 성공 궤적만 남기면 학습 분포가 다시 잘 푸는 문제 쪽으로 치우쳐 On-Policy 학습의 이점이 희석되고, 필터링된 rollout 만큼 생성 비용도 낭비됩니다. 정답 여부로 샘플을 선별하는 일은 verifiable reward를 사용하는 다음 RL 단계가 자연스럽게 담당하게 됩니다.
Multi-Domain RL
1.3B, 0.9B 모델의 경우 모델의 크기가 더욱 작아지면서 Kanana-2-3B 모델 학습에 사용한 Parallel-RL을 사용했을 때, 모델 학습이 불안정하였고 성능 향상이 유의미하게 일어나지 않았습니다. 적은 파라미터를 가진 소형 모델일 수록 가중치 병합 시 도메인 간 간섭(Interference)이나 가중치 충돌이 심하게 발생하기 때문입니다. 따라서 이러한 간섭을 우회하고자 “Kanana LLM 1.5 개발기”에서 사용했던 RLVR 및 Generative reward model을 차용하여 여러 도메인을 동시에 학습하는 Multi-Domain RL을 적용하였고 최종적으로 강력한 모델을 완성할 수 있었습니다.
One more thing: Kanana-2-Embedding
이번에는 앞서 소개한 Decoder-only 구조의 Kanana-2 SLM 기반으로 학습한 Text-only Bilingual Embedding 모델, Kanana-2-Embedding을 소개합니다.
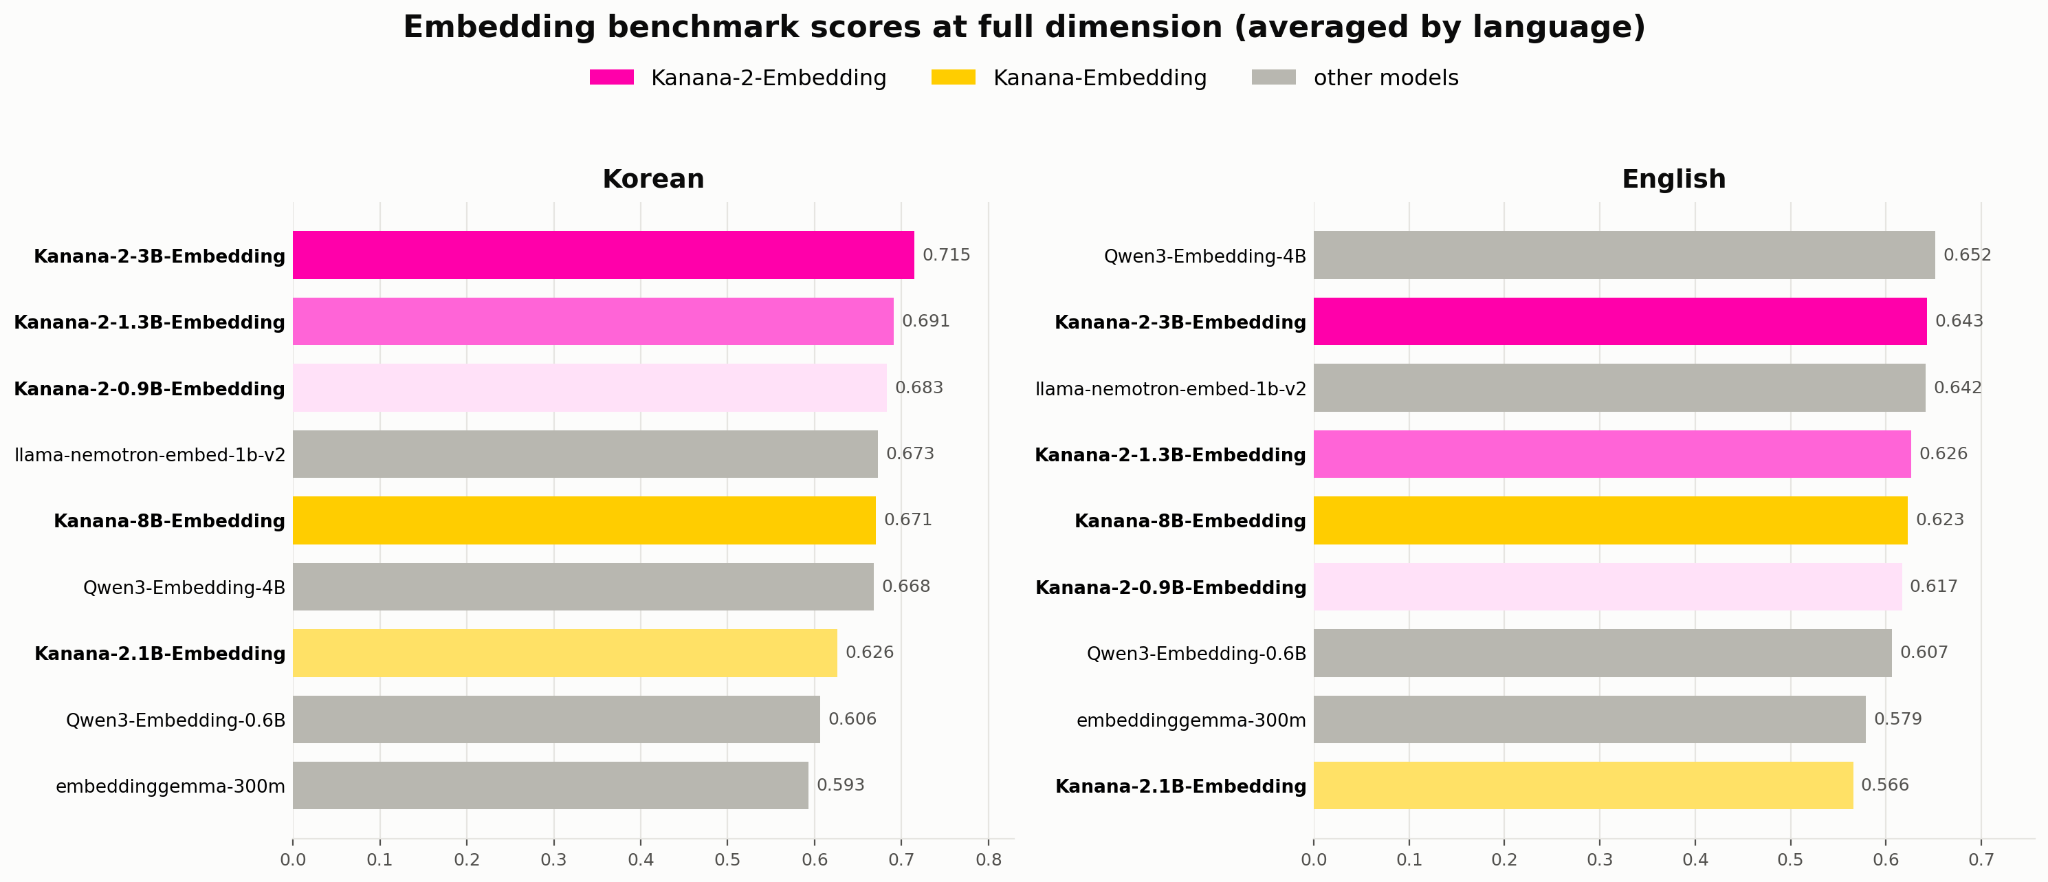
Kanana-2-Embedding은 기존 오픈소스 모델 대비 한국어와 영어 모두에서 이전 Kanana-Embedding 시리즈 대비 비약적인 성능 향상을 보였으며, MRL (Matryoshka Representation Learning) 기법을 도입하여 차원 효율성 면에서도 탁월한 성과를 거두었습니다.
아래는 저희가 이번 임베딩 모델을 학습하며 한 고민과, 실험 내용 및 결과를 공유드리고자 합니다.
Experiments
첫 번째로, 저희 팀이 모델 학습을 위해 수행한 실험들에 대해 공유드리겠습니다. Decoder-only 구조로 학습된 Kanana-2 SLM 모델의 언어 이해 및 생성 능력을 임베딩 차원으로 전이시키기 위해 다음과 같은 두 가지 초기화 방법을 구상하였습니다.
-
Causal Attention + Last Token Pooling: Decoder-only 모델의 causal attention 구조를 그대로 가져가되, 마지막 EOS 토큰의 hidden state를 임베딩으로 사용하기(e.g. E5, Qwen3-Emb)
-
Bidirectional Attention + Mean Token Pooling: Causal attention 구조를 Bidirectional Attention mask로 변환하여 각 인덱스의 토큰이 모든 인덱스의 토큰 정보를 참조할 수 있도록 하며, 전체 입력 시퀀스 토큰 자리의 hidden state vector를 평균화하기(e.g. LLM2Vec, NV-Embed)
학습된 Decoder-only 모델로부터 임베딩 모델로 전환하는 대부분의 연구들이 위의 두 옵션 중 하나를 채택하며, 실제로 이 중 어떤 방법이 더 좋은 방법인지를 실험적으로 확인하고자 하였습니다.
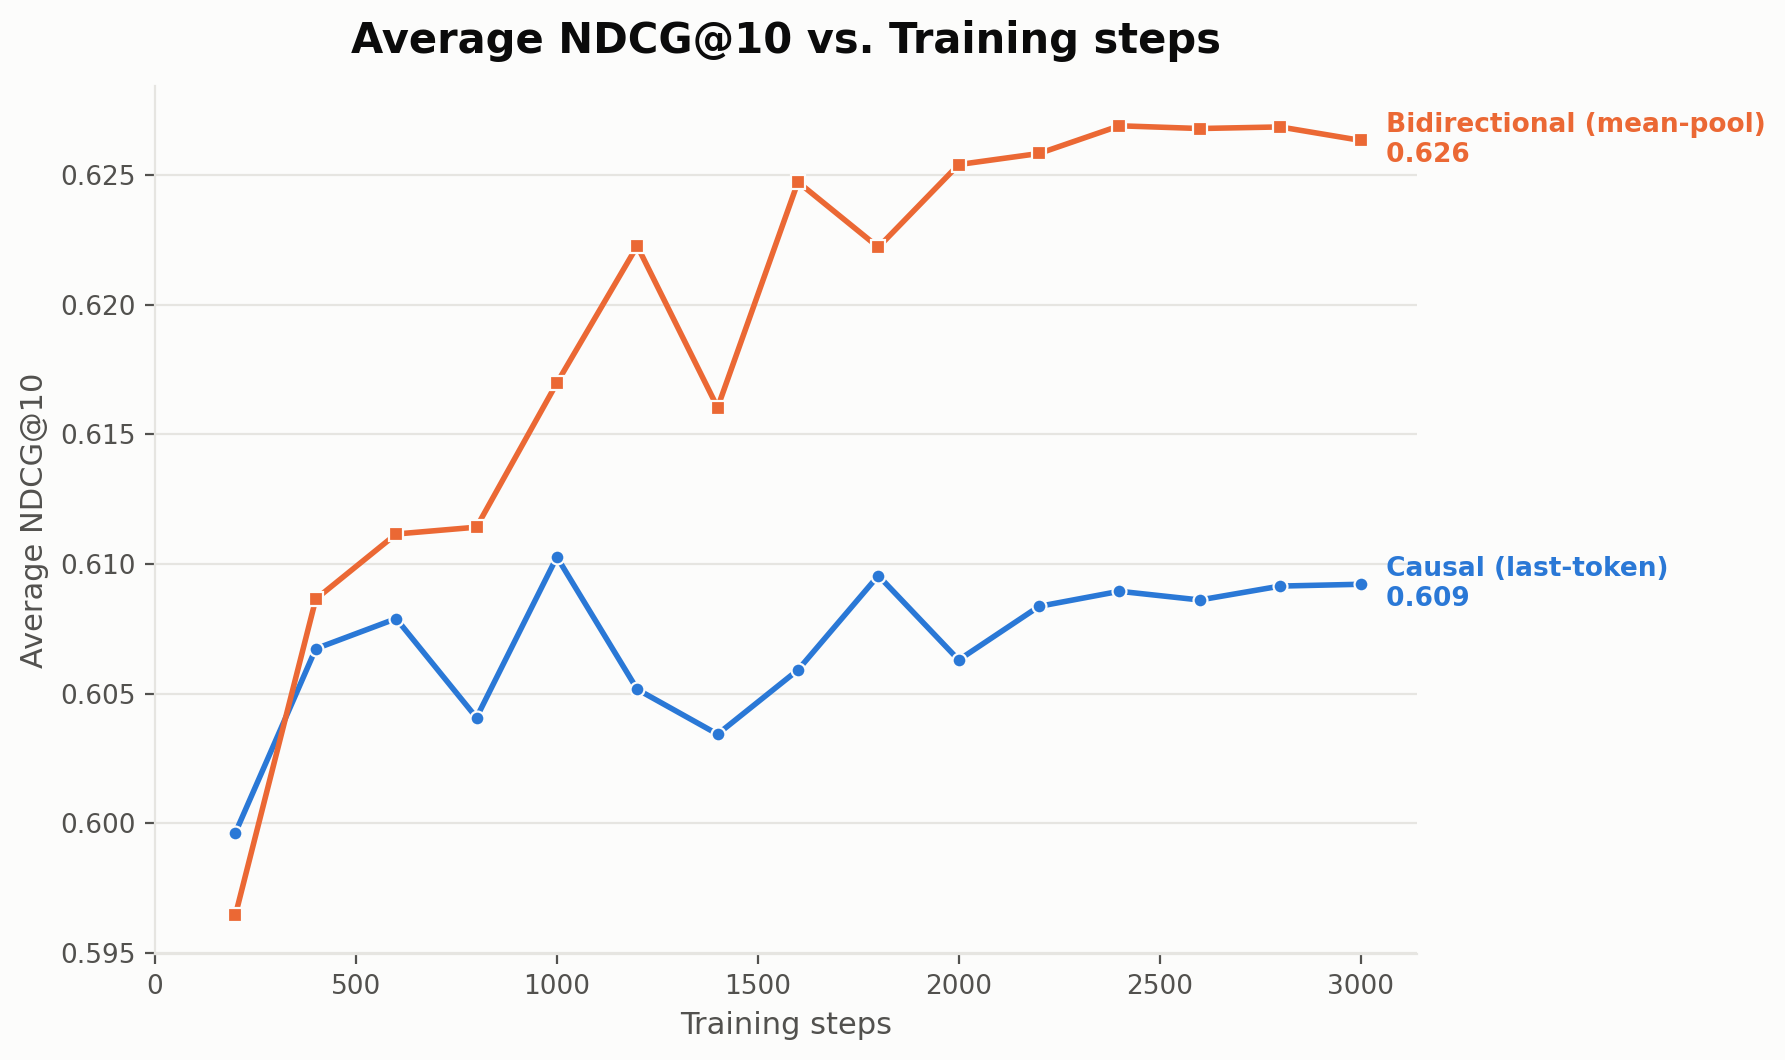
두 초기화 방식으로 각각 학습을 수행해본 결과, 임베딩 모델로 수행하는 다양한 태스크들 중 검색 (Retrieval) 태스크에서 유일하게 큰 성능 차이가 발생하는 것을 알 수 있었습니다. 학습이 진행될수록 Bidirectional + Mean Pool의 초기화 방식이 검색 태스크에서 Causal + Last Pool 방식을 능가하는 것을 뚜렷하게 관찰할 수 있었고, 추후 실험 및 본 학습에서 모두 이 방식을 채택하였습니다.
대조 학습(Contrastive Learning) 손실 함수 비교
다음으로는 Training Objective에 대한 실험을 수행하였습니다. 다양한 연구에서 임베딩 모델의 표현력을 극대화 시키기 위한 Contrastive Learning (대조 학습) 방법을 제안했고, 그 중 동일한 조건 하에 어떤 손실 함수(Loss Function)로 학습하는게 가장 좋은 표현력을 갖도록 하는지 실험하였습니다.
다음과 같이 대조 학습에서 널리 사용하는 InfoNCE loss 계열의 네 가지 손실 함수(In-batch NCE, GIST, HN-only, KaLM)를 비교하였습니다. 아래 표에서 각 행 레이블은 각 손실 함수의 분모 항에 쿼리와 정답 문서간의 유사도와 비교할 대상인 q(쿼리), d(문서), hard neg (정답에 가까운 헷갈리는 오답 문서) 사이의 유사도가 포함되는지 여부를 의미합니다.
| loss | q-d | q-q | d-d | d-hard neg | q-synth |
|---|---|---|---|---|---|
| In-batch NCE | ✅ | ❌ | ❌ | ✅ | ❌ |
| GIST | ✅ | ✅ | ✅ | ✅ | ❌ |
| HN-only | ❌ | ❌ | ❌ | ✅ | ❌ |
| KaLM | ✅ | ❌ | ❌ | ✅ | ✅ |
표 6. 대조 학습의 각 손실 함수 중 분모 항에 포함되어 있는 유사도
모든 실험 및 학습에는 공통적으로 2,048 global batch size를 사용하였고 multi-GPU에서 서로 다른 device의 배치끼리 유사도를 global-level로 비교해야 하는 경우 GradCache 방법을 사용하였습니다.
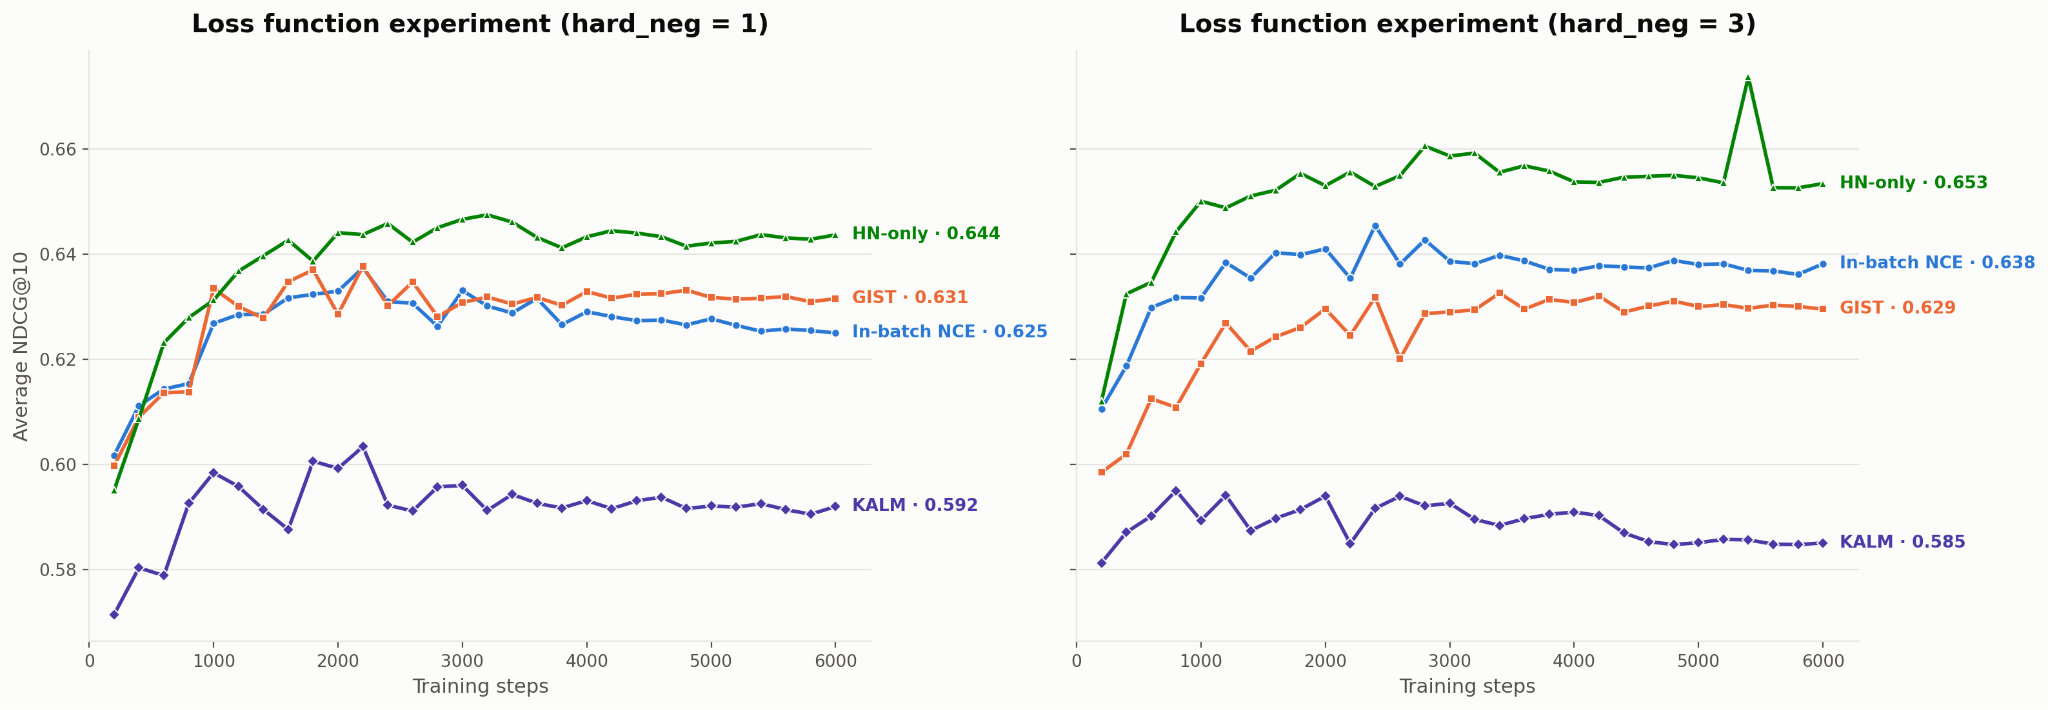
실험 결과는 직관과는 반대로, 분모에서 가장 적은 샘플과 유사도를 비교하는 HN-only 손실 함수가 Hard negative 샘플 개수와 관계없이 가장 우세한 성능을 보였습니다. 이는 적은 컴퓨팅 비용과 데이터 수집의 노력만으로도 임베딩 모델 입장에서 더 효과적인 학습이 가능하고, Decoder-only 모델에도 이미 어느 정도의 임베딩 능력이 내재되어 있음을 시사합니다. 이러한 관찰을 바탕으로 추후 실험 및 본 학습에서는 모두 HN-only 손실 함수를 사용하여 학습을 진행하였습니다.
마지막 실험으로는 손실 함수의 분모 항에 적용해주는 Temperature 값에 대한 실험입니다. 두 임베딩 값에 대한 비교는 Cosine similarity (코사인 유사도)를 통해 측정하지만 코사인 유사도의 표현 범위가 [-1,1]로 매우 좁아 학습 과정 중 여러개의 코사인 유사도를 비교할 때 확률 차이가 거의 안생기게 됩니다. 따라서, 이 코사인 유사도를 Temperature 값만큼 스케일할 때, 예를 들어 이 값을 작게 설정할 수록 분포를 더 뾰족하게 만들어 모델 입장에서 더 어려운 샘플에 더 집중하게 하는 효과를 냅니다.
| Hard Negative 개수 | Δ en | Δ ko |
|---|---|---|
| 7 | +0.51%p | +0.46%p |
| 9 | +0.99%p | +0.37%p |
표 7. 손실 함수의 Temperature 값 Δ(0.02 − 0.05)에 따른 성능 상승폭
손실 함수의 Temperature를 0.05로 설정하고 학습하였을 때 대비 0.02로 설정했을 때의 향상폭인 Δ (0.02 − 0.05) 결과는 위 표와 같습니다. 언어, Hard negative 개수와 관계 없이 Temperature를 낮게 설정하는 학습이 미세하게 더 좋은 성능을 보였고, 실제로 학습 과정 중 더 어려운 샘플에 집중하도록 하는 것이 효과적임을 확인하였습니다. 따라서, 본 학습에서는 Temperature 값으로 0.02를 채택하였습니다.
Training & Evaluations
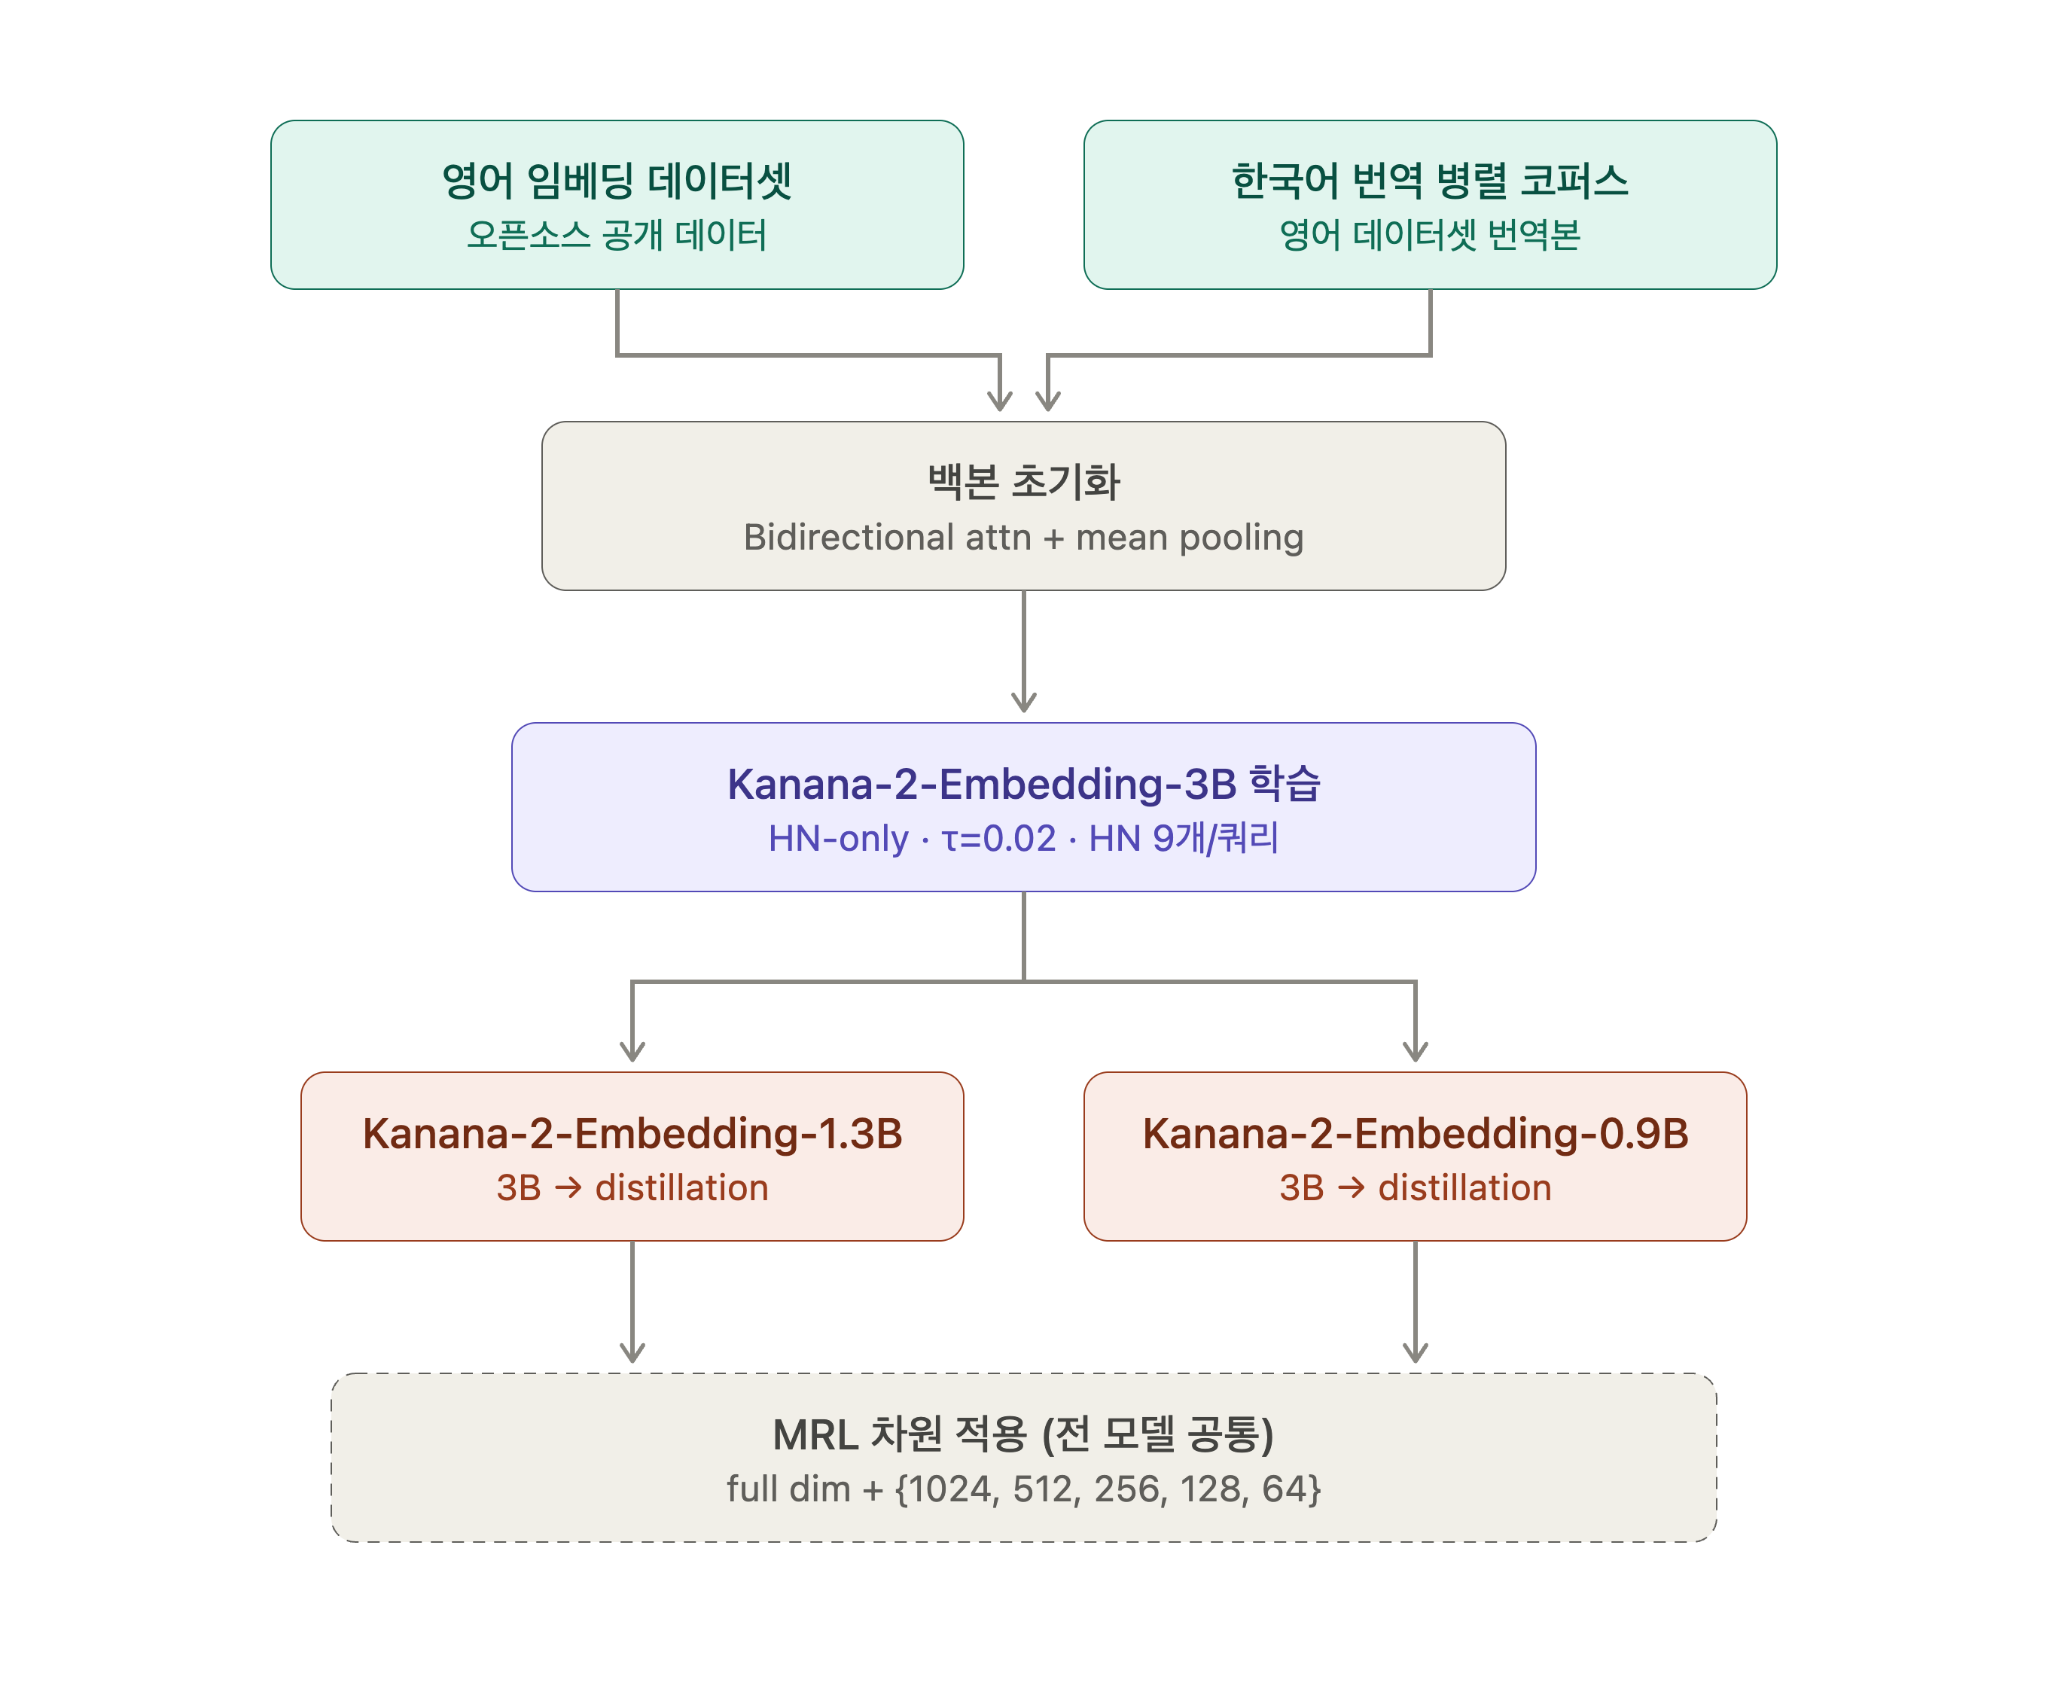
위와 같은 실험들을 통해 최종적으로 (1) Bidirectional Attention + Mean Token Pooling 초기화 모델에 (2) HN-only, (3) Temperature=0.02 값을 적용하여 쿼리 당 9개의 Hard negative 샘플로 학습을 진행하였습니다. 학습 데이터셋은 오픈소스로 공개된 임베딩 학습용 영어 데이터셋과 이를 한국어로 번역한 병렬 코퍼스를 함께 사용하였습니다. 먼저 학습된 Kanana-2-Embedding-3B 모델로부터 Kanana-2-Embedding-1.3B/0.9B 모델은 distillation을 수행하였습니다. MRL 차원은 각 모델의 전체 차원과 {1024,512,256,128,64} 차원들을 사용하였습니다. 아래는 전체적인 학습 워크플로우입니다.
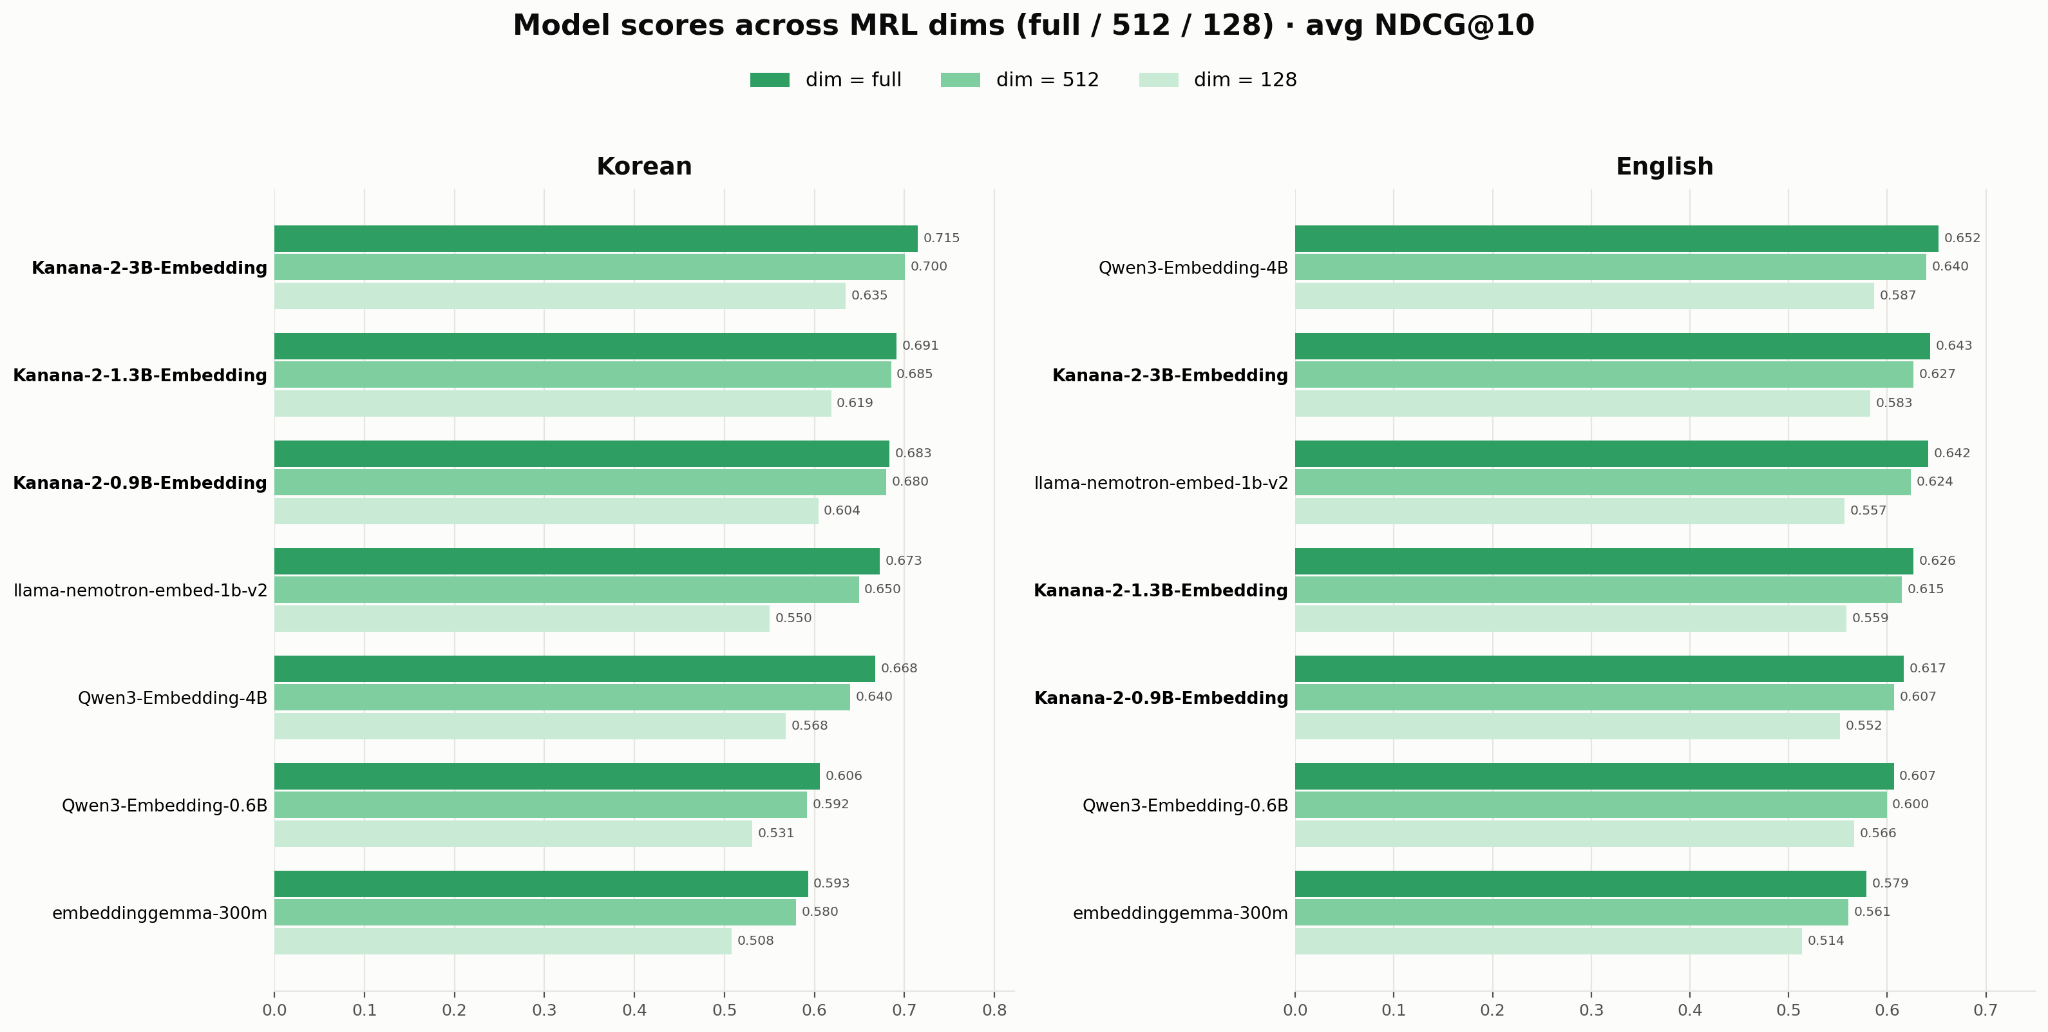
평가 결과 아래와 같이 Kanana-2-Embedding 시리즈 모델들은 유사 사이즈의 강력한 오픈소스 임베딩 모델들을 한국어 태스크에서 모두 상회하고, 영어에서도 준하는 성능을 보였습니다. 특히, 유사 사이즈 SOTA 모델인 Qwen-3-Embedding보다도 더 높은 추론 효율성으로 유사하거나 더 높은 성능을 달성하였습니다. 평가 시 Task Instruction Prompt가 특정 모델에 유리하게 작용하는 것을 방지하기 위해 별도의 프롬프트는 추가하지 않았습니다.
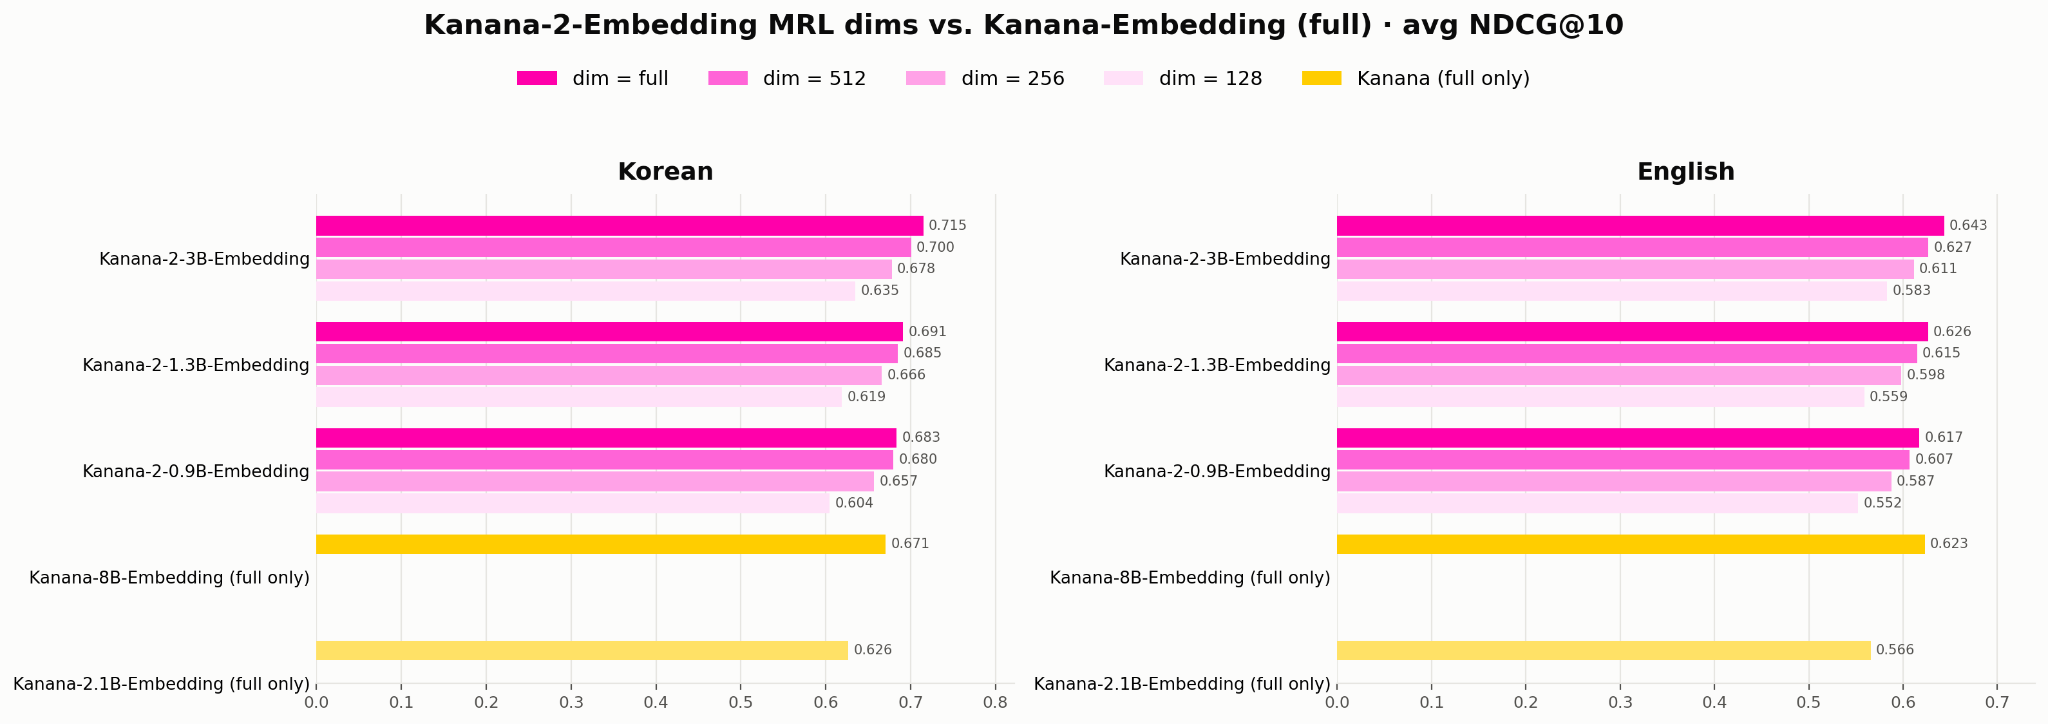
저희 팀의 이전 버전 임베딩 모델인 Kanana-Embedding 시리즈와 비교해도 가공할만한 성능을 확인할 수 있었습니다. 한국어의 경우, Kanana-2-Embedding-0.9B 모델의 MRL dim=512 성능이 이전 버전의 8B 임베딩 모델의 성능을 능가할 정도로, 메모리와 추론 속도 관점에서 수십 배 이상의 효율성 개선을 달성하였으며 영어에서도 훨씬 큰 모델과 비슷한 점수를 기록했습니다.
이번에 Kanana-2-Embedding 시리즈를 제작하는 과정에서 Kanana-2-Embedding-3B teacher로부터 작은 임베딩 모델로의 증류가 성공했다는 점에서, 추후에는 더 큰 Decoder-only 모델로 시작해 학습을 진행하여 더 강력하고 효율적인 임베딩 모델을 구축하고자 합니다.
Further Works
이번 Kanana-2 SLM에서는 Cascade Pruning & Distillation을 통해 3B 모델로부터 2B, 1.3B, 0.9B 모델을 단계적으로 구축했습니다. 이러한 방법은 높은 성능의 모델을 안정적으로 개발할 수 있지만, 표와 같이 Dense 시작 모델 구축, Architecture Search, 목표 모델별 개별 학습이라는 세 가지 추가적인 개발 과정이 필요합니다.
| Cascade Pruning & Distillation | Elastic MoE-to-Dense | |
|---|---|---|
| Dense 시작 모델 별도 구축 | O | X |
| Architecture Search 별도 수행 | O | X |
| 목표 모델별 개별 학습 | O | X |
| 하나의 학습으로 여러 모델 생성 | X | O |
표 8. Cascade Pruning & Distillation 방식과 Elastic MoE-to-Dense 방식 비교
- Dense 시작 모델 구축 비용: 시작점이 될 고성능 Dense 모델을 만드는 데 대규모 학습 비용이 듭니다. 최근에는 MoE 모델의 Expert를 선택/병합해 Dense 모델을 초기화하는 MoE-to-Dense 기법이 대안으로 떠오르고 있습니다.
- Architecture Search 탐색 비용: 압축 대상 요소(Hidden Dim, Intermediate Dim, Layer, Head)가 늘어날수록 조합의 수가 폭발적으로 증가합니다.
- 선형적인 학습 비용 증가: 모델 크기별로 Pruning과 Distillation을 개별 수행해야 하므로 대상 모델 수가 늘수록 비용이 비례해 증가합니다.
먼저 Cascade Pruning & Distillation은 적절한 Dense 시작 모델이 준비되어 있음을 전제로 합니다. Kanana-2 SLM에서는 Kanana-2-3B Base를 시작점으로 사용했지만, 일반적으로 이러한 Dense 모델을 구축하는 과정 자체도 상당한 학습 비용이 필요합니다. 최근 LLM은 MoE 구조를 중심으로 발전하고 있는 만큼, MoE로부터 Pruning의 시작점이 되는 Dense 모델을 효율적으로 구축하는 문제가 중요한 과제라고 생각합니다. 이를 위해 최근에는 MoE 모델의 Expert를 선택하거나 Merge하여 하나의 Dense 모델을 초기화하는 MoE-to-Dense 방법이 제안되고 있습니다. 이러한 접근은 Dense 시작 모델을 처음부터 새로 학습하지 않고도 확보할 수 있는 가능성을 보여줍니다.
하지만, Dense 시작 모델이 준비되더라도, 목표 모델 구조를 결정하기 위한 Architecture Search 비용은 여전히 남아 있습니다. 앞서 소개한 Cascade Pruning & Distillation은 각 목표 모델 크기에 적합한 구조를 결정하기 위해 다양한 Pruning configuration을 실험한 뒤, 가장 좋은 구조를 선택하여 Distillation을 수행했습니다. 이러한 방법은 모델 수가 적을 때는 효과적이지만, Pruning 대상(Hidden dimension, MLP intermediate dimension, Layer, Attention head)이 늘어날수록 탐색해야 하는 Configuration의 수가 빠르게 증가합니다. 실제로도 구조를 결정하기 위해 여러 candidate를 학습하고 비교하는 과정이 필요했으며, 이러한 Architecture Search 비용은 모델 압축 과정에서 무시하기 어려운 비중을 차지했습니다.
또한 현재의 Cascade 방식에서는 각 목표 모델 크기마다 Pruning과 Distillation을 각각 수행해야 합니다. 따라서 압축하려는 모델의 수가 늘어날수록 전체 학습 비용 역시 선형적으로 증가합니다.
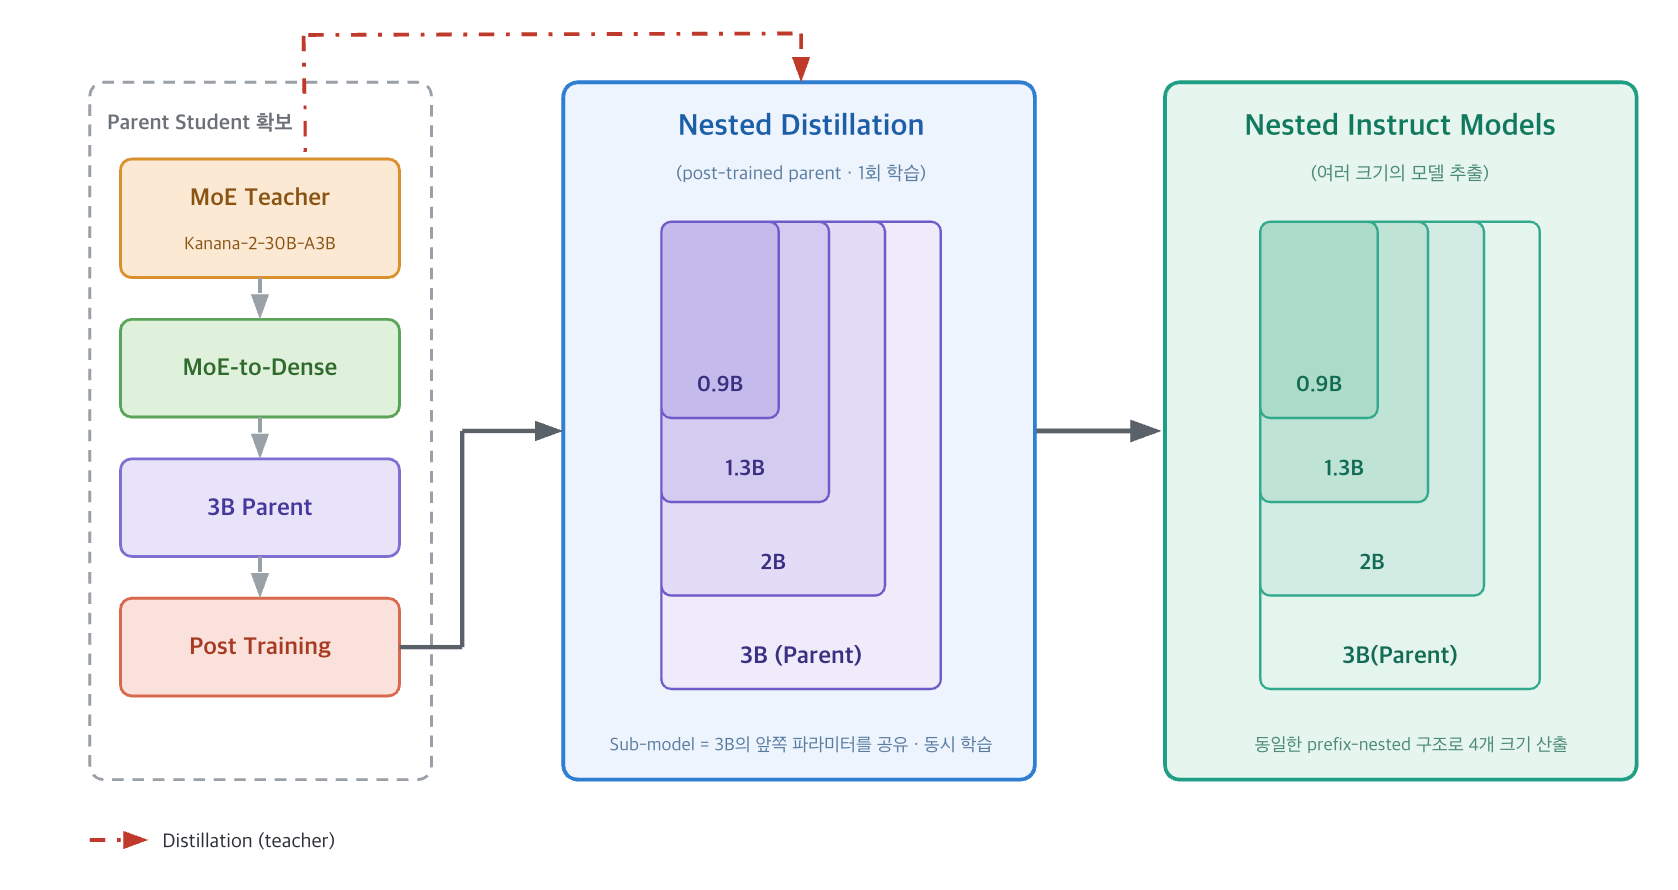
NVIDIA에서 제안한 Nemotron Elastic과 Star Elastic은 이러한 문제를 해결하기 위해 Architecture Search와 Distillation을 하나의 학습 과정으로 통합했습니다. 하나의 가장 큰 Student 모델 내부에 여러 크기의 Sub-model을 Nested 구조로 함께 학습하며, 동일한 파라미터를 공유합니다. 또한 Router를 통해 각 Sub-model의 Hidden dimension, MLP intermediate dimension, Layer, Attention head 구성을 함께 최적화함으로써, 하나의 Distillation 과정에서 다양한 크기의 모델과 구조를 동시에 탐색할 수 있습니다. 이러한 접근은 여러 candidate를 반복적으로 학습하고 비교하는 과정을 줄여 Architecture Search 비용을 크게 절감할 수 있으며, 목표 모델의 수가 많아질수록 더욱 효과적입니다. 또한 하나의 Parent Student 내부에서 여러 크기의 Sub-model을 함께 학습하기 때문에, 모델 크기마다 Distillation을 반복적으로 수행할 필요가 없습니다.
Nemotron Elastic은 Router 기반 Architecture Search와 Nested Distillation으로 구성됩니다. 이번 실험에서는 먼저 Router를 제외하고, Nested Distillation만으로도 여러 크기의 Sub-model을 안정적으로 함께 학습할 수 있는지 확인했습니다.
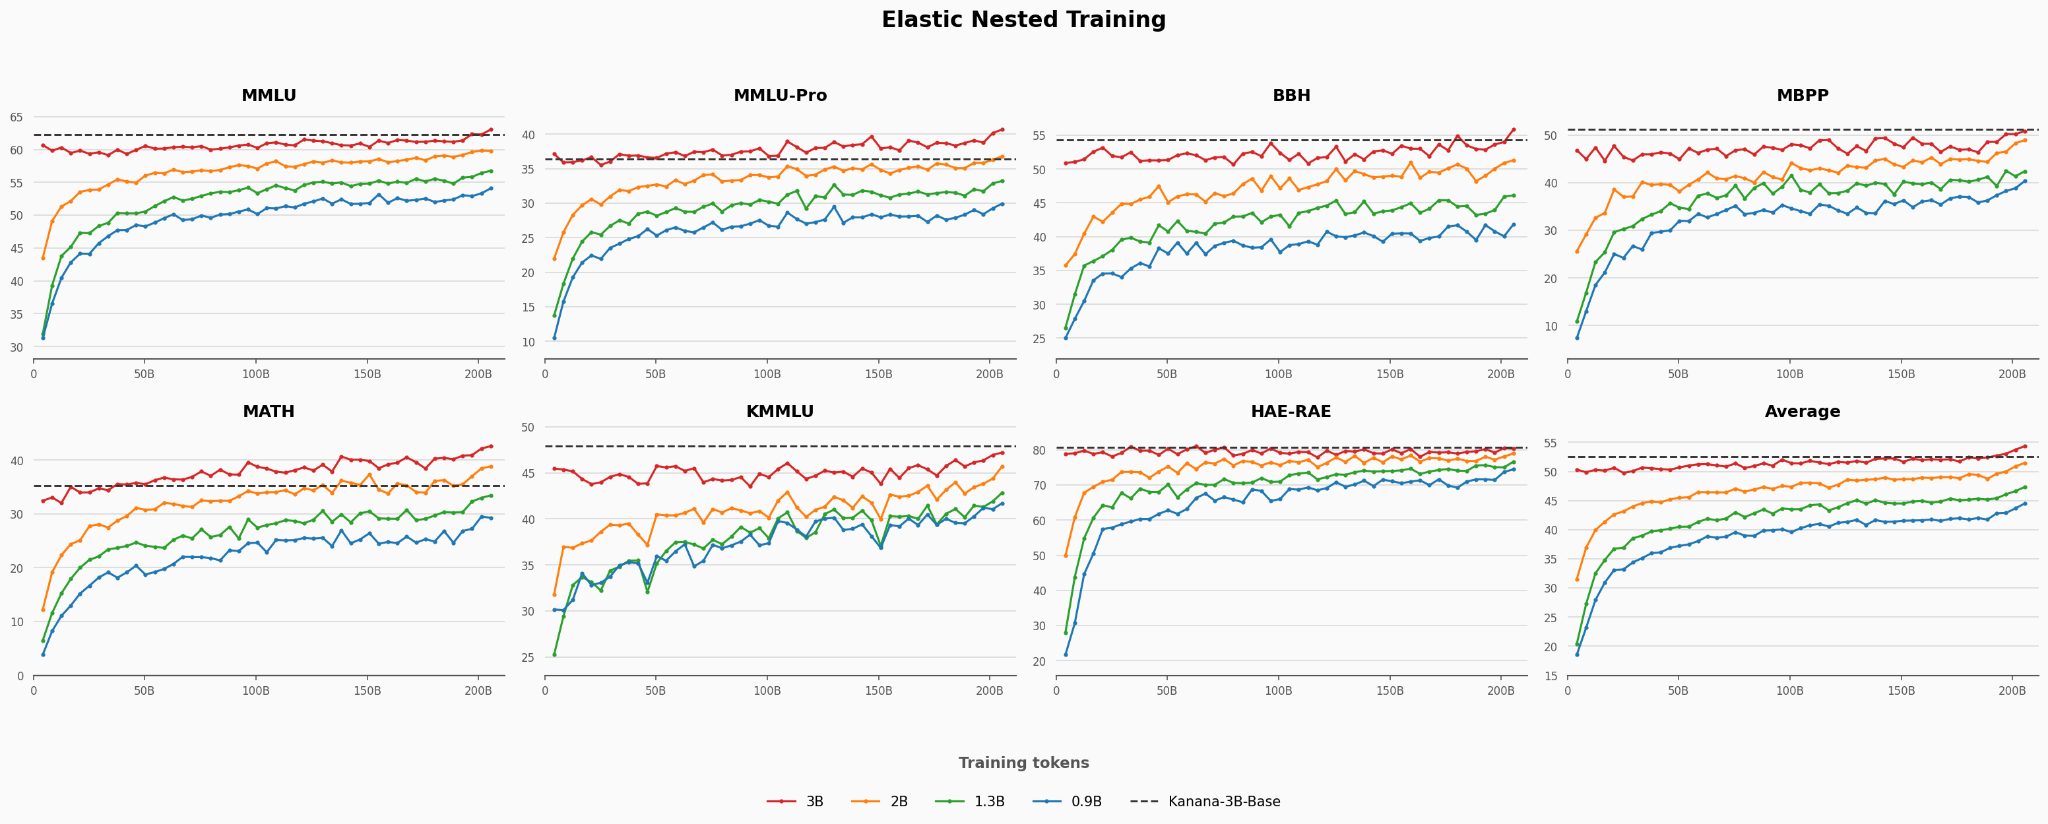
Nemotron Elastic은 원래 Post-trained 모델을 대상으로 제안되었지만, 이번 실험의 목적은 Router나 Post-training 효과가 아니라 Nested Distillation의 학습 안정성을 확인하는 것이었기 때문에 Base 모델을 대상으로 실험을 진행했습니다. Teacher 모델로는 Kanana-2-30B-A3B-Instruct-2601의 내부 개선 버전을 사용했으며, Parent Student는 Kanana-2-3B-Base를 사용했습니다. 또한 Router는 사용하지 않고 Cascade 과정에서 선정한 Pruning configuration을 그대로 고정했습니다. 하나의 3B 모델 안에 2B, 1.3B, 0.9B Sub-model을 Nested 구조로 구성하여 동시에 Distillation을 수행했습니다.
실험 결과, 모든 Sub-model은 학습이 진행될수록 성능이 꾸준히 향상되었습니다. 특히 3B 모델은 대부분의 벤치마크에서 기존 성능을 거의 회복했으며, 2B, 1.3B, 0.9B Sub-model 역시 지속적으로 성능이 향상되었습니다. 또한 동일한 모델 크기에서 기존 Cascade Pruning & Distillation으로 개별 학습한 모델과 비교해도 전반적으로 큰 성능 차이를 보이지 않았습니다. 이는 하나의 Parent Student 안에서 여러 Sub-model을 동시에 학습하더라도, 기존 Cascade Pruning & Distillation과 유사한 수준의 성능을 도달할 수 있음을 보여줍니다. 현재는 이러한 Nested Distillation에 Router 기반 Architecture Search를 결합하여, 하나의 학습 과정에서 다양한 모델 구조를 탐색하고 여러 크기의 모델을 동시에 생성하는 Elastic Training을 Kanana SLM에도 적용하고 있습니다. 이를 통해 Dense 시작 모델 구축, Architecture Search, 모델별 개별 학습에 드는 비용을 줄이면서도 다양한 크기의 고성능 SLM을 보다 효율적으로 개발하는 것을 목표로 연구를 이어가고 있습니다.
결론
이번 글에서는 카카오의 두 번째 SLM 시리즈인 Kanana-2-3B, 1.3B, 0.9B 모델의 개발 과정을 상세히 공유드렸습니다. Kanana-2 SLM은 Cascade Pruning & Distillation과 SWA(Sliding Window Attention) 도입을 통해 효율적인 온디바이스 AI 환경에 최적화된 성능을 구현했습니다. 또한, Off/On-Policy Distillation과 최신 Embedding 학습 기법을 적용하여 언어 이해와 생성 능력을 극대화했습니다. 향후에는 Elastic Training을 통해 더욱 비용 효율적이고 강력한 모델을 구축할 예정입니다.
이번에 공개하는 Kanana-2-3B와 Kanana-2-1.3B의 Base 및 Instruct 모델이 다양한 연구와 서비스 개발에 도움이 되기를 바라며, 앞으로도 카카오의 AI 기술에 많은 관심과 기대 부탁드립니다.
함께한 사람들
Kanana 조직의 kaya.butter(한규빈), ryan.u(류민호), wavy.jung(정두해), mat.mul(김보섭)가 기여해 주셨습니다.