Engineering
카카오의 경량 멀티모달 언어모델 ‘Kanana-1.5-v-3b’ 개발부터 공개까지
samuel.brain, sonny.7카카오
2025년 7월 24일
원문에서 보기 ↗카카오의 멀티모달 언어모델 ‘Kanana-v’의 개발과 오픈소스 공개 소식을 공유합니다
안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나(Kanana) 조직의 Samuel(강성훈), Sonny(손동희)입니다. 저희 조직에서는 이미지를 포함한 다양한 모달리티 데이터를 처리할 수 있는 멀티모달 언어모델을 개발하고 있습니다.
모달리티 데이터: 텍스트, 이미지, 오디오, 비디오 등 감각 기관을 통해 얻는 다양한 형식의 데이터를 의미합니다.
작년 12월, 저희는 첫 번째 멀티모달 언어모델인 ‘Kanana-v’를 소개하며, 한국형 멀티모달 AI 모델의 가능성을 선보인 바 있습니다. 그 후속 모델로, 경량화된 구조와 보다 향상된 멀티모달 지시 이행(Multimodal Instruction Following) 능력을 통해 실용성과 성능을 모두 갖춘 ‘Kanana-1.5-v-3b-instruct(이하 Kanana-v-3b)’를 새롭게 개발 하였습니다. 특히 이번에는 그간의 모델 개발과정과 함께, 허깅페이스를 통해 모델을 오픈소스로 공개합니다. 상업적으로 활용 가능한 Kanana License를 적용하여 누구나 사용할 수 있으니 많은 관심 부탁드립니다!
Kanana-v-3b는 카카오의 자체 언어모델 ‘Kanana-1.5-3b-instruct’를 기반으로 이미지와 텍스트를 함께 입력받아 자연어로 응답을 생성할 수 있도록 확장한 경량 멀티모달 언어모델입니다. [그림 1]에서 보이듯, ViT 기반의 Vision Encoder와 자체개발한 C-Abstractor [1] 구조를 사용하여 이미지 정보를 LLM이 이해할 수 있는 형태로 변환하여 입력하고, LLM은 입력된 정보와 텍스트 지시를 이해하여, 텍스트 형태의 답변을 생성하는 구조로 구성되어 있습니다.
ViT 기반(Vision Transformer-based): 이미지 처리나 컴퓨터 비전 분야에서 Transformer 아키텍처를 활용한 모델을 의미합니다.
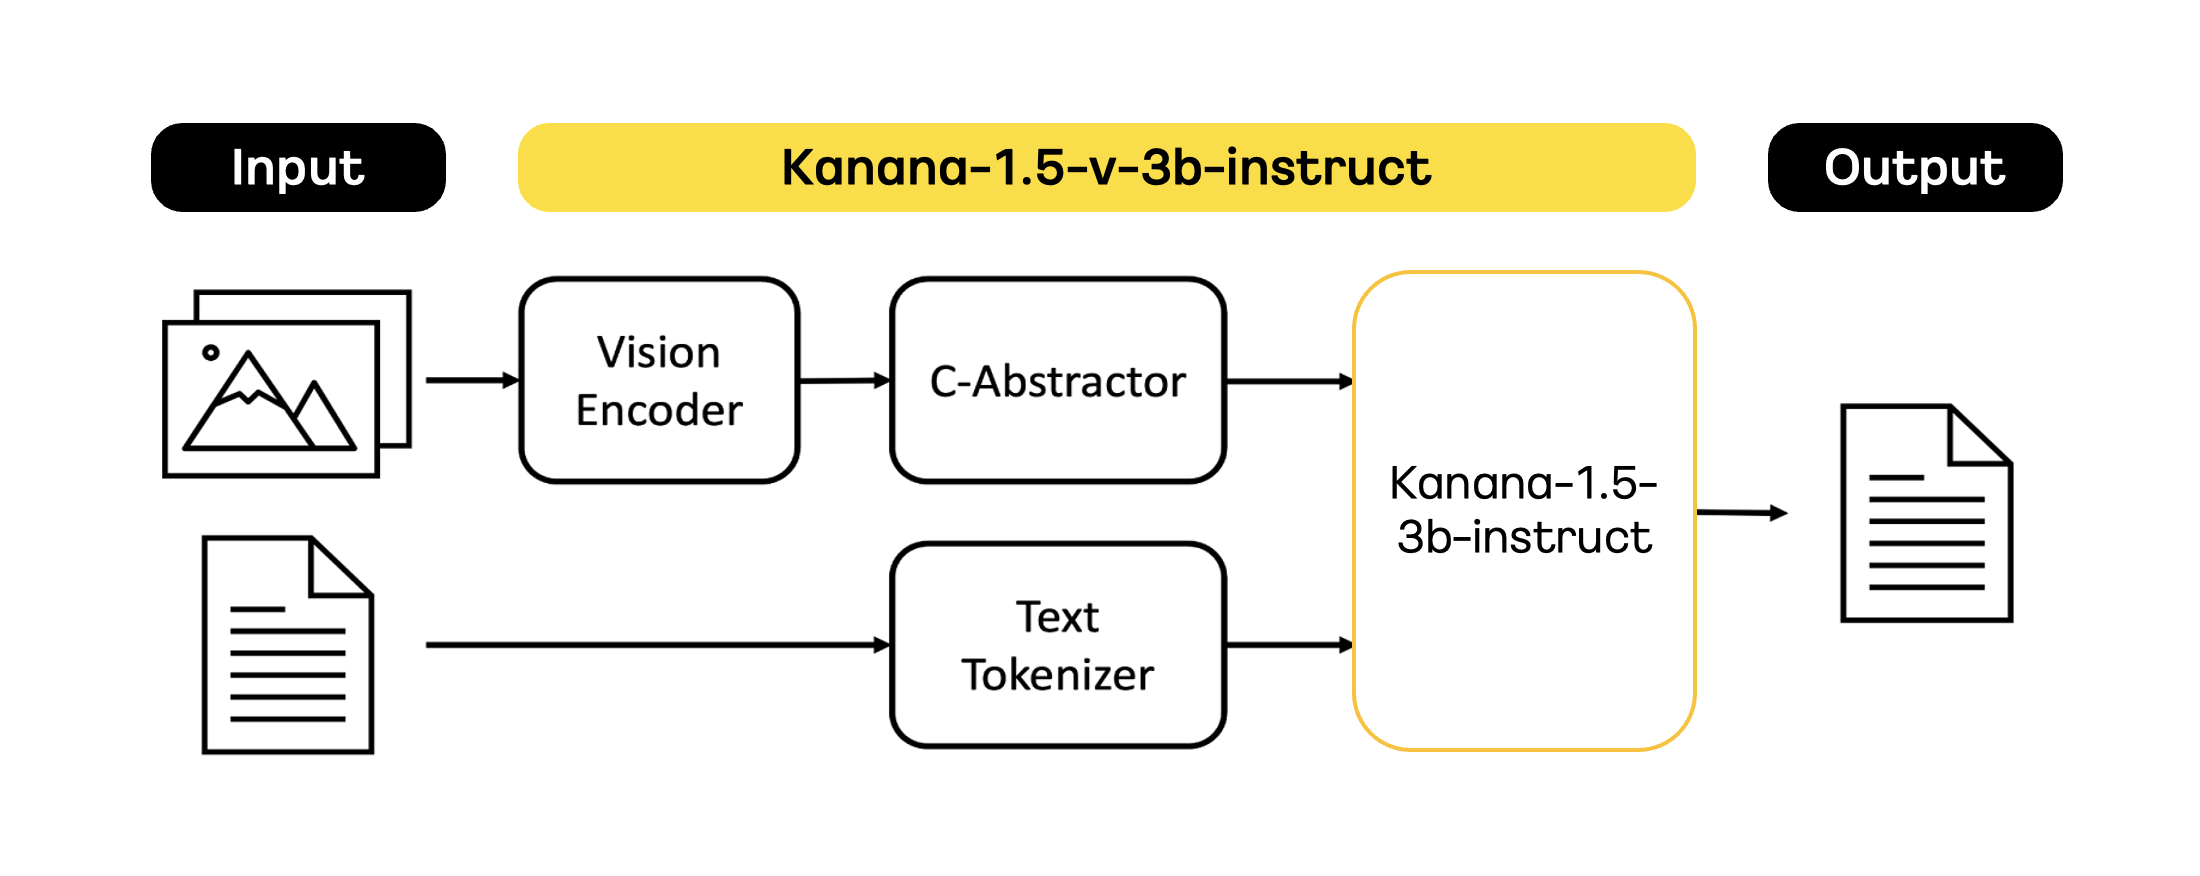
약 36억 개(3.6B)의 파라미터를 가진 Kanana-v-3b는 비슷한 규모(<4B)의 글로벌 모델과 비교하여 다양한 한국어 벤치마크에서 뛰어난 성능을 기록했습니다. 영어 벤치마크에서도 경쟁력 있는 결과를 보였으며, 특히 소형 모델임에도 멀티모달 지시 이행 능력(Multimodal Instruction Following)에서도 우수한 성능 [그림 2] 을 보입니다.
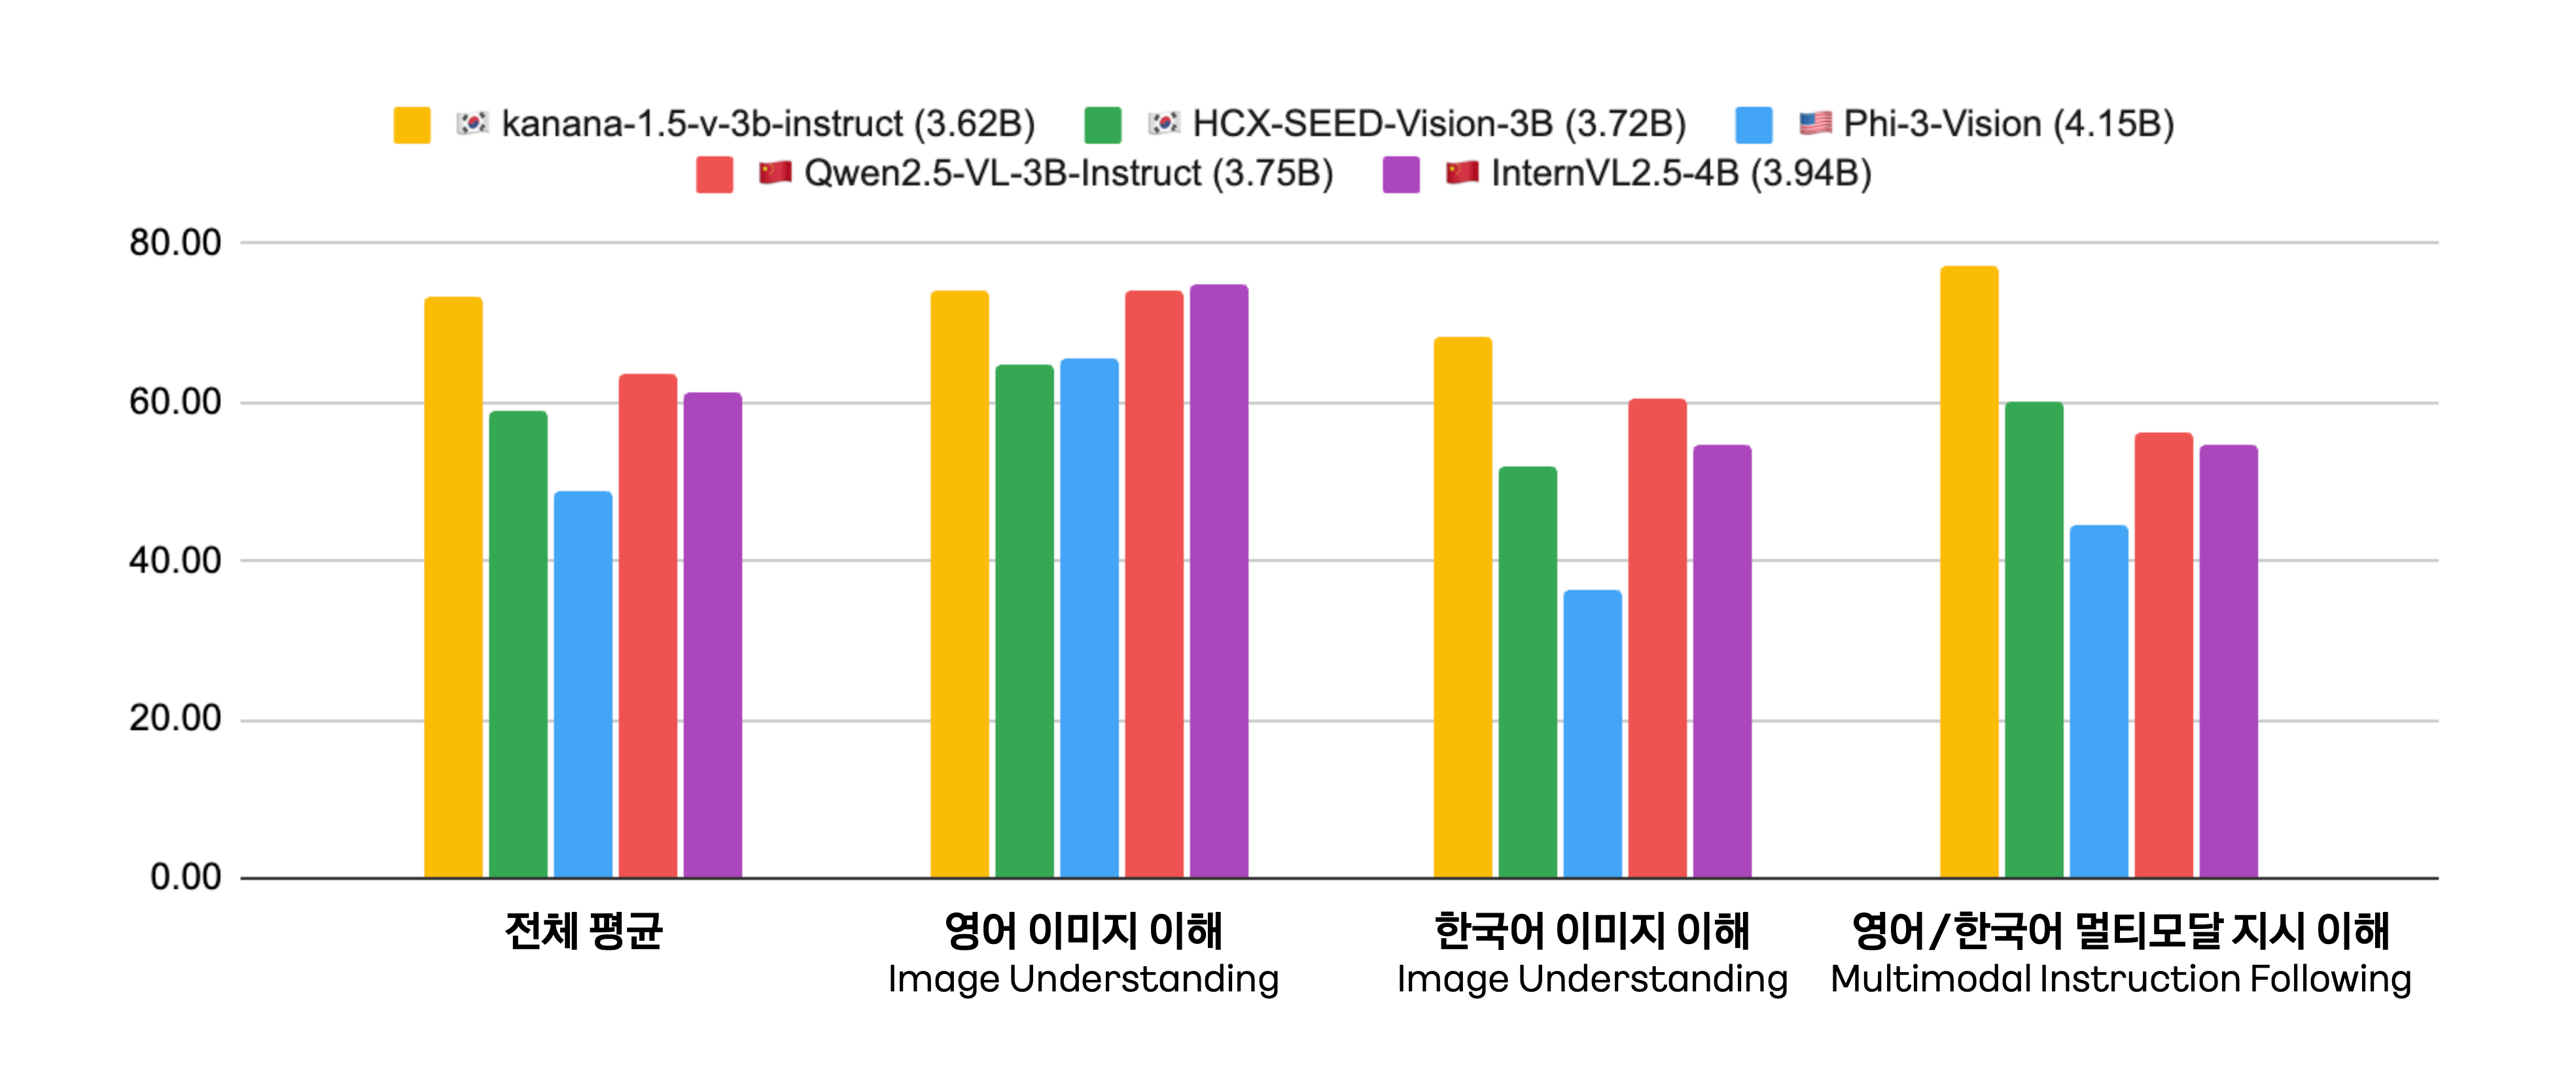
이 글에서는 Kanana-v-3b의 성능뿐 아니라, 소형 멀티모달 모델 개발 과정에서 저희가 집중했던 문제와 해결 방법을 어떻게 학습 과정에 반영했는지 자세히 소개하겠습니다.
영어・한국어 모두 잘하는 Kanana-v-3b
Kanana-v-3b 모델은 특히 사용자의 지시(Instruction)를 정확히 이해하고 이를 충실히 따르는 능력인 지시 이행 능력(Instruction Following)의 성능 향상에 중점을 두었습니다. 지난 Kanana-v 개발기에서는 주로 LLM이 이미지를 보고 이해하는 능력 학습에 집중했다면, 이번 글에서는 사용자의 의도를 정확히 파악하고, 보다 정확하고 자연스러운 답변을 생성하는 사용감 좋은 모델을 학습하는 데에 초점을 맞추었습니다.
Kanana-v-3b의 전반적인 성능은 멀티모달 지시 이행, 한국어 및 한국 문화 특화 벤치마크, 영어 벤치마크의 세 가지 주요 측면에서 측정되었습니다. 각 평가는 실제 환경에서 사용자가 AI 모델과 자연스럽게 상호작용할 수 있는지와 모델의 산업적 활용을 비롯하여 다양한 응용 분야로의 적용 가능성을 판단하는 데 중요한 기준이 됩니다.
첫 번째로, 텍스트와 이미지에 기반한 복잡한 지시를 얼마나 잘 이해하고, 지시를 충족한 답변을 생성하는지 평가하는 멀티모달 지시 이행 능력(Multimodal Instruction Following)의 성능을 살펴보고, 이어서 Kanana-v-3b 모델의 가장 큰 장점인 한국어, 및 한국문화 특화 성능을 다양한 벤치마크를 통해 분석합니다. 마지막으로는 타 글로벌 모델들과의 경쟁력을 평가하기 위해 널리 사용되는 영어 벤치마크를 통해 모델의 성능을 비교하겠습니다.
말귀를 잘 알아듣는 멀티모달 언어모델
멀티모달 지시 이행 능력(Multimodal Instruction Following)이란, 텍스트뿐만 아니라 이미지 등의 다양한 모달리티 입력을 바탕으로, 자연어로 주어진 지시(Instruction)를 이해하고 그에 맞는 응답을 생성하는 능력을 의미합니다. 예를 들어, 사용자가 “이미지를 요약해서 개조식으로 정리해 줘”라고 입력했을 때, 모델은 입력 이미지와 텍스트를 정확히 이해하고, 지시된 포맷에 맞춰 응답해야 합니다.
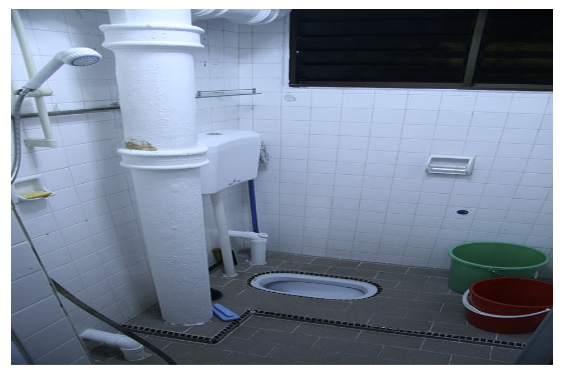
이제 사용자는 AI모델에게 명확한 명령어만 입력하는 것이 아니라, [표 1]의 예시와 같이 “욕실이나 방이라는 단어를 사용하지 않고 이미지를 한 문장으로 설명해 줘”처럼 더 복잡하고 직관적인 요청을 자연어로 입력하고 있습니다. 이러한 멀티모달 지시 이행 능력(Multimodal Instruction Following)은 사용자와 AI가 더욱 자연스럽게 상호작용하도록 만드는 핵심 기술입니다. 특히 실제 서비스 환경에서는, 이 기술이 “이 모델, 진짜 똑똑하네!”라는 인상을 사용자에게 줄 수 있는 중요한 차별화 포인트가 됩니다.
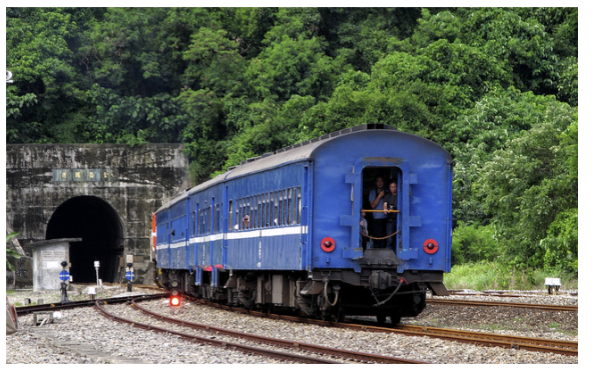
최근의 연구들은 멀티모달 지시 이행 능력(Multimodal Instruction Following)을 평가하기 위해, 영어를 대상으로 한 벤치마크들(MIA-Bench[2], MM-IFEval[3], MM-OmniAlign[4] 등)을 제안하고 있습니다. 하지만 한국어의 경우 이러한 벤치마크가 존재하지 않기에 MIA-Bench의 이미지와 질문을 사용하여 MIA-Bench-Ko라는 벤치마크 [표 1]를 자체적으로 제작하였습니다.
 |  |
|---|---|
| 질문 : 욕실이나 방이라는 단어를 사용하지 않고 이미지를 한 문장으로 설명하세요. | 질문 : 이 이미지의 배경을 두 개의 독특한 형용사와 한 개의 동사를 사용하여 설명하세요. |
표 1. MIA-Bench-Ko 벤치마크 데이터 예시 (이미지 출처 : https://www.flickr.com/)
MIA-Bench를 단순히 한국어로 번역하는 것에서 한 걸음 더 나아가, 영어와 한국어 사이의 문법적, 문화적 차이점으로 적절하지 않은 질문들을 [표 2]와 같이 수정하여, 한국어 문법과 문화를 반영할 수 있도록 구성하였습니다.
| MIA-Bench의 지시 | 번역 및 수정된 MIA-Bench-Ko의 지시 |
|---|---|
| Describe the image in one sentence without using the letter ‘e’. | 'ㅅ’이 들어가지 않도록 한 문장으로 이미지를 설명하세요. |
| Narrate the content of the image as if it were part of a dialogue in a play, using Elizabethan English. | 이미지의 내용을 연극 대사의 한 부분처럼 이야기하십시오. 조선시대의 한국어를 사용하세요. |
[표 2] MIA-Bench-Ko의 지시 예시. MIA-Bench의 지시(Instruction)를 한국어 및 한국 문화를 고려하여 번역 및 수정하여 MIA-Bench-Ko의 지시를 구성했습니다.
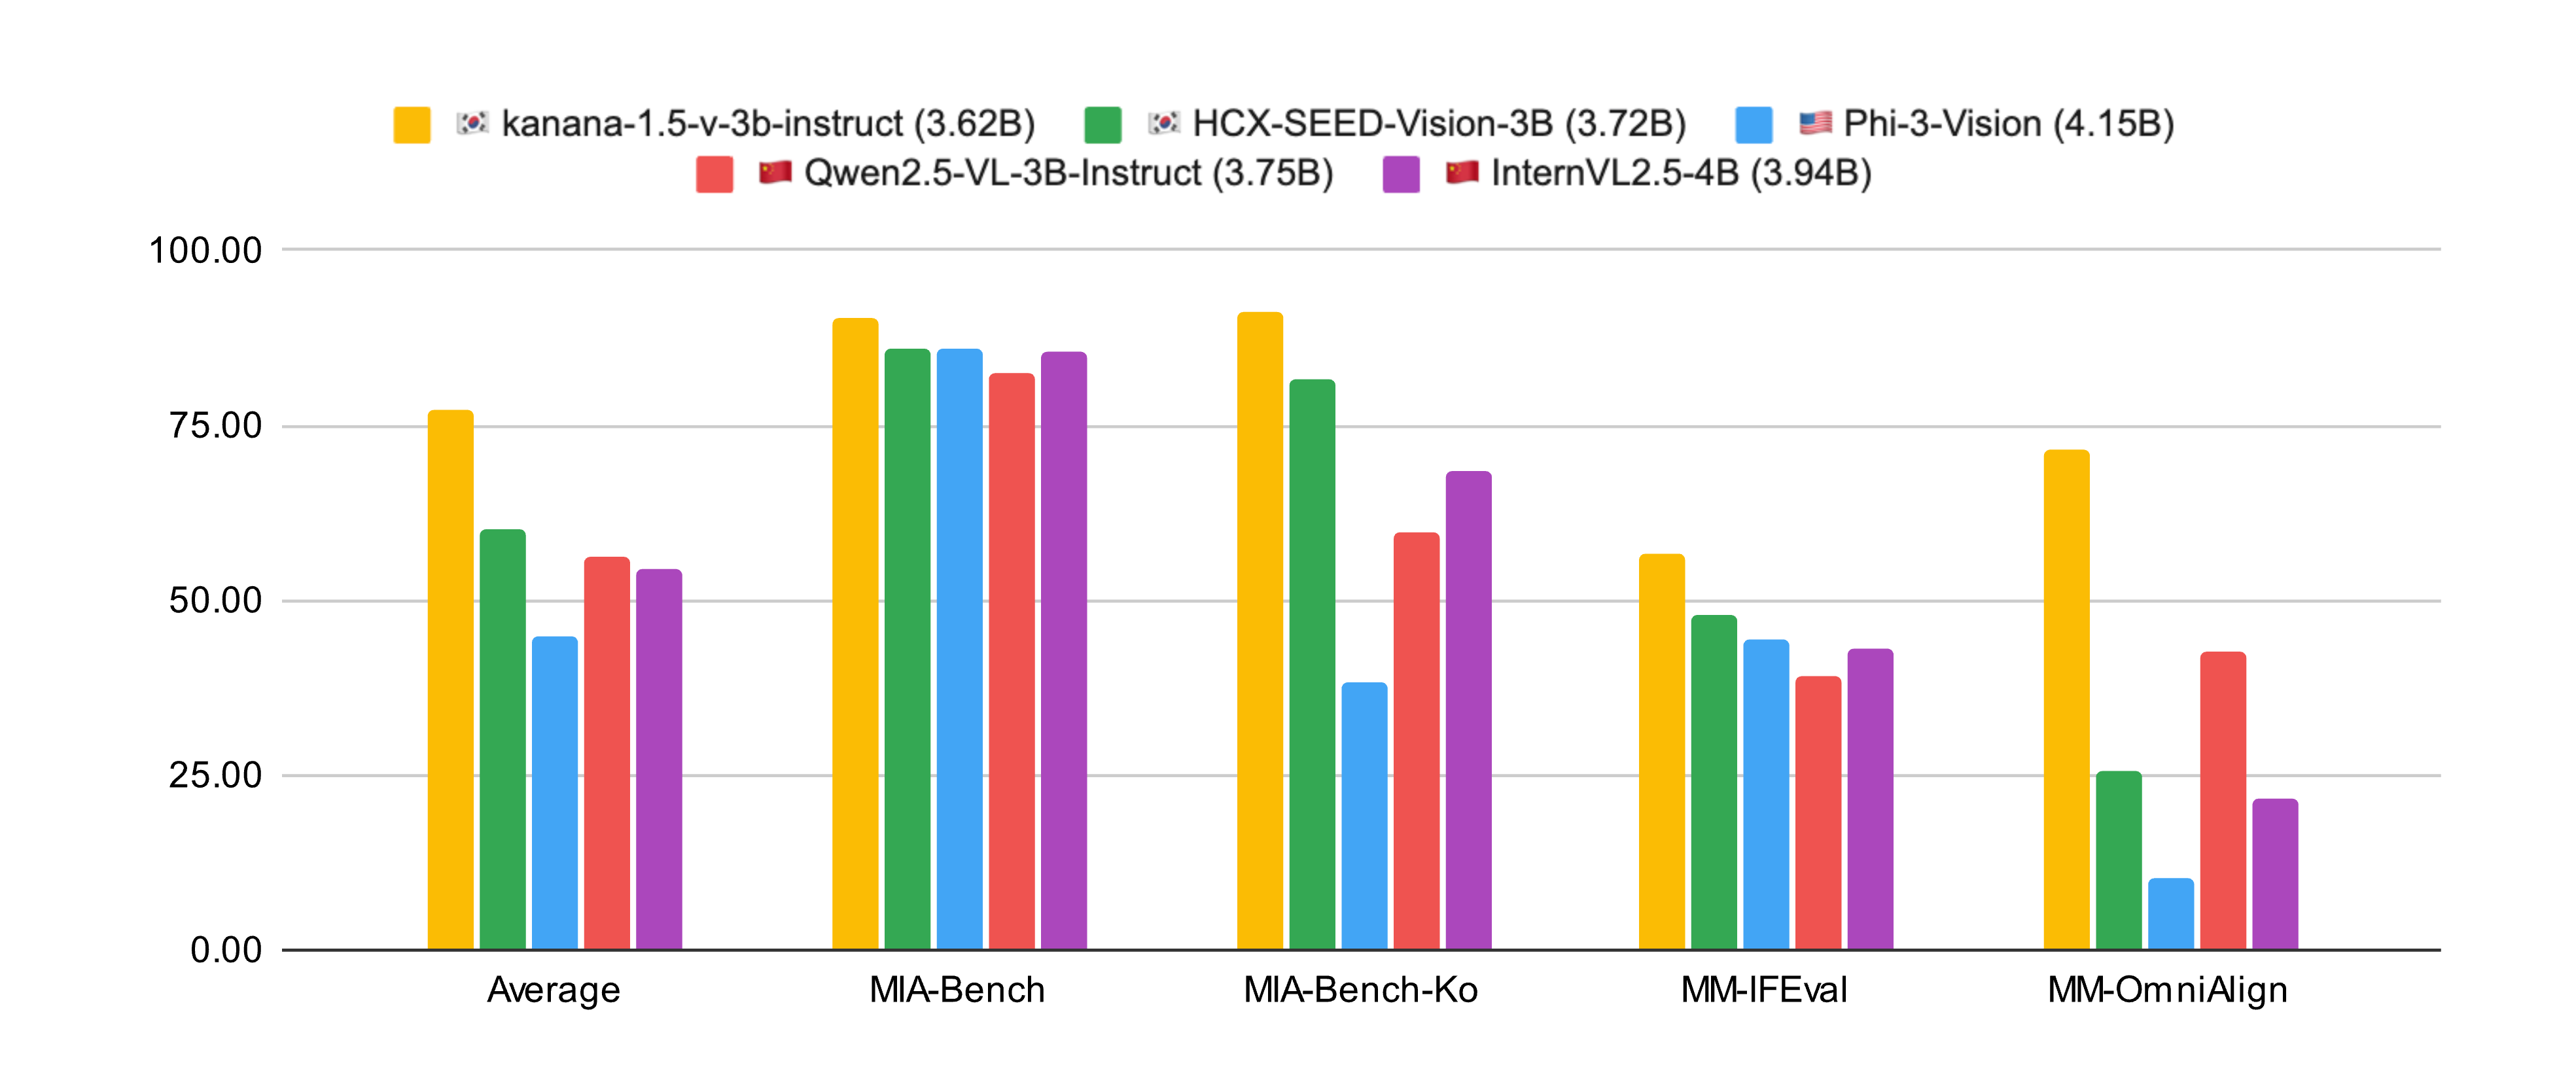
멀티모달 지시 이행 능력(Multimodal Instruction Following)의 성능을 비슷한 크기의 글로벌 모델들과 비교해 본 결과, 아래 [그림 3], [표 3]과 같이 Kanana-v-3b가 비슷한 파라미터를 갖는 다른 모델들 대비 한국어뿐만 아니라 영어에서도 가장 뛰어난 성능을 보여주고 있음을 확인할 수 있었습니다.
| Kanana-1.5-v- 3b-instruct | HCX-SEED- Vision-3B | Phi-3-Vision | Qwen2.5-VL- 3B-Instruct | InternVL2.5- 4B | |
|---|---|---|---|---|---|
| MIA-Bench | 90.28 | ++85.81++ | 85.78 | 82.55 | 85.68 |
| MIA-Bench-Ko | 91.17 | ++81.80++ | 38.35 | 59.61 | 68.35 |
| MM-IFEval | 56.67 | ++47.91++ | 44.37 | 39.14 | 43.06 |
| MM-OmniAlign | 71.43 | 25.40 | 10.32 | ++42.86++ | 21.43 |
| Average | 77.39 | ++60.23++ | 44.71 | 56.04 | 54.63 |
표 3. 멀티모달 지시 이행 능력(Multimodal Instruction Following) 벤치마크 비교. (굵은 글자는 첫 번째로 높은 성능, 밑줄은 두 번째로 높은 성능을 의미합니다.)
Kanana-v-3b는 영어 멀티모달 지시 이행 능력(Multimodal Instruction Following) 성능을 측정하는 MIA-Bench에서 경쟁력 있는 글로벌 모델들을 능가했을 뿐만 아니라, 한국어와 한국 문화를 고려해 번역한 MIA-Bench-Ko에서는 더욱 큰 격차로 다른 모델들을 압도하는 성능을 보여주었습니다.
한국 문화에 특히 더 강한 멀티모달 언어모델
한국어의 경우, 영어와 달리 보편적으로 사용되는 평가지표들이 없기에, 멀티모달 언어모델의 한국어 성능을 정확히 평가하고 비교할 수 있는 벤치마크들이 부족한 상황입니다. 영어로 구축된 멀티모달 언어모델 벤치마크를 번역하여 성능을 측정할 수는 있지만, 이미지 내의 한글을 이해할 수 있는지에 대한 여부나 한국에 대한 지식 등을 평가할 수 없다는 한계가 존재합니다.
이러한 문제로, 다른 글로벌 수준의 모델들과 한국어 이해 능력을 정확하게 비교하기 위해 기존 제작한 한국어 벤치마크를 확장하여 총 7종의 한국 대상 벤치마크를 제작하였습니다. 이미지 내 한국어 문자를 올바르게 읽을 수 있는지부터 시작하여, 문서를 이해하고, 또한 한국 문화와 관련된 이미지에 대해서 올바르게 대답할 수 있는지 [표 4]를 세밀하게 평가하는 것을 목표로 하였고, 각 벤치마크의 이름과 평가하는 내용은 [표 5]에 정리되어 있습니다.
| KoChartTask | KoMMDBench | KoEntity |
|---|---|---|
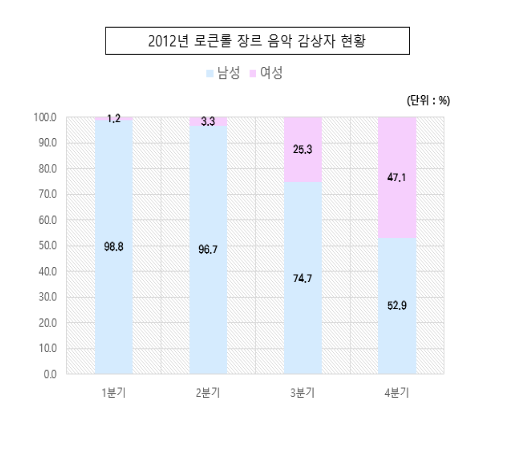 | 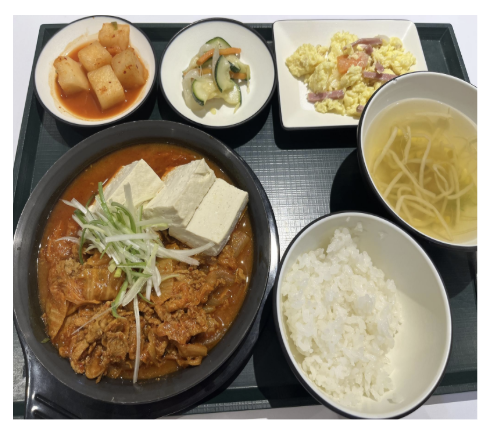 | 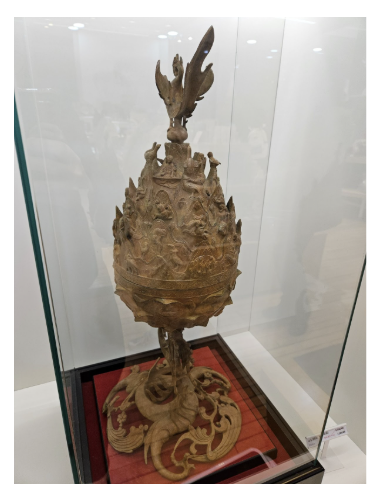 |
| 질문 : 2분기에서 여성 감상자의 비율은 몇 퍼센트인가요? | 질문 : 사진의 왼쪽 위 접시에 있는 음식의 이름이 무엇인가요? | 질문 : 사진 속 물체의 이름은 무엇인가요? |
표 4. 자체 구축한 한국어 평가 벤치마크의 예시들 (사진 출처 : AIHUB / 직접 촬영 / 직접 촬영)
| 한국어 벤치마크 이름 | 평가하는 내용 |
|---|---|
| KoOCRBench | 한국어 문자 인식 (OCR) |
| KoChartTask | 한국어 차트 해석 기반 질의응답 |
| KoFoodMenu, KoCosMed | 생활 속 한국어 텍스트 이해 기반 질의응답 |
| KoMMDBench, KoEntity, KoCelebV2 | 한국 문화 및 지식기반 질의응답 |
| KoExam, KoMathSol | 한국어 문제풀이 |
[표 5] 자체 구축된 한국어 평가 벤치마크의 이름과 평가 내용
| Kanana-1.5-v- 3b-instruct | HCX-SEED- Vision-3B | Phi-3-Vision | Qwen2.5-VL- 3B-Instruct | InternVL2.5- 4B | |
|---|---|---|---|---|---|
| KoOCRBench | 85.93 | 32.91 | 25.13 | ++50.67++ | 20.52 |
| KoChartTask | 84.96 | 73.55 | 52.36 | 84.96 | ++82.61++ |
| KoFoodMenu | 70.84 | 57.08 | 34.70 | ++66.32++ | 65.09 |
| KoCosMed | 87.58 | 78.16 | 56.75 | 82.01 | ++82.66++ |
| KoMMDBench | 74.00 | ++64.57++ | 37.93 | 61.75 | 62.65 |
| KoEntity | 72.04 | ++64.12++ | 31.71 | 58.15 | 50.42 |
| KoCelebV2 | 43.24 | ++37.58++ | 26.25 | 33.72 | 34.23 |
| KoMathSolution | 36.88 | 27.88 | 38.75 | 47.13 | ++46.50++ |
| KoExam | ++58.99++ | 31.82 | 24.05 | 60.68 | 47.43 |
| Average | 68.27 | 51.96 | 36.40 | ++60.60++ | 54.68 |
표 6. 한국어 벤치마크 성능 비교. 다양한 벤치마크에서 Kanana-v-3b는 경쟁 모델 대비 우수한 성능을 보여주고 있습니다. (굵은 글자는 첫 번째로 높은 성능, 밑줄은 두 번째로 높은 성능을 의미합니다.)
평가 결과, Kanana-v-3b는 비슷한 크기의 글로벌 모델들과 비교했을 때, 한국어 벤치마크 모든 영역에서 월등한 성능을 보였습니다. 특히, KoOCRBench, KoFoodMenu, KoCosMed에서 평가하는 한국어 문자인식 및 해석 능력에서 큰 격차를 보여주었으며, 이는 실제 서비스 환경에서 활용 가능성을 높이는 중요한 요소입니다.
또한 KoMMDBench와 KoEntity와 같은 한국에 대한 문화/지식 기반 QA 태스크에서도 타 모델 대비 뛰어난 이해력과 응답 정확도를 기록하였습니다. 이는 단순 언어 처리 능력을 넘어서, 한국어 표현의 맥락과 문화적 배경까지 포괄적으로 이해할 수 있는 모델이라는 점에서 특히 의미가 큽니다.
글로벌 경쟁력을 갖춘 멀티모달 언어모델
Kanana-v-3b는 한국어 뿐만 아니라 영어에서도 주요 경쟁 모델들과 비교해도 손색없는 성능을 보여줍니다. 영어로 구성된 이미지와 질의에 대한 모델 응답의 정확도를 측정하기 위해 총 15종의 공신력 있는 벤치마크를 수행하여 그 성능을 비교 [표 7] 하였습니다.
| Kanana-1.5-v- 3b-instruct | HCX-SEED- Vision-3B | Phi-3-Vision | Qwen2.5-VL- 3B-Instruct | InternVL2.5- 4B | |
|---|---|---|---|---|---|
| MMMU | 43.89 | 38.89 | 45.33 | ++50.67++ | 52.33 |
| MathVista | 56.00 | 47.40 | 43.60 | 62.00 | ++61.80++ |
| DocVQA | ++93.06++ | 79.87 | 87.04 | 94.19 | 92.13 |
| ChartQA | 81.20 | 71.88 | 81.40 | 83.60 | ++82.76++ |
| OCRBench | 82.50 | 62.90 | 63.60 | 79.10 | ++79.20++ |
| InfoVQA | ++73.62++ | 55.59 | 54.80 | 77.22 | 69.73 |
| TextVQA | 78.62 | 73.51 | 69.61 | 77.77 | ++78.24++ |
| RealWorldQA | 65.36 | 62.48 | 59.08 | 59.74 | ++62.88++ |
| MMStar | ++56.32++ | 46.66 | 47.47 | 56.26 | 59.72 |
| MMB | ++78.44++ | 72.42 | 73.37 | 77.75 | 81.96 |
| SEED-image | ++75.17++ | 74.84 | 71.69 | 74.83 | 75.59 |
| MMVet | 65.87 | 47.27 | 45.96 | 61.06 | 61.38 |
| LLaVA-Wild | ++89.60++ | 79.30 | 70.40 | 96.90 | 86.30 |
| ScienceQA | ++95.61++ | 86.84 | 90.84 | 79.69 | 97.14 |
| AI2D | 74.81 | 72.31 | 76.98 | ++78.79++ | 79.83 |
| Average | ++74.00++ | 64.81 | 65.41 | 73.97 | 74.73 |
표 7. 영어 벤치마크 성능 비교. Kanana-v-3b는 비슷한 모델 크기를 갖는 글로벌 모델들과 비교할 때 경쟁력 있는 성능을 보여줍니다.
종합적으로 파라미터의 수가 4B(40억) 미만인 글로벌 모델들 사이에서, 경쟁력 있는 성능을 달성 했습니다.
하지만 아직 MMMU와 Math 등 일부 영역에서는 글로벌 모델과 비교해 상대적 우위를 달성하지는 못했으며, 특히 고차원적 추론(Reasoning) 능력을 요구하는 STEM(Science, Technology, Engineering, Mathematics) 관련 과제에서 추가적인 개선이 필요한 것으로 확인되었습니다. 앞으로 Math 등 추론 능력이 중요한 STEM 분야에서의 성능 향상을 위해, 관련 데이터를 지속적으로 확보함과 동시에 모델의 추론(Reasoning) 능력을 강화할 수 있는 학습 기법도 적극적으로 도입해 나갈 계획입니다.
Kanana-v-3b의 학습 전략
Kanana-v-3b는 앞서 언급 드린 것처럼 글로벌 수준의 모델들과 비교해서 경쟁력 있는 영어 성능을 달성하면서도, 압도적인 한국어 성능 및 멀티모달 지시 이행 능력(Multimodal Instruction Following) 능력을 보여주었는데요, 이러한 모델을 학습시키기 위해 사용한 학습 전략 전반에 대해 소개하려 합니다.
Kanana-v-3b는 앞서 공유드린 Kanana-v와 동일한 모델 구조를 가지고 있습니다. 짧게 정리하면, 네이티브 해상도(Native Resolution) [5] 를 지원하는 DFN [6] 기반의 Vision Encoder와 Kanana-1.5-3b-instruct LLM으로 구성되어 있고, 그 사이를 자체 기술인 허니비(Honeybee)에서 제안한 C-Abstractor [1] Projector로 연결한 구조입니다. 모델 구조는 기존 Kanana-v와 동일하지만, 단계별 학습 전략을 개선하여 모델의 성능을 더욱 향상시킬 수 있었습니다.
허니비(Honeybee): 카카오브레인에서 자체 개발한 멀티모달 언어모델 오픈소스로, 이미지와 대규모 언어모델을 연결하는 새로운 모듈을 제안하기 위해 만들어졌습니다.
모델은 크게 4단계의 학습을 거치게 되고, 각 단계는 아래의 [표 8]와 같이 정리할 수 있습니다.
| 단계 | 학습 모듈 | 데이터 도메인 | |
|---|---|---|---|
| Projector Pre-training | 1 | Projector | Image captions, OCR |
| Continued pre-training | 2 | Entire Model | Dense image captions, Grounding, OCR, Document, Interleaved image-text corpus |
| Knowledge Distillation | 3 | Entire Model | Various QA-format datasets on various domains |
| Instruction Following and Human Preference Alignment | 4 | Entire Model | Korean multimodal instruction following dataset Human verified high quality Visual QA dataset |
| Instruction Following and Human Preference Alignment | DPO | Entire Model | Human preference data for multimodal instruction following (Chosen, Rejected response pairs) |
표 8. Kanana-v-3b의 단계별(Stage-wise) 학습 전략
- 1단계: Projector Pre-training. 기존 Kanana-v와 동일하게, 이미지 캡션(Image Caption) 데이터와 한국어, 영어 OCR 데이터셋을 사용하여, LLM과 Vision Encoder 사이를 연결해 주는 Projector만을 학습하게 됩니다.
- 2단계: Continued pre-training. 앞서 공개되었던 Kanana-v 모델과의 차이점으로 대량의 상호교차 이미지-텍스트 코퍼스(Interleaved image-text corpus)를 학습 과정에 추가로 사용하였습니다. 상호교차 이미지-텍스트 코퍼스(Interleaved image-text corpus)의 경우 <이미지> <텍스트> <이미지> <텍스트>가 반복되는 형태로, Vision Encoder 학습 과정에서 배우지 못한 한국형 문화와 관련된 이미지와 텍스트의 지식을 주입하는 목적을 가지고 있습니다.
- 3단계: Knowledge Distillation(KD). 경량 모델의 성능을 향상시키기 위해서, 성능이 높은 더 큰 교사(Teacher) 모델의 지식을 학생(Student) 모델에 전이하는 지식 증류(Knowledge Distillation) 학습 기법을 적용했습니다.
- 4단계, DPO: Instruction Following 학습. 사용자의 지시를 더 잘 알아듣고, 의도를 파악하여 응답을 생성하는 모델을 학습하기 위해서, 한국어 멀티모달 지시 이행(Multimodal Instruction Following) 데이터셋을 구축하였고, SFT와 직접 선호 최적화(Direct Preference Optimization) 기법을 사용하여 학습했습니다.
가장 큰 개선을 이끌어 낸 3단계의 지식 증류 기법(Knowledge Distillation)과 4단계 DPO의 지시 이행 및 인간 선호 정렬(Instruction Following & Human Preference Alignment) 학습 단계는 아래에서 자세히 설명하겠습니다.
큰 모델의 지식을 경량 모델에 전달하는 지식 증류 기법
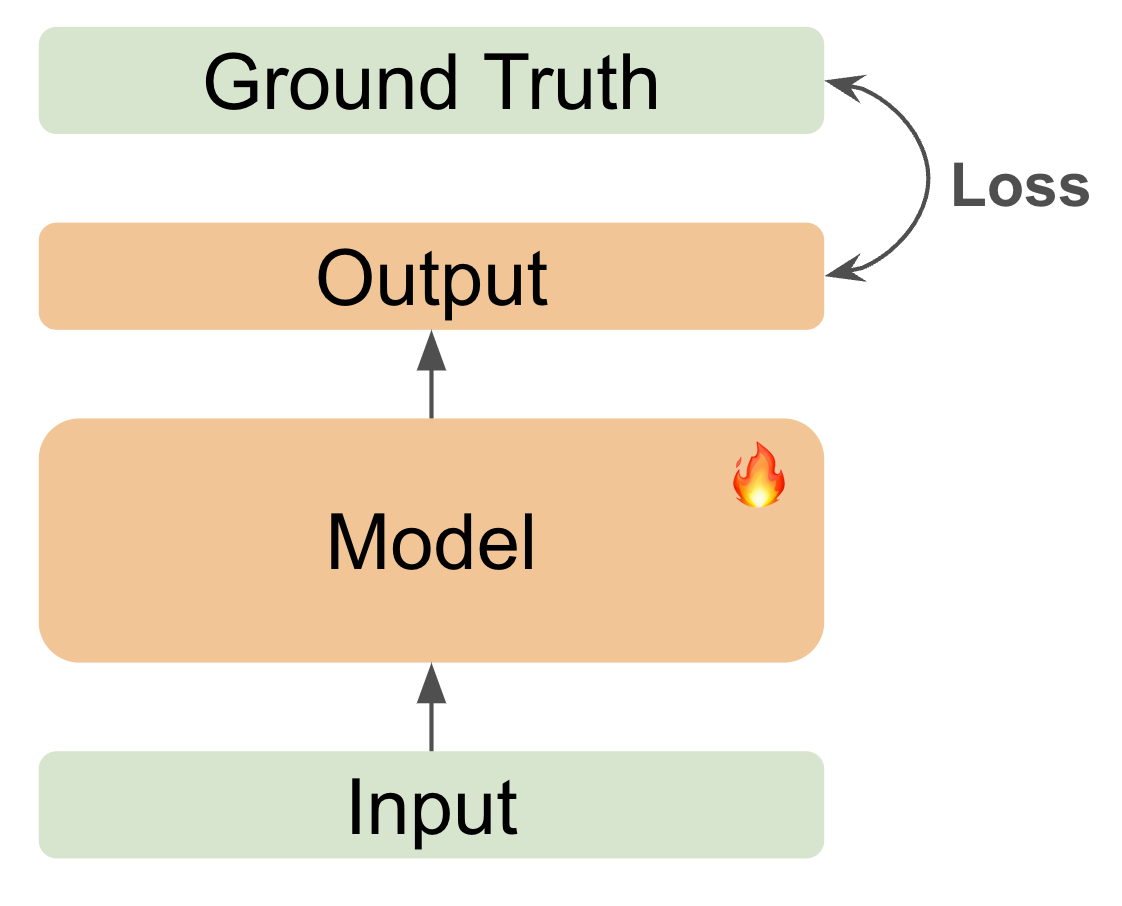
3단계에서는 다양한 형태의 VQA 데이터를 모델에 학습시키는 단계입니다. 이 과정을 통해 모델은 주어진 이미지와 질문을 함께 이해하고, 그에 대한 알맞는 답변을 텍스트로 생성하는 능력을 갖추게 됩니다. 일반적으로 이러한 단계에서는 정답에 해당되는 텍스트를 생성하도록 학습시키는 SFT(Supervised Fine-Tuning) 방식을 주로 사용합니다.
하지만 저희가 개발한 Kanana-v-3b 모델은 파라미터 숫자가 적은 경량 모델로, SFT만으로 성능을 최고 수준으로 끌어올리기에는 한계가 있었습니다. 이러한 한계를 극복하기 위해 저희는 3단계에서 지식 증류(Knowledge Distillation) 학습 방법론을 적용하였습니다.
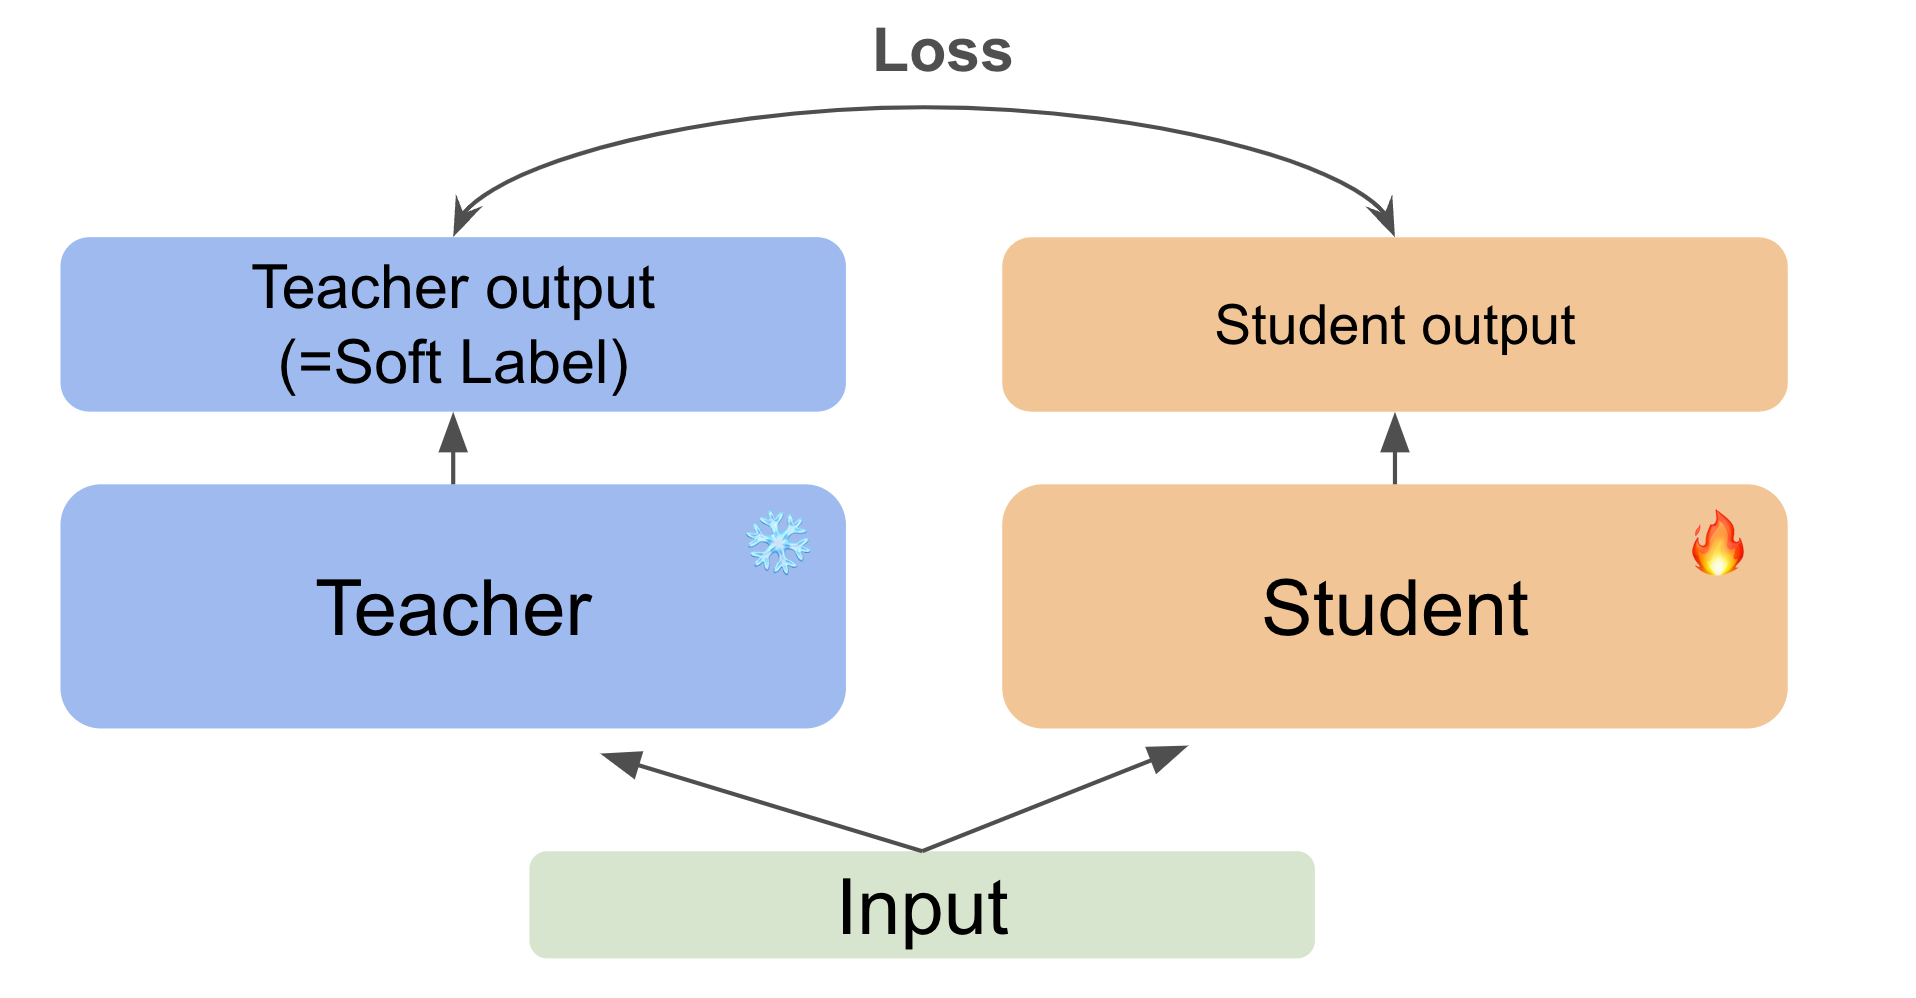
지식 증류(Knowledge Distillation)는 성능이 우수하고 큰 교사(Teacher) 모델의 지식을 상대적으로 작고 효율적인 학생(Student) 모델로 전달하여 학생(Student) 모델의 성능을 향상시키는 학습 방법으로, 비전문가가 전문가의 문제 해결 과정을 보며 따라 배워나가는것과 유사합니다.
구체적인 학습 과정은 다음과 같습니다. 먼저 교사(Teacher) 모델이 주어진 입력에 대한 정답의 확률 분포를 생성합니다. 이렇게 생성된 확률 분포는 학생(Student)이 학습하는 소프트 레이블(Soft Label)로, 학생(Student)은 동일한 입력에 대해 교사(Teacher)의 확률 분포를 최대한 유사하게 모방하도록 학습이 됩니다. 학습 과정에서 교사(Teacher)의 파라미터는 업데이트하지 않고, 학생(Student)의 파라미터들만 업데이트해줍니다 [표 9].
 |  |
|---|---|
| SFT 학습 방법론 | 지식 증류(Knowledge Distillation) 학습 방법론 |
표 9. SFT 학습 방법론과 지식 증류(Knowledge Distillation) 학습 방법론의 비교
이러한 지식 증류(Knowledge Distillation) 학습 방법론은 경량 모델의 성능을 높이기 위해 주로 사용되는 방법론으로, 최근에는 멀티모달 언어모델 학습과정에도 적용하여 성능을 향상시킨 연구[7]도 있습니다.
저희도 Kanana-v-3b의 성능을 향상시키기위해 더 크고, 성능이 뛰어난 ‘Kanana-1.5-v-9.8b-instruct’를 교사(Teacher)로 사용하여 지식 증류(Knowledge Distillation)를 적용 했습니다.
그렇다면 교사(Teacher)를 활용한 지식 증류(Knowledge Distillation)가 얼마나 효과가 있었을까요? 이를 검증하기 위하여 동일한 학습 데이터셋을 바탕으로 3단계에서 SFT를 적용한 모델과 지식 증류(Knowledge Distillation)를 적용한 모델의 성능을 비교하였습니다. 지식 증류(Knowledge Distillation)를 적용하여 학습한 모델이 대부분의 영어, 한국어 벤치마크에서 유의미한 성능 향상을 달성하여, 그 효과를 증명하였습니다.
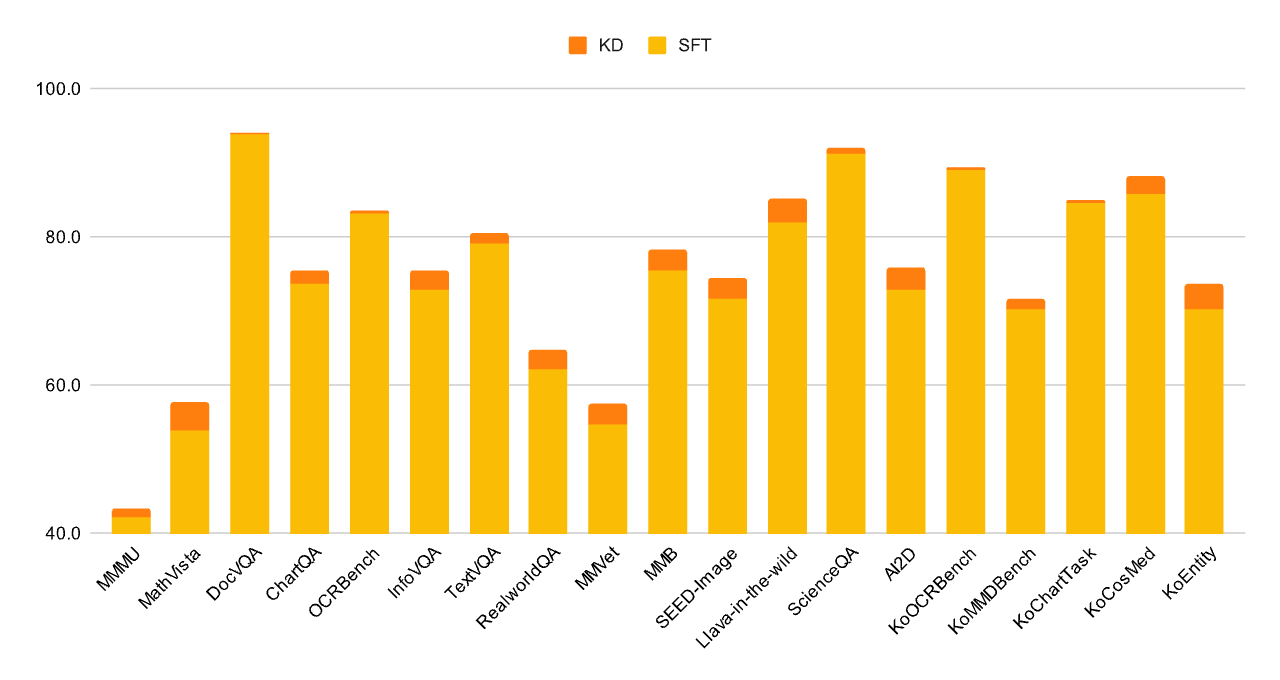
이번 실험을 통하여, 지식 증류(Knowledge Distillation)는 경량 모델의 성능을 한 단계 끌어올리는 확실한 방법임을 확인하였습니다. 이러한 결과는 Kanana-v-3b가 효율적이면서 강력한 성능을 갖춘 모델로 성장하는 데 핵심적인 발판이 되었습니다.
멀티모달 지시 이행 & 인간 선호 정렬 학습
모델의 성능을 끌어올리기 위해서는 단순히 많은 데이터를 사용하는 것 이상으로, 데이터의 품질이 핵심적인 요소로 작용합니다. 일반적으로 고품질 학습 데이터는 (1)다양성(Diversity)과 (2)정확성(Accuracy)의 두 가지 축에서 그 품질을 평가할 수 있습니다.
다양성은 모델이 다양한 상황과 지시(Instruction)를 학습할 수 있도록 하는 기반으로, 입력 형태, 주제, 도메인, 표현 방식에서 폭넓은 스펙트럼을 포함해야 합니다. 정확성은 각 샘플이 노이즈 없이 정확하게 라벨링 되어 있고, 멀티모달 간의 정합성이 유지되는지를 의미합니다.
영어 데이터의 경우, 다양한 고품질 소스가 공개되어 있을 뿐 아니라 수집 경로도 비교적 풍부하여 다양성과 정확성 모두를 확보하기 용이합니다. 반면, 한국어의 경우 공개된 멀티모달 데이터가 매우 제한적이며, 확보 가능한 데이터는 양뿐 아니라 품질 측면에서도 한계가 존재합니다. 영어에 비해 한국어에서는 이미지-텍스트의 멀티모달 데이터셋들에 포함된 작업이 다양하지 않고, 동시에 이미지-질문-답변의 정확성 역시 영어에 비해서 낮은 경우가 많습니다.
이러한 배경에서 한국어로 구성된 학습 데이터의 사용 전략은 단계별로 상이하게 설계되었습니다. 3단계에서는 모델에게 최대한 다양한 작업 유형(Task)을 학습시키는 것을 목표로 하여, 데이터의 양을 최우선적으로 확보하고, 제한된 다양성 내에서 가능한 한 폭넓은 지시 패턴(Instruction Pattern)을 포함하는 대규모 학습을 진행하였습니다. 이후 4단계에서는 양보다는 질 중심의 소량 고품질 한국어 데이터를 추가적으로 학습시켜, 한국어 환경에서의 실제 사용성과 언어 적응 능력을 향상시키는 방향으로 학습 전략을 수립하였습니다.
Kanana-v-3b의 높은 성능을 달성하기 위해서 한국어 데이터의 다양성을 추구한 KoMIF(Korean Multimodal Instruction Following) 데이터셋과, 한국어 OCR과 Visual QA 데이터셋을 사람이 전수 검수하여 수정한 KoText-HQ(Korean Text High Quality) 데이터셋을 구축하였습니다.
한국어 멀티모달 지시 이행 능력 성능 향상을 위한 KoMIF 데이터셋 구축
3단계까지 학습된 Kanana-v-3b는 다양한 태스크(Task)의 많은 샘플을 통해 이미 이미지 내 다양한 정보를 이해할 수 있는 능력을 보유하고 있습니다, 또한 LLM으로 사용하고 있는 Kanana-1.5-3b는 Kanana-v를 학습하기 이전에 이미 복잡한 한국어 지시를 이해하고, 응답할 수 있는 능력을 지니고 있습니다.
그럼에도 불구하고 3단계까지 학습된 Kanana-v-3b에서 한국어 지시를 무시하고, 입력된 이미지 정보만 사용하여 답변을 생성하는 현상이 종종 발생하는 것을 확인했습니다.
아래의 예시 [표 10]는 한국어 차트 이미지와, “사진 속 차트를 생성하는 Python 코드를 알려줘”라는 프롬프트를 입력하였을 때 3단계 모델은 Python 코드를 생성하지 않고, 차트에 담긴 정보를 서술하는 응답을 출력합니다.
| 모델 입력(이미지/지시) |
|---|
이미지: 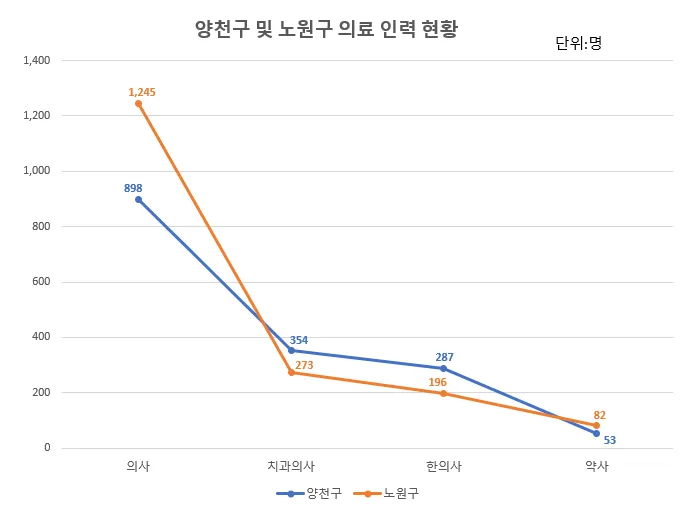 [출처: AIHUB] 지시: 사진 속 차트를 생성하는 Python 코드를 알려줘. |
| 모델 응답 |
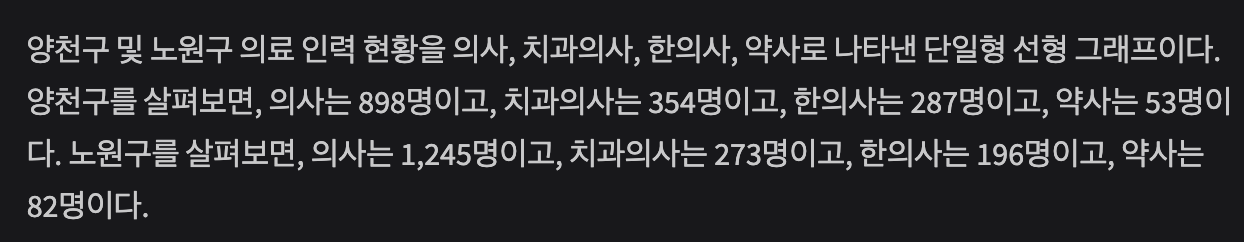 |
표 10. 한국어 지시(Instruction)를 잘 이해하지 못하고, 잘못된 답변을 생성하는 3단계 모델의 답변 예시.
3단계에서, 저희는 다양한 소스로부터 수집된 데이터로 모델을 학습시켰다고 생각했지만, 한국형, 한국어 데이터의 다양성은 여전히 부족했습니다. 그 결과 [표 10]의 예시처럼 "이미지를 보고 코드를 생성하라"라는 유저의 지시에 제대로 응답하지 못했던 것이죠.
실제로 데이터를 좀 더 면밀히 분석해 보았고, 3단계 학습 데이터셋에 있는 대다수의 그래프 유형 한국어 데이터가 단순 묘사 문제만을 다루고 있던 것을 확인할 수 있었습니다. 그렇기 때문에 모델이 유저의 지시에 반응하지 않고 이미지의 유형만 보고 반응하는 편향(Bias)를 보였다고 생각했습니다.
이러한 문제를 해결하기 위해서 한국어를 대상으로, KoMIF(Korean Multimodal Instruction Following)라고 명명된 다양성을 추구한 고품질의 학습 데이터를 구축하였습니다.
KoMIF는 이미지-질문-답변으로 구성되어 있으며, 이때 질문과 답변에서 복잡한 한국어 질문을 정확히 이해해야, 올바른 답변을 할 수 있다는 다른 데이터와 구분되는 중요한 특징을 강조하여 제작되었습니다.
복잡한 한국어 질문의 예시로는, “특정 단어를 언급하지 않고 묘사하라”, “이미지 내 물체를 의인화하여 대본을 작성하라”, “차트를 보고 세 개의 인사이트를 발굴하라” 등이 있으며, 동일한 이미지에 대해서도 이미지 내의 정보를 정리하는 질문, 정답이 없지만, 창의적인 응답을 요구하는 문제 등 다양한 질문을 구성하여, 응답을 생성하는 과정에서 지시(Instruction) 정보의 의존도를 강화할 수 있도록 구성되었습니다.
KoMIF 데이터의 구축 과정은 다음과 같습니다.
- 스텝 1: 대상 이미지 선정. 한국어 질문과 답변을 대상으로 하기에, 한국 문화와 지식을 포함할 수 있는 대상 이미지 풀을 선정합니다.
- 스텝 2: 질문과 평가기준 생성. 각각의 이미지로부터 다양한 종류의 질문을 생성합니다. 질문은 단순한 이미지 묘사부터, 창의적인 답변을 요구하는 질문까지 최대한 다양성을 확보합니다. 질문과 동시에 답변이 질문의 지시를 잘 따르는지 판단할 수 있는 평가 기준도 동시에 생성합니다.
- 스텝 3: 답변 생성. 이미지와 생성된 질문으로부터 답변을 생성합니다.
- 스텝 4: 데이터 정제. 생성된 답변을 스텝 2에서 생성한 평가 기준을 토대로 평가합니다. 평가 기준을 통과하지 못한 데이터는 버려집니다.
주목할 만한 점은 4단계에서 구축된 KoMIF 학습 데이터를 학습한 모델은 KoMIF 학습 데이터에 Python 코드와 관련된 질문이 없는 데에도 불구하고, 위 동일한 예시에 대해서 유저의 지시에 정확하게 반응하여 주어진 차트를 생성하는 Python 코드를 생성했다는 점입니다. [표 11]. 즉, 질문의 다양성을 높임으로써 모델이 유저의 지시에 좀 더 주의를 기울이도록 학습시킬 수 있었고, 이렇게 학습된 모델은 보지 못했던 조합의 입력에 대해서도 기존에 학습했던 LLM의 지식을 활용하여 정확하게 응답할 수 있게 되었습니다.
| 모델 입력(이미지/지시) |
|---|
이미지: 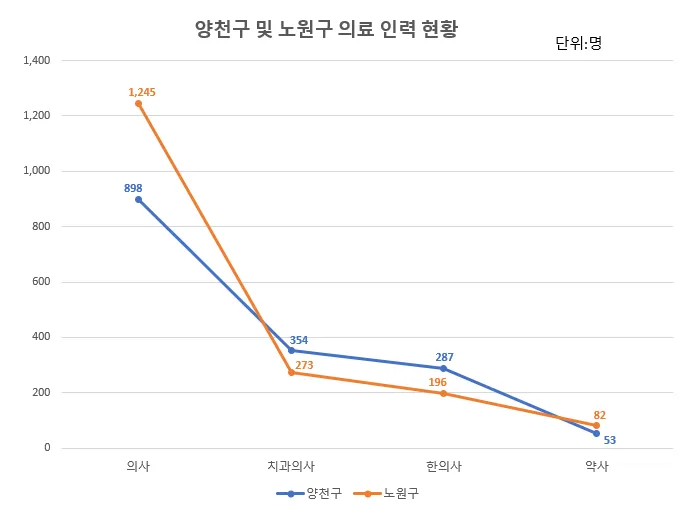 [출처: AIHUB] 지시: 사진 속 차트를 생성하는 Python 코드를 알려줘. |
| 모델 응답 |
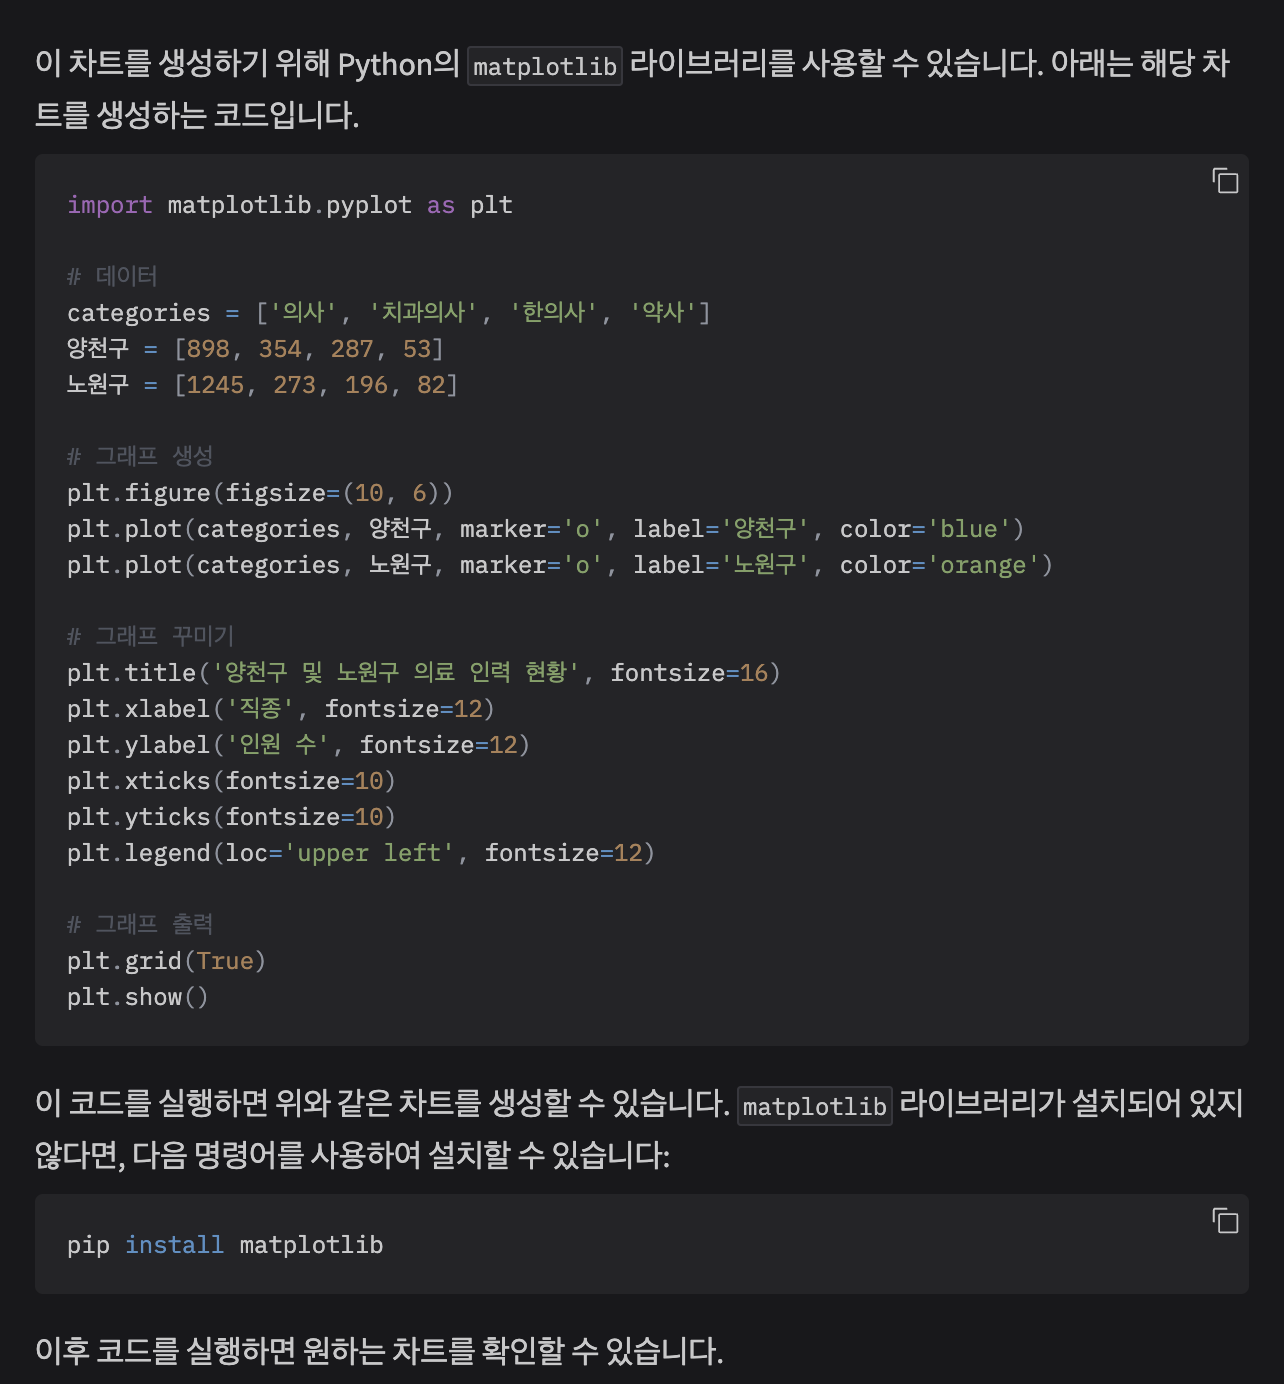 |
표 11. KoMIF 데이터를 학습한 뒤 동일한 입력에 대해서 올바른 답변을 생성하는 4단계 모델.
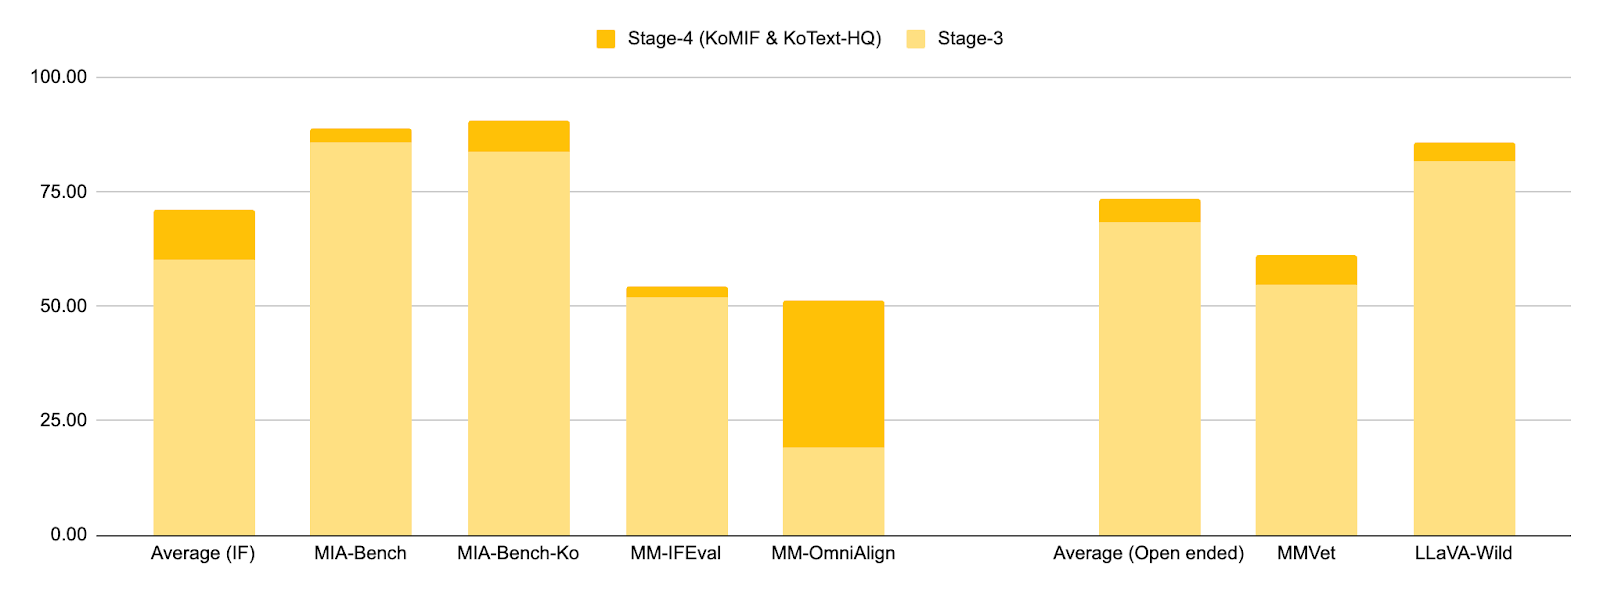
지시 이행(Instruction Following) 성능을 정량적으로 측정하는 벤치마크에서도, MIA-Bench, MIA-Bench-Ko, MM-IFEval, MM-OmniAlign의 모든 점수가 향상되는 것을 확인할 수 있었습니다. 또한 자유 응답형(Open Ended) 벤치마크에서도 성능이 향상됨을 확인할 수 있었습니다. KoMIF의 모든 데이터가 한글 질문과 답변으로 이루어져 있지만, 영어 지시 이행(Instruction Following) 성능을 측정하는 MIABench, MM-IFEval, MM-OmniAlign 벤치에서도 점수가 향상되는 점에서, KoMIF에서 목표로 한 답변 시 질문 의존도를 높히는 목표가 일반화되어 영어 지시 이행(Instruction Following) 능력도 향상되었다고 분석하고 있습니다.
보다 정확한 텍스트 이해를 위한 KoText-HQ 데이터셋 구축
4단계에는 멀티모달 지시 이행(Multimodal Instruction Following)뿐만 아니라, 소량의 한국어 고품질 데이터를 함께 학습하여 추가적인 성능 향상을 도모했습니다.
한국어 데이터의 정확성(Accuracy)를 향상시키기 위해서, 4단계에서 KoText-HQ로 명명된, 사람이 직접 검수한 소량의 고품질 데이터를 아래의 과정을 통해 구축했습니다.
- 스텝 1: 한국어 학습 데이터 풀에 대해서, 모델의 추론(Inference) 결과와 데이터셋 어노테이션(Annotation)이 크게 다른 샘플들을 선정합니다.
- 스텝 2: 선정한 학습 데이터에 대해서 사람이 직접 이미지, 질문, 답변의 오류를 수정합니다. 이렇게 구축된 KoText-HQ 데이터는 4단계에서 KoMIF 데이터와 함께 모델 학습 과정에서 사용되었습니다.
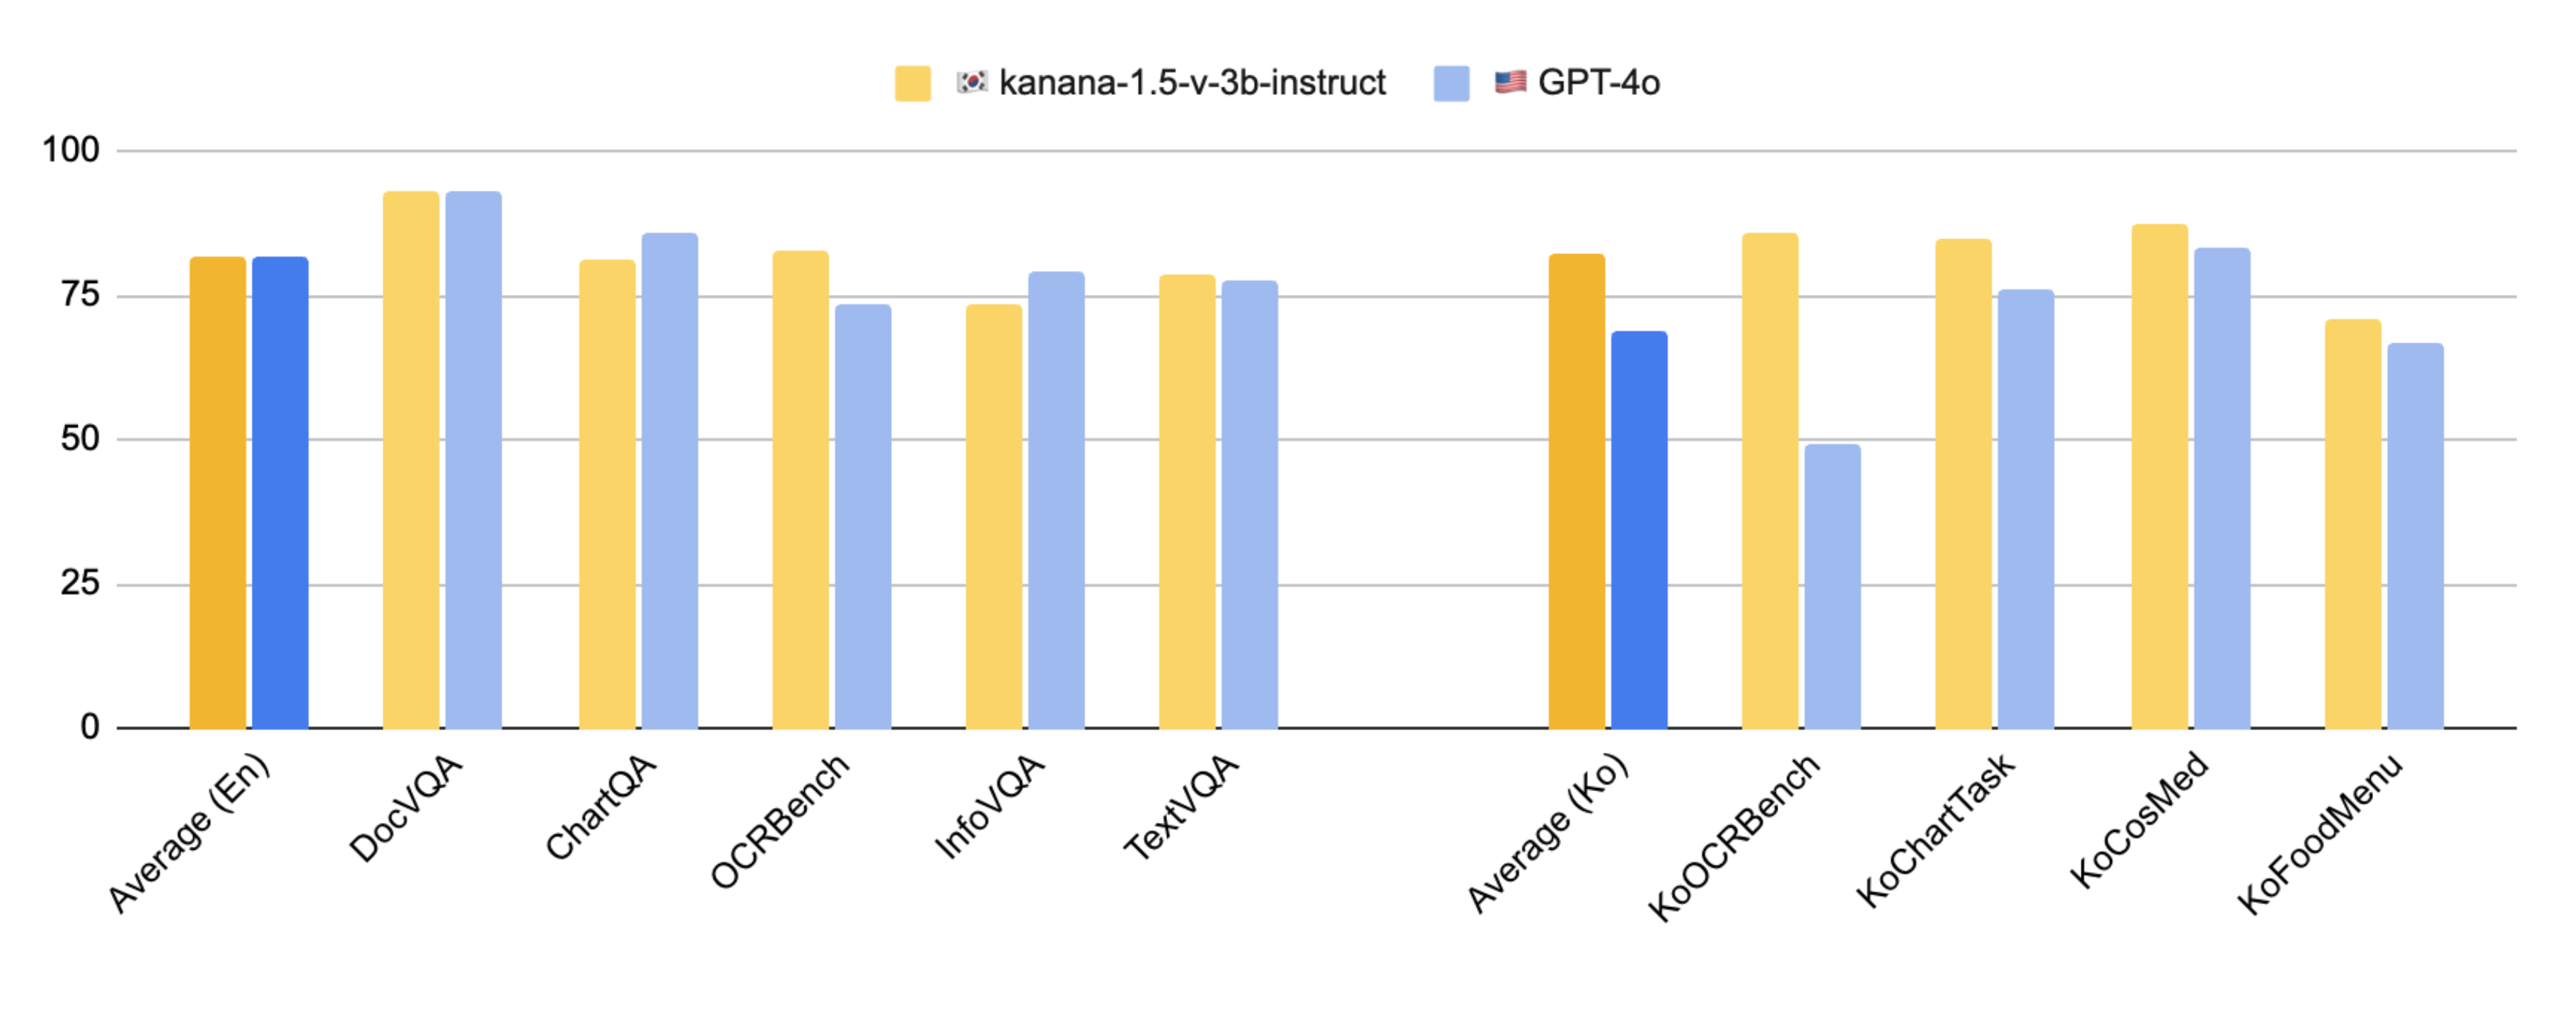
KoText-HQ 데이터셋으로 학습한 이후, 문서 이해 영역에서 성능이 크게 향상된 것을 확인할 수 있었습니다.
직접 선호 최적화를 통한 인간 선호 정렬 개선
4단계에서 KoMIF와 KoText-HQ를 학습한 모델은 응답의 정확도를 평가하는 여러 벤치마크에서 이미 경쟁력 있는 성능을 달성했습니다. 그러나 실제 사용자와의 상호작용에서는 단순한 정답뿐 아니라, 더 자연스럽고 설득력 있는 응답을 생성하는 능력 역시 중요합니다. 사용자에게 더 설득력 있는 응답을 제공하는 사용감 좋은 모델로 개선하기 위해, 4단계 이후 인간 선호 정렬(Human Preference Alignment) 단계를 추가로 수행하였습니다.
이 단계에서는 학습 리소스 효율이 높은 직접 선호 최적화(Direct Preference Optimization, DPO)[8] 을 적용하였으며, 단순히 사용자가 선호하는 응답을 모방하는 지도학습 파인튜닝(Supervised Fine-Tuning, SFT) 방식과 달리, 선호 응답과 비선호 응답 간의 상대적인 차이를 학습하여 모델이 사용자의 기대에 더욱 부합하는 답변을 생성할 수 있도록 유도하였습니다.
DPO를 적용하기 위해서는 같은 이미지-질문에 대해서 선호되는 응답(Chosen Response)와 비선호되는 응답(Rejected Response)를 정의하여 학습 데이터를 구축하여야 합니다. DPO 학습 데이터 구축을 위해서 KoMIF 학습 데이터 구축 방법을 확장하여, 선호 응답(Chosen)과 비선호 응답(Rejected Response) 쌍을 구축하였습니다.
이미지에 대해서 질문과, 답변을 평가할 수 있는 평가 기준을 같이 생성하는 과정까지는 동일하지만, 이후 답변을 KoMIF와 KoText-HQ를 학습한 모델로부터 복수 개의 다양한 응답을 생성하였습니다.
생성된 각각의 응답들은 평가 기준으로 평가되고, 더 선호되는 응답을 선호 응답(Chosen)으로, 비선호되는 응답을 비선호 응답(Rejected Response)으로 정의하였습니다. 평가 과정에서 둘 사이의 뚜렷한 선호도를 비교할 수 없는 응답들은 DPO 학습 데이터에서 배제되었습니다.
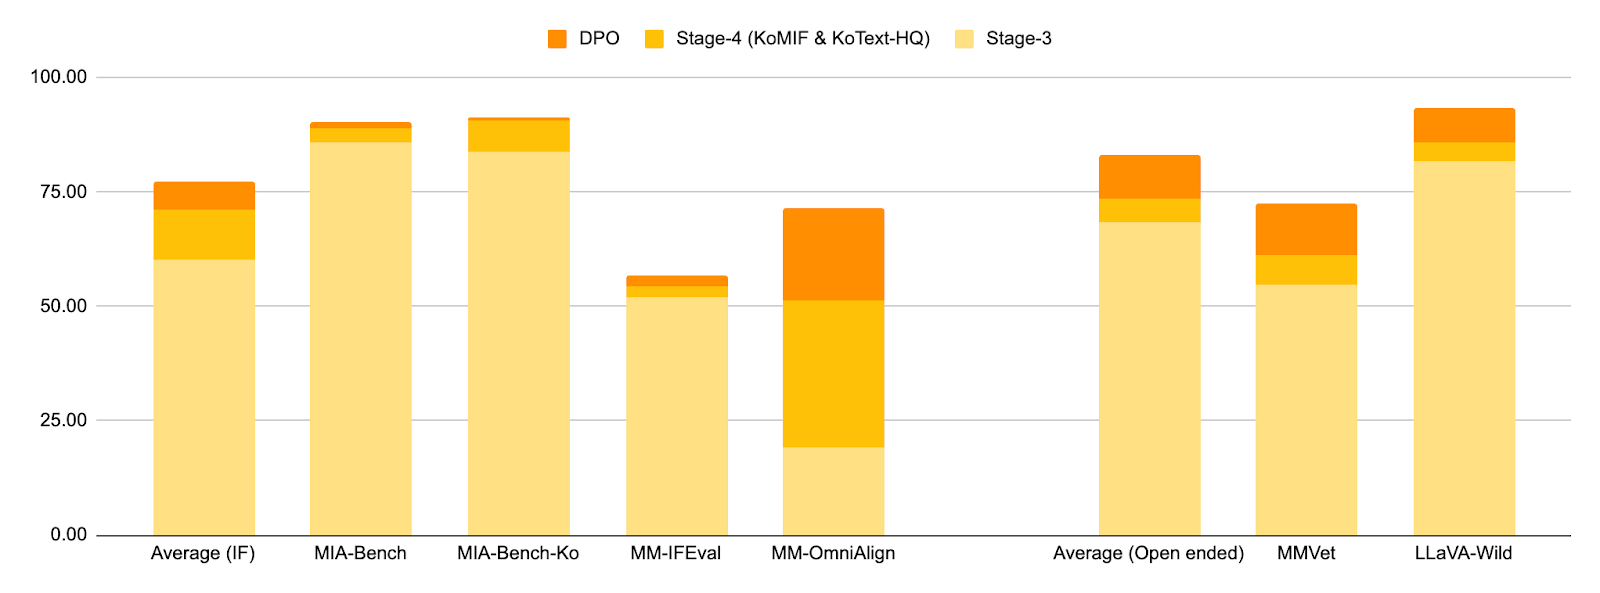
DPO 학습은 다양한 멀티모달 지시 이행(Multimodal Instruction Following)와 자유 응답형(Open Ended) 벤치마크 벤치마크에서 4단계 대비 추가적인 성능 향상 [그림 7]을 이끈 반면 다중선택형 벤치마크(Multiple Choice Benchmark)의 성능은 유지되었습니다. 이는 DPO 학습 과정이 추가적인 지식을 학습하여 답변의 정확도를 높이는 방향보다는, 선호 응답과 비선호 응답 사이의 차이를 학습하여, 사용자가 기대에 부합하는 답변을 생성하는 목표에 부합하는 결과입니다.
Kanana-v-3b의 기능과 사용 예시
앞서 소개드린 학습 과정들을 통해 Kanana-v-3b는 여러 주요 기능들을 갖추게 되었습니다. 지금부터 구체적인 예시와 함께 Kanana-v-3b의 핵심 기능 및 다양한 활용 가능성을 공유드리겠습니다.
뛰어난 지시 이행 능력
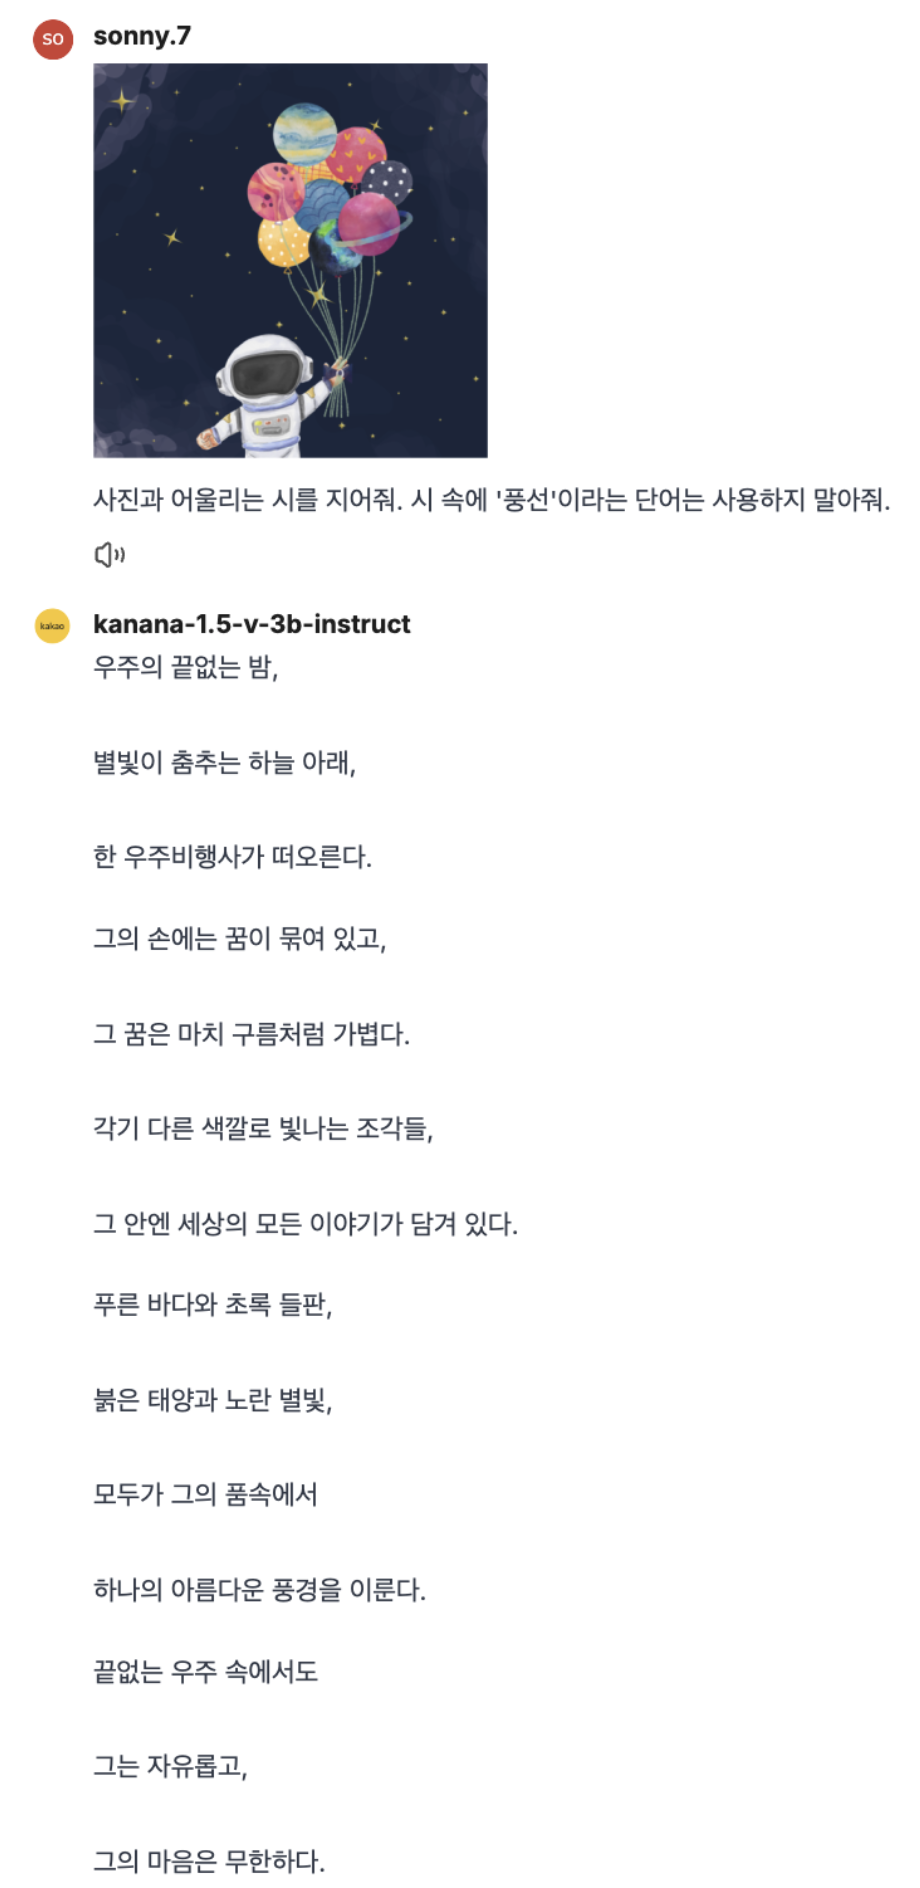
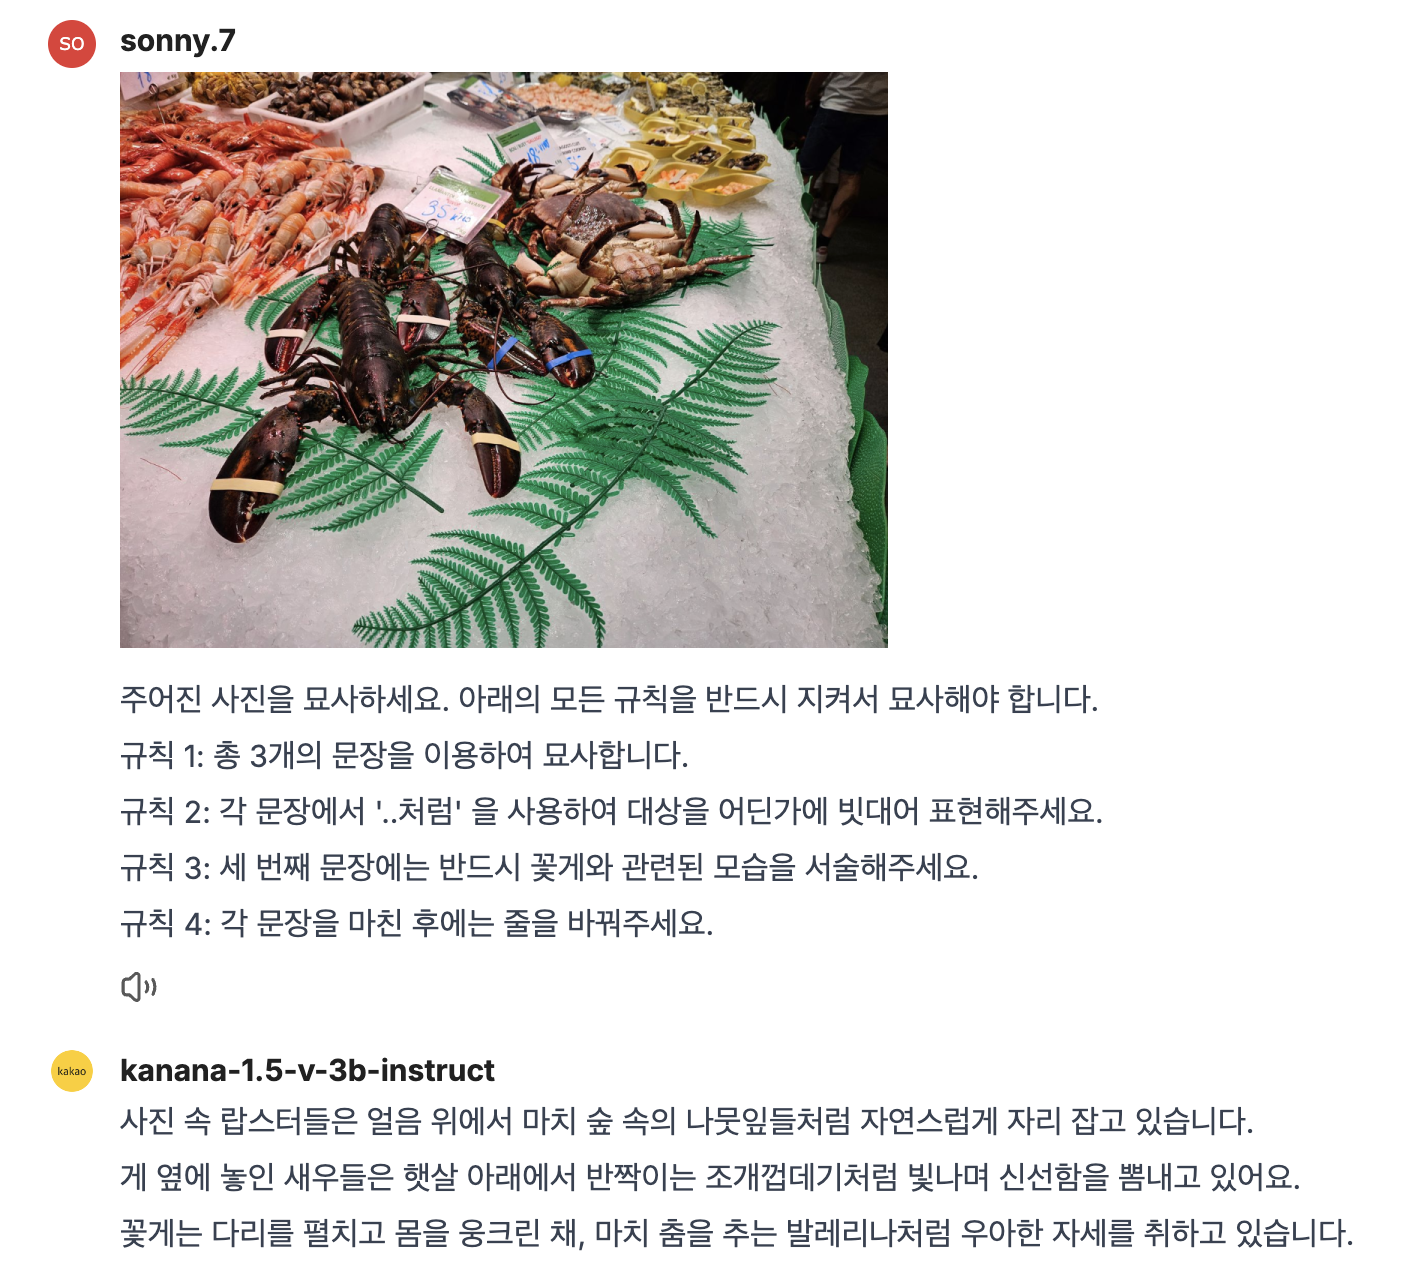
Kanana-v-3b는 사용자의 지시를 정확하게 이해하고, 그 의도에 맞는 답변을 생성하는 우수한 지시 이행(Instruction Following) 능력을 갖추고 있습니다. 즉, Kanana-v-3b는 복잡한 요구 사항에도 맥락과 사용자의 의도를 파악하여 응답을 만들어 낼 수 있습니다. 그 결과로 Kanana-v-3b는 다양한 사용 사례에 효과적으로 적용될 수 있는 모델로, 높은 활용 가능성을 보여줍니다. 주어진 예시들을 통해 Kanana-v-3b의 뛰어난 지시 이행(Instruction Following) 능력을 살펴보실 수 있습니다.
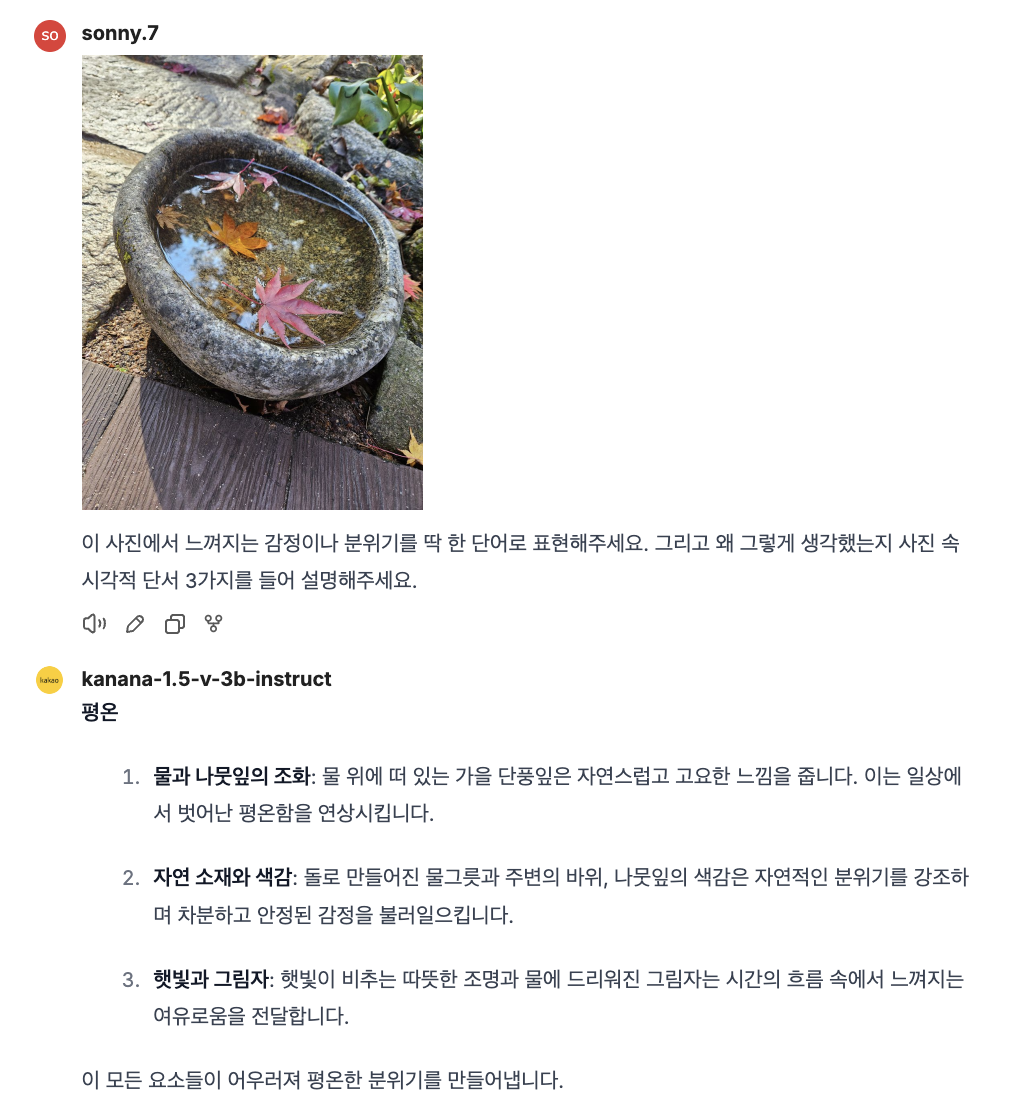
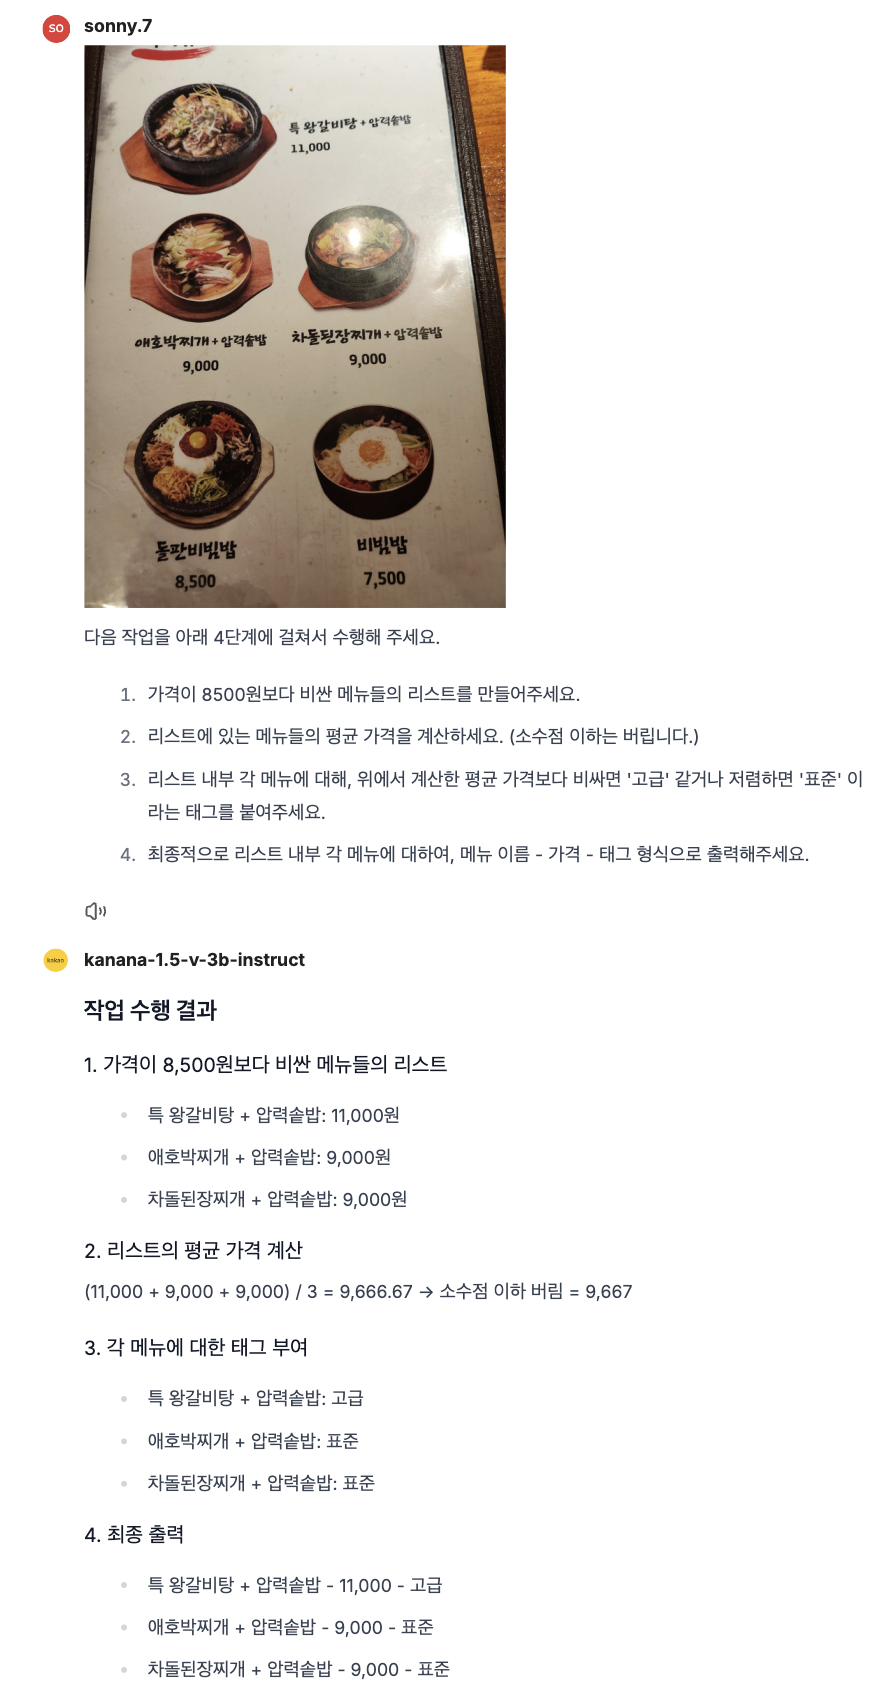
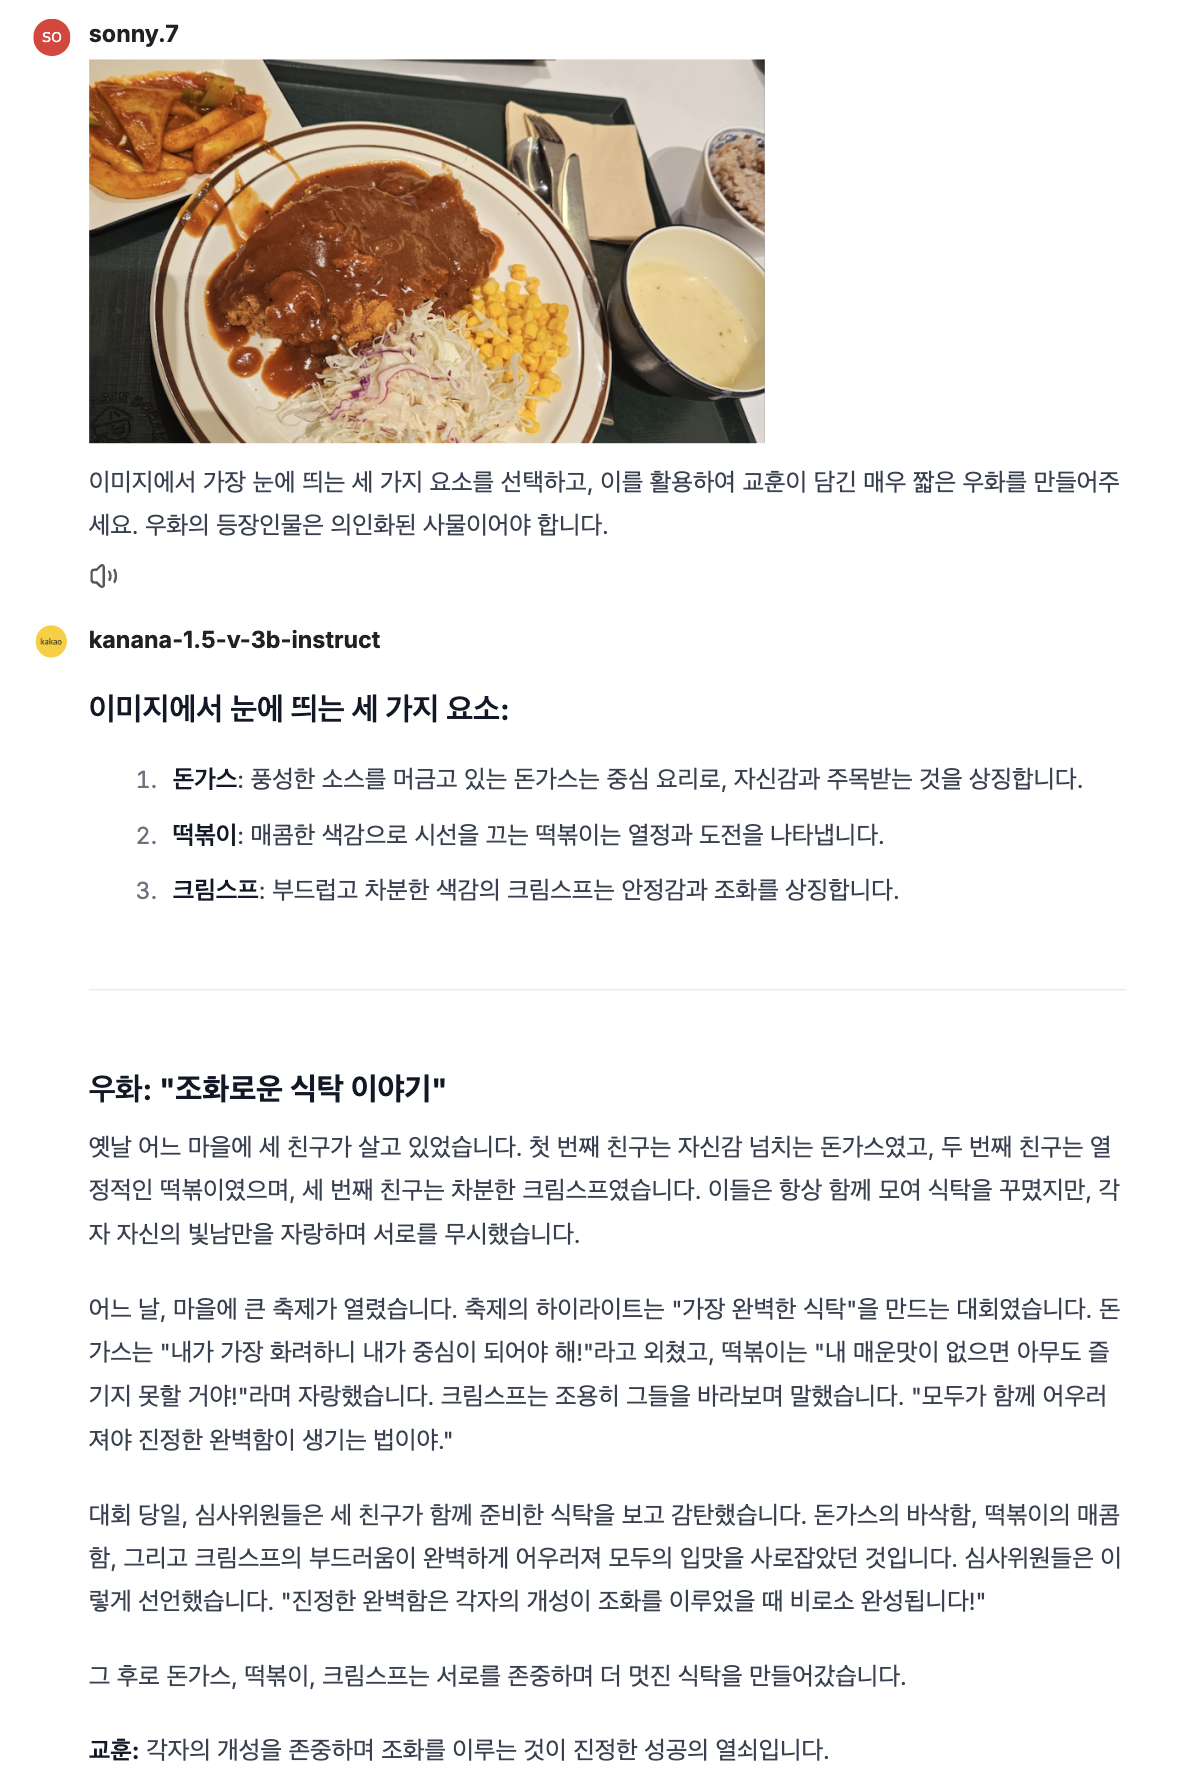
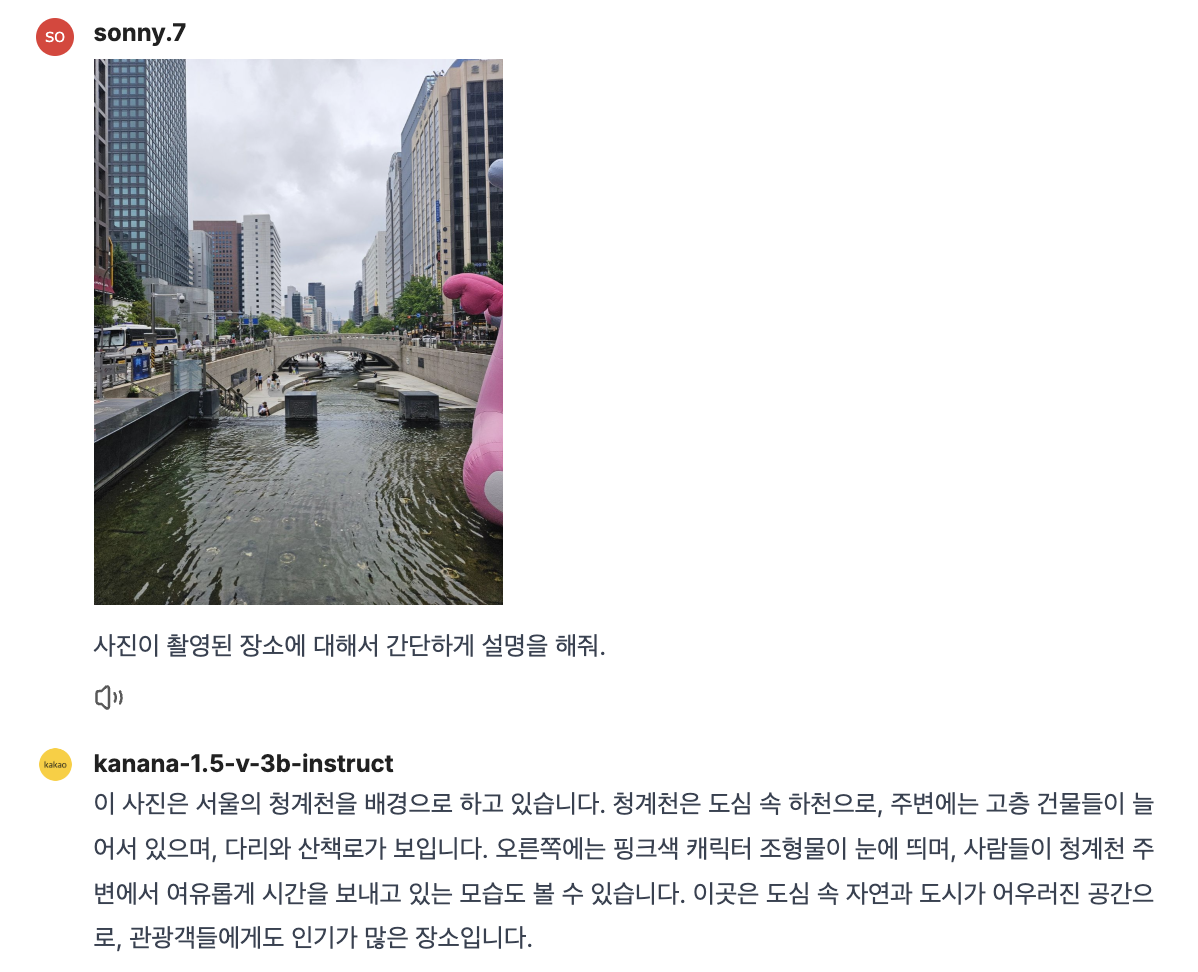
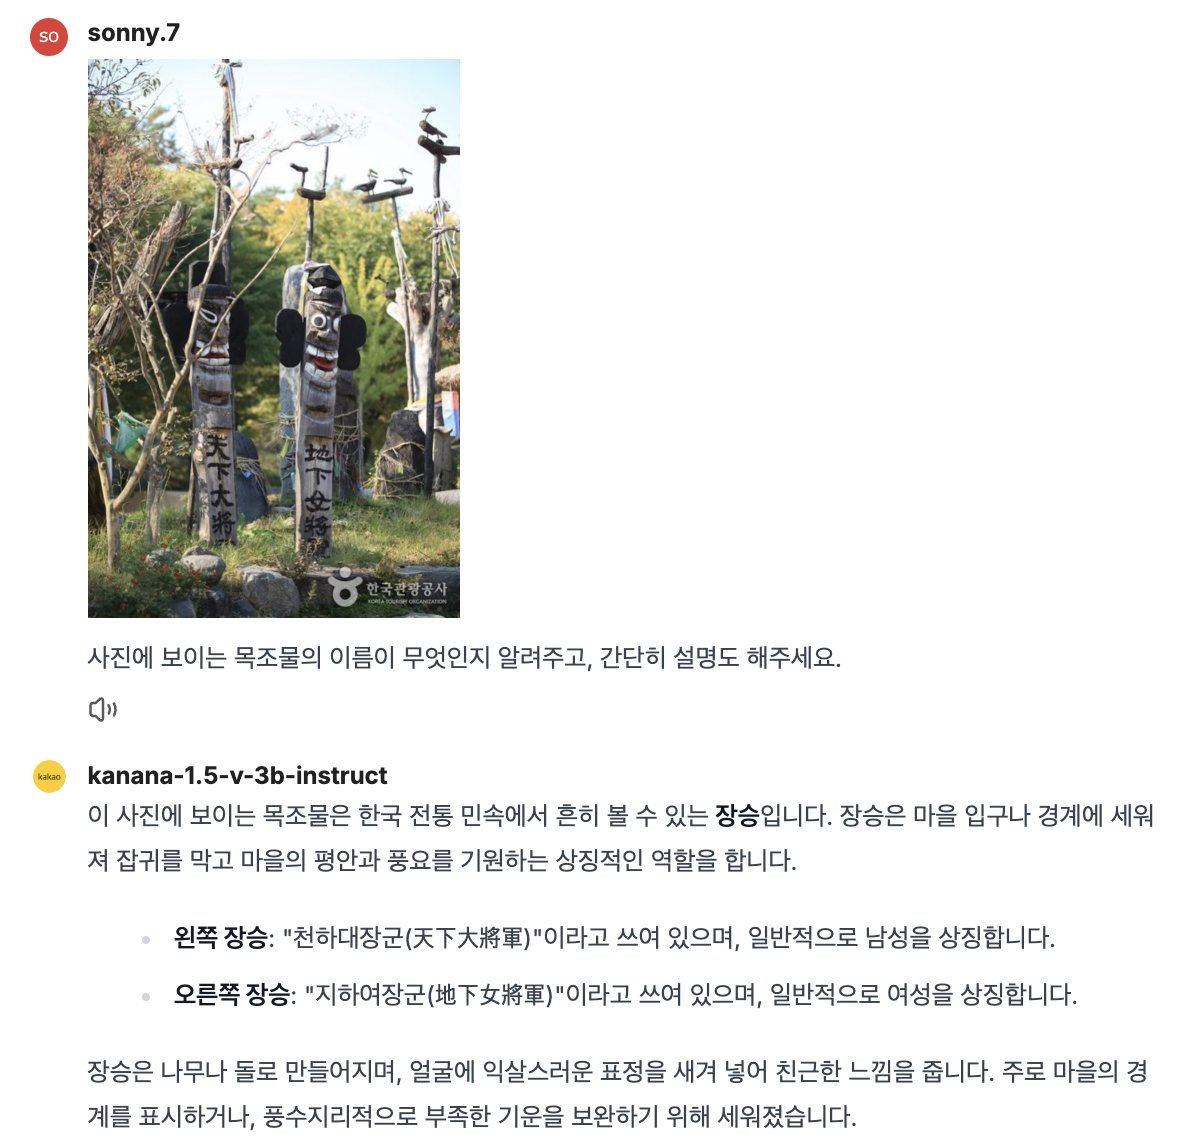
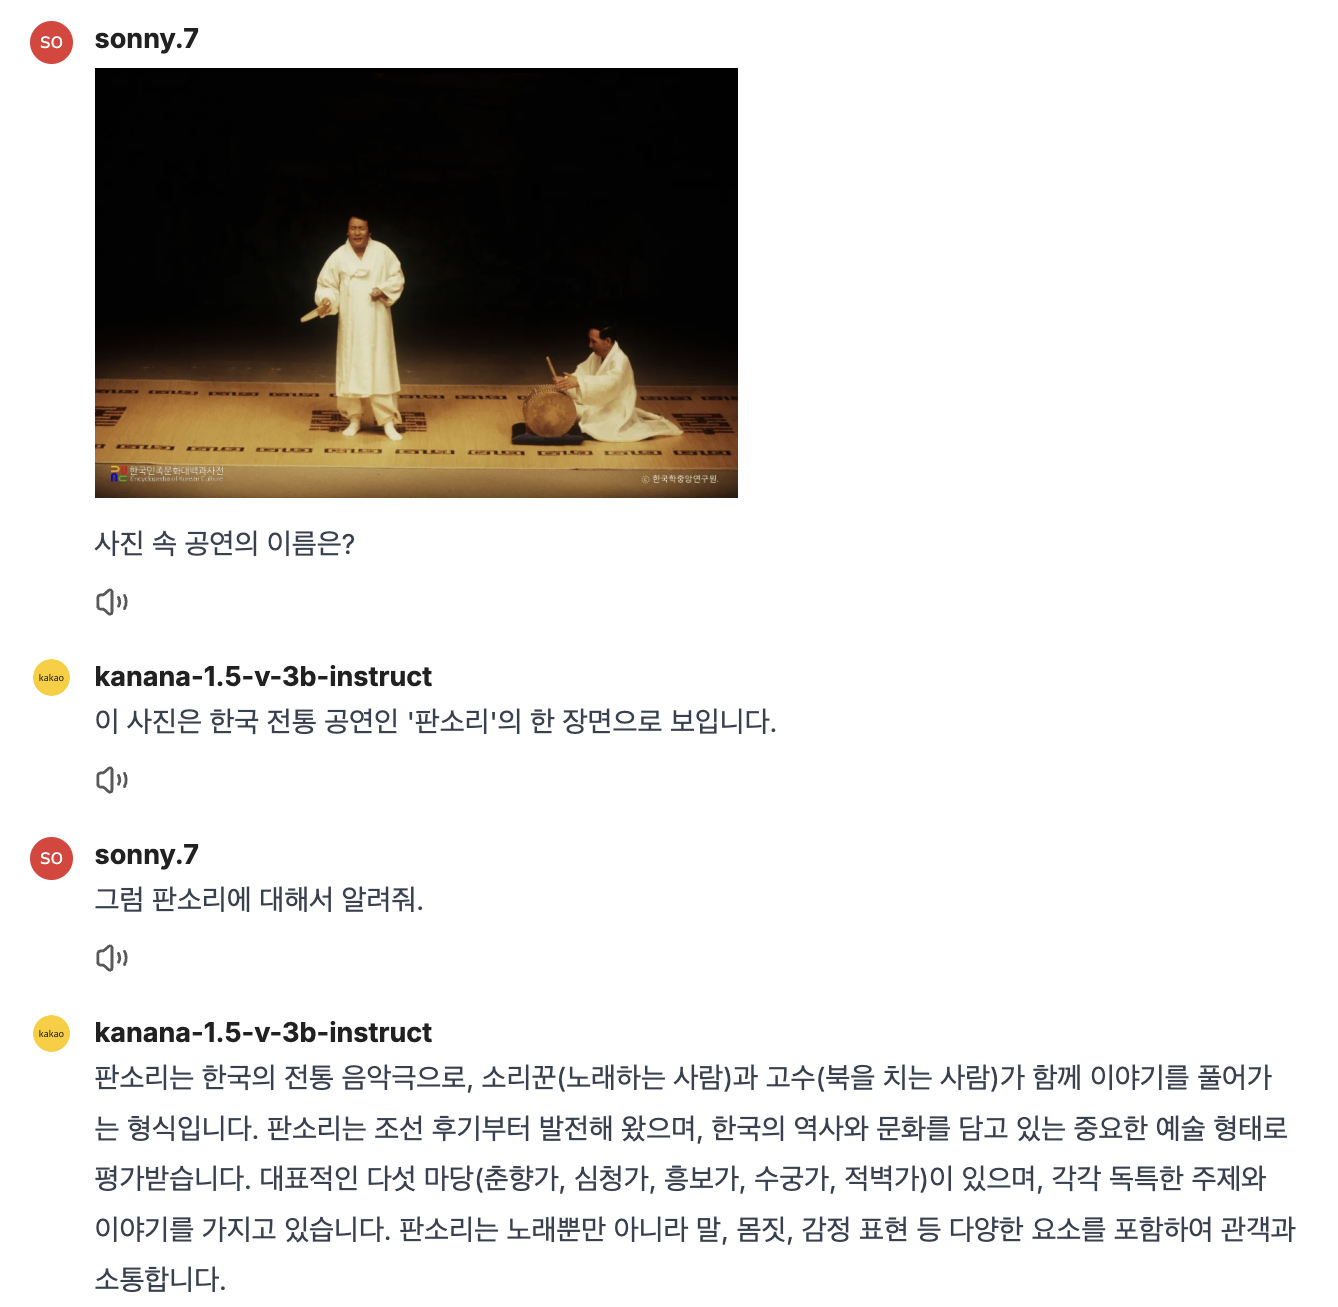
한국 문화에 대한 이해
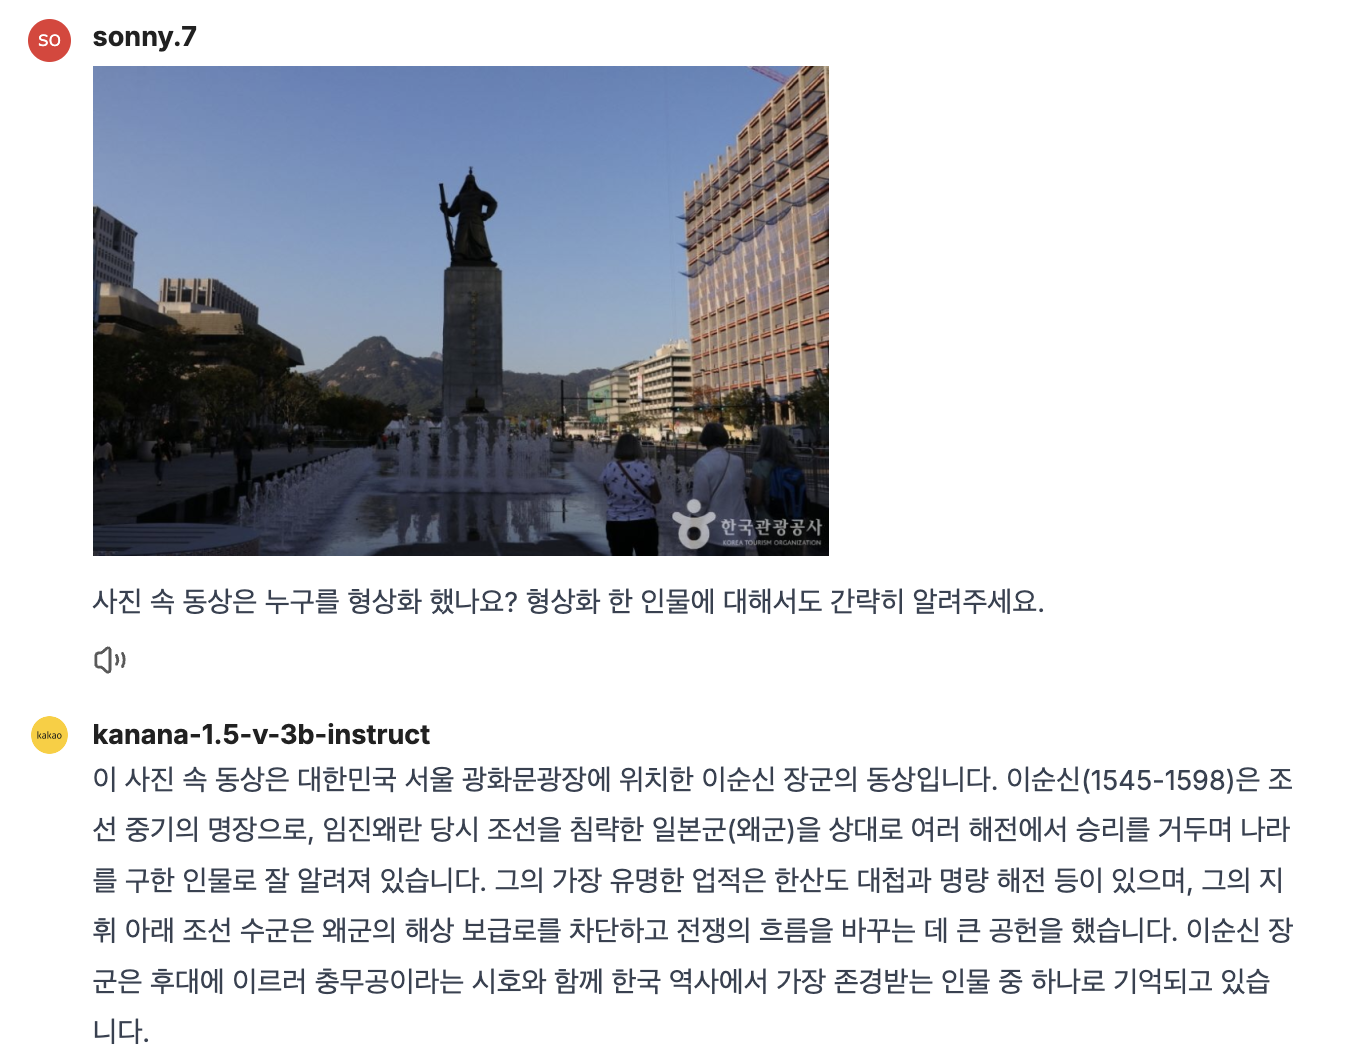
한국어 기반 서비스에서 멀티모달 언어모델을 효과적으로 활용하기 위해서는 한국 문화에 대한 이해가 필수적입니다. 문화적 맥락에 대한 이해가 있어야만 더욱 자연스럽고 맥락에 맞는 답변을 생성할 수 있기 때문이죠.
이에 저희는 Kanana-v-3b 모델이 한국 문화와 관련된 이해 능력을 갖추도록 개발했습니다. 그 결과, 아래 예시처럼 문화적 맥락을 이해하고 그에 맞는 답변을 제공하는 것이 가능해졌습니다.
이미지 속 텍스트 인식 능력
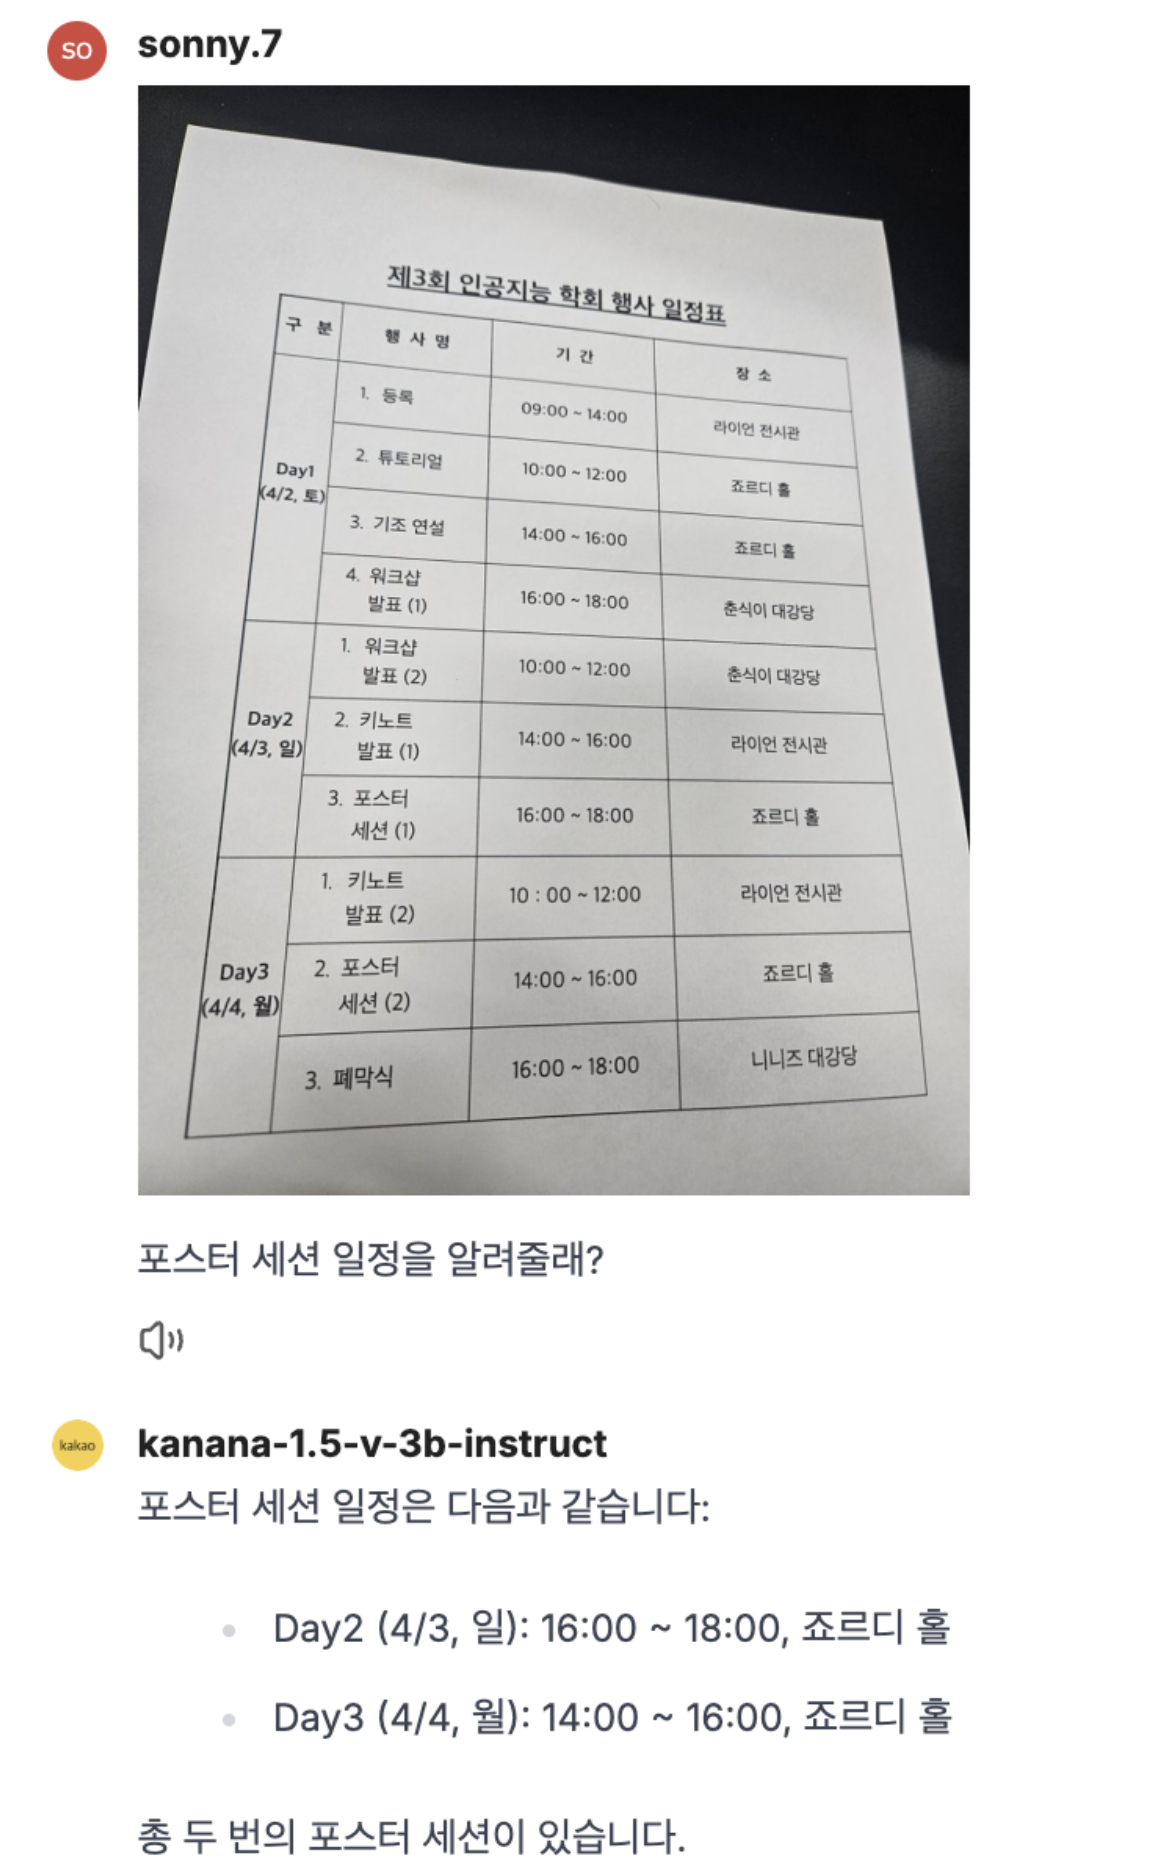
실생활에서 접하는 표지판, 메뉴판 등에는 중요한 문자 정보가 포함된 경우가 많습니다. 따라서 멀티모달 언어모델의 활용도를 높이기 위해서는 이미지 속 텍스트를 정확하게 인식하고 이해하는 능력이 매우 중요합니다. Kanana-v-3b는 이미지 속 주요 정보를 JSON 형태로 정리하여 출력하거나, 손 글씨로 작성된 내용까지 인식할 수 있습니다.
아래 예시를 통하여 Kanana-v-3b의 텍스트 인식 능력을 확인하실 수 있습니다.
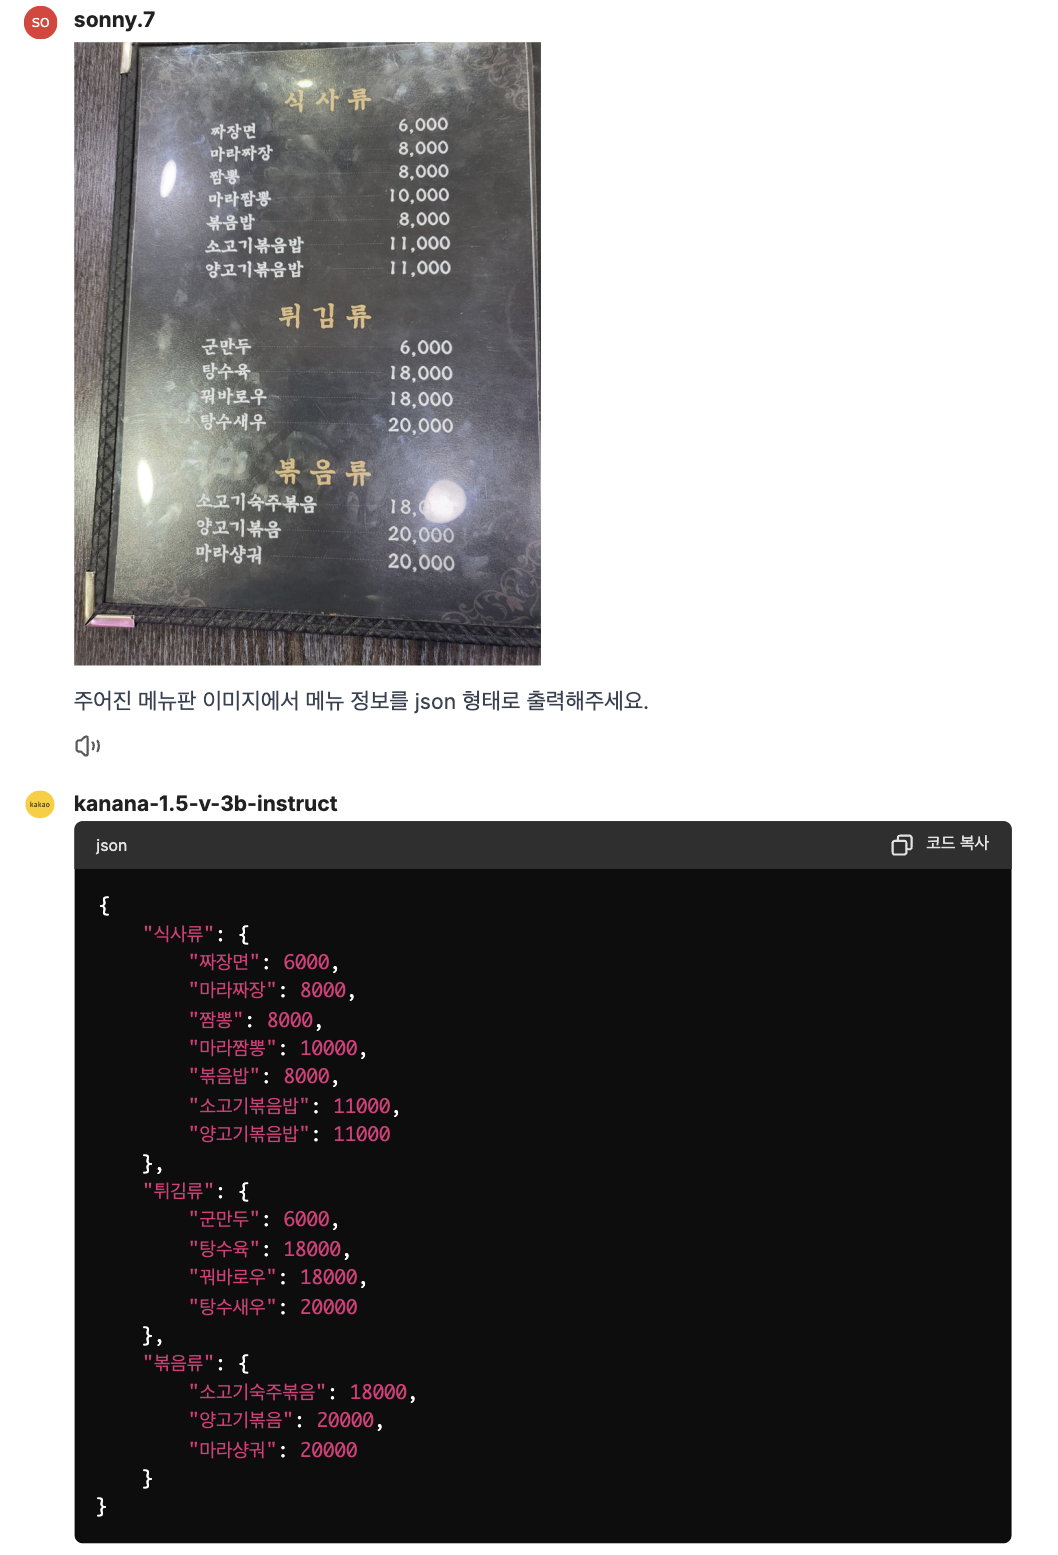
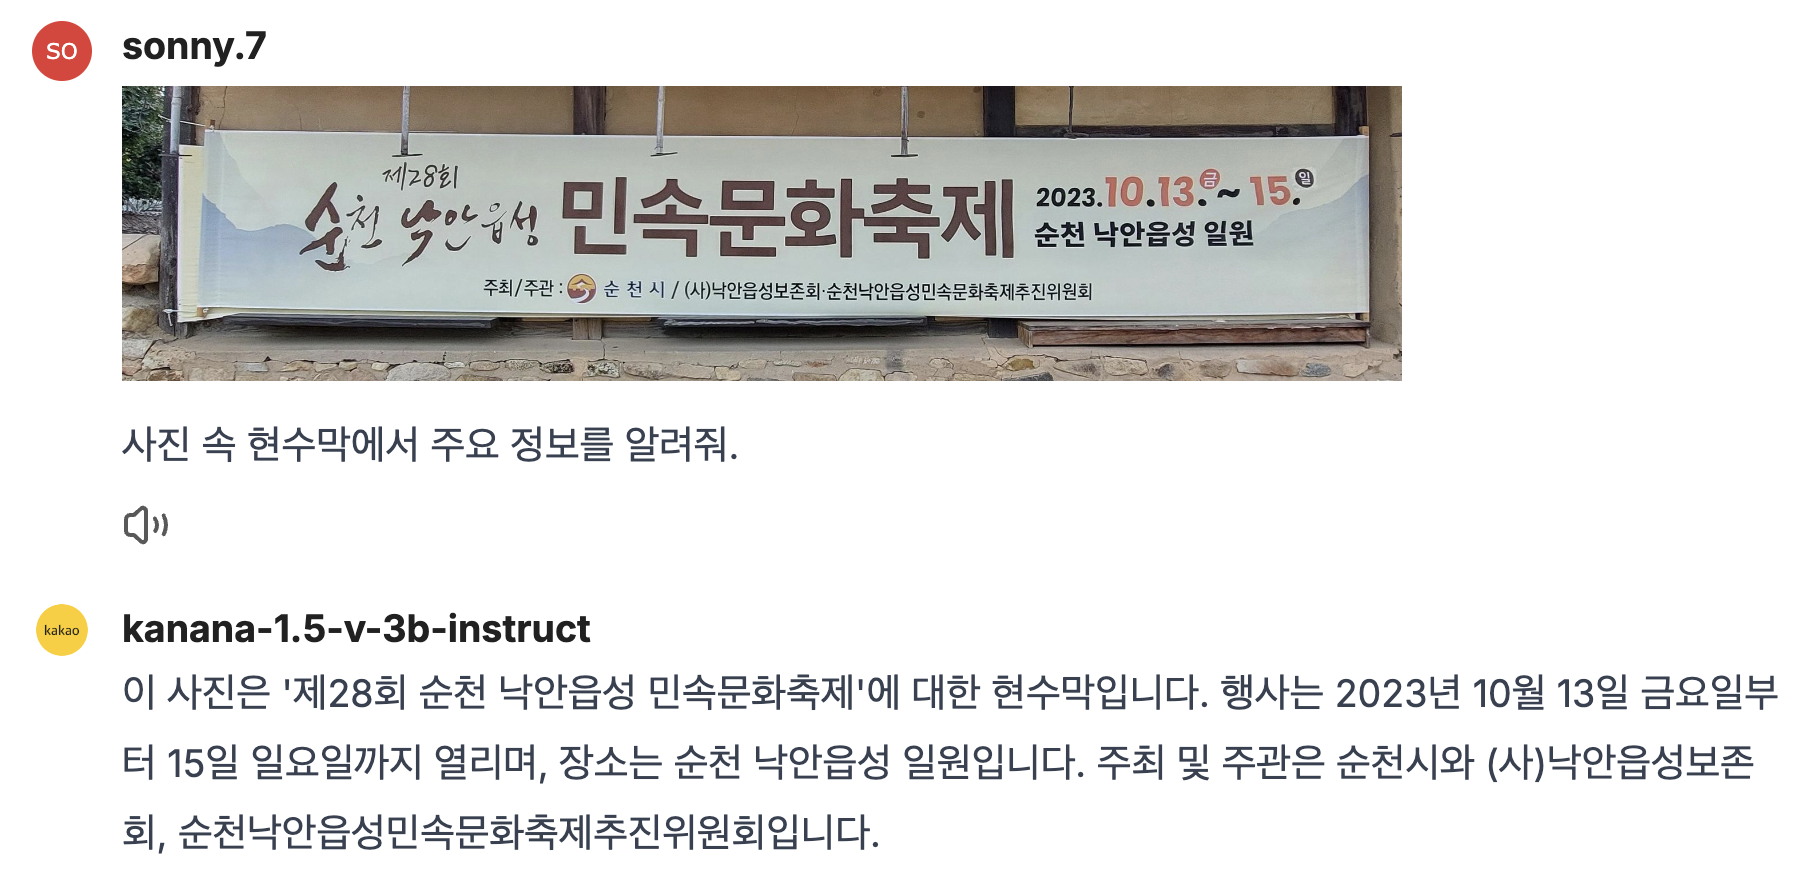
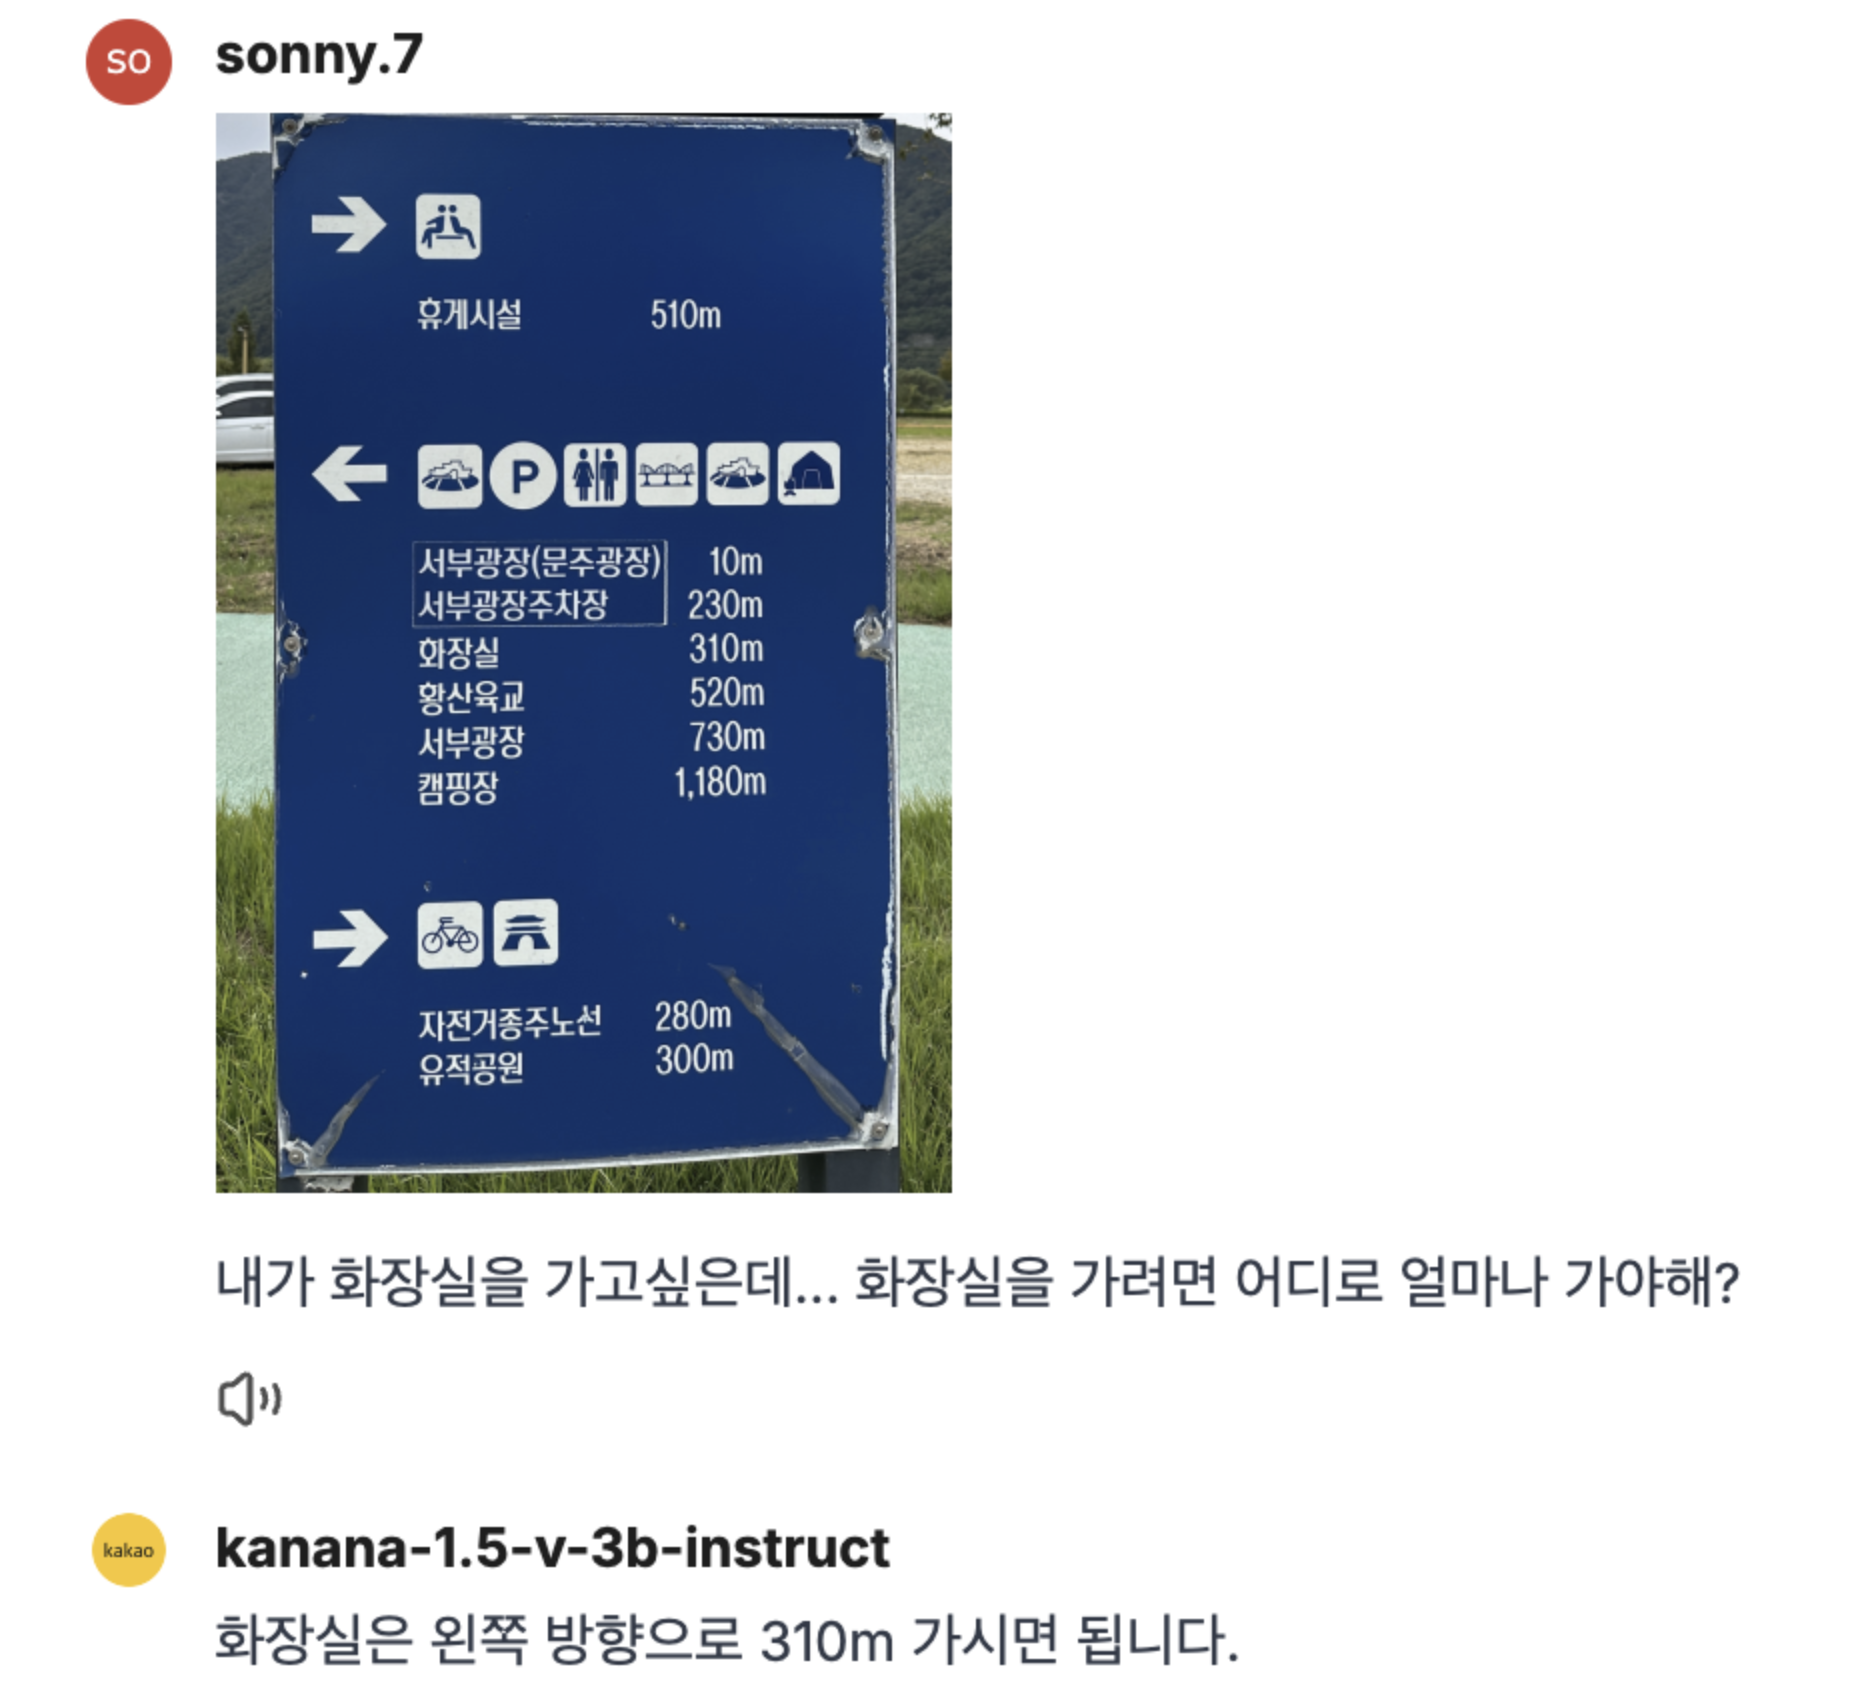
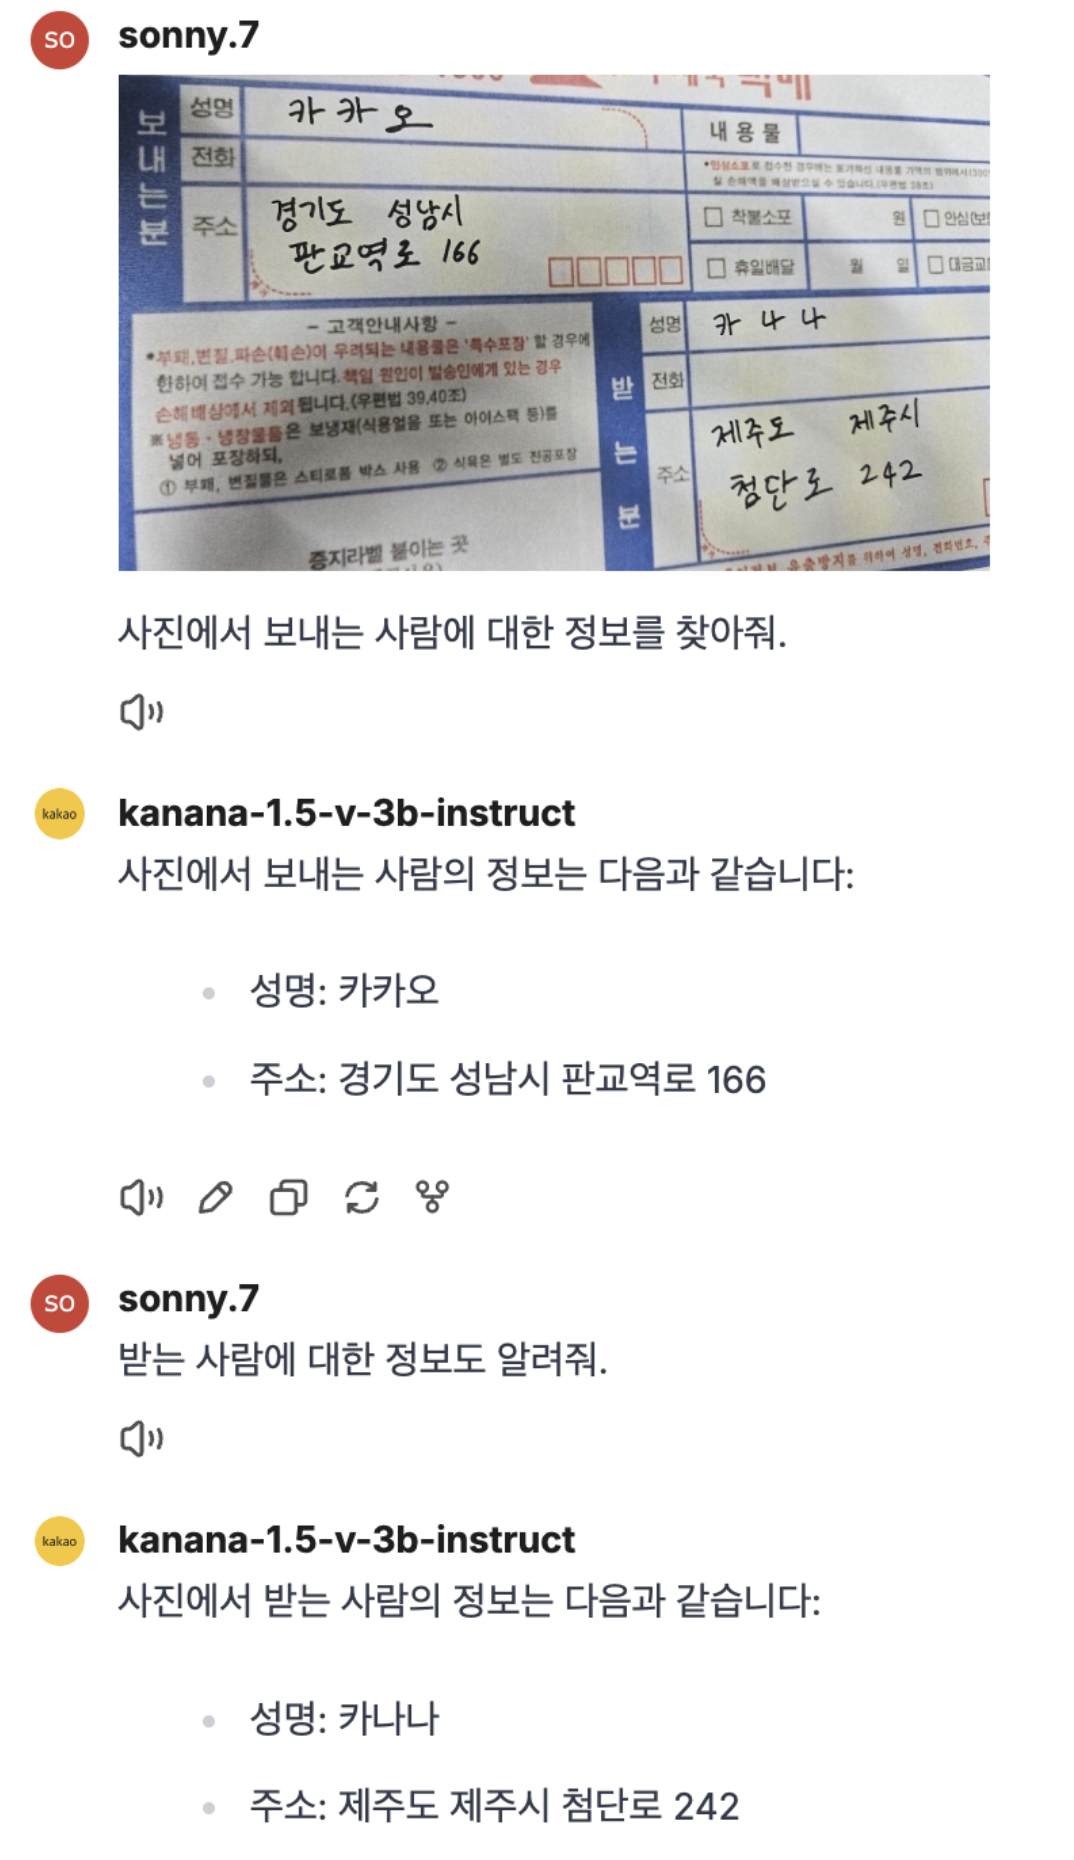
차트 및 표 인식 능력
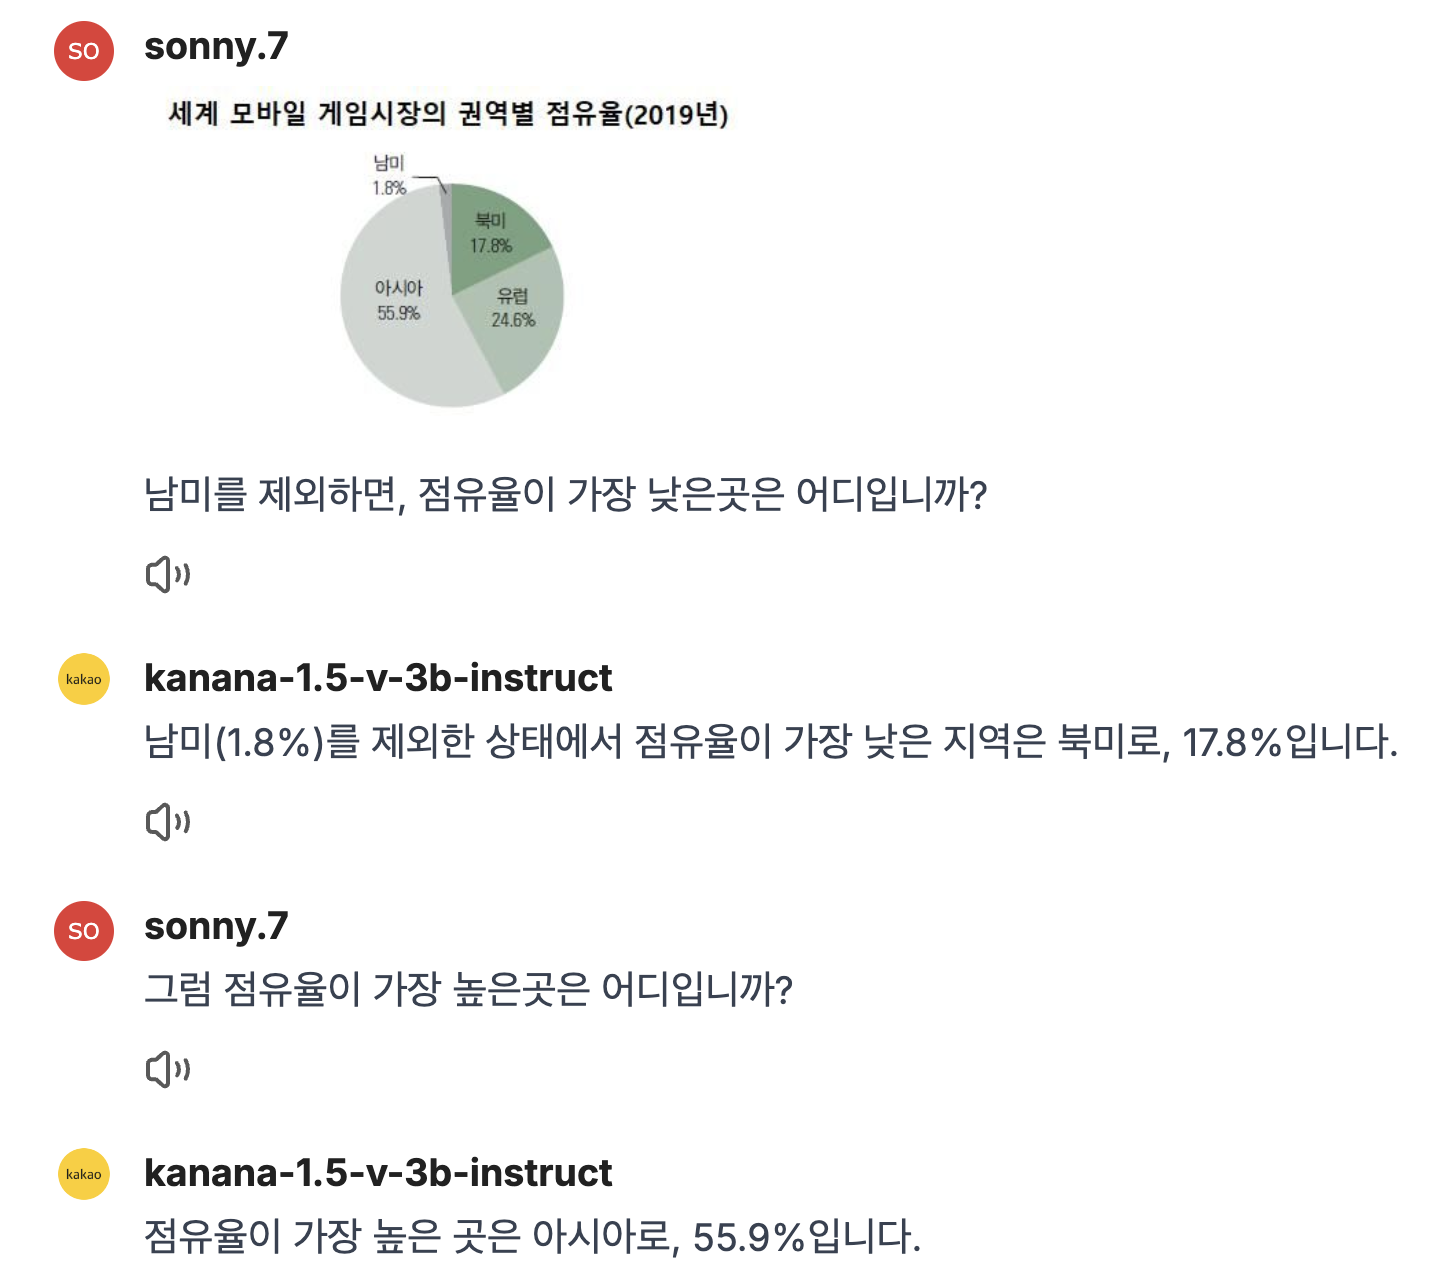
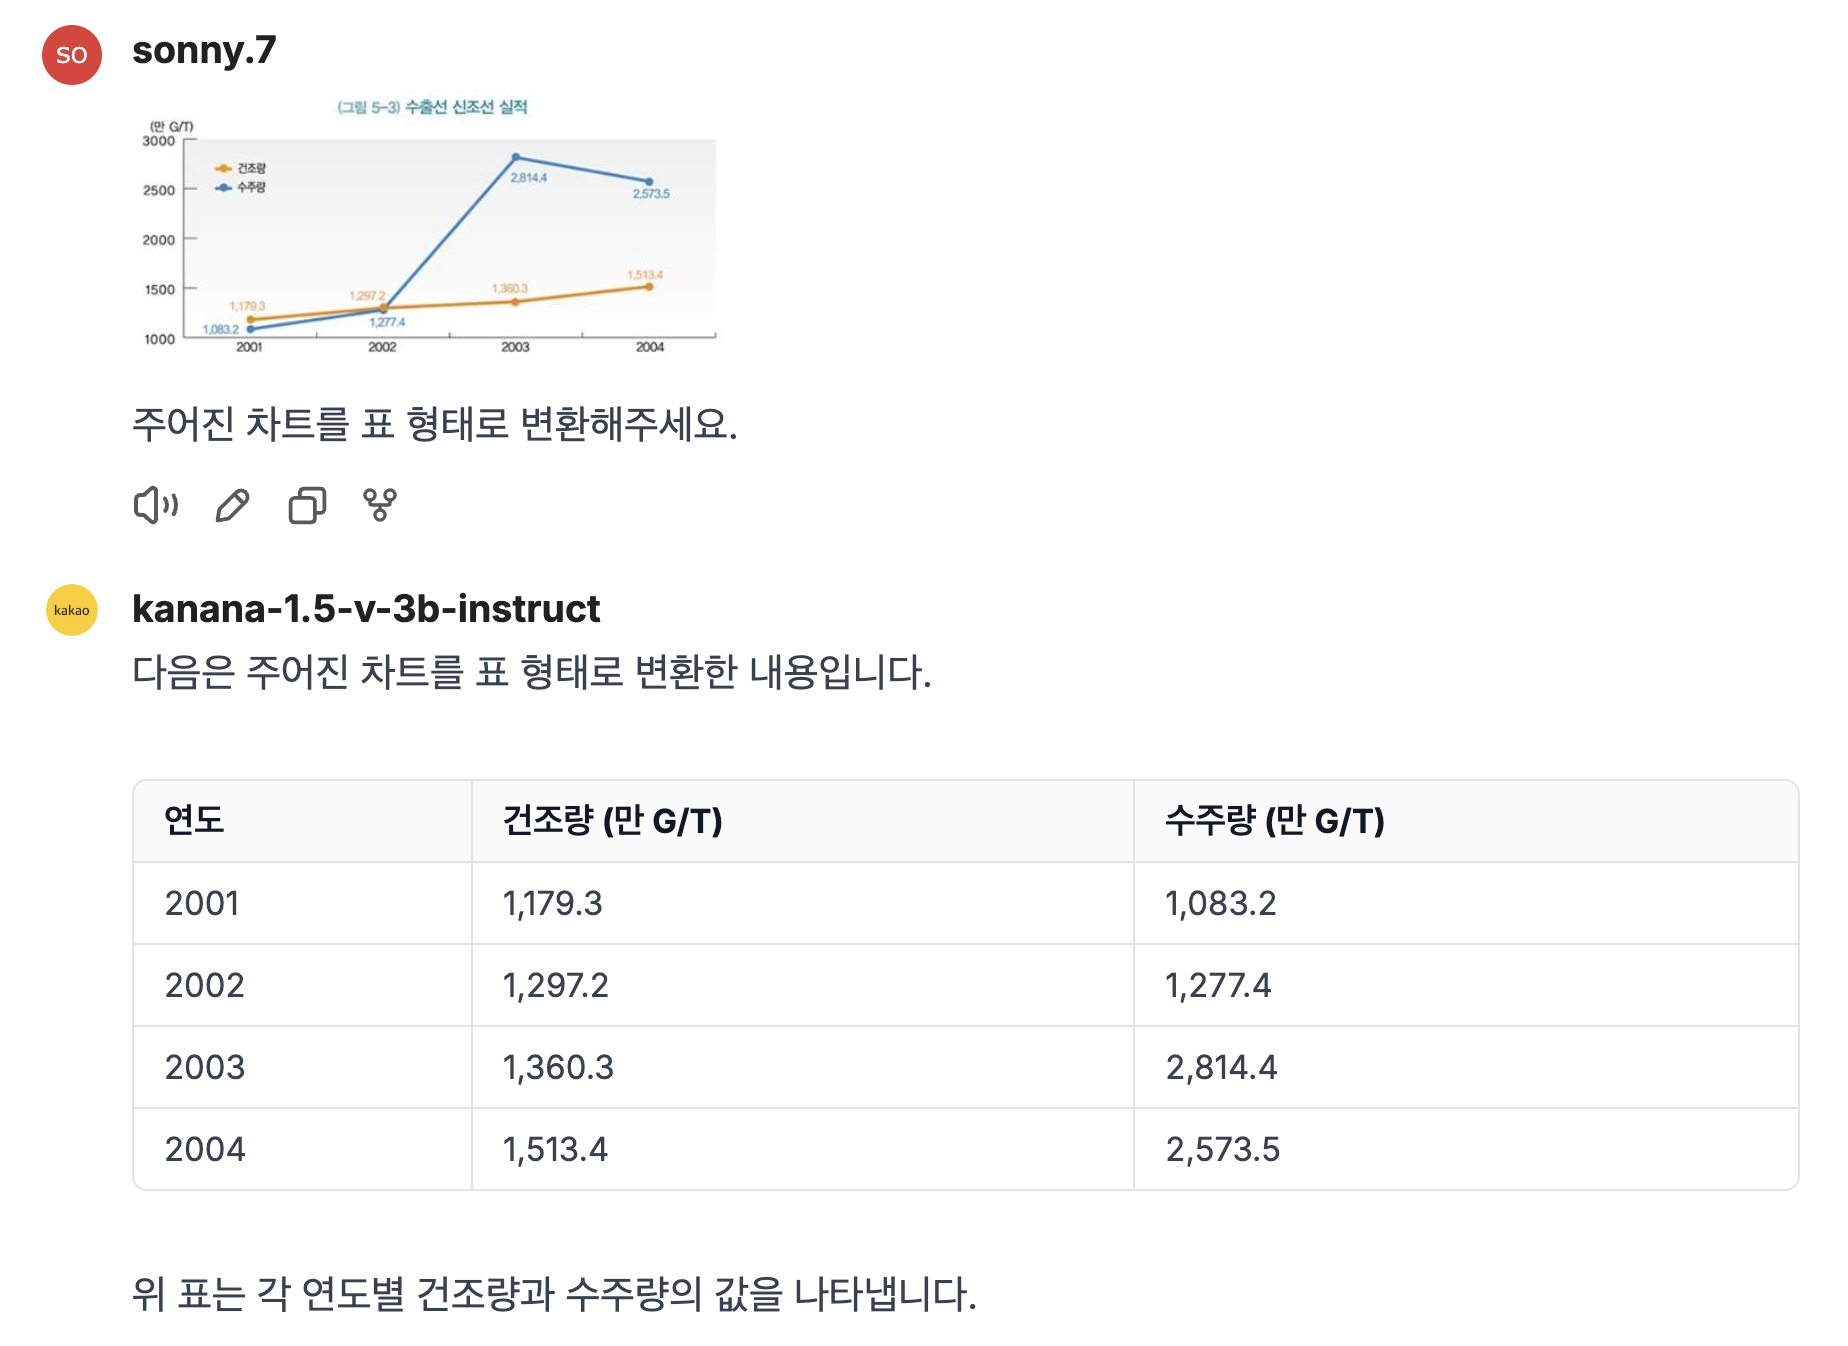
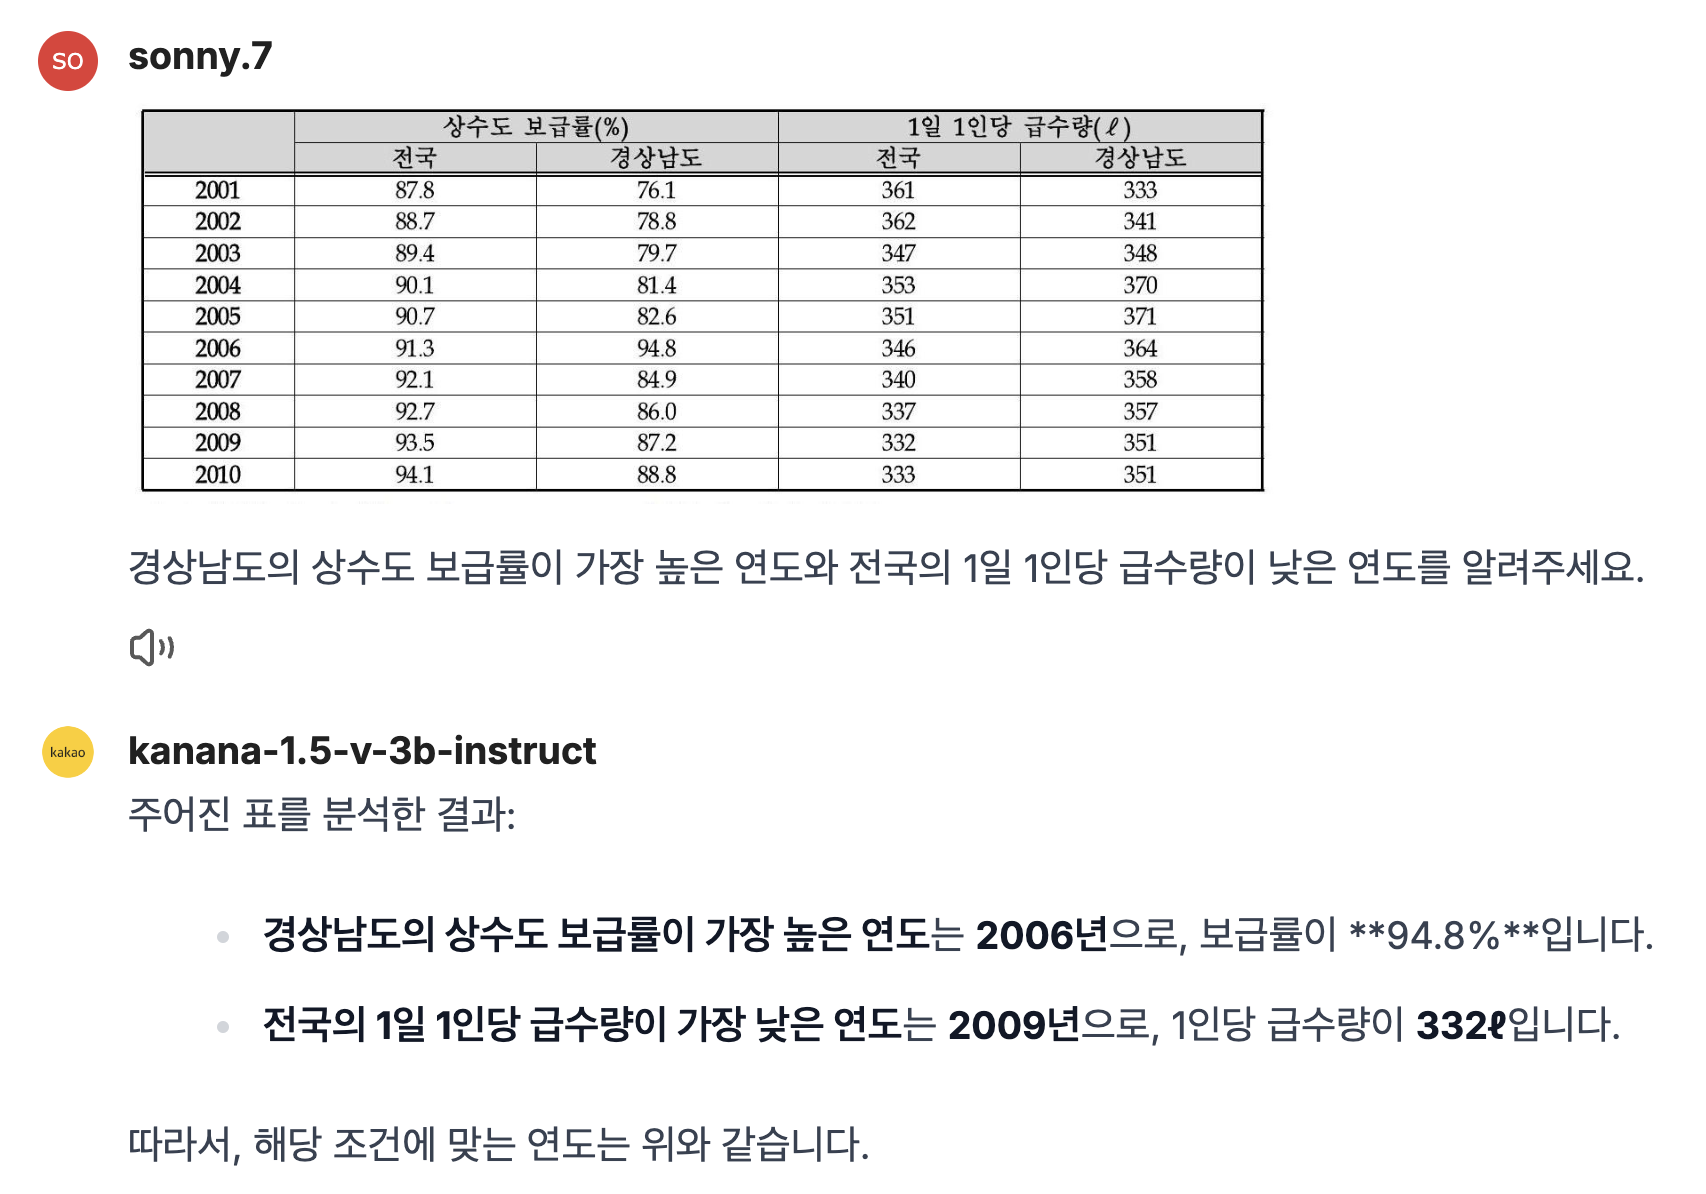
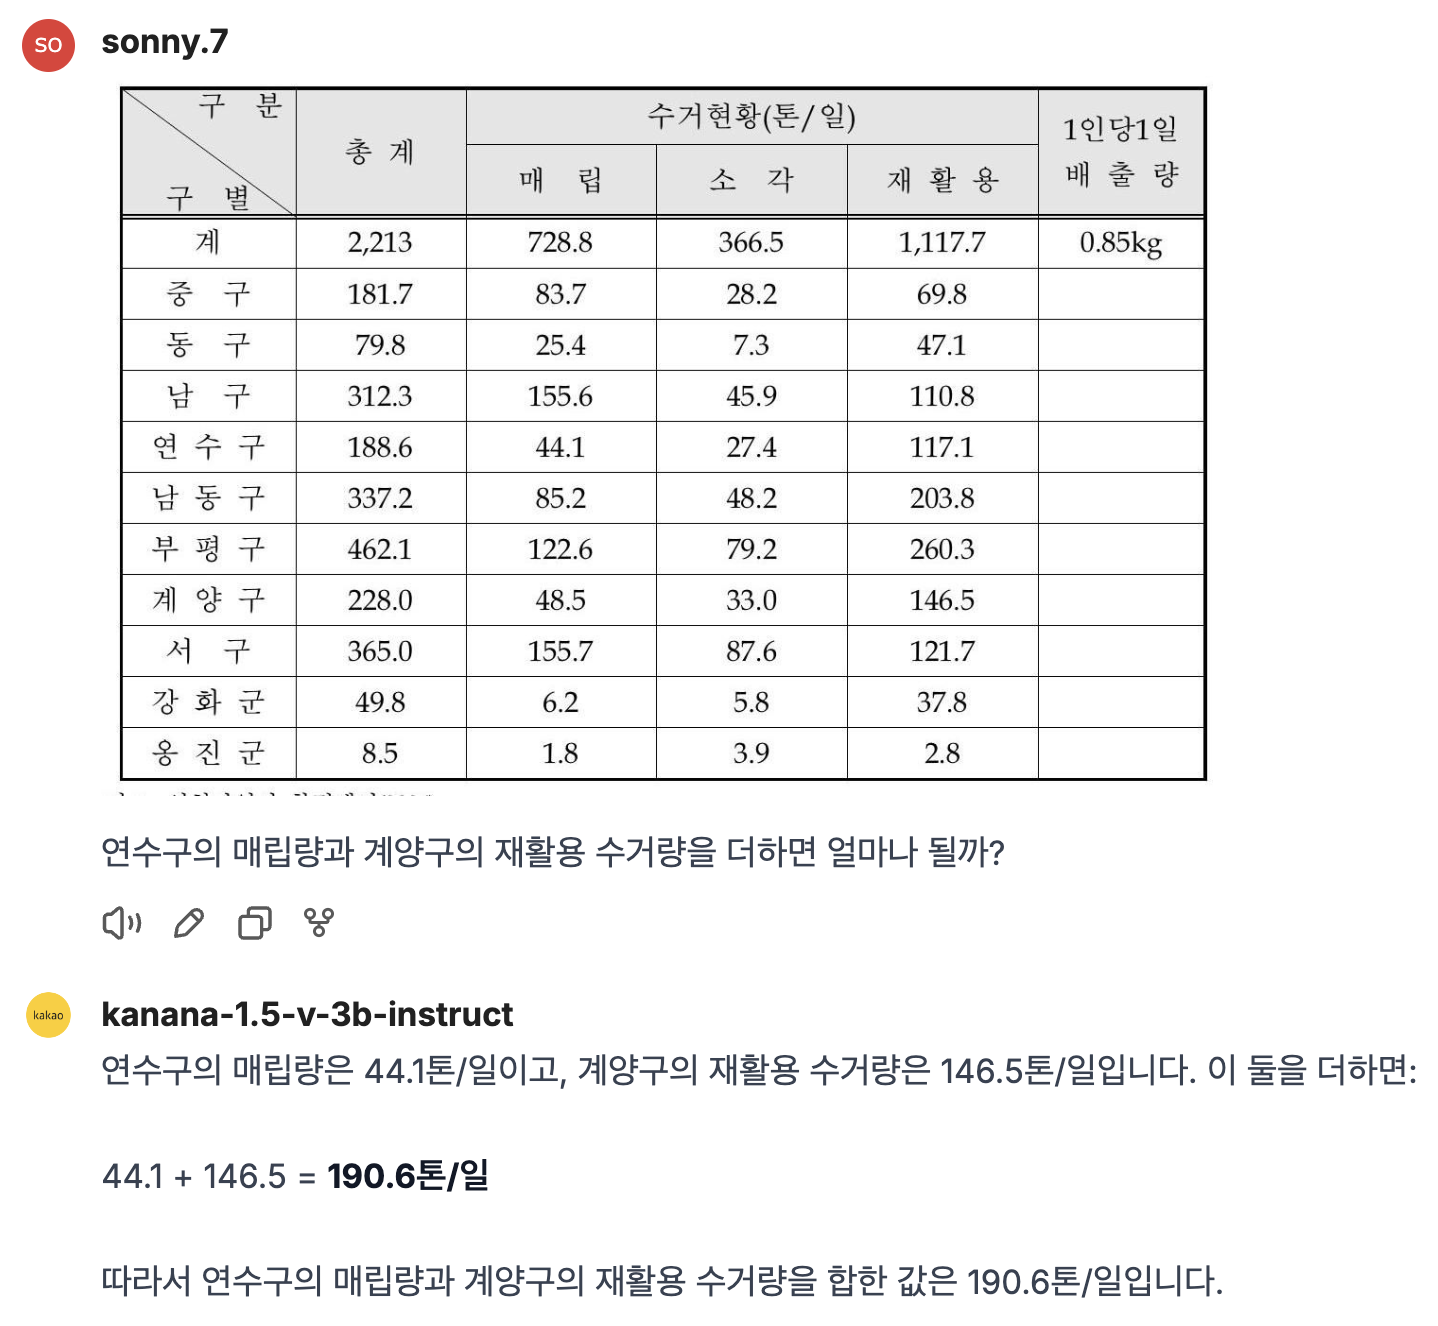
차트와 표는 복잡한 정보를 간결하게 시각화하여 전달하는 효과적인 수단입니다. 멀티모달 언어 모델이 실제 환경에서 널리 활용되기 위해서는, 이러한 구조화된 시각 정보를 정확하게 인식하고 이해하는 능력이 필수적입니다.
Kanana-v-3b는 다양한 형태의 표와 차트를 해석하고, 그 안에 담겨 있는 여러 정보들의 관계를 효과적으로 파악할 수 있습니다. Kanana-v-3b의 차트와 표 인식 능력은 아래 예시를 통해 확인하실 수 있습니다.
수학 문제 풀이
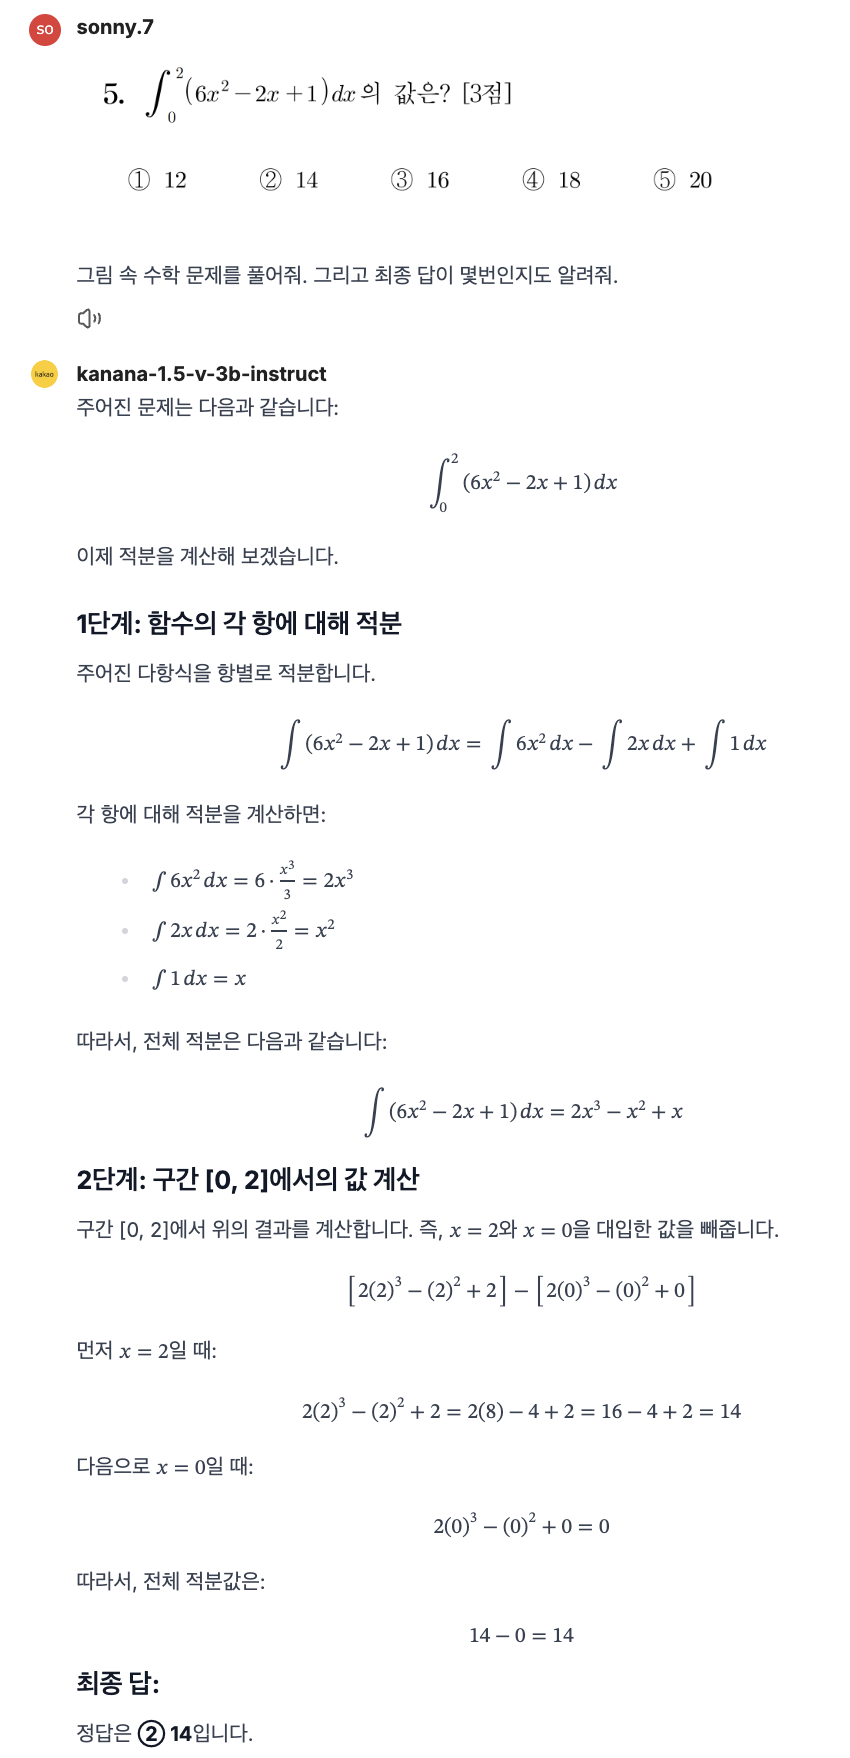
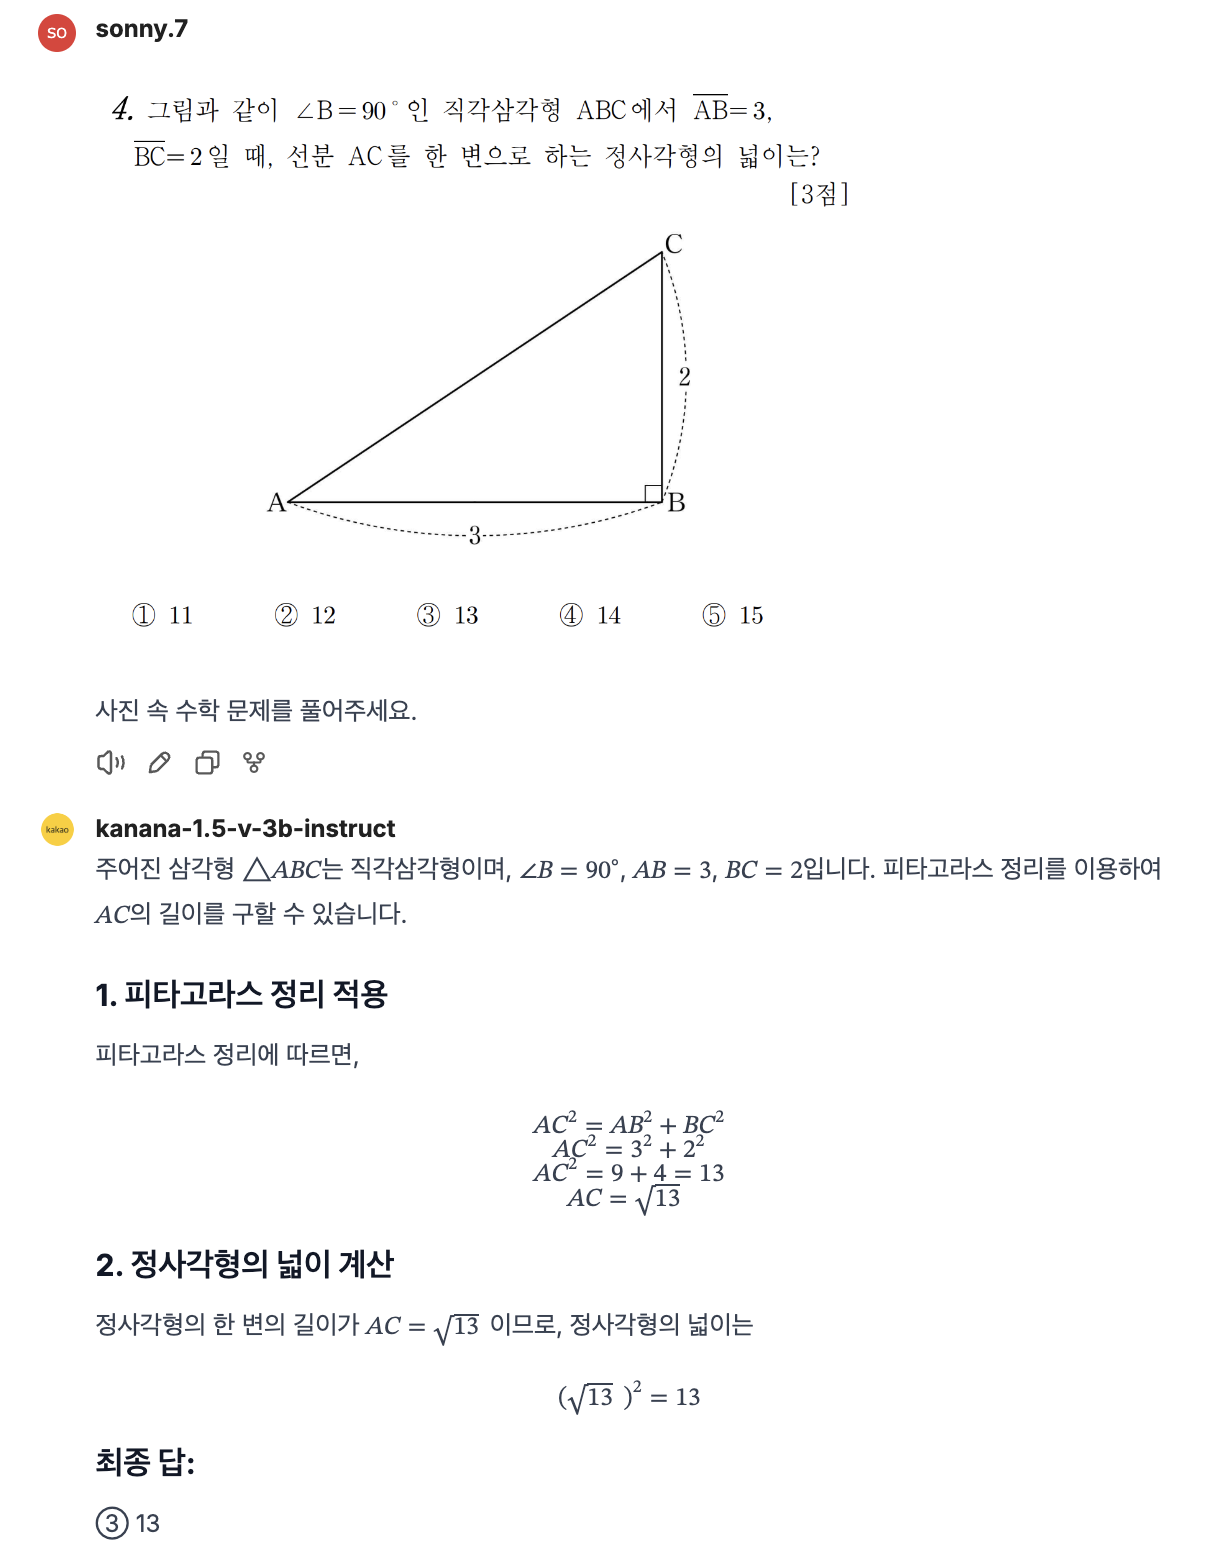
Kanana-v-3b는 논리적 사고와 단계적 추론을 바탕으로 간단한 수학 문제를 해결 할 수 있습니다. 모든 수학문제를 풀어낼 수 있는 수준은 아니지만, 논리적 사고, 추론 능력을 바탕으로 고등학교 수준의 쉬운 문제 정도는 해결할 수 있습니다.
앞으로의 목표
지금까지 Kanana-v-3b의 우수한 성능과 구체적인 사용 사례를 통해, 저희 모델이 가진 높은 경쟁력을 확인할 수 있었습니다. 하지만 동시에, 모델의 완성도와 추가적인 성능 향상을 위해 개선이 필요한 부분이 존재합니다. 앞으로 Kanana-v의 구체적인 개발 목표와 방향성에 대해서도 공유드리겠습니다.
온 정책 기술 증류
언어모델의 지식 증류(Knowledge Distillation, KD)는 학습 데이터를 구성하는 방식, 특히 학생 모델(Student Model)이 데이터 생성에 직접 참여하는지에 따라 오프 정책(Off-policy) 방식과 온 정책(On-policy) 방식으로 나눌수 있습니다.
오프 정책(Off-policy) KD는 이미 구축이 완료되어 고정된 데이터셋을 사용하거나, 교사(Teacher) 모델이 생성한 데이터를 활용하는 등 학습 중인 학생 모델(Student Model)이 데이터 생성에 관여하지 않는 모든 방법을 의미합니다. 저희의 3단계는 이미 구축되어있는 고정된 데이터셋을 사용하였기 때문에, 오프 정책(Off-policy) KD에 해당됩니다.
반면, 온 정책(On-policy) KD는 학습 중인 학생 모델(Student Model)이 주어진 입력에 대해 실시간으로 생성한 답변을 학습 샘플로 사용하는 방식입니다. 온 정책(On-policy) 방식은 학생 모델이 생성한 답변을 바탕으로 학습이 진행되기 때문에, 학생 모델이 데이터 생성에 관여하지 않는 오프 정책(Off-policy) 방식에 비해 학습이 보다 안정적이고 효율적으로 진행됩니다.
이러한 온 정책(On-policy) KD는 언어모델의 성능을 한 단계 끌어올리는 핵심 전략으로 주목 받고 있으며, 그 효과 또한 입증되었습니다.[9] 저희는 온 정책(On-policy) KD 방법론을 멀티모달 언어모델로 확장 적용하여 Kanana-v의 성능을 한층 더 고도화하고자 합니다.
추론 능력
추론(Reasoning) 능력은 멀티모달 언어모델이 단순히 지식을 나열하는 것을 넘어, 논리를 요구하는 질문에 대해서 올바른 답변을 생성하기 위한 핵심 요소입니다. 특히 이미지와 텍스트가 함께 주어졌을 때, 모델이 주어진 상황을 심층적으로 이해하고, 복합적 맥락에서 정확한 답을 도출하기 위해서는 강력한 추론(Reasoning) 능력이 필수적입니다.
Deepseek-R1[10]의 성공 이후 추론(Reasoning) 능력이 강화된 많은 LLM들이 공개되고 있습니다. 저희 또한 Kanana-V의 이후 개발 방향으로, 모델이 자신의 추론 과정을 스스로 구성하고, 이를 기반으로 정확한 답을 이끌어 낼 수 있는 능력을 갖추고자 연구를 진행하고 있습니다. 단순히 이미지를 이해하는 수준을 넘어, 사용자의 숨겨진 의도와 맥락을 포함하여 정확한 답변을 제공할 수 있는 모델로 고도화하고자 합니다.
맺음말
지금까지 Kanana-v의 경량 모델 Kanana-v-3b의 개발과정과 그 성과를 함께 알아보았습니다.
Kanana-v-3b는 글로벌 수준의 모델들과 견줄 수 있는 경쟁력과 함께, 사용자의 의도를 정확히 파악하는 지시 이행(Instruction Following) 능력을 극대화하여 실제 사용성을 높였습니다.
앞서 소개해드린 것처럼 ‘Kanana-v-3b’ 오픈소스로 공개되어 누구나 사용하실 수 있고, 성능을 직접 체감하실 수 있습니다. 이번 공개를 통해 대한민국의 AI 생태계 성장에 힘을 보태고, 누구나 멀티모달 언어모델의 무한한 가능성을 탐색할 수 있는 출발점이 되기를 기대합니다. 여러분의 많은 관심과 사용을 부탁드립니다.
저희는 ‘Kanana-v’에서 더 나아가, 통합 멀티모달 언어모델인 ‘Kanana-o’도 개발하고 있습니다. 이전 블로그에 소개드린 것처럼 ‘Kanana-o’는 텍스트, 이미지, 음성 등 다양한 모달리티 정보를 통합적으로 이해하는 멀티모달 언어모델로 일상 속 다양한 상황에서 사용자에게 이전에 없었던 편리함을 제공하는 것을 목표로 하고 있습니다.
지속적인 멀티모달 언어모델 고도화를 통해 일상에 새로운 경험과 혁신을 더할 수 있도록 최선을 다해 연구와 개발을 이어나가도록 하겠습니다. 저희의 연구와 개발 여정에 많은 관심과 격려 부탁드립니다.
함께한 사람들
Kanana 조직의 brook.p (박범희), edwin.ai (강우영), james.e (이재명), jessie.e (이지혜), kevin.nlp (고현웅), martin.gale (조대진), peter.brain (노병석), samuel.brain (강성훈), sonny.7 (손동희), welt.bae (배병욱), wooner.l (이동진)이 함께 했습니다.
데이터 구축에 있어서는 Kanana 조직의 alan.zero (노영만), el.if (조민범), hulk.5 (오형석), jaden.o (박지호), jennie.ee (이지혜), jeri.s (이희현) 이 많은 도움을 주셨습니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana 조직의 loophy.cc(조정민) 에게 감사의 말을 전합니다.
참고문헌
[1] Cha, Junbum, et al. “Honeybee: Locality-enhanced projector for multimodal llm.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024.
[2] Qian, Yusu, et al. “MIA-Bench: Towards Better Instruction Following Evaluation of Multimodal LLMs.” ICLR 2025.
[3] Ding, Shengyuan, et al. “MM-IFEngine: Towards Multimodal Instruction Following.” arXiv preprint arXiv:2504.07957. 2025
[4] Zhao, Xiangyu, et al. “OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference”. arXiv preprint arXiv:2502.18411. 2025
[5] Dehghani, Mostafa, et al. “Patch n’pack: Navit, a vision transformer for any aspect ratio and resolution.” Advances in Neural Information Processing Systems 36 (2023).
[6] Fang, Alex, et al. “Data filtering networks.” arXiv preprint arXiv:2309.17425 (2023).
[7] Cai, Yuxuan, et al. “Llava-kd: A framework of distilling multimodal large language models.” arXiv preprint arXiv:2410.16236 (2024).
[8] Rafailov, Rafael, et al. “Direct preference optimization: Your language model is secretly a reward model.” Advances in neural information processing systems 36 (2023): 53728-53741.
[9] Yang, An, et al. “Qwen3 technical report.” arXiv preprint arXiv:2505.09388 (2025).
[10] Guo, Daya, et al. “Deepseek-r1: Incentivizing Reasoning capability in llms via reinforcement learning.” arXiv preprint arXiv:2501.12948 (2025).