DevOps
NTH(NodeTerminationHandler)
Jensen여기어때
2024년 4월 2일
원문에서 보기 ↗안녕하세요. 여기어때컴퍼니 SRE팀에서 EKS(Elastic Kubernetes Service, AWS의 관리형 Kubernetes 서비스)를 담당하고 있는 젠슨입니다.
Copyright 2024. 여기어때컴퍼니 All Right Reserved. Graphic by 김제린(Riny).
Karpenter 0.3x에 대한 블로그 마지막에 NTH에 대해서 예고해 드린 적이 있습니다. NTH는 Spot Instance를 사용할 때 Node가 갑작스럽게 종료되면서 해당 Node에서 운영중이던 Pod들이 안정적으로 종료되고 신규 Node에서 배포될 수 있도록 도와주는 기능입니다.
이러한 기능을 사용할 수 있는 이유는 Spot Instance가 종료되기 2분 전에 Interruption Event를 받기 때문입니다. 기본적으로 Karpenter에서는 이러한 Event에 대응할 수 있는 InterruptionQueueName이라는 옵션을 제공합니다. 그러면 NTH는 왜 필요한 것일까요?
1. NodeTerminationHandler
Spot Instance는 2분 전에 Interruption Event를 통해서 ‘내가 곧 종료된다’라는 것을 알 수 있다고 했습니다. 그러나 2분이라는 시간 안에 해당 WorkerNode에서 수행 중이던 Pod들이 모두 다른 WorkerNode로 이동하기에는 다소 부족할 수 있습니다. 그러면 이렇게 종료된다는 Event를 조금 더 빠르게 받을 수는 없을까요? 애매하긴 하지만 15분 전에 Rebalance Recommendation이라는 Event를 받을 수 있습니다. 제가 애매하다는 표현을 썼는데 그 이유는 Rebalance Recommendation Event를 받았다고해서 해당 Node가 반드시 죽는 것은 아니기 때문입니다. 아래 그림을 보면서 설명해 드리도록 하겠습니다.
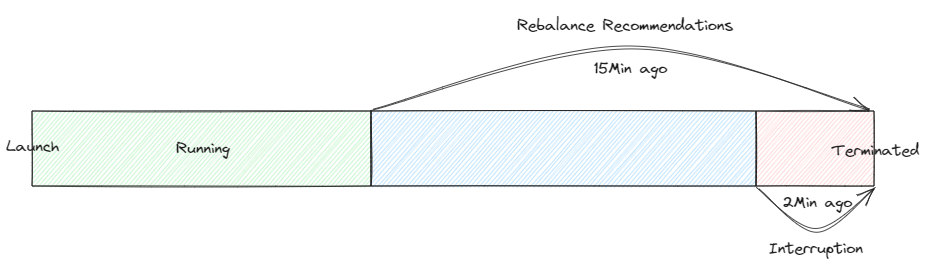
1. Interruption Event가 발생할 경우
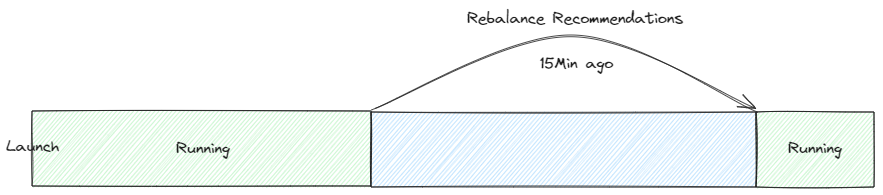
2. Interruption Event가 발생하지 않을 경우
같은 시간에 Launch된 Instance가 있다고 할 때 2개의 Instance가 모두 Rebalance Recommendation Event를 받았다고 가정해 보겠습니다. 첫 번째 Instance는 Interruption Event를 받아서 Terminated되었고 두 번째 Instance는 Interruption Event를 받지 않아서 계속해서 Running되고 있습니다. 결국 Rebalance Recommendation은 WorkerNode가 종료된다라는 의미가 아니라 Interruption의 대상 리스트에 올라갔다 정도로 생각할 수 있습니다. 그러면 Rebalance Recommendation이 발생할 때 해당 WorkerNode에서 수행중이던 Pod들을 종료하고 재배포 해주면 충분한 시간이 보장되면서 완벽하지 않을까? 라는 생각을 할 수 있습니다. 물론 저도 그렇게 생각하며 이러한 Event가 얼마나 발생하는지 뽑아보았습니다.
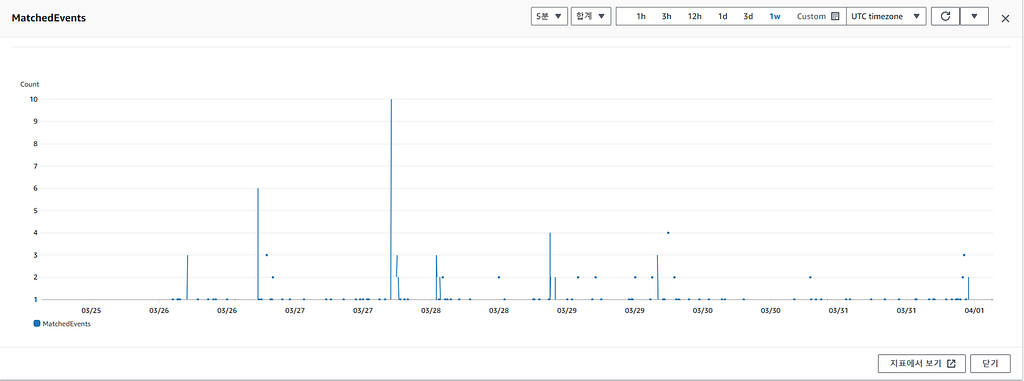
Interruption Event
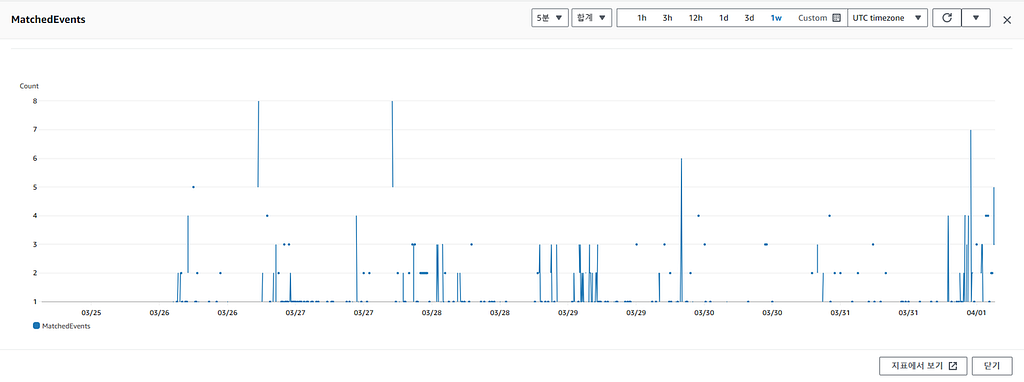
Rebalance Recommendation Event
Spot Instance를 사용해 보신 분들은 아시겠지만 생각보다 Instance의 교체가 자주 발생합니다. 위의 그래프는 Interruption과 Rebalance Recommendation의 약 일주일치 자료인데 비교도 안될 정도로 많은 Event가 발생하는 것을 확인할 수 있습니다. 이대로 Rebalance Recommendation Event에 대응하여 Pod들을 옮겨주기에는 너무나 많은 WorkerNode 교체가 발생할 것으로 예상 되었고 결국 여기어때에서는 Interruption에 대한 처리만 하는 것으로 결정하였습니다.
사실 NTH를 사용하는 가장 큰 이유는 Karpenter의 기본 기능 만으로는 대처할 수 없는 15분전 Rebalance Recommendation Event를 처리할 수 있다 라는 점인데 여기어때에서 2분전 Event에 대해서만 처리하도록 결정되어 NTH를 꼭 사용해야하는 목적은 사라지게 되었습니다. 그러나 NTH와 관련된 많은 Reddit이나 자료들을 보면서 생각보다 많은 사람들이 NTH가 Karpenter의 기본 기능으로 사용되었으면 좋겠다는 반응을 보이고 있어서 비록 2분 전 Interruption만을 처리하도록 구성하지만 NTH를 사용하기로 했습니다.
NTH는 설치 모드에 따라서 제공하는 기능이 다른데 아래 표는 Karpenter 기본 기능과 NTH 설치 모드에 따라서 제공되는 기능 비교표입니다.
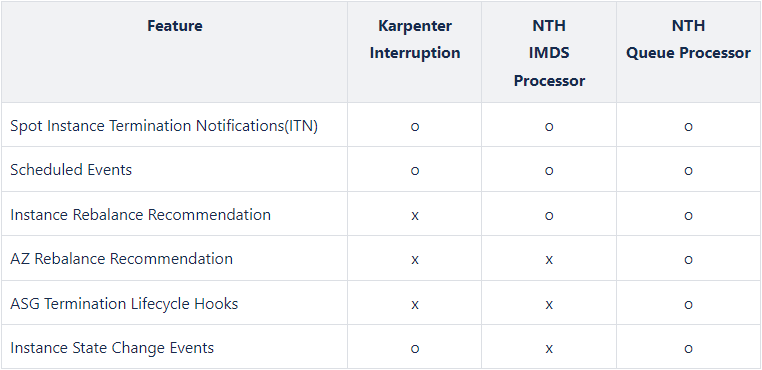
설치 모드에 따른 기능 비교
상세한 내용은 아래 링크에서 확인할 수 있습니다.
https://karpenter.sh/docs/concepts/disruption/#interruption
https://github.com/aws/aws-node-termination-handler
결국 NTH도 설치 모드에 따라서 제공하는 기능이 다르다는 것을 알 수 있습니다. 이제부터 각 모드에 따른 설치 방법에 대해서 알아보도록 하겠습니다.
2. IMDS Processor
IMDS는 InstanceMetaDataService를 의미 합니다. 운영중인 모든 WorkerNode에 DaemonSet으로 배포되며 해당 Pod가 MetaData를 통해 Interruption Event가 발생되었는지를 확인하는 방법입니다. 이 방법은 제공하는 기능이 제한적이지만 설치가 쉽다는 장점을 가지고 있습니다. 기능이 제한적인 이유는 MetaData를 통해 알 수 있는 정보가 제한적이기 때문입니다. 그럼 설치부터 진행해 보도록 하겠습니다.
일단 해당 Helm을 가져와야 하기 때문에 인증절차가 필요합니다.
aws ecr-public get-login-password \
  --region us-east-1 | helm registry login \
  --username AWS \
  --password-stdin public.ecr.aws
Login Successed라는 메세지가 출력되면 인증이 완료된 것이고 이제 Helm을 설치해야 하는데 설치할 버전을 잘 선택해 줘야 합니다.
https://gallery.ecr.aws/aws-ec2/helm/aws-node-termination-handler
helm upgrade --install aws-node-termination-handler \
   --namespace kube-system \
   --set enableSpotInterruptionDraining="true" \
   --set enableScheduledEventDraining="true" \
   --set enableRebalanceMonitoring="false" \
   --set enableRebalanceDraining="false" \
   --set deleteSqsMsgIfNodeNotFound="false" \
   --set webhookURL=${SLACK_WEBHOOK_URL} \
   oci://public.ecr.aws/aws-ec2/helm/aws-node-termination-handler --version 0.23.0
설치할 때 많은 옵션들을 넣을 수 있는데 제가 위에서 넣은 옵션들은 각각 이러한 내용을 의미합니다.
enableSpotInterruptionDraining - Spot 종료 알림 시 Node Dranning
enableScheduledEventDraining - EC2 예약 이벤트 알림 시 Node Dranning
enableRebalanceMonitoring - Rebalance 알림 시 Node Cordon
enableRebalanceDraining- Rebalance 알람 시 Node Dranning
deleteSqsMsgIfNodeNotFound - 알람 대상 Node가 없는 경우 SQS 메시지 삭제
webhookURL - 해당 이벤트 처리 후 처리 내용을 전송할 WebHook URL
더 자세한 옵션들은 아래 링크에서 확인할 수 있습니다.
설치가 정상적으로 완료되면 aws-node-termination-handler Pod에 아래와 같은 Log가 보일 것입니다.
2024/04/01 07:09:50 INF Started watching for interruption events                                                                                                                                                                          │
2024/04/01 07:09:50 INF Kubernetes AWS Node Termination Handler has started successfully!                                                                                                                                                 │
2024/04/01 07:09:50 INF Started watching for event cancellations                                                                                                                                                                          │
2024/04/01 07:09:50 INF Started monitoring for events event_type=SPOT_ITN_MONITOR                                                                                                                                                         │
2024/04/01 07:09:50 INF Started monitoring for events event_type=SCHEDULED_EVENT_MONITOR
이제 Spot Instance에 Interruption이 발생할 때까지 기다려야 하는데 우리는 기다릴 시간이 없으니 FIS를 통해 테스트 해보도록 하겠습니다. FIS는 AWS에서 제공하는 Spot Interruption을 발생시켜주는 도구 입니다. 자세한 가이드는 아래 링크를 참고해 주시기 바랍니다.
https://ec2spotworkshops.com/karpenter/060_scaling/fis_experiment.html
FIS를 통해 Trigger를 생성해 주면 현재 운영중이던 WorkerNode 중 1대가 Cordon 상태로 변경되는 것을 확인할 수 있습니다. 이때 이 Node에서 수행중이던 aws-node-termination-handler의 Log를 보면 아래와 같이 동작하는 것을 확인할 수 있습니다.
2024/04/01 07:25:27 INF Adding new event to the event store event={"AutoScalingGroupName":"","Description":"Spot ITN received. Instance will be interrupted at 2024-04-01T07:27:26Z \n","EndTime":"0001-01-01T00:00:00Z","EventID":"spot- │
2024/04/01 07:25:28 INF Requesting instance drain event-id=spot-itn-648c9b5a5672fec6bbfe4e48d5d8e2c941e0bb52c784e27e4c9a2162dfd47920 instance-id= kind=SPOT_ITN node-name=ip-x-x-x-x.ap-northeast-2.compute.internal provider-id=  │
2024/04/01 07:25:28 INF Pods on node node_name=ip-x-x-x-x.ap-northeast-2.compute.internal pod_names=["test-5c9d48ff5f-cx8dz","aws-node-bmk92","aws-node-termination-handler-7rx4f","ebs-csi-node-7pm6p","kube-proxy-n2g9d","promet │
2024/04/01 07:25:28 INF Draining the node                                                                                                                                                                                                 │
2024/04/01 07:25:28 ??? WARNING: ignoring DaemonSet-managed Pods: kube-system/aws-node-bmk92, kube-system/aws-node-termination-handler-7rx4f, kube-system/ebs-csi-node-7pm6p, kube-system/kube-proxy-n2g9d, prometheus/prometheus-prometh │
2024/04/01 07:25:28 ??? evicting pod default/test-5c9d48ff5f-cx8dz                                                                                                                                                                        │
2024/04/01 07:26:09 INF Node successfully cordoned and drained node_name=ip-x-x-x-x.ap-northeast-2.compute.internal reason="Spot ITN received. Instance will be interrupted at 2024-04-01T07:27:26Z \n"                            │
Stream closed EOF for kube-system/aws-node-termination-handler-7rx4f (aws-node-termination-handler)
WorkerNode가 Dranning 되면서 해당 Node에서 수행중이던 Pod는 Evict 되었습니다. 당시에 Slack에도 Alert이 왔는데 다음과 같은 메세지 입니다.
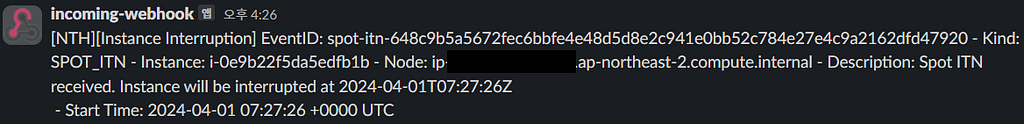
Slack Alert
잘 처리되고 있는 것을 볼 수 있는데 여기서 한 가지 아셔야 할게 있습니다. Log를 보면 아시겠지만 Event를 받은 Node에서 수행중이던 Pod들은 해당 Node에서 Evict 됩니다. 그렇다는 이야기는 replica 수량이 1로 설정되어 있는 Pod들은 아무리 Interruption 처리를 해준다고 하더라도 서비스가 잠시동안 중단될 수 있다라는 것을 의미 합니다. 저는 실제로 NTH가 이 부분까지 처리해 줄줄 알았습니다. ㅠㅠ 결국 Spot Instance를 사용하면서 무중단 서비스를 해야 하는 경우에는 replica 수량을 2 이상으로 하면서 pdb 설정을 해야 하는 것으로 보였습니다.
이제 정상적으로 잘 동작하는 것을 확인했으니 다음 모드로 넘어가도록 하겠습니다. 참고로 삭제는 아래처럼 하시면 됩니다.
helm uninstall aws-node-termination-handler -n kube-system
3. Queue Processor
Queue는 IMDS와 비교하여 설치 과정이 다소 복잡하지만 많은 기능을 제공하고 DaemonSet이 아닌 Deployment로 설치 됩니다.
여기서 한 가지 고민해 보셔야 할 점은 IMDS, Queue 어떠한 모드로 설치하더라도 내가 원하는 기능을 제공하고 있다고 할 때 어떤 설치 방법이 효율적인 것인지를 생각 하셔야 합니다. 모든 WorkerNode 에 배포되어야 하는 IMDS는 WorkerNode의 리소스를 소비 합니다. Queue 같은 경우는 Deployment이기 때문에 모든 WorkerNode의 리소스를 소비하지는 않지만 별도의 AWS 서비스들을 소비 합니다. 아래 설치 과정을 보면서 선택해 주시면 좋을 것 같습니다.
제일 먼저 SQS Queue를 생성해 줍니다.
## Queue Policy
QUEUE_POLICY=$(cat <<EOF
{
    "Version": "2012-10-17",
    "Id": "MyQueuePolicy",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {
            "Service": ["events.amazonaws.com", "sqs.amazonaws.com"]
        },
        "Action": "sqs:SendMessage",
        "Resource": [
            "arn:aws:sqs:ap-northeast-2:${AWS_ACCOUNT_NUMBER}:${QUEUE_NAME}"
        ]
    }]
}
EOF
)

## make sure the queue policy is valid JSON
echo "$QUEUE_POLICY" | jq .

## Save queue attributes to a temp file
cat << EOF > /tmp/queue-attributes.json
{
  "MessageRetentionPeriod": "300",
  "Policy": "$(echo $QUEUE_POLICY | sed 's/\"/\\"/g' | tr -d -s '\n' " ")",
  "SqsManagedSseEnabled": "true"
}
EOF

aws sqs create-queue --queue-name "${QUEUE_NAME}" --attributes file:///tmp/queue-attributes.json
SQS Queue가 정상적으로 생성 되었으면 해당 Event에 반응할 WorkerNode를 선정할 수 있습니다. IMDS에서는 DaemonSet으로 모든 WorkerNode가 대상이였지만 Queue 같은 경우에는 대상을 Tag로 지정할 수 있습니다. Test를 위해 WorkerNode에 아래와 같은 Tag를 넣도록 하겠습니다.
aws-node-termination-handler: True
이제 EventBridge를 생성합니다.
aws events put-rule \
  --name ASGTermRule \
  --event-pattern "{\"source\":[\"aws.autoscaling\"],\"detail-type\":[\"EC2 Instance-terminate Lifecycle Action\"]}"

aws events put-targets --rule ASGTermRule \
  --targets "Id"="1","Arn"="${SQS_ARN}"

aws events put-rule \
  --name MyK8sSpotTermRule \
  --event-pattern "{\"source\": [\"aws.ec2\"],\"detail-type\": [\"EC2 Spot Instance Interruption Warning\"]}"

aws events put-targets --rule MyK8sSpotTermRule \
  --targets "Id"="1","Arn"="${SQS_ARN}"

aws events put-rule \
  --name MyK8sRebalanceRule \
  --event-pattern "{\"source\": [\"aws.ec2\"],\"detail-type\": [\"EC2 Instance Rebalance Recommendation\"]}"

aws events put-targets --rule MyK8sRebalanceRule \
  --targets "Id"="1","Arn"="${SQS_ARN}"

aws events put-rule \
  --name MyK8sInstanceStateChangeRule \
  --event-pattern "{\"source\": [\"aws.ec2\"],\"detail-type\": [\"EC2 Instance State-change Notification\"]}"

aws events put-targets --rule MyK8sInstanceStateChangeRule \
  --targets "Id"="1","Arn"="${SQS_ARN}"

aws events put-rule \
  --name MyK8sScheduledChangeRule \
  --event-pattern "{\"source\": [\"aws.health\"],\"detail-type\": [\"AWS Health Event\"],\"detail\": {\"service\": [\"EC2\"],\"eventTypeCategory\": [\"scheduledChange\"]}}"

aws events put-targets --rule MyK8sScheduledChangeRule \
  --targets "Id"="1","Arn"="${SQS_ARN}"
생성이 완료되면 EventBridge에 새로운 Rule들이 생성된 것을 확인할 수 있습니다. 이 때 우리가 원하는 Event만 활성화 시키고 필요 없는 Event는 비활성화 시켜주셔야 합니다. IMDS는 설치할 때 원하는 Event를 선택해 주었지만 Queue는 이러한 Event를 여기서 설정해 줄 수 있습니다.
이제 Helm 차례 입니다. IMDS 때와 동일 하지만 옵션이 조금 다릅니다.
aws ecr-public get-login-password \
   --region us-east-1 | helm registry login \
   --username AWS \
   --password-stdin public.ecr.aws
helm upgrade --install aws-node-termination-handler \
  --namespace kube-system \
  --set enableSqsTerminationDraining=true \
  --set queueURL=${SQS_QUEUE_URL} \
  --set nodeSelector."eks\.amazonaws\.com/nodegroup"=${NODE_GROUP_NAME} \
  --set managedTag="aws-node-termination-handler" \
  --set checkTagBeforeDraining="true" \
  --set webhookURL=${SLACK_WEBHOOK_URL} \
  oci://public.ecr.aws/aws-ec2/helm/aws-node-termination-handler --version 0.23.0
설치할 때의 옵션들을 살펴보면 다음과 같습니다.
enableSqsTerminationDraining - Spot 종료 알림 시 Node Draining
queueURL - Queue URL
nodeSelector - Deployment를 배포할 Node
managedTag - Tag 가 있는 Instance를 대상
checkTagBeforeDraining - Tag가 있는 Instance를 Draining
(ManagedTag가 일치하는 대상 기준)
webhookURL - 해당 이벤트 처리 후 처리 내용을 전송할 WebHook URL
IMDS 와 Queue에서 제공하는 옵션이 다르기 때문에 꼭 아래 URL에서 옵션을 확인하시기 바랍니다.
설치가 완료되면 IMDS 때와는 다르게 Deployment로 생성이 되며 aws-node-termination-handler Pod에 아래와 같은 Log가 보일 것입니다.
2024/04/01 08:56:00 INF Starting to serve handler /metrics, port 9092                                                                                                     │
2024/04/01 08:56:00 INF Starting to serve handler /healthz, port 8080                                                                                                     │
2024/04/01 08:56:00 INF Started watching for interruption events                                                                                                          │
2024/04/01 08:56:00 INF Kubernetes AWS Node Termination Handler has started successfully!                                                                                 │
2024/04/01 08:56:00 INF Started watching for event cancellations                                                                                                          │
2024/04/01 08:56:00 INF Started monitoring for events event_type=SQS_MONITOR
이제 FIS를 통해 Test를 진행하여 Log에 어떤 변화가 있는지 확인해 보도록 하겠습니다.
2024/04/01 08:59:49 INF Adding new event to the event store event={"AutoScalingGroupName":"","Description":"Rebalance recommendation event received. Instance i-0a1480b71 │
2024/04/01 08:59:50 INF Requesting instance drain event-id=rebalance-recommendation-event-35373333646639642d376238352d613462342d316164372d396534663732646639363736 instan │
2024/04/01 08:59:50 INF Pods on node node_name=ip-x-x-x-x.ap-northeast-2.compute.internal pod_names=["test-5c9d48ff5f-jcdgp","aws-node-g4gtd","ebs-csi-node-qv87r" │
2024/04/01 08:59:50 INF Draining the node                                                                                                                                 │
2024/04/01 08:59:50 ??? WARNING: ignoring DaemonSet-managed Pods: kube-system/aws-node-g4gtd, kube-system/ebs-csi-node-qv87r, kube-system/kube-proxy-pgtd2, prometheus/pr │
2024/04/01 08:59:50 ??? evicting pod default/test-5c9d48ff5f-jcdgp                                                                                                        │
2024/04/01 09:00:31 INF Node successfully cordoned and drained node_name=ip-x-x-x-x.ap-northeast-2.compute.internal reason="Rebalance recommendation event receive │
2024/04/01 09:00:31 INF Webhook Success: Notification Sent!
IMDS 때와 마찬가지로 WorkerNode가 Draining 되면서 해당 Node에서 수행중이던 Pod는 Evict 되었습니다. 아래는 Slack Alert입니다.
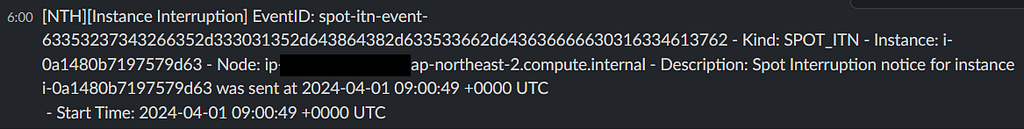
Slack Alert
정상적으로 처리되는 것을 확인할 수 있습니다.
NTH는 두 가지 모드를 제공하며 동작 방식 및 설정방식은 약간 다르지만 어떠한 방법을 사용하더라도 Spot Instance의 갑작스러운 종료에 대응할 수 있습니다. 위에서 설명한대로 본인의 환경에 조금 더 효율적은 방법을 사용하여 배포해서 사용해 주시면 될 것 같습니다.
감사합니다.