Backend
MySQL Orchestrator 기반의 새로운 HA 표준 개발기
sun.j, lukas.kdy, zoey.ful, anna.ny카카오
2025년 9월 30일
원문에서 보기 ↗개요
MHA는 2012년 DeNA에 근무하고 있던 일본인 Yoshinori Matsunobu가 개발한 솔루션으로 대규모 MySQL 운영 환경에서 고가용성을 확보하기 위해 개발되었습니다. 이후 Yoshinori Matsunobu는 MHA를 오픈 소스로 공개하였고, 대규모 MySQL을 운영하는 회사에서 고가용성을 확보하기 위해 MHA를 사용할 수 있게 되었습니다.
2015년경 카카오도 대규모 MySQL 운영 환경 하에 고가용성을 확보해야 하는 목표가 있었습니다. 이때 MHA가 가장 적절하다고 판단하였고 해당 소스 기반으로 고가용성을 확보하는 MySQL표준 구성을 확립하였습니다. 하지만, 시간이 지나면서 MySQL 버전이 올라가고, 요구 사항이 다양해 지면서 MHA로는 모든 요구 사항을 받아들이며 고가용성을 확보하기 어려워졌습니다. 그래서, 2023년부터 고가용성 확보를 위한 R&D를 진행하고 MHA 기반의 표준 구성을 대신하여 Orchestrator 기반의 새로운 표준 구성을 확립하였습니다.
이 문서에서는 카카오 MySQL 플랫폼 엔지니어가 어떻게 Orchestrator 기반으로 새로운 고가용성 표준안을 확립하였는지 살펴보려고 합니다.
1. MHA가 가진 한계
MHA는 MySQL 고가용성 확보가 어려운 환경에서 Failover/Switch가 가능하게 제공해준 솔루션으로 MMM과 MySQL 고가용성을 높여준 오픈소스입니다. 하지만, 시간이 지나도 MHA는 버전에 따른 기능 추가도 되지 않았고, 소스코드가 관리되지도 않았습니다. 또한, Perl 언어로 작성되어 운영하는 엔지니어에 많은 부담감을 주었습니다.
[MMM]
MMM은 MySQL Master-Master Manager로 자동 페일오버를 구현한 솔루션입니다. 네덜란드 출신의 Roland Bouman에 의해 개발되었으며, 2010년대 MHA와 더불어 자동페일오버가 가능한 고가용성을 확보하고자 하는 경우 많이 사용하였습니다.
1.1 변화하는 환경에 대응 부족
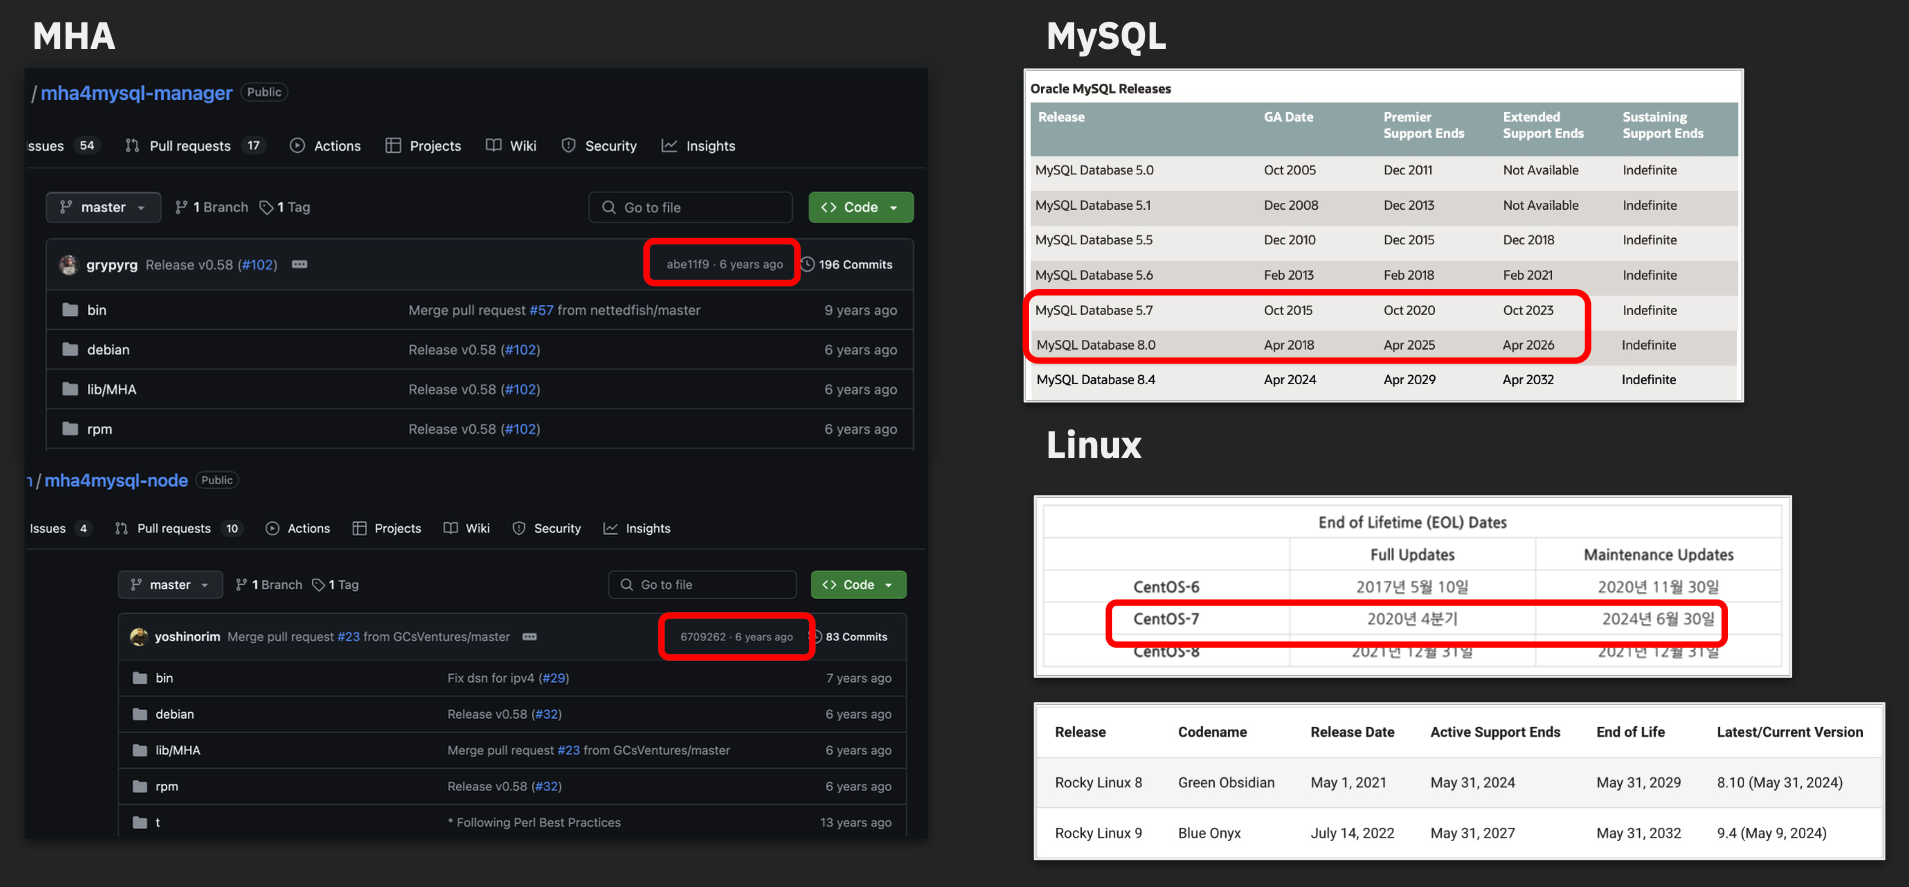
MHA 소스는 거의 10년이 넘는 동안 패치 및 기능 추가가 전혀 없는 상태로 소스만 오픈되어있습니다. MySQL 버전과 OS 버전이 계속 올라가는 환경에서 현재 MHA는 그에 대한 대응이 아예 없다고 해도 무방한 상태로 판단하였습니다.
1.2 기능적 한계
MHA는 Source 서버의 운영 상태를 외부에서 Source 서버에 접근하여 확인하는 로직으로 구현되어있습니다. MHA는 네트웍이 안정적인 상태이어야 한다는 기본 전제가 깔려있는 상태에서 개발되었다고 볼 수 있습니다. 그러다 보니 다양한 네트웍 장애에 오동작으로 인한 문제가 확인되었습니다.
카카오에서는 이런 문제를 해결하기 위해 HAM이라고 하는 MHA Cluster Manager를 개발하여 그 구성 하에서 MHA가 운영될 수 있게 대응하였지만, MHA Source 코드가 Perl로 되어있다 보니 개발에 참여한 분들이 많은 어려움을 겪을 수 밖에 없었습니다. 또한, 현재 한국에서 Perl 은 거의 사용하지 않는 언어다 보니 소스 코드 분석이나 수정에 많은 시간 소요가 들 수 밖에 없었습니다.
MHA는 Source 서버로 운영이 어렵다고 판단한 경우 Replica 서버를 승격하여 고가용성을 확보하는 것을 기본 개념으로 개발되었습니다. 카카오에서는 다양한 서비스 요구 사항으로 Replica 서버의 상태를 확인하여 고가용성을 확보할 수 있도록 해야 하는데 이러한 기능 개발에 MHA는 기본 설계가 달라 카카오 내 요구 사항을 적용할 수 없었습니다.
즉, 다음과 같은 기능적 한계가 있다고 확인하였습니다.
-
Source만 확인 가능한 구조적 한계
-
네트워크 문제에 대응이 어려운 구조적 문제
-
Perl 소스 코드로 인한 유지 보수의 어려움
2. 차세대 HA 솔루션 선정
MHA를 대체하기 위한 고가용성 솔루션을 조사하기 위해 2023년도에 사용이 가능했던 다음의 솔루션들을 조사하였습니다.
-
MySQL Cluster
-
MySQL Proxy
-
ProxySQL
-
Corosync + Pacemaker + NFS Share
-
Corosync + Pacemaker + DRBD
-
MySQL with NFS + Heartbeat
-
PRM
-
MySQL Replication + Heartbeat
-
Percona XtraDB Cluster
-
Automatic Asynchronous Replication Connection Failover
-
ClusterContral
-
MySQL Innodb Cluster
-
Orchestrator
우리가 찾아야 하는 솔루션은 다음의 요구사항에 적합해야 했습니다.
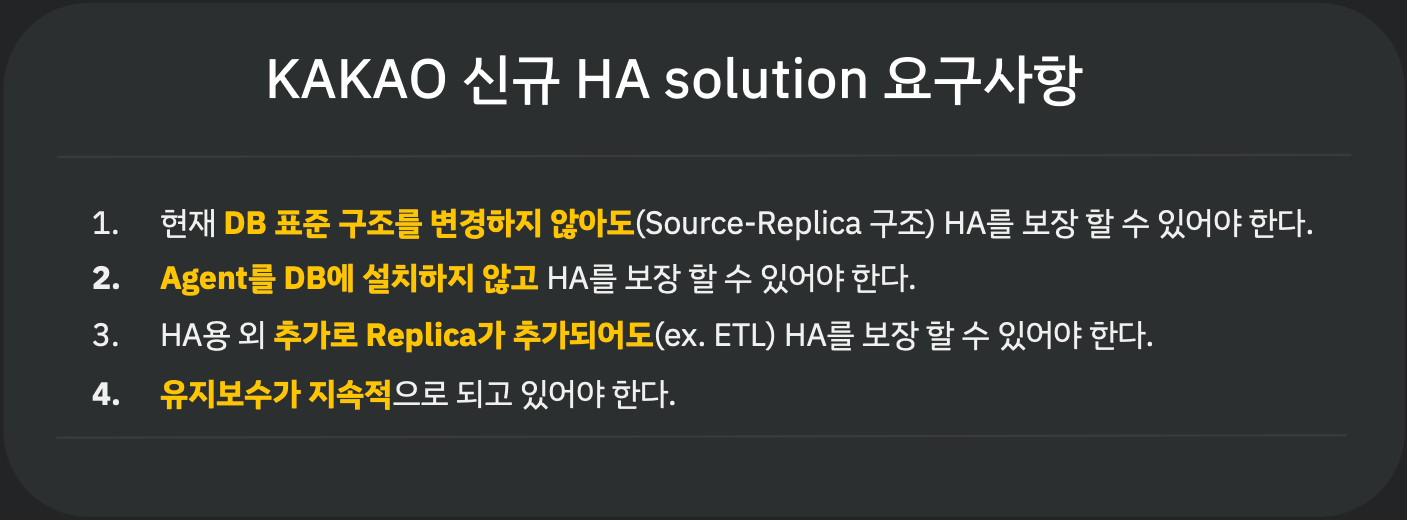
조사한 여러 솔루션 중 다음의 목표에 맞는 솔루션이 무엇인지 비교/검토하였고, 최종적으로 Orchestrator를 선정하게 되었습니다.
2.1 Orchestrator 소개
Orchestrator는 MySQL Replication Topology를 위한 HA 및 시각화 관리 도구입니다. Shlomi Noach가 개발한 것으로 자동 페일오버 기능을 넘어 복잡한 Replication 구조 전체를 지능적으로 이해하고 healing하는데 초점을 맞춘 오픈소스 HA 솔루션입니다.
[Shiomi Noach]
MySQL 생태계에서 영향력 있는 엔지니어 중 한명으로 Orchestrator와 gh-ost와 같은 필수 도구를 개발한 이스라엘 출신의 데이터베이스 개발 전문가입니다. 유튜브에서 시작된 Vitess에 컨트리뷰터로도 기여하며 MySQL에 대한 전문성을 보여주고 있습니다.
다음의 링크로 들어가서 확인하면 Shiomi Noach가 개발하거나 참여한 프로젝트들을 확인할 수 있습니다.
2.2 Orchestrator 특징
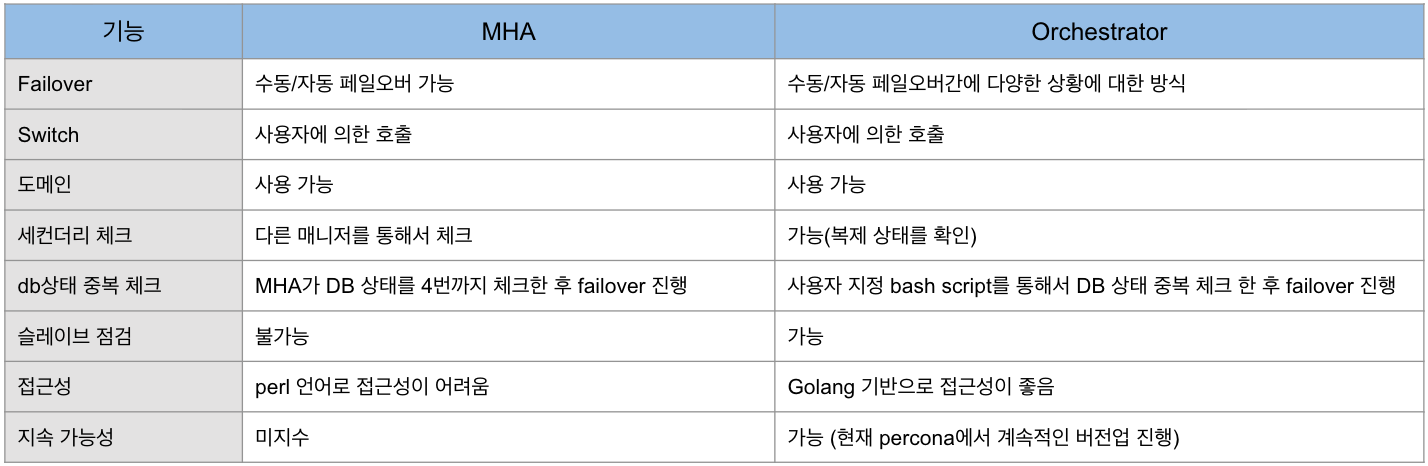
Orchestrator는 MHA와는 다르게 하나의 클러스터에서 등록된 여러 MySQL Replication Topology를 관리할 수 있습니다. 또한, MHA와 다르게 Orchestrator도 클러스터로 구성하여 Orchestrator 자체 고가용성도 확보할 수 있습니다.
MHA와 비교하여 MySQL 고가용성 확보를 위해 다음과 같은 기능을 가지고 있습니다.
2.2.1 Orchestrator 클러스터 구성 구성 방안
앞서 이야기 한대로 Orchestrator는 MHA와 다르게 Orchestrator 자체 고가용성 확보를 위한 HA 구성이 가능합니다. 또한, 하나의 클러스터에서 여러 DB 정보를 등록하여 관리하여 사용하기 때문에 대규모 MySQL 모니터링도 쉽게 구현하여 사용할 수 있습니다.
Orchestrator 클러스터 구성을 위해 다음과 같은 2가지 사항에 대해 선택이 필요합니다.
-
Meta DB 구성 방법
-
Orchestrator 프로세스 관리 방법
위 선택에 따라 총 4가지 방법으로 Orchestrator 클러스터를 구성할 수 있습니다.
[No HA]
HA 구성을 하지 않게 간단히 구성해 볼 수 있습니다. 구성이 가장 쉽고 간단한 방식으로 테스트 및 개발 환경에서 사용하는 것을 추천합니다.
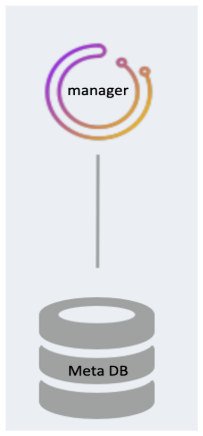
[출처 : https://github.com/openark/orchestrator/blob/master/docs/high-availability.md ]
[Semi HA]
여러 개의 Orchestrator와 하나의 Meta DB로 구성된 구조를 말합니다. Meta DB는 Source-Replica 방식으로 구성하는 것도 가능합니다. Orchestrator Manager의 HA는 제공하지 않는 구조입니다.
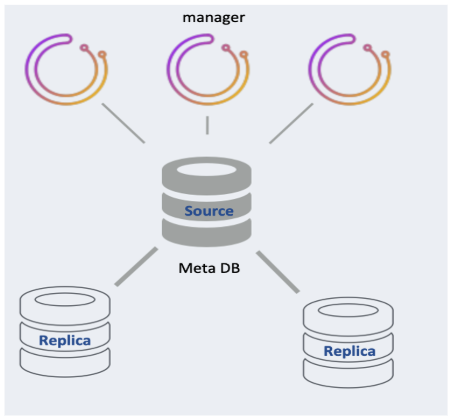
[출처 : https://github.com/openark/orchestrator/blob/master/docs/high-availability.md ]
[Shared Backend HA]
여러 개의 Orchestrator와 하나의 Cluster로 구성된 Meta DB로 구성된 구조를 말합니다. DB는 InnoDB Cluster와 같은 구조를 사용하는 것도 가능합니다. 이 구조도 마찬가지로 Orchestrator Manager의 HA는 제공하지 않습니다.
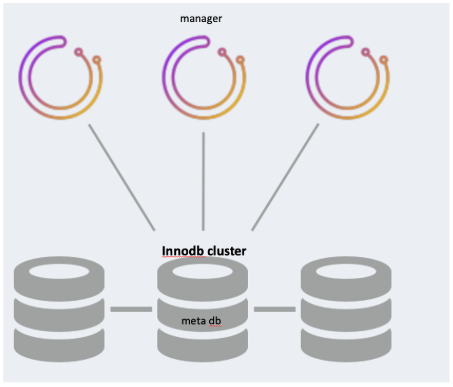
[출처 : https://github.com/openark/orchestrator/blob/master/docs/high-availability.md ]
[Raft HA]
Raft 알고리즘을 이용해 Orchestrator Manager를 클러스터로 구성한 구조를 말합니다. 클러스터 Node간에 선출된 Leader가 메인으로 동작하여 MySQL을 모니터링하고 장애를 검출합니다. Meta DB의 데이터는 Leader가 맡아서 관리합니다.
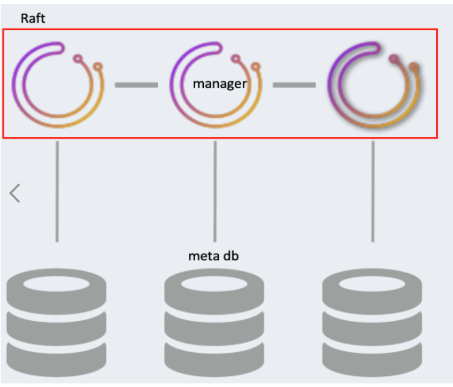
[출처 : https://github.com/openark/orchestrator/blob/master/docs/high-availability.md ]
위 4가지 구성 방법의 각각의 특징을 표로 정리하면 다음과 같이 정리할 수 있습니다.
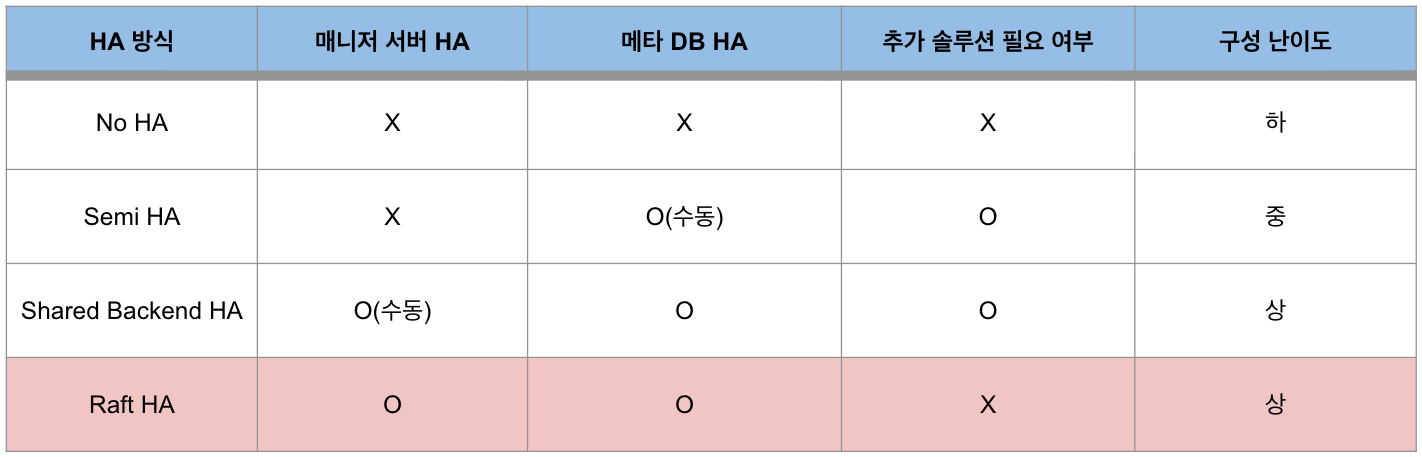
이 중 구성 난이도는 가장 높지만 안전하게 사용할 수 있는 Raft HA 구성 방법으로 Orchestrator를 구성하여 사용하기로 결정하였습니다.
3. Orchestrator 상세 구성
앞에 설명한 Orchestrator 구성을 좀 더 상세히 그림으로 표현하면 다음과 같이 그려볼 수 있습니다.
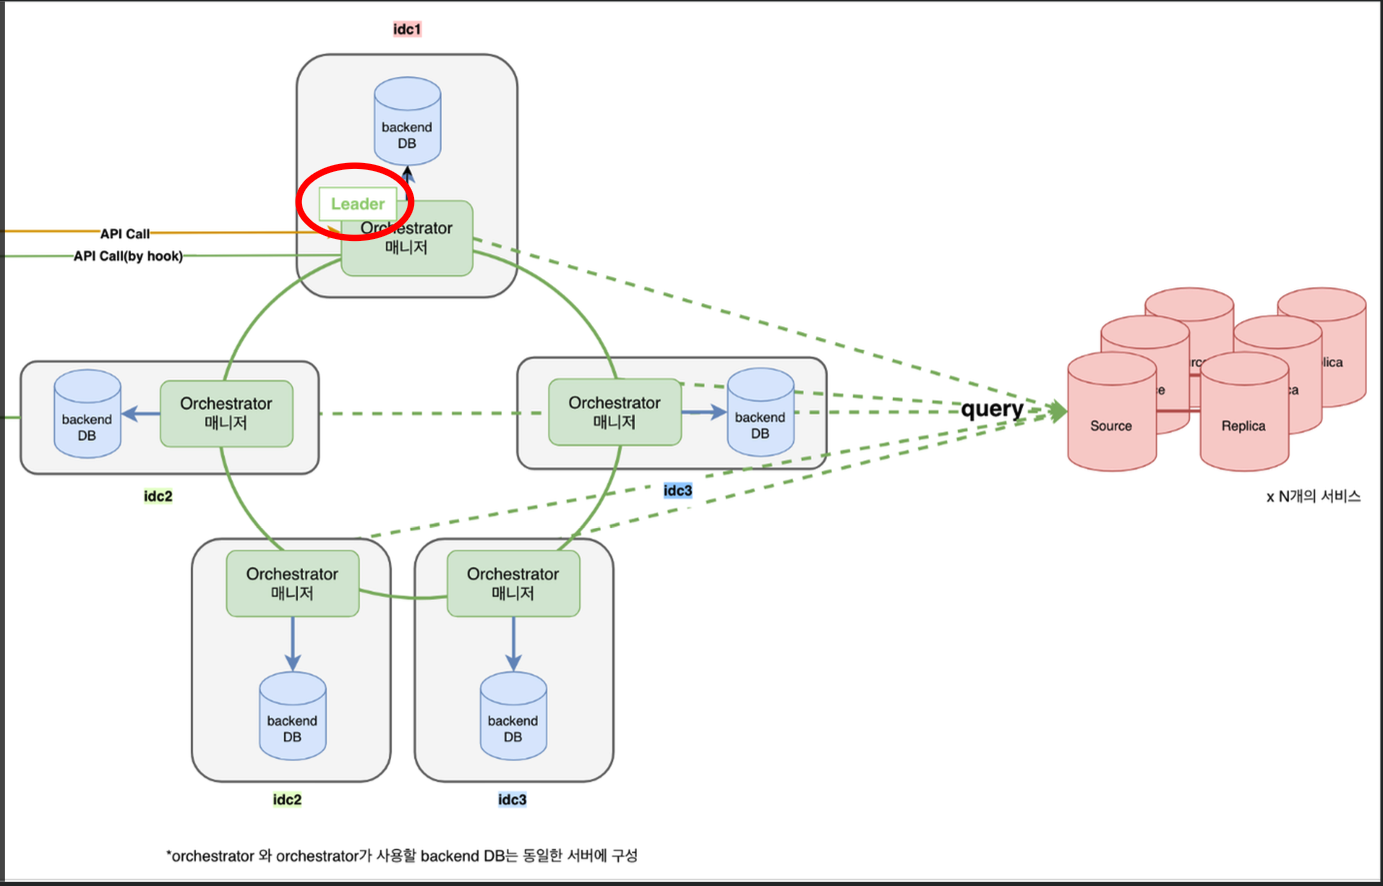
Orchestrator 프로세스에 대한 HA는 Raft 알고리즘을 통해 이루어 집니다.
[Raft 알고리즘 ]
Raft 알고리즘은 분산 시스템에서 Consensus(합의)를 이끌어내는 알고리즘으로 여러 서버가 마치 하나의 서버처럼 동작하도록 데이터의 일관성과 순서를 보장해주는 알고리즘입니다.
Raft 알고리즘으로 리더를 선출하는 과정을 간단히 정리하면 다음과 같이 표현해 볼 수 있습니다.
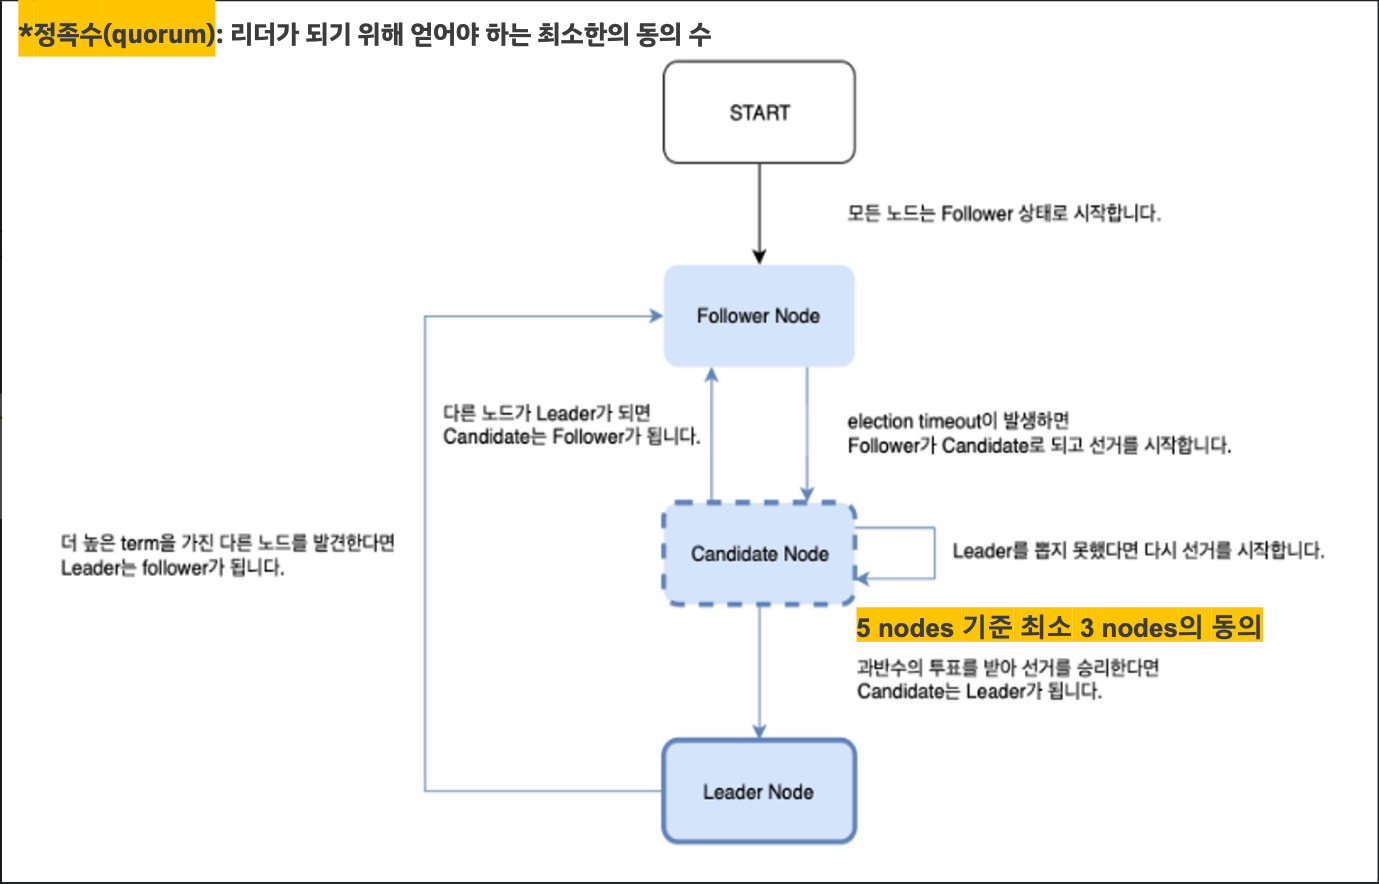
여기서 중요한 것은 정족수 입니다. 리더 선출을 위해 얻어야 하는 최소한의 동의 수 인데요. 다음의 기준으로 노드 수를 결정해야 합니다.
-
최소 3대 이상으로 구성해야 합니다.
-
홀수 노드로 구성하는 것을 권장합니다.
⇒ 짝수로 노드가 구성되어도 Raft 알고리즘의 방어 로직에 따라 Split-Brain 현상은 발생하지 않지만, 장애가 해결되어 정족수 이상의 노드가 다시 통신할 수 있을때까지 서비스가 중지되어 가용성이 떨어지게 됩니다. 또한, 한대가 적은 홀수로 노드를 구성하는 것과 장애 허용 노드 개수가 동일하기 때문에 비효율적입니다.
| 노드 구성 | 과반수(Quorum) | 장애 허용(Fault Tolerance) | 주요 시나리오 |
|---|---|---|---|
| 3개 노드 | 2 | 1개 노드 장애 | 2 vs 1로 분리: 2개 노드 그룹이 과반수를 만족하여 정상 동작 |
| 4개 노드 | 3 | 1개 노드 장애 | 2 vs 2로 분리: 양쪽 모두 과반수 실패로 전체 클러스터 서비스 불가 |
| 5개 노드 | 3 | 2개 노드 장애 | 3 vs 2로 분리: 3개 노드 그룹이 과반수를 만족하여 정상 동작 |
[Split-Brain 현상]
HA 클러스터에서 발생할 수 있는 위험한 상황을 뜻하는 용어로, 네트워크 단절 등의 문제로 2개 이상의 노드가 자신이 Primary라고 선언하여 하나의 클러스터에서 2개의 Primary가 선언되어 데이터 불일치가 일어날 수 있는 상태로 전환됨을 뜻하는 용어입니다.
Raft 알고리즘은 앞서 설명한 것과 같이 Split-Brain 현상을 막기 위해 리더 선출 최소 정족수를 과반수로 정하여 동작합니다. 또한 내부 로그 커밋도 과반수에서 진행되어야 해당 변경 사항을 커밋합니다.
4. 카카오 업무 환경에 맞게 Orchestrator 사용하기
Orchestrator의 표준을 정했지만, 실제 서비스에 사용하기에 아직은 해야 하는 일들이 많이 있었습니다. 실제 카카오 환경에 사용할 수 있게 추가 개발이 필요했습니다. 크게 2가지 부분에서 추가 개발이 필요하다고 판단하였습니다.
-
카카오 DBaaS 환경과의 연동 필요
-
카카오 내부 요구사항에 따른 커스텀 로직 추가 필요
4.1 카카오 DBaaS와의 연동 시스템 개발
카카오는 다량의 MySQL을 운영하는 환경이어서 모든 DB를 DBaaS를 구축하여 운영하고 있습니다. 그렇기 때문에 Orchestrator도 오픈 소스를 그냥 사용하는 것이 아니라, 카카오에서 사용하는 DBaaS 시스템과 연동하며 사용할 수 있게 추가 개발이 필요하였습니다. 즉, Orchestrator 운영을 위한 솔루션이 있어야 했고, 그 솔루션을 Protego라 명명하였습니다.
Protego라고 하는 이 솔루션은 다음과 같은 기능을 가지고 있습니다.
-
DB메타 정보 제공
-
Orchestrator와 카카오 DBaaS 시스템 사이의 연동 기능 제공
4.2 Orchestrator 내부로직 추가 개발 및 변경
카카오는 DBaaS를 구축하여 운영하는 환경이었고, 자체적으로 고가용성 및 사용성 확보를 위해 내부에서 요구하는 추가 요구 개발사항들이 있습니다. 오픈 소스인 Orchestrator는 내부 로직이 카카오와 맞는 부분도 있지만 맞지 않는 부분도 있었습니다.
그래서, Orchestrator 내부 로직을 최소한으로 수정하여 사용할 수 있게 카카오 버전의 Orchestrator를 만들어서 사용하기로 결정하였습니다. 이제, Orchestrator 소스 코드 내부 구성을 간단히 파악하며 어떤 부분들이 수정되었는지 알아보도록 하겠습니다.
4.2.1 Orchestrator 내부 구성 및 수정 방향
Orchestrator는 크게 내부 코드를 5가지로 구분하여 정리해 볼 수 있습니다.
-
Core Engine(Go)
-
WEB Interface
-
Client API
-
Backend DB (MySQL)
-
Hook(sh)
위 구성 요소들을 그림으로 표현하면 다음과 같이 그려볼 수 있습니다.
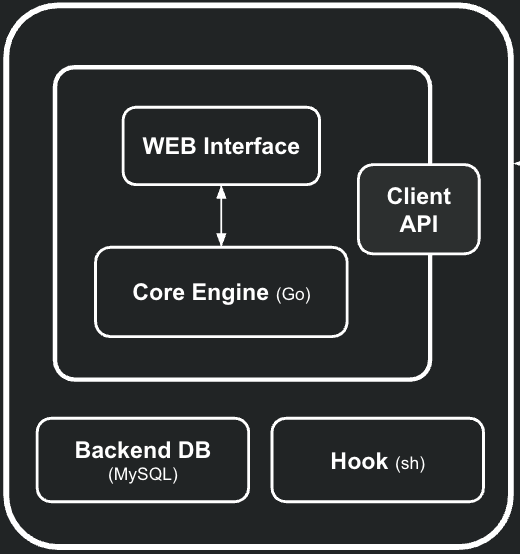
카카오에 맞게 사용하기 위해 Orchestrator 코드 수정을 하기로 결정했지만, 오픈 소스 Orchestrator의 패치 및 버전 변경 시 쉽게 적용하기 위해 다음과 같은 전제조건 하에 변경을 진행하였습니다.
-
코드 변경은 최소화 한다.
-
오픈 소스 Orchestrator 최신 버전과 커스텀한 kakao 버전의 코드 관리를 위한 배포 프로세스를 정의하여 양쪽 소스 간의 충돌로 인하여 문제가 발생하지 않도록 한다.
4.2.2 Orchestrator 수정 내용
Orchestrator 구성 요소별로 어떤 내용들이 수정되었는지 간단히 살펴보겠습니다.
[WEB Interface]
Orchestrator가 제공하는 UI 중 위험하다고 판단되는 UI는 제거하여 사용하도록 하였습니다.
[Client API]
Orchestrator는 외부와 통신할 수 있는 Client API 영역이 존재합니다. 여기에 연동 시스템인 Protego와 연동하여 사용할 수 있는 API 기능들을 추가하여 개발하였습니다.
[Hook]
Orchestrator Hook 영역을 통해 Orchestrator에서 발생하는 여러 이벤트들에 대한 알람 기능을 추가하여 사용성을 높혔습니다.
[Backend DB]
Orchestrator의 메타정보를 Protego에서 접근하여 여러 다양한 기능 구현을 위한 정보로 사용하였습니다.
4.2.3 Orchestrator 기능 추가 내용 - DNS Failover
카카오에서는 MySQL 의 Replica 서버를 서비스에 투입하여 사용하고자 하는 요구 사항이 있었습니다. MHA는 설계적으로 Replica 서버의 모니터링이 어려워 해당 요구 사항을 받아들이기 어려웠는데요. Orchestrator는 구조적으로 조금만 수정 개발하면 Replica 서버 모니터링 및 서비스 제외 기능을 개발할 수 있어서 그 기능을 개발하여 사용하기로 하였습니다.
저희가 개발한 기능은 DNS Failover로 다음과 같이 동작합니다.
-
서비스용으로 사용하는 Replica 도메인을 생성하여 맵핑
-
Orchestrator Backend DB 정보를 활용하여 Replica의 상태 정보를 체크
-
Replica 서버의 장애가 확인되면 다른 Replica 서버로 도메인 변경
다른 작업은 하지 않고, 도메인만 변경하기 때문에 DNS Failover 기능이라 부르고 있습니다. 현재는 5분 정도의 시간텀을 두어 도메인 변경을 하게 개발하였으나, 추가 요구 사항에 따라 더 고도화할 수 있을 것으로 보고 있습니다.
4.3 Orchestrator 배포/빌드 자동화
카카오는 다량의 MySQL 서버들을 운영하고 있습니다. 그래서 다수의 서버를 대상으로 Orchestrator를 안전하고 쉽게 배포/빌드하여 운영할 수 있도록 자동화하였습니다.
3가지 작업 단계로 나눠서 자동화 작업을 진행하였습니다.
-
최초 Orchestrator Cluster 구성
-
배포 작업
-
빌드 작업
[ 최초 구성 단계 ]
처음 Orchestrator Cluster 구성 시 git clone 부터 빌드/계정 생성/파일 수정 등 총 7가지 과정의 수동 작업을 스크립트로 자동화하여 휴먼에러를 최소화하고 빠르게 구성할 수 있게 자동화하였습니다.
[ 배포 작업 ]
빌드가 필요없는 코드를 배포할 때에는 각 서버에 접근하여 소스 코드를 동기화하고 (git pull), conf 파일을 클러스터에 맞게 수정을 한 후 경우에 따라 재기동을 해주어야 했다면 jenkins를 통해 배포 및 conf 설정까지 자동화하여 필요한 경우 Orchestrator 재기동만 할 수 있게 자동화 하였습니다.
[ 빌드 작업 ]
각 서버에 접근하여 소스 코드를 받고 안전한 빌드 작업을 위한 모니터링 후 빌드 작업을 진행했다면, jenkins를 통해 빌드 상태 전후 모니터링을 통해 안전하게 빌드할 수 있도록 구성하여 자동화하였습니다.
5. Orchestrator 동작 방식에 맞게 MySQL 운영하기
MHA와 다르게 Orchestrator는 MySQL의 장애를 판단하는 방법이 다릅니다. 그에 따라 이전에 사용하던 시스템 변수 값을 변경해야 하는 이슈를 확인하게 되었습니다.
Orchestrator는 MySQL 서버 상태를 세가지 값을 가지고 판단합니다.
-
Source 서버의 Select 1 쿼리의 수행 결과
-
Replica 서버의 SHOW REPLICA STATUS 결과
-
Replica 서버의 SHOW SOURCE STATUS 결과
즉, Source 서버의 Health Check 결과와 Replica 서버의 Replication 상태 정보를 기반으로 Fail-over를 결정합니다. 이 때 중요한 시스템 변수 값이 slave_net_timeout 입니다.
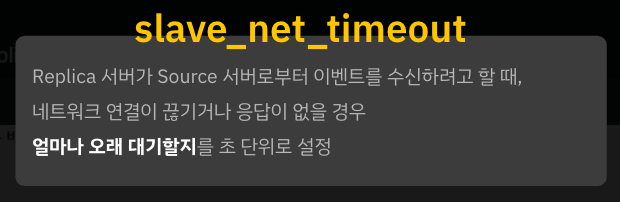
slave_net_timeout 시스템 변수는 Replica 서버가 Source 서버로 부터 이벤트 수신을 받지 못했을 때 얼마나 오래 대기할지를 결정하게 되는데요, 이 시스템 변수에 설정된 시간(초)만큼 대기한 뒤에 연결 끊김을 확정하기 때문에 Fail-over 확정 시간에 영향을 주게 됩니다.
예제를 들어 설명해 보도록 하겠습니다.
5.1 Source 서버 다운 시 동작방식
Source 서버가 문제가 발생하여 MySQL이 내려간 경우에는 다음과 같이 동작합니다.
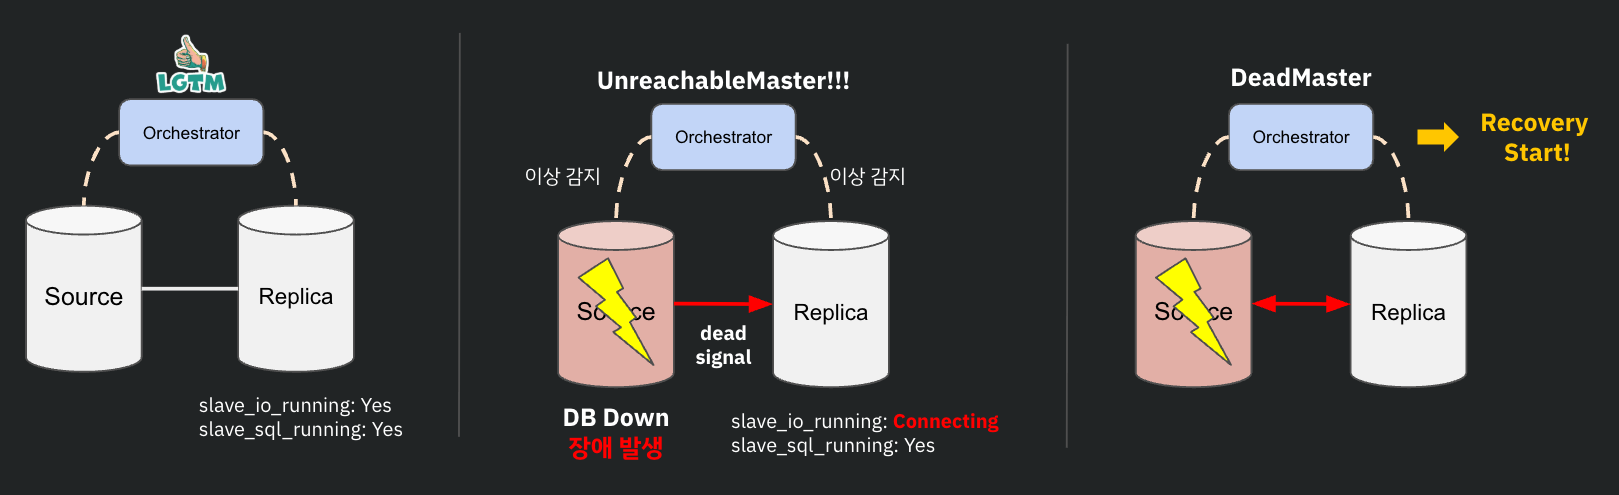
Source 서버가 Down이 되면 Orchestrator는 이상을 감지하고 UnreachableMaster 상태임을 확인합니다. 그리고 Replica 서버의 Replication 상태 정보를 확인합니다. 일반적으로 Source 서버가 Down되면 자신의 Replica 서버로 Dead Signal을 보내주는데, Replica는 이 Signal을 확인하여 Replica IO Running 상태를 Connecting으로 변경합니다. 그리고, Orchestrator는 Replication 동작 이상을 확인하게 되고 Fail-over를 확정하여 이를 진행하게 됩니다. 이때 소요 시간은 약 2초에서 6초 정도입니다.
5.2 Source 서버 이상 없이 Network에 이상만 발생한 경우의 동작방식
Source 서버의 프로세스는 이상이 없는 상태에서 Network만 이상이 발생하여 Source 서버가 제대로 사용될 수 없는 상태가 되었을 경우에는 다음과 같이 동작하게 됩니다.
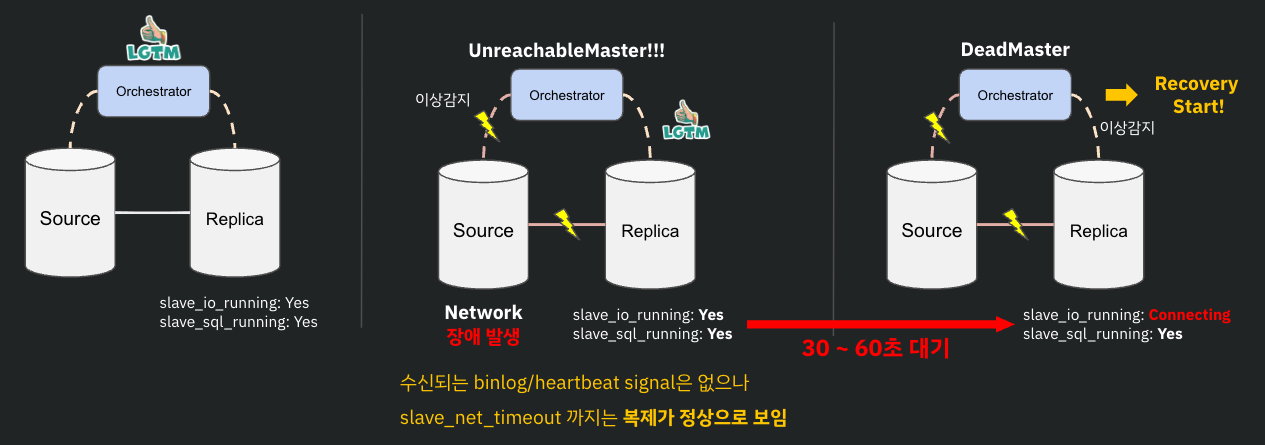
Source 서버의 프로세스에는 이상이 없는 상태에서 Network의 문제로 인해 Source 서버를 사용하지 못하게 되는 경우에는 위에 그림에서 설명한 대로 Replica 서버가 Dead Signal을 못받기 때문에 slave_net_timeout 시간까지 Replication 중지가 확정되지 않습니다. 그래서 Orchestrator는 IO Thread 동작이 멈추는 시간만큼 지연된 다음 Fail-over가 확정되어 진행됩니다.
5.3 운영 변경 사항
위의 동작 방식으로 인해 카카오에서는 MySQL 서버들의 slave_net_timeout 시스템 변수값을 변경하였습니다.
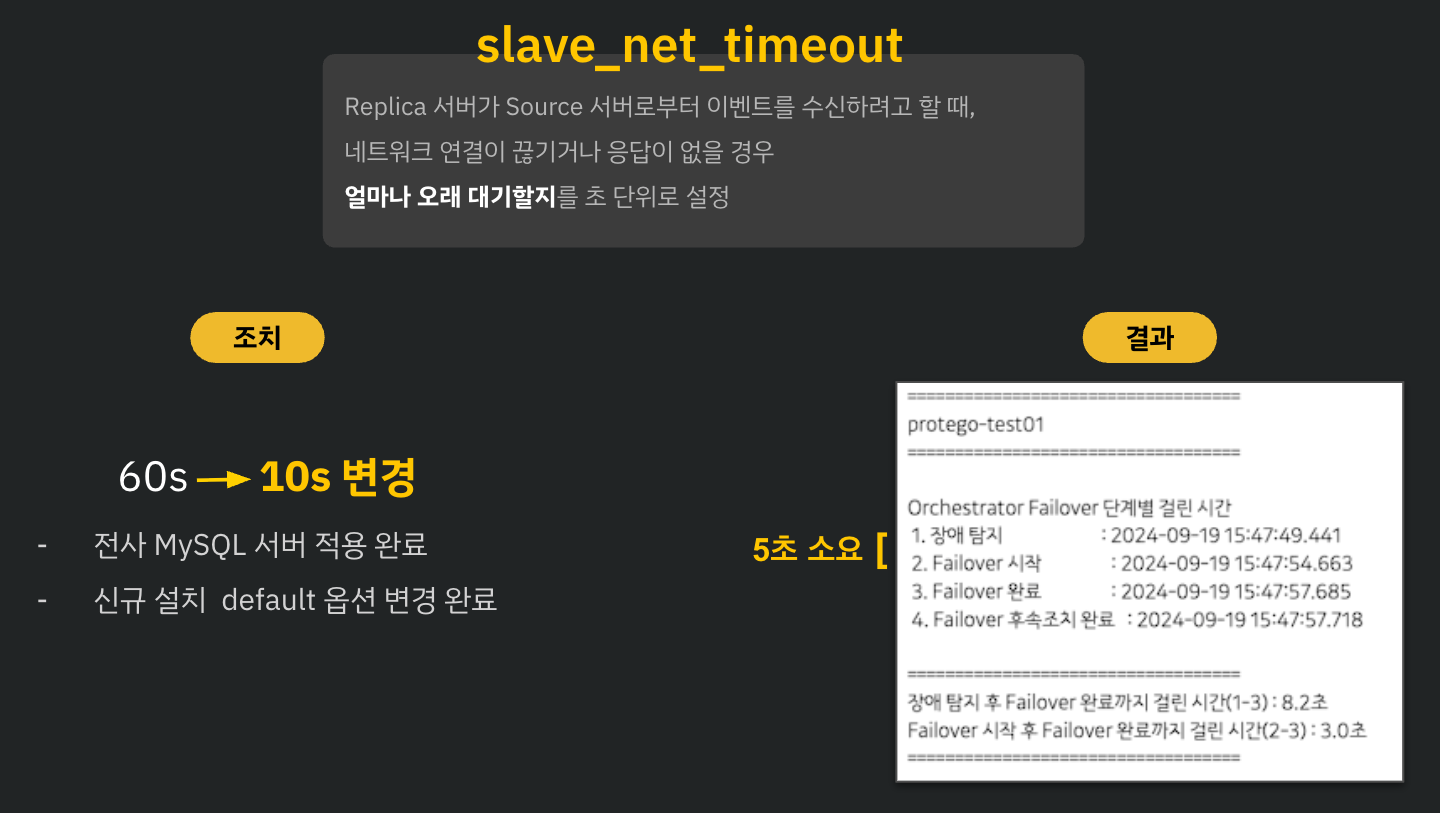
이와 같은 변경사항으로 인해 Network 장애로 인한 Fail-over 는 5초~10초 정도내로 수행되도록 개선되었습니다.
6. 결론
현재 카카오는 Orchestrator와 MHA를 함께 사용하고 있습니다. 3년 안에 모든 시스템을 Orchestrator로 통합하는 것을 목표로 전환 작업을 진행하고 있습니다. 전환이 완료되면 다음과 같은 업무적 효과를 얻을 수 있을 것으로 기대합니다.
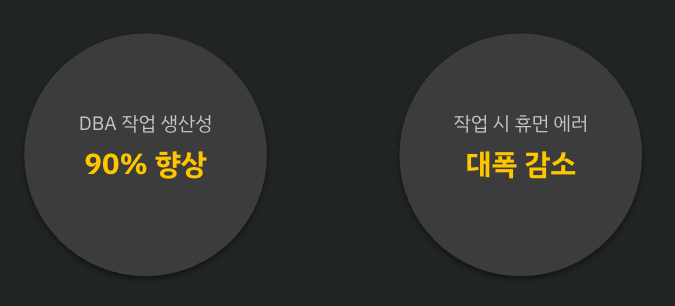
업무 생산성 향상 외에도, HA 고도화를 통한 기능적 확장에도 도움이 될 것이라고 기대하고 있습니다.
-
Network 장애로 인한 Failover 오류 제거
-
Replica 서버 모니터링 및 후속 처리 기능 추가
카카오에서 운영하는 MySQL의 고가용성을 위한 차세대 HA 표준안에 관심이 있는 많은 분들에게 좋은 정보가 되었으면 합니다.
7. 참고자료
-
MHA github repository
-
Oracle Lifetime Support
https://www.oracle.com/us/assets/lifetime-support-technology-069183.pdf
-
Rocky Linux Release and Version Guide
-
Orchestrator repository
-
MySQL Document - slave_net_timeout