Engineering
이상 탐지 1부-정상과 비정상, 그리고 이상 탐지
2023년 4월 17일
원문에서 보기 ↗
들어가며
안녕하세요. NHN Cloud의 클라우드AI팀 박현목입니다.
이상 탐지(anomaly detection)라는 용어를 한 번쯤은 들어 보셨거나, 들어 보지 않으셨더라도 그 뜻을 이해하시는 데 어려움은 없으실 것입니다. 하지만 평소 더 깊은 내용이 궁금하셨거나 지금 약간의 호기심이 생기신 분들을 위해 얕게나마 제가 알게 된 지식을 공유해 드리고자 합니다. 최대한 많은 정보를 담기 위해 4부로 나누어서 글을 연재할 예정입니다.
1부-정상과 비정상, 그리고 이상 탐지 2부-통계적 기법으로 이상 탐지하기 3부-머신 러닝으로 이상 탐지하기 4부-딥 러닝으로 이상 탐지하기
이번 글은 1부-정상과 비정상, 그리고 이상 탐지에 관한 이야기입니다.
1. 이상 탐지란?
시작하기에 앞서 다소 철학적인(?) 질문을 드리려고 합니다.
정상이란 무엇인가? 무엇으로 비정상을 구분하는가?
사실 이렇게까지 진지한 질문은 필요 없지만 제가 말하고자 했던 바는 이상(anomaly)이라는 것을 찾기 위해서는 우선 무엇이 이상인지부터 명확하게 정의할 필요가 있다는 것입니다. 여전히 명확한 정의는 힘들겠지만 한 문장으로 이상을 정의한다면 특이하고 보기 드문 사건 이라고 할 수 있습니다. '그게 명확한 정의인가?'라고 생각하실 수 있지만, 이후의 모든 이야기가 보기 드물다는 개념에서 출발한다는 것을 지금부터 천천히 알려 드리겠습니다.
다시 말씀드리면 이상 탐지(anomaly detection)란 우리만의 기준을 세워 특이한 값, 보기 드문 사건을 탐지하는 일입니다. 적절한 모델을 통해 기준선을 생성하고, 이상 징후를 미리 감지하여 경고를 보내며, 근본적인 원인을 해결하고 대비하는 것이 이상 탐지의 목적이라고 할 수 있습니다.
누군가 우리에게 미리 주식 시장의 변동성을 인지하고 경고해 준다면 좋지 않을까요?
1.1 Novelty/Outlier
위에서 제가 이상(anomaly)이란 특이한 값과 보기 드문 사건이라고 했습니다. 그럼, 이것들은 어떻게 정의할 수 있을까요? 학자들은 Novelty/Outlier라는 단어를 사용하며 아래와 같이 정의했습니다.
- Novelty: 이전과는 다른 새로운 형태의 본 적 없는 데이터
- Outlier: 다른 데이터와 비교해 확연하게 다른 데이터
정의만 두고 본다면 뭔가 알다가도 모를 것 같은 느낌이 듭니다. 하지만 이상 탐지에서 두 용어는 확실하게 구분하여 사용하고 있으며 이상 탐지의 하위 범주인 novelty detection과 outlier detection 또한 서로 명확하게 구분되고 있습니다. 간단한 이야기를 통해서 두 용어의 차이를 살펴보겠습니다.
우주 어딘가 빨간 사과와 수박만 자라는 Apple world라는 곳이 있습니다. 하지만 어떤 이유인지 수박은 오래전 사라졌고 그 생김새만 주민들 사이에서 전해져 내려오고 있었습니다. 그러던 어느 날 시장에서 사 온 사과들을 바구니에서 하나씩 꺼내던 이상이는 갑자기 손에서 이질감을 느낍니다. 뭔가 매끈매끈하고 한 손에는 잡히지도 않는 게 방금까지 꺼내던 사과와는 확연히 다릅니다! 수박을 꺼내어 살펴보던 이상이는 이것이 전설 속의 수박이라는 것을 깨닫습니다. 같은 시간 Apple world의 다른 곳에서는 초록색 사과가 발견됩니다. 주민들은 이게 사과라는 건 대충 알았지만, 그동안 한 번도 본 적 없던 초록색 사과였기 때문에 당황스러움을 감출 수 없습니다.
우선 이런 수준 낮은 이야기를 들려 드린 점 사과(🍎)드리겠습니다. 이해를 돕기 위해 억지로 이야기를 만들어냈지만, Novelty와 Outlier의 특징이 이 이야기에 모두 담겨 있습니다. 이미 눈치채셨겠지만, 이 이야기에서 Novelty는 초록 사과, Outlier는 수박입니다. Novelty의 가장 큰 특징은 본 적 없다 는 것입니다. 모든 조건을 떠나 우리가 처음 보는 데이터라면 그것은 Novelty로 정의됩니다. Outlier의 특징은 다르다 는 것입니다. 이미 알고 있는지가 중요한 것이 아니라 지금 우리가 가지고 있는 데이터 바구니와 다른지가 Outlier를 구분하는 방법입니다. 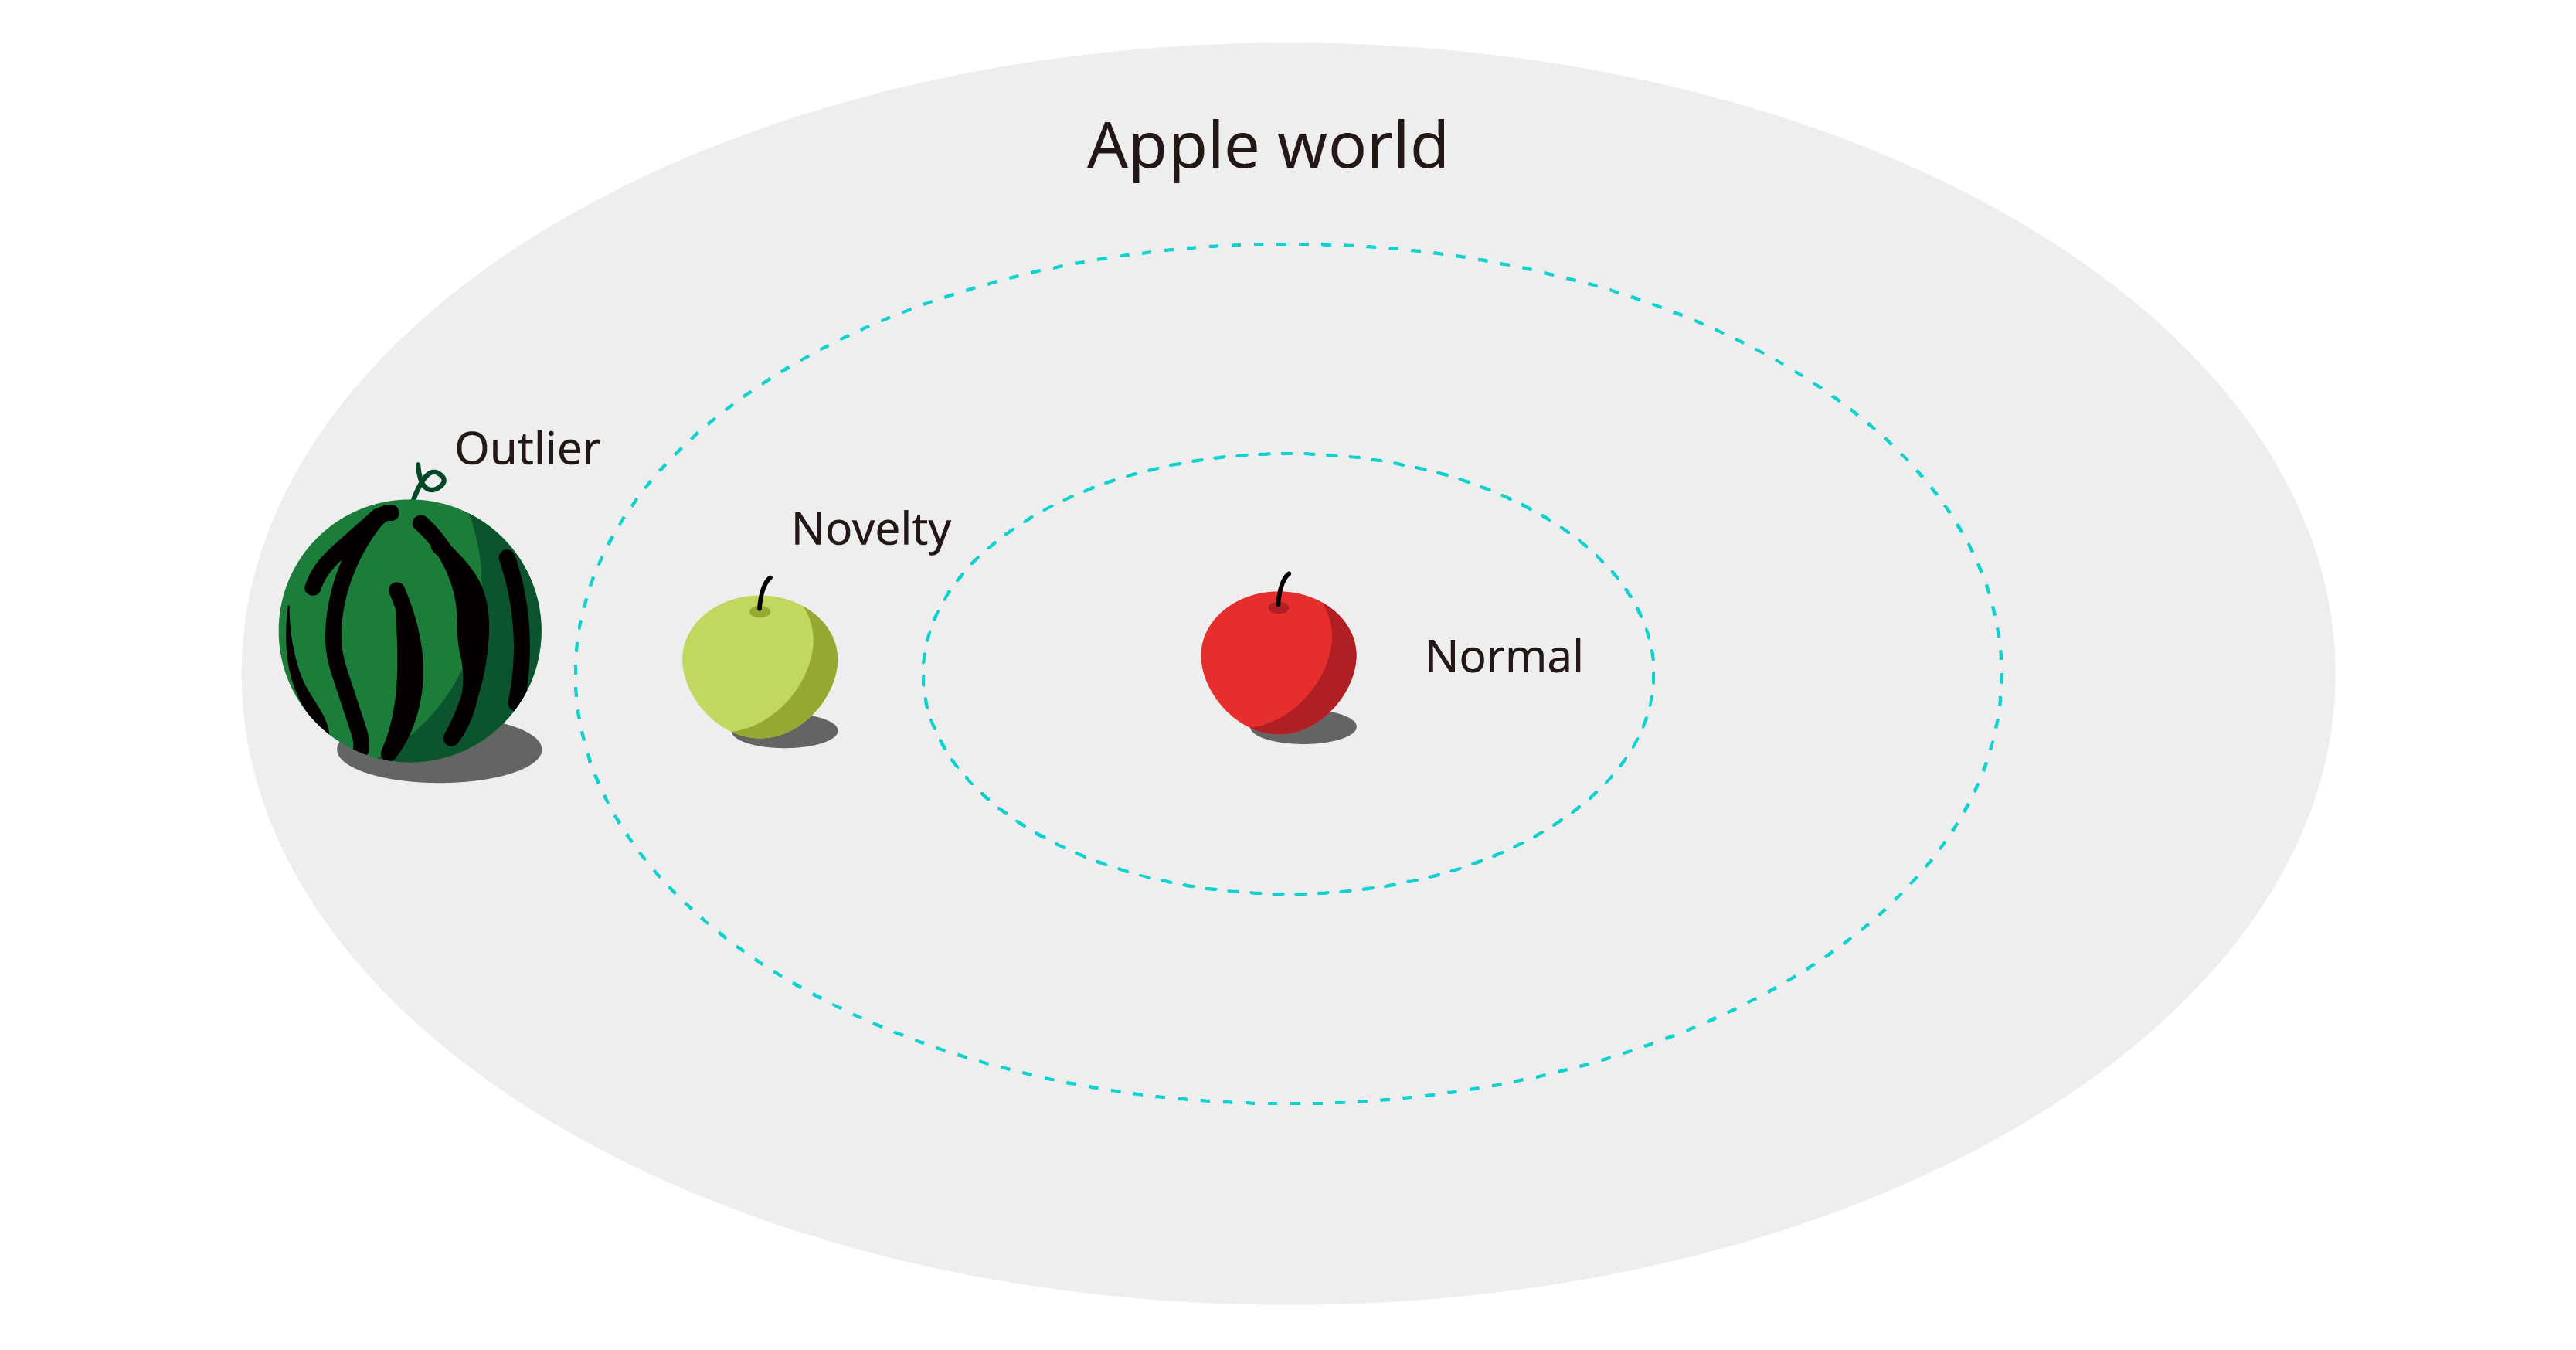
Q) Novelty=정상, Outlier=비정상?
위의 그림만 본다면 'Novelty는 조금 특이한 데이터일 뿐 비정상 데이터는 아니지 않을까? Outlier만 찾아내면 되는 것 아닌가?' 하는 생각이 듭니다. 두 질문 모두 틀린 말은 아니지만, 엄밀히 따지면 질문부터 잘못되었습니다. 흔히 알고 있는 비정상(abnormal)과 이상 탐지에서의 이상(anomaly)은 유사하지만 다른 뜻을 가지고 있습니다. 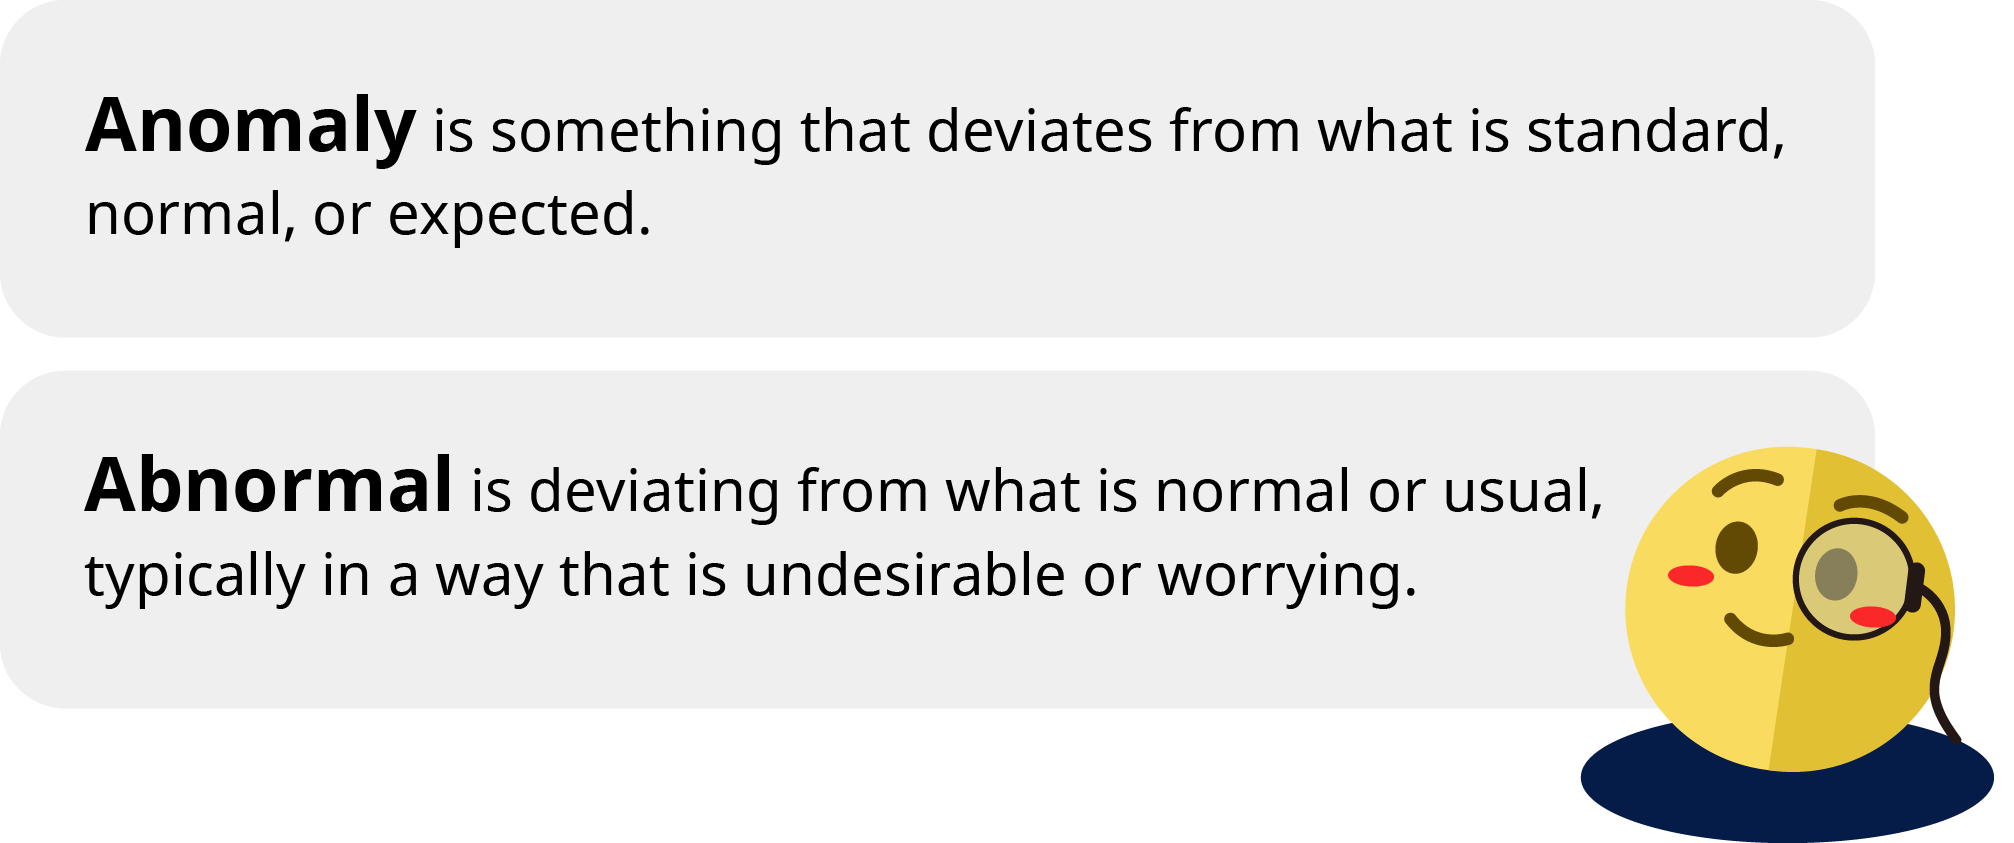 비정상(abnormal)은 일반적인 관점에서 바람직하지 못한 행위를 일컫습니다. 하지만 이상(anomaly)은 행위보다는 데이터에 대상을 두고 있으며 기존과 다르다는 것에 초점을 두고 있습니다. 위에서 이상 탐지는 특이한 값, 보기 드문 사건을 사전에 탐지하는 기법이라고 말씀드렸습니다. 따라서 이상 탐지는 비정상(abnormal)보다는 이상(anomaly)을 찾는 것에 목적을 둡니다. 다만 편의상 비정상(abnormal), 이상(anomaly)을 같은 의미에서 사용하곤 합니다.
1.2 Novelty Detection vs Outlier Detection
이제 두 데이터가 어떤 차이가 있는지 확실히 구분할 수 있게 되었습니다. 그렇다면 방법론 면에서는 어떤 차이를 두고 있을까요? 두 방법론을 구분하는 기준은 학습 데이터의 특성과 탐지 대상 영역에 있습니다. 이해를 돕기 위해 아래의 표에 정의, 데이터 특성, 이상 탐지에서 부르는 용어를 기준으로 두 가지 기법을 정리했습니다. 길게 써 놓았지만, 핵심은 어떤 데이터를 학습하고 어디서 이상 데이터를 찾을 것이냐입니다.
| 정의 | 학습 데이터 특성 | 탐지 대상 | 이상 탐지 | |
|---|---|---|---|---|
| Novelty detection | 새로운 데이터가 학습된 데이터 분포에 포함되는지 여부를 판단 | 정상 데이터로만 구성 | 새로운 입력 | Semi-supervised anomaly detection |
| Outlier detection | 학습 데이터 내에서 데이터들이 가장 많이 집중된 영역을 찾아내고 그 외의 데이터를 제거하는 것 | 정상/이상 데이터가 모두 존재 | 학습 데이터 내에서 제거 | Unsupervised anomaly detection |
위에서 Novelty는 본 적 없는 데이터라고 했습니다. 그래서 novelty detection의 목표는 말 그대로 본 적 없는 데이터를 찾아내는 것입니다. 그리고 본 적이 없다는 것은 학습 데이터에 의해 결정됩니다. 위의 사과 문제에서 모델이 빨간 사과만 학습했다면 모델 입장에서는 초록 사과, 수박 모두 본 적 없는 데이터(novelty)가 되는 것입니다. 반대로 수박과 초록 사과만을 학습한다면 이제는 오히려 빨간 사과가 본 적 없는 데이터가 되는 것입니다. 이렇게 학습 데이터를 어떻게 구성하는지에 따라 novelty의 기준이 달라질 가능성이 있으며, 오직 새롭게 입력되는 데이터를 대상으로 테스트를 진행합니다.
반면에 outlier detection의 학습 데이터는 정상/이상 데이터가 모두 존재합니다. 모델의 목표는 주어진 학습 데이터에서 가장 많은 데이터가 집중된 영역을 찾아내어 영역 밖의 데이터(outlier)를 제거하는 것입니다. 따라서 별도의 테스트 데이터를 필요로 하지 않습니다. 이러한 특성들 때문에 novelty/outlier detection을 이상 탐지에서는 semi-supervised/unsupervised anomaly detection이라고 부릅니다.
어렵다! 뭐가 더 좋냐? 그냥 잘되는 것 하나만 쓰면 안 될까?
단도직입적으로 말씀드리면 데이터 때문에 그러고 싶어도 못합니다. 아래에서 다시 설명하겠지만, 이상 탐지는 정상/이상 데이터 간의 불균형이 매우 심한 분야입니다. 더 나아가 무엇이 정상/이상 데이터인지도 명확하게 구분하기 어렵습니다. 지금 우리가 확보한 데이터가 모두 정상인 줄 알고 novelty detection을 적용했지만, 나중에 알고 보니 이상 데이터가 섞여 있었다면...? 😨
따라서 현재 가지고 있는 데이터에 맞추어 두 가지 중 적절한 방법을 택하는 것이 좋은 이상 탐지를 위한 첫 번째 단계라고 할 수 있습니다. 아래에서 간단한 예시만 소개하고 두 기법에 대한 설명은 마치겠습니다.
Novelty Detection in Anomaly Detection
아래의 그림에서 하얀색 점이 학습 데이터이며 보라색 점은 정상 데이터, 노란색 점은 비정상 데이터입니다. 빨간 선으로 표시된 영역이 모델이 찾아낸 학습 데이터의 분포이며, 이때 새로운 데이터가 그 안에 들어온다면 정상 데이터로 간주합니다. 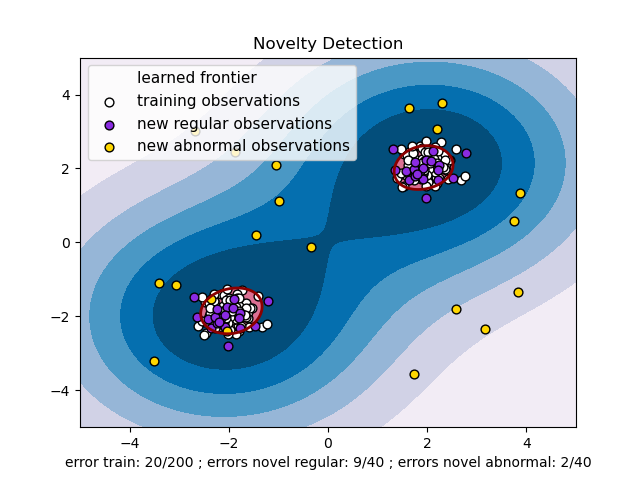
Outlier Detection in Anomaly Detection
학습 데이터를 잘 설명할 수 있는 분포를 찾아낸다는 것은 novelty detection과 유사하지만, 이번에는 모든 데이터를 잘 설명할 수 있도록 강요하지 않습니다. 아래의 그림은 Local Outlier Factor라는 대표적인 outlier detection 모델의 예시입니다. 검은 점으로 표현된 데이터 중에서 밀집도가 높은 영역의 데이터들은 빨간 원으로 표현된 outlier score가 높지 않다는 것을 확인할 수 있습니다. 하지만 밀집도가 낮은 데이터들은 outlier score가 높게 나타나고 있습니다. 학습 데이터 내에서 이러한 군집들을 찾아내는 것이 outlier detection의 주목적이라고 할 수 있습니다. 유명한 군집화 알고리즘들(예: K-means 등)이 outlier detection에 자주 사용됩니다. 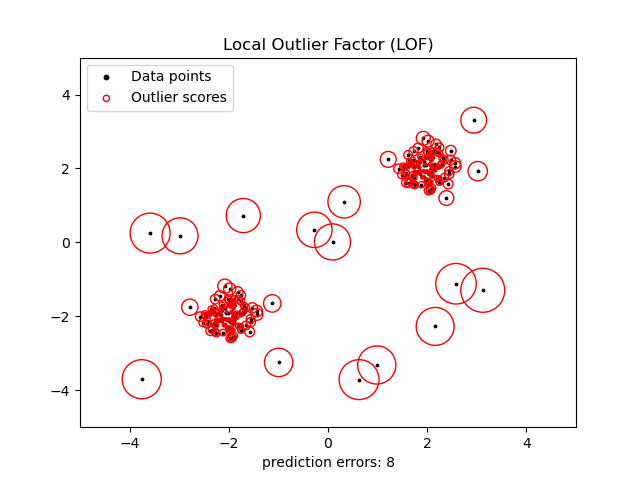
2. 이상 탐지에서 사용하는 데이터
2.1 데이터의 종류
이상 탐지에 사용되는 데이터는 특별한 제한은 없으며 탐지하고자 하는 목표, 대상이 무엇인지에 따라 다양한 데이터를 사용할 수 있습니다. 서버의 정상 작동 여부를 검사한다면 CPU, 메모리, 트래픽 등 서버 동작 과정에서 추출할 수 있는 모든 데이터를 사용할 수 있습니다. 제조 설비에서는 공정 검사를 위해 제품의 외관 이미지를 사용할 수도 있습니다. 이렇게 목적과 분야에 따라 다양하게 이상 탐지가 적용될 수 있습니다.
- 이상 거래 탐지(fraud detection): 보험, 신용, 금융 관련 데이터에서 불법 행위를 검출하는 문제
- 의료 이상 탐지(medical anomaly detection): 의료 영상, 뇌파 기록 등의 의학 데이터에서 이상치를 탐지하는 문제
- 산업 이상 탐지(industrial anomaly detection): 제품 외관 검사, 장비 결함 등 제조업 데이터에서 이상치를 탐지하는 문제
- 로그 이상 탐지(log anomaly detection): 시스템의 로그를 보고 문제, 실패 원인을 추적하는 문제
몇 개의 데이터를 동시에 사용하는지에 따라 다르게 구분하기도 합니다. 하나의 데이터만 사용한다면 단변량(univariate), 여러 개의 데이터를 동시에 사용한다면 다변량(multivariate)이라고 합니다. 이상 탐지에서는 변수들 간의 연관성도 중요한 요소로 작용하기 때문에 단변량, 다변량을 구분하는 것이 매우 중요합니다.
또한 CPU 사용량처럼 순차적으로 발생하는 연속적인 관측치를 시계열 데이터(time-series)라고 부르며 이후로는 시계열 데이터를 중심으로 설명을 이어가겠습니다.
2.2 시계열에서의 이상 데이터
시계열 데이터에서의 이상하다는 것은 무엇을 의미할까요? 일반적으로 시계열 데이터는 값 자체(평균, 최댓값, 최솟값)도 중요하지만 규칙성도 중요한 요소로 작용합니다. 또한 시계열 데이터의 특성상 비정상 데이터가 단기적 또는 장기적으로 나타날 수도 있습니다. 이러한 특성에 따라서 시계열에서의 이상 데이터를 아래와 같이 분류합니다. 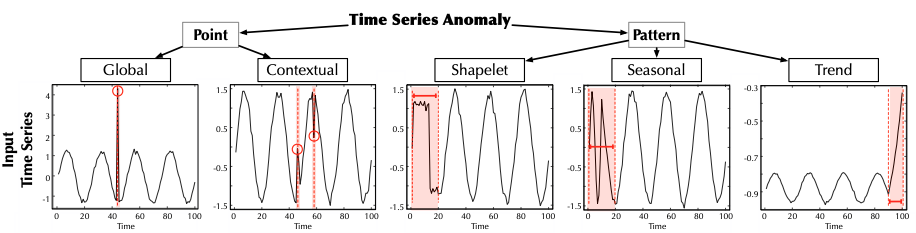 우선 이상 데이터가 나타나는 기간에 따라 크게 Point time-series anomaly 와 Pattern time-series anomaly로 구분합니다.
Point time-series anomaly
- Global anomaly: 전체 시계열(예시에서는 100 steps)을 고려했을 때 그 값이 정상적인 범주를 크게 벗어나는 데이터를 의미합니다.
- Contextual anomaly: 인접한 시계열 데이터를 고려했을 때 약간의 변칙이 존재하는 데이터를 의미합니다.
Pattern time-series anomaly에서는 자주 사용되는 용어가 있습니다.
- Shapelet: 시계열 데이터에서 중요한 특성을 가지고 있는 시퀀스를 의미합니다.
- Cycle(순환성): 정해지지 않은 빈도, 기간으로 일어나는 상승 혹은 하락을 의미합니다.
- Trend(추세): 데이터가 장기적으로 증가하거나 감소하는 흐름을 의미합니다.
- Seasonality(계절성): 일정한 주기를 가지고 반복되는 패턴을 의미합니다. 순환성과 비슷하지만 주기를 가진다는 차이점이 있습니다.
Pattern time-series anomaly
- Shapelet anomaly: 전체 시계열에 존재하는 일반적인 shapelet과 다른 shapelet, cycle을 가진 부분 시계열을 의미합니다.
- Seasonal anomaly: 모양이나 트랜드는 유사하지만 시계열의 계절성에서 벗어나는 부분 시계열을 의미합니다.
- Trend anomaly: 시계열의 추세에 영구적인 변화를 주는 부분 시계열을 의미합니다.
3. 이상 탐지가 어려운 이유
3.1 도메인 지식
이상 탐지가 어려운 데에는 여러 이유가 있지만, 근본적인 이유는 도메인에 대한 지식이 부족하다는 점입니다. 기본적으로 정상/이상 데이터를 구분하기 위해서는 무엇이 정상인지 파악해야 합니다. '그냥 의도치 않은 동작을 이상으로 해석하면 되는 것이 아니냐?'는 의문을 가질 수도 있지만 그렇게 간단하지만은 않습니다. 일반적인 상황에서 이상 데이터는 매우 희귀하며 명확하지 않은 경우가 많습니다. 마치 원효대사의 해골물 이야기처럼 우리는 이상하다는 걸 아예 느끼지도 못하고 넘어갈 수도 있습니다. 따라서 도메인에 대한 지식이 충분하지 않다면 정상/이상 데이터가 뒤섞이는 문제(anomaly contamination)가 발생할 수 있습니다.
또한 데이터가 생성, 측정되는 과정에 대한 깊은 이해가 필요합니다. 데이터 측정 과정에서 발생하는 노이즈, 손상은 반드시 전처리 과정을 거쳐야 하는데 이때 충분한 도메인 지식이 없다면 나중에 많은 문제가 발생할 수 있습니다.
3.2 데이터 불균형
위에서도 말씀드렸듯 일반적으로 이상 데이터는 매우 희귀하며 명확하지 않습니다. 매우 적은 양의 이상 데이터와 상대적으로 많은 양의 정상 데이터를 함께 혼합해 머신 러닝에 사용한다면 성능이 나빠질 가능성이 매우 높습니다. 일반적으로 비정상 데이터가 정상 데이터의 10%보다 적은 경우 단순 분류(classification) 머신 러닝을 권장하지 않습니다. 이상 탐지에서는 비정상 데이터가 극히 드물기 때문에 아직까지는 정상 데이터만 학습시키는 비지도 학습이 대세를 이루고 있습니다.
나가며
이번 글에서는 이상 탐지가 무엇인지 간략하게 소개했습니다. 평소 이상 탐지에 대해 관심이 있으셨다면 조금이나마 더 도움이 되셨길 바라며, 이상 탐지가 무엇인지 잘 모르셨다면 좋은 정보를 얻어간 시간이 되셨길 바랍니다! 다음 글은 2부-통계적 기법으로 이상 탐지하기로 간단한 예시와 함께 공유 드리도록 하겠습니다.
긴 글 읽어주셔서 감사합니다. 😀
다음 글 미리보기
이미지 출처 및 참고 자료
- scikit-learn developers, 2.7. Novelty and Outlier Detection, scikit-learn.org
- Data Science Digest, What’s the difference between novelty detection and outlier detection?, Jun 16, 2021
- Jiehui Xu 외, Anomaly Transformer: Time Series Anomaly Detection with Association Discrepancy, arxiv, 29 Jun 2022