Engineering
AI 인프라 설계의 기술적 레퍼런스, <NHN FactoryX 기술 백서>를 소개합니다
2026년 7월 13일
원문에서 보기 ↗
어제의 경험으로 내일의 변화를 만들어 내는 공장, NHN FactoryX
필요한 만큼의 GPU를 사서 랙에 꽂으면 AI 인프라가 완성될까요? 🤔
실제로 대규모 GPU 클러스터를 운영해 본 팀이라면, 장비 구매는 끝이 아니라 시작이라는 것을 알 수 있습니다. 수백 장의 GPU가 동시에 통신을 시도하는 순간 네트워크에 병목이 발생하고, 학습 데이터를 읽어오는 속도가 GPU 연산을 따라가지 못해 고가의 장비가 데이터를 기다립니다. 최신 AI GPU 랙의 전력 밀도는 60~90kW에 달하지만 공랭식 냉각의 실질적 한계는 30kW 부근이라 그 이상에서는 GPU 온도를 억제할 수 없고, 결국 시스템이 스스로 성능을 깎아내리기 시작합니다.
GPU를 '사는 것'과 GPU를 'AI 인프라로 만드는 것'은 완전히 다른 문제입니다. 그리고 이 간극을 메우는 데 필요한 기술적 의사결정은 생각보다 많고, 예상보다 깊습니다.
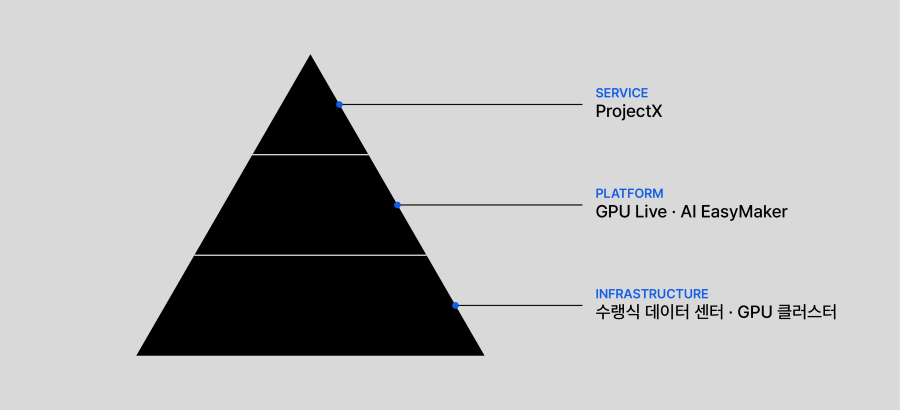
NHN FactoryX는 NHN Cloud가 7년 이상의 GPU 인프라 운영 경험을 바탕으로 만든 AI 워크로드를 위한 풀스택 환경입니다. NHN FactoryX 서울 데이터 센터에 4,080장의 GPU를 단일 클러스터로 묶어 FP8 기준 27.4 EFLOPS 규모의 연산 능력을 확보했습니다. 구조는 세 개의 계층으로 나뉩니다. 맨 아래에서 수랭식 데이터 센터와 GPU 클러스터(Infrastructure)가 물리적 기반을 제공하고, 그 위에서 GPU Live와 AI EasyMaker(Platform)가 GPU 자원의 동적 할당과 ML 파이프라인을 담당하며, 최상위에는 ProjectX(Service)가 위치해 기업 전용 AI 에이전트 개발·연동 환경을 제공합니다. 현재 산업계·학계·공공 기관이 이 플랫폼 위에서 LLM 학습, 멀티모달 AI 연구, 추론 서비스를 운영하고 있습니다.
이번에 발간한 〈NHN FactoryX 기술 백서〉는 이 중 인프라와 플랫폼 영역의 설계 근거를 약 60여 페이지에 걸쳐 풀어 설명한 기술 백서입니다.
NHN FactoryX의 모든 것, 〈NHN FactoryX 기술 백서〉
AI 인프라의 도입은 더 이상 장비 구매가 아니라 기술 검증을 동반하는 의사결정 프로세스입니다. GPU 모델 사양만 비교해서는 안 되며, 인터커넥트 토폴로지, 스토리지 I/O, 네트워크 병목 대응, 냉각 설계, 선형 확장성까지, 풀스택 관점의 설계를 동시에 고민해야 합니다. 이 전체를 한 곳에서 체계적으로 다룬 자료가 부재했기 때문에 NHN Cloud는 AI 인프라 요구 사항에 NHN FactoryX가 어떻게 답하고 있는지를 하나의 문서로 정리한 기술 백서를 발간했습니다.
이 백서는 위에서 다룬 NHN FactoryX의 세 레이어 가운데 인프라와 플랫폼, 즉 AI 워크로드를 물리적으로 지탱하고 자원을 지능적으로 배분하는 두 레이어의 설계 철학과 기술 근거를 담고 있습니다. 백서는 먼저 기존의 범용 클라우드 인프라가 AI 워크로드에 대응하기에 어떤 점에서 한계가 있는지 짚는 데서 출발합니다. 기존 데이터 센터는 CPU 중심 연산, 공랭식 냉각, 이더넷 기반 네트워크를 전제로 설계되어 범용 워크로드에는 효율적이지만, 대규모 AI 학습에서는 구조적 병목에 직면합니다. 이 한계를 넘기 위해 NHN FactoryX가 어떤 설계 선택을 했는지를, 다음 네 개의 핵심 영역으로 정리합니다.
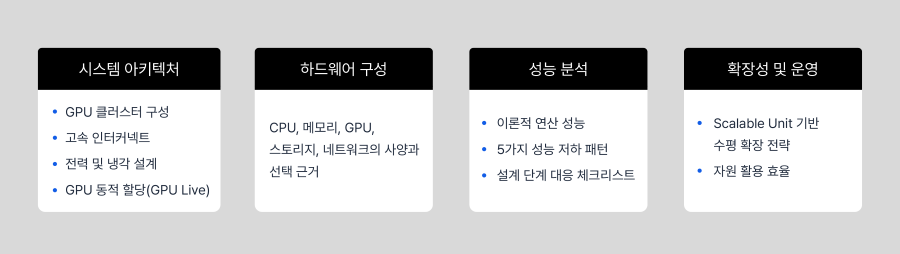
각 영역은 독립적으로 참조할 수 있지만, 풀스택 관점에서 서로 연결되어 있습니다. 여기에서는 이 백서가 다루는 질문 중 핵심이 되는 내용을 간략하게 훑어보고자 합니다.
〈NHN FactoryX 기술 백서〉 훑어보기
"왜 공기로는 안 되나요?" - 공랭식 냉각의 구조적 한계
AI GPU의 전력 밀도는 세대마다 가파르게 올라가고 있습니다. A100 시절에는 랙당 13~39kW 수준이었지만, 최신 B200/B300 세대에서는 랙당 90kW에 육박합니다. 문제는 여기서 발생합니다. 공기의 체적 열용량은 물의 약 1/3,500에 불과합니다. 같은 열을 제거하려면 공기는 물보다 3,500배 많은 양이 필요하다는 뜻입니다. 랙당 전력 밀도가 30kW를 넘는 순간부터 공랭식은 열역학적 한계에 부딪힙니다.
〈NHN FactoryX 기술 백서〉는 이 한계를 ASHRAE 등급 기준과 CFD 시뮬레이션 연구를 인용해 구조적으로 짚어보고, D2C 수랭식 도입 시 반드시 검증해야 할 다섯 가지 요건(벤더 호환성, 인터페이스 표준화, 운전 파라미터, 확장성, 수질 관리)을 하나하나 설명합니다. NHN FactoryX는 이 과정을 거쳐 프리쿨링 연계 운전으로 PUE 1.15 이하를 달성할 수 있는 구조를 만들었습니다. 공랭식 대비 연간 냉각 에너지를 약 30~40% 절감할 수 있는 수치입니다.
자세한 내용은 👉〈NHN FactoryX 기술 백서〉 2.3절 전력 및 냉각 설계에서 확인하실 수 있습니다.
"GPU 수천 장을 어떻게 나눠 쓰나요?" - GPU Live의 설계 철학
GPU 클러스터를 팀별로 고정 배정하면 운영은 단순하지만, 대규모 클러스터 트레이스 분석에서 자원 활용률이 한 자릿수에서 30%대에 머무르는 사례가 보고되어 왔습니다.
GPU Live는 이 문제를 동적 할당 기술로 풀되, 자체 스케줄러를 새로 만들지 않고, Kubernetes 표준 생태계의 검증된 컴포넌트 위에 NHN FactoryX 환경에 맞는 운영 정책을 얹는 방식을 택했습니다. GPU 드라이버 업데이트나 분산 학습 프레임워크의 변화를 표준 경로로 흡수할 수 있고, 향후 NPU 같은 이종 가속기가 등장해도 동일한 표준 인터페이스로 통합이 가능하도록 하기 위함입니다.
그 위에 GPU Live가 직접 설계한 영역이 있습니다. 3계층 멀티테넌시(System → Organization → Project)로 조직 간 자원·정책·권한을 격리하고, GPU 기준 Best-fit 빈패킹으로 단편화를 줄이며, 쿼터·오버부킹·자동 회수를 결합해 활용률을 끌어올립니다. 학습 워크로드는 Gang Scheduling으로 일괄 시작·종료하고, 추론 워크로드는 인스턴스 단위로 장애 복구와 재배치를 처리합니다. 같은 GPU 풀에서 성격이 전혀 다른 두 워크로드를 안정적으로 수용하는 구조입니다.
자세한 내용은 👉〈NHN FactoryX 기술 백서〉 2.4절 GPU 동적 할당 기술(GPU Live)에서 확인하실 수 있습니다.
"베어메탈이면 충분하지 않나요?" — GPUaaS를 선택한 이유
베어메탈 방식은 GPU 자원을 물리 서버 단위로 직접 할당하므로 하드웨어 성능을 최대한 활용할 수 있습니다. 다만 다수의 사용자가 동일 인프라를 공유할 경우 테넌트 간 보안 격리가 보장되지 않고, 테넌트별 환경 구성이 상이하여 장애 발생 시 일관된 운영 정책을 적용하기 어렵다는 한계가 있습니다.
NHN FactoryX는 이 한계를 극복하기 위해 GPU 인프라 상위 계층에 GPUaaS 플랫폼을 구축하는 방식을 택했습니다. 테넌트·워크스페이스·프로젝트로 이어지는 계층적 구조를 기반으로 자원과 보안 통제를 일관되게 적용하고, 한 기관에서 대규모 학습으로 자원 사용량이 급증하더라도 다른 기관의 서비스에는 영향이 없는 격리 구조를 실현했습니다. 실제로 957개 GPU 노드 위에서 산업계·학계·연구계의 다수 기관이 독립된 워크스페이스를 운영하고 있습니다.
서비스 계층이 추가되면 네트워크 병목으로 인한 성능 저하가 우려될 수 있지만, NHN FactoryX는 GPUaaS 플랫폼 환경에서 255노드 규모의 HPL(High Performance Linpack) 벤치마크를 수행해 베어메탈과 동일한 수준의 성능을 확인했습니다. 컨테이너가 호스트 수준의 네트워크 성능을 유지하도록 설계한 결과입니다.
자세한 내용은 👉〈NHN FactoryX 기술 백서〉 06장 활용 사례에서 확인하실 수 있습니다.
마치며
이 글에서는 〈NHN FactoryX 기술 백서〉의 핵심 내용 중 일부를 살펴보았습니다. 백서 전체를 관통하는 메시지를 한 문장으로 요약해 보면 이렇습니다. AI 인프라는 개별 하드웨어의 성능 향상을 넘어, 물리적 공간 설계부터 전력 및 냉각 효율, 초고속 네트워크 튜닝, 소프트웨어 정의 기반의 관리 플랫폼까지 모든 요소가 유기적으로 통합되어야 합니다.
NHN FactoryX는 이 통합을 하나의 공간에서 실현합니다. 수랭식 데이터 센터 위에 GPU 클러스터를 구성하고, GPUaaS 플랫폼으로 자원을 관리하며, AI 개발 플랫폼까지 3개 레이어를 풀스택으로 제공합니다. 동일한 GPUaaS 아키텍처 위에서 멀티테넌트 공유 환경과 기업 프라이빗 전용 환경이 모두 구현되며, 957개 GPU 노드 규모에서 베어메탈 동등 수준의 성능과 조직 간 보안 격리를 동시에 달성하고 있습니다.
AI 인프라는 현재진행형입니다. GPU 세대 전환에 따른 전력 밀도 증가, Kubernetes DRA를 비롯한 자원 관리 표준의 진화, NPU 등 이종 가속기의 등장은 인프라 설계의 전제 조건을 지속적으로 변화시킵니다. NHN FactoryX는 차세대 GPU 플랫폼까지의 상위 호환성을 전제로 수랭식 인프라를 설계하였으며, GPU Live의 동적 할당 모델을 이종 가속기로 확장하기 위한 기술 검토를 진행하고 있습니다.
백서에는 이 글에서 미처 다 다루지 못한 GPU 세대별 사양 비교, 5가지 성능 저하 패턴과 설계 단계 체크리스트, Scalable Unit 기반 증설 전략, 기업 프라이빗 AI 인프라 구축 사례 등이 구체적인 수치와 다이어그램과 함께 담겨 있습니다. AI 인프라 도입을 검토하는 기술 의사결정자, 대규모 AI 시스템을 설계하거나 운영하는 아키텍트 및 엔지니어 분들께 실질적인 기술 레퍼런스로 활용되길 기대합니다.
긴 글을 읽어 주셔서 감사합니다. 🙇♀️
