Engineering
Kubernetes CPU Limit을 사용하면 벌어지는 일
2025년 9월 15일
원문에서 보기 ↗
들어가며
오늘날 대부분의 서비스가 컨테이너 환경을 이용하고 있고, 컨테이너를 실행하는 환경으로는 Kubernetes가 표준으로 자리 잡고 있습니다. Kubernetes에서 컨테이너를 실행할 때는 Pod를 사용하는데요. Pod를 사용할 때 컨테이너의 리소스를 얼마나 할당할 것인가는 클러스터의 안정성과 연결되어 있기 때문에 중요한 문제 중 하나입니다. Pod의 컴퓨팅 리소스는 보통 다음과 같이 requests 와 limit으로 설정할 수 있습니다.
apiVersion: v1
kind: Pod
metadata:
  name: frontend
spec:
  containers:
  - name: app
    image: images.my-company.example/app:v4
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
  - name: log-aggregator
    image: images.my-company.example/log-aggregator:v6
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
리소스를 설정할 때 우리는 보통 메모리를 중심으로 정하는데요, 컨테이너의 메모리 사용량이 한계값에 도달하면 Pod는 재실행됩니다. 그렇다면, CPU 사용량의 경우에는 어떨까요? 자주 사용되진 않지만 한 번쯤 알아두면 좋은 CPU 사용량 제한에 대해 알아보았습니다.
Kubernetes CPU Resource 설정
먼저 Pod의 Resource 항목에서 설정 가능한 CPU의 Request와 Limit, 그리고 단위에 대해 알아보도록 하겠습니다.
1. CPU Requests
CPU requests는 컨테이너가 정상적으로 실행하기 위한 최소한의 CPU 양을 의미합니다. requests는 kube-scheduler가 Pod를 노드에 할당하는 스케줄링 작업에서 사용합니다. kube-scheduler는 Pod의 requests 값을 합산하여 할당 가능한 노드를 찾아서 Pod를 배치합니다. 노드에 Pod의 requests를 수용할 만한 여유가 있어야 할당이 되는 것이죠. 이 조건을 만족하는 노드가 없다면 Pod는 pending 상태로 스케줄링되지 않습니다. Pod가 특정 노드에 스케줄링되었다면 요청된 CPU의 양은 보장됩니다. 이 말은 requests의 양만큼 CPU를 항상 점유한다는 뜻은 아닙니다. CPU 사용에 경합이 발생했을 때도 요청한 만큼의 CPU 시간을 할당 받는 것을 보장합니다. requests의 값이 없다면 Pod가 비효율적으로 배치될 수 있고 필요 이상의 클러스터 자원을 사용하여 불필요한 비용 지출이 발생할 수 있습니다.
2. CPU Limits
CPU limits는 컨테이너가 사용할 수 있는 CPU의 절대적인 최댓값을 의미하며 kubelet이 관리합니다. Pod의 컨테이너가 limits를 초과하여 CPU를 사용하려 할 때 해당 컨테이너의 CPU 사용을 인위적으로 낮추는 스로틀링(Throttling)을 통해 상한선을 강제합니다. limits는 여러 서비스가 동시에 실행되고 있는 Kubernetes 클러스터에서 하나의 컨테이너가 CPU를 과점하여 다른 컨테이너의 성능에 영향을 주거나 노드의 안정성을 해치는 CPU 기아 상태를 방지하는 데 의미가 있습니다.
3. CPU Unit
Kubernetes에서 CPU의 단위는 절대적인 양으로 사용되며 1 Kubernetes CPU는 1vCPU 또는 물리적인 1 CPU 코어의 컴퓨팅 파워와 동일한 것으로 간주합니다. Kubernetes에서는 코어를 밀리코어(millicore)로 더 작게 나누어 설정할 수 있습니다. 1000m은 1 CPU와 동일하며 0.5 CPU는 500m과 같습니다.
4. QoS(quality of service, 서비스 품질) 클래스
Kubernetes는 설정한 requests와 limits에 따라서 자동으로 QoS 클래스를 할당합니다. • Guaranteed (보장) : Pod 내의 모든 컨테이너가 CPU와 메모리에 대해 requests와 limits를 모두 설정하고, 그 값이 서로 동일할 때(requests.cpu == limits.cpu) 할당됩니다. 이 Pod들은 가장 높은 우선순위를 가지며, 노드에 리소스 압박이 발생했을 때 가장 마지막에 축출(eviction)됩니다. • Burstable (버스트 가능) : Pod 내에 최소 하나 이상의 컨테이너가 CPU 또는 메모리 requests를 설정했지만, Guaranteed 클래스의 조건을 충족하지 못할 때 할당됩니다(예: requests.cpu < limits.cpu). 이 Pod들은 노드에 여유 리소스가 있을 경우, 요청한 양보다 더 많은 리소스를 "버스트(burst)"하여 사용할 수 있습니다. • BestEffort (최선 노력): Pod 내의 어떤 컨테이너도 CPU나 메모리에 대한 requests나 limits를 설정하지 않았을 때 할당됩니다. 이 Pod들은 가장 낮은 우선순위를 가지며, 노드 리소스가 부족해지면 가장 먼저 축출 대상이 됩니다.
리눅스 커널의 CPU 관리 메커니즘
Kubernetes에서 설정한 requests와 limits를 리눅스 커널이 어떻게 실제로 CPU를 할당하고 제한하는지 알아보도록 하겠습니다. 여기에는 컨테이너 기술을 탄생시킨 cgroup(Control Group)과 CFS(Completely Fair Scheduler)가 사용됩니다.
1. 리눅스 컨트롤 그룹(cgroup)
cgroup은 프로세스들의 집합에 대해 CPU, 메모리, I/O와 같은 시스템 리소스의 사용량을 제한하고, 추적하며, 격리합니다. cgroup은 /sys/fs/cgroup/이라는 가상 파일 시스템 내에 계층적 구조로 구성됩니다. Kubernetes는 이 구조 내에 kubepods.slice라는 전용 경로를 만들어 Pod들의 리소스를 관리합니다. CPU 리소스 관리를 담당하는 cgroup의 특정 모듈을 ‘컨트롤러’ 또는 ‘서브시스템’이라 부르며, Kubernetes가 CPU requests와 limits를 구현하기 위해 사용하는 것이 바로 CPU 서브시스템입니다.
2. Completely Fair Scheduler(CFS)
CFS는 리눅스 커널의 기본 프로세스 스케줄러로, 그 이름처럼 ‘완전한 공정성’을 목표로 합니다. CFS는 마치 ‘이상적인 멀티태스킹 CPU’가 존재하는 것처럼, 실행 가능한 모든 태스크(프로세스)가 정확히 동일한 비율의 CPU 시간을 할당 받도록 노력합니다. 실제 하드웨어는 한 번에 하나의 작업만 실행할 수 있기 때문에, CFS는 ‘가상 런타임(virtual runtime, vruntime)’이라는 개념을 사용합니다. CFS는 항상 가장 작은 vruntime 값을 가진 작업, 즉 지금까지 가장 적게 실행된 작업을 선택하여 실행함으로써 장기적인 관점에서 공정성을 보장합니다.
3. Kubernetes와 커널의 매핑
kubelet은 Kubernetes의 yaml 명세를 실제 커널에 적용하기 위해서 변환 작업을 수행합니다. kubelet은 resources 설정을 읽어 해당 컨테이너의 cgroup 디렉터리 내 특정 파일에 값을 덮어쓰는 방식으로 커널에 지시를 내립니다.
3.1. Requests와 cpu.shares: 상대적 가중치 시스템
Pod의 resources.requests.cpu 값은 cgroup의 cpu.shares 파일 값으로 변환됩니다. 공식은 다음과 같습니다.
cpu.shares=requests.cpu (millicores)×1024/1000.
예를 들어, 1000m(1 코어) 요청은 1024 shares로, 500m 요청은 512 shares로 변환됩니다. 가장 중요한 점은 cpu.shares가 노드에 CPU 경합이 있을 때만 의미를 가지는 상대적 가중치라는 것입니다. 만약 CPU 자원을 두고 경쟁하는 두 컨테이너가 있고, 하나는 2048 shares, 다른 하나는 1024 shares를 가지고 있다면, 전자는 후자보다 두 배의 CPU 시간을 할당 받게 됩니다. 하지만 노드가 유휴 상태이고 CPU 경합이 없다면, 컨테이너는 자신의 shares 값과 무관하게 필요한 만큼의 CPU를 사용할 수 있습니다.
3.2. Limits와 cpu.cfs_period_us & cpu.cfs_quota_us: 절대적 시간 할당량 시스템
Pod의 resources.limits.cpu 값은 CFS 대역폭 제어라는 메커니즘을 통해 강제됩니다. 이 메커니즘은 두 가지 파라미터에 의해서 결정됩니다. • cpu.cfs_period_us: 할당량을 정산하는 주기로 단위는 마이크로초입니다. Kubernetes는 기본값인 100000(즉 100ms)을 사용합니다. 이 한 window 내에서 할당량이 정해집니다. • cpu.cfs_quota_us: 위에서 정의된 period 동안 cgroup이 소비할 수 있는 총 CPU 시간을 정의합니다. 단위는 마이크로초입니다. 이 값은 resources.limitscpu로부터 계산됩니다. limits가 없을 경우 -1로 할당량 없음을 의미합니다.
변환 공식은 다음과 같습니다.
cpu.cfs_quota_us=limits.cpu (cores)×cpu.cfs_period_us.
예를 들어, limits.cpu를 500m(0.5 코어)로 설정하면, cpu.cfs_quota_us=0.5×100000=50000이 됩니다. 이는 해당 컨테이너가 매 100ms 주기마다 최대 50,000 마이크로초(50ms)의 CPU 시간만 사용할 수 있음을 의미합니다.
요약
| Kubernetes 설정 | Kubernetes에서의 목적 | 리눅스 cgroup 파일 | 동작 |
|---|---|---|---|
| resources.requests.cpu | 스케줄링 및 경합 시 최소 CPU 보장 | cpu.shares | 상대적 가중치; CPU 경합 시에만 활성화 |
| resources.lmits.cpu | 런타임 시 최대 CPU사용량 제한 | cpu.cfs_quota_us | 절대적 시간 할당량; 항상 활성화, 스로틀링 발생 |
Limits 적용으로 발생할 수 있는 현상
CPU limits를 설정했을 때 발생하는 가장 중요하고 종종 오해 받는 현상이 바로 CPU 스로틀링입니다. 스로틀링은 단순히 성능을 약간 늦추는 것이 아니라, 애플리케이션의 지연 시간에 심각하고 예측 불가능한 영향을 미칠 수 있는 ‘정지-대기(stop-wait)’ 프로세스입니다.
1. CPU 스로틀링과 발생 원인
CPU 스로틀링은 컨테이너 내의 프로세스들이 현재의 cfs_period_us(보통 100ms) 동안 할당된 cfs_quota_us를 모두 소진했을 때 발생합니다. 할당량을 모두 사용한 컨테이너의 프로세스들은 커널 스케줄러에 의해 실행이 '정지'됩니다. 그리고 다음 100ms 주기가 시작되어 할당량이 다시 채워질 때까지 대기해야 합니다. 이 현상은 특히 멀티 스레드 애플리케이션에서 증폭되어 나타납니다. 예를 들어, 한 컨테이너가 1 코어(cfs_quota_us=100000)의 limit을 가지고 있지만, 4개의 바쁜 스레드를 동시에 실행한다고 가정해 봅시다. 이 컨테이너는 4개의 코어를 동시에 사용하여 단 25ms의 실제 시간만에 100ms의 CPU 시간 할당량을 모두 소진할 수 있습니다. 그 후, 해당 컨테이너는 남은 75ms 동안 노드에 유휴 코어가 있더라도 완전히 스로틀링되어 아무 작업도 수행할 수 없게 됩니다. 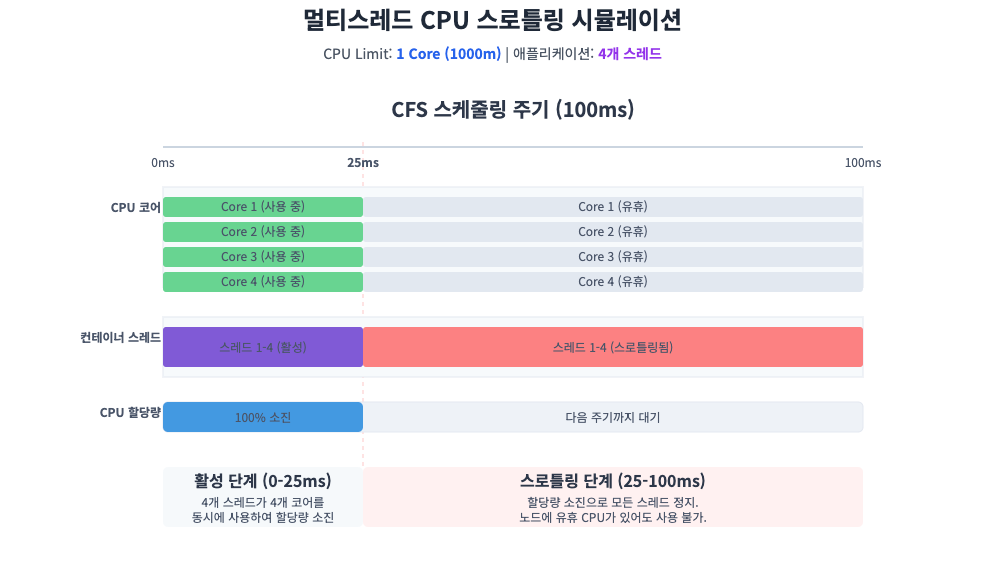
2. CPU 스로틀링으로 인한 지연 시간 증가
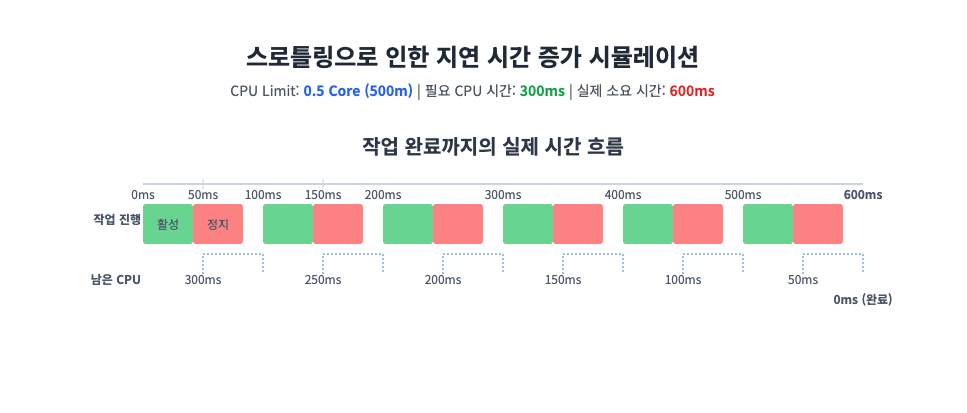 스로틀링은 애플리케이션 요청 처리 시간에 직접적으로 지연을 추가합니다. 예를 들어, 어떤 작업을 완료하는 데 순수하게 300ms의 CPU 시간이 필요한 애플리케이션이 100ms 주기당 50ms의 limit에 의해 제한된다고 가정해 봅시다. 이 작업은 다른 시스템 부하가 전혀 없더라도 최소 6개의 주기, 즉 600ms의 실제 시간이 걸려야 완료될 수 있습니다. 이러한 지연은 타임아웃, 연쇄적인 장애, 그리고 궁극적으로는 나쁜 사용자 경험으로 이어질 수 있습니다. 스로틀링은 전통적인 CPU 사용률 지표로는 확인하기가 힘든 경우가 있습니다. 어떤 컨테이너가 CPU 사용률 50%(자신의 limit 값)를 보이고 있더라도, 실제로는 심각하게 스로틀링되어 매우 느린 상태일 수 있습니다. 이 경우 CPU는 전통적인 의미에서 '최대치로 사용'되는 것이 아니라, 인위적으로 억제되고 있는 상태입니다.
3. '시끄러운 이웃' 오해
limits가 ‘시끄러운 이웃(noisy neighbor)’ 문제, 즉 하나의 애플리케이션이 리소스를 독점하여 다른 애플리케이션에 영향을 주는 것을 막아 줄 수 있을 것처럼 보입니다. 하지만 실제로는 requests에 의해 결정되는 cpu.shares가 경합 상황에서도 적절하게 리소스를 배분할 수 있는 시스템이라고 할 수 있습니다. 만약 모든 Pod에 적절한 requests가 설정되어 있다면, CFS 스케줄러는 shares 값에 비례하여 CPU 시간을 분배함으로써 특정 Pod가 다른 Pod들이 기아 상태에 빠지는 것을 방지합니다. 반면 limits는 다른 누구도 CPU를 필요로 하지 않는 상황에서조차 Pod의 사용량을 제한하는 무딘 도구에 가깝습니다.
스로틀링 테스트
테스트를 위해 한 웹 애플리케이션을 만들었습니다. 이 애플리케이션에 1 CPU를 할당하면 작업을 완료하는 데 대략 12초 정도 걸립니다. 이 애플리케이션에 각각 1 CPU, 0.1 CPU를 할당하여 CPU 사용량과 작업 시간을 확인하여 지금까지 확인한 현상이 발생하는지 테스트해 보았습니다.
테스트용 Pod 준비
아래와 같이 CPU limit만 다르게 설정하여 Pod를 생성하였습니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cpu-test-app
  labels:
    app: cpu-test-app
spec:
  replicas: 1
  selector:
    matchLabels:
      app: cpu-test-app
  template:
    metadata:
      labels:
        app: cpu-test-app
    spec:
      containers:
      - name: cpu-test-app
        image: cpu-test-app
        ports:
        - containerPort: 8081
        resources:
          requests:
            memory: "64Mi"
            cpu: "100m"    # 0.1 코어
          limits:
            memory: "128Mi"
            cpu: "100m"    # 0.1 코어로 제한
        livenessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 10
          periodSeconds: 30
        readinessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
---
# 1 코어 제한 버전
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cpu-test-app-1core
  labels:
    app: cpu-test-app-1core
spec:
  replicas: 1
  selector:
    matchLabels:
      app: cpu-test-app-1core
  template:
    metadata:
      labels:
        app: cpu-test-app-1core
    spec:
      containers:
      - name: cpu-test-app
        image: cpu-test-app
        ports:
        - containerPort: 8080
        resources:
          requests:
            memory: "64Mi"
            cpu: "1000m"   # 1 코어
          limits:
            memory: "128Mi"
            cpu: "1000m"   # 1 코어로 제한
        livenessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 10
          periodSeconds: 30
        readinessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
응답 시간 비교
0.1 CPU를 할당한 애플리케이션에서는 122초가 소요된 반면 1 CPU가 할당된 애플리케이션에서는 11.51초만 소요된 것을 확인할 수 있었습니다. 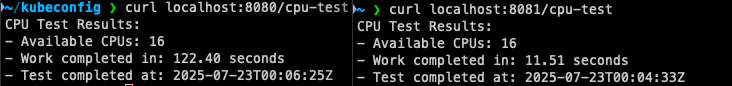
그라파나를 통한 스로틀링 현상 확인
- 초록색: 1 CPU
- 노란색: 0.1 CPU
CPU 사용률에서 노란색 그래프가 CPU limits가 0.1로 설정되어 그 이상 사용하지 못하는 모습을 보여줍니다. CPU 할당 횟수에서 노란색이 Limits에 걸려서 더 많은 cpu 할당이 발생한 것을 확인할 수 있습니다. 이것은 스로틀링으로 인한 지연 시간 증가 시뮬레이션과 일치하는 결과입니다. 당연하게도 스로틀링 비율도 노란색이 더 높은 것을 알 수 있습니다. 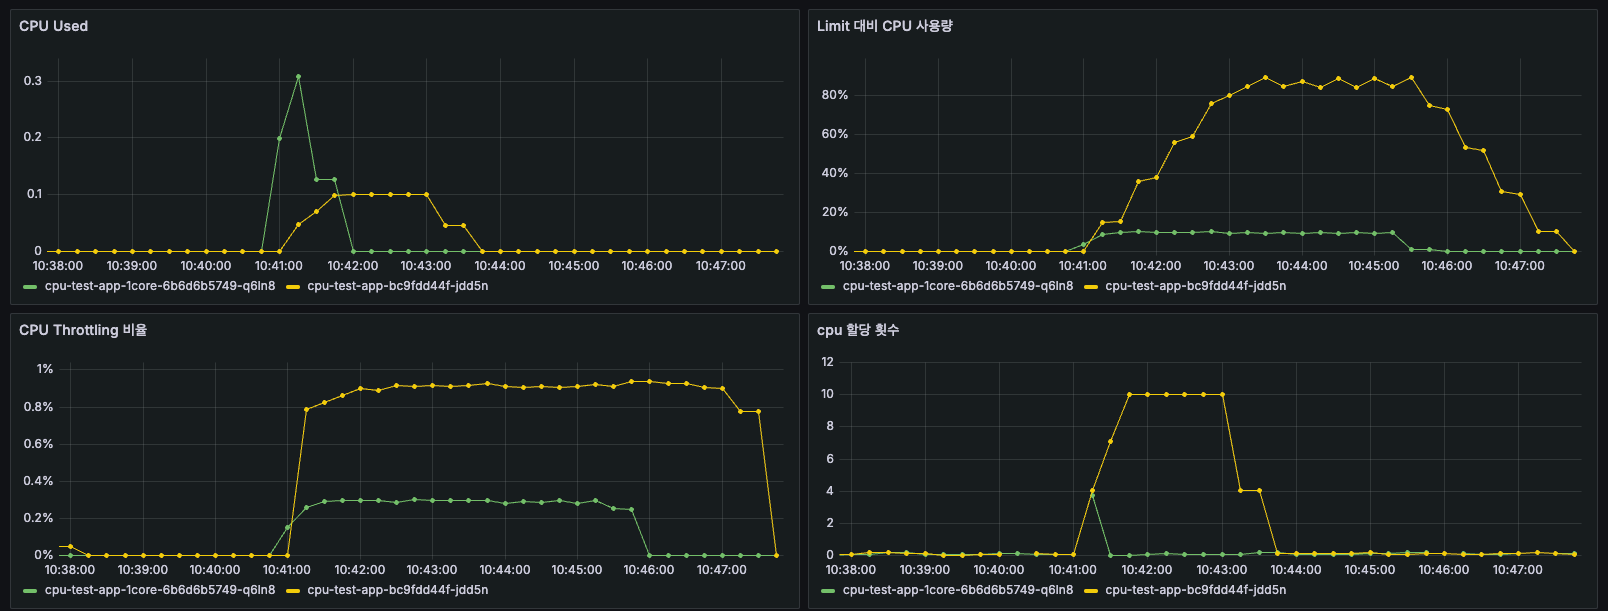 중요한 지표는 스로틀링 비율로서 비율이 5%를 지속적으로 넘는 현상이 발생한다면 스로틀링이 빈번하게 발생하여 성능에 제약을 받아 서비스가 느려져 있을 가능성이 있으므로 조치를 취해야 합니다.
스로틀링 비율 지표 예시
sum by (namespace, pod) (rate(container_cpu_cfs_throttled_periods_total{container!=""}[5m]))
/
sum by (namespace, pod) (rate(container_cpu_cfs_periods_total{container!=""}[5m]))
나가며
결론은 아래와 같습니다.
- 일반적인 경우,
- request만 설정하여 자원이 더 필요할 때는 노드의 가용 자원을 사용하고 자원이 모자랄 때는 비율로 할당 받도록 하는 것이 좋은 것 같습니다. (QoS는 Burstable로 설정됨)
- QoS가 Burstable로 설정되지만 CPU는 Eviction의 조건이 아니기 때문에 throttling이 발생할지언정 pod가 eviction 되지는 않습니다.
- limit만 설정하는 경우는 피해야 합니다. limit만 설정할 경우 request가 0이 되어 자원 가용량이 없는 노드에도 스케줄링 될 수 있으며 런타임 시 예측이 어려워집니다.
- CPU request는 Pod가 노드에 할당될 때는 절댓값으로 사용되고 할당된 뒤에는 상대적인 비율로 사용됩니다.
긴 글을 읽어 주셔서 감사합니다. 😀
참고 문헌
• Kubernetes, Resource Management for Pods and Containers, https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/ • KubeBlog, Understanding CPU Requests and Limits, 2023. 10. 5., https://www.kubeblog.com/basics/understanding-cpu-requests-and-limits/ • Itiel Shwartz, Kubernetes CPU Limits: What’s the Right Way to Assign CPU Resources?, 2025. 1. 14., https://komodor.com/learn/kubernetes-cpu-limits-throttling/ • Eliran Cohen, For the love of god, learn when to use CPU limits on Kubernetes., 2023. 3. 5., https://medium.com/@eliran89c/for-the-love-of-god-learn-when-to-use-cpu-limits-on-kubernetes-2225341e9dbd • Max Levin, Kubernetes CPU Throttling: What it is, and Best Practices, 2024. 6. 6., https://www.groundcover.com/blog/kubernetes-cpu-throttling • CODE FARM, Linux CGroups and Containers, 2024. 2. 3., https://blog.codefarm.me/2021/11/23/linux-cgroups-containers/ • Andreas Karis Blog, Quick guide for cgroups, 2020. 9. 3., https://andreaskaris.github.io/blog/linux/cgroups/ • Martin, Cgroups - Deep Dive into Resource Management in Kubernetes, 2023. 2. 20., https://martinheinz.dev/blog/91 • Jianhao, Kubernetes CPU requests and limits, 2021. 11. 11., https://jaanhio.me/blog/kubernetes-cpu-requests-limits/ • Red Hat, Resource Management Guide > CPU, https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/6/html/resource_management_guide/sec-cpu • Real-time Ubuntu, Linux kernel schedulers, https://documentation.ubuntu.com/real-time/latest/explanation/schedulers/ • Rifewang, Kubernetes: CPU Configuration, Linux CFS, and Performance Issues with Programming Languages, 2024. 12. 11., https://medium.com/@rifewang/kubernetes-cpu-configuration-linux-cfs-and-performance-issues-with-programming-languages-ccef783ed22e • JettyCloud, Making Sense of Kubernetes CPU Requests And Limits, 2023. 3. 20., https://medium.com/@jettycloud/making-sense-of-kubernetes-cpu-requests-and-limits-390bbb5b7c92 • Tania Duggal, PerfectScale, Kubernetes CPU Limit: Best Practices for Optimal Performance, 2024. 10. 24., https://www.perfectscale.io/blog/kubernetes-cpu-limit-best-practises • Shane Corbett, AWS Blogs, Using Prometheus to Avoid Disasters with Kubernetes CPU Limits, 2022. 9. 21., https://aws.amazon.com/blogs/containers/using-prometheus-to-avoid-disasters-with-kubernetes-cpu-limits/
