Engineering
이미지와 음성을 아우르는 카카오의 멀티모달 언어모델 Kanana-o 알아보기
edwin.ai, james.e카카오
2025년 5월 1일
원문에서 보기 ↗안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나(Kanana) 조직의 Edwin(강우영) , James(이재명) 입니다. 저희 팀에서는 다양한 모달리티 데이터를 처리할 수 있는 멀티모달 언어모델을 중점적으로 개발하고 있습니다.
지난해 12월, 이미지를 이해할 수 있는 멀티모달 언어모델인 Kanana-v를 소개해 드린 바 있는데요. 이번 글에서는 텍스트와 오디오를 이해하는 오디오 언어모델인 Kanana-a 와 텍스트, 이미지, 오디오 모두를 이해하는 Kanana-o를 소개합니다.
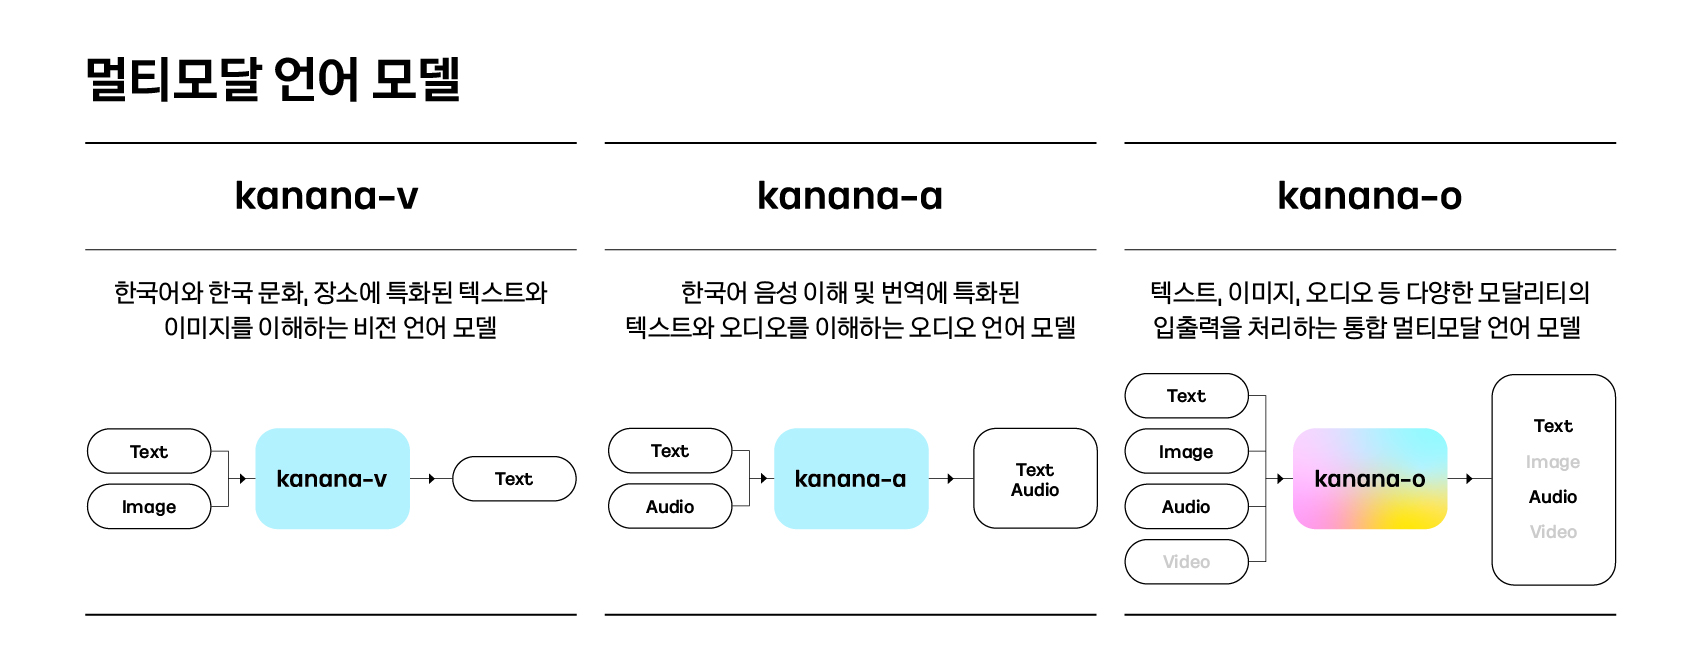
Kanana-o는 Kanana-v와 Kanana-a를 모델 병합(Model Merging) 기법으로 결합하여 학습 효율을 극대화했습니다. 또한, 자체 제작한 이미지-오디오 통합 모달리티 데이터를 포함해 지금까지 쌓아온 학습 노하우를 바탕으로, 단기간에 다양한 한국어 및 영어 벤치마크에서 글로벌 경쟁력을 입증했습니다.
이번 글에서는 이러한 결과를 만들어내기까지 저희가 마주했던 도전 과제들과, 이를 극복하기 위해 고민하고 노력했던 과정을 자세히 소개하고자 합니다.
특히, 아직 소개해드리지 못헀던 Kanana-a에 대해 먼저 자세하게 소개하고, 이를 Kanana-v와 결합하여 Kanana-o를 만든 과정을 설명드리겠습니다. 이어서 성능에 대한 자세한 정량 수치와 다양한 활용 예시들을 보여드리며 글을 마무리하도록 하겠습니다.
카카오의 음성 이해 모델: Kanana-a
사람과 기계가 소통하는 가장 자연스러운 방식은 ‘말하기’라고 할 수 있습니다. 음성은 텍스트보다 입력 속도가 빠르고, 시각적 주의를 요구하지 않으며, 몰입감 있는 소통 수단으로서도 강력합니다. 특히 운전 중, 운동 중, AR/VR 기기처럼 손이나 눈이 자유롭지 않은 환경에서는 텍스트보다 훨씬 직관적인 인터페이스가 됩니다.
그뿐만 아니라, 음성은 단순한 정보 전달을 넘어 감정과 뉘앙스까지 담을 수 있는 소통의 수단입니다. 우리는 누군가의 말투, 속도, 억양, 리듬, 배경 소리까지 종합해 의미를 해석하고, 그에 맞는 방식으로 반응합니다.
반면, 텍스트 중심 LLM은 이 모든 비 언어적 정보(paralinguistic cues)를 인식하지 못하고 단어 그 자체에만 반응합니다. 예를 들어, 떨리는 목소리로 말하는 “괜찮아요”는 문자로는 표현되지 않는 감정을 담고 있으며, 격앙된 고객의 말투에 맞춰 상담사가 말하는 속도를 낮추는 것도 텍스트만으로는 구현하기 어렵습니다.
이처럼 실제 상황에서 사람과 사람 사이의 상호작용은 텍스트로 환원되기 어려운 정보들로 가득 차 있습니다.
그래서, Audio LLM은 단순한 텍스트 LLM의 확장이 아니라, 인간과 기계 간 소통 방식을 근본적으로 바꾸는 새로운 패러다임이라고 할 수 있습니다. 이 섹션에서는 저희가 Audio LLM을 설계하며 겪은 기술적 고민과 구조적 선택에 대한 내용을 공유드리고자 합니다.
Kanana-a의 개발 과정과 전체 구조
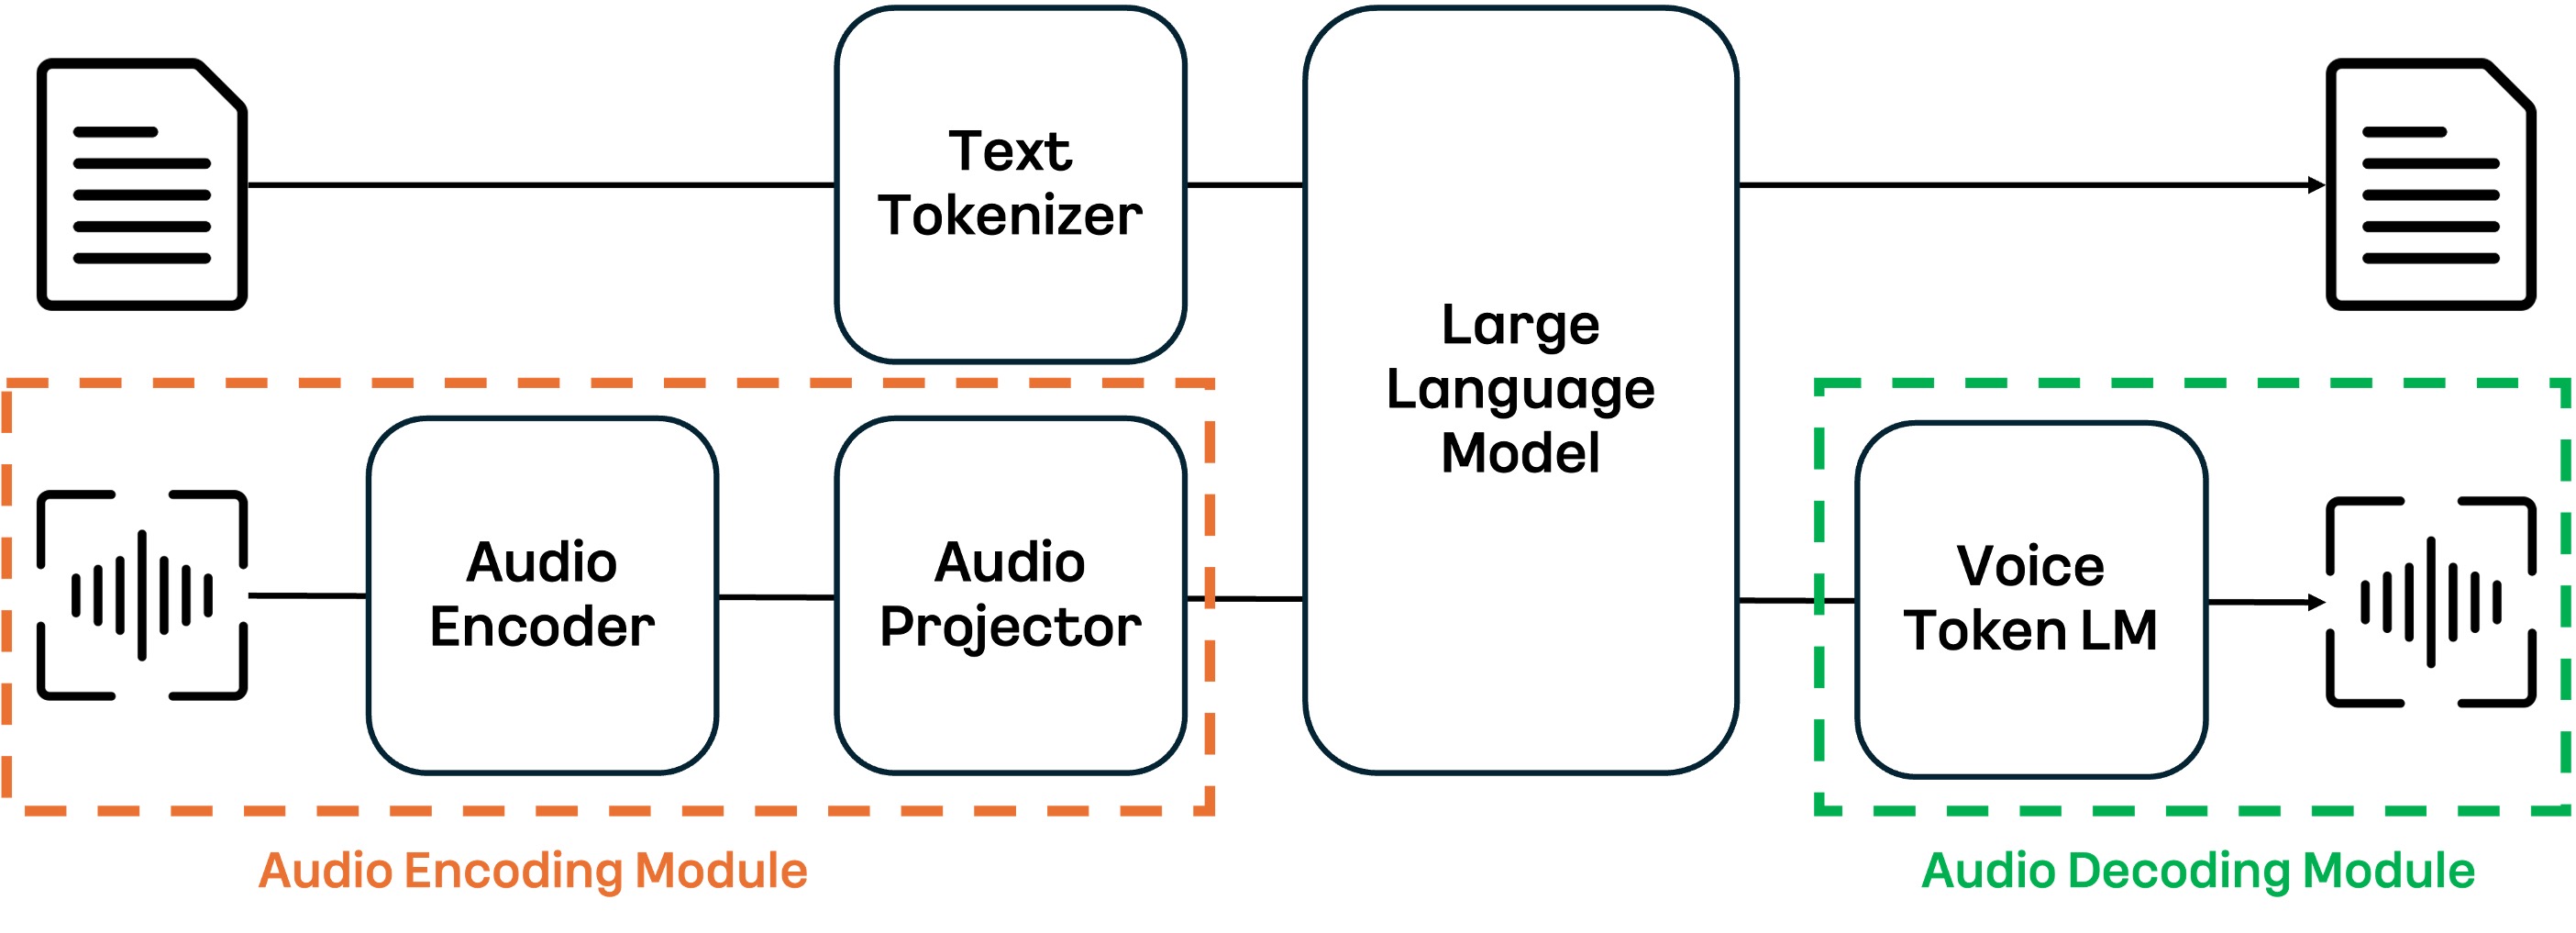
Kanana-a는 텍스트와 음성을 함께 이해하고 생성할 수 있는 멀티모달 언어모델로, 전체 구조는 세 가지 주요 모듈로 구성됩니다.
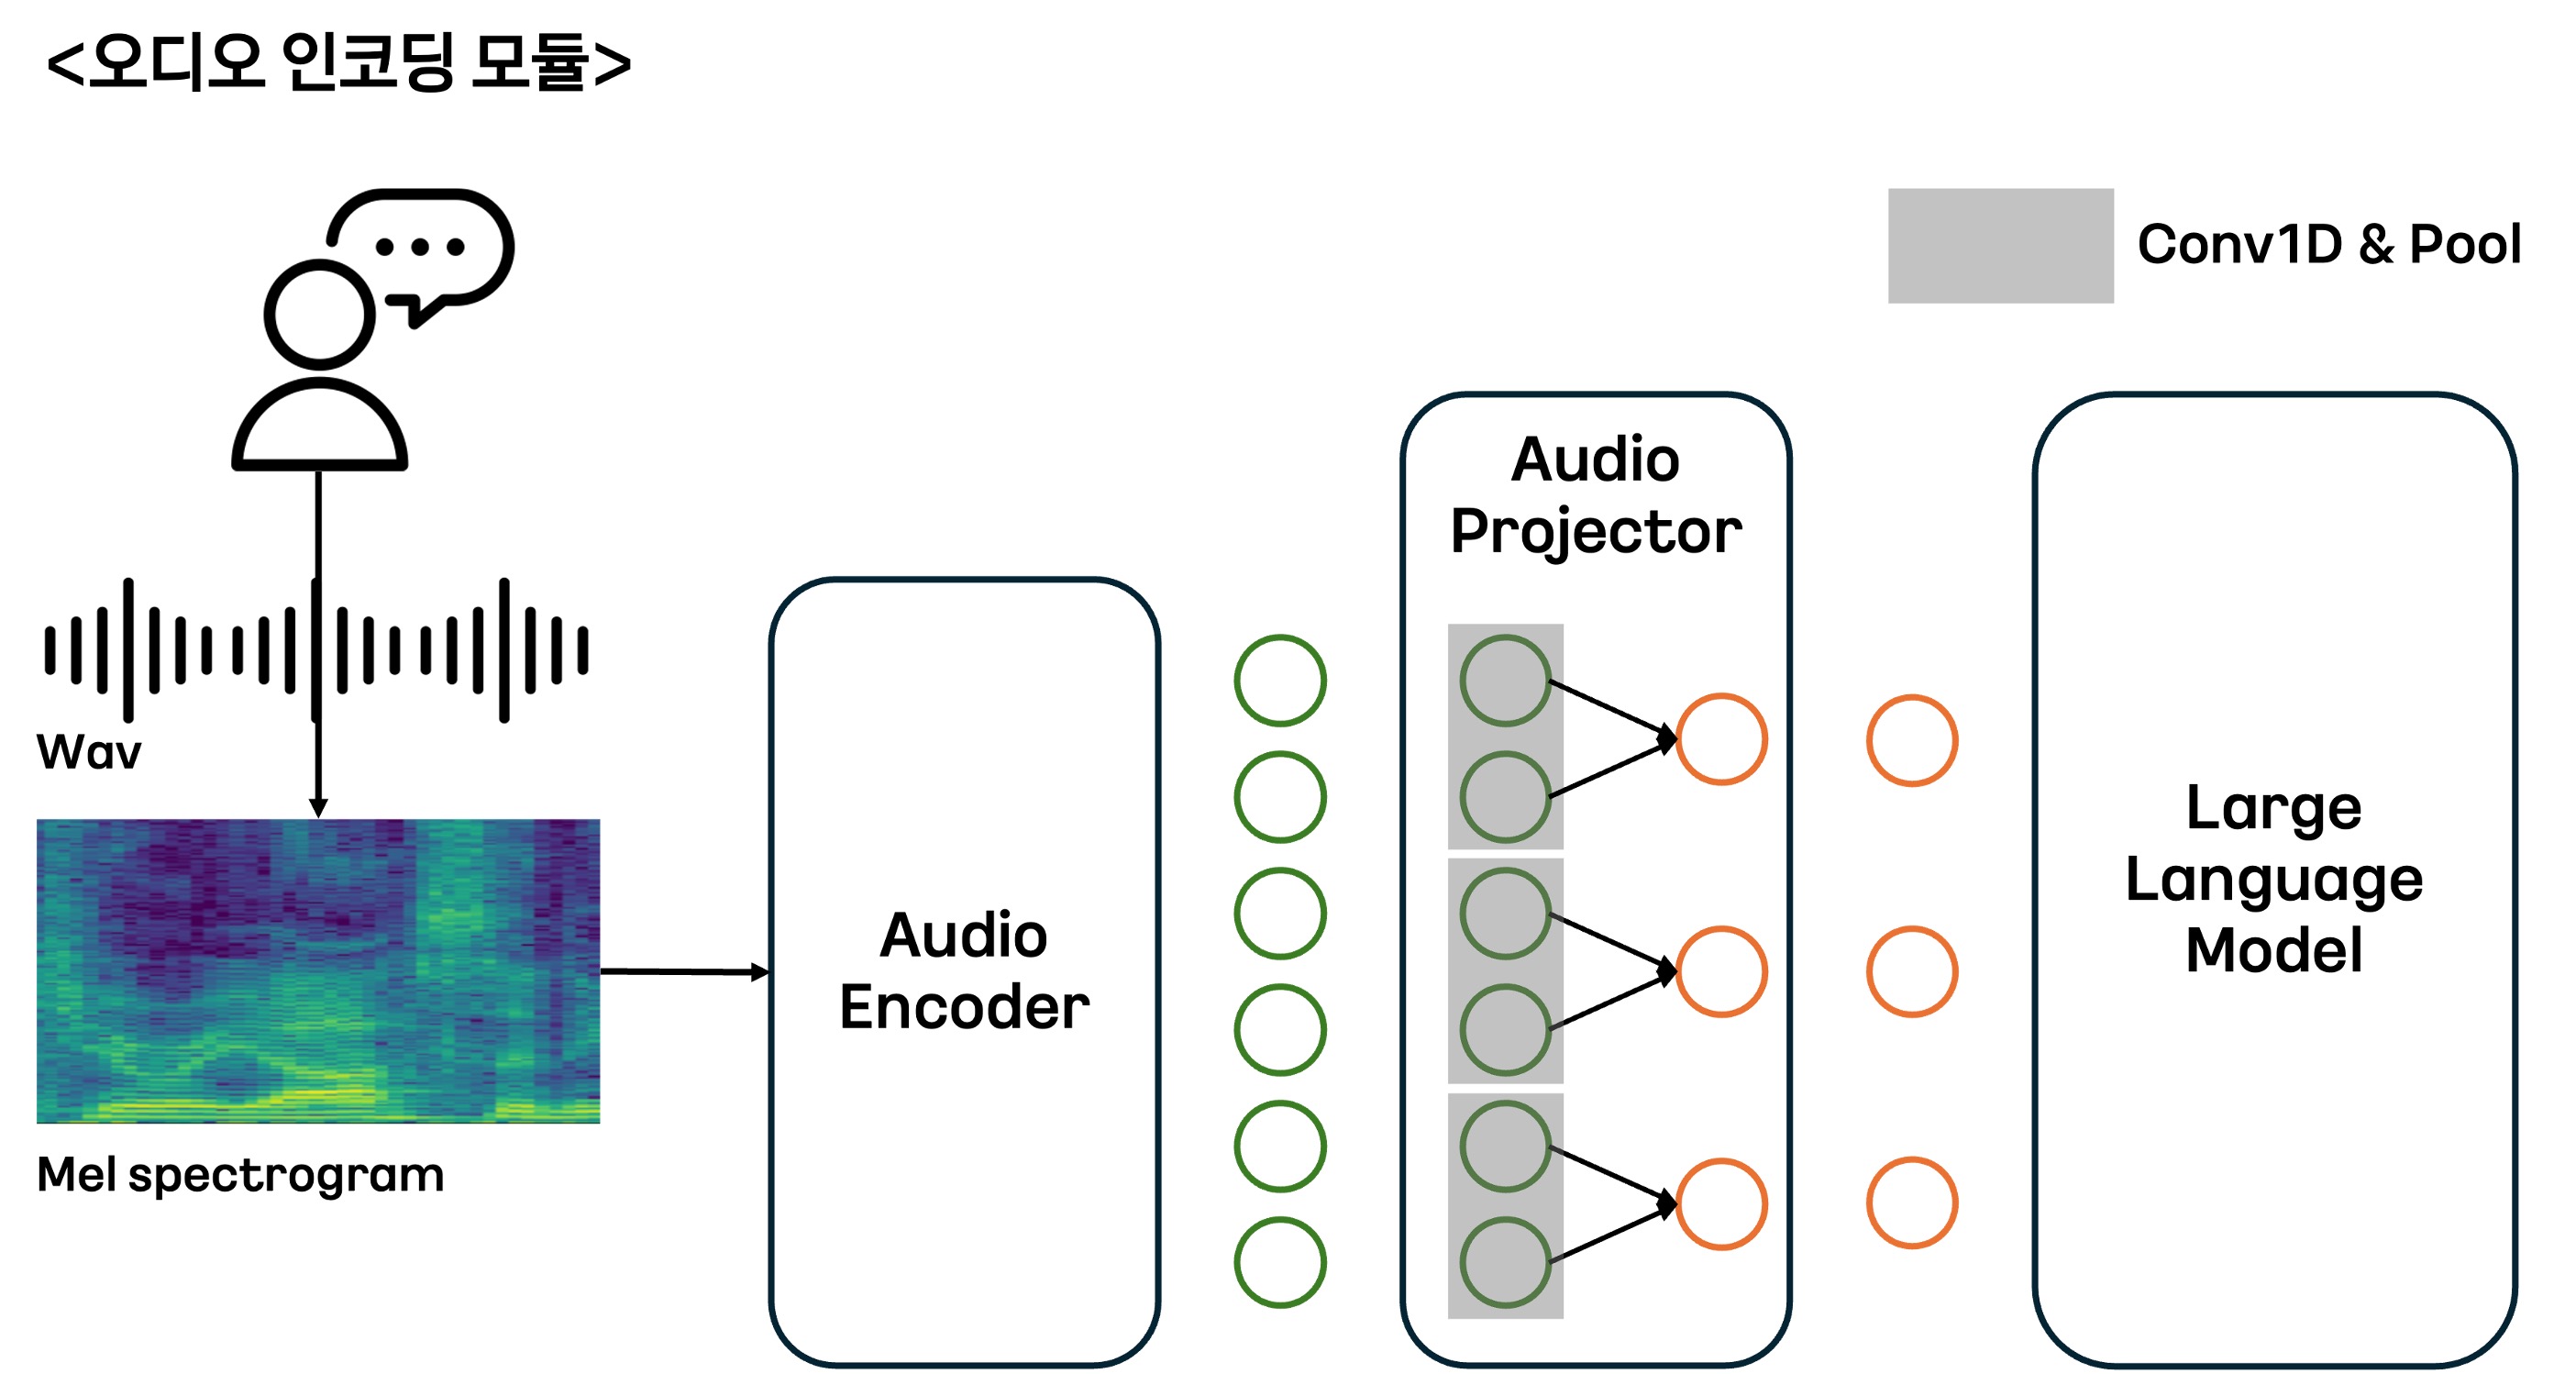
첫 번째는 오디오 인코딩(audio encoding) 모듈로, 입력된 음성 신호를 멜 스펙트로그램(Mel Spectrogram)으로 변환한 후, 오디오 인코더를 통해 LLM이 처리 가능한 형태의 임베딩 벡터로 압축합니다.
두 번째는 LLM 기반 응답 생성 단계입니다. 이 과정에서 모델은 텍스트와 음성 임베딩을 함께 입력받아, 질의에 대한 의미를 통합적으로 이해하고 적절한 응답 시퀀스를 생성합니다.
마지막으로, LLM에서 생성된 응답은 오디오 디코딩(audio decoding) 모듈을 통해 사람이 들을 수 있는 실제 음성 파형으로 복원됩니다. 이 단계에서는 LLM의 응답을 참고하여 이산적인 음성 토큰을 만들어낸 뒤 멜 디코더와 보코더가 함께 사용되어 자연스러운 음성 출력을 완성합니다.
오디오 인코딩 모듈
음성 데이터는 텍스트에 비해 입력 길이와 복잡도가 훨씬 높습니다. 예를 들어, “안녕하세요”와 같은 1초 분량의 인사말을 16kHz로 샘플링하면, 16,000개의 연속적인 숫자로 표현됩니다. 이처럼 단 몇 초의 음성도 수만 개의 숫자로 구성되기 때문에, 이를 그대로 대형 언어모델(LLM)에 입력하면 막대한 연산량과 지연(latency) 문제가 발생하게 됩니다.
그렇다면 입력으로 주어지는 원본(raw) 음성 신호를 어떻게 하면 더 짧고 효율적인 형태로 바꿔 입력할 수 있을까요? 이 문제에 대한 저희의 고민과 경험을 바로 이어서 공유드리겠습니다.
오디오 인코더: Raw 음성 신호를 LLM 친화적인 표현으로
먼저, 입력된 음성 신호는 오디오 인코더 (Audio Encoder)를 통해 일정 수준 압축된 피처 벡터(feature vector)로 변환됩니다. 일반적으로 멀티모달 언어모델에서는 각 모달리티에 대해 사전학습된 인코더(pretrained encoder)를 사용합니다.
저희는 음성 인식 분야에서 널리 쓰이고 있는 OpenAI의 Whisper[1] 모델을 채택했습니다. Whisper는 96개 언어, 약 68만 시간 규모의 대규모 데이터를 학습한 모델로, MIT 라이선스 하에 공개되어 있어 제품을 개발하는 기업 입장에서도 접근성이 매우 좋은 모델이라고 할 수 있습니다.
Whisper 인코더의 특징 중 하나는 높은 압축률인데요, 예를 들어, 초당 16,000개의 샘플로 구성된 음성 데이터를 멜 스펙트로그램으로 변환한 뒤 Whisper 인코더에 통과시키면, 초당 50개의 특징 벡터들만으로 표현할 수 있습니다.
더욱 짧게 압축할 순 없을까? - 추가적인 Audio Projector의 설계
Whisper 인코딩만으로도 압축률은 상당하지만, 1분 이상으로 음성이 길어지면 약 3,000개 이상의 피처 벡터가 생성되기 때문에 여전히 LLM 입력에는 다소 부담스러운 길이입니다. 따라서 이를 좀 더 줄이면서도 입력 음성에 있던 정보를 최대한 유지시켜 줄 수 있는 추가적인 무언가가 필요한데요, 비슷한 목적으로 Vision-LLM에서 사용되는 visual projector처럼 audio projector를 두어 이를 해결해볼 수 있습니다.
저희는 Kanana-v 모델에서 사용되었던 2D-C-Abstractor[2] 구조를 변형하여, 1D 시퀀스 전용 구조인 1D-C-Abstractor를 적용했습니다. 이 모듈은 Conv1D 계열의 연산과 적절한 풀링(pooling) 기법을 조합하여, 긴 시퀀스를 더 짧으면서도 정보량이 잘 보존되도록 변환해줍니다. 이를 통해 1분 길이, 약 3,000개의 Whisper output 피처 벡터가 1D-C-Abstractor를 추가적으로 거치면서 600개 이하로 줄어들게 됩니다.
이렇게 되면 대형 언어모델에 무리 없이 입력할 수 있을 정도로 입력 길이를 효과적으로 줄이면서도, 음성의 핵심 정보를 잘 유지할 수 있게 됩니다.
오디오 디코딩 모듈
음성을 생성하는 방식은 최근 몇 년 사이 큰 변화를 겪었습니다. 과거에는 복잡한 신호처리 기반 방식이 주를 이뤘다면, 이제는 텍스트 생성과 동일하게 이산형 토큰(discrete token)을 예측하는 방식이 주류로 자리잡고 있습니다.
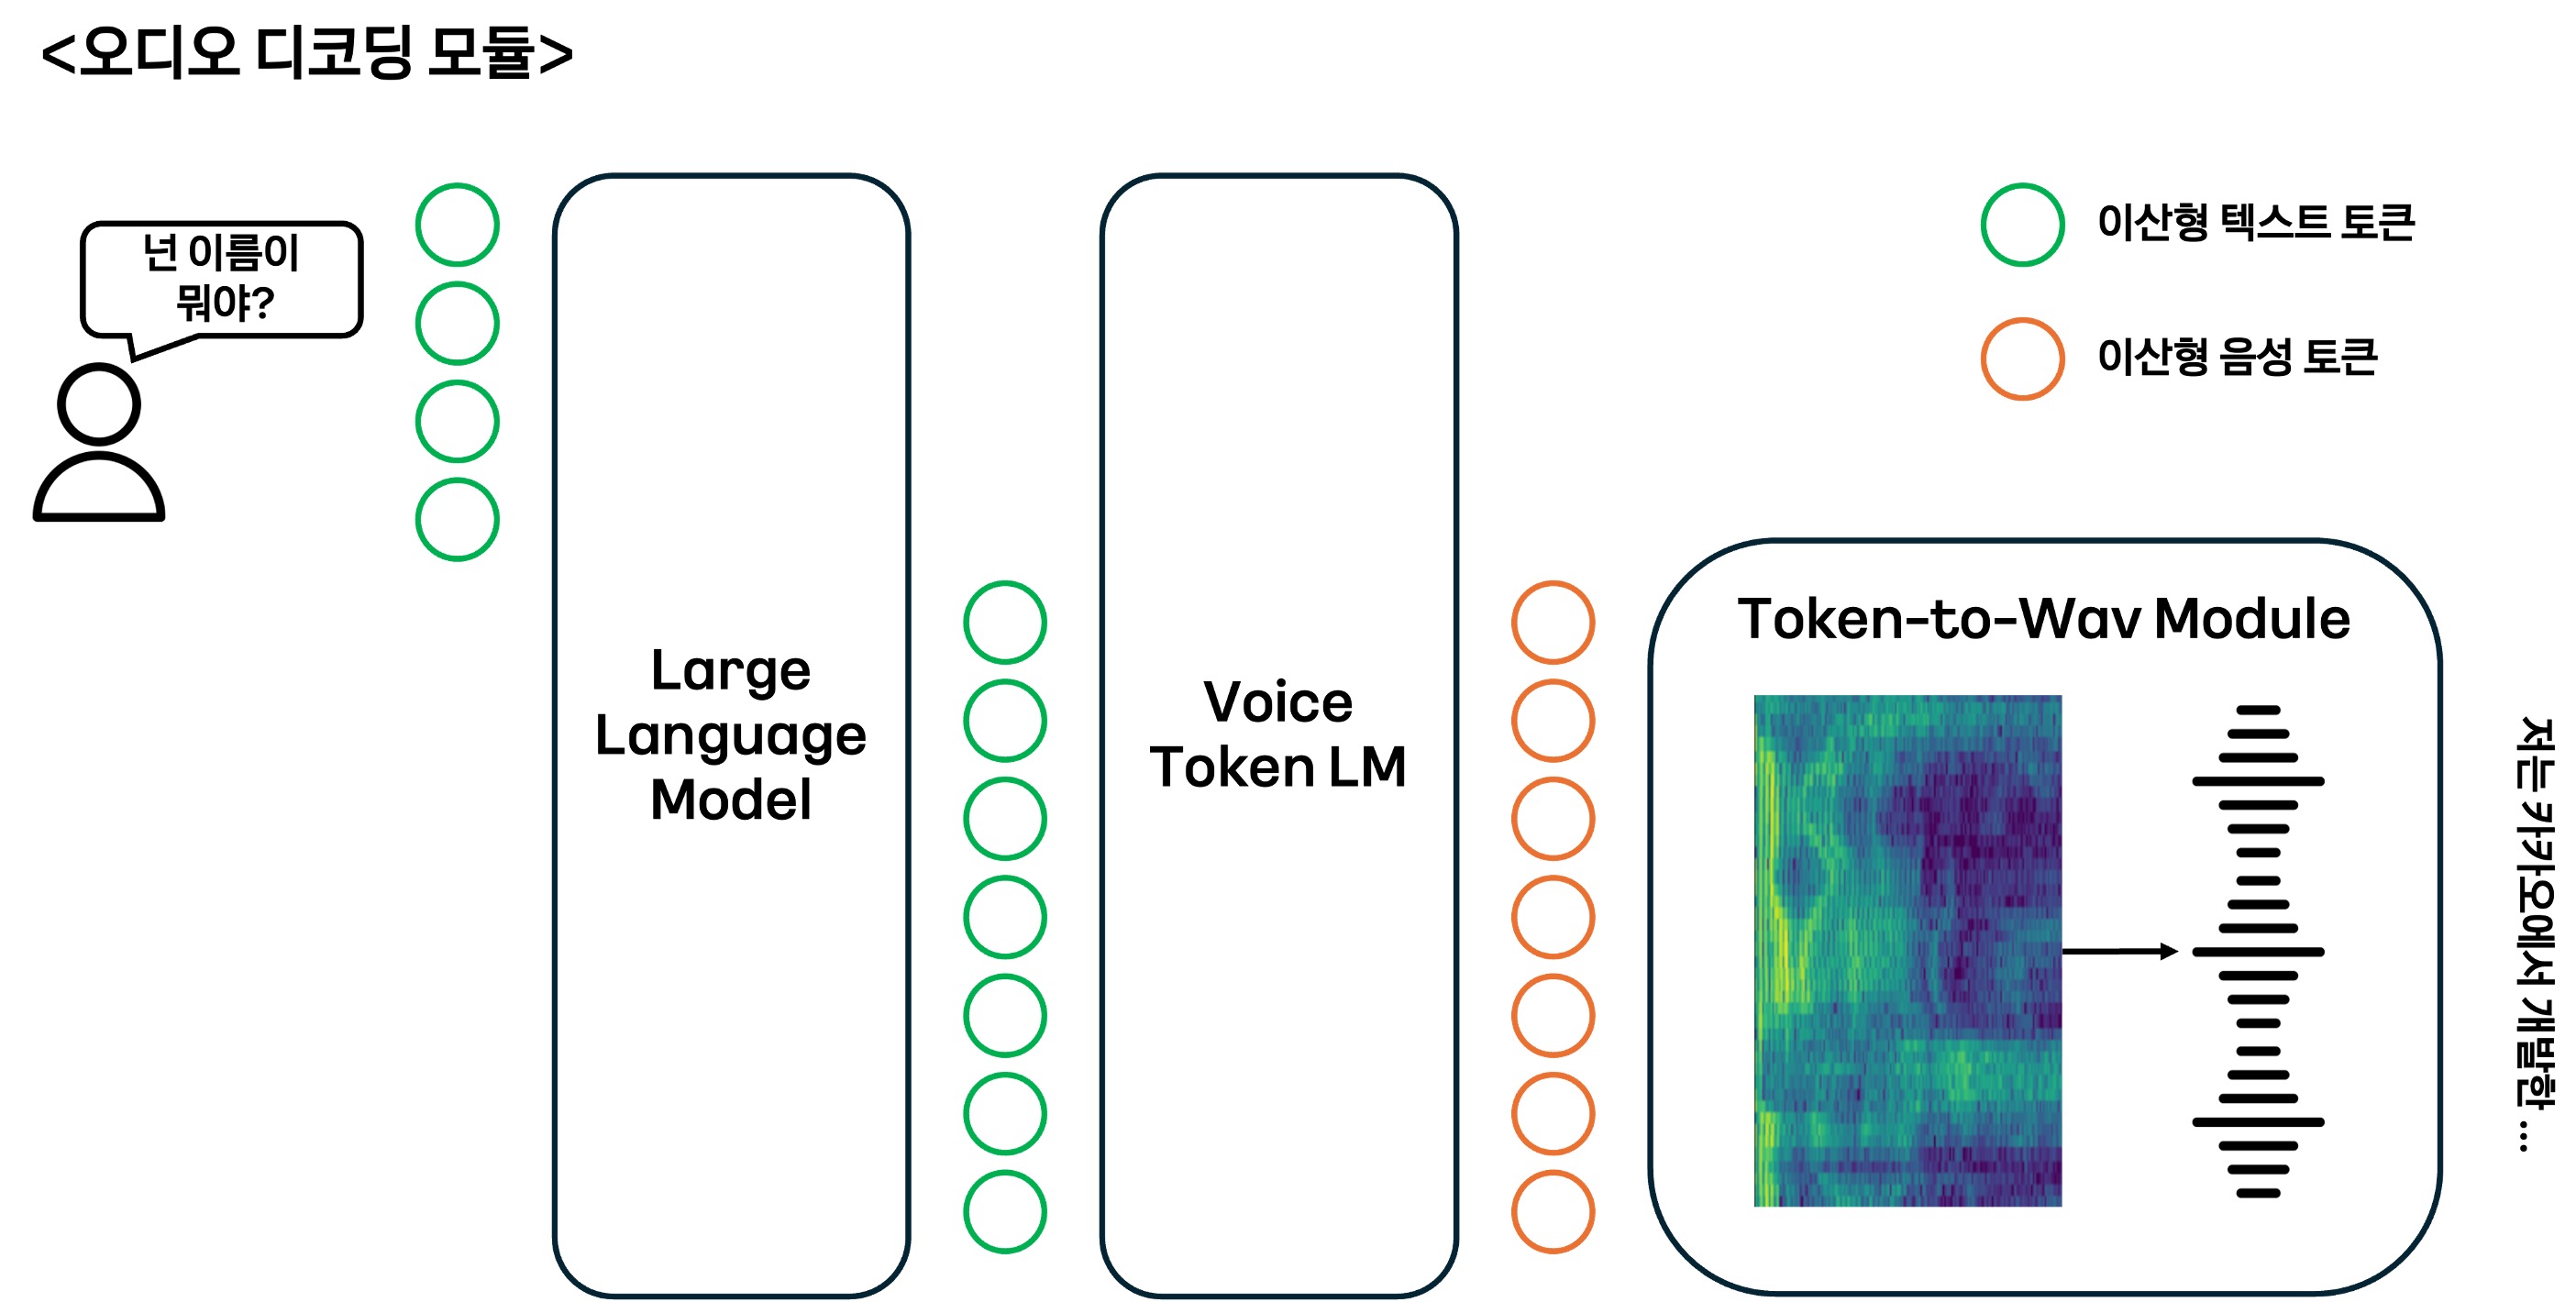
오디오 디코딩 모듈에서는 유저의 질의에 대한 LLM의 답변이 Voice Token LM의 입력으로 들어가게 되고, Voice Token LM에서는 이를 바탕으로 이산화된 음성 토큰 시퀀스를 예측해줍니다. 이후 생성된 이산 음성 토큰이 Token-to-Wav 모듈을 거쳐 실제 사람이 들을 수 있는 음성 파형으로 변형되는 과정을 거칩니다.
여기에서는 오디오 디코딩 모듈에서 사용되는 이산형 음성 토큰을 만드는 방법부터 시작하여, 이산 음성 토큰 시퀀스가 실제로 Voice Token LM에서 어떻게 학습되며, 최종적으로 어떻게 음성 파형으로 변환되는지에 대한 전반적인 과정에 대해 소개드리겠습니다.
음성 생성도 결국 “Next Token Prediction”
앞서 설명드린 것처럼, 음성 입력은 일반적으로 오디오 인코더를 통해 연속적인 벡터 형태로 변환됩니다. 반면, 음성의 출력은 연속적인 신호가 아닌 이산형 토큰의 시퀀스 (sequence)로 생성됩니다. 이는 GPT류의 언어모델에서 사용하는 next token prediction 방식과 동일한 구조입니다.
물론 음성과 텍스트는 문어체와 구어체의 차이, 억양, 감정 등 비언어적 요소 측면에서 다를 수 있지만, 둘 모두 의미 있는 정보를 순차적으로 담고 있는 시퀀스 데이터라는 점에서 동일한 모델링 접근이 가능합니다.
결국 핵심은 학습 과정에서 오디오 토큰 시퀀스의 분포를 얼마나 잘 학습하느냐에 달려 있으며, 이 때문에 GPT류의 생성 방식이 음성 생성에도 효과적으로 적용될 수 있는 것이죠. 이렇게 생성된 토큰 시퀀스는 이후 사전학습된 Token-to-Waveform 모듈을 통해 다시 실제 음성 파형으로 변환됩니다.
이산화의 핵심 음성 토크나이저
음성 데이터를 이산형 토큰으로 변환하는 핵심 모듈이 바로 음성 토크나이저(tokenizer)입니다. 텍스트 토크나이저가 단어를 서브워드로 나누듯, 음성 토크나이저는 연속적인 오디오 신호를 짧은 단위의 코드(code)로 분해합니다.
하지만 음성에는 텍스트와 달리 비언어적 정보—예를 들면 속도, 리듬, 억양, 감정 등이 포함되어 있습니다. 좋은 토크나이저는 이런 정보를 손실 없이 압축할 수 있어야 합니다. 단순히 발화 내용을 표현하는 것 이상으로, 말하는 사람의 감정이나 화법을 정확히 담아야 진정한 자연스러운 음성 합성이 가능해집니다. 이를 위해서는 대규모 데이터셋 기반의 섬세한 학습이 필수적입니다.
다행히도 이러한 요구조건들을 어느정도 충족하는 다수의 공개 음성 토크나이저가 있었는데요, 저희는 안정성과 성능이 검증된 공개 음성 토크나이저 중 하나를 사용했습니다.
선택한 음성 토크나이저가 세계적으로 널리 쓰이기는 하지만, 한계점도 분명하게 존재합니다. 아무래도 글로벌 범용성을 고려해 설계된 만큼, 한국어에 특화된 성능은 아직 부족하다고 할 수 있습니다. 우리가 목표로 하는 서비스는 한국어 사용자에게 최적화된 경험을 제공해야 하기에, 이 부분은 개선이 필요한 요소입니다.
이러한 한계를 극복하기 위해, 저희 팀은 퍼블릭 데이터와 자체 수집 데이터를 포함한 대규모 한국어 음성 데이터셋을 기반으로 자체 음성 토크나이저 개발을 진행하고 있습니다. 한국어의 특수한 발화 구조, 억양, 어미 변화 등을 잘 반영하면서도, 스트리밍 환경에서도 잘 동작하는 고성능 음성 토크나이저를 목표로 하고 있으며, 조만간 구체적인 성과를 공유드리겠습니다.
반복 패턴과 토큰 낭비 — 음성 이산화의 숨겨진 함정
저희가 사용하고 있는 음성 토크나이저는 음성 데이터를 초당 25개의 이산 토큰으로 변환하며, 각 토큰은 약 6천여개의 코드북 항목 중 하나로 구성됩니다. 나쁘지 않은 압축률이지만, 실제 사용해보면 시퀀스가 여전히 길고 반복이 많은 구조임을 알 수 있었습니다. 예를 들어, 하나의 발음이 몇 백 ms 동안 지속될 경우, 동일한 토큰이 여러 번 반복되는 구조가 만들어집니다.
이러한 반복 구조는 Transformer 기반 모델 입장에서는 일종의 안티패턴(anti-pattern)으로 작용할 수 있습니다. 즉, 정보량은 거의 없으면서도 시퀀스를 불필요하게 늘리고, 학습 시 주의 집중(attention)을 분산시켜 오히려 학습 효율을 저하시킬 수 있는 구조입니다.
음성 토큰에도 BPE를 적용하다
이 문제를 해결하기 위해, 저희는 텍스트 토크나이징에서 검증된 기법인 BPE(Byte Pair Encoding)를 음성 토큰에도 적용해 보기로 했습니다. BPE는 자주 등장하는 토큰 쌍을 반복적으로 병합해 시퀀스 길이를 압축시킬 수 있는 방식으로, 음성처럼 반복성이 높은 데이터에 특히 효과적이라고 할 수 있습니다.
저희는 약 6천여 개의 음성 토큰으로 구성된 기존 음성 토크나이저의 토큰 시퀀스를 대상으로, BPE 기반 토크나이저를 새롭게 학습하여 적용했습니다. 그 결과, vocab size 10,000 기준으로 약 30%의 시퀀스 길이 감소 효과를 얻을 수 있었습니다.
이산 음성 토큰 모델링
음성 토크나이저와 BPE를 통해 음성 응답을 이산형 토큰 시퀀스로 표현할 수 있게 되면서, 다음으로는 이 토큰 시퀀스를 어떤 방식으로 모델링할 것인가에 대한 고민의 단계입니다. 초기의 Audio LLM 연구에서는 음성 토큰을 기존 텍스트 LLM의 vocabulary에 직접 포함시키는 방식이 주로 사용되었습니다.
이 접근은 음성 토큰을 LLM의 임베딩 테이블과 출력 헤드에 추가하여, 텍스트와 음성을 하나의 시퀀스로 모델링하도록 하는 방식입니다. 그러나 이 방식에는 두 가지 실질적인 한계가 존재했습니다.
첫째, 음성 토큰은 텍스트에 비해 시퀀스 길이가 긴 편이므로, LLM이 이를 함께 처리하면 추론 속도와 계산 효율이 급격히 떨어집니다.
둘째, 임베딩과 출력 레이어 확장으로 인해 LLM 자체를 fine-tuning 해야 하며, 이 과정에서 기존 언어 지식이 손실(knowledge forgetting)될 가능성이 있습니다. 이는 서비스 품질 유지에 중요한 문제로 작용할 수 있죠.
이러한 한계를 극복하기 위해, 최근에는 음성 응답 생성을 전담하는 별도의 경량 모델, 즉 Voice Token LM을 사용하는 방식이 주목받고 있습니다. 이 방식에서는 LLM이 텍스트 형태의 응답을 먼저 생성하고, Voice Token LM은 LLM의 last hidden state를 입력으로 받아 해당 응답에 해당하는 음성 토큰 시퀀스를 생성합니다.
이렇게 함으로써 텍스트 응답에 담긴 의미 정보뿐 아니라, 입력 음성의 감정이나 억양 등 음향적 힌트까지 함께 활용할 수 있어, 자연스럽고 상황에 맞는 음성 응답 생성이 가능합니다. 게다가 Voice Token LM은 일반적으로 1B 내외의 경량 모델로 구성되기 때문에, 텍스트 시퀀스 대비 긴 오디오 시퀀스를 효율적으로 처리할 수 있으며, 계산량 및 추론 시간 측면에서도 매우 유리합니다.
저희 역시 앞서 소개한 두 가지 방식—LLM 단일 모델 통합 vs Voice Token LM 분리 방식—을 모두 실험적으로 비교해보았습니다. 그 결과, Voice Token LM을 활용한 방식이 연산 효율 면에서 더 우수했을 뿐 아니라, LLM의 기존 언어 지식도 안정적으로 유지되는 것을 확인할 수 있었습니다.
이산 음성 토큰을 실제 음성으로
마지막으로는 이산 음성 토큰들을 실제 사람이 들을 수 있는 음성 파형 (waveform)으로 변환시켜주는 token-to-wav 모듈 입니다. 이 모듈에서는 별도의 두 모델이 순차적인 두 단계에 걸쳐 사용됩니다.
첫 번째 단계는 언어모델이 출력한 이산 음성 토큰으로부터 멜 스펙트로그램(mel-spectrogram)을 생성하는 과정입니다. 이를 위해 저희는 Meta에서 발표한 음성 합성 모델인 Voicebox[3]의 구조를 기반으로 자체 구축한 한국어 데이터를 추가하여 학습한 모델인 Token-Voicebox를 활용했습니다. 이렇게 생성된 멜 스펙트로그램은 실제 음성 파형으로의 변환을 위한 중간 표현 역할을 하게 됩니다.
두 번째 단계는 멜 스펙트로그램을 실제 오디오 신호로 복원하는 작업입니다. 이 단계에서는 카카오엔터프라이즈에서 개발한 보코더(Vocoder) 모델인 Univnet[4]을 사용했습니다. Univnet은 멜 스펙트로그램을 입력으로 받아 고품질의 음성 파형을 빠르고 정확하게 생성할 수 있는 모델로, 실시간 음성 서비스에도 적합한 성능을 보여줍니다.
이 과정에서 사용되는 두 모델은 이산 음성 토큰을 기반으로 사전에 학습된 모델이며, Kanana-a의 오디오 디코딩 모듈 뒤에 연결되어 inference시 실제 음성을 생성하는 용도로 사용됩니다.
학습 데이터셋 구성
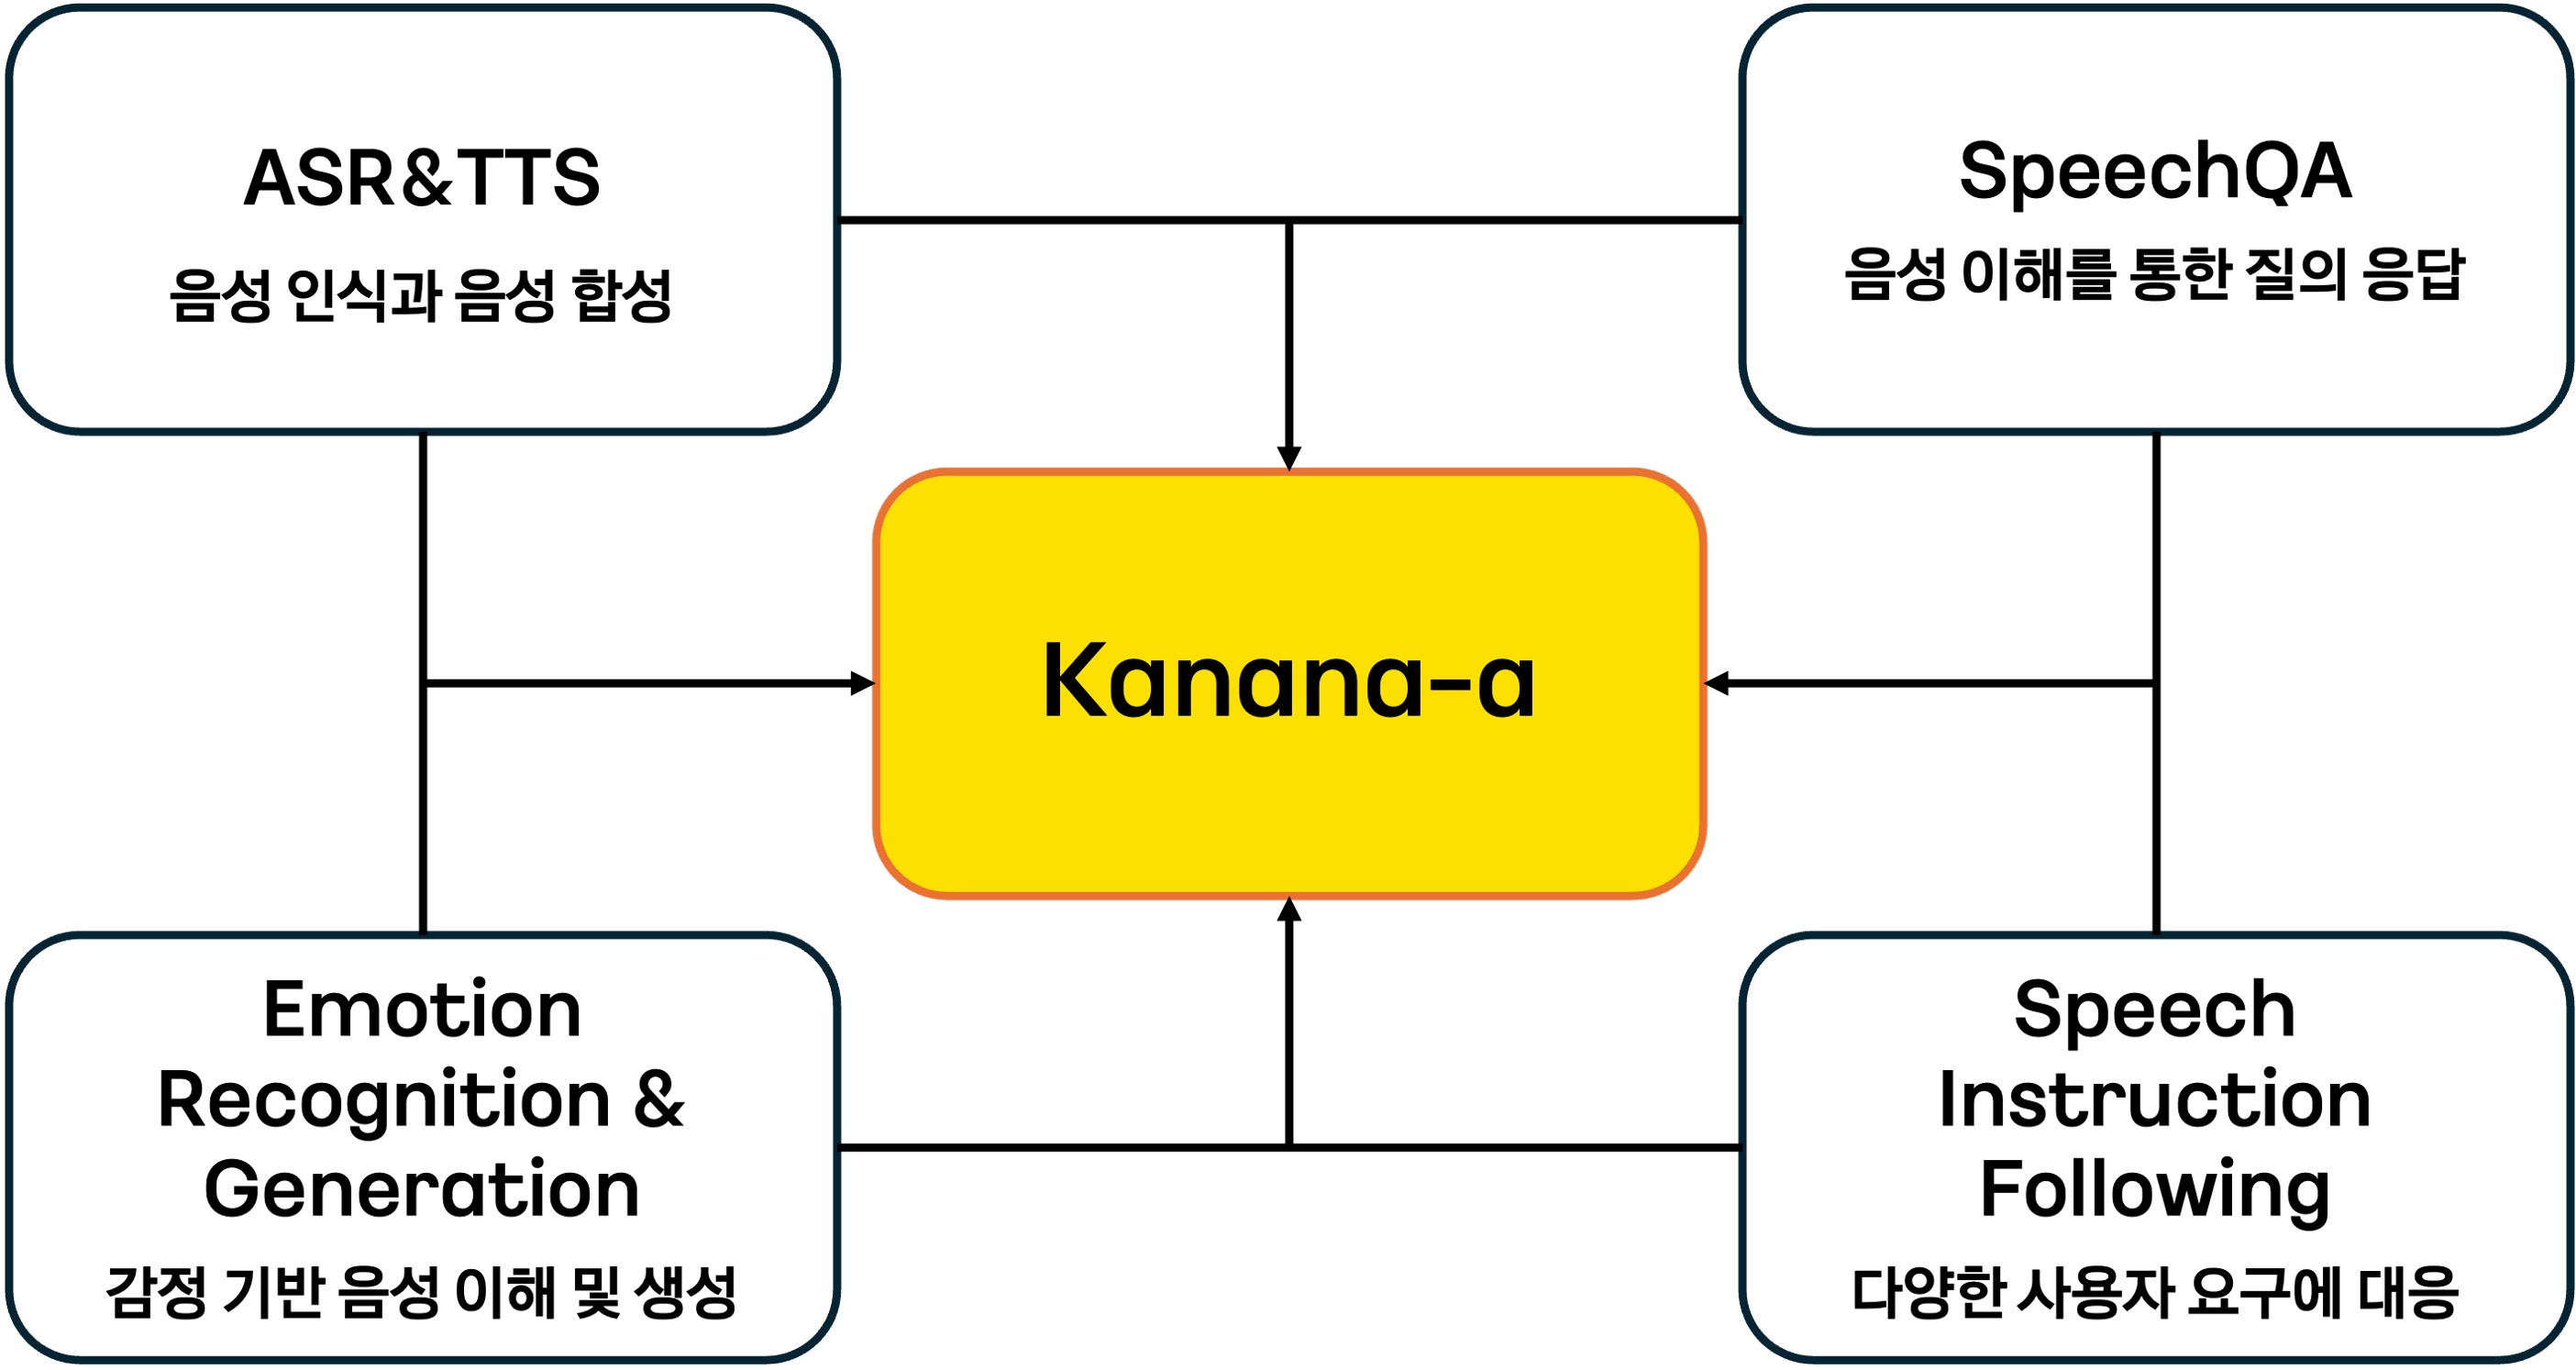
지금까지 Kanana-a의 모델 구조에 대해 설명드렸다면, 이제는 이를 뒷받침하는 학습 데이터셋 구성에 대해 소개드리고자 합니다. 강력한 음성 이해 모델을 만들기 위해서는 모델 설계 못지않게, 학습에 사용되는 데이터의 다양성과 품질이 핵심입니다.
특히 음성 데이터는 공개된 고품질 데이터가 상대적으로 부족하고, 한국어 음성 데이터의 경우 영어보다 데이터 부족 문제가 심각한 상황이라는 점에서 더 많은 고민과 노력이 필요했습니다.
이에 저희는 대부분의 데이터를 직접 수집하거나 가공하여, Kanana-a에 특화된 음성 학습 데이터셋을 구성했습니다.
ASR & TTS: 음성 인식과 음성 합성의 기반 데이터
음성 이해의 가장 기본이 되는 데이터는 ASR(Automatic Speech Recognition)과 TTS(Text-to-Speech) 데이터 입니다. ASR은 음성을 텍스트로 변환하는 태스크이며, TTS는 텍스트를 자연스러운 음성으로 변환하는 태스크입니다. 이 두 태스크는 음성 기반 AI 시스템의 근간이 되며, 이 기반 데이터의 품질과 규모가 이후 모든 다운스트림 태스크 성능에 큰 영향을 미칩니다.
영어 도메인의 경우 음성 인식 및 음성 합성에서 퍼블릭하게 공개된 데이터들이 많기 때문에 공개 데이터들을 주로 활용하였습니다. 반면, 한국어의 경우 AI HUB에 공개된 음성 인식 데이터들을 최대한 활용하되, 부족한 부분을 보충하기 위해 성우를 고용하여 고품질의 음성 데이터를 자체적으로 수집하였습니다.
이 중 TTS 태스크를 위한 데이터셋의 경우 음성 발화의 학습 대상이 되므로, 최대한 잡음없이 깔끔한 음성 발화 데이터만 남을 수 있도록 추가적인 필터링이 필요했습니다. 저희는 음성에 존재하는 잡음이나 왜곡, 자연스러움 등을 측정하는 DNSMOS(Deep Noise Suppression Mean Opinion Score)[5]와 SNR(Signal-to-Noise Ratio) 스코어를 필터링 기준으로 삼아 데이터 필터링 파이프라인을 구축 하였습니다.
또한, 음성 합성 기능을 학습시킬때 고려해야할 중요한 포인트가 한 가지 더 있습니다. 다양한 소스에서 수집된 TTS 데이터는 그만큼 음성 스타일이 제각각 입니다. 이러한 데이터를 그대로 모델 학습에 활용하면 생성되는 음성 스타일 또한 일관되지 않고 매번 달라질 수 있으며, 이는 사용자의 몰입감을 저해하는 요인이 됩니다.
따라서 저희는 보다 안정적이고 통일된 스타일의 음성을 생성할 필요성을 느꼈습니다. 이를 위해 전문 성우를 섭외하여 단일 화자의 음성 데이터를 별도로 수집하였고, 해당 데이터를 기반으로 모델을 튜닝함으로써 ‘카나나’만의 고유한 음성 스타일을 정립할 수 있었습니다.
SpeechQA: 음성 이해를 통한 질의응답 데이터
주어진 음성에 있는 내용을 그대로 text로 변환해주는 음성 인식 태스크에서 더 나아가 주어진 음성의 내용을 모두 파악하고, 유저의 질문에 해당하는 부분을 찾아 정확한 답변을 해주는 것 역시 음성 이해 모델의 중요한 능력 중 하나라고 할 수 있습니다.
저희는 이러한 태스크를 SpeechQA 태스크라고 부르는데요, 이 태스크의 경우 음성 인식 및 합성 데이터셋 대비 학습용으로 쓸만한 퍼블릭 데이터가 그리 많지는 않았습니다. 이에 저희는 SpeechQA를 위한 자체 데이터셋을 직접 제작하였습니다.
저희는 우선 전문 인터뷰, 강의, 뉴스 등 지식 기반 음성 데이터를 수집한 후, 일정한 길이로 잘라 단위 문맥(context)을 만들고, 각 문맥에 대해 LLM을 활용해 질의응답 쌍을 생성했습니다.
이 데이터 덕분에 Kanana-a는 단순한 음성 반복이 아닌, 내용 이해 기반의 정답 도출 능력까지 학습할 수 있었습니다.
Emotion Recognition & Generation: 감정 기반 음성 이해 및 생성
사람과의 대화에서 감정은 전달되는 의미 못지않게 중요한 정보입니다. 화자의 발화로부터 음성에 담긴 감정을 정확하게 파악하고, 상황에 맞는 적절한 반응을 제공함으로써 사용자에게 신뢰성 높은 소통과 자연스러운 대화 경험을 제공할 수 있습니다.
이 영역은 다행히도 AI HUB 등에서 공개된 국내외 퍼블릭 데이터가 비교적 풍부했기 때문에, 기존 데이터를 기반으로 모델을 학습시킬 수 있었습니다. 이를 통해 Kanana-a는 말투나 어조 속에 담긴 감정의 뉘앙스까지 이해하고 생성할 수 있도록 학습되었으며, 보다 풍부한 감정 표현을 통해 자연스러운 발화가 가능하도록 모델을 지속적으로 개선중입니다.
Speech Instruction Following: 다양한 사용자 요구에 대응하는 데이터
마지막으로, 사용자의 다양한 지시(instruction)에 유연하게 반응하는 능력을 길러주기 위한 instruction following용 음성 데이터도 저희가 자체적으로 구축했습니다. 이 데이터는 실제 사용자 경험에 가장 가까운 형태로, 모델의 실용성 및 범용성을 크게 높여줍니다.
Instruction following 데이터는 일상 대화, AI 어시스턴트, 음성 스타일 제어 등 다양한 사용자 지시에 유연하게 대응하는 능력을 기르기 위해 포괄적으로 구성되었습니다. 기존 텍스트 기반 instruction 데이터셋을 구어체화 하고 음성화하는 방식으로 대량의 데이터를 확보했으며, 더 나아가 자연어로 발화 음성의 스타일—억양, 빠르기, 화자 성별 등—을 자유롭게 컨트롤 할 수 있도록 하는 데이터셋 역시 직접 구축하였습니다. 이에 더해 한↔영 음성 통역 데이터는 AI HUB의 공개 데이터를 적극 활용하였습니다.
| Task | Instruction | ||
|---|---|---|---|
| Voice Assistant | 샐러드를 먹고 나서 배가 아픈데, 그 이유가 뭐지? 어떻게 나을 수 있을까? | ||
| Speech Style Control | “{Context}”에 대해 40대 남성의 중후한 목소리로 답변해줘. | ||
| Korean Dialect | “{Context}”는 어느 지역 방언이야? 표준어로 다시 읽어줘. | ||
| Translation | “{Context}”를 한국어/영어로 통역해서 말해줘. |
<표1. Speech instruction following 데이터셋의 예시. Instruction의 경우 음성이나 텍스트 모두 지원>
학습 전략
Kanana-a는 크게 Audio Encoder, Audio Projector, LLM, Voice Token LM의 4가지 주요 모듈로 구성되어 있습니다. 이들을 각각의 스테이지에서 세심하게 학습하는 것이 중요한데요, 전체적인 학습 전략은 아래 테이블과 같이 3-stage 학습 전략에 기반합니다.
참고로 주요 학습 모듈 외에 voice token LM이 출력해주는 이산 음성 토큰을 멜 스펙트로그램 및 최종 음성 파형으로 변경해주는 모듈은 사전 학습된 상태로 고정하였습니다.
| Stages | Training modules | Data domains | |
|---|---|---|---|
| Speech pre-training | 1 | Audio projector, Voice token LM | ASR, TTS |
| Continued pre-training | 2 | Entire model | ASR, TTS, SpeechQA(일부), SER(일부) |
| Supervised fine-tuning | 3 | Entire model | ASR, TTS, SpeechQA, SER, Speech instruction following |
<표2. Kanana-a의 3-stage 학습 전략>
Stage-1: Speech Pretraining
먼저 첫 학습 stage에서는 Audio Projector와 Voice Token LM을 대규모 ASR 및 TTS 데이터셋을 활용해 사전학습 시킵니다. 이 단계의 핵심 목표는 이 두 모듈이 사전학습된 Audio Encoder와 LLM의 입출력 임베딩 공간에 자연스럽게 정렬(align)될 수 있도록 만드는 것입니다.
이 과정을 통해 LLM은 음성 입력을 이해하고, 텍스트 응답을 음성으로 전환시킬 수 있는 기본적인 음성 입출력 흐름을 학습하게 됩니다. 특히, 이 단계에서 해당 능력을 제대로 학습하지 않으면 이후의 학습 과정에 큰 문제가 생기기 때문에 이 단계에서 충분히 학습을 수행시킬 필요가 있습니다.
Stage-2: Continued pre-training
첫 스테이지에서 Audio Projector 및 Voice Token LM 사전학습을 통해 전반적인 음성 피처의 흐름을 Audio Encoder와 LLM의 입, 출력 공간에 어느정도 맞춰 주었습니다.
이번 스테이지는 전체 모델을 동시에 학습하여 이러한 음성 피처 흐름의 정합성을 강화함으로써 음성 이해 및 합성 능력을 최대한 끌어올리는 단계라고 할 수 있습니다.
이 단계에서는 사전학습된 Audio Encoder와 LLM도 같이 학습되는데요, ASR 및 TTS데이터에 부족한 음성의 비 언어적 정보를 같이 모델링 시키기 위해 음성 감정 인식 데이터의 일부도 같이 활용합니다. 또한 간단한 SpeechQA 데이터도 일부 활용하여 LLM이 음성 입력을 분석하고 적절한 응답을 해주도록하는 조금 더 강화된 음성 이해 능력을 학습시키고자 하였습니다.
Stage-3: Supervised Fine-tuning
이전 스테이지들을 통해 모델이 입력 음성을 이해하고, 발화할 수 있는 기본 능력을 갖추게 되었습니다. Stage 3에서는 이를 바탕으로 유저의 지시(instruction)에 반응하고, 감정까지 고려한 자연스러운 음성 응답을 생성할 수 있도록 모델을 고도화합니다. 이를 위해 앞서 설명드린 SpeechQA, Speech Emotion Recognition & Generation, Speech Instruction Following 데이터 모두를 활용하였습니다.
이 중에서 특히 Speech Instruction Following 태스크에서는 세심한 주의가 필요합니다.
앞서 모델 구조 섹션에서 살짝 언급드린 것처럼, 유저의 지시에 대한 응답은 LLM이 text로 먼저 생성하게 한 뒤, Voice Token LM이 text 응답에 상응하는 음성 토큰을 생성하도록 해야 합니다. LLM이 text 응답을 먼저 생성하는 과정을 건너뛰게 되면, lightweight Voice Token LM이 유저의 지시를 바로 음성 토큰으로 바꾸는 과정에서 복잡한 요청을 제대로 이해하지 못하게되고 결국 답의 내용 뿐만 아니라 음성의 품질까지 저하될 수 있습니다.
따라서 저희는 LLM이 텍스트 형태로 응답을 먼저 생성하게 하고, 그 텍스트를 Voice Token LM이 받아 음성 토큰으로 변환하는 방식으로 변경하게 되었습니다. 그리고 이 과정에서 LLM의 응답뿐만 아니라 입력으로 주어졌던 컨텍스트까지 포함하여 LLM의 last hidden state를 Voice Token LM에 전달함으로써, 단순한 텍스트 정보뿐만 아니라 감정이나 말투 같은 비언어적 정보도 함께 음성 합성 과정에서 반영될 수 있도록 했습니다.
이렇게 구조를 재설계한 결과, 음성 응답의 자연스러움과 명료도가 눈에 띄게 좋아지는것을 확인할 수 있었습니다.
Learning without forgetting
Stage 2와 3에서는 LLM과 Audio Encoder까지 포함해 전체 모델을 같이 학습시키는데요, 이 과정에서 주의해야 할 중요한 이슈가 있습니다. 바로 “망각”(Catastrophic forgetting) 현상입니다.
망각 현상은 이전부터 AI 모델을 학습할때 항상 부딪혀왔던 문제로, 새로운 지식을 학습시킬 때 모델이 이전에 학습했던 사전 지식을 점차 잊게되는 현상을 말합니다. 특히, ASR이나 TTS처럼 고도의 추론이 필요하지 않은 단순 변환 태스크들을 학습하다 보면 기존에 LLM이 학습했던 고도의 추론 능력이 빠르게 소실될 수 있기 때문에 이러한 망각 현상을 잘 완화시키는 것이 중요합니다. 이는 사전 학습된 가중치를 기반으로 추가적으로 fine-tuning되는 Audio Encoder에도 동일하게 적용되는 문제이죠.
저희는 이를 완화시키기 위해 Kanana-v에서 수행했던 것과 마찬가지로 Audio Encoder 및 LLM의 학습률(Learning rate)을 레이어별로 섬세하게 조정하였으며, LLM 학습시 사용하였던 말뭉치(Text corpus) 데이터도 일부 포함시켜 Stage-2 및 3 학습을 진행시켰습니다. 이를 통해 다양한 언어 벤치마크들의 성능을 유지시키면서도 고도의 음성 이해 및 합성 능력을 가진 Kanana-a를 만들 수 있었습니다.
스트리밍 음성 합성
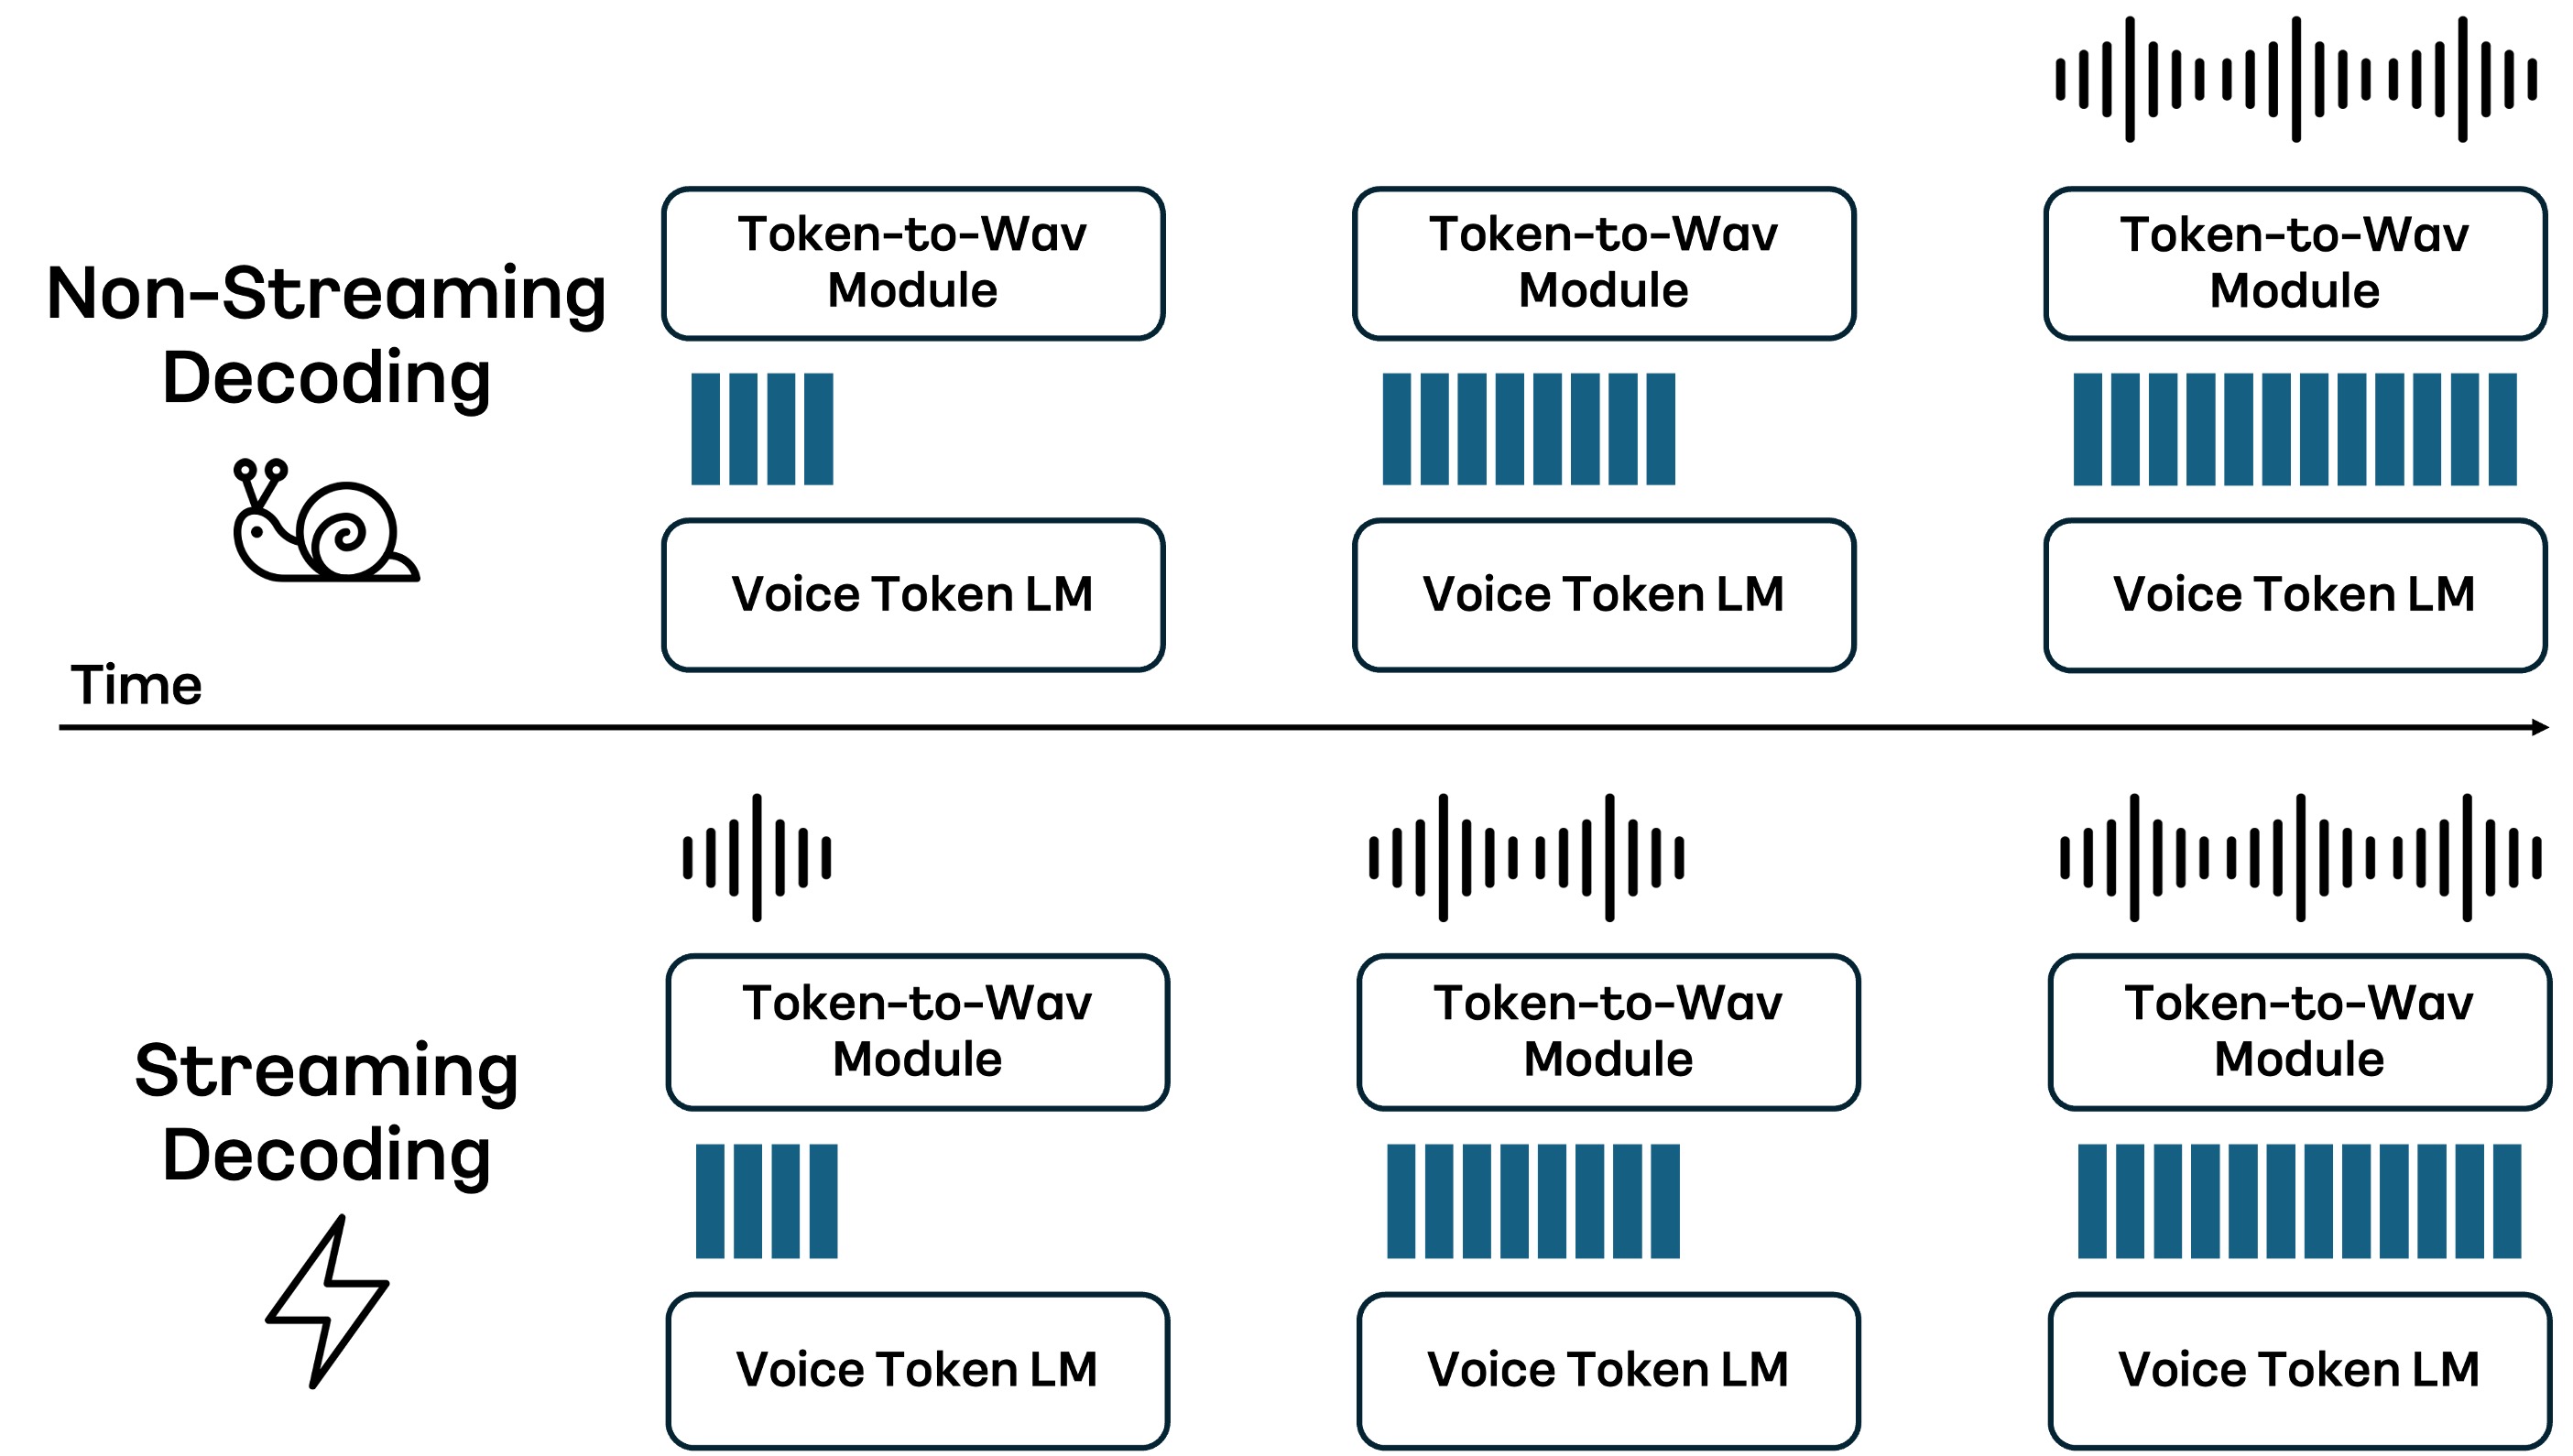
BPE 인코딩을 적용하여 언어모델에서 출력하는 음성 토큰의 길이를 줄이고 lightweight 한 Voice Token LM 을 사용하였음에도 불구하고, 전체 음성 토큰이 생성될때까지 기다린 다음 유저에게 답변을 제공하는 비 스트리밍 방식을 음성 대화 서비스에 적용하기엔 대기시간(latency)이 너무 큽니다.
이러한 긴 대기시간을 해결하기 위해서 생성되는 답변이 전부 나올때까지 기다리는 대신, 어느정도 길이마다 생성된 답변을 바로바로 유저에게 전달하는 스트리밍 디코딩(Streaming Decoding) 방식을 추가적으로 지원하도록 하였습니다. 이는 ChatGPT를 포함하여 다른 AI 모델들에서 주로 사용되는 방식으로, 유저가 중간중간 생성된 답변을 읽는 동시에 다음 답변 시퀀스를 생성하도록 하여 유저로 하여금 거의 지연없는 답변을 받는 느낌으로 인식될 수 있습니다.
음성 대화 상황에서도 이를 적용하기 위해서는 음성 토큰을 파형으로 바꾸기 위해 기존에 학습했던 Token-Voicebox와 Univnet을 스트리밍을 지원하도록 새로 학습하거나 Chunked Inference 방식 등을 적용해서 스트리밍을 지원하는 게 일반적입니다.
Kanana-a에서는 chunked inference 방식을 적용하여 스트리밍을 지원하고 있으며, 이를 통해 응답 대기시간을 크게 줄인 결과 유저는 전보다 더욱 빠르게 모델의 응답을 들을 수 있게 되었습니다.
카카오의 통합 멀티모달 언어모델: Kanana-o
최근 인공지능 기술은 LLM에서 Vision-centric Multimodal LLM, 그리고 이제는 Omni-modal LLM으로 진화하고 있습니다. 2024년 초까지의 멀티모달 모델 대부분은 시각 정보를 중심으로 설계되었지만, 2024년 5월 GPT-4o의 등장은 인공지능 연구자들에게 새로운 영감을 주었습니다. 감정을 담아 말하고, 사람의 말투에 따라 속도와 어조를 바꾸며, 대화 중 실시간으로 반응하는 GPT-4o의 데모는 단순한 기술적 진보를 넘어, AI가 사람과 ‘소통’할 수 있는 존재로 다가온 순간이었습니다.
이제 AI는 하나의 감각만 정교하게 다루는 것으로는 충분하지 않습니다. 우리가 누군가의 표정과 말투를 동시에 읽고, 풍경을 보며 질문을 던지고, 목소리의 떨림에서 감정을 감지하는 것처럼, 인공지능 역시 단일 텍스트 입력을 넘어, 시각과 청각을 아우르는 복합적인 감각 정보에 반응할 수 있어야 진정한 상호작용이 가능해집니다.
Kanana-o는 이러한 배경에서 출발한 카카오의 통합 멀티모달 언어모델 (Omni-modal LLM)입니다. 음성과 이미지, 텍스트 중 어떤 형태로든 입력을 받을 수 있고, 상황에 따라 텍스트 또는 음성으로 자연스럽게 응답할 수 있는 구조로 설계되었습니다. 이는 단순히 Kanana-a(Audio LLM)와 Kanana-v(Vision LLM)를 결합한 것에 그치지 않고, 서로 다른 감각 정보를 하나의 맥락으로 엮어내는 통합적 이해와 생성 능력을 실현하기 위한 시도입니다.
이번 섹션에서는 지금까지 연구・개발한 Kanana-a와 Kanana-v를 어떻게 엮어 Kanana-o를 만들어낼 수 있었는지에 대해 학습 방식부터 데이터 수집, 정량 및 정성 결과까지 저희의 고민과 성과에 대해 자세하게 공유드려보도록 하겠습니다.
모델 구조 및 학습 전략: 기본적인 학습 전략과 한계점
Kanana-a와 Kanana-v는 같은 LLM backbone을 공유합니다. 따라서 이 두 모델의 구조적인 결합은 앞서 보여드린 Kanana-a 모델에 시각 정보를 처리할 수 있는 Vision Encoder와 Visual Projector를 추가하는 것으로 Kanana-o의 모델 구조를 디자인 할 수 있습니다.
이 글에서 설명드리지 않은 Kanana-v에 대해 자세한 내용이 궁금하신분은, 저희 테크 블로그의 “이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기”를 참고하시는 것을 추천드립니다.
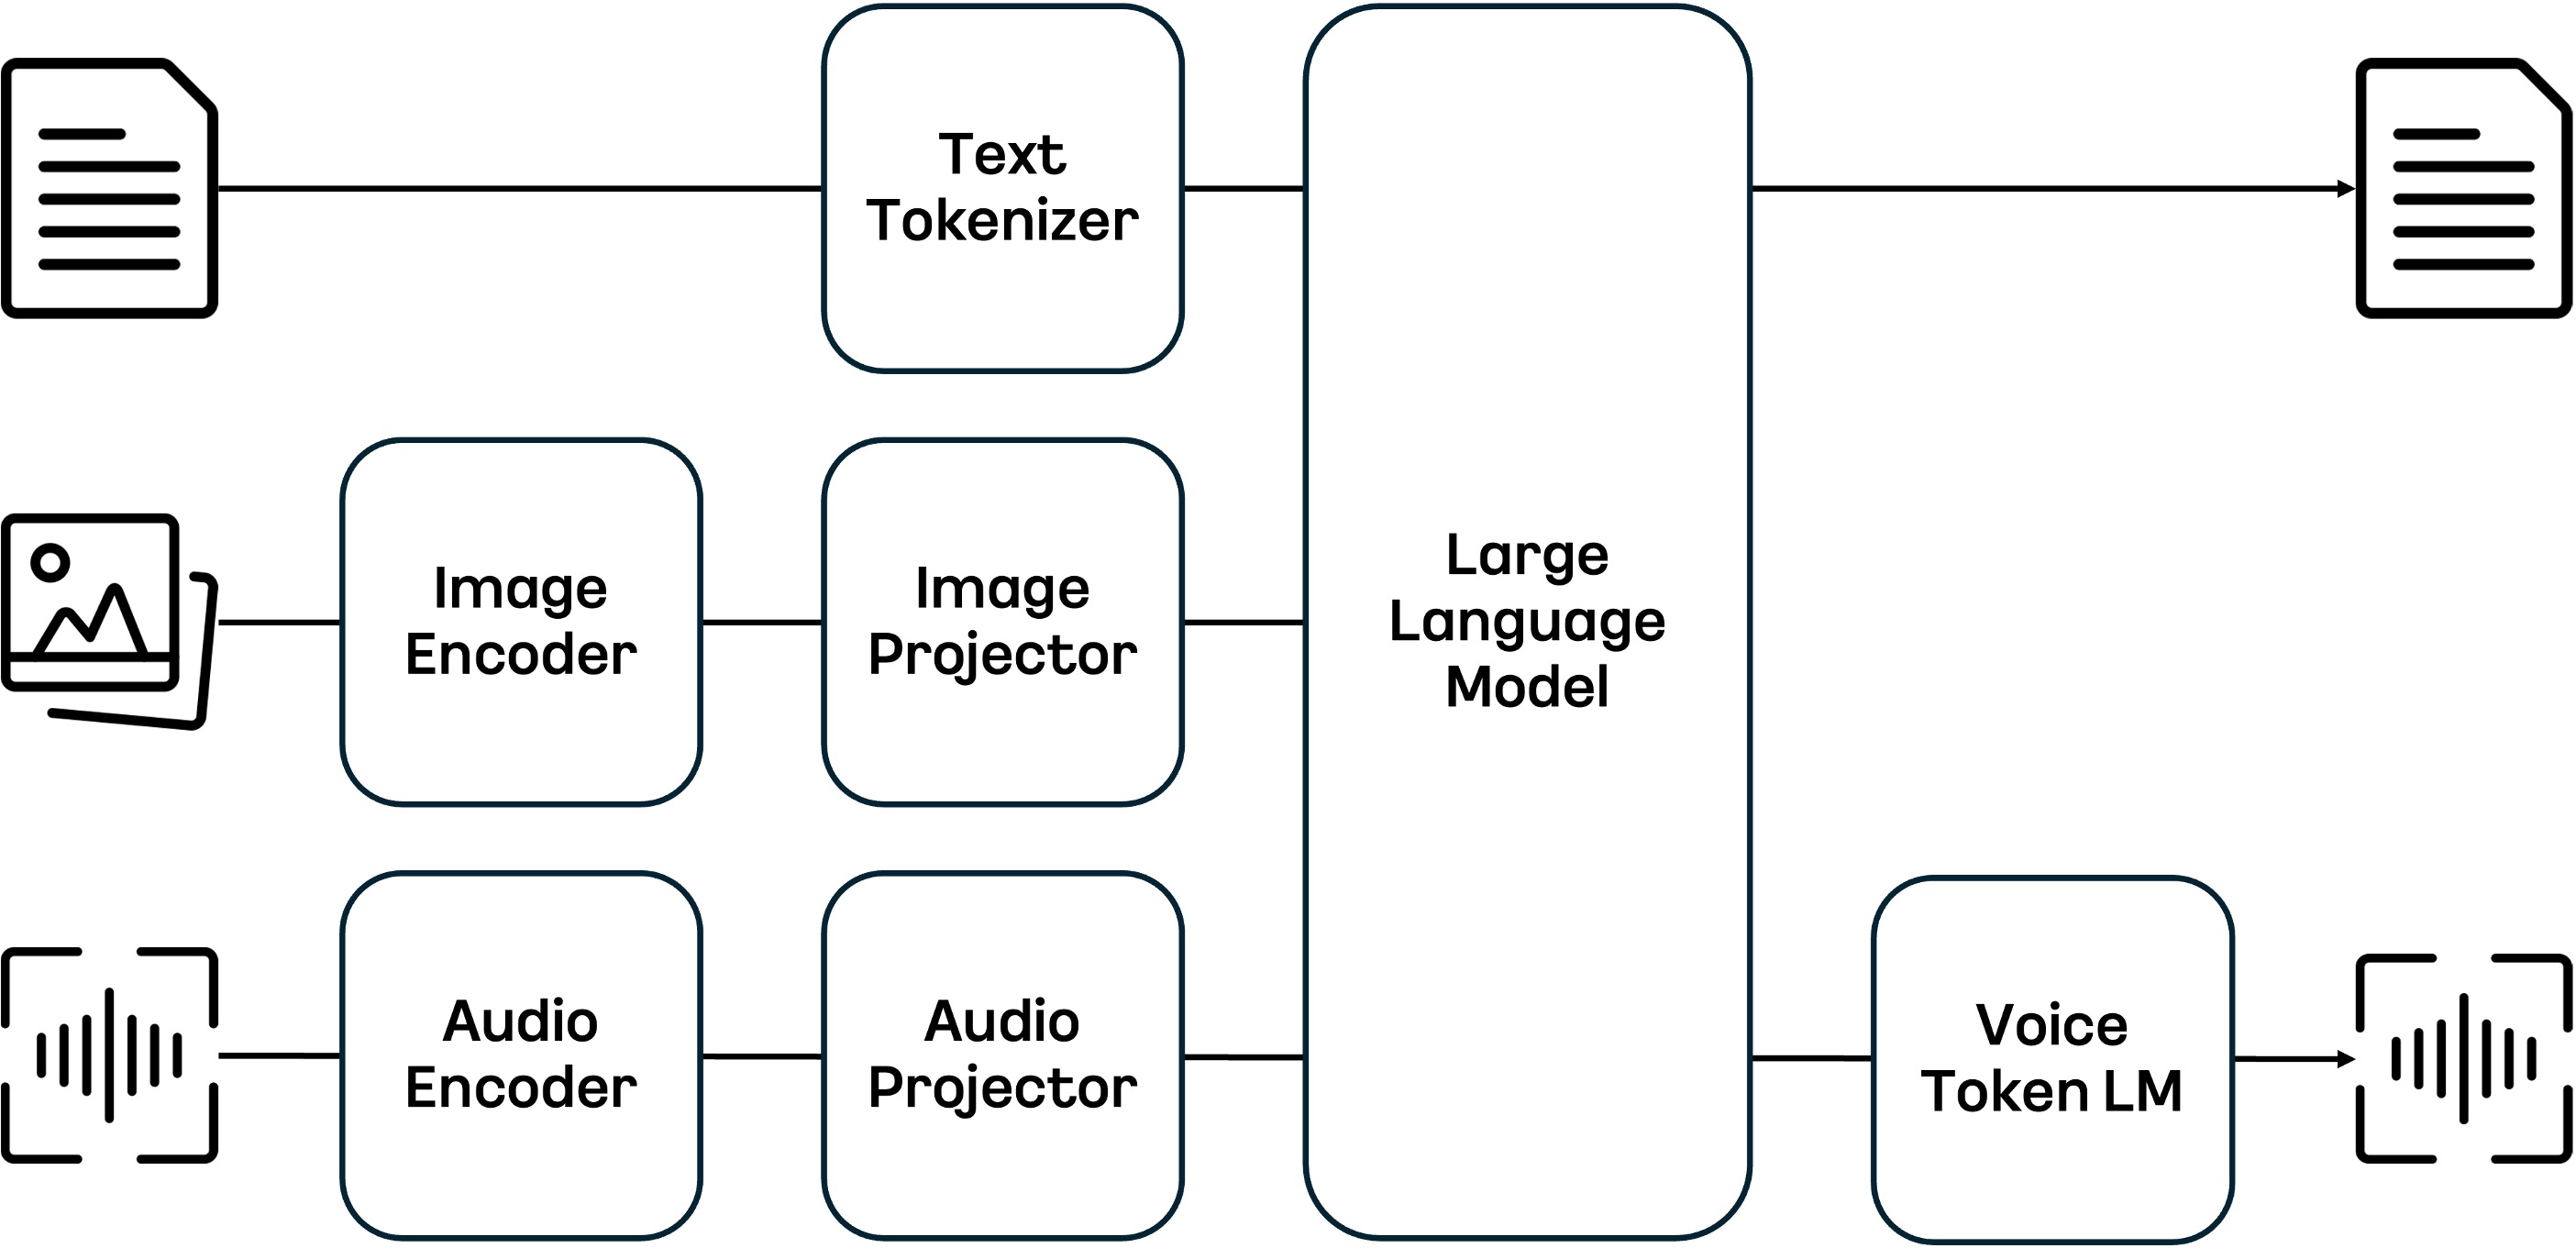
그럼 이제 시청각 정보를 아우르는 통합 멀티모달 언어모델인 Kanana-o를 학습시키는 전략에 대해 본격적으로 다뤄보도록 하겠습니다.
우선 통합 멀티모달 언어모델을 학습하는 방식은 크게 두 가지로 구분될 수 있는데요, 각각의 모달리티 별 학습을 순차적으로 수행하는 순차 학습(Sequential Training)과 처음부터 모든 모달리티 데이터를 같이 학습시키는 병합 학습(Joint Training) 방식이 있습니다. EMOVA[6]에서는 이 중 병합 학습 방식이 최종적인 성능 측면에서 더 좋다는 결과를 보여주었고, 저희 역시 이를 기본 전략으로 채택하였습니다.
병합 학습 방식의 경우 각각의 모달리티별 벤치마크 성능이 균형있게 잘 나온다는 장점이 있습니다. 하지만 모든 모달리티 데이터를 모든 스테이지에서 활용하다보니 스테이지별 학습 시간이 길어질 수 있고, 결국 저희는 아래와 같은 두 가지 현실적인 문제에 부딪혔습니다.
- Ablation 실험의 유연성 부족 문제: 모델을 개발하면서 한 번의 학습으로 최상의 성능을 얻기는 매우 어렵습니다. 학습률, 스테이지별 전략, 데이터셋 비율 등 다양한 요소들을 탐색해야 하는데, 매번 전체 데이터를 사용해 긴 학습을 반복하는 것은 자원이 제한된 환경에서 매우 비효율적이었습니다.
- 독립 모듈 개선 시 재학습 부담 문제: Kanana-a와 Kanana-v는 독립적으로 발전 중인 모듈입니다. 한쪽의 학습 레시피가 바뀌어 성능이 개선되더라도, 기존 방식대로라면 통합 모델인 Kanana-o를 처음부터 다시 학습해야 했습니다. 이는 연구와 서비스 모두에서 지속가능한 개발을 어렵게 만드는 요인이었습니다.
Model Merging: 병합으로 풀어낸 유연성과 학습 속도
이러한 문제를 해결하기 위해 저희는 최근 LLM 연구 커뮤니티에서 활발히 사용되고 있는 모델 병합(Model Merging)[7] 기법을 도입했습니다. 모델 병합은 서로 다른 태스크에 특화된 모델들을 하나의 모델로 통합시키는 방법으로, 이를 잘 활용하면 Kanana-o의 학습 시간을 엄청나게 단축시킬 수 있습니다.
핵심은 Kanana-a와 Kanana-v가 같은 LLM을 공유한다는 사실인데요, 이때문에 각각 학습된 Kanana-a와 Kanana-v를 모델 병합 기법을 사용하여 자연스레 병합시킬 수 있고, 병합된 모델에 대해 마지막 stage-3 정도만 추가로 학습시키는 방식으로 학습 효율을 끌어올릴 수 있었던 것이죠. 실제로 전체를 처음부터 Joint Training으로 학습하는 것과 동등한 수준의 성능을 모델 병합 기법과 짧은 추가 학습만으로 달성할 수 있음을 확인 하였습니다.
Kanana-o는 이러한 Model Merging 기법을 전략적으로 활용해, Kanana-a와 Kanana-v를 독립적으로 실험 및 개선하면서도, 필요에 따라 빠르게 통합하여 최신 성능을 반영한 통합 모델을 생성할 수 있는 구조를 확보했습니다. 결과적으로 모델 개발 관점에서 속도와 유연성, 성능을 동시에 잡는 효율적인 학습 파이프라인을 구축할 수 있었습니다.
Omni-modal 학습 및 평가 데이터셋
기존의 Multimodal LLM 학습은 주로 이미지-텍스트, 또는 오디오-텍스트처럼 두 개의 모달리티만을 포함한 바이모달(bi-modal) 데이터셋에 의존해 왔습니다. 그러나 Kanana-o는 이미지, 오디오, 텍스트의 세 가지 입력 모달리티가 어떤 조합으로 주어지더라도 이를 유연하게 이해하고 응답할 수 있어야 하는 Omni-modal LLM입니다.
따라서 저희는 기존의 두 가지 바이모달 데이터셋에서 한 걸음 더 나아가 이미지와 오디오가 함께 입력되거나 이미지, 오디오, 텍스트 세 가지 모달리티가 동시에 입력으로 들어오는 등의 더욱 다양한 시나리오들을 상정하였습니다.
초기에는 기존의 두 가지 바이모달 데이터로도 어느 정도 일반화가 가능할 것이라는 기대가 있었지만, 실제 실험에서는 학습 시 보지 못한 모달리티 조합에 대해 모델의 반응이 불안정하게 나타나는 경우가 종종 있었습니다. 이러한 관찰을 토대로 저희는 제대로된 Omni-modal LLM을 학습시키려면 세 가지 모달리티가 다양하게 조합되어 들어오는 학습 데이터셋이 어느정도는 필요하다고 판단했습니다.
하지만 현실적으로 이러한 삼중 조합 모달리티 데이터셋은 공개되어 있는 사례가 거의 없으며, 특히 한국어 기반으로는 사실상 전무한 상황입니다. 이러한 한계 속에서 저희는 기존 Kanana-v에서 사용했던 이미지-텍스트 데이터셋을 기반으로 TTS 기반 음성 합성을 통해 새로운 형태의 Omni-modal 학습 데이터를 구축하였습니다.
아래에서 저희가 이 새로운 데이터셋을 어떻게 만들었는지에 대해 조금 더 자세히 설명드려보도록 하겠습니다.
학습 데이터셋
기존 Kanana-v 모델은 철저한 정제 과정을 거친 이미지-텍스트 쌍 데이터를 기반으로 학습되었으며, 해당 데이터는 한국어와 영어 모두에서 콘텐츠 품질은 물론, 표현 다양성과 주제 분포까지 고르게 갖춘 균형 잡힌 구성을 갖추고 있습니다.
저희는 이 데이터셋을 기반으로 입력 혹은 응답 텍스트에 대응되는 음성을 TTS 모델을 통해 생성함으로써, 이미지-텍스트 쌍을 이미지-오디오 혹은 이미지-오디오-텍스트 형태로 확장 하였습니다.
TTS 음성 합성에는 Voicebox[3]와 StyleTTS2[8]를 기반으로 내부적으로 확보한 고성능 TTS 시스템을 사용하여 실제 발화와 유사한 품질의 음성들을 확보하였습니다. 또한, 실제 사용자 환경에 가까운 다화자 환경에서도 강건한 성능을 보장할 수 있도록 다양한 화자의 목소리를 사용하여 음성을 합성 하였습니다.
이렇게 생성된 이미지-오디오-텍스트 데이터셋은 매 학습 iteration마다 다양한 입력-출력 조합을 구성하는 식으로 활용되었습니다. 예를 들어 이미지와 텍스트를 입력으로 받아 음성으로 응답하거나, 이미지와 음성을 입력으로 받아 텍스트로 설명하는 식의 조합을 자유자재로 구성할 수 있었죠.
이처럼 서로 다른 모달리티 간의 연결성과 상호작용을 학습하게 함으로써, Kanana-o는 실제 환경에서도 유연하게 정보를 처리하고 적절한 형태로 응답할 수 있는 능력을 갖출 수 있었습니다.
<영상1. Omni-modal 학습 데이터셋 예시>
평가 데이터셋
Kanana-o는 다양한 모달리티 조합을 바탕으로 학습된 모델인 만큼, 그 성능을 정밀하게 평가하려면 Omni-modal 특성에 부합하는 맞춤형 평가셋이 필요합니다. 예를 들어, 기존 Kanana-v 모델은 이미지와 텍스트를 입력으로 받아 텍스트로 응답하는 구조였기 때문에, 텍스트 기반 응답을 평가하는 공개 벤치마크(MMB, SEED, MME 등)를 그대로 활용할 수 있었습니다.
그러나 Kanana-o는 “이미지+오디오 → 텍스트” 시나리오까지 지원해야 하므로, 이를 다루는 삼중 모달 평가셋이 새롭게 요구 되었습니다.
이에 저희는 학습 데이터 증강과 동일한 방식으로 기존 이미지-텍스트 벤치마크를 확장하여, 이미지-오디오 입력을 지원하는 새로운 평가셋을 구성했습니다. 구체적으로는, 기존 벤치마크의 텍스트 명령어(예: 질문)를 TTS를 통해 음성으로 변환한 뒤, 이를 이미지와 함께 입력으로 사용하고 Kanana-o의 텍스트 응답을 평가하는 방식입니다.
이 방식은 입력 형식만 다를 뿐 질문의 시맨틱 정보는 동일하게 유지되기 때문에, 텍스트 입력과 오디오 입력 간 이해 성능을 직접 비교할 수 있다는 장점이 있습니다. 덕분에 Kanana-o의 다중 모달 처리 능력을 정밀하게 진단할 수 있었고, 이를 바탕으로 향후 모델 개선 방향을 설정하는 데에도 실질적인 도움이 되었습니다.
정량 성능 평가
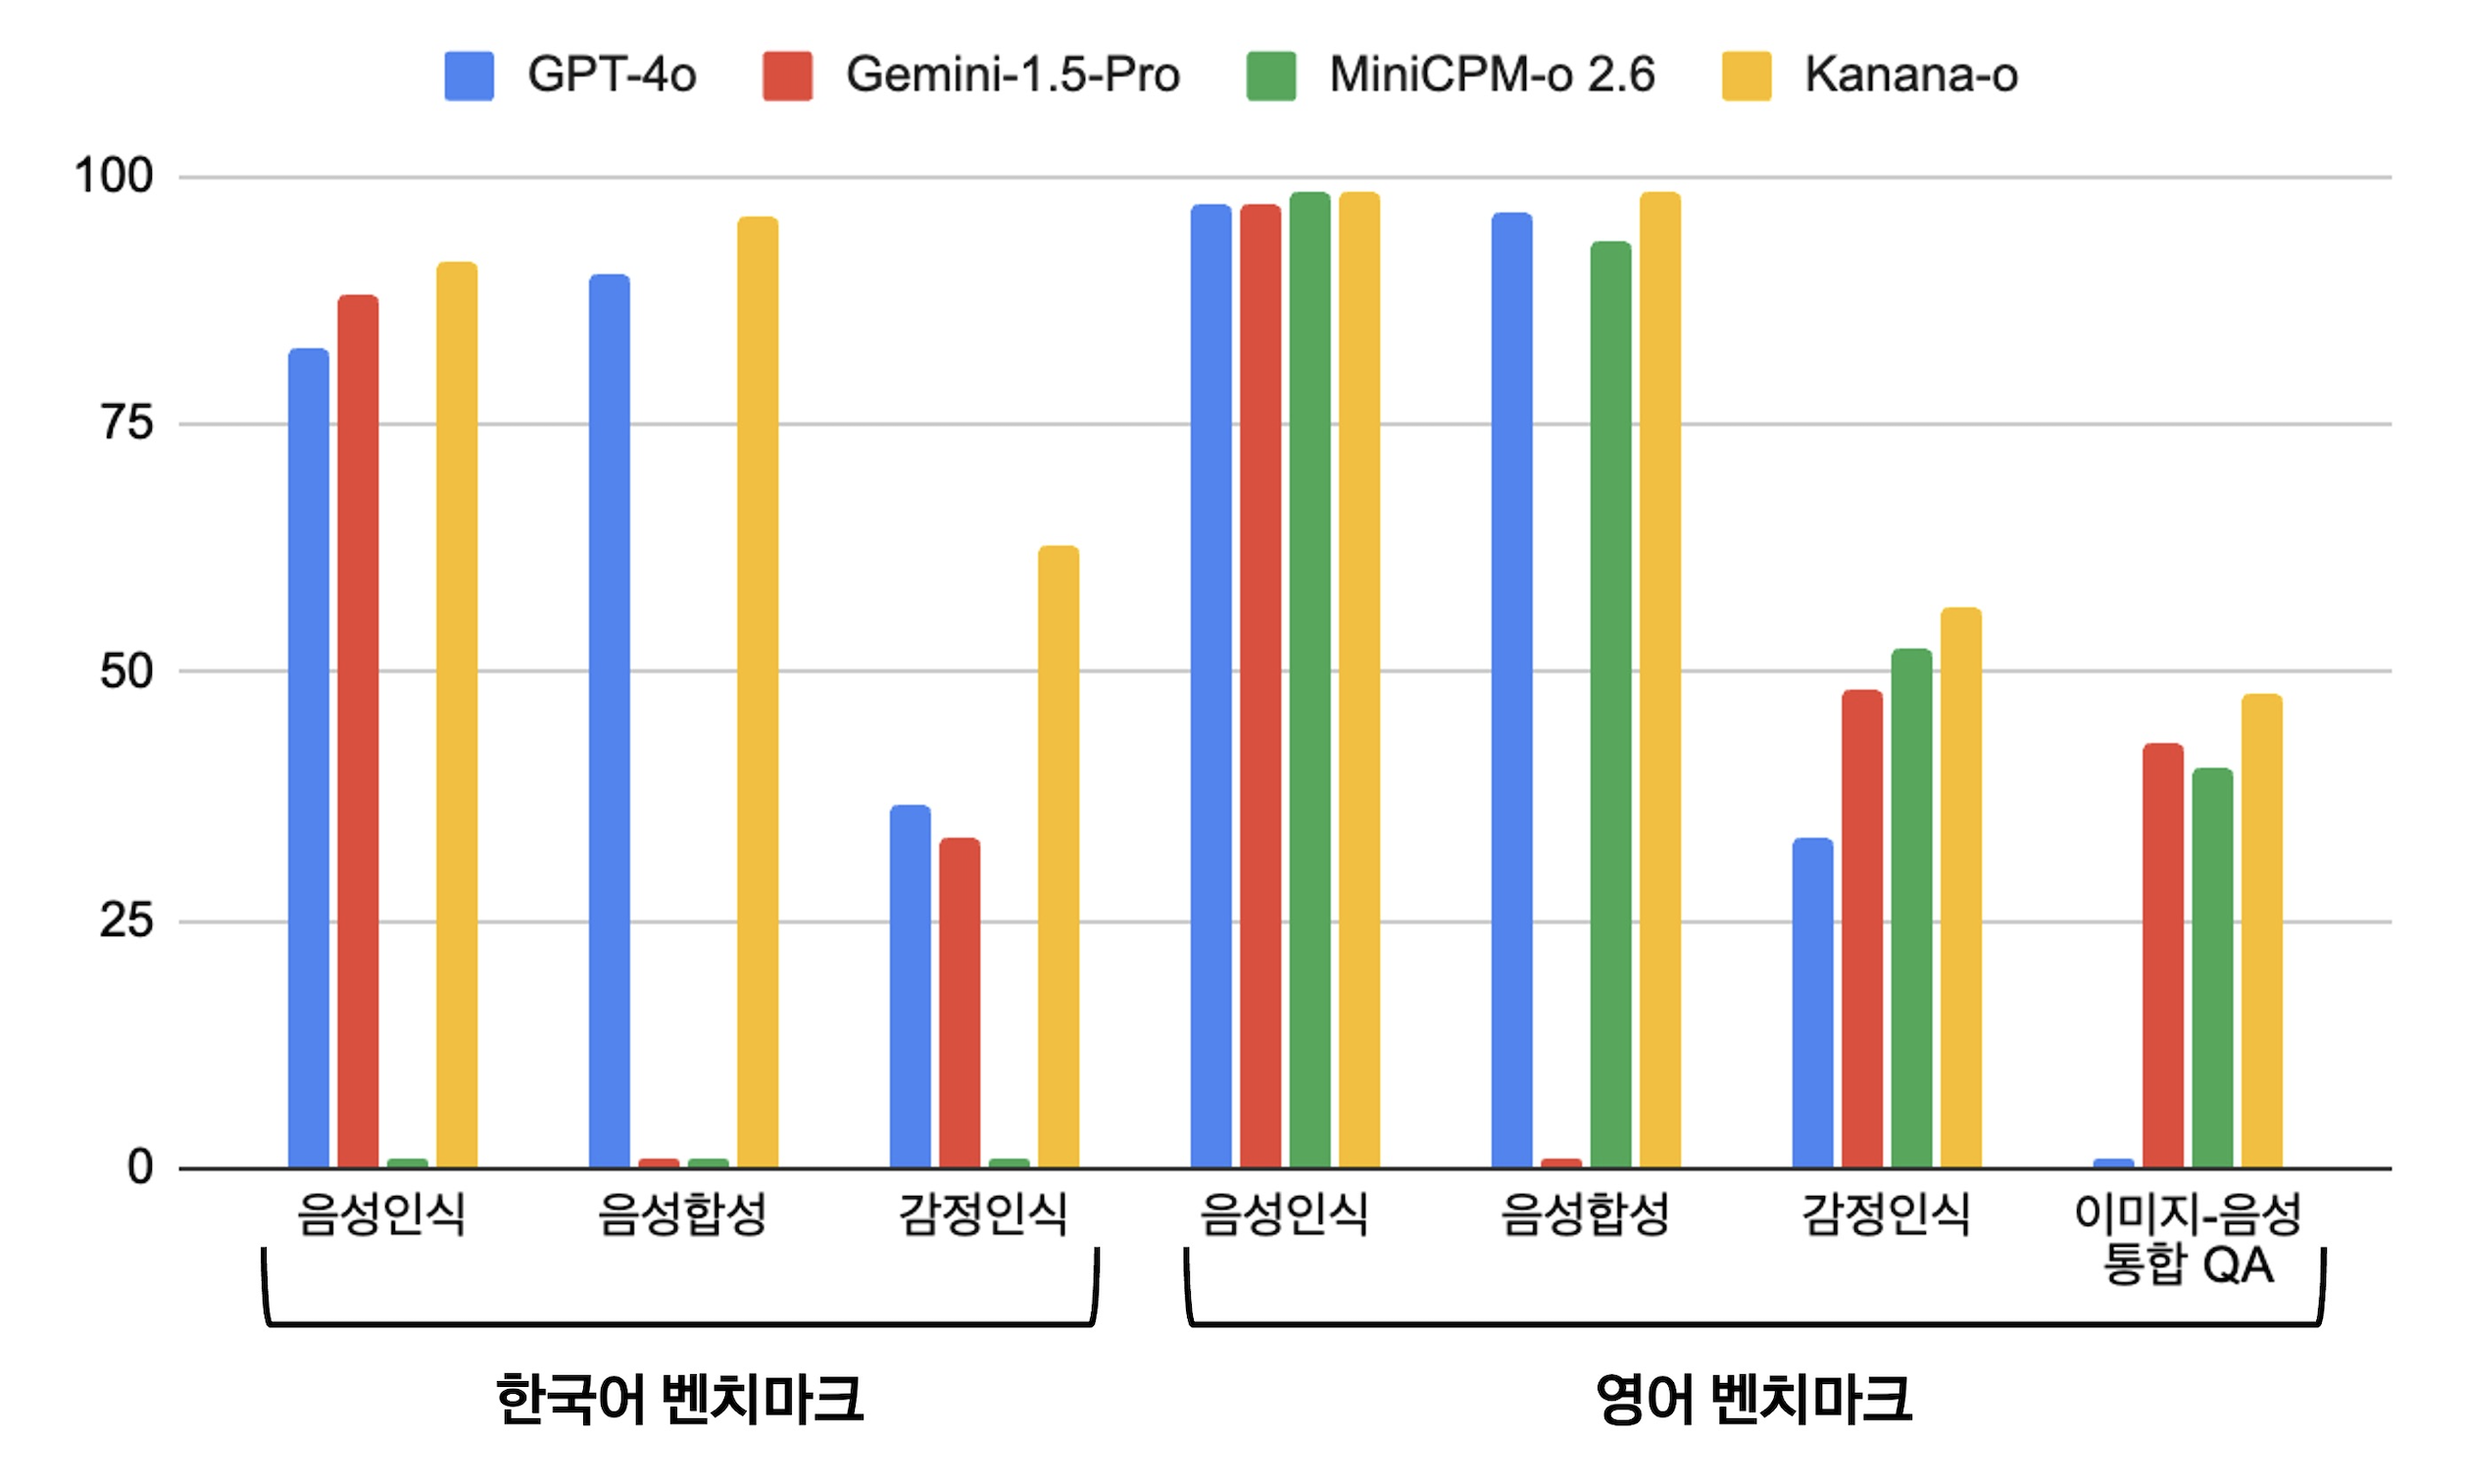
지금까지 Kanana-a와 Kanana-o를 만들기 위해 데이터 수집부터 모델 구조 설계, 학습에 이르기까지 겪었던 도전과 고민의 과정을 소개해 드렸습니다. 수많은 시행착오와 치열한 고민 끝에 완성한 저희 모델은 한국어에서 압도적인 성능을 기록했고, 영어에서도 글로벌 수준의 모델들과 어깨를 나란히 할 만큼 경쟁력을 갖추었는데요. 지금부터 저희 모델의 성과를 보다 구체적인 수치와 함께 소개해 드리겠습니다.
Kanana-o 음성 이해 및 생성 능력 비교
한국어 음성 평가의 경우 세계적으로 널리 활용되는 보편적인 평가 데이터들이 아직은 많지 않습니다. 영어 데이터를 단순히 한국어로 통역해 활용할 수도 있겠지만, 이러한 방식으로는 한국어 고유의 발화 특성이나 문화적 맥락, 그리고 배경지식과 같은 중요한 요소들을 제대로 평가할 수 없습니다.
이에 저희는 영어 음성 모델 평가에 주로 사용되는 태스크 카테고리를 기반으로 하여 한국어 맞춤형 평가 데이터셋을 직접 구축하였습니다. 여기에는 기본적인 음성 인식(ASR) 및 음성 합성(TTS) 뿐만 아니라, 주어진 음성 맥락에 대해 묻고 답하는 SpeechQA, 화자의 감정을 정확히 파악해야 하는 Speech Emotion Recognition(SER) 태스크들이 포함되어 있습니다.
아래 표 4에서 보시는 바와 같이 Kanana-o는 한국어에 대해 모든 태스크에서 세계적으로 널리 활용되는 통합 멀티모달 언어모델들을 압도하는 성능을 보여주고 있습니다. 특히 화자의 감정을 인식하는 SER 태스크에서는 그 격차가 훨씬 큰데요, 그만큼 저희 모델은 한국어 음성에 담긴 미묘한 감정을 잘 이해하고 있다고 할 수 있습니다. 앞으로도 Kanana-o는 이를 더욱 개선하여 상황에 맞는 적절한 응답을 해줄 수 있도록 지속적으로 발전시켜 나갈 예정입니다.
| ASR-clean (CER↓) | ASR-noisy (CER↓) | TTS (CER↓) | SpeechQA (ACC↑) | SER (ACC↑) | |
|---|---|---|---|---|---|
| KsponSpeech eval-clean | KsponSpeech eval-other | KsponSpeech eval-clean | Inhouse | Inhouse | |
| GPT-4o | 17.5 | 15.3 | 9.7 | 96.8 | 36.6 |
| Gemini-1.5-Pro | 12.0 | 10.8 | - | 98.4 | 33.2 |
| Kanana-o | 8.5 | 8.5 | 4.1 | 98.8 | 62.7 |
<표 4. 한국어 음성 이해 및 생성 성능 비교. Gemini의 경우 음성 발화 기능을 지원하지 않음.>
세계적으로 널리 활용되는 통합 멀티모달 언어모델들 대비 저희 Kanana-o가 글로벌 경쟁력을 갖게 하기 위해서는 영어 음성에 대한 이해 및 생성 성능이 매우 중요하다고 할 수 있습니다.
이에 현재 널리 활용되고 있는 영어 음성 이해 및 생성 벤치마크에 대한 성능 비교를 수행하였습니다. 표 5에서 확인하실 수 있듯이, Kanana-o는 영어 벤치마크들에서도 세계적인 모델들 대비 충분히 경쟁력 있는 성능을 보여주고 있으며, 특히 ASR 및 TTS와 같은 근본적인 음성 이해 능력에서 우수한 성과를 기록했습니다.
| ASR (WER↓) | TTS (WER↓) | SpeechQA (ACC↑) | SER (ACC↑) | SpeechIF (GPT Score↑) | ||
|---|---|---|---|---|---|---|
| LibriSpeech test-clean | LibriSpeech test-other | LibriSpeech test-clean | Speech LlamaQA | MELD | Speech AlpacaEval | |
| GPT-4o | 2.6 | 5.5 | 3.7 | 71.7 | 33.2 | 7.4 |
| Gemini-1.5-Pro | 2.9 | 4.9 | - | - | 48.4 | - |
| MiniCPM-o 2.6 | 1.7 | 4.4 | 6.7 | 61.0 | 52.4 | 5.1 |
| Kanana-o | 1.6 | 4.2 | 1.6 | 65.0 | 56.7 | 5.0 |
<표 5. 영어 음성 이해 및 생성 성능 비교. Gemini의 경우 음성 발화 기능을 지원하지 않음.>
또한, Kanana-o는 한국어와 영어를 동시에 이해하고 생성할 수 있는 통합 멀티모달 모델로서 음성 통역 분야에서도 뛰어난 성능을 나타냅니다. 표 6에서 보시는 바와 같이 입력 음성에 대해 텍스트 혹은 음성으로 통역된 결과를 답해주는 음성 통역 태스크들에서도 글로벌 주요 모델들과 비교하여 손색없는 통역 성능을 확인할 수 있습니다.
| En-to-Kor Text (BLEU↑) | Kor-to-En Text (BLEU↑) | En-to-Kor Speech (BLEU↑) | Kor-to-En Speech (BLEU↑) | |
|---|---|---|---|---|
| FLEURS en/kor | FLEURS en/kor | FLEURS en/kor | FLEURS en/kor | |
| GPT-4o | 23.4 | 24.0 | 21.8 | 23.4 |
| Gemini-1.5-Pro | 27.0 | 24.1 | - | - |
| Kanana-o | 25.4 | 24.6 | 24.2 | 22.3 |
<표 6. 한국어-영어 음성 통역 성능 비교. Gemini의 경우 음성 발화 기능을 지원하지 않음.>
Kanana-o 이미지-오디오 통합 이해 능력 비교
단일 모달리티 입력만을 다루던 것에서 나아가, Kanana-o는 이미지, 오디오, 텍스트를 모두 아우르는 통합 멀티모달 모델을 목표로 개발되었습니다. 이처럼 다양한 형태의 입력을 동시에 이해하고 적절히 결합해 응답할 수 있는 능력은, 단순히 개별 모달리티에 대한 이해를 넘어서 모달리티 간 의미적 연결성을 얼마나 자연스럽게 학습했는가를 보여주는 핵심 지표입니다.
아래에서는 Kanana-o가 이미지-오디오 입력 조합을 얼마나 효과적으로 이해하고 있는지, 그리고 기존의 대표적인 모델들과 비교해 어느정도의 경쟁력을 갖추었는지를 정량적 결과를 통해 살펴보겠습니다.
먼저 살펴볼 것은 이미지에 대해 음성 및 텍스트로 주어지는 지시(instruction)를 모델이 얼마나 정확하게 이해하고 응답하는지 평가하는 벤치마크입니다. 이러한 통합 모달리티 벤치마크는 앞서 “Omni-modal 학습 및 평가 데이터셋” 섹션에서 말씀드린 것과 같이 공개된 데이터가 거의 없기 때문에 영어에서의 OmniBench를 제외하면 저희가 자체적으로 구축한 평가 데이터를 활용하였습니다.
표 7과 8에서 보실 수 있듯이, Kanana-o는 음성 기반 태스크들 뿐만 아니라 통합 모달리티 벤치마크에서도 우수한 성능을 달성 하였는데요, 특히 한국어에서는 경쟁모델들 대비 가장 높은 성능을 보였습니다. 참고로, GPT-4o는 현재 이미지와 음성을 동시에 입력받는 기능을 지원하지 않아, 이번 비교에서는 제외되었습니다.
| Speech MMB-Kor | Speech MME-Kor | Speech SEED-Kor | Speech LlavaBench-Kor | AVG | |
|---|---|---|---|---|---|
| Gemini-1.5-Pro | 68.2 | 54.0 | 68.0 | 87.9 | 69.5 |
| MiniCPM-o 2.6 | 50.2 | 47.2 | 63.0 | 67.5 | 57.0 |
| Kanana-o | 71.2 | 58.1 | 71.1 | 82.7 | 70.8 |
<표 7. 한국어 이미지-오디오 통합 이해 능력 비교>
| OmniBench | Speech MMB-En | Speech MME-En | Speech SEED-En | Speech LlavaBench-En | AVG | |
|---|---|---|---|---|---|---|
| Gemini-1.5-Pro | 42.9 | 77.7 | 75.3 | 75.6 | 98.1 | 73.9 |
| MiniCPM-o 2.6 | 40.5 | 65.7 | 74.5 | 73.6 | 87.4 | 68.3 |
| Kanana-o | 47.9 | 76.4 | 70.9 | 72.8 | 87.6 | 71.1 |
<표 8. 영어 이미지-오디오 통합 이해 능력 비교>
Kanana-o 기능과 활용 예시
Kanana-o는 자유로운 입출력 모달리티 조합이 가능한 모델로서 앞서 정량 평가에서 정의된 기능들 외에도 더욱 폭넓은 활용 가능성을 지니고 있습니다. 이제 Kanana-o가 제공하는 다양한 기능들을 실제 예시를 통해 살펴보고, 각 기능이 어떤 상황에서 유용하게 활용될 수 있는지 알아보겠습니다.
음성 인식 (ASR)
음성 인식은 음성 인터페이스에 기반을 둔 멀티모달 언어모델에서 가장 기본이 되면서도 핵심적인 능력 중 하나입니다. 저희 Kanana-o 모델은 깔끔한 음성을 인식하는 능력은 물론 배경 잡음이 섞인 음성 역시 정확하게 인식할 수 있는 능력을 갖추었습니다.
다만 아래 예시에서 처럼 대부분 정확히 인식하지만 발음이 모호하게 들리는 부분에서는 이를 그대로 인식하여 스크립트를 작성하고 있습니다. 저희는 이를 더욱 개선하여 발음에 불분명한 부분이 있더라도 문맥을 고려하여 자연스러운 인식 결과를 만들어낼 수 있도록 모델을 더욱 개선하고자 합니다.
<정성 예시 1. 배경 잡음이 있는 상황에서의 음성 인식 결과>
음성 감정 묘사 및 감정 기반 음성 생성
상대방의 말을 듣고 그 속에 담긴 감정을 이해한 뒤, 이에 적절하게 반응하는 능력은 원활한 소통과 자연스러운 대화를 위해 필수적입니다. Kanana-o 모델은 목소리에서 드러나는 감정을 이해할 수 있을 뿐만 아니라, 프롬프트로 주어지는 감정이나 발화 스타일에 맞춰 자연스러운 음성을 생성할 수도 있습니다.
먼저 아래 예시를 통해 Kanana-o가 감정을 얼마나 세밀하게 포착할 수 있는지를 확인할 수 있습니다. 단순히 단어 위주의 감정 분류에 그치는 것이 아니라, 목소리에 스며든 억양과 분위기까지 깊이 이해하며, 듣는 이의 입장에서 어떻게 느껴질지를 섬세하게 파악하는 능력을 보여줍니다.
<정성 예시 2. 화자 음성에 대한 감정 묘사 결과>
Kanana-o는 감정을 섬세하게 이해하는 데 그치지 않고, 이를 바탕으로 프롬프트로 지정된 감정이나 발화 스타일에 맞춰 자연스러운 음성을 생성할 수도 있습니다. 아래 예시에서는 동일한 문장이라도 사용자의 지시에 따라 감정과 분위기에 맞는 음성을 적절히 생성해내는 Kanana-o의 능력을 확인할 수 있습니다.
<정성 예시 3. 프롬프트로 주어진 발화 스타일에 따른 음성 합성 결과>
방언 인식 및 표준어화
Kanana-o는 한국어와 한국 문화에 대한 깊은 이해를 갖춘 모델입니다. 발화되는 음성이 어떤 지역의 방언인지 정확히 인식할 수 있으며, 이러한 방언 이해 능력을 바탕으로 방언을 자연스러운 표준어로 변환하여 발화할 수 있는 능력도 갖추었습니다.
아래 정성 예시 4에서는 한국의 지역별 방언에 대한 이해를 바탕으로 입력 음성이 어느지역 방언을 사용하는지 정보를 제공해줄 수 있음을 보여주며, 정성 예시 5에서는 이를 바탕으로 방언을 표준어로 변환해 발화해주는 기능까지 수행할 수 있습니다.
<정성 예시 4. 방언 인식 결과>
<정성 예시 5. 방언을 표준어로 변환 후 발화하는 예시>
음성 통역
언어의 차이는 원활한 의사소통을 어렵게 하는 원인이 됩니다. Kanana-o는 이러한 언어적 장벽을 해소할 수 있는 기능을 제공합니다. 예를 들어 사용자가 한국어로 말하면 이를 즉시 영어로 통역하여 음성으로 전달해주고, 상대방이 영어로 말하면 이를 다시 한국어로 통역한 음성으로 들려줍니다. 이 기능은 서로 다른 언어를 사용하는 사람들 간의 자연스럽고 편안한 소통에 도움을 줄 수 있습니다.
<정성 예시 6. 한/영 양 방향 음성 통역 결과>
이미지-오디오 통합 이해 및 생성
Omni-modal LLM인 Kanana-o는 음성뿐만 아니라 이미지까지 동시에 이해하고 활용하여 더욱 폭넓은 소통을 지원합니다. 예를 들어, 음성 뿐만 아니라 이미지로 캡처된 영어 문서도 즉시 한국어로 번역해주거나, 이미지에 담긴 상황을 상세하게 묘사해 들려줄 수 있습니다. 또한 이미지에 관한 궁금한 점을 텍스트나 음성 형태로 질문하면, 원하는 형태로 답변을 제공받을 수 있습니다.
특히 Kanana-o는 활용예시 #14의 “다섯 문장 이내”나 활용예시 #15의 “보행자 신호등의 색”등 사용자의 지시를 정확히 따르며 답변을 제공할 뿐 아니라, 활용예시 #16과 같이 어린이용 동화를 만들어 주는 등 창의적인 대답 또한 가능합니다.
<정성 예시 7. 이미지와 음성 및 텍스트 입력 조합에 따른 다양한 모델 응답 예시>
앞으로의 목표
지금까지 Kanana-o를 개발하며 치열하게 고민하고 실험해온 과정, 그리고 그 결과물들을 소개해드렸습니다. Kanana-o는 음성, 이미지, 텍스트를 아우르는 Omni-modal LLM으로서 다양한 입력 조합에 유연하게 대응할 수 있도록 설계되었으며, 여러 벤치마크를 통해 글로벌 경쟁력도 입증하였습니다. 하지만 실사용 환경에 최적화되기 위해서는 여전히 해결해야 할 기술적 과제들이 존재합니다.
음성 기반 Multi-turn 대화 처리
현재 Kanana-o는 단발성 음성 명령에 대한 이해와 응답에는 안정적인 성능을 보이고 있지만, 문맥을 유지한 다중 턴 음성 대화(Multi-turn dialogue) 시나리오에서는 아직 개선의 여지가있습니다. 실제 사용자 환경에서는 발화가 연속적으로 이어지고, 질문과 응답이 맥락에 따라 유기적으로 연결되기 때문에, 대화 흐름을 기억하고 문맥을 유지하는 능력이 필수적입니다. 따라서 향후에는 대화 상태를 추적하며 장기적으로 맥락을 유지할 수 있는 능력이 모델에 통합될 예정입니다.
Full-duplex 음성 대화 지원
저희 Kanana-o를 포함한 대부분의 기존 음성 기반 멀티모달 모델은 turn-taking 방식, 즉 사용자의 발화가 끝난 뒤에 시스템이 응답을 시작하는 구조로 작동합니다.
하지만 사용자와 시스템이 동시에 말하고 들을 수 있는 Full-duplex 대화 구조는 보다 자연스럽고 몰입감 있는 음성 상호작용을 가능하게 합니다. 특히 보이스 어시스턴트나 AR/VR 환경처럼 실시간성이 중요한 상황에서는 이러한 동시 대화 능력이 핵심 요소가 됩니다. Kanana-o 역시 이를 중요한 발전 방향으로 보고 있으며, Full-duplex 대응 능력을 향상시키기 위한 연구를 지속적으로 진행 중입니다.
Human alignment 학습 및 안전성 강화
음성 인터페이스는 텍스트보다 사용자 감정, 말투, 뉘앙스 등 비언어적 정보를 더 많이 포함하고 있기 때문에, 사용자와의 정서적 교감 및 안전성(safety) 문제가 더욱 민감하게 작용합니다. 부적절한 응답이 텍스트에서는 오해 수준으로 그칠 수 있지만, 음성에서는 더 직관적이고 민감한 방식으로 전달될 수 있기 때문이지요.
따라서, RLHF(Reinforcement Learning from Human Feedback)와 같은 Human preference alignment learning 기법을 통해 Kanana-o를 더욱 개선시키기 위해 데이터 수집 및 정제부터 학습 방법론 탐색까지 다방면으로 노력을 기울이고 있습니다.
글로벌 대응을 위한 다국어 확장
Kanana-o는 현재 한국어와 영어에 특화된 데이터셋으로 학습되었지만, 글로벌 확장을 위한 다국어 지원은 중장기적으로 반드시 해결해야 할 과제입니다. 특히 음성 입력은 언어별 발화 특성, 억양, 리듬 등이 상이하기 때문에, 단순한 통역 기반이 아닌 언어별 음성 모델링 특성을 고려한 설계가 요구됩니다.
이는 현재 OpenAI나 Google처럼 대규모 자원과 다국어 노하우를 보유한 기업만이 일정 수준 이상 달성할 수 있는 어려운 문제입니다만, 저희는 Kanana-o가 글로벌 수준의 경쟁력을 갖추게 하기위해 이 문제를 핵심 과제로 삼고, 꾸준히 연구를 이어갈 예정입니다.
맺음말
Kanana-o는 한국어와 영어 모두에서 글로벌 경쟁력을 입증한 카카오의 통합 멀티모달 언어 모델입니다. 정량적으로 측정될 수 있는 벤치마크 점수에서의 성과를 넘어, 감정 표현이나 한국어 특유의 뉘앙스까지 이해하며 사용자에게 친근하고 편안한 소통을 제공하기 위해 많은 고민과 노력을 기울였습니다.
저희는 여기서 멈추지 않고, 앞서 언급드린 기술적 개선과 더불어 더욱 다양한 서비스에 Kanana-o를 접목하여 실생활 속의 편의성을 높이고자 합니다. 차세대 소통 인터페이스로서 사람들의 일상에 가치를 더할 수 있도록 끊임없이 발전해 나가겠습니다.
Kanana-o의 앞으로의 여정에도 많은 관심과 응원을 부탁드리겠습니다.
함께한 사람들
Kanana 조직의 brook.p(박범희), coco.upgrade(한건수), edwin.ai(강우영), hulk.5(오형석), james.e(이재명), jessie.e(이지혜), kevin.nlp(고현웅), logan.c(차준범), martin.gale(조대진), peter.brain(노병석), samuel.brain(강성훈), sonny.7(손동희), welt.bae(배병욱), wooner.l(이동진) 이 함께했습니다.
데이터 구축에 있어서는 Kanana 조직의 alan.zero(노영만), el.if(조민범), isaac.newton(신종주), jaden.o(박지호), jennie.ee(이지혜), jeri.s(이희현) 이 많은 도움을 주셨습니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana 조직의 loophy.cc(조정민) 에게 감사의 말을 전합니다.
참고문헌
[1] Radford, Alec, et al. “Robust speech recognition via large-scale weak supervision.” International conference on machine learning. PMLR, 2023.
[2] Cha, Junbum, et al. “Honeybee: Locality-enhanced projector for multimodal llm.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024.
[3] Le, Matthew, et al. “Voicebox: Text-guided multilingual universal speech generation at scale.” Advances in neural information processing systems 36 (2023): 14005-14034.
[4] Jang, Won, et al. “UnivNet: A Neural Vocoder with Multi-Resolution Spectrogram Discriminators for High-Fidelity Waveform Generation.” Proc. Interspeech 2021. 2021.
[5] Reddy, Chandan KA, Vishak Gopal, and Ross Cutler. “DNSMOS: A non-intrusive perceptual objective speech quality metric to evaluate noise suppressors.” ICASSP 2021-2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2021.
[6] Chen, Kai, et al. “Emova: Empowering language models to see, hear and speak with vivid emotions.” arXiv preprint arXiv:2409.18042 (2024).
[7] Wortsman, Mitchell, et al. “Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time.” International conference on machine learning. PMLR, 2022.
[8] Li, Yinghao Aaron, et al. “Styletts 2: Towards human-level text-to-speech through style diffusion and adversarial training with large speech language models.” Advances in Neural Information Processing Systems 36 (2023): 19594-19621.