Engineering
MongoDB 8.0 업그레이드 해야하는 12가지 이유
andy.hj, philip.seo, ayla.c카카오
2025년 12월 17일
원문에서 보기 ↗들어가며
데이터베이스를 운영하며 가장 중요하게 생각하는 가치는 안정성입니다.
그래서 카카오에서는 새로운 MongoDB GA(General Availability) 버전이 공개되면 안정적인 운영을 위해 약 1년 간의 안정화 기간을 거쳐 충분히 검증된 시점에 업그레이드를 검토하고 있습니다. 그리고 현재 MongoDB 8.0 역시 출시된 지 약 1년이 지난 시점인데요.
솔직히 말해 데이터베이스 업그레이드는 언제나 조심스러운 작업입니다.
보통은 업그레이드 후 성능 향상을 기대하지만, 실제로는 여러 기능 추가와 복잡도 증가로 인해 오히려 성능이 떨어지는 사례도 흔하게 발생합니다. MongoDB도 예외는 아닌데요, 거의 매년 신규 버전을 출시하며 많은 기능을 적극적으로 도입해 사용성이 꾸준히 개선되었지만, 성능면에서는 아쉬운 평가가 존재했던 것도 사실입니다.
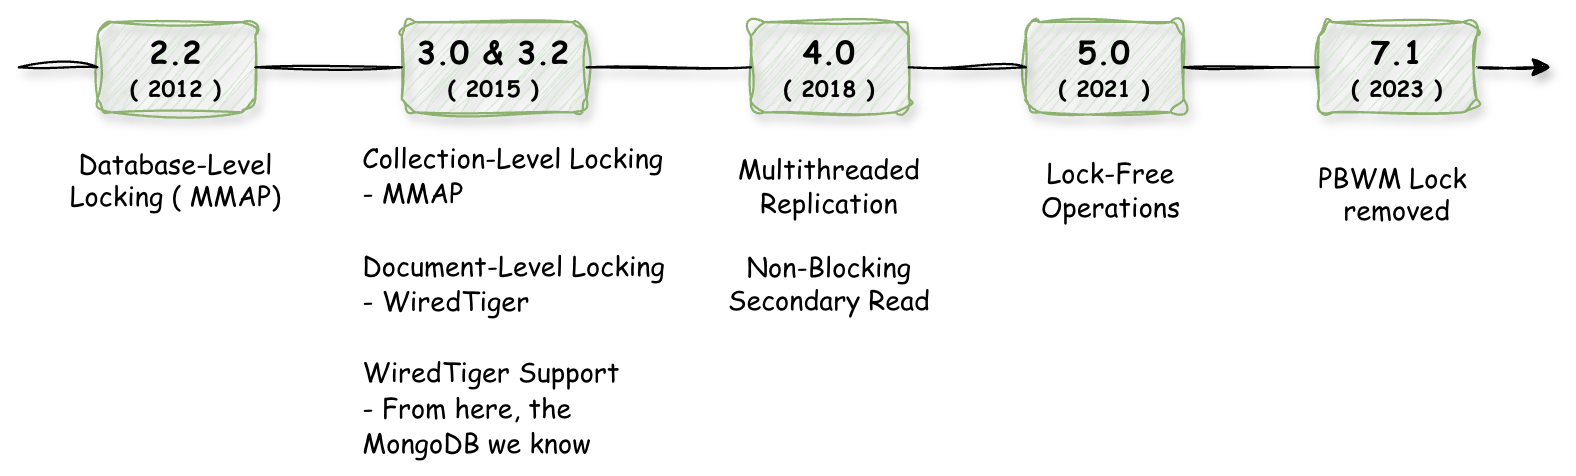
이러한 고객의 피드백을 반영해 MongoDB 8.0에서는 성능과 안정성 개선에 많은 투자를 했고, 실제로 눈에 띄는 성과를 보였음을 강조하고 있습니다. 이번 글에서는 MongoDB가 강조하는 개선 포인트를 염두에 두고, MongoDB 8.0의 주요 개선 사항을 DBA 관점에서 검토한 내용을 공유하고자 합니다.
MongoDB 8.0 업그레이드해야 하는 12가지 이유
1. 장기 지원 버전
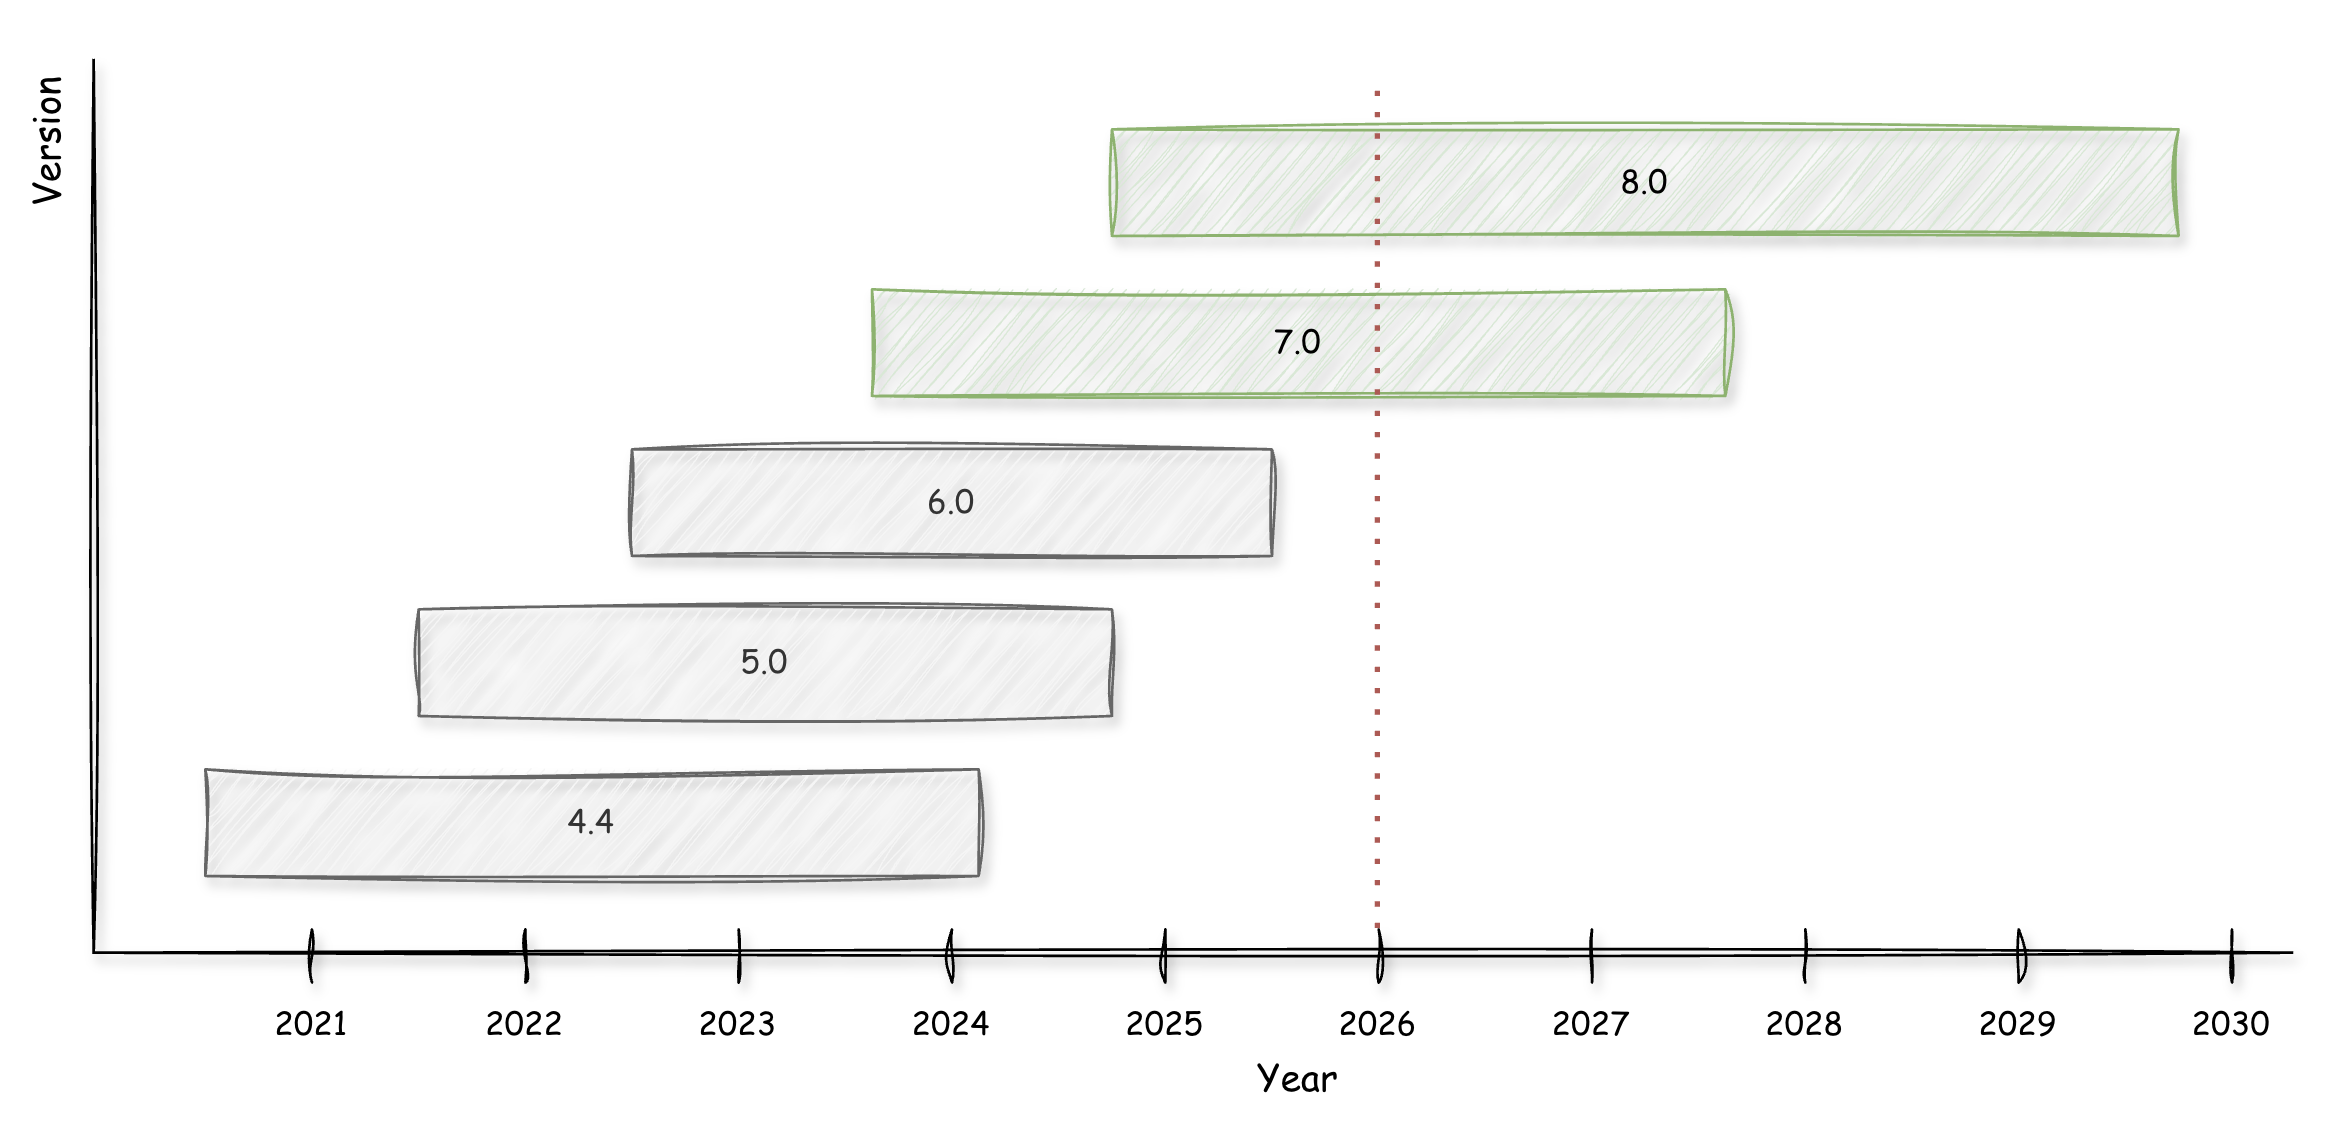
제일 먼저 소개드리고 싶은 내용은 정책적인 변화입니다.
그동안 MongoDB의 메이저 버전은 약 3년의 지원 기간을 가져왔지만, MongoDB 8.0은 2024년 10월 출시 후 2029년 10월 31일까지 약 5년 간 지원이 예정되어 있습니다. MongoDB가 이를 공식적으로 ‘LTS(Long-Term Support)’ 버전이라고 명명한 것은 아니지만, 사실상 장기 운용을 전제로 한 정책 변화로 볼 수 있습니다.
또한, “MongoDB 8.2 부터 On-premise 환경에서도 마이너 릴리스를 지원한다”는 내용이 추가되었는데, 이는 기존의 래피드 릴리스(Rapid Release) 정책이 클라우드 환경인 Atlas 전용에서 온프레미스(On-premise) 환경까지 확장된 것으로 해석할 수 있습니다. 래피드 릴리스(Rapid Release)는 새로운 기능과 개선 사항을 빠르게 제공하기 위한 버전이었는데, 이제는 자체 인프라 환경에서도 클라우드 환경과 동일한 주기로 신규 기능을 사용할 수 있게 된 것입니다. (MongoDB 8.2부터는 기존의 래피드 릴리스를 마이너 릴리스로 표현하는 것으로 보입니다.)
운영 관점에서 보면 이러한 정책 변화는 상당히 의미가 있습니다. 지원 주기가 길어지면서 장기적으로 운영할 수 있는 기준 버전을 확보할 수 있게 되었고, 그만큼 업그레이드에 소모되는 리소스를 줄일 수 있습니다. 또한 마이너 릴리스 적용 범위가 확대된 덕분에 신규 기능을 더 빠르게 검토할 수 있어, 각 서비스별로 안정성을 우선할지 새로운 기능을 신속히 도입할지를 유연하게 선택할 수 있는 전략적 여지가 생겼습니다.
2. Write Concern “majority” 성능 개선
MongoDB에서 Write Concern 의 “majority”(과반수) 는 쓰기 연산의 내구성(Durability)을 보장하기 위한 옵션입니다. 이는 쓰기 작업이 다수의 복제 멤버에 반영되어야 성공으로 간주하는 동작 방식으로, 이를 통해 안정성과 데이터 일관성을 확보할 수 있습니다.
MongoDB 5.0부터는 이 설정이 기본값으로 적용되었습니다. 이로 인해, 데이터의 내구성은 보장되지만 그만큼 쓰기 성능 저하의 주요 원인으로 지적되어 왔습니다. 그래서 MongoDB 8.0에서는 이러한 문제를 해결하기 위해 "majority"의 내부 동작 방식을 개선했습니다.
주요 변경사항은 각 세컨더리 노드(Secondary Node)에서 “majority” 판단의 기준이 되는 시간을 변경한 것인데요, 기존에는 oplog를 실제 데이터 파일까지 반영한 시점인 lastApplied 를 기준으로 판단했다면, MongoDB 8.0부터는 oplog.rs 컬렉션에 쓰는 것 까지만 완료된 시점인 lastWritten이라는 신규 시간 값으로 판단 기준을 변경했습니다.
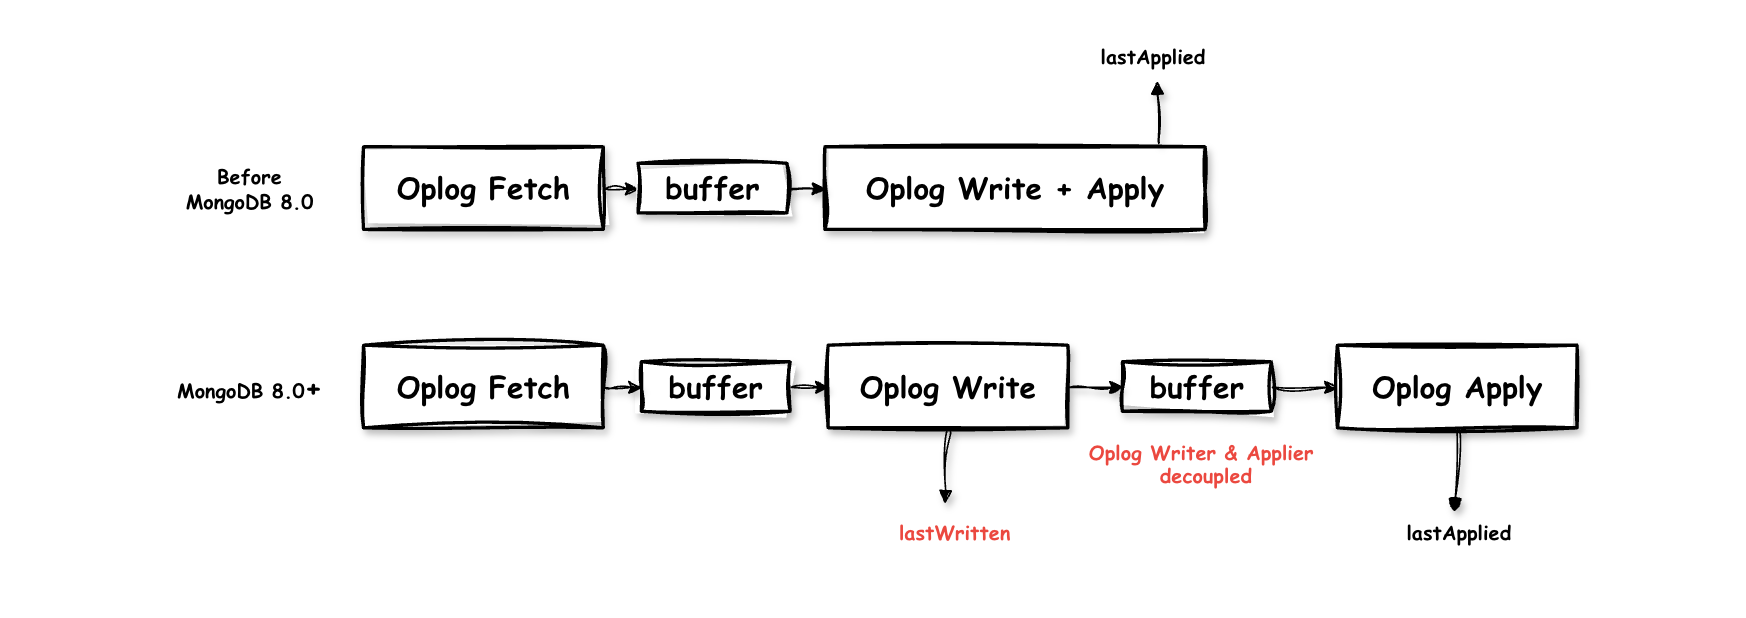
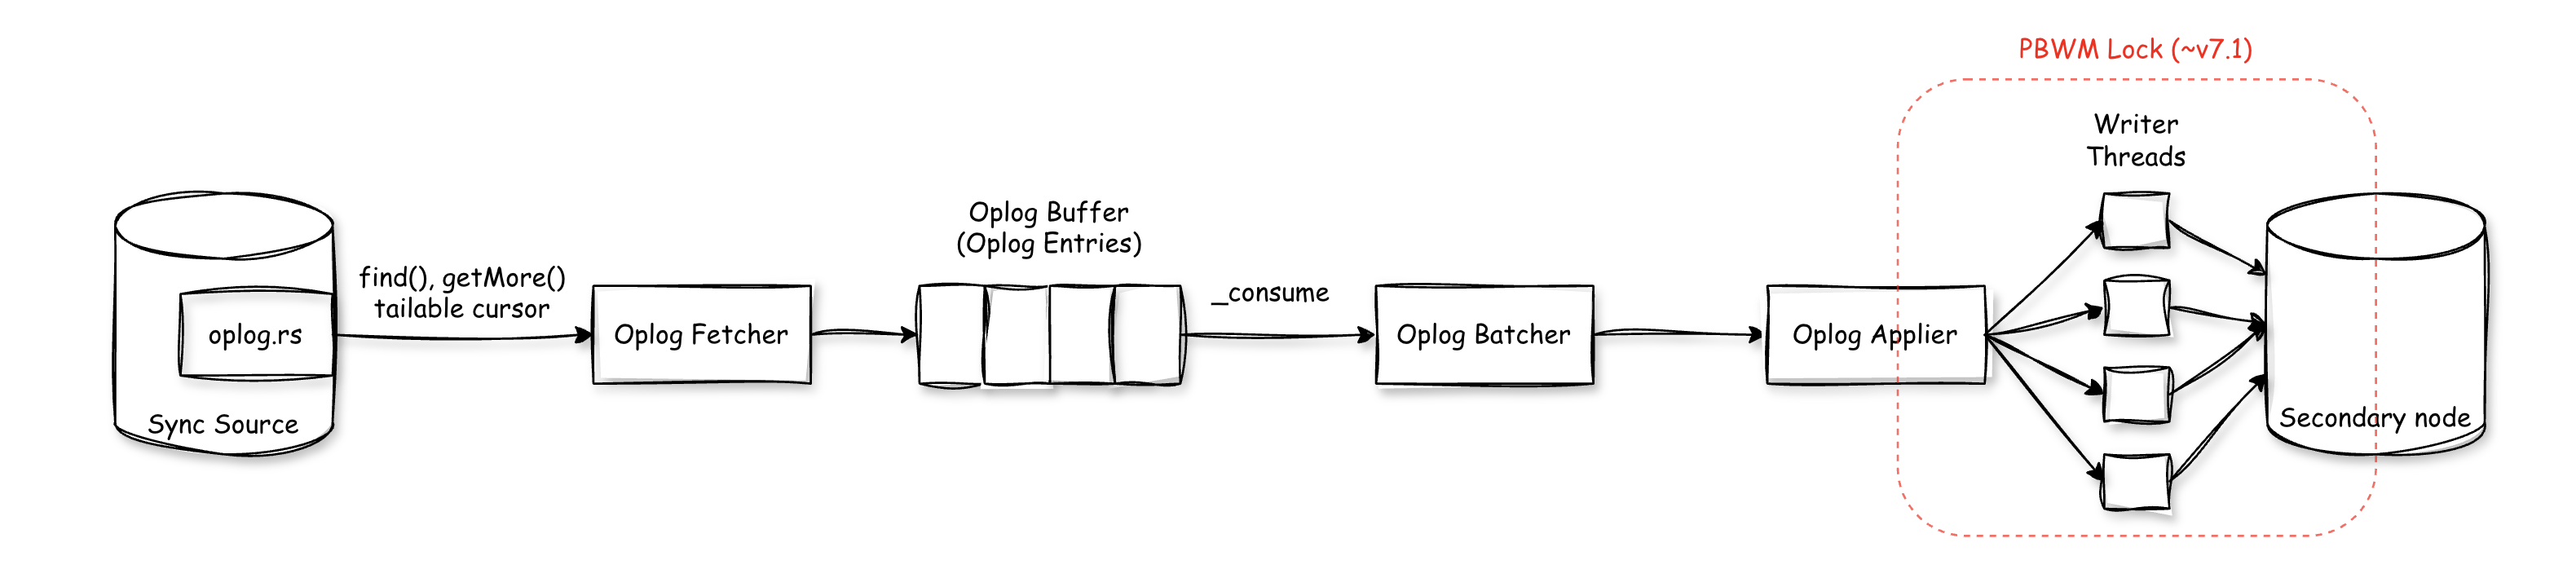
세컨더리 노드의 복제 과정은 다음 세 단계로 요약할 수 있습니다.
1. Oplog Fetch
syncSource로부터 find + getMore를 이용해 oplog 엔트리를 가져와 oplogBuffer에 저장합니다.
2. Oplog Write
버퍼에서 oplog 엔트리를 배치 단위로 읽어 oplog.rs에 기록하고, lastWrittenOpTime 을 갱신합니다.
아직 실제 컬렉션에 적용되지는 않았으며, 해당 배치는 이후 oplogApplierBuffer로 전달됩니다.
3. Oplog Apply
oplogApplierBuffer에 저장된 배치를 병렬로 실제 컬렉션에 적용하고, 완료된 배치의 마지막 시점으로 lastAppliedOpTime을 갱신합니다.
즉, MongoDB 8.0은 “majority” 판단 기준을 lastAppliedOpTime에서 lastWrittenOpTime으로 변경했다고 보시면 됩니다. 그 결과 변경사항이 세컨더리 노드의 데이터 파일에 실제로 적용될 때까지 기다릴 필요가 없어졌고, 쓰기 응답 속도는 그만큼 향상되었습니다.
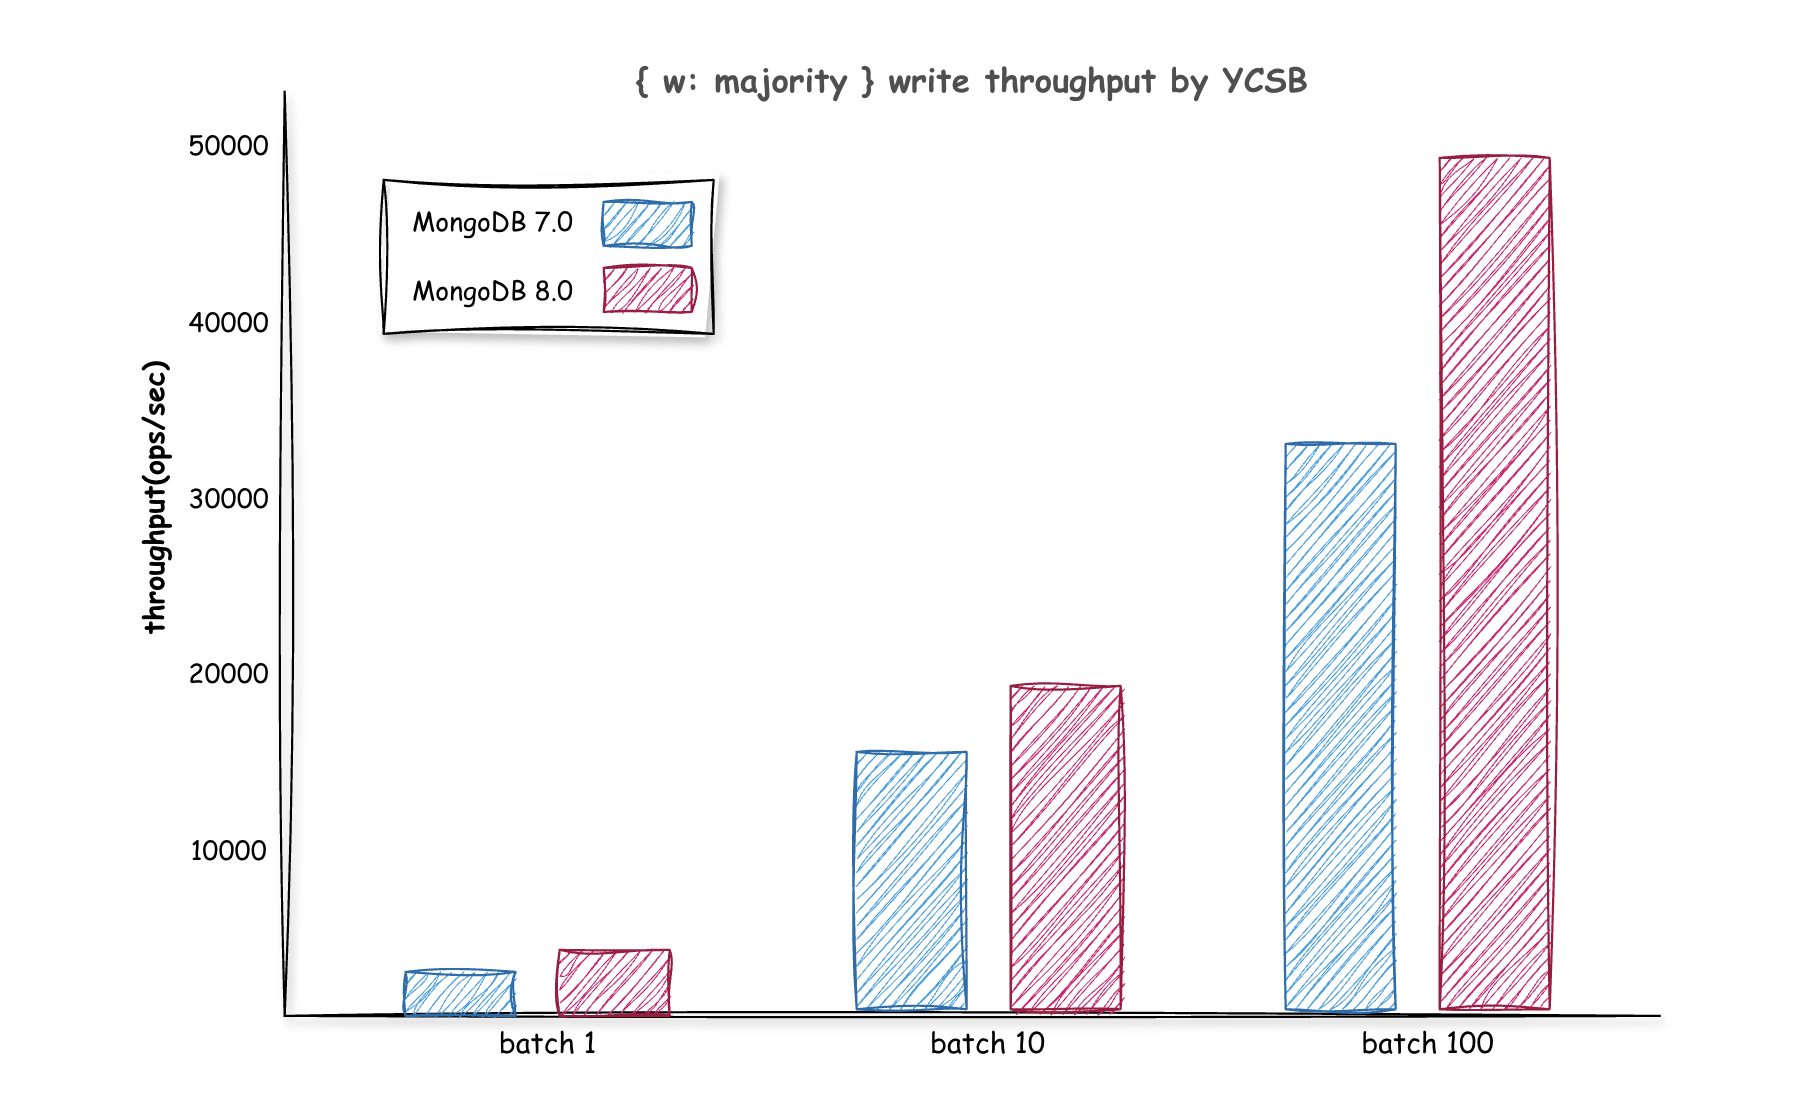
실제로 YCSB, mongo-perf, 그리고 사내 벤치마크 도구를 활용해 측정한 결과 MongoDB 8.0은 7.0 대비 쓰기 처리량(Throughput)이 약 30~47% 향상되는 모습을 보였습니다. 배치 크기가 커질수록 개선 폭도 더욱 크게 나타났으며, 이는 MongoDB가 공식적으로 제공한 성능 개선 수치와도 전반적으로 일치하는 결과였습니다.
물론 이러한 성능 개선에는 트레이드 오프가 존재합니다. 만약 애플리케이션이 “majority” 쓰기 직후 세컨더리 노드에서 데이터를 조회한다면, 해당 노드가 아직 Apply 단계까지 완료하지 않았을 수 있어 최신 변경 사항이 반영되지 않은 결과를 반환할 수 있습니다.
다만 이러한 문제는 인과적 일관성 세션(Causally Consistent Session)을 사용해 기능적으로 보완할 수 있으며, 사실 세컨더리 노드의 지연 가능성은 이전 버전에서도 동일했던 특성이기 때문에 MongoDB 8.0의 동작 방식은 기존 사용성을 고려한 합리적인 개선사항이라고 볼 수 있습니다.
추가로, MongoDB 8.0부터 OplogWriter와 OplogApplier 사이에 새로운 버퍼가 추가되면서 serverStatus에서 제공되는 복제 관련 메트릭 구조도 일부 변경되었으므로 모니터링 시 참고하시면 좋을 것 같습니다.
| Deprecated Metrics | New Metrics |
|---|---|
| metrics.repl.buffer.count | metrics.repl.buffer.apply.count / write.count |
| metrics.repl.buffer.sizeBytes | metrics.repl.buffer.apply.sizeBytes / write.sizeBytes |
| metrics.repl.buffer.maxSizeBytes | metrics.repl.buffer.apply.maxSizeBytes / write.maxSizeBytes |
정리하자면, Write Concern “majority”의 충족 여부를 Oplog Write 기준으로 판단하도록 변경함으로써, 세컨더리가 내구성을 보장하기 위한 최소한의 동작만 수행한 뒤 사용자에게 더 빠르게 응답할 수 있도록 개선하였습니다. 다만, 쓰기 직후 세컨더리에서 읽기를 수행해야 한다면 최신 데이터가 아직 반영되지 않았을 수 있으므로, 필요한 경우 인과적 일관성 세션(Causally Consistent Session) 활용을 고려해야 합니다.
3. Bulk Write 개선
MongoDB 8.0의 Bulk Write 개선은 크게 두 가지 방향으로 이루어졌습니다. 하나는 여러 컬렉션을 대상으로 사용할 수 있는 신규 bulkWrite 데이터베이스 명령의 도입이고, 다른 하나는 oplog 처리 방식의 최적화입니다.
첫 번째로, 이전까지의 bulkWrite() 메서드는 네트워크 왕복 비용을 줄이기 위해 한 컬렉션 내의 여러 연산을 단일 요청으로 묶어 전송할 수 있었습니다.
db.collection.bulkWrite([
	{  insertOne:  {  document:  {...}  }  },
	{  updateOne:  {  filter:  {...},  update:  {...}  }  },
	{  deleteOne:  {  filter:  {...}  }  }
])
하지만 이 방식은 컬렉션 단위로만 동작했기 때문에, 여러 컬렉션에 걸친 작업을 한 번에 처리하는 것은 불가능했습니다. MongoDB 8.0에서는 이러한 제약을 해소하기 위해 새로운 bulkWrite 데이터베이스 명령을 추가했습니다. 이제 단일 요청으로 여러 컬렉션의 작업을 동시에 수행할 수 있으며, 각 컬렉션은 nsInfo 배열로 지정됩니다.
db.runCommand({
	bulkWrite:  1,
	ops:  [
		{  insert:  0,  document:  {  type:  "beef",  size:  "medium",  price:  6  }  },
		{  insert:  0,  document:  {  type:  "sausage",  size:  "large",  price:  10  }  },
		{  insert:  1,  document:  {  type:  "굽네",  price:  10  }  },
		{  update:  0,  filter:  {  type:  "cheese"  },  updateMods:  {  $set:  {  price:  8  }  }  },
		{  delete:  0,  filter:  {  type:  "pepperoni"  }  }
	],
	nsInfo:  [
		{  ns:  "test.pizzas"  },  // index 0
		{  ns:  "test.chicken"  }  // index 1
	]
})
이 개선으로 여러 컬렉션을 대상으로 한 대량 작업을 효율적으로 수행할 수 있게 되었습니다.
두 번째로, Bulk Insert의 oplog 생성 방식이 최적화되었습니다.
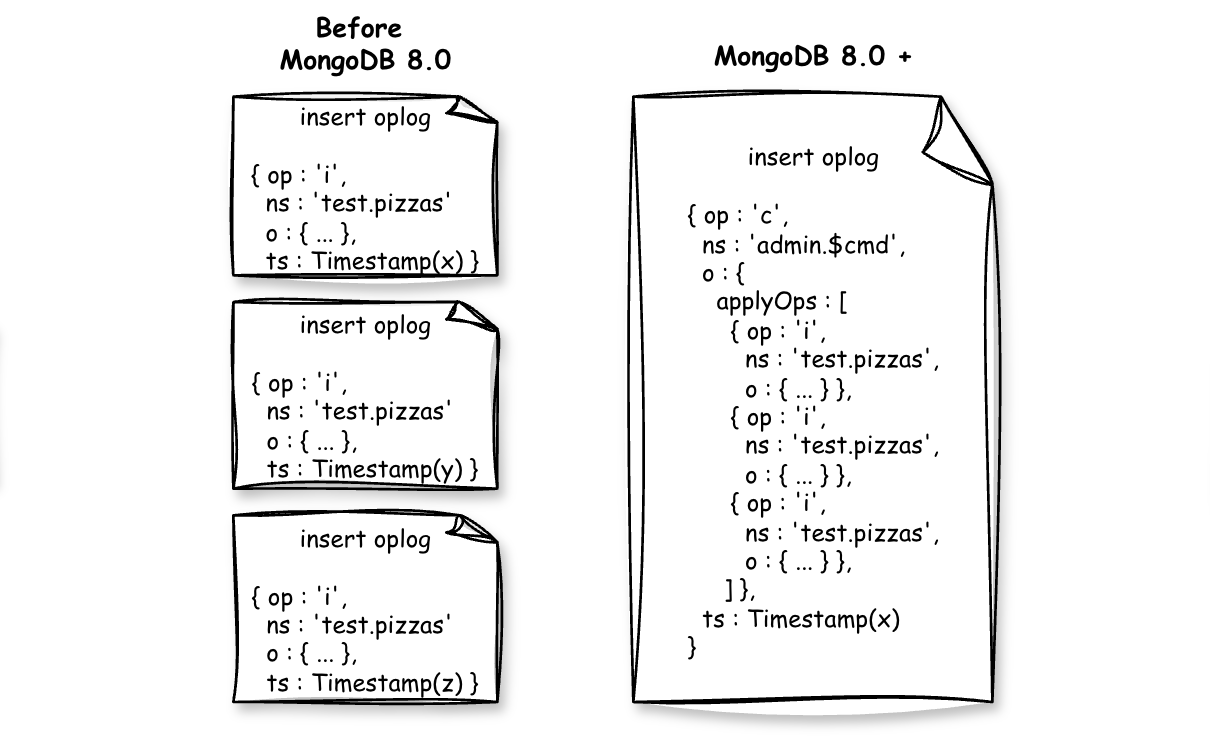
이전 버전에서는 insertMany()처럼 여러 도큐먼트를 한 번에 삽입하더라도, 각 도큐먼트마다 별도의 oplog 엔트리가 생성되었습니다. 즉, 100개의 도큐먼트를 삽입하면 oplog에도 100개의 엔트리가 기록되고, 각각의 optime이 개별적으로 할당되었습니다.
하지만 WiredTiger 스토리지 엔진은 이미 내부적으로 Bulk Insert를 단일 트랜잭션(Batch) 으로 처리할 수 있기 때문에, oplog를 개별 엔트리로 다시 분리하는 것은 비효율적인 동작이었습니다. 그래서 가능한 경우, 여러 insert 연산을 하나의 oplog 엔트리로 묶어 기록하도록 동작을 변경했습니다. 물론 제한없이 모든 항목이 하나로 통합되는 것은 아니고 내부 파라미터인 internalInsertMaxBatchSize(default 500)에 의해 제한됩니다.
이러한 변경으로 세컨더리 노드에서의 동기화 효율이 상승하여 복제 지연(Replication Lag) 발생 가능성이 낮아지며 쓰기 성능 개선 효과를 가져왔습니다. 스토리지 엔진의 실제 동작 방식과 oplog 적용 방식이 일관되도록 변경한 것으로, 대규모 쓰기 작업이 많은 환경에서는 효과를 볼 수 있을 것으로 기대됩니다.
4. Express Plan
MongoDB의 Aggregation Pipeline과 Find 쿼리는 유연하고 범용적인 최적화를 제공하기 위해 1. 쿼리 파싱 / 검증 → 2. 쿼리 정규화 / 옵티마이저 최적화 → 3. 쿼리 플랜 생성 → 4. PlanStage 구성 → 5. PlanExecutor 실행과 같이 여러 단계를 거쳐 진행됩니다.
하지만, 실제 MongoDB 사용 사례를 보면 _id 필드를 이용한 단건 조회를 하는 경우가 많습니다. MongoDB에서 PK 역할을 하는 _id 필드는 항상 유니크 인덱스를 가지므로 쿼리 플랜을 선정하는데 복잡한 과정을 거칠 필요가 없습니다. 그래서 기존에는 IDHACK이라는 단일 문서 검색에 최적화된 스테이지를 제공했었습니다.
다만, IDHACK 스테이지를 선택하기 전에 이미 범용적인 쿼리 플래닝 과정을 거치기 위해 소모되는 불필요한 시간이 존재했었는데요, 이 지점을 최적화하기 위해 MongoDB 8.0에서는 Express Plan을 새로 도입했습니다.
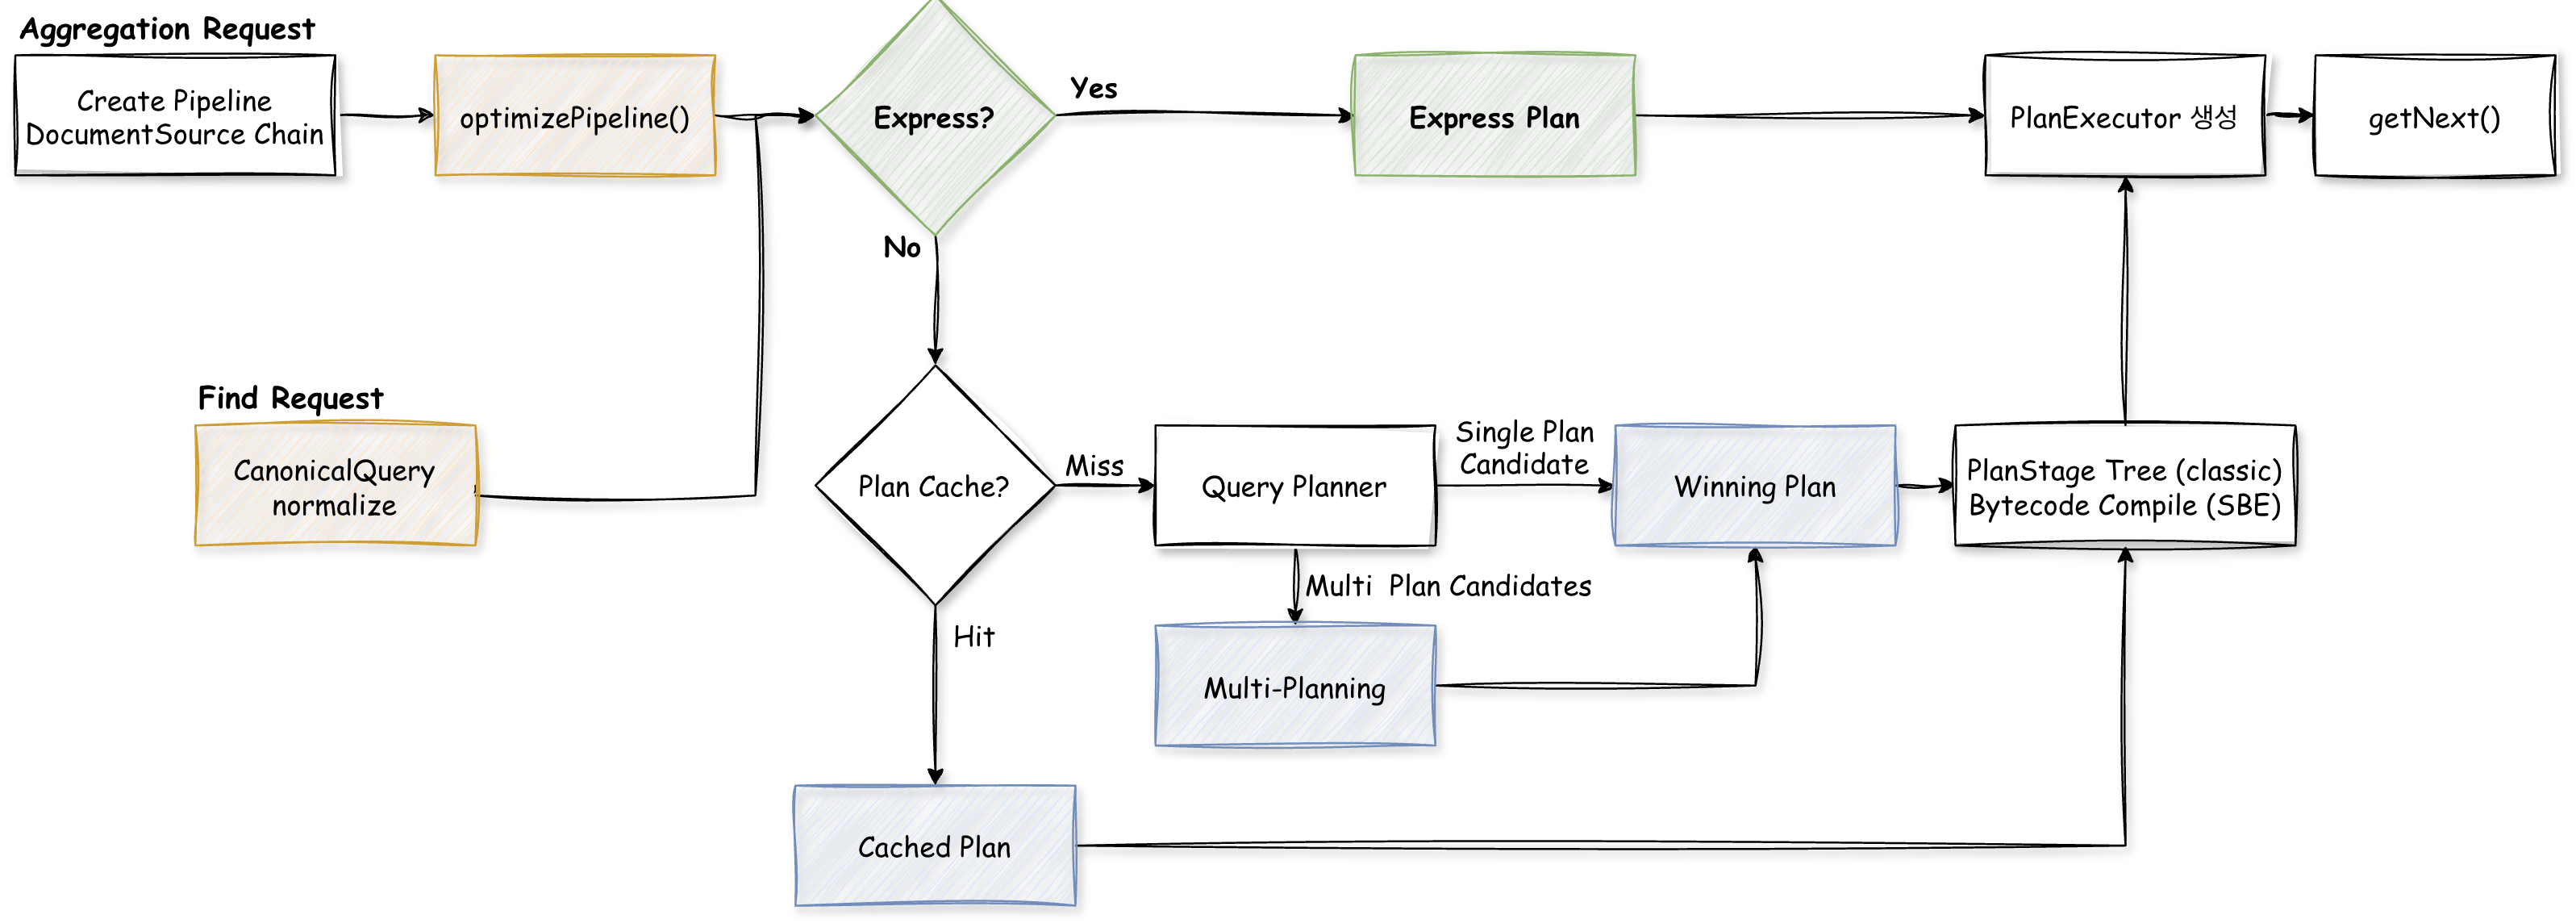
Express Plan 사용 조건이 충족되는 경우, 쿼리 파싱 직후 쿼리 플래닝 등에 소요되는 불필요한 작업을 모두 생략하여 단순 조회가 필요한 작업의 효율을 극대화시켰습니다. 그래서 Express Plan은 쿼리가 명확한 실행 경로를 보장할 수 있는 형태일 경우만 활성화되며, 아래 두 가지 유형에 해당해야 합니다.
1. IdPointQueryEligible
_id 필드에 대한 단일 값(Point Query) 조회인 경우
예) db.collection.find({ _id: ObjectId("…") })
2. IndexedEqualityEligible
단건 조회임이 보장되는 조회인 경우
해당 필드에 대한 유니크 인덱스가 존재하거나, 쿼리에 limit: 1이 명시되어야 함
예) db.collection.find({ email: “user@example.com” })
아래와 같은 제약 조건도 모두 충족해야 하며, 하나라도 위배될 경우 쿼리는 기존 방식으로 Fallback되어 수행됩니다.
-
hint, sort, skip 등 추가 옵션이 없어야 함
-
범위 조건, 정규식 등 사용 불가
-
projection을 사용할 경우, 최상위 필드에 대한 단순 선택만 가능하며 변환이 필요한 기능은 사용 불가
Exress Plan 활성 조건이 충족되면 아래 과정들이 생략되고, 사전 정의된 실행 경로를 바로 수행합니다.
-
Query Planning 및 Plan Cache 조회
-
Working Set(Classic) 또는 Slot(SBE) 할당
-
Executor 구성 및 Stage 트리 초기화
-
Halloween Problem* 검증
이러한 Express Plan의 성능 향상을 확인하기 위해, 단일 스레드 환경에서 MongoDB 7.0과 8.0을 대상으로 동일한 mongo-perf 워크로드 실험을 진행했습니다.
| 항목 | Throughput (ops/s) | Latency (ms/op) | 개선율 |
|---|---|---|---|
| Queries.IntNonIdFindOne | 43,092 → 64,365 | 0.0232 → 0.0155 | +49.4% / −33.0% |
| Queries.IdentityView.IntNonIdFindOne | 52,530 → 77,443 | 0.0190 → 0.0129 | +47.4% / −32.2% |
| Queries.NonIdFindOne | 39,281 → 58,824 | 0.0255 → 0.0170 | +49.8% / −33.3% |
실험 결과, Express Plan이 적용되는 단순 쿼리 항목에 대해서는 평균 45% 이상의 처리량 향상과 약 30%의 응답 시간 단축이 확인되었습니다. 이는 정리한 내용과 같이 쿼리 준비 단계가 생략되어 쿼리 파싱 직후 바로 실행 루프로 진입해 불필요한 오버헤드가 제거된 영향으로 보입니다.
이렇듯 Express Plan은 제한적인 조건에서만 발동하지만, 간단한 쿼리에 대해서는 쿼리 실행에 필요한 준비 과정을 상당 부분 생략하여 성능상의 이점을 극대화한 점에서 큰 의미가 있다고 생각합니다.
참고: Halloween Problem이란?
Halloween Problem은 데이터베이스에서 업데이트 작업 시, 인덱스 스캔 중 업데이트된 도큐먼트가 다시 스캔 대상에 포함되어 중복 처리 또는 무한 루프가 발생하는 문제를 말합니다. 이 현상은 1970년대 중반 IBM 연구팀이 처음 발견한 시점이 할로윈(10월 31일) 근처였던 데서 이름이 유래되었습니다.
예를 들어 다음과 같은 시나리오에서 문제가 발생할 수 있습니다.
# { x: 1 } 인덱스 생성
db.collection.updateMany(
	{  x:  {  $gte:  0  }  },
	{  $inc:  {  x:  5  }  }
)
-
인덱스를 스캔하여 x=0 도큐먼트를 찾아 x: 5로 도큐먼트 업데이트
-
인덱스에서 위치가 변경됨
-
스캔이 진행되며 같은 도큐먼트를 x=5 위치에서 다시 만나 또 x: 10으로 업데이트 → 무한 루프 발생
MongoDB는 이를 방지하기 위해 업데이트 시 이미 처리된 도큐먼트의 recordId를 기록하여 추적합니다. 하지만 Express Plan은 조건상 단건 도큐먼트에 대한 처리임이 보장되므로, 이러한 검증 과정이 불필요해 생략됩니다.
5. Resharding 개선
MongoDB에서 샤드키(Shard Key)는 샤드 클러스터 상에서 각 샤드 간 데이터의 분포를 결정하는 중요한 요소로, 과거에는 한번 결정하면 변경이 불가했기 때문에 운영 과정에서 어려움을 겪는 경우가 종종 있었습니다. MongoDB 5.0부터는 Live Resharding 기능이 도입되어 이러한 제약이 해소되기 시작했지만, 초기 버전에서는 성능과 안정성 측면에서 실무에 바로 적용하기는 쉽지 않았다고 생각합니다.
그리고 MongoDB 8.0에서는 리샤딩 전반의 성능과 안정성이 크게 향상되었고, 특히 동일한 샤드키로 데이터를 재분배하는 forceRedistribution 옵션까지 추가되면서 실제 운영에서 활용 범위가 훨씬 넓어졌습니다. 리샤딩 기능은 도입 이후 버전이 업그레이드되면서 크게 개선되고 있기 때문에, 이번 글에서는 과거 버전과의 비교보다는 MongoDB 8.0 기준으로 리샤딩이 어떤 방식으로 동작하며, 어떤 경우에 활용하면 좋을지를 살펴보겠습니다.
리샤딩은 대표적으로 기존 샤드키를 기준으로 데이터를 저장하고 있는 샤드를 Donor, 새로운 샤드키를 기준으로 데이터를 저장할 샤드를 Recipient, 그리고 각 샤드 간에 데이터를 주고 받는 전반적인 리샤딩 과정을 관리하는 Coordinator가 존재합니다. 그리고 이를 ReshardingCoordinatorService, ReshardingDonorService, ReshardingRecipientService의 세가지 State Machine으로 표현하고 있습니다.
| Service | 역할 | 주요 상태(State) |
|---|---|---|
| ReshardingCoordinatorService | 전체 리샤딩 프로세스 조율 ( configsvr Primary 담당 ) | initializing → preparing-to-donate → cloning → applying → blocking-writes → committing → done |
| ReshardingDonorService | 기존 샤드에서 데이터를 제공 | preparing-to-donate → donating-initial-data → donating-oplog-entries → preparing-to-block-writes → blocking-writes → done |
| ReshardingRecipientService | 데이터를 받아 새 컬렉션 구성 | awaiting-fetch-timestamp → creating-collection → cloning → building-index → applying → strict-consistency → done |
각 상태별 주요 동작 과정을 Coordinator 흐름을 기준으로 살펴보겠습니다.
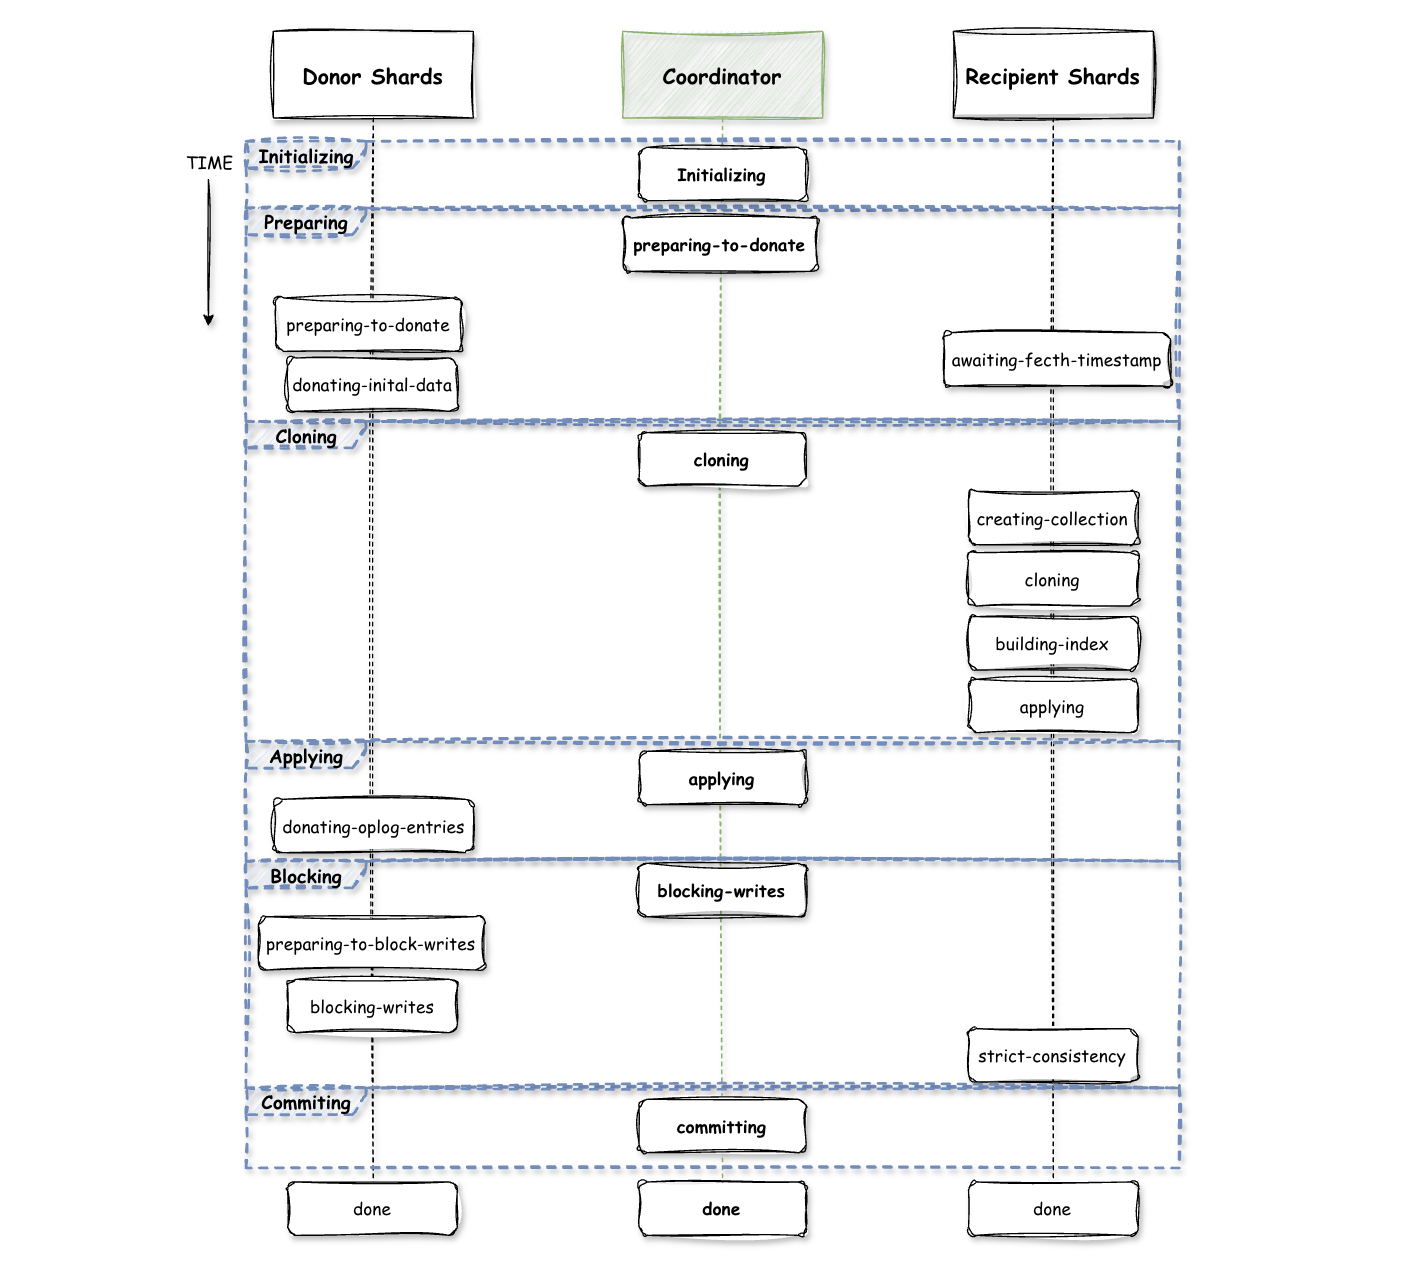
1. Initializing
리샤딩 명령(reshardCollection)이 mongos에서 Coordinator로 전달되며 시작됩니다. Coordinator는 새로운 샤드키 기준으로 미리 청크(Chunk) 메타데이터를 생성합니다.
2. Preparing-to-Donate
Coordinator는 모든 Donor에 minFetchTimestamp를 요청합니다. minFetchTimestamp는 Recipient가 Donor 샤드로부터 데이터를 가져가도 안전한 상태를 나타내는 시점입니다. 내부적으로는 Donor 샤드의 oplog에 신규 샤드키 기준으로 저장될 샤드 정보를 저장하는 destinedRecipient 필드를 추가한 시점입니다.
{
	op : 'n',
	ns : 'config.system.forceOplogBatchBoundary',
	o : {
		msg: "All future oplog entries on the namespace test.test must include a 'destinedRecipient' field"
		},
	# minFetchTimestamp
	ts : Timestamp({ t: 1764565371, i:1}),
	...
}

# donor  샤드  oplog 예)
{
	op : 'i',
	ns : 'test.test',
	...
	destinedRecipient: "shard02"
}
Coordinator는 각 Donor 샤드로부터 minFetchTimestamp를 수신하고, 모든 Donor 샤드에 destinedRecipient 필드가 추가된 것을 보장하기 위해 가장 큰 minFetchTimestamp를 cloneTimestamp로 결정합니다. 만약 하나의 Donor 샤드라도 복제 시점 이후 destinedRecipient 필드가 존재하지 않는다면 oplog를 적용하는 시점에 어떤 Recipient 샤드에 반영할지 알 수 없어 정상적인 리샤딩이 이루어질 수 없습니다.
3. Cloning (스냅샷 기반 복제)
awating-fetch-timestamp 상태로 대기하던 Recipient 샤드는 cloneTimestamp를 전달 받으면 상태를 creating-collection으로 변경하고 리샤딩을 위한 임시 컬렉션을 생성합니다. 이렇듯 리샤딩은 기존 컬렉션에 영향을 주지 않고 임시 컬렉션에 복제 후 기존 컬렉션을 대체하는 방식으로 수행되므로, 안정성을 보장하는 대신 수행전에 충분한 디스크 공간이 확보되어야 합니다.
다음으로 readConcern( level: “snapshot”, atClusterTime: )으로 cloneTimestamp 기반의 스냅샷 조회를 통한 복제를 수행합니다. 이 과정에서 MongoDB 8.0부터는 인덱스 스캔이 아닌 $natural 정렬 기반의 전체 컬렉션 조회를 통해 데이터를 복제하며, 인덱스 빌드는 컬렉션 데이터 복제가 완료된 이후 수행되도록 과정을 분리하여 성능을 크게 개선하였습니다.
여기에서 사용되는 readConcern “snapshot”은 MongoDB 5.0에서 지원하기 시작하였고, MongoDB 4.4에 도입된 과거 변경 이력을 기록하는 History Store의 도입으로 가능하게 된 기능입니다. 변경 이력을 모두 메모리에 유지할 필요 없이 History Store에 기록이 가능하므로 리샤딩 프로세스가 진행되는 동안 cloneTimestamp 기준 시점의 컬렉션 전체 데이터를 메모리 문제 없이 조회할 수 있습니다.
History Store에 대한 상세 내용은 이전 글의 WiredTigerHS.wt를 참고 부탁드립니다.
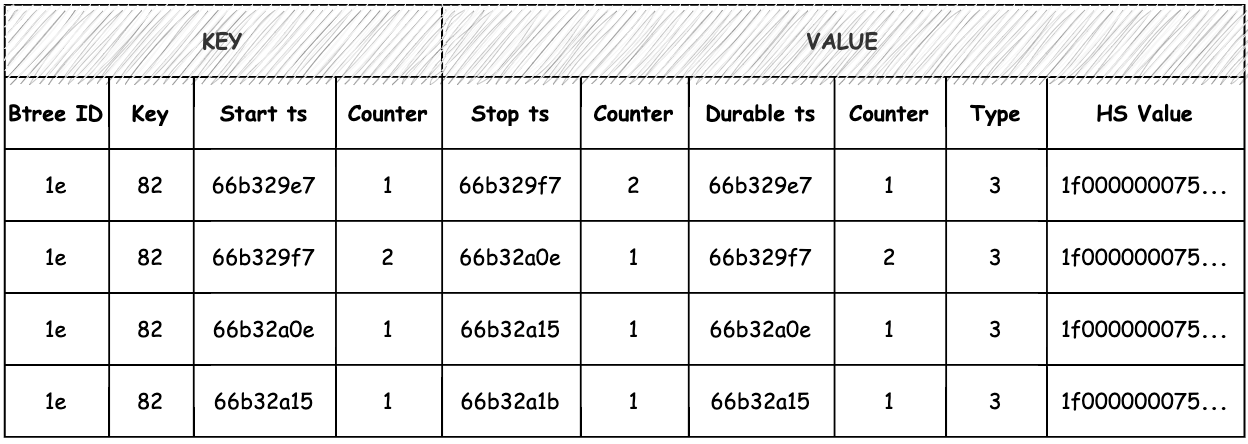
또한, Recipient 샤드는 데이터 복제가 완료된 이후 사용할 각 Donor 샤드의 oplog를 미리 본인의 샤드(local oplog buffer)에 저장합니다.
4. Applying (Catch-up Phase)
Applying 단계에서는 oplog apply를 계속 진행하여 최신 상태까지 반영하며, 기존 컬렉션과 임시 컬렉션을 전환하기 위해 작업을 일시적으로 차단하는 Critical Section에 진입하기 위한 조건을 충족하는지 계속 추적합니다. 이 때 임계치는 내부 파라미터인 remainingReshardingOperationTimeThresholdMillis에 의해 관리되며, 중단 시간을 최소화하기 위해 MongoDB 8.0부터 기본값을 2초에서 500ms로 줄였습니다.
5. Blocking-Writes
모든 Recipient가 조건을 충족하면 Donor에게 쓰기 차단을 요청하며, Recipient는 잔존하는 oplog를 모두 반영한 후 기존 컬렉션과 일관성이 맞는지 메타정보를 비교하여 확인합니다. 이 단계에서 최대 2초 이내의 쓰기 중단이 발생하므로 서비스에서는 리샤딩 수행 전에 이를 허용할 수 있을지 확인해야 합니다. 이후 모든 Recipient가 Strict Consistency 상태에 도달하면 최종 단계인 커밋을 진행합니다.
6. Commit
커밋 과정에서 임시 컬렉션을 기존 컬렉션명으로 Rename하면서 전환이 수행되며, 정상적으로 완료되었다면 쓰기 차단 해제, 임시 컬렉션 삭제 등을 진행하며 리샤딩 과정이 마무리됩니다.
{
	o : {
		renameCollection: 'test.system.resharding.2a013fxxxxxx',
		to: 'test.test',
		stayTemp: false,
		dropTarget: UUID('2a013fxxxxxx')
}
이처럼 리샤딩은 모든 데이터를 임시 컬렉션에 복제하는 방식이어서 수행 전에 충분한 디스크 공간이 필요하며, 리샤딩 과정 중 자원 사용량의 증가로 서비스 워크로드에 따라 영향을 받을 수 있음을 고려해야 합니다. 그러므로 사용 전에 공식 문서의 기준을 참고하시길 권장드립니다.
또한, MongoDB 8.0에서는 forceRedistribution 옵션으로 동일한 샤드키 기반의 리샤딩을 지원합니다. 기존에는 신규 샤드를 추가할 경우 데이터의 이동은 백그라운드에서 수행되는 밸런싱 작업에 의존적이었는데, 이 과정에서 mongos는 Lazy Loading 기반으로 동작하여, 과거 config의 메타데이터를 참조하여 발생하는 Stale Config 오류로 인한 쿼리 지연이 유발되곤 했습니다.
하지만 forceRedistribution 옵션을 사용하면 전체 데이터를 임시 컬렉션에 다시 구성한 뒤 Rename만으로 교체하기 때문에 오랜 밸런싱 시간을 기다릴 필요도 없고, Stale Config 이슈도 함께 해소할 수 있습니다. 따라서 대규모 서비스를 운영하는 입장이라면 충분히 사용을 검토해볼 수 있는 기능이라고 생각됩니다.
6. Move & Unshard a Collection
MongoDB 8.0에서는 위에서 소개한 리샤딩 기능을 활용한 컬렉션 단위 이동(moveCollection)과 샤딩 해제(unshardCollection) 기능이 추가되었습니다.
이전 버전까지 Unsharded 컬렉션은 프라이머리 샤드(Primary Shard)에만 저장되었으며, movePrimary라는 데이터베이스 명령을 통한 데이터베이스 단위의 이동만 지원을 했습니다. 하지만 movePrimary는 수행 도중 해당 데이터베이스의 모든 요청을 차단하기 때문에 운영 중인 서비스에 사용하기는 어려움이 존재했습니다. 물론 Zone Sharding을 통해 밸런싱을 유도하여 컬렉션을 이동시키는 등의 우회 방안들이 존재하지만, 이런 방법도 불필요한 샤딩으로 인해 발생하는 샤드키 지정, 유니크 제약 조건 등 여러 사이드 이펙트를 감수하고 사용해야 했습니다.
마찬가지로, 샤딩되어 있는 컬렉션이 트래픽 감소 혹은 유니크 제약 조건 등의 이유로 더 이상 샤딩되어 있을 필요가 없을 경우, 기존에는 제공되는 명령가 없었기 때문에 신규 컬렉션으로 별도 마이그레이션을 진행해야 했습니다.
MongoDB 8.0부터는 moveCollection과 unshardCollection을 공식적으로 지원하여 샤딩된 컬렉션을 샤딩되지 않은 상태로 되돌리고, 해당 컬렉션을 다른 샤드로 이동하는 작업까지 가능해졌습니다.
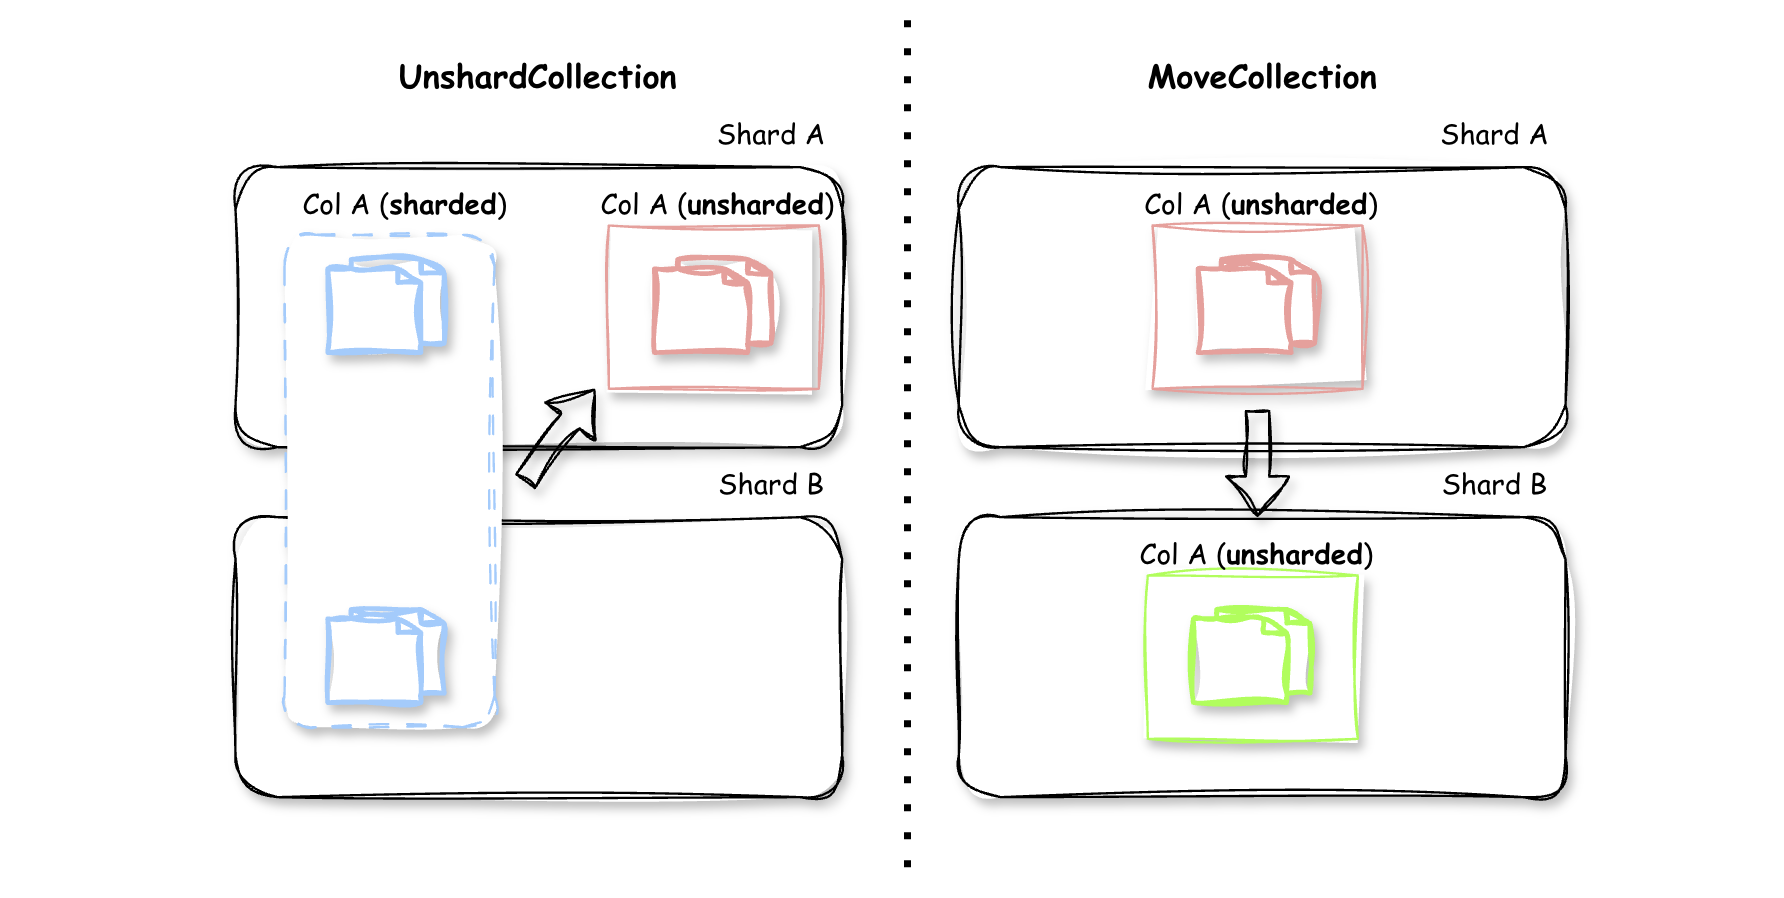
각 기능의 동작 방식을 살펴보면, moveCollection은 _id: MinKey() ~ MaxKey() 범위의 단일 청크를 생성한 뒤 이동 대상 샤드로 리샤딩을 수행하는 방식으로 동작합니다.
db.adminCommand(
	{
		moveCollection: ".",
		toShard: "",
	}
)
unshardCollection 역시 {_id: 1}을 새로운 샤드키로 단일 청크를 생성해 리샤딩을 진행하며, MongoDB 8.0부터는 forceRedistribution 옵션을 통해 동일한 샤드키에 대해서도 리샤딩을 수행할 수 있기 때문에 기존 샤드키의 형태는 제약 요인이 되지 않습니다.
db.adminCommand(  {
	unshardCollection:  ".",
	toShard:  ""
}  )
이렇게 생성된 컬렉션은 외형적으로는 샤딩된 컬렉션처럼 보이지만, 내부적으로는 Unsharded 컬렉션으로 동작해야 하므로 이를 구분하기 위해 "unsplittable"이라는 새로운 필드가 추가되었습니다. 즉, 해당 플래그가 활성화되어 있다면 샤딩된 컬렉션의 제약사항은 적용되지 않습니다.
# config.collections
{
	key:  {  _id:  1  },
	unsplittable:  true
}
moveCollection과 unshardCollection은 사용자 입장에서 자주 필요한 명령은 아닐 것 같습니다. 다만, 단일 클러스터에서 여러 서비스를 운영하고자 하는 경우 해당 기능을 활용해 특정 컬렉션의 트래픽이 높아지면 샤딩을 적용하고, 줄어들면 다시 Unsharded 컬렉션으로 되돌리고 필요에 따라 샤드를 이동하는 등 자원을 유연하게 활용해 공용클러스터 형태의 운영이 가능할 것으로 생각됩니다.
7. 샤드키 필터 조건 완화
MongoDB 샤드 클러스터 환경에서는 샤딩된 컬렉션에 대해 특정 메소드를 사용할 때 필터 조건에 샤드키를 반드시 포함해야 한다는 제약이 있었지만, MongoDB 8.0에서는 이러한 제약도 해소되었습니다. 즉, findAndModify, deleteOne, updateOne with upsert 모두 이제 필터 조건에서 샤드키가 필수 조건이 아니기 때문에, 샤드 클러스터 환경에서도 유연한 쿼리 사용이 가능합니다.
| 연산 | ~ MongoDB 7.0 | MongoDB 8.0 ~ |
|---|---|---|
| deleteOne() | 풀 샤드키 또는 _id 필요 | 샤드키 불필요 |
| findAndModify | 단일 샤드 보장 필요(사실상 풀 샤드키 요구) | 샤드키 불필요 |
| updateOne({upsert:true}) | 풀 샤드키 필수 | 샤드키 불필요 |
MongoDB 7.0의 경우 아래 예시와 같이 ShardKeyNotFound 에러가 발생합니다.
// shard key: {"b": "hashed"}
> db.target.findAndModify({
	query: { a:10 },
	update: { $inc: { score: 1 } },
	upsert: true
})
MongoServerError[ShardKeyNotFound]: Query with sharded findAndModify expected to only target one shard, but the query targeted 3 shard(s)
반면, MongoDB 8.0부터는 동일한 쿼리를 수행했을 때 에러 없이 정상적으로 수행됩니다.
// shard key: {"b": "hashed"}
> db.target.findAndModify({
	query: { a:10 },
	update: { $inc: { score: 1 } },
	upsert: true
})
{
	acknowledged: true,
	insertedId: null,
	matchedCount: 1,
	modifiedCount: 1,
	upsertedCount: 0
}
이처럼 기존에는 단일 도큐먼트 수정 시 명시적으로 샤드키 또는 MongoDB의 기본 키인 _id를 필터에 포함해 어느 샤드에서 실행해야 하는지를 명확히 지정할 수 있을 때만 허용되었습니다. 반면, MongoDB 8.0에서는 Two-Phase Protocol 개념을 도입하여 이러한 제약을 해소했습니다.
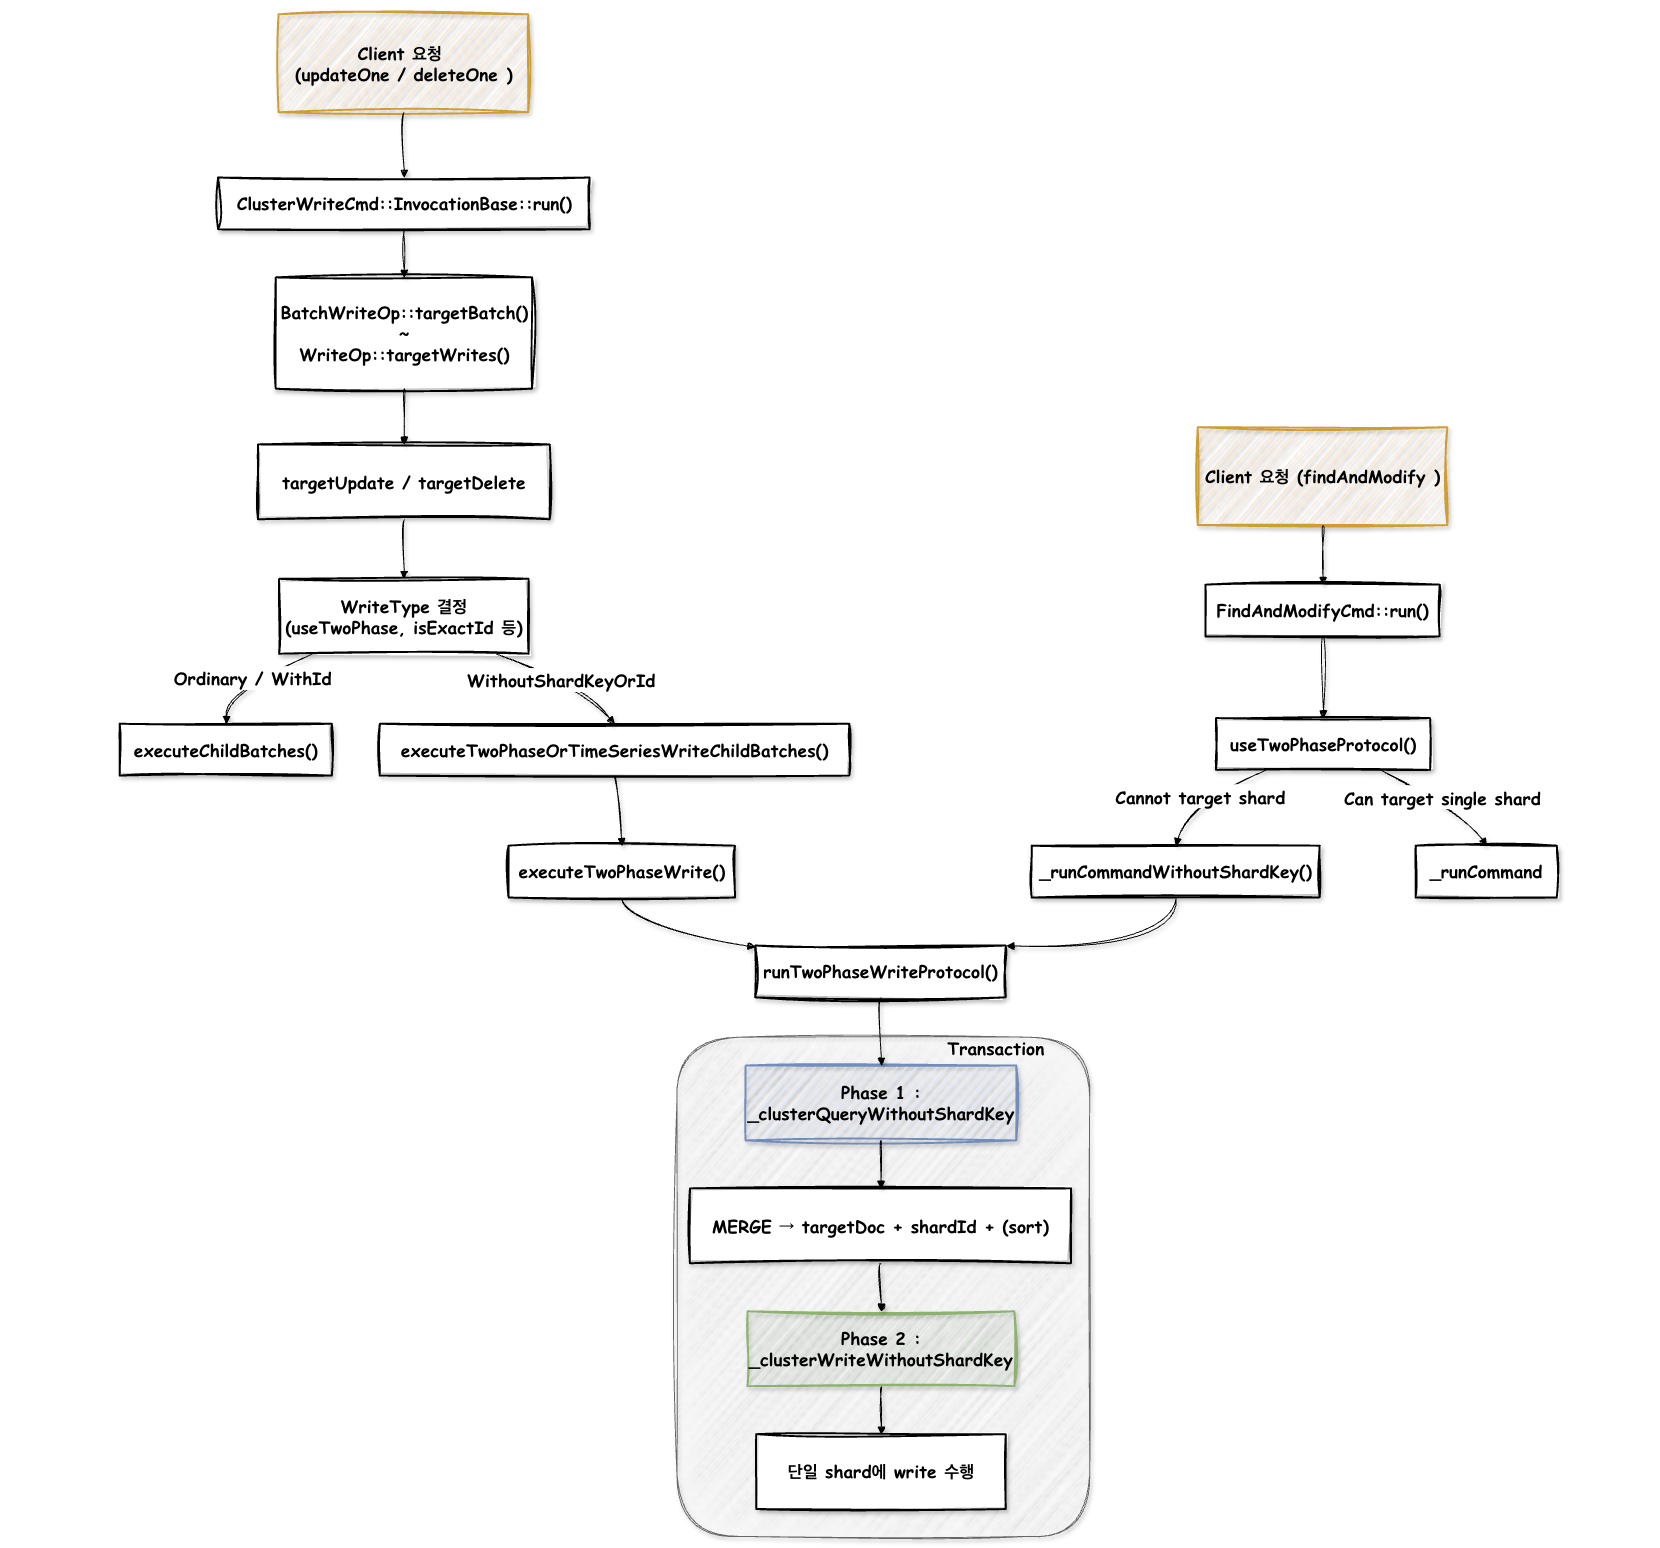
Phase 1: _clusterQueryWithoutShardKey
-
첫 번째 단계에서는 수정할 도큐먼트가 어느 샤드에 있는지 찾기 위해 단건 조회($match + $limit : 1) 쿼리를 잠재적으로 관련된 모든 샤드에 전송합니다.
-
그리고 각 샤드로부터 응답을 받은 결과를 병합(Merge Stage)한 후, MongoDB 8.0부터 추가된 정렬 조건을 고려하여 실제 연산을 수행할 단 하나의 샤드를 선정합니다.
Phase 2: _clusterWriteWithoutShardKey
-
두 번째 단계에서는 첫 번째 단계에서 특정한 샤드에 쓰기 연산(updateOne / deleteOne 등)을 수행합니다.
-
일련의 과정은 하나의 트랜잭션으로 묶여 실행되며, 최종 쓰기는 단일 샤드에서만 수행됩니다. 즉, 단일 샤드에 대한 트랜잭션이기 때문에 2PC(Two-Phase Commit)를 사용하지 않으며, 여기에서 말하는 Two-Phase Protocol은 용어만 비슷할 뿐 Two-Phase Commit과는 전혀 다른 개념입니다.
정리하자면, 제공된 조건으로 단일 샤드를 특정할 수 없는 경우 실제 쿼리를 통해 샤드를 특정하고 단일 샤드에만 연산을 수행하도록 내부적으로 보장해주는 방식입니다. 하지만 이러한 특성으로 일반적인 연산과는 다르게 최소 두번의 왕복이 필요하므로 성능을 고려한다면 여전히 필터 조건에는 샤드키를 포함하는 것이 권장됩니다.
주의해서 사용할 필요가 있는 기능이라 생각되지만, 샤드 클러스터 상의 제약을 하나씩 해소하며 사용성을 개선하고 있다는 점에서 의미가 있는 것 같습니다.
8. New Query Shape과 Query Setting
MongoDB의 쿼리 옵티마이저는 주어진 쿼리에 대해 가장 효율적인 인덱스를 활용하는 실행 계획(Execution Plan)을 자동으로 선택합니다. 하지만 데이터 분포 혹은 인덱스 특성에 따라 옵티마이저가 비효율적인 인덱스를 선택하여 예상치 못한 지연이 발생하는 경우가 발생하곤 했습니다. 이러한 경우를 지원하기 위해 Query Shape과 Query Setting을 도입했는데, 이를 소개하기 앞서 기존에 사용자가 옵티마이저의 선택에 개입할 수 있던 방식을 먼저 소개드리겠습니다.
기존에는 크게 cursor.hint() 와 index filter 두 가지 방식을 통해 지원을 했는데요, 먼저 cursor.hint()의 경우 쿼리를 수행할 때 지정한 인덱스를 사용하도록 강제하는 방식입니다. 서버에서 설정하는 것이 아닌 클라이언트에서 제어하는 방식으로 일회성 쿼리에서는 유용하게 사용할 수 있습니다. 그러나, 삭제된 인덱스를 인지하지 못하고 사용할 경우 장애를 유발할 수 있고, 사용할 인덱스를 변경하려면 애플리케이션의 관련 코드를 모두 수정해야 하기 때문에 유지보수에 어려움이 있습니다.
db.users.find().hint( { age: 1 } )
다음으로 Index Filter라는 서버에서 제어가 가능한 옵션도 존재했습니다. 이 기능은 아래와 같이 planCacheSetFilter 명령을 통해 지정을 할 수 있는데요, 해당 기능은 개별 노드에서 지정을 해야 하며 메모리에서만 설정 값을 유지하기 때문에 서버 재시작시 설정 값이 초기화되는 특성을 가집니다. 또한 쿼리 형태와 전혀 관련 없는 인덱스를 설정하더라도 설정 값으로 쿼리를 그대로 수행하기 때문에 컬렉션 전체 스캔을 유발하는 문제도 존재했습니다.
db.runCommand(
	{
		planCacheSetFilter: "orders",
		query: { item: "ABC" },
		projection: { quantity: 1, _id: 0 },
		sort: { order_date: 1 },
		indexes: [
			{ item: 1, order_date: 1 , quantity: 1 }
		]
	}
)
이러한 두 방식이 가지는 한계를 극복하기 위해, MongoDB 8.0에서는 쿼리의 구조적 형태를 식별하는 Query Shape 개념 과 Shape을 기준으로 실행 정책을 제어할 수 있는 Query Setting 기능이 새롭게 도입되었습니다.
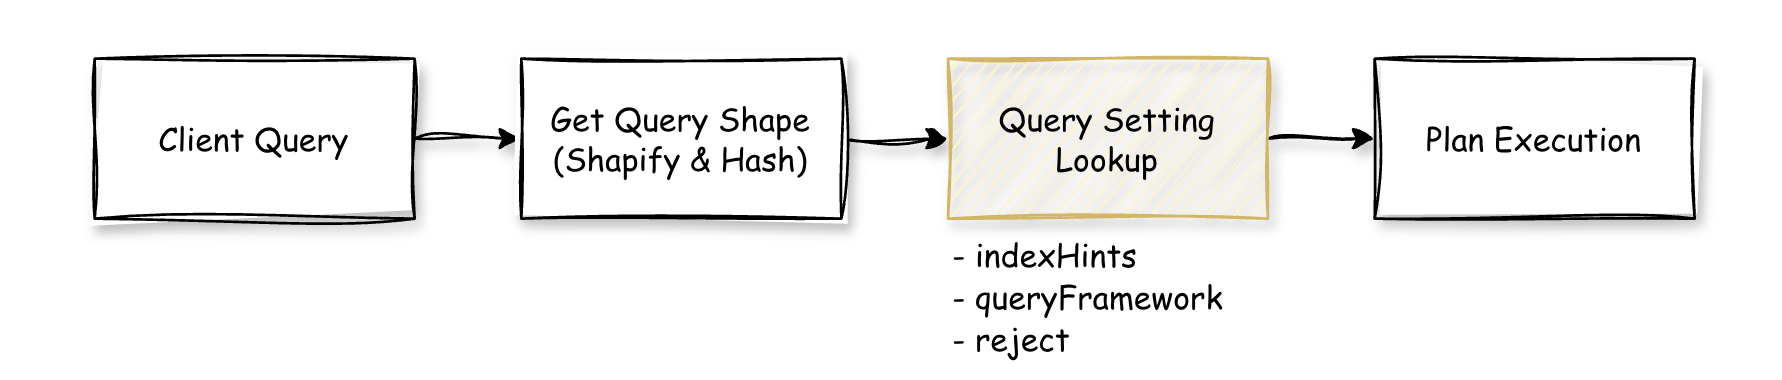
이 기능은 기존의 Index Filter를 완전히 대체하며, 인덱스 힌트 기능을 기존보다 안전한 방식으로 제공하는 것뿐만 아니라 queryFramework(sbe 또는 classic engine)를 지정하거나 원하는 쿼리 형태의 실행을 차단하는 기능을 제공하여 사용성을 크게 개선했습니다. 이로써 Index Filter 기능은 MongoDB 8.0에서 완전히 제거되었습니다.
Query Settings 예시)
db.adminCommand( {
   setQuerySettings: {
   	, // Provide  fields  for  find,  distinct,  or  aggregate  command
   	$db:  // Provide a database name
   },
   // Provide a settings document with indexHints and other fields
   settings: {
   	indexHints: [ {
   		ns: { db: , coll:  },
   		allowedIndexes:
   	}, ... ],
   	queryFramework: ,
   	reject: ,
   	comment:
   }
} )
Index Filter와 달리 setQuerySettings 명령으로 설정된 정책은 클러스터 전체에 영구적으로 적용되며, 서버 재시작 후에도 유지됩니다. 해당 명령으로 지정할 수 있는 주요 옵션은 다음과 같습니다.
| 항목 | 설명 |
|---|---|
| indexHints | 옵티마이저가 고려할 인덱스 목록을 지정합니다. 설정된 인덱스로 플랜 생성이 불가능한 경우 자동으로 플랜을 재지정합니다. |
| queryFramework | 쿼리 엔진을 classic 또는 sbe 엔진으로 명시적으로 지정합니다. 단, Express Plan 대상 쿼리에 설정하면 Express Plan은 비활성화됩니다. |
| reject | 해당 쿼리 형태의 모든 쿼리를 차단합니다. 대량 스캔 등 위험한 쿼리를 방지하는 데 활용할 수 있습니다. |
| comment | 정책 적용 배경이나 목적을 기록할 수 있으며, $querySettings 조회 시 함께 확인할 수 있습니다. |
indexHints 옵션은 기존과 유사한 방식으로 사용되지만, 내부적으로 더욱 강력한 기능을 제공합니다. 새로 도입된 Query Setting의 설정 값은 Index Filter 혹은 cursor.hint()와 같이 사용하더라도 우선적으로 적용됩니다. 또한, 쿼리에 전혀 활용 불가능한 인덱스 또는 삭제된 인덱스가 설정되었다면 쿼리 실행 계획을 생성하는 과정에서 에러(NoQueryExecutionPlans)를 반환하며 쿼리 세팅을 무시(IGNORE_QUERY_SETTINGS)하는 플래그를 활성화한 뒤 다시 쿼리 플래너를 생성합니다.
즉, 다시 수행된 쿼리 플래너에서는 쿼리 세팅 설정과 무관하게 최적의 실행 계획을 선정하기 때문에 예상치 못한 지연을 예방합니다. 하지만, 쿼리 세팅에 불필요한 인덱스가 계속 유지된다면, 쿼리 플래너가 두 번씩 생성되어 성능 오버헤드가 발생할 수 있으므로 사용하지 않는 설정 값에 대한 관리가 필요합니다.
다음으로 내부적으로 쿼리 형태를 식별하기 위해서 queryShapeHash라는 해싱 값을 사용하며, 아래와 같은 세 단계를 거쳐 생성합니다.
-
Shapify: 쿼리 구조를 직렬화하며 각 필드 값은 표준화
-
BSON 직렬화: ns 및 collation 정보를 포함한 BSON 객체로 변환
-
SHA256 해싱: 직렬화된 BSON에서 queryShapeHash를 생성
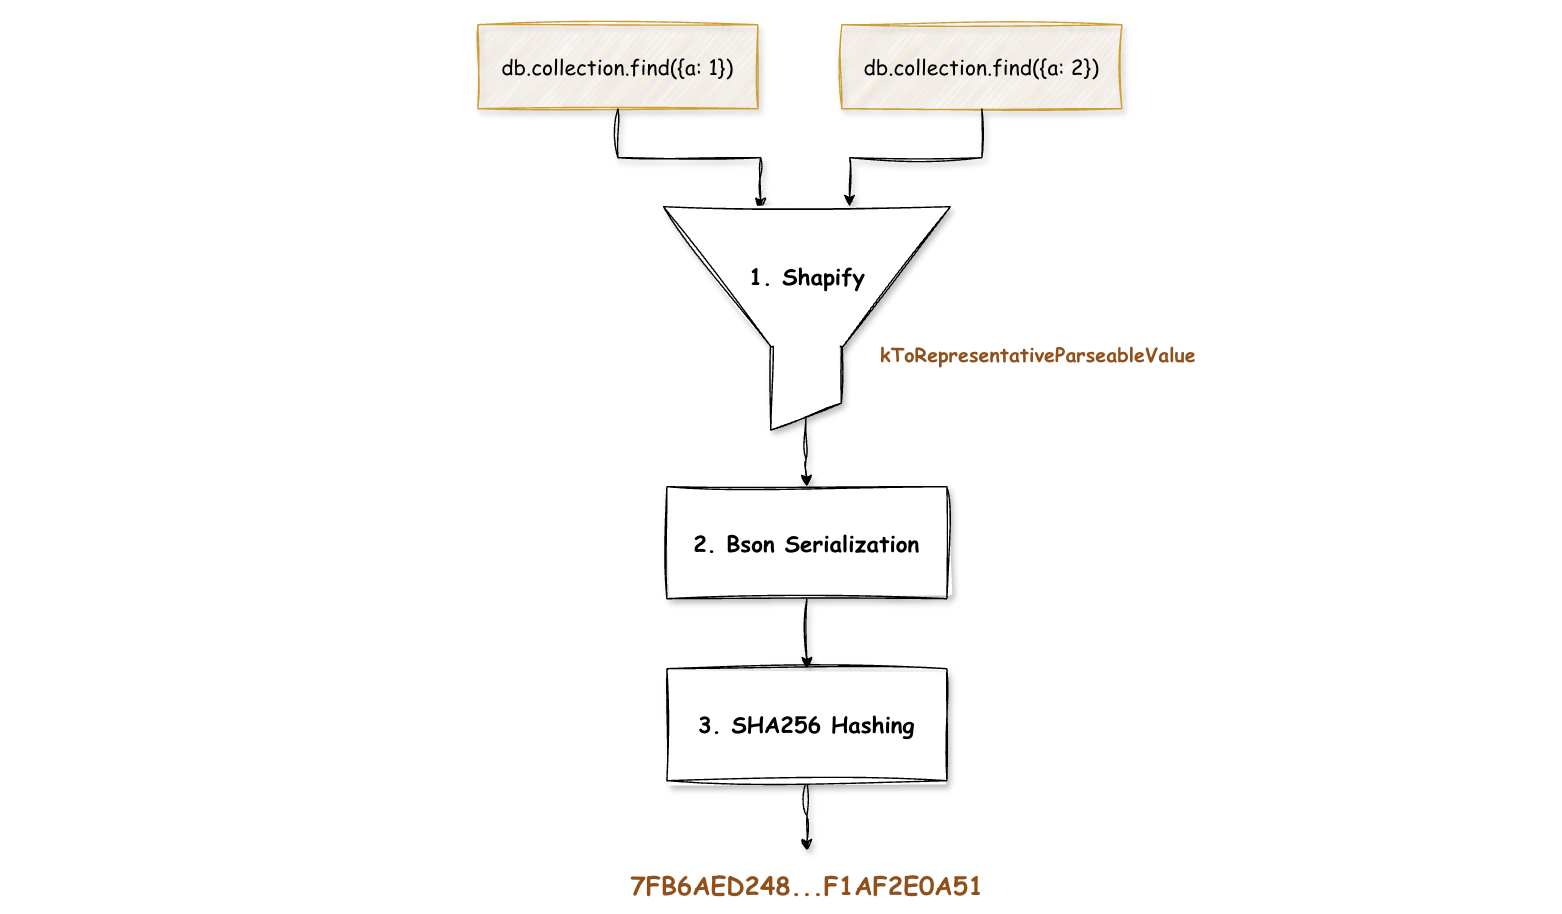
이 과정에서 kToRepresentativeParseableValue라는 직렬화 옵션을 사용하여 실제 값은 제거되고 타입 정보만 유지되기 때문에, 예를 들어 {a: 1}과 {a: “Apple”}은 서로 다른 Query Shape으로 분류되지만, 같은 타입 내에서 값만 달라지는 경우에는 동일한 Query Shape으로 관리할 수 있습니다.
use test
db.collection.find({a:1})
- queryShapeHash: 7FB6AED24855D5E3394E4F703BA31A10E69FD2C9D423C1935F3E0AF1AF2E0A51

db.collection.find({a:2})
- queryShapeHash: 7FB6AED24855D5E3394E4F703BA31A10E69FD2C9D423C1935F3E0AF1AF2E0A51

db.collection.find({a:"Apple"})
- queryShapeHash: 966EB9FC296C702E1BC7698DBD75FDA436E767BB258562F58435EA9D1CD7CE76
정리하자면, MongoDB 8.0에 도입된 Query Shape과 Query Setting은 데이터베이스 관리와 쿼리 최적화를 한 단계 발전시켰으며 DBA 입장에서 활용도가 높은 기능이라고 생각됩니다. 만약, 의도치 않은 쿼리가 반복적으로 수행되어 시스템에 위험을 초래할 경우 해당 유형의 쿼리를 reject 옵션으로 즉시 차단할 수 있고, 쿼리를 세팅한 목적과 배경 같은 히스토리를 comment 필드에 기록해 모니터링에 활용할 수 있습니다.
참고: queryShapeHash vs planCacheShapeHash
MongoDB 8.0 이전부터 옵티마이저가 내부적으로 플랜 캐시(Plan Cache)를 조회하기 위한 식별자인 queryHash라는 해싱 값이 있었는데요. MongoDB 8.0에서 추가된 queryShapeHash와 명칭이 유사하여 queryHash를 planCacheShapeHash라는 명칭으로 변경하였고, 기존에 사용하던 queryHash 필드는 향후 버전에서 제거될 예정입니다. 명칭을 변경했음에도 두 해싱 값의 용도의 혼란이 있을 수 있어 참고사항으로 비교한 내용을 정리해두겠습니다. (개인적으로 MongoDB의 작명 센스에 아쉬운 점이 참 많습니다. )
| queryShapeHash | planCacheShapeHash (구. queryHash) | |
|---|---|---|
| 용도 | Query Settings, Query Stats 관리 | 플랜 캐시 전용 |
| 형태 | 64자리 256비트 16진수 문자열(SHA256) | 8자리 32비트 16진수 문자열(MurmurHash) |
| 고유성 | 높은 수준의 고유성 보장 | 상대적으로 충돌 가능성 높음 |
| 조건 값의 타입 구분 | O | X |
9. Config Shard
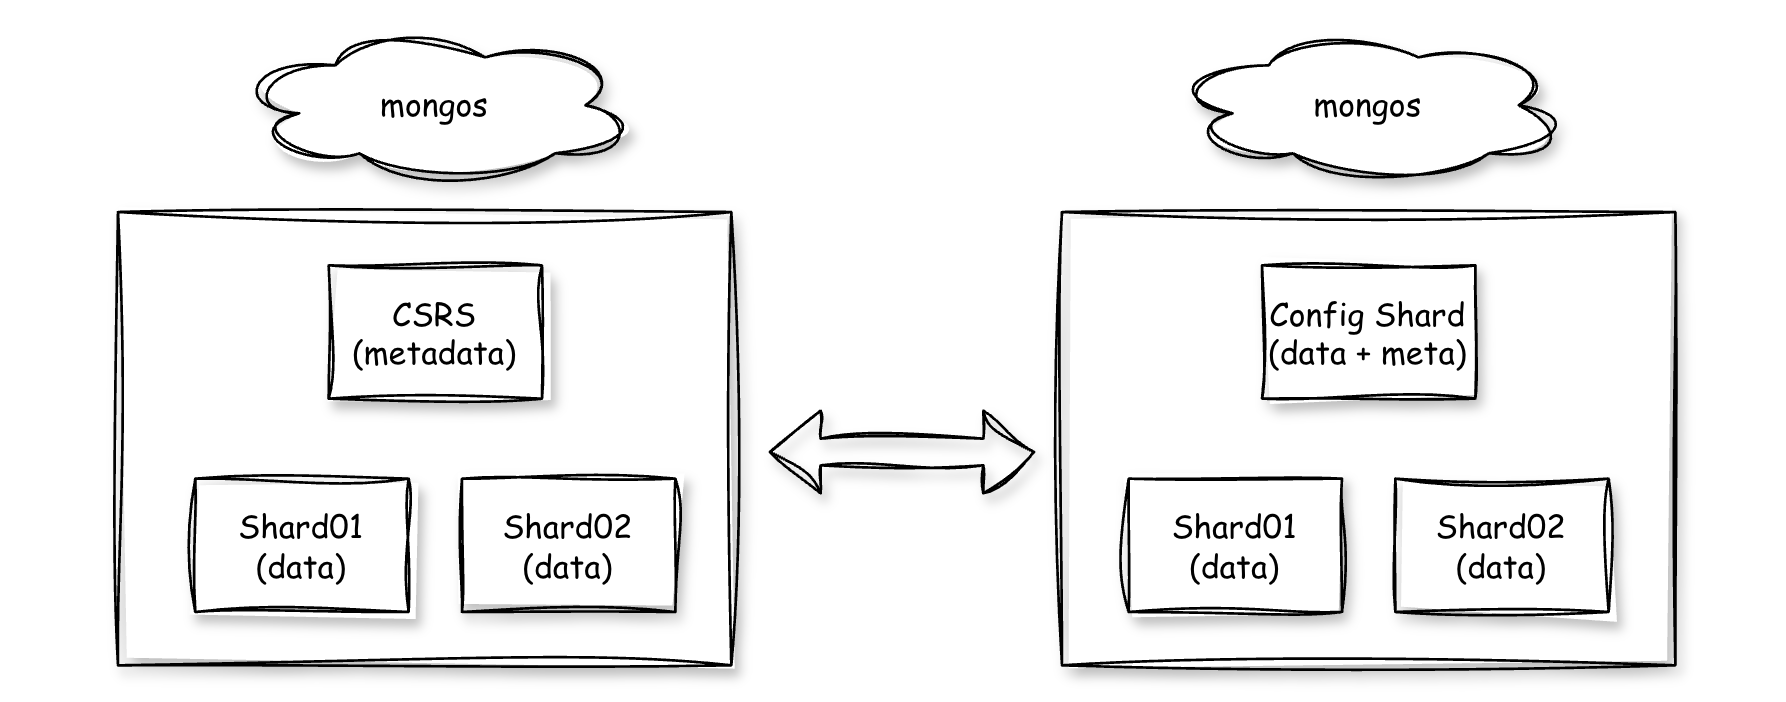
MongoDB 8.0에서는 컨피그 서버가 단순히 메타데이터만 관리하던 기존 구조에서 한 단계 확장되어, 사용자 데이터를 함께 저장할 수 있는 옵션이 추가되었습니다. 이제 컨피그 서버는 일반 샤드 노드처럼 동작할 수 있으며, 이러한 새로운 형태의 노드를 컨피그 샤드(Config Shard) 라고 부릅니다.
기존에는 CSRS(Config Server Replica Set)가 메타데이터 전용으로만 운영되었기 때문에, 단일 샤드 클러스터라도 컨피그 서버를 위한 3개의 노드가 추가적으로 필요했습니다. 하지만 컨피그 샤드의 도입으로 컨피그 서버를 기존 샤드처럼 활용할 수 있게 되면서, 소규모 샤드 구성에서 배포 복잡도와 리소스를 줄일 수 있다는 장점이 추가되었습니다.
MongoDB 8.0에서는 아래 두 개의 admin 명령을 통해 전용 컨피그 서버와 컨피그 샤드 간 전환이 가능합니다.
# 전용 컨피그 서버를  컨피그 샤드로  전환
db.adminCommand(  {
	transitionFromDedicatedConfigServer:  1
}  )

# 컨피그 샤드를 분리하여 전용 컨피그 서버로 전환
db.adminCommand(  {
	transitionToDedicatedConfigServer:  1
}  )
이 명령들은 mongos에서 실행되며, transitionFromDedicatedConfigServer는 내부적으로 addShard를 기반으로 config라는 샤드명으로 CSRS를 샤드로 등록하여 토폴로지를 갱신합니다. 반대로 transitionToDedicatedConfigServer는 removeShard를 기반으로 데이터 드레인 후 메타데이터 정리, 샤드 목록에서 컨피그 샤드를 제외하는 순서로 동작합니다.
기존에는 샤드 클러스터라면 단일 샤드 구성이라도 초기 비용이 높아, 레플리카 셋으로 구성 후 서비스 확장에 따라 샤드 클러스터로 전환하는 경우가 있었는데, 이 경우 샤드 전환 과정에서 작업의 복잡도가 높았고 특히 과거 버전(7.0 이전)에서는 서비스 중단이 필요하였기 때문에 운영상 고려할 부분이 많았습니다.
하지만 MongoDB 8.0의 컨피그 샤드 도입으로, 최초 구성 시 단일 샤드 클러스터로 구성 후 레플리카 셋과 동일하게 사용하다가 필요에 따라 유연하게 샤드를 확장할 수 있게 되었습니다. 이 점을 활용하여 Atlas에서도 전용 클러스터를 샤딩 아키텍처 기반으로 구성하는 방안을 추진 중인 것으로 보입니다.
다만, 아래와 같은 경우에는 컨피그 샤드를 사용할 수 없습니다.
-
Queryable Encryption(QE) 컬렉션은 reshardCollection 또는 moveCollection을 사용할 수 없어, 컨피그 샤드 ↔ CSRS 전환 시 데이터 이동이 불가능합니다.
-
Queryable Backup(On-premise)은 컨피그 샤드 구조와 호환되지 않습니다.
정리하자면, 컨피그 샤드는 작은 규모 클러스터의 운영 비용과 배포 복잡도를 줄이고 샤드 확장을 더 유연하게 만들기 위한 하나의 옵션이라 생각됩니다. 다만, 메타데이터와 사용자 워크로드를 동시에 처리하기 때문에 테스트 환경 혹은 소규모 프로덕션 환경에서의 사용이 권장되며, 일정 규모 이상의 운영 환경에서는 여전히 전용 컨피그 서버 구성이 안정성 측면에서 유리하다고 생각됩니다.
10. PBWM(Parallel Batch Writer Mode Lock) 제거
MongoDB는 사용자 요구사항과 변화되는 환경에 맞게 락 매커니즘을 지속적으로 개선해왔습니다. 특히 WiredTiger 스토리지 엔진 도입 이후 Document-Level Locking과 Timestamp 기반 연산을 지원하면서 기존 락에서 발생하던 많은 오버헤드를 줄이기 위해 노력했습니다. 그리고 v7.1부터는 예기치 못한 세컨더리 읽기 지연을 유발하던 PBWM(Parallel Batch Writer Mode) 락이 제거되었습니다.
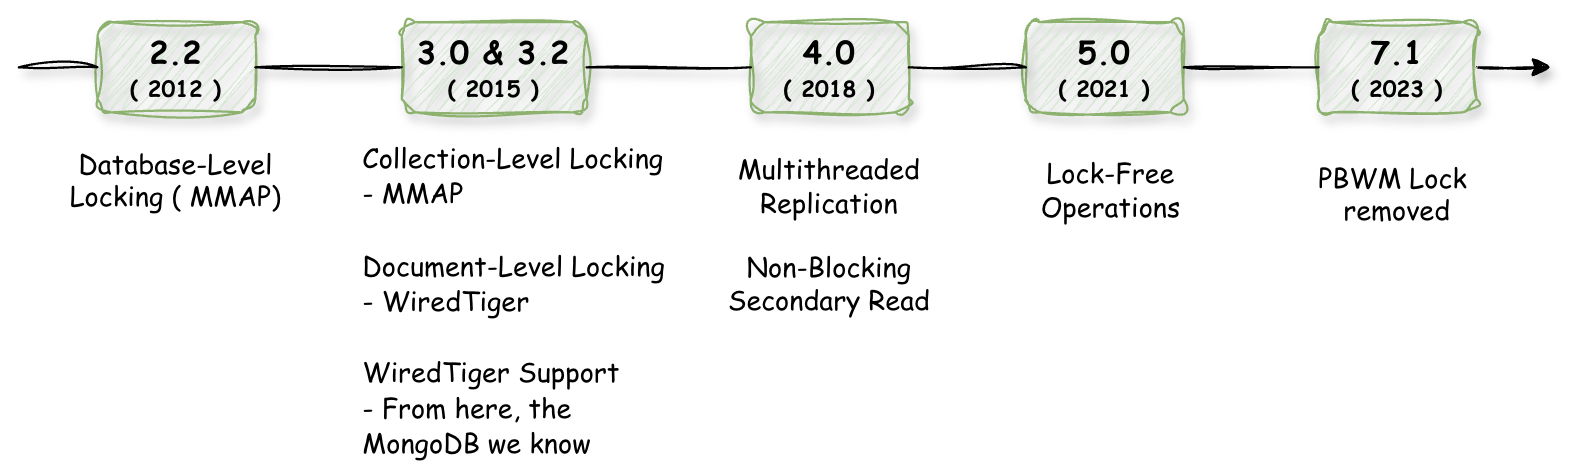
PBWM은 세컨더리 노드가 oplog 배치를 병렬로 적용할 때 일관성을 보장하기 위한 글로벌 리소스로, 과거에는 배치가 진행되는 동안 세컨더리의 읽기 작업이 모두 대기해야 했습니다. 글로벌 리소스 특성상 배치와 직접 관련 없는 데이터 조회 역시 예외 없이 같은 대기열에 묶여 지연을 초래하는 경우도 있었습니다.
MongoDB 3.6에서는 이런 불편을 개선하기 위해 WiredTiger에 MongoDB Timestamp 개념을 지원하기 위한 기능이 도입되었고, 이 때부터 시간 개념을 활용한 많은 기능들이 최근 버전까지도 도입되고 있습니다. 해당 기능으로 PBWM 락으로 인한 이슈도 많은 부분 해소를 했는데요, MongoDB 4.0부터 세컨더리에서는 배치 적용이 완료된 시점인 lastApplied 값을 활용해 Timestamp 기반 조회를 수행하여 PBWM 락으로 인한 읽기 지연을 해소했습니다. 그리고 체감하신 분들도 있을텐데, MongoDB 5.0에 도입된 Lock-Free Operations도 동일한 개념이 적용되면서 llistCollections와 같이 단순 메타 조회에서도 간헐적으로 발생하던 지연이 해소되었습니다.
사용자가 일반적으로 사용하는 세컨더리 조회는 MongoDB 5.0부터는 모두 lastApplied 기반의 조회로 전환되었지만, 일부 lastApplied를 사용하지 않는 내부 작업들은 영향 범위에 있었고, 글로벌 리소스인 만큼 엮어있는 부분이 많아 PBWM 락을 바로 제거하기는 어려웠습니다. 하지만, MongoDB 7.1에서는 여러 검증을 거쳐 PBWM 락을 제거하기로 결정했고, 커뮤니티 바이너리 기준 MongoDB 8.0에서는 PBWM 락으로 인한 리스크가 모두 제거되었습니다. 아마 대부분의 서비스는 체감하기 어려운 변경이라 생각되지만, 이런 내부적인 변경들이 모여 MongoDB 8.0의 성능 향상에 기여했다고 생각합니다.
11. Per-CPU TCMalloc
(내용에 앞서, 해당 변경사항은 TCMalloc의 신규 기능에 의존적이므로 상세 내용은 공식 문서의 가이드를 참조하시는 것을 권장드립니다.)
MongoDB는 기본 메모리 할당자로 구글의 TCMalloc을 사용하고 있습니다. TCMalloc은 Thread-Caching Malloc의 줄임말로, 계층적 캐시 구조를 통해 멀티 스레드 환경에서 발생하는 메모리 할당 및 해제 병목 현상을 해결하고 월등한 속도와 확장성을 제공하는 고성능 메모리 할당자입니다. 다만, MongoDB와 같이 많은 스레드를 사용하는 환경에서는 메모리 파편화, 캐시 비효율 등의 문제가 지적되어 왔습니다.
MongoDB 8.0에서는 이러한 한계를 해소하기 위해 Per-CPU 방식으로 개선된 최신 TCMalloc을 적용했습니다. 변경 사항을 소개하기에 앞서, TCMalloc이 어떠한 형태로 메모리 할당을 수행하는지 알아보겠습니다.
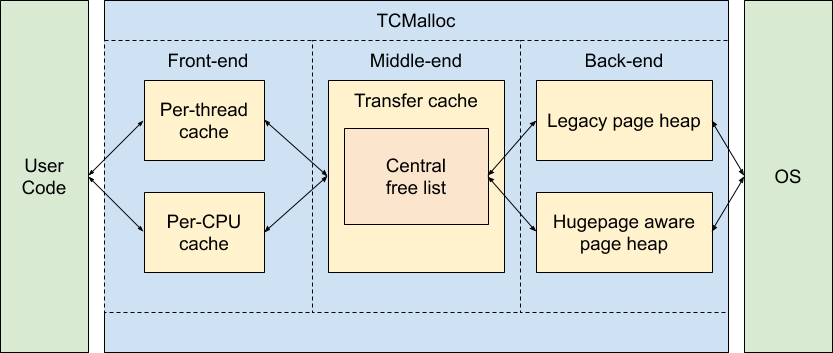
TCMalloc은 크게 세 개의 계층으로 역할을 구분하여 전체적인 효율을 높일 수 있도록 설계되었습니다.
-
Front-end: 애플리케이션의 malloc() / free() 호출이 가장 먼저 도달하는 계층으로, 매우 빠르고 경합 없는 메모리 접근을 제공하는 것이 목표입니다.
-
Middle-end: Front-end의 캐시가 고갈되면 다시 채워주고, 반대로 너무 많은 여유 객체가 쌓이면 회수하는 역할을 합니다.
-
Back-end: OS와 직접 상호작용하는 최하위 계층입니다. mmap() / sbrk() 등 시스템 콜을 통해 OS로부터 메모리를 할당받고, 필요없는 메모리는 반환하는 역할을 합니다.
애플리케이션이 메모리를 요청했을 때, 가장 빠른 로컬 캐시에서 시작해 실패할 때마다 더 큰 규모의 풀로 순차적으로 요청을 넘기는 흐름으로 동작합니다.
1. Size Classification: 요청된 메모리 크기는 파편화 방지를 위해 미리 정해진 Size Class로 상향 조정됩니다. (예: 9byte → 16byte, 1000byte → 1024byte).
2. Front-end Cache 조회: 현재 스레드에 할당된 로컬 캐시(Free List)에서 사용 가능한 메모리를 찾습니다. 메모리가 있다면 즉시 할당하고 종료됩니다.
3. Middle-end (Central Free List) 요청: 로컬 캐시에 해당 Size Class가 없으면, 공유되는 중앙 캐시인 Central Free List에 할당을 요청합니다.
4. Back-end (PageHeap) 요청: 중앙 캐시마저 비어 있다면, Middle-end는 Back-end의 PageHeap에 연속된 메모리 페이지 덩어리(Span)를 요청하고, 이를 쪼개어 중앙 캐시와 로컬 캐시를 채웁니다.
5. OS 시스템 콜 요청: 전체 과정 중 가장 고비용의 작업으로, PageHeap에도 여유가 없을 경우 최종적으로 OS에 새로운 메모리 청크를 요청합니다.
MongoDB 8.0에서 적용된 TCMalloc의 주요 변경 사항은 Front-end의 Per-CPU Cache와 Back-end의 Hugepage-Aware PageHeap입니다.
기존의 Per-thread 방식은 스레드가 적은 경우에는 효율적이지만, 스레드가 많을수록 캐시가 분산되고 각 스레드의 할당/해제 패턴 차이로 파편화가 심화될 수 있다는 문제가 있었습니다. Per-CPU 방식은 이런 문제를 근본적으로 해결했다고 합니다. 캐시의 수가 스레드 수가 아닌 CPU 코어 수에 비례하므로, 스레드가 많아져도 캐시 효율이 떨어지지 않습니다.
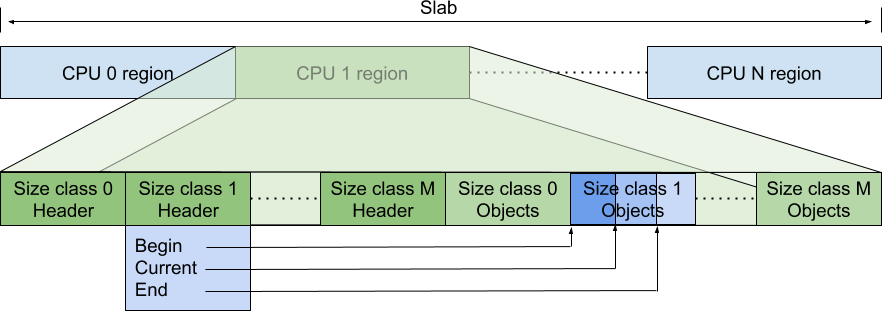
각 CPU 코어는 독립적인 Slab 구조를 가지며, Size Class별로 즉시 재사용 가능한 Free List가 유지됩니다. 이러한 방식은 Linux Kernel 4.18에 도입된 잠금 없는 동시 제어 메커니즘인 rseq(Restartable Sequences)를 활용해 대부분의 요청을 각 코어 내에서 잠금없이 빠르게 처리할 수 있도록 구현했고, 가끔 발생하는 Slab 고갈 시에만 Middle-end와 통신하여 전반적인 효율을 향상시켰습니다.
다음으로 MongoDB 8.0 부터는 THP(Transparent Huge Pages)의 활성화를 권장합니다. THP는 리눅스 커널의 메모리 관리 기능으로, 4KB 등의 페이지가 아닌 2MB 크기의 큰 페이지를 사용하여 TLB(Translation Lookaside Buffer)의 효율을 극대화하기 위한 기능입니다. 하지만 대부분의 DBMS는 비연속적인 메모리 접근 패턴을 보이며 2MB의 큰 페이지 중 일부 작은 영역만 산발적으로 사용하여 내부 파편화 및 메모리 낭비가 발생하곤 합니다. 또한 커널의 defrag 프로세스가 2MB의 연속적인 페이지를 만들기 위한 과정에서 예기치 못한 응답 지연을 유발하는 경우가 존재했습니다. 그래서 대부분의 DBMS에서는 THP를 기본적으로 비활성화하는 것을 권장하였습니다.
MongoDB 8.0에 포함된 TCMalloc은 백엔드에 Hugepage-Aware PageHeap 기능이 추가되었으며, 기존 방식과 달리 HugePage 크기(2MB) 단위의 청크로 메모리를 관리하고 할당할 수 있도록 설계되었습니다. 이 방식에서는 TCMalloc 자체적으로 작은 객체들을 의도적으로 한곳에 모아 연속적인 2MB 단위의 페이지를 구성하기 때문에, OS 입장에서 defrag와 같은 별도의 작업을 할 필요가 없도록 한 방식으로 이해하면 좋을 것 같습니다.
이와 관련된 신규 모니터링 메트릭도 추가되었으니, 모니터링에 참고하시면 좋을 것 같습니다.
| Metrics (TCMalloc) | Description |
|---|---|
| usingPerCPUCaches | per-cpu cache 활성화 여부(true일 경우 활성화) false라면, Linux Kernel 4.18 이상인지 + glibc rseq가 비활성화 상태인지 확인 필요 |
| generic.peak_memory_usage generic.current_allocated_bytes | current_allocated_bytes가 도달했던 최대 사용량을 샘플링한 값으로, 시스템의 최대 메모리 요구량를 파악하는데 활용 가능 |
| tcmalloc.cpuCache | 각 CPU 코어별 캐시의 상세 데이터를 제공하여, 코어별 부하 불균형 등 진단에 활용 가능 verbosity를 2 이상으로 설정해야 확인 가능 예) db.runCommand({ serverStatus: 1, tcmalloc: 2}).tcmalloc |
12. MongoDB Search & Vector Search의 Community Edition Public Preview
MongoDB 8.0의 신규 기능은 아니지만, 마이너 버전인 MongoDB 8.2부터 도입된 반가운 기능이 있어 함께 소개드리려 합니다. 기존에는 Atlas Search라는 이름으로 클라우드 환경(Atlas)에서만 제공되던 Lucene 기반의 Full-Text Search와 Vector Search 기능(이하 MongoDB Search)이 이제 MongoDB Community Edition에서도 사용 가능해졌습니다. 현재는 Public Preview 단계라 일부 기능에 제한이 있을 수 있지만, 내년에는 정식 릴리스가 예정되어 있으며 Atlas에서 제공하던 Search 기능과 거의 유사한 수준에 도달할 것으로 예상하고 있습니다. 이로써, MongoDB가 지원하는 범위가 확장되어 검색 기능을 포함한 다양한 기능을 MongoDB만으로도 통합할 수 있을 것으로 기대됩니다.
지금까지 많은 서비스들이 검색 기능을 위해 Elasticsearch와 같은 별도 전문 검색 엔진을 도입해왔고, 그 결과 서로 다른 두 시스템을 운영하고 데이터를 동기화하는 데 따른 부담이 적지 않았습니다. 하지만 이제 MongoDB Search 기능을 MongoDB 내에서 통합 제공할 수 있게 되면서, 개발자와 운영자는 시스템 복잡도와 운영 비용을 크게 줄일 수 있을 것으로 보입니다.
MongoDB Search 기능의 핵심은 mongot라는 신규 검색 전용 프로세스입니다. mongot는 기존 mongod와 분리된 독립 프로세스로 동작하며, 내부적으로 Apache Lucene 기반으로 검색 인덱스를 구축합니다. 아직 초기 단계이기에 Elasticsearch 대비 기능적 완성도나 커스터마이징 측면에서 부족한 부분도 있지만, 일반적인 사용 사례에서는 충분히 고려해볼 만한 옵션이라 생각됩니다.
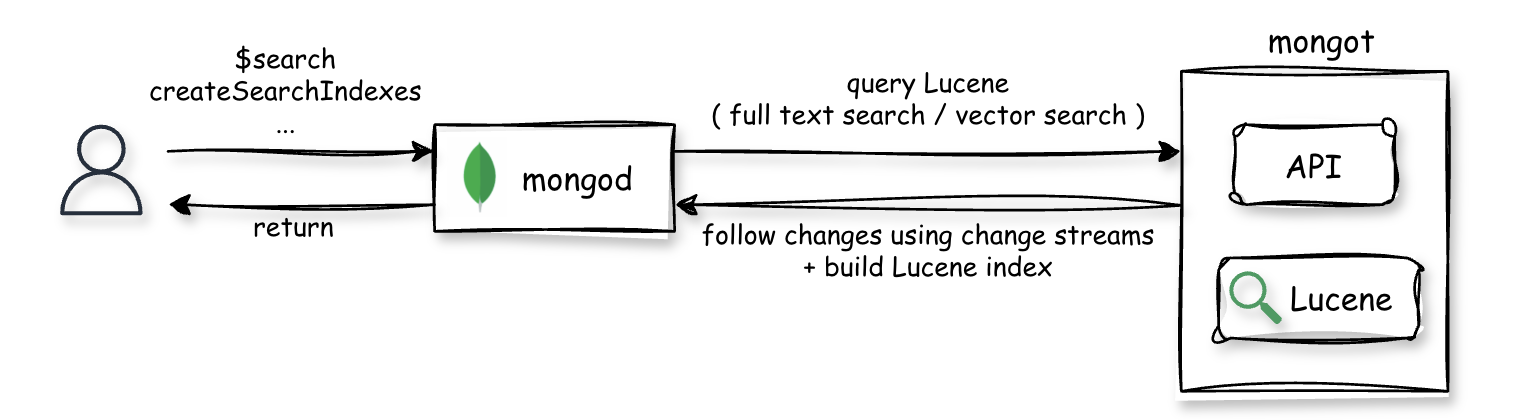
데이터 동기화는 MongoDB의 Change Streams를 통해 이루어집니다. Change streams는 oplog 기반으로 데이터 변경을 실시간 모니터링할 수 있는 기능으로, 도큐먼트 정보부터 작업 유형, 네임스페이스, 변경 시점 등 다양한 메타정보를 담은 이벤트를 생성합니다. 또한 모든 이벤트에는 Resume Token이 포함되어 있어, 장애가 발생하더라도 해당 지점부터 안전하게 동기화를 이어갈 수 있는 기능을 제공합니다.
이 방식으로 mongot는 mongod의 데이터를 동기화하며, createSearchIndexes 명령을 통해 사용자가 정의한 Lucene 인덱스를 빌드합니다. 그리고 사용자가 $search 쿼리를 실행하면, mongod는 mongot에 검색을 요청한 뒤 mongot가 반환한 _id 목록을 기반으로 해당 도큐먼트들을 조회해 최종 결과를 반환합니다.
운영 관점에서 mongot의 구성 방식을 좀 더 살펴보겠습니다. mongot는 syncSource로 레플리카 셋을 지정할 수 있기 때문에, 일부 mongod 노드 장애가 발생해도 정상 노드로부터 지속적으로 데이터를 동기화할 수 있습니다.
# mongot.conf
syncSource:
	replicaSet:
		hostAndPort:  "mongod.search-community:27017"
		username:  mongotUser
		passwordFile:  /mongot-community/pwfile
		authSource:  admin
		tls:  false
		readPreference:  primaryPreferred
...
그렇다면 mongot 자체 장애는 어떻게 대응할까요? 검색 요청은 Stateless하게 처리되므로, GSLB나 DNS 라우팅을 활용하면 여러 mongot 인스턴스를 묶어 부하 분산 및 HA 구성을 손쉽게 적용할 수 있습니다.
# mongot.conf
setParameter:
	searchIndexManagementHostAndPort:  mongot.search-community:27028
	//  DNS  round-robin  or  GSLB  domain
	mongotHost:  mongot.search-community:27028
...
즉, 두 개 이상의 mongot 프로세스를 별도 서버에서 운영하고 동일한 레플리카 셋을 바라보게 하면, mongod 혹은 mongot 일부 장애가 발생하더라도 검색 서비스는 중단 없이 지속할 수 있습니다.
또한 Change Streams 기반으로 동기화를 수행하기 때문에 mongot 프로세스의 재기동되더라도 syncSource의 oplog만 정상적으로 남아 있다면 중단 시간 동안 발생한 변경 사항을 빠르게 따라잡을 수 있습니다. 만약 중단 시간이 길어 oplog 보관 기간을 초과했다면 Initial Sync를 통해 인덱스를 처음부터 재구축하는 방식으로 자동 복구가 진행해야 합니다. 대용량 컬렉션에서 Initial Sync 비용은 적지 않기 때문에 oplog 보관 기간을 여유 있게 설정하는 것이 중요합니다.
정리하자면, mongot의 가장 큰 강점은 전문 검색 기능을 MongoDB 플랫폼 내부에서 통합적으로 제공한다는 점입니다. 이는 기존 서비스 구조와의 연계성, 확장성, 운영 편의성 측면에서 많은 장점을 제공하며, 두 시스템을 병행 운영하며 동기화를 관리하던 기존 모델 대비 큰 리소스 절감을 기대할 수 있습니다.
| 구분 | mongot | 전문 검색 엔진(Elasticsearch 등) |
|---|---|---|
| 운영 부담 | 낮음 - MongoDB 내에서 통합 관리 가능 - 동기화 시스템 등 별도 클러스터 구축 및 운영 부담 없음 | 높음 별도 클러스터 구축, 수동 동기화 등 |
| 쿼리 | Aggregation Pipeline($search) 기존 MongoDB 쿼리 형태로 사용 가능 | 자체 API를 사용하여 처리 |
| Full-Text Search | O (Lucene 기반) | O |
| Vector Search | O | △ |
| 기능 다양성 | △ | O |
MongoDB Search가 검색 기능을 단일 환경에서 통합적으로 제공한다는 점은 큰 장점이지만, 아직은 MongoDB가 모든 영역에서 Elasticsearch 등 전문 검색 엔진을 대체할 수 있는 것은 아니므로, 도입 전 서비스의 검색 요구사항을 충분히 검토하는 과정이 필요합니다.
99. 기타 사항
지금까지 MongoDB 8.0의 주요 변경사항들을 소개드렸는데요. 마지막으로, 검토 과정에서 저희가 발견해서 MongoDB 측에 제보했던 몇 가지 주의사항들을 함께 공유드리며 글을 마무리하려고 합니다. 이들 중에는 제보를 통해 최신 버전에서 이미 수정된 이슈도 있고, 아직 진행 중인 것들도 존재합니다.
Sort Option Issue
updateOne(), replaceOne() 옵션에서도 이제 정렬 옵션을 사용할 수 있습니다. 기존에도 findAndModify()를 통해 사용자가 지정한 정렬 순서로 업데이트할 하나의 도큐먼트를 지정할 수 있었는데, 해당 기능이 확장되었다고 보면 될 것 같습니다.
db.people.updateOne(
   {  state:  "active"  },
   {  $set:  {  state:  "inactive"  }  },
   {  sort:  {  rating:  1  }  }
)
하지만 드라이버가 MongoDB 8.0 호환성을 충족하더라도, 일부 드라이버에서는 sort 옵션이 무시되는 버그가 있어 사용 전에 주의가 필요합니다. 예를 들어 Node.js 드라이버 6.16.0 버전은 MongoDB 8.0 호환성을 충족하지만, 해당 버전에는 정렬 옵션이 구현되어 있지 않아 예상과 다른 결과가 반환될 수 있습니다. 이로 인해 같은 드라이버를 사용하는 mongosh 2.5.6(2025년 7월) 역시 MongoDB 8.0 호환성을 충족함에도 sort 옵션이 반영되지 않는 문제가 존재했습니다. 이 문제는 Node.js 드라이버 6.17.0에서 정렬 기능이 추가되면서 해결되었고, 이후 mongosh 2.5.7에서 해당 수정 사항이 반영되어 정상 동작하게 되었습니다.
따라서, updateOne() 또는 replaceOne()에서 정렬 옵션 사용 시 예상과 다른 도큐먼트가 갱신된다면 사용하시는 드라이버를 최신 버전으로 업그레이드하는 것을 권장드립니다.
Inconsistent Behavior of _id Filter in Sharded Collection
MongoDB 8.0에서 샤드키로 _id 필드를 사용하지 않는 컬렉션에서 _id를 필터 조건으로 사용할 경우 일관되지 않은 동작을 할 수 있습니다.
해당 동작을 이해하려면 먼저 MongoDB에서 _id 필드가 어떤 역할을 하는지 짚고 넘어갈 필요가 있습니다. _id 필드는 MongoDB에서 PK로 사용되어 각 샤드에서는 고유성이 자동으로 보장되지만, _id 필드를 샤드키로 사용하지 않는다면 클러스터 전체에서의 고유성을 보장하지는 않습니다. 그럼에도, MongoDB는 애플리케이션에서 _id 값에 대한 각 샤드 간의 고유성을 보장할 것으로 가정하고 내부 동작을 설계한 경우가 많습니다. 실제로 드라이버에서 자동으로 생성하는 ObjectId를 사용할 경우 고유성을 보장한다고 보셔도 무방합니다.
MongoDB unique-indexes : “In cases where the _id field is not the shard key, MongoDB expects applications to ensure the uniqueness of _id values across the shards”
또한 앞서 8번 항목에서 소개한 ‘샤드키 필터 완화’ 동작에서도 _id 필드를 필터 조건으로 사용하는 것만으로도 Two-Phase Protocol이 적용되지 않는 것도 동일한 이유입니다.
하지만, Schema-less인 MongoDB의 특성상 _id 필드를 커스텀 값으로 사용하는 것은 자연스러운 일입니다. 즉, 의도적이든 작업 실수이든 각 샤드 간 중복된 _id 값이 저장될 가능성은 시스템 설계상 허용되므로 이에 대한 안정성을 보장해주어야 한다고 생각합니다. 그럼에도 불구하고, 아래 예시와 같이 클러스터 전역에서 _id가 고유할 것이라 가정하는 일부 동작으로 인해 일관되지 않은 동작을 하는 경우가 존재합니다.
예시) _id가 아닌 필드를 샤드키로 지정한 컬렉션에서 서로 다른 샤드에 동일한 _id 값을 가진 도큐먼트가 존재하는 경우
#shard key : {"a": "hashed"}
use  testdb
db.testCol.insertOne({"_id":10,  "a":1,  "status":"active"}) # shard01
db.testCol.insertOne({"_id":10,  "a":11,  "status":"active"}) # shard02
updateOne()은 필터를 기준으로 컬렉션 내 단일 도큐먼트를 갱신하는 작업이므로, 위 상황에서 {_id: 10} 조건으로 updateOne()을 수행하면 하나의 도큐먼트가 갱신될 것을 기대합니다. 하지만, _id 필드 조건의 업데이트는 Two-Phase Protocol이 적용되지 않고 브로드캐스트로 처리되기 때문에 각 샤드에 있는 도큐먼트를 모두 갱신합니다.
>  db.testCol.updateOne({"_id":10},{"$set":{"status":"inactive"}})
{
   acknowledged:  true,
   insertedId:  null,
   matchedCount:  1,
   modifiedCount:  1,
   upsertedCount:  0
}

#active -> inactive
>  db.testCol.find()
[
   {  _id:  10,  a:  11,  status:  'inactive'  }, # shard02
   {  _id:  10,  a:  1,  status:  'inactive'  } # shard01
]
아쉬운 점은 실제 2개의 도큐먼트가 모두 갱신되었음에도, 반환되는 matchedCount와 modifiedCount는 1로 표시된다는 것인데요, 이전 버전까지도 동일한 형태로 수행되긴 했지만 갱신 건수 반환은 정상적으로 이루어졌습니다. 이러한 상태 값 불일치의 경우 단순 버그이기에 최신 버전에서 바로 패치될 예정입니다. 다만, _id를 고유하게 판단하는 기조는 많은 부분과 얽혀있기 때문에 구체적인 해결책이 나오기까지는 시간이 걸릴 것으로 예상됩니다. deleteOne / replaceOne() 명령에서도 이슈가 존재하나, 원인과 대응 방법이 동일하기 때문에 이번 문서에서는 위 사례로 갈음하겠습니다.
정리하자면, MongoDB는 애플리케이션에서 각 샤드 간 _id 값의 고유성을 보장할 것을 기대하고 동작을 하기 때문에 _id를 커스텀 값으로 사용할 경우 예기치 않은 동작이 발생할 가능성이 존재합니다. 그러므로 샤드 클러스터 환경에서 샤딩된 컬렉션을 사용하는 경우, 드라이버에서 자동으로 생성하는 ObjectId를 사용하는 것이 안정성 측면에서 권장되며, 필요하다면 _id 필드를 샤드키로 지정하여 각 샤드 간의 고유성을 보장하는게 좋습니다.
추가로, MongoDB 8.0에서는 많은 변경사항이 있는 만큼 공식 문서 수정이 필요한 부분도 많았는데요. 검토 중 확인된 부분은 모두 수정 요청드리긴 했지만, 변경된 동작 방식 / 파라미터 등이 아직 반영되지 않았거나 놓친 부분이 많을 것이라 생각합니다. 물론, 사소한 부분이 대부분이었고 서비스 운영에 문제가 될 요소들은 없었습니다. 독자분들도 사용 중에 수정이 필요한 부분이 발견되신다면 적극적으로 MongoDB 커뮤니티 혹은 서포트 채널을 통해 제보해주시면 좋을 것 같습니다.
마무리하며
이번 글에서는 MongoDB 8.0의 지원 기간이 길어진 만큼, 앞으로 오랜 기간 사용될 것으로 예상되어 주요 개선 사항을 조금 더 자세히 살펴보았습니다. MongoDB 3.x 버전부터 지켜 본 바로는 업그레이드마다 사용자의 요구사항을 충족시키기 위해 노력하는 모습이 보이며, MongoDB 8.0 역시 그런 변화들이 잘 담긴 버전이라고 생각합니다. 저희 팀에서는 성능 향상을 체감할 수 있고 운영 편의성 또한 증진되었다 판단하여 좋게 평가하고 있습니다.
물론 제품 사용에 있어 항상 최신 버전을 쓰는 것이 정답은 아닐 수 있습니다. 팀의 상황과 서비스 특성에 따라 적절한 업그레이드 시점을 선택하는 것이 더 중요하다고 생각합니다. 그래서 업그레이드를 고민 중이시라면 이번 글의 내용이 MongoDB 8.0 도입 여부를 판단하는 데 도움이 되었으면 합니다. 또한, MongoDB 8.0은 이미 출시된 지 1년 이상 지난 버전이기에, 이미 해당 버전을 사용 중이신 분들께는 이번 글이 변경 사항과 주의 포인트를 점검하는 참고 자료로서 도움이 되기를 바랍니다.
긴 글 읽어주셔서 감사합니다.