Engineering
CVPR 2025 참관기: 고품질 인물 생성을 위한 HG-DPO 연구 소개
orca.ai카카오
2025년 7월 3일
원문에서 보기 ↗안녕하세요. 카카오에서 AI를 연구개발하는 카나나(Kanana) - Visual Content Generative AI팀의 Orca입니다. 저희 팀에서는 고품질의 이미지와 동영상 등 시각 콘텐츠를 생성하는 비주얼 생성 모델을 연구하고 있습니다. 지난 if(kakaoAI) 2024에서 나만의 프로필 이미지 생성 모델 개발기 발표를 통해서도 저희 팀의 연구 성과를 공유드린 바 있는데요.
이번에는 저희 연구가 ‘CVPR(Computer Vision Pattern Recognition) 2025’에 하이라이트 논문(Highlight paper)으로 선정되어, 지난 6월 11일부터 15일까지 미국 테네시주 내슈빌에서 열린 ‘CVPR(Computer Vision Pattern Recognition) 2025’ 학회에 직접 다녀올 수 있었습니다. CVPR은 컴퓨터 비전 분야에서 세계 최고 권위를 지닌 국제 학술대회로, 매년 전 세계의 최신 연구 성과와 기술 트렌드가 공유되는 자리입니다.
이번 글에서는 현장에서 확인한 생성 모델의 연구 동향과 저희가 발표한 인물 이미지 생성 기술 관련 “Boost Your Human Image Generation Model via Direct Preference Optimization” 논문에 대해서도 간략히 소개해 드리고자 합니다.
최신 생성 연구 동향: Diffusion model
생성 모델은 현재 가장 활발히 연구되고 있는 분야 중 하나로, 이번 CVPR에서도 굉장히 많은 생성 모델 연구를 확인할 수 있었습니다. 우선 Diffusion model을 이용한 이미지 생성 모델 연구가 가장 활발한 분야 중 하나였습니다. 이러한 Diffusion model 기반의 이미지 생성 모델을 이용한 Personalized text-to-image와 같은 응용 연구도 활발히 이루어지고 있었고, 이미지 생성을 넘어서 Diffusion model을 이용한 비디오 생성 모델 연구도 굉장히 활발하게 이루어지고 있었습니다.
*Diffusion model(확산 모델): 최근 인공지능 분야에서 주목받는 생성형 모델 중 하나로, 이미지나 오디오처럼 복잡한 데이터를 생성하는 데 뛰어난 성능을 보입니다. 물리학에서의 ‘확산(Diffusion)’ 과정을 모사하여, 노이즈가 추가된 데이터에서 점차 원래의 데이터를 복원하는 방식으로 학습하고 생성합니다.
실사에 가까운 고품질 이미지 생성하기
이어 저희 발표 논문 “Boost Your Human Image Generation Model via Direct Preference Optimization”을 소개해보겠습니다. 저희 논문은 앞서 소개한 Diffusion model을 기반으로 한 인물 이미지 생성 관련 연구입니다. 전체 발표 논문 중 13.5%에 해당되는 하이트라이트 논문(Highlight paper)에 선정되며 그 기술력을 인정받았습니다.
연구 목표
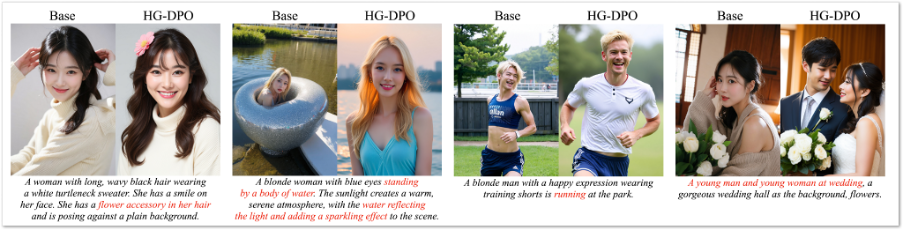
저희가 진행한 연구는 고품질 인물 이미지를 생성하는 것을 목표로 합니다. 인물 이미지 생성은 인체 구조나 포즈가 조금만 어색해도 품질이 저하되기 때문에 난이도가 어려운 과제입니다. 아래 이미지에서도 볼 수 있듯이, 고품질 인물 이미지 데이터셋으로 Fine-tuning된 Base model마저도 만족스러운 품질의 인물 이미지를 생성하지 못하는 문제가 있었습니다. 저희가 제안하는 HG-DPO 방식을 이용하면, Base model을 개선시켜 효과적으로 고품질 인물 이미지를 생성할 수 있습니다.
저희는 이를 위해 기존 LLM Alignment 분야에서 사용되던 Direct Preference Optimization(DPO) 기법을 Diffusion 기반 이미지 생성 모델에 접목했습니다. DPO는 하나의 Input에 대해 인물이 더 선호하는(Winning) 결과와 덜 선호하는(Losing) 결과 쌍을 학습 데이터로 모델에 제공해, 사람들이 더 선호하는 결과를 생성하도록 모델을 학습시키는 방법입니다. HG-DPO의 목적은 DPO를 이용하여 Base model을 한 번 더 Fine-tuning 시킴으로써 인물 이미지 생성 성능을 극대화시키는 것입니다. 이를 통해 실사에 가까운 고품질의 자연스러운 이미지를 생성할 수 있습니다.
*LLM Alignment(대형 언어 모델 정렬): LLM의 출력이 인간의 의도, 가치, 윤리 기준에 부합하도록 만드는 과정 또는 연구 분야를 의미합니다. 모델이 사용자의 질문에 유용하고, 사실에 기반하며, 안전한 방식으로 응답하도록 조정하는 것이 목적으로, 주로 RLHF(Reinforcement Learning from Human Feedback), DPO(Direct Preference Optimization), Constitutional AI, AI Constitutional Guidance 등의 기술이 사용됩니다.
*DPO(Direct Preference Optimization): LLM의 응답 품질을 향상시키기 위해 인간의 피드백을 직접 반영하여 모델을 미세 조정하는 학습 방법입니다. RLHF(Reinforcement Learning from Human Feedback)의 복잡한 보상 모델과 강화학습 단계를 제거하고 단순한 선호(Pairwise preference) 데이터를 활용해 더 효율적으로 학습하는 방식입니다.
기존 방식들의 한계와 HG-DPO의 전략
DPO는 최근 LLM Alignment를 넘어 이미지 생성 분야로도 확장되어 Diffusion-DPO와 같은 방법들이 등장했습니다. 하지만, 인물 이미지는 굉장히 높은 사실성을 필요로 하기 때문에, 이러한 기존 방법들을 그대로 적용하기에는 한계가 존재합니다. 그것은 기존의 방법들이 생성 이미지들만을 이용하여 Winning과 Losing 이미지 쌍을 구성하여 학습하기 때문에 학습 가능한 이미지 품질의 상한선이 낮다는 것입니다. 생성된 이미지는 그 품질이 아무리 좋더라도, 실사의 품질에는 미치기 어려운데요. 그 결과, 인물의 디테일이나 모델이 학습할 수 있는 표현력에 한계가 생기게 됩니다.
전략 1: 학습 데이터에 실사 도입
이러한 한계를 뛰어넘기 위해, HG-DPO는 첫 번째 전략으로 기존 DPO 방식들과 다르게 실사를 Winning 이미지로, 생성 이미지를 Losing 이미지로 삼는 새로운 DPO 학습 방식을 사용 합니다. 이를 통해 모델이 단순히 생성 이미지 중 상대적으로 나은 수준의 품질을 추구하는 것을 넘어, 실사 수준의 품질을 추구하도록 유도할 수 있습니다.
전략 2: 안정적인 학습을 위한 Curriculum learning 기반의 3단계 학습 방식 도입
하지만, 위의 전략을 기반으로 한 단순 Single stage 학습은 좋은 결과로 이어지지 못했습니다. 이러한 문제에 대해 저희는 저희의 전략을 Single stage로 수행하는 것이 너무 어렵다고 가정하고, 두 번째 전략으로 여러 Stage로 이루어진 Curriculum learning 방식을 도입했습니다.
Curriculum learning은 모델을 쉬운 방법으로 먼저 학습시키고, 점진적으로 어려운 방법으로 학습시키는 방식으로 모델을 더욱 안정적으로 학습시킬 수 있습니다. HG-DPO의 Curriculum learning은 아래 이미지와 같이 Easy, Normal, 그리고 Hard stages를 통해 수행됩니다. 각 Stage마다 학습 난이도를 점차 높이며, 모델은 실사와 비슷한 이미지를 생성할 수 있도록 학습됩니다.
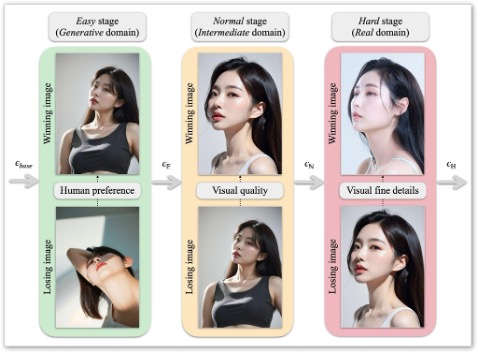
Easy stage
Easy stage에서는 실사의 품질을 추구하기 전에, 기본적으로 사람들에게 선호되는 이미지를 생성하는 방법을 학습합니다. 이 Stage에서는 실사를 사용하지 않고, 생성된 이미지만을 사용합니다. 이 때, 효과적인 학습을 위해 Winning 이미지는 Losing 이미지에 비해 선호도에 있어서 확실한 우위를 가져야 합니다. 이를 위해, 하나의 프롬프트에 대해 Winning과 Losing 이미지 각각을 위해 정확히 두 개의 이미지만을 생성하는 것이 아니라, N개의 이미지를 생성합니다. 그리고, 이 N개의 이미지들에 대해 Human preference estimator인 PickScore를 이용하여 Score를 측정하고, Score가 가장 높은 이미지를 Winning 이미지, 그리고 가장 낮은 이미지를 Losing 이미지로 선택합니다. 이러한 방식을 통해 만들어진 Winning과 Losing 이미지 사이의 확연한 선호도 차이를 통해, 모델은 더욱 선호되는 이미지를 생성하는 법을 학습합니다.
*PickScore: Text-to-image 생성 모델이 생성한 여러 이미지 중 어떤 이미지가 사람에게 더 선호될지를 예측하기 위해 설계된 Human Preference Estimator(사람의 선택을 예측하는 모델)로, 이미지의 품질을 점수화해 사람의 평가 없이도 선호도를 추정할 수 있도록 학습된 평가 모델입니다.
Normal stage
Normal stage에서는 Easy stage에서 학습된 모델을 더욱 개선시켜, 단순히 선호되는 이미지가 아닌 더욱 실사에 가까운 구도와 포즈를 갖는 이미지를 생성하는 방법을 학습 합니다. 이를 위해서 Winning 이미지는 Losing 이미지와 다르게 실사의 구도와 포즈를 갖는 이미지여야 합니다. 동시에, 구도와 포즈를 집중적으로 학습하기 위해, 디테일은 사라진 이미지여야 합니다. 저희는 이것을 Intermediate image(중간 이미지)라는 개념을 도입하여 가능하게 합니다. Intermediate image는 실사에 Noise를 더하고, 그것을 다시 Reconstruction하는 방식으로 만들어집니다. 이렇게 만들어진 Intermediate image는 실사의 구도와 포즈를 유지하지만, 디테일은 잃어버린 실사와 생성 이미지의 중간(Intermediate) 이미지가 되고, 이것을 Normal stage의 Winning 이미지로 사용합니다. 반면, Losing 이미지는 Easy stage에서 Winning 이미지로 사용되었던 이미지를 사용합니다. 이러한 방식을 통해 만들어진 Winning 이미지는 Losing 이미지와 디테일 측면에서는 차이가 없지만, 구도와 포즈에 있어서 실사와 유사하다는 명확한 차이를 갖게 됩니다. 이 차이를 통해 모델은 구도와 포즈 측면에 있어서 더욱 실사에 가까운 이미지를 생성하는 법을 학습합니다.
Hard stage
마지막으로, Hard stage에서는 Normal stage에서 학습된 모델을 더욱 개선시켜, 구도와 포즈를 넘어 디테일까지 실사에 가까운 이미지를 생성하는 법을 학습합니다. 이를 위해, 실사를 Winning 이미지로 사용하고 Normal stage 의 Winning 이미지를 이번에는 Losing 이미지로 사용합니다. 이러한 방식을 통해, Winning 이미지는 Losing 이미지와 구도와 포즈의 측면에 있어서는 차이가 없지만, 디테일의 측면에 있어서 명확한 차이를 갖게 됩니다. 이 차이를 통해 모델은 디테일까지 실사에 가까운 이미지를 생성하는 법을 학습합니다.
평가
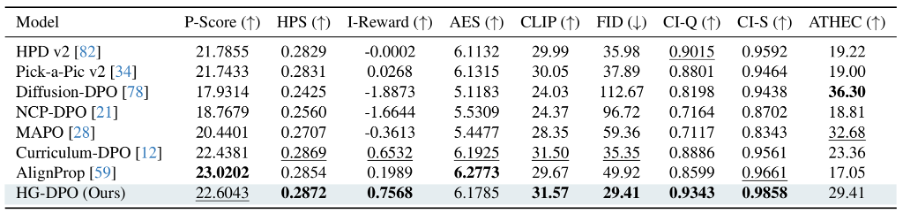
저희는 HG-DPO가 다른 방식들 대비 갖는 뛰어난 효과를 정량적, 정성적인 방법들을 통해 입증했습니다. 아래 표를 보면 HG-DPO는 대부분의 지표에서 1위 혹은 2위를 차지하고 있습니다.
참고로 벤치마크에 대한 설명을 드리면, P-Score, HPS, I-Reward, AES는 생성된 이미지에 대한 선호도 점수이며, CLIP은 생성된 이미지가 입력으로 주어진 프롬프트를 얼마나 충실히 따르고 있는지를 나타내는 점수입니다. FID와 CI-Q는 이미지의 품질에 대한 지표이고, CI-S와 ATHEC은 이미지의 Sharpness에 대한 지표입니다. 표에서, 볼드체와 밑줄은 각 지표에서 1위와 2위에 해당하는 점수에 해당합니다.
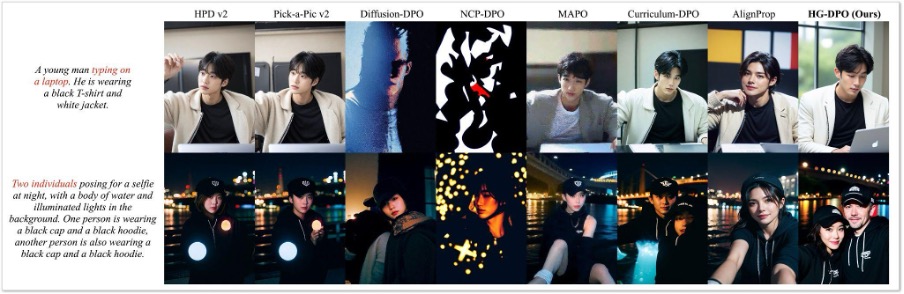
정량적인 수치 뿐만 아니라, 아래 정성 결과에서도 타사 모델 대비 보다 자연스러운 이미지를 생성할 수 있음을 확인하였습니다.
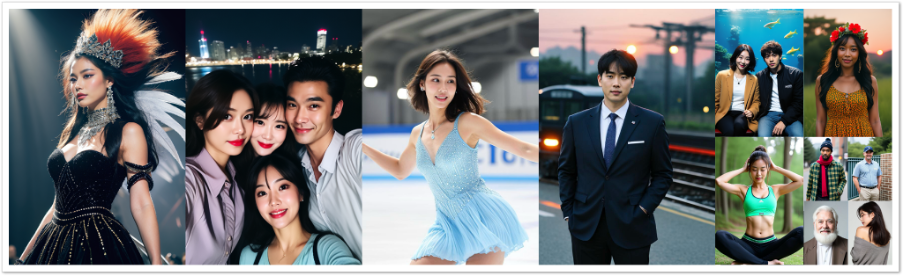
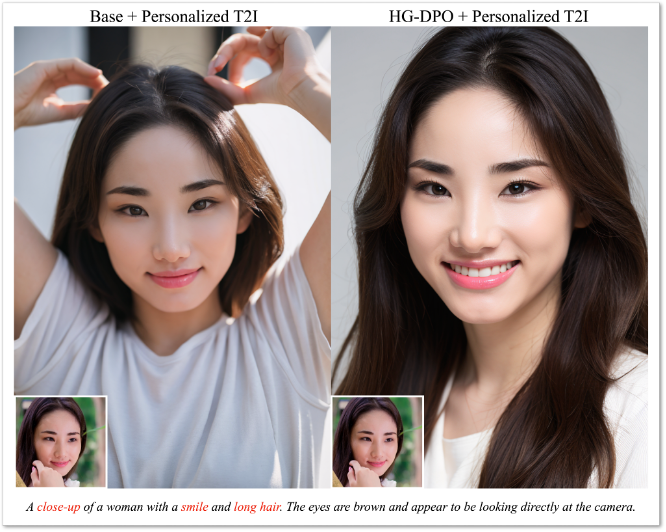
또한, 저희는 HG-DPO가 Personalized text-to-image 생성 모델에도 효과적으로 적용될 수 있음을 입증 했습니다. Personalized text-to-image 생성이란, 텍스트 프롬프트 이외에 사용자가 반영하고 싶은 이미지를 추가적인 입력으로 이용하여, 그 이미지를 반영한 이미지를 생성하는 방식을 의미합니다. 예를 들어, 사용자는 본인의 얼굴 이미지를 사용하여 본인의 얼굴이 들어간 고품질의 이미지를 생성할 수 있습니다. 아래 이미지에서 볼 수 있듯이, Personalized text-to-image 생성모델에 HG-DPO를 적용함으로써, 고품질의 프로필 사진을 만들 수 있습니다.
끝으로
이번 CVPR 2025 참관과 논문 발표를 통해, 카카오가 AI 연구에 몰입할 수 있는 환경을 잘 갖추고 있다는 점을 다시 한 번 느꼈습니다. 탄탄한 학습 인프라와 유연한 실험 문화, 그리고 팀 간의 긴밀한 협업 체계 덕분에 의미 있는 연구 성과를 지속적으로 만들어낼 수 있었습니다.
하지만 저희의 목표는 논문 발표에 그치지 않습니다. 이번 HG-DPO 연구 역시 단순한 기술 검증을 넘어, 실제 사용자에게 가치를 주는 서비스로의 연결을 염두에 두고 출발했습니다. 고품질 인물 이미지 생성 기술은 연구 개발적인 도전을 넘어 실제 서비스 분야에서도 큰 수요가 있는 영역입니다. 앞으로 지속적인 기술 고도화를 통해 사용자의 특성을 보다 정교하게 반영한 이미지 생성 기술을 선보일 계획입니다. 이번 연구 결과 또한, 카카오의 자체 개발 이미지 생성 모델인 ‘콜라주 바이 카나나(Kollage by Kanana)’의 고도화에 적용되고 있습니다.
생성 모델이 실제 서비스로 빠르게 확산되는 지금, 연구 성과를 더 많은 사용자 경험으로 연결하며, 저희 팀은 앞으로도 기술과 사용자의 접점을 넓혀갈 수 있는 연구를 이어가겠습니다. 감사합니다.
참고문헌
- Jonathan Ho, Ajay Jain, and Pieter Abbeel. Denoising diffusion probabilistic models. Advances in neural information processing systems, 33:6840–6851, 2020.
- Jing Shi, Wei Xiong, Zhe Lin, and Hyun Joon Jung. Instantbooth: Personalized text-to-image generation without test time finetuning. arXiv preprint arXiv:2304.03411, 2023.
- Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn. Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36, 2024.
- Bram Wallace, Meihua Dang, Rafael Rafailov, Linqi Zhou, Aaron Lou, Senthil Purushwalkam, Stefano Ermon, Caiming Xiong, Shafiq Joty, and Nikhil Naik. Diffusion model alignment using direct preference optimization. arXiv preprint arXiv:2311.12908, 2023.
- Yoshua Bengio, Jerome Louradour, Ronan Collobert, and Jason Weston. Curriculum learning. In Proceedings of the 26th annual international conference on machine learning, pages 41–48, 2009.
- Yuval Kirstain, Adam Polyak, Uriel Singer, Shahbuland Matiana, Joe Penna, and Omer Levy. Pick-a-pic: An open dataset of user preferences for text-to-image generation. Advances in Neural Information Processing Systems, 36, 2024.
- Xiaoshi Wu, Yiming Hao, Keqiang Sun, Yixiong Chen, Feng Zhu, Rui Zhao, and Hongsheng Li. Human preference score 27 v2: A solid benchmark for evaluating human preferences of text-to-image synthesis. arXiv preprint arXiv:2306.09341, 2023.
- Jiazheng Xu, Xiao Liu, Yuchen Wu, Yuxuan Tong, Qinkai Li, Ming Ding, Jie Tang, and Yuxiao Dong. Imagereward: Learning and evaluating human preferences for text-to-image generation. Advances in Neural Information Processing Systems, 36, 2024.
- Christoph Schuhmann. Laion-aesthetics. https:// laion.ai/blog/laion-aesthetics/, 2022.
- Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, et al. Learning transferable visual models from natural language supervision. In International conference on machine learning, pages 8748–8763. PMLR, 2021.
- Martin Heusel, Hubert Ramsauer, Thomas Unterthiner, Bernhard Nessler, and Sepp Hochreiter. Gans trained by a two time-scale update rule converge to a local nash equilibrium. Advances in neural information processing systems, 30, 2017.
- Jianyi Wang, Kelvin CK Chan, and Chen Change Loy. Exploring clip for assessing the look and feel of images. In AAAI, 2023.
- Yilang Peng. Athec: A python library for computational aesthetic analysis of visual media in social science research. Computational Communication Research, Forthcoming.