Engineering
이상 탐지 2부-통계적 기법으로 이상 탐지하기
2023년 5월 22일
원문에서 보기 ↗
들어가며
안녕하세요. NHN Cloud의 클라우드AI팀 박현목입니다.
총 4부로 구성한 본 시리즈의 1부-정상과 비정상, 그리고 이상 탐지에서는 이상(anomaly)이란 무엇이며, 이상 탐지가 무엇인지를 간략하게 소개해 드렸습니다.
1부-정상과 비정상, 그리고 이상 탐지 2부-통계적 기법으로 이상 탐지하기 3부-머신 러닝으로 이상 탐지하기 4부-딥 러닝으로 이상 탐지하기
이번 글은 통계적 기법으로 이상을 탐지하는 방법에 대한 이야기입니다.
이상 탐지에는 다양한 기법들이 존재합니다. 하지만 모든 기법을 전부 다룰 수는 없으므로 현재까지도 많은 분야에서 응용되고 있는 2가지 분류(statistical, machine learning)를 소개하고자 합니다. 그 중에서도 통계적 기법(statistical)에 대해 이야기해 보겠습니다. 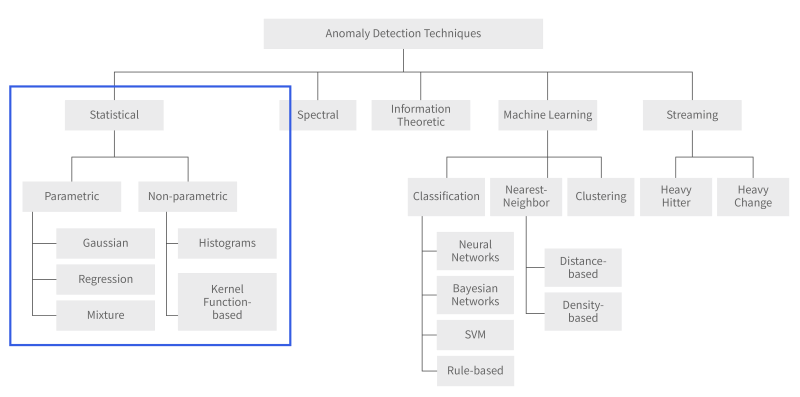
1. 이상 탐지 기법
지난 글에서 이상 탐지란 특이한 값, 보기 드문 사건 을 찾아내는 일이라고 정의했습니다. '보기 드물다'라는 것이 저에게는 참 쉬우면서도 어려운 개념이었습니다. 사람은 기억과 감정을 가지고 있어서 특이하고 처음 보는 일을 자연스럽게 인지하고 놀라기도, 당황하기도 합니다. 하지만 이런 현상에 수학적, 기계적으로는 어떻게 접근해야 할까요? 이때 적용된 것이 바로 확률입니다.
2. Statistical method
2.1 Parametric
가우시안 분포, 정규 분포라는 단어를 한 번쯤은 들어보셨을 것 같습니다. 독일의 수학자 카를 프리드리히 가우스^Carl Friedrich Gauss^가 만들어냈기 때문에 그의 이름을 따 '가우시안 분포'라고 부르는데요, 이것은 통계에서 절대 빠질 수 없는 매우 유명한 확률 분포입니다. 가우시안 분포는 아래 그림처럼 중심(m)에 확률(높이)이 집중되어 있고, 중심에서 멀어질수록 서서히 확률이 줄어드는 모양을 하고 있습니다. 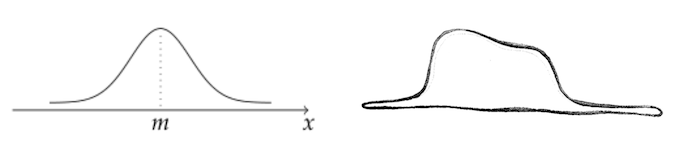 마치 어린 왕자의 그림처럼 생긴 저 곡선이 '세상을 설명하는 분포'로 불리고 있으며, 이상 탐지에서도 이 가우시안 분포를 사용합니다.
- Gaussian density estimation: 관측 데이터를 바탕으로 데이터의 실제 분포를 하나의 가우시안 분포에 근사하여 확률적으로 분석하는 방법입니다.
- Mixture of gaussian density estimation: 하나가 아니라 다수의 가우시안 분포를 사용하는 gaussian density estimation입니다.
간단한 예시와 함께 위의 2가지 기법에 대해 더 자세히 알아보겠습니다.
오늘도 열심히 하루 일과를 마친 아기 고양이가 집으로 돌아가기 위해 길을 나섭니다. 그런데 갑자기 앞이 보이지 않는 이상한 길이 나타납니다. 시간이 지나니 조금씩 안이 보이기 시작했지만 그 길에는 잔뜩 화가 난 강아지가 있었습니다. 아기 고양이는 강아지를 피해 가고 싶었지만, 아직도 보이지 않는 길에 강아지가 얼마나 있을지는 알 수 없었습니다. 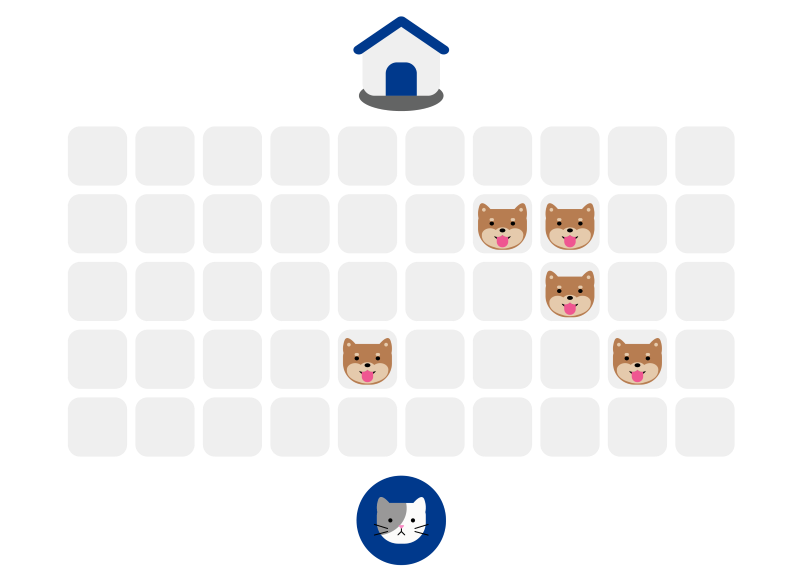
평소 수학을 좋아하던 아기 고양이는 한 가지 아이디어가 떠올랐습니다.
'지금 보이는 강아지들로 분포를 예측해 보자!'
아기 고양이는 강아지들의 위치가 가우시안 분포를 따를 것이라고 가정하고 집까지 안전하게 갈 수 있는 길을 그려 봤습니다. 그 결과 안전한 길을 찾아낸 아기 고양이는 무사히 퇴근하여 시원한 우유 한잔을 마시며 퇴근 라이프를 즐깁니다. 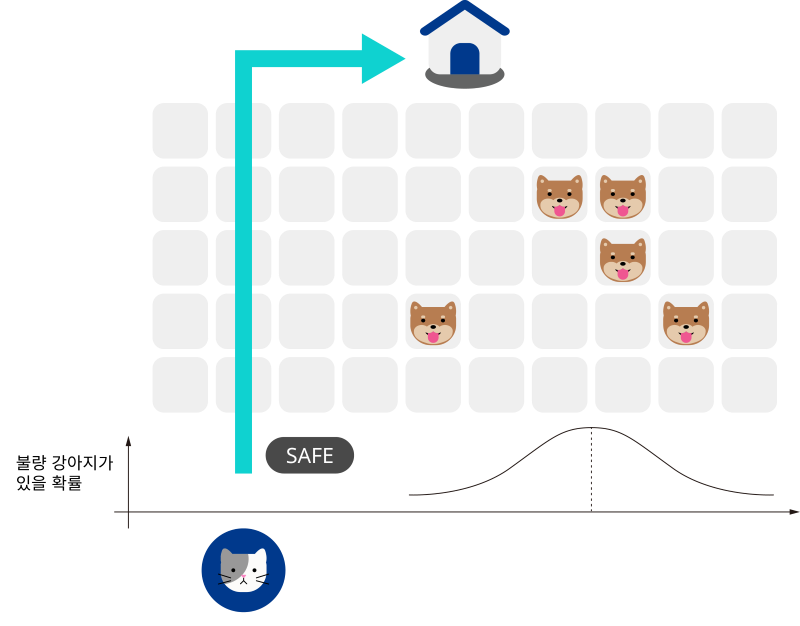
다음날도 열심히 일한 아기 고양이는 집으로 돌아가기 위해 길을 나섭니다. 그런데 이번에는 어제보다 조금 더 길이 넓어졌습니다..! 아기 고양이는 조금 당황했지만, 이번에도 가우시안 분포와 함께라면 두려울 게 없다는 마음으로 길을 찾아냅니다. 끝에 있는 강아지가 조금 신경 쓰였지만 그래도 고양이는 길을 나아갑니다. 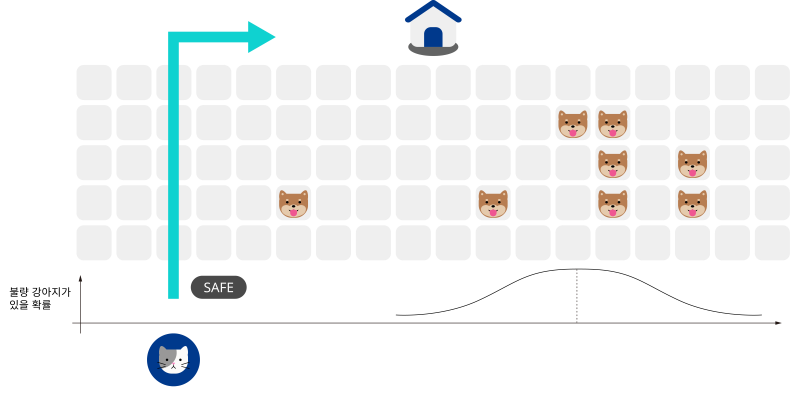 하지만 이번엔 아기 고양이가 틀렸습니다! 안전한 줄 알았던 길에 알고 보니 강아지가 더 있었습니다!
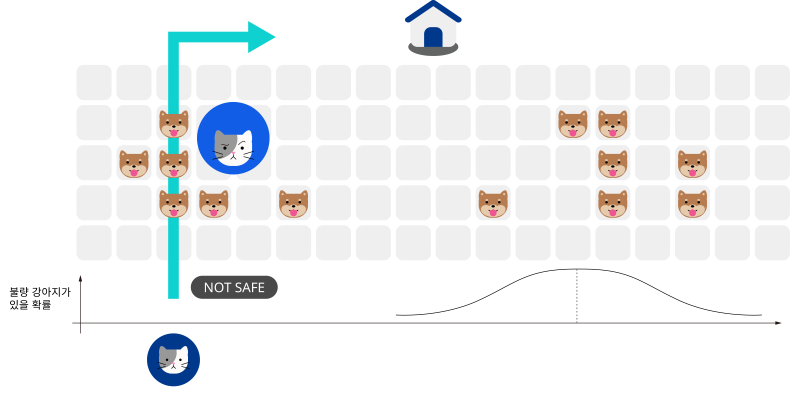 아기 고양이는 생각에 잠깁니다.
'아... 저런 분포는 하나의 가우시안 분포로 나타낼 수가 없는데...? 그럼 하나 더 써 볼까?'
그렇게 가우시안 분포를 하나 더 추가해서 찾아낸 길을 통해 오늘도 아기 고양이는 안전하게 집으로 돌아갑니다. 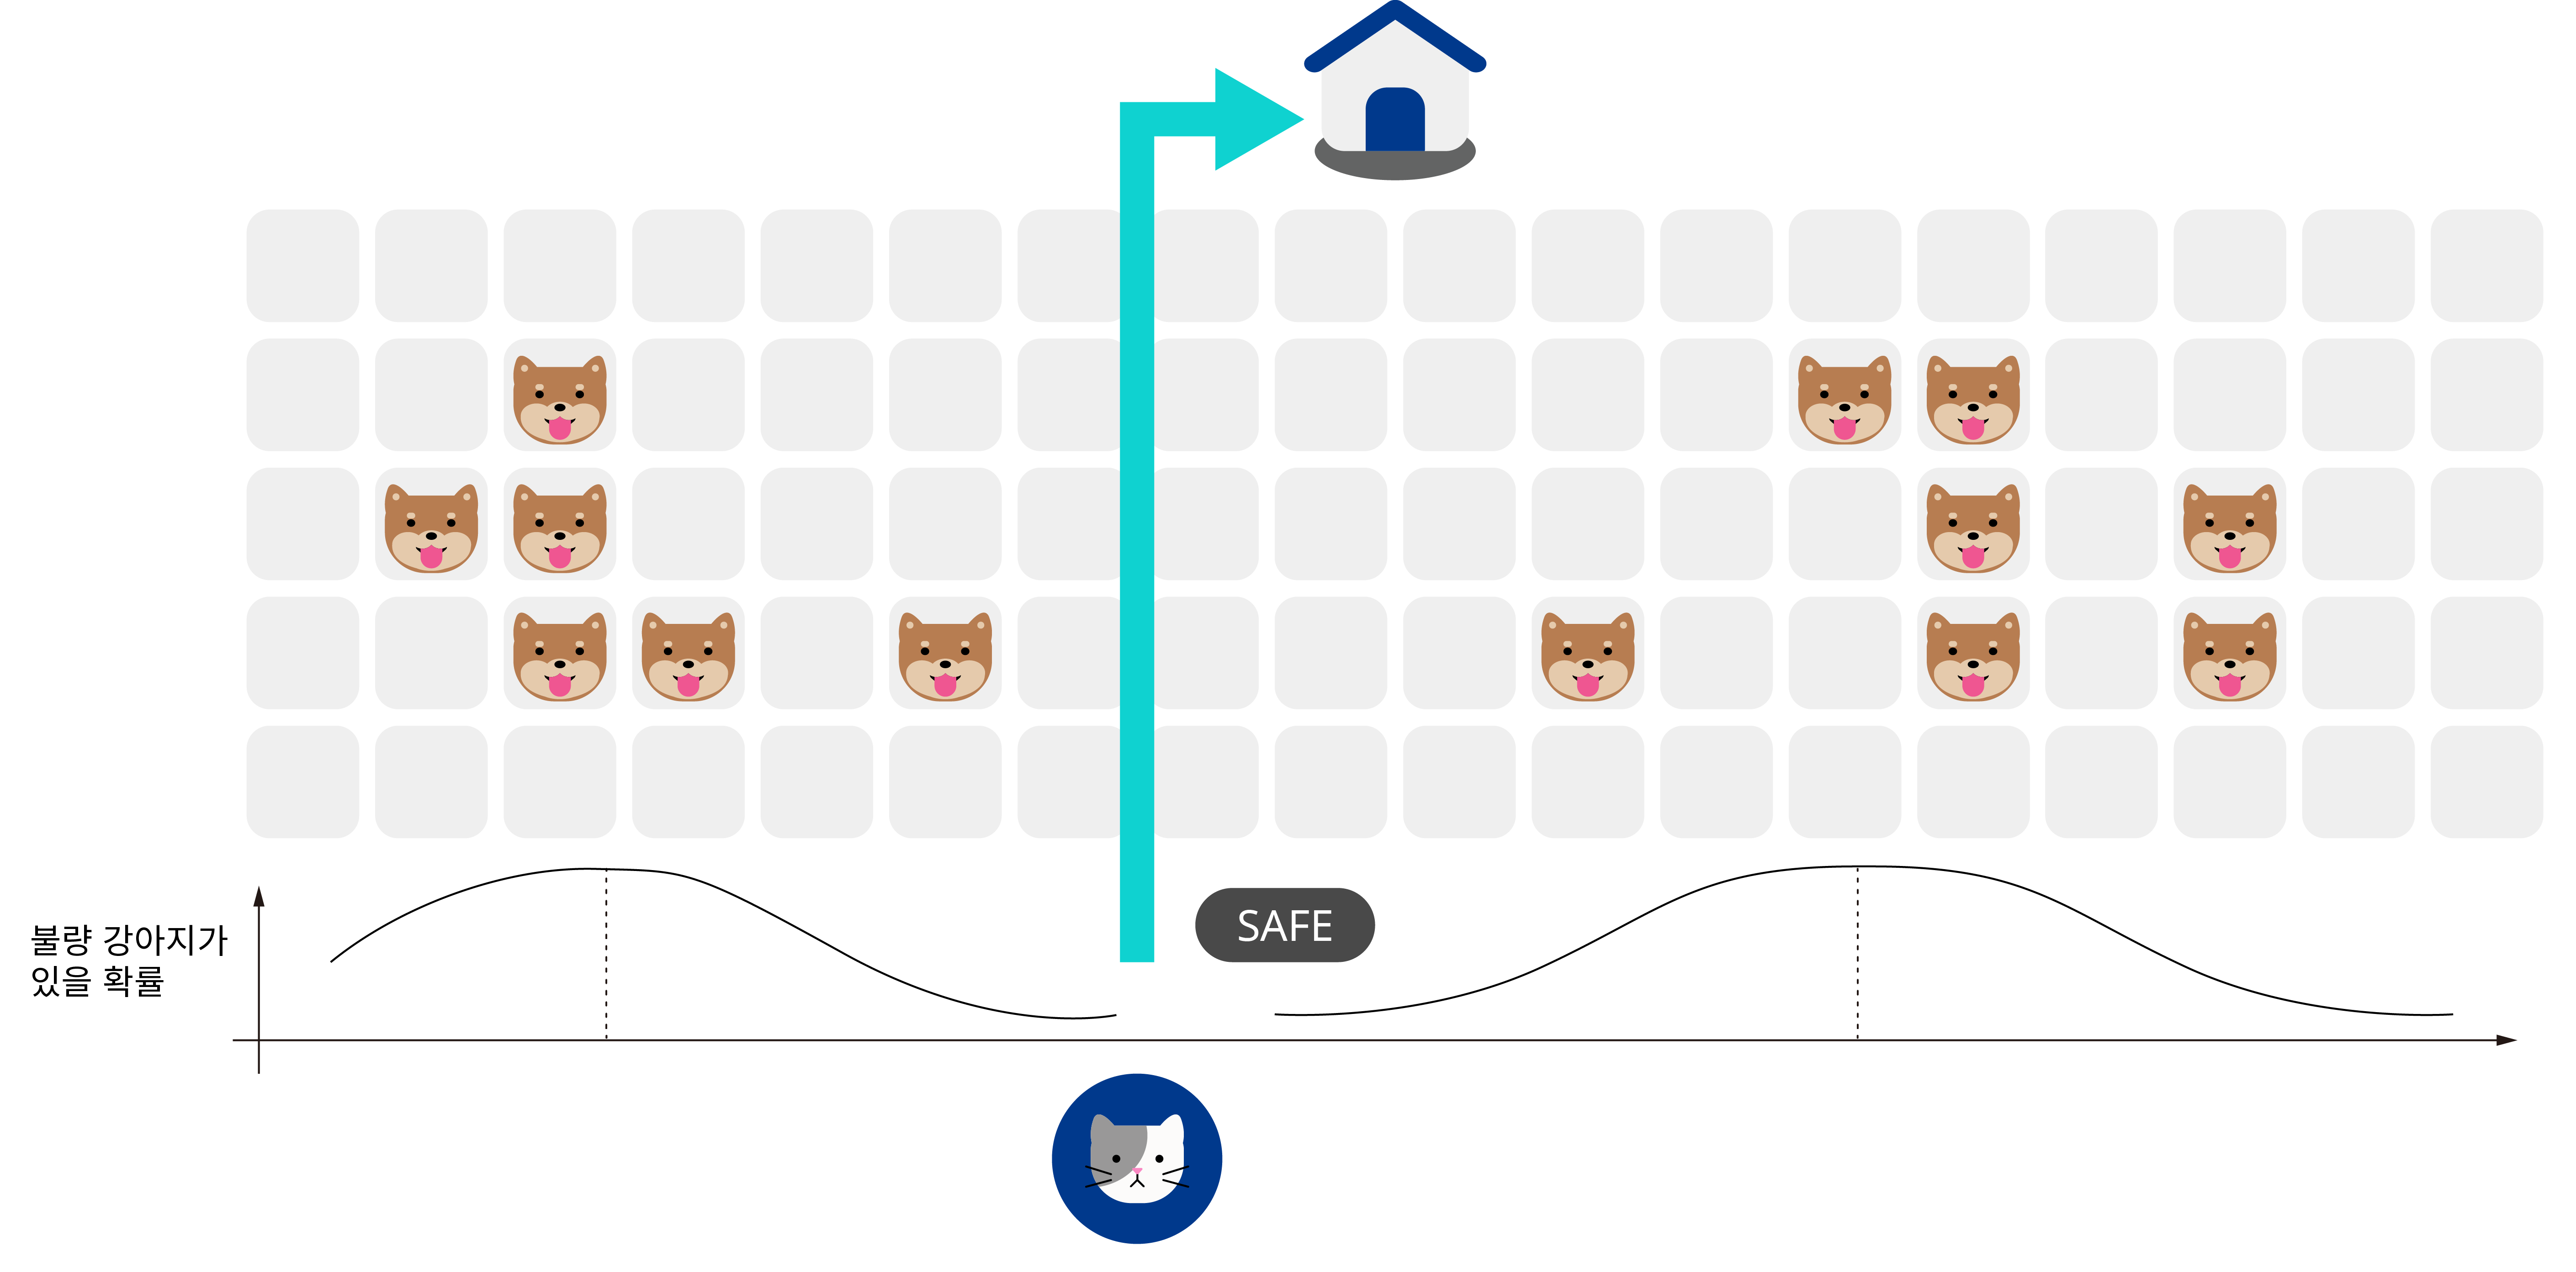
위에서 보여드린 예시에서 첫날이 Gaussian density estimation , 다음날이 Mixture of gaussian density estimation 입니다. 둘은 몇 개의 확률 분포를 사용할 것인지의 차이입니다. 이렇게 관측 데이터를 바탕으로 데이터의 실제 분포를 이미 우리가 알고 있는 확률 분포에 근사하는 것이 parametric statistical method이며 간단하게 데이터의 실제 분포를 예측할 수 있는 방법 중 하나입니다.
HOW?
그렇다면 이상 탐지에서는 위 기법들을 어떻게 활용할까요? 3-sigma rule이라는 용어를 들어셨을 텐데요. 가우시안 분포에서 평균으로부터 3 표준편차(sigma) 범위 내에 거의 모든 값이 들어간다는 경험적인 규칙입니다. 이때 3 표준편차마저 벗어나는 데이터를 보기 드문 사건(anomaly)이라고 해석하는 것이 이상 탐지에서의 Gaussian density estimation 입니다. 반드시 해당 규칙을 적용할 필요는 없으며 아래의 그림에서 세로 축의 값(확률)을 기준으로 탐지하는 것도 가능합니다. 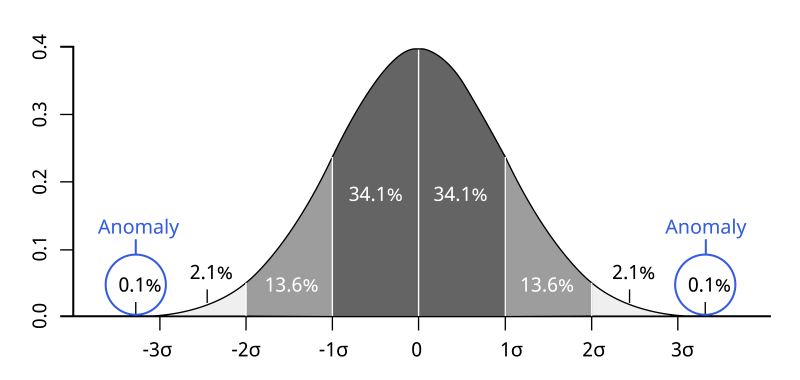
2.2 뭐 아는 게 있어야 정하지! Non-parametric
위에서 알려 드린 2가지 기법은 parametric statistical method에 해당합니다. 쉽게 말하면 관측 데이터들이 우리가 미리 정해 둔 확률 분포로부터 나왔다고 가정하는 것입니다. 하지만 이 접근법은 치명적인 단점이 존재합니다. 미리 정해 둔 확률 분포에 의해 결과가 크게 달라지며, 확률 분포를 정하기도 너무 어렵다는 것입니다. 애초에 무엇인지 명확히 모르는 것을 추측하기 위해 미리 정해 둔다는 게 어불성설 아닐까요...?
조금 극단적인 예시를 들어 보겠습니다. 아래의 길에서는 몇 개의 가우시안 분포를 사용해야 할지 아시겠나요? 애초에 무슨 근거로 강아지들의 분포가 가우시안 분포를 따른다고 확신할 수 있을까요? 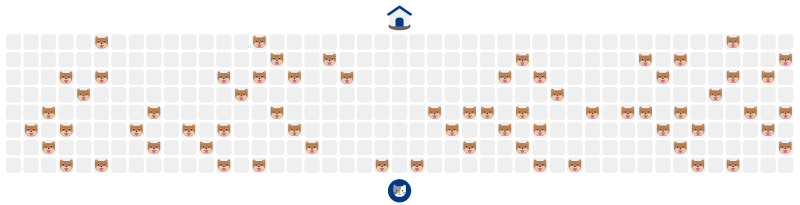 그래서 제안된 방법이 Non-parametric statistical method 입니다. 해당 방법은 데이터의 실제 확률 분포에 대해서는 사전에 가정하지 않으며 오직 관측 데이터 그 자체만을 봅니다. 히스토그램 과 kernel-density estimation이 대표적인 예시입니다.
히스토그램 이 간격을 정해 놓고 그 구간에 들어오는 데이터의 개수를 세는 방법이라면 kernel-density estimation 은 데이터 하나하나에 확률 분포를 적용하는 방법입니다. Mixture of gaussian density estimation을 데이터마다 적용했다고 이해하시면 될 것 같습니다. 조금만 더 쉬운 예시를 들어 보겠습니다.
누군가 네모난 판에 규칙적으로 레이저 포인터를 쏜다고 가정해 보겠습니다. 우리는 어떤 규칙, 확률로 레이저 포인터가 나타나는지는 알 수 없습니다. 이때 레이저 포인트가 나타날 때마다 모래 한 주먹을 그 위에 뿌려 보겠습니다. 다른 판에는 모래가 아닌 네모난 블록을 하나씩 쌓아 두겠습니다. 이 과정을 반복한다면 나중에는 어떤 모습일지 한 번 상상해 볼까요?
아래 그림처럼 레이저 포인트가 나타난 횟수에 맞추어 모래 언덕과 블록 탑이 만들어졌습니다. 이때 언덕과 탑의 높이를 확률이라고 생각하시면 됩니다. 우리는 데이터의 실제 분포에 대한 어떠한 가정도 하지 않고 오직 관측 데이터만 사용해서 확률 분포를 추측했습니다! 이것이 바로 non-parametric statistical method 입니다. 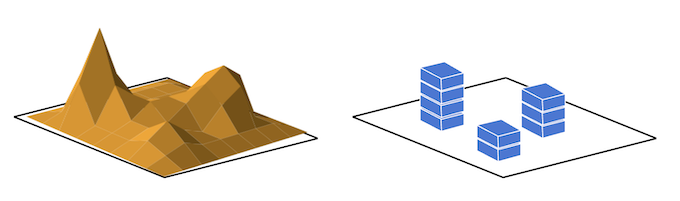
위 예시에서 모래를 쌓는 것이 kernel-density estimation , 블록을 쌓는 것이 히스토그램 입니다. 두 방법의 차이는 연속성입니다. 히스토그램은 비교적 간단하지만 확률 분포에 빈 공간이 발생할 수 있습니다. 반면에 kernel-density estimation은 연속적인 확률(모래)을 쌓아 가는 과정이기 때문에 확률 분포가 자연스럽게 퍼지면서 빈 공간 없이 데이터의 분포를 추측할 수 있습니다. 어떤 모래(확률)와 어떤 크기의 블록(측정 간격)을 사용는지에 따라 같은 관측 데이터에서도 다양한 결과를 얻을 수 있습니다.
3. 단점
통계적 접근법은 간단하고 쉽게 데이터에 다가갈 수 있다는 장점이 있습니다. 하지만 분명한 단점도 존재합니다.
- 적절한 확률 분포를 찾는 것이 어렵다.
- 다차원 데이터에서는 잘 동작하기 어렵다.
가우시안 분포가 아무리 세상을 잘 설명한다지만 모든 것을 설명하지는 않습니다. 위에서 강아지들이 가우시안 분포를 따를지, 균등 분포를 따를지는 아무도 모르는 일입니다. 적절한 확률 분포를 찾더라도 분포의 평균, 분산 등 고려해야 할 파라미터는 여전히 남아 있습니다.
다른 이유는 다변량(multivariate) 데이터를 다루기 어렵다는 점입니다. 위의 문제들에서는 2차원 평면만 고려했기 때문에 쉽고 직관적으로 문제에 접근할 수 있었습니다. 하지만 만약 3차원, 4차원, 더 나아가 100차원까지 축이 늘어난다면 상상하기도 어려운 문제가 될 수 있습니다. 다차원 데이터 문제는 통계적 접근법에 국한되는 문제는 아니지만, 통계적 접근법에서는 특히 다루기 어려운 문제입니다.
나가며
이번 글에서는 통계적 관점에서 이상 탐지를 어떻게 다루는지 소개해 드렸습니다. 다음 글은 3부-머신 러닝으로 이상 탐지하기로 통계적 기법에서 더 발전한 형태의 이상 탐지에 대해 소개해 드리겠습니다.
감사합니다.
이미지 출처 및 참고 자료
- David L. Chandler, Explained: Sigma, MIT News, February 9, 2012
- Sherenaz W. Al-Haj Baddar 외, Anomaly Detection in Computer Networks: A State-of-the-Art Review, ResearchGate, December 2014
- Editorial, Six Anomaly Detection Techniques – Pros And Cons, roboticsbiz, June 19, 2021