Engineering
국내 최초 MoE 모델 ‘Kanana-MoE’ 개발기
lana.ny, khel.2h, kevin.nlp카카오
2025년 7월 24일
원문에서 보기 ↗안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나 LLM 조직에서 Pre-Training을 연구하는 Lana, Post-Training을 연구하는 Khel, Kevin 입니다.
최근 대규모 언어 모델 (LLM) 크기와 성능이 경쟁이 치열해지면서, 모델 파라미터 수가 기하급수적으로 증가함에 따라 이제는 연산 비용 절약, 메모리 사용량 최적화, 효율적인 학습 을 어떻게 할 것인지가 업계의 큰 화두가 되었습니다. 이러한 문제를 해결할 수 있는 강력한 방법 중 하나로 주목받고 있는 기술이 바로 “Mixture of Experts (이하 MoE)” 입니다. 초기 MoE 관련 연구 중 하나인 Switch Transformer [1] 논문에 따르면, Sparse 구조인 MoE 모델은 토큰 하나를 처리하는 데 필요한 연산량 (FLOPS per token)이 동일한 Dense 모델에 비해 원하는 성능까지 7.5배 빠른 학습 속도로 도달할 수 있으며, expert 수가 많아질수록 학습 속도도 더욱 빨라졌습니다. 이는 동일한 학습 시간과 컴퓨팅 자원이 주어졌을 때, MoE 모델 구조를 활용하면 더욱 빠른 속도로 목표 성능에 도달이 가능함을 의미합니다. 해당 논문에서는 더 나아가 토큰당 필요한 연산량이 3배 이상인 Dense 모델과도 비교해보았을 때, MoE 모델에서 여전히 좀더 효율적인 학습이 가능했음을 시사하고 있습니다.
저희 조직에서도 이러한 효율적인 MoE 언어 모델을 만들기 위해 내부적으로 다양한 연구를 진행해왔습니다. 그 결과로 단 3B 수준의 활성 파라미터만으로 8B Dense 모델에 준하는 성능을 달성한 MoE 모델 Kanana-1.5-15.7B-A3B 를 소개해드리고자 합니다. 해당 모델은 Kakao Hugging Face에 오픈소스로 공개되어 있으니, 많은 관심 부탁드립니다.
1) Mixture of Experts: 필요한 부분만 효율적으로 사용하자
Mixture of Experts (MoE) 모델이 왜 필요한가?
일반적인 대규모 언어 모델 (LLM), 소위 “Dense 모델 ”은 입력된 데이터를 처리하기 위해 모든 파라미터가 연산에 참여하여 출력을 만들게 됩니다. 저희 조직에서 앞서 오픈소스로 공개했던 Kanana-1.5-8B, Kanana-1.5-2.1B 같은 모델들이 여기에 해당합니다. Dense 구조를 갖는 경우 언어 모델의 파라미터 규모가 클수록 더 많은 지식을 저장할 수 있어 성능이 향상되는 장점이 있지만, 한편으로는 파라미터 규모에 비례하여 연산량이 같이 증가한다는 명백한 한계가 존재합니다. 따라서 모델이 커질 경우 추론 시에 사용되는 장비의 부담과 비용이 늘어나기 때문에, 모델 성능을 높이기 위해서 무한정 파라미터 수를 늘리는 것은 현실적으로 거의 불가능합니다.
이러한 Dense 구조의 큰 모델이 갖는 한계를 보완하면서도 모델의 수용 가능한 지식의 총량을 확장하기 위해 MoE [2] 구조가 활용될 수 있습니다. MoE 구조의 언어 모델은 전체 파라미터 중 주어진 입력에 가장 적합한 일부 전문가 (expert) 파라미터들을 선별적으로 활성화하여 추론에 필요한 연산을 진행합니다. 이러한 특징을 가지는 MoE 모델은 크게 두 가지 목적으로 활용될 수 있습니다.
- 초거대 모델 학습 : Dense 구조로는 현실적으로 초거대 규모의 모델을 만드는 것에 무리가 있지만, MoE 구조를 채택한다면 가능합니다. 대표적인 예시로, DeepSeek-V3 [3] (671B 파라미터 중 37B 활성화), Qwen3-235B-A22B [4] (235B 파라미터 중 22B 활성화), Llama 4 Maverick [5] (400B 파라미터 중 17B 활성화) 같은 모델들은 MoE 구조 덕분에 엄청난 수의 전체 파라미터로 지식의 총량은 확장하면서도 추론에 사용되는 연산에는 일부만 사용하면서 부담을 줄여 강력한 성능을 갖는 거대 모델을 구현할 수 있었습니다.
- 추론 비용 효율화 : 모델의 절대적인 사이즈를 확장하는 용도 외에도, 성능을 유지하되 추론 비용 효율화를 위해서도 MoE 구조가 활용될 수 있습니다. 모델을 실제로 사용할 때 모든 파라미터가 연산에 사용되는 Dense 구조의 모델과 달리, MoE 모델은 필요한 일부 파라미터만 선별적으로 연산에 참여하게 되므로 모델 커널 최적화만 충분히 되어있다면 추론 비용을 크게 절약할 수 있습니다. 약 10B 규모의 성능을 보이는 알리바바 그룹의 Qwen3-30B-A3B [4] 모델이 이런 목적에 해당된다고 볼 수 있습니다.
이번에 소개해드릴 Kanana-1.5-15.7B-A3B 모델은 위 내용 중 두 번째 목적인 추론 비용 효율화 에 중점을 두었습니다. 앞서 공개되었던 Kanana-1.5-8B 모델에 버금가는 성능을 보이면서도, 추론 연산에는 2~3배 적은 활성 파라미터만을 사용하여 높은 효율을 달성하는 것이 이번 모델의 목표였습니다.
Mixture of Experts (MoE) 는 어떻게 생겼을까?
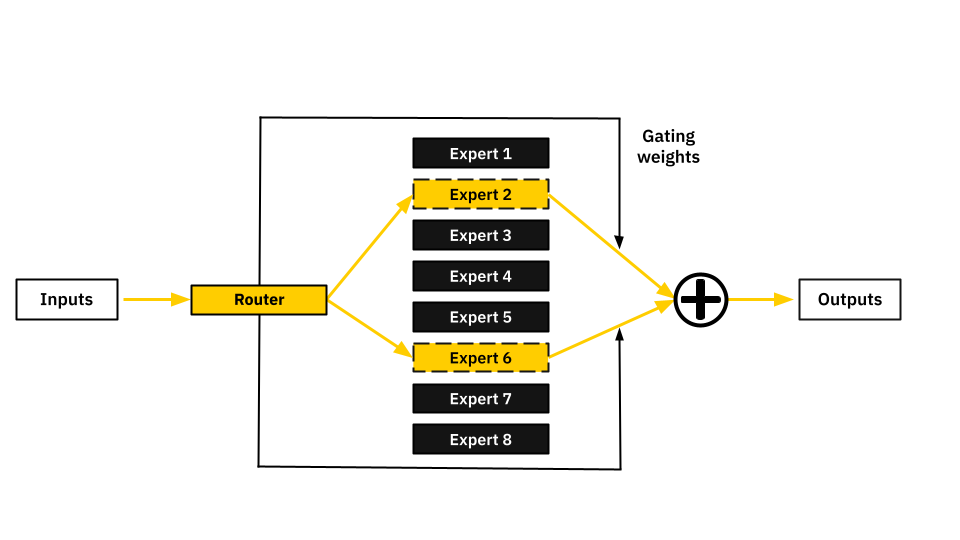
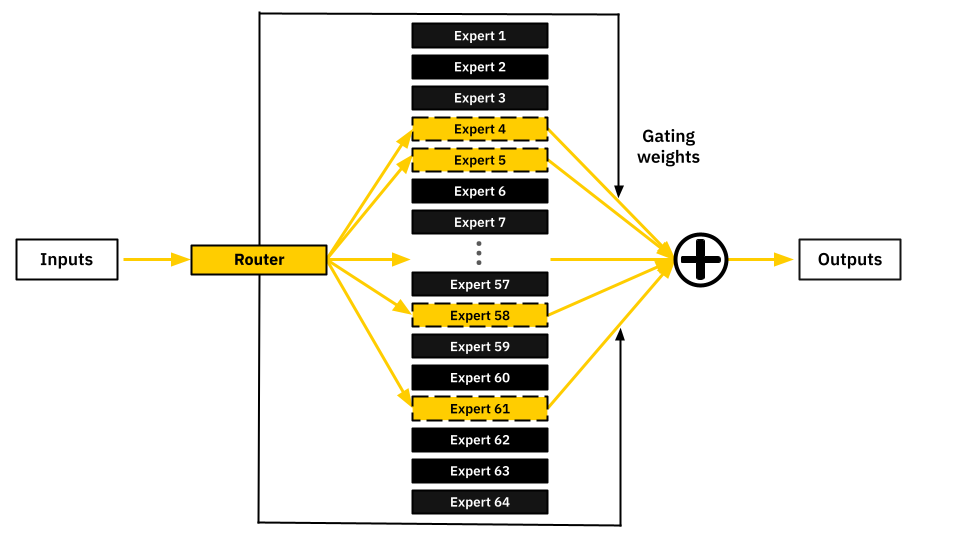
MoE 모델과 Dense 모델의 가장 핵심적인 구조적 차이는 단연 Dense 모델의 MLP (Multi-Layer Perceptron) 레이어가 MoE (Mixture of Experts) 레이어로 대체되었다는 것입니다. MoE 레이어에서 입력을 받게 되면, 가장 먼저 router에서 어떤 expert들이 적절할지 expert들의 점수를 매긴 뒤, 상위 몇 개의 expert들로만 입력 값을 흘려보내 처리하도록 해줍니다. 이후 활성화된 expert들로부터의 연산 출력값을 router가 매긴 점수에 따라 가중치를 두어 합하고 (weighted sum), 이후 연산 과정에 사용합니다. 이러한 MoE 아키텍처는 전체 전문가 (expert) 수, 그리고 router로부터 선택되어 활성화되는 expert 수의 규모에 따라 크게 두 가지로 나뉩니다.
- Coarse-grained MoE : Mixtral [6] 시리즈와 같은 비교적 초기의 MoE 모델들은 10개 미만의 소수의 expert를 갖는 Coarse-grained 구조를 가지고 있었습니다. 이 경우 각 expert는 단독으로 Dense 모델의 MLP 레이어 역할을 할 수 있을 정도의 크기를 가지며, 추론 시에는 약 2개 정도로 적은 수의 expert만을 활성화하게 됩니다.
- Fine-grained MoE : 이후 Qwen [4,7], DeepSeek [3] 시리즈의 MoE 모델이 등장하며 훨씬 많은 수의 초소형 expert로 구성되는 Fine-grained 구조가 점차 트렌드로 자리잡게 되었는데요, 이 구조는 64개와 같이 훨씬 많은 수의 (혹은 그보다 더 많은 수의) 초소형 expert들을 두고, 그중 8개, 16개 정도로 Coarse-grained에서 보다 좀 더 많은 수의 expert들을 활성화시켜 작업을 처리합니다. Coarse-grained 의 경우와 달리 Fine-grained expert는 단독으로 Dense 모델의 MLP 레이어로는 사용되기는 어려울 정도로 매우 작은 크기를 가지고 있습니다.
저희 Kanana-1.5-15.7B-A3B 또한 64개의 초소형 expert들로 구성하며, router로부터 8개의 expert들이 활성화되는 Fine-grained 구조를 채택하였습니다.
2) MoE 모델 Pre-Training 전략
효율적으로 Expert 만들기: Upcycling Dense LLM
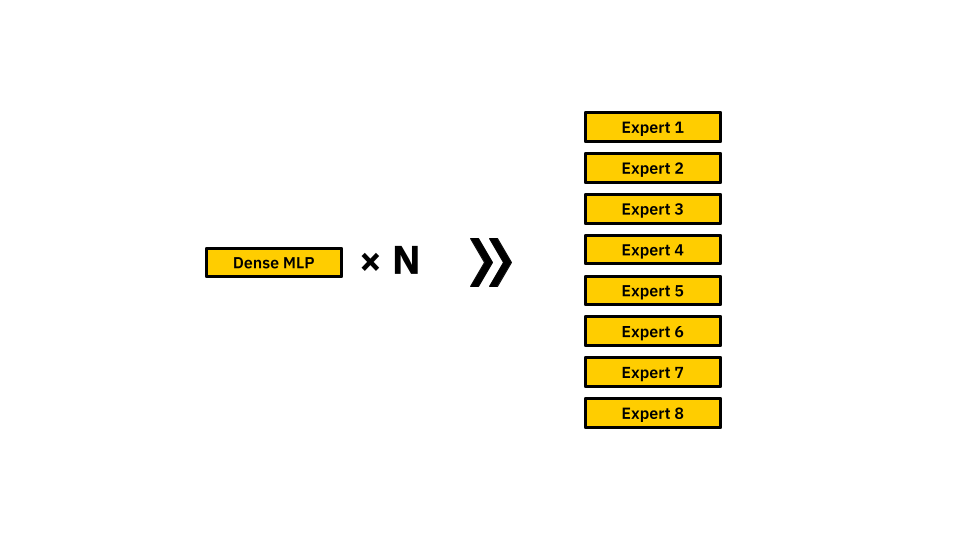
이번 연구에서 저희는 모델의 모든 파라미터를 초기화해준 뒤 처음부터 학습(from-scratch)하는 대신, 학습 시간과 비용을 절약하기 위해 기존의 Dense LLM을 MoE 모델로 변환해주는 upcycling 방식 을 채택했습니다. 이는 Dense 모델의 MLP 레이어 외의 부분들은 그대로 사용하되, MLP 부분을 복제해서 여러 개의 expert를 만드는 방법으로, Sparse upcycling: Training mixture-of-experts from dense checkpoints [8] 논문에서 제안되었습니다. 이 논문에서 제안된 upcycling 방법은 Dense 모델의 MLP 레이어가 그대로 하나의 expert가 되는 것이기 때문에, 단일 expert의 크기가 상대적으로 크게 형성되는 Coarse-grained MoE를 만드는 데 적합한 방법이었습니다.
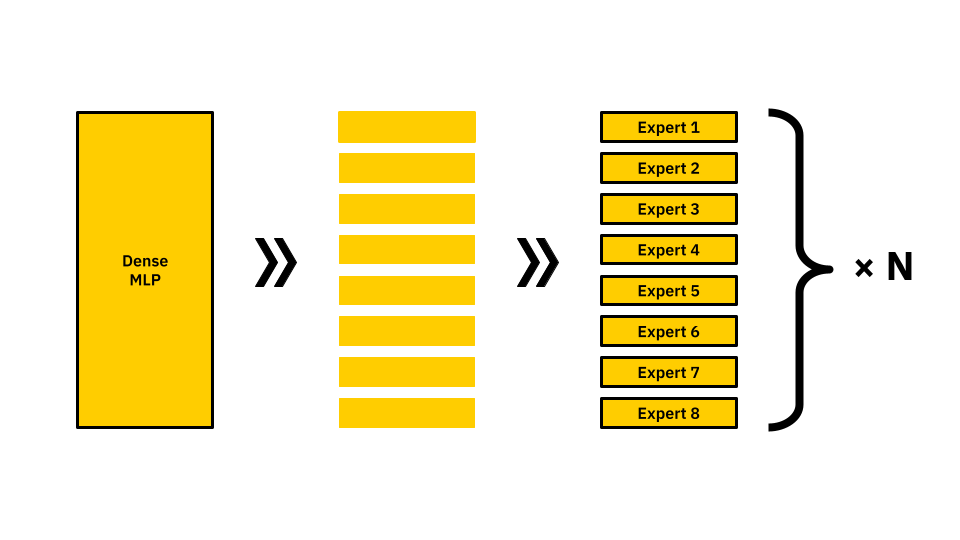
저희는 많은 수의 초소형 expert를 갖는 Fine-grained MoE를 만들고자 했기 때문에, Qwen2 MoE [7] 에서 제안한 upcycling 방법에서 착안하여 expert보다 훨씬 큰 사이즈의 Dense 모델 MLP 레이어를 잘라 여러 개의 작은 expert들을 만들어 주는 방법을 채택했습니다. 이 upcycling 방법은 expert들이 모두 같은 duplicate은 아니기 때문에 상대적으로 weight에 randomness 또한 더 해줄 수 있습니다. 이를 위해 저희는 Kanana LLM 1.5 개발기에서 소개된 Kanana-Nano-1.5-3B의 Base 단계의 가중치를 upcycling의 기반이 되는 Dense 모델로 삼고, MLP 레이어를 8등분 해준 뒤 각각 8개의 복제를 만들어 총 64개의 Fine-grained expert를 만들어주었습니다. Dense 모델 MLP의 intermediate size의 약수가 아닌 수로 expert의 intermediate size를 설정해주는 Qwen2 MoE와 달리, 저희는 Upcycling Large Language Models into Mixture of Experts [9] 에서 착안하여 Dense LLM의 MLP layer (intermediate size : 9216)를 정확히 8등분하여 하나의 expert (intermediate size : 1152)를 만들어주었습니다. 이번 실험을 통해 Dense 모델을 upcycle할 때 MoE 레이어의 expert들을 8종류의 파라미터로 초기화해주는 것만으로도 이후 효과적인 학습을 위해 필요한 diversity가 확보될 수 있음을 확인할 수 있었습니다.
Dense MLP를 잘라서 expert를 만들어주는 것 외에도 Qwen2 MoE에서는 expert 초기 파라미터들의 diversity를 더욱 높이기 위해 intermediate dimension을 따라 shuffling을 해주거나 50%의 expert 파라미터를 랜덤으로 초기화하는 등의 시도가 제안되었으나 [7], 저희 모델을 통해 내부적으로 실험해보았을 때 loss나 모델 성능 측면에서 이득이 보이지 않아 이는 적용하지 않았습니다.
MoE 성능 향상에 최적화한 2단계 Pre-Training
Dense LLM을 upcycle하여 expert를 만들고 초기 파라미터를 구성한 뒤, 저희는 이전 Kanana LLM v1, v1.5 시리즈에서와 마찬가지로 2단계에 걸쳐 pre-training 학습을 진행해주었습니다. MoE 모델은 Dense 모델과 근본적으로 다른 구조를 가지고 있기 때문에, 기존에 Dense 모델에 최적화된 데이터 혼합 (Data Mixture)를 그대로 사용하는 방식으로는 최적의 성능을 얻기 어렵다고 판단했습니다. 따라서 저희는 MoE 모델에서 가장 효과적인 성능을 낼 수 있는 새로운 구성의 Data Mixture를 찾아 학습에 적용시켜주었습니다.
- Stage 1: 첫 번째 pre-training 단계에서는 약 700B 토큰 규모의 데이터를 학습시키면서, 일반적인 영역을 다루되 퀄리티가 높은 데이터들을 중심으로 구성해주었습니다. 랜덤 파라미터에서 처음부터 학습할 때는 퀄리티가 아주 높지 않더라도 지식의 다양성 측면에서 필요한 데이터들도 성능 향상에 도움이 되지만, 이미 학습이 끝난 모델을 기반으로 upcycle을 통해 만들어진 MoE 모델은 상대적으로 적은 양의 고품질 데이터만으로도 효과적으로 성능을 끌어올릴 수 있었습니다. 또한 MoE 모델에 최적화된 데이터 구성을 신속하게 찾기 위해, 본 모델보다 작은 규모의 실험용 MoE 모델을 만들어 활용하였습니다. 소형 MoE 모델로 여러 가지 데이터 혼합(Data Mixture)에 대해 빠르게 테스트하며 MoE 모델 학습에 최적화된 데이터 구성을 찾아주었고, 이를 본 모델의 첫 번째 pre-training에 적용해주었습니다.
- Stage 2 : 이어서 진행된 두 번째 pre-training에서는 코딩, 수학 같은 특정 도메인의 고퀄리티 데이터들에 집중하면서 300B 토큰을 학습해주었습니다. 두 번째 스테이지의 최적의 데이터 구성은 첫 번째 pre-training 스테이지가 완료된 모델로부터 여러 번의 실험을 통해 찾아주었습니다. 이 때 Kanana LLM 1.5 개발기에서 소개되었던 고품질의 코드, 수학 데이터 또한 성능에 큰 이득을 주어 적극적으로 활용되었습니다.
안정적으로 균형 잡힌 MoE 모델 학습하기: Auxiliary loss functions
MoE 모델의 구조적 특징인 routing 부분의 학습이 안정적으로 이루어지도록 하고자, 저희는 기존 next token prediction 기반의 loss에 두 가지 보조 손실 함수 (Auxiliary loss function) 를 추가하여 학습에 사용하였습니다.
첫 번째로, MoE 모델 학습의 주요 과제 중 하나는 특정 몇 개의 expert에서만 계속해서 선택되며 학습이 활발하게 일어나는 불균형을 방지하는 것입니다. 토큰이 계속해서 소수의 expert들로만 흘러가도록 학습된다면, 모델이 가지고 있는 모든 expert들을 충분히 활용하지 않는 비효율적인 모델이 될 수 있습니다. 이러한 문제를 예방하기 위해, 기존 언어모델 학습에 사용되는 loss에 추가적으로 auxiliary load balancing loss 를 두어 expert들의 균형잡힌 학습 을 유도하였습니다 [2]. Switch Transformers [1] 에서 정의된 아래 수식에서 N은 전체 expert 수, f_i는 i번째 expert로 routing된 토큰의 비율, P_i는 expert router에서 구해지는 해당 expert로의 routing 확률을 의미합니다. Batch 단위로 loss를 계산한다면, 이는 모두 batch 내에서 구해지는 평균값으로 대체됩니다. 이렇게 정의되는 load balancing loss는 학습 과정에서 특정 expert가 선택되는 비율이나 routing 확률에 과도한 불균형이 생기는 것을 방지해줍니다.
\mathcal{L}_{LBL} = N\sum_{i=1}^Nf_i\cdot P_i
이 외에도 MoE 모델 학습에서 router에 과도한 logit 값이 입력되면서 생기는 학습 불안정성을 예방하고자, ST-MoE 연구에서 추가적으로 “router z-loss” 를 아래와 같이 정의하였습니다 [10].
\mathcal{L}_Z=\frac{1}{B}\sum_{i=1}^B \bigg(\log\sum_{j=1}^Ne^{x_j^{(i)}}\bigg)^2
위 식에 따라 router z-loss는 한 번에 입력으로 받는 토큰의 수를 B, expert 수를 N개라고 할 때, router에 들어가는 logit x 값에 과도하게 큰 값이 생기지 않도록 조절해주게 됩니다.
앞서 말씀 드린 load balancing loss, router z-loss를 기존 loss에 합쳐준다면 아래와 같이 나타낼 수 있습니다. 이때, \alpha, \beta는 각 loss의 영향력을 결정하는 가중치 (coefficient) 입니다.
\mathcal{L}=\mathcal{L}_{CE}+\alpha\cdot\mathcal{L}_{LBL}+\beta\cdot\mathcal{L}_{Z}
섬세하게 다뤄줘야 하는 Fine-Grained Upcycled MoE
이미 학습이 완료된 파라미터들을 기반으로 만들어진 이번 MoE 모델은 랜덤으로 초기화된 모델을 처음부터 학습할 때보다 하이퍼파라미터에 훨씬 민감한 경향을 보였습니다. 특히 학습률(learning rate)이 조금만 높아져도 파라미터가 필요 이상으로 업데이트되면서 학습이 불안정해지거나 성능 향상이 더디어지는 현상이 나타났습니다. 이에 저희는 기존 Kanana 모델 시리즈를 처음부터 학습할 때의 learning rate나 DeepSeek LLM [11] 에서 제안하는 방법으로 계산되는 learning rate보다 더 낮은 learning rate를 선정하여 안정적인 학습을 유도해주었습니다.
효과적인 학습을 위해 learning rate를 직접 조절하는 것 외에, global batch size를 키워주는 것 또한 학습 안정화에 도움을 줄 수 있었습니다. 학습 도중 global batch size를 키우면 각 데이터 샘플이 파라미터 업데이트에 미치는 영향이 줄어들어 간접적으로 learning rate를 낮추는 것과 비슷한 효과가 생기게 됩니다. 학습 후반부에 gradient norm이 증가하고 loss 감소가 정체되는 등 불안정한 학습을 보이고 있을 때, 이미 충분히 낮은 learning rate를 더 이상 낮추기는 조심스러운 상황에서 global batch size를 키워줌으로써 문제를 해결할 수 있었습니다. 이처럼 학습 과정에서 batch size를 scheduling하는 방법은 DeepSeek-V2 [12], V3 [3] 학습에 활용되었던 사례에서 착안하여 이번 MoE 모델 학습에 적용해주었습니다.
또 다른 학습 하이퍼파러미터로 앞서 말씀드린 load balancing loss의 영향력을 조절하는 가중치(coefficient) 또한 학습에 적지 않은 영향을 주는 것을 확인할 수 있었습니다. 특히 특정 도메인의 지식을 집중적으로 주입시켜주는 pre-training 후반부에서 load balancing loss의 coefficient를 절반으로 줄여주면, 학습이 안정화 될 뿐만 아니라 특정 지식에 일부 expert들이 좀더 집중적으로 선택되는 것이 허용되면서, 특정 분야 지식을 집중적으로 담고 있는 도메인 expert가 자연스럽게 형성되는 효과가 있었습니다.
그 외에도 학습 후반부에 모델 성능의 variance를 낮추고자 마지막 몇 개의 학습 step들에 대해서 모델 merging을 해 줄 때 MoE 모델 성능이 유의미하게 향상되었습니다. 특히, 학습 과정에서 variance가 상대적으로 높게 나타났던 코드 성능이 크게 향상될 수 있었습니다.
3) Pre-Training 결과로 MoE 구조의 장점 확인하기
37%의 파라미터 만으로 성능 따라잡기
저희 MoE 모델 개발의 핵심 목표는, 적은 활성 파라미터만으로 훨씬 큰 수준의 Dense 모델에 준하는 성능을 구현하며 추론 효율성을 극대화하는 것이었습니다. 이번 실험에서 다양한 벤치마크 점수를 기반으로 목표를 달성했음을 확인할 수 있었습니다.
| Models | MMLU | KMMLU | HAE-RAE | GSM8K | HumanEval | MBPP |
|---|---|---|---|---|---|---|
| Kanana-Nano-1.5-3B-Base | 59.23 | 47.30 | 78.00 | 61.79 | 46.34 | 46.80 |
| Kanana-1.5-8B-Base | 64.24 | 48.94 | 82.77 | 63.53 | 61.59 | 57.80 |
| Kanana-1.5-15.7B-A3B-Base | 64.79 | 51.77 | 83.23 | 61.18 | 59.76 | 60.10 |
지난 번 공개된 Kanana-1.5-8B 의 성능과 비교했을 때, MoE 모델은 37% 수준에 불과한 활성 파라미터만으로도 대등한 성능을 보였습니다. 특히 일반적인 한국어 지식을 평가하는 KMMLU와 python 코드 생성 능력 평가 벤치마크인 MBPP에서는 3점 가까이 더 높은 점수를 기록했습니다.
Upcycling의 기반이 되었던 Dense 모델인 Kanana-Nano-1.5-3B와 비교하였을 때 결과는 더욱 인상적이었습니다. 활성 파라미터 수는 모두 3B로 거의 동일한 수준임에도 MoE 모델은 전반적으로 더 높거나 비슷한 성능을 달성했으며, 특히 코드 생성 능력을 평가하는 Humaneval, MBPP 벤치마크의 경우 모두 10점 이상이라는 압도적인 성능 향상을 보였습니다.
위 결과를 통해 MoE 구조가 수많은 expert에 방대한 지식을 분산 저장함으로써 수용 가능한 지식의 총량을 늘리고, 상황에 따라 필요한 expert들만 선별적으로 활성화시키는 것이 적은 활성 파라미터만으로도 훌륭한 모델 성능을 달성하는 데 효과적이었음을 확인할 수 있었습니다.
Expert의 전문성 확인하기
Fine-grained 구조의 MoE 모델은 expert 수가 아주 많기 때문에, expert마다 서로 다른 분야의 지식을 담고 있어 활성화되는 맥락 또한 다를 것으로 생각했습니다. 이를 검증하고자 실제로 입력 데이터의 도메인에 따라 expert가 선택되는 양상이 다른지 확인하는 실험을 진행했습니다. 대표적인 몇가지 벤치마크들의 프롬프트를 MoE 모델에 입력하고 답변이 생성되는 과정에서 모델의 각 레이어별로 expert가 선택되는 비율을 heatmap으로 아래와 같이 시각화해보았습니다.
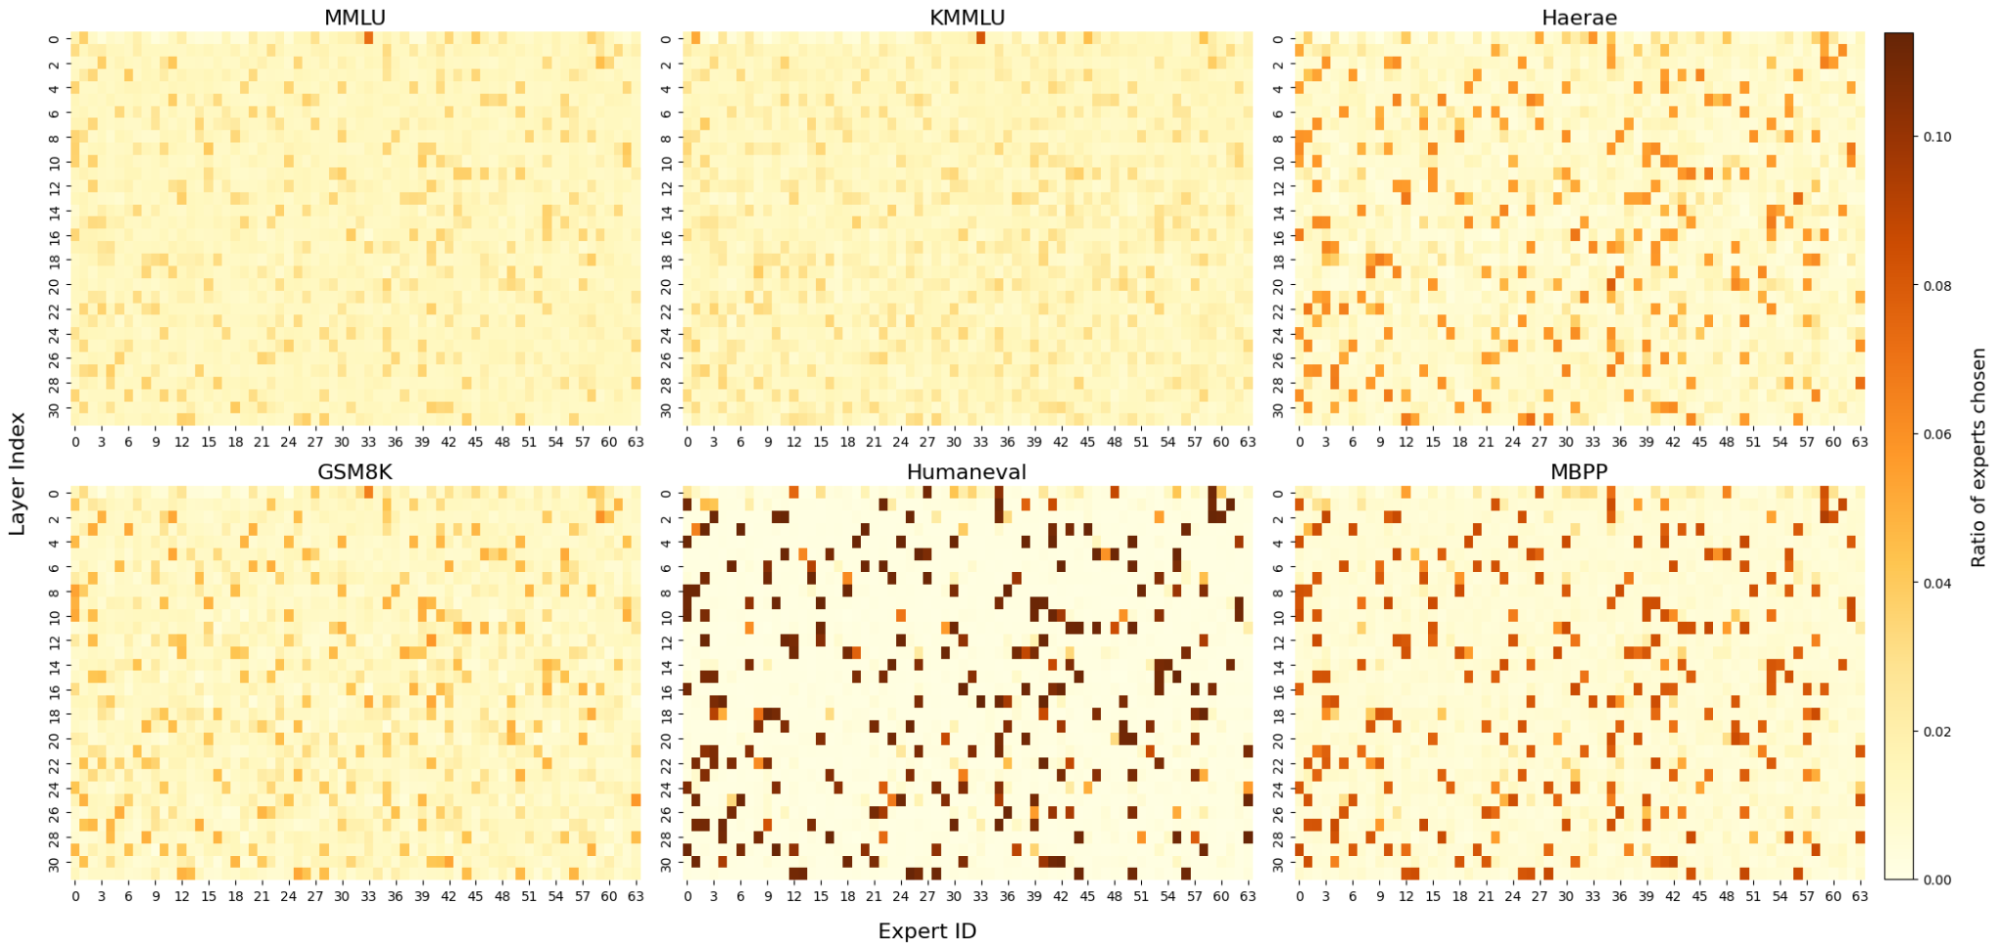
Heatmap 분석 결과, 입력 데이터의 도메인에 따라 expert가 활성화되는 양상에 뚜렷한 차이가 나타났습니다. 특히, 도메인이 한 분야에 전문화되어 있을 수록 소수의 특정 expert들에 더욱 routing이 집중되는 현상이 있었습니다.
그림 5의 Heatmap에서, 일반적이고 광범위한 지식을 다루는 MMLU, KMMLU 벤치마크는 상대적으로 균일하게 expert가 활성화되는 패턴을 보였습니다. 반면, 파이썬 코드 생성 벤치마크인 Humaneval, MBPP의 경우 특정 expert들이 집중적으로 선택되며, 거의 선택되지 않은 expert들도 다수 존재하는 것으로 보였습니다. 따라서 Fine-grained MoE 구조에서는 전문 분야를 처리할 때 특히 선호되는 도메인 expert들이 존재함을 확인할 수 있었습니다.
도메인 별 Expert 선택 양상의 불균형을 좀더 수치화해서 확인하기 위해, 각 레이어별 expert가 선택되는 횟수 분포의 Gini index를 계산하여 시각화해보았습니다. Gini index가 1에 가까울 수록 특정 expert들이 집중적으로 활성화됨을 의미하며, 0에 가까울수록 균등하게 활성화됨을 의미합니다.
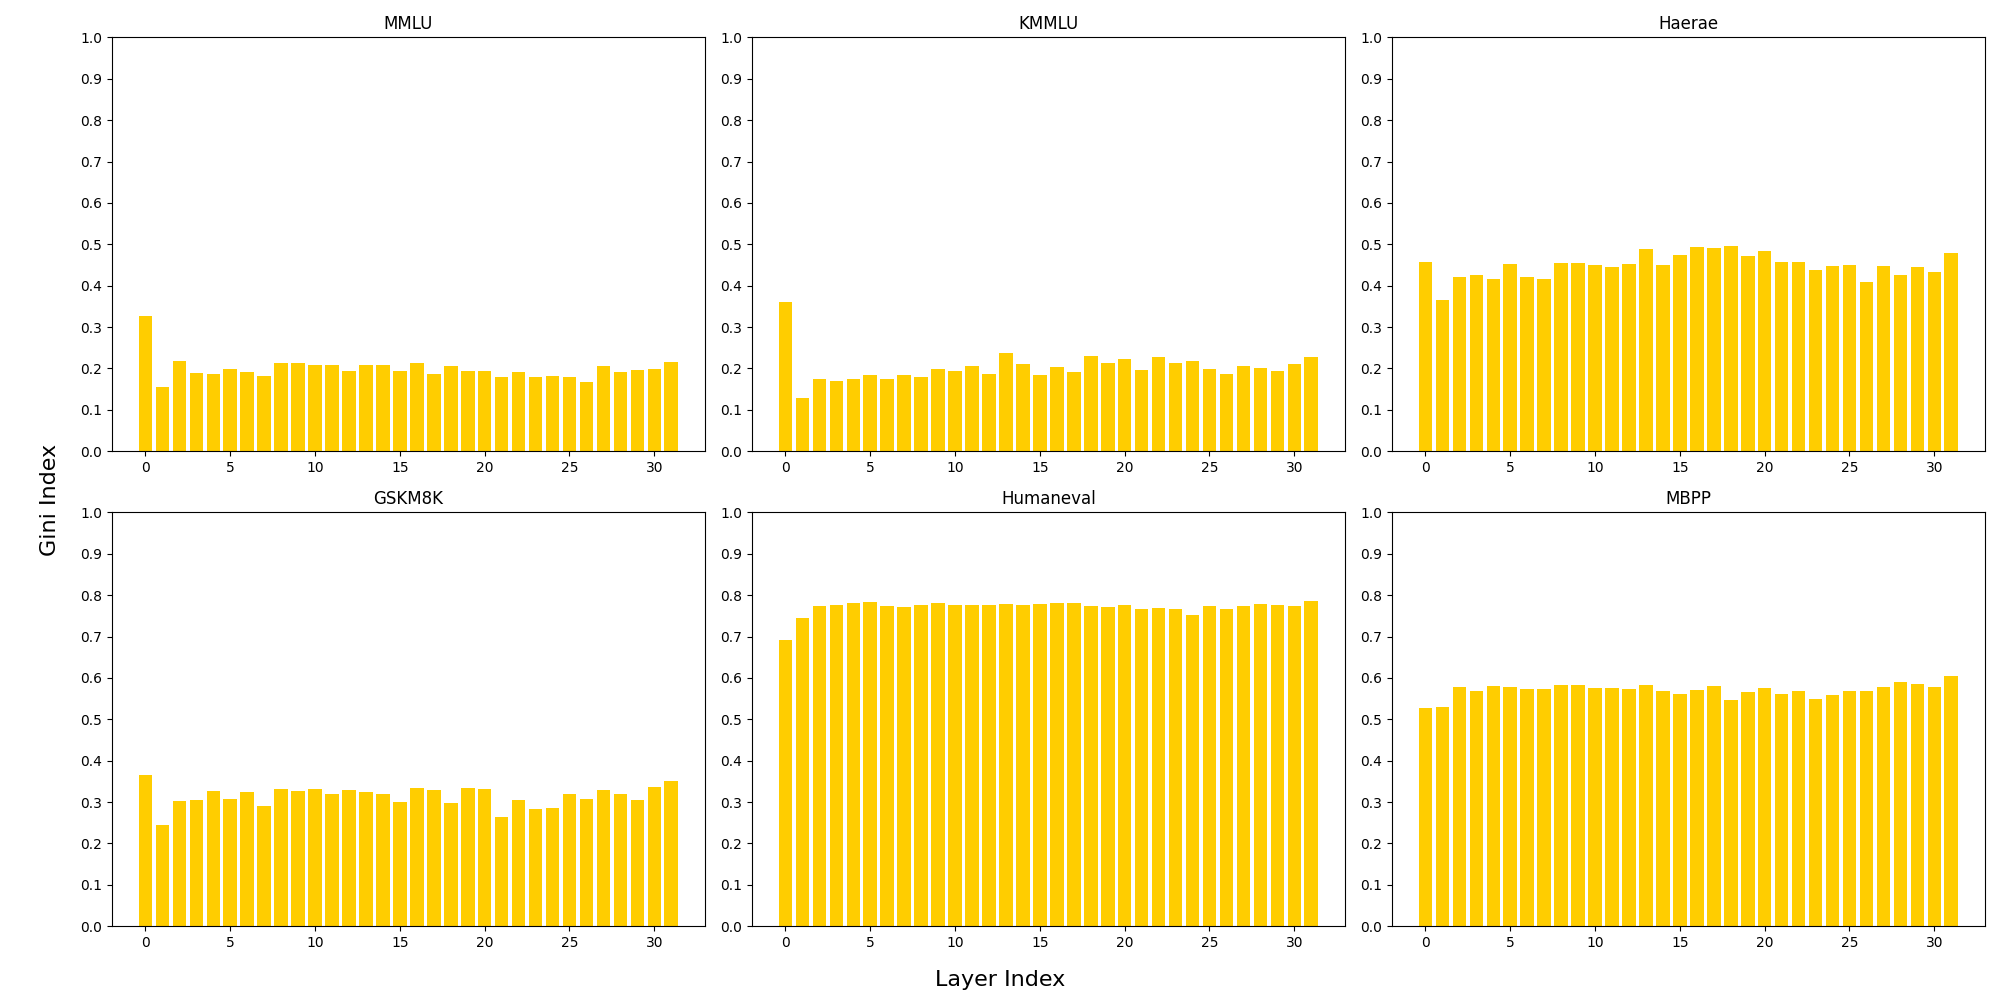
다양한 분야의 지식을 다루는 MMLU, KMMLU의 경우, Gini index 값이 다른 벤치마크들보다 확연히 낮게 나타난 것으로 보아 답변 생성에 공통적으로 필요한 지식이나 특정 도메인에 치우치지 않은 일반적인 지식의 경우 상대적으로 다양한 expert에 넓게 분산되어 있음을 알 수 있었습니다. 반면, 위 heatmap의 결과에서와 마찬가지로 GSM8K, Haerae로 갈수록 조금 더 높은 Gini index 값을 보였고, 코드 벤치마크인 Humaneval이나 MBPP에서는 더욱 더 특정 expert들로 토큰이 집중되어 훨씬 더 높은 Gini index 값을 보였습니다. 따라서, 특정 도메인의 문제 해결에 최적화된 도메인 expert가 존재하고, 모델이 이러한 도메인 expert를 상황에 따라 적절하게 선별하여 사용한다는 것을 한 번 더 확인할 수 있었습니다.
MoE의 구조의 Long Context 이해 능력
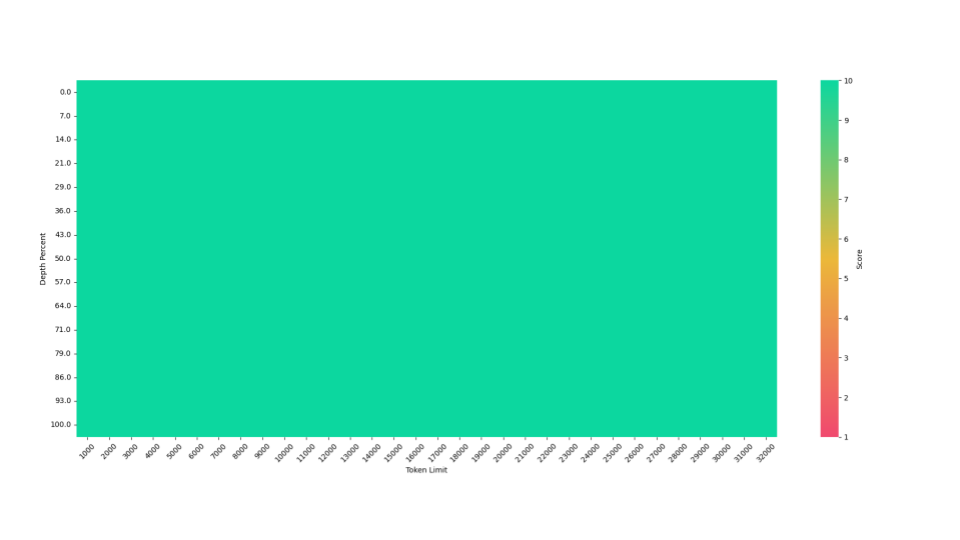
수많은 expert를 갖는 MoE 구조가 모델에 담을 수 있는 지식의 총량을 효과적으로 늘릴 수 있음은 앞 결과들로부터 확연히 알 수 있었습니다. 이러한 구조적 이점이 긴 문맥(Long Context)을 이해하는 능력의 확장으로도 이어질 수 있는지 확인하고자 추가적인 학습을 진행해주었습니다. Kanana LLM 1.5 개발기에서 소개되었던 방법을 따라, 기존에 8K 길이로만 학습되었던 모델이 32K 이상 길이에도 대응할 수 있도록 하기 위해 긴 데이터들의 비중을 높여 추가로 소량의 학습을 진행해주었습니다. 이때, Long Context 확장에 최적화된 새로운 외부 데이터들은 전혀 사용하지 않고, 두번째 pre-training stage에서 사용한 데이터들을 재사용하되 길이가 긴 데이터들의 샘플링 비중만 늘려주는 간단한 방식으로도 MoE 모델의 Long Context 이해 능력이 충분히 향상될 수 있었습니다(그림 7). 따라서 MoE 모델 구조가 단순히 저장할 수 있는 지식의 양을 늘리는 것을 넘어 긴 문맥을 이해하고 처리하는 데도 효과적임을 알 수 있었습니다.
4) Post-Training
Overview
저희는 Pre-training에 이어서 MoE 모델이 인간의 지시를 따를 수 있도록 Post-training을 수행했습니다. 저희는 MoE 모델 개발과 함께 Post-training 파이프라인을 재설계하여 성능 향상과 학습 효율성이라는 두 가지 목표를 달성하고자 하였습니다. 이 과정에서 주로 변경된 지점들을 다음 3가지로 요약 할 수 있습니다.
- Staged RL로 수렴시점 문제해결
- Grouped GEMM 도입으로 MoE 연산 병목 해소
- 크기가 작은 모델들에 대해 On-policy distillation을 적용
Staged RL로 수렴 시점 문제 해결
25년 5월에 발표된 저희 이전 블로그 포스트를 보면 SFT 이후 RL을 수행할 때 정답을 명확히 맞춰야 하는 수학, 코딩 등의 태스크들은 RL with Verifiable Reward (RLVR)을, General conversation에 가까운 태스크들은 RL with Generative Reward Model (RLGRM)을 적용했다는 것을 확인 할 수 있습니다.
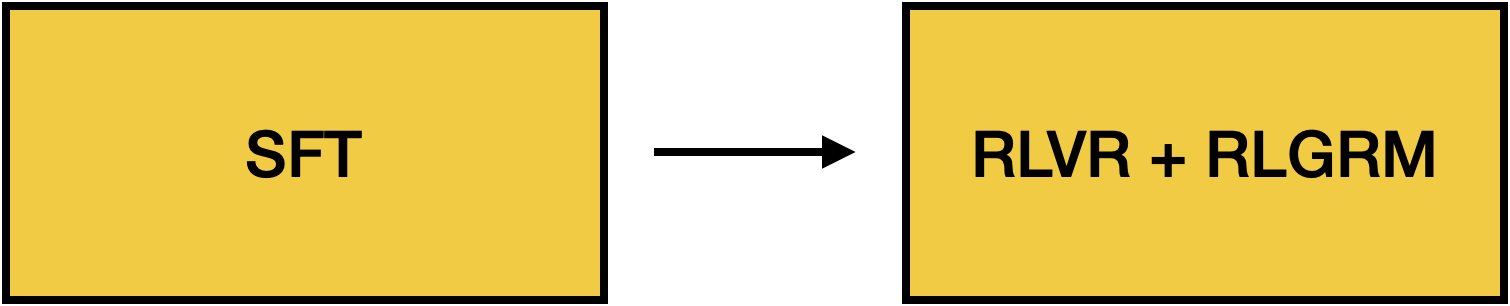
그러나 이 두가지 훈련 방법을 동시에 사용했을 경우 각각 최적의 성능을 얻게되는 지점이 다르다는 문제가 존재했습니다. 예를 들어 RLGRM은 약 500 스텝 근처에서 최적의 성능을 얻은 후 점점 성능이 하락하지만 RLVR은 약 2000 스텝 근처에서 최적의 성능을 얻는 시나리오를 생각해 볼 수 있습니다.
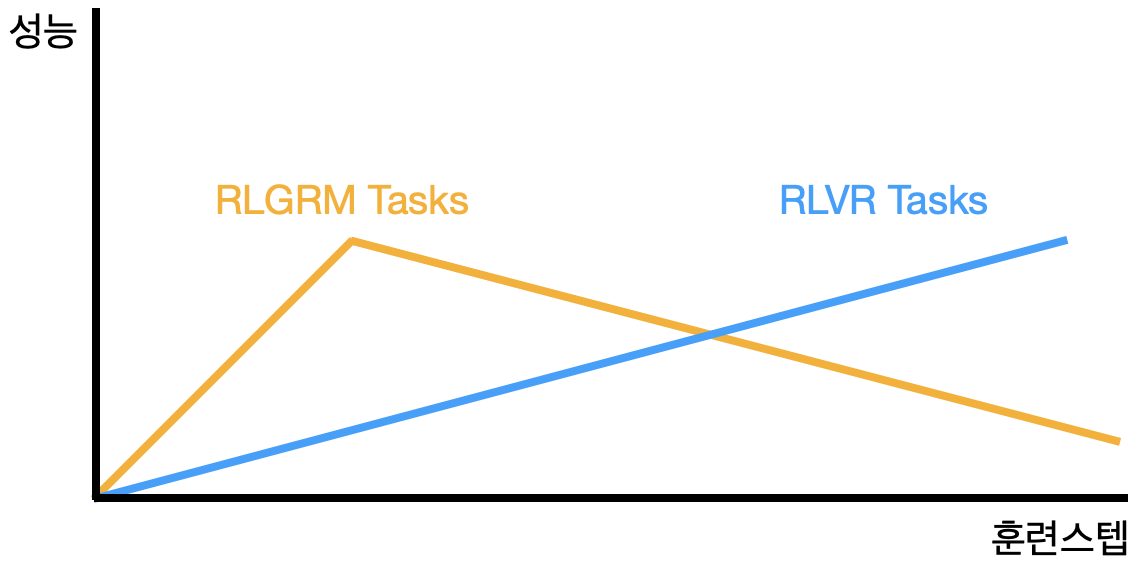
이러한 문제를 해결하기 위해 저희는 RLVR과 RLGRM을 구분해서 따로 훈련하는 Staged RL 파이프라인을 설계하였습니다. 먼저 SFT 훈련을 거친 후 RLVR과 관련 태스크들을 훈련하도록 하고, 마지막으로 RLGRM과 관련 태스크들을 훈련합니다. 이렇게 파이프라인을 변경함으로써 두가지 영역 모두에서 최적의 성능을 확보할 수 있었습니다.
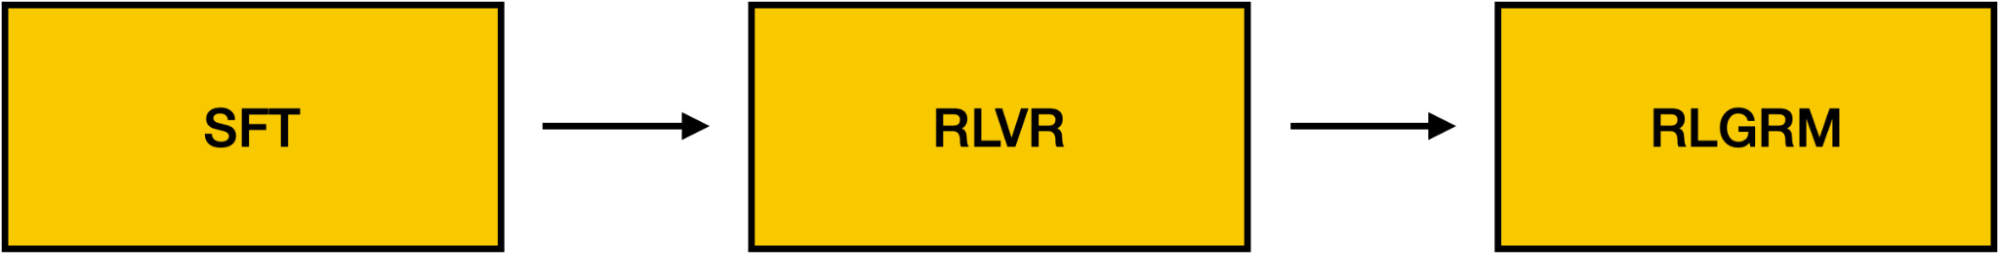
또한 이러한 Staged RL 파이프라인을 MoE 모델에 적용했을때도 Dense 모델과 동일하게 RLVR과 RLGRM 모두에서 일관된 성능 향상을 관찰할 수 있었으며, MoE active 3B 모델에 동일한 훈련 파이프라인을 거치면 Dense 8B 모델과 거의 유사한 성능을 얻을 수 있다는 것 역시 실험적으로 관찰할 수 있었습니다.
Grouped GEMM 도입으로 MoE 연산 병목 해소
이번에 MoE 모델을 Post-training 하면서 저희가 느낀 큰 허들 중 하나는 바로 긴 훈련 시간이었습니다. Megatron-LM [19]과 같은 Pre-training 프레임워크는 MoE 아키텍처에 대해 고도로 최적화되어 있지만 Open-RLHF [20], verl [21]과 같은 Post-training 프레임워크에서는 대부분 Hugging Face Transformers [22]의 구현체를 사용하곤 합니다.
그러나 Hugging Face Transformers의 MoE는 아래 코드조각처럼 각 Expert를 루프를 통해 순차적으로 호출함으로써 GPU 자원을 비효율적으로 사용하도록 구현되어 있는데, 저희는 이 구간이 전체 훈련에서 가장 큰 병목지점이라는 것을 확인하였습니다.
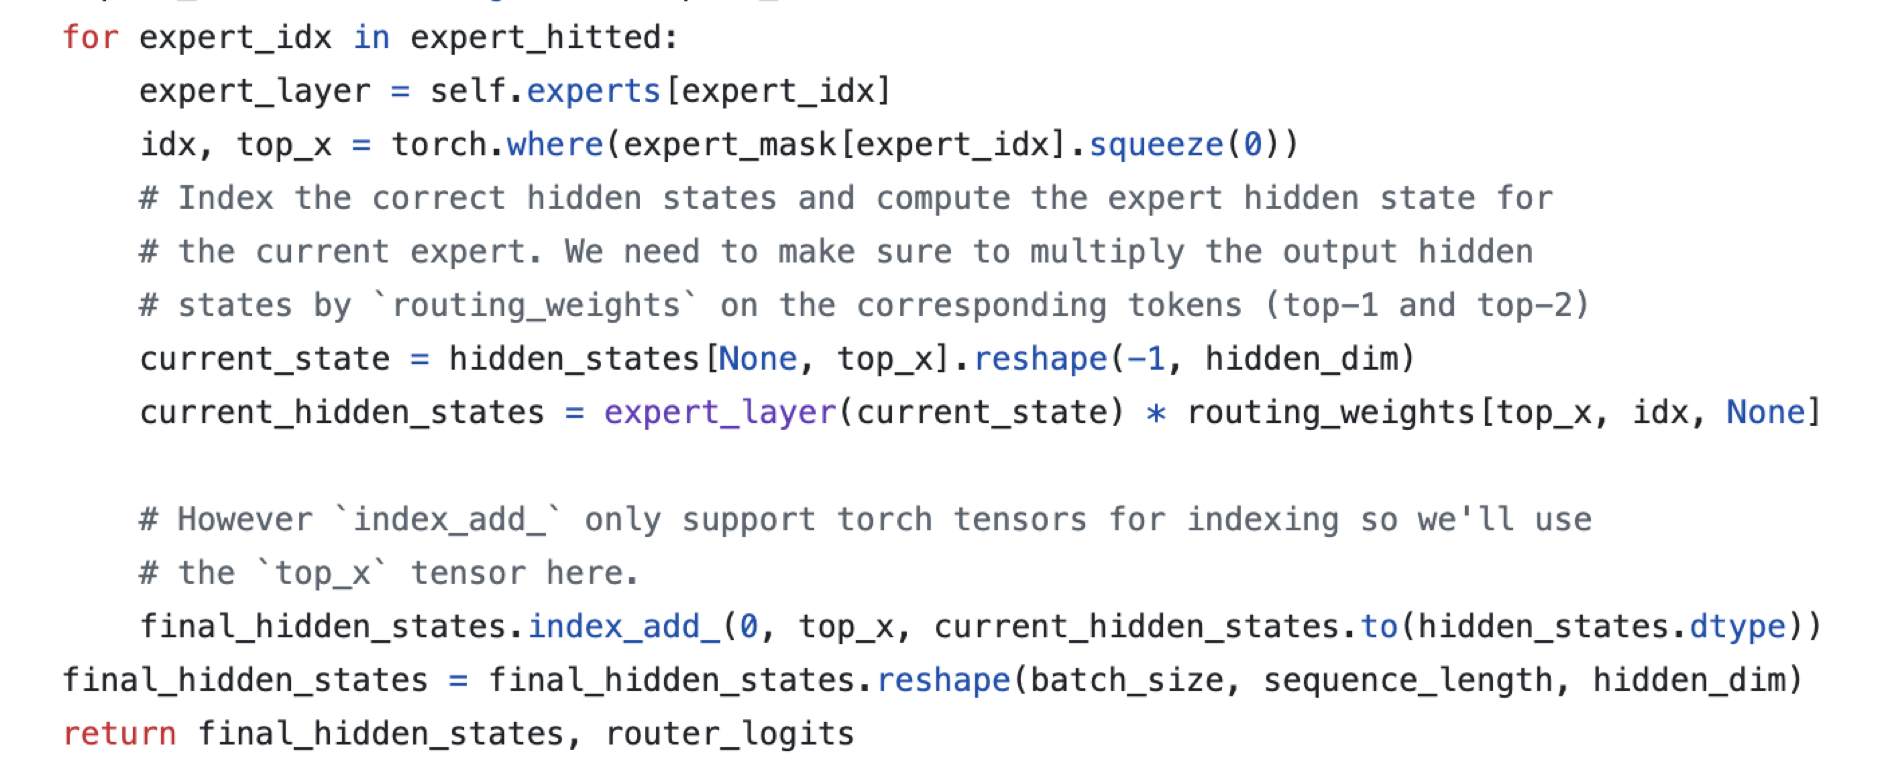
이를 개선하기 위해 저희는 하나의 Batched 연산으로 여러 Expert를 병렬적으로 처리할 수 있는 Grouped GEMM 커널을 Post-training에 도입함으로써, MoE 연산을 이전보다 효율적으로 처리할 수 있게 되었습니다.
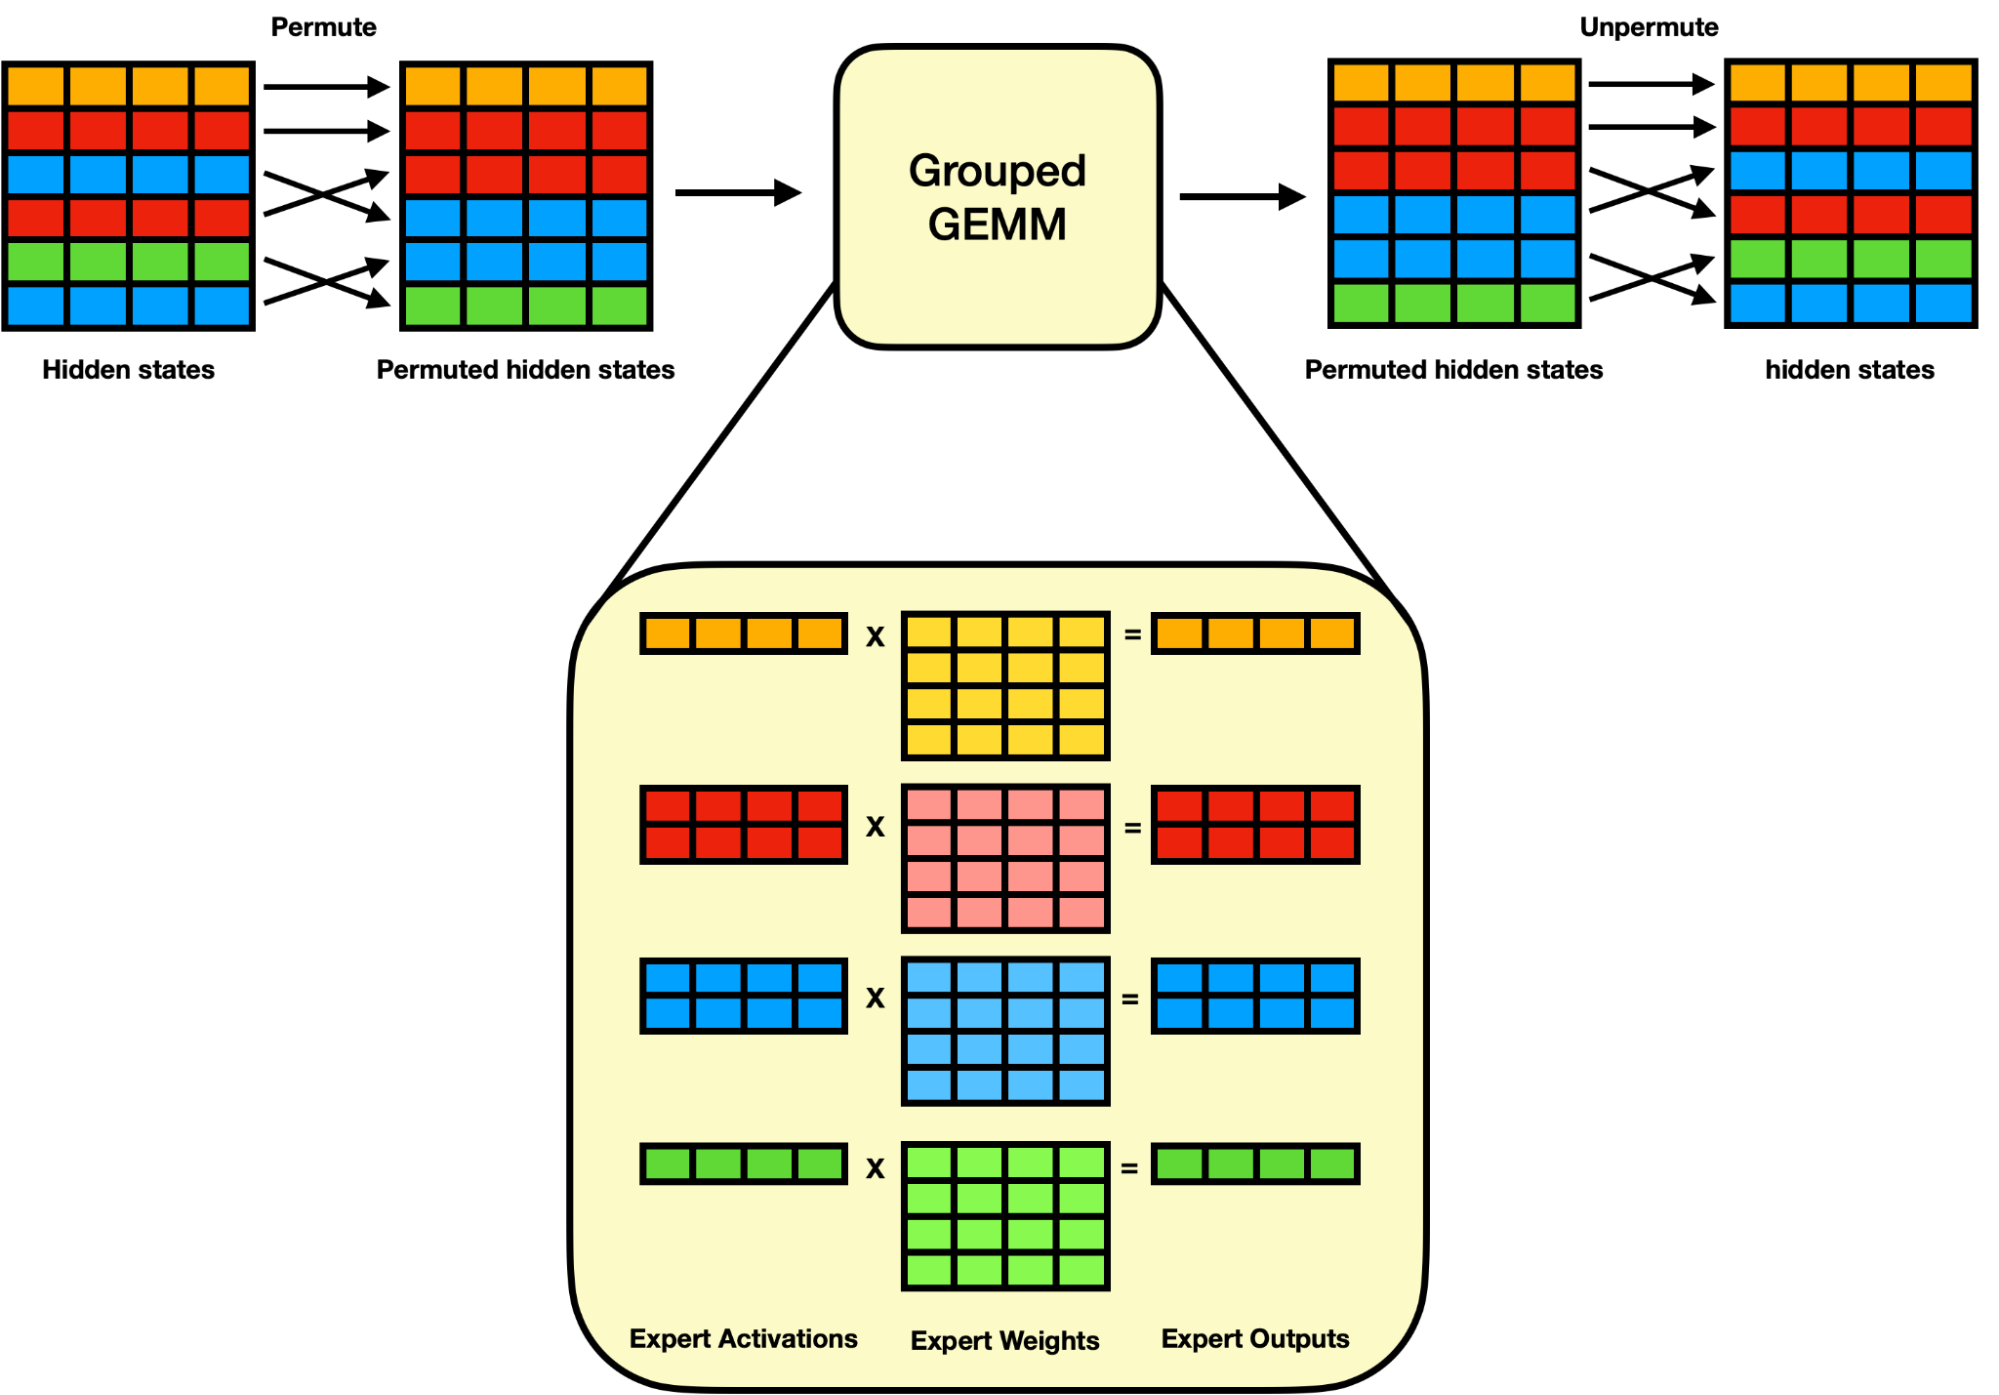
Grouped GEMM 커널은 NVIDIA의 Cutlass [23]와 같은 라이브러리에서도 이미 고성능 커널로 구현되어 검증되었고, 저희는 이러한 오픈소스 커널을 직접 분석하고 저희 MoE 모델 구조에 맞게 통합하였습니다.
이러한 최적화 덕분에 기존 Hugging Face Transformers 구현 대비 최대 10배 이상 빠른 training throughput을 달성하였으며, 대규모 실험을 수시간 내에 반복 수행하는 것이 가능해졌습니다. 이를 통해 보다 다양한 ablation, 하이퍼파라미터 튜닝 등이 가능하게 되었습니다.
크기가 작은 모델들에 대해 On-policy distillation을 적용
추가로 저희는 MoE 모델의 성능을 더욱 향상시키기 위해, Qwen3 technical report [4]에서 소개되었던 On-policy distillation [24]을 도입하여 후속 실험을 진행하였습니다.
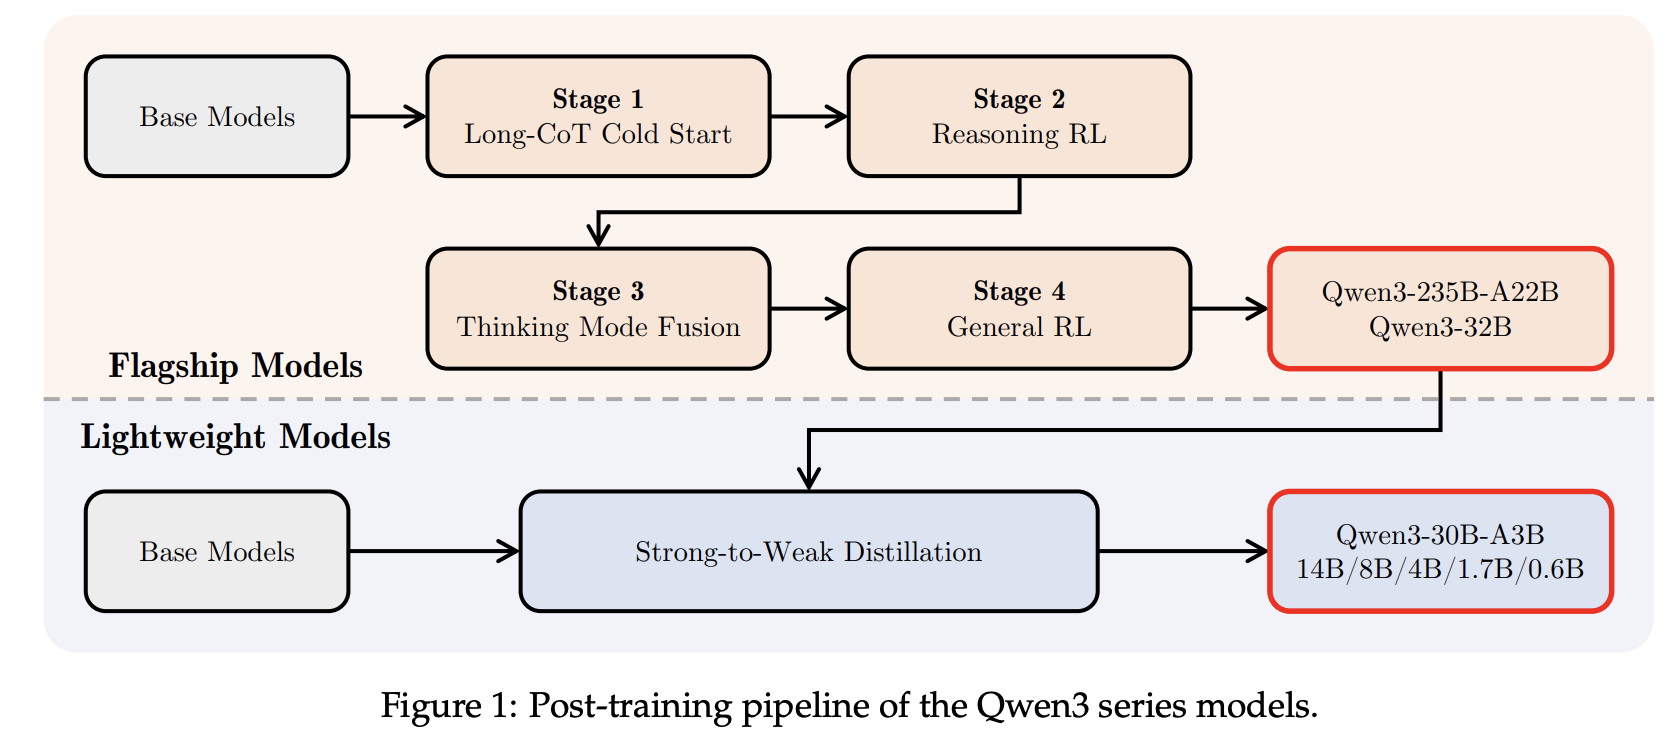
On-policy distillation은 아래 그림과 같이, Student 모델로 응답을 생성한 뒤, 해당 응답에 대한 Student와 Teacher 모델의 Logit 분포 간 KL-divergence를 최소화하는 방식의 훈련입니다. 이 방식은 전통적인 Offline distillation과 달리 Student 모델이 실제 생성한 응답을 기반으로 이루어지는 Online 훈련이라는 점에서 차별화되는데, Student 모델이 자주 탐색하는 분포에 집중하여 Teacher의 지식을 효과적으로 전달할 수 있다는 장점이 있습니다.
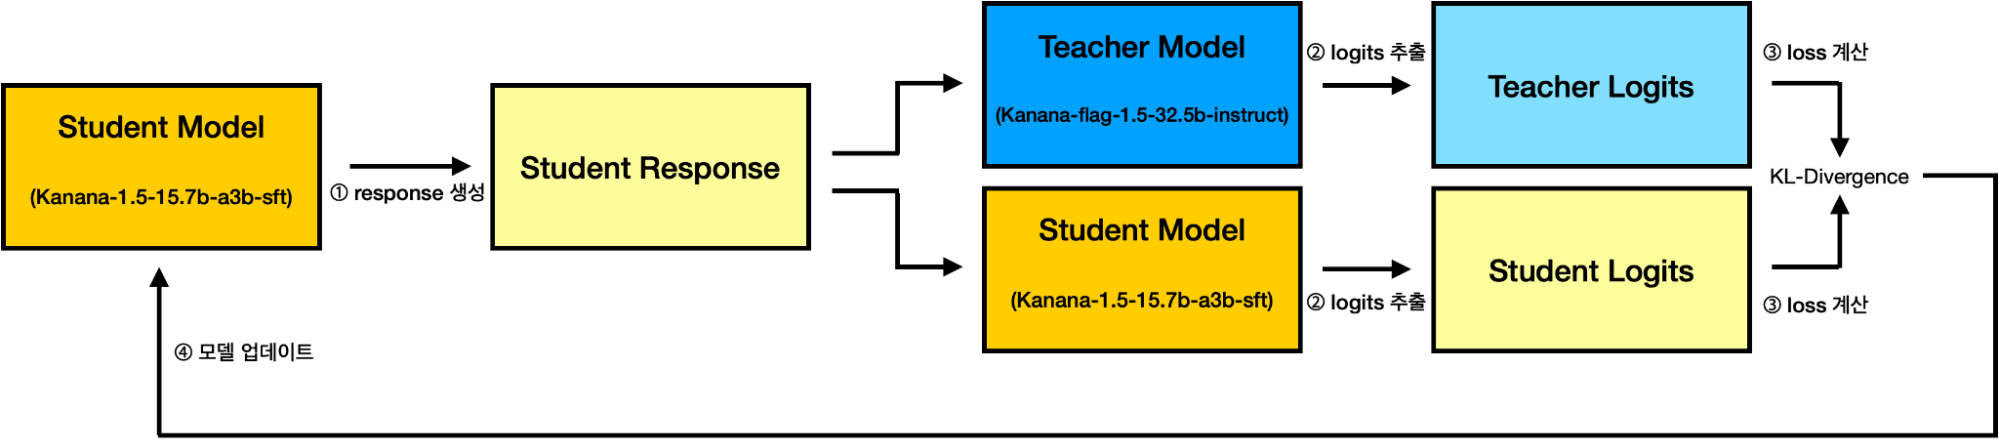
저희는 Student로 Kanana-1.5-15.7B-A3B의 SFT 모델을 사용하였고, Teacher로는 이전 블로그 포스트에서 소개드린 Kanana-Flag-1.5-32.5B-Instruct를 사용하여 On-Policy distillation 실험을 수행하였습니다.
Qwen3 technical report에 따르면, 작은 크기의 모델에서는 이러한 Distillation만으로도 RL보다 더 나은 성능을 보일 수 있다고 보고된 바 있습니다. 실제로 저희의 실험에서도 수학 및 코딩 태스크에서는 RL 모델 대비 의미 있는 성능 향상을 확인할 수 있었습니다. 다만, General conversation 영역에서는 기대했던 만큼의 개선은 확인되지 않았습니다.
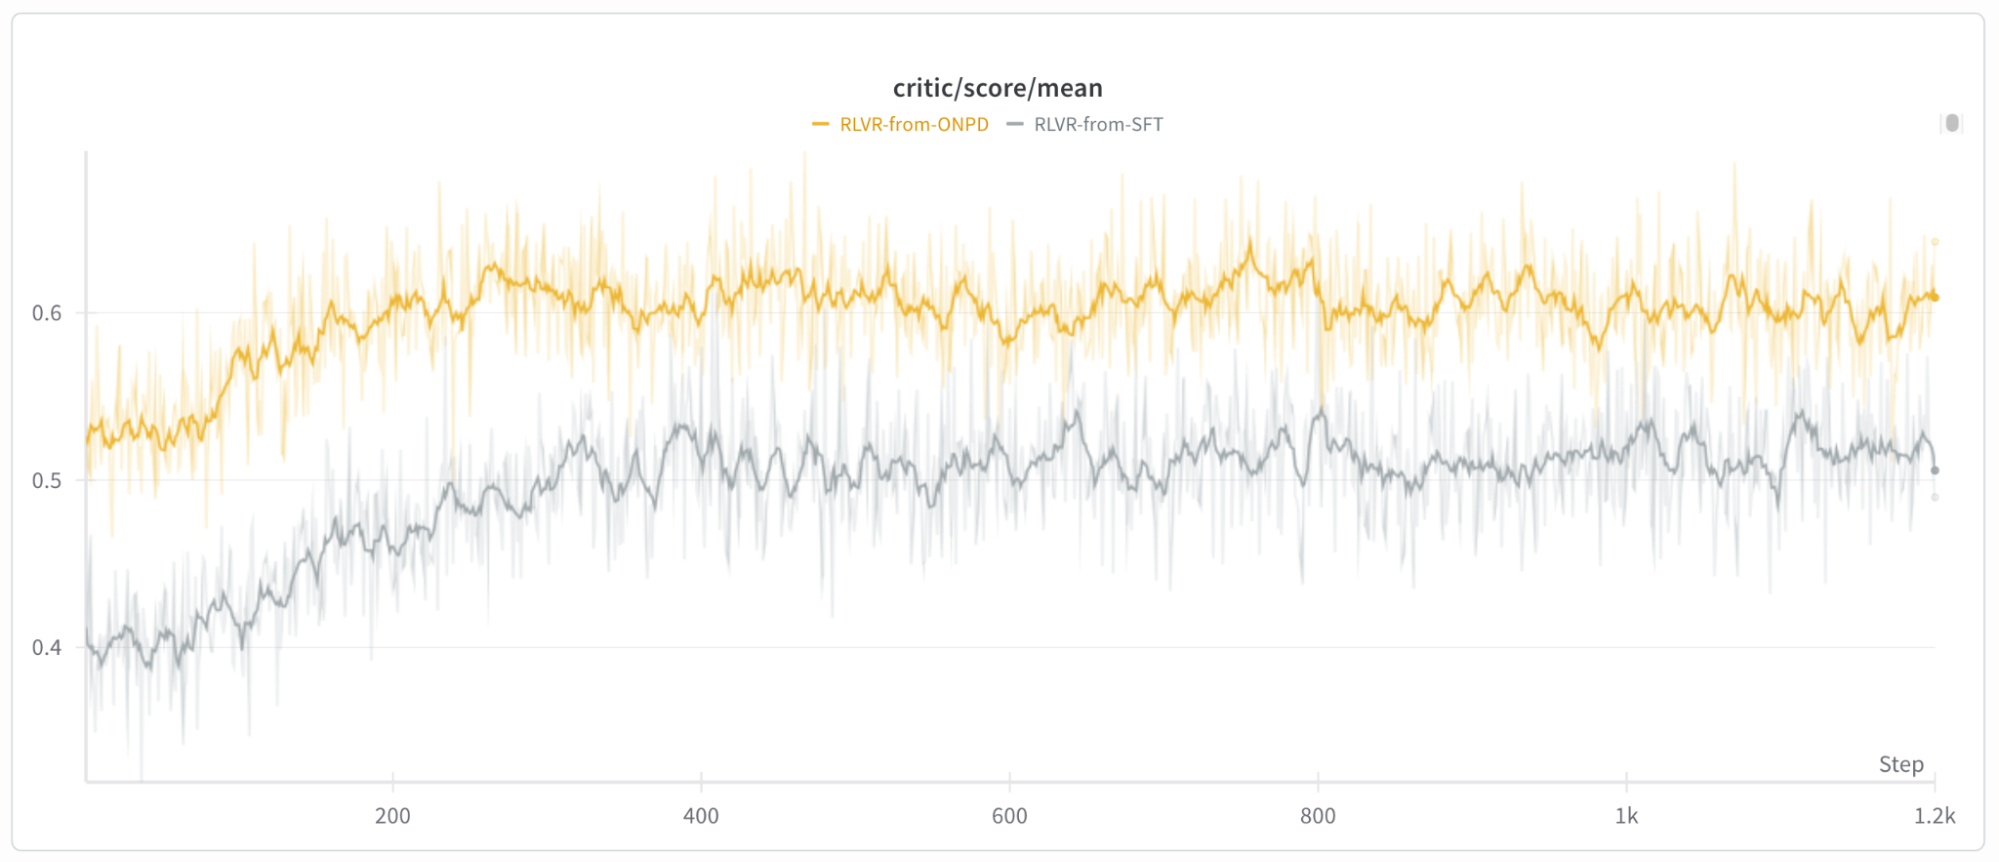
On-policy distillation만으로는 부족한 General conversation 성능을 더욱 끌어올리기 위해 저희는 Distillation된 모델을 초기 정책(initial policy)으로 추가적인 RL 훈련을 수행하였습니다. 위 그림처럼 Distillation된 모델은 기존 SFT 모델에 비해 훨씬 더 우수한 초기 정책을 제공하므로 동일한 RL 환경에서 빠르게 수렴하고 최종 성능 역시 더 높은 수준에서 안정화되는 경향을 확인할 수 있었습니다.
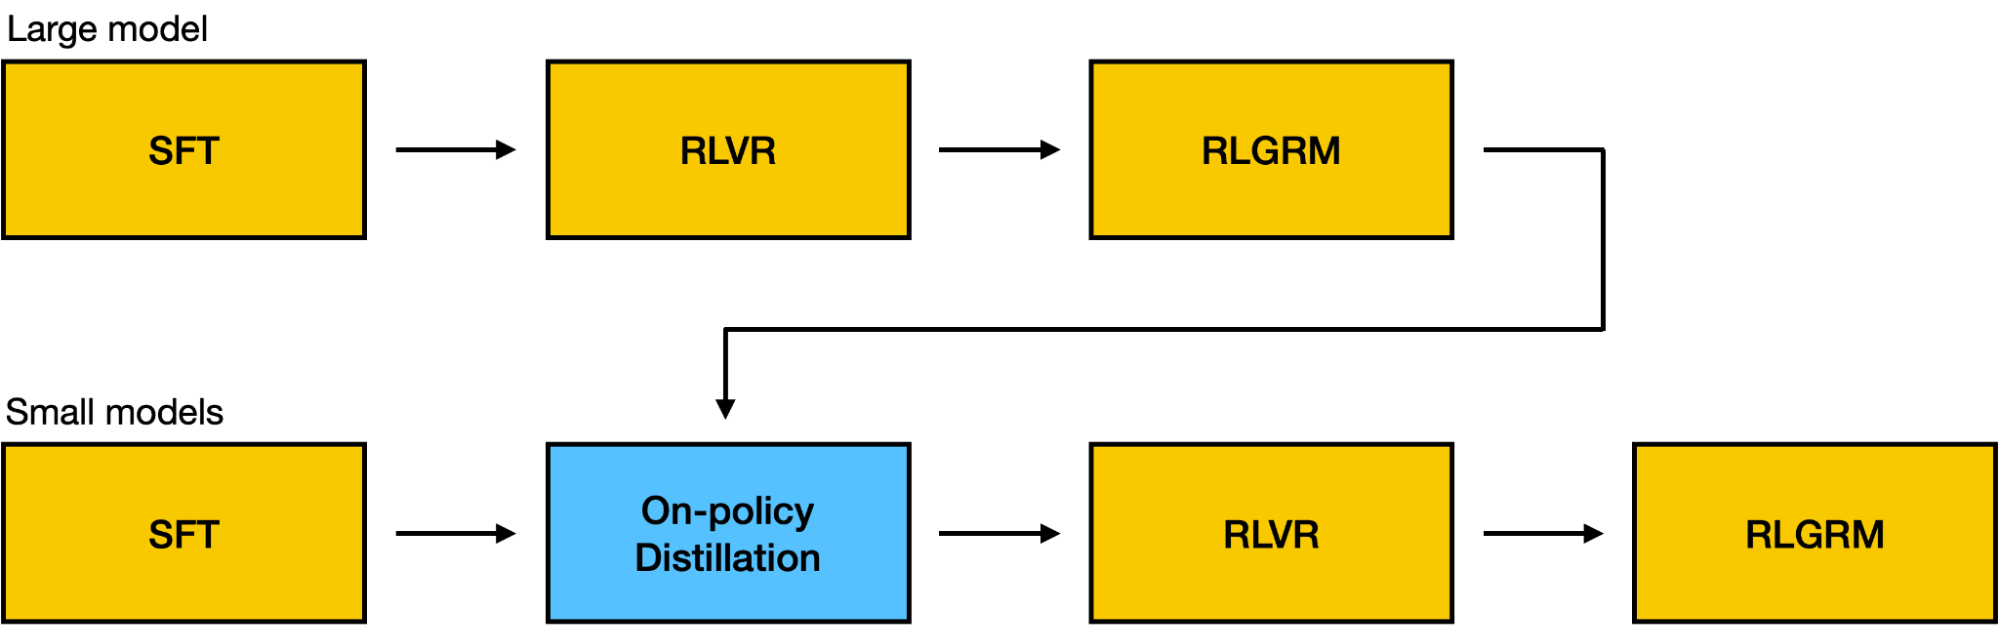
저희는 위 그림처럼 크기가 큰 모델에는 SFT → RLVR → RLGRM의 3단계 훈련 파이프라인을 적용하고, 크기가 작은 모델에는 SFT → On-policy Distillation → RLVR → RLGRM과 같은 4단계 훈련 파이프라인을 적용하였습니다. 결과적으로 크기가 작은 모델에 대해서 4단계 훈련 파이프라인을 적용하면 기존 3단계 파이프라인으로 훈련하는 것에 Math, MBPP 등의 Verifiable downstream task에서 뚜렷한 성능 향상을 얻을 수 있다는 것을 확인할 수 있었습니다.
결과
앞서 설명드린 세가지 주요 변화와 함께 추가적인 데이터 개선을 거쳐 Kanana-1.5-15.7B-A3B-Instruct 모델이 완성되었습니다. Kanana-1.5-15.7B-A3B-Instruct는 추론시 사용되는 파라미터의 수는 적지만 많은 수의 Expert안에 Dense 32.5B 모델로부터 증류된 방대한 지식을 보유하고 있기 때문에 실서비스 측면에서 매우 효율적인 모델이라고 할 수 있습니다.
| Models | MT-Bench | KoMT-Bench | IFEval | HumanEval+ | MBPP+ | GSM8K | MATH |
|---|---|---|---|---|---|---|---|
| Kanana-Nano-1.5-3B-Instruct | 7.01 | 6.52 | 70.08 | 70.73 | 64.29 | 80.36 | 56.70 |
| Kanana-1.5-8B-Instruct | 7.76 | 7.63 | 80.11 | 76.83 | 67.99 | 87.64 | 67.54 |
| Kanana-1.5-15.7B-A3B-Instruct(without on-policy distill) | 7.63 | 7.31 | 75.21 | 78.66 | 67.72 | 83.55 | 61.02 |
| Kanana-1.5-15.7B-A3B-Instruct(with on-policy distill) | 7.67 | 7.24 | 73.35 | 79.27 | 70.37 | 83.02 | 66.42 |
위 테이블에서 Kanana-1.5-15.7B-A3b-Instruct는 3B 수준의 Active parameter만으로 Dense 8B 모델과 비슷한 성능을 보이며 On-policy distillation 훈련 이후에는 더 높은 성능을 얻을 수 있다는 것을 확인 할 수 있습니다.
마무리하며
Kanana-1.5-15.7B-A3B은 Kanana LLM에 MoE 구조 도입을 향한 첫걸음이었습니다. 이번 연구에서는 빠른 결과 확인을 위해 학습이 완료된 Dense 모델을 upcycling 하는 방식을 채택해주었으며, 적은 활성 파라미터만으로 추론 효율적인 모델을 만들 수 있는 MoE의 장점을 확인할 수 있었습니다. 또한, 작은 모델에서 효과적이었던 SFT → On-policy Distillation → RLVR → RLGRM 파이프라인이 MoE 모델에서도 성공적으로 적용이 가능함을 확인하였습니다. 이러한 연구 결과들을 기반으로 향후에는 Dense 모델에 비해 훨씬 빠른 속도로 목표 성능 도달이 가능한지 확인하고자 MoE 모델을 처음부터 학습하는 (from-scratch) 방향의 연구를 진행하고 있습니다.
더 나아가, 추론 효율성을 넘어 글의 서두에서 언급했던 MoE 구조의 또 다른 강점인 초대형 언어 모델로의 확장 가능성에 주목하여, 차세대 Kanana 모델 개발에서는 이러한 MoE 모델의 스케일업에 대한 연구를 본격적으로 추진하고 있습니다.
저희 Kanana LLM 팀은 앞으로도 국내 LLM 생태계의 발전을 선도하며, 글로벌에서 경쟁할 수 있는 독자적인 기술력 확보를 향해 계속 나아가겠습니다. 감사합니다.
Appendix
Evaluation protocol은 아래와 같습니다.
- base
- MMLU, KMMLU, HAE-RAE: 5-shot, log-likelihood
- HumanEval: 0-shot, pass@1
- MBPP: 3-shot, pass@1
- GSM8K: 5-shot, exact-match (strict-match)
- instruct
- MT-Bench, KoMT-Bench: 0-shot, gpt-4o-2024-08-06 as judge model
- IFEval: 0-shot, mean of strict-prompt-level and strict-instruction-level
- HumanEval+, MBPP+: 0-shot, pass@1
- GSM8K, MATH: 0-shot, rule-based verification
Acknowledgements
- Language Model Training
mat.mul,chloe.py,json.bourne,juliet.bak,lambda.xprime,louie.m,ryan.u,sean.ai,terry.uh,wavy.jung
- Multimodal Model
loophy.cc
참고 문헌
[1] Fedus, William, Barret Zoph, and Noam Shazeer. “Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity.” Journal of Machine Learning Research 23.120 (2022): 1-39.
[2] Shazeer, Noam, et al. “Outrageously large neural networks: The sparsely-gated mixture-of-experts layer.” arXiv preprint arXiv:1701.06538 (2017).
[3] Liu, Aixin, et al. “Deepseek-v3 technical report.” arXiv preprint arXiv:2412.19437 (2024).
[4] Yang, An, et al. “Qwen3 technical report.” arXiv preprint arXiv:2505.09388 (2025).
[5] Meta AI. “The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation.” Meta AI, 5 Apr. 2025, https://ai.meta.com/blog/llama-4-multimodal-intelligence.
[6] Jiang, Albert Q., et al. “Mixtral of experts.” arXiv preprint arXiv:2401.04088 (2024).
[7] Yang, An, et al. “Qwen2 technical report, 2024.” htts://arxiv.org/abs/2407.10671 7 (2024): 8.
[8] Komatsuzaki, Aran, et al. “Sparse upcycling: Training mixture-of-experts from dense checkpoints.” arXiv preprint arXiv:2212.05055 (2022).
[9] He, Ethan, et al. “Upcycling large language models into mixture of experts.” arXiv preprint arXiv:2410.07524 (2024).
[10] Zoph, Barret, et al. “St-moe: Designing stable and transferable sparse expert models.” arXiv preprint arXiv:2202.08906 (2022).
[11] Bi, Xiao, et al. “Deepseek llm: Scaling open-source language models with longtermism.” arXiv preprint arXiv:2401.02954 (2024).
[12] Liu, Aixin, et al. “Deepseek-v2: A strong, economical, and efficient mixture-of-experts language model.” arXiv preprint arXiv:2405.04434 (2024).
[13] Hendrycks, Dan, et al. “Measuring massive multitask language understanding.” arXiv preprint arXiv:2009.03300 (2020).
[14] Son, Guijin, et al. “Kmmlu: Measuring massive multitask language understanding in korean.” arXiv preprint arXiv:2402.11548 (2024).
[15] Son, Guijin, et al. “Hae-rae bench: Evaluation of korean knowledge in language models.” arXiv preprint arXiv:2309.02706 (2023).
[16] Cobbe, Karl, et al. “Training verifiers to solve math word problems.” arXiv preprint arXiv:2110.14168 (2021).
[17] Chen, Mark, et al. “Evaluating large language models trained on code.” arXiv preprint arXiv:2107.03374 (2021).
[18] Austin, Jacob, et al. “Program synthesis with large language models.” arXiv preprint arXiv:2108.07732 (2021).
[19] Shoeybi, Mohammad, et al. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism” arXiv preprint arXiv:1909.08053 (2019).
[20] Hu, Jian, et al. “OpenRLHF: An Easy-to-use, Scalable and High-performance RLHF Framework” arXiv preprint arXiv:2405.11143 (2024).
[21] Sheng, Guangming, et al. “HybridFlow: A Flexible and Efficient RLHF Framework” arXiv preprint arXiv:2409.19256v2 (2024).
[22] Wolf, Thomas, et al. “HuggingFace’s Transformers: State-of-the-art Natural Language Processing” arXiv preprint arXiv:1910.03771 (2019).
[23] NVIDIA, “CUDA Templates for Linear Algebra Subroutines” https://github.com/NVIDIA/cutlass (2017)
[24] Agarwal, Rishabh, et al. “On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes” arXiv preprint arXiv:2306.13649 (2023)
[25] Zheng, Lianmin, et al. “Judging llm-as-a-judge with mt-bench and chatbot arena.” Advances in neural information processing systems 36 (2023): 46595-46623.
[26] Research, L. G., et al. “EXAONE 3.0 7.8 B Instruction Tuned Language Model.” arXiv preprint arXiv:2408.03541 (2024).
[27] Zhou, Jeffrey, et al. “Instruction-following evaluation for large language models.” arXiv preprint arXiv:2311.07911 (2023).
[28] Liu, Jiawei, et al. “Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation.” Advances in Neural Information Processing Systems 36 (2023): 21558-21572.
[29] Hendrycks, Dan, et al. “Measuring mathematical problem solving with the math dataset.” arXiv preprint arXiv:2103.03874 (2021).