Data
웹로그 히스토리 데이터를 이용한 데이터 분석 꼼수
2021년 6월 18일
원문에서 보기 ↗뉴딥기술랩에서 수행하고 있는 여러 유형의 데이터 처리/분석 작업들 중 간단하지만 다른 분야에서도 유용하게 활용할 만한 내용인 듯하여 공유해 드립니다.
안녕하십니까? 뉴딥기술랩/데이터테크랩/BI분석서비스팀을 담당하고 있는 임지홍입니다. 오늘은 데이터를 좀 더 풍부하게 만들어 분석을 용이하게 만드는 방법을 한 가지 예시를 들면서 설명드리려 합니다. 어떤 서비스를 운영하면서 아래와 같이 사용자의 페이지를 방문 이력을 저장하고 있다고 가정을 해보겠습니다. 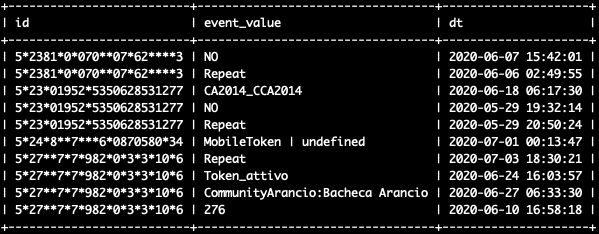
이 데이터를 이용해서 몇 명이 방문하고 있고 어떤 페이지를 많이 보더라는 지표도 뽑아보고 chart도 그려가며 데이터에 익숙해지다 보니 문득 다음과 같은 것들이 궁금해질 경우가 생기게 됩니다.
방문자들이 내 사이트에 접속하면 보통 몇 개의 페이지를 볼까? 한 페이지 당 얼마나 머무를까?

페이지 이동 중 가장 체류를 오래 하는 페이지는? 혹은 가장 이탈이 심한 페이지는 어딜까?
처음부터 이러한 것도 관측할 것이다라고 판단하고 이를 처리할 수 있도록 세션정보 같은 데이터(로그) 스펙을 만들어 놓았으면 바로 분석이 가능했겠지만 아쉽게도 위의 테이블의 정보가 전부입니다.
그렇다고 어떤 것을 분석할지 모르는 막연한 상황에서 마구잡이로 스펙을 미리 정해놓는다는 것은 어려운 일이기도 하고요.
이번 글에서는 이런 상황에서 갖고 있는 데이터 만으로 세션정보를 만들어 보는 과정을 설명해 볼까 합니다.
서비스의 세션 타임아웃이 10분이라는 가정을 전제로 현재 이벤트의 시간을 이전 이벤트의 시간과 비교해서 차이가 10분 이내면 같은 세션이고 10분 이상이면 다른 세션이다라고 판단할 수 있는 데이터를 만드는 작업을 진행해 보겠습니다.
(물론 이 가정은 오류가 많겠지만 그래도 없는 것보다는 있는 게 좋으니까요 ^^;;)
우선 이전 시간과 비교를 하려면 이전 event의 dt를 가져와야겠죠?
select
    id, event_value, dt, lag(dt) over (partition by id order by dt) as prev_dt
from
    event_context_history
DB마다 약간은 차이가 있지만 문법을 말로 설명해보면, "id로 부분 그룹핑을 한 후 그 그룹 내에서 dt로 정렬한 파티션을 만들어 놓고 그곳에서 현재 row보다 이전 row(lag)의 dt를 가져와라"입니다. 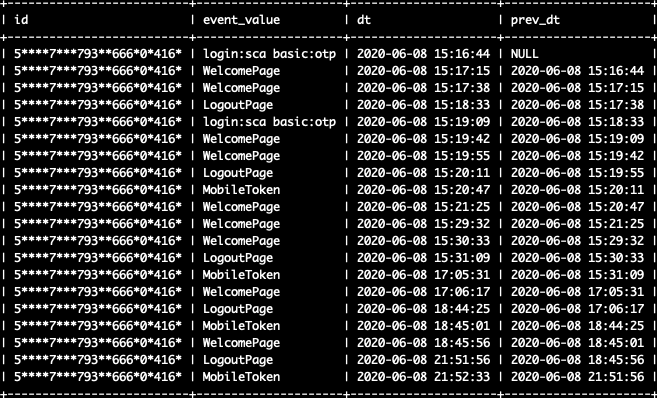
이전 이벤트의 시간을 가져와 봤습니다. 이전 이벤트가 없다는 것은 session의 시작이라고 판단해도 될 것 같습니다. 여기에 시간 차가 얼마나 얼마나 나는지 확인해 보면,
select
    *, nvl(unix_timestamp(dt) - unix_timestamp(prev_dt), 0) as diff
from (
    select
        id, event_value, dt, lag(dt) over (partition by id_id order by dt) as prev_dt
    from
        event_context_history
) a
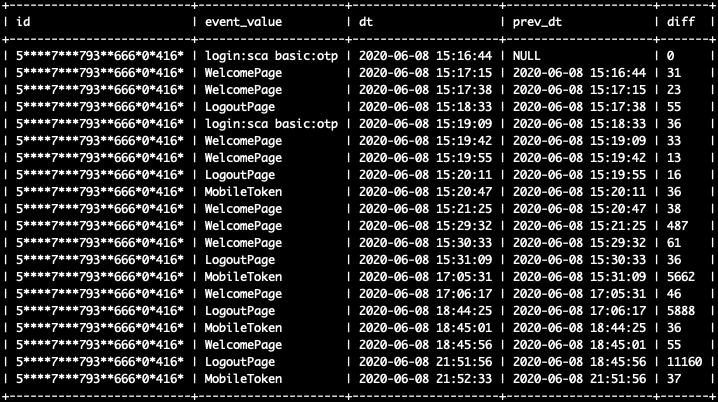
이렇게 표현이 될 테고요.
다음 부분이 핵심일 것 같은데요...
아까 세션 타임아웃을 10분이라고 잡았으니 diff 값이 600(초)을 넘으면 새로운 세션이라고 판단할 수 있도록 데이터를 만들어 보겠습니다.
select
    id, event_value, dt, diff,
    sum(case when diff < 600 then 0 else 1 end) over (partition by id order by dt) as session_id
from (
    select
        *, nvl(unix_timestamp(dt) - unix_timestamp(prev_dt), 0) as diff
    from (
        select
            id, event_value, dt, lag(dt) over (partition by id_id order by dt) as prev_dt
        from
            event_context_history
    ) a
) b
이전과 비슷한 방식으로, id로 파티션을 생성하고 시간 차가 600초 이상 날 때마다 session_id값을 1씩 늘려가며 row마다 누적 값을 기록하는 꼼수?입니다.
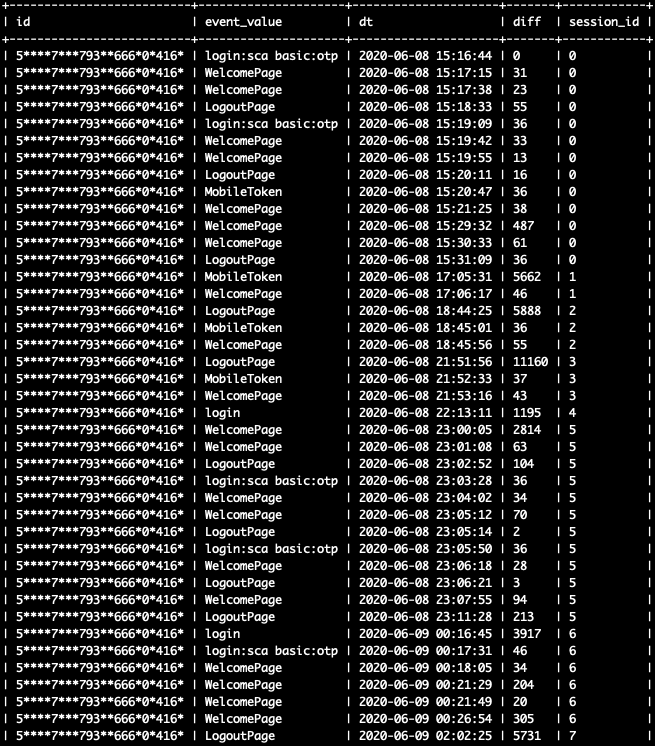
앞의 이벤트와 600초 이상 차이 날 때마다 session_id값이 1씩 늘어나는 것을 볼 수 있습니다.
이 사용자는 6월 8일부터 6월 9일까지 8번을 방문했다고 예측할 수 있고 꼼꼼하게 로그아웃을 하고 있는 것을 알 수 있게 되었으며 더 나아가 사용자들이 한 번 접속했을 때 얼마 정도 머무르는지 어떤 이동패턴을 보이는지 분석해 볼 수 있게 되었습니다.
다음과 같이 시각화해서 좀 더 우아하게 페이지 패턴을 분석할 수도 있게 되었고요. 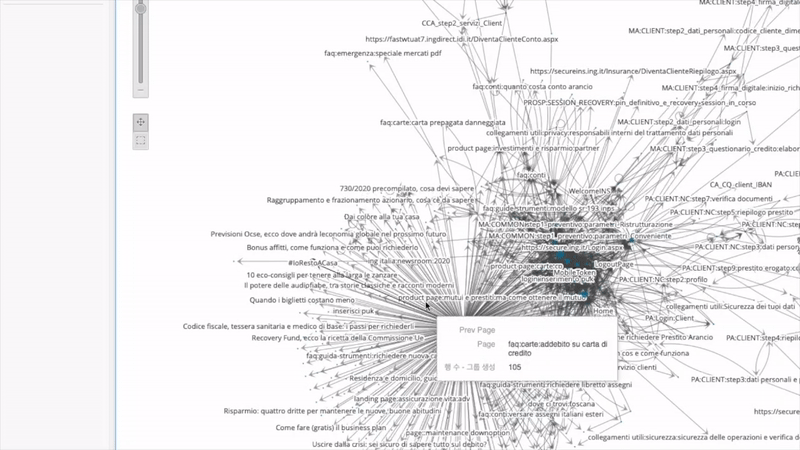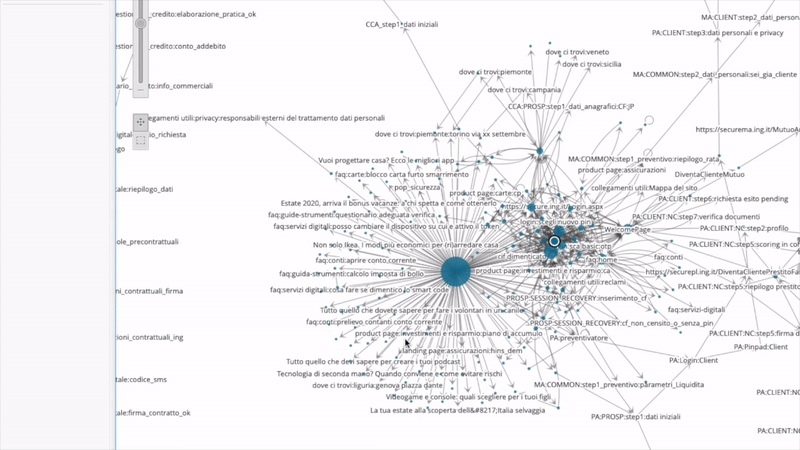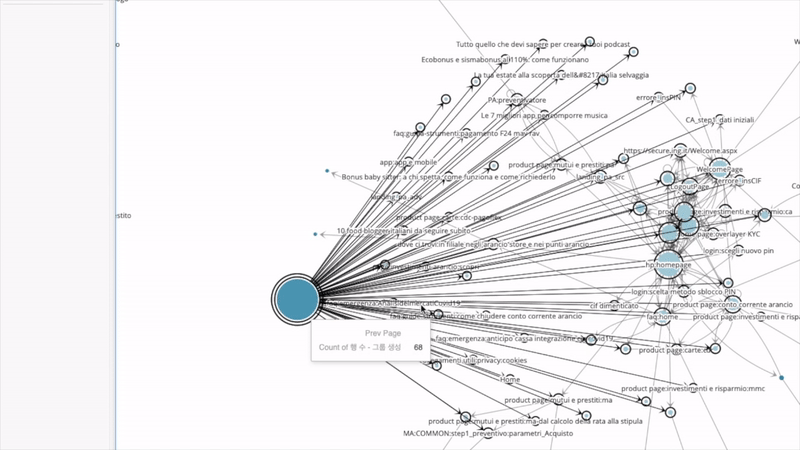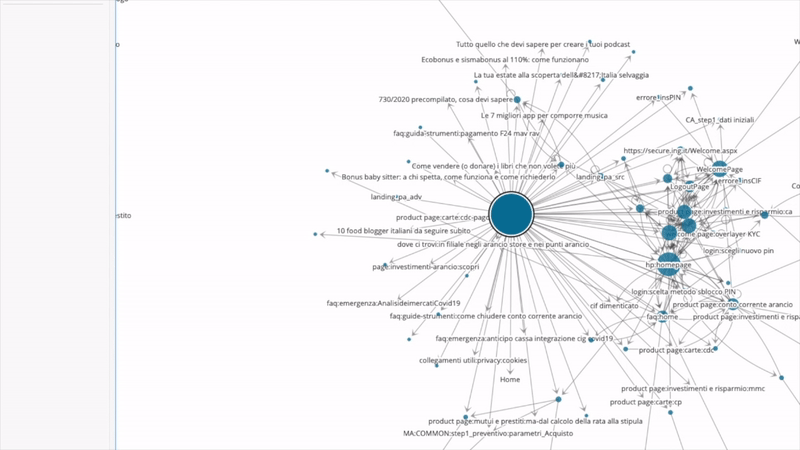
테이블화 되어 있지 않아 SQL을 쓰지 못하거나 DB에 담지 못하는 대용량 데이터를 처리해야 하는 경우라도 유사한 방식을 spark 등을 통해 아래와 같이 처리할 수 있고요.
from pyspark.sql import functions as F
from pyspark.sql.window import Window

session_window = Window.partitionBy("id").orderBy("dt")
pg_df = pageName_df.withColumn("prev_event", F.lag(pageName_df.context_value).over(session_window))
pg_df = pg_df.withColumn("prev_dt", F.lag(pageName_df.dt).over(session_window))
pg_df = pg_df.withColumn("diff", (F.unix_timestamp(pg_df.dt)-F.unix_timestamp(pg_df.prev_dt)))
m1_df = pg_df.withColumn("session_group", F.sum(F.when(pg_df.min_diff < 600, 0).otherwise(1)).over(session_window))

m1_df.select("id", "prev_dt", "dt", "diff", "session_group").show()
처음부터 갖가지 사항을 고려하여 스펙(스키마)을 만드는 것이 이런 수고를 덜 수 있는 가장 좋은 방법이겠지만 그렇지 못한 경우라도 상상력?을 발휘하여 부족한 부분을 보충하면서 insight를 넓혀 나갈 수 있는 경우도 종종 있어 이런 사례를 통해 유사한 상황이 발생했을 경우 도움이 될까 하여 공유드려 봅니다.
긴 글 읽어 주셔서 감사합니다.