Engineering
지도 서비스(Reverse Geocoding)내재화 이야기
서창균Ocean(오션) / 랭킹추천개발팀여기어때
2024년 12월 10일
원문에서 보기 ↗Reverse Geocoding API 내재화 이야기
안녕하세요!
여기어때 검색추천개발실 오션 입니다.
저희가 진행한 Reverse Geocoding 내재화 프로젝트에 대해 이야기해보려고 합니다.
프로젝트의 시작
문제 상황
Reverse Geocoding은 여기어때 서비스 내부 기능 중 하나 입니다.
하지만 외부 API에 의존하다 보니 몇 가지 어려움이 있었습니다.
- 일 최대 N백만원의 API 사용 비용 발생
- 호출량 초과로 인한 서비스 중단 리스크 존재
이런 상황에서 “우리가 직접 만들면 어떨까?”라는 생각으로 프로젝트가 시작되었습니다.
신뢰할 수 있는 데이터 찾기
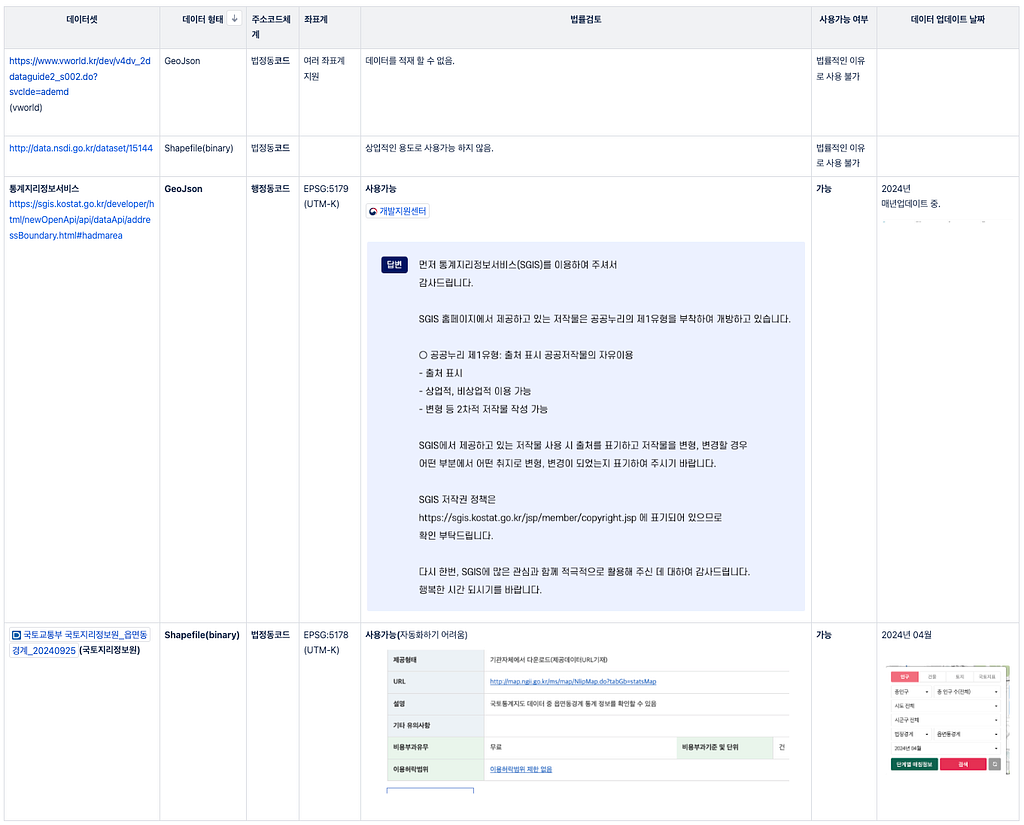
프로젝트의 첫 단추는 ‘데이터’였습니다. 아무리 좋은 시스템을 만들어도 데이터가 부정확하다면 모래성과 다름없겠죠? 저희는 여러 공공 데이터를 꼼꼼히 검토했습니다.
최종 선택: 통계지리정보서비스 데이터
법정동 vs 행정동
혹시 법정동과 행정동이 다르다는 걸 아시나요?
- 법정동: 1914년부터 이어온 전통적인 주소 체계
- 행정동: 실제 주민센터가 관리하는 현대적인 행정 단위
재미있는 사실: 서울 종로구의 경우 법정동은 87개나 되지만, 행정동은 단 17개 입니다!
프로토타입 개발 과정
1차 시도: Elasticsearch와 함께 한 데이터 검증
첫 단계: 친숙한 도구로 시작하다
검색실에서 이미 사용 중이던 Elasticsearch를 첫 시도의 도구로 선택했습니다. 새로운 도구를 도입하는 대신, 이미 잘 알고 있는 도구를 활용하기로 했죠.
왜 Elasticsearch였나요?
- 손쉬운 데이터 처리
-
GeoJSON 형식의 데이터를 약간의 가공으로 색인가능
-
지리 정보 처리 기능 제공
- 직관적인 API
-
빠른 개발 및 테스트 가능
-
쿼리를 통한 즉각적인 결과 확인 용이(외부 API와의 결과값 비교 용이)
검증의 중요성
이 단계에서 가장 중요했던 것은 우리가 만들 서비스가 기존 외부 API와 동일한 수준의 정확도를 제공할 수 있는지 확인하는 것이었습니다.
Elasticsearch는 이러한 초기 검증 단계에서 완벽한 도구였습니다.
다음 단계로
검증을 성공적으로 마친 후, 이제 더 효율적이고 최적화된 해결책을 찾아 나설 차례였습니다.
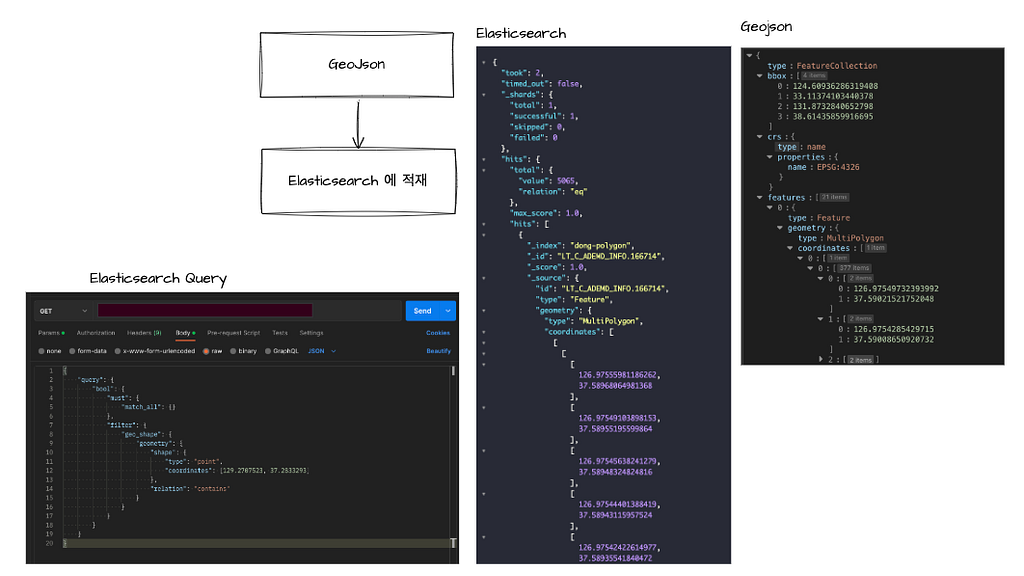
Elasticsearch를 활용한 검증 FLOW
2차 시도: GeoHash 활용하여 개선하기
Elasticsearch를 사용하지 않으면서 “더 가볍고 빠르게 만들 수 없을까?” 라는 고민에서 시작된 두 번째 여정은 GeoHash를 사용해 보았습니다.
GeoHash란?
지구를 바둑판처럼 격자로 나누고, 각 공간을 문자열로 표현하는 방식입니다. 예를 들어 “wydm9qx”라는 문자열 하나로 특정 위치를 정확하게 찾을 수 있죠. 마치 우리가 우편번호로 주소를 찾는 것처럼요!
우리의 선택
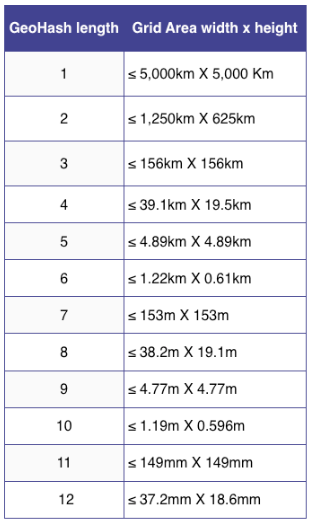
정확도와 성능의 균형을 위해 Level 8을 선택했습니다. 이는 약 38m × 19m 크기의 오차범위(정확도)를 제공하는데요,
- 너무 높은 레벨: 불필요하게 많은 데이터 생성
- 너무 낮은 레벨: 부정확한 결과
- Level 8: 서비스 내에서 오차범위는 이정도면 된다는것을 내부 협의를 통해서 정의했습니다.
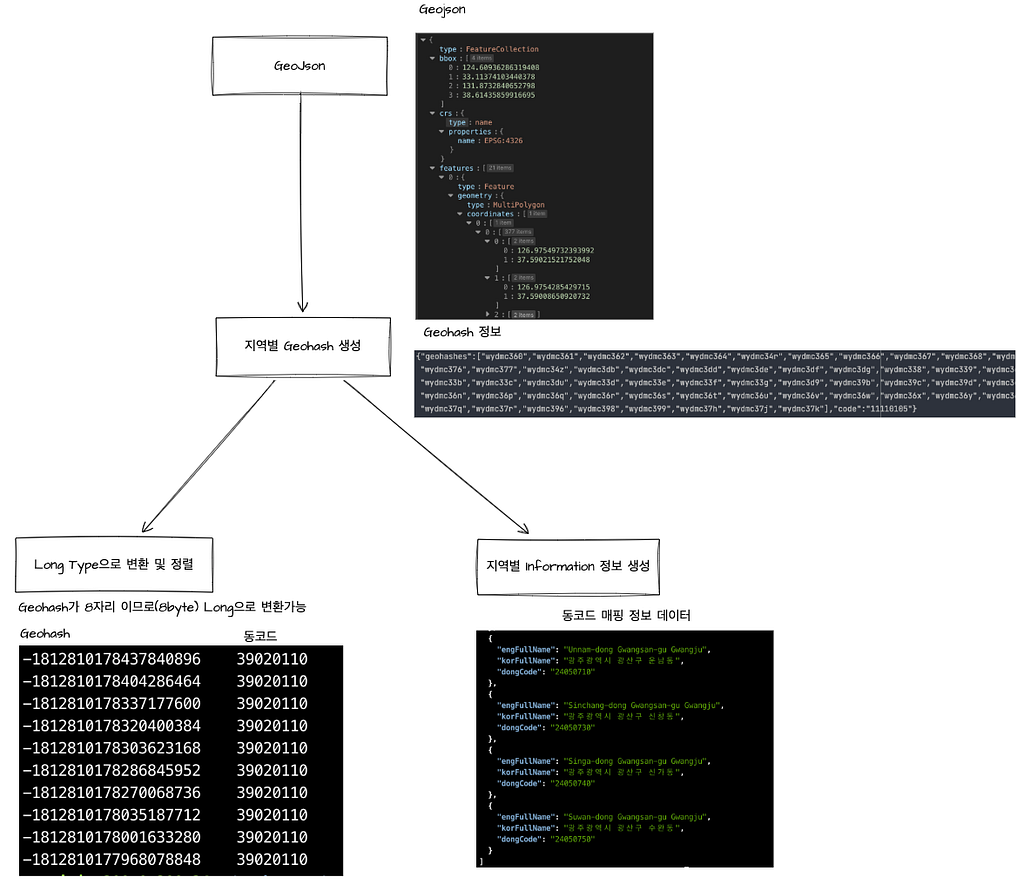
Geojson → GeoHash 변환 과정
해결해야 할 과제
처음 구현했을 때는 메모리 사용량이 무려 8GB! 마치 소형차에 대형 트럭용 엔진을 넣은 것 같은 상황이었죠. 최적화 작업(HashMap → Binary Search 변경)을 통해 4GB까지 줄이는데 성공했지만, 좌표에 대한 주소를 얻는 방식에서는 저장량이 비약적으로 늘어날 수 밖에 없는 구조라 비효율적인 것을 깨달았습니다.
3차 시도: Point In Polygon으로 찾은 해답
“더 단순하게 접근하면 어떨까?” 라는 생각으로 시작되었습니다.
Point In Polygon이란?
점이 다각형 안에 있는지 판단하는 알고리즘입니다.
마치 종이 지도 위에 연필로 점을 찍고 “이 점이 서울 안에 있나?” 확인하는 것처럼 직관적이죠!
좀 더 효율적인 Loop를 위해 지역 자르기
처음에는 전국의 모든 동을 하나하나 확인하는 방식으로 접근했는데요. 한 좌표의 위치를 확인하기 위해 전국 모든 행정동( 약 3,600 개)을 확인하는 것은 비 효율적이었습니다.
1단계 큰 지도를 17개의 핵심 권역으로 나눔
- 서울, 부산, 대구, 인천 등 광역시도 기준
- 각 권역은 고유한 바운딩 박스(외곽 경계)를 가짐
2단계 탐색 프로세스
- 1단계: 좌표가 속한 권역을 먼저 특정
- 2단계: 해당 권역 내의 동에 대해서만 상세 위치 확인
성능 테스트 결과
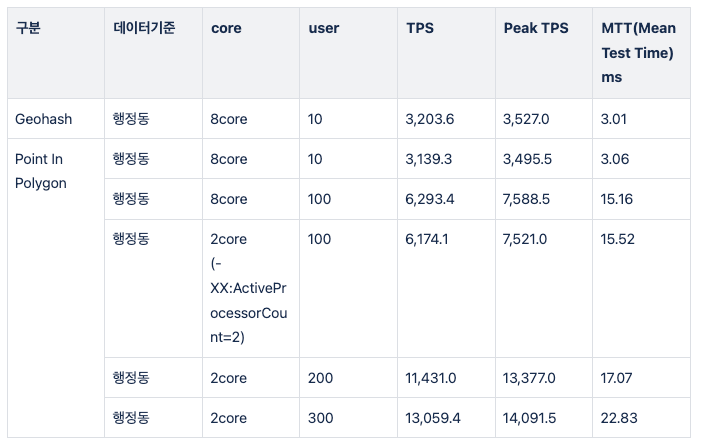
- Point In Polygon: 초당 3,100건 처리
- 부하 테스트 시 최대 13,000 TPS 달성!
- 메모리 사용량 2GB로 감소 🎉
- 성능은 그대로 유지
프로젝트 성과와 개선 효과 💫
비용 절감 효과
필요한 기능을 성공적으로 내재화하여 안정적인 운영과 비용 절감을 동시에 이루었습니다.
비용 비교 분석 (일일 50만건 호출 기준)
- 기존 외부 API (네이버/카카오) 연간 약 N억원 소요 (2월 기준 월 N백만원)
- 자체 개발 API (AWS 인프라 활용) 연간 약 N백만원 (4월 기준 월 N십 만원)
- 98% 비용 절감 효과 달성! 🎯
응답 시간 개선
- 기존 외부 API 대비 응답 지연 현상 완전 해소 평균 응답 시간: 1ms 이하 최대 응답 시간: 8ms
마치며
이번 프로젝트를 통해 외부 의존도는 줄이고, 서비스 안정성은 높일 수 있었습니다. 앞으로도 더 나은 서비스를 만들기 위해 노력하는 여기어때가 되겠습니다!
다음에는 더 재미있는 기술 이야기로 찾아뵙겠습니다.
읽어주셔서 감사합니다!