Data
밑바닥부터 시작하는 실시간 데이터 파이프라인 : Debezium 톺아보기
Yuni여기어때
2025년 6월 26일
원문에서 보기 ↗안녕하세요, 여기어때컴퍼니 공통플랫폼개발팀 유니입니다.
기존에는 데이터 웨어하우스에 일 또는 시간 단위 배치로 적재 했지만, 데이터를 더 빠르게 반영할 필요성이 커졌고, 이를 위해 CDC(Change Data Capture)를 도입하게 되었습니다. 결과적으로 CDC를 포함하여 다양한 서비스 운영과 분석에 필요한 실시간 데이터 파이프라인 구축을 목표로 하였습니다.
이번 글에서는 신입 데이터 엔지니어가 CDC를 구축하기 위해 밑바닥부터 낱낱이 분석한 CDC 오픈 소스 플랫폼 Debezium의 동작 과정을 다음과 같이 소개 드리려 합니다.
-
Debezium으로 로그 기반 CDC 구현하기
-
Kafka Connect와 Debezium 톺아보기
-
Debezium 실전 적용기
-
마무리하며
1. Debezium으로 로그 기반 CDC 구현하기
1️⃣ 변경 사항을 감지하는 방법
데이터베이스에서 발생한 변경 사항을 감지하는 방법에는 여러 가지가 있습니다. 별도의 테이블에 변경 내역을 저장하는 방식(Trigger 기반), 주기적으로 쿼리를 실행하여 이전 데이터와 비교하는 방식(Query 기반), 변경 시각을 컬럼에 남기고 비교하는 방식(Timestamp 기반)등 이 있습니다.
그중에서도 데이터베이스에서 내부적으로 변경 사항을 저장하는 트랜잭션 로그(e.g - MySQL의 binlog, PostgreSQL의 WAL)를 활용하는 로그 기반 CDC를 선택했습니다. 이 방식은 로그 파일을 읽어 처리하기 때문에 원본 데이터베이스에 부하를 적게 줍니다. 또한 트랜잭션 로그에는 최종 값뿐만 아니라 이전 값과 이후 값이 모두 기록되어 데이터의 최신 상태를 일관성 있게 유지할 수 있습니다.
2️⃣ Debezium
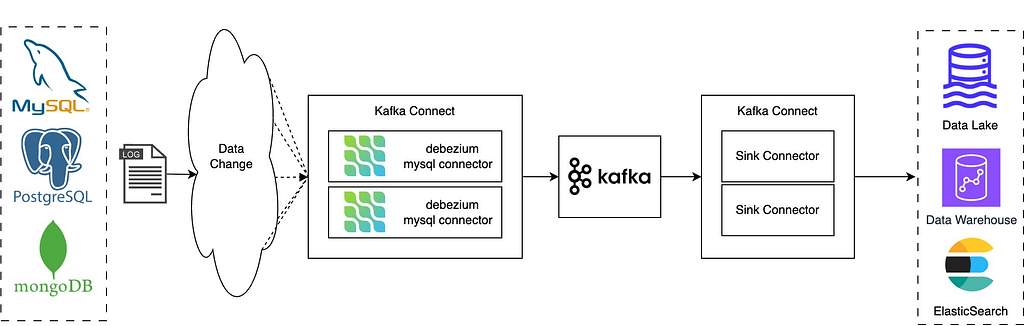
Debezium은 로그 기반 CDC를 지원하는 오픈소스 플랫폼으로, Kafka Connect 프레임워크 위에서 동작합니다. Debezium은 소스 커넥터로서 MySQL, PostgreSQL, MongoDB 등 다양한 데이터베이스의 트랜잭션 로그에서 변경 사항을 캡처해 Kafka로 스트리밍합니다.
이렇게 Kafka로 들어온 데이터는 Sink 커넥터를 통해 실시간으로 타겟 시스템으로 보내져, 데이터를 동기화합니다. 특히, 데이터 웨어하우스뿐만 아니라 여러 가지 다양한 시스템으로의 확장 가능성을 고려했을 때, Kafka 기반의 변경 데이터 스트리밍을 지원하는 Debezium이 적합한 선택이었습니다.
2. Kafka Connect와 Debezium 톺아보기
Debezium을 실행하려면 먼저 Kafka Connect 환경을 구성해야 합니다. Kafka Connect는 외부 시스템과 Kafka 간의 연계를 담당하며, 데이터를 외부에서 가져오거나 다른 시스템으로 전달할 수 있도록 돕습니다. Debezium은 Kafka Connect의 Source 커넥터로 동작하며, 데이터베이스의 변경 이벤트를 실시간으로 캡처해 Kafka로 전달 가능한 형태로 변환합니다. 따라서 Debezium을 효과적으로 활용하려면 Kafka Connect에 대한 기본적인 이해가 필요합니다.
2–1. Kafka Connect 톺아보기
Kafka Connect를 구성하는 요소는 크게 물리적인 단위와 논리적인 단위로 나뉘어집니다.
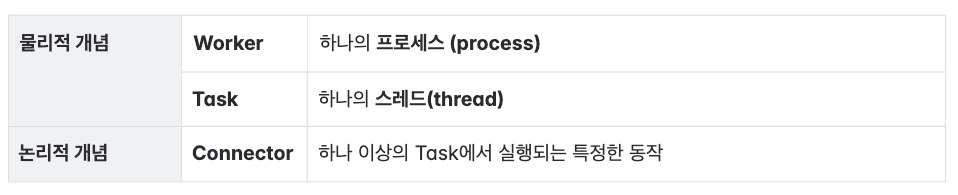
따라서 원하는 동작을 명시한 Connector를 등록하면, 1개 이상의 Task로 나누어져서 1개 이상의 Worker 위에서 동작하게 됩니다. Debezium은 바로 이 Task 에 해당하는 부분을 구현한 것입니다. 일반적으로 하나의 Connector는 여러 Task로 분산되어 동작하지만 Debezium MySQL Connector의 경우 이벤트 발생 순서 보장을 위해 Task의 개수를 1개로 제한하고 있습니다.
그럼 Kafka Connect 내에서 Debezium이 어떤 역할을 하는지 살펴보겠습니다. Kafka Connect에서 커넥터를 등록하면 Task가 생성되며, 각 Task는 execute() 함수를 실행한 후 종료될 때까지 while 루프를 통해 특정 작업을 반복합니다. Debezium은 바로 이 반복되는 동작을 구현한 플러그인 역할이 됩니다.
그렇다면, Debezium이 반복하는 작업은 무엇일까요?
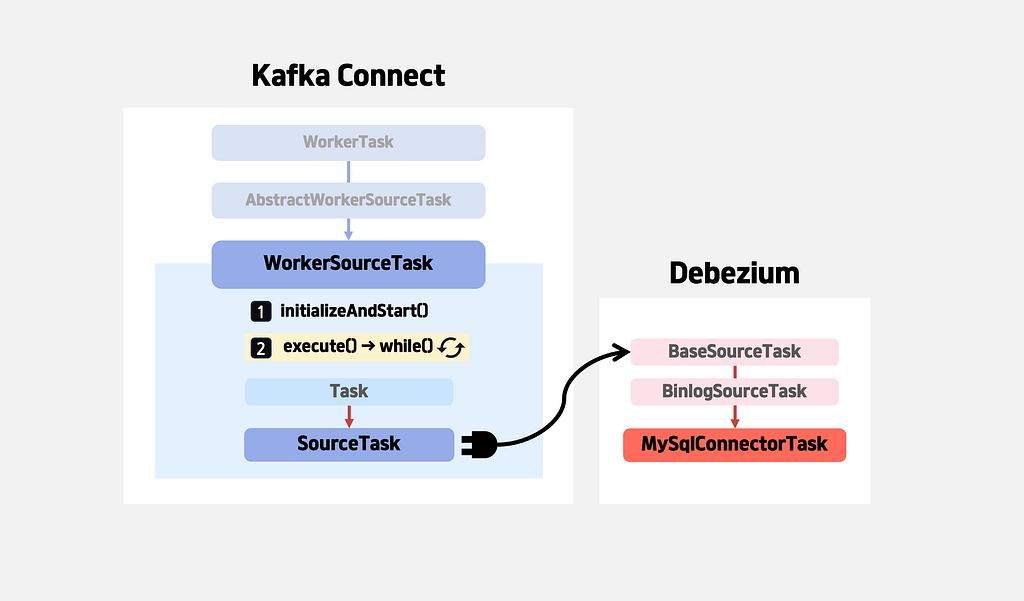
Kafka Connect의 AbstractWorkerSourceTask 클래스의 execute() 함수에서 주요한 부분만 모아 가져왔습니다.
@Override
public void execute() {
  try {
      while (!isStopping()) { ••••••••••••••••••(0)

        if (toSend == null) {
          toSend = poll(); •••••••••••••••••(1)

        if (sendRecords()) { •••••••••••••••••(2)
          batchDispatched();
        }
    }
  }
  finalOffsetCommit(false); ••••••••••••••••••••(3)
}
3단계로 나누어 살펴보면 다음과 같습니다.
- 종료 상태가 될 때까지 아래의 동작들을 반복합니다.
poll()함수로 무언가를 받아옵니다.
sendRecords()함수로 레코드를 어딘가로 보내고 있습니다.
finalOffsetCommit(): while문이 종료되면 오프셋에 대한 최종 커밋을 합니다.
정리하자면, 종료 상태가 될 때까지 무언가를 받아와 이를 어딘가로 보내는 작업을 반복하고 있다는 것을 알 수 있습니다. 무얼 받고, 또 그것을 어디로 보내는 것 일까요?
1️⃣ 1단계 : 가져오자
AbstractWorkerSourceTask의 poll() 함수의 내부를 살펴보면 SourceTask의 타입의 task에서 다시 poll() 함수를 호출하는 것을 확인할 수 있습니다. Debezium에서는 이 SourceTask를 상속받은 BaseSourceTask 클래스가 존재하며, 이 클래스에서는 poll() 함수 내에서 doPoll()이라는 함수를 다시 호출합니다.
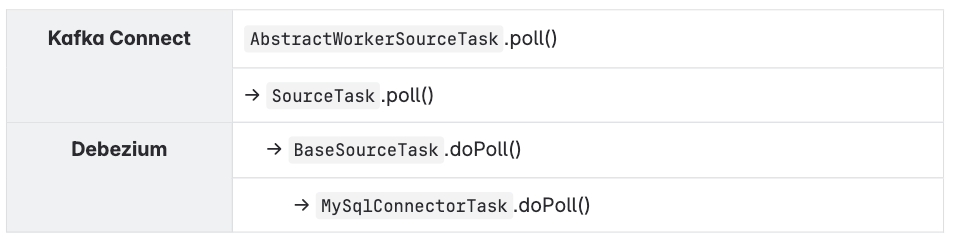
저희는 MySQL을 사용하기때문에 BaseSourceTask를 상속하는 MySqlConnectorTask의 doPoll() 함수를 살펴보겠습니다.
@Override
public List<SourceRecord> doPoll() throws InterruptedException {
    final List<DataChangeEvent> records = queue.poll();
    return records.stream().map(DataChangeEvent::getRecord).collect(Collectors.toList());
}
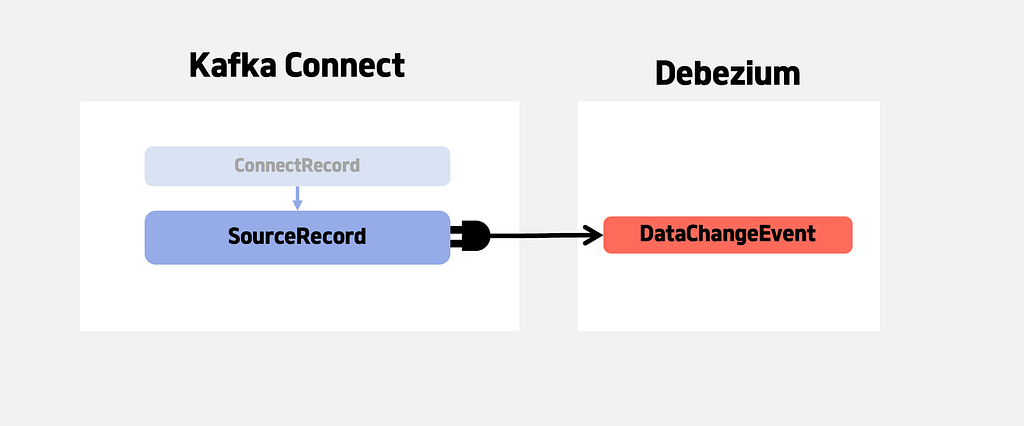
어떤 큐 에서 poll() 함수를 호출하여 이를 DataChangeEvent의 리스트에 담고 있습니다. 그리고 나서 이 리스트를 반환하는 작업이 이뤄집니다. 여기서 한가지 더 살펴봐야 하는 부분이 있습니다. doPoll() 함수의 반환 타입이 SourceRecord의 리스트인 것을 보면, Debezium에서는 SourceRecord가 DataChangeEvent, 즉 데이터 변경 이벤트 한 건에 해당한다는 것을 알 수 있습니다.
2️⃣ 2단계 : 보내자
다음으로 AbstractWorkerSourceTask에 sendRecords() 함수를 살펴보겠습니다. 마찬가지로 대부분의 내용을 제외하고 핵심 동작을 보면, ProducerRecord 타입의 항목을 producer.send() 함수를 통해 Kafka로 보내고 있는 것을 확인할 수 있습니다.
boolean sendRecords() {
    for (final SourceRecord preTransformRecord : toSend) {
        try {
            final String topic = producerRecord.topic();
            producer.send(producerRecord, (recordMetadata, e) -> { ... });
        }
    }
    return true;
}
그리고 이 ProducerRecord 안에는 Kafka 메시지를 보내기 위한 정보(=토픽명, 파티션 번호, 헤더, key, value, 타임스탬프)가 담겨있습니다.
public class ProducerRecord<K, V> {

    private final String topic;
    private final Integer partition;
    private final Headers headers;
    private final K key;
    private final V value;
    private final Long timestamp;
    ...
}
3️⃣ 3단계 : 기록하자
while 반복이 종료되고 나면 finalOffsetCommit() 함수가 실행되는 것을 확인할 수 있습니다. final이라는 표현을 보아 이전에도 오프셋 커밋 작업이 이뤄졌다는 것을 추측할 수 있습니다. 이전에 살펴보았던 sendRecords() 함수를 살펴보면 recordSent(preTransformRecord, producerRecord, recordMetadata); 를 확인할 수 있습니다.
producer.send(producerRecord, (recordMetadata, e) -> {
            recordSent(preTransformRecord, producerRecord, recordMetadata);
});
recordSent() 함수를 따라가보면 Debezium의 BaseSourceTask서 commitRecord() 함수를 찾을 수 있습니다. 오프셋 커밋 작업을 통해 Kafka에 데이터를 보낸 후 해당 파티션의 마지막 처리된 오프셋을 업데이트하여, 중복 처리나 데이터 손실을 방지하는 핵심 역할을 합니다.
@Override
public void commitRecord(SourceRecord record) throws InterruptedException {
    LOGGER.trace("Committing record {}", record);

    Map<String, ?> currentOffset = record.sourceOffset();
    if (currentOffset != null) {
        updateLastOffset(record.sourcePartition(), currentOffset);
    }
}
📍 전체 흐름 정리
소스 코드를 통해 Kafka Connect의 내부 동작을 하나씩 살펴보았습니다. 이제 이를 보다 직관적으로 이해할 수 있도록 전체적인 흐름을 그림으로 정리하였습니다. 각 단계에서 어떤 작업이 이루어지는지 함께 설명드리겠습니다.
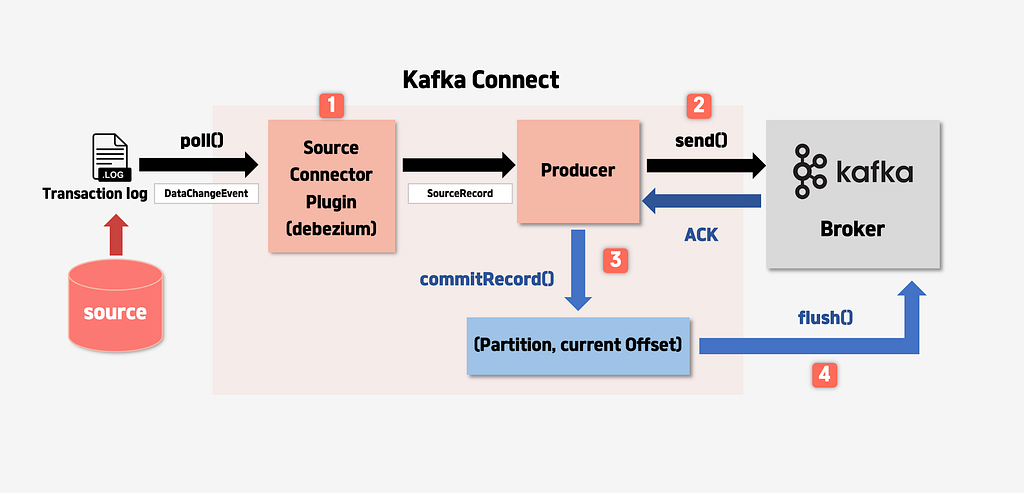
1. 루프가 반복될 때마다 Connector 플러그인이 Source로부터 데이터를 가져오며, 이 데이터는 SourceRecord 인스턴스로 변환됩니다. (Debezium의 경우 DataChangeEvent를 가져옵니다.)
2. 가져온 소스 레코드는 Kafka Producer를 통해 Kafka로 전송됩니다.
3. Kafka로부터 전송 성공(ACK)을 확인하면, Kafka Connect 는 해당 파티션의 최신 오프셋(offset) 값을 업데이트합니다.
4. 설정된
offset.flush.interval.ms주기마다flush()가 실행되며, 최신 오프셋 값이 Kafka에 저장됩니다.
2–2. Debezium 톺아보기
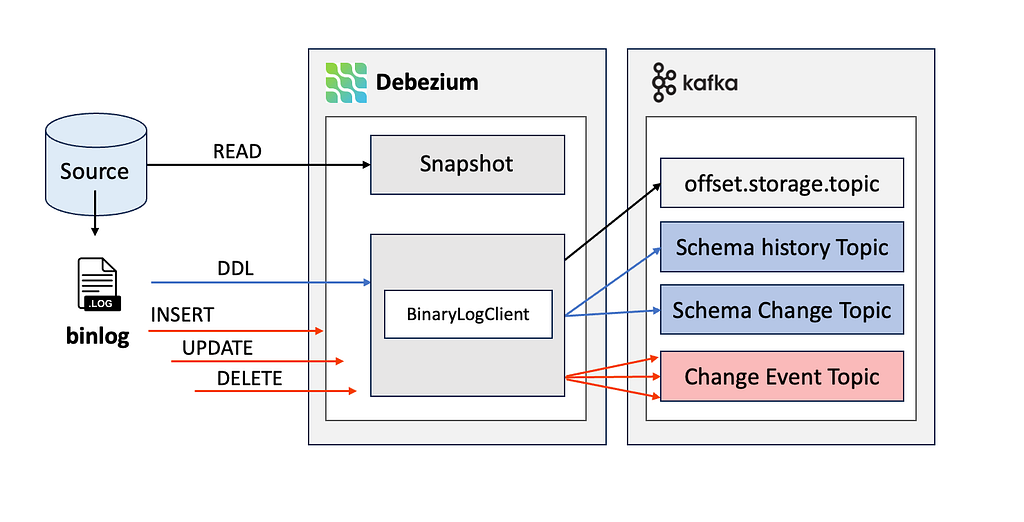
이제 Kafka Connect가 돌아가는 구조를 파악했으니, Debezium이 CDC를 구현한 부분에 대해서 살펴보겠습니다. Debezium은 초기 데이터 동기화를 위해 스냅샷이라는 과정을 수행하며, 이후에는 앞서 살펴본 Kafka Connect의 구조를 활용해 변경 사항을 스트리밍합니다. 이 과정이 어떻게 동작하는지 자세히 설명드리겠습니다.
📍스냅샷
****CDC(Change Data Capture)는 데이터의 변경 사항만 추적하고 반영하는 방식으로 동작합니다. 따라서 CDC를 시작하기 전에, 원본(Source)과 대상(Target)에 동일한 데이터가 존재해야 합니다. 그래서 먼저 한 번 전체 데이터를 복사해 반영하는 과정이 필요하며, Debezium에서는 이를 스냅샷(Snapshot)이라고 합니다.
CDC에서 트랜잭션 로그(Binlog)를 활용하는 방식과 달리, 스냅샷은 Source 데이터베이스의 모든 레코드를 조회하는 과정 입니다. Debezium의 스냅샷 관련 소스 코드를 살펴보면, 스냅샷을 수행할 때 CDC를 수행할 대상 테이블과 컬럼을 기반으로 SELECT 쿼리를 실행하는 것을 확인할 수 있습니다.
@Override
public Optional<String> snapshotQuery(String tableId, List<String> snapshotSelectColumns) {

  return Optional.of(snapshotSelectColumns.stream()
    .collect(Collectors.joining(", ", "SELECT ", " FROM " + tableId)));
}
즉, 현재 시점의 모든 데이터를 조회하여 READ 이벤트를 생성한 뒤, 이를 Kafka Topic에 메시지로 저장합니다. 그리고 Sink Connector가 해당 이벤트를 처리하여 Target에 반영함으로써, 이후 변경 사항이 정상적으로 적용될 수 있도록 Source와 동일한 데이터를 갖는 상태가 됩니다.
스냅샷이 완료되면, 이후에는 Binlog를 기반으로 변경 사항을 지속적으로 반영하며, Source에서 발생한 데이터 변경이 Target에도 일관되게 유지될 수 있도록 합니다.
📍 변경 사항 스트리밍
스냅샷이 완료된 이후에는 트랜잭션 로그 (예: MySQL의 binlog)를 읽어 데이터베이스 변경 이벤트를 처리합니다. 이를 앞서 살펴본 Kafka Connect의 구조와 동일하게 3단계로 나누어 설명하겠습니다.
1️⃣ 1단계 : 가져오자
Debezium의 MySQL 커넥터는 오픈소스 라이브러리를 활용하여 MySQL 서버의 binlog 이벤트를 실시간으로 수신합니다. 수신된 binlog 이벤트는 유형(EventType)에 따라 적절하게 해석됩니다.
protected EventDeserializer createEventDeserializer() {
    ...
    eventDeserializer.setEventDataDeserializer(EventType.WRITE_ROWS, ... );
    eventDeserializer.setEventDataDeserializer(EventType.UPDATE_ROWS, ... );
    eventDeserializer.setEventDataDeserializer(EventType.DELETE_ROWS, ... );
    ...
}
2️⃣ 2단계 : 보내자
다음으로 이벤트를 카프카에 보내기 위한 형태로 가공하여 Kafka 토픽으로 전송해야 합니다. Debezium에서는 이벤트의 종류에 따라 크게 두 가지 유형의 토픽을 사용합니다.
• Change Event 토픽 :
INSERT,UPDATE,DELETE와 같은 DML 이벤트가 발생하면 Operation(Create, Delete, Update)에 맞게 처리된 후 테이블에 맵핑되는 이름의 토픽으로 전송됩니다.• Schema 관련 토픽 :
CREATE TABLE,ALTER TABLE과 같은 DDL 이벤트가 발생하면, 인메모리 스키마 모델을 갱신하여 변경된 스키마를 반영합니다.
Schema 관련 토픽은 용도에 따라 두 개로 구분되며 각각의 역할은 다음과 같습니다.
• Schema Change 토픽 : 외부 시스템에서 스키마 변경 이벤트를 감지하기 위해 DDL이 기록되는 토픽
• Schema History 토픽 : 커넥터 내부에서 스키마 변경 이력을 관리하기 위해 DDL이 기록되는 토픽
이러한 구조를 통해 Debezium은 데이터 변경 이벤트(DML)와 스키마 변경 이벤트(DDL)를 효과적으로 처리하여, Kafka로 안정적으로 스트리밍할 수 있도록 설계되어 있습니다.
3️⃣ 3단계 : 기록하자
앞서 Kafka Connect가 레코드를 Kafka로 성공적으로 전송하면 최신 오프셋 값을 업데이트한다고 설명했습니다. Debezium에서 오프셋 값은 binlog 파일의 position 에 해당합니다. 따라서 offset.storage.topic 에는 CDC가 진행된 위치를 주기적으로 기록하며, 메시지 구조는 다음과 같습니다.
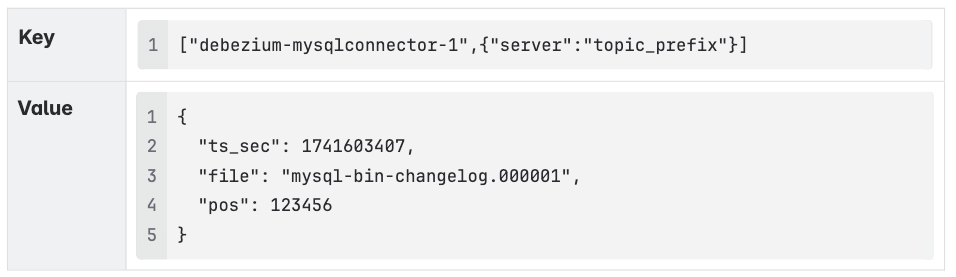
이 토픽에 저장된 메세지 값을 기반으로 커넥터를 중지하고 재시작할 때도 중복이나 유실 없이 CDC를 재개할 수 있습니다.
3. Debezium 실전 적용기
이처럼 소스 코드 레벨에서 Debezium과 Kafka Connect를 깊이 분석한 경험은 실제 구축 과정에서 마주했던 문제의 본질적인 원인을 파악하고 해결하는 데 많은 도움이 되었습니다. 성능을 측정하고 최적화하는 과정에서 내부 구조를 보다 상세히 이해하며 개선 지점을 명확히 파악할 수 있었고, 데이터 정합성을 보장하기 위해 필요한 기능을 직접 구현하는 과정의 토대가 되었습니다. 이 과정에서 겪었던 어려움과 이를 극복한 과정을 구체적으로 전달해 드리겠습니다.
1️⃣ 성능 측정부터 개선까지
CDC 이벤트가 실제로 반영되는 데 걸리는 시간을 정확히 측정할 기준을 설정하는 것은 쉽지 않은 과제였습니다.
처음에는 Kafka 토픽 메시지에 포함된 source.ts_ms 값과 타겟 시스템에서 업데이트된 시간을 비교하기 위해 별도의 컬럼을 추가하는 방식을 고려했습니다. 그러나 CDC 데이터 흐름이 Source → Debezium → Kafka → Sink Connector → Target을 거치는 과정에서 어느 단계에서 지연이 발생하는지 명확히 구분하기 어려웠습니다.
이 문제를 해결하기 위해 메시지 내 source.ts_ms, ts_ms, Kafka 메시지의 타임스탬프 등 다양한 지표를 분석했지만, 각 지표가 어느 시점에서 기록되는지를 명확히 이해하는 것이 필요했습니다. 이에 따라 Debezium의 내부 동작과 타임스탬프가 설정되는 메커니즘을 분석하면서 각 지표가 의미하는 시점을 파악할 수 있었고, 이를 통해 특정 단계에서 발생하는 지연의 원인을 보다 정확히 식별할 수 있었습니다.
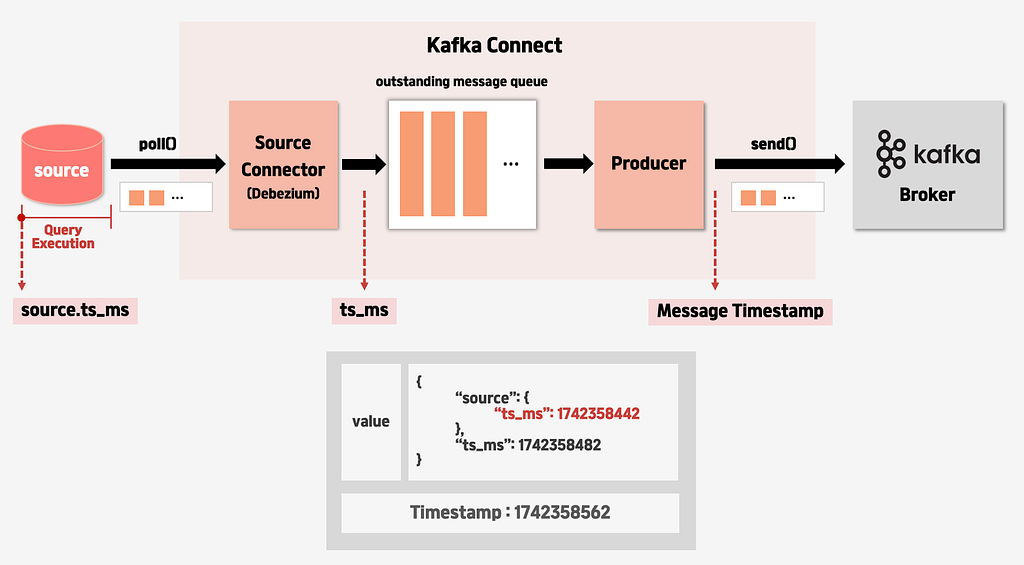
Kafka 메세지에 포함된 source.ts_ms 필드는 이벤트가 발생한 시각을 나타냅니다. 따라서 쿼리 실행 시간이 길어지면 전체 처리 시간도 자연스럽게 증가할 수밖에 없습니다. ts_ms 필드은 Change Event Queue(=Kafka에 Write되기 전 대기하는 큐)에 들어가기 전에 기록됩니다. 메세지의 timestamp는 Producer가 메세지를 보낼 때 시각이 기록됩니다.
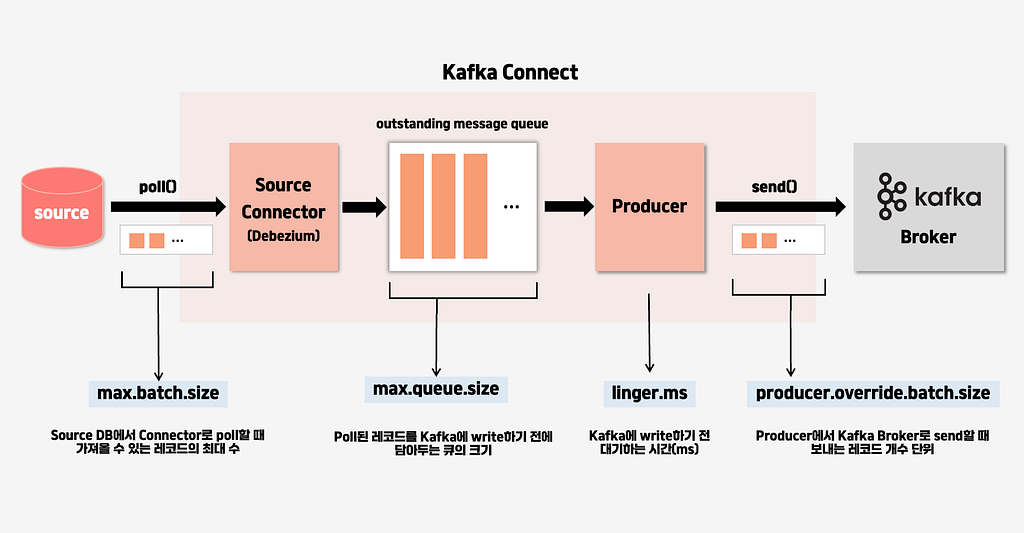
어떤 단계에서 성능 병목 현상이 발생했는지 파악한 이후에는, 이를 해결 하기 위해 Kafka Connect의 Configuration 값을 조정하여 성능을 개선하고자 하였습니다. 먼저 설정 값을 조정했을 때 내부적으로 어떻게 영향을 미치는지 분석하고 이를 바탕으로 값을 조절하였습니다. 조정한 커넥터 설정 옵션은 다음과 같습니다.
• max.batch.size : Source DB에서 Connector로 poll할 때 가져올 수 있는 레코드의 최대 수
• max.queue.size : Poll된 레코드를 Kafka에 write하기 전에 담아두는 큐의 크기
• linger.ms : Kafka에 write하기 전 대기하는 시간(ms)
• producer.override.batch.size : Producer에서 Kafka Broker로 send할 때 보내는 레코드 개수 단위
2️⃣ 커스텀 SMT 개발
Source에 해당하는 MySQL과 Sink에 해당하는 Redshift 두 시스템 간의 데이터 정합성을 맞추는 과정에서 특정 타입에 대한 전처리가 필요하였습니다. Kafka Connect에서는 Connector와 Kafka 사이에 Transform 과 Converter 라는 중간 단계를 거칩니다. Converter 는 데이터를 직렬화하여 바이트(byte) 형태로 변환하거나, 반대로 바이트 데이터를 역직렬화하는 역할을 수행합니다. Transform은 이벤트에 대해 간단한 전처리를 할 수 있습니다.
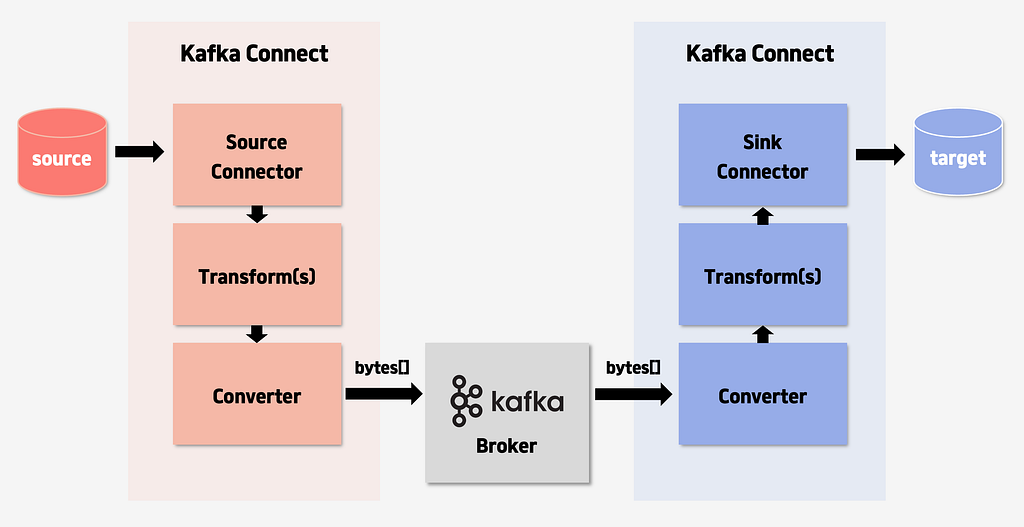
기본적으로 제공되는 Cast 나 TimeStampConverter와 같은 Transform이 있지만, 대부분 기능이 제한적이거나 변환할 필드명을 명시해야 했습니다. 필드명과 상관없이 해당 타입의 모든 필드에 원하는 동작을 적용하기 위해 직접 SMT에 해당하는 클래스를 구현하였습니다.
private R applyWithSchema(R r) {
  ...

  for (Field field : struct.schema().fields()) {
      if (field.schema().name() != null) {
        switch (field.schema().name()) {
            case Date.SCHEMA_NAME:
              Object value = struct.get(field);
              ...
              if (value instanceof Integer) {
                updatedValue.put(field.name(), formatDate((Integer)value));
               } else {
                updatedValue.put(field.name(), value);
               }
               break;
           ...
        }
    }
    return newRecord(r, updatedSchema, updatedValue);
}
MySQL의 Decimal, Date, Timestamp 타입을 적절히 변환하기 위해 Debezium의 내부 동작을 살펴볼 필요가 있었습니다. 이를 위해 소스 코드를 분석하며 각 타입이 어떤 클래스에서 어떤 방식으로 처리되는지 확인했고, 기존 SMT 코드들도 검토하며 원하는 변환이 정확히 이루어지도록 조정하였습니다.
밑바닥을 알면 사라지는 두려움
데이터 엔지니어로서 첫 발걸음으로 실시간 데이터 파이프라인을 구축하는 과정은 수많은 도전의 연속이었습니다. 낯설었던 오픈소스 코드를 분석하고 직접 수정하면서 시스템의 동작 원리를 깊이 이해할 수 있었고, 이를 통해 단순히 도구를 사용하는 것을 넘어, 실제 환경에 맞게 수정하고 적용하는 경험을 할 수 있었습니다.
막막했던 코드 한 줄 한 줄이 이제는 자연스럽게 읽히고, 새로운 문제 앞에서도 두려움보다 해결할 수 있다는 믿음이 먼저 들게 되었습니다. 나아가 처음 보는 시스템이나 복잡한 이슈가 발생해도 주저하지 않고 코드를 열어 원인을 파악하고 해결책을 찾아나갈 수 있도록 성장하게 된 것 같습니다.
긴 글을 읽어주셔서 감사합니다.