Engineering
File Crafter 서비스 소개
2023년 2월 20일
원문에서 보기 ↗
대용량 파일 업로드 기능의 문제점
대부분의 웹 서비스 개발자는 파일 업로드 기능을 제공해 본 경험이 있을 겁니다. 웹 서비스에서 빈번하게 사용되는 기능이므로 웹 서비스 프레임워크에서 제공하는 편의 기능을 이용하여 다소 번거롭긴 하지만 큰 어려움을 겪지 않고 기능을 구현해 낼 수 있습니다.
그러나 정작 큰 문제는 기능 제공 후에 발생하게 됩니다. 어떤 사용자가 대용량 엑셀 파일📊을 업로드하면 서버에서는 엑셀 파일을 읽어 들이고 압축을 풀어 레코드 단위로 처리해 내는 작업이 실행됩니다. 이 과정에서 CPU와 메모리 등의 시스템 자원을 점유하게 되고, 네트워크 IO나 디스크 IO도 발생하게 됩니다. 당연히 파일의 크기가 크면 클수록 요구되는 시스템 자원의 크기도 커지게 됩니다. 이로 인해 메모리 부족의 예외가 발생하기도 하며, 서비스가 사용자 요청에 응답하지 않는 상태에 빠지기도 합니다. 대용량 파일 업로드를 동시에 이용하는 사용자가 많다면 단순히 서비스 응답이 지연되는 수준이 아니라 장애로 이어질 수도 있습니다.
개발자가 신경 써야 할 일들
이런 문제를 해결하기 위해서는 웹 서비스 개발자가 신경 써야 할 일이 많습니다. 메모리를 조금씩만 사용할 수 있도록 스트림 방식으로 파일을 처리해야 하며, CPU를 점유하지 않도록 파일 처리 작업의 우선순위를 낮춰야 합니다. 작업 완료까지 오랜 시간이 걸릴 수 있으므로 작업 완료 여부를 사용자에게 알려 주는 기능도 제공할 필요가 있습니다. 작업이 너무 길어지면 타임아웃이 발생하기 때문에 서비스의 여러 계층에서 타임아웃도 넉넉하게 조정해야 합니다. 이 모든 번거로운 작업은 대용량 파일 처리를 동기 방식으로, 웹 서비스 내부에서 처리하려고 하기 때문에 발생하는 것입니다.
File Crafter
NHN Cloud에서는 이런 복잡한 대용량 파일 처리 과정을 File Crafter라는 서비스로 제공하고 있습니다. File Crafter 서비스를 통해 대용량 파일을 처리하는 과정을 비즈니스 로직을 담당하는 고객의 서비스에서 분리하고, 비동기적으로 처리함으로써 고객의 서비스가 비즈니스 로직에만 집중할 수 있도록 합니다.
File Crafter는 대용량 엑셀, CSV, JSON 파일을 읽어 들이거나 생성하는 기능을 제공하고 있습니다. 고객의 서비스에 부하를 주지 않도록 비동기적으로 일정량의 레코드 단위로 처리해 줍니다.
주요 기능
Import
최종 사용자가 업로드한 대용량 파일을 일정 단위로 읽어 들여 고객의 서비스로 업로드해 주는 기능을 제공합니다. File Crafter에게 Import 시작 요청을 보내면서 파일을 함께 전달하면 1,000건씩 고객이 준비한 "Import Callback API"🔗에게 POST method를 이용하여 업로드하게 됩니다. 이 요청을 반복하여 전체 데이터를 업로드합니다. 자세한 과정은 다음과 같이 도식화할 수 있습니다.
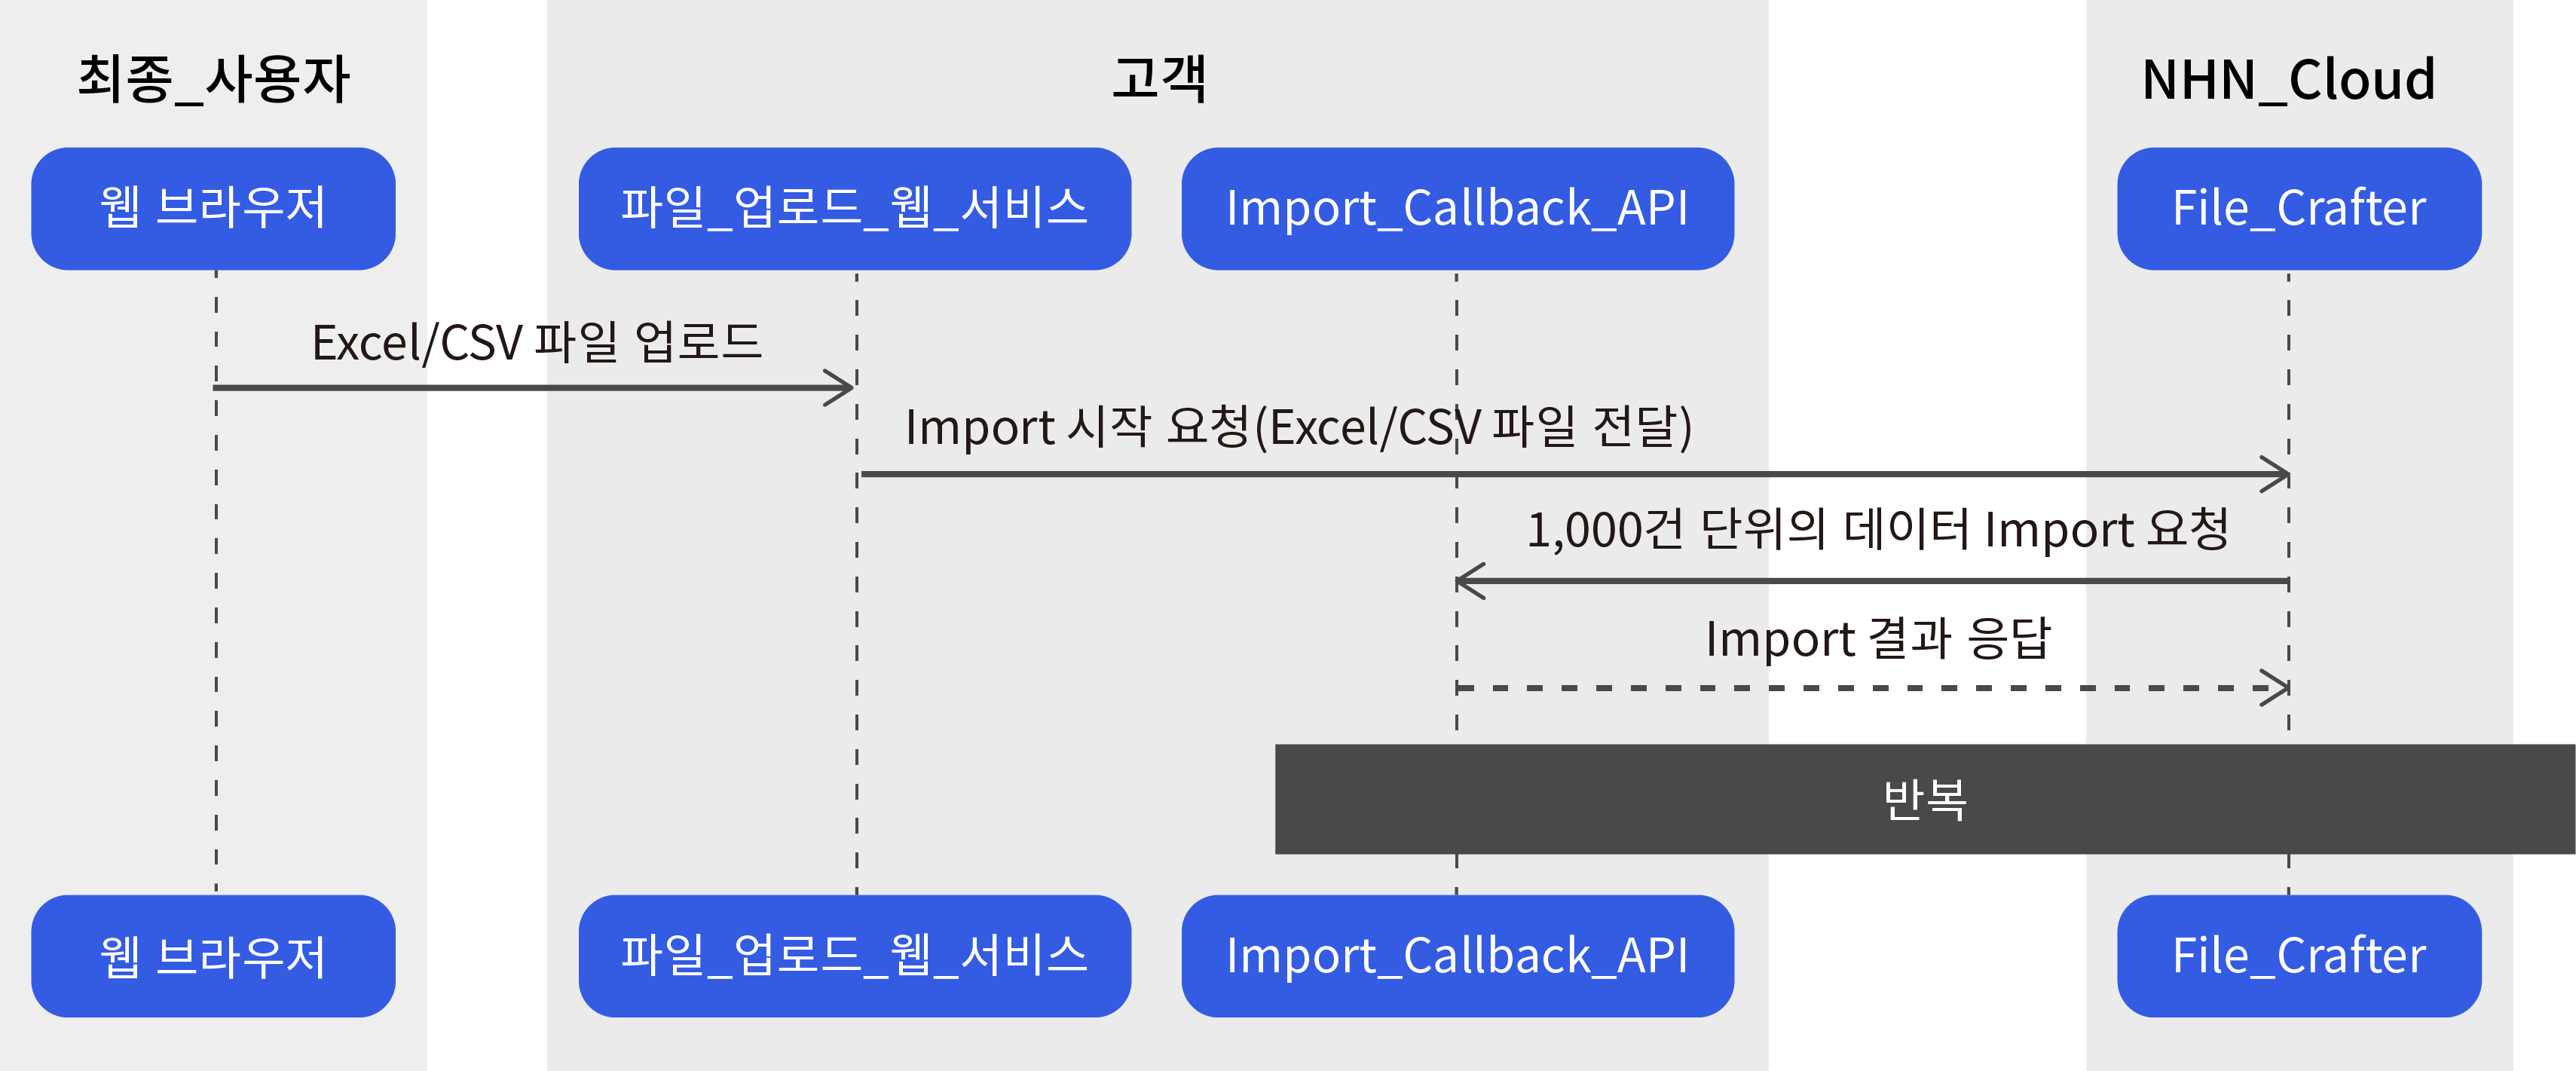
고객의 웹 서비스는 대용량 파일 처리에 신경 쓰지 않고, 오로지 File Crafter가 처리한 데이터를 일정 단위로 받아서 내부적으로 사용하면 됩니다. 이 과정에서 메모리 부족이나 과도한 CPU 점유의 문제를 걱정할 필요가 없습니다.
Validate
Import 과정에서 데이터 유효성 검증(validation)이 필요할 수 있기 때문에, 선택적인 기능으로 제공하고 있습니다. 고객의 비즈니스 로직에 따라 개별적으로 처리해야 하므로 Import와 마찬가지로 callback API🔗가 필요합니다.
아래의 도식에서 기본적인 Import 기능의 과정과 비교해 보면 validate 단계가 앞서서 진행됨을 확인할 수 있습니다.
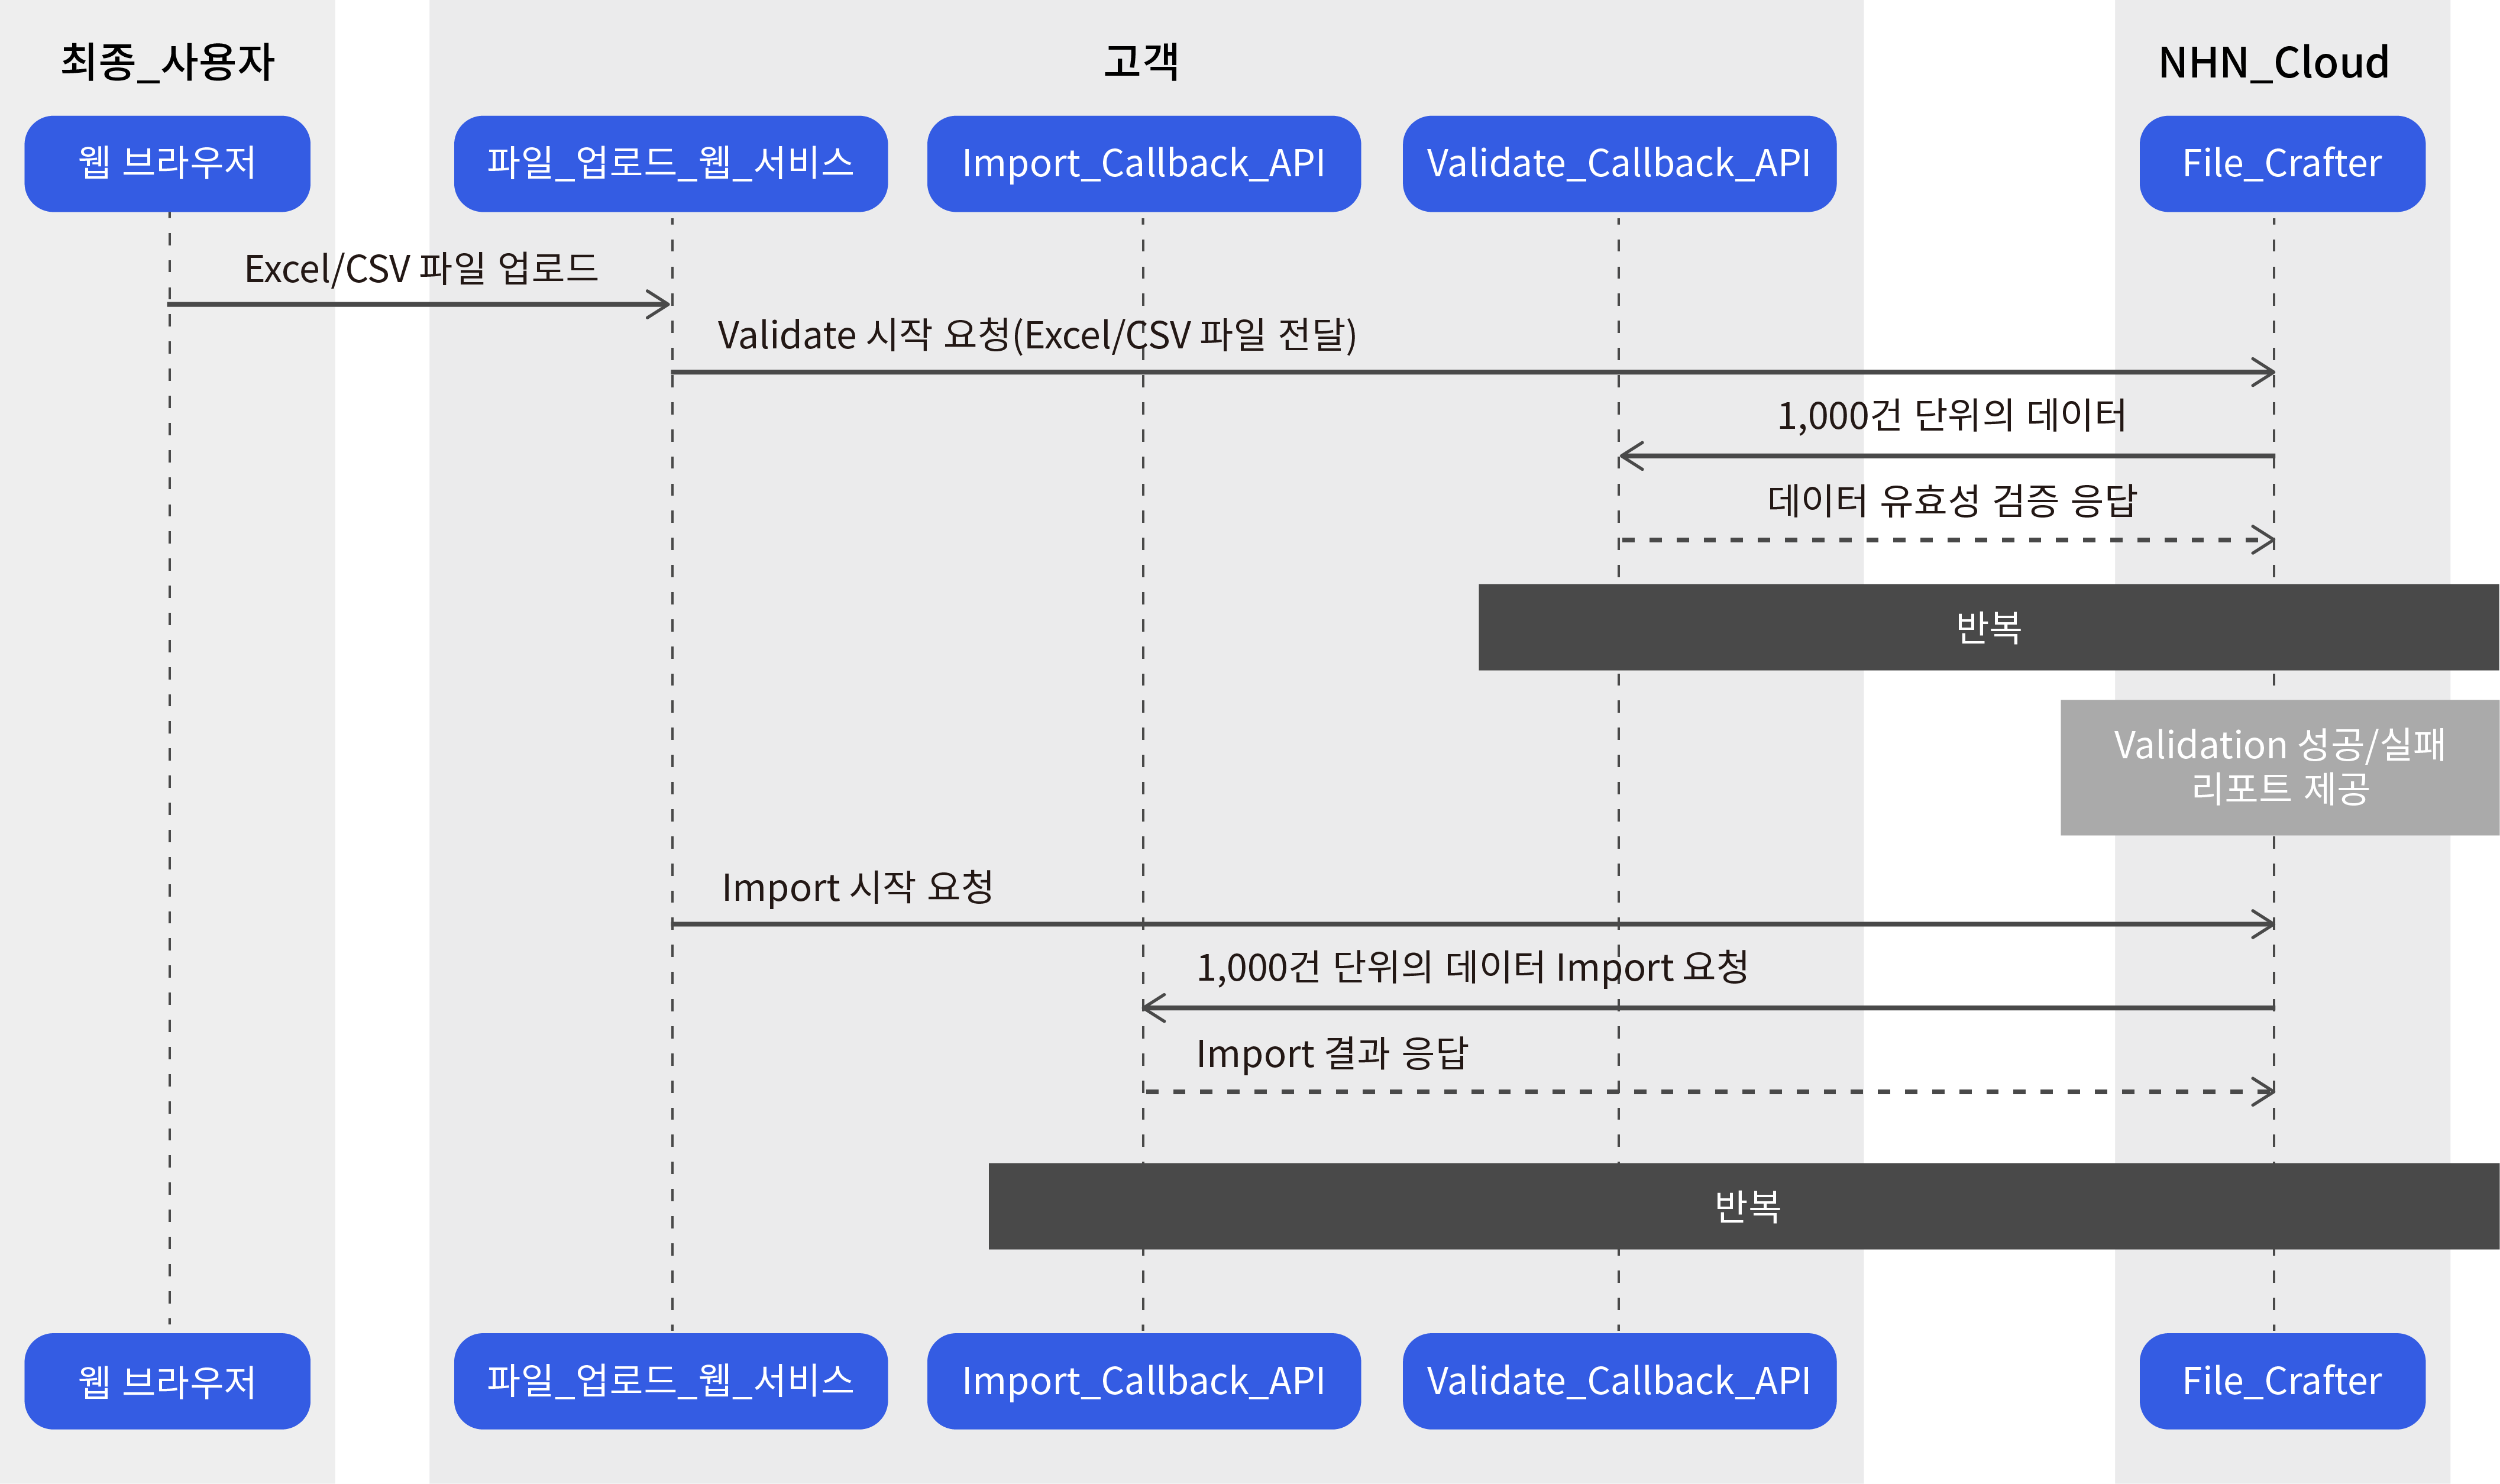
Validate 단계가 완료되면 유효성 검증(validation)의 성공✅과 실패❌ 여부에 따라 성공 리포트와 실패 리포트를 각각 제공합니다. 이것을 이용하여 성공한 데이터만 Import되도록 할 수 있고, 아니면 실패한 데이터를 가지고 고객의 서비스 내에서 재추출하는 작업에 참고할 수도 있습니다.
Export
고객의 서비스에 저장되어 있는 데이터를 대용량 파일(엑셀/CSV/JSON)로 Export하는 기능도 제공합니다.
고객은 File Crafter가 데이터를 조회할 수 있도록 "Export Callback API"🔗를 제공해야 합니다. 이 API를 통해 일정 건수 단위로 데이터를 조회하여 엑셀이나 CSV, JSON 등의 파일로 만들어 냅니다.
최종 결과물 파일은 고객이 보유하고 있는 S3 호환 스토리지에 저장하게 됩니다. NHN Cloud의 Object Storage를 이용할 수도 있고 외부 클라우드의 S3 호환 스토리지를 이용할 수도 있습니다.
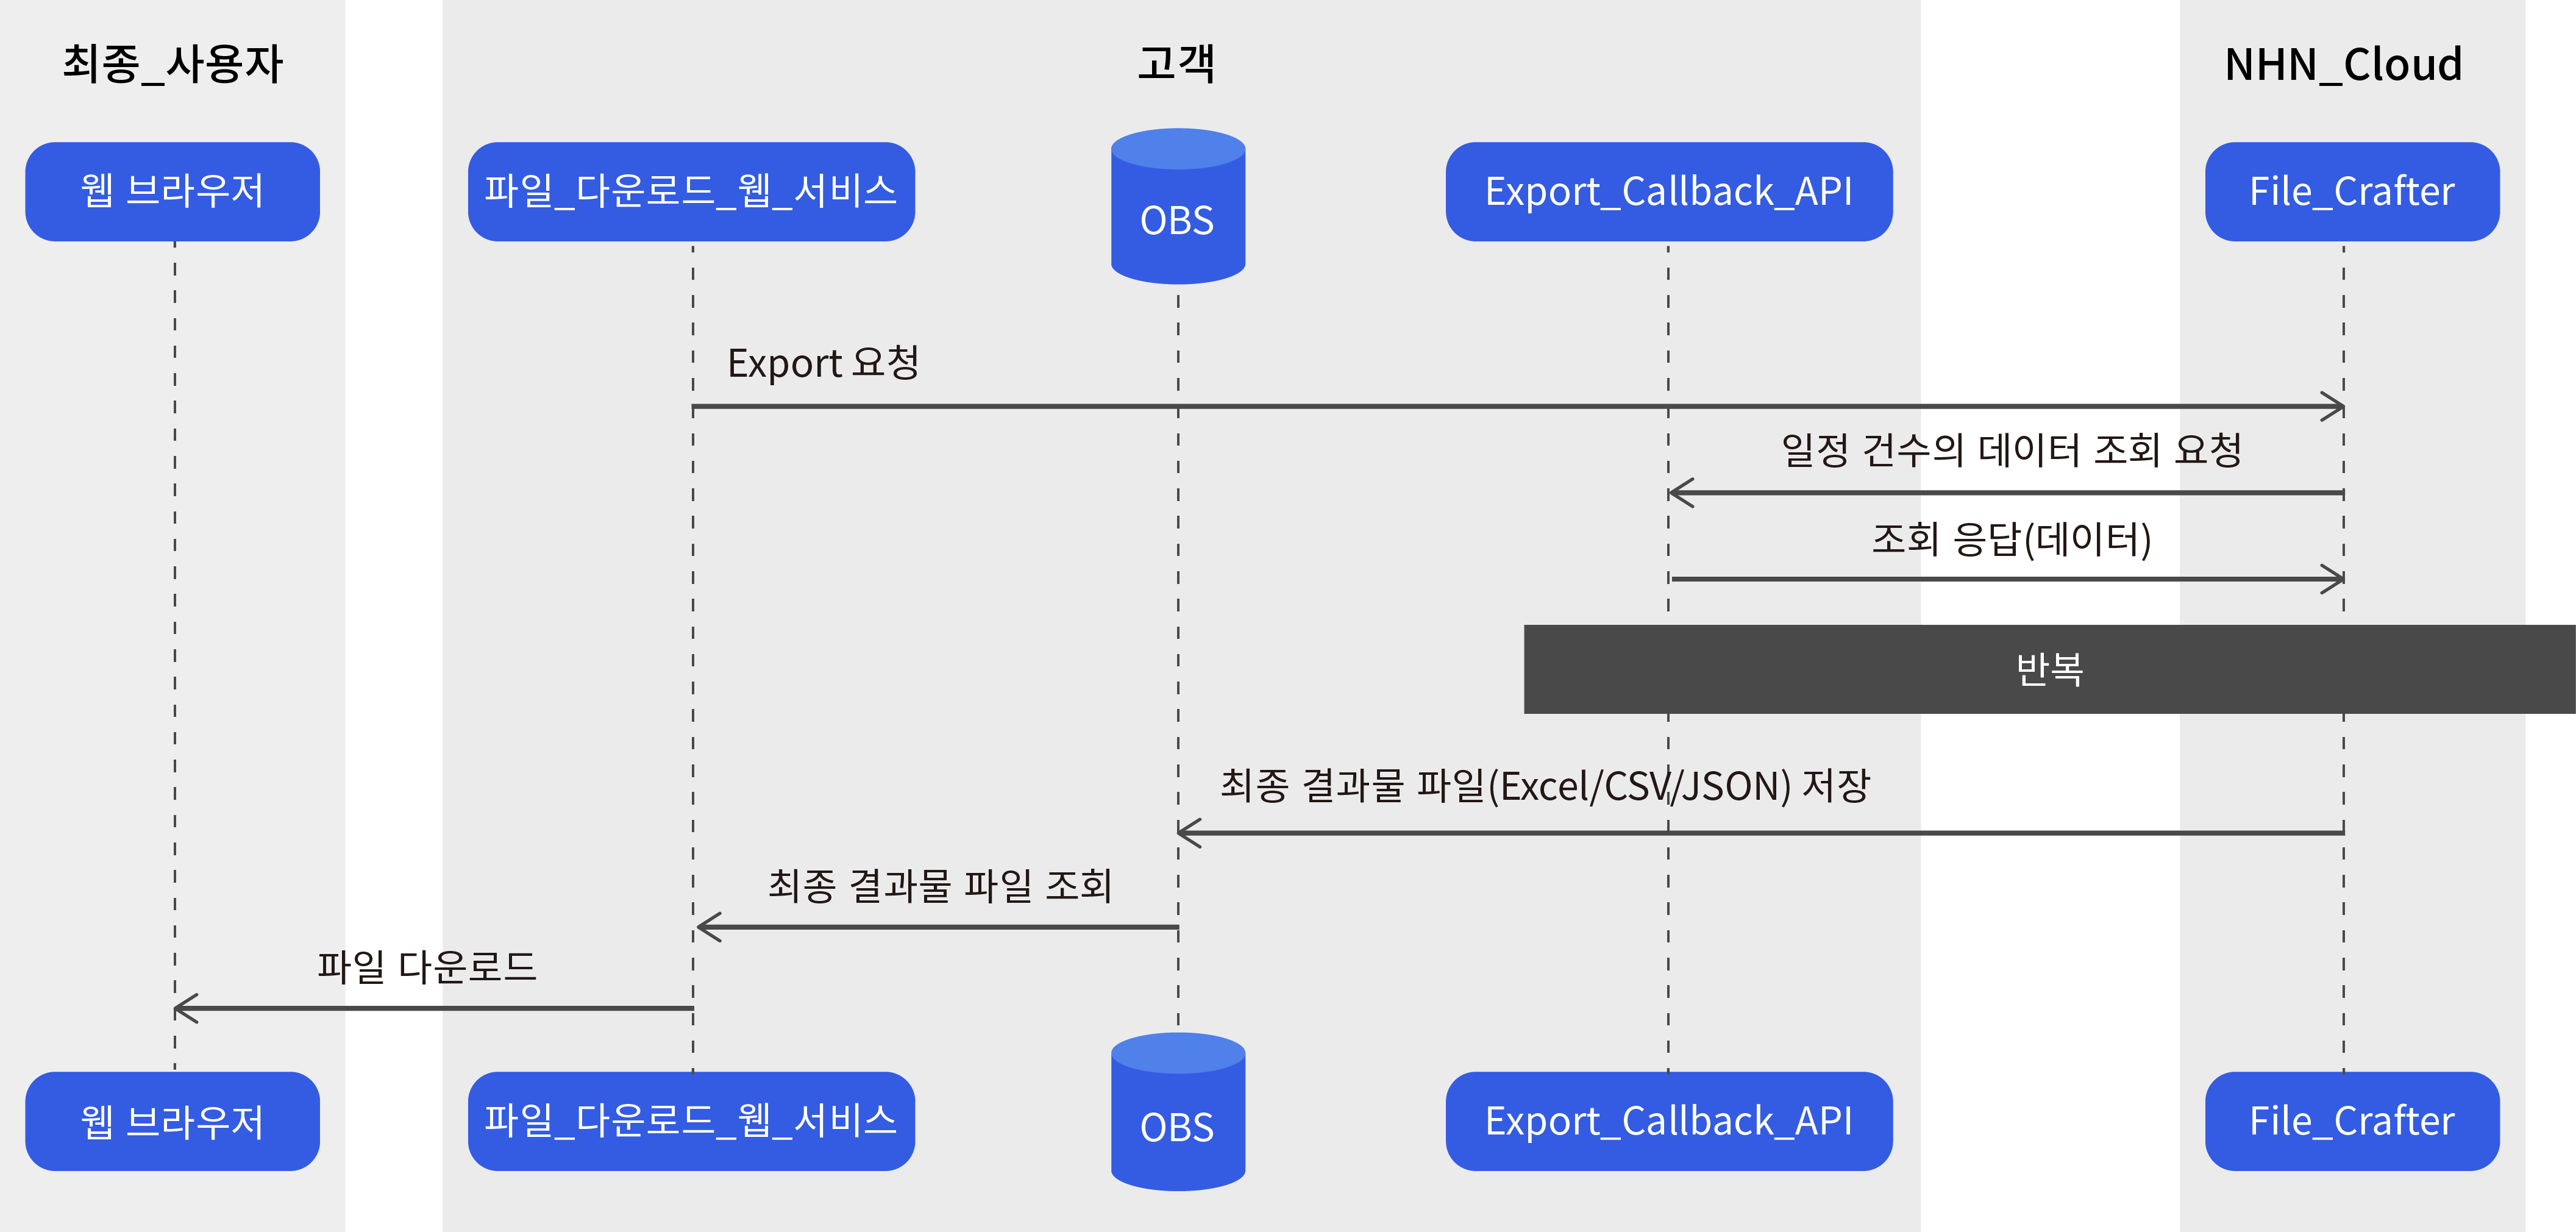
Export Callback API에 과부하를 걸지 않도록 일정 단위의 조회(pagination) 기능을 활용합니다. 자원 효율적인 API 기능 제공을 위해 Export Callback API에 pagination 기능을 구현해 두는 것을 권장합니다.
편의 기능
암호🔒
Import할 때 엑셀 파일에 암호가 걸려 있으면 사용자 입력을 받아서 복호화 후에 처리하는 기능을 제공하고 있으며, 반대로 Export할 때 사용자가 지정한 암호를 이용해 암호화하는 기능도 제공하고 있습니다.
엑셀 파일의 다중 시트
엑셀 파일은 다중 시트로 구성할 수도 있는데, 추가 파라미터를 지정함으로써 시트별로 분리하여 저장하는 기능도 제공하고 있습니다.
엑셀 파일의 분할 저장
엑셀 파일은 최대 100만 개 정도의 레코드를 포함할 수 있습니다. 그래서 이 이상의 데이터를 가지는 경우에는 여러 개의 엑셀 파일로 분할해서 저장해야 합니다. 분할 저장을 위한 편의 기능을 제공하고 있습니다. 꼭 하나의 파일로 Export해야 한다면 엑셀 대신 CSV 파일을 사용하는 것을 고려해 보시기 바랍니다.
참조 문서
자세한 내용은 File Crafter 가이드📖를 참고하시기 바랍니다.
향후 계획
File Crafter 웹 콘솔을 통한 편의 기능을 확충할 계획입니다. 또한, 고객의 데이터를 더욱 안전하게 보호하는 기능을 지속적으로 강화할 예정입니다. 이미 만들어져 있는 Callback API를 그대로 사용할 수 있도록 하드코드되어 있는 파라미터를 사용자 정의 파라미터로 사용할 수 있도록 편의성을 제고할 예정입니다.
고객이 비즈니스 로직 개발에 집중하실 수 있도록 NHN Cloud는 이와 같은 헬퍼(helper) 서비스를 안정적으로 제공하겠습니다.