Engineering
Claude Code Dynamic Workflow 쉽게 이해하기
2026년 8월 21일
원문에서 보기 ↗나의 에이전트가 순서대로 일하는 대신,
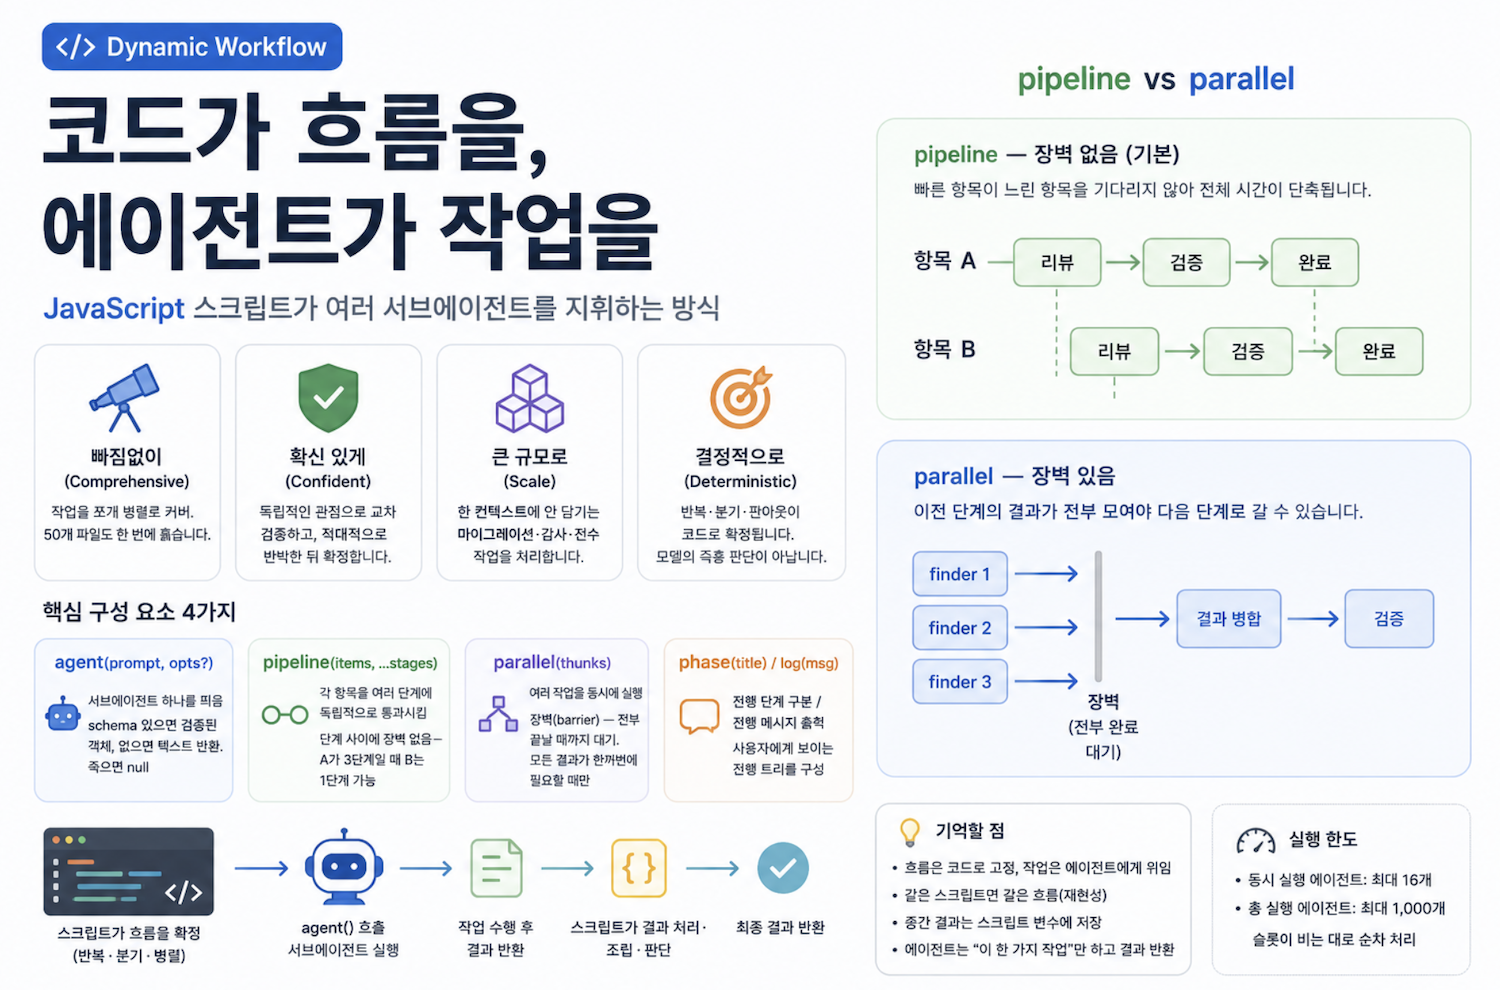
JavaScript 스크립트가 여러 서브에이전트를 지휘하는 방식. 반복·분기·병렬 같은 제어 흐름을 코드로 확정해 두고, 실제 작업만 에이전트에게 맡깁니다.
Claude Code의 Dynamic Workflow 기능이 이 방식을 실행합니다.
아래에 나오는 agent()·pipeline() 같은 함수는 그 스크립트 안에서 쓰는 API이고, Claude Code가 이를 읽어 서브에이전트를 띄웁니다.
1. 왜 Dynamic Workflow인가
큰 작업을 에이전트 하나에게 통째로 맡기면 두 가지 한계가 생깁니다.
컨텍스트가 넘치고(한 머리에 다 안 들어감), 흐름이 모델의 즉흥 판단에 좌우됩니다(매번 다르게 행동).
Dynamic Workflow는 이 문제를 "흐름은 코드로 고정, 작업은 에이전트에 위임" 으로 풉니다. 네 가지를 동시에 얻습니다:
| 🔭 빠짐없이 (Comprehensive) | 작업을 쪼개 병렬로 커버. 50개 파일도 한 번에 훑습니다. |
| ✅ 확신 있게 (Confident) | 독립적인 관점으로 교차 검증하고, 적대적으로 반박한 뒤 확정합니다. |
| 📦 큰 규모로 (Scale) | 한 컨텍스트에 안 담기는 마이그레이션·감사·전수 작업을 처리합니다. |
| 🎯 결정적으로 (Deterministic) | 반복·분기·팬아웃이 코드로 확정됩니다. 모델의 즉흥 판단이 아닙니다. |
2. 핵심 개념: 코드가 흐름을, 에이전트가 작업을
무엇이 달라지는지부터 보겠습니다.
| 일반 에이전트 호출 | Dynamic Workflow | |
|---|---|---|
| 흐름을 정하는 주체 | 에이전트가 "다음에 뭘 할지" 매번 스스로 판단 | 루프·조건·팬아웃을 스크립트가 확정 |
| 재현성 | 모델 판단에 달려 있어 매번 다르게 동작 | 같은 스크립트면 같은 흐름 |
| 중간 결과 | 전부 Claude의 컨텍스트에 쌓임 | 스크립트 변수에 남고, 컨텍스트에는 최종 결과만 |
| 에이전트의 역할 | 계획과 실행을 함께 떠맡음 | "이 한 가지 작업"만 하고 결과 반환 — 조립은 코드가 |
구현은 단순합니다. 워크플로우는 meta 블록으로 시작하는 평범한 JavaScript 스크립트이고, 본문에서 agent()를 호출하면 서브에이전트가 떠서 작업하고 그 결과를 다시 JS 코드로 다룹니다.
export const meta = {
  name: 'review-changes',
  description: '변경된 파일을 차원별로 리뷰하고 각 발견을 검증',
  phases: [{ title: 'Review' }, { title: 'Verify' }],
}
// ↑ meta는 반드시 순수 리터럴 (변수·함수 호출 금지)
// ↓ 여기서부터 스크립트 본문 — await를 바로 쓸 수 있음

phase('Review')
const result = await agent('이 디렉토리에서 버그를 찾아라', { schema: BUGS_SCHEMA })
// schema를 주면 검증된 객체를 반환 — 파싱 불필요
기억할 점: 서브에이전트에게는 "너의 마지막 텍스트가 곧 반환값"이라고 전달됩니다. 사람에게 보내는 메시지가 아니라 데이터 를 반환합니다.
schema를 주면 검증까지 자동입니다.
위 코드는 뼈대만 보여주는 조각입니다. 스키마 정의부터 결과 반환까지 그대로 돌아가는 전체 스크립트는 6장에 있습니다.
3. 기본 구성 요소 4가지
| 함수 | 역할 | 핵심 |
|---|---|---|
agent(prompt, opts?) | 서브에이전트 하나를 띄움 | schema 있으면 검증된 객체, 없으면 텍스트 반환. 죽으면 null |
pipeline(items, ...stages) | 각 항목을 여러 단계에 독립적으로 통과시킴 | 단계 사이에 장벽 없음 — A가 3단계일 때 B는 1단계 가능. 기본 선택 |
parallel(thunks) | 여러 작업을 동시에 실행 | 장벽(barrier) — 전부 끝날 때까지 대기. 모든 결과가 한꺼번에 필요할 때만 |
phase(title) / log(msg) | 진행 단계 구분 / 진행 메시지 출력 | 사용자에게 보이는 진행 트리를 구성 |
그 외에 budget (토큰 예산), args (외부 입력), workflow() (다른 워크플로우를 하위 단계로 실행) 등이 있습니다.
런타임이 걸어두는 상한은 두 개입니다.
동시에 도는 에이전트는 최대 16개 이고(CPU 코어가 적은 머신에서는 그보다 적게), 한 번의 실행에서 띄울 수 있는 에이전트는 총 1,000개입니다.
그래서 항목을 100개 넘겨도 슬롯이 비는 대로 순서대로 전부 처리됩니다.
4. pipeline vs parallel — 가장 중요한 선택
이 둘의 차이가 워크플로우 설계의 핵심입니다. 기본은 항상 pipeline이고, parallel은 "정말로 모든 결과를 한꺼번에 모아야 할 때"만 씁니다.
pipeline — 장벽 없음 (기본)
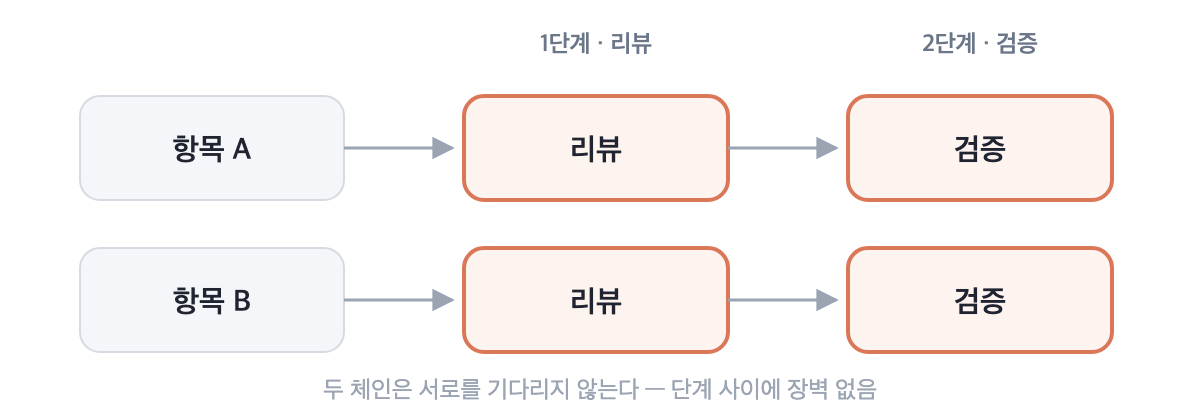
그림 1. 항목 A와 항목 B가 각각 리뷰·검증 단계를 독립적으로 통과하는 흐름도
A가 검증 중일 때 B는 아직 리뷰 중일 수 있습니다. 빠른 항목이 느린 항목을 기다리지 않으므로, 전체 시간은 가장 느린 한 체인이 결정합니다.
parallel — 장벽 있음
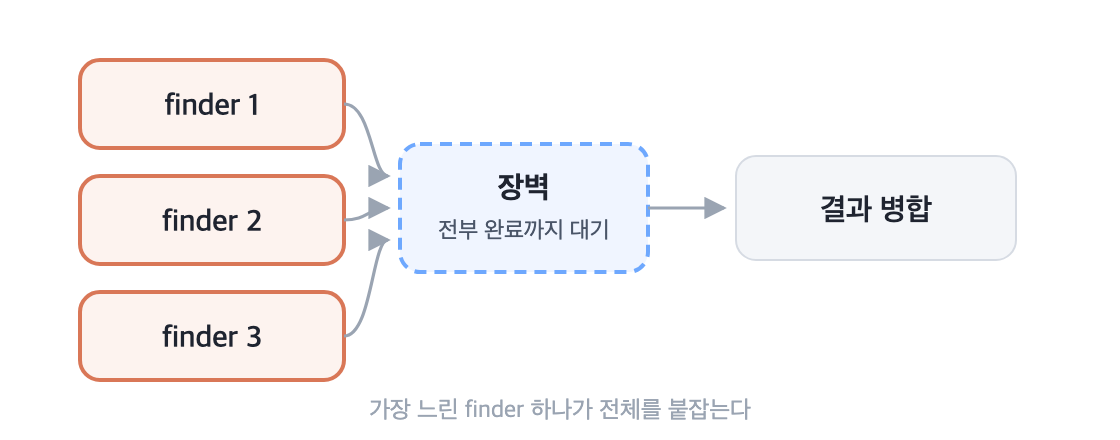
그림 2. finder 3개가 장벽에서 전부 완료를 기다린 뒤 결과 병합으로 이어지는 흐름도
이전 단계의 결과가 전부 모여야 다음 단계로 갈 수 있습니다. 전체 결과에서 중복을 제거한 뒤 검증하거나, 0건이면 조기 종료하는 경우가 여기 해당합니다.
판별 기준: "다음 단계가 이전 단계의 모든 항목을 교차 참조하는가?"
— 예(중복 제거/병합/조기 종료)면
parallel, 아니면pipeline. "그냥 flatten/map/filter가 필요해서"는 장벽의 이유가 되지 못합니다.변환은 pipeline 단계 안에서 하세요.
// 표준 패턴 — 리뷰가 끝나는 즉시 그 차원만 검증 시작 (pipeline)
const results = await pipeline(
  DIMENSIONS,
  d => agent(d.prompt, { phase: 'Review', schema: FINDINGS }),
  review => parallel(review.findings.map(f => () =>
    agent(`적대적으로 검증: ${f.title}`, { phase: 'Verify', schema: VERDICT })
      .then(v => ({ ...f, verdict: v }))
  ))
)
const confirmed = results.flat().filter(Boolean).filter(f => f.verdict?.isReal)
5. 대표 패턴
아래는 자주 쓰는 형태들입니다. 작업 성격에 맞게 조합하면 됩니다.
🛡️ 적대적 검증 (Adversarial verify)
발견마다 독립적인 회의론자 N명이 반박을 시도. 과반이 반박하면 폐기. 그럴듯하지만 틀린 결과를 걸러냄.
🧭 관점 다양화 검증
같은 검증자 N명 대신 각자 다른 렌즈(정확성·보안·성능·재현성)를 줌. 중복으로는 못 잡는 실패 모드를 포착.
⚖️ 심사위원단 (Judge panel)
서로 다른 각도로 N개 시도를 생성 → 병렬 심사로 채점 → 우승안 기반으로 종합. 해법 공간이 넓을 때 강력.
🔁 마를 때까지 반복 (Loop-until-dry)
크기를 모르는 발견 작업(버그·엣지케이스)에서, K번 연속 새 결과가 없을 때까지 finder를 계속 투입. 꼬리를 놓치지 않음.
🔀 멀티모달 스윕
컨테이너별·내용별·엔티티별·시간별 등 서로 다른 방식으로 동시 검색. 한 가지 각도로는 다 못 찾을 때.
🔍 완전성 비평가 (Completeness critic)
마지막에 "빠진 게 뭐냐 — 안 돌린 방식, 미검증 주장, 안 읽은 출처?"를 묻는 에이전트. 답이 다음 라운드 작업이 됨.
6. 전체 예제 — 처음부터 끝까지
지금까지 나온 조각을 하나로 합친 완결된 스크립트입니다.
모듈별로 버그를 찾고, 찾은 즉시 각 발견을 적대적으로 검증해 확정된 것만 반환합니다.
MODULES 경로만 자기 저장소에 맞게 바꾸면 그대로 돌아갑니다.
export const meta = {
  name: 'audit-modules',
  description: '모듈별로 버그를 찾고 각 발견을 적대적으로 검증',
  phases: [
    { title: 'Find', detail: '모듈별 병렬 탐색' },
    { title: 'Verify', detail: '발견마다 반박 시도' },
  ],
}

// 스키마 — agent()가 이 형태로 검증된 객체를 돌려준다. 파싱·재시도 불필요.
const FINDINGS = {
  type: 'object',
  properties: {
    findings: {
      type: 'array',
      items: {
        type: 'object',
        properties: {
          title: { type: 'string' },
          file: { type: 'string' },
          detail: { type: 'string' },
        },
        required: ['title', 'file', 'detail'],
      },
    },
  },
  required: ['findings'],
}

const VERDICT = {
  type: 'object',
  properties: {
    isReal: { type: 'boolean' },
    reason: { type: 'string' },
  },
  required: ['isReal', 'reason'],
}

// 대상 목록 — 외부에서 args로 넘기거나 기본값 사용
const MODULES = args?.modules ?? ['src/auth', 'src/billing', 'src/api']

log(`${MODULES.length}개 모듈 감사 시작`)

const results = await pipeline(
  MODULES,

  // 1단계: 모듈마다 버그 탐색
  (mod) =>
    agent(`${mod} 디렉토리에서 실제로 터질 수 있는 버그를 찾아라.`, {
      label: `find:${mod}`,
      phase: 'Find',        // pipeline 안에서는 phase()가 아니라 opts.phase를 쓴다
      schema: FINDINGS,
    }),

  // 2단계: 그 모듈의 발견만 즉시 검증 — 다른 모듈을 기다리지 않는다
  (found, mod) => {
    if (!found?.findings.length) return []   // agent가 죽으면 null이 온다
    return parallel(
      found.findings.map((f) => () =>
        agent(
          `다음 주장을 반박해 보라: "${f.title}" (${f.file})\n${f.detail}\n` +
            `확신이 없으면 isReal=false로 판단하라.`,
          { label: `verify:${mod}`, phase: 'Verify', schema: VERDICT },
        ).then((v) => ({ ...f, verdict: v })),
      ),
    )
  },
)

const confirmed = results
  .flat()
  .filter(Boolean)                      // 죽은 에이전트는 null로 떨어진다
  .filter((f) => f.verdict?.isReal)

log(`확정 ${confirmed.length}건`)
return { confirmed }
읽을 때 짚어볼 지점 네 곳입니다.
-
2단계의 두 번째 인자
mod—pipeline의 각 단계는(이전 결과, 원본 항목, 인덱스)를 받습니다. 그래서 1단계 반환값에 모듈명을 끼워 넣어 나르지 않아도 됩니다. -
pipeline안의parallel— 겉은 장벽 없이 흐르고, 안에서 한 모듈의 발견들만 동시에 검증합니다. 4장의 판별 기준이 그대로 적용된 형태입니다. -
phase()대신opts.phase—pipeline·parallel안에서는 전역phase()상태가 경쟁할 수 있어 옵션으로 직접 지정합니다. -
필터가 두 번 — 단계 자체가 실패한 항목은
null로 떨어지므로filter(Boolean)이 걸러내고, 검증 에이전트가 죽어verdict가null인 항목은 뒤의verdict?.isReal이 걸러냅니다. 에이전트는 죽을 수 있다고 전제하고 씁니다.
7. 언제 쓰고, 언제 쓰지 않나
| ✅ 적합 | ✋ 부적합 |
|---|---|
| 전수 감사·리뷰·리서치 (병렬 팬아웃) | 대화형 한 턴짜리 응답 |
| 대규모 마이그레이션 (사이트 발견 → 변환 → 검증) | 사소한 기계적 편집 |
| 독립 관점의 교차/적대적 검증이 필요한 작업 | 흐름이 단순해 단일 에이전트로 충분한 일 |
| 한 컨텍스트에 안 담기는 규모 | 사용자가 명시적으로 요청하지 않은 대규모 팬아웃 |
중요한 전제: Dynamic Workflow는 한 번에 수십에서 수백 개의 에이전트를 띄우고 그만큼 토큰을 씁니다. 그래서 기본값은 직접 요청했을 때만 실행되는 쪽입니다
— 프롬프트에
ultracode키워드를 넣거나 "워크플로우로 처리해줘"처럼 말하거나, 저장해 둔 워크플로우를/이름으로 부르는 방식입니다.반대로
/effort ultracode를 켜 두면 매 작업마다 Claude가 알아서 판단해 워크플로우를 씁니다.
예산으로 깊이를 조절한다
비용이 문제라면 깊이를 예산에 맡길 수 있습니다.
스크립트 안에서 budget으로 남은 토큰을 조회할 수 있어서, 몇 개를 돌릴지 미리 정하는 대신 예산이 마를 때까지 돌리는 식으로 쓸 수 있습니다.
const bugs = []
// budget.total이 없으면 remaining()은 Infinity → 가드 필수
while (budget.total && budget.remaining() > 50_000) {
  const r = await agent('이 코드베이스에서 버그를 찾아라', { schema: BUGS })
  bugs.push(...r.bugs)
  log(`${bugs.length}개 발견, ${Math.round(budget.remaining()/1000)}k 남음`)
}
루프 대신 고정 규모를 정하는 방식도 같은 요령입니다. budget.total을 나눠 finder 수를 계산하면, 예산이 클수록 더 많이 투입됩니다.
실전에서는 하이브리드
먼저 인라인으로 정찰(파일 나열, 범위 파악)해 작업 목록을 발견한 뒤, 그 목록을 워크플로우로 파이프라인 처리하는 형태가 많습니다.
작업 전에 모든 걸 알 필요는 없고, 오케스트레이션 단계 전에만 알면 됩니다.
직접 해보기: 가장 빠른 길은 기본 내장 워크플로우입니다.
/deep-research <질문>을 실행하면 여러 에이전트가 출처를 교차검증해 리포트를 만들어내는 과정을 그대로 볼 수 있습니다.
내 작업에 쓰려면 프롬프트에 ultracode를 넣거나 "워크플로우로 처리해줘"라고 요청하면 됩니다.
진행 상황은 /workflows에서 실시간으로 볼 수 있고, 마음에 든 실행은 그 화면에서 s 키로 내 명령어로 저장할 수 있습니다.
Claude Code v2.1.154 이상 , 유료 플랜에서 동작합니다(Pro는 /config의 Dynamic workflows를 켜야 합니다).
Anthropic API, Amazon Bedrock, Google Cloud Agent Platform, Microsoft Foundry에서도 지원됩니다.