Data
CDC 파이프라인 정합성 검사 Spark 잡 개발 - Part 2. Spark 최적화편
dawn.choi카카오
2025년 7월 28일
원문에서 보기 ↗1. 들어가며
안녕하세요, 카카오 데이터분석플랫폼 조직의 dawn(최여명)입니다.
앞선 Part 1. 코드 설계편에서는 정합성 검사 Spark 잡(Job)의 코드를 어떻게 구조적으로 설계했는지를 중심으로 글을 작성했는데요. 이번 Part 2. Spark 최적화편에서는 이 잡이 Spark 환경에서 빠르고 안정적으로 동작할 수 있도록 적용한 여러 최적화 전략들을 다뤄보려고합니다.
정합성 검사는 매일 수백 개의 잡이 실행되고 하나의 테이블이 수억 건에 달하는 대용량일 때도 많기 때문에 성능 최적화가 매우 중요합니다. 또한 MySQL과 Iceberg처럼 데이터소스에 따라 다른 최적화 접근법도 필요합니다.
이 글에서는 Spark를 선택하게 된 이유부터 최적화 방식, 그리고 실제 운영하며 마주했던 성능 문제를 해결하기 위해 고민하고 적용했던 노하우들을 중심으로 공유드리겠습니다.
그럼 지금부터 Part 2인 Spark 최적화편을 시작하겠습니다.
2. Spark를 선택한 이유
먼저 저희 CDC 시스템에서 정합성 검사를 수행하기 위해서는 몇 가지 중요한 조건을 만족해야 했습니다.
- 매일 약 300개 이상의 연동 테이블을 빠짐없이 검사해야 하며,
- 하나의 테이블에 최대 수억 건에 달하는 대용량 데이터가 존재할 수 있고,
- 단순한 MySQL to MySQL 비교뿐 아니라, MySQL to Iceberg처럼 이기종 데이터소스 간 비교도 필요합니다.
이러한 요구사항을 고려했을 때, Spark는 가장 적합한 선택지였는데요. 이유는 아래와 같습니다.
- Spark는 잡 제출 방식으로 자원을 할당받고 실행되기 때문에, 수많은 테이블을 각각 개별 잡 단위 로 나누어 처리할 수 있습니다. 덕분에 테이블 단위로 모니터링과 실패 복구도 수월해집니다. 특히 사내 YARN 클러스터를 활용하면 자동으로 큐잉과 자원 스케줄링을 수행해주기 때문에 관리포인트를 최소화할 수 있습니다.
- Spark는 데이터를 여러 파티션으로 나누고, 이를 클러스터 내 Executor들이 병렬로 처리하는 구조를 가지고 있어 대용량 테이블의 데이터도 빠르게 처리할 수 있습니다.
- 다양한 데이터소스(MySQL, Iceberg 등)에서 읽은 데이터를 모두 아주 잘 추상화된 DataFrame 형태로 다룰 수 있습니다. 이 덕분에 데이터 비교 로직을 공통화하고 간결하게 유지할 수 있습니다.
3. MySQL에서의 스캔모드에 따른 최적화
MySQL의 데이터를 읽을 때는 단순히 빠르게 읽는 것보단 데이터베이스의 부하 측면에서도 주의가 필요합니다. NoSQL과 달리 RDB는 트랜잭션과 데이터 무결성을 엄격하게 보장하기 때문에 지나치게 무겁거나 잦은 쿼리 요청은 데이터베이스 부하로 이어질 수 있습니다. 정합성 검사가 세컨더리(Secondary) DB에서 수행되긴 하여도 동기화의 지연이나 프라이머리(Primary)-세컨더리(Secondary) 스위칭시 영향이 있을 수 있기에 데이터 스캔시 속도와 안정성 사이에서 적절한 타협점을 찾는 것이 중요합니다.
Spark는 내장된 JDBC 데이터소스 API(spark.read.format("jdbc"))와 JDBC 드라이버를 사용하여 MySQL로부터 데이터를 읽습니다. 이 때 Spark의 Executor 수, Core 수, 메모리 크기와 같은 물리적인 설정도 중요하지만 JDBC 데이터소스 API에서 제공되는 여러 병렬 처리 옵션을 적절히 튜닝하는 것도 중요합니다. 앞선 Part 1에서 정합성 검사 시 데이터를 읽는 방식은 총 세 가지가 존재한다고 말씀드렸는데요.
- 전체 데이터를 읽는
fullscan - 특정 PK만 조회하는
keybased - 한정된 범위만 조회하는
limit
각 모드별로 사용되는 옵션과 이 옵션 값들을 어떻게 튜닝했는지에 대해 하나씩 설명하겠습니다.
Fullscan 모드
풀스캔(fullscan) 모드는 말 그대로 테이블의 전체 데이터를 읽는 방식이기 때문에 데이터베이스에 부하를 최소화하면서도 데이터를 빠르게 읽을 수 있도록 적절한 병렬 처리가 중요합니다. 하나의 쿼리가 너무 많은 레코드를 읽으면 슬로우 쿼리가 발생할 수 있고, 반대로 너무 작은 단위로 나눠 많은 쿼리를 동시에 실행하면 커넥션 풀을 과도하게 점유하여 부하가 커지고 오버헤드가 증가할 수 있습니다. 따라서 쿼리당 처리할 레코드 수와 병렬 처리 수준 간의 밸런스를 잘 맞추는 것이 매우 중요하고 최적화를 위해 Spark의 JDBC 데이터소스 API 옵션 중 몇 가지를 주요 옵션으로 사용합니다
우선 numPartitions는 Spark가 테이블을 읽을 때 최대 몇 개의 병렬 파티션으로 나누어 처리할지를 설정하는 옵션으로 최대 JDBC 동시 커넥션 수를 의미하기도 합니다. 이 옵션은 Spark의 Executor 인스턴스 수와 Core 수를 곱한 워커 수와도 밀접한 관련이 있는데요.
- numPartitions 값이 워커 수보다 크면 Spark는 더 잘게 데이터를 나누지만 실제 동시 처리는 워커 수를 초과할 수 없어 기대한 성능만큼 나오지 않을 수 있습니다.
- 반대로 워커 수(Executor 수 × Core 수)가 numPartitions보다 너무 크면, 지나치게 많은 JDBC 커넥션이 동시에 붙어 데이터베이스 부하가 증가할 수 있습니다.
따라서 최대 병렬 처리 수준은 min(spark.executor.instances x spark.executor.cores, numPartitions)와 같은 공식으로 나타낼 수 있으며 Spark 자원과 데이터베이스 성능을 고려해 적절한 값을 설정해주는 것이 매우 중요합니다,
이렇게 설정한 numPartitions 옵션과 함께 partitionColumn, lowerBound, upperBound 옵션을 함께 사용하게 됩니다. partitionColumn은 테이블을 나눌 때 기준이 될 컬럼으로 주로 PK(Primary Key)를 지정합니다. 또한 데이터 분할 범위를 정하기 위해 lowerBound와 upperBound 옵션에 각각 해당 컬럼의 최소값(min(id))과 최대값(max(id))을 미리 조회하여 설정합니다. 참고로 여기서 lowerBound와 upperBound는 단순히 파티션 범위를 나누는 기준값일 뿐, 실제 데이터를 필터링하는 조건으로는 적용되지 않습니다.
아래는 실제 풀스캔 모드의 예시 코드입니다.
spark.read
  .format("jdbc")
  .option("url", urlWithParameters)
  .option("dbtable", datasourceConfig.table)
  .option("numPartitions", datasourceConfig.numPartitions)
  .option("lowerBound", lowerBound.get)
  .option("upperBound", upperBound.get)
  .option("partitionColumn", keyColumn)
  .option("customSchema", datasourceConfig.customSchema)
  .options(commonProperties)
  .load()
실제 1,000만 건의 레코드를 가지고 있는 테이블을 사용하여 numPartitions 값과 워커 수에 따른 읽기 성능 테스트를 진행한 결과는 아래와 같은데요. 병렬 처리가 증가할수록 소요시간이 크게 감소했지만, 특정 시점 이후에는 병렬도를 더 높이더라도 성능 향상이 미미하거나 정체되는 것을 확인할 수 있습니다.
| Executor 수 | Core 수 | 워커 수 (Executor 수 x Core 수) | numPartitions | 소요시간 (초) |
|---|---|---|---|---|
| 8 | 4 | 32 | 1 | 28 |
| 8 | 4 | 32 | 5 | 8 |
| 8 | 4 | 32 | 10 | 5 |
| 8 | 4 | 32 | 50 | 5 |
| 16 | 4 | 64 | 100 | 4 |
| 32 | 4 | 128 | 100 | 4 |
Keybased 모드
키 기반(keybased) 모드는 특정 기본 키(PK, Primary Key)를 가진 레코드만 부분적으로 정합성을 검사하는 방식입니다. 저희 CDC 파이프라인에서는 매일 변화가 발생한 PK만 별도의 ORC(Optimized Row Columnar) 파일로 저장하는 서브 태스크를 함께 운영하고 있습니다. 따라서 매번 테이블 전체를 풀스캔하지 않고 이 변화분 기록 파일을 기반으로 해당 날짜의 변경된 데이터만 추출하여 정합성을 검사합니다.
Spark에서는 이 작업에 predicates 옵션을 활용합니다. 이 옵션은 SQL의 WHERE 절 조건을 문자열 리스트 형태로 전달받아 각 조건별로 쿼리를 실행하고 결과를 개별 파티션으로 나눠 읽을 수 있게 합니다. 그리고 predicates에 넣은 문자열 리스트 길이만큼 JDBC 커넥션이 생성되고 병렬 처리가 가능하게 됩니다. 이 때 풀스캔 모드와 마찬가지로 최대 병렬 처리 수준은 워커 수를 뛰어넘을 수 없으며 데이터베이스에 부하가 가지 않도록 적절한 길이로 나누어 조회하는 것이 중요합니다.
정합성 검사에서는 WHERE id IN (…) 형식의 조건문을 사용하여 특정 PK 집합에 대한 데이터만 부분적으로 추출하는데요. 예를들어 변화분 파일에 1부터 10000까지의 PK가 기록되어 있다고 가정해보겠습니다. 먼저 PK를 100개 단위로 나누어 id IN (...) 형태의 조건문 문자열로 변환합니다. 이후 이 조건문들을 다시 설정한 값에 따라 다시 나누어 predicates 옵션에 전달합니다.
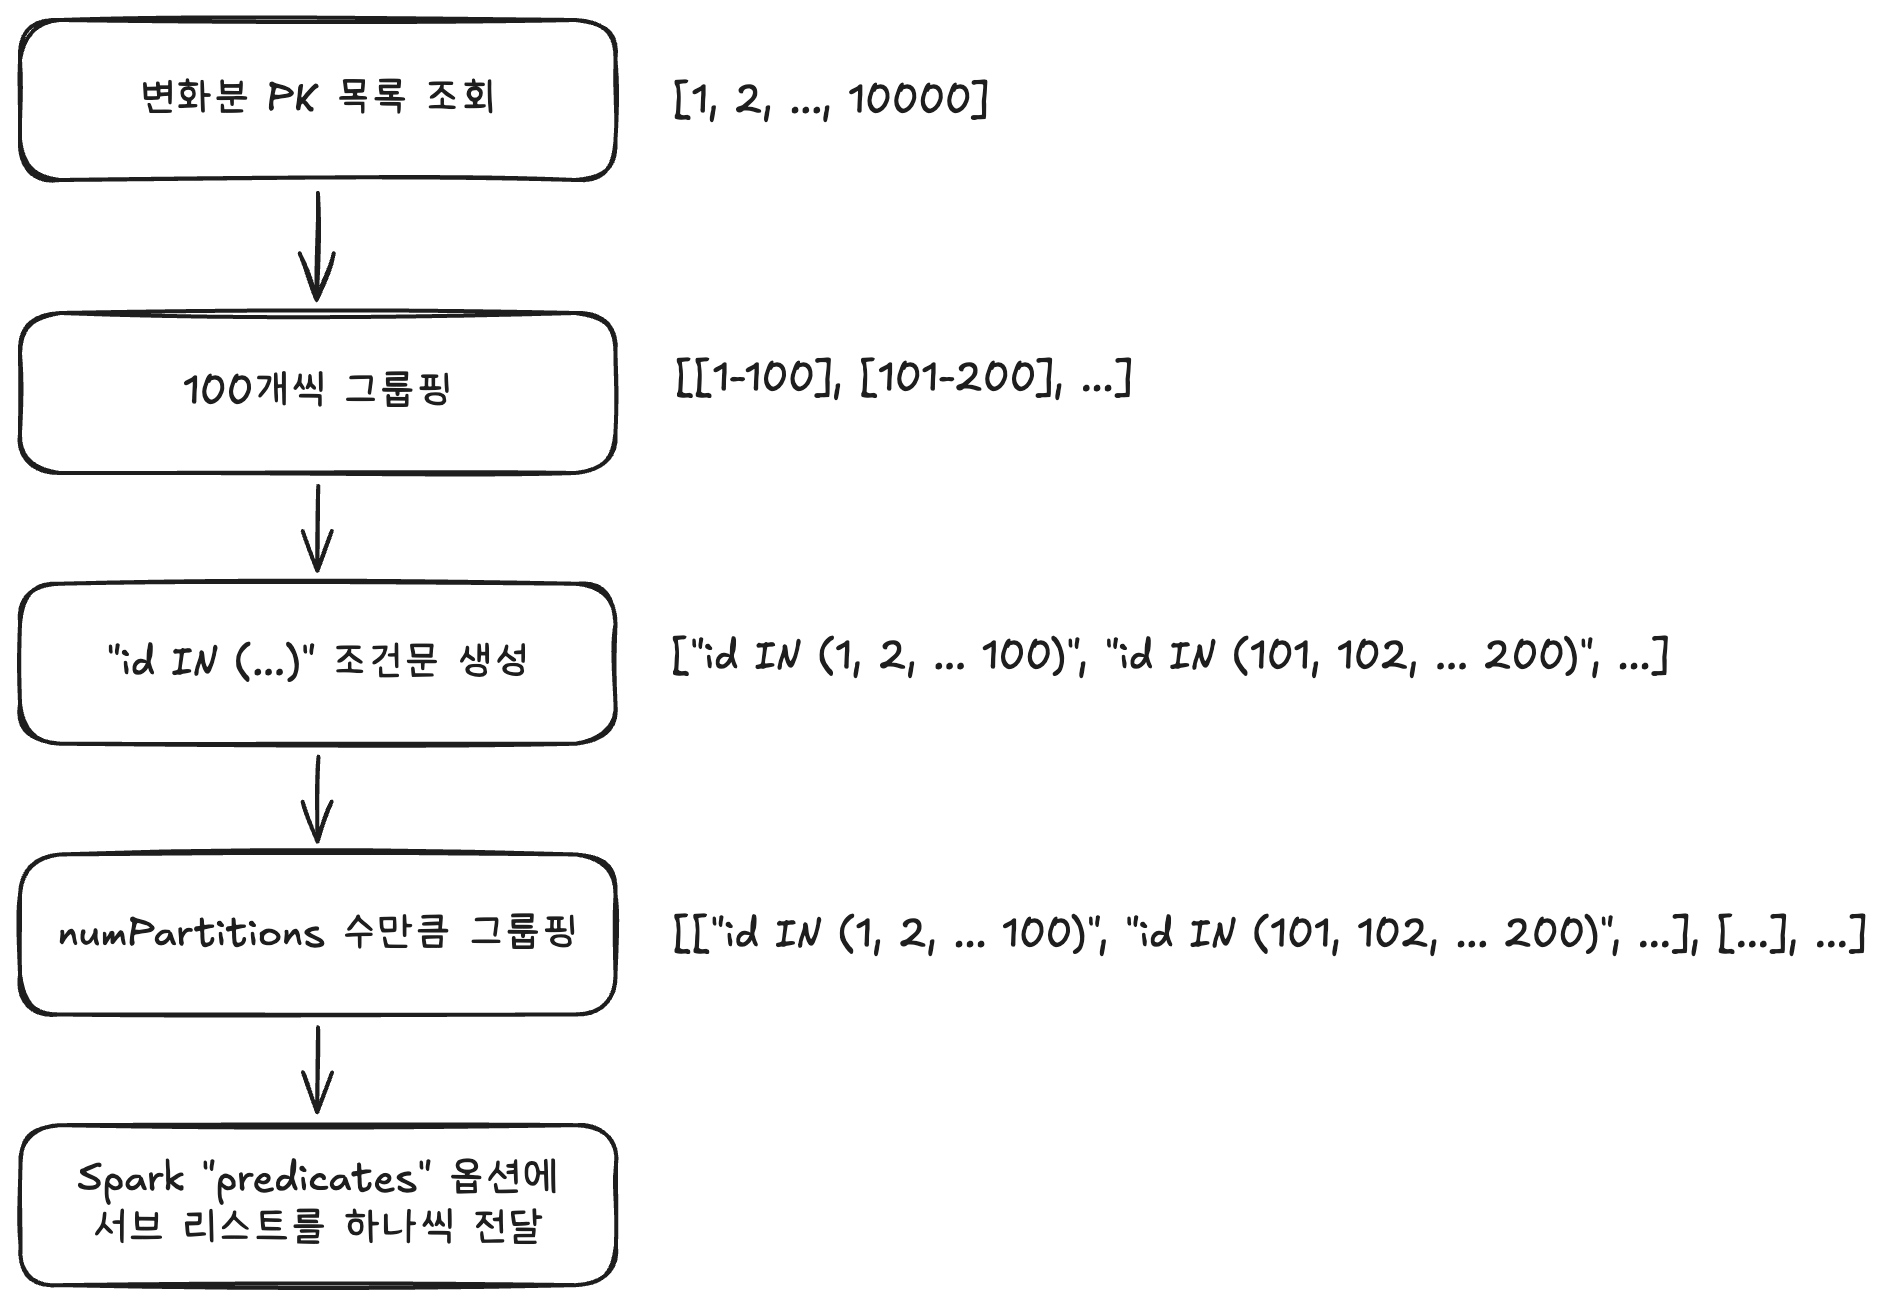
이렇게 하면 각 리스트의 크기만큼 병렬로 쿼리가 실행되어 데이터를 빠르게 읽을 수 있습니다. 또한 모든 조건문을 한꺼번에 전달하지 않고 일정 개수씩 그룹핑해서 전달하는 이유는 워커 수가 많은 경우 과도한 동시 JDBC 커넥션으로 인한 부하를 방지하기 위함입니다.
한편 변화분이 너무 많거나 그룹을 지나치게 작은 단위로 나누게 되면 과도하게 많은 파티션과 태스크가 생성되어 오히려 잡 실행 시간이 비정상적으로 길어질 수 있는데요. 이를 방지하기 위해 Spark의 coalesce를 사용해 데이터프레임의 파티션 수를 적절히 압축 해줍니다. 이때 레코드 하나의 평균 크기를 약 0.5KB로 가정하고, 1개 파티션당 약 256MB를 목표로 하여 파티션당 50만 개의 레코드 가 들어가도록 조정합니다. 결과적으로 PK Row 수 / 500,000 만큼의 파티션 수로 coalesce를 적용합니다.
아래는 실제 키 기반 모드의 예시 코드입니다.
val predicates = keyGroups.map { group =>
  val keysString = generateTuples(group)
  s"(${datasourceConfig.pkColumns.mkString(", ")}) IN ($keysString)"}.toArray
val predicateGroups = predicates.grouped(datasourceConfig.numPartitions).toSeq
val dfs = predicateGroups.map { predicates =>
  spark.read
    .option("customSchema", datasourceConfig.customSchema)
    .jdbc(urlWithParameters, datasourceConfig.table, predicates, properties)
}

dfs.reduce(_ union _).coalesce(keys.size / COALESCE_PARTITION_SIZE + 1)
참고로 위에서 사용한 predicates 옵션은 spark.read.format("jdbc") 방식에서는 지원되지 않으며 반드시 spark.read.jdbc(...) 메서드를 통해 사용해야 합니다.
Limit 모드
Limit 모드는 테이블에서 일부 레코드만 추출하여 정합성을 검사하는 방식입니다. 연동 직후 전체 데이터를 스캔하기에는 데이터 양이 너무 커 부담이 되는 경우 최신 일부 데이터만 샘플링하여 빠르게 검증하고자 할 때 유용합니다.
이 모드는 Spark의 JDBC API에서 dbtable 옵션에 서브쿼리를 정의하는 방식으로 동작하며 SQL 쿼리 내부에 LIMIT 구문을 명시합니다. 또한 이 모드에는 풀스캔이나 키 기반 모드처럼 병렬 처리 최적화를 적용하지 않습니다. 대신 단일 쿼리로 수행되며 안정성을 위해 내부적으로 최대 LIMIT 개수를 100만 건으로 제한하고 있습니다.
아래는 실제 Limit 모드의 예시 코드입니다.
if (modeConfig.limitNumber > MAX_LIMIT_NUMBER) {
  throw new IllegalArgumentException(s"limitNumber exceeds the maximum limit number $MAX_LIMIT_NUMBER")
}

val limitQuery =
  s"(SELECT * FROM ${datasourceConfig.table} ORDER BY $keyColumn DESC LIMIT ${modeConfig.limitNumber}) AS tmp"

spark.read
  .format("jdbc")
  .option("url", urlWithParameters)
  .option("dbtable", limitQuery)
  .option("customSchema", datasourceConfig.customSchema)
  .options(commonProperties)
  .load()
4. Iceberg에서의 스캔모드에 따른 최적화
Iceberg는 MySQL과 다르게 엄격하게 관리되는 운영 DBMS가 아니기 때문에 부하로부터 비교적 자유롭습니다. 따라서 데이터를 조회하는데 부담이 적고 병렬 처리 수에 대한 제약도 없어 Spark 워커 수를 훨씬 더 크게 할당할 수 있습니다. 하지만 Iceberg는 RDB처럼 PK 기반 인덱스를 제공하지 않기 때문에 특정 레코드만 빠르게 조회하는 것은 어렵습니다. 따라서 keybased나 limit 모드처럼 일부 레코드만을 읽어야 하는 경우에도 전체 데이터를 먼저 스캔한 뒤 후처리를 통해 필요한 데이터만 필터링하는 구조로 동작합니다.
또한 매번 데이터를 풀스캔하는 만큼 Spark가 Iceberg 테이블을 더욱 효율적으로 읽을 수 있도록 compaction이나 스냅샷 만료(expireSnapshots) 같은 유지 관리 작업을 주기적으로 수행해주고 있습니다. 이런 작업은 데이터 파일 수를 최적화하고 메타데이터 크기를 줄여 불필요한 스캔을 줄이고 읽기 성능을 높이는 데 도움이 됩니다.
아래는 각 모드에 대한 실제 코드 예시입니다.
Fullscan 모드
spark.read
  .format("iceberg")
  .load(s"${datasourceConfig.namespace}.${datasourceConfig.table}")
Iceberg 테이블 전체를 그대로 읽습니다. Iceberg의 파일 단위 메타데이터를 기반으로 Spark가 병렬 처리를 자동으로 수행합니다.
Keybased 모드
val keysDF = readSearchKeyPath()
if (keysDF.isEmpty) {
  return spark.emptyDataFrame
}
val fullScanDF = readWithFullScanMode()
val resultDF = fullScanDF.join(keysDF, datasourceConfig.pkColumns, "inner")
resultDF
먼저 데이터를 풀스캔 후 변화분 파일에서 가져온 PK와 inner join을 수행해 필요한 부분만 추출합니다.
Limit 모드
val df = readWithFullScanMode()
val resultDF = df.orderBy(desc(keyColumn)).limit(modeConfig.limitNumber)
resultDF
먼저 데이터를 풀스캔 후 DataFrame API를 통해 order by과 limit을 수행하여 최근 N개의 데이터만 추출합니다.
5. 기타 최적화 및 로직 적용 사항
캐싱
Spark의 Lazy Evaluation(지연 평가) 특성상 Action 연산자(e.g. count(), show())가 호출될 때마다 해당 연산에 필요한 전체 연산을 다시 실행합니다. 이 때문에 동일한 DataFrame을 반복해서 사용하는 경우 매번 데이터를 다시 읽어오게 되어 불필요한 비용이 발생할 수 있습니다.
따라서 같은 데이터에 대해 여러 번 연산을 수행하는 경우 cache()를 통해 데이터를 메모리 또는 디스크에 저장해두는 것이 효율적입니다. 특히 정합성 검사처럼 데이터베이스에서 데이터를 읽어오는 경우 캐싱을 통해 중복된 쿼리 실행과 DB 부하를 방지할 수 있습니다.
실제 저희 정합성 검사 코드에서도 Reader가 spark.read로 데이터를 로드한 직후 바로 cache()를 호출해 캐싱을 수행합니다. 이후 count(), show(), take() 등 여러 연산을 수행하더라도 데이터베이스에는 최초 1회만 접근하게 됩니다.
정합성 비교 로직
두 데이터소스에서 읽은 DataFrame 정합성 비교시 다음 세 가지 케이스를 고려합니다.
- 소스 DB와 타겟 DB에 동일한 PK를 가진 레코드가 그 외 서로 다른 컬럼 값을 갖는 경우
- 소스 DB에만 특정 PK가 존재하는 경우(소스 DB에 레코드가 INSERT 됐지만 타겟 DB에는 반영이 안 되어 있을 가능성)
- 타겟 DB에만 특정 PK가 존재하는 경우(소스 DB에서 레코드가 DELETE 됐지만 타겟 DB에는 반영이 안 되어 아직 남아 있을 가능성)
이러한 케이스를 모두 포괄하기 위해 두 DataFrame을 PK 기준으로 full_outer 조인을 수행합니다. full_outer 조인을 사용하면 한쪽에만 존재하는 레코드도 함께 조회할 수 있기 때문입니다. 이후 소스와 타겟의 PK 중 하나라도 값이 Null인 경우를 필터링하고 (케이스 2, 3에 해당), PK는 같지만 다른 컬럼 중 값이 다른 경우를 필터링하여 (케이스 1에 해당) 최종적으로 일치하지 않는 레코드만 필터링합니다.
아래는 실제 비교 로직의 코드 예시입니다.
// 소스와 타겟 PK 기준으로 full outer 조인 수행
val joinedDF = source.getDF
  .alias("source")
  .join(target.getDF.alias("target"), pkColumns, "full_outer")

// 소스와 타겟의 PK 중 하나라도 값이 null인 경우
val pkNullCondition =
  pkColumns.map(colName => sourceCol(colName).isNull || targetCol(colName).isNull).reduce(_ || _)

// PK는 같지만 다른 컬럼 중 값이 다른 경우 필터링
val nonPkMismatchCondition = nonPkColumns
  .map(colName =>
    (sourceCol(colName) =!= targetCol(colName)) ||
      (sourceCol(colName).isNull && targetCol(colName).isNotNull) ||
      (sourceCol(colName).isNotNull && targetCol(colName).isNull)
  )
  .reduce(_ || _)

// 위 두 조건 사용하여 일치하지 않는 레코드만 필터링
val filteredDF = joinedDF.filter(pkNullCondition || nonPkMismatchCondition)
nonPkMismatchCondition에서 단순히 =!= 연산만 사용하는게 아닌 isNull과 isNotNull 조건을 사용하는 이유는 =!= 연산은 Null 값 비교 시 True나 False가 아닌 Null을 반환 하기 때문입니다. 예를 들어 한쪽에는 Null, 다른 한쪽에는 Null이 아닌 값이 존재하게되면 =!= 연산은 False가 아닌 Null을 반환하며 이는 필터링 조건에서 무시됩니다. 따라서 Null 값을 명시적으로 비교하여 정확한 필터링이 가능하도록 처리합니다.
또한 위 조인 연산은 Spark의 실행 계획 상 일반적으로 SortMergeJoin으로 수행됩니다. full_outer 조인은 양쪽 테이블의 모든 데이터를 유지해야 하는 특성상 조인 키를 기준으로 데이터 정렬이 필수적이며, 특히 정합성 검사와 같이 양쪽 데이터의 크기가 유사하고 대규모인 경우 SortMergeJoin이 가장 효율적이고 안정적인 방식입니다.
로컬 모드
정합성 검사 Spark 잡은 보통 사내 YARN 클러스터에 제출하지만 보안존 DB처럼 외부 접근이 제한된 환경에서는 사내 YARN 클러스터의 수많은 서버로부터의 접근을 허용할 수 없습니다. 이런 경우에는 접근이 허용된 단일 워커 장비에서 로컬 모드로 잡을 수행합니다.
이 때 사용되는 Spark 옵션에는 몇가지 차이점이 존재하는데요. 우선 로컬 모드의 경우 Executor가 별도로 분리되지 않고 Driver 프로세스 내에서 함께 실행됩니다. 따라서 Executor와 관련된 옵션인 spark.executor.instances, spark.executor.memory 등과 같은 옵션 설정이 무의미합니다. 대신 spark.driver.memory 옵션을 단일 워커 장비가 최대로 사용할 수 있는 크기로 설정하는 것이 유리합니다. 또한 SparkContext의 master 인자를 local[*]로 지정해 시스템에서 사용 가능한 모든 코어 수만큼 Executor 스레드를 생성하여 병렬 작업을 수행할 수 있습니다.
그리고 로컬 모드에서는 spark.sql.autoBroadcastJoinThreshold 값을 -1로 설정해 브로드캐스트 조인이 발생하지 않도록 제한하는 것이 좋습니다. 브로드캐스트 조인은 조인 대상 테이블 전체를 메모리에 적재하고 Disk Spill을 지원하지 않아 로컬 모드 같이 자원이 넉넉하지 않은 환경에서는 OOM(Out Of Memory)이나 무한 실행과 같은 문제가 생길 수 있습니다. 실제로 이 옵션을 설정하지 않은 채 로컬 모드에서 잡을 실행했을 때 작업이 끝나지 않고 무한정 실행되는 현상이 있었으며 -1로 설정함으로써 안정적으로 해결할 수 있었습니다.
6. Part 2를 마무리하며
이번 Spark 잡을 개발하며 대용량 정합성 검사를 안정적이고 효율적으로 수행하기 위한 다양한 최적화 기법을 깊이 있게 연구하고 적용해볼 수 있었습니다. 각 스캔 모드별로 적합한 Spark API와 옵션을 고민하며 성능을 극대화하는 방법을 배울 수 있었고, 데이터소스의 특성에 따라 제약 조건이 다르다는 점도 체감하며 그에 맞는 접근 방식을 고민해볼 수 있었습니다. 또한 캐싱을 적절히 활용해 중복 연산과 DB 부하를 줄이고, 다양한 케이스를 포괄하는 조인 로직을 설계하며, 로컬 모드 환경에서도 자원을 최대한 활용하는 등 여러 측면에서 유의미한 인사이트를 얻을 수 있었습니다.
물론 아쉬움도 있습니다. 예를 들어 변화분 PK가 연속된 구간으로 존재하는 경우, 키 기반 모드에서 WHERE IN 쿼리 대신 범위 기반 쿼리(BETWEEN)를 사용하는 방식이 더 효율적이지 않을까 고민이 들었습니다. Iceberg 테이블 역시 File-level Pruning이 더 효과적으로 작동할 수 있도록 사전 필터링을 적극적으로 활용하거나 Sort Order와 같은 구조적인 최적화 기법을 도입할 여지도 있다고 생각합니다. 또한 로컬 모드는 단일 워커 서버라는 제약이 있어 Spark on Kubernetes 구조로 확장하면 더 나은 성능을 기대할 수 있을 것으로 보입니다.
그럼에도 불구하고 이번 프로젝트를 통해 단순히 Spark 잡을 작성하는 수준을 넘어, 운영 환경과 목적에 최적화된 구조를 직접 설계하고 안정적으로 운영하는 실질적인 경험을 쌓을 수 있었습니다. 현재 이 Spark 잡은 매일 수백 개의 대용량 테이블 정합성을 빠르고 안정적으로 검사하며 운영되고 있습니다.
마지막으로 이번 코드 개발에 함께 참여해주신 stephen.c(천수환), sun.min(이선민), wayne.pk(박경원) 님께 감사의 인사를 전하며 글을 마무리합니다. 긴 글 읽어주셔서 감사드리며 이 글이 CDC 파이프라인에 정합성 검사 도입을 고민 중인 개발자분들께 작게나마 도움이 되기를 바랍니다.