Data
Third-Party 데이터 웨어하우스 구축
David / 김호준여기어때
2022년 10월 26일
원문에서 보기 ↗Third Party 데이터 웨어하우스 구축
Contents
- Overview
- Third Party Tools (Braze, Amplitude)
- Building braze data into DW
- Building amplitude data into DW
- Issues & Solutions
Overview
안녕하세요. 인프라개발팀 데이터엔지니어 데이비드입니다.
본 블로그에서는 Third Party 수집 데이터를 사내 DW(Data Warehouse)에 구축하기 위해 데이터 엔지니어로서 수행한 작업 내용을 공유드립니다. 주요 내용은 데이터 엔지니어링이지만 Third Party 툴을 사용하시는 마케터나 데이터 분석가 분들께도 도움이 됐으면 좋겠습니다.
최종 목표는 사용자 행동 데이터 기반 BI(Business Intelligence)/Analytics를 하기위한 DW 환경을 구축 하는 것 입니다.
- 해당 환경을 구축하기 위해, 데이터소스 별 Raw Data 추출 → ETL → DW 적재 과정이 필요합니다.
- 고품질 데이터를 가공하기 위해, 다양한 데이터소스를 통합하는 과정이 필요합니다.
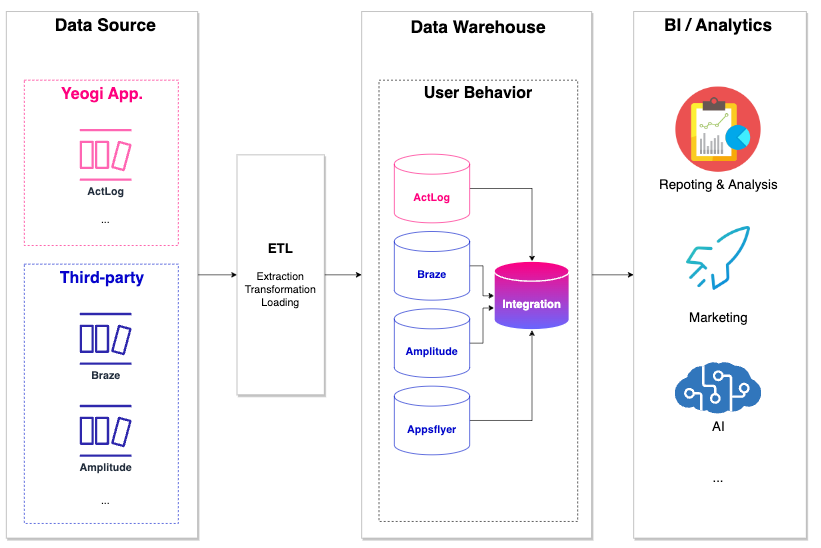
Data Warehouse Architecture
Third-Party Tools
먼저 Third Party 툴에 대해 간략히 살펴보겠습니다.
각 솔루션마다 다양한 데이터 및 기능(분석/예측/시각화 등)을 제공하며, 차별화 포인트가 다릅니다.
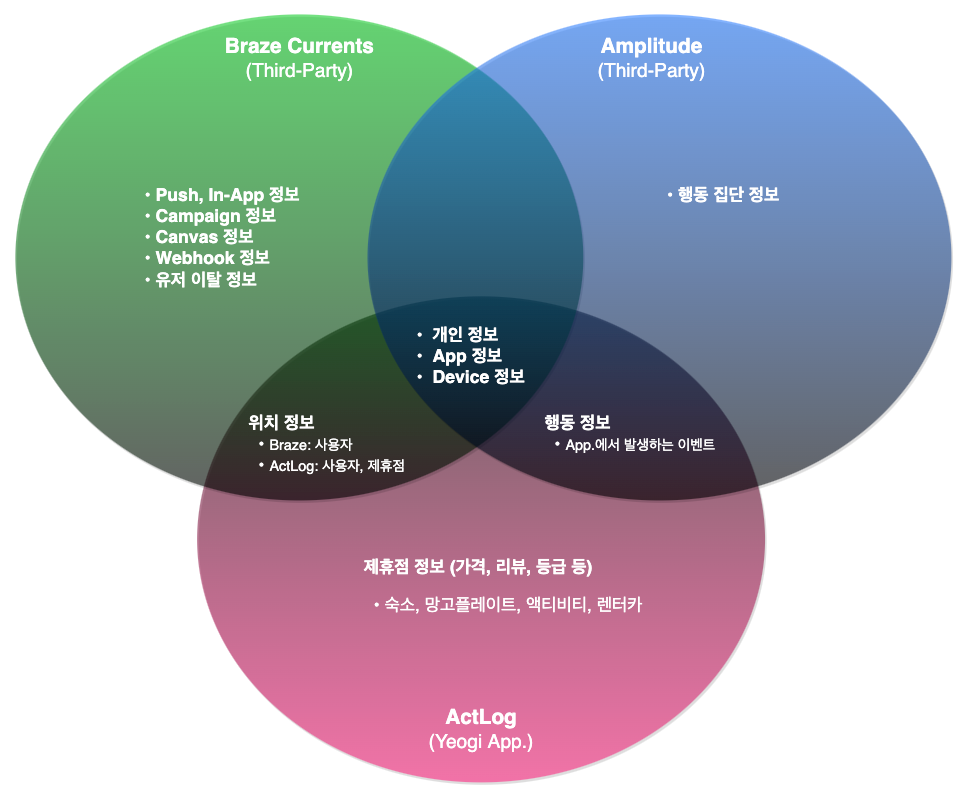
Venn Diagram of Data Source Features
Braze (고객 인게이지먼트 & 마케팅 자동화 솔루션)
고객 프로필/행동 데이터를 웹/앱에서 실시간으로 수집 및 처리하여 수준 높은 개인화 캠페인을 제작하고 자동화하며, 고객 인게이지먼트 전략을 지속적으로 발전시킬 수 있음
차별화 포인트
- 푸시메시지, 인앱메시지, 이메일, 문자, 쿠폰 발급 등 일체의 메시징 수단들을 Braze 솔루션 하나로 통제
- 고객 세분화, 여정구축, 개인화를 한번에 처리
- 구매/이탈 예측을 통한 타겟 오디언스 설정
- 크로스 채널을 통한 캠페인 성과 극대화
Amplitude (고객 행동 기반의 제품 분석 솔루션)
고객 프로필/행동/제품사용 데이터를 웹/앱에서 실시간으로 수집 및 처리하여 고객이 선호하는 맞춤형 경험을 제공할 수 있음
차별화 포인트
- 빠르고 지능적인 고객 행동 분석 및 인사이트 도출을 통해 고객 인게이지먼트/리텐션/충성도를 높이고 생산성을 향상시킬 수 있음
- 데이터 분석을 통한 행동 예측 및 추천
- 고객 행동과 분석에 기반한 A/B 테스팅 솔루션
- 실무에 바로 쓰는 14가지 인사이트 차트
Building braze data into DW
- Architecture
Braze 데이터 DW 구축 과정 및 아키텍쳐는 다음과 같습니다.
- Export Data (Braze to S3)
- 이벤트 별 ETL 처리: 한 시간에 한번 S3에 추출된 데이터(한 시간 전 데이터)를 추출/변환/적재하는 스케쥴이 실행됩니다.
- DW (Redshift) 적재: 특정 크기 이상(내부 기준) 발생하는 이벤트의 경우 External Schema(S3 내 Parquet 저장 및 Redshift Spectrum 접근)로 처리하며, 그렇지 않은 경우 Internal Schema(Redshift 적재)로 처리합니다.
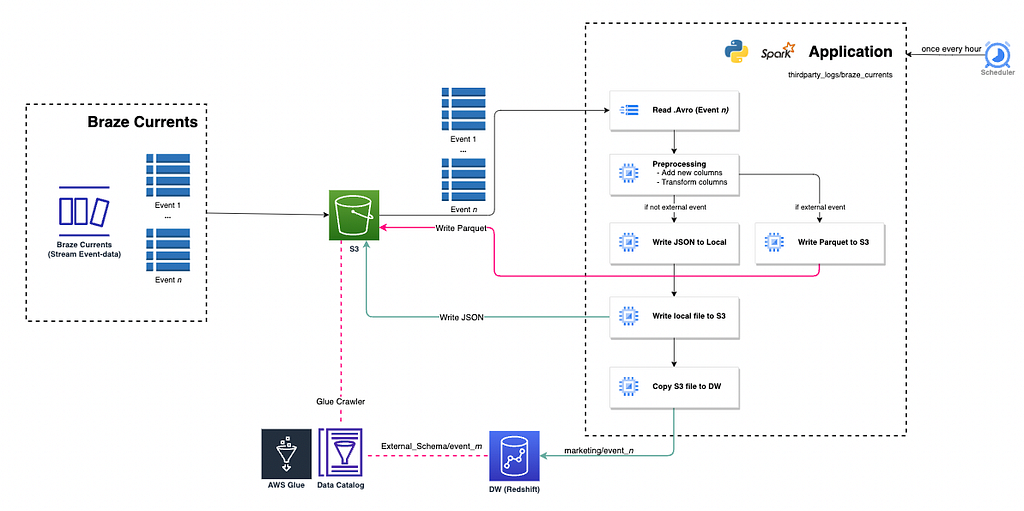
Braze Architecture
- Export Data (Braze to S3)
Braze와 AWS S3를 연동하고 추출할 데이터 종류들을 선택하는 과정입니다.
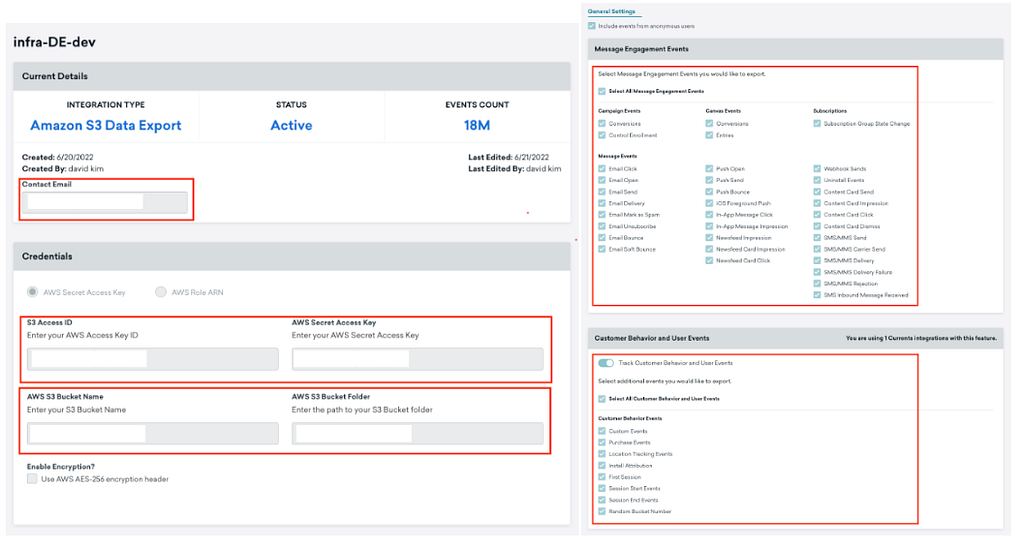
Braze Extraction Settings
Braze Currents 데이터 특징 및 S3 저장 경로는 다음과 같습니다.
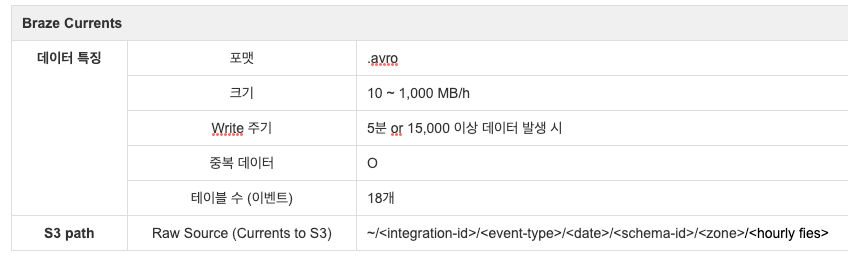
S3로 추출된 데이터 구조는 다음과 같습니다.
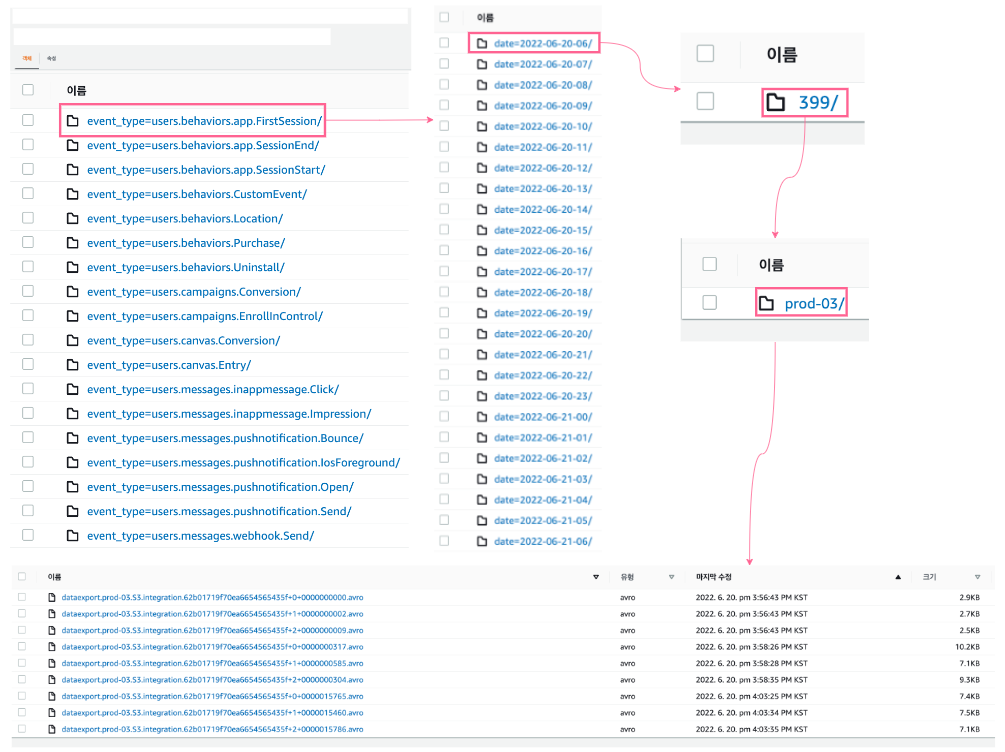
Data Structure of Braze Extraction Data
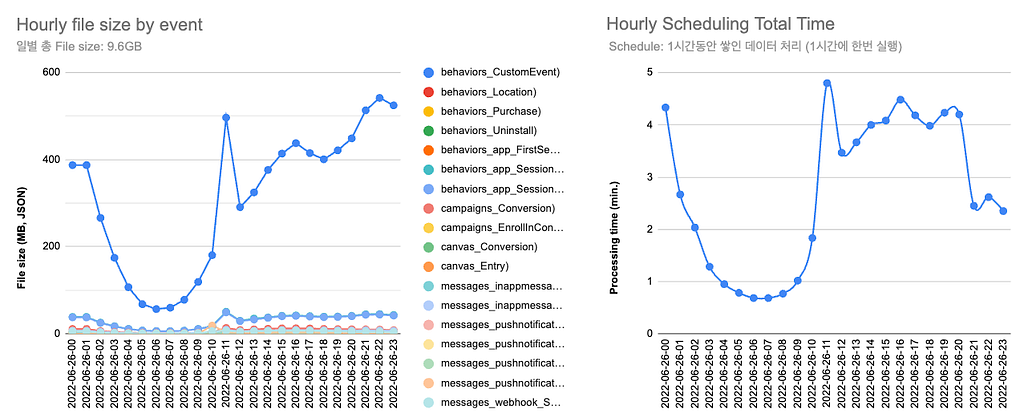
- Metric
파일 크기: 오후 시간대에 트래픽이 급격히 올라 파일 크기가 증가하는 것을 볼 수 있으며, 하루에 총 발생하는 데이터는 9.6GB 입니다.
외부 스키마: behaviors_CustomEvevnt의 경우, 데이터 크기가 내부 기준 이상 발생하기 때문에 External Schema로 처리합니다.
처리 시간: 시간 별 스케쥴 전체 처리 시간은 5분 이하입입니다.
Building amplitude data into DW
- Architecture
Amplitude 데이터 DW 구축 과정 및 아키텍쳐는 다음과 같습니다.(ETL을 제외하고 Braze와 동일)
- Export Data (Amplitude to S3)
- 이벤트 별 ETL 처리: 한 시간에 한번 S3에 추출된 데이터(한 시간 전 데이터)를 추출/변환/적재하는 스케쥴이 실행됩니다.
- DW (Redshift) 적재: 특정 크기 이상(내부 기준) 발생하는 이벤트의 경우 External Schema(S3 내 Parquet 저장 및 Redshift Spectrum 접근)로 처리하며, 아닌 경우 Internal Schema(Redshift 적재)로 처리합니다.
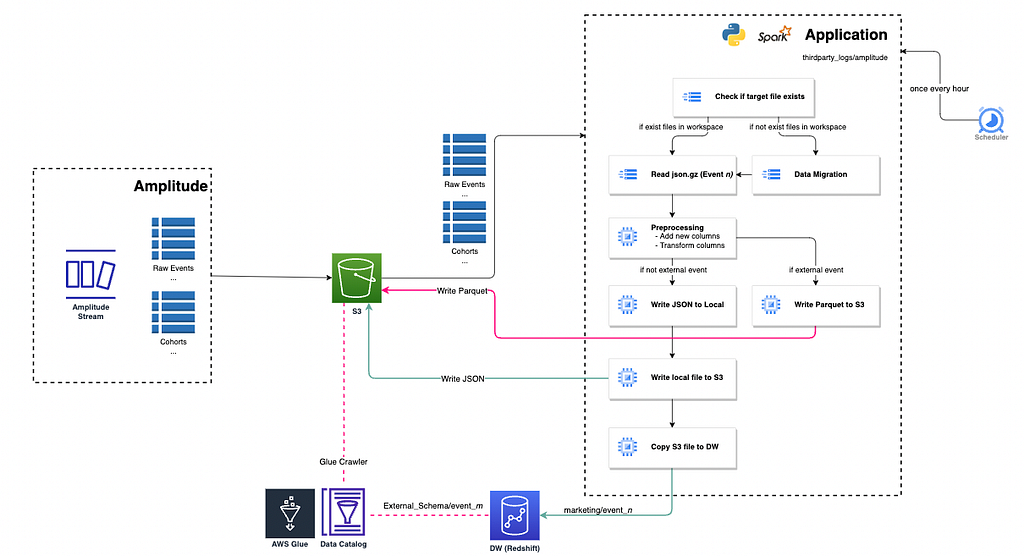
Amplitude Architecture
- Export Data (Amplitude to S3)
Amplitude와 AWS S3를 연동하고 추출 과정의 로그 확인이 가능하며, 과거 데이터 수동 추출이 가능합니다.(Braze는 불가능)
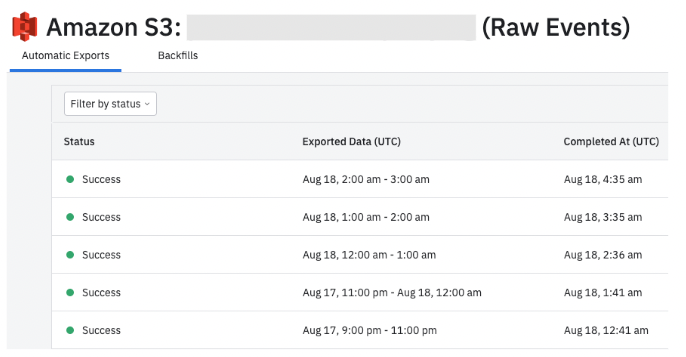
Amplitude Extraction Settings
Amplitude 데이터 특징 및 S3 저장 경로는 다음과 같습니다.
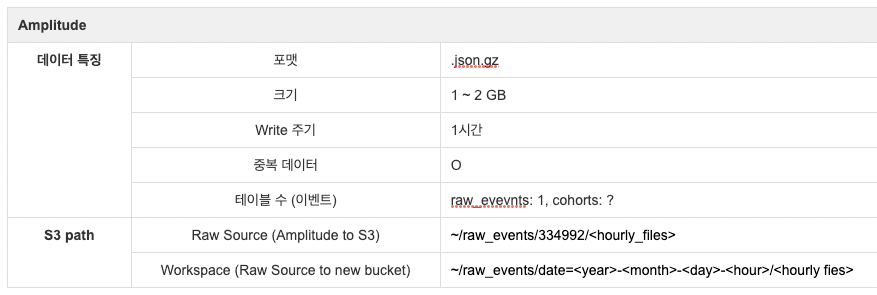
S3로 추출된 데이터 구조는 다음과 같습니다. Braze와 다르게 전체 데이터가 한 폴더에 스케쥴 파티션(시간) 없이 저장되어 ETL 처리 시간 및 편의성에 이슈가 있기 때문에 해당 프로세스를 개선하였습니다.
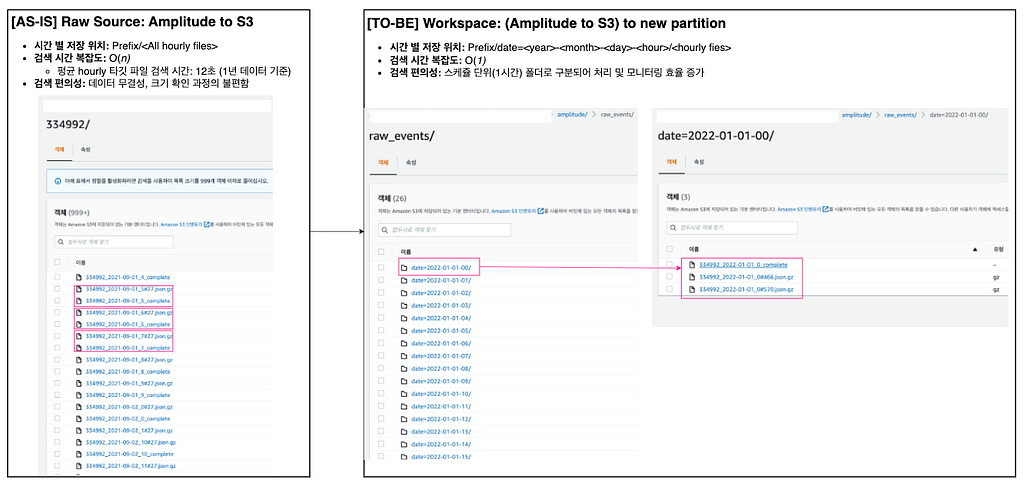
Data Structure Improvements
처음 처리되는 데이터는 New Partition(Work Space)으로 이전하는 작업이 추가되며, 재처리하는 경우는 이전 작업 없이 Work Space를 참조하여 데이터를 처리합니다. (Braze와 ETL 처리가 다른 부분)
- Metric
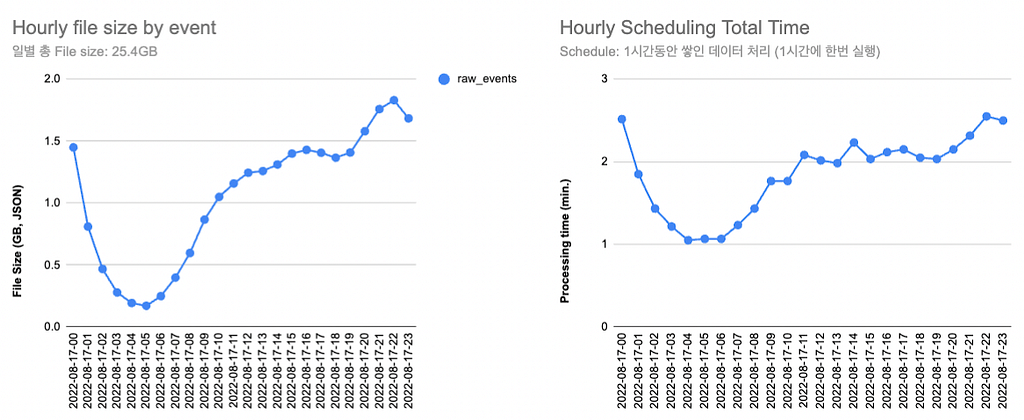
파일 크기: 하루에 총 발생하는 데이터는 25.4GB 입니다.
외부 스키마: Amplitide는 raw_evevnts 테이블 하나에 모든 데이터가 쌓이며, External Schema로 처리됩니다.
처리 시간: 시간 별 스케쥴 전체 처리 시간은 3분 이하입니다.
Issues & Solutions
데이터 중복
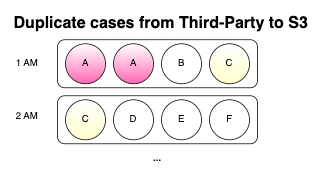
- 이슈: Braze, Amplitude 모두 최소 한 번 전달 정책(At-least-once Delivery)을 사용하기 때문에 데이터의 누락은 없으나, 중복이 발생합니다.
- 해결 방안
- 같은 스케쥴 파일 내 중복 케이스 (A): 시간 단위 스케쥴 ETL 과정에서 중복 제거
- 다른 스케쥴 파일 간의 중복 케이스 (C): 여러 방법이 있으며, 각 장/단점을 고려하여 상황에 맞게 적용
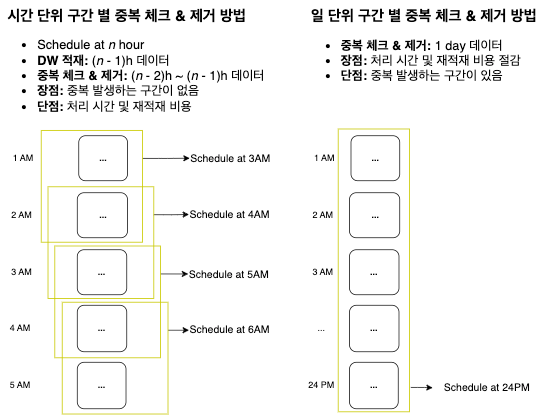
다른 스케쥴 파일 간의 중복 케이스 (C): 처리 방법
데이터 소스 별 호환성
- 이슈
- 데이터 소스 별 특정 컬럼의 인코딩 방법이 다른 경우
- 데이터 소스 간 직접 조인 키가 없는 경우
- 해결 방안
- Actlog(Yeogi App.) 데이터 소스 기준으로 인코딩 방법 통일
- 내부 타 브릿지 테이블을 거쳐 조인
이상으로 Third Party 데이터 웨어하우스 구축 이야기를 마치겠습니다.
사용자 행동 데이터를 잘 분석하고 활용하여 여기어때가 더 좋은 서비스를 할 수 있기를 기대하며, 다음에 더 좋은 내용으로 찾아 뵙겠습니다.
긴 글 읽어주셔서 감사합니다.