Backend
BloomFilter는 언제 쓰나요?
2019년 7월 25일
원문에서 보기 ↗"데이터테크랩의 김준성 전임님, 박지수 전임님과 함께 수행한 업무 중 공유하면 좋을 것 같은 내용을 정리한 글입니다."
확률적 자료구조인 블룸필터가 저장소도 아낄 수 있고 빨리 검색할 수 있어서 hbase, redis 등 여러 디비에서도 활용되고 있다는 말을 많이 들어보셨을 겁니다. 좋은 것은 알겠는데 실제 어떻게 활용되고 있는지 어떤 원리로 데이터를 함축적으로 표현할 수 있는지 간단하게 설명해 드리고 또 실제 데이터 처리 환경에서 어떻게 사용하고 있는지 예시를 통해 소개해 드리는 시간을 준비해 봤습니다.
블룸필터의 원리 및 구현
블룸필터를 한줄로 설명드리면 "어떤 값이 집합에 속해 있는가?를 검사하는 필터 및 이를 구성하는 자료형" 을 칭합니다.
이 구조를 도식화 해보면 다음과 같습니다. 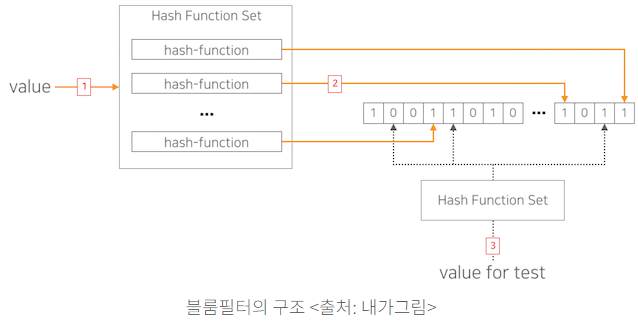
저장하고 싶은 집합의 값을 n개의 hash function을 거치게 하고(1) 이를 통해 나온 각 bit를 bitmap으로 저장(2)합니다.
모든 값에 대해 이과정을 거치면 최종 저장해야 하는 원소의 집합 데이터(dictionary)가 만들어 집니다.
이렇게 저장된 데이터에 어떤 값이 속해 있는지 확인하는 과정은 그림의 1, 2번의 과정과 비슷합니다. 검사하기 위한 값은 hash-function을 거쳐 bitmap으로 표현되고 이 bitmap과 앞서 만든 dictionary를 &연산하여 자신의 bitmap이 나오면 dictionary에 포함되어 있다라고 판단하는 구조 입니다.
많은 데이터가 있어도 bitmap으로 자료를 저장하기 때문에 저장공간을 엄청나게 아낄 수 있지만 hash collision이 일어나 없는 값을 있다라고 말할 경우도 발생합니다. (False Positive)
이를 해결하기 위해 hash function의 갯수 및 bitmap size를 조절하는 방식으로 정확도를 높일 수 있습니다. 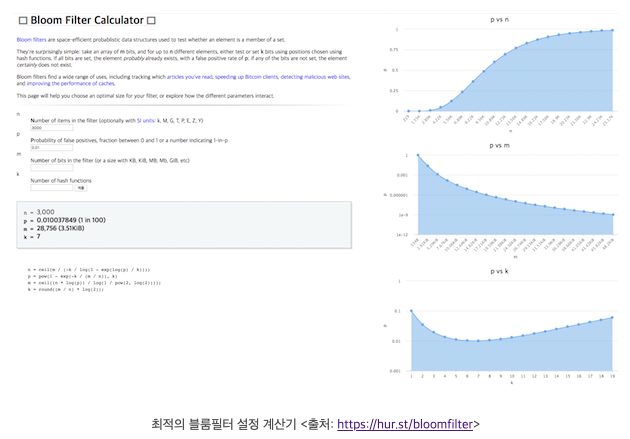
이런 공식을 소스로 다음과 같이 간단하게 구현할 수 있습니다.
package com.airguy.mr.paycouser;

import org.apache.hadoop.util.bloom.BloomFilter;
import org.apache.hadoop.util.bloom.Key;
import org.apache.hadoop.util.hash.Hash;

public class DTLFilter {

	private BloomFilter BF = null;

	public DTLFilter(int RecordNum) {
		int vector_size = getOptimalVectorSize(RecordNum, 0.01f);
		int function_size = getOptimalFunctionSize(RecordNum, vector_size);

		BF = new BloomFilter(vector_size, function_size, Hash.MURMUR_HASH);
	}

	public int getOptimalVectorSize(int numRecords, float falsePosRate) {
		int size = (int) (-numRecords * (float) Math.log(falsePosRate) / Math.pow(Math.log(2), 2));
		return size;
	}

	public int getOptimalFunctionSize(float numMembers, float vectorSize) {
		return (int) Math.round(vectorSize / numMembers * Math.log(2));
	}

	public void add(String key) {
		BF.add(new Key(key.getBytes()));

	}

	public boolean contain(String key) {
		return BF.membershipTest(new Key(key.getBytes()));
	}
}
실전 적용 Case 1
데이터테크랩에서 생성하는 데이터 중에는 "1년 치 사용자 별 이력을 뽑는데 페이코 사용자만 뽑아줘!"라는 무지막지한 과정을 거쳐야 생성할 수 있는 데이터가 있습니다.
아무생각없이 의식의 흐름대로 모든 사용자의 1년치 데이터를 aggregation하면 OOM이 나거나 운이 좋아 구동되어도 아주 오랜시간이 필요하게 됩니다.
보통 이런 조인작업의 경우 작은 놈을 배포하여 처리하는 broadcast join이나 map-side join을 수행하게 되는데 작은 놈인 "페이코 사용자 목록"또한 엄청나게 큰 사이즈라 통상적인 작업으론 처리할 수 없는 문제가 생기게 되었습니다.
그래서 데이터테크랩에서는 다음과 같은 flow로 작업을 구성 했습니다. 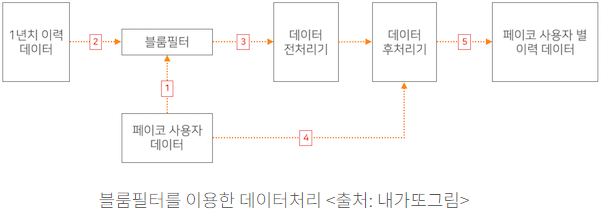
- 우선 페이코 사용자 데이터를 이용하여 블룸필터를 만들고 -> 200Kbytes 미만의 필터가 만들어 집니다.
- 이 필터를 각 워커에 broadcast한 후 1년치 데이터를 처리하기 전 이 필터를 거치게 하여 페이코 유저가 확실히 아닌 사람을 1차적으로 추스립니다. -> 이 작업을 통해 6~80%의 쓰지 않는 데이터가 걸러 집니다.
- 필터를 거친 데이터에 한해서 집계 작업을 진행 합니다.
- (3)에서 만들어진 데이터는 false positive성격에 의해 페이코 회원일 수도 아닐 수도 있습니다. 지정한 오차률 정도 데이터가 더 만들어 질텐데 이를 회원정보 data와 join하여 최종 결과물(5)을 산출 합니다. 이전 과정을 통해 사이즈가 많이 작아진 데이터들의 작업이라 적은 시간내에 수행이 완료 됩니다.
이러한 절차로 48시간 이상이 예상되는 작업(너무 오래 걸려서 끝까지 돌려본 적이 ㅠ.ㅠ)을 5시간 30분 만에 수행가능하도록 개선 할 수 있었습니다.
실전 적용 Case 2
앞의 case가 데이터 처리과정 중에 사용하는 예시라면 이번엔 서비스에서 사용하는 경우를 설명드려보겠습니다.
비슷한 예로 사용자별 이력을 조회할 필요가 있을 경우 보통은 다음과 같이 저장을 하게됩니다.
| 사용자ID | 사용이력 |
|---|---|
| 사용자1 | 이력코드 범주 1 |
| 사용자1 | 이력코드 범주 2 |
| 사용자1 | 이력코드 범주 3 |
| 사용자2 | 이력코드 범주 1 |
| 사용자2 | 이력코드 범주 2 |
| ... |
혹은
| 사용자ID | 사용이력 |
|---|---|
| 사용자1 | 이력코드1,이력코드2,이력코드3 ... |
| 사용자2 | 이력코드1,이력코드2 |
| ... |
이 데이터를 통해서 어떤 사용자의 이력을 조회할 때 전통적인 RDB에서는 사용자 컬럼에 인덱스를 추가하는 식으로 full-scan을 회피하는데요, 이력을 조회할 경우 데이터양이 큰 자료형이라 인덱스를 걸기에도 비교연산을 하기에도 비용이 큽니다. 또 큰데이터를 처리해야하는 조직의 특성상 해당데이터는 몇 십억 건으로 이루어져 있어 RDB의 혜택을 누리지 못하고 HADOOP EcoSystem을 이용하고 있습니다.
해서 다음과 같은 자료형으로 변환하고 이를 조회할 수 있는 UDF를 만들어 사용하고 있습니다.
| 사용자ID | 사용이력 |
|---|---|
| 사용자1 | 사용자1의 이력 블룸필터 |
| 사용자2 | 사용자2의 이력 블룸필터 |
| ... |
용량이 1/2 ~ 1/4 정도로 줄어들기도 하지만 더 중요한 실제 구동속도를 비교해보면 다음과 같습니다. 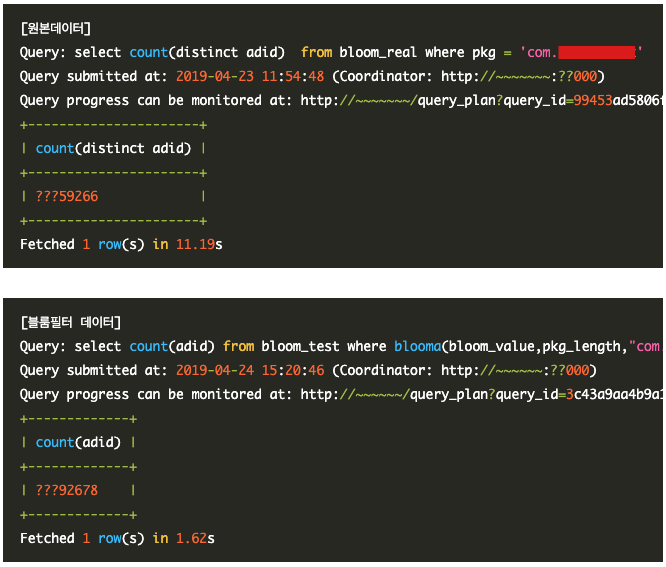 처리속도가 과장 좀 보태서 1/10로 줄어드는 마법이 ^^;;;
하지만 결과에서 보시다시피 약간의 오차가 있습니다.
앞서 설명드린 "있다고 하면 있을 수도 있고 없을 수도 있는데 없다고 하면 진짜 없어!"라는 False Positive 성질 때문에 없는 이력을 있다라고 한 경우가 생겨서 입니다. 오차률을 0.01%로 설정해서 생긴 오차인데 더 정확하게 설정할 수도 있지만 그럼 용량과 처리시간이 덩달아 늘어나는 trade-off가 있습니다.
정확할 필요가 없는 대략적인 수치를 빨리 알고 싶을 때 유용한 case라고 보시면 될 것 같습니다.
마치며
블룸필터는 처리능력대비 적은 메모리 공간을 필요로 하는 장점 때문에 DB이외에도 많은 곳에서 사용되고 있습니다. 가상화폐, IP 필터링, 사전(+스펠 체크), Router, 크롬브라우저(멀웨어 사이트인가?-블랙리스트)가 좋은 예가 될 것 같습니다.
당장 1억 유저단위 서비스에서 신규유저인지 검사하는데 100메가 정도의 메모리만을 사용하며 micro-seconds 단위로 응답 가능한 검증기를 간단하게 구현 가능하기도 하구요.
데이터가 갖춰지고 그 view를 활용하는 서비스 개발방법론 이외에도 특별한 (한계점을 넘어서는) 요구에 맞춰 같은 데이터를 다른 방식으로 표현하고 제공하는 데이터 엔지니어링/사이언스의 잘 알려지지 않은 부분을 소개시켜 드리고자 글을 써봤습니다.
한 번에 그림도 그려가며 죽 써 내려간 글이라 오류도 많고 엉성한 설명이 눈에 거슬릴 지도 모르지만 "이런 것도 있습니다." 라고 가볍게 소개 해드리는 글이니 넓은 아량으로 이해해 주기길 바랍니다.
긴 글 읽어 주셔서 감사드리며 궁금한 점은 언제든 연락 부탁드리겠습니다.
최근엔 (이라고 하기엔 좀 시간이 지난 2014년 쯤) delete 등의 작업을 수행할 수 있는 "Cuckoo Filter"라는 놈도 세상에 나왔습니다. (https://brilliant.org/wiki/cuckoo-filter/) 똑똑한 사람이 너무 많습니다. ^^;;