Engineering
잃어버린 리포트를 찾아서: 카카오 메시징 시스템의 경쟁 조건 문제와 안티 패턴 제거 과정
ravae.c카카오
2026년 2월 9일
원문에서 보기 ↗상상해 보세요. 친구가 당신에게 편지를 보냈습니다.
보냈다는 친구의 말도 맞고, 우체국의 발송 기록도 멀쩡합니다. 집 앞에는 집배원이 다녀간 흔적까지 남아 있습니다.
그런데 정작 우편함 안에는 편지가 없습니다.
보낸 사람도 있고, 보낸 기록도 있고, 도착했다는 정황까지 있는데, 받은 사람만 그 편지를 본 적이 없는 상황입니다. 이상하죠?
지난달, KIMS(Kakao Integrated Messaging Service)에서 비슷한 일이 실제로 벌어졌습니다.
카카오 메시징 시스템의 경쟁 조건 문제와 안티 패턴 제거 과정
안녕하세요. 카카오 사내용 SMS 전송 시스템을 담당하고 있는 커넥티비티 플랫폼의 ravae.c (최지원)입니다.
KIMS(Kakao Integrated Messaging Service)는 카카오 내부 서비스에서 사용되는 SMS 전송 플랫폼으로, 하루 약 100만 건의 메시지를 처리하며, 다수의 IDC 환경에 분산된 MSA 기반 시스템으로 운영되고 있습니다.
또한 메시지의 안정적인 전송을 위해 다수의 외부 SMS 벤더사와 연동되어 있습니다.
메시지 전송 요청이 들어오면, 내부적으로 여러 단계를 거쳐 메시지를 처리하게 되는데요, 아래 그림을 통해 이 흐름을 조금 더 자세히 살펴보겠습니다.
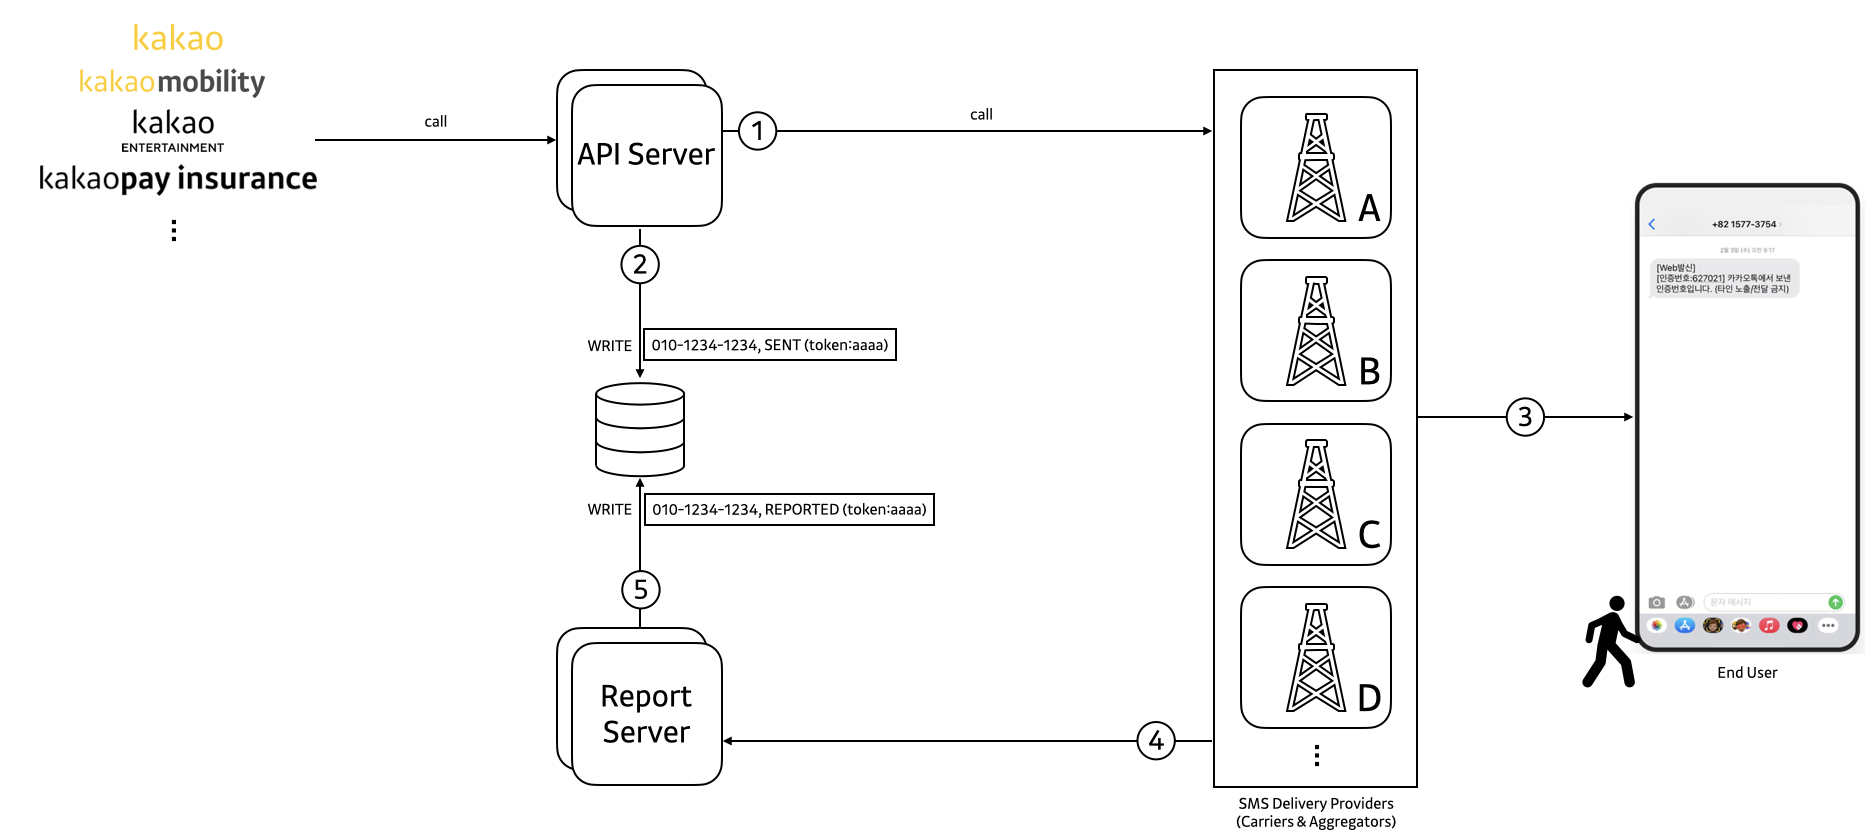
카카오 및 카카오 공동체의 다양한 서비스로부터 메시지 전송 요청이 들어오면,
① API Server는 실시간 품질 지표를 기준으로, 여러 벤더사 중 가장 적합한 곳으로 메시지 전송 요청을 라우팅합니다.
② 벤더사 호출 이후, 메시지를 SENT 상태로 DB에 기록합니다.
③ 메시지는 실제 단말 사용자에게 전달됩니다.
④ 이후 벤더사는 어떤 메시지가 언제, 어떤 결과로 전달되었는지에 대한 전송 결과 리포트를 우리에게 보내줍니다.
⑤ 리포트를 수신하면, 메시지의 상태를 REPORTED 상태로 DB에 업데이트합니다.
정리하면, KIMS의 메시지 처리 흐름은 전송 요청 → 벤더 호출 → 리포트 수신 → 상태 확정이라는 단계를 거치며, 각 단계는 비동기적으로 분리된 컴포넌트에서 수행됩니다.
그리고 이 구조는, 모든 단계가 우리가 기대한 순서대로 동작한다면 문제없이 잘 동작합니다.
적어도 잘 동작할 것이라 믿고 있었습니다… 그 일이 발생하기 전까지는요…
어? 리포트가 어디갔지?
운영 중 어느 날, 내부 모니터링 과정에서 이상한 현상이 포착되었습니다. 일부 메시지의 상태가 REPORTED로 갱신되지 않은 채, SENT 상태에 그대로 머물러 있었던 것입니다.
처음에는 벤더사로부터 리포트를 받지 못했을 가능성을 의심했지만, Report Server 로그를 확인한 결과, 리포트 수신 로그는 남아 있었습니다.
즉, 벤더사로부터 리포트는 정상적으로 수신되었지만, 저희는 그 결과를 DB에 반영되지 못한 채, 메시지 상태가 SENT 상태로 멈춰 있던 상황이었습니다.
마치 중간 어딘가에서 리포트가 사라진 것처럼 보였습니다.
실종된 리포트의 특징은?
동시성(Concurrency) 문제의 원인을 규명하는 일은 본질적으로 어렵습니다. 특히 문제 발생 빈도가 낮고, 특정 조건에서만 간헐적으로 드러나는 경우라면 분석 난이도는 더욱 높아집니다.
이러한 동시성 버그는 실행 순서와 타이밍에 강하게 의존합니다. 그래서 단위 테스트나 로컬 환경에서는 재현되기 어렵고, 운영 환경에서 여러 조건이 우연히 맞아떨어질 때에만 관측되는 경우가 많습니다.
이번 사례 역시 쉽게 재현되지는 않았지만, 다행히 분석이 가능할 정도의 누락 건이 충분히 축적되어 있었고, 누락 건들 사이에 몇 가지 공통 패턴이 있었습니다.
Problem 1. 리포트 누락건은 특정 벤더사로 전송된 메시지에 한정되어 관측되었습니다.
Problem 2. 메시지 유형 중에서는 무료 메시지가 아닌, 과금 대상 유료 메시지에서 주로 발생했습니다.
리포트 누락은 전체의 극히 일부인 약 0.02%에서만 발생했습니다. 전체가 아닌, 제한된 조건에서, 극히 일부에서만 이슈가 발생하고 있다는 점이 원인 분석과 디버깅을 더욱 어렵게 만들었어요.
왜 특정 조건에서만, 이렇게 선택적으로 리포트 누락이 발생했던 걸까요?
로그의 단서를 찾아서
Problem 1. 리포트 누락건은 특정 벤더사로 전송된 메시지에 한정되어 관측되었습니다.
애플리케이션 로그를 분석해 보니, Problem 1의 원인을 설명해 주는 결정적인 단서를 찾을 수 있었습니다.
아래는 리포트 누락이 발생한 시점의 로그를 시간 순으로 정리한 것입니다.
// (API Server) 벤더 API 호출 성공, 토큰 수신 완료 (아직 DB에 영속화되지 않음)

2025-11-21T15:43:21.362+09:00 INFO API Server : [VENDOR_RESPONSE] SMS sent successfully, token acquired (token=aaaa, persistence=PENDING)

// (API Server) 과금 단계: Kafka 이벤트 발행 완료 (여전히 DB 미영속 상태)

2025-11-21T15:43:21.370+09:00 INFO API Server : [POST_PROCESS] Kafka event published for SENT message (token=aaaa, persistence=PENDING)

// ✅ 21.370초 이후의 어느 시점에 레코드 영속화가 이루어짐

// (Report Server) 벤더사 Report 진입 시점 (API Server 후처리와 동일 타임스탬프)

2025-11-21T15:43:21.370+09:00 INFO Report Server : [ENTRY] DeliveryReportController invoked (token=aaaa)

// (Report Server) 메시지 조회 실패, 저장 실패

2025-11-21T15:43:21.372+09:00 WARN Report Server : [LOOKUP_FAIL] Delivery report received but message not found (vendor=B, token=aaaa)
이 로그에서 특히 주목할 점은 시간 간격입니다. 벤더사의 API 호출(5:43:21.362) 이후, 해당 벤더사의 리포트가 우리 시스템에 유입되기까지(15:43:21.370) 불과 8ms만이 소요된 것이 보이시나요?
일반적으로 다른 벤더사들은 메시지 처리를 마치고 리포트를 전달하기까지 평균 1초 이상이 걸리는 반면, 이 벤더사는 평균 약 20ms로 리포트 전달 시점이 상대적으로 매우 빠른 편이었습니다.
특히 리포트 누락이 발생한 사례들만 모아보면, 리포트 유입까지의 평균 지연 시간은 약 8ms로, 전체 평균보다도 훨씬 짧았습니다.
그 결과, 저희가 메시지에 대한 후처리와 DB 영속화를 완료되기도 이전에, 리포트가 먼저 시스템에 도착하는 상황이 발생했습니다.
이로 인해 메시지의 Write 경로와 Read 경로가 동일한 시점에 교차하게 되었고, 극히 짧은 타이밍에서 경쟁 조건(Race Condition)이 발생하게 되었던 것이었습니다.
맞춰지는 퍼즐조각
Problem 2. 메시지 유형 중에서는 무료 메시지가 아닌, 과금 대상 유료 메시지에서 주로 발생했습니다.
시스템 구조를 더 들여다보면서 우리는 Problem 2에 대한 단서도 발견할 수 있었습니다.
과금 대상인 유료 메시지의 경우, 과금 이벤트 발행을 위한 추가 후처리 로직이 존재했는데요, 벤더 호출부터 해당 후처리 단계까지의 전 과정이 하나의 @Transactional 범위로 묶여 단일 트랜잭션 내에서 실행되고 있었습니다.
그 결과 무료 메시지에 비해 트랜잭션 수행 시간이 길어졌고, DB Commit 시점도 자연스럽게 지연되고 있었죠.
이로 인해 유료 메시지에서는 메시지가 DB에 영속화되기 전에 전송 결과 리포트가 먼저 도착할 가능성이 더 커지고 있었습니다.
아이러니하게도, 과금을 정확히 처리하기 위해 추가한 로직이 오히려 과금 대상 메시지에서 문제를 유발하고 있었던 것입니다. 😅
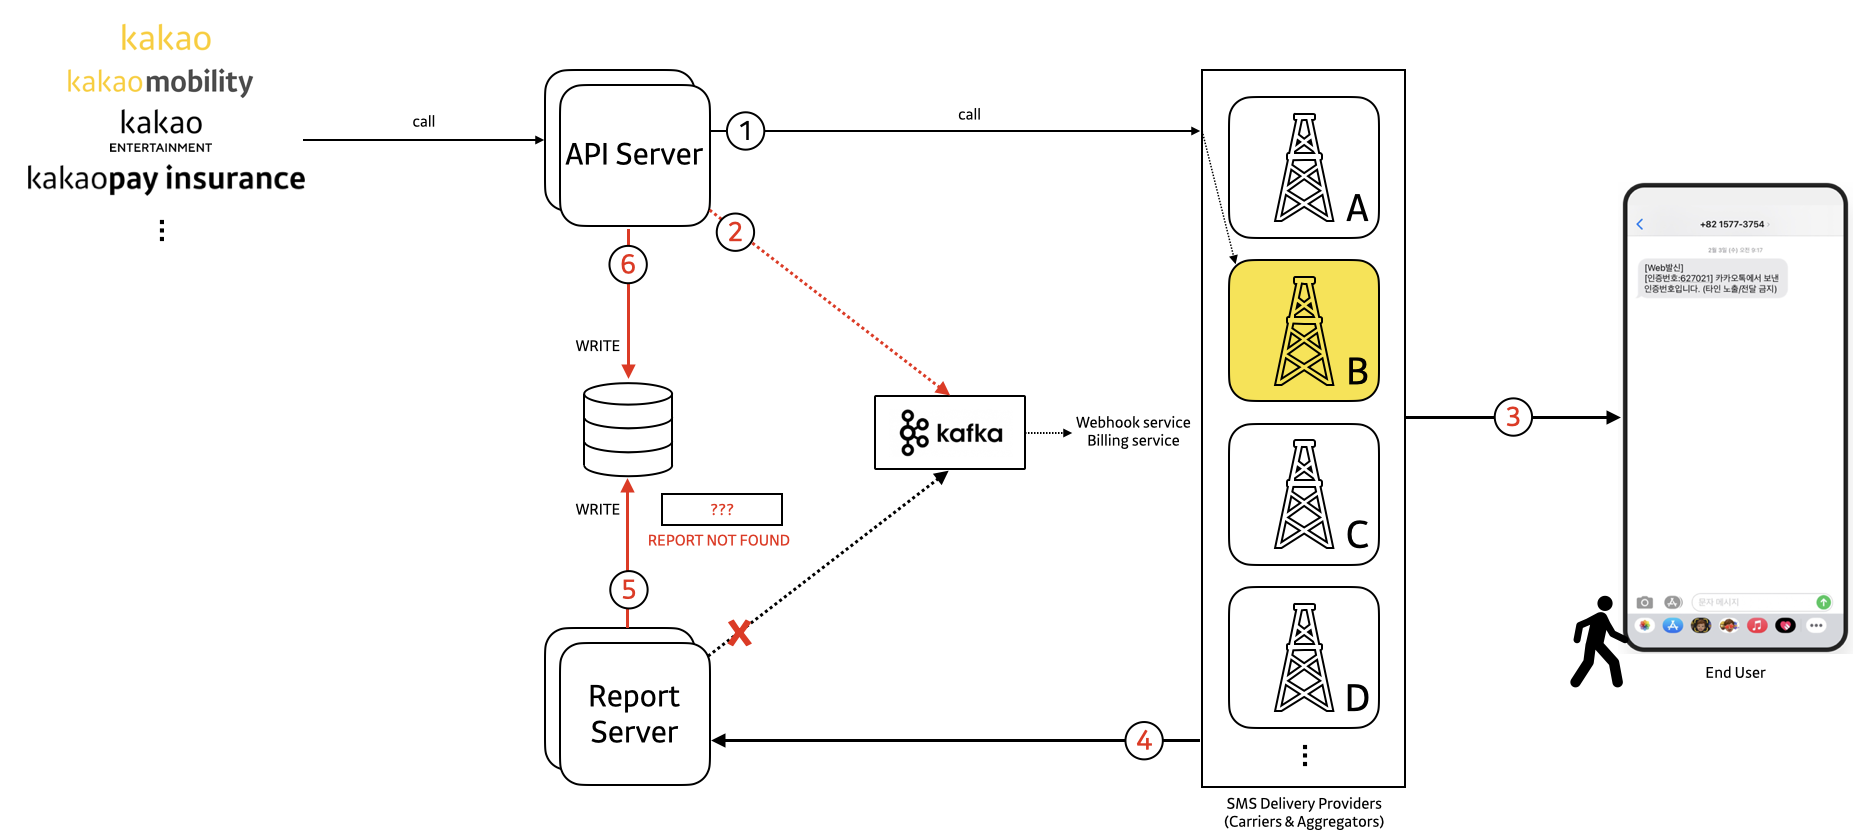
이 상황을 그림과 함께 정리하면 다음과 같습니다.
① [API Server] 실시간 품질 지표를 기준으로, 여러 벤더사 중 가장 적합한 곳으로 메시지 전송 요청을 라우팅합니다. (여기가진 Figure 1의 ①단계와 동일해요)
② [API Server] 여기서 과금을 위한 후처리 작업이 수행됩니다.
③과 ④ 메시지는 실제 단말 사용자에게 전달되고, 벤더사는 전송 결과 리포트를 우리에게 보내줍니다.
⑤ [Report Server] 리포트를 수신한 Report Server는 메시지 상태를 REPORTED로 업데이트하려고 시도합니다. 그러나 이 시점에는 아직 메시지 레코드가 DB에 존재하지 않아, 해당 리포트는 유효하지 않은 리포트로 판단되어 Drop됩니다.
⑥ [API Server] API Server는 과금 이벤트 발행을 마친 뒤에야 비로소 메시지 레코드를 DB에 영속화 합니다.
보이시나요? API Server가 ① → ② → ⑥의 순서로 처리를 진행하는 동안, 우리보다 더 민첩했던 벤더사는 이미 모든 처리를 마치고 전송 결과 리포트까지 전달한 상태였습니다.
이 시점에서 퍼즐은 거의 맞춰졌습니다. 문제의 원인도 분명해졌습니다.
그렇다면 이제 이 구조적인 경쟁 조건을 어떻게 제거할 수 있을까요?
첫 번째 조치: 트랜잭션을 다이어트해보자
가장 먼저 시도한 접근은 트랜잭션을 가볍게 만드는 것이었습니다. 기존 구조에서는 Kafka 이벤트 발행과 같은 비즈니스 로직이 트랜잭션 내부에서 함께 실행되며 Long-lived Transaction을 유발했고, 그 결과 DB 영속화 시점이 불필요하게 지연되고 있었습니다.
이를 개선하기 위해, 트랜잭션 내에서 반드시 필요하지 않은 로직을 분리하기로 했습니다.
과금 이벤트 발행을 @Async, @TransactionalEventListener 기반으로 분리하여 커밋 이후 별도 스레드에서 비동기 실행되도록 변경했습니다.
eventPublisher.publishEvent(new MtMessageStatusChangedEvent(message));
@Async

@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)

public void handle(MtMessageStatusChangedEvent event) {

// 과금 이벤트 발행을 포함한 후처리 로직 수행

}
이 변경으로, 이에 따라 트랜잭션의 책임 범위는 상태 변경과 DB 영속화(커밋)까지로 한정되어, 보다 가벼워질 수 있었습니다.
그 결과, 트랜잭션의 평균 커밋 시점을 약 10ms 앞당길 수 있었고, 리포트 수신 시점에 메시지 레코드가 이미 DB에 존재할 가능성이 높아지면서 리포트 누락 건수도 눈에 띄게 감소했습니다.
부수적인 효과로, 이벤트 발행 실패 시 트랜잭션 전체가 롤백되는 Dual-write[1] 문제 역시 함께 해소되었습니다. 개념상 롤백될 수 없는 외부 이벤트 발행을 트랜잭션 내부에 두고 있었던 이 구조 자체도 애초에 부적절했던거죠.
그런데, 트랜잭션을 가볍게 만드는 과정에서, 한 가지 근본적인 질문이 저희의 머릿속을 스쳐갔습니다.
우리는 지금 트랜잭션을 정말 잘 활용하고 있는 걸까?
일반적으로 원자성을 보장하기 위해, 정합성을 지키기 위해, 혹은 다소 관성적으로 우리는 트랜잭션을 사용하곤 합니다.
하지만 이번 사례를 다시 들여다보면서, 트랜잭션이 제공하는 보장이 우리 상황에 실제로 필요한 가치인지, 아니면 복잡성과 비용만 증가시키고 있는지를 본격적으로 재검토하게 되었습니다.
우리는 정말 트랜잭션이 필요한걸까?
문제를 해결하는 과정에서 한 걸음 물러나, 트랜잭션 자체가 우리의 비즈니스 요구사항에 적절한 선택이였는지를 처음부터 다시 검토하게 되었습니다.
트랜잭션은 물론 강력한 도구이지만, 모든 상황에서 항상 필요하지는 않으며, 때로는 오히려 성능 저하와 복잡성 증가를 초래하기 때문에, 트랜잭션적인 보장을 완화하거나 아예 쓰지 않는 게 이득일 수도 있습니다.
저희 시스템은 MySQL의 기본 격리 수준인 REPEATABLE READ를 사용하고 있었고, 일반적으로 해당 격리 수준에서 트랜잭션을 도입하는 이유는 다음 세 가지로 정리할 수 있습니다.
원자성(Atomicity) 작업 도중 문제가 발생했을 때, 전체 변경을 롤백할 수 있는 보장입니다. (즉, 롤백 가능성, Abortability[2])
읽기 격리(Read Isolation) 다른 트랜잭션의 중간 상태를 읽지 않도록 보호합니다.
쓰기 격리(Write Isolation) 커밋되기 전까지는 다른 트랜잭션에서 해당 변경 사항을 볼 수 없도록 합니다.
이제 이 보장들이 우리 시나리오에서 실제로 필요한 보장인지를 하나씩 살펴보며 질문을 던져 보았습니다.
- 원자성(Atomicity) 작업 도중 문제가 발생했을 때, 전체 변경을 롤백할 수 있는 보장입니다.
🤔 여기서 질문: “Abortability가 필요한 상황인가?”
ACID에서 말하는 원자성은, 여러 개의 쓰기 작업 중 일부만 수행된 상태에서 장애가 발생했을 때(예를 들면 프로세스가 죽거나 네트워크가 끊기면)전체 변경을 어보트(Abort)하고, 지금까지 실행한 쓰기를 취소할 수 있는 것을 의미합니다.
하지만 우리 시스템의 특성을 다시 살펴보면, 이 트랜잭션 안에서 수행되던 쓰기(Write) 연산은 단 하나였습니다.
최초 상태 → SENT
여러 테이블에 걸친 동시 쓰기나, 크로스 레코드 원자성을 보장해야 하는 구조는 아니었습니다. 즉, 부분 성공을 허용하지 않기 위해 반드시 트랜잭션이 필요한 시나리오는 아니었던 것입니다.
2. 읽기 격리(Read Isolation) 다른 트랜잭션의 중간 상태를 읽지 않도록 보호합니다.
🤔 여기서 질문: “일관된 읽기가 필요한 상황인가?”
이번엔 읽기 격리입니다. 해당 트랜잭션에서는 상태 변경(Write)에 앞서, 몇 개의 메타데이터 테이블을 조회(Read)하고 있었습니다.
예를 들어 현재 라우팅 대상 벤더의 정보나, 벤더별 실시간 품질 지표 같은 값들이었어요.
다만 이 데이터들의 특성을 살펴보니, 강한 시점 일관성(Strict Freshness)이 요구되는 정보는 아니었습니다.
벤더 품질 지표는 분 단위로 갱신되고 있었고, 최악의 경우 1분 전 스냅샷이 사용되더라도 비즈니스적으로 문제가 없는 수준이었습니다.
또한 조회 대상 테이블들 간에도 강한 결합 관계는 없었습니다. 즉, 서로 독립적인 메타데이터를 읽는 구조였기 때문에, 동일한 스냅샷에서 일관되게 격리하여 읽어야 할 필요성이 크지 않았습니다.
즉, 우리의 상황에서 읽기 격리를 위해 트랜잭션을 유지해야 할 유지해야 할 명확한 이유를 찾기 어려웠습니다.
3. 쓰기 격리(Write Isolation) 커밋되기 전까지는 다른 트랜잭션에서 해당 변경 사항을 볼 수 없도록 합니다.
🤔 여기서 질문: “이 변경이 정말 다른 트랜잭션에게 숨겨야 할 변경이었을까?”
쓰기 격리는 트랜잭션이 커밋되기 전까지 변경 사항을 다른 트랜잭션에서 관측하지 못하도록 하는 특성입니다.
READ COMMITTED 이상에서는, 다른 트랜잭션이 미커밋 변경을 읽지 못하게(Dirty Read 방지)하며, 트랜잭션 도중의 중간 상태 노출을 방지하고, 상태 전이의 일관성을 유지합니다.
저희의 시스템에서는 Hibernate 기반의 JPA를 사용하고 있었고, @Transactional 아래에서는 Dirty Checking 메커니즘에 따라, 변경 사항이 Persistence Context(1st-level Cache)에만 반영된 채, 트랜잭션 종료 시점까지 실제 DB Write가 지연되고 있었습니다 [3]
문제는 바로 이 지점이었습니다.
생각해보면, 리포트 누락은 Report Server가 리포트를 빠르게 수신한 상황에서, API Server에서 수행된 상태 변경(초기 상태 → SENT)이 아직 DB에 커밋되지 않았을 때 발생했습니다.
@Transactional으로 보호된 API Server의 상태 변경은 Dirty Checking에 의해 트랜잭션 종료 시점까지 DB에 반영되지 않았고, 이로 인해 리포트 수신 시점과 메시지 레코드 커밋 시점 사이의 간극이 더욱 벌어졌습니다.
그 결과, Report Server는 리포트를 정상적으로 수신했음에도 불구하고, 해당 시점에는 메시지 레코드가 아직 DB에 존재하지 않아 조회에 실패하게 되었습니다.
즉, 이 경로에서의 트랜잭션 경계와 커밋 지연은 리포트 수신 타이밍과 맞물리며, Write 경로와 Read 경로 간의 타이밍 충돌을 증폭시키는 요인으로 작용하고 있었습니다.
이 세 가지 측면을 종합한 결과, 우리는 해당 경로의 트랜잭션 유지가 불필요하다고 결론지었습니다.
트랜잭션 제거로 얻을 수 있는 부수적인 이점
또한, 트랜잭션을 사용하지 않음으로써 얻을 수 있는 부수적인 이점도 분명했습니다. @Transactional은 때로 성능과 운영 안정성을 저해하는 요인으로 작용하고 있었거든요.
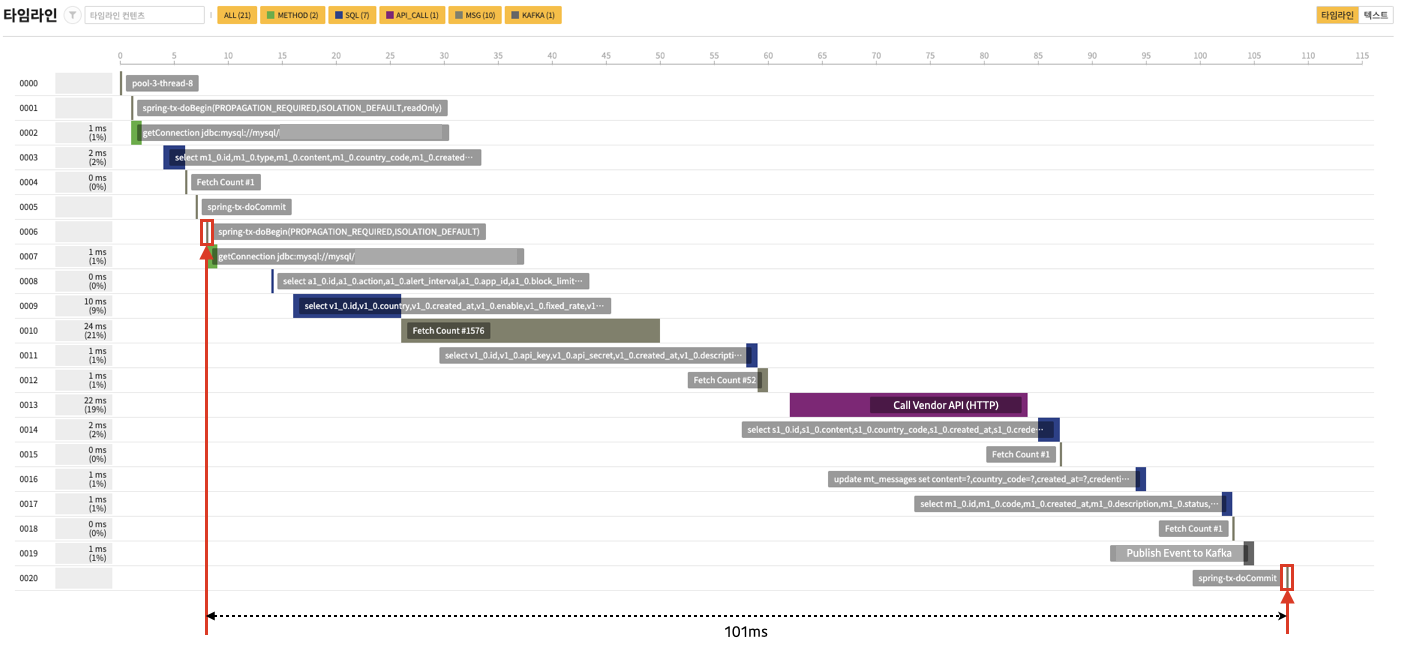
초기 구조에서, API Server의 트랜잭션 점유 시간은 평균 약 101ms에 달했습니다 (Figure 3).이를 처리량 관점에서 환산해 보면, 이 수치가 시스템 전반에 어떤 영향을 주고 있었는지를 보다 명확히 확인할 수 있습니다.
-
트랜잭션 점유 시간: ≈ 0.101s
-
커넥션 1개당 처리량: ≈ 9.9 req/s
-
이론상 최대 처리량: ≈ 99 req/s (HikariCP 커넥션 풀 사이즈 10 기준)
이론 상, 저희 서비스의 TPS가 최대 처리량 한계를 초과하면, 요청은 HikariCP의 커넥션 대기 큐에 적재되며, 대기 시간이 Connection Timeout을 넘길 경우 Timeout 예외로 이어지게 되는데요, 실제로도 API Server에서는 트래픽이 일시적으로 증가하거나 벤더사 API 응답이 지연되는 상황에서 이러한 대기 및 Timeout 현상이 간헐적으로 발생하고 있었습니다.
이는 트랜잭션 점유 시간이 길어져 DB 커넥션이라는 공유 자원을 더 오래 점유하게 되고, 그 결과 큐잉 지연(Queueing Delay)이 누적되면서 시스템 전체의 처리 효율이 점진적으로 저하되는 구조였기 때문입니다.
즉, 한정된 자원을 비효율적으로 사용하는 구조였습니다.
두 번째 조치: 트랜잭션을 풀다
앞서 살펴본 내용을 종합해 보면, 저희의 처리 경로에서는 트랜잭션이 제공하는 여러 보장이 실질적인 이점을 주지 못한다는 결론에 도달하였습니다.
오히려 커밋 지연과 자원 점유로 인해 문제를 키우는 쪽에 가까웠죠.
물론 극히 낮은 확률의 장애 상황까지 고려한다면, 모든 연산을 하나의 트랜잭션으로 묶는 선택이 더 안전해 보일 수는 있습니다.
하지만 발생 가능성이 낮은 시나리오를 대비해 시스템을 과도하게 복잡하게 만들 경우, 그에 따른 비용과 제약은 빠르게 증가하는 반면 실제로 얻는 이점은 적을 수 있습니다.
이번 사례가 바로 그런 경우였습니다. 이에 따라 저희는 해당 처리 경로에서 @Transactional을 제거하기로 결정했습니다.
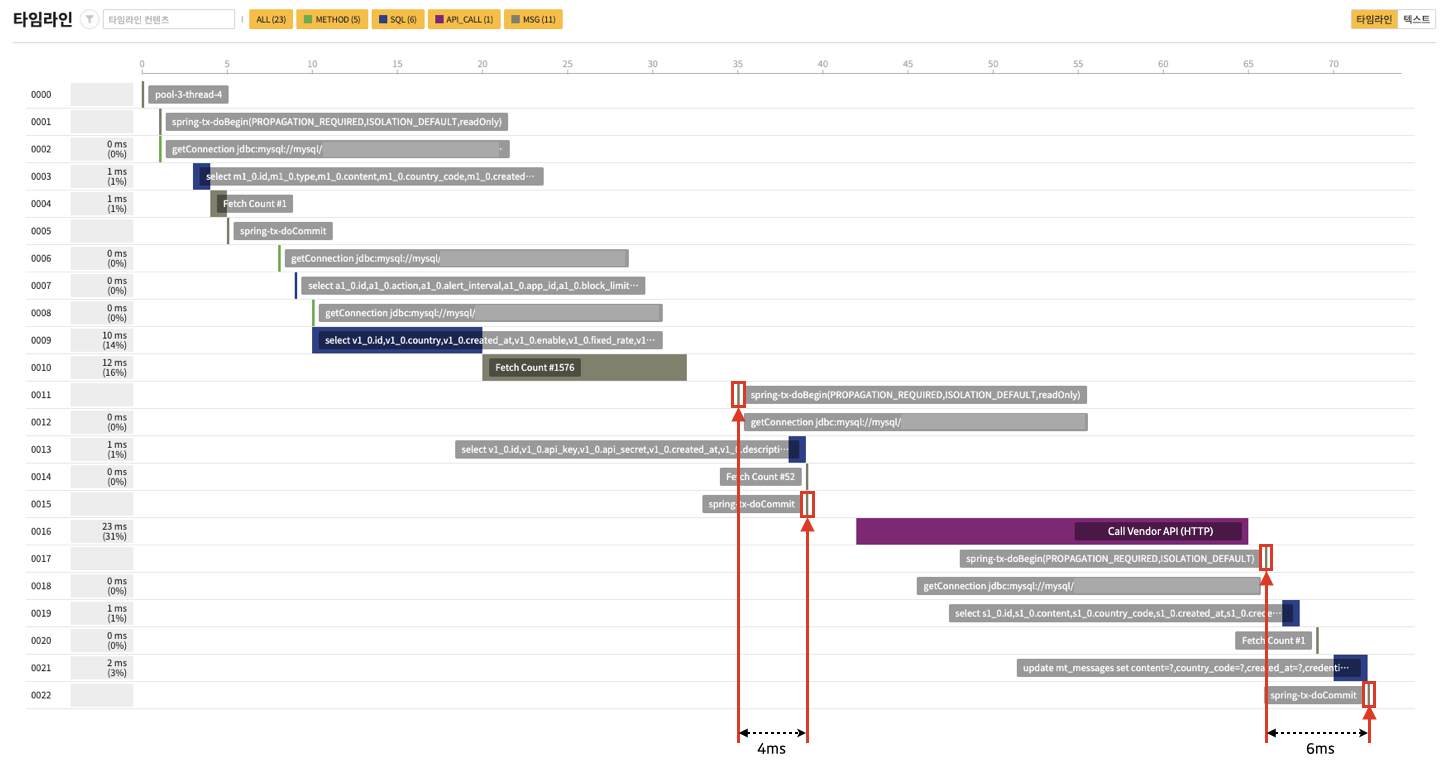
@Transactional 제거 이후 분산 트레이싱을 확인한 결과, Figure 4에서와 같이, 해당 경로의 DB 커넥션 점유 시간은 약 4ms, 6ms 수준으로 줄어들었고, 우리의 소중한 자원인 DB 커넥션 풀을 더욱 효율적으로 멀티플렉싱할 수 있는 구조로 개선되었습니다.
앞선 과정에서 트랜잭션 범위를 축소하고, 불필요한 경로에서 @Transactional을 제거하면서 트랜잭션을 한 차례 의도적으로 가볍게 만드는 작업을 진행했습니다.
이러한 트랜잭션 다이어트 후, 저희는 성공적으로 상태 값 영속화 시점을 앞당길 수 있었고, 그 결과 리포트 누락 건수가 약 40%까지 감소했습니다.
이는 분명히 의미 있는 개선이었어요. 하지만 동시에, 이 접근의 한계는 명확했습니다.
트랜잭션을 아무리 가볍게 만들지라도, DB 영속화까지 소요되는 시간 자체를 0으로 만들 수는 없었고, 이 구조가 유지되는 한 Write 경로와 Read 경로가 경쟁하는 상황은 언제든 다시 발생할 수 있을 것이기 때문이에요.
즉, 이 조치는 Race Condition의 발생 확률을 낮출 뿐, 문제를 구조적으로 제거하는 해결책이라고 보기는 어려웠습니다.
이제 남은 선택지는 하나였습니다. 확률을 낮추는 접근이 아니라, 경쟁 자체가 발생하지 않는 구조를 만드는 것이었습니다.
세 번째 조치: Transactional Outbox Pattern 도입하기
경쟁 자체가 발생하지 않는 구조를 만들기는 어떻게 할 수 있을까요? 고민을 많이 했지만 결론은 아웃박스(Outbox)였어요.
접근 방식은 단순했습니다. Report Server는 리포트를 받는 즉시 모두 Outbox 테이블에 먼저 기록하고, 이후 잃어버린 리포트는 별도의 워커가 Outbox를 기반으로, 리포트 적용을 재시도하도록 구성하는 것이였어요.
이를 통해, 온라인 처리 경로에서 일시적인 실패가 발생하더라도, 오프라인 경로에서 리포트가 재처리되어 누락되지 않도록 하는거죠.
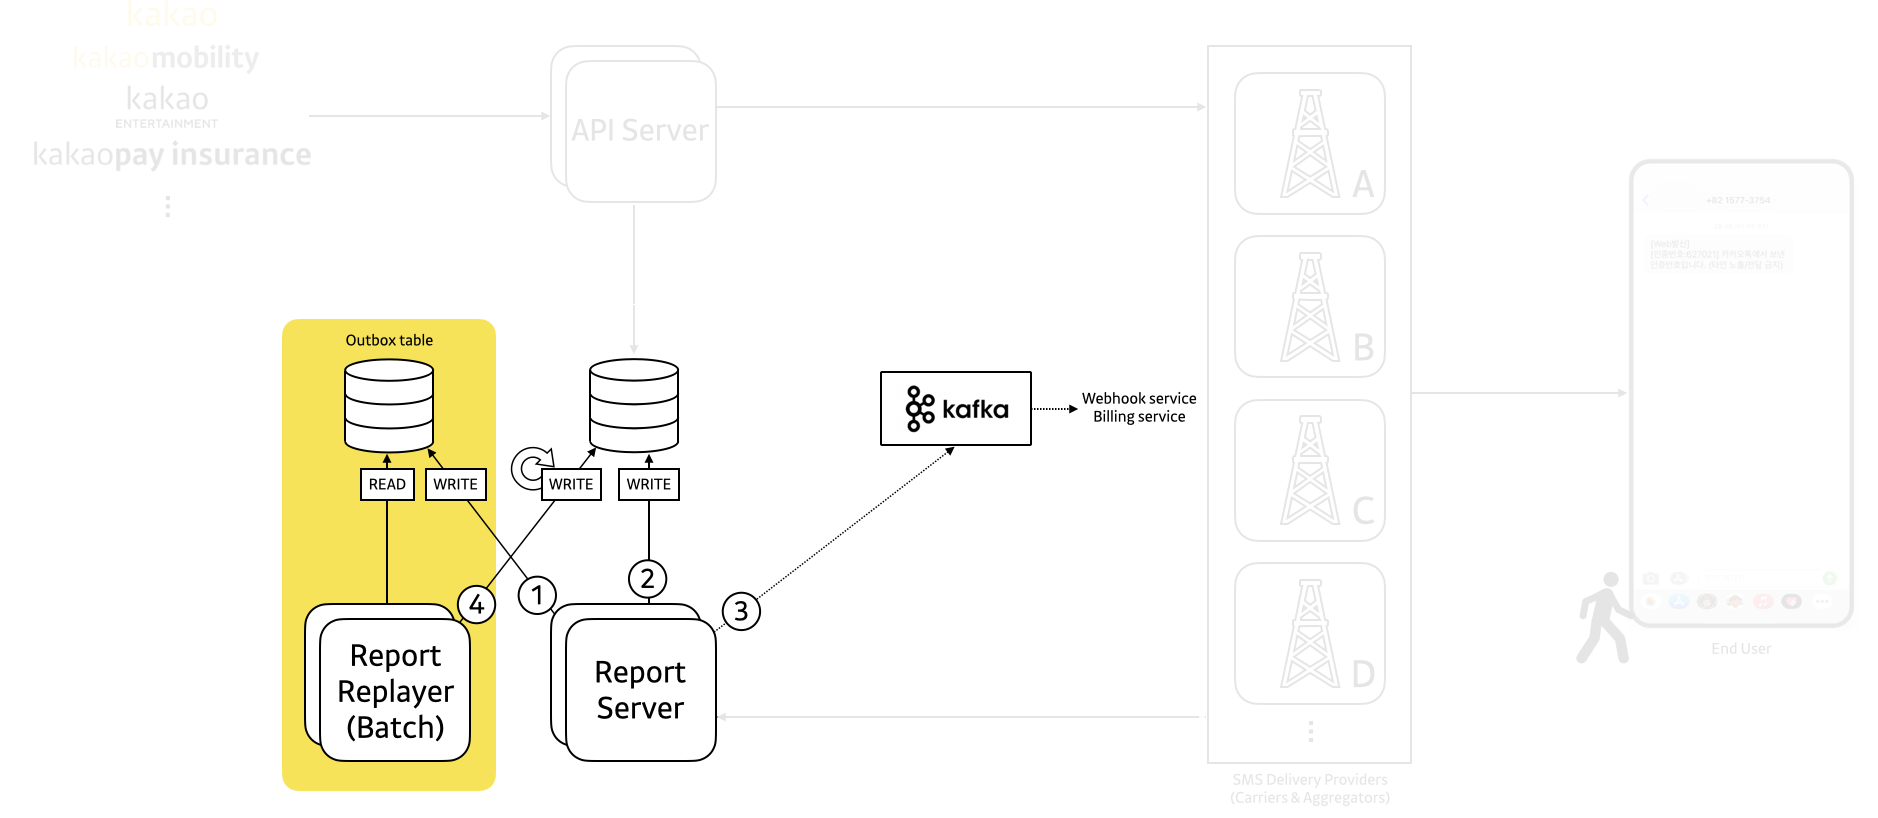
초기 구현안은 이랬습니다.
① [Report Server] 리포트를 수신하면, 가장 먼저 Outbox 테이블에 기록합니다.
② [Report Server] 기존 로직과 동일하게 메시지 상태를 REPORTED로 전이합니다.
③ [Report Server] 과금 이벤트를 발행합니다.
④ [Report Replayer] 주기적으로 Outbox 테이블을 스캔하여 아직 처리되지 않은 리포트들을 배치 처리합니다.
참고로 이 초기 구현의 Report Replayer는 리포트에 대한 DB 상태 전이 복구만 수행하도록 제한되어 있었으며, 과금 이벤트 미발행에 대한 복구 로직은 없었습니다.
즉, 이 단계의 목적은 Outbox 기반 재처리 구조가 리포트 유실(DB 누락)을 구조적으로 제거할 수 있는지를 확인하는 것이었습니다.
이에 따라 기대했던 결과 역시, 과금 이벤트 누락은 기존과 유사한 수준으로 유지되되, DB 기준 리포트 누락은 사라지는 것이었습니다.
결과는 어땠을까요?
저희 기대의 절반만 맞았습니다.
구조 적용 이후 DB 기준 리포트 누락은 0%로 줄었지만, 과금 이벤트 누락은 오히려 이전보다 더 눈에 띄게 증가하기 시작했습니다.
왜 이런 일이 발생했을까요?
(마지막!) 멱등성 가드와의 충돌
벤더사는 네트워크 지연이나 장애 상황에서 동일한 리포트를 여러 번 전송하는 경우가 종종 있습니다.
그러나 동일한 리포트를 저희가 두 번 수신했다고 해서, 사용자에게 과금이 두 번 발생해서는 안 되기 때문에* , 이를 방지하기 위해 Report Server에는 과금 이벤트를 최대 한 번만 발행하도록 보장하는, 원자적 Compare-and-set 연산 기반의 멱등성 가드가 구현되어 있었습니다.
*[참고] 저희의 과금 로직은 외부 과금 시스템과 연동되어 있으며, 이벤트가 발행되는 즉시 과금이 수행되는 구조로 동작합니다. 즉, 과금 이벤트의 중복 제거는 저희 시스템의 책임이었습니다.
예를 들면 다음과 같은 형태입니다.
UPDATES mt_messages SET status = 'REPORTED'
    WHERE token = 'aaaa' AND status = 'SENT'
즉, 상태 전이가 성공한 경우에만 (SENT → REPORTED) 과금 이벤트를 발행하도록 설계되어 있었던 거죠.
문제는 Outbox 도입 이후, Report Server와 Report Replayer라는 두 개의 처리 경로가 동시에 같은 데이터를 바라보며 상태 전이를 시도하게 되었다는 점이었습니다.
분산 환경에서는 ‘누가 먼저 실행될지’를 가정할 수 없습니다. 앞선 사례에서는 이 가정을 벤더사가 깨뜨렸다면, 이번에는 우리 시스템 내부의 요소가 그 가정을 깨뜨렸습니다.
실제로 다음과 같은 순서 역전이 발생하고 있었습니다.
① [Report Server] 리포트를 수신하고 Outbox에 기록합니다.
④ [Report Replayer] 이 때 마침 실행 주기가 도래하여, Report Server보다 먼저 리포트를 처리하고 메시지 상태를 REPORTED로 변경해 버립니다.
② [Report Server] 기존 리포트 처리 로직이 실행되지만, 이미 상태가 REPORTED이므로 멱등성 가드에 의해 로직이 무시됩니다.
③ 그 결과 과금 이벤트는 발행되지 않습니다. 즉, 리포트는 DB에 정상적으로 존재하고, 상태도 정상이지만, 과금 이벤트만 누락되는 새로운 형태의 문제가 발생한 것입니다.
우리는 배치 처리를 ‘안전망’으로 추가했지만, 결과적으로는 두 개의 Writer(At-most-once 시맨틱을 지키기 위한 멱등성 가드와 리포트 복구를 위한 배치 처리 경로)가 정면으로 충돌하는 구조를 만들고 말았습니다.
이처럼 실시간 처리와 과거 데이터 재처리가 동일한 데이터를 수정하는 구조에서는, 두 경로가 서로 간섭하지 않도록 보장하는 메커니즘이 필수적입니다.
물론 Figure 5의 처리 순서를 강제로 ② → ③ → ①로 고정하면 문제를 회피할 수는 있었지만, 이는 코드 곳곳에 "이 순서를 반드시 지켜야 한다"는 암묵적인 제약을 심는 것과 다르지 않았고, 유지보수 관점에서 매우 위험한 설계라고 판단했습니다.
네 번째 조치: Single Writer Principle[4]
결론적으로 저희가 선택한 최종 버전은 아래와 같습니다.
핵심 아이디어는 단순합니다. “같은 데이터에 대해 쓰기를 수행하는 주체는 하나만 두자.”
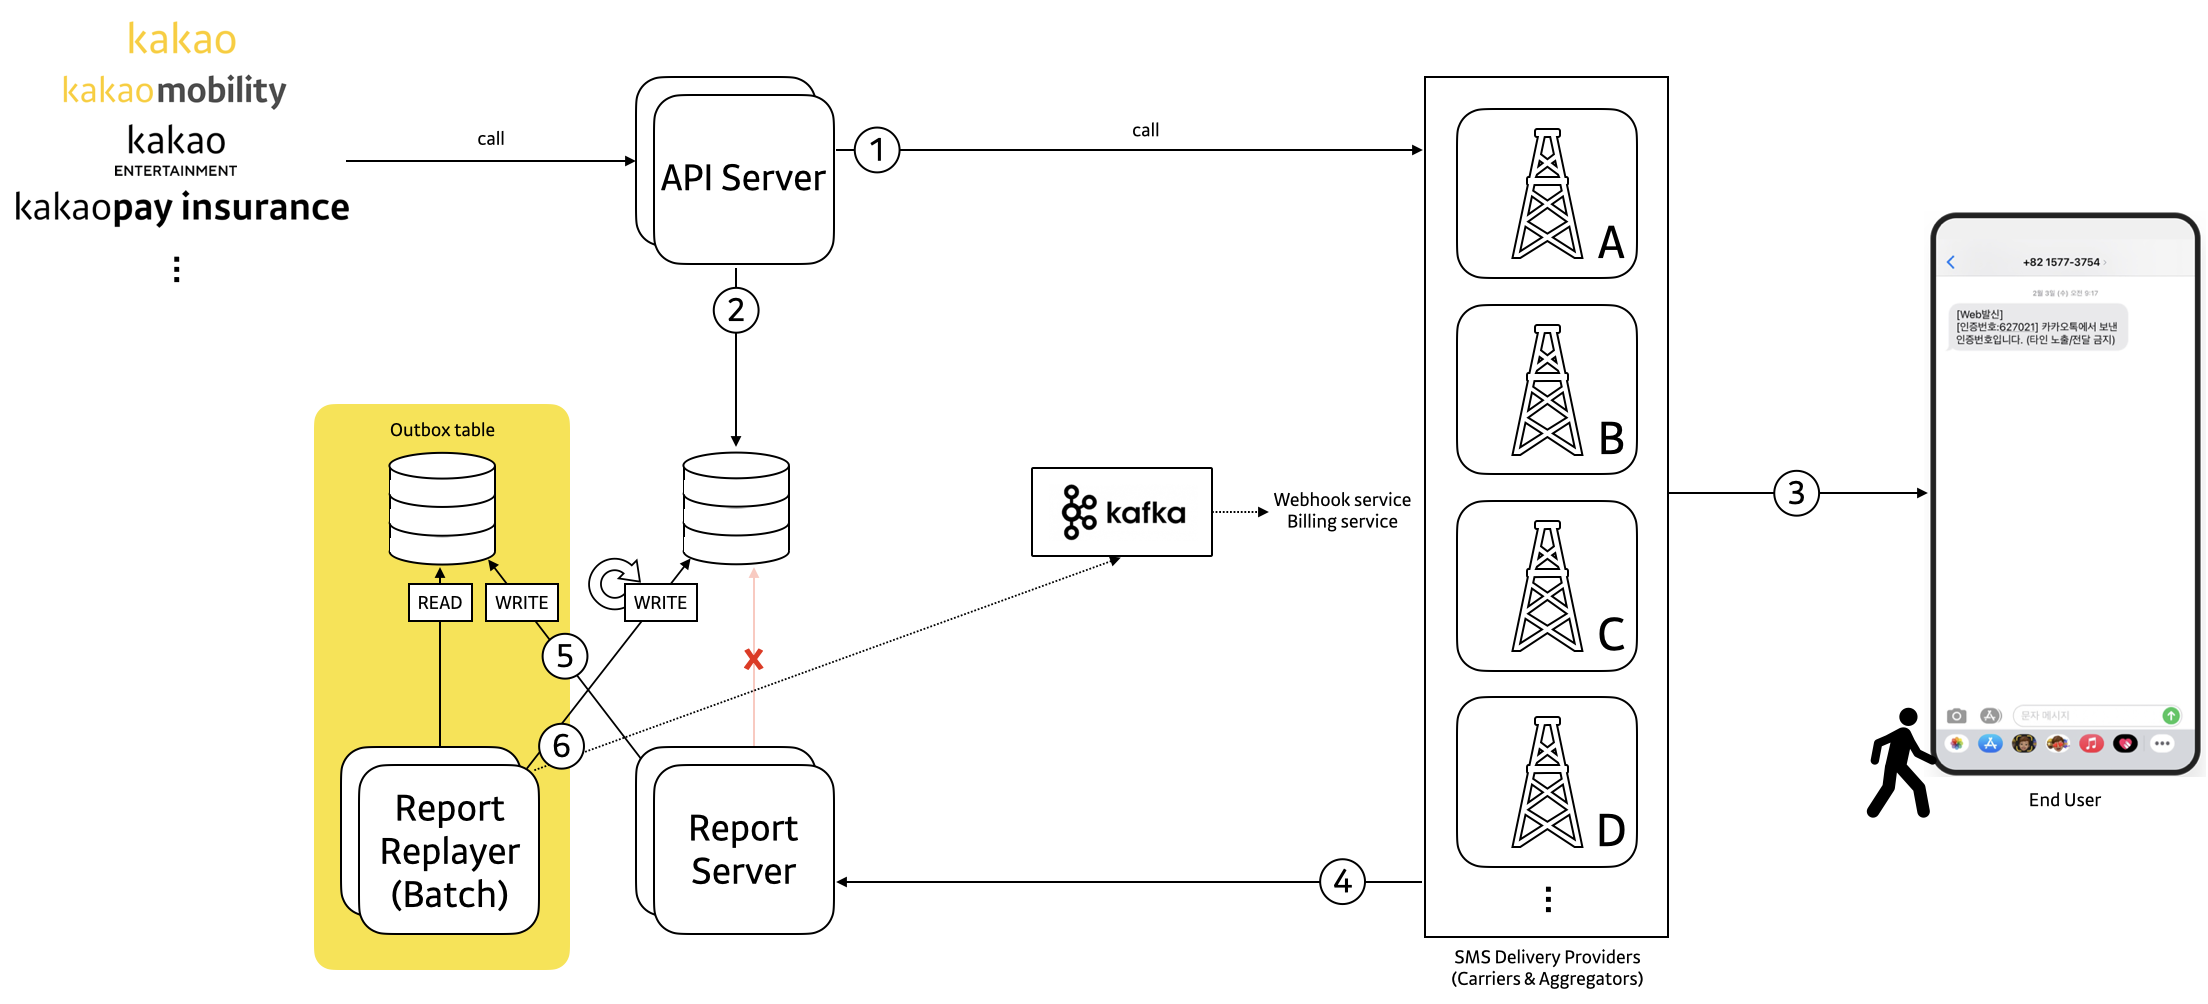
⑤ Report Server는 벤더로부터 리포트를 수신하면 아무 판단도 하지 않고 Outbox 테이블에 실시간으로 적재만 합니다.
⑥ Report Replayer는 주기적으로 Outbox 테이블을 순회하며, 리포트를 메시지 테이블에 반영하고, 이 시점에서만 과금 이벤트를 발행합니다.
즉, 리포트 저장 상태 전이 과금 이벤트 발행을 단 하나의 경로에 통합했습니다.
그 결과, Report Server ↔ Report Replayer 간 경쟁 조건은 구조적으로 제거되었고, 리포트 반영과 과금 이벤트 발행 사이의 원자성이 자연스럽게 보장되었습니다.
리포트 누락을 대비한 재시도는 Outbox 테이블이 담당하며, 결과적으로 효율적인 Exactly-once 처리가 가능해졌습니다.
우리가 포기한 것과 얻은 것 (Trade-offs)
물론 이 선택에는 비용이 있습니다.
리포트 처리를 배치 기반으로 전환하면서 즉시성이 일부 희생되었습니다.
그러나 과금, 정산 도메인에서 더 중요한 것은 실시간성보다 최종 일관성(Eventual Consistency)이었습니다. 늦더라도 반드시 맞는 결과가, 빠르지만 틀릴 수 있는 결과보다 우선이기 때문입니다.
우리는 또한 위에서, 트랜잭션에 대한 관성적인 사용을 포기했습니다.
이번 시나리오에서 트랜잭션은 기대한 수준의 일관성과 격리성을 충분히 제공하지 못했고, 오히려 Fast Path에 불필요한 처리[5]를 포함시켜 지연과 병목을 키우는 요인이 되었기 때문입니다.
대신 저희가 얻은 것은 경쟁 자체가 발생하지 않는 구조입니다.
Single Writer Principle을 적용해 동일 데이터에 대한 쓰기를 단일 경로로 직렬화함으로써, 요소 간 Contention을 제거하고 예측 가능한 지연을 확보했으며, 리포트 및 이벤트 누락 문제도 함께 해소할 수 있었습니다.
읽기는 자유롭게 두고 쓰기는 하나로 제한하는 설계는 확장성 측면에서도 유리했습니다.
돌아보면 이번 사례를 통해, 동시성 문제는 코드의 미세한 조정만으로 해결될 수 없으며, 경쟁 자체가 발생하지 않는 아키텍처로 전환할 때에만 근본적으로 제거할 수 있다는 점을 깨닫게 되었습니다.
아키텍처는 언제나 트레이드오프의 연속이며, 트랜잭션 또한 만능 해법은 아닙니다.
무엇을 얻기 위해 무엇을 포기할 수 있는지를 명확히 인식하며 설계하자!! 이것이 이번 이슈가 남긴 가장 큰 교훈이었습니다.
참고 문헌
[1] Confluent. “The Dual Write Problem.” Confluent Blog. https://www.confluent.io/blog/dual-write-problem/
[2] Martin Kleppmann. 『데이터 중심 애플리케이션 설계』(Designing Data-Intensive Applications). 위키북스, 2018.
[3] Hibernate ORM Team. “Hibernate ORM User Guide – Flushing.” https://docs.hibernate.org/orm/6.5/userguide/html_single/#flushing
[4] Martin Thompson. “Single Writer Principle.” Mechanical Sympathy Blog. https://mechanical-sympathy.blogspot.com/2011/09/single-writer-principle.html
[5] Connie U. Smith. “New Software Performance AntiPatterns: More Ways to Shoot Yourself in the Foot.” 28th International Computer Measurement Group Conference, 2002.
함께한 사람들
cherry.spicy, pippin.hobbit, kyen.a이 함께했습니다.
감사의 말
이 글에 담긴 내용들을 함께 검토하며, 다양한 관점에서 건설적인 피드백을 주신 doy.seok, daniel.wm, hook.jeong, david.koh, heiley.me를 비롯한 커넥티비티 플랫폼의 모든 구성원들께 감사의 말을 전합니다.