AI/ML
LLM, 더 저렴하게, 더 빠르게, 더 똑똑하게
robin.hwang카카오
2024년 9월 9일
원문에서 보기 ↗안녕하세요. 카카오 기술전략 소속의 로빈입니다.
현재 저는 카카오의 AI 교육 자문 활동 맡아 AI 교육 커리큘럼 설계 및 감수를 진행하고 있으며, AI Native Company로의 여정을 위해 AI를 활용하는 사내 시스템을 구축하고 있습니다. 또한 사내의 ChatGPT 커뮤니티를 운영하며, 생성형 AI와 관련한 다양한 트렌드와 소식을 사내 크루들에게 전달하고 있기도 합니다.
많은 분들이 AI 서비스를 구현할 때 가장 고민되는 것 중에 하나가 바로 '어떤 LLM을 선택할까 ’일 것 입니다. LLM의 중요한 특성 중 하나가 지속적으로 변화한다는 점일 텐데요, 개인적으로 LLM은 언제든 바뀔 수 있다는 점을 염두에 두고 AI 서비스를 설계하는 것이 필수적이라고 생각합니다. 실제로 이미 많은 오픈소스 모델들은 OpenAI의 API 스펙에 맞춰 구현 및 제공되고 있으며, 개발자가 필요에 따라 모델을 쉽게 교체할 수 있는 구조를 갖추고 있습니다.
아울러 언제든지 LLM을 바꿀 수 있는 서비스를 설계해야 하는 이유를 살펴보면 아래와 같습니다.
- LLM의 사용 가격이 지속적으로 낮아지고 있습니다.
- LLM의 생성 속도가 빨라지고 있습니다.
- LLM의 성능이 향상되고 있습니다.
- LLM의 처리량이 증가하고 있습니다.
- 경량 LLM의 활용도가 높아지고 있습니다.
이번 글에서는 이 다섯 가지 변화에 주목해 최신 LLM 트렌드를 살펴보고자 합니다.
1️⃣ LLM의 사용 가격이 지속적으로 낮아지고 있습니다.
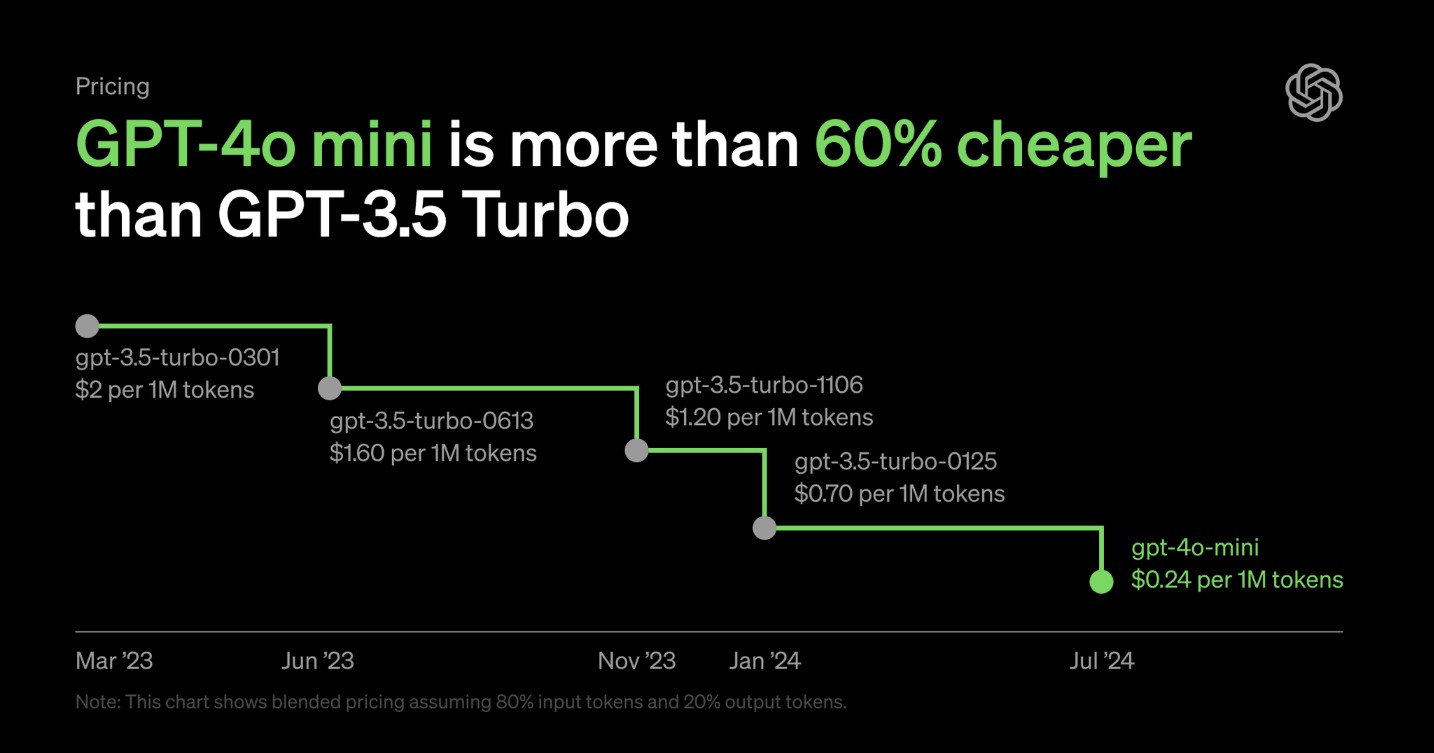
OpenAI의 경우, GPT-3.5 Turbo 초기에는 100만 토큰당 2달러 수준이었으나 2024년 7월 GPT-4o mini가 100만 토큰당 0.24달러의 사용 가격대로 출시되면서 사용 비용이 GPT-3.5 Turbo 초기 모델 대비 10분의 1수준으로 저렴해지고, 이전 모델 대비 60% 이상 저렴해졌습니다.
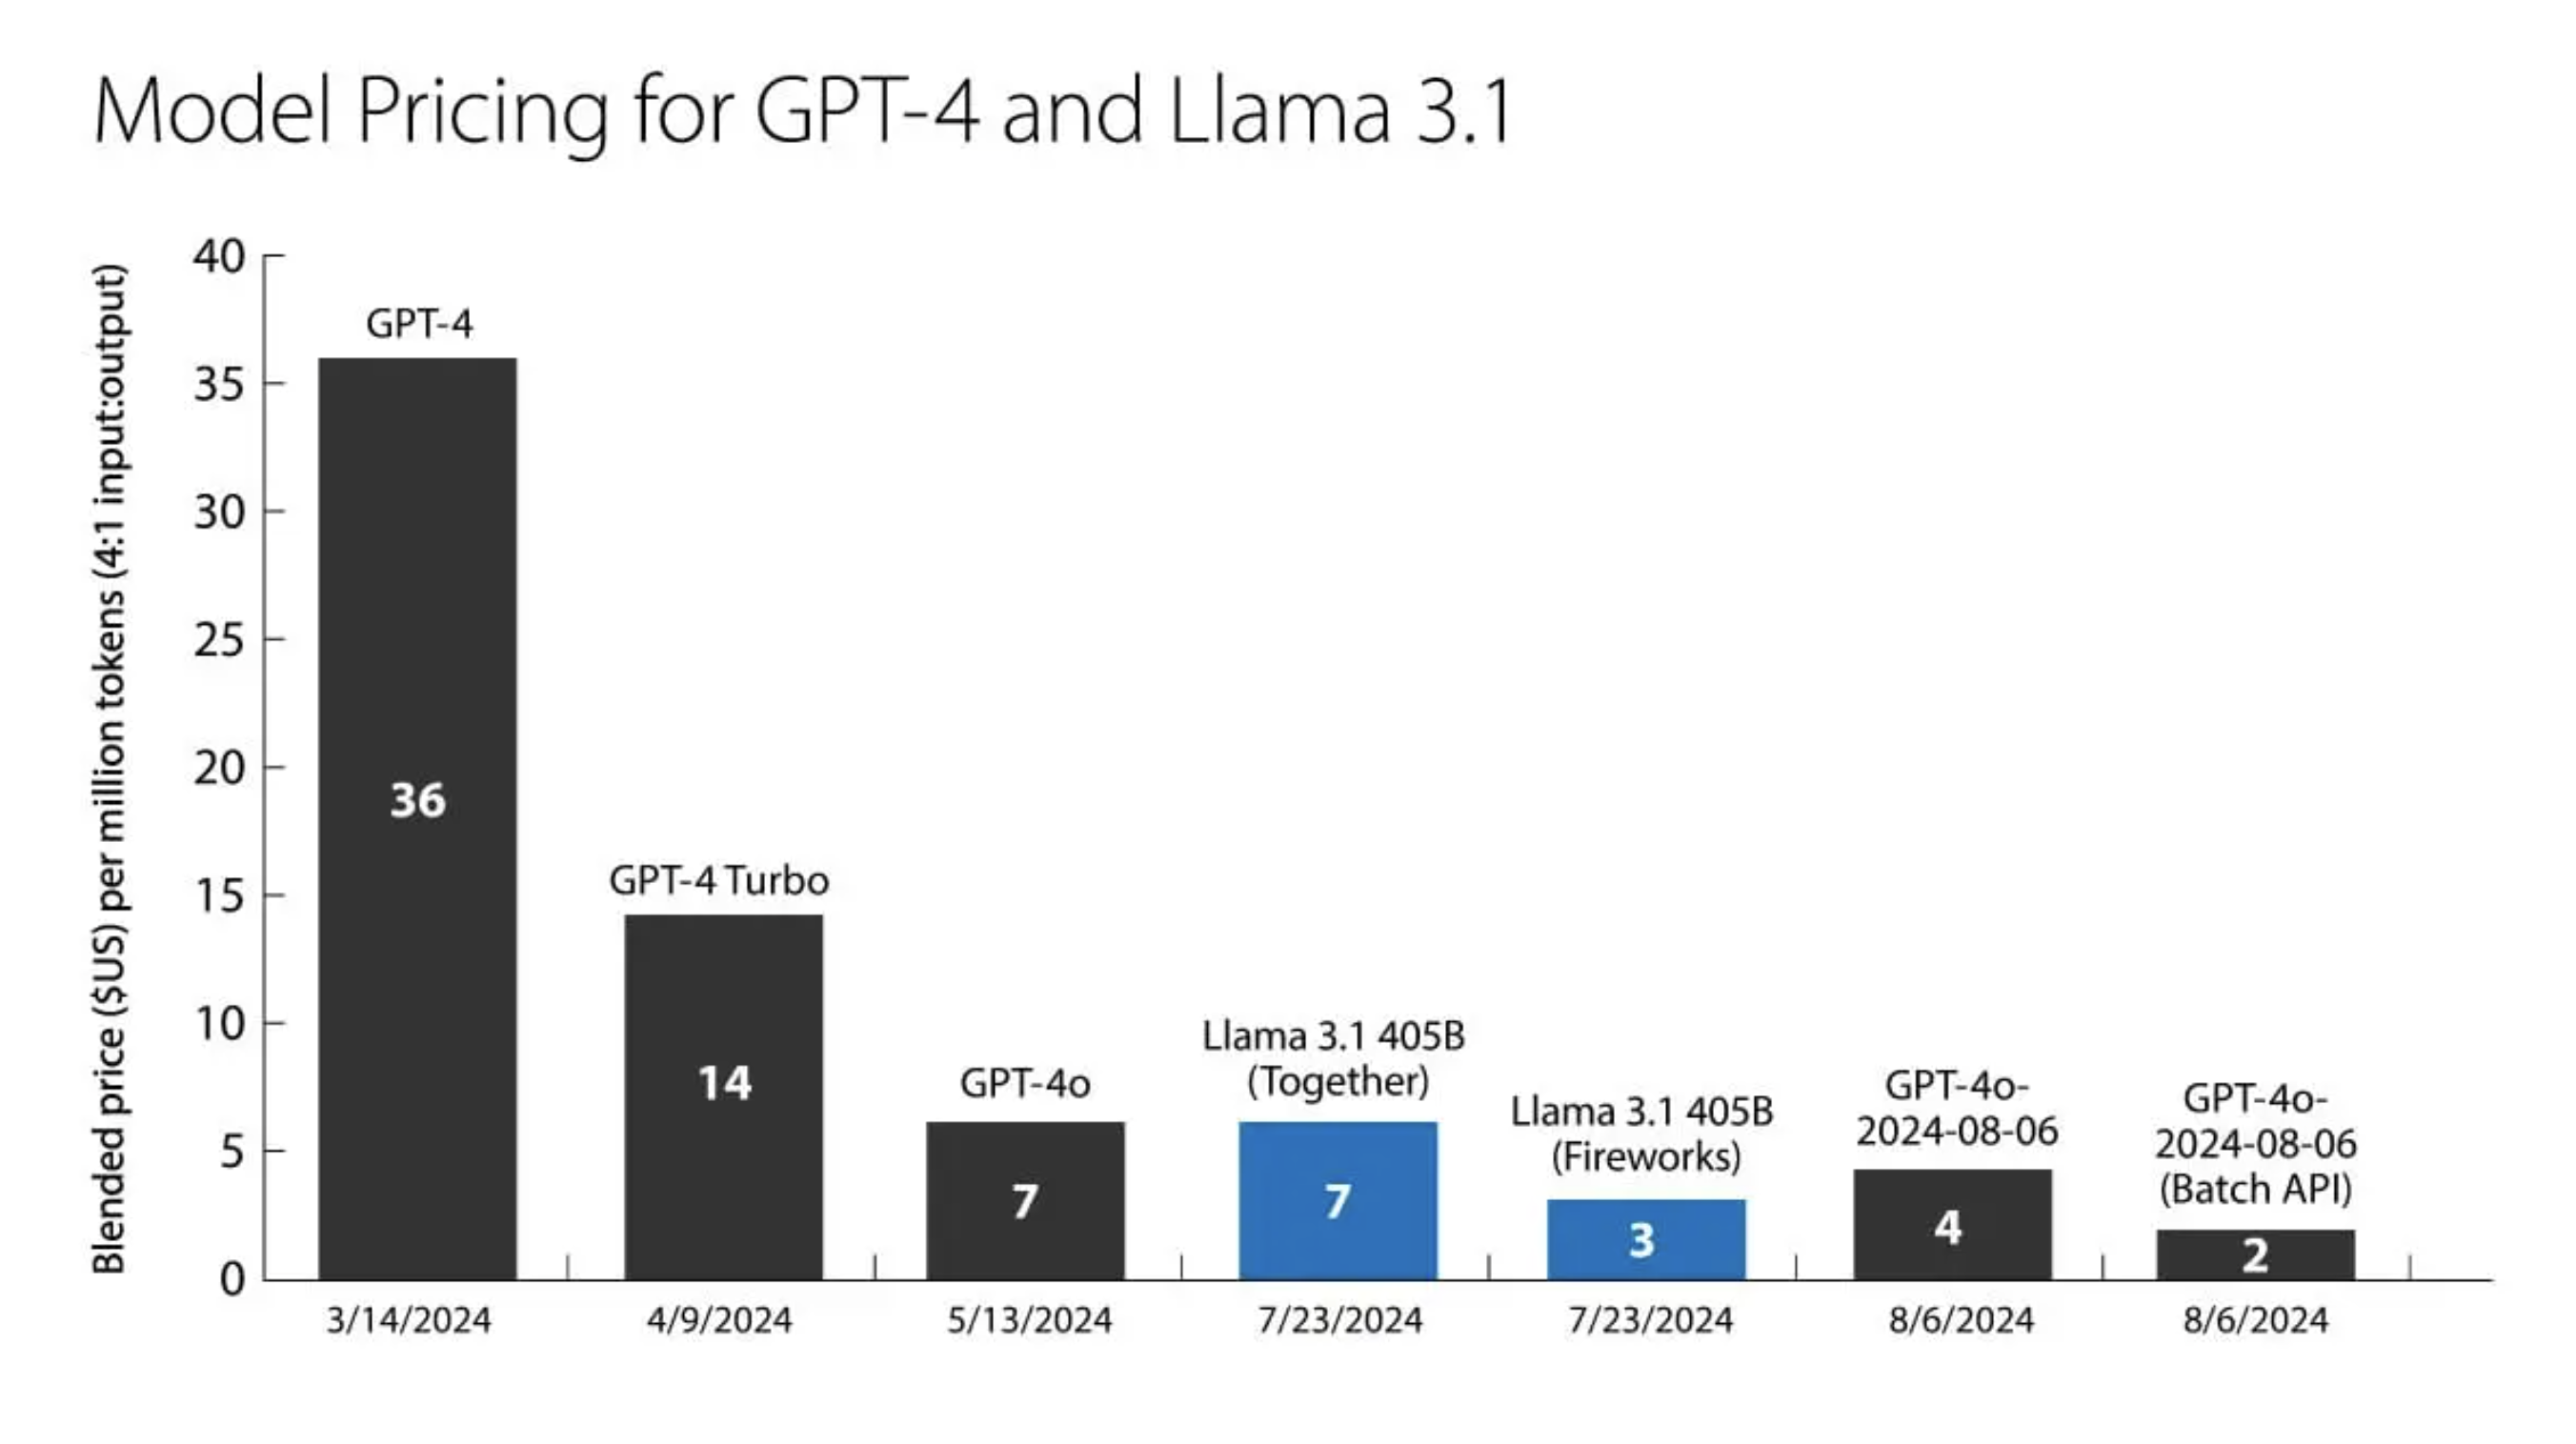
GPT-4는 첫 출시 시점에 100만 토큰당 비용은 36달러 (입력과 출력 비율: 8:2 적용)의 비용이 들었지만, 2023년 GPT-4 Turbo가 등장하면서 비용이 한 번 하락하였고, 가장 최근에는 2024년 5월 GPT-4o가 100만 토큰당 4달러로 출시되었습니다. 이는 17개월 동안 약 79% 가격이 인하된 결과입니다. 최대 24시간이 걸리는 배치 API를 사용하는 경우 다시 절반 가격인 100만 토큰당 2달러 수준으로 API를 사용할 수도 있습니다.
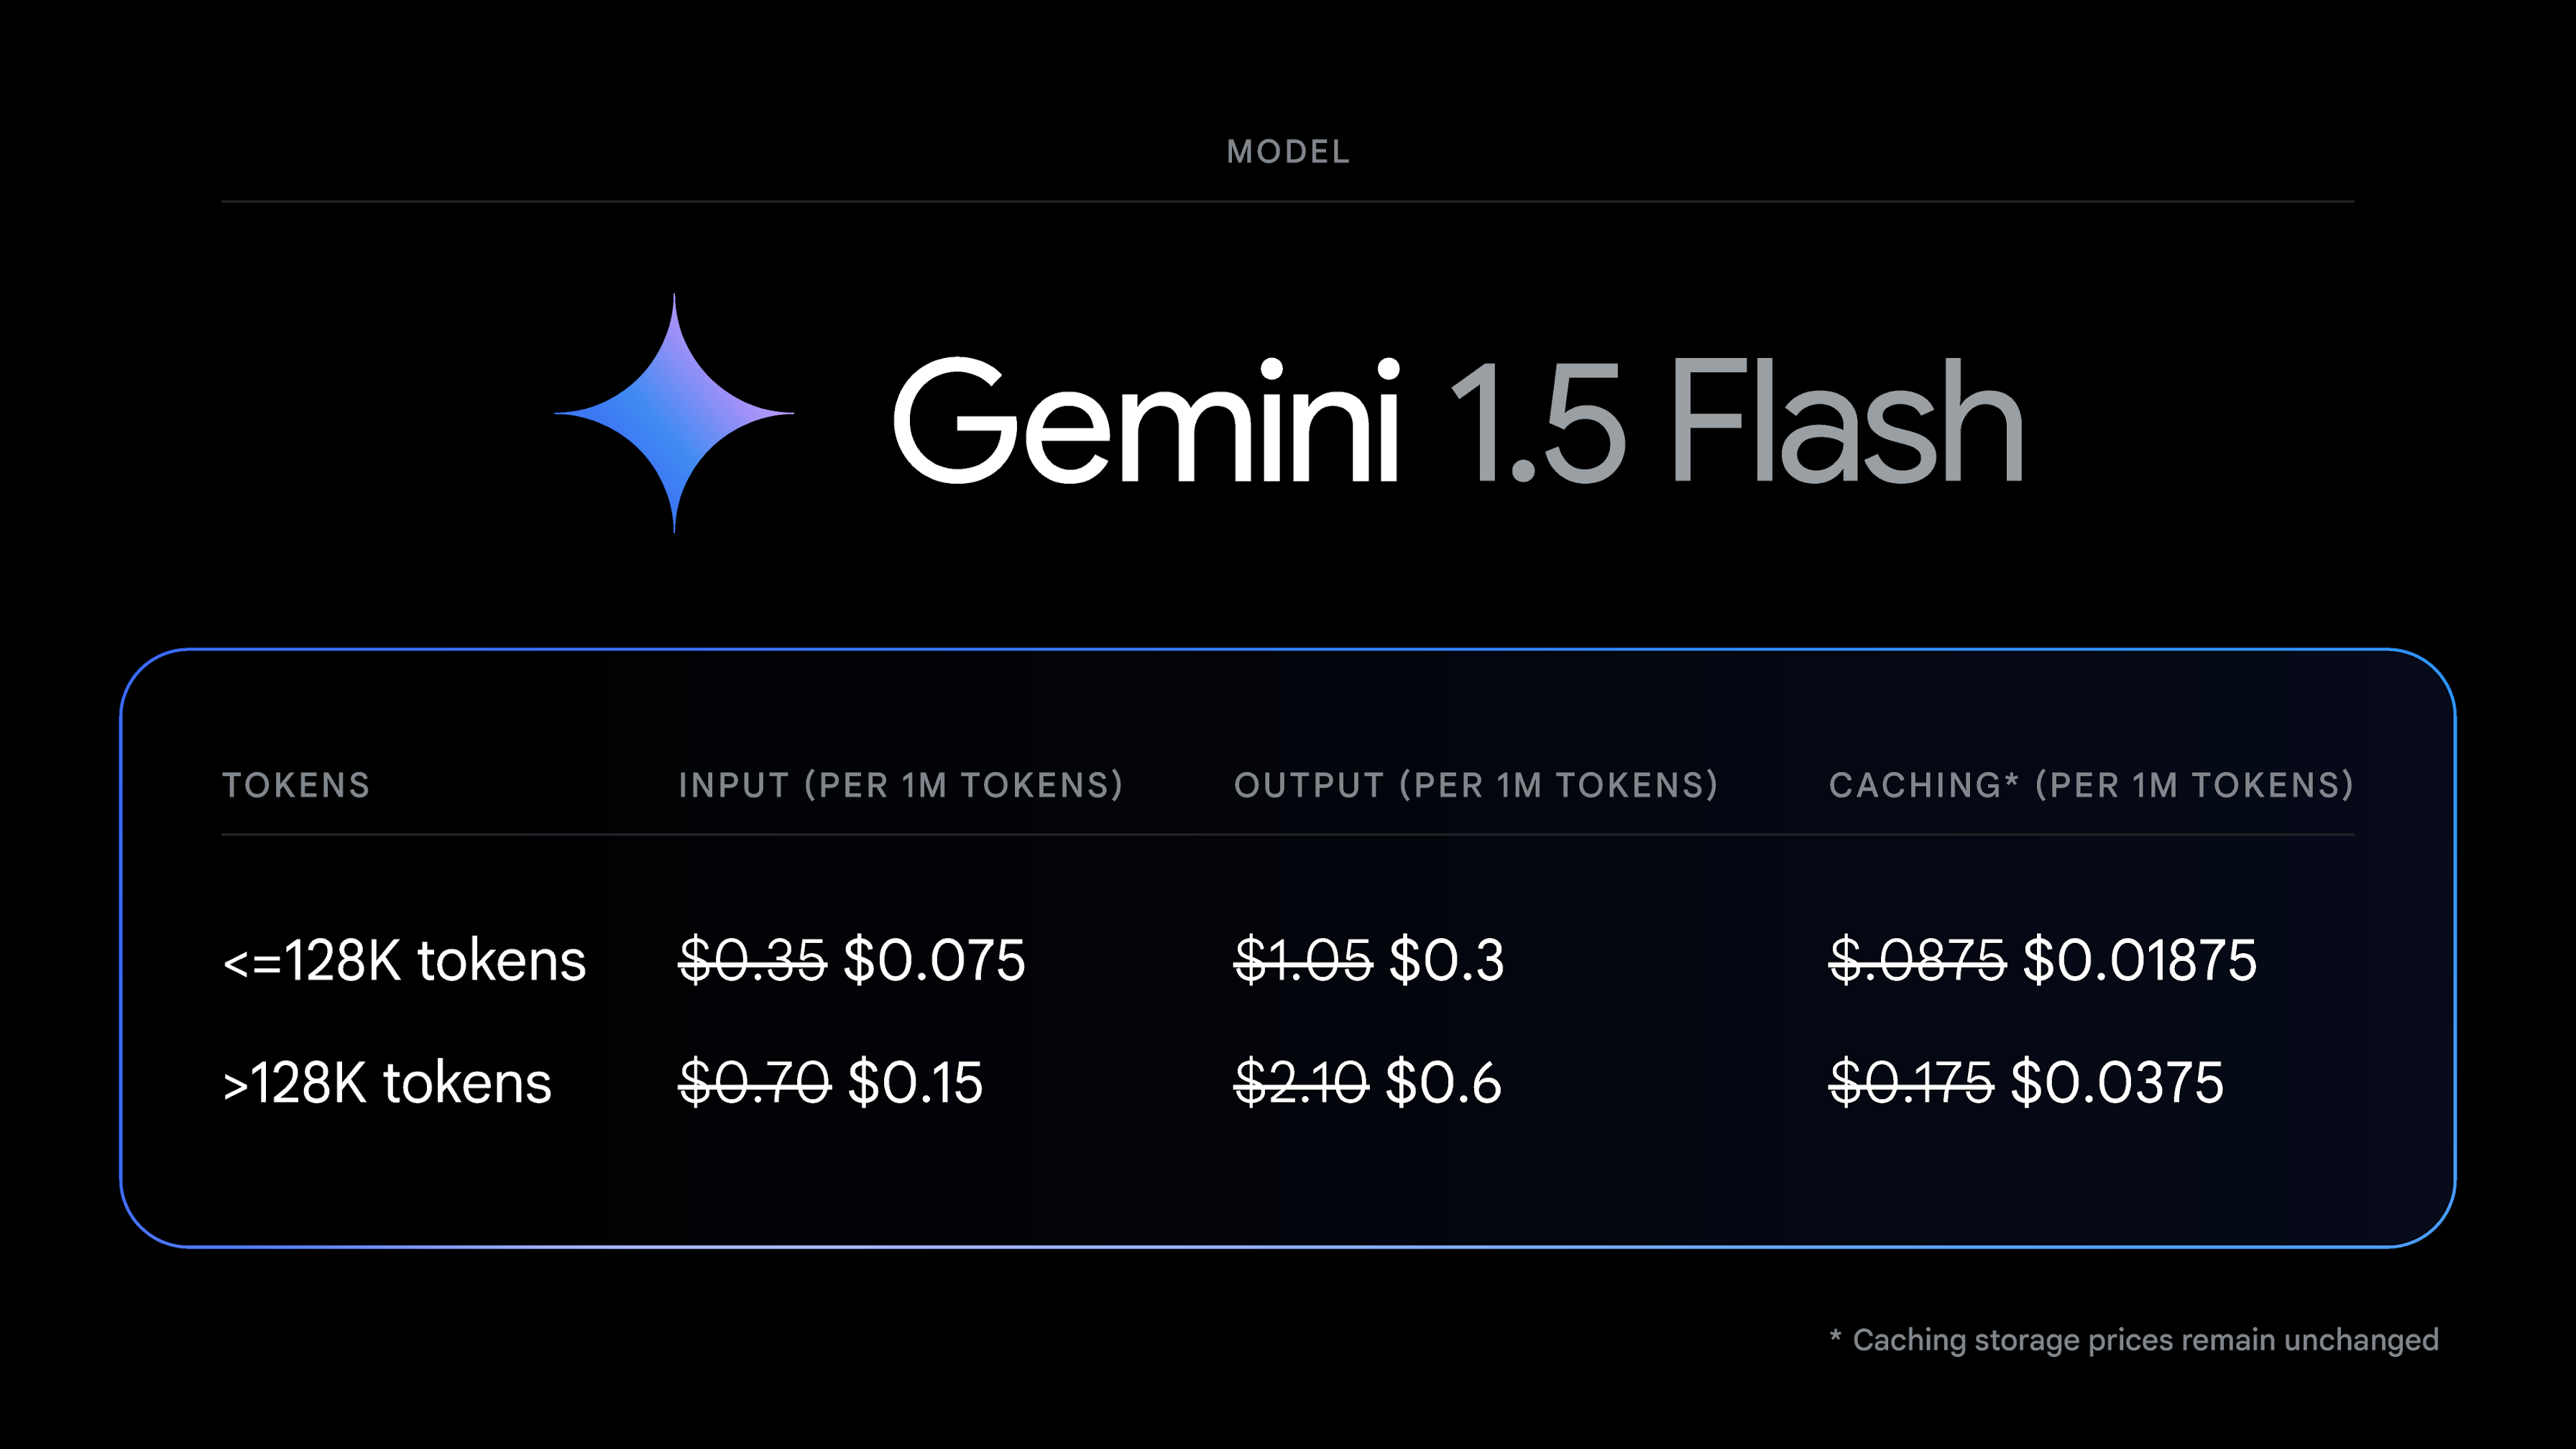
OpenAI 뿐만 아니라, Google 제미나이(Gemini)도 최근 Gemini Flash를 선보이며 API 가격을 크게 낮췄으며, 경쟁사의 GPT-4o mini가 출시된 이후 GPT-4o mini보다 절반 수준의 가격으로 한 번 더 비용 인하를 단행했습니다.
Claude 역시 Claude-3 출시와 함께 API 사용 가격을 인하했는데요, 이러한 LLM들의 토큰당 가격 인하 흐름은 오픈소스 모델의 API 가격 경쟁이 영향을 끼친 것으로 생각됩니다. 실제로 오픈소스 모델인 Llama의 경우, Provider마다 차이가 있는데 100만 토큰당 3 ~ 7달러의 비용 선에서 제공되어며 전반적인 LLM 모델들의 가격 인하를 유도하고 있습니다.
2️⃣ LLM은 더욱 빨라지고 있습니다.
AI를 활용한 서비스를 구축할 시, LLM의 토큰 생성 속도는 프로젝트의 중요한 핵심 요소 중 하나입니다. 토큰은 보통 음절 단위나 단어 수준을 의미하는데, 일반적으로 사람은 초당 30~50 토큰을 읽을 수 있으며 기존의 검색 엔진은 이보다 빠른 밀리초 단위로 수십~수백 토큰의 결과를 제공했습니다.
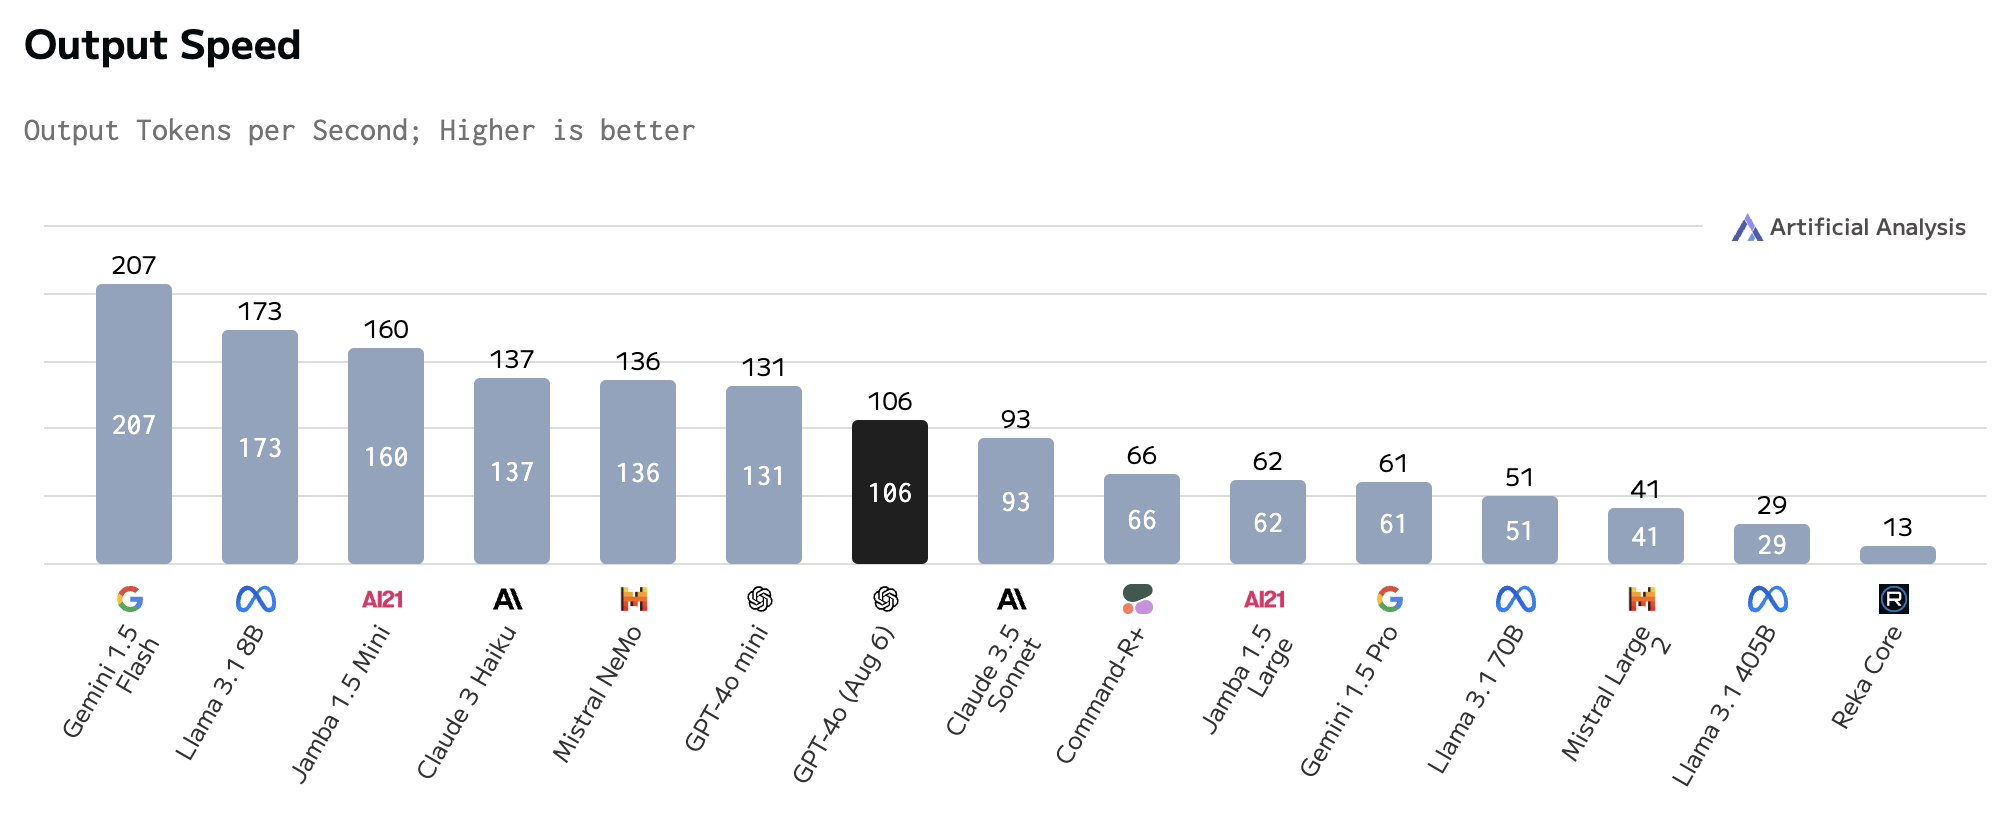
초기 LLM의 경우 사람이 읽는 속도보다 느리게 텍스트를 생성했었는데요, 현재 LLM의 생성 속도는 눈에 띄게 큰 폭으로 개선되었습니다. 일례로 OpenAI의 GPT-4o는 초당 106 토큰을 생성하고, GPT-4o mini는 초당 131 토큰, Gemini Flash는 초당 207 토큰을 생성할 수 있습니다. 다만 생성 속도는 트래픽, 입력 데이터의 양 그리고 처리할 내용의 복잡성에 따라 변동될 수 있는 점은 참고하시면 좋을 것 같습니다.
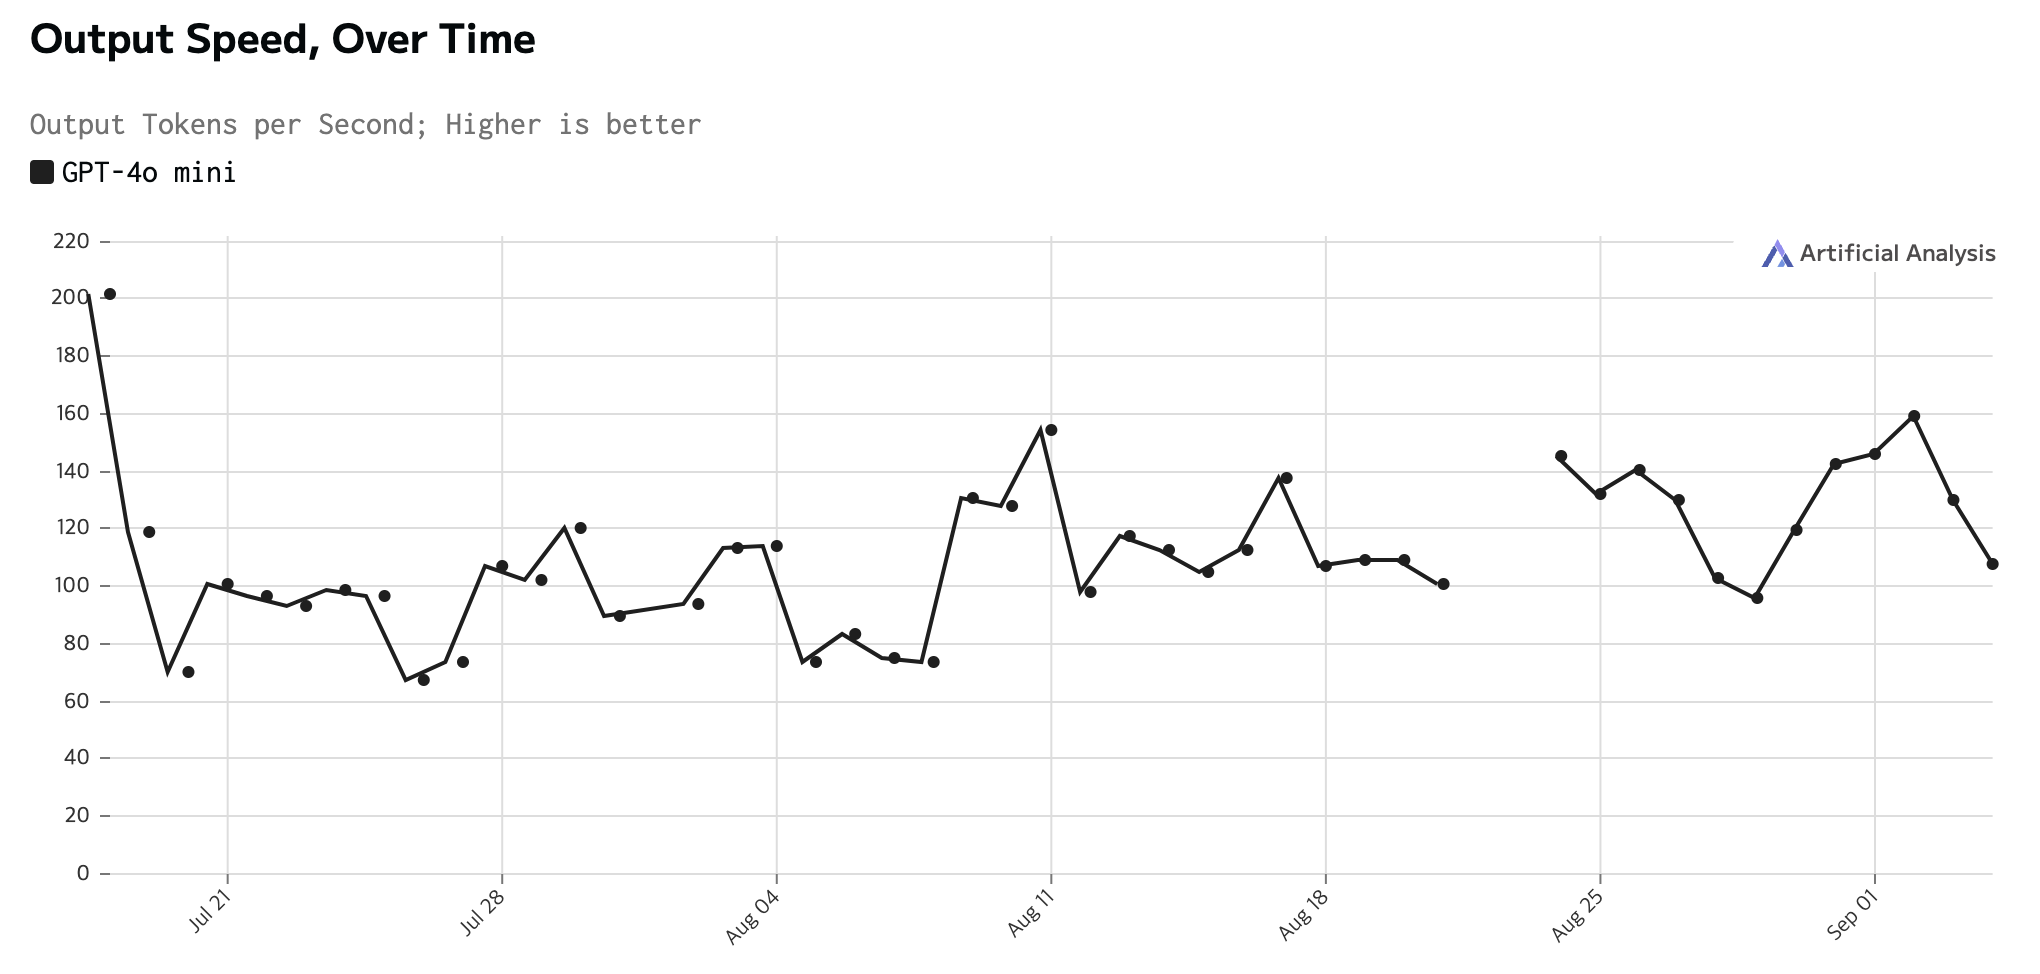
이러한 모델들의 속도 향상은 모델 자체뿐 아니라 GPU와 같은 하드웨어 성능에도 크게 좌우됩니다. Nvidia의 A100, H100 및 H200과 같은 고성능 GPU들이 주목을 받는 이유도 여기에 있습니다. 최근에는 AI 모델에 특화된 커스텀 칩들이 등장하면서 더욱더 빠른 생성 속도를 제공하고 있습니다. 그중 Groq은 초당 750 토큰에 가까운 속도로 텍스트를 생성하며, Llama-3 8B를 기준으로 Nvidia 기반 시스템을 능가하는 성능을 선보이고 있습니다.
또한, 최근 Cerebras 사가 공개한 3세대 Wafer Scale Engine으로 구동되는 추론은 Groq보다 두배 이상 빠른 초당 1,800 토큰을 생성하며, 속도 면에서 어마어마한 진전을 이뤘습니다. Cerebras는 이러한 속도를 달성하기 위해, 현재 세계에서 가장 큰 커스텀 칩을 구축하고 전체 모델을 칩에 저장함으로써 메모리 대역폭의 병목 현상을 해결했다고 밝힌 바 있습니다.
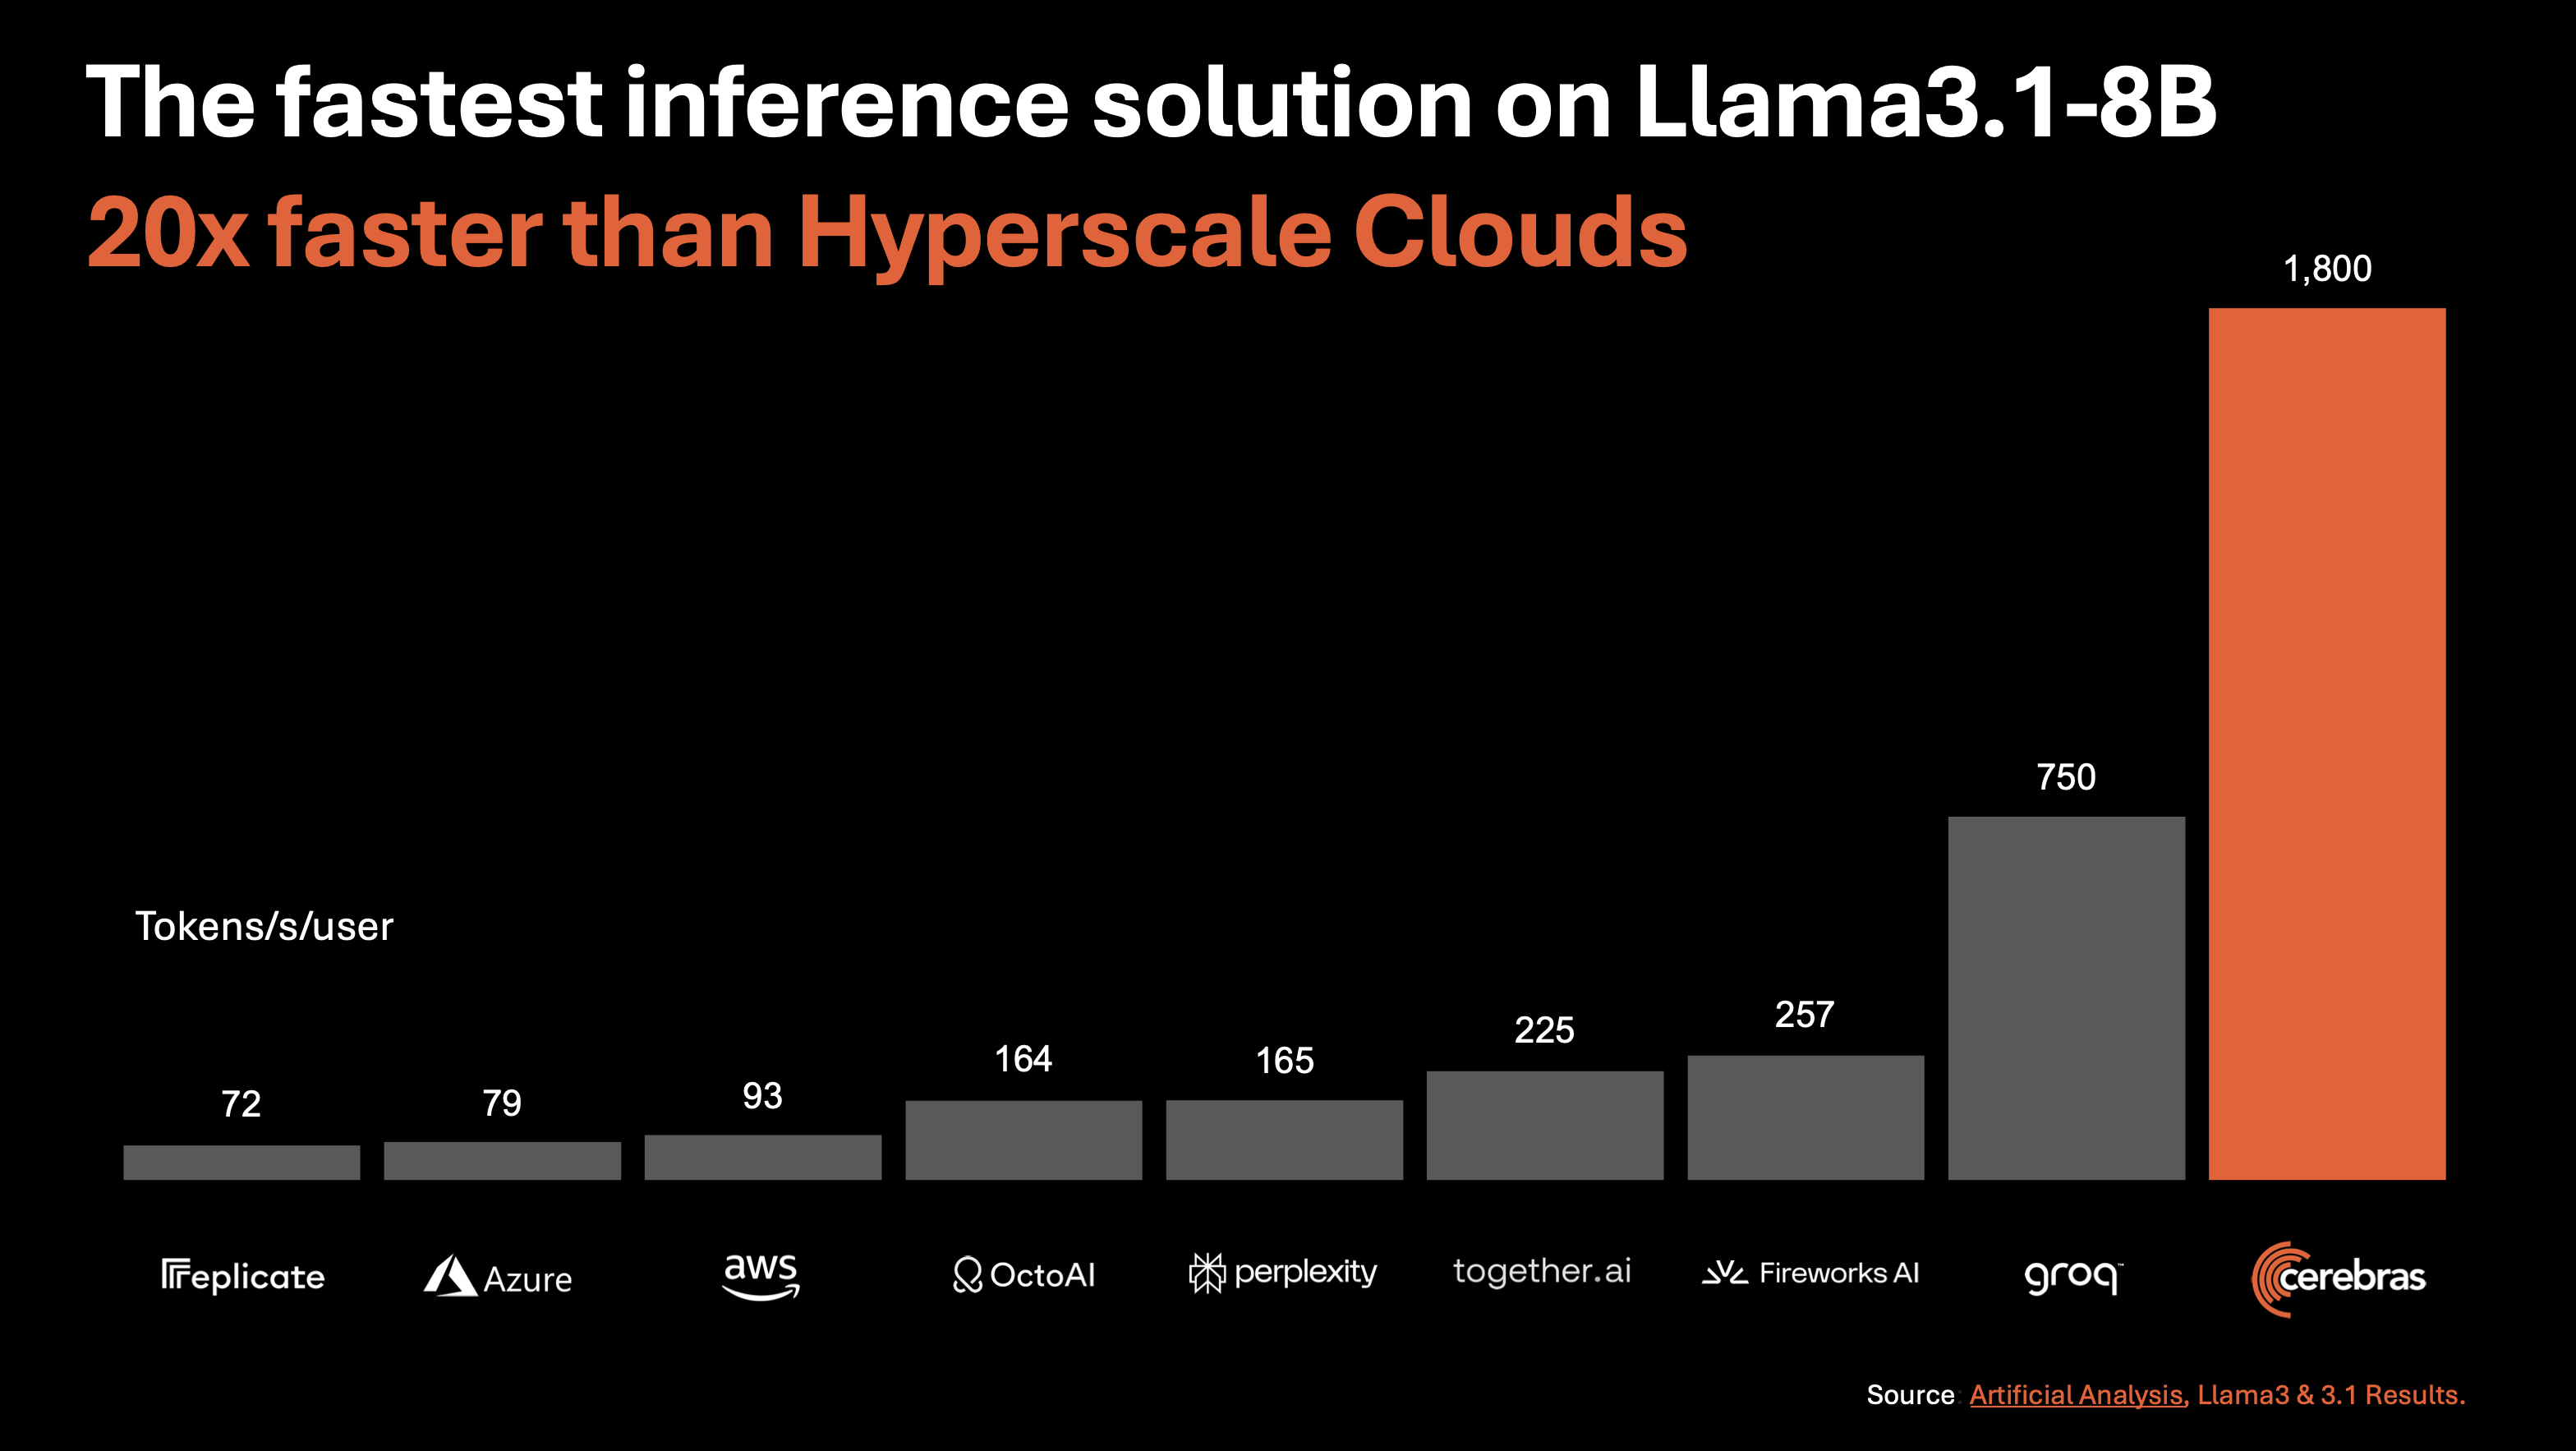
위의 차트에서도 확인할 수 있듯, 이러한 엄청난 속도 덕분에 스트리밍 방식이 아니어도 사용자가 불편함 없이 실시간으로 생성 결과를 확인할 수 있을 정도로 모델의 토큰 생성 속도가 향상되었습니다. 물론, 초당 1,800 토큰이 꼭 필요한지는 논란의 여지가 있지만, LLM 속도가 매우 빨라지는 만큼 새로운 가능성들이 열릴 수 있습니다. 예를 들어, 자율주행 및 로봇 산업과 같이 실시간 대량 데이터 처리 기술이 필요한 영역에서도 LLM의 활용이 크게 확대될 수 있을 것입니다.
3️⃣ LLM은 더욱 똑똑해지고 있습니다.
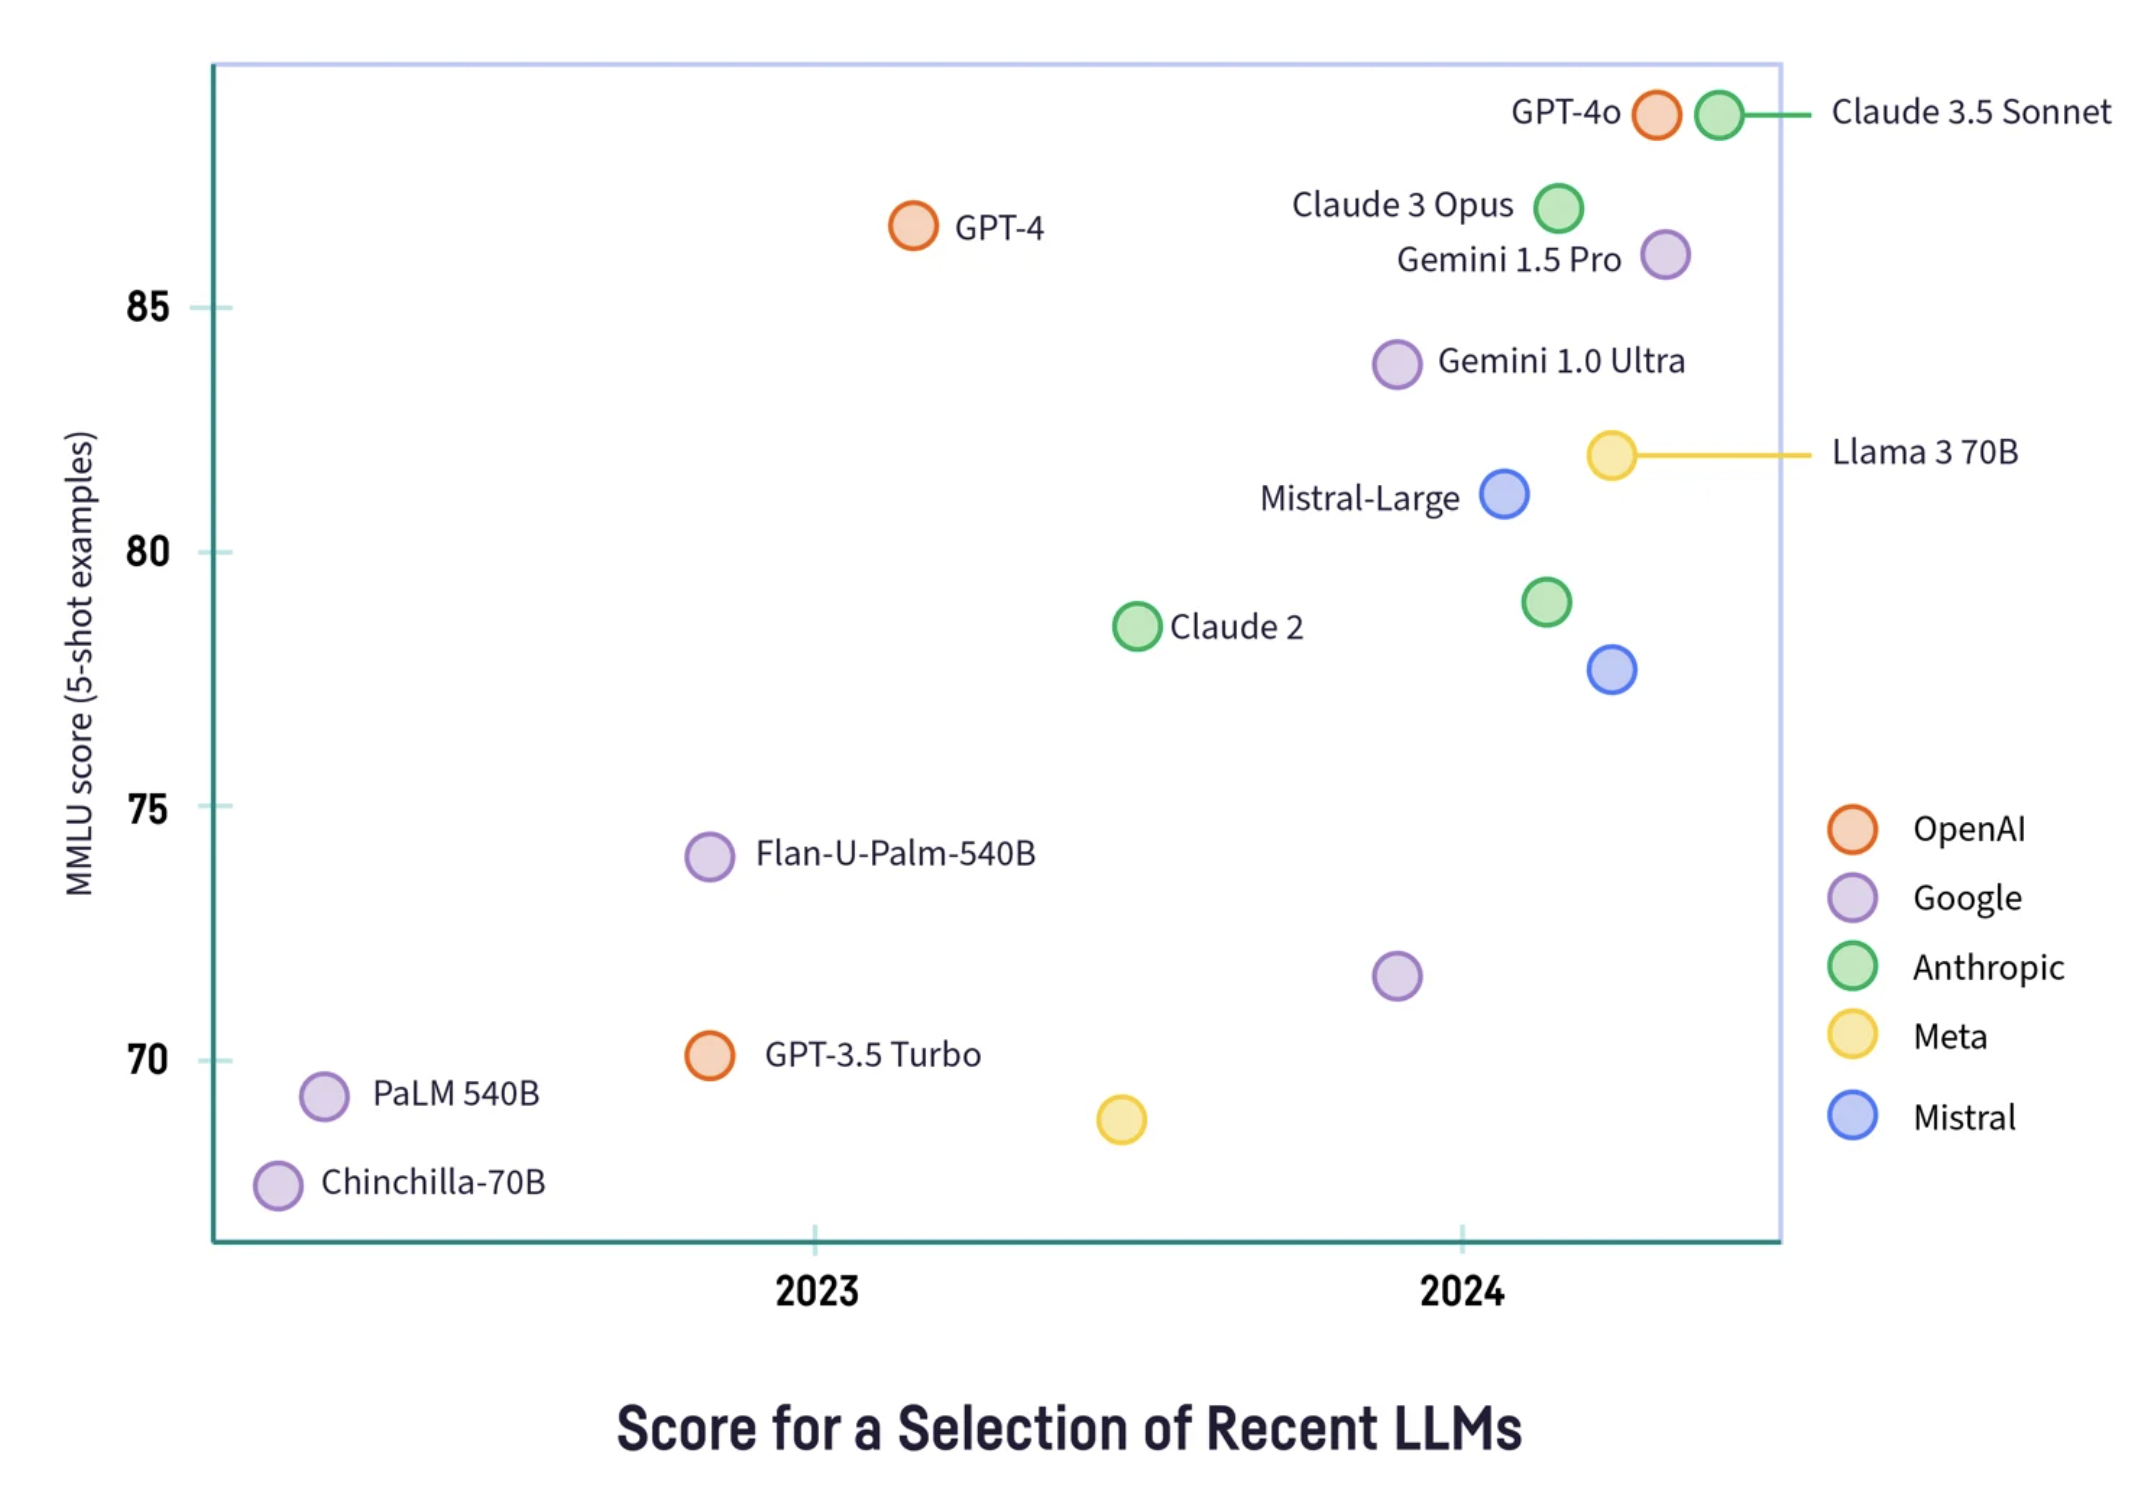
2022년 11월 말, GPT-3.5 기반의 ChatGPT가 출시되었을 때 이미 놀라운 성능을 보여주었지만, 이듬해 GPT-4가 출시되며 더욱 향상된 모델을 사용할 수 있었습니다. 이후에도 GPT-4는 꾸준히 업데이트되며 벤치마크 점수가 계속 상승했는데요, 최근에는 8월 6일에 업데이트된 GPT-4o 버전에서 모델의 성능이 눈에 띄게 향상된 것을 확인할 수 있었습니다.
Anthropic의 Claude 또한 버전 2에서 3으로 업그레이드되면서 Opus, Sonet 및 Haiku 세 가지 모델을 선보였으며, 모두 이전 버전보다 성능이 크게 개선되었습니다. 현재는 Claude 3.5 Sonet이 가장 뛰어난 성능을 제공하고 있으며, 루머에 따르면 최근 일부 사용자들에게 다음 모델인 Claude 3.5 Opus가 잠시 공개되기도 했습니다.
Google은 여러 LLM을 거쳐 2023년 12월에 제미나이(Gemini)를 출시하면서 Ultra, Pro 및 Nano로 모델군을 구분했고, 현재는 Gemini 1.5 Pro가 가장 우수한 성능을 자랑합니다. 며칠 전에는 Gemini 1.5 Pro와 Flash가 새로운 업데이트를 통해, 코딩을 생성하고 복잡한 프롬프트를 처리하는 능력이 향상되기도 하였습니다.
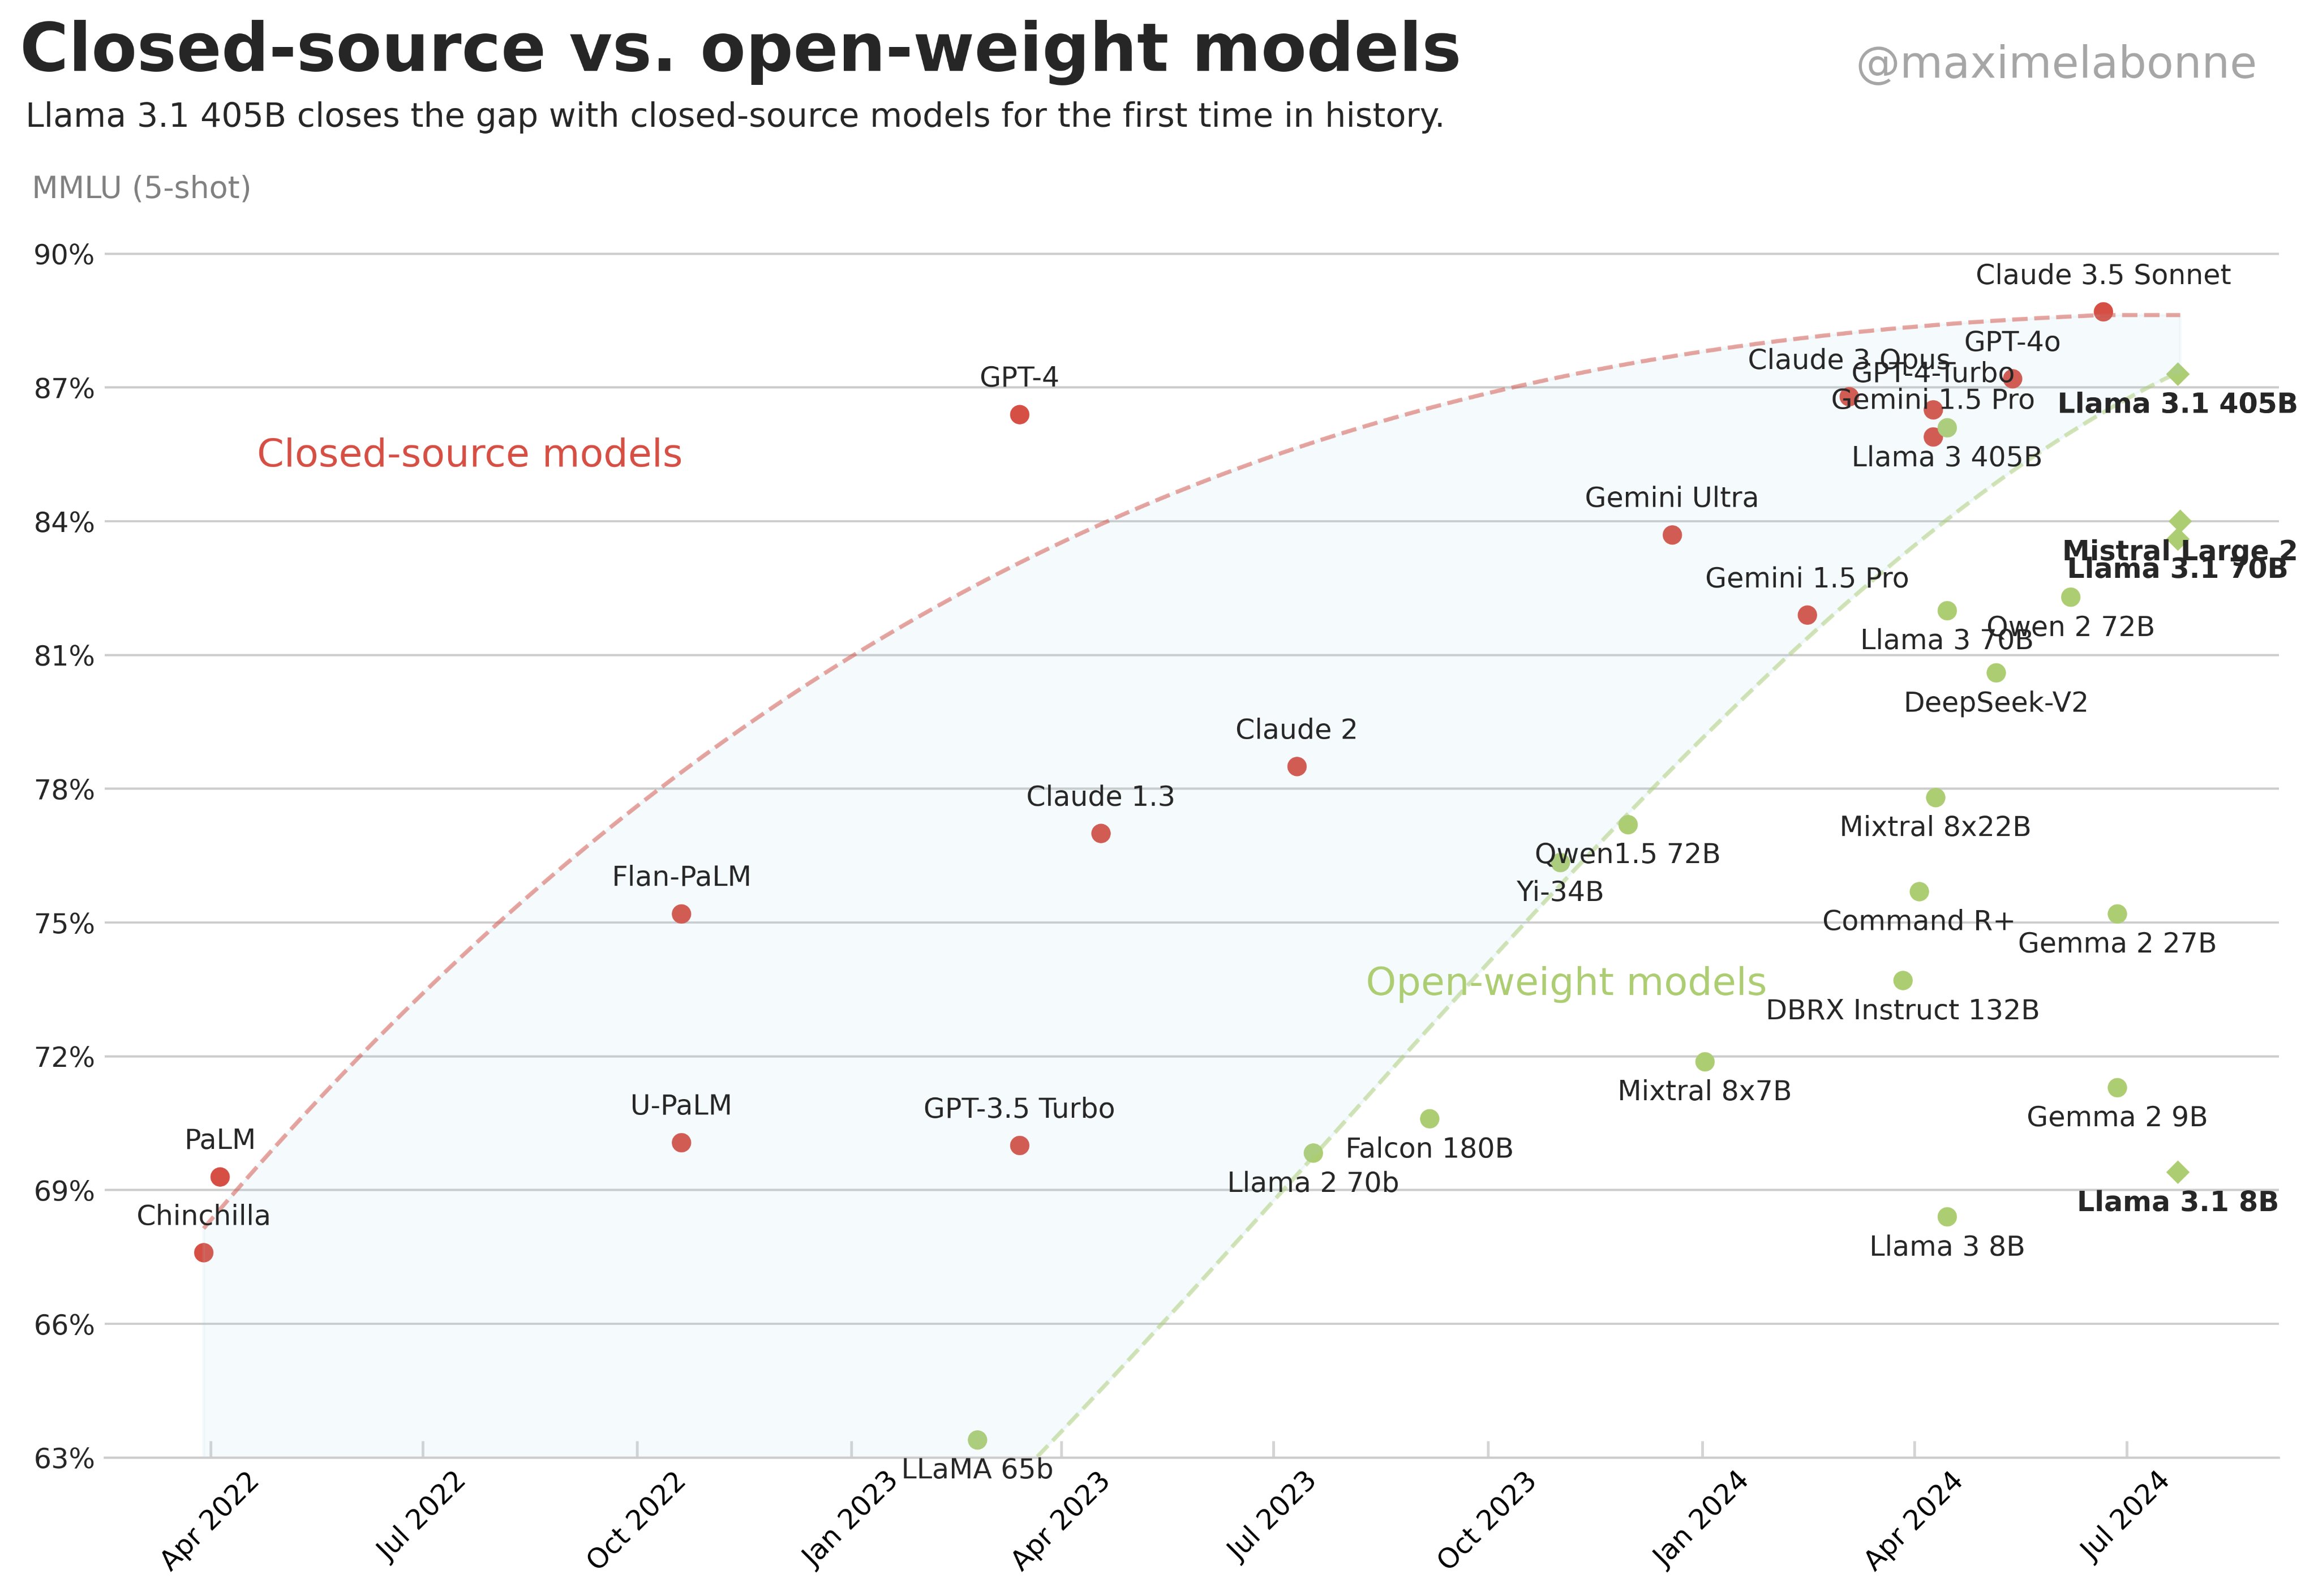
오픈소스 LLM들도 성능 면에서 상용 LLM들의 성능을 빠르게 따라잡고 있습니다. Meta의 Llama 3.1, Alibaba의 Qwen2 및 Mistral의 Mistral Large 등이 대표적인 오픈소스 모델들이며, 완전한 오픈소스는 아니지만 제한적으로 상업적 사용이 가능해지고 있습니다(Mistral Large 제외). 이 모델들은 GPU 인프라만 갖춘 기업이라면, 사내 데이터를 외부에 노출시키지 않고 GPT-4에 근접한 성능을 가지는 LLM을 활용할 수 있다는 장점이 있습니다.
한편, Q* 또는 Q-Star로 알려졌던 OpenAI의 Strawberry는 지금까지 흔히 접할 수 있었던 단순한 챗봇을 넘어 복잡한 수학 문제와 프로그래밍 문제를 해결할 수 있는 추론 능력을 갖춘 혁신적인 모델로 발전할 것으로 예상됩니다. 또한 Strawberry는 GPT-5급 모델이라는 소문이 돌고 있으며, 출시가 임박하여 곧 OpenAI의 채팅 모델에 통합될 가능성이 높다고 합니다.
추가로, OpenAI는 차세대 모델인 Orion을 개발 중에 있으며, 이는 완전한 GPT-5급 모델로 예상됩니다. Orion은 더욱 향상된 성능과 확장성을 바탕으로 또 한 번의 중요한 변화를 예고하고 있습니다. 아래와 같이 LLM의 발전은 한편으로는 최적화, 다른 한편으로는 규모 확장을 통해 지속적인 진보를 이루고 있는 것으로 보입니다.
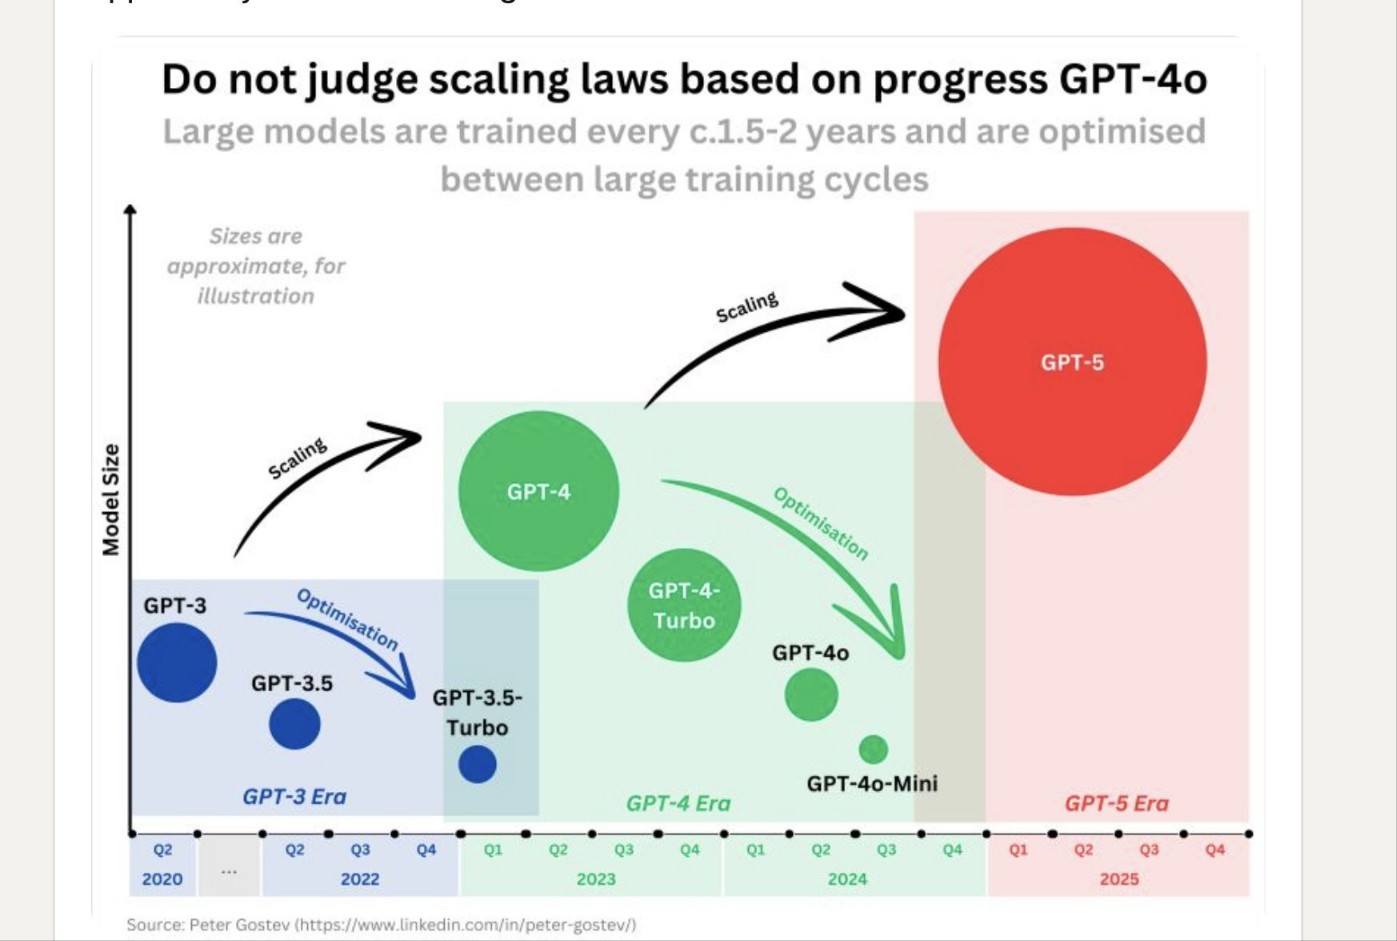
4️⃣ LLM 처리가 늘어나고 있습니다(Context 사이즈 증가)
GPT-3.5가 출시될 당시, 한 번에 처리할 수 있는 컨텍스트 사이즈는 4천 토큰에 불과했습니다. 그러나 GPT-4로 넘어가면서 이 사이즈는 8천 토큰으로 확장되었고, 이후 3만 6천 토큰, 현재는 12만 8천 토큰까지 처리할 수 있게 되었습니다. 최근 알파 유저들에게 공개된 gpt-4o-64k-output-alpha 모델은 기존 4천 토큰 대비 6만 4천 토큰까지 확장된 아웃풋 토큰수를 사용할 수 있습니다.
Anthropic의 Claude는 버전 2부터 20만 토큰을 지원하고 있으며, Google의 제미나이(Gemini)는 출시 당시부터 100만 토큰이라는 파격적인 컨텍스트 사이즈를 제공했습니다. 심지어 내부 실험에서는 1,000만 토큰까지 처리할 수 있었다고 합니다. 그리고 6월부터는 Gemini 1.5 Pro 의 Context를 200만 토큰까지 지원하기 시작했습니다.
오픈소스 LLM 진영의 경우, 최근까지 8K 토큰을 지원하다가, 7월에 출시된 Llama 3.1이 12만 8천 토큰을 지원하기 시작했습니다. 또한 Alibaba의 Qwen2의 경우, 별도의 Agent 모델을 통해 100만 토큰까지 처리할 수 있습니다.
최근 Magic 사는 Google Cloud와 협력하여, 1억 토큰에 달하는 컨텍스트 윈도우를 갖춘 코드 어시스턴트를 개발하기 위해 두 대의 새로운 Google 클라우드 기반의 슈퍼컴퓨터를 구축한다고 발표했습니다. 이는 Magic의 사명인 자동화된 소프트웨어 엔지니어 및 연구자 를 개발하는 데 있어 중요한 단계로 생각되는데요, 1억 토큰은 대략적으로 모델이 최대 750권의 소설에 해당하는 방대한 양의 수집된 텍스트를 이해할 수 있다는 의미입니다. 이러한 기능은 자율적인 AI 에이전트가 스스로 동작하는 데 필수적인 요소입니다.
아울러 이러한 대규모 컨텍스트 사이즈가 지원된다는 것은 LLM 모델이 더 많은 데이터를 한 번에 처리할 수 있다는 것을 의미합니다. 지금도 제한된 컨텍스트 내에서 정확하게 정보를 처리하기 위한 다양한 RAG(Retrieval-Augmented Generation) 기술들이 개발되고 있지만, 컨텍스트 사이즈가 커지면서 일부 전문가들은 RAG의 필요성이 점차 줄어들고 있다고 의견을 공유하기도 합니다. 그러나 컨텍스트 사이즈가 곧 비용을 의미하는 현재의 상황에서는 앞으로도 RAG 기술이 더욱 고도화될 가능성이 높아 보입니다.
5️⃣ 경량 LLM(sLLM)이 유용해지고 있습니다.
최근 AI 서비스 개발의 트렌드를 꼽자면 하나의 모델만 사용하는 대신 속도, 비용, 보안 및 구현 기능에 따라 여러 LLM을 하이브리드로 결합해 사용하는 방식이라고 할 수 있습니다.
대표적인 사례로는 AI 검색 서비스인 Perplexity 가 있습니다. 이 서비스는 사용자 쿼리를 빠르게 분석하는 sLLM을 앞단에 배치하여 먼저 사용자 의도를 정확히 파악합니다. 이후 레퍼런스 정보 요약, 전체 내용 생성 및 후속 질문 목록 생성 등 각 기능에 맞는 다른 LLM들을 결합하여 결과를 생성하는 하이브리드 구조로 운영됩니다.
또한 다른 사용 케이스들을 생각해 본다면, 번역에 특화된 sLLM이나 빠른 응답을 위한 추론 중심의 sLLM을 활용하여 사용자 경험을 최적화할 수도 있을 것입니다. 이렇게 모바일이나 노트북에 설치 가능한 On-Device 모델은 성능이 다소 떨어질 수 있지만, 빠른 응답, 개인정보 보호 및 보안을 중시하는 환경에서 특정 도메인의 성능을 강화하여 유용하게 쓰일 수 있습니다.
Google의 Gemma , Gemini Nano , Microsoft의 Phi 3.5 및 Apple의 Apple Intelligence에 적용된 모델 등이 대표적인 sLLM 모델들입니다.
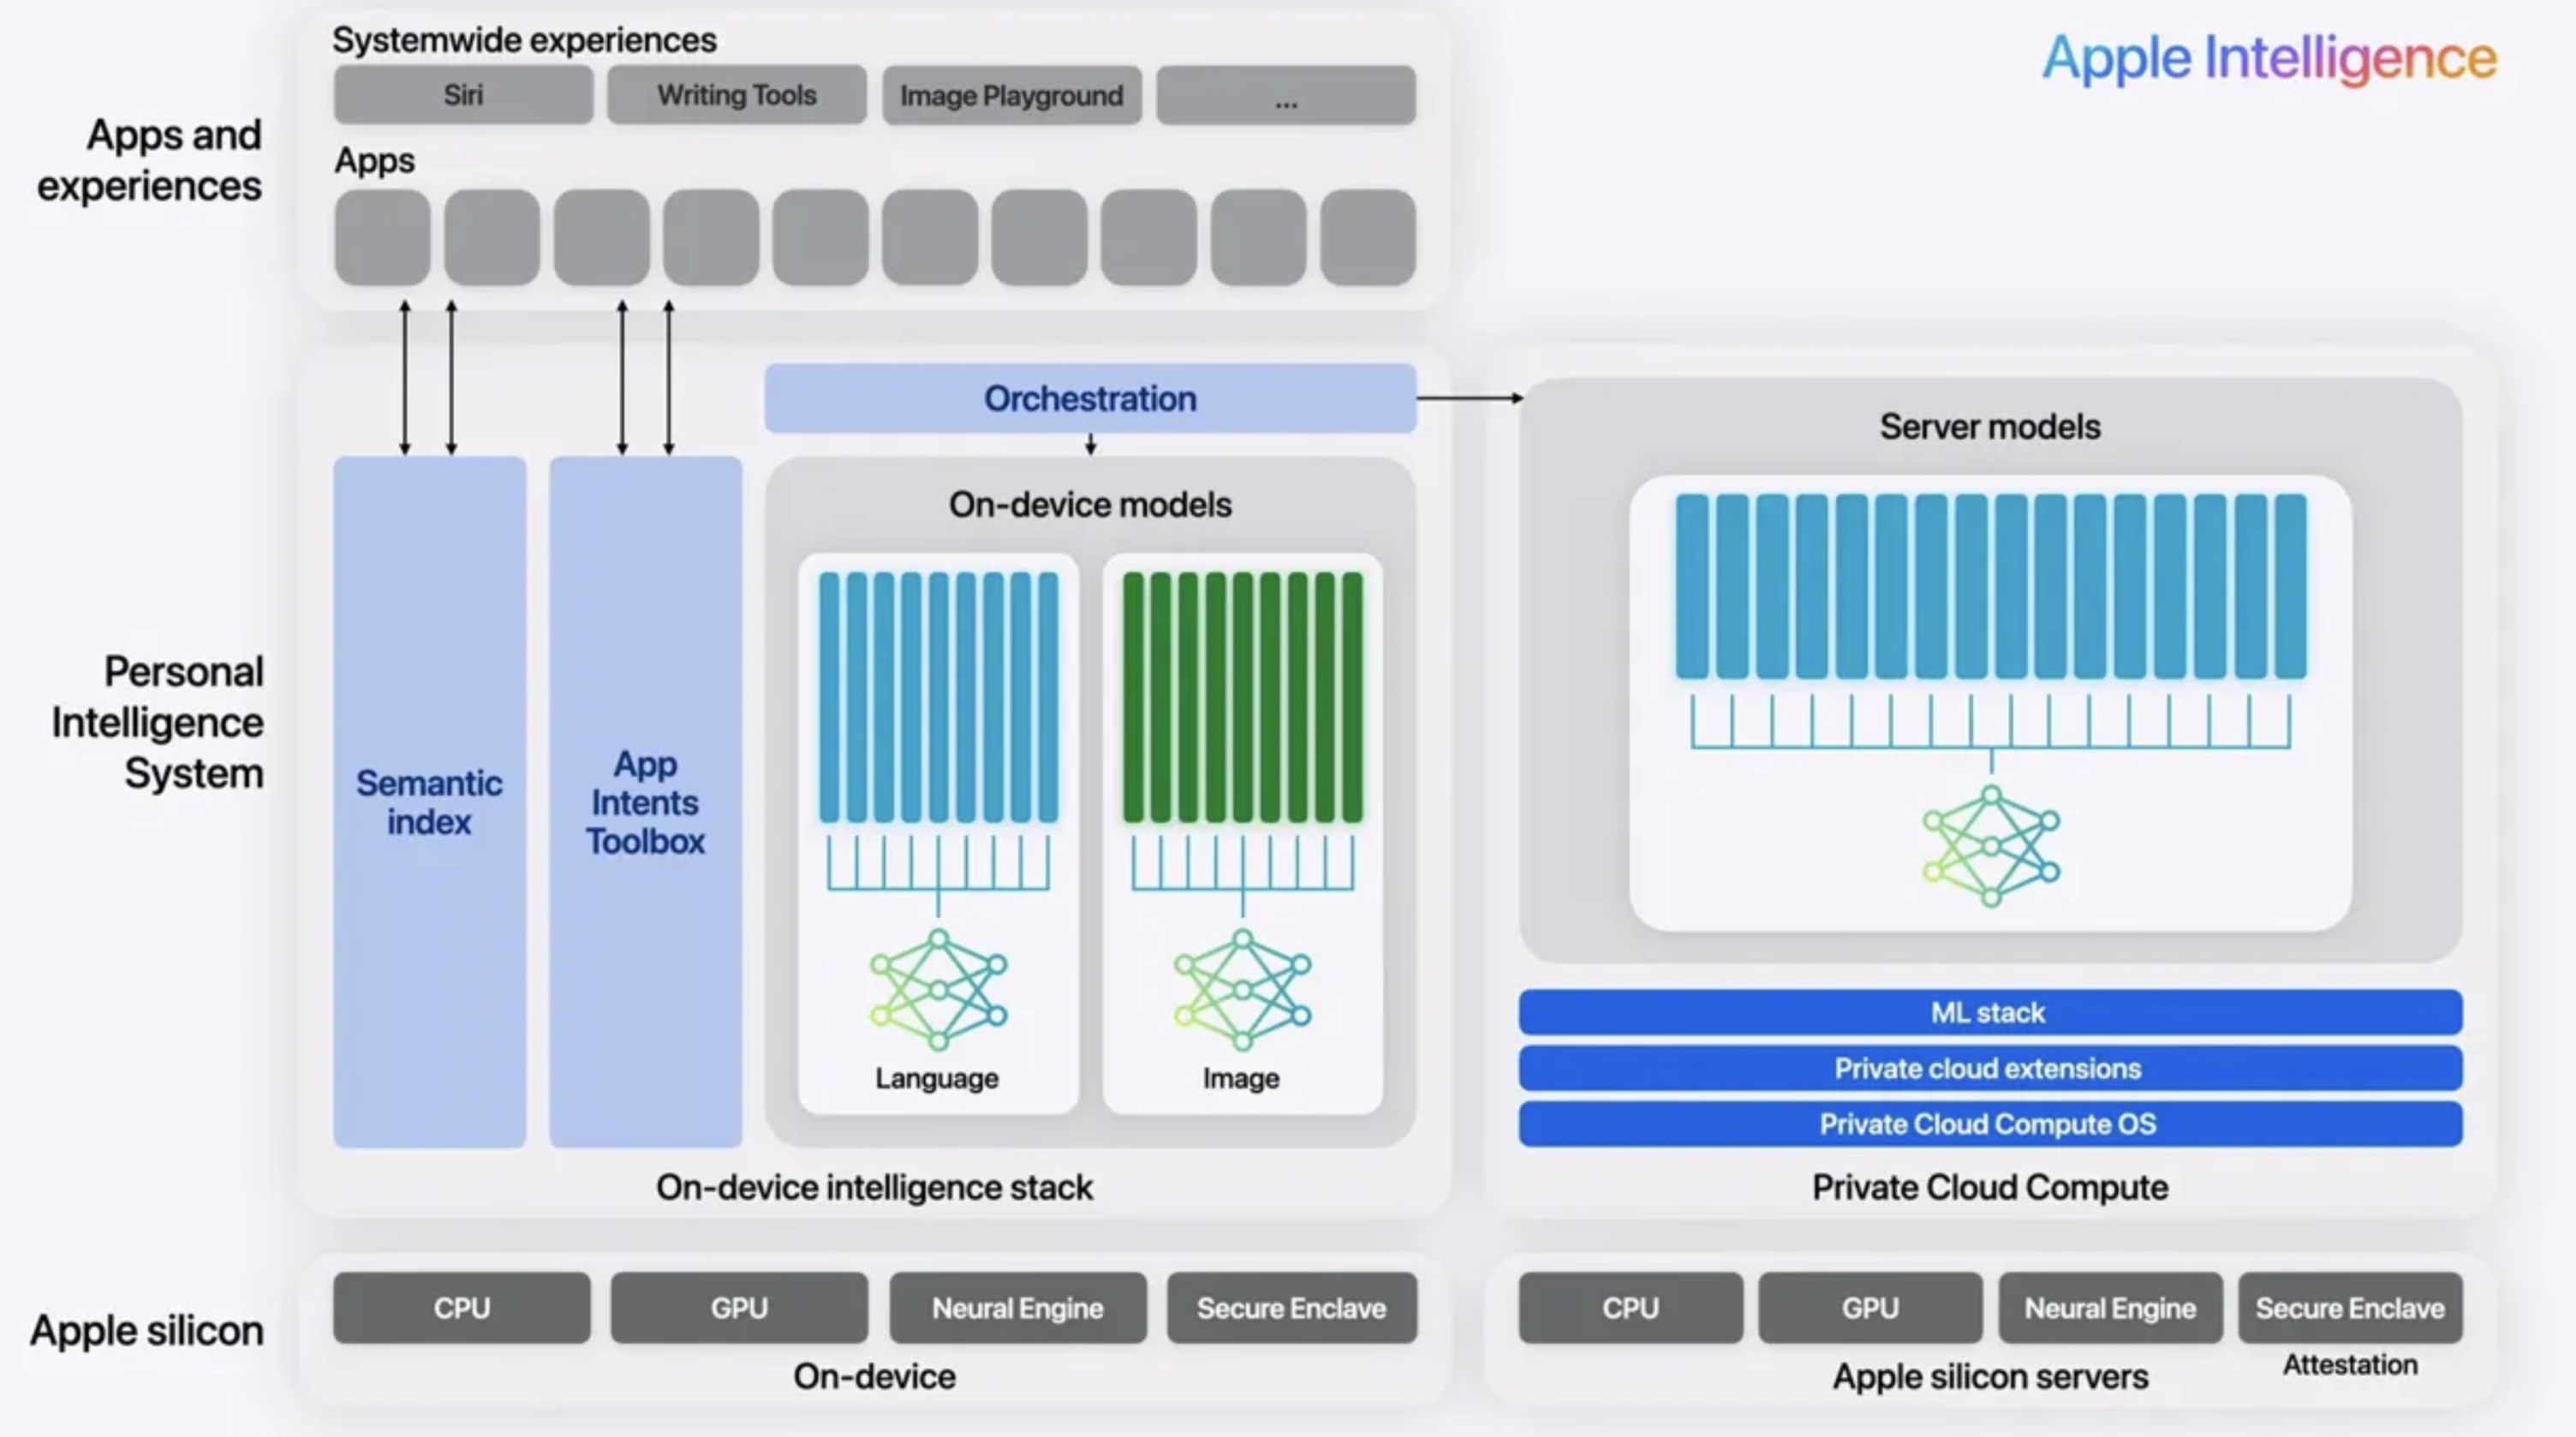
글을 마치며
지금까지 살펴본 것처럼 LLM이 빠르게 발전하면서 AI 기반 서비스의 개발에 새로운 가능성을 열고 있습니다. 가격 인하, 속도 향상, 성능 개선, 처리량 증가 및 경량 모델의 활용 증가는 AI가 앞으로 더욱더 많은 산업군에 도입될 가능성을 높이고 있습니다. 앞으로도 계속 LLM의 성능이 발전하면서 다양한 응용 분야에서 더욱 효율적이고 지능적인 솔루션을 제공하게 될 것입니다.
결론적으로, AI 서비스를 설계할 때는 빠르게 변화하는 LLM 환경에 유연하게 대응할 수 있는 아키텍처를 고려해야만 계속해서 더 저렴하고, 더 빠르고, 더 똑똑한 AI 서비스를 지속적으로 개발할 수 있을 것입니다. LLM의 발전 속도는 앞으로도 가속화될 것으로 예상되며, 이에 따라 AI 서비스의 가능성은 무한히 확장될 것입니다. 앞으로의 발전이 어떤 혁신을 가져올지 기대됩니다.
긴 글을 함께 해주셔서 감사합니다.
이미지 출처
- 그림 1) OpenAI
- 그림 2) Google
- 그림 3) The Batch
- 그림 4) artificialanalysis
- 그림 5) artificialanalysis
- 그림 6) cerebras inference
- 그림 7) dataiku
- 그림 8) x @maximelabonne
- 그림 9) x @kimmonismus
- 그림 10) magic.dev
- 그림 11) Apple
Written by Robin.hwang
Edited by June.6