Engineering
Kanana-2 개발기 (1): Pre-training에서의 의사결정들을 중심으로
lambda.xprime카카오
2026년 1월 15일
원문에서 보기 ↗안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 LLM 조직에서 Pre-training을 연구개발하는 Lambda입니다.
지난 12월 19일 카카오가 자체 개발한 차세대 언어모델 Kanana-2-30b-a3b를 오픈소스로 공개한 데에 이어, 한 달여 만에 성능과 활용성을 대폭 강화한 Kanana-2 모델 4종(Base, Mid-training, Instruct, Thinking)을 공개합니다.
Kanana-2는 성능은 높이면서 학습 및 운용 비용은 낮추기 위해, 기존 모델과 달리 ‘전문가 혼합(MoE, Mixture of Experts)’ 아키텍처를 채택 했습니다. 이를 통해 전체 파라미터 크기는 32B(320억 개)에 달하는 거대 모델의 지능을 보유하면서도, 실제 추론 단계에서는 3B(30억 개) 파라미터만 활성화하여 연산 효율을 극대화했습니다. MoE 학습에 필수적인 여러 커널들을 직접 개발해 적용함으로써 성능 손실 없이 학습 속도는 높이면서 메모리 사용량은 획기적으로 줄인 ‘고효율 저비용’ 모델을 완성했습니다.
이번 공개 모델을 통해 데이터와 방법론의 유효성을 검증한 저희는 이제 더 거대한 스케일의 Kanana-2-155b-a17b를 학습하고 있습니다. 대규모 MoE 아키텍처 학습은 연구와 엔지니어링, 양 측면에서 매우 까다로운 과제입니다.
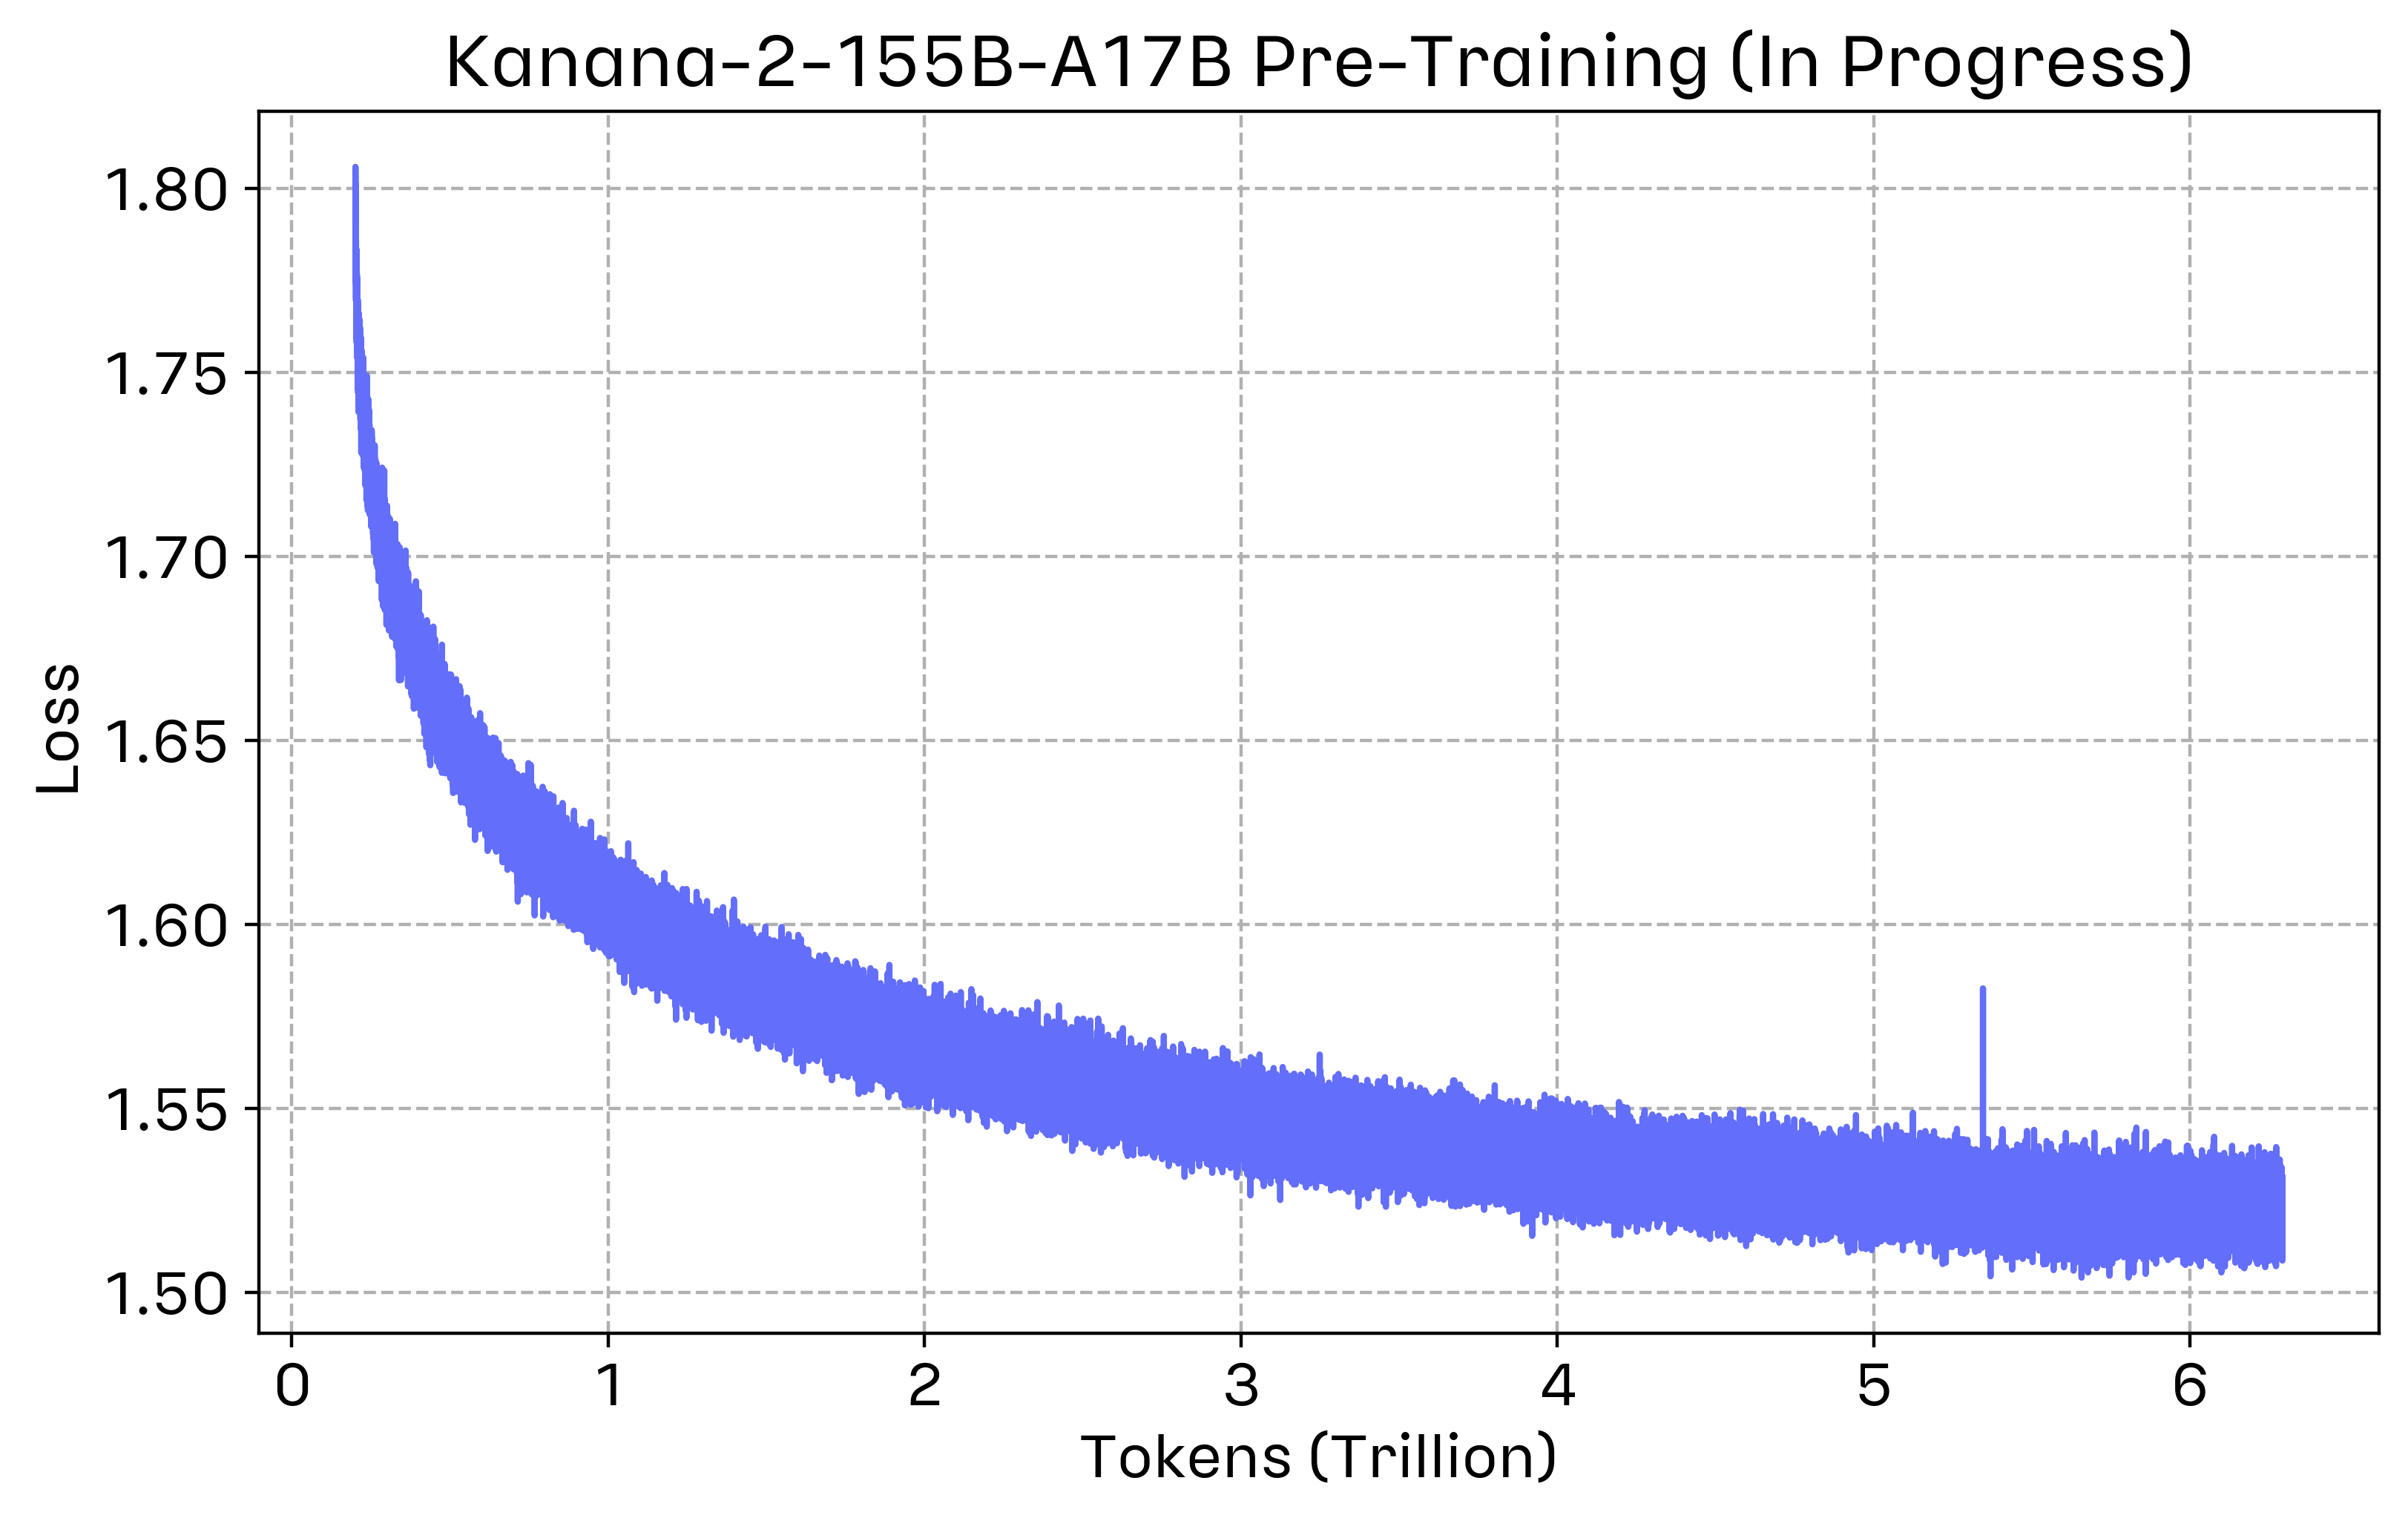
그림 1: Kanana-2-155b-a17b의 Pre-training Loss. 200B 이전의 Loss는 포함하지 않았고, Smoothing이나 Sub-sampling은 진행하지 않았습니다. Constant LR Phase임에도 불구하고 매우 안정적인 Loss Curve를 보임을 확인할 수 있습니다.
저희는 아키텍처와 데이터는 물론 FP8 training을 위한 Infrastructure Optimization, MuonClip, Hyperparameter Transfer 등의 기술 개발을 통해 Large-scale에서도 매우 효율적이면서 안정적인 훈련을 달성하였습니다. 그림 1에서 훈련 중인 155b 모델의 Loss Curve를 살펴보면 Constant LR(Learning Rate)을 사용하는 단계임에도 불구하고 Loss Spike 없이 매우 안정적인 수렴 추세를 보이고 있습니다. 또한, 현재 표 1과 같은 벤치마크 점수를 기록하며, 고품질의 다양한 데이터를 계속 투입하여 더 좋은 최종 모델을 만들 수 있도록 노력하고 있습니다.
이 두 가지 MoE 모델을 연이어 학습하는 과정은 저희 팀의 기술과 역량을 한 단계 도약시키는 계기가 되었습니다. 공개되는 모델과 결과물도 중요하지만, 이에 도달하는 동안 겪은 고민과 해결 과정을 공유하는 것 또한 가치있는 일이라고 생각합니다. 이번 글에서는 단순히 모델 공개 소식을 전하는 것을 넘어, 수천억 파라미터 규모의 Kanana-2-155b-a17b를 안정적으로 학습시키기 위해 고민하고 최적화해 온 핵심 기술 스택들에 대해 공유하고자 합니다.
| GLM-4.5-Air-Base | dots.llm1.base | Kanana-2- 155b-a17b-base | |
|---|---|---|---|
| Total Param | 106B | 142B | 155B |
| Active Param | 12B | 14B | 17B |
| Tokens | 23T | 11T | 8.9T (in progress) |
| MMLU 5-shot | 80.80 | 82.66 | 80.21 |
| MMLU-Pro 5-shot | 58.46 | 60.34 | 59.10 |
| BBH 3-shot | 82.51 | 82.35 | 83.77 |
| SimpleQA 5-shot | 29.84 | 31.39 | 30.70 |
| KMMLU 5-shot | 63.57 | 56.23 | 70.02 |
| KoSimpleQA 5-shot | 30.30 | 24.70 | 55.90 |
| MATH 4-shot | 48.20 | 56.34 | 59.82 |
| MBPP 3-shot | 71.03 | 69.19 | 67.28 |
표 1: Kanana-2-155b-a17b의 Pre-training 중간 평가. 8.9T 토큰의 훈련만으로 이미 경쟁력있는 성능을 보이고 있습니다. SimpleQA와 KoSimpleQA는 10지선다 객관식으로 변형하여 평가하였습니다.
A Controlled Testbed for Mid- and Post-Training
이번에 공개하는 Kanana-2-30b-a3b-base-2601 모델이 Mid-training 모델과 다른 점은 합성된 추론(Reasoning) 데이터를 활용하지 않았다는 것 입니다. 최근 강화학습에 기반한 Post-training의 발전과 함께, Mid-training 단계에서 이러한 합성 추론 데이터를 활용하는 것이 수학적/논리적 사고력에 큰 도움이 된다는 것이 잘 알려져 있습니다. 하지만 동시에 Reasoning Trace의 Distribution Mismatch 현상, Spurious Reward로도 모델 성능이 향상되는 현상 등 직관적으로는 설명되지 않는 흥미로운 현상들 또한 관찰되고 있습니다.
앞서 언급한 현상들, 더 좋은 Mid-와 Post-training, 그리고 둘 사이의 상호작용을 연구하기 위해서는 Olmo-3와 같이 잘 설계된 비교실험을 위한 깨끗한 Base 모델이 필요합니다. 하지만 현재 한국어 LLM 커뮤니티에는 이러한 실험을 진행할 만한 모델이 너무나 부족합니다. 오늘 공개하는 Kanana-2-30b-a3b-base-2601 모델이 더 흥미롭고 지속가능한 한국어 추론 연구에 활용되기를 바랍니다. Kanana-2-30b-a3b-base-2601 모델의 성능과 Mid-training 모델과의 비교는 표 2에 나타나 있으며, 이 글에서는 Base 모델 개발 과정의 주요 의사결정을 중심으로 소개하겠습니다.
| Qwen3-30B -A3B-Base | Kanana-2-30b-a3b -mid-2601 | Kanana-2-30b-a3b -base-2601 | |
|---|---|---|---|
| MMLU 5-shot | 81.14 | 75.44 | 74.83 |
| MMLU-Pro 5-shot | 61.83 | 56.14 | 52.61 |
| BBH 3-shot | 79.97 | 79.76 | 76.46 |
| SimpleQA 5-shot | 26.47 | 29.70 | 29.13 |
| KMMLU 5-shot | 62.25 | 62.15 | 61.98 |
| KoSimpleQA 5-shot | 26.33 | 49.70 | 49.40 |
| MATH 4-shot | 62.58 | 54.40 | 48.86 |
| MBPP 3-shot | 72.58 | 62.39 | 60.21 |
표 2: Kanana-2-30b-a3b의 Pre-training 평가 결과.
SimpleQA와 KoSimpleQA는 10지선다 객관식으로 변형하여 평가하였습니다.
Optimizer
최근 LLM 학습, 특히 Pre-training 단계에서 Muon(MomentUm Orthogonalized by Newton-Schulz) Optimizer가 큰 주목을 받고 있습니다. 처음에는 NanoGPT Speedrun을 위해 고안되었던 Muon이었지만, 최근 Moonlight, Kimi-K2 등에서 Large-scale Pre-training에서도 잘 작동할 수 있도록 하는 트릭들이 연구되었습니다. 덕분에 기존 사실상의 표준(De Facto Standard)으로 사용되던 AdamW를 제치고 Muon이 Kimi, GLM, Motif 등 여러 모델들의 훈련에 널리 사용되고 있습니다. 저희 Kanana-2 또한 Muon Optimizer로 훈련되었으며, 그 과정에서 얻은 노하우와 디테일한 실험 결과들을 공유드리고자 합니다.
기존에 널리 사용되던 AdamW는 Element-wise Optimizer입니다. 즉, Gradient를 사용해서 Parameter를 업데이트할 때, 다른 Parameter의 Gradient가 어떠한지에 대해서는 신경쓰지 않습니다. Muon은 이와 다르게, 2D Parameter와 그 Gradient가 주어졌을 때, Gradient를 Orthogonalize(직교화)하여 Parameter Update Matrix로 사용합니다. 실제 훈련에서 Gradient를 Orthogonalize하기 위해서는, SVD와 같은 방법론이 아니라 Newton-Schulz와 같이 GPU를 효율적으로 사용할 수 있는 Iterative Algorithm을 사용하게 됩니다. 저희는 기존 연구들에서 활용되었던 Newton-Schulz 대신, 더 정확한 Orthogonalization을 가능케 하는 Polar Express를 사용하였습니다. 한 가지 짚고 넘어갈 점으로, 작은 Scale의 실험에서는 Polar Express가 Newton-Schulz 대비 유의미한 이득을 보이지는 않았습니다. 다만, Polar Express의 추가적인 오버헤드가 크지 않고, Large-scale Training의 후반부로 갈수록 Weight Update의 Noise를 줄이는 것이 중요하다고 생각하여 Polar Express를 채택하였습니다. 이 외에도 LR Adjustment, Momentum Update의 구현 차이, RMSNorm(RMS Normalization)의 Parameterization 등 여러 디테일에 대해 탐색과 실험을 진행하였습니다. 결론적으로는 Polar Express를 제외하면 Moonlight와 대동소이한 구현을 Kanana-2 훈련에 사용하였으며, 해당 디테일들에 대한 논의는 오픈소스 커뮤니티에서 읽어보실 수 있습니다.
Muon에 더불어, Total 155B 수준의 Large-scale MoE Training을 위해 Kimi-K2에서 제안된 MuonClip을 사용하였습니다. MuonClip을 사용하기 위해서는 먼저 Attention 내부에서 계산되는 Max Logit 값을 얻어내야 했습니다. 빠른 훈련을 위해 사용하는 Flash Attention의 경우 이 값을 On-chip에만 저장하므로, 기존에 사용하던 Kernel을 수정하여 Max Logit 값을 동시에 반환하도록 하는 과정이 필요했습니다. 이를 통해 얻어진 Attention의 Max Logit 값들은 MuonClip에 사용될 뿐만 아니라, 로깅을 통해 훈련이 안정적으로 진행되고 있는지 판단하는 근거 중 하나로도 유용하게 활용되었습니다.
이렇게 구축된 MuonClip이 잘 작동하는지 확인하기 위해, 작은 Scale에서의 Ablation 실험을 진행하였습니다. 실험 설계에 있어서의 문제 중 하나는, Logit Explosion을 관찰하려면 충분히 큰 스케일의 모델을 훈련해야 한다는 것이었습니다. 예를 들어, Kimi-K2의 경우 Logit Explosion을 관찰하기 위해 Total 53B-active 9B 모델을 훈련하였는데, 이는 충분한 토큰수의 비교실험을 진행하기에는 너무 컸습니다. 때문에 저희는 기존 연구를 참고하여, Model을 작게 유지하는 대신 LR을 조절하여 MuonClip이 실제로 Training Stability에 도움이 되는지 확인하는 실험을 진행했습니다. 작은 자원으로 Large-scale에서 발생할 수 있는 문제들을 Stress Test하고 싶다면, 이러한 접근방법이 도움이 될 것입니다.
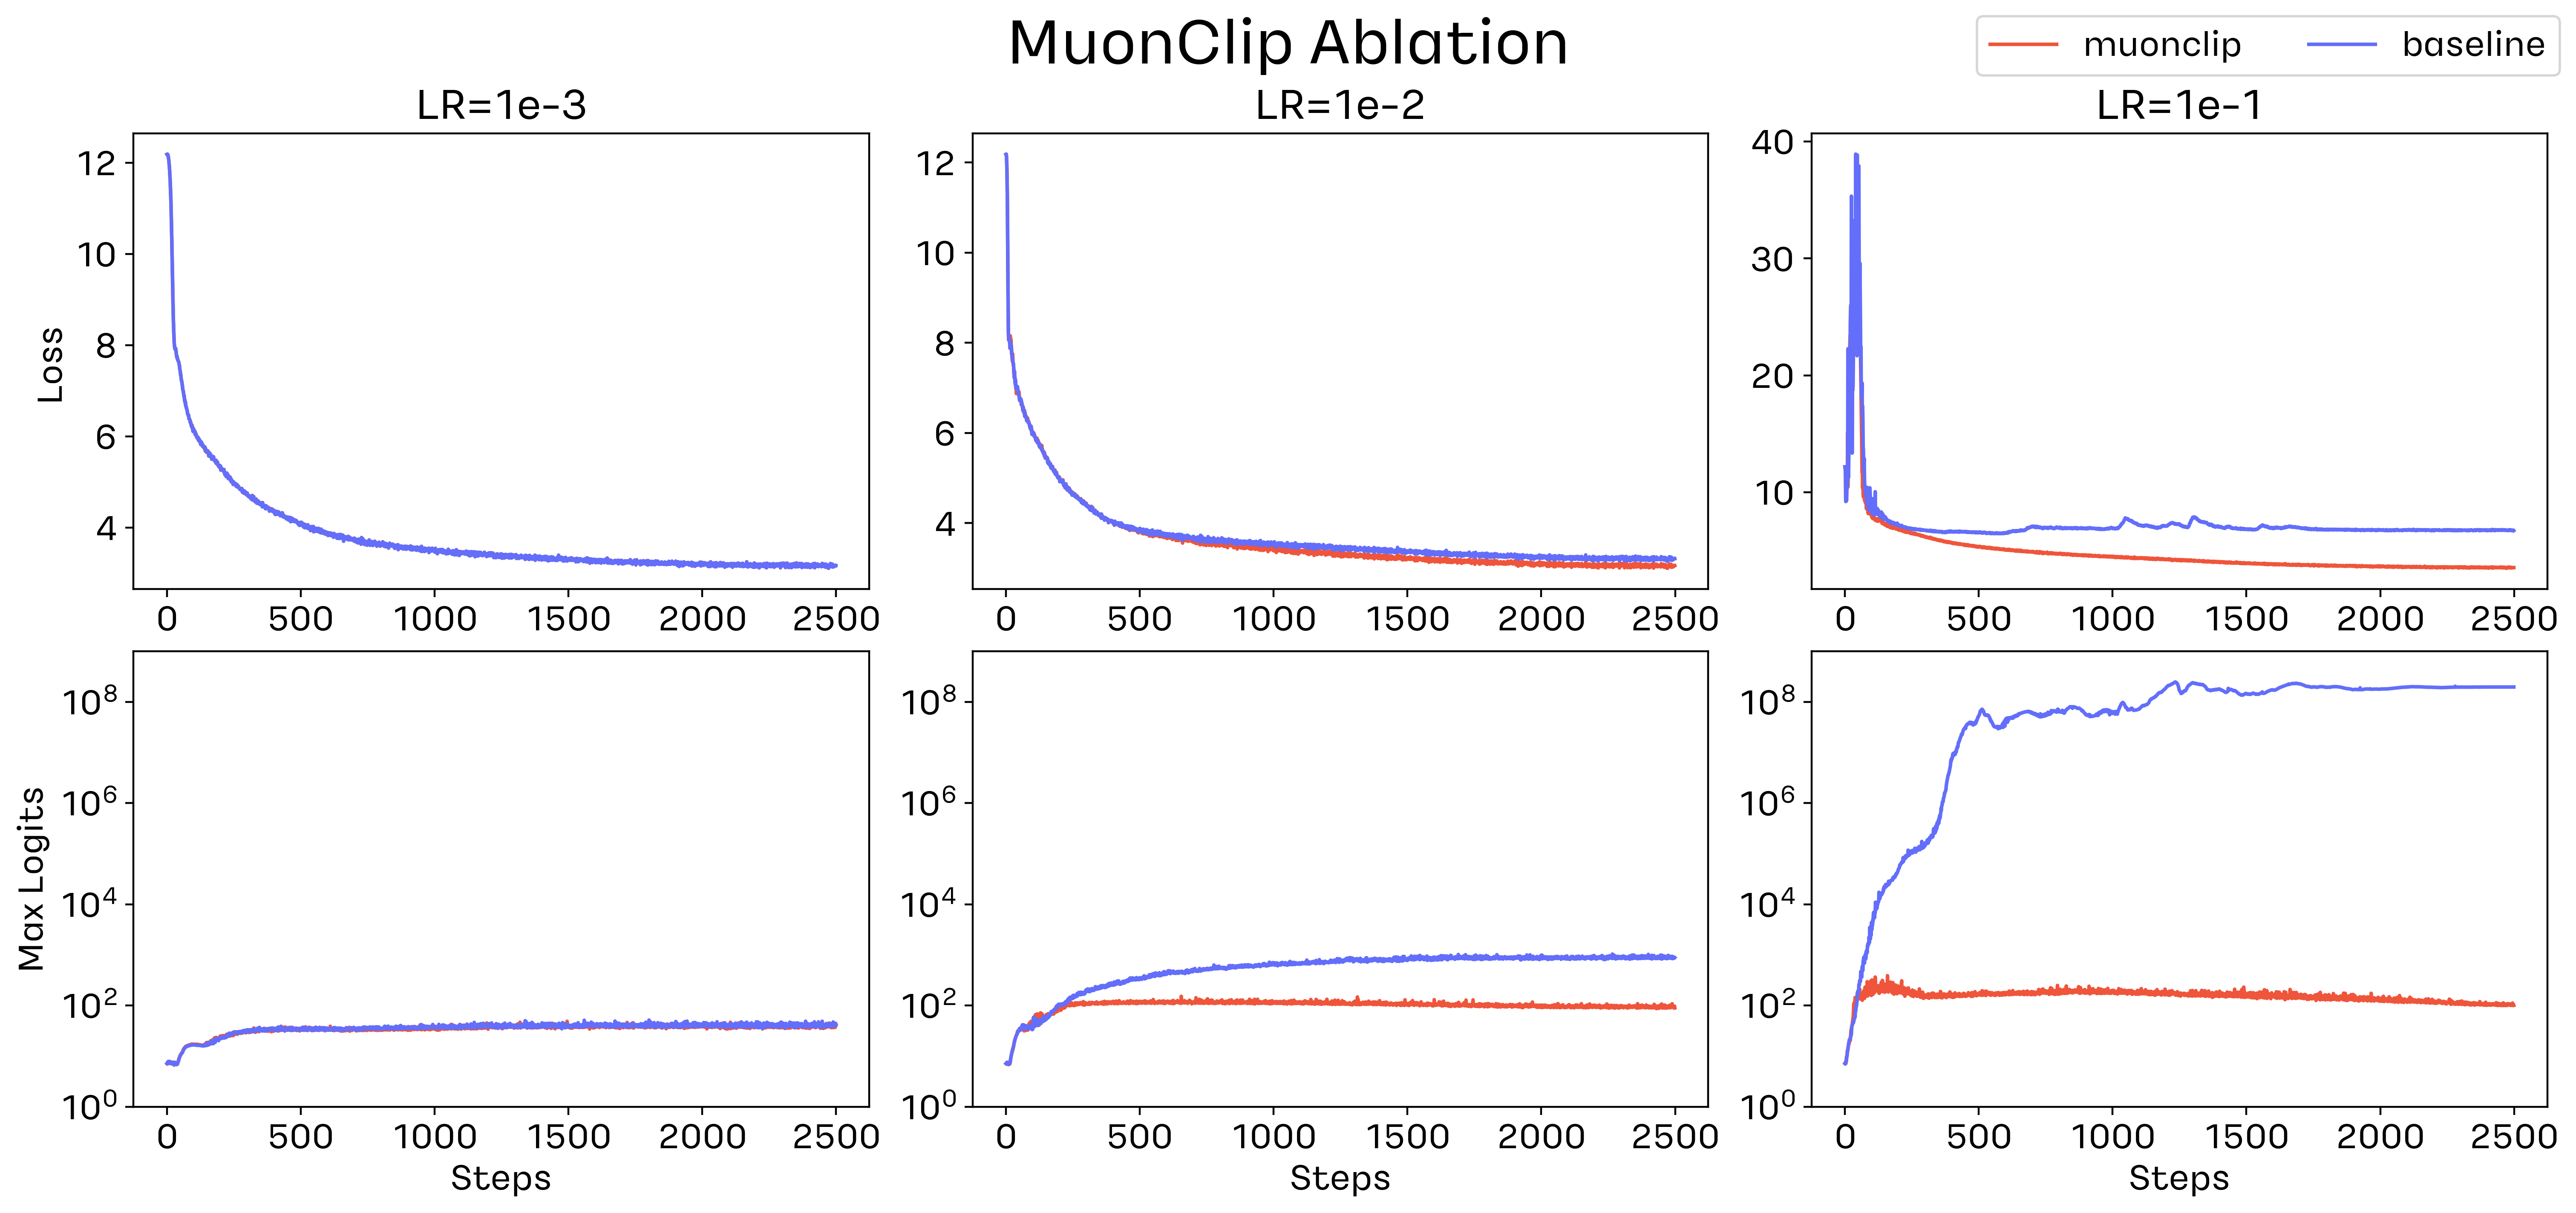
그림 2: Muon과 MuonClip의 LR별 비교 실험. 설령 훈련이 발산하지 않더라도, 높은 Attention Logit 값이 훈련에 부정적 영향을 끼칠 수 있음을 보여주며, MuonClip이 해당 문제를 잘 해결해주는 것을 확인할 수 있습니다.
실험 결과는 그림 2에 나타나 있습니다. 가장 왼쪽의 충분히 작은 LR을 사용하는 훈련의 경우 Muon과 MuonClip이 동일한 Loss Curve를 가짐을 확인하였습니다. 이는 Clipping이 일어나지 않는 상황에서는 Muon과 MuonClip이 동일하게 작동함을 확인하는 일종의 Sanity Check에 해당합니다. 가장 오른쪽의 매우 큰 LR을 사용하는 실험은 MuonClip의 효과를 잘 보여줍니다. Clipping이 없으면 Attention Logit이 발산함과 동시에 훈련이 올바르게 수렴하지 않는 반면, MuonClip에서 두 지표가 모두 정상적인 범위 내에서 유지됨을 확인할 수 있었습니다. 가장 흥미로운 실험은 가운데 실험입니다. 먼저 Attention Logit을 살펴보면 Muon Baseline에서 Attention Logit은 100을 넘는 상태에서 유지되고, MuonClip은 100 이하의 값으로 잘 Clipping되는 것을 확인할 수 있습니다. Loss를 살펴보면 LR=1e-1의 사례처럼 Loss가 발산하지는 않으나, 여전히 Muon과 MuonClip 사이에 유의미한 차이가 존재함을 확인할 수 있습니다. 이를 뒤집어 말하면, 훈련이 발산하지 않더라도 여전히 높은 Attention Logit 값이 훈련에 부정적인 영향을 끼치고 있을 수 있다는 것입니다. 이러한 상황을 방지하기 위해 Large-scale Training에서는 Attention Logit을 반드시 관찰할 것을 추천합니다.
2-Step Hyperparameter Transfer
모델의 최적화 과정에서 Learning Rate (LR), Batch Size와 같은 Hyperparameter (HP)는 최적의 성능을 달성하기 위해 매우 중요한 변수 중 하나입니다. 하지만 수천 억 파라미터 규모의 모델을 훈련할 때는 전통적인 HP Sweeping을 사용할 수 없게 됩니다. 하나의 모델을 훈련하는 것조차 엄청난 자원을 필요로 하기 때문에, 여러 개의 155B 모델을 훈련하여 최적의 HP를 찾는다는 것은 현실적으로 불가능한 일이기 때문입니다. 때문에 이러한 문제를 해결하기 위해 최근 많이 연구되는 것이 HP Transfer, 혹은 HP Scaling Law입니다. 이는 작은 Proxy Scale에서 적은 비용으로 최적의 HP (혹은 Hyperparameter Scaling Law)를 찾고, 이 값을 수학적으로 외삽하여 Target Scale에서의 HP를 얻어내는 방법입니다. 이 때, 두 가지 축의 Scaling을 감안해야 합니다. 모델 크기 M의 Scaling과 데이터의 양 D의 Scaling이 바로 그것입니다.
최근의 오픈소스 모델들에서 가장 많이 활용되는 접근방법 중 하나는 Optimal HP를 M과 D 모두의 함수로 추정하는 Joint Scaling Law입니다. 하지만 저희는 다음과 같은 여러 가지 이유로 Joint Scaling Law를 선택하지 않았습니다. 첫째로, Proxy Scale에서도 M과 D 2개의 축으로 이루어진 Grid에 대해 Optimal HP를 탐색해야 하기 때문에 탐색 비용이 많이 듭니다. 둘째로, M의 Scaling에 대해서는 Maximal Update Parametrization (MuP)라는 좋은 대안이 있었습니다. 현상론적 법칙인 Scaling Law에 비하여, 조금 더 이론적으로 탄탄한 대안을 고려하는 것이 안전한 방향이라고 판단하였습니다. MuP를 활용하면서도 효율적인 Proxy Scale Search를 달성하기 위해 2-step HP Transfer를 고안하여 활용하였습니다. 구체적으로 설명하면, 일단 Proxy Scale에서 HP의 Scaling Law를 탐색하되, M은 고려하지 않고 D 축으로의 Scaling만 고려합니다. D 축으로의 Transfer를 통해 Target D, Proxy M Scale에서의 Optimal LR을 결정합니다. 이를 기반으로 MuP를 통해 최종적으로 Target D, Target M Scale에서의 Optimal LR을 결정할 수 있습니다. (그림 3 참조)
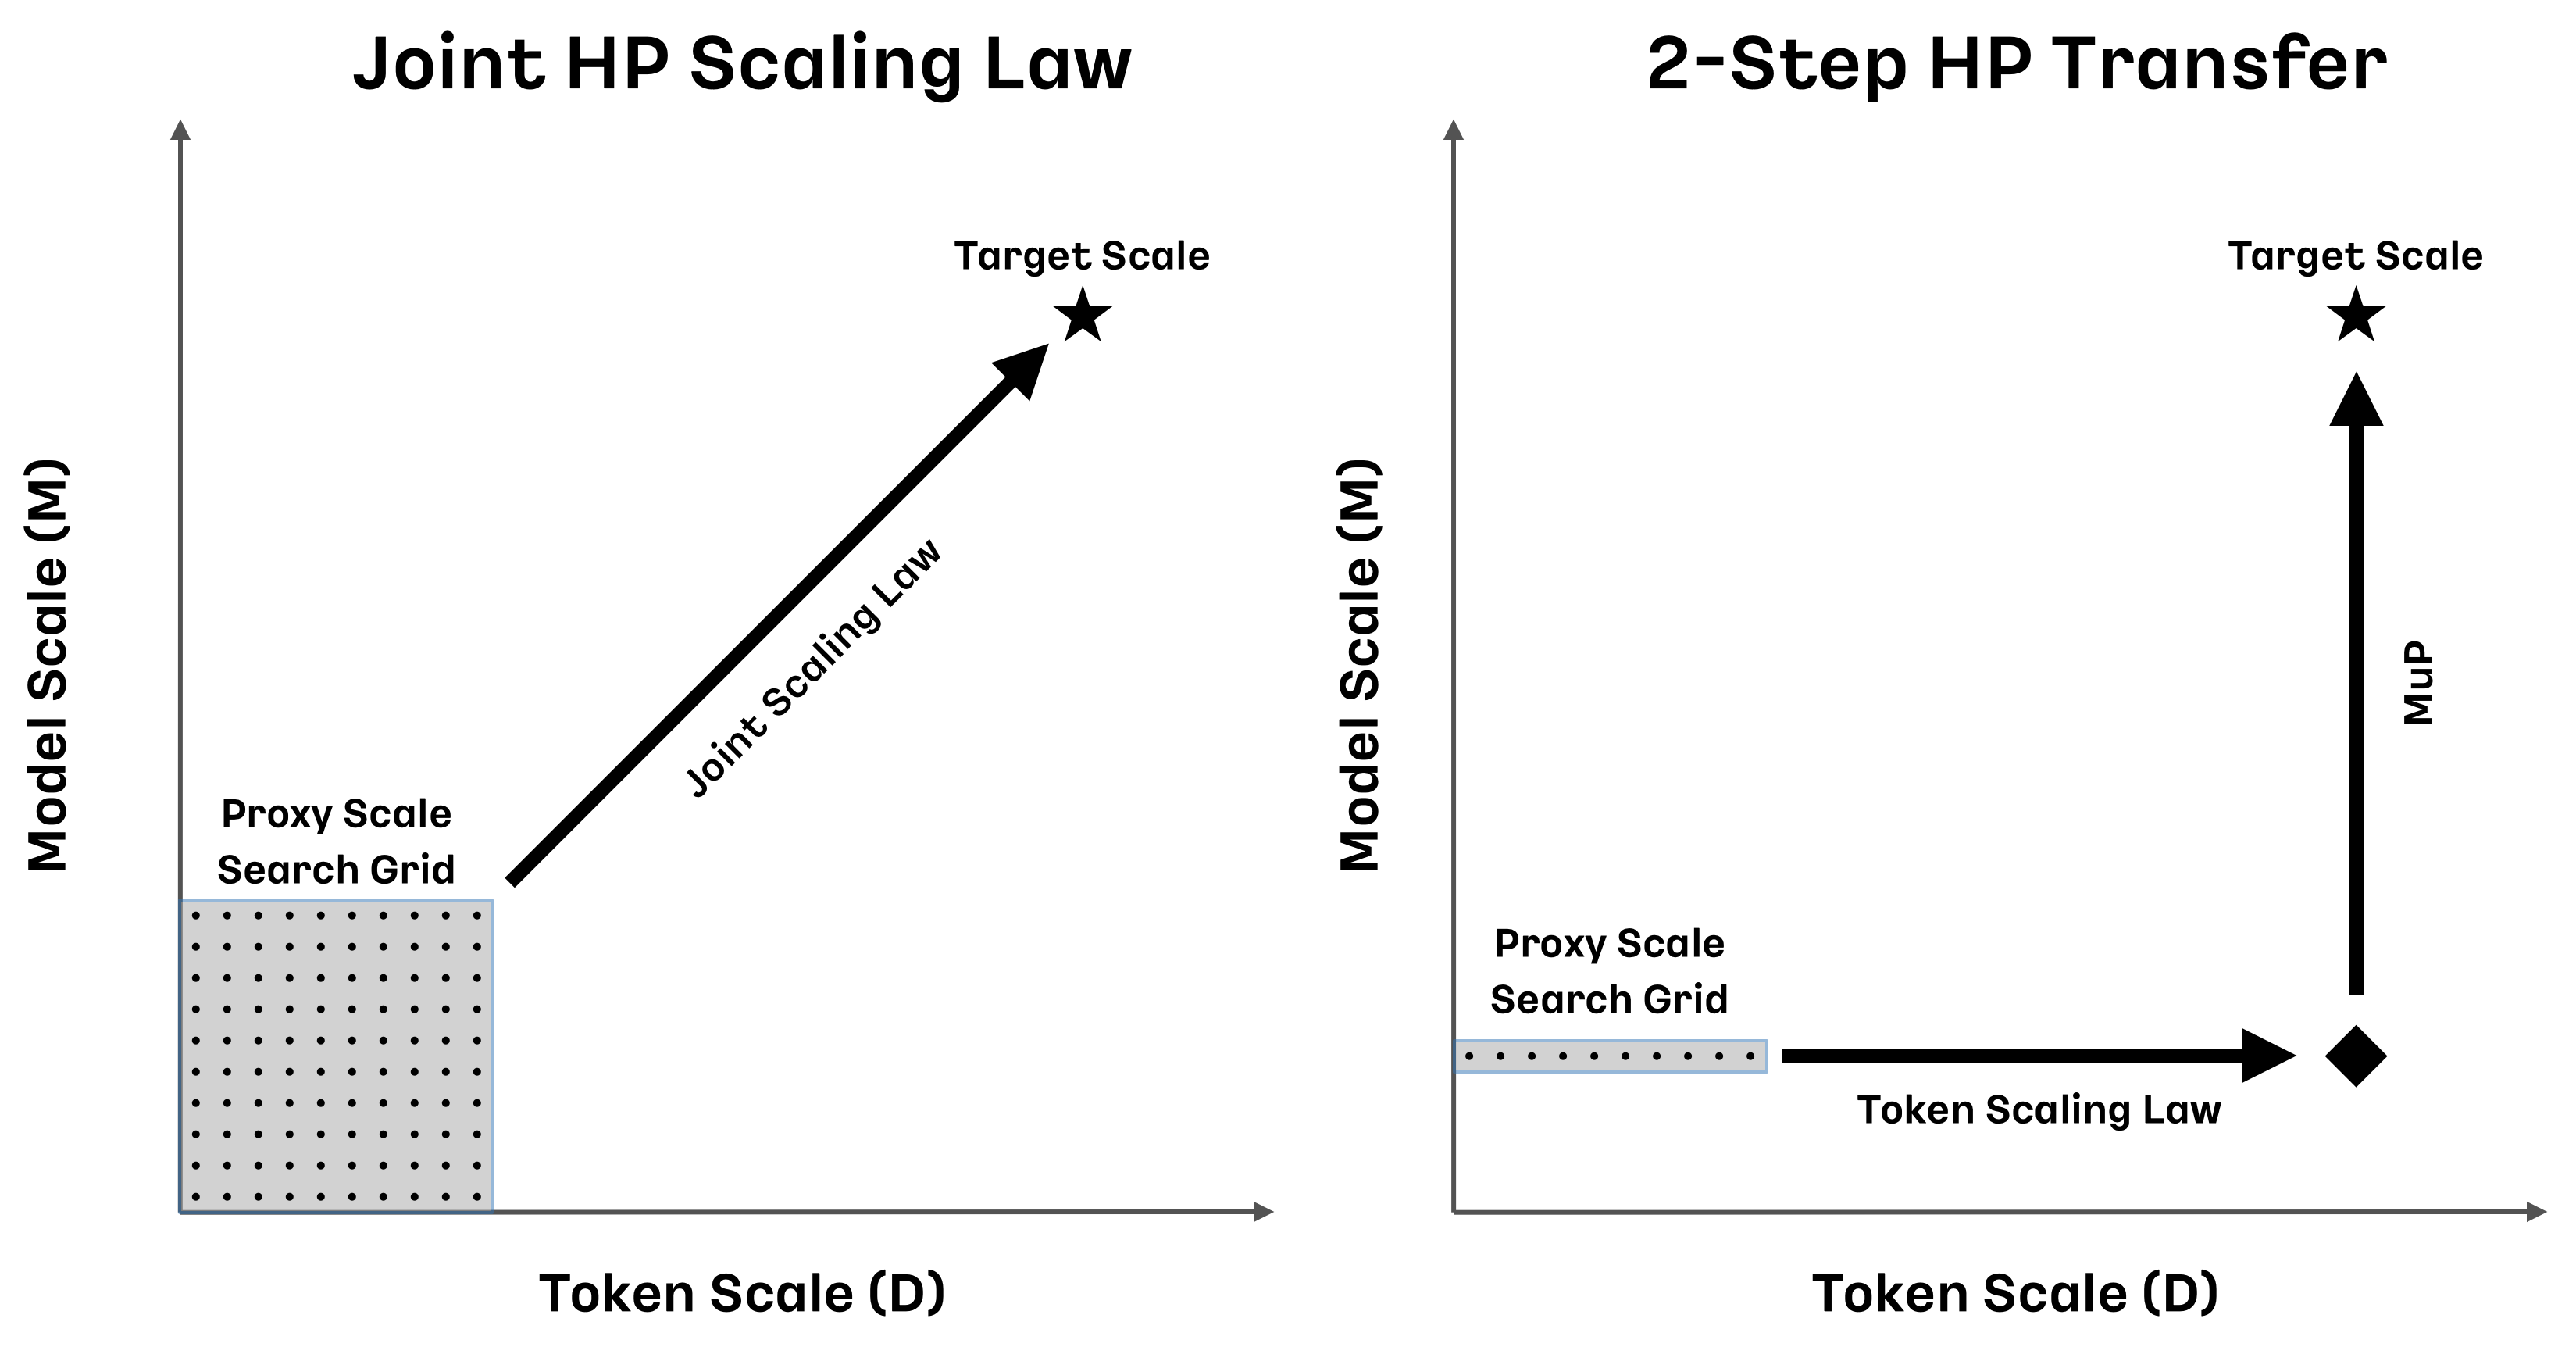
그림 3: Hyperparameter (HP) Transfer를 위한 두 가지 방법론 비교. 모델과 데이터에 대해 동시에 Transfer하는 Joint Scaling Law 대신, 데이터에 대해서는 Scaling Law를, 모델에 대해서는 MuP를 활용하는 2-step HP Transfer를 채택했습니다.
Kanana의 HP Transfer가 또 다른 점 중 하나는, Batch Size에 대한 Transfer는 고려하지 않았다는 것입니다. Batch Size가 M과 D에 대해 어떻게 Scaling되는가에 대한 연구들을 감안했을 때, 통일된 결론을 내리기 어려웠습니다. 예를 들어, DeepSeek과 Ling은 Batch Size가 Training Compute의 Scaling Law를 따른다고 분석한 반면, StepFun은 M에 독립적인, D의 Scaling Law를 따른다고 분석하였습니다. Critical Batch Size의 측면에서 보아도, D만의 Scaling Law를 따른다고 분석하는 연구와 Training Loss에 의해 결정된다고 가정하는 연구가 혼재하는 상황이었습니다. Batch Size는 모델링 관점에서뿐 아니라 훈련의 Throughput을 결정하는 데에도 중요한 요소이고, Throughput 최적화를 위해 훈련 중간중간에 변경되는 일 또한 잦다는 점까지 고려하면 문제는 더 복잡해집니다. 이런 이유들로 인해 Batch Size의 Reliable한 Transfer 방법론을 결정하는 것은 어렵다고 판단하고, HP Transfer를 LR Transfer 문제로 간소화하였습니다.
먼저 LR의 Model Scaling에 대해서는 MuP를 주로 참고하였습니다. 연구를 진행하던 당시 기준으로, 저희는 Muon과 MoE를 사용하기로 결정하였으나 대부분의 연구들이 Dense Model과 AdamW를 기준으로 진행되었다는 한계가 있었습니다. MoE + Muon 상황에서도 MuP가 잘 작동하는지가 명확하지 않은 상황이었기 때문에 해당 부분에 대한 검증을 진행했습니다. 특히, 155B를 넘어서는 스케일링까지 고려하기 위해 Expert 부분에 대해서는 Dimension 대신 Expert의 개수 (즉 Sparsity)를 Scaling하였습니다. 구현 측면에서는, 추론이나 배포 시에 간편하도록 하기 위해 Output Multiplier나 Attention Scaling 등은 고려하지 않고 가장 간단한 LR의 Scaling만을 적용하였습니다. 그 결과, MoE와 Muon에 대해서도 MuP가 잘 작동함을 확인하고 해당 방법론을 Kanana-2-155b-a17b의 훈련에 적용하였습니다.
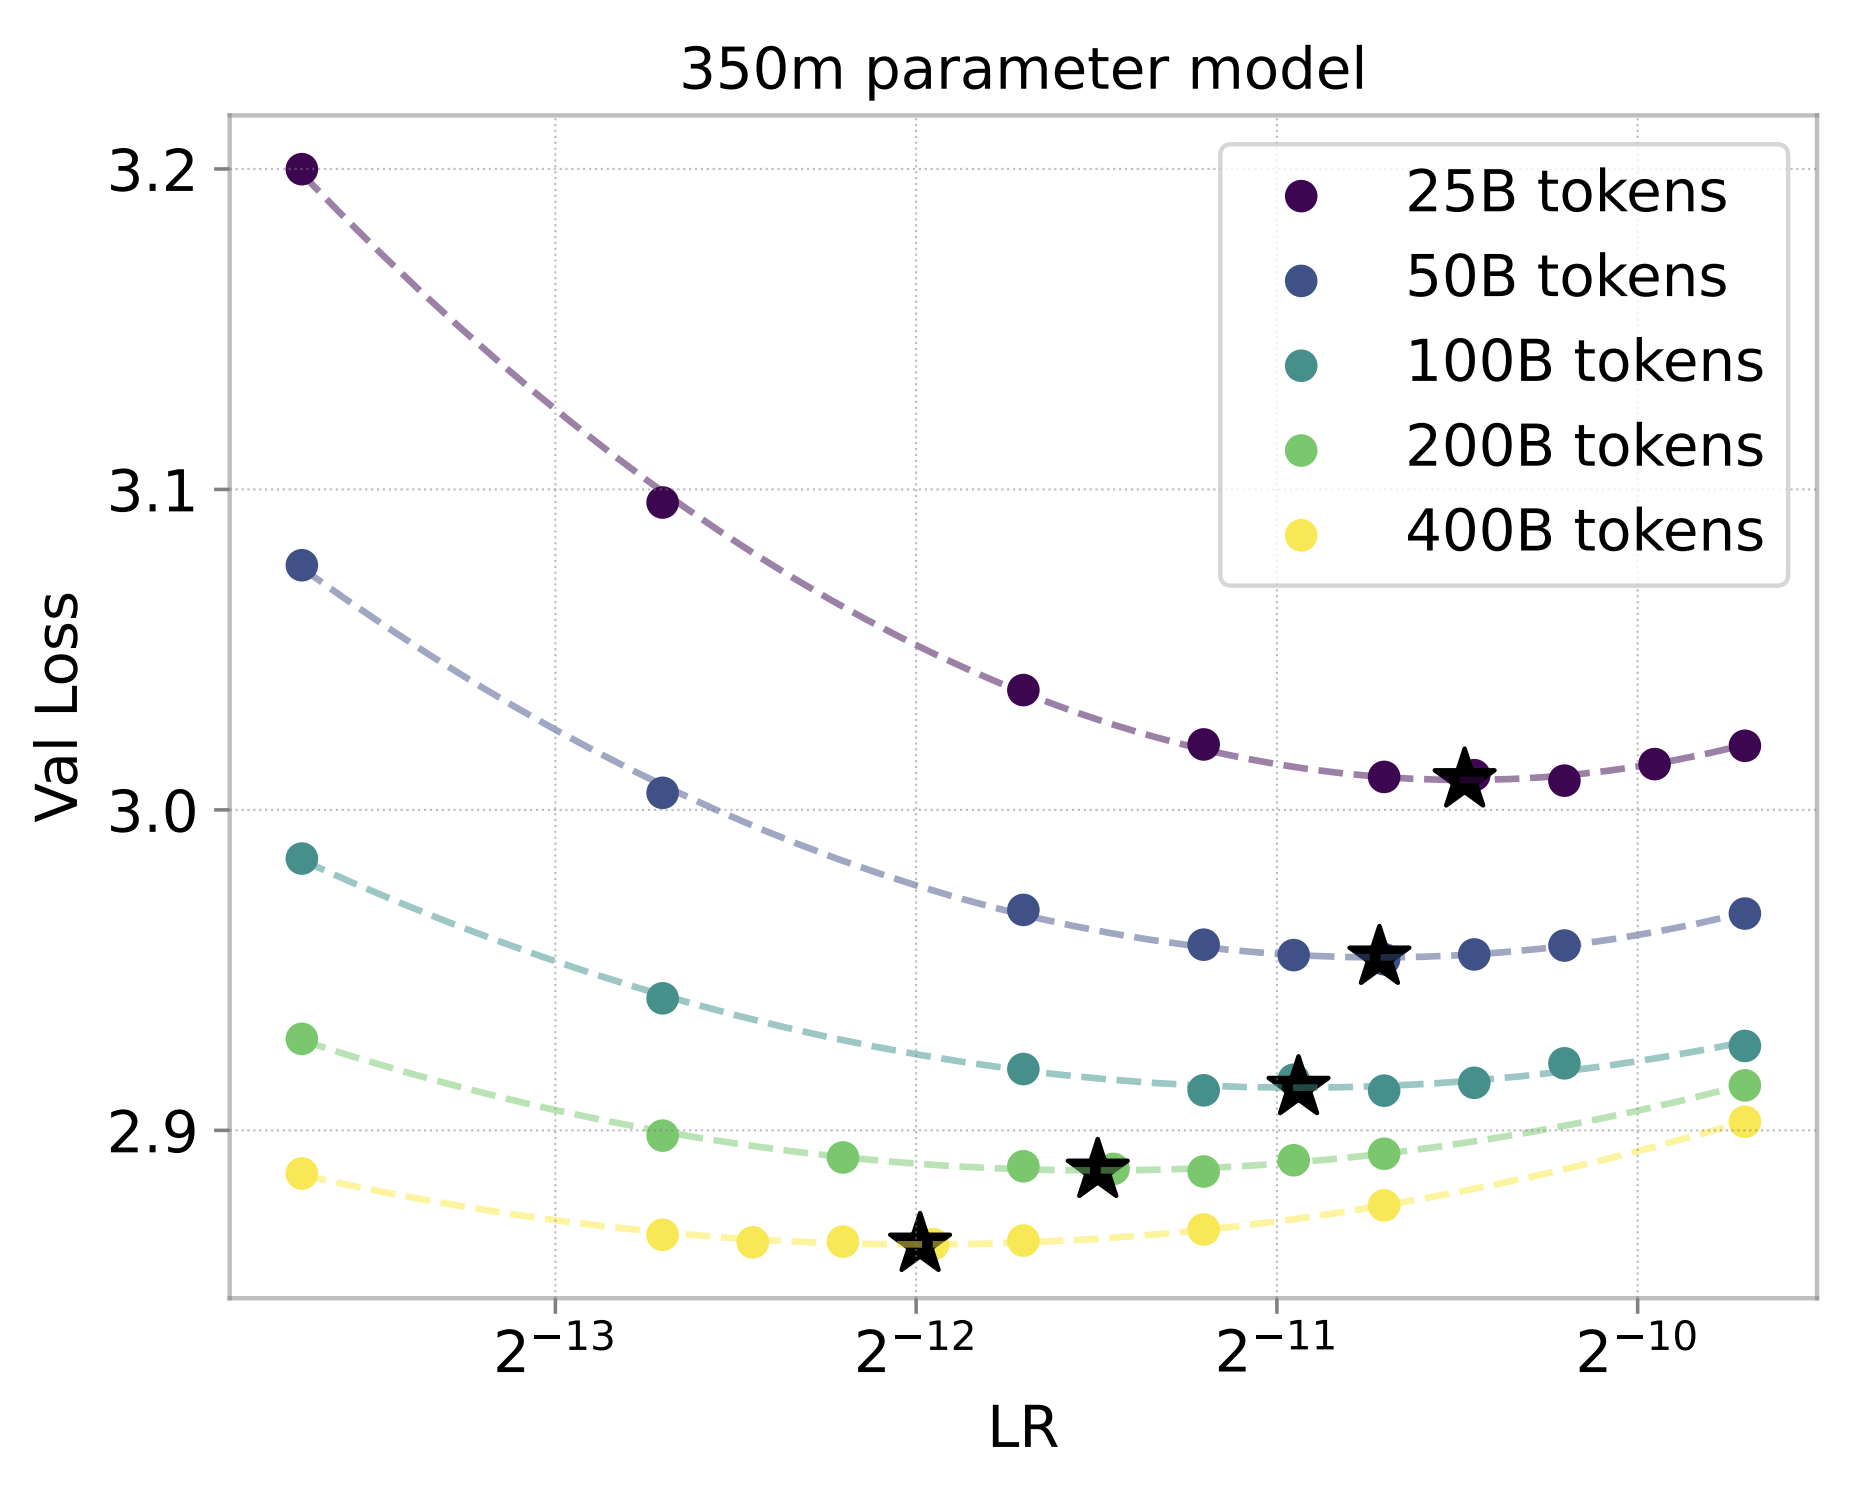
그림 4: Bjorck, Johan, et al. "Scaling optimal LR across token horizons." arXiv preprint arXiv:2409.19913 (2024).
LR의 Token Scaling에 대해서는 “Scaling Optimal LR Across Token Horizons” 연구를 주로 참조하였습니다. 연구에 따르면 그림 4와 같이, D가 증가할수록 Optimal LR은 감소하게 되고 이러한 Optimal LR의 변화를 Token Scale D에 대한 Scaling Law로 분석할 수 있게 됩니다. D를 제외한 다른 변수를 제거하기 위해 Batch Size Schedule, Weight Decay 등은 Kanana-2-155b-a17b와 동일한 값으로 두고 Optimal LR Search를 진행하였습니다. 한 가지 특기할 만한 점으로, 위 논문에서는 Proxy Scale에서의 탐색 시에 각 Token Budget별로 LR Decay를 진행하였으나, 탐색을 더욱 효율화하기 위해 LR Decay 대신 Constant LR을 유지한 채로 Exponential Moving Everage를 활용하였습니다. 이 덕분에 LR별 하나의 모델을 훈련하는 것만으로 여러 Token Budget에서의 Optimal LR 값을 효율적으로 얻을 수 있었습니다.
Infrastructure Optimization
Multi-node GPU Cluster에서 큰 모델을 훈련하는 것은 쉬운 일이 아닙니다. 하지만 그보다 더 어려운 것은, 단순한 훈련을 넘어서서 주어진 자원 하에서 빠르고 저렴한 비용으로 훈련할 수 있도록 최적화하는 것입니다. 동시에 향후 더 큰 모델까지 훈련할 수 있도록 Scalable한 구조를 만든다면 금상첨화입니다. 저희는 이러한 관점에서 인프라 최적화에도 큰 노력을 쏟았습니다. 이 글에서는 그 중에서도 크게 두 가지, FP8 Training과 System-level Optimization에 대해 간단히 설명드리고자 합니다.
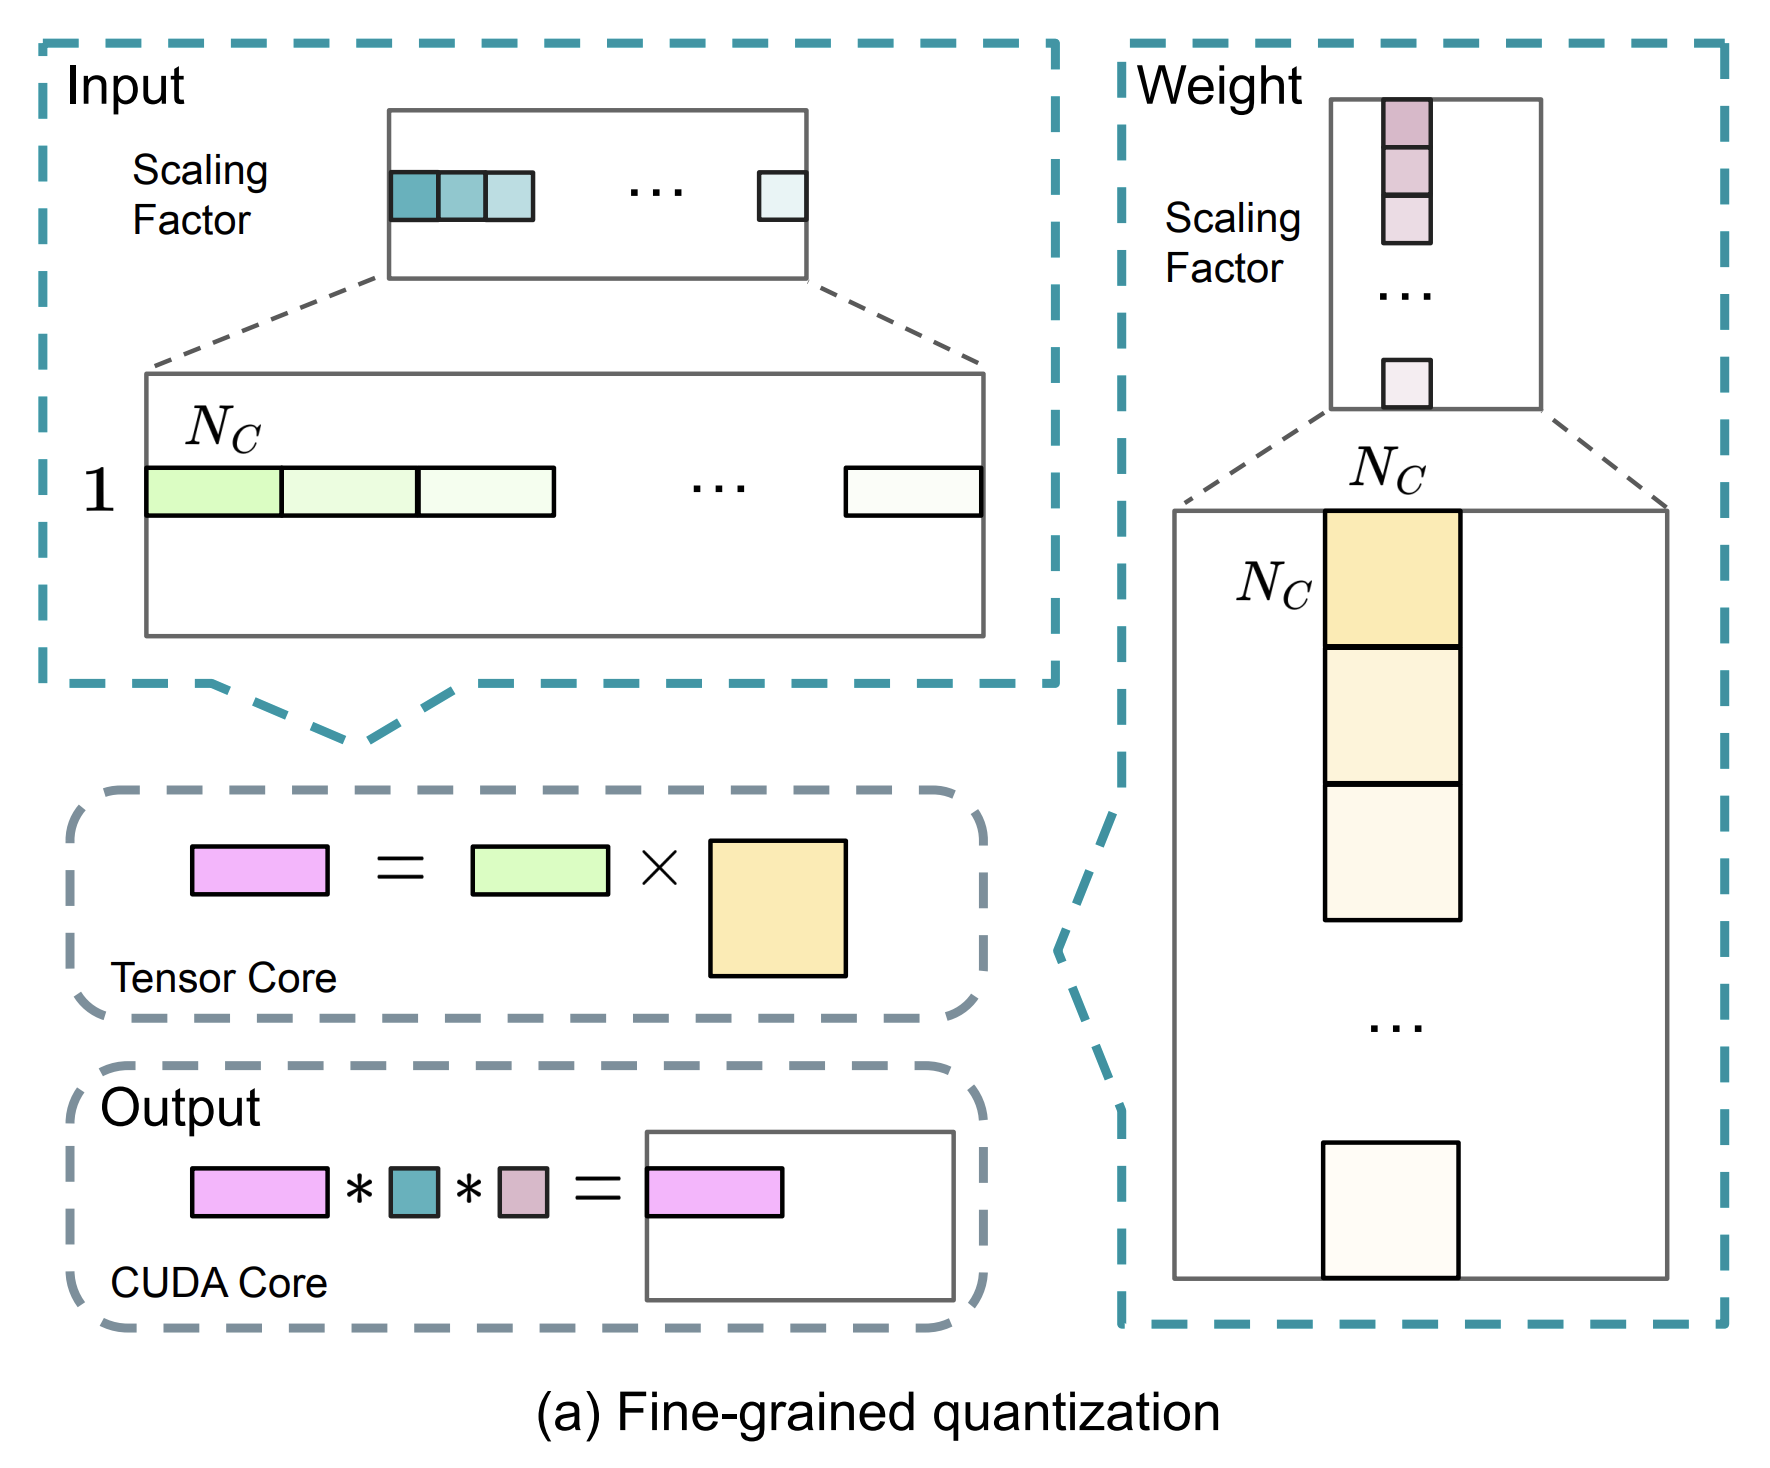
그림 5: Liu, Aixin, et al. "Deepseek-v3 technical report." arXiv preprint arXiv:2412.19437 (2024).
Hopper GPU에서 도입된 FP8 Tensor Core를 활용한 훈련은 그 연산속도와 메모리 측면에서의 이점 덕분에 이미 널리 사용되는 테크닉입니다. 다만, 자세한 디테일을 들여다보면 다양한 변형들이 존재합니다. 특히 Quantization Granularity를 살펴보면, Tensor 전체가 하나의 Quantization Scaling Factor를 공유하는 Per-tensor Scaling이나 Row/Column별로 Scaling Factor를 공유하는 Per-token/Per-channel Scaling 등이 존재합니다. 저희는 FP8 Training의 효율성을 가져가면서도, Quantization으로 인한 성능 감소를 최소화하기 위해 DeepSeek V3에서 제안된 Fine-grained Scaling을 채택하였습니다. 그림 5와 같이, Fine-grained Quantization의 경우 Input Activation은 1x128 Tile, Weight는 128x128 Block, 단위로 양자화를 진행하게 됩니다.
DeepSeek의 Fine-grained Quantization을 사용하기로 결정하였지만, 더 정교한 Quantization을 선택한 만큼 잘 작동하는 FP8 Training Framework를 구축하는 일은 쉽지 않은 일이었습니다. 그 어려움을 이해하기 위해서는 FP8 Training에 필요한 커널들이 무엇인지 이해해야 합니다. 언뜻 행렬 연산을 위한 GEMM (General Matrix to Matrix Multiplication) 커널이 있으면 충분하다고 생각하기 쉽지만, 실제 훈련 Framework에 통합하기 위해서는 효율적인 Quantization 커널이 필요합니다. Fine-grained Quantization에서는 Forward 연산에 사용했던 행렬들을 Backward에 그대로 사용할 수 없기 때문에 추가적인 Weight Transposition 커널 또한 필요해지게 됩니다. DeepSeek은 여기에 더해서 Activation에 대해서도 Backward 시에 Dequantization-Transposition-Requantization 커널을 사용했다고 언급하고 있지만, 그 대신 Kanana-2에서는 Backward에 필요한 Quantization을 Forward 시에 미리 계산하는 식으로 구현했습니다. 또한 Grouped GEMM을 위해 Input Activation들을 Expert별로 재배열해주는 Permutation(순열) 커널, 그리고 이러한 재배열 시에 Expert별 토큰의 개수가 128의 배수가 되도록 하는 Alignment (Padding) 연산이 필요합니다. 이러한 여러 커널들을 Non-GEMM 커널로 통칭하도록 하겠습니다.
Kanana-2 훈련을 위해 준비하던 당시에는 Fine-grained FP8 Training에 최적화된 구현체들이 거의 없었고 DeepSeek이 공개한 DeepGEMM와 NVIDIA의 TransformerEngine의 선택지 정도가 있었습니다. DeepGEMM의 경우 GEMM의 성능이 좋고 DeepSeek이 직접 공개한 커널이니만큼 신뢰할 수도 있었지만, 훈련에 필요한 Non-GEMM 커널들이 구현되어있지 않았습니다. 때문에 TransformerEngine 구현체를 우선적으로 고려하였는데, BF16 Baseline 대비 기대하는 만큼의 성능 향상이 없었습니다. 원인을 분석해본 결과, Non-GEMM의 효율성이 매우 낮아 연산량 대비 너무나 많은 시간을 필요로 했습니다. 이러한 분석 결과를 바탕으로 Non-GEMM 커널들의 구현 필요성을 확인하게 되었고, 방향을 바꾸어 TransformerEngine 구현체를 활용하는 대신 GEMM과 Non-GEMM 커널들을 모듈화된 방식으로 조합하고, 필요한 경우 커널을 구현하여 사용하는 것으로 결정하였습니다.
먼저 일반적인 GEMM 커널의 경우, DeepGEMM이 TransformerEngine 대비 더 나은 성능을 보였기 때문에 DeepGEMM을 사용하였습니다. MoE 훈련에는 일반적인 GEMM에 더해서 효율적인 Grouped GEMM 커널 사용이 필수적이기 때문에 이에 대한 성능 평가도 진행하였는데, 실험 당시 기준으로 Forward와 Input Gradient는 DeepGEMM이, Weight Gradient는 TransformerEngine이 더 좋은 성능을 보였습니다. 이러한 결과가 나오는 이유는 앞서 설명했듯이 겉보기에는 단순히 행렬 연산으로 보이는 Forward, Input Gradient, Weight Gradient 연산 각각이 실제로는 다른 커널을 필요로 하기 때문입니다. 이 때문에 저희는 최대한의 효율성을 위해 MoE의 Forward/Input Gradient에는 DeepGEMM을, Weight Gradient에는 TransformerEngine을 사용하여 훈련 코드베이스에 통합하였습니다.
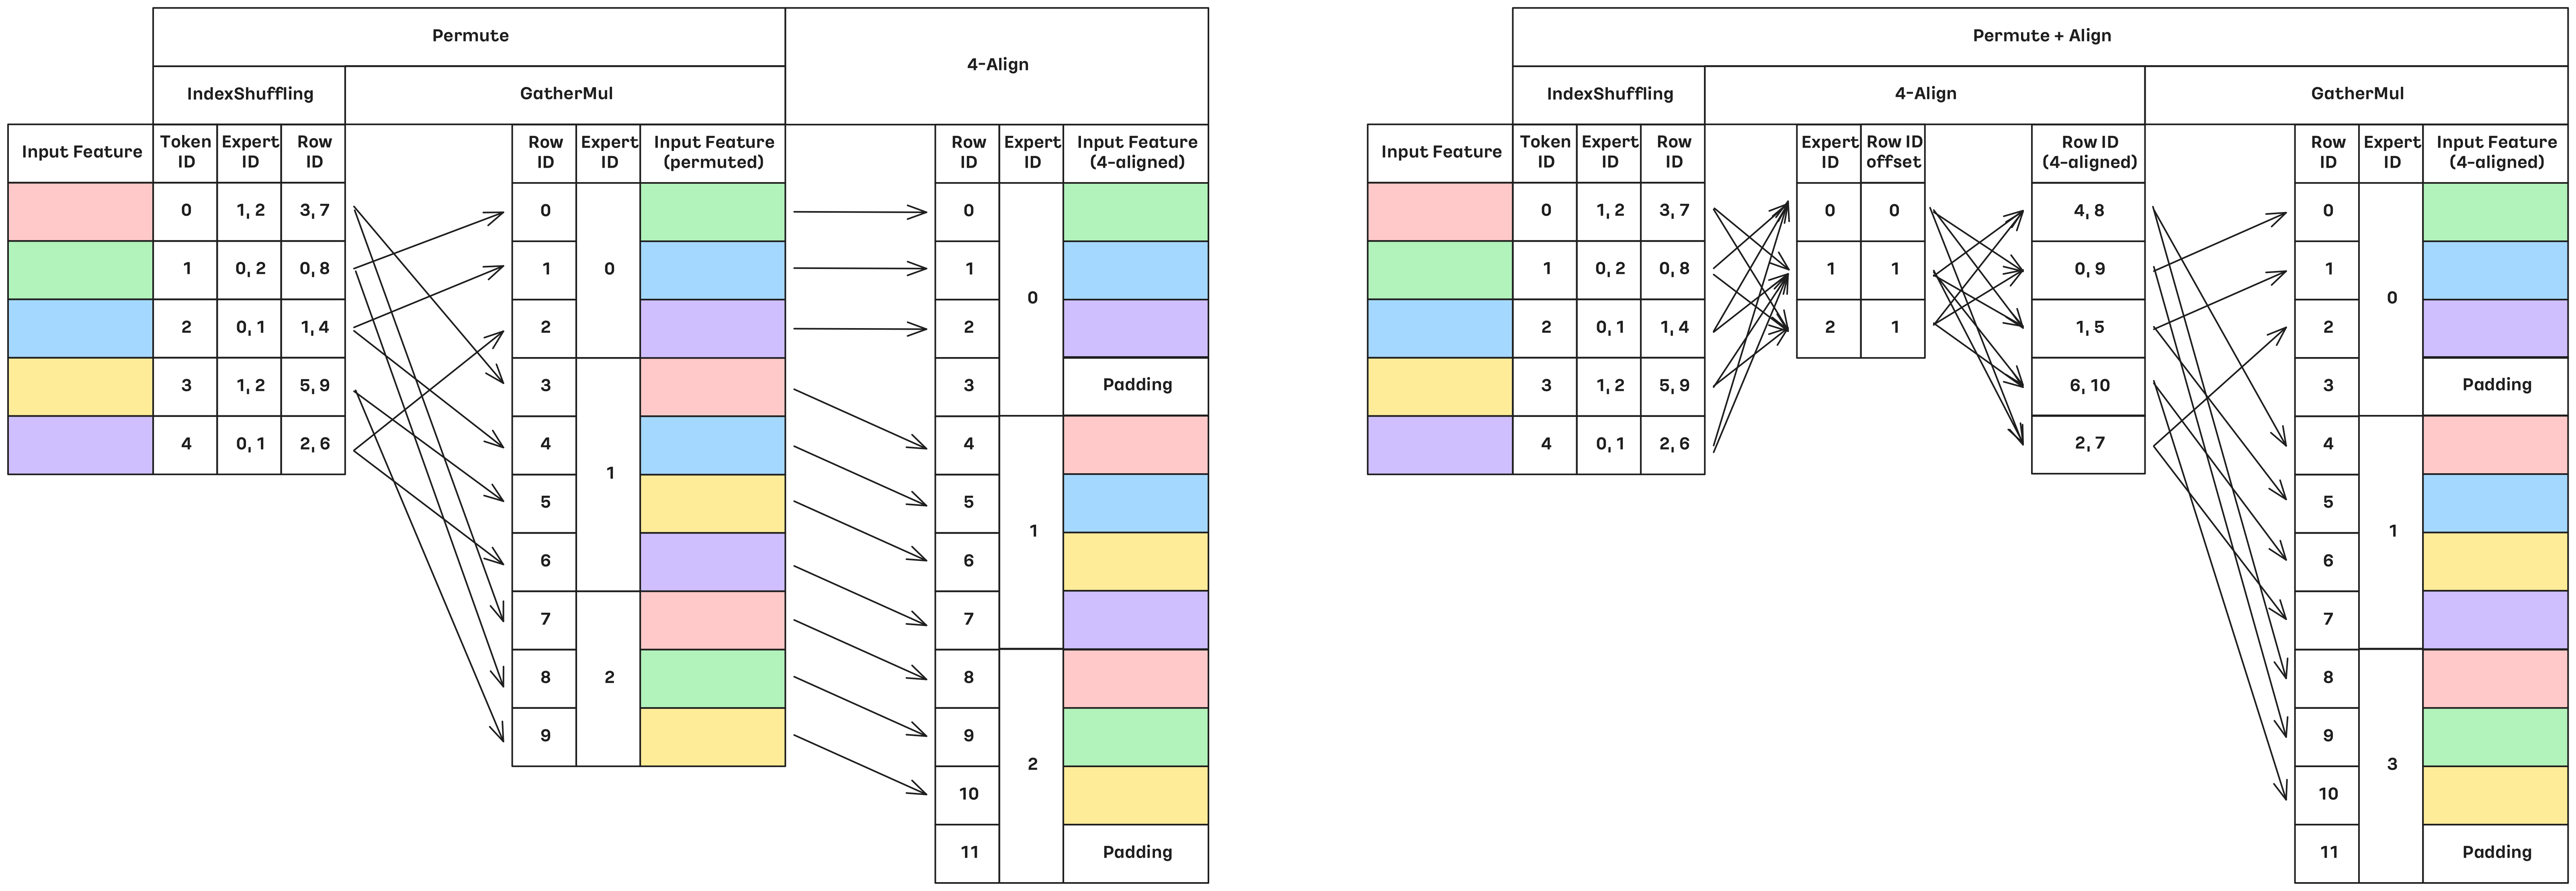
그림 6: MoE 훈련에서 Permutation과 Alignment 연산에 대한 모식도. 왼쪽처럼 두 연산을 별개의 커널로 다루는 대신, 오른쪽처럼 하나의 커널로 합쳐 메모리 접근을 최소화하였습니다.
Non-GEMM의 경우 문제가 좀 더 복잡했습니다. 앞서 말씀드렸던 대로, 그 당시에 존재하던 TransformerEngine 커널의 효율성이 좋지 않았기 때문에 새롭게 Quantization 커널을 개발하였습니다. 특기할만한 가장 큰 속도 병목은 MoE Quantization 커널이었는데, Weight과 Activation 모두에 대해 Quantization이 Expert별로 순차적으로 실행되는 문제가 있었습니다. 때문에 여러 Expert들에 대한 Quantization을 하나의 커널로 통합하였고, 큰 속도 향상을 확인하였습니다. 또한 일반적으로는 BF16 Weight를 메모리에 둔 채로 GEMM 직전에 Online Quantize하게 되는데, Model Weight에 필요한 메모리를 줄이기 위해 Forward에 필요한 FP8 Quantized Weight만을 저장하고 Backward 시에는 Block Quantize된 Weight들을 Transpose(전치)하는 커널을 개발하여 활용하였습니다. 이를 통해 여러 Microbatch들에 대해 중복되는 Weight Quantization 연산을 줄일 뿐만 아니라, 훈련에 필요한 GPU Memory 또한 줄일 수 있었습니다. Permutation과 Alignment 커널 또한 개선이 필요했습니다. 두 연산을 독립적인 두 커널로 실행할 경우 불필요한 메모리 접근으로 인한 오버헤드가 상당하여, Token Permutation과 Alignment 두 가지 연산을 하나의 커널로 통합하였고 큰 효율성 향상을 달성했습니다. (그림 6 참조) 이와 같은 FP8 커널 개발에 더해서, Flash Attention 3가 DeepSeek MLA의 Backward를 지원하지 않고 있었기 때문에 해당 부분을 개발하여 오픈소스에 기여하였습니다.
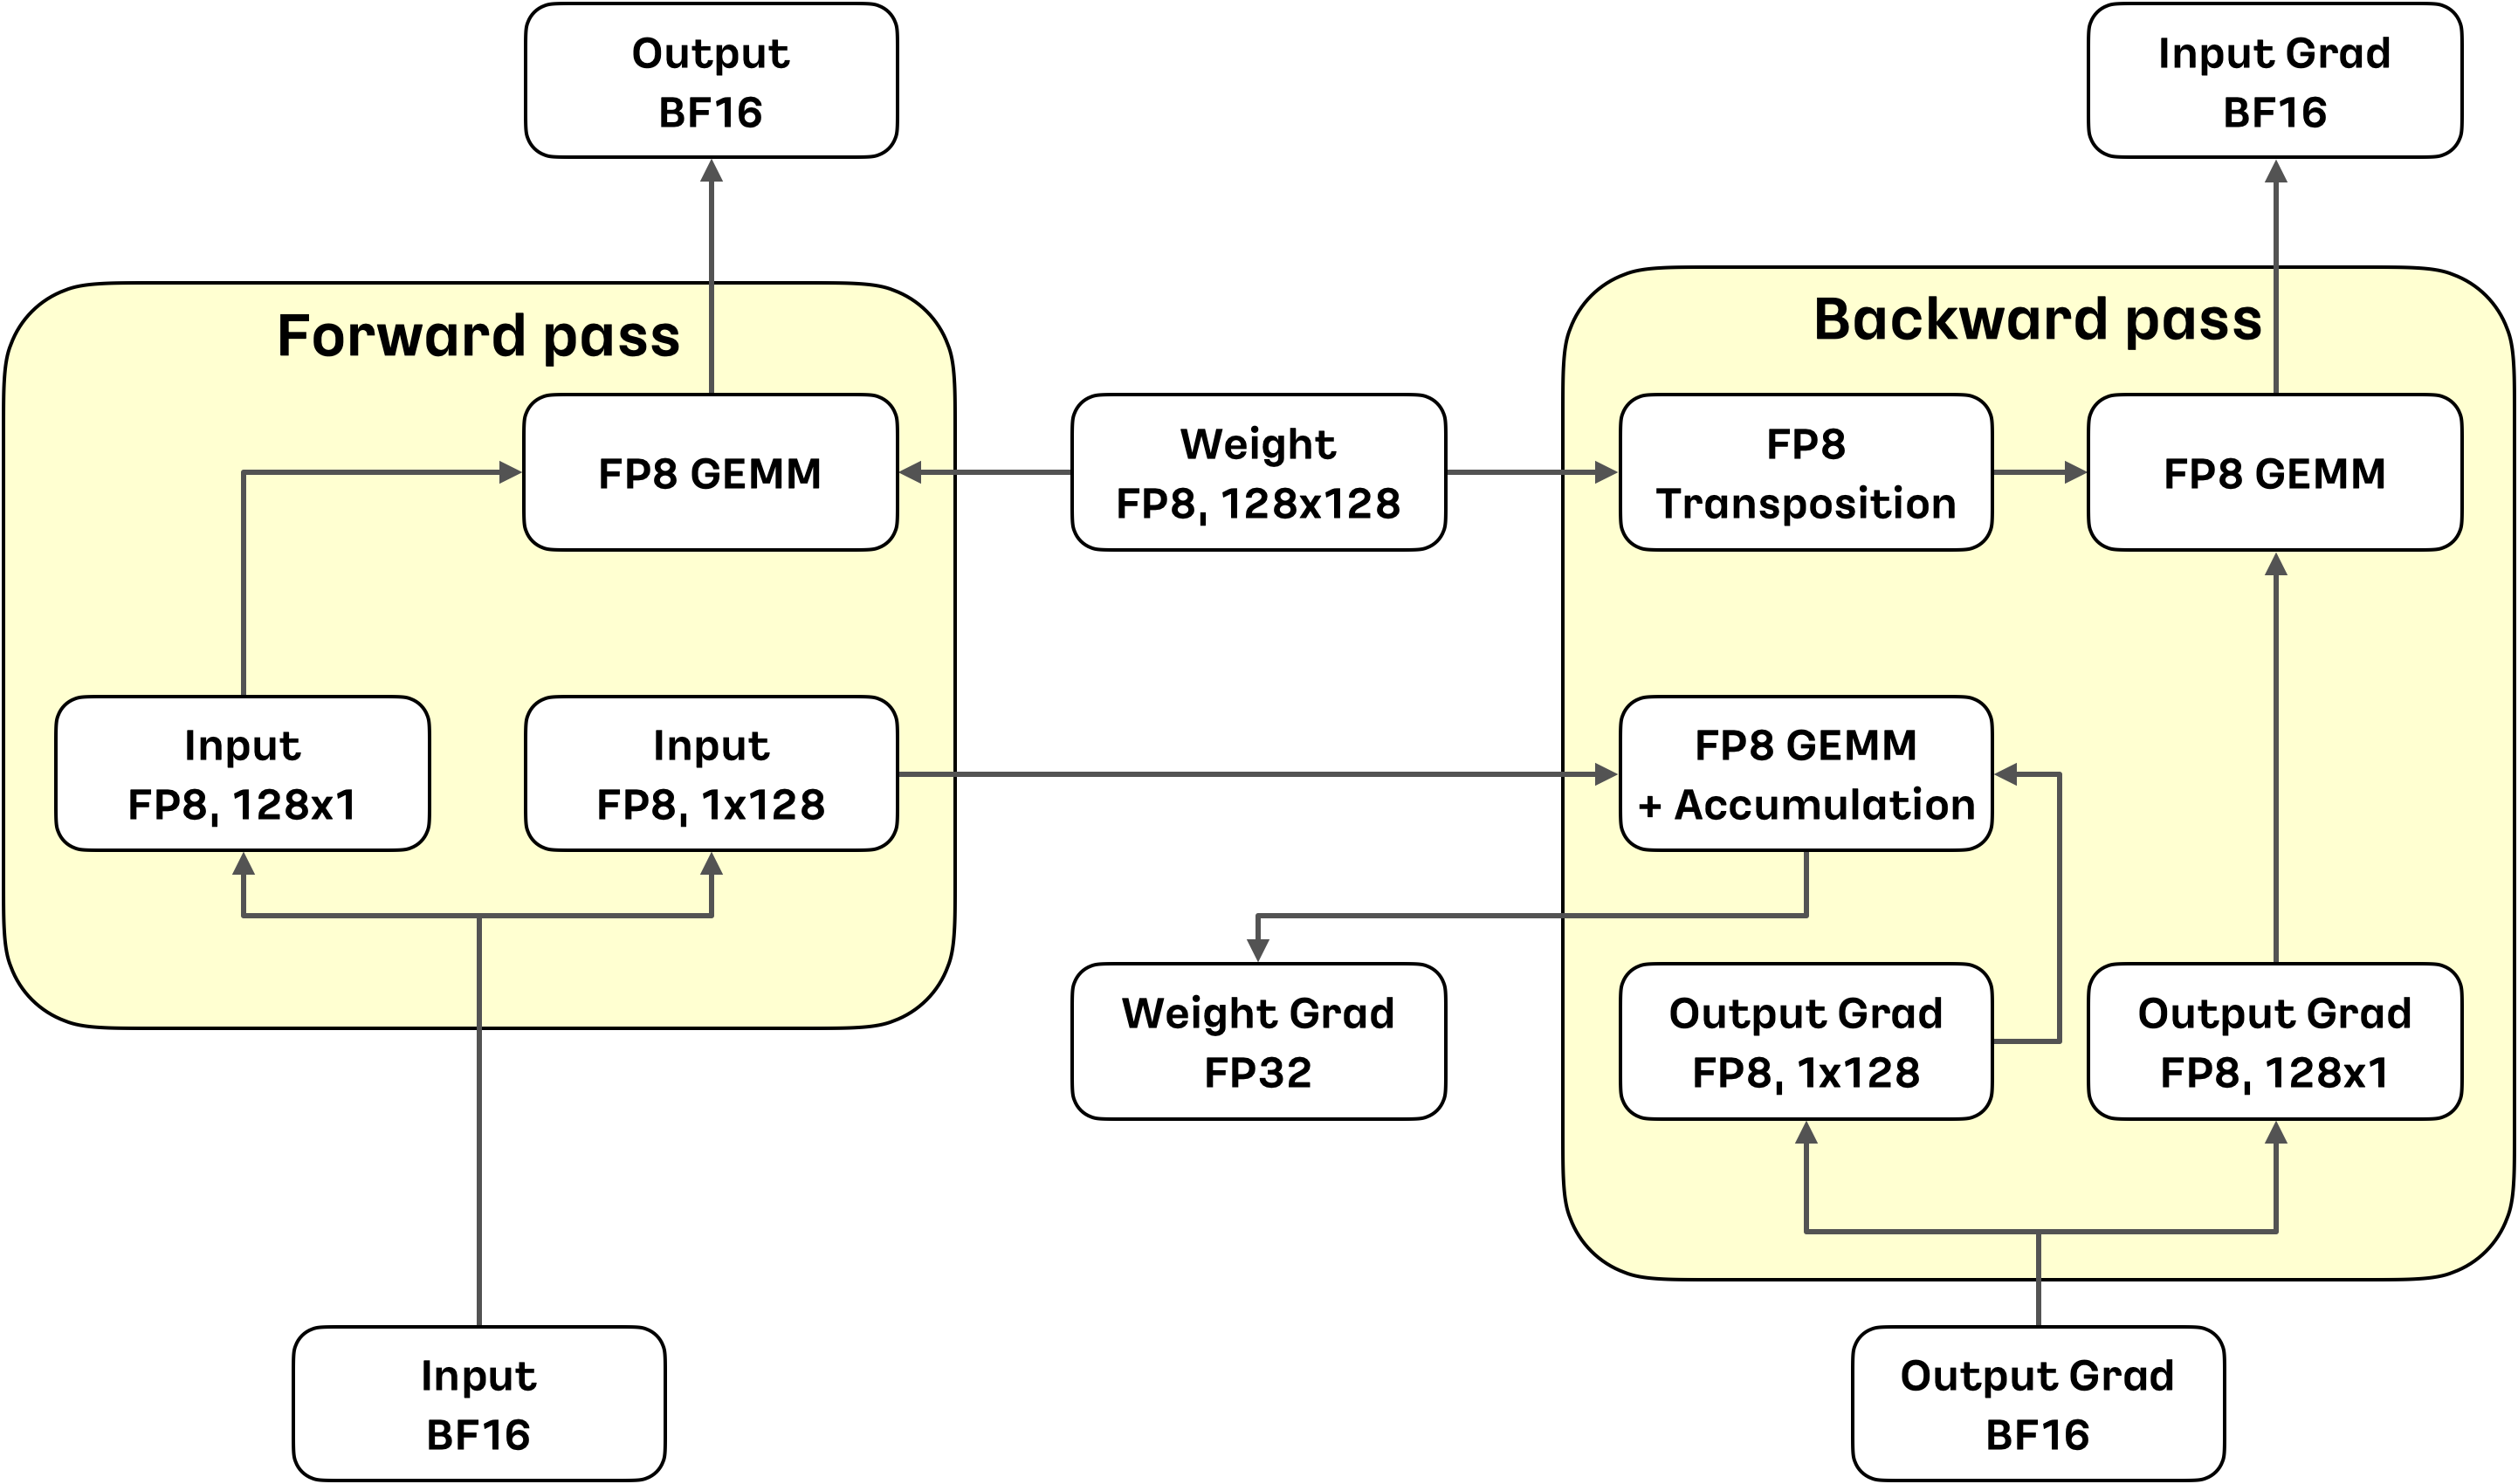
그림 7: Kanana-2의 Mixed Precision Training Framework
FP8 모듈에 대해 Forward/Backward Pass에서 Intermediate Tensor들이 활용되는 과정은 그림 7과 같습니다. 대부분의 모듈을 FP8로 훈련하되, DeepSeek V3를 참고하여 Embedding, LM Head, MoE Router, Normalization, Attention 연산은 BF16으로 유지하였습니다. Large-scale Training에서의 Precision Error를 최소화하기 위해 Master Weight, Optimizer State, Gradient는 모두 FP32를 사용하였습니다. 자원 효율성과 훈련의 정확도라는 두 마리 토끼를 모두 잡기 위해 이와 같이 Framework 개발에 큰 공을 들였고, 이를 기반으로 155B 모델의 훈련을 현재까지는 성공적으로 진행하고 있습니다.
Large-scale Training에서의 최적화는 GPU를 사용하는 연산들에 국한되지 않습니다. 예를 들어 Multi-GPU Training에서 GPU별로 Garbage Collection (GC)의 타이밍이 다르면, 다른 GPU들이 GC GPU를 기다리게 되는 현상이 발생함이 알려져 있습니다. Python의 Automatic GC를 끄고 Manual하게 GC Interval을 설정함으로써 Multi-GPU GC가 Synchronous하도록 개선한 결과, 7% 정도의 성능 향상을 확인할 수 있었습니다.
또 다른 큰 장애물 중 하나는 스토리지와 체크포인팅이었습니다. FP8 Main Weight, FP32 Master Weight, 1개의 FP32 Optimizer State를 가정하면 훈련 중간중간에 저장되는 체크포인트 하나만 해도 155B 모델 기준 1.4TiB에 이릅니다. Large-scale에서는 모델 체크포인팅에 소요되는 시간조차 훈련에 큰 영향을 미칠 수 있으며, 이 영향을 해결하기 위해서 Distributed Asynchronous Checkpointing을 도입하였습니다. 체크포인팅이 차지하는 스토리지 또한 문제였습니다. 효율적인 훈련을 위해 고속 Lustre 스토리지를 사용하고 있는데, 고속에다가 고액의 스토리지인 만큼 가용 가능한 용량이 많지 않았습니다. 뿐만 아니라 체크포인트별로 평가도 해야 하기 때문에 결국 기존 체크포인트의 Object Storage로의 이동, HF 모델로의 변환, 평가, 평가가 끝난 체크포인트는 Lustre에서 제거, 평가 결과 리포팅 등등의 여러 작업이 필요했습니다. 이에 드는 공수를 최소화하기 위해 prefect를 사용하여 체크포인팅 이후의 워크플로우를 자동화하였고, 이는 팀 전체가 더 중요하고 어려운 일에 집중할 수 있도록 하는 데에 매우 큰 도움이 되었습니다.
Towards Scalable & Generalizable
지금까지 저희가 진행한 실험들, 그리고 그를 기반으로 진행한 의사결정에 대해서 소개드렸습니다. 하지만 “어떤 실험을 진행할 것인가”만큼이나 중요했던 결정은 “어떤 실험을 진행하지 않을까"라는 문제였다고 생각합니다. 데이터, 연구에서 엔지니어링에 이르기까지 신경써야 하는 부분은 너무나도 많은 반면, 자원은 한정되어 있습니다. 때문에 모든 디테일에 대한 검증을 진행할 수 없다는 점을 인정하고, 여러 아이템 중 우선순위를 정하는 일이 필요했으며, 아이템의 기대효과뿐 아니라 투입해야 할 자원의 양까지 종합적으로 고려해야 했습니다.
가장 좋은 예시 중 하나가 바로 모델 아키텍처입니다. 아키텍처를 바꾸는 것은 단순히 훈련 코드를 바꾸는 것에 그치지 않고, 추론/배포 시의 여러 하드웨어와 프레임워크까지 신경써야 하는 결정사항입니다. 이러한 측면에서 아키텍처의 변경에 들어가는 자원은 해당 검증실험에 필요한 자원보다 훨씬 크다고 보아야 하며, Kimi-Linear, mHC 등의 최신 아키텍처 연구들이 Scaling Analysis를 필수적으로 진행한다는 점까지 고려하면 엄밀한 검증실험을 위한 자원 또한 적지 않습니다. 때문에 저희는 연구 당시 기준으로 500B 이상의 두 오픈소스 모델을 통해 검증된 DeepSeek V3 아키텍처를 사용하였습니다.
작은 스케일에서 검증실험을 진행했다 하더라도, 의사결정이 검증실험과 반대로 갈 수 있다는 점 또한 어려운 지점 중 하나였습니다. 그 주된 이유는 우리가 작은 스케일의 결과를 기반으로 큰 스케일을 훈련하는 만큼, 그 결정이 Scalable하고 Generalizable해야 한다는 대원칙이 있었기 때문입니다. 예를 들어 작은 스케일에서의 Data Ablation 결과가 큰 스케일로 Transfer되지 않는 현상이 그러합니다. 반대로 이야기하면, Scalable/Generalizable하고 더 간단한 선택지가 있다면 해당 선택지를 우선적으로 고려하였습니다. 앞서 언급했던 Polar Express와 MuP가 그 좋은 예시입니다.
Conclusion
지금까지 Kanana-2-30b-a3b-base 공개와 함께, 현재 훈련 중인 Kanana-2-155b-a17b를 위해 진행한 연구개발 내용들을 공유드렸습니다. 특히 결과물보다는 개발과정에서 맞닥뜨린 여러 갈림길들에서 어떠한 결정을 했는지를 위주로 공유드리려고 노력했으며, 이어 실제 에이전트 환경에서 중요한 도구 호출(Tool Calling)과 지시 이행(Instruction Following) 능력 향상에 초점을 둔 Post-training 개발기에도 많은 관심 부탁드립니다. 이러한 내용들이 Kanana뿐만 아니라 한국 LLM 커뮤니티에 큰 도움이 되었으면 하는 바람입니다. 저희 또한 여기에서 멈추지 않고, 더 강력하고 효율적인 Kanana 모델을 위해 노력하겠습니다.
마지막으로, Large-scale Training은 데이터/연구부터 엔지니어링까지 모든 것들을 신경써야 하는 일종의 종합예술에 가깝습니다. 때문에 좋은 개인들의 합이 아니라, 좋은 팀으로서 일해야만 이러한 일을 해낼 수 있다고 믿습니다. Kanana-2 개발 과정 전반에서 가보지 않은 길을 함께 탐색하고 성장한 기여자분들께 너무나도 감사하다는 말씀을 드리며 글을 마치도록 하겠습니다.
Contributions
Language Model Training
- lambda.xprime, json.bourne, wavy.jung, lana.ny, channing,yun, kaya.butter, juliet.bak, ryan.u
AI Engineering
- monk.ey, jacob.crux, muzi.0, harry.b, ready.90, kenneth.dd
Acknowledgements
글의 검수를 맡아주신 Language Model Training 팀의 mat.mul, Multimodal model 조직의 loophy.cc께 감사드립니다.
관련 글 목록
- Kanana-2 개발기: 개선된 post-training recipe를 중심으로
- 더 똑똑하고 효율적인 Kanana-2 오픈소스 공개
- “생각하고 답변하는” 카카오의 하이브리드 멀티모달 언어모델, Kanana-v-4b-hybrid 개발기
- 더욱 똑똑하게 답하며, 더욱 풍부한 감정표현을 향한 Kanana-o의 진화 과정
- 한국어와 이미지를 한 번에, 카카오의 멀티모달 임베딩 모델 개발기
- Agentic AI를 향한 카나나 모델의 진화
- Kanana 언어모델에 추론 기능 붙여보기 (feat. Kanana-1.5)
- 국내 최초 MoE 모델 ‘Kanana-MoE’ 개발기
- Kanana LLM 1.5 개발기
- 더 똑똑해진 카카오의 언어모델 ‘Kanana 1.5’ 상업적 활용 가능한 오픈소스 공개
- 카카오의 언어모델, Kanana 테크니컬 리포트 공개
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다