Engineering
데이터테크랩의 빨리 세는 법
2019년 8월 22일
원문에서 보기 ↗데이터테크랩의 나기호 선임님과 함께 진행하고 있는 과제를 소개해 드리는 글 입니다.
오늘은 부서에서 개발 중인 플랫폼 중 많은 데이터의 숫자를 빨리 세기 위해, 혹은 빨리 찾기 위해 만들고 있는 DataMart를 소개해 드리겠습니다.
빨리 집계하기 위해 가장 많이 도입하는 전통적인 방법은 OLAP환경의 DataCube입니다. 흔히 BI라고 불리죠.
데이터의 구조를 차원(attribute 혹은 dimension)으로 설계하고 이에 필요한 값(metrics 혹은 measures)들을 미리 계산해 놓는 방식입니다. (미리 계산하지 않고 관계만 설정해놓은 상태에서 조회 시 큐브가 생성되는 Relational OLAP 도 있지만 속도를 논하는 글이니 논외로 하겠습니다.)
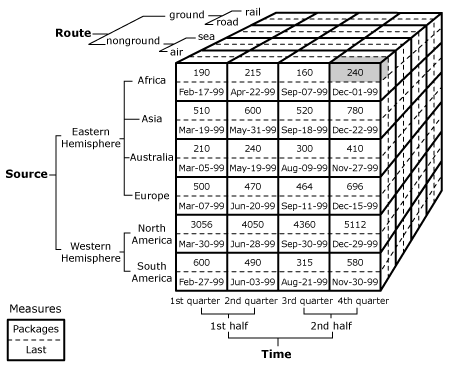 <그림1: Data Cube, 출처: https://docs.microsoft.com/ko-kr/sql/analysis-services/multidimensional-models-olap-logical-cube-objects/cube-cells-analysis-services-multidimensional-data?view=sql-server-2017\>
데이터 큐브를 간단하게 설명해 드리면
select country, count(population) as population_of_nation from nation_table group by 1
의 결과 값(contry의 인구 수)을 미리 만들어 놓는 일종의 index 혹은 cache 입니다.
또,
select country, state, count(population) as population_of_state from nation_table group by 1, 2
의 결과값(contry-state의 인구 수)도 미리 계산해 놓습니다.
이렇게 필요한 모든 경우의 수를 미리 계산해 놓으면 되는데, Dimension이 많아질수록 Catesian Product도 기하급수적으로 늘어 Cardinality가 너무 높아져 버립니다. (죄송합니다. 유식한 척하고 싶었습니다. 그냥 계산 양도 많고 저장해야 하는 공간도 커져버린다는 말입니다.) 그렇다 보니 빠르게 집계하기 위해 만든 큐브조차 결국엔 느려지게 되는 악순환이 반복됩니다. 또 주(state) 단위의 수치를 보다 보면 사람의 욕심은 끝이 없어 city 단위 수치도 보고 싶어 집니다. (drill-down) 그런데 우리는 주 단위까지만 계산해 놨습니다. 큐브가 깨지는 순간입니다. 빨리 계산하기 위해 만들어놓은 "통짜 테이블"을 다시 쪼개야 하고 쪼갠 것들을 JOIN 하는 식으로 회귀하는... 그래서 "OLAP 왜 구축했지?"라는 자아비판도 하게 됩니다.
데이터테크랩에서도 이러한 도전을 빈번히 받다 보니 회사를 오래 다니고 싶어 다음과 같은 생각을 해봅니다. "어차피 깨질 거 미리 조각 내놓고 나눈 놈들을 따로 (빨리) 세서 합하자!"
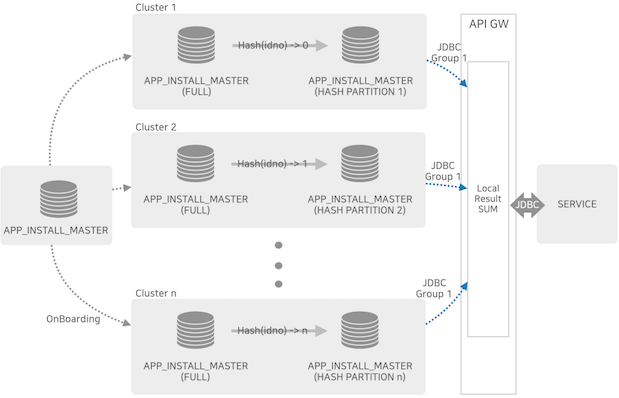
몸뚱이가 큰 데이터를 key 기반의 partition으로 나누고 이것을 여러 클러스터에 나누는 형태입니다. 그리고 이 클러스터들의 계산 결과가 중앙의 computing gateway에 집중되어 최종 결과물을 산출, 전달하는 방식입니다.
(그리고 보니 AWS의 Redshift와 유사한 모양이 나오네요...)
그림을 보시면 알겠지만 각 클러스터들과의 인터페이스는 JDBC여서 꼭 클러스터가 아니더라고 JDBC 스펙을 지원하는 모든 DB가 연동 가능합니다. API GW와 서비스의 인터페이스 또한 JDBC여서 이를 사용하는 서비스들은 바로 적용이 가능합니다.
또 잘게 쪼개 놨기 때문에 테이블을 Cube나 Dice로 만들 필요 없이 그냥 정규화해놓고 Join 해서 사용해도 됩니다.
이러한 구조를 이용해 65대의 정도(?)의 데이터 노드를 가지고 있는 사내 공통 클러스터인 CDP(Common Data Platform)에서조차 10초 이상 이 소요되는 엄청 무거운 3억 건의 다중 조인 쿼리를 4대로 구성된 클러스터 4개의 연합(총 16대)으로 3초 대까지 줄일 수 있었습니다.
건초더미에서 바늘을 겁나 빨리 찾을 수 있는, 그런데 쉽게(SQL, JDBC) 사용할 수 있는 방안을 만들면서 추가로 "데이터를 사용하는 서비스는 데이터가 어떻게 구성되어 있는지 알 필요가 없고 데이터를 관리할 때 사용자에 따라 현재 상황에 따라 보이는 데이터를 조절할 수 있는 정책 또한 구성할 수 있었습니다."
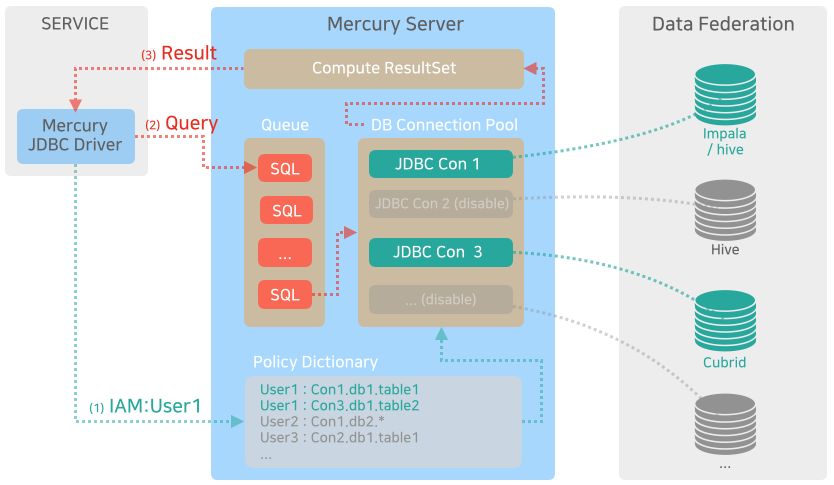
- 로그인을 하는 순간 계정에 따라 어떤 JDBC에 접속 가능한지, 또 어떤 디비명과 테이블에 접근 가능한지 policy가 정해집니다.
- 많은 쿼리가 유입되면 하위 DB들에게 부하가 걸릴 수 있으므로 request를 큐로 관리하며 동시에 구동될 수 있는 요청을 조절합니다.
- 질의가 시작되면 각 장비(JDBC)에 쿼리를 전달하고 나온 결과(local result)를 최종적으로 취합하여 요청자에게 전달합니다.
이렇게 만들어 놓으니 다음과 같은 시나리오도 추가로 가능해졌습니다. 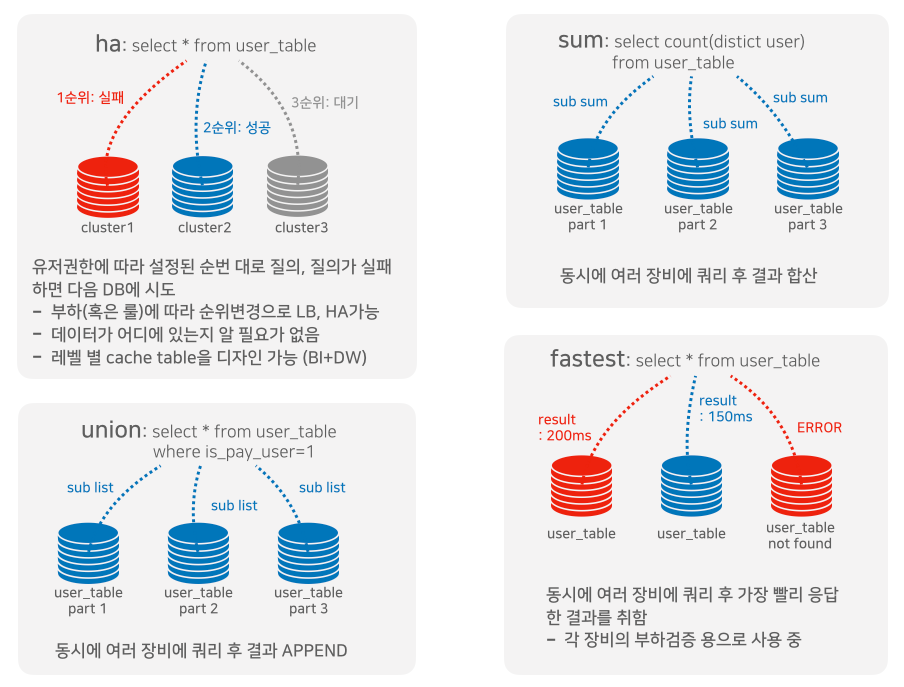
HA 모드:
접속 가능한 Connection에 우선순위를 두어 질의하며 성공할 때까지 순회하는 구조입니다. 1순위의 장비에 장애가 발생되면 2순위에 질의를 하게 되므로 자동적으로 HA를 구현할 수 있습니다. 또한 순회하므로 사용자는 어떤 디비에 원하는 테이블이 존재하는지 알 필요가 없습니다.
여기에 우선순위 도 질의를 하는 시점에 정할 수 있으므로 덜 바쁜 Connection 순으로 질의를 요청할 수 있어 LB 또한 가능합니다.
SUM, UNION 모드:
주어진 Connection 모두에게 동시에 질의한 후 나온 부분 결과를 취합하여 전달해주는 구조입니다. 키 별도 데이터가 분산되어 있기 때문에 distinct 처리도 가능하며 각 Connection이 담당해야 하는 데이터가 적어 지기 때문에 scale-out이 될수록 빠른 처리 속도를 보이게 됩니다.
Fastest 모드:
주어진 Connection 모두에게 동시에 질의한 후 가장 먼저 응답을 주는 데이터를 취하는 구조입니다. HA모드에서 덜 바쁜 Connection을 찾을 때 사용하고 있습니다.
마치며
이런 설루션은 주위에 잘 찾아보면 여러 가지가 있습니다.
대표적으로는 Presto, ProxySQL 등이 있지요.
하지만 queue, data-encapsulation, user-policy 등 우리만의 "비즈니스 사정" 적용하려다 보니 알맞은 설루션을 찾지 못해 직접 구현하게 되었습니다. 대신 JDBC을 이용하는 구조이기 때문에 언제든지 이러한 Connection들과 data federation을 구현할 수가 있는 구조로 만들었습니다.
또한 기대도 하지 않은 부분이었지만 특정 (우리에게 필요한) case에서는 AWS의 redshift를 훨씬 상회하는 처리속도를 보여줬습니다. (완전 꿀임다 ^^;;)
저와 같이 많은 분들께서 일할 때마다 항상 어디까지는 외부 설루션을 도입하고 어디서부터 직접 개발해야 하나?라는 고민과 도전을 접하게 될 텐데요... 그런 고민들을 절충하면서 한 번에 생각보다 쉽게 풀어나갈 수 있었던 case여서 다른 분들께도 공유하고픈 마음에 글을 쓰게 되었습니다.
도움이 되었으면 하며 긴 글 읽어 주셔서 감사합니다.