Engineering
AI와 개발하기: 숨은 결정을 드러내기
2026년 8월 3일
원문에서 보기 ↗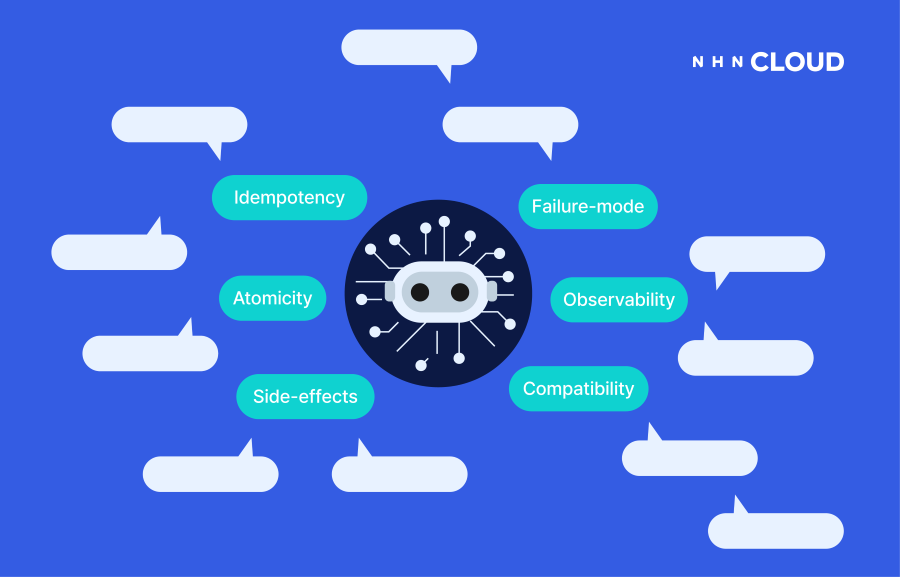
들어가며
AI 시대의 개발은 코드를 직접 얼마나 잘 쓰느냐보다, AI가 만든 산출물이 내 의도와 맞는지 얼마나 구조적으로 검증할 수 있느냐의 문제가 되고 있습니다.
AI 에이전트가 코드의 상당 부분을 작성하게 되면, 사람은 모든 구현 세부 사항을 직접 통제하지 않습니다. 대신 의도를 설명하고, AI가 만든 결과가 그 의도에 맞는지 확인합니다. 개발자의 통제 지점이 코드 작성에서 의도 전달과 검증으로 옮겨갑니다.
그런데 통제 지점이 옮겨간다고 해서 인지 부하가 사라지는 것은 아닙니다. 오히려 직접 코드를 쓰지 않은 만큼, 결과물이 어떤 판단을 거쳐 만들어졌는지 다시 확인해야 하는 부담이 생깁니다.
제가 처음 부딪힌 문제도 여기에 있었습니다. AI가 만든 코드는 생각보다 그럴듯했지만, 결과물을 확인할 때마다 인지 부하가 컸습니다. 코드를 읽으면서 계속 이런 질문을 다시 해야 했기 때문입니다.
이 코드가 정말 내가 원한 방식으로 설계된 게 맞나?
처음에는 이 문제를 리뷰 단계에서 풀려고 했습니다. AI에게 변경된 코드를 더 자세히 설명하게 하고, 각 변경의 의도와 리뷰 포인트를 정리하게 했습니다. 하지만 설명은 이미 만들어진 결과를 해석해 줄 뿐이었습니다. 문제는 더 앞에 있었습니다. 기능 요구사항을 설명할 때, 그 요구사항을 코드로 옮기는 데 필요한 기술 결정이 충분히 드러나지 않았습니다.
알림 메일 요구사항에 숨은 결정들
예를 들어 이런 요구사항이 있다고 해 보겠습니다.
주문이 완료되면 사용자에게 알림 메일을 보낸다.
이 문장은 기능 요구사항으로는 자연스럽습니다. 무엇이 트리거이고, 사용자에게 어떤 결과가 생겨야 하는지 알 수 있습니다. 하지만 코드 수준에서 보면 이 문장 안에는 여러 기술 결정이 숨어 있습니다.
- 알림 발송은 주문 완료 트랜잭션 안에서 실행해야 하는가?
- 알림 발송이 실패하면 주문 완료도 실패해야 하는가?
- 주문 완료 이벤트가 두 번 처리되면 알림도 두 번 가도 되는가?
- 알림 발송 실패는 재시도되어야 하는가?
- 실패한 알림은 어떤 로그, 이벤트, 메트릭으로 추적되어야 하는가?
- 외부 메일 시스템 호출은 동기 호출이어야 하는가, 비동기 작업으로 분리해야 하는가?
비즈니스 요구사항은 "완료되면 알림을 보낸다"이지만, 구현은 이런 질문들에 대한 답으로 만들어집니다. 스펙을 길게 쓰는 것만으로는 충분하지 않습니다. 중요한 것은 문장의 양이 아니라, 어떤 결정이 필요한지 드러나는 구조입니다.
자연어 프롬프트만으로는 "필요한 결정을 모두 말했는가"를 확신하기 어렵습니다. 코드베이스마다 기존 패턴이 다르고, 작업마다 중요해지는 결정 축도 다릅니다. 어떤 작업에서는 트랜잭션 경계가 중요하고, 어떤 작업에서는 호환성이 중요하며, 어떤 작업에서는 권한이나 tenant isolation이 핵심이 됩니다.
따라서 AI와의 스펙 설계에서 중요한 것은 요구사항을 길게 써 놓고 필요한 결정을 AI의 해석에 맡기는 것이 아니라, 숨어 있는 결정을 함께 논의할 수 있도록 먼저 드러나게 하는 데 있습니다.
스펙 작성 과정에 결정 구조를 반영한다
이 관점에서 보면 스펙을 작성하는 방식이 달라져야 합니다.
스펙을 작성하는 과정에서는 "무엇을 만들 것인가"만 묻지 말고, "이 기능을 구현하기 위해 어떤 결정을 내려야 하는가"를 함께 물어야 합니다.
그래서 질문은 이렇게 바뀝니다.
이 기능 요구사항 뒤에 어떤 기술 결정이 숨어 있는가?
그리고 그다음 질문은 이것입니다.
그 결정이 코드에 반영되었는지 어떻게 검증할 것인가?
예를 들어 "주문 완료 후 알림 메일 발송"이라는 요구사항은 다음과 같은 결정 구조로 바뀝니다.
| 결정 축 | 스펙에서 확정해야 하는 질문 |
|---|---|
| Atomicity | 주문 완료와 알림 발송은 같은 트랜잭션으로 묶여야 하는가? |
| Idempotency | 같은 주문 완료 이벤트가 다시 처리되어도 알림은 한 번만 가야 하는가? |
| Failure-mode | 알림 발송 실패가 주문 완료 상태에 영향을 주어야 하는가? |
| Observability | 알림 요청과 실패는 어떤 로그나 이벤트로 추적되어야 하는가? |
| Side-effects | 외부 메일 시스템 호출은 언제, 어떤 방식으로 발생해야 하는가? |
| Compatibility | 기존 주문 완료 API나 이벤트 계약은 바뀌지 않는가? |
결정 축은 작업의 성격에 따라 달라집니다. 어떤 변경에서는 Atomicity와 Failure-mode가 핵심이고, 어떤 변경에서는 Compatibility와 Security가 핵심이 됩니다. 그러니 AI는 먼저 현재 요구사항과 코드베이스를 보고, 이번 작업에서 논의해야 할 축을 골라내야 합니다.
이 축이 있으면 자연어 요구사항을 보고 그때그때 떠오르는 것만 묻지 않아도 됩니다. AI가 먼저 "이 작업에서는 어떤 기술 결정이 갈리는가"를 드러내고, 사람은 그 결정들을 하나씩 확인합니다. 확정된 결정만 스펙에 반영하면 되므로, 이 방식은 자연스럽게 인터뷰 형태가 됩니다.
AI와의 코드 기반 인터뷰
이 결정들을 함께 논의하려면, AI에게 곧바로 구현을 맡기는 대신 코드베이스를 근거로 질문하게 해야 합니다. 먼저 현재 코드베이스를 읽고, 결정이 갈리는 지점을 찾습니다.
같은 "알림을 보낸다"는 요구사항이라도 프로젝트마다 적절한 구현은 다릅니다. 어떤 코드베이스에는 이미 outbox 패턴이 있을 수 있고, 어떤 코드베이스는 동기 외부 호출을 기존 컨벤션으로 씁니다. 어떤 서비스는 이벤트 발행을 표준으로 삼고, 어떤 서비스는 작업 큐나 배치 재시도를 사용합니다.
그러니 질문을 추상적으로 던져서는 안 됩니다.
좋지 않은 질문은 이런 식입니다.
알림 실패 시 어떻게 처리할까요?
이 질문은 너무 넓습니다. 사용자는 다시 맥락을 떠올려야 하고, 코드베이스의 현재 구조까지 머릿속에 올려야 합니다.
더 나은 방식은 코드와 함께 묻는 것입니다.
// option A — 트랜잭션 안에서 바로 알림 전송
@Transactional
fun completeOrder(orderId: OrderId) {
    val order = orderRepo.get(orderId)
    order.markCompleted()
    notificationClient.send(order)
}

// option B — commit 후 발행할 outbox만 저장
@Transactional
fun completeOrder(orderId: OrderId) {
    val order = orderRepo.get(orderId)
    order.markCompleted()
    outboxRepo.save(NotificationRequested(order.id))
}
이렇게 보여주면 질문이 구체화됩니다.
이 코드베이스에는 이미 outbox 테이블과 발행 worker가 있습니다.
알림 실패가 주문 완료를 rollback하면 안 된다면, B처럼 commit 이후 발행하는 방식이 더 적합합니다.
이 방향으로 확정할까요?
이 인터뷰의 목적은 AI가 사용자에게 모든 판단을 떠넘기는 것이 아닙니다. 오히려 반대입니다. AI가 코드베이스를 먼저 읽고, 가능한 선택지를 좁히고, 추천안을 제시해야 합니다. 사용자는 그 추천을 보고 중요한 결정을 확정합니다.
이 과정에서 인지 부하가 줄어듭니다. 사용자는 처음부터 모든 기술 요소를 떠올릴 필요가 없습니다. AI가 결정이 갈리는 지점을 코드와 함께 드러내고, 사용자는 그 지점에서 "이 방향이 맞다" 또는 "아니다"를 결정하면 됩니다.
전술적 패턴: grill-me
이 전략을 실제 작업 흐름으로 만들 때는 grill-me라는 공개 스킬의 인터뷰 방식을 빌렸습니다. 핵심은 단순합니다.
- 한 번에 하나의 질문만 합니다.
- 질문에는 추천 답을 함께 제시합니다.
- 추상적인 원칙보다 관련 코드를 먼저 보여줍니다.
- 결정이 갈리는 순서대로 묻습니다.
이 네 가지 규칙이 별것 아닌 것처럼 보이지만, 실제로는 인지 부하를 크게 줄입니다. "이 기능을 어떻게 만들까요?"라고 넓게 묻는 대신, AI가 코드베이스를 읽고 "여기서는 트랜잭션 경계를 먼저 정해야 합니다"라고 좁혀 묻기 때문입니다.
다만 grill-me를 그대로 쓰면 너무 일반적입니다. 그래서 그 인터뷰 골격을 스펙 설계용으로 감쌌습니다. 사용자에게 비즈니스 요구사항을 받으면, AI는 먼저 현재 코드와 기존 컨벤션을 읽고 이번 작업에서 의미 있는 결정 슬롯만 고릅니다. 그리고 각 슬롯을 grill-me 방식으로 하나씩 진행합니다.
예를 들면 이런 흐름입니다.
이번 작업은 알림 발송 기능 추가로 보입니다.
핵심 결정은 Atomicity / Idempotency / Failure-mode입니다.
Observability는 실패 추적을 위해 짧게 확인하고, Compatibility는 기존 API 계약 변경이 없으므로 생략하겠습니다.
그다음 첫 질문으로 바로 들어갑니다.
먼저 Atomicity를 보겠습니다.
주문 완료와 알림 발송을 같은 트랜잭션으로 묶을지, 주문 완료 commit 이후 outbox로 분리할지 결정해야 합니다.
이 코드베이스에는 이미 outbox worker가 있으므로, 추천은 commit 이후 outbox 발행입니다.
이런 식으로 진행하면 사용자가 처음부터 모든 기술 결정을 떠올릴 필요가 없습니다. AI가 코드베이스를 근거로 결정 후보를 꺼내고, 사용자는 그중 실제로 중요한 결정을 함께 확정합니다. 전술은 grill-me의 인터뷰 규칙을 빌리고, 전략은 그 질문들을 기술 결정 축으로 제한합니다. 이렇게 해야 인터뷰가 잡담으로 흐르지 않고, 구현 전에 놓치기 쉬운 결정을 줄일 수 있습니다.
리뷰 시점의 일이 달라진다
이 방식의 효과는 구현 전보다 리뷰 시점에서 더 분명하게 드러납니다.
기존 방식에서는 리뷰어가 코드를 보며 처음부터 다시 해석해야 했습니다.
- 이 코드는 어떤 의도로 작성된 것인가?
- 왜 이 설계를 선택했는가?
- 어떤 실패 모드를 고려했는가?
- 중복 요청이나 동시 요청은 안전한가?
이 질문들은 모두 중요하지만, 구현이 끝난 뒤 처음 발견되면 리뷰 비용이 커집니다. 리뷰어는 코드와 요구사항을 동시에 읽으며 숨은 결정을 역추적해야 합니다.
반면 스펙 단계에서 기술 결정이 드러나 있으면 리뷰 질문이 바뀝니다.
- 스펙에서 확정한 트랜잭션 경계가 코드에 반영됐는가?
- 중복 방지 키가 합의한 기준대로 사용됐는가?
- 실패한 알림은 주문 완료 상태를 흔들지 않고 재시도 가능하게 남는가?
- 로그와 이벤트는 합의한 관측 지점을 제공하는가?
이제 리뷰는 전체 코드를 처음부터 해석하는 일이 아니라, 합의된 결정이 코드에 반영되었는지 확인하는 일이 됩니다.
그만큼 리뷰의 초점도 선명해집니다. 코드가 길어도 모든 줄을 같은 밀도로 읽지 않고, 스펙에서 합의한 결정이 실제 구현에 어떻게 반영되었는지를 먼저 봅니다.
이 변화는 AI에게 모든 결정을 맡기지 않았기 때문에 가능합니다. 구현 전에 결정이 드러났고, 사람과 AI가 그 결정을 함께 확정했기 때문에 리뷰도 같은 기준에서 시작합니다.
자연어는 출발점일 뿐이다
자연어는 여전히 출발점입니다. 사람은 비즈니스 요구사항을 자연어로 설명하는 것이 가장 자연스럽고, AI도 그 설명을 바탕으로 작업을 시작합니다.
다만 자연어 요구사항을 그대로 구현 프롬프트로 넘기면, 비즈니스 의도 뒤에 숨어 있는 기술 결정이 AI의 몫으로 넘어갑니다. 그 결정은 구현 어딘가에 반드시 반영되지만, 사람이 함께 논의하지 않은 결정으로 남습니다.
AI와의 스펙 설계에서 중요한 것은 요구사항의 분량이 아니라, 그 요구사항 뒤에 숨어 있는 결정을 함께 논의할 수 있는 형태로 드러내는 데 있습니다.
