Engineering
뱅크샐러드의 실험플랫폼 분석 인프라 살펴보기
2021년 2월 10일
원문에서 보기 ↗안녕하세요. 실험플랫폼 팀 Data Scientist 이수형입니다.
뱅크샐러드는 실험을 통해 제품을 개선하는 노력이 실제로 사용자에게 더 좋은 경험으로 이어지는지 매일매일 데이터를 통해 검증해나가고 있습니다. 여기서 말하는 실험(A/B Test, Online Controlled Experiment)이란 사용자가 마주하는 변화를 정량적인 데이터로 측정하는 과정입니다. 내부적으로 실험을 원활하게 진행하기 위해, 2020년 초에 실험플랫폼 팀이 만들어졌습니다.
실험플랫폼 팀은 크게 두 가지 역할을 합니다. 첫 번째는 쉽게 실험을 할 수 있도록 인프라(실험플랫폼 UI, 분석 파이프라인, …)를 구축합니다. 두 번째는 실험을 통해 성과를 검증하는 문화를 만들어갑니다. 지금은 모든 제품 개선을 실험으로 계획하고, UI에서 실험 분석 결과를 확인합니다. 이러한 과정을 통해 제품 개선을 실험 분석 결과로 검증하고 사용자에게 배포할지 Rollback할지 의사결정 합니다. 이러한 모습이 되기까지 1년이라는 시간 동안 실험플랫폼팀 및 많은 구성원의 노력이 필요했습니다. 이 글에서는 실험플랫폼의 여러 노력 중에서 실험 분석 인프라를 구축한 내용에 대해 이야기하려 합니다.
뱅크샐러드의 모든 조직은 제품/기능을 기획할 때 임팩트에 대한 가설을 세우고, 실험을 진행합니다. 사내 백오피스인 실험플랫폼 웹을 통해 실험 결과를 분석하고, 분석 결과를 토대로 해당 제품/기능을 사용자에게 배포할지 Rollback할지 의사결정 합니다. 이러한 모습이 되기까지 실험플랫폼팀은 2가지 노력을 해왔습니다. 첫째, 실험을 통해 성과를 검증하는 문화를 만들었습니다. (이 내용은 진정한 실험 조직의 탄생에서 자세히 볼 수 있습니다) 둘째, 누구나 쉽게 실험을 진행할 수 있도록 인프라(실험플랫폼 UI, 분석 파이프라인, …)를 구축합니다. 이 글에서는 두 번째 노력 중 실험 분석 인프라를 어떻게 구축했는지에 대해 이야기하려 합니다.
실험플랫폼이 실험 문화를 정착시키기 위해 어떤 노력을 했는지 궁금하신 분들은 진정한 실험 조직의 탄생을 참고 바랍니다.
실험플랫폼의 핵심가치
실험플랫폼 팀의 핵심 가치는 “신뢰할 수 있는 데이터를 제공하고 모든 제품 개선들을 실험을 통해 검증할 수 있게 한다” 입니다. 실험 분석 인프라는 팀의 핵심가치를 토대로 설계되었고 발전되어 왔습니다.
-
신뢰성
신뢰할 수 없는 데이터를 제공하는 실험플랫폼은 없는 편이 차라리 낫습니다. 실험플랫폼을 통해 신뢰할 수 없는 데이터를 제공받은 사용자는 잘못된 의사결정을 하게 됩니다. 만약 이러한 경우가 반복된다면, 사용자는 실험플랫폼의 분석 결과를 믿지 않고 데이터 기반 의사결정을 거부하게 될 것입니다.
예를 들어, 뱅크샐러드 PM(Product Manager)이 앱 로딩 속도를 개선하여 이탈 사용자를 줄이기 위한 실험을 진행한다고 가정해보겠습니다. 시간이 흐른 후 실험 결과를 들여다보았더니, 앱 로딩 속도를 개선하였음에도 불구하고 이탈 사용자를 줄이지 못했다는 결과가 나왔습니다. 그러나 뒤늦게 이러한 실험 결과가 데이터의 유실로 인한 부정확한 결과였다는 게 밝혀졌고 실제로는 실험을 통해 검증하려던 가설이 맞았다면 어떨까요? 처음엔 그럴 수도 있다고 넘어갈지도 모릅니다. 그러나 이후 진행되는 실험에서, 실험 결과가 잘못되는 일이 반복된다면 뱅크샐러드 PM은 더는 실험 결과를 신뢰하지 못할 것입니다.
이처럼 단 몇 번의 오류만으로도 실험플랫폼은 조직 구성원들의 신뢰를 잃을 수 있습니다. 그러나 잃어버린 신뢰를 되찾는 것은 몇 배는 더 어렵기에 신뢰할 수 있는 데이터를 제공하는 것은 중요합니다.
-
유연성
모든 제품 개선들은 실험을 통해 직관이 아닌 실험 결과로 의사결정 할 수 있어야 합니다. 뱅크샐러드는 빠르게 성장하면서 다양한 제품 영역에서 수많은 가설을 검증하고 있습니다. 이를 위해서 실험플랫폼 팀은 App과 Web 서비스의 개선, Server 단의 개선(API 속도 개선) 등 다양한 영역에서 실험을 가능하게 만들어야 합니다. 그리고 이를 정량적으로 측정하기 위한 여러 종류의 실험 지표를 지원해야 합니다. 이뿐만 아니라 더 효율적인 실험을 제공하고 연구하기 위해서는 Data Scientist & Analyst들이 쉽게 새로운 통계 방법론을 추가해 볼 수 있는 환경이 필요합니다.
이처럼 다양하고 효율적인 실험을 지원하기 위해서 유연한 실험 분석 인프라를 제공하는 것은 중요합니다.
분석 인프라 V1: 수동으로 실험 분석하기
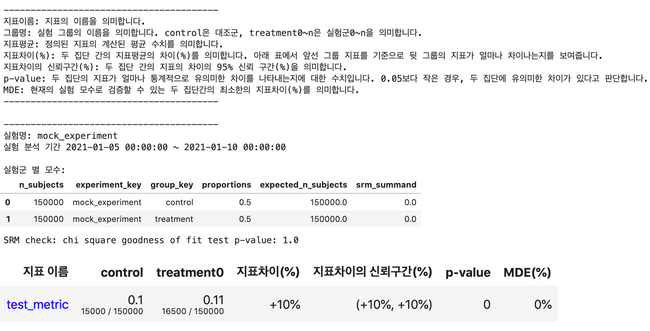
Figure 1 | 수동 분석 Script
실험이 진행되면 사용자를 실험의 대조군(Control group)/실험군(Treatment group)에 할당하고, 각 실험 그룹의 반응을 데이터로 수집하고, 수집된 데이터를 통해 실험 결과를 분석하게 됩니다. 실험 분석 인프라는 이러한 실험과정에서 발생하는 데이터를 자동으로 적재하고 분석할 수 있어야 합니다. 다만, 자동화된 분석 인프라가 완성 되기 전에 예정된 실험들의 분석이 가능한 환경을 만드는 것이 더 중요했습니다. 자동화된 분석 인프라가 갖춰질 때까지 기다리는 것은 그 시간 동안 제품을 개선하지 못한다는 의미였기 때문에 회사 입장에서는 큰 손실이었습니다. 반면에 실험 없이 제품 개선을 반영하는 것은 제품 개선이 사용자에게 주는 영향을 정량적으로 측정하지 못한다는 의미였기 때문에 이 또한 저희가 원하는 방향이 아니었습니다. 개선들을 예정대로 적용하고 정량적으로 측정하기 위해서는 꼭 필요한 기능들만이 포함된 첫 번째 분석 인프라를 만들어야 했습니다.
많은 제품 개선이 예정되어 있었기에 빠르게 분석 인프라를 개발하는 방향으로 계획해나갔습니다. 그리고 팀 내의 개발자 누구나 쉽게 실험 결과를 분석할 수 있는 방법을 고민하였습니다. 이러한 실험 분석 인프라는 자동화를 위한 초석이 되어야 했습니다. 그래서 빠르게 개발할 수 있고 쉽게 동작시킬 수 있도록 하나의 Script로 계획했습니다. 개발 언어는 추후 자동화 분석 인프라가 Python(Pyspark)기반으로 개발 될 예정이였기 때문에 Python을 사용했습니다. 그렇게 Python Notebook으로 된 첫 번째 분석 인프라를 개발했습니다.
첫 번째 분석 인프라를 통해 사용자의 반응을 데이터로 파악했고 그 결과를 제품에 반영해나가는 팀이 늘어갔습니다. 어느새 모든 제품 개선이 실험을 통해 의사결정 되었습니다. 하지만 시간이 지날수록 첫 번째 분석 인프라에 대한 불편의 목소리는 커졌습니다.
-
효율성
첫 번째 분석 인프라는 효율적이지 못한 구조였습니다. 첫 번째 분석 인프라에서 실험 분석 과정은 Data Storage인 AWS S3에 접근하기 위해 AWS Sagemaker라는 서비스에 접속하고, Python Notebook을 동작시켜야 했습니다. 실험 분석 과정에는 분석 결과를 복사해서 문서화 하는 등의 작업 또한 포함되어 있었습니다. 진행하는 실험의 개수가 많아질수록 분석을 수동으로 작동시켜야 하는 사람(Data Scientist & Analyst)의 리소스가 추가로 필요했고, 단순 반복 작업에 고급 인적 자원을 써야 했습니다.
-
확장성
기존 방식은 하나의 script로 관리되기 때문에, 새로운 분석 방법론을 추가하기 위해서는 전체 코드에 대한 파악이 필요했습니다. 시간이 지날수록 코드 양이 많아져 변경하는 사람뿐 아니라 리뷰어 또한 리뷰를 하기 쉽지 않은 구조였습니다.
-
일관성
실험 분석 결과는 입력값(분석 기간, 실험명, …)이 같다면 항상 같은 결과가 나오는 것이 중요합니다. 만약 입력값이 잘못되어 실험 결과가 달라진다면, 그 실험 분석 결과는 신뢰하지 못합니다. 첫 번째 분석 인프라는 수동으로 진행할 실험명, 실험 지표들, 분석 기간 등을 사람이 입력값으로 넣어 동작시켜야 합니다. 그 과정에서 잘못된 값을 넣는 인적과오가 발생하여 잘못된 분석 결과가 제공될 수 있습니다. 잘못된 분석 결과를 제공하는 것은 제품의 개선방향에 대해 잘못된 의사결정을 일으킬 수 있는 문제가 존재했습니다.
첫 번째 실험 분석 인프라를 만들 때는 실험의 개수도 작아 관리가 수월했기 때문에 수동으로도 충분히 분석할 수 있었습니다. 하지만 점점 많아지는 실험들을 관리하고 정확한 분석 결과를 제공하기에는 무리가 있었습니다.
분석 인프라 V2: 자동으로 실험 분석하기
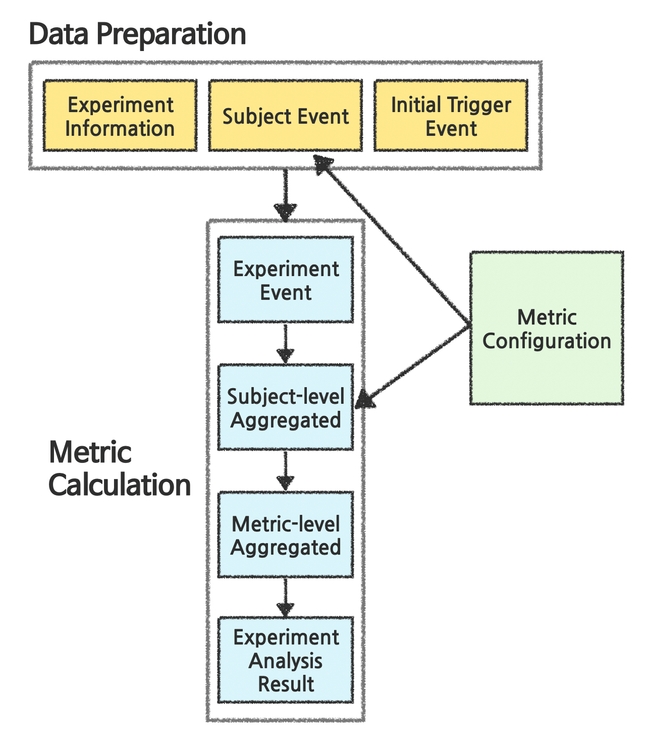
Figure 2 | 자동 실험 분석 파이프라인 구조
첫 번째 분석 인프라가 가진 문제를 해결하기 위해서는 실험 분석 파이프라인을 개발해야 했습니다. 실험 분석 파이프라인이란, 자동으로 실험의 결과와 관련된 데이터를 수집하여 실험 분석 결과를 계산하고 적재하는 환경을 의미합니다. 파이프라인은 실험의 지표(Metric)를 관리하는 Metric Configuration, 실험 분석 결과 계산에 필요한 데이터를 가공하는 Data Preparation, 실험 분석 결과를 계산하는 Metric Calculation 세 부분으로 나누어 구성했습니다.
Metric Configuration
metric_name: 사용자 당 탭 방문수
event_query: ...
aggregation_query: ...
Metric Configuration이란 실험 지표들을 관리하기 위한 설정들을 의미합니다. 실험 지표란 실험 결과를 대변할 수 있는 정량적 수치로, 계산하는데 필요한 정보와 방법은 지표별로 달라집니다.
- 사용자 당 가계부 방문 수
- 계산에 필요한 정보: 사용자가 가계부에 방문한 기록
- 계산하는 방법: 사용자별로 가계부에 방문한 횟수를 더하여 계산한다
- 사용자의 가계부 방문 전환율
- 계산에 필요한 정보: 사용자가 가계부에 방문한 기록
- 계산하는 방법: 사용자별로 1번 이상 방문한 경우에는 1, 아닌 경우에는 0으로 계산한다
위와 같이 지표 계산에 필요한 정보와 방법을 관리하는 체계가 Metric Configuration입니다. Metric Configuration은 지표 계산에 필요한 정보를 조회하는 Query인 Event Query, 계산하는 방법을 나타내는 Query인 Aggregation Query를 관리합니다. 정의된 Query들은 Data Preparation과 Metric Calculation에서 지표를 계산하기 위해 사용됩니다.
Data Preparation
Data Preparation이란 용어 그대로 분석에 필요한 데이터를 준비하는 과정입니다. 실험 분석을 위해서는 어떤 실험인지, 어떤 사용자가 실험에 노출되었는지, 실험 지표는 무엇인지에 대한 정보가 필요합니다. 이 정보들은 아래와 같이 각 Context(실험, 사용자, 지표) 별로 구조화됩니다.
Experiment Information: 실험을 정의하는데 필요한 정보들을 의미합니다. 실험이 생성/수정/삭제/완료된 history를 활용하여 분석해야 하는 실험들의 정보를 조회하게 됩니다. 실험 정보는 실험이 사용자에게 노출되는 비율, 노출되는 조건(Platform, App Version, …), 실험 상태, 실험 기간 등으로 정의됩니다.
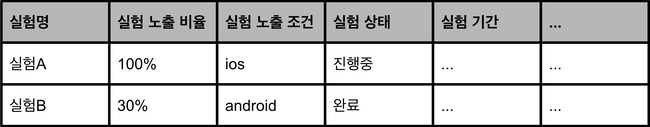
Figure 3 | Experiment Information
Trigger Event: Trigger란 Subject(사용자)가 실험에 노출된 이벤트를 의미합니다. 여기서 Subject란 실험의 분석 단위를 의미하며 User, Device, Session 등으로 정의됩니다. Trigger Event는 Subject의 종류가 무엇이며, Subject가 어떤 실험의 어떤 그룹에 언제 노출되었는지의 데이터로 정의됩니다.
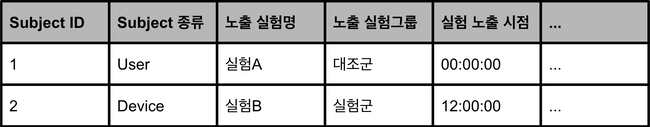
Figure 4 | Trigger Event
Subject Event: 실험의 지표를 계산하기에 필요한 Subject의 이벤트 정보들을 의미합니다. Subject가 언제 어떤 이벤트를 어떻게 일으켰는지의 데이터가 포함되며, Metric Configuration의 Event Query를 사용해 계산되게 됩니다.
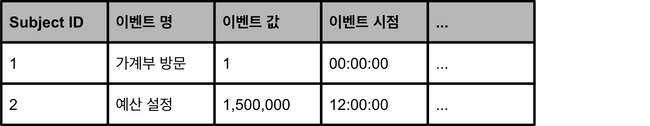
Figure 5 | Subject Event
위 3가지 정보들을 가공하기 위한 Raw Data는 내부 로깅 시스템을 통해 적재됩니다. 적재된 데이터는 Data Preparation단계를 통해 실험 분석 결과 계산에 필요한 정보로 가공됩니다.
Metric Calculation
실험 분석 결과는 실험을 통한 의사결정에 필요한 정보들을 의미하고, 반드시 아래의 정보들을 포함해야 합니다.
- 지표 수치
- 지표 차이
- 지표 차이의 통계적 유의성
Metric Calculation은 Data Preparation에서 가공된 데이터를 통해 위 정보들을 계산하는 과정입니다. 해당 과정은 4단계로 나누어 독립적으로 진행되며, 각 과정의 결과물들은 AWS S3에 적재됩니다. 이렇게 과정을 나눈 이유는 두가지가 있습니다.
첫 번째로 Data Scientist & Analyst 분들이 분석을 효율적으로 할 수 있게 하기 위해서입니다. 분석 요청마다 처음부터 모든 분석 과정을 반복하는 것이 아닌, 각 과정의 저장된 결과를 재사용하여 효율적으로 분석을 진행할 수 있게 했습니다.
예를 들어, 실험 설계 과정에서 정의되지 않은 실험 지표를 추가해서 분석하려는 경우를 가정해 보겠습니다. Metric Calculation의 과정이 나누어져 있다면, 지표를 계산하기 전까지의 과정은 반복하지 않아도 됩니다. S3에 적재된 데이터를 사용하여 지표를 계산하는 과정만 반복하면 됩니다.
두 번째로 파이프라인에 통계적인 방법론 추가와 같은 변경사항을 반영하기에 유연한 구조를 만들기 위해서입니다. Metric Calculation의 특정 과정에 변경사항이 있더라도 다른 단계에는 영향을 주지 않도록 구성했습니다. 이렇게 독립적으로 파이프라인을 구성해, 변경사항이 있을 때 변경사항에 해당하는 단계만 변경하도록 했습니다.
마지막으로 분석 결과 혹은 과정에서 문제가 생겼을 경우, 어느 단계에서 문제가 발생했는지 모든 과정을 확인하는 것이 아닌 관련된 과정만을 확인하여 Debugging이 쉬운 구조를 구축했습니다.
Metric calculation 과정은 재사용이 많은 기준으로 나누었습니다. 재사용의 대표적인 예시는 추가 분석입니다. 뱅크샐러드의 경우 실험을 Subject의 특성(성별, 연령, …)으로 나누어 실험 분석을 하거나, 설계 시에 설정되지 않은 실험 지표를 추가하여 분석하고자 하는 경우가 많았습니다. 이를 기준으로 실험(Experiment Event), Subject(Subject-level Aggregated), Metric(Metric-level Aggregated) 단위로 과정을 나누었습니다. 이 과정에서 얻은 결과를 통해 최종적으로 실험 분석 결과(Experiment Analysis Result)를 계산합니다.
각 과정의 결과물은 다음과 같습니다.
Experiment Event: Subject Event를 Subject가 실험에 노출된 시점(Trigger Time) 이후의 데이터만 조회한 결과물입니다. 분석을 진행할 때 필요한 데이터는 Subject가 실험에 노출된 이후 시점의 데이터입니다. 그전의 데이터는 실험의 영향을 받기 전(받지 않은) 데이터이기 때문에 제외해야 합니다.
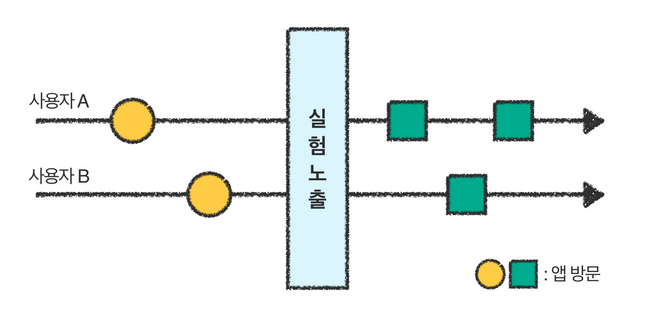
Figure 6 | 실험 노출 이후의 가계부 방문 이벤트만을 실험 분석에 사용
Subject-level Aggregated: 지표 계산을 위해서 Experiment Event를 Subject 단위로 Aggregation 하여 Subject별로 지표를 계산한 결과입니다. Metric Configuration의 Aggregation Query를 사용해서 계산합니다.
- 사용자 A의 앱 방문 수: 실험 노출 이후 2번 가계부를 방문함
- 사용자 B의 앱 방문 수: 실험 노출 이후 1번 가계부를 방문함
Metric-level Aggregated: 지표 값의 평균, Standard Error 등 통계적 유의성을 검증하는데 필요한 정보들을 지표 단위로 계산한 결과입니다.
- 사용자의 앱 방문 수의 평균: (2+1) / 2 = 1.5
Experiment Analysis Result: 실험 분석 결과입니다. 지표의 수치, 지표의 차이, 지표의 통계적 유의성(p-value) 등이 포함되며 의사결정에 필요한 정보들(신뢰구간, 표준편차, Minimum Detectable Effect)을 함께 제공하게 됩니다. 통계 방법론은 Two-sample z-test를 사용합니다.
최종적으로 계산된 Experiment Analysis Result는 실험플랫폼 UI에서 보이게 됩니다.
첫 번째 분석 인프라에서 Script를 동작시키고 그 결과를 문서화하는 과정은 주에 2시간 정도의 Data Scientist & Analyst 분들의 리소스가 필요했습니다. 자동화된 분석 인프라는 이러한 리소스 문제를 해결했고, 인적과오로 생길 수 있는 데이터 정합성 문제 또한 해결 했습니다. 그리고 실험 결과를 UI에서 확인할 수 있기 때문에 Python에 대한 이해가 없어도 누구나 실험 결과를 확인할 수 있게 되었습니다.
실험 분석 결과의 신뢰성과 접근성이 높아지면서 팀원들은 진행 중인 실험의 결과를 더 자주 확인했습니다. 실험에 대한 다양하고 적극적인 논의가 이루어졌고 데이터 기반 의사결정 과정이 더 성숙해졌습니다.
유연하고 신뢰할 수 있는 자동화된 분석 인프라는 기술적인 측면뿐 아니라 뱅크샐러드의 실험 문화를 한 단계 더 발전시켰습니다.
마치며
실험플랫폼은 1년이라는 시간 동안 문화적으로나 기술적으로 많은 발전을 이루어 왔습니다. 자동화된 분석 인프라 구성은 그중에서도 기술적으로 큰 도약이었습니다. 하지만 분석 결과를 제공하는 것은 실험플랫폼의 가장 기본적인 기능이기도 합니다.
뱅크샐러드의 실험 문화는 하루가 달리 성숙해지고 있습니다. 모든 제품 개선을 실험을 통해 검증하는 것뿐 아니라, 진행된 실험들에 대해 논의하고 더 나은 실험을 하기 위해 고민하고 있습니다. 성숙해지는 실험 문화를 기술적으로 지원하기 위해서는 지금보다 많은 기술적인 발전이 필요합니다.
지금까지는 실험플랫폼에 꼭 필요한 핵심 기능을 구현하기 위해 노력했습니다. 앞으로는 검정력을 높여 더 빠른 실험을 제공하거나, 여러 종류의 지표를 계산하는 등 다양하고 복잡한 실험을 쉽게 할 수 있도록 실험플랫폼을 고도화하는데 더 많은 노력을 기울이려고 합니다.