Engineering
게으른 개발자의 코딩 방법: AI주도 개발방법론
2021년 7월 9일
원문에서 보기 ↗프롤로그
4차 산업혁명시대로 불리는 현재, 우리는 AI가 대중화된 시대에 살고 있다. 그리고 업무에도 깊숙하게 AI는 적용되고 있다. 과거부터 사무 처리 업무의 자동화는 관심거리였고, 매크로, RPA(Robotic Process Automation) 등으로 표현되며 사무 자동화도 계속 발전하며, 업무 처리의 효율성과 생산성에 많은 기여를 하고 있다. 하물며, 이제는 Windows 10에서 기본적으로 Power Automate Desktop이 탑재된다는 소식이 들리며, RPA는 보편화될지도 모른다는 생각도 든다.
우리 개발자들은 비개발 영역의 활동을 개선하기 위한 수많은 서비스를 개발하고, 보급하며, 지속하기 위한 유지보수 개발을 하고 있다. 그런데, “왜? 우리 개발자들의 개발 활동은 개선되지 못할까?” “왜? 개발자들은 늦은 시간까지 코딩을 하게 되는가?”라는 생각이 들었다.
그러던 중, 개발하는 과정에서의 반복 패턴을 발견하게 되었다. 개발 활동 자체에도 RPA를 도입해 보자는 생각이 들었고, 각종 파일을 수 초 내에 생성해 내는 Code Generator를 활용한 개발 경험 기를 공유하고자 한다.
개발 프로젝트는 어떻게 시작되는가?
개발자의 개발 활동을 개선하기 위해서는 어떻게 개발이 시작되고 계속되는지, 개발 라이프 사이클을 살펴볼 필요가 있다. 신규 프로젝트를 예를 들어 살펴보자.
최고 경영진 혹은 사업 책임자 등에 의해 사업적 요구사항이 발생되면 우리는 그것을 어떻게 만들지 형태를 구체화하는 명세서를 작성한다. 서로의 컨센서스를 맞추기 위한 화면 명세서와 때에 따라서는 간단한 목업 혹은 프로토타입 작업이 이어진다. 이러한 서비스 기획 활동은 파워포인트 혹은 최근에는 Figma, Adobe XD 등과 같은 툴로 소통하게 된다. 이렇게 어떤 형태의 결과물을 만들지 확정되면, 개발자들이 투입되어 시스템을 설계하고 구현하게 된다. 물론, 기타 여러 활동들이 있지만 현재는 개발자의 활동에 집중하기 위해 개발 설계부터 구현까지의 과정을 살펴보고자 한다.
개발자는 화면 명세로부터 각종 항목을 확인하고, 그것들을 개념화하여 데이터베이스로 어떻게 정리할지 설계하게 된다. DB 설계 과정에서는 테이블 명세서, ERD 등을 작성하게 된다. 도출된 항목의 필수 여부, 값의 형태, 값을 생성하는 주체, 값이 생성되는 주기 등을 고려하여 정규화하거나 사전에 미리 성능을 고려하여 반정규화 할 수 있는지 등을 검토하게 된다.
이러한 정리가 끝나면, 화면 명세로부터 개발해야 하는 기능 항목도 정리하게 되는데, 소위 CRUD(Create, Read, Update, Delete)라고 부르는 단위를 중심으로 기능을 정리하고, API 요소(Server-side)와 화면 개발 요소(Client-side)를 정리하게 된다.
그리고 개발할 환경을 먼저 구축해야 하는데, 웹 프로젝트의 경우 우리 회사는 대부분 Java 언어 기반에 Spring Framework 기반으로 개발하게 된다. 따라서, 신규 프로젝트라면 Git에 새로운 Repository를 만들고 Maven이나 Gradle 기반 프로젝트를 구성, Spring 설정(application.yml의 설정, Configuration 코드 수정 등) 등을 완료함으로써 개발 첫 삽이 떠진다.
그리고 서비스 기획 과정에서 정의된 정책적인 요소에 따라 CRUD 기능 단위와 이것들을 조합 또는 확장하여 만드는 소위 비즈니스 로직을 구현함으로써 본격적인 개발이 시작된다. 물론 이외 스테이지 별 서버 구축, 개발 인프라 구축 등이 있겠고 현재는 개발 구현 단계의 생산성을 높이는데 관심을 두고 있어 생략한다.
개발의 생산성을 높이기 위해, 어디까지 알아보았나?
생산성을 높인다는 의미는 빠른 시간 내에 결과물을 완성해 내는 것을 의미한다고 볼 수 있다. 하지만 현실에서는 트레이드오프가 늘 발생하기 마련이다. 고품질이면서, 빠른 시간 내에, 적은 비용으로 결과물을 완성해 낸다는 것은 거의 불가능한 일이라고 볼 수 있다. 이 불가능을 그래도 어느 정도 해결해 보기 위한 방법을 찾아보고자 한다.
상대적으로 쉽게 접근할 수 있는 것부터 해결해 보려고 한다. 빠른 시간 내에 할 수 있는 것에는 어떤 것들이 있을까? 우선 물리적인 시간 비용이 적게 들어야 한다는 의미로 해석을 해 보았다. 알다시피 개발 활동은 수많은 코드를 생산하는 것이 주된 업무이고, 코드는 개발자가 한 땀 한 땀 타이핑하며 완성해 내는 결과물이다. 그렇다면, 구현 단계에서 타이핑해야 하는 것을 줄여준다면 구현 단계의 시간은 단축할 수 있지 않을까?
실제 현업 웹 개발 환경에서는 타이핑을 줄여 줄 수 있는 프레임워크, 라이브러리, 플러그인 등이 많이 활용되고 있다. JAVA 기반의 웹 개발 생태계에서는 Spring Framework 환경에서 Spring boot를 통해 빠르게 개발을 시작할 수 있도록 Spring Initializr 같은 것들도 존재한다. 또한 Getter, Setter 혹은 Builder 패턴의 클래스를 생산하기 위한 타이핑을 줄이 위해 Lombok 같은 라이브러리도 사용한다.
프레임워크와 각종 라이브러리를 활용하여 우리의 개발 생산성은 이미 높아져 있지만, 그럼에도 우리는 타이핑해야 하는 양은 늘 많다. 영문 타이핑 속도가 빠르다 하더라도, 그리고 IDE가 자동완성을 많이 해준다고 하여도, 물리적으로 생산해야 하는 코드는 늘 많기 마련이다.
구현 과정에서 하나라도 덜 타이핑을 하기 위한 방법으로 우리는 ORM을 선택할 수도 있다. ORM을 채택하는 이유는 다양하겠지만, 최소한 타이핑을 적게 하는 것도 이유가 될 것이다. ORM을 선택하더라도 우리는 최소한 만들어야 하는 클래스 파일들은 존재한다. 이러한 것도 싫어하는 나 같은 게으른 개발자들을 위해 세상에는 많은 종류의 Code Generator가 있는데, JPA를 선택했다면 Entity 클래스 파일을 DB 기준으로 자동 생성해주는 IDE 플러그인들을 사용하기도 한다.
하지만, 기본적인 CRUD 로직을 구현하는 것 또한 많은 타이핑을 요구한다. MVC 구조로 개발하다 보면 반복적으로 코드를 생산해 내기도 해야 한다. 이것을 줄이기 위한 방법으로 스캐폴딩 도구를 찾기도 한다.
나는 이러한 경험 속에서 관통하는 부분이 데이터 구조라고 생각한다. 데이터를 어떻게 처리할지에 대해 우리는 많은 코드를 작성하기 때문이다.
테이블 명세서에서 출발하는 자동화
우리는 흔히 데이터 구조를 정리할 때, 엑셀로 테이블 명세서를 작성하게 된다. 물론, 다른 전문 도구 혹은 그렇지 않은 경우도 있겠다. 엑셀 파일로 작성된 테이블 명세서를 협업 대상자(동료 개발자, DBA, 모델러 등)들과 소통할 때 사용하고 용도 폐기하게 된다. 나는 생산성을 높이기 위해서는 데이터 구조에 관심을 가져야 한다고 생각한다. 그래서 데이터 구조를 설계하면서 나오는 파일에 관심을 가져 본다.
DB 테이블을 설계할 때, 다음 항목들을 기술하게 된다.
- 영문으로 된 테이블 명칭
- 테이블에 대한 설명 (현업에서 생략되기도 함)
- 개념적으로 묶이는 모듈명 (현업에서 생략되기도 함)
- 테이블을 구성할 세부 칼럼명
- 칼럼 별 설명 (현업에서 생략되기도 함)
- 데이터 도메인 (현업에서 생략되기도 함)
- 데이터 타입
- Not null 여부
- 기본 값
- PRIMARY KEY 여부
- UNIQUE KEY 여부
- INDEX KEY 여부
- 기타 등등
이 테이블 명세서 엑셀 파일을 가지고, 나는 어떤 스캐폴딩 도구를 만들어낼 수 있을지 생각해 보았다. 물론 스캐폴딩 도구 개발 또한 적은 시간을 들여서 할 수 있길 기대했기에 익숙한 스크립트 언어를 기반으로 시작하게 되었다.
엑셀 파일로부터 테이블 명세 정보를 읽어 들인 이후, 적어도 DDL 구문들은 자동화하여 만들 수 있다. 아래와 같은 테이블 생성하는 쿼리를 템플릿 파일을 만들면 말이다.
CREATE TABLE 영문으로 된 테이블 명칭 (
    {세부 컬럼 명}     {데이터 타입}     {Not null 여부}  COMMENT ‘컬럼별 설명’

) ENGINE=InnoDB COMMENT=’테이블에 대한 설명’;

ALTER TABLE 영문으로 된 테이블 명칭
  ADD PRIMARY KEY ({PRIMARY KEY 여부가 Y인 컬럼들});
그리고 NHN의 경우, 사내에서 데이터베이스 정보를 관리하는 플랫폼이 존재하고 이 시스템에 신규 테이블의 정보를 등록하면 담당 모델러가 검토하고, DBA가 운영 DB에 생성해주는 업무 절차가 존재한다. 이 과정에서 사용할 수 있는 테이블 대량 생성용 엑셀 파일도 만들 수 있다.
다음으로, 우리는 각종 VO, DTO 클래스를 만들게 되는데 이 과정에서도 테이블 명세 엑셀 파일을 참조할 수 있게 된다. 물론, 우리가 코드를 자동 생산해 낸다고 하더라도 유지보수는 우리의 몫이니 우리가 편하려면 Lombok을 활용하는 템플릿을 작성한다.
package {미리 지정해둔 패키지 경로};

import Lombok.*

@Data
@AllArgsConstructor
@NoArgsConstructor
public class 영문으로 된 테이블 명칭 {
     private {데이터 타입}    {세부 컬럼 명};
}
하지만, JAVA 코드를 생산하는 과정에서는 테이블 명세에서 작성되지 않은 여러 가지 추가 정보가 필요한데, 항목은 다음과 같다.
- 사용할 JAVA 패키지
- 클래스 명을 생성하는 규칙
- 파일을 생성할 로컬 경로
- DB 데이터 타입과 JAVA 데이터 타입 대조표
이러한 정보는 스캐폴딩 도구의 옵션으로 처리할 수 있는 부분이고, 각 계층 간 생성 규칙을 테이블 명세서 엑셀 파일에 별도의 시트로 추가하여 정의했다.
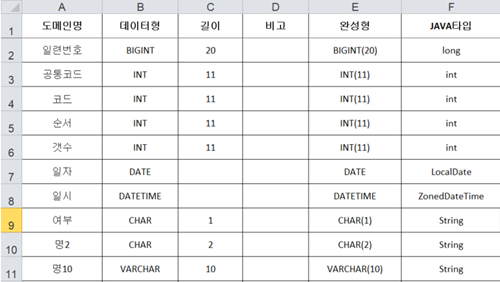
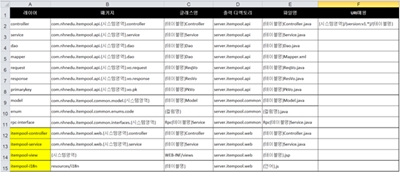
우리가 타이핑해야 하는 파일의 종류가 어떤 것들이 있는지 정리해 보면 다음과 같다. 물론 프로젝트의 성격과 시스템 설계 방향에 따라 사용하는 용어, 코딩하는 파일의 범위는 다를 수 있겠지만 대부분은 아래 범주를 벗어나지 않을 것 같다.
- DDL 구문을 담은 SQL 파일
- 사내 데이터베이스 정보 관리 플랫폼 등록 시, 사용할 테이블 대량 생성 요청용 엑셀 파일
- 코드 타입의 칼럼과 대응할 Enum 파일
- 각종 VO, DTO 파일들
- API 요청 / 응답 정보 VO
- 계층 간 자료 교환에서 사용할 DTO
- DB 테이블과 매핑되는 Entity
- RESTful API 개발 과정에서:
- Controller 클래스 파일 (@RestController)
- Service 클래스 파일 (@Service)
- DAO 클래스 파일 (@Repository)
- MyBatis XML 파일
- Junit 단위 테스트 파일 (@Test)
- Postman을 통해 API 테스트 할수 있는 Postman Collection 파일
- Web 페이지 개발 과정에서:
- Controller 클래스 파일 (@Controller)
- 목록 화면용 JSP 파일
- 등록, 수정용 JSP 파일
- 다국어 대응을 위한 i18 next용 언어별 메시지 파일
코드 템플릿을 작성할 때, 생각해야 하는 것들
우리는 코딩을 크게 2가지 측면에서 한다. 입력하는 코드의 작성과 출력하는 코드의 작성으로 나눌 수 있다. 코드 템플릿을 만들 때 주의 깊게 살펴야 할 부분이 바로 이 부분인데, 각 관점에서 반복적으로 나타나는 것이 무엇인지 패턴을 파악하는 것이다. 나를 정말 도와 줄 수 있는 것을 캐치해 내는 것이 중요하다.
출력의 관점에서는 웹 개발 프로젝트는 다양한 SQL 구문을 작성하게 된다. 특히 SELECT 구문을 다양하게 작성하게 되는데, 주로 검색 또는 필터와 관련된 부분이 있을 것이다. MyBatis를 사용하고 있다면 다이내믹 쿼리를 통해 코드 생산량을 줄일 수도 있겠지만, 성능 관리 관점에서 좋은 방법은 아니기 때문에 우리는 각 상황에 맞는 SELECT 쿼리를 작성하게 된다. 작성하는 SELECT 쿼리의 패턴이 아래와 같이 정리되었다.
- COUNT() 함수로 건수를 조회하는 SELECT 구문
- 해당 테이블의 총 건수를 구하는 SELECT 구문
- Primary Key 값이 존재하는지 확인하는 SELECT 구문
- Foreign Key를 참조하는 데이터 건수를 확인하는 SELECT 구문
- Unique Key 중복 여부를 확인하기 위한 SELECT 구문
- 특정 검색 항목으로 검색되는 데이터 건수를 확인하는 SELECT 구문
- 데이터 목록을 조회하는 SELECT 구문
- 해당 테이블의 전체 데이터를 조회하는 SELECT 구문
- 해당 테이블의 데이터를 특정 offset으로부터 limit 만큼 조회하는 SELECT 구문
- 해당 테이블의 데이터를 특정 칼럼으로 오름차순 정렬하여 조회하는 SELECT 구문
- 해당 테이블의 데이터를 특정 칼럼으로 내림차순 정렬하여 조회하는 SELECT 구문
- 특정 검색 항목으로 데이터를 조회하는 SELECT 구문
- 단일 데이터를 조회하는 SELECT 구문
- Primary Key 값으로 데이터를 조회하는 SELECT 구문
- Unique Key 값으로 데이터를 조회하는 SELECT 구문
물론, JPA와 같은 ORM을 사용하고 있다면 Named Query로 직접 코딩 없이 간단히 해결되기도 하는 부분들이다.
데이터의 입력의 관점에서 살펴보면, 유효성 검사를 넣게 된다. 기본적인 패턴 검사의 경우 더 앞 단의 컨트롤러 계층에서 처리되겠지만, 데이터 참조 정합성의 검사는 서비스 계층에서도 챙겨야 할 수 있다. 데이터 등록 또는 수정 처리하는 서비스 계층의 로직을 작성할 때, 기초 정보를 담은 테이블 명세서에서 Foreign Key로 정의된 칼럼에 대한 값 체크 로직을 생산하도록 템플릿을 작성한다면 직접 코딩해야 할 양을 또 줄일 수 있을 것이다.
public void register(DTO클래스명  DTO변수) {

  if (!{외래키 테이블에 대한 서비스 인스턴스}.existsBy외래키 ( DTO변수.get외래키() )) {
     throw new IllegalArgumentException(“외래키 값이 올바르지 않음.”);
}
    테이블에 대한DAO.insert(DTO변수);
}
스캐폴딩 도구를 만들면서, 단순히 입력하고 출력하는 것 외에도 실제 우리가 개발 구현 활동에서 챙기는 반복적인 코드나, 기능(가령, 목록 페이지에서 엑셀 파일 다운로드 처리하는 기능)도 템플릿 코드를 작성하여 생성되도록 하는 것을 고려한다면, 많은 코드 생산을 줄일 수 있을 것이다.
하지만, 주의할 것이 우리는 반복되는 코드를 복사, 붙여 넣기 하는 매크로를 만드는 것이 아니다. 그렇기 때문에 반복되는 코드라면 자동 생산해 내는 영역이 아니라, 개발자의 설계 영역에서 프레임워크까지는 아니어도 공통화된 코드 영역으로 분리하는 고민이 필요하다.
Code Generator에 의한 초벌 개발에 따른 장단점
Code Generator를 통해 기계적으로 개발 관련 파일을 생산해 냈을 때의 장단점이 있는데, 다음과 같다.
장점은 크게 3가지 정도 있었다.
첫 번째는 코드의 일관성이 유지된다. 협업 개발자들과 코드 리뷰 과정에서 집중해야 하는 부분이 비즈니스 로직에 더 초점이 맞춰진다. 정적 분석 도구에 의해 지적되는 부분들, 팀 내 합의된 네이밍/코딩 스타일 컨벤션의 준수 여부 등에 대해서는 이미 맞춰진 상태로 프로젝트 전체의 80% 이상의 코드가 생산되기 때문이다.
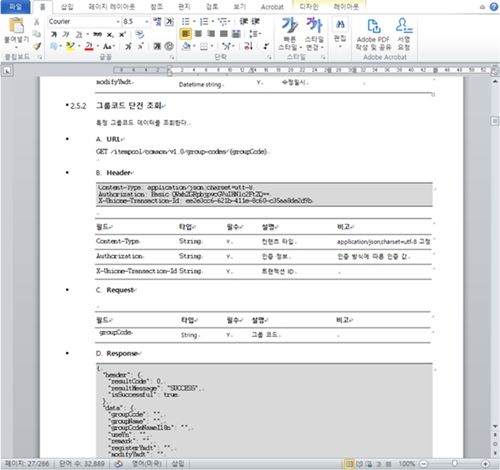
두 번째는 개발 관련 부수적인 문서(API 명세 등)나 다른 개발 도구(Postman용 Collection파일 등)에서 활용할 파일을 같이 생산하기 때문에 이러한 부분에서의 시간 단축이 있다. 실제 개발된 API의 개수는 200여 종이 넘었고 때문에 API 명세서 문서는 300페이지가 넘었다.
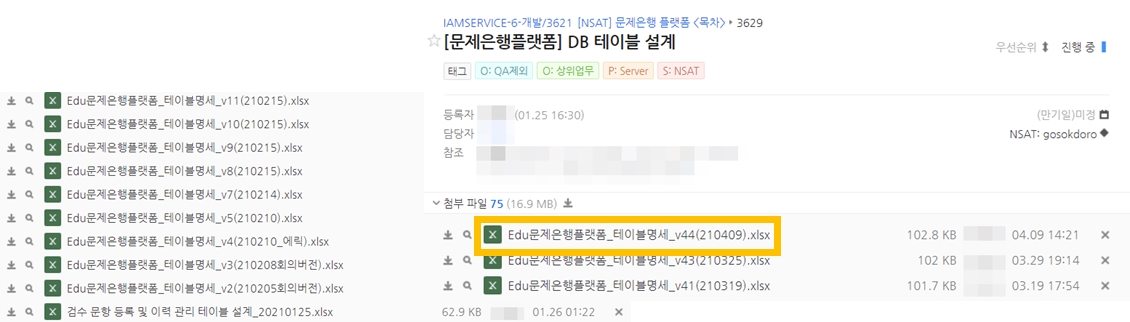
세 번째는 개발자가 좀 더 고급적인 기능 개발과 설계에 집중할 수 있다. 실제 Code Generator로 개발 진행하면서, DB 테이블 명세는 45차례 수정되었다. 오타가 있어서, 개념적으로 정의가 맞지 않아서, 관리되어야 하는 항목이 늘거나 줄어서 등의 다양한 이유로 설계 변경이 있었지만 구현 코드 변경에 부담이 적었다.
단점은 역설적 일지 모르겠지만 템플릿 파일을 생성하는 것에 어려움이 있다는 것이다. 시스템 설계에 좀 더 시간을 할애하는 만큼 개발 구현이 다소 늦어지는 것도 사실이다. 시스템을 신규로 구축하는 경우에는 틀이 갖춰져 있지 않기에 반복적인 부분에 대해 추상화하거나 여러 디자인 패턴 중에 적합한 것을 취사선택하며 공통화하는 작업이 병행된다. 때문에 대량 생산하는 파일 결과물을 보고 여러 차례의 리팩터링이 반복된다.
하지만, 한번 틀이 잡히면 이후부터는 코딩에 투입했어야 할 물리적인 시간이 급격히 단축된다.
Code Generator를 만들며 소소하게 신경 쓴 것들
최대한 개발자가 직접 생산하는 코드들의 코딩 스타일과 유사해야 했고, 코드 리뷰 과정에서 우리가 토의하고 합의한 내용이 녹여져 있어야 했으며, SonarQube 같은 정적 분석 도구가 지적하는 것들은 사전에 생산해내지 않기 위해 노력을 했다.
몇 가지 예시는 다음과 같다.
첫 번째는 사용자 정보를 담는 VO 클래스의 명칭이 UserVO였다고 했을 때, 사용자 목록을 조회 후 담는 변수의 명칭은 userVOList가 아닌 users였으면 했다. 그래서 VO라는 suffix는 제거하고 단어를 복수(pluralize)로 만드는 작업을 했다.
두 번째는 i18n 메시지를 생성할 때, 각 나라 별 언어의 특성에 맞게 처리하고자 노력했다. 한국어의 경우 특정 컬럼의 값이 올바르지 않다는 메시지를 생산할 때 “(은)는” 등과 같이 병기 표기하는 것이 싫어, 조사를 앞에 따르는 단어의 종성 여부에 따라 조사를 변화하도록 처리했다. 종성이 있다면 이/은/을/과가 붙고 종성이 없다면 가/는/를/와가 붙는 식이다.
세 번째는 테이블 명세에서 데이터 도메인을 세분화하여, 도메인에 따라 대응되는 비즈니스 로직도 다양하게 처리하려고 했다. 가령, 데이터 타입은 int이지만, 데이터 도메인은 ‘공통 코드’로 명명했다. FE영역의 등록/수정 화면에서 코드를 선택하는 부분을 목록 중에서 선택할 수 있도록 FE 로직을 구현하는데 참조했다. BE 로직에서는 ‘공통 코드’를 Enum으로 정의하였기에 DB형은 int지만 Enum으로 변수형이 참조될 수 있도록 하였다.
데이터 도메인을 세분화를 잘하면, Code Generator 관점의 이점이 생각보다 많다. 가령 정보 입력 페이지에서 ‘일련번호’ 도메인으로 정의된 외래 키에 해당하는 항목을 입력하는 폼이 있다면, ‘우편번호 찾기’처럼 페이지 내 모달을 띄워 검색 후 선택 값이 입력되게끔 만들 수 있다.
네 번째는 현재 사용자의 일련번호라던가, 테넌트의 일련번호 같은 정보를 서비스 계층으로 전달하는 DTO가 존재한다면 해당 DTO의 Setter를 통해 그 값이 채워지도록 코드가 삽입되도록 했다.
다섯 번째는 이번 프로젝트는 MyBatis를 사용하고 있기 때문에 SELECT 쿼리를 생성할 때, 테이블 간의 관계에 따라 JOIN 구문을 적절히 생성하게 했다. Not null 칼럼의 외래 키 값은 INNER JOIN 구문으로, nullable 칼럼의 외래 키 값은 LEFT JOIN 구문으로 작성하고 JOIN 순서를 조정한다.
Code Generator를 직접 만들지 않더라도 참고해 보면 좋은 것들
최근의 개발은 MSA로 진행되면서 HTTP 통신을 기반으로 구현되는 경우가 많고, 때문에 주로 JSON 전문을 주고받으며 관련된 DTO를 코딩하는 것도 일이 되고 있다. 앞서 언급되었지만 세상에는 다양한 Code Generator가 많고 이것을 적절히 활용하는 것도 도움이 된다.
- JSON 스키마 혹은 JSON 전문을 기준으로 POJO를 만들어주는 사이트: http://www.jsonschema2pojo.org/
- DB 스키마를 읽고 POJO를 생성해 주는 IntelliJ IDE 플러그인: https://plugins.jetbrains.com/plugin/12297-pojo-generator
- GUI 기반으로 SQL 쿼리를 만들 수 있는 사이트: https://wtools.io/generate-sql-create-table
- JSON 전문을 GUI 기반에서 수정할 수 있는 사이트: https://www.jeremydorn.com/json-editor
- 자바스크립트 기반으로 스캐폴딩 개발을 지원하는 도구: https://yeoman.io/
에필로그
이번에 Code Generator를 통해 개발하게 된 프로젝트는 NSAT 서비스의 근간이 되는 ‘문제은행 CMS’ 시스템이다. 작년에 만든 시스템을 보다 범용적이게 확장하고, 다국어 대응이 안되고 있는 부분을 개선하는 과업이다. 특정 평가 콘텐츠 영역에 편향된 구조로 설계되어 있는 것을 범용적으로 변경하다 보니, 결국 DB 테이블 변경이 많이 발생했고, 리팩터링 하는 것보다 새로 개발하는 편이 더 낫겠다는 판단에서 동료들과 큰 모험을 감행했다.
한정적인 시간 내에 어떻게 개발을 하는 것이 좋을까 고민하던 과정에서 채택한 개발 방법론이 바로 Code Generator(스캐폴딩 도구)를 활용하는 방법이었다. 이것을 Code Generator Driven Development라 부를까, AI Driven Development라 부를까 유치한 생각도 해본다.