Frontend
자바스크립트 엔진의 최적화 기법 (2) - Hidden class, Inline Caching
2016년 4월 18일
원문에서 보기 ↗자바스크립트 엔진의 최적화 기법 (2) - Hidden class, Inline Caching
목 차
- Prototype vs Class
- Hidden classes
- 하지만 성능이 문제
- Inline Caching
- 결론
1. Prototype vs Class
자바스크립트는 기본적으로 클래스가 없습니다. 대신 프로토타입이라는 개념이 있어 ‘객체들간의 상속’을 구현할 수 있습니다. 모든 것이 객체로 취급되기 때문에 어찌 보면 자바스크립트는 다른 클래스 기반 언어보다 더 OOP 언어에 가깝다고도 볼 수 있지만, 사실 프로토타입을 기존 개념의 클래스보다 효과적으로 쓸 수 있는지는 의문입니다. (물론 제가 경험이 부족해서 그렇게 느끼는 걸 수도 있지만요)
어쨌든 자바스크립트는 프로토타입 기반 언어이기 때문에 클래스 기반 언어와 달리 컴파일러 입장에서 특별히 신경 써 주어야 할 것이 하나 더 있습니다. 그것은 바로...
필드 구조
클래스 기반 언어의 경우 같은 클래스에 속한 객체들은 모두 같은 필드 구조를 가집니다. 따라서 어떤 객체의 특정한 멤버 변수에 접근할 때, 어떤 변수에 접근하는지, 메모리의 어느 위치를 참조하면 되는지를 수행하기 전 컴파일 타임 때 미리 알 수가 있습니다.
예를 들어 A라는 클래스의 객체들은 x,y라는 필드를 가지고 있고, A 타입의 객체들을 만들 때 변수 x는 A가 저장된 위치의 0번 offset, 변수 y는 A가 저장된 위치의 1번 offset이라고 미리 정해 놓는다면, 컴파일하면서 a.x에 접근하는 녀석은 [a + offset(x)], a.y에 접근하는 녀석은 [a + offset(y)]의 메모리 값을 읽어오도록 주소값으로 대체해서 코드를 생성하면 됩니다.
상속을 생각하더라도 상속받은 녀석이 부모 클래스의 멤버 변수를 없애는 일은 없기 때문에 추가되는 녀석들을 뒤에 붙이면 문제가 생기지 않습니다. (물론 멤버 함수의 경우에는 다형성이 있기 때문에 이야기가 달라집니다.)
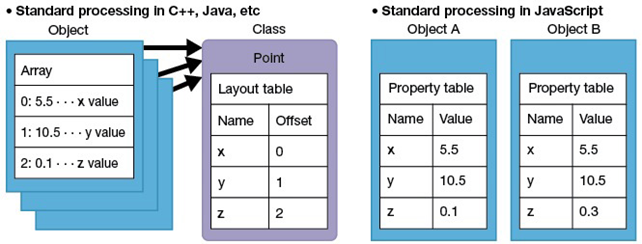
(출처: Google V8 - Hidden classes)
위 그림이 클래스 기반 언어와 자바스크립트의 차이를 가장 잘 보여주는 그림이라 할 수 있습니다. 클래스 기반 언어(왼쪽)는 오프셋 값만으로 모든 멤버 변수에 접근할 수 있지만, 자바스크립트(오른쪽)는 수행 중간에 필드 구조가 변경될 수 있기 때문에 기본적으로 [프로퍼티 이름 + 값] 세트를 모든 객체가 들고 있어야 합니다. 만약 객체 100개를 생성했는데, 100개가 모두 같은 필드 구조를 가지고 있다 해도 언제 바뀔 지 모르기 때문에 계속 저 테이블을 들고 다녀야 합니다. 중복해서 나타나는 멤버 변수 이름을 다 가지고 있기 때문에 일단 메모리는 당연히 문제가 되고, 더불어 성능에도 문제가 생깁니다 (이 부분은 나중에 설명드리겠습니다). 뭔가 대책이 필요합니다.
2. Hidden classes
이러한 문제를 멋지게 해결한 것이 hidden class라는 개념입니다. 이름에서도 알 수 있듯이 비록 자바스크립트에는 클래스가 없지만, 엔진 안쪽에 숨겨진 클래스 개념을 두는 최적화 기법입니다.
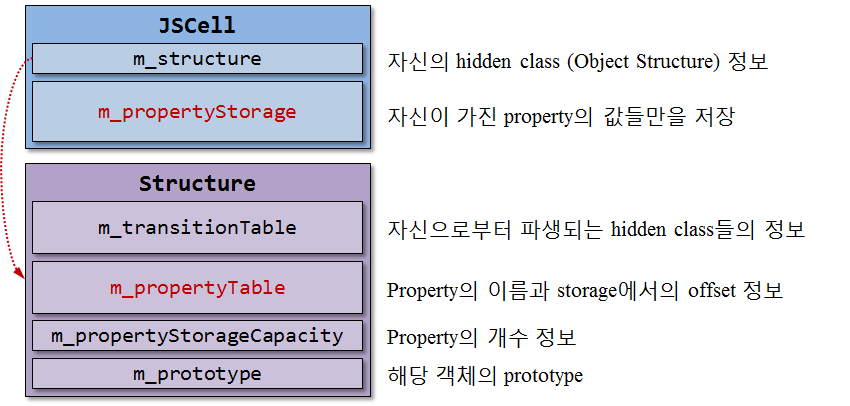
위 그림은 WebKit의 JavaScriptCore 엔진의 hidden class 관련 내부 자료구조입니다. 쉽게 표현하자면 JSCell은 오브젝트를 담는 자료구조이고, Structure는 hidden class 자료구조입니다. (위 그림은 옛날 버전(2009년쯤)의 코드에서 참고한 것이지만, 현재도 크게 다르지 않습니다.)
JSCell만 놓고 보면 기존 클래스 기반 언어의 방식과 유사해 보입니다. 실제 프로퍼티 값들만을 저장하고, 대신 자신이 (현재) 속한 hidden class에 대한 포인터를 가지고 있습니다.
구조는 조금 복잡한데, m_propertyTable은 현재 나를 hidden class로 가지고 있는 오브젝트들이 어떤 필드 구조를 가지고 있고, 각각의 필드가 어느 오프셋에 저장되어 있는지를 나타내는 테이블입니다. 객체의 멤버 변수를 참조할 때 이 테이블을 참조함으로써 어떤 위치의 값을 읽으면 되는지 알아낼 수 있는 것입니다. (여기서 눈치가 빠르다면 어? 더 비효율적인거 아닌가? 생각할 수 있습니다. 하지만 다음 챕터가 있습니다)
그리고 필드 구조가 런타임에 변할 수 있다라는 요구조건을 만족시키는 것이 바로 m_transitionTable입니다. 중간에 객체의 필드 구조가 변한다면 이 테이블을 참조하여 객체가 다른 히든 클래스로 옮겨가거나 혹은 새로 생성하게 됩니다.
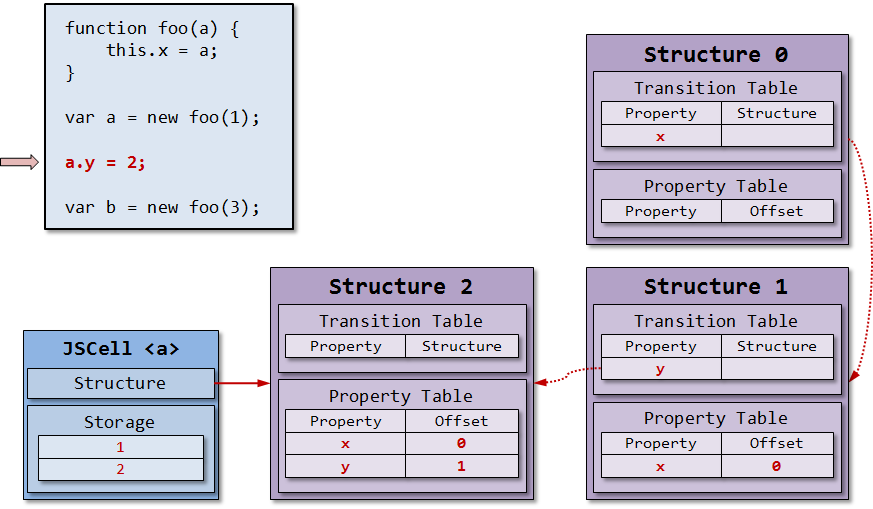
왼쪽 위의 코드에서 a.y = 2 부분이 수행되고 나면 히든 클래스가 위 그림과 같이 형성되는데, 그 과정은 다음과 같습니다.
- 아무 필드가 없는 객체는 [Structure 0]을 참조한다.
- a에 x 필드가 추가되면서, [Structure 1]이 생성되고, 프로퍼티 테이블에 x(offset = 0)가 추가된다.
- [Structure 0]의 트랜지션 테이블에 x가 추가된다. 앞으로 [structure 0]을 가리키는 객체에서 x라는 필드가 추가된다면, 트랜지션 테이블을 참조하여 [Structure 1]로 옮겨가게 된다.
- a.y = 2가 수행되면서 y라는 필드를 추가하려고 한다. x때와 마찬가지로, [Structure 2]를 만들고, [Structure 1]에 y가 추가되는 경우에 대한 링크를 만든다.
- 최종적으로 a는 [Structure 2]를 가리키고 있으므로, x에 접근할 때는 offset 0번을, y에 접근할 때는 offset 1번을 가져다 쓰면 된다.
여기에서 마지막 코드인 var b = new foo(3) 이 수행되면 아래와 같은 상태가 됩니다.
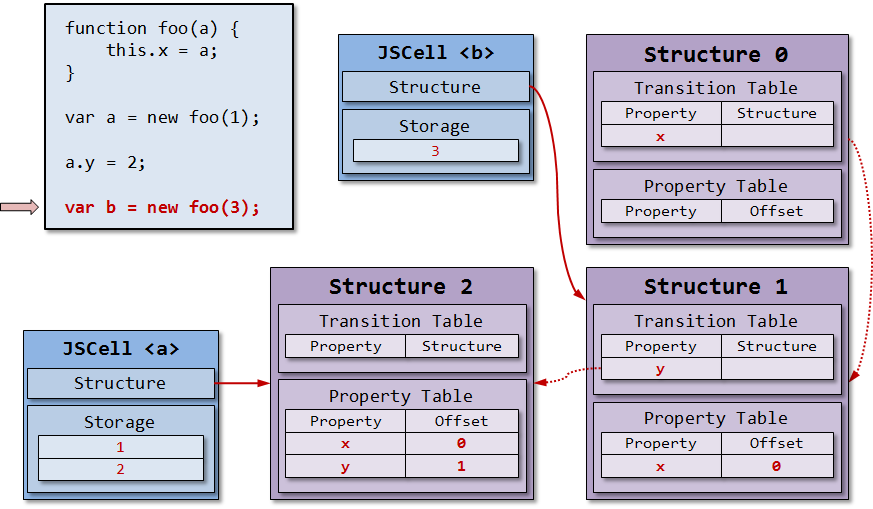
- b가 처음 만들어지면서 [Structure 0]을 가리키는데, x 프로퍼티가 추가된다.
- [Structure 0]의 트랜지션 테이블을 보니 x가 추가될 때의 링크가 있기 때문에, b의 히든 클래스를 [Structure 1]로 변경한다.
- 만약 여기서 b.y를 추가한다면 [Structure 2]를 가리키도록 변경될 것이다.
- 만약 여기서 b.z를 추가한다면 새로운 [Structure 3]을 만들 것이고, [Structure 1]의 트랜지션 테이블에 z가 추가될 것이다.
3. 하지만 성능이 문제
Hidden class를 쓰게 되면 같은 필드를 가지는 객체가 많아질 경우 메모리는 확실히 세이브가 될 수 있습니다. 하지만 실제 필드에 접근해서 값을 가져오려면 객체->hidden class->프로퍼티 테이블->프로퍼티 비교->[오브젝트 + 오프셋] 위치로 접근이라는 단계를 거쳐야만 실제 필드에 접근할 수가 있게 됩니다.
Hidden class가 없다 하더라도 프로퍼티 비교 단계를 거쳐야 하기 때문에 실제로는 hidden class에 접근하는 오버헤드만 추가되는 것이지만, 어떤 프로그램이든 사실상 객체의 필드에 값을 넣었다 뺐다 하는게 전부(는 아니고 거의 대부분)입니다. 하나의 추가 동작이지만 그것이 필드 접근이라면 전체적인 성능에 큰 영향을 미치게 되는 것이지요.
하지만, hidden class는 추진력을 얻기 위해 무릎을 굽히는 것일 뿐. 모든 과정은 inline caching을 위한 준비입니다.
4. Inline Caching
객체 필드에 접근을 할 때 hidden class를 사용한다면 결국 우리가 얻고 싶은 것은 접근하려는 필드의 오프셋 값입니다. 간단히 말하면 인라인 캐싱은 이 오프셋 값을 캐싱하겠다는 이야기입니다.
인라인 캐싱이야말로 자바스크립트 엔진의 최적화 철학이 가장 잘 드러나는 방법인데, 다음과 같은 두 가지 가정이 바탕에 깔려 있습니다.
- 동적인 언어라고 해봤자 실제로는 안바뀌는게 더 많다
- 성능을 빠르게 하려면 딴 거 다 필요없고 루프를 노려라
두 가지 모두 예전 포스팅이었던 adaptive JITC 최적화에서 언급했던 내용이지만 인라인 캐싱에서도 똑같이 적용됩니다. 첫 번째 포스팅참고.
객체의 필드 구조가 런타임에 의해 변경될 수 있지만, 실제로는 자주 발생하지 않고, 더군다나 루프 안에서 변할 일은 거의 없을 것입니다. 이 가정이 맞다면 인라인 캐싱은 높은 효율을 보여줄 것이고, 실제로 벤치마크를 돌렸을 때 인라인 캐싱 적용 유무가 엄청나게 큰 차이를 보이게 됩니다.
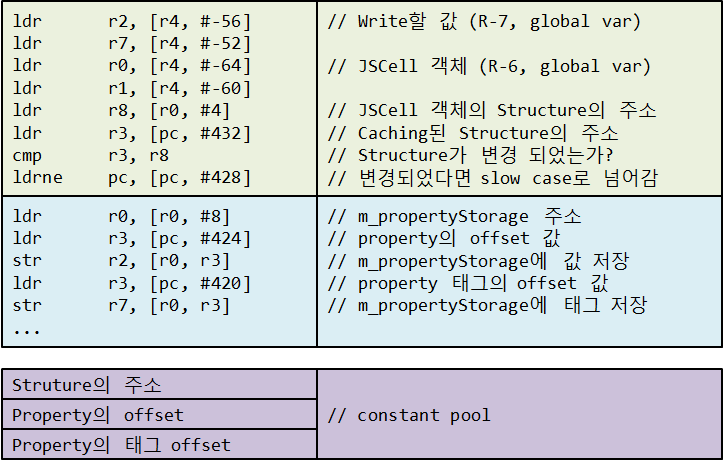
위 그림은 JavaScriptCore bytecode중 하나인 put_by_id, 그러니까 객체의 필드에 값을 쓸 때 생성되는 네이티브 코드입니다.
자세히 보면 머리아프니까 (이미 hidden class에서 머리가 아팠겠지만...) 간단하게 보면,
- 처음 수행되었을 때에는 캐싱된 값이 없으므로, slow case (핸들러 함수, 비효율적)로 실행함. 이 때 찾은 오프셋 값과 히든 클래스(structure)를 constant pool 영역에 캐싱한다.
- 다음번에 같은 필드에 접근할 때 캐싱된 structure와 현재 객체가 가리키는 structure의 주소값을 비교한다.
- 만약 같다면 캐싱된 프로퍼티의 오프셋이 유효하다는 의미이므로, 아래쪽 코드 (파란색 영역)를 수행해서 바로 필드에 값을 저장한다.
- 만약 다르다면 필드 구조가 달라졌다는 의미이므로, 오프셋 값이 무효가 됨. 이 경우에는 slow case 로 넘어가서 다시 캐싱하거나 아예 캐싱을 포기하도록 변경한다.
실제로 적용되는 예제를 보면,
for (var i=0; i<10; i++) {
   arr[i].x = i;
}
위의 .x 부분에서 inline caching이 이루어지는 것입니다. 첫 번째 iteration(i=0)에서는 캐싱된 값이 없기 때문에 slow case로 실행이 되고, arr[0]의 structure와 arr[0].x의 오프셋 값이 캐싱됩니다. 그런 다음 두 번째부터 마지막까지는 캐싱된 오프셋 값을 바로 쓸 수 있기 때문에 클래스 기반 언어와 똑같은 성능을 보이게 됩니다.
단, arr[1]부터 arr[9]까지 모두 같은 필드 구조를 가지고 있어야만 성립되는 이야기입니다. 따라서 arr에 서로 다른 필드 구조를 가지는 객체가 이것저것 섞여서 들어있다던가, 아니면 저 코드가 arr에 든 오브젝트에 새로운 x 필드를 추가해 주기 위해 작성된 코드라던가 하는 경우에는 인라인 캐싱의 혜택을 전혀 못 받게 됩니다. (오히려 더 손해를 보게 됩니다)
한 가지 덧붙이자면, 간략한 설명을 위하여 첫 번째 수행에서 바로 캐싱을 한다고 말씀드렸지만, 정확하게는 두 번째 수행부터 캐싱을 합니다. 왜냐하면 한 번 수행된 코드는 한 번만 수행될 가능성이 높지만, 두 번 수행된 코드는 이후에 더 수행될 확률이 높기 때문입니다. (이것 역시 컴파일러 최적화 분야에서 자주 적용되는 기본 가정입니다.) 즉, 한 번만 수행되는 코드에 대해서는 캐싱을 해 봤자 의미가 없으므로 안 하는게 낫습니다.
5. 결론
인라인 캐싱이 적용되려면 루프 안에서 필드 접근을 하려는 객체가 모두 같은 hidden class를 가리키고 있어야 합니다. 루프 안에서, 루프 중간에 객체의 필드 구조를 바꾸게 되면 좋지 않지만 실제로 이렇게 구현할 일은 거의 없을 것입니다. 그러므로 우리가 신경쓸 수 있는 부분은 위 예제 코드처럼 배열 내의 객체들을 반복해서 접근할 때, 하나의 배열 안에는 모두 같은 필드 구조를 가지는 (같은 hidden class를 가지는) 객체들만 넣어서 접근하도록 해 주는 정도가 될 것 입니다.
결국 지난 포스팅과 같은 결론에 도달했네요. 성능이 좋은 자바스크립트 프로그램을 만들고 싶다면, 자바스크립트를 정적인 언어라고 생각하고 쓰는 것이 좋습니다. 동적인 특성들을 최대한 활용하여 멋지고 파워풀한 코드를 작성할 수도 있지만, 거기엔 항상 성능이라는 대가가 따른다는 것을 명심해야 합니다.