Engineering
우리 팀만의 vLLM 플러그인 만들기 1편 - 검색 AI 모델 서빙 성능 극대화하기
2026년 8월 11일
원문에서 보기 ↗네이버 플레이스 AI MLOps는 지난 1년간 검색과 추천에 사용하는 스코어링 모델의 서빙 구조를 vLLM 기반으로 전환했습니다. 이 글에서는 사내 Engineering Day에서 발표한 내용을 바탕으로, 모델 서빙 경로를 최적화해 성능을 높인 과정을 소개합니다.
먼저 결과부터 살펴보겠습니다. 0.6B 재순위화(reranking) 모델을 Hugging Face Transformer.encode로 서빙했을 때 처리량은 63.85 QPS였습니다. 같은 모델과 GPU, 입력을 사용하면서 vLLM의 score 태스크로 옮기자 397.21 QPS로 약 6.2배 증가했습니다. 속성 기반 감성 모델(ABSA, Aspect-Based Sentiment Analysis)의 단건 p50 지연 시간은 101.22ms에서 16.43ms로 83.8% 감소했고, CLIP 기반 이미지 랭킹 모델의 처리량은 최적화를 다섯 단계 적용하자 3.76 img/s에서 62.2 img/s로 누적 16.5배 증가했습니다.
모델은 한 줄도 더 빠르게 만들지 않았는데 어떻게 이런 차이가 났을까요? 저희가 찾은 지점은 두 군데였습니다. 하나는 모델의 순전파를 실행하는 런타임 자체의 효율이고, 다른 하나는 순전파 앞뒤의 요청 경로입니다. 모델을 vLLM 사용자 정의 모델로 구현해 풀링 런타임에 올리고, 전처리와 후처리를 IO Processor 안으로 옮겼습니다. 그리고 이 결과물을 플러그인 패키지로 만들어 pip install 한 번으로 설치할 수 있도록 배포했습니다.
어디서 성능이 새고 있었나
검색·추천 모델의 작업 특성은 생성형 LLM과 다릅니다. 생성 모델은 한 요청에서 토큰을 길게 생성하므로 토큰당 지연 시간과 KV 캐시 관리가 중요합니다. 반면 재순위화, 감성 분석, 이미지 스코어링 모델은 입력이 짧지만 한 번의 검색 요청에서 후보 수십~수백 개를 함께 평가해야 합니다. 검색 응답 흐름 안에서 실행돼야 하므로, p95 지연 시간 예산(latency budget)도 수십 ms 수준으로 매우 제한적입니다.
기존 구조에서는 모델마다 별도의 추론 경로를 운영했습니다. 검색 백엔드에서 시작한 요청이 애플리케이션 서버, 전처리 서비스, 모델 서버, 후처리 서비스, 랭킹 서비스를 차례로 거쳤고, 모델이 늘어날 때마다 이 경로가 하나씩 복제되었습니다. 그 결과 전후처리 로직은 여러 서비스에 흩어지고, 배포와 운영은 모델별로 파편화되고, 모델 하나를 바꿀 때마다 API 스키마와 전처리, 배포가 같이 흔들렸습니다.
지연 시간 예산이 어디서 무너지는지 분석해 보니, 의외로 원인은 모델의 순전파(forward) 처리가 아니라 그 주변에 있었습니다.
- 여러 네트워크 구간을 지나는 비용
- JSON과 텐서의 직렬화 비용
- 토크나이저와 모델 서버가 분리되면서 발생하는 추가 왕복
- 작은 요청이 여러 경로로 흩어져 배치를 충분히 구성하지 못하는 문제
서비스가 나뉜 만큼 장애 지점도 늘어나 폴백과 타임아웃 정책을 일관되게 유지하기 어려웠습니다. 결국 모델 최적화가 아니라 경로 최적화의 문제였습니다. 개선해야 할 대상은 모델 하나가 아니라, 순전파를 실행하는 런타임과 그 앞뒤를 연결하는 전체 경로였습니다.
vLLM 풀링 런타임으로 모델 실행 구조 통합
vLLM은 주로 생성형 모델을 위한 엔진으로 알려져 있지만, 핵심에는 Transformer의 은닉 상태를 효율적으로 처리하는 런타임이 있습니다. 생성은 이 런타임에 샘플링 계층을 결합한 하나의 사용 방식일 뿐이고, 같은 런타임을 풀링 관점에서는 은닉 상태를 임베딩, 분류 확률, 토큰 점수와 같은 출력으로 바꾸는 시스템이라고 볼 수 있습니다.
검색·추천 모델에서 원하는 출력이 바로 이것이었기 때문에, 감성 분석, 재순위화, 이미지 랭킹 모델을 전부 vLLM 사용자 정의 모델로 구현해 같은 풀링 런타임 위에서 실행하기로 했습니다. 이는 하나의 vLLM 프로세스가 여러 모델을 동시에 서빙한다는 뜻은 아닙니다. 모델별로 서빙 인스턴스를 실행하되 런타임, 기본 이미지, 플러그인 패키지, 배포 방식을 공유하는 것입니다.
이 구조의 핵심 이점은 vLLM이 제공하는 연속 배치(continuous batching, 들어온 요청을 실행 가능한 시점마다 동적으로 묶어 처리하는 스케줄링 방식), CUDA Graph(반복되는 GPU 작업을 캡처해 커널 실행 오버헤드를 줄이는 기능), 최적화된 어텐션 백엔드, 페이지 단위 GPU 메모리 관리와 같은 런타임 최적화를 그대로 활용할 수 있다는 점입니다. 모델별 서버를 따로 만들면 이런 최적화를 매번 처음부터 다시 쌓아야 하지만, 같은 런타임 위에서는 모든 모델이 공유하는 자산이 됩니다.
풀링 모델의 구성
입력 토큰을 트랜스포머에 통과시키면 각 토큰 위치에 대응하는 은닉 상태가 생성됩니다. 풀링은 이 은닉 상태를 목적에 맞게 선택하거나 집계해 모델의 출력으로 만드는 과정입니다. vLLM 풀링 모델의 출력 동작은 무엇을 반환할지 정하는 태스크와 은닉 상태를 어떻게 선택하거나 집계할지 정하는 풀링 방식에 의해 주로 결정됩니다.
- 태스크:
embed,classify,token_embed,token_classify - 풀링 방식: CLS(BERT 계열의 첫 토큰), LAST(인과적 모델의 마지막 토큰), MEAN(평균), ALL(전체), STEP(특정 토큰)
vLLM 코드를 직접 열어보면 이 구조가 꽤 단정하게 분리되어 있다는 것을 알 수 있습니다. 내부에서 CLSPool은 hidden_states[cursor.first_token_indices_gpu] 한 줄로 첫 토큰의 은닉 상태를 선택하고, MeanPool은 index_add_로 구간별 합계를 누적한 뒤 프롬프트 길이로 나눕니다. 가변 길이 배치에는 GPU와 CPU가 불필요하게 동기화되지 않도록 구간 ID를 CPU에서 만들고 비동기로 전송하는 처리가 포함돼 있는데, 직접 구현한다면 매번 다시 만들어야 하는 부분입니다.
풀링 결과는 다시 출력 헤드를 통과합니다. 임베딩 헤드는 차원 투영과 정규화를, 분류 헤드는 (logit − μ) / σ 형태의 점수 보정과 활성화 함수를 담당합니다.
즉, vLLM의 SequencePooler는 다음과 같은 두 단계로 이해할 수 있습니다.
pooled = pooling(hidden_states)
pooled = head(pooled)
이렇게 분리된 덕분에 얻는 자유는 생각보다 큽니다. 모델의 순전파는 유지하면서 풀링 방식과 출력 헤드만 바꾸면 같은 백본으로 재순위화 모델, 분류 모델, 임베딩 모델을 구성할 수 있습니다.
참고로 재순위화 모델은 num_labels=1인 classify 태스크의 교차 인코더 스코어링 모델로 표현할 수 있습니다.
GPU 커널에서 실제로 벌어지는 일
막연히 vLLM에 올리면 빨라진다고만 하면 허황된 소리처럼 들립니다. 그래서 같은 모델, 같은 입력을 Hugging Face Transformer.encode 경로와 vLLM score 태스크 경로에서 각각 실행하고, NVIDIA Nsight Compute로 GPU 커널 단위에서 비교했습니다.
측정에는 0.5B 재순위화 모델과 H100 GPU(CUDA 12.8)를 사용했습니다. ncu --set full 커널 재실행 모드에서 준비 구간의 커널 실행 3만 회를 제외하고, 안정 상태의 커널 200개를 집계했습니다. vLLM은 vllm serve에 연속 부하를 주어 실제 서빙과 유사한 상태에서 측정했습니다.
| 지표 | Hugging Face encode | vLLM score |
|---|---|---|
| 전역 메모리 명령 수 | 7.07M | 262K(약 27분의 1) |
| 공유 메모리 명령 수 | 18.19M | 5.57M |
cp.async | 0 | 3.24M |
| L2 적중률 | 95.63% | 99.17% |
가장 큰 차이는 전역 메모리 명령 수였습니다. vLLM 경로에서는 GPU 커널이 전역 메모리에 발행한 명령이 약 27분의 1로 줄었습니다. 같은 일을 단순히 더 빠르게 처리한 것이 아니라, 더 적은 커널 실행으로 처리한 것입니다. 작은 순전파 여러 번이 큰 타일 단위의 행렬 곱셈 한 번에 흡수됐다는 직접적인 증거입니다.
Hugging Face 경로에서는 사용하지 않던 cp.async도 vLLM 경로에서 3.24M회 실행됐습니다. cp.async는 Ampere 세대부터 도입된 명령으로, L1 캐시를 거치지 않고 전역 메모리의 데이터를 공유 메모리로 직접 옮깁니다. 이 경로가 Tensor Core 파이프라인과 결합하면서 행렬 곱셈 처리량을 높입니다. 다만 L1/TEX 적중률만 보면 캐시 효율이 나빠진 것처럼 보일 수 있습니다. 측정에서 이 값은 0.11%에서 0.00%로 낮아졌지만, 이는 L1을 의도적으로 우회하고 cp.async와 L2 재사용을 활용했기 때문입니다.
정리하면 vLLM이 빠른 이유는 특정 어텐션 커널 하나의 차이 때문이 아니라, 배치 안에서 같은 연산을 더 적은 커널 실행과 더 효율적인 메모리 경로로 다시 배치했기 때문입니다. 수식이 같아도 커널 배치는 다릅니다.
IO Processor로 전후처리 경로 통합
런타임을 개선해도 전후처리 경로가 그대로라면 전체 지연 시간은 충분히 줄어들지 않습니다. vLLM의 IO Processor를 사용하면 전처리 서비스, 토큰화, 모델 서버, 후처리 서비스로 이어지던 요청을 하나의 풀링 엔드포인트에서 처리할 수 있습니다.
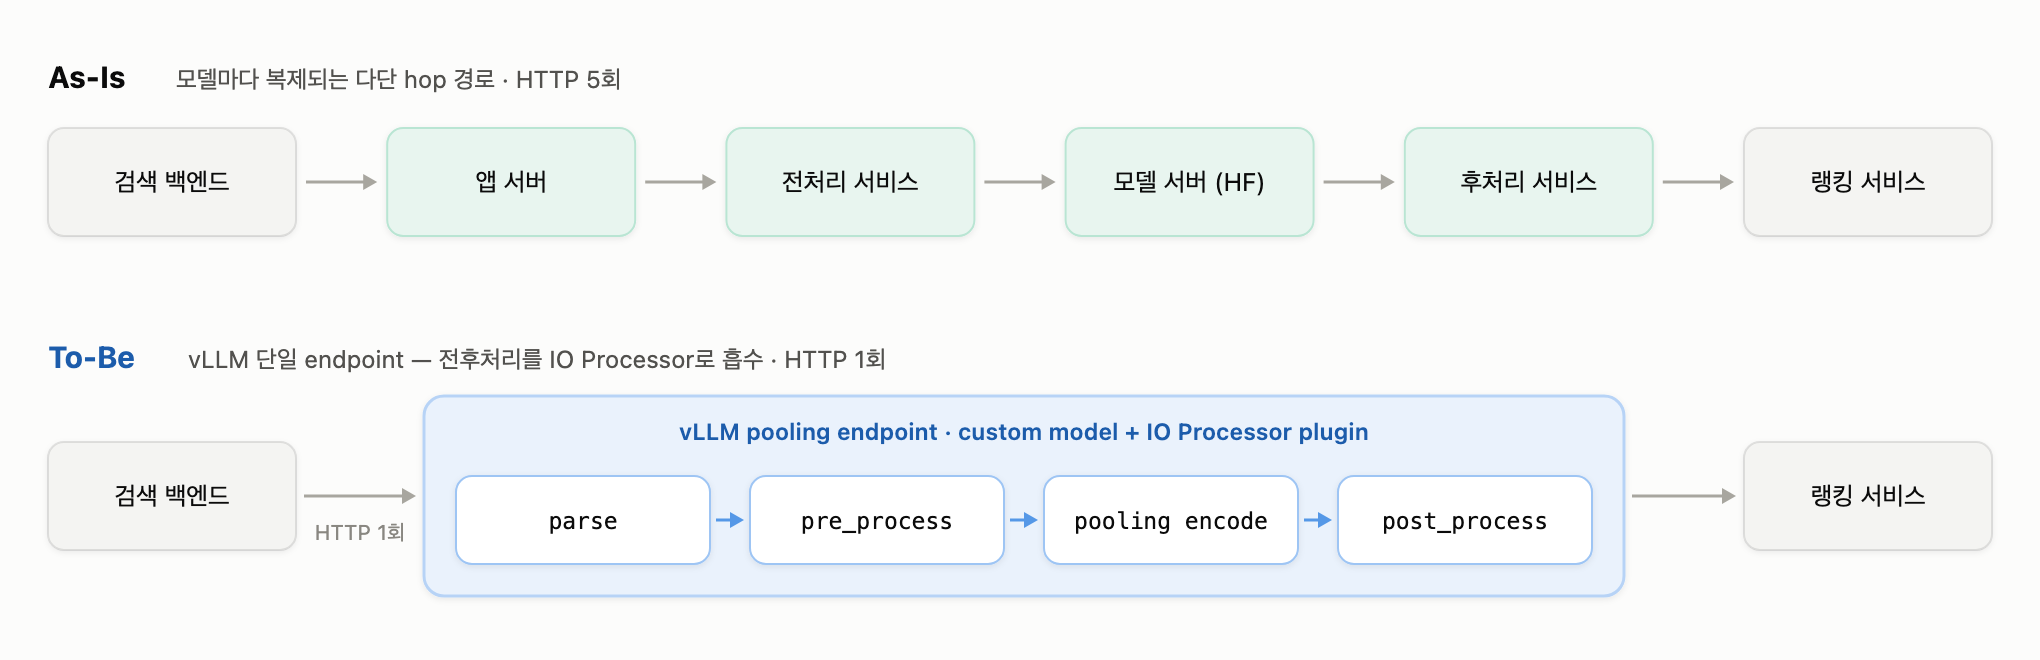
기존 다단계 서빙 경로와 IO Processor를 적용한 단일 엔드포인트 구조
네트워크 구간과 직렬화 비용이 줄고, 토크나이저가 모델과 결합되며, 여러 요청을 하나의 배치로 모을 기회도 늘어납니다. 장애 지점과 모니터링할 지점도 단순해집니다. 이는 개별 구간을 조금씩 줄이는 최적화가 아니라 지연 시간의 하한 자체를 낮추는 구조적 변화입니다.
vLLM 공식 문서에 따르면, 요청은 다음의 다섯 단계를 거칩니다.
parse_data(data): HTTP 본문과 같은 외부 객체를 플러그인 입력 형식으로 변환합니다.merge_pooling_params(params): 매개변수가 없으면PoolingParams(task="plugin")을 생성합니다.pre_process(prompt): 입력을 vLLM 엔진이 처리할 수 있는 프롬프트로 변환합니다.- vLLM 엔진이 풀링 추론을 실행합니다.
post_process(model_output): 모델 출력을 서비스 응답 형식으로 변환합니다.
속성 기반 감성 모델의 IO Processor를 예로 들면, pre_process에서 tokenizer(aspect, review)를 호출해 [CLS] aspect [SEP] review [SEP] 형식의 입력을 만듭니다. 이어서 요청 단위 캐시에 input_ids를 저장하고, prompt_token_ids 형태로 vLLM에 전달합니다. 핵심은 vLLM이 알 필요 없는 비즈니스 토큰화를 pre_process 안에서 모두 처리하는 것입니다.
출력 쪽에는 구현할 때 반가운 세부 동작이 하나 있습니다. 비동기 처리에서는 출력 순서가 요청 순서와 다를 수 있는데, post_process_async의 기본 구현이 ID를 기준으로 출력을 정렬한 뒤 동기 방식의 post_process를 호출합니다. 덕분에 IO Processor를 구현할 때는 동기 방식의 post_process만 신경 쓰면 됩니다.
단, 주의해야 할 점도 있습니다. pre_process에서 요청 단위 캐시에 넣은 값은 post_process에서 반드시 pop으로 제거해야 합니다. 이를 누락하면 장시간 실행되는 파드에서 메모리 사용량이 계속 늘다가 몇 시간 뒤 OOM으로 이어질 수 있습니다. 저희가 겪은 사고 가운데 가장 흔한 유형이었습니다.
전후처리 통합이 항상 유리한 것은 아닙니다. 전후처리를 런타임 안으로 가져오면 그 CPU 부하도 GPU 파드 안으로 들어옵니다. 이미지 디코딩처럼 CPU 사용량이 큰 작업은 GPU가 입력을 기다리게 해 오히려 성능을 낮출 수 있습니다. 뒤에서 살펴볼 이미지 랭킹 모델에서도 전처리 worker 수를 늘렸더니 GIL과 CPU 경합 때문에 처리량이 낮아졌습니다. 네트워크 구간을 합치면 폴백과 타임아웃의 단위도 함께 합쳐져 장애 반경이 넓어질 수 있습니다. 그래서 저희는 토큰화처럼 가벼운 전처리는 바로 통합하고, CPU 비용이 큰 전처리는 병렬 처리 수준을 측정하고 조정한 뒤 통합했습니다.
세 가지 모델에서 확인한 성능 개선
같은 런타임과 IO Processor 패턴을 세 모델에 적용했습니다. 적용 방식은 같았지만 모델마다 얻은 결과와 배운 점은 달랐습니다.
재순위화 모델: 처리량 6.2배 증가
재순위화 방식은 크게 바이 인코더, 교차 인코더, 지연 상호작용(late interaction) 방식으로 나눌 수 있습니다. 바이 인코더는 질의와 문서를 각각 임베딩한 뒤 유사도를 계산하므로 빠르지만 둘 사이의 세밀한 상호작용을 놓칠 수 있습니다. 교차 인코더는 질의와 문서를 한 입력으로 묶어 처리하므로 정확도가 높지만 후보 수만큼 순전파를 수행해야 합니다.
저희는 정확도를 우선해 교차 인코더를 사용했고, 후보 수만큼 늘어나는 순전파 비용은 vLLM이 풀어줄 것이라고 보았습니다. 실제로 IO Processor가 하나의 질의와 N개의 후보를 입력 쌍으로 만들면 vLLM이 여러 순전파를 하나의 배치로 처리했습니다. 같은 0.6B 모델과 같은 입력, 같은 GPU에서 세 경로의 처리량을 측정한 결과는 다음과 같습니다.
| 실행 경로 | QPS | 기준 대비 |
|---|---|---|
Hugging Face encode | 63.85 | 기준 |
vLLM generate(로그 확률 반환) | 327.18 | 약 5.1배 |
vLLM score | 397.21 | 약 6.2배 |
Hugging Face 경로에서 vLLM generate 태스크 경로로 옮겼을 때의 5.1배 차이는 앞서 살펴본 커널 수준의 변화가 그대로 작용한 결과입니다.
작성 시점에 H100에서 Qwen3 계열 0.6B 재순위화 모델과 vLLM 0.19.0을 사용해 다시 측정했습니다. 모든 경로는 BF16으로 실행했고, 실제 검색 질의와 리뷰 1만 쌍을 입력했습니다. Hugging Face 경로는 패딩 방식과 배치 크기를 조합해 가장 빠른 설정을 사용했습니다.
| 실행 경로 | 처리량(pairs/s) | 기준 대비 |
|---|---|---|
| Hugging Face, 길이 256 고정 패딩 | 194 | 기준 |
| Hugging Face, 동적 패딩(배치 32) | 400 | 2.1배 |
vLLM score | 1,769 | 9.1배 |
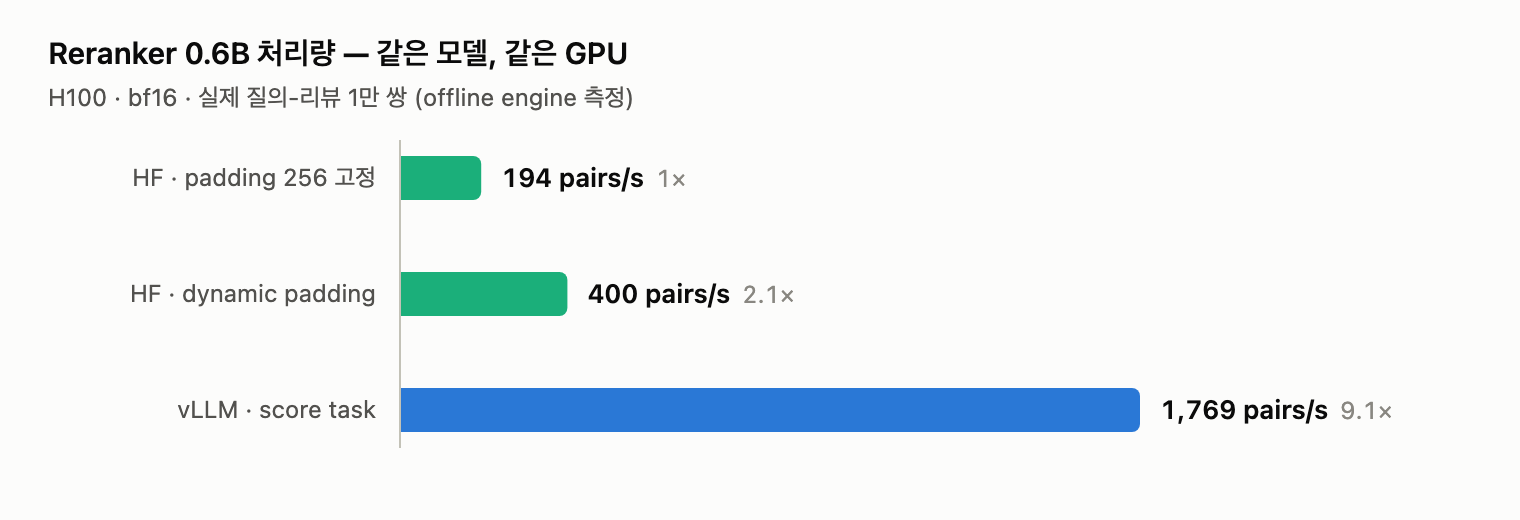
고정 패딩과 동적 패딩을 적용한 Hugging Face 경로, vLLM 경로의 처리량 비교
vLLM score 경로의 처리량은 고정 패딩을 적용한 Hugging Face 경로보다 9.1배 높았고, 동적 패딩을 적용한 Hugging Face 경로보다도 4.4배 높았습니다. 동적 패딩이 격차의 절반가량을 설명했지만, 나머지 차이는 배치 처리와 커널 배치에서 발생했습니다. Hugging Face 경로의 패딩과 배치 크기를 가장 유리하게 조정해도 따라오지 못한 부분입니다.
위 결과는 엔진에 입력 1만 쌍을 한 번에 전달한 오프라인 측정입니다. 그래서 실제 API 요청 방식으로도 확인해 보았습니다. score 태스크의 /rerank 엔드포인트는 질의 하나와 후보 문서 20개를 한 요청으로 받습니다. H100 한 장에서 동시 요청 1개일 때 p50은 24.9ms, 처리량은 787 pairs/s였습니다. 동시 요청 16개에서는 p50 99.7ms, 처리량 3,043 pairs/s를 기록했습니다. 후보 20개를 HTTP 요청 한 번으로 처리할 수 있고, 별도의 샘플링 매개변수 없이 로짓을 바로 반환한다는 API 특성도 저희가 score 태스크를 선택한 이유였습니다.
vLLM에서는 핵심 로직 몇 줄만 바꿔 다른 재순위화 방식을 쉽게 적용할 수 있습니다. 바이 인코더는 task="embed" 결과에 F.cosine_similarity를 적용하고, 교차 인코더는 질의와 문서 쌍을 함께 토큰화한 뒤 task="classify"를 적용합니다. 지연 상호작용 방식은 task="token_embed" 결과에 MaxSim을 적용합니다. 같은 IO Processor 인터페이스를 유지하면서 설정과 처리 로직만 바꾸면 되므로, 나중에 지연 상호작용 방식을 실험하더라도 새 플러그인을 만들 필요가 없습니다.
속성 기반 감성 모델: p50 지연 시간 83.8% 감소
속성 기반 감성 모델은 리뷰에서 속성별 감성을 추출합니다. 예를 들어 “음식은 맛있었는데 웨이팅이 너무 길었어요”라는 리뷰에서 음식은 긍정, 웨이팅은 부정이라는 구조화된 신호를 만듭니다.
ModernBERT-large 0.4B 기반 인코더를 L4 24GB GPU 한 장에서 실행해 Hugging Face 경로와 vLLM 경로의 지연 시간을 비교했습니다. vLLM 버전은 0.19.0이었고, 두 경로 모두 FP32를 명시했습니다. Hugging Face 경로는 길이를 256으로 고정 패딩해 단건 요청에서도 매번 최대 길이로 순전파를 실행합니다. 이 경로의 p50은 101.22ms, p99는 155.54ms였습니다. vLLM 경로는 동적 패딩과 최적화된 커널을 적용해 p50 16.43ms, p99 22.02ms를 기록했습니다. p50과 p99 지연 시간이 각각 83.8%, 85.8% 감소한 결과입니다.
변환 전후 결과의 동등성(parity)은 테스트 데이터 414건을 사용해 원본 모델과 vLLM 변환 모델의 결과를 대조하는 방식으로 검증했습니다. 감성 분류는 414건 모두 일치해 일치율 100%를 기록했고, 범위(span)는 413건이 일치해 99.76%의 일치율을 보였습니다. 한 건의 차이는 원본 모델의 패딩 처리에서 발생한 경계 사례였으며, 이 사례에서는 vLLM 쪽이 더 정확한 범위를 산출했습니다.
단건 요청에서 배치 처리로 넘어가면 양상이 조금 달라집니다. 배치 크기를 1, 8, 32, 64로 늘렸을 때 처리량은 각각 5.91배, 3.70배, 4.14배, 4.05배 증가해, 단건보다 배치에서 개선 폭이 줄어들었습니다. 이는 운영 설정에 맞추기 위해 enforce_eager=True로 CUDA Graph를 사용하지 않아, 즉시 실행에 필요한 부가 비용이 배치와 함께 선형으로 누적됐기 때문입니다. 즉, 측정 오차가 아니라 운영 설정에서 비롯된 차이입니다.
숫자가 너무 좋으면 의심부터 해야 합니다. 초기 측정에서는 배치 64 기준으로 13.1배라는 결과가 나왔습니다. 기뻐하기에는 숫자가 너무 좋아 원인을 확인해 보니, dtype="auto"로 실행한 vLLM이 풀링 모델과 FP16 지원 GPU의 조합을 보고 FP32 모델을 FP16으로 자동 변환하고 있었습니다. 즉, 이 수치는 런타임 개선 효과 4.05배와 FP16 변환 효과 약 3.2배가 합쳐진 결과였습니다. 양쪽을 FP32로 고정하자 순수한 런타임 개선 폭인 4.05배가 남았습니다.
이 일 이후 저희 팀에는 자료형은 항상 명시적으로 전달한다는 운영 규칙이 생겼습니다. 부수적인 발견도 있었습니다. 양쪽 경로의 자료형을 FP32로 맞추자 최대 GPU 메모리 사용량은 vLLM이 오히려 약 10% 더 많았습니다(2,642MiB에서 2,901MiB). PagedAttention 블록 테이블과 CUDA 작업 공간의 사전 할당 비용이 드러난 것으로, 평소에는 FP16 자동 변환이 이 비용을 가려주고 있었다는 뜻이기도 합니다.
이미지 랭킹 모델: 단계별 최적화로 처리량 16.5배 증가
이미지 랭킹 모델은 가장 손이 많이 간 모델입니다. CLIP 비전 인코더와 텍스트 인코더 위에 교차 모달 랭킹 어댑터를 결합해 이미지와 질의의 랭킹 점수를 산출하는 멀티모달 스코어링 모델입니다. 앞선 두 모델처럼 한 번의 변경으로 큰 폭의 개선을 얻은 것이 아니라 다섯 단계에 걸쳐 성능을 높였기 때문에, 각 단계를 따로 살펴볼 가치가 있었습니다.
출발점은 Hugging Face 단건 순전파 기준 3.76 img/s였습니다. 비전 인코더와 어댑터가 순차적으로 실행되면서 GPU 사용률은 9%까지 떨어졌습니다.
모델 단계에서 약 8.2배. 먼저 어댑터 내부 연산을 배치로 처리하고 이미지를 미리 리사이즈해 처리량을 약 5.7배 높였습니다. 가장 큰 변화는 비전 특징 577개를 캐시로 옮기고 입력 시퀀스에는 표시 토큰 하나만 남긴 것입니다. 시퀀스 길이가 654개에서 78개로 줄면서 텍스트 인코더의 연산량이 크게 감소했고, 한 배치에 넣을 수 있는 입력도 12개에서 105개로 늘었습니다. 마지막으로 BF16을 적용하자 처리량은 30.97 img/s에 도달했습니다. 모델의 순전파 코드를 거의 건드리지 않고 8배가 넘는 성능 향상을 얻은 것입니다.
서빙 단계에서는 16.5배까지. 이후부터 측정 단위는 로컬 단건 실행에서 vllm serve와 동시 HTTP 요청을 사용하는 서버 모드로 바뀝니다. IO Processor의 이미지 다운로드를 순차 처리에서 ThreadPoolExecutor(16) 기반 병렬 처리로 바꾸고, 연결 풀과 keep-alive를 적용했습니다. 어댑터의 nn.MultiheadAttention은 vLLM의 QKVParallelLinear, FLASH_ATTN 기반 인코더 어텐션, RowParallelLinear 조합으로 교체했습니다. 그 결과 CUDA Graph의 PIECEWISE 모드에서 그래프 51개를 정상적으로 캡처할 수 있었습니다. 렌더러 worker 수도 조정해 최종 처리량은 62.2 img/s에 도달했습니다. worker를 32개까지 늘리면 GIL과 CPU 경합 때문에 오히려 처리량이 낮아졌습니다.
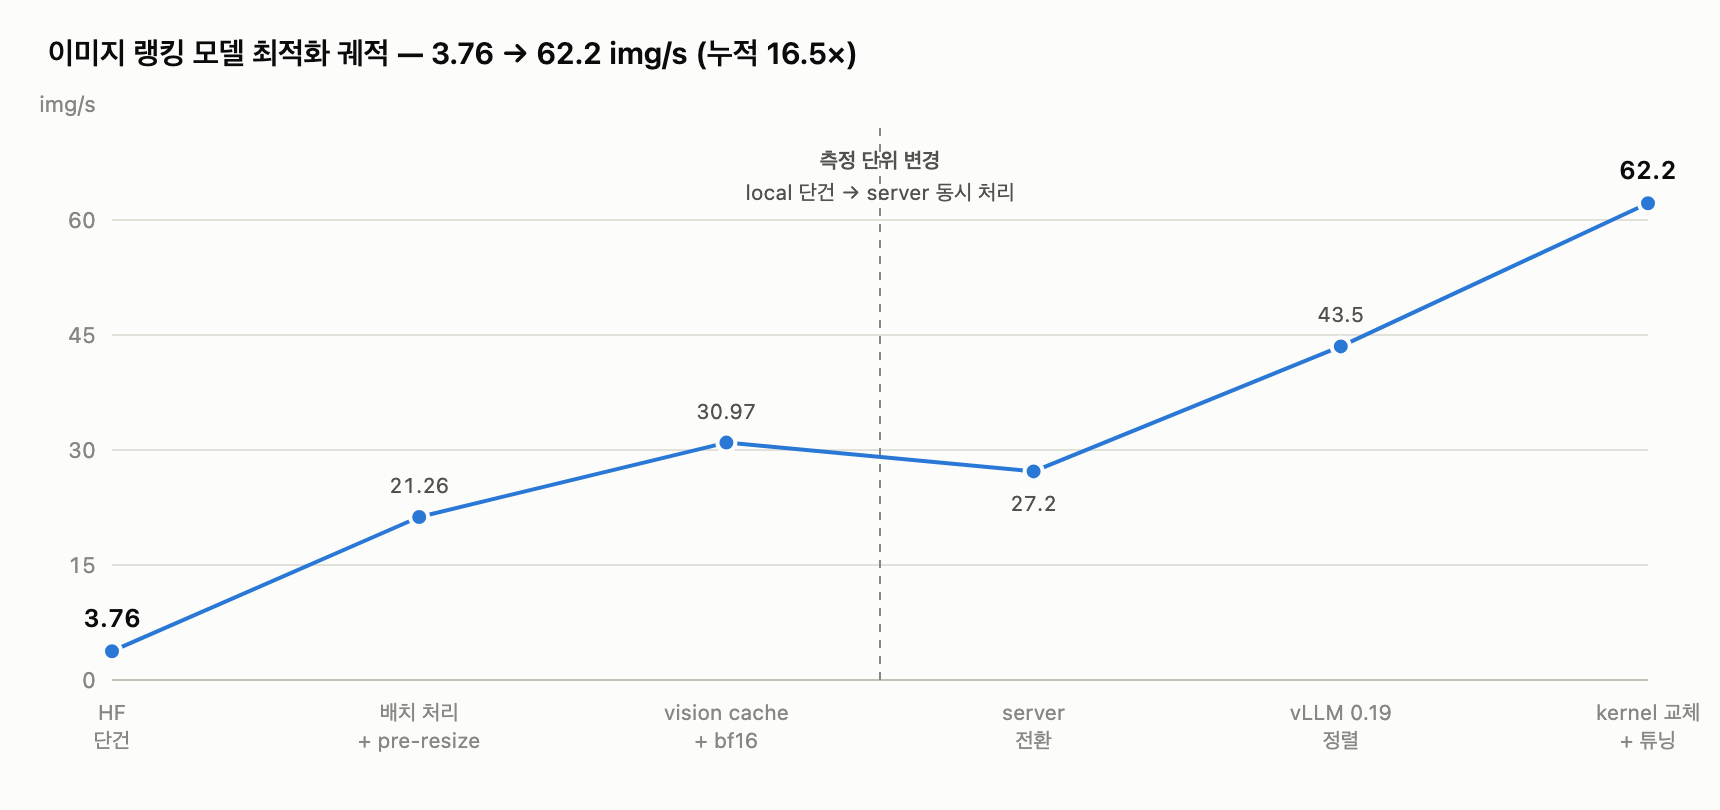
Hugging Face 단건 실행부터 vLLM 서버 적용까지 단계별 이미지 처리량 변화
빠르게 만드는 것까지는 절반이었습니다. CUDA Graph를 적용한 직후 같은 범주의 이미지가 모두 같은 점수를 반환하는 문제가 발생했습니다. PIECEWISE CUDA Graph가 78개 토큰을 80개로 패딩하면서 비전 캐시 분기의 total % 78 == 0 조건이 성립하지 않았고, 준비 실행에 사용한 0 벡터가 실제 추론에도 입력된 것이 원인이었습니다.
10만 건 규모의 부하 테스트에서는 같은 이미지가 같은 배치에 여러 번 들어올 때 점수가 달라지는 문제도 발견했습니다. dict[key] = features로 저장한 값을 pop()하는 방식은 중복 입력 가운데 하나만 처리하고 나머지를 0 벡터로 바꿨습니다. 캐시를 FIFO 구조로 바꾸자 불일치가 50건 중 47건에서 1건으로, 평균 오차는 0.47에서 0.05로 줄었습니다. 처리량뿐 아니라 동시 요청과 중복 입력에서도 결과가 일관적인지 확인한 뒤에야 운영에 적용할 수 있다는 것을 보여주는 사례였습니다.
전체 요청 경로의 성능 비교
앞선 결과는 모두 모델 추론 구간을 비교한 수치입니다. 처음에 문제로 삼은 것은 경로 전체였으므로, 구조 변경이 실제 요청 전체에 미치는 영향을 공정하게 확인하기 위해 기존 구조(전후처리 서비스와 Hugging Face 모델 서버로 이어지는 두 구간)와 vLLM 기반 구조(vLLM과 IO Processor를 결합한 단일 엔드포인트)를 같은 장비에서 실행해 동일한 부하를 적용했습니다.
속성 기반 감성 모델 실험에는 H100 80GB GPU 한 장을 사용했습니다(앞선 L4 실험과 달리 이 전체 경로 비교만 H100에서 진행). 두 경로 모두 FP32이며 요청 하나에는 입력 쌍 8개가 포함됩니다. 기존 구조는 실제 레거시 구현과 같이 길이를 256으로 고정 패딩하고 서비스별로 단일 worker를 사용했습니다. 통신은 같은 장비 안에서 이루어졌습니다.
| 지표 | 기존 구조(2개 구간) | vLLM 단일 엔드포인트 |
|---|---|---|
| p50(동시 요청 1개) | 45.4ms | 25.9ms(43.0% 감소) |
| p50(동시 요청 32개) | 1,576ms | 366ms(76.8% 감소) |
| p95(동시 요청 32개) | 1,657ms | 477ms(71.2% 감소) |
| 최대 처리량 | 약 176 pairs/s | 683 pairs/s(3.9배) |
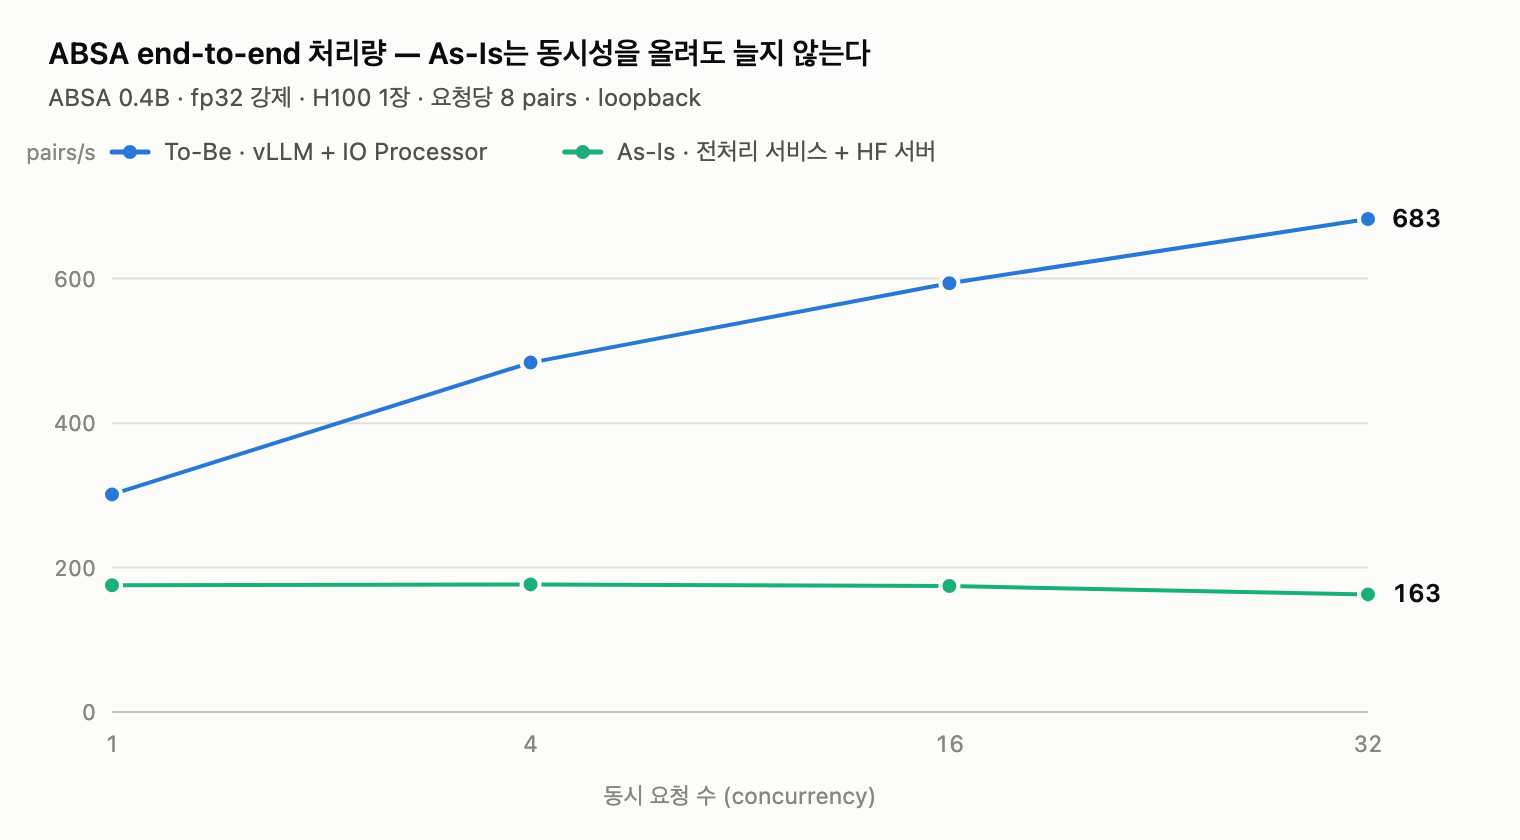
동시 요청 수에 따른 기존 구조와 vLLM 단일 엔드포인트의 처리량
가장 눈여겨볼 것은 처리량입니다. 기존 구조는 동시 요청을 1개에서 32개로 늘려도 처리량이 약 176 pairs/s에서 증가하지 않았습니다. 요청 사이에 배치를 구성하지 못해 GPU가 요청을 순차 처리했고, 늘어난 동시성은 대기 시간으로 이어졌습니다. 반면 vLLM은 연속 배치로 여러 요청을 합쳐 처리하므로 동시 요청 수와 함께 처리량도 증가했습니다.
여기서 네트워크 구간 하나가 추가하는 순수 비용을 분리하기 위해 새 구조 앞에 전달만 수행하는 프록시를 한 단계 추가해 봤습니다. 같은 장비 안에서 p50 차이는 요청당 약 0.5ms였습니다. 즉, 두 구조의 성능 차이는 네트워크 왕복 자체가 아니라 분리된 경로의 요청 단위 순차 처리와 고정 패딩, 이중 직렬화에서 비롯된 것입니다. 실제 서비스 네트워크에서는 각 구간의 지연 시간이 추가되므로 이 결과는 보수적인 값이라고 볼 수 있습니다.
이미지 랭킹 모델에서도 같은 방식으로 전체 요청 경로를 비교했습니다. 텍스트는 페이로드가 작아 네트워크 구간 하나의 비용이 약 0.5ms였지만, 이미지는 전송하고 처리할 데이터가 훨씬 큽니다.
기존 구조는 별도 전처리 서비스가 이미지를 내려받아 디코딩·리사이즈·재인코딩한 뒤 Base64로 모델 서버에 전달했습니다. 새 구조에서는 클라이언트가 이미지 URL만 보내고 IO Processor가 다운로드부터 처리했습니다. 요청당 원본 이미지 10장, 이미지 평균 크기는 3~4MB였습니다.
| 지표 | 기존 구조(전처리 서비스 경유) | vLLM 단일 엔드포인트 |
|---|---|---|
| p50(동시 요청 1개) | 1,191ms | 694ms(41.7% 감소) |
| p50(동시 요청 16개) | 17,339ms | 3,965ms(77.1% 감소) |
| 최대 처리량 | 약 8.6 img/s | 40.6 img/s(4.7배) |
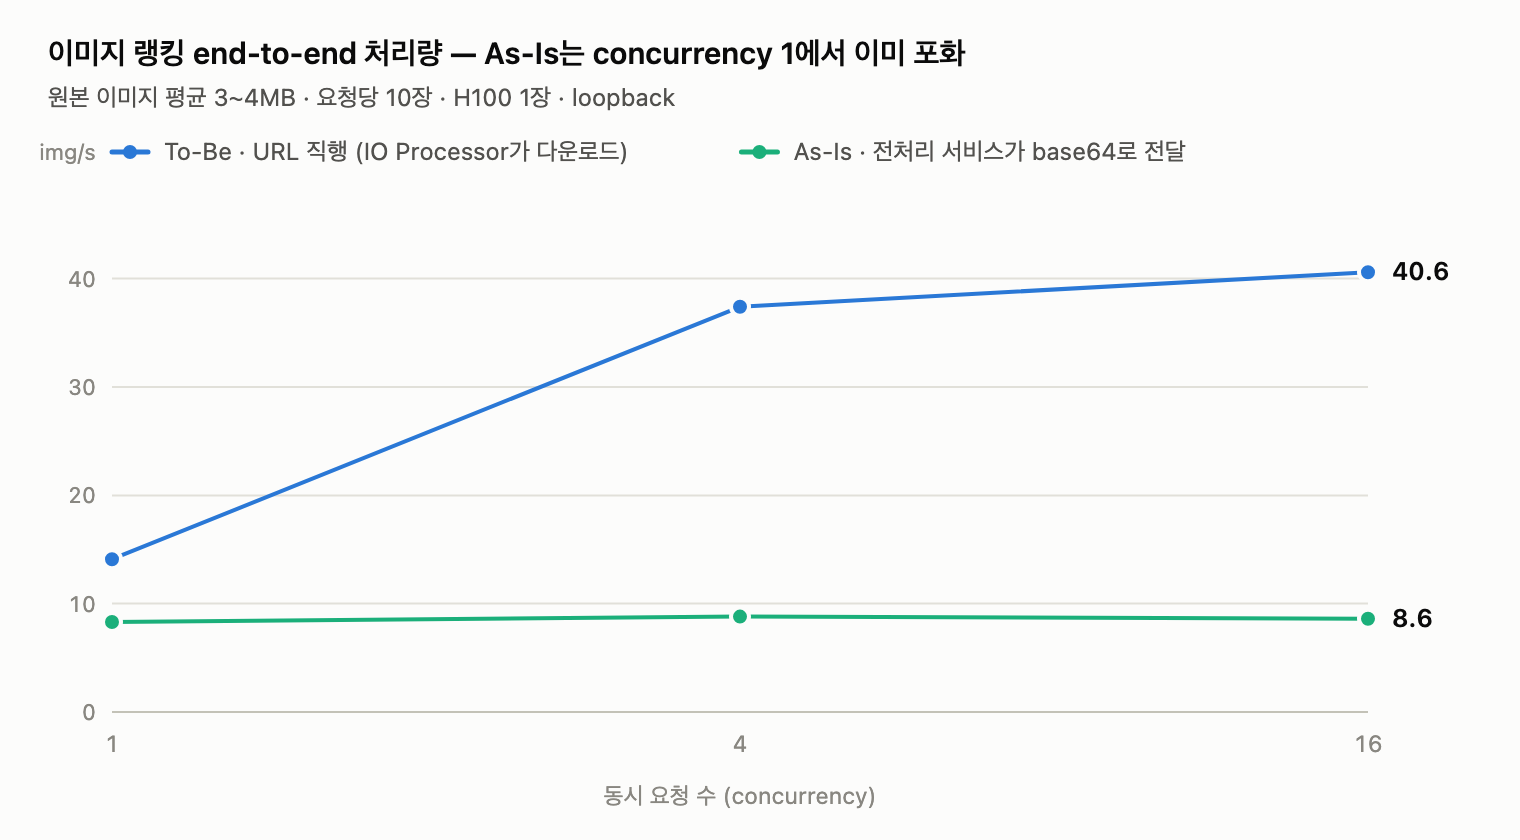
동시 요청 수에 따른 기존 전처리 구조와 IO Processor 구조의 이미지 처리량
기존 전처리 서비스는 다운로드, 대형 이미지 디코딩, 리사이즈, Base64 재인코딩을 한 프로세스에서 처리해 동시 요청이 1개일 때부터 한계에 도달했습니다. 새 구조에서는 IO Processor의 다운로드 스레드 풀과 vLLM 렌더러 worker가 작업을 병렬로 처리했습니다. 그 결과 최대 처리량은 4.7배 증가했고, 동시 요청 16개에서 p50 지연 시간은 약 17초에서 4초로 줄었습니다.
다만 CDN에서 미리 리사이즈한 섬네일(w560)을 입력하면 두 경로 모두 빨라지고 처리량 차이도 1.7배로 줄었습니다. 심지어 동시 요청이 1개일 때는 기존 구조가 근소하게 빨랐습니다. 전처리 서비스가 이미지를 줄인 만큼 모델 서버의 부담이 작아지기 때문입니다. 즉, 두 구조의 성능 격차는 동시 요청이 늘어날 때 벌어집니다. 런타임 구조를 선택하기 전에 CDN 리사이즈 같은 입력 최적화부터 챙겨야 한다는 것도 이 실험이 보여준 중요한 사실입니다.
또한 기존 경로에서는 전처리 서비스의 JPEG 재인코딩으로 인해 같은 이미지의 점수가 미세하게 달라졌습니다(1.883 → 1.813). 전처리 위치는 성능뿐 아니라 결과의 정합성에도 영향을 줍니다.
vLLM을 수정하지 않는 플러그인 구조
여기까지가 성능에 관한 이야기였다면, 남은 질문은 배포입니다. 사용자 정의 모델과 IO Processor를 어떻게 vLLM에 연결할 것인가를 결정해야 했습니다. 제 경험상 가장 쉬우면서도 가장 후회하기 쉬운 방법은 vLLM을 포크하는 것입니다. 빠르게 시작할 수 있지만, 새 릴리스가 나올 때마다 변경 사항을 병합하고 달라진 내부 인터페이스에 대응해야 해 유지보수 비용이 눈덩이처럼 불어납니다. 저희는 vLLM 코어를 계속 업데이트할 수 있도록 비즈니스 로직만 분리하고 싶었습니다. 다행히 외부 플러그인(out-of-tree plugin)을 사용하면 사용자 정의 모델과 IO Processor를 별도 패키지로 연결할 수 있었습니다.
사용자 정의 모델 등록 코드와 IO Processor는 하나의 플러그인 패키지에 포함했습니다. pyproject.toml에는 다음과 같이 엔트리 포인트를 선언합니다.
[project.entry-points."vllm.general_plugins"]
register_models = "our_vllm_plugin:register_models"

[project.entry-points."vllm.io_processor_plugins"]
reranker = "our_vllm_plugin.io_processors:reranker"
absa = "our_vllm_plugin.io_processors:absa"
image_ranker = "our_vllm_plugin.io_processors:image_ranker"
pip install로 패키지를 설치하면 vLLM이 시작할 때 두 엔트리 포인트 그룹을 찾아 플러그인을 자동으로 불러옵니다. 새 모델을 추가할 때는 pyproject.toml에 엔트리 포인트를 한 줄 추가하면 됩니다. vLLM 본체에서 이를 처리하는 코드도 놀랄 만큼 단순합니다. Python 표준 엔트리 포인트 메커니즘 위에 vllm.general_plugins와 vllm.io_processor_plugins라는 두 그룹 이름만 약속해 둔 구조입니다.
discovered = entry_points(group=group)  # Python 표준 importlib.metadata
for plugin in discovered:
    func = plugin.load()
    plugins[plugin.name] = func
여기서 눈여겨볼 점이 하나 있습니다. 일반 플러그인은 모든 worker 프로세스에서 로드돼 ModelRegistry를 채우고, IO Processor는 process 0에서만 로드돼 요청 스케줄링 앞단에서 동작합니다. 이 분리는 운영 파드에서 모니터링과 재시작의 단위를 결정합니다. 모델 OOM으로 worker 프로세스가 재기동돼도 IO Processor 캐시는 유지되며, IO Processor의 문제를 수정할 때는 worker 프로세스를 건드리지 않고 process 0만 재기동할 수 있습니다.
배포는 KServe InferenceService로 표준화했습니다. 공통 vLLM 이미지에 플러그인 패키지, 모델 아티팩트, IO Processor 설정만 바꿔 끼우면 자동 확장, 라우팅, 관측 기능이 표준 방식으로 적용됩니다. 모델 서빙은 Python 프로세스를 띄우는 것으로 끝나지 않고 배포·자동 확장·롤백·모니터링까지 포함하는 운영 문제입니다. 그래서 모델별 로직은 플러그인에 두고 운영 방식은 KServe로 통일했습니다.
다만 주의할 점도 있습니다. 플러그인 엔트리 포인트가 안정적이더라도 사용자 정의 모델 클래스가 사용하는 vLLM 내부 인터페이스는 버전에 따라 바뀔 수 있습니다. 따라서 플러그인 패키지에서는 vllm==0.19.0처럼 정확한 버전을 지정하고, 새 버전은 호환성 검증을 마친 뒤 올리고 있습니다.
모델 변환에서 지켜야 할 실행 계약
Hugging Face 모델을 vLLM 사용자 정의 모델로 옮기는 일을 흔히 ‘가중치 변환’이라고 부릅니다. 그런데 실제 작업에서는 가중치 자체보다 원본 모델의 실행 계약을 재현하는 일이 더 어렵습니다. 학습 프레임워크의 유연한 순전파가 암묵적으로 처리하던 동작을 vLLM의 명시적인 인터페이스에 맞춰 하나하나 재현해야 하기 때문입니다.
재현해야 할 항목은 다음과 같습니다.
- 설정 매핑
- 모델 클래스
- 접두사 변경과 필요한 경우의 헤드 결합을 포함한 가중치 적재
- 풀링 헤드 결정
- 토크나이저 또는 프로세서
- IO Processor
모델 클래스를 구현할 때 반드시 지켜야 할 규칙이 하나 있는데, deepcopy(vllm_config)로 설정을 복사한 뒤 hf_config를 교체해야 한다는 것입니다. 호출자가 공유하는 vllm_config를 직접 수정하면 여러 요청 사이에 간섭이 생길 수 있습니다. 문서에서 크게 드러나지 않아 직접 문제를 겪고 나서야 알게 된 규칙입니다.
세 모델을 변환하며 반복해서 확인한 항목도 정리했습니다.
- Hugging Face의 유연한 순전파를 vLLM의 명시적인 실행 방식으로 재현
- CLS, LAST, MEAN, 사용자 정의 방식 가운데 실제 출력과 같은 풀링 방식 선택
- sigmoid, softmax, 레이블 매핑, 임곗값 재현
- PIL, torchvision, Hugging Face 프로세서 기반 전처리의 운영 안정성 확보
- 단건과 배치 결과의 수치 동등성 검증
- FP32 기준 결과와 FP16·BF16 온라인 점수의 차이 검증
- vLLM 버전별 내부 인터페이스 변화 대응
이 가운데 하나라도 빠지면 오프라인 평가 지표는 같지만 온라인 점수가 조금씩 달라지는, 디버깅하기 매우 까다로운 문제가 생길 수 있습니다. 사람이 눈으로 확인하기 어려운 문제이므로 저희는 단건·배치 결과의 수치 동등성 테스트를 CI에 추가해 변환 결과를 자동으로 검증하고 있습니다.
마치며
이번 전환의 결과를 요약하면 다음과 같습니다.
| 모델 | 변경 전 | 변경 후 | 개선 폭 |
|---|---|---|---|
| 재순위화 0.6B | 63.85 QPS | 397.21 QPS | 6.2배 |
| 속성 기반 감성 모델 0.4B(p50) | 101.22ms | 16.43ms | 83.8% 감소 |
| 이미지 랭킹 | 3.76 img/s | 62.2 img/s | 16.5배 |
이 성능은 모델을 더 빠르게 만들어서 나온 것이 아닙니다. vLLM 풀링 런타임이 커널 실행 수와 메모리 접근 방식을 재배치하고, IO Processor가 순전파 앞뒤의 네트워크 구간과 직렬화를 줄인 결과입니다. 그리고 그 결과물은 플러그인 패키지로 분리해 vLLM을 포크하지 않고도 pip install 한 번으로 같은 구조를 새 모델에 반복 적용할 수 있게 했습니다.
돌아보면 이 작업에서 배운 것은 서빙 성능이 어디에서 저하되는지 끝까지 의심하는 태도였습니다. 모델의 순전파를 의심했지만 실제 원인은 경로에 있었고, 13.1배라는 초기 결과를 의심하자 자료형 자동 변환 효과가 섞여 있다는 사실을 발견했습니다. 이미지 모델은 빨라진 뒤에야 캐시와 패딩 때문에 결과가 달라지는 문제를 확인했습니다. 또한 검색 품질은 모델 하나가 아니라 여러 스코어링 모델이 같은 런타임 위에서 빠르고 안정적으로 동작할 때 만들어진다는 점을 수치로 확인할 수 있었습니다.
비슷한 고민을 하고 계신 분들께 이 기록이 작은 이정표가 되길 바랍니다.